





Hãy hình dung trung tâm trợ giúp của một ứng dụng web. Bạn đã viết một bài có tiêu đề « Đặt lại mật khẩu tài khoản ». Tuy nhiên, người dùng không nhất thiết sẽ gõ những từ đó vào thanh tìm kiếm. Thay vào đó, họ hỏi: « Làm thế nào để lấy lại quyền truy cập vào tài khoản của tôi? »
Thông tin phù hợp đã tồn tại. Vấn đề là tìm lại nó dù từ vựng thay đổi, rồi đưa nó lên đủ cao để người dùng nhìn thấy. Hiển thị một bài cũng nói về tài khoản nhưng giải thích cách thay đổi địa chỉ email sẽ không giải quyết yêu cầu của họ.
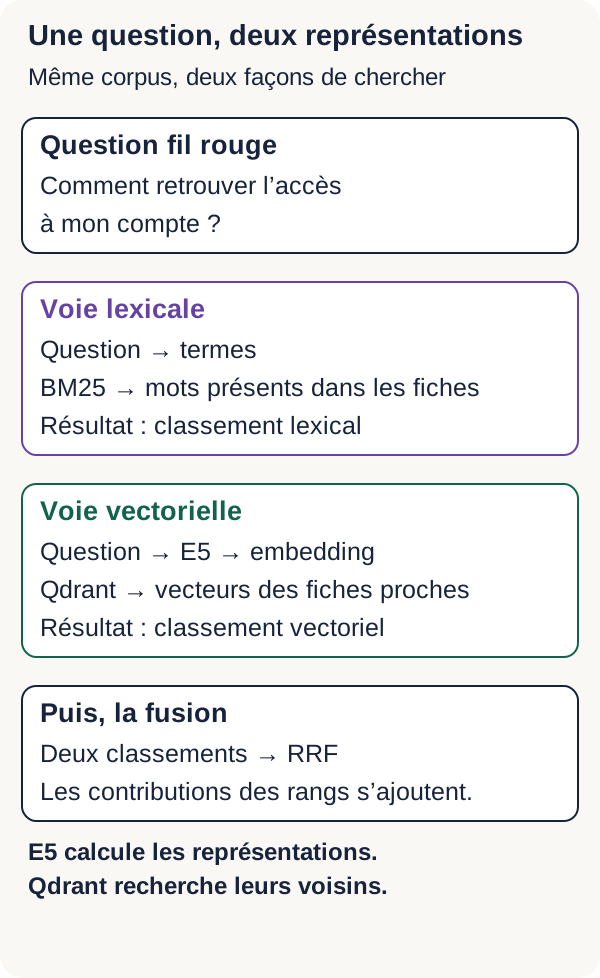
Đó là vấn đề chúng ta sẽ khảo sát. Câu hỏi xuyên suốt, « Làm thế nào để lấy lại quyền truy cập vào tài khoản của tôi? », phải dẫn đến bài ID 0, REF-100, về việc đặt lại mật khẩu. Nó không nhắm đến bài ID 1, REF-101, về thay đổi địa chỉ email. Cả hai đều thuộc nhóm Compte, nhưng trả lời những ý định khác nhau.
Chúng ta sẽ xây dựng ba bảng xếp hạng, quan sát những điểm chúng không đồng thuận và hiểu các phép tính của chúng. Kèm một điều bất ngờ hữu ích: kết hợp hai phương pháp không tự động tốt hơn chỉ dùng một phương pháp.
Tải xuống dự án hoàn chỉnh của hướng dẫn — bản lưu trữ công khai r3, gồm mã nguồn, dữ liệu, kiểm thử và hướng dẫn dành cho người đọc.
Các lệnh, đoạn mã và kết quả được trình bày tương ứng với lộ trình r3. Những ví dụ nhỏ được ghi rõ là sư phạm dùng để hiểu các phép tính; chúng không phải là các phép đo mới của mô hình.
Những gì bạn sẽ xây dựng
Bạn sẽ xây dựng một công cụ tìm kiếm nhỏ trả về ba danh sách bài cho cùng một câu hỏi.
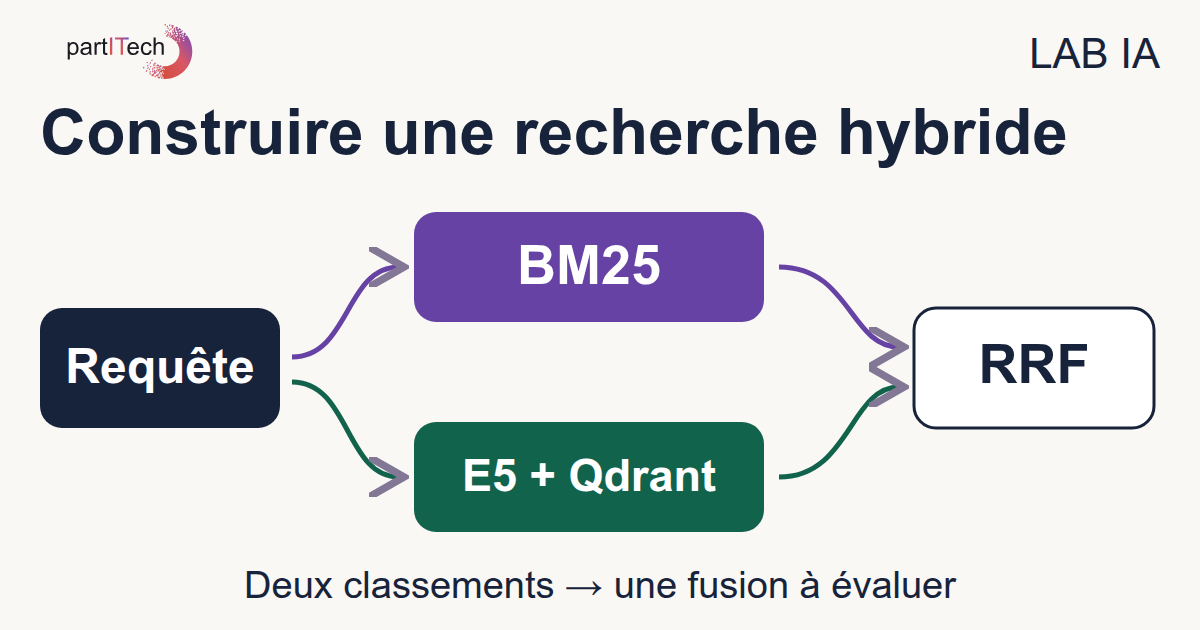
BM25 xếp hạng các bài dựa trên những thuật ngữ chúng có chung với câu hỏi. E5 và Qdrant xếp hạng chúng dựa trên biểu diễn số của văn bản. Sau đó RRF kết hợp các vị trí có được trong hai danh sách.
Vì vậy, với một lập trình viên web, đầu ra giống kết quả tìm kiếm trong một danh mục hơn là một cuộc hội thoại: danh sách có thứ tự gồm định danh, tham chiếu và văn bản nguồn. Hướng dẫn tạo ra các tệp JSON mà bạn có thể mở và so sánh. Nó chưa cung cấp giao diện web để tìm kiếm.
Đây không phải chatbot. Không mô hình nào soạn câu trả lời cho người dùng. Chúng ta tìm đúng bài; không yêu cầu AI diễn đạt lại quy trình hoặc bịa ra câu trả lời khi danh mục không có.
Những gì bạn sẽ học
Lộ trình gồm ba bước:
- Chuẩn bị một thí nghiệm dễ đọc: nạp một corpus JSON, giữ các định danh ổn định và xác định các bài được mong đợi cho từng câu hỏi.
- Xây dựng hai cách tìm kiếm: tính BM25, tạo embedding E5 trên GPU, rồi lưu trữ và truy vấn chúng bằng Qdrant.
- So sánh thay vì giả định: hợp nhất thứ hạng bằng RRF, đo mức liên quan và độ trễ, sau đó giải thích từng kết quả theo từng bài.
Một corpus đơn giản là tập hợp các tài liệu được nghiên cứu. Một chú thích mức liên quan cho biết bài nào được xem là câu trả lời tốt cho một câu hỏi. Hai khái niệm này cũng quan trọng như việc chọn mô hình.
Điều kiện tiên quyết
Kiến thức
Bạn biết dùng danh sách và từ điển Python, viết hàm, đọc JSON và làm việc trong terminal. Bạn biết các khái niệm cơ bản về Docker: image, container và volume. Không cần có sẵn kiến thức về BM25, embedding hay Qdrant.
Bạn không cần biết cách huấn luyện một mô hình. Trong hướng dẫn này, chúng ta sẽ dùng một mô hình đã được huấn luyện để tính các biểu diễn văn bản. Lập chỉ mục các bài không có nghĩa là huấn luyện lại E5.
Phần cứng
Cấu hình dự kiến là Linux x86_64, có GPU NVIDIA tương thích CUDA với 5 Gio bộ nhớ video trống, 12 Gio RAM khả dụng và 20 Gio dung lượng đĩa trống, cả trên vùng lưu trữ dự án lẫn vùng của Docker.
Bộ nhớ video, hay VRAM, thuộc về GPU; không được nhầm nó với RAM chính của máy. CUDA là môi trường được dùng ở đây để thực hiện tính toán của mô hình trên GPU NVIDIA.
Các giá trị này là biên độ thoải mái được preflight kiểm tra, không phải mức tối thiểu được xác lập bằng việc tìm cấu hình nhỏ nhất có thể. Lộ trình r3 đã được tái lập trên một RTX 3090. ZIP không có lộ trình CPU: vì vậy, đừng coi việc chạy không có GPU là một biến thể đã được xác nhận của bài thực hành này.
Phần mềm
Cần có Docker Engine với plugin Compose, trình điều khiển NVIDIA và NVIDIA Container Toolkit. Internet chỉ dùng để xây dựng image, tải chúng và lấy mô hình. Khi các tài nguyên này đã có, việc tính toán và tìm kiếm sử dụng các dịch vụ cục bộ.
Đường đi của một truy vấn
Hãy tách bạch hai thời điểm dễ bị nhầm lẫn: chuẩn bị tài liệu và trả lời một yêu cầu tìm kiếm.
Trước lần tìm kiếm đầu tiên, BM25 chuẩn bị bộ đếm thuật ngữ. Về phần mình, E5 biến mỗi bài thành một danh sách số, gọi là vector hoặc embedding, mà Qdrant lưu giữ. Khi một câu hỏi đến, BM25 gán điểm từ vựng cho nó và E5 tính vector của câu hỏi. Khi đó Qdrant có thể tìm các vector bài gần nhất.
Fiches → BM25 : préparation des fréquences
Fiches → E5 passage: → vecteurs → Qdrant : indexation
Question → BM25 → classement lexical
Question → E5 query: → vecteur → Qdrant → classement dense
Classement lexical + classement dense → RRF → classement hybride
RRF xuất hiện ở cuối: nó nhận hai bảng xếp hạng đã được tính và xây dựng bảng thứ ba. Nó không tham gia vào việc chuẩn bị mô hình hay việc E5 đọc các bài.
Lưu ý: một điểm số chỉ có ý nghĩa cùng với phương pháp tính nó. BM25 cộng các đóng góp của thuật ngữ. Nhánh dense đo độ tương đồng cosine, mà chúng ta sẽ giải thích sau. RRF cộng các đóng góp gắn với thứ hạng. So sánh trực tiếp các con số này chẳng khác nào so sánh điểm nhận được theo ba thang điểm khác nhau.
Vì vậy chúng ta sẽ giữ cả ba đầu ra. Câu hỏi hữu ích sẽ không phải « công cụ nào cho số lớn nhất? », mà là « bài được mong đợi nằm ở đâu trong mỗi danh sách? ».
Chuẩn bị máy và các container
Kiểm tra Docker có thấy GPU của bạn
Tải xuống và giải nén ZIP, sau đó mở terminal ở thư mục gốc của nó, nơi có README.md. Mọi lệnh sau đều bắt đầu từ thư mục này. Đừng chạy chúng từ một dự án Docker khác.
Preflight là bước kiểm tra trước, tương tự việc kiểm tra điều kiện tiên quyết trước khi chạy một ứng dụng. Trước hết Linux phải nhìn thấy card bằng nvidia-smi, sau đó Docker phải làm chính card đó có thể truy cập từ container. Hai điều kiện này khác nhau: một card hiển thị trên máy chủ vẫn có thể không truy cập được từ Docker.
Script kiểm tra GPU đã chọn, RAM, không gian đĩa của dự án và vùng lưu trữ Docker. Nó cũng khởi tạo CUDA trong một container chẩn đoán. Kết quả mong đợi là PREFLIGHT=PASS.
./scripts/preflight.sh
NVIDIA Container Toolkit cho phép đưa GPU và các thành phần cần thiết của trình điều khiển máy chủ vào container. Nó không thay thế trình điều khiển đó, và preflight không tự cài đặt nó cho bạn. Nếu chẩn đoán báo GPU thấy được trên máy chủ nhưng không thấy trong Docker, hãy sửa cấu hình được nêu trước khi tiếp tục. Tài liệu chính thức của NVIDIA Container Toolkit trình bày chi tiết việc cài đặt này.
Tiếp theo, khởi tạo dự án:
sh scripts/setup.sh
Nó ghi LOCAL_UID, LOCAL_GID và GPU_DEVICE vào .env, rồi tạo các thư mục làm việc. Hai thiết lập đầu dùng danh tính cục bộ cho các tệp; thiết lập thứ ba chọn card được đưa ra ngoài. Hãy kiểm tra lựa chọn này nếu máy bạn có nhiều GPU.
Cuối cùng, xây dựng image:
docker compose build
Quá trình build phải kết thúc không lỗi. Image r3 bắt đầu từ Python 3.12.13 slim-bookworm Linux amd64, được cố định bằng digest. Digest này xác định chính xác image, thay vì một tên có thể trỏ tới phiên bản khác sau này.
Khóa phụ thuộc cài đặt PyTorch 2.10.0+cu129, Transformers 4.57.6 và Safetensors 0.7.0, cùng URL và dấu vân tay SHA-256 của chúng. PyTorch thực hiện các tính toán số của mô hình; Transformers cung cấp, trong đó có các lớp nạp mô hình và tokenizer. Các thành phần CUDA mà bộ này dùng đến từ gói nhị phân PyTorch; trình điều khiển vẫn nằm trên máy chủ.
Các tham chiếu phân phối là image Python chính thức và wheel PyTorch CUDA 12.9. Để tái lập thí nghiệm, hãy giữ các phiên bản trong ZIP thay vì thay bằng các phiên bản mới nhất có sẵn.
Bản đồ tư duy về volume và dịch vụ
Trước khi chạy mã, hãy xác định đầu vào và đầu ra của nó ở đâu:
| Thành phần | Vai trò trong hướng dẫn |
|---|---|
app |
Python, PyTorch và GPU: chuẩn bị, mã hóa, tìm kiếm và ghi kết quả. |
qdrant |
Chỉ mục vector tạm thời và tìm kiếm láng giềng. |
models/ |
Mô hình cục bộ trong models/e5, được lấy một lần rồi đọc ngoại tuyến. |
outputs/ |
JSON tạo ra ở mỗi bước, được mount lên máy chủ để đọc. |
Dịch vụ app đóng vai trò chương trình chính. Qdrant là một dịch vụ riêng, được truy vấn trên mạng Docker. Các thư mục models/ và outputs/ vẫn hiển thị trên máy của bạn nhờ các volume mount.
Đoạn trích sau đến từ dịch vụ app. Đây không phải tệp Compose độc lập: anchor common, được tái sử dụng bởi <<: *common, được định nghĩa trong tệp hoàn chỉnh. Hãy giữ compose.yaml của ZIP cho các dịch vụ và giới hạn khác.
  app:
    <<: *common
    environment:
      MODEL_DIR: /models/e5
      QDRANT_URL: http://qdrant:6333
      HF_HUB_OFFLINE: "1"
      TRANSFORMERS_OFFLINE: "1"
    volumes:
      - ./models:/models:ro
      - ./outputs:/app/outputs
    networks: [isolated]
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              device_ids: ["${GPU_DEVICE:-0}"]
              capabilities: [gpu]
MODEL_DIR là đường dẫn mô hình được nhìn thấy từ bên trong container. Volume mount ./models:/models:ro nối thư mục cục bộ models/ của bạn với /models; :ro nghĩa là « chỉ đọc ». Còn việc mount outputs/ cho phép lấy các tệp do chương trình ghi.
QDRANT_URL dùng tên dịch vụ qdrant trên mạng Docker. Các biến HF_HUB_OFFLINE và TRANSFORMERS_OFFLINE yêu cầu các thư viện liên quan làm việc ngoại tuyến. Cuối cùng, device_ids chỉ đưa GPU đã chọn ra ngoài; tài liệu Docker về GPU trong Compose giải thích phần đặt trước này.
Image được xây dựng có tên tutorial-hybride:r3.
Bạn sẽ thường gặp docker compose run --rm --no-deps app ở phần sau. Lệnh này chạy chương trình trong một container tạm thời của dịch vụ app, xóa container đó khi kết thúc và không tự động khởi động các phụ thuộc. Vì thế chúng ta sẽ khởi động Qdrant rõ ràng trước các bước cần nó. Các đầu ra được mount lên máy chủ không biến mất cùng container tạm thời này.
Đi xa hơn — Vì sao các container được gia cố
compose.yaml hoàn chỉnh giới hạn những gì container có thể thay đổi hoặc tiêu thụ. read_only đặt thư mục gốc của chúng ở chế độ chỉ đọc, cap_drop: [ALL] loại bỏ các capability Linux bổ sung và no-new-privileges cấm việc có thêm đặc quyền. Mạng nội bộ cùng các giới hạn về bộ nhớ, CPU, tiến trình và tmpfs hoàn thiện các hạn chế này. Tmpfs là một không gian tạm trong bộ nhớ.
Trong lộ trình này, app đọc các mô hình và chỉ ghi đầu ra. Qdrant lưu collection của nó trong vùng lưu trữ tạm thời. Dịch vụ fetch là ngoại lệ đối với mạng và việc ghi mô hình: nó phải kết nối tới kho của chúng và điền vào models/.
Các lựa chọn này giảm khả năng hành động của các dịch vụ. Chúng không tạo thành một bảo đảm an toàn phổ quát và không phải các thiết lập cần sửa đổi để học BM25, E5 hay RRF.
Lấy E5 theo cách có thể tái lập
Mô hình được dùng là intfloat/multilingual-e5-small, ở bản revision cố định 614241f622f53c4eeff9890bdc4f31cfecc418b3.
Trọng số của một mô hình là các tham số số được học trong quá trình huấn luyện. Chúng ta sẽ tải chúng xuống, rồi sử dụng nguyên trạng. Cố định revision giống như giữ lại một commit cụ thể của dependency: ta biết kiến trúc, tệp và trọng số nào đã phục vụ thí nghiệm. Điều này làm các lần chạy có thể so sánh, mà không hứa rằng mọi phần cứng đều cho các phép đo hoàn toàn giống nhau.
Chín tệp cần thiết được mô tả trong configs/models.lock.json, cùng kích thước và dấu vân tay SHA-256. Dấu vân tay là một bản tóm tắt được tính từ các byte của tệp; so sánh nó với giá trị mong đợi giúp phát hiện tệp khác biệt hoặc chưa đầy đủ.
scripts/fetch_model.py tải xuống vào một tệp tạm, kiểm tra kích thước và dấu vân tay, rồi đổi tên nguyên tử sang tệp cuối cùng trong models/e5. Nói cách khác, tên chính thức chỉ được dùng khi kiểm tra đã thành công.
docker compose --profile acquisition run --rm --no-deps fetch
Một tệp cục bộ đã hoàn chỉnh sẽ được kiểm tra lại và tái sử dụng. Trong quá trình lấy về, một tệp bị thiếu hoặc không đúng sẽ được tải lại và phải qua các kiểm tra. Nếu việc xác minh thất bại, quá trình lấy về dừng lại.
Cuối cùng, chín tệp đã xác minh nằm trong models/e5. Lần lấy đầu tiên của chúng chiếm khoảng 493 Mo. Sau đó Internet không còn cần thiết để mã hóa văn bản và tìm kiếm bài.
Việc lấy mô hình và suy luận được tách biệt. Suy luận ở đây là dùng mô hình để tính một vector, không phải huấn luyện nó. Nếu một tệp bị thiếu ở thời điểm đó, encoder sẽ thất bại: nó không lặng lẽ tải một mô hình khác. Quy trình và các giới hạn của nó được mô tả trong docs/MODEL_ACQUISITION.md. Đừng thay revision đã khóa chỉ để làm lỗi biến mất.
Trước khi lập chỉ mục, hãy chạy các kiểm thử và điểm kiểm tra sư phạm:
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app scripts/checkpoint.py
Các lần tái lập r3 hoàn tất 18 kiểm thử không lỗi cũng không bị bỏ qua, rồi xác nhận 7 checkpoint. Chúng bao quát các phép tính, việc lấy mô hình giả lập, suy luận E5 trên CUDA và các bước sư phạm.
Điểm quan trọng là phép tính E5 thực sự trên CUDA: chỉ hiển thị một card sẵn có trong Docker sẽ không đủ để chứng minh mô hình hoạt động trên đó. Hãy xử lý lỗi trước khi tiếp tục; một danh sách kết quả có vẻ hợp lý không thay thế được một kiểm thử thành công.
Nạp các bài
Corpus chứa 16 bài hư cấu. Chúng ta cũng có bốn truy vấn phát triển, với các bài được mong đợi có ID 0, 1, 14 và 15. Chúng dùng để khám phá cách vận hành, đặc biệt với câu hỏi xuyên suốt của chúng ta.
Đánh giá dùng một tập khác: 12 câu hỏi, mỗi câu có một bài liên quan, và hai câu hỏi ngoài corpus, mà không bài nào được chú thích là liên quan.
Chú thích ở đây là nhị phân: một bài hoặc liên quan, hoặc không liên quan với câu hỏi. Đây là các lựa chọn sư phạm, không phải kết quả của một cuộc khảo sát người dùng. Các chú thích dùng để đánh giá bảng xếp hạng; chúng không được dùng để huấn luyện E5 trong hướng dẫn này.
Khởi động Qdrant, rồi chuẩn bị dữ liệu:
docker compose up -d qdrant
docker compose run --rm --no-deps app -m src.cli prepare
Mở outputs/prepared.json. Nó phải thông báo 16 tài liệu và hiển thị bài đầu tiên, ID 0, REF-100. Ở giai đoạn này, Qdrant hoạt động nhưng chưa chứa vector nào: chuẩn bị dữ liệu và lập chỉ mục là hai thao tác riêng biệt.
Dữ liệu: một bài, một định danh, một chú thích
Đây là bài đầu tiên như trong data/corpus.json:
{
  "id": 0,
  "reference": "REF-100",
  "family": "Compte",
  "text": "REF-100 — Réinitialiser le mot de passe du compte. Cliquez sur Mot de passe oublié puis suivez le lien envoyé par courriel."
}
id xác định bài trong mã và trong chỉ mục. reference là tham chiếu dễ đọc của nó. family cho biết chủ đề chung. text chứa nội dung cần tìm.
Trong data/development.json, « Làm thế nào để lấy lại quyền truy cập vào tài khoản của tôi? » có chú thích relevant: [0]. Điều đó nghĩa là: với câu hỏi này, chúng ta mong đợi bài 0. Bài ID 1 được chú thích riêng cho « Thay đổi email của tôi ».
Sự phân biệt giữa family và relevant là thiết yếu. Hai bài trong nhóm Compte có thể rất gần nhau về từ vựng nhưng trả lời hai vấn đề khác nhau. Công cụ không chỉ phải tìm đúng chủ đề: chúng ta sẽ kiểm tra xem nó có tìm đúng quy trình hay không.
Các ID này vẫn ổn định trong bảng xếp hạng, chỉ mục và chú thích, ngay cả khi giao diện chỉ hiển thị tiêu đề hoặc đoạn trích. Corpus không chứa dữ liệu khách hàng nào.
BM25: tần suất, độ hiếm và độ dài
Hãy bắt đầu bằng một phương pháp có thể theo dõi mà không cần mạng nơ-ron.
BM25 là một quy tắc xếp hạng từ vựng: nó cho điểm một bài theo các thuật ngữ dùng chung với câu hỏi. Thay vì chỉ trả lời « văn bản này có chứa từ đó không? », nó phân biệt những từ hữu ích ít nhiều khác nhau và tính đến sự lặp lại của chúng.
Ba ý tưởng dẫn dắt phép tính: một thuật ngữ xuất hiện mang lại tín hiệu; một thuật ngữ hiếm trong corpus mang lại tín hiệu phân biệt hơn; lặp lại thuật ngữ hoặc viết văn bản rất dài không được tự động thắng mọi bảng xếp hạng.
Nhánh này tạo thành tìm kiếm đầu tiên không dùng mô hình nơ-ron, đặc biệt hữu ích khi một tham chiếu hoặc mã lỗi có tính phân biệt. Điểm của nó không phải xác suất: nó dùng để sắp thứ tự các bài trong cùng corpus cho cùng một truy vấn.
Trước hết, quyết định thế nào là một thuật ngữ
Chương trình chuẩn hóa ký tự Unicode theo NFKC, chuyển văn bản thành chữ thường và trích các chuỗi được \w+ nhận diện. NFKC làm hài hòa một số cách biểu diễn ký tự; bước này không có nghĩa là « xóa dấu ».
Vì thế, courriel, trở thành courriel, và REF-100 trở thành hai token, ref và 100. Dấu vẫn được giữ. Mã cũng không tự động đưa compte và comptes về cùng một thuật ngữ.
Một token là đơn vị sinh ra từ cách tách này. Ở đây, nó không phải câu, cũng không nhất thiết là từ như ta thấy trên màn hình. Quy tắc này có hệ quả thực tế: BM25 không xử lý tham chiếu REF-100 như một định danh không thể tách. Việc xác thực một tham chiếu chính xác sẽ là thao tác khác.
Đếm trong một bài không phải đếm trong corpus
Để đọc công thức, hãy giữ các tương ứng sau:
f(t,d): số lần thuật ngữtxuất hiện trong bàid;|d|: số token trong bài này.N: tổng số bài;df(t): số bài chứa thuật ngữ, bất kể số lần lặp trong từng bài.avgdl: độ dài trung bình của các bài, được đo với cùng cách tách token.
Ví dụ, nếu một từ xuất hiện năm lần trong chỉ một bài, tần suất trong bài đó là 5, nhưng bài này chỉ đóng góp 1 vào df(t).
Độ hiếm được tính bởi IDF, viết tắt của inverse document frequency (tần suất tài liệu nghịch đảo):
IDF(t) = log(1 + (N - df(t) + 0,5) / (df(t) + 0,5))
Ở đây log chỉ logarit tự nhiên, được tính bằng math.log. Không cần ghi nhớ công thức để hiểu tác động của nó: một thuật ngữ càng được nhiều bài chia sẻ, nó càng ít giúp phân biệt chúng.
Hãy lấy ba bài hư cấu trong một ví dụ nhỏ, khác với corpus của hướng dẫn. Nếu rare xuất hiện trong một bài, df(rare)=1 và IDF≈0,981. Nếu courant xuất hiện trong cả ba, df(courant)=3 và IDF≈0,134. Vì vậy, trong các điều kiện khác như nhau, từ đầu mang trọng số lớn hơn.
Vì sao lặp lại không mang lại điểm vô hạn
Đóng góp đầy đủ của một thuật ngữ là:
IDF(t) × f(t,d) × (k1 + 1) / (f(t,d) + k1 × (1 - b + b × |d| / avgdl))
Thiết lập k1=1,2 kiểm soát sự bão hòa: lặp lại một thuật ngữ làm tăng đóng góp của nó, nhưng tăng ngày càng ít. Thiết lập b=0,75 kiểm soát hiệu chỉnh gắn với độ dài. Với b=0, hiệu chỉnh này bị bỏ qua; với b=1, nó được áp dụng hoàn toàn.
Để làm sự bão hòa cụ thể, hãy lấy một phép tính sư phạm trong đó bài có đúng độ dài trung bình. Hệ số nhân IDF bằng 1 cho một lần xuất hiện, 1,375 cho hai lần và khoảng 1,964 cho mười lần. Do đó, mười lần lặp không cho số điểm gấp mười.
Các thuật ngữ của câu hỏi thì được loại trùng lặp. Lặp lại cùng một từ mười lần trong câu hỏi không làm đóng góp của nó nhân mười.
Tài liệu BM25 của Apache Lucene mô tả vai trò của k1, b và biến thể IDF dùng ở đây. Đây là tài liệu tham khảo về các khái niệm; mã Python của hướng dẫn vẫn là phần triển khai chúng ta cần quan sát.
Đọc phần triển khai
"""BM25 : fréquence des mots, rareté et correction de longueur."""
import math
import re
import unicodedata
from collections import Counter


def validate_query(query):
    if not isinstance(query, str) or not query.strip() or len(query) > 2048:
        raise ValueError(
            "Requête attendue : texte non vide de 2048 caractères maximum"
        )
    return query


def tokens(text):
    return re.findall(r"\w+", unicodedata.normalize("NFKC", text).lower())


class BM25:
    def __init__(self, documents, k1=1.2, b=0.75):
        self.documents = documents
        self.k1 = k1
        self.b = b
        self.terms = [Counter(tokens(doc["text"])) for doc in documents]
        self.lengths = [sum(terms.values()) for terms in self.terms]
        self.average_length = sum(self.lengths) / max(1, len(documents))
        self.document_frequency = Counter(
            term for terms in self.terms for term in terms
        )

    def search(self, query, limit=10):
        validate_query(query)
        if limit <= 0:
            raise ValueError("limit doit être positif")
        result = []
        for doc, frequencies, length in zip(
            self.documents, self.terms, self.lengths
        ):
            score = 0.0
            for term in set(tokens(query)):
                frequency = frequencies[term]
                if not frequency:
                    continue
                count = self.document_frequency[term]
                rarity = math.log(
                    1 + (len(self.documents) - count + 0.5) / (count + 0.5)
                )
                length_factor = (
                    1 - self.b + self.b * length / self.average_length
                )
                score += (
                    rarity * frequency * (self.k1 + 1)
                    / (frequency + self.k1 * length_factor)
                )
            if score > 0:
                result.append((doc["id"], score))
        return sorted(result, key=lambda row: (-row[1], row[0]))[:limit]
Trong __init__, Counter đếm thuật ngữ của từng bài. lengths và average_length chuẩn bị các độ dài. Sau đó document_frequency đếm số bài mà mỗi thuật ngữ xuất hiện: duyệt các khóa của một Counter tránh đếm lại nhiều lần cùng thuật ngữ trong một bài.
Trong search, việc xác thực đòi hỏi một chuỗi không rỗng dài tối đa 2 048 ký tự và một giới hạn dương. Chương trình duyệt từng bài, rồi từng thuật ngữ riêng biệt trong câu hỏi. Một thuật ngữ vắng mặt không đóng góp gì. Với các thuật ngữ khác, rarity tính IDF và length_factor tính hiệu chỉnh độ dài, trước khi thêm đóng góp vào điểm.
Cuối cùng, các bài có điểm bằng không bị bỏ qua. Việc sắp xếp dùng -row[1] để đặt điểm cao nhất lên trước, rồi row[0] để phân giải các trường hợp bằng điểm theo ID tăng dần. Kết quả là danh sách các cặp (identifiant, score).
Bây giờ bạn có thể nối mã với ba ý tưởng ban đầu: đếm, cân trọng số độ hiếm, hiệu chỉnh sự lặp lại và độ dài. Không mô hình nào đã được huấn luyện để thực hiện các thao tác này.
Chạy tìm kiếm từ vựng:
docker compose run --rm --no-deps app -m src.cli lexical
Với câu hỏi xuyên suốt, năm ID đầu của bảng xếp hạng BM25 r3 đã được xác minh là [15, 1, 8, 9, 0]. Vì vậy, bài được mong đợi, ID 0, đến ở hạng 5.
BM25 tìm được các thuật ngữ của câu hỏi, nhưng câu hỏi không chứa mọi từ của quy trình đặt lại. Hãy giữ quan sát này trước khi thử nhánh còn lại. Mục tiêu không phải là thay đổi tham số đến khi ép được câu trả lời mong muốn, mà là hiểu tín hiệu đầu tiên này có thể — và không thể — phân biệt điều gì.
Từ ngữ đến embedding
BM25 trả lời một câu hỏi cụ thể: « Những thuật ngữ nào có trong bài này? » Bây giờ chúng ta sẽ thêm một cách khác để so sánh văn bản.
Một embedding là danh sách các số do mô hình tạo ra từ một văn bản. Bạn có thể hình dung nó như tọa độ của một điểm. Những văn bản mà mô hình đã học cách đưa lại gần nhau có thể có điểm gần nhau, ngay cả khi chúng không dùng chính xác cùng các từ.
Mô hình được chọn ở đây tạo ra 384 tọa độ cho mỗi văn bản. Đó là ý nghĩa của « vector chiều 384 », hay « 384D ». Chúng ta không tự chọn một trục compte, một trục mot_de_passe và một trục facture. Các tọa độ đến từ những biểu diễn mà mô hình đã học.
Không được nhầm vector này với ID của bài. ID dùng để tìm lại cùng tài liệu trong chương trình. Embedding dùng để so sánh nó với tài liệu khác. Nó cũng không phải dấu vân tay SHA-256: hash kiểm soát các byte, còn embedding dùng để đo sự gần nhau trong một không gian đã học.
Nhánh này được gọi là tìm kiếm dense vì dùng loại biểu diễn số đó. Nó mang lại tín hiệu khác với tín hiệu của các thuật ngữ chung. Vì thế « Lấy lại quyền truy cập » có thể gần một bài nói về « quên mật khẩu ».
Nhưng gần không có nghĩa là chắc chắn liên quan. Hai bài nói về quản lý tài khoản có thể giống nhau mà không đưa ra cùng quy trình. Vì vậy, chúng ta sẽ so sánh kết quả với chú thích thay vì tin vào ấn tượng hiểu biết đơn thuần.
E5: từ văn bản đến vector
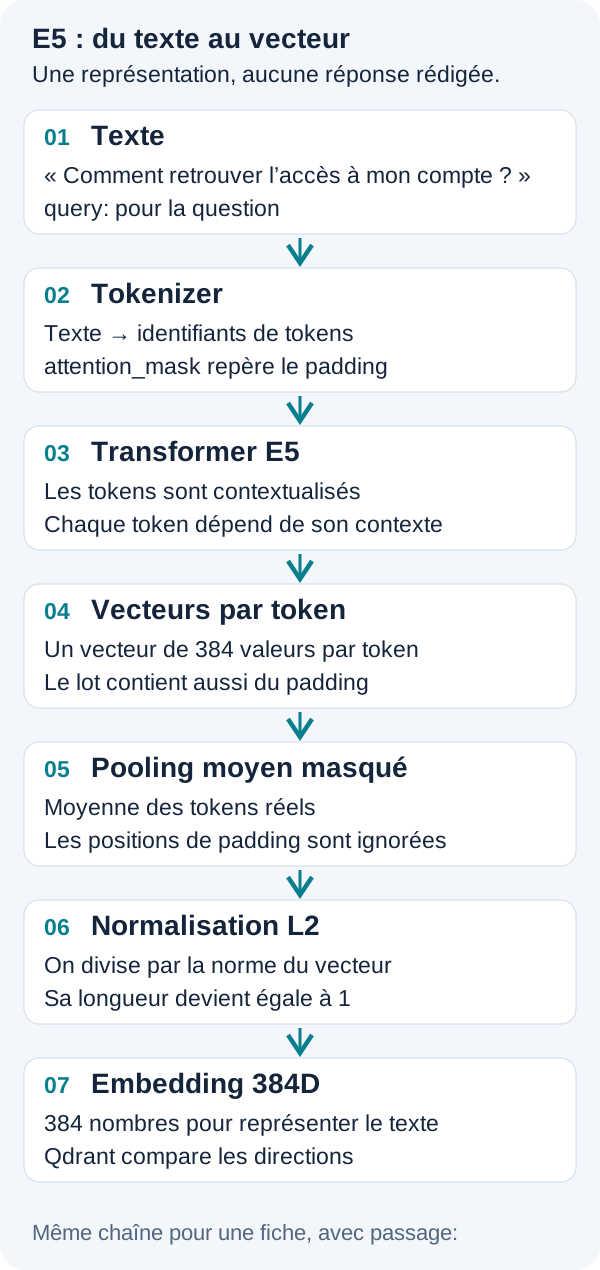
E5 ở đây là encoder: nó biến văn bản thành vector. Nó không soạn câu trả lời và chúng ta không dạy nó tham số mới bằng 16 bài. Chúng ta dùng các trọng số đã có để thực hiện một phép tính suy luận.
Hãy xem các bước theo thứ tự. Các tên gọi có vẻ kỹ thuật; mỗi tên tương ứng với một biến đổi khá cụ thể của dữ liệu.
1. Chỉ rõ vai trò của văn bản
Một câu hỏi bắt đầu bằng query: . Một bài bắt đầu bằng passage: . Những tiền tố này vẫn bằng tiếng Anh, kể cả khi nội dung là tiếng Pháp.
Với câu hỏi xuyên suốt, E5 vì vậy nhận câu hỏi dưới dạng query: Comment retrouver l'accès à mon compte ?. Bài được thêm tiền tố passage: trước khi mã hóa.
Tiền tố không dịch văn bản. Nó chỉ vai trò của nó: một bên là nhu cầu được diễn đạt, bên kia là nội dung cần tìm. Tài liệu chính thức về E5 đa ngôn ngữ, tại revision được dùng trình bày quy ước này và ví dụ mã hóa.
2. Biến văn bản thành token và chuẩn bị một batch
Tokenizer tách văn bản thành các đơn vị mô hình nhận ra, rồi thay chúng bằng định danh số, input_ids. Một token có thể biểu thị một từ, một phần từ hoặc một ký hiệu. Vì vậy cách tách này không giống BM25.
Chương trình xử lý văn bản theo batch tối đa 16. Để tính cùng lúc các chuỗi có độ dài khác nhau, nó điền chúng đến một độ rộng chung. Đó là padding, tức phần điền thêm.
Mô hình cũng nhận một attention_mask. Ví dụ [1, 1, 0] có nghĩa hai vị trí đầu hợp lệ, còn vị trí thứ ba là phần điền thêm. Thông tin này cho phép phân biệt văn bản với các vị trí được thêm vào để tính theo batch.
3. Có được một biểu diễn cho mỗi vị trí
Transformer, kiến trúc của mô hình, tính một vector cho mỗi vị trí của văn bản có xét đến ngữ cảnh. Kết quả trung gian được gọi là last_hidden_state trong mã.
Vì thế chúng ta chưa có một vector cho mỗi bài, mà có một vector cho mỗi vị trí. Từ hidden trong « hidden state » chỉ đơn giản là một biểu diễn nội bộ của mô hình, không phải thông tin bí mật.
Đây không phải một từ điển thay một từ bằng từ đồng nghĩa. Quan hệ giữa các cách diễn đạt đến từ quá trình học trước đó của mô hình. Điều này có thể đưa một số văn bản lại gần nhau, nhưng vẫn không đảm bảo chúng trả lời cùng một nhu cầu.
4. Từ nhiều vector thành một: trung bình có mask
Bây giờ ta cần biểu diễn của toàn bộ văn bản. Pooling là thao tác gom biểu diễn của các vị trí thành một vector duy nhất. Ở đây, chúng ta tính trung bình theo từng tọa độ, loại trừ padding.
Hãy lấy một ví dụ sư phạm với hai tọa độ, nhỏ hơn rất nhiều so với vector E5 thực:
Première position valide : [2, 4]
Deuxième position valide : [4, 4]
Position de remplissage  : ignorée
Masque                   : [1, 1, 0]

Somme des positions valides : [2 + 4, 4 + 4] = [6, 8]
Nombre de positions valides : 2
Moyenne                    : [6 / 2, 8 / 2] = [3, 4]
Mask phục vụ hai việc ở bước này: đưa đóng góp của các vị trí padding về không và đếm các vị trí hợp lệ để chia. Nhờ đó ta có trung bình của văn bản, không phải trung bình của văn bản được điền thêm một cách nhân tạo.
Với E5, nguyên lý tương tự áp dụng cho 384 tọa độ. Không tọa độ nào, khi tách riêng, nên được hiểu như một nhãn nghiệp vụ chẳng hạn « nói về lập hóa đơn ».
5. Chuẩn hóa vector để so sánh hướng của nó
Chuẩn hóa L2 đưa độ dài toán học của vector, gọi là norm, về 1. Độ dài này không phải số tọa độ: vector vẫn là 384D sau khi chuẩn hóa.
Trong ví dụ hai tọa độ của chúng ta, [3, 4] có norm bằng 5 vì 3² + 4² = 25. Chia các tọa độ cho 5 cho [0.6, 0.8].
Tại sao phải làm vậy? Ta muốn so sánh hướng của vector thay vì biên độ. Tích vô hướng là nhân các tọa độ tương ứng của hai vector, rồi cộng các tích đó. Khi hai vector đều có norm bằng 1, kết quả này là độ tương đồng cosine của chúng.
Giá trị cao cho biết sự gần nhau trong không gian đã học. Nó không phải xác suất bài trả lời được câu hỏi. Cần đối chiếu độ tương đồng với nội dung và chú thích, đặc biệt khi nhiều quy trình nói về cùng một chủ đề.
Đọc mã, rồi tìm lại từng bước
"""E5 sur un seul GPU CUDA ; les poids sont acquis séparément."""
import os
import torch
from transformers import AutoModel, AutoTokenizer


class Encoder:
    def __init__(self):
        if not torch.cuda.is_available():
            raise RuntimeError(
                "GPU CUDA requis ; vérifier GPU_DEVICE et NVIDIA Container Toolkit"
            )
        torch.manual_seed(42)
        torch.set_num_threads(4)
        directory = os.environ.get("MODEL_DIR", "/models/e5")
        self.tokenizer = AutoTokenizer.from_pretrained(
            directory, local_files_only=True
        )
        self.model = (
            AutoModel.from_pretrained(directory, local_files_only=True)
            .to("cuda")
            .eval()
        )

    def encode(self, texts, kind):
        if kind not in ("query", "passage") or not texts:
            raise ValueError("Préfixe query/passage et liste non vide requis")
        vectors = []
        for offset in range(0, len(texts), 16):
            batch = self.tokenizer(
                [kind + ": " + text for text in texts[offset:offset + 16]],
                padding=True,
                truncation=False,
                return_tensors="pt",
            )
            if batch["input_ids"].shape[1] > 512:
                raise ValueError("Texte dépassant 512 tokens : découpez le document")
            batch = batch.to("cuda")
            with torch.inference_mode():
                hidden = self.model(**batch).last_hidden_state
                mask = batch["attention_mask"].unsqueeze(-1).bool()
                pooled = hidden.masked_fill(~mask, 0).sum(1) / mask.sum(1)
                normalized = torch.nn.functional.normalize(pooled, p=2, dim=1)
            if not torch.isfinite(normalized).all():
                raise ValueError("Embedding non fini")
            vectors.extend(normalized.cpu().tolist())
        return vectors
Constructor kiểm tra CUDA, cố định seed ở 42, giới hạn các thread CPU ở 4 và nạp tokenizer cùng mô hình từ MODEL_DIR. local_files_only=True cấm một lượt tải xuống ngầm. Mô hình được đặt trên GPU bằng .to("cuda").
Các lời gọi .eval() và torch.inference_mode() có hai vai trò bổ sung. Lời gọi đầu đặt hành vi mô hình sang chế độ đánh giá. Lời gọi thứ hai tắt cơ chế theo dõi gradient cần cho huấn luyện. Tài liệu PyTorch về inference_mode nói rõ rằng cái này không thay thế cái kia. Ở đây, chúng ta mã hóa văn bản; không cập nhật trọng số nào.
Trong encode, danh sách được tạo bằng kind + ": " + text thêm tiền tố. Tokenizer chuẩn bị các định danh và mask, rồi batch.to("cuda") gửi dữ liệu đó đến GPU.
Đoạn trung tâm khớp chính xác với phép tính đã giải thích ở trên: hidden chứa biểu diễn các vị trí; unsqueeze(-1) thêm một trục vào mask để áp dụng nó cho các tọa độ; masked_fill triệt tiêu đóng góp của padding; .sum(1) cộng các vị trí; phép chia tính trung bình; normalize cố định norm của vector.
Cuối cùng, torch.isfinite từ chối các giá trị không hợp lệ, như vô cực hoặc NaN, trước khi gửi sang Qdrant. normalized.cpu().tolist() đưa kết quả về các danh sách Python thông thường.
Một giới hạn rõ ràng, thay vì âm thầm cắt ngắn văn bản
Tokenizer dùng truncation=False. Nếu batch đã token hóa vượt quá 512 vị trí, chương trình từ chối văn bản trước phép tính Transformer và yêu cầu tách tài liệu. Kiểm tra áp dụng cho chuỗi đã token hóa, bao gồm tiền tố và các token do tokenizer thêm vào.
Điều này tránh để một phần bài biến mất âm thầm trước khi mã hóa. Đừng nhầm giới hạn này với 2 048 ký tự của kiểm tra từ vựng: đây là hai kiểm soát, biểu đạt theo hai đơn vị khác nhau.
Đầu ra mong đợi của encoder là danh sách các vector hữu hạn có độ dài 384, không bao giờ là văn bản được tạo ra. Các bài được mã hóa thành passage trước khi lập chỉ mục; câu hỏi được mã hóa thành query tại thời điểm tìm kiếm. Tài liệu mô hình E5 đa ngôn ngữ bổ sung cho phần trình bày này.
Lưu trữ và tìm kiếm vector bằng Qdrant
E5 vừa tính các con số. Bây giờ cần giữ chúng lại và tìm các số giống vector của một câu hỏi. Trong hướng dẫn này, đó là vai trò của Qdrant.
Để hình dung việc lưu trữ, hãy tưởng tượng một bản ghi có ba thành phần: định danh bài, vector của nó và nội dung JSON. Qdrant gọi bản ghi đó là một point và tập hợp các point là một collection. So sánh với một bảng có thể giúp định hướng, nhưng ở đây tìm kiếm dựa trên sự gần nhau của các vector.
Nội dung gắn với vector được gọi là payload. Nó giữ lại ID, tham chiếu và văn bản của bài để có thể hiển thị sau khi tìm kiếm. Payload không tính embedding: E5 đã tạo nó trong Python.
Việc lập chỉ mục phải bảo đảm điều gì
Đoạn trích sau đến từ lớp VectorStore. Nó chỉ chứa các phương thức index và search, không phải toàn bộ lớp hay các phương thức giao tiếp HTTP.
Việc lập chỉ mục yêu cầu một vector chiều 384 cho mỗi bài. Nó tạo một collection cấu hình với distance: Cosine, rồi thêm các bài và vector vào đó. Nếu collection đã tồn tại, nó từ chối tiếp tục: nhờ vậy lộ trình không nhầm một lần lập chỉ mục mới với trạng thái còn lại từ lần trước.
    def index(self, documents, vectors):
        if len(documents) != len(vectors) or any(
            len(vector) != 384 for vector in vectors
        ):
            raise ValueError("Un vecteur de dimension 384 par document est requis")
        self.ready()
        path = "/collections/" + self.collection
        exists = self.request(path + "/exists")["result"]["exists"]
        if exists:
            raise ValueError(
                "Collection existante : arrêter le projet avant une nouvelle indexation"
            )
        self.request(
            path,
            {"vectors": {"size": 384, "distance": "Cosine"}},
            "PUT",
        )
        if documents:
            points = [
                {"id": doc["id"], "vector": vector, "payload": doc}
                for doc, vector in zip(documents, vectors)
            ]
            self.request(path + "/points?wait=true", {"points": points}, "PUT")
        return self.request(path)["result"]

    def search(self, vector, limit=10):
        body = {
            "query": vector,
            "limit": limit,
            "with_payload": True,
            "params": {"exact": True},
        }
        result = self.request(
            "/collections/" + self.collection + "/points/query", body
        )["result"]["points"]
        return sorted(
            [(row["id"], row["score"]) for row in result],
            key=lambda row: (-row[1], row[0]),
        )
Trong index, kiểm tra đầu tiên xác minh cả số lượng vector lẫn chiều của chúng. self.ready() đi trước các lời gọi dịch vụ. Yêu cầu tới /exists kiểm tra sự có mặt của collection, còn thao tác tạo chỉ ra chiều và phép đo gần nhau mong đợi.
Sau đó mỗi phần tử của points gắn id, vector và payload. Tham số wait=true yêu cầu chờ thao tác ghi được áp dụng. Sau lập chỉ mục, collection phải chứa 16 point.
Chạy bước này:
docker compose run --rm --no-deps app -m src.cli index
Mở outputs/index.json. Nó cho biết số point, chiều và thiết bị CUDA. Collection chỉ được tạo một lần cho mỗi lần khởi động dự án. Để xây dựng lại, cần dừng dự án, khởi động lại Qdrant rồi lập chỉ mục lại.
« Tìm kiếm chính xác » không có nghĩa « bảo đảm câu trả lời đúng »
Trong search, query chứa vector của câu hỏi. limit đặt số láng giềng tối đa được yêu cầu. with_payload: True yêu cầu kèm dữ liệu của chúng; sau đó đoạn trích đưa kết quả về các cặp (id, score) để xếp hạng.
Thiết lập exact: True yêu cầu tìm kiếm láng giềng đầy đủ, thay vì tìm kiếm xấp xỉ. Tài liệu Qdrant Search giải thích sự khác biệt này.
Vì vậy, từ chính xác liên quan đến phép tính láng giềng theo vector và phép đo đã chọn. Nó không có nghĩa Qdrant kiểm tra tính đúng đắn của quy trình được tìm lại. Một láng giềng được tính chính xác vẫn có thể là bài không liên quan với người dùng của chúng ta.
Bây giờ chạy nhánh dense:
docker compose run --rm --no-deps app -m src.cli dense
Đọc các láng giềng và cosine của chúng trong outputs/dense.json. Với câu hỏi xuyên suốt, top 5 r3 là [0, 1, 8, 2, 14]: bài mong đợi, ID 0, đứng hạng nhất, so với hạng năm ở BM25.
Điểm cosine đo được của nó là 0,8599599. Điều đó không có nghĩa « 85,99599 % khả năng câu trả lời đúng ». Kết quả đáng chú ý là bài được chú thích liên quan đứng đầu, và bạn có thể đọc lại văn bản của nó.
Tạm dừng: kết hợp hai danh sách này thế nào?
Đây là năm bài đầu của mỗi nhánh cho cùng câu hỏi. Top 5 chỉ có nghĩa « năm vị trí đầu của bảng xếp hạng ».
| Hạng | BM25 | E5 / Qdrant |
|---|---|---|
| 1 | ID 15 · REF-115 Xóa một thành viên khỏi nhóm sẽ thu hồi quyền truy cập dự án nhưng giữ tài liệu đã chia sẻ của họ |
ID 0 · REF-100 Đặt lại mật khẩu tài khoản |
| 2 | ID 1 · REF-101 Đổi địa chỉ email của tài khoản từ hồ sơ |
ID 1 · REF-101 Đổi địa chỉ email của tài khoản từ hồ sơ |
| 3 | ID 8 · REF-108 Bật xác thực hai yếu tố |
ID 8 · REF-108 Bật xác thực hai yếu tố |
| 4 | ID 9 · REF-109 Đóng mọi phiên hoạt động từ mục Bảo mật |
ID 2 · REF-102 Tải hóa đơn PDF từ Lập hóa đơn rồi Lịch sử thanh toán |
| 5 | ID 0 · REF-100 Đặt lại mật khẩu tài khoản |
ID 14 · REF-114 Mời một thành viên vào nhóm |
E5 đặt việc đặt lại mật khẩu lên đầu. BM25 trước hết đặt bài về việc xóa một thành viên nhóm, bài này cũng nói về quyền truy cập. Hai cách tìm kiếm dùng cùng corpus, nhưng không coi trọng cùng các tín hiệu.
Ta có thể muốn cộng các điểm của chúng. Vấn đề là thang đo: tổng BM25 và cosine không phải hai điểm được tính trên cùng một thang. Cộng trực tiếp chúng sẽ đưa vào trọng số tùy ý giữa các phương pháp.
Ngược lại, hai danh sách có một thông tin chung dễ đọc: hạng. Thứ nhất, thứ hai, thứ ba… Chúng ta sẽ dùng vị trí này để kết hợp chúng.
RRF: hợp nhất mà không chuyển đổi điểm
RRF, viết tắt của Reciprocal Rank Fusion, là cách hợp nhất dựa trên hạng. Hãy tưởng tượng hai bảng xếp hạng từ hai người đánh giá: ta cho điểm các bài theo vị trí trong mỗi bảng, rồi cộng các điểm đó.
RRF không đọc văn bản hoặc embedding. Nó không chuyển điểm BM25 thành cosine và không học cách nhận ra quy trình mong đợi. Nó áp dụng một quy tắc số học.
Một đóng góp cho mỗi hạng quan sát được
Với một bài ở hạng rang trong danh sách, đóng góp là:
1 / (k + rang)
Các hạng bắt đầu từ 1. Hằng số k làm dịu chênh lệch giữa các vị trí. Với k lớn, các hạng đầu có đóng góp khá gần nhau. Với k nhỏ, các vị trí đầu tiên nặng hơn.
Với một bài d, ta cộng các đóng góp của những bảng xếp hạng nơi nó xuất hiện:
RRF(d) = Σ 1 / (k + rang_i(d))
Ký hiệu Σ chỉ đơn giản là « lấy tổng ». Một bài vắng mặt khỏi danh sách nhận 0 cho danh sách đó. Ta không bịa cho nó một hạng ở cuối.
Tính lại cho hai bài tài khoản của chúng ta
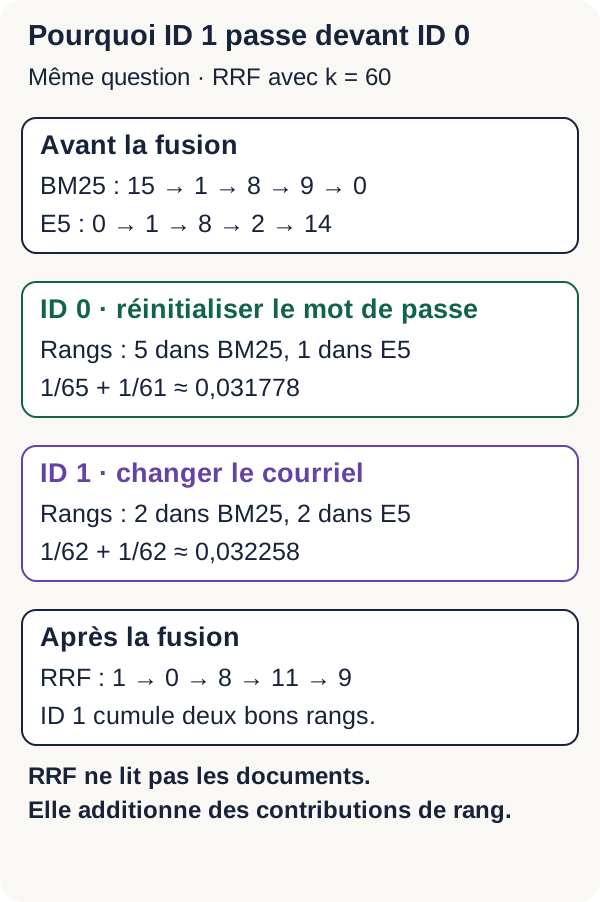
Lộ trình dùng k=60. Với ID 0, các vị trí là 5 trong BM25 và 1 trong dense:
RRF(ID 0) = 1/65 + 1/61 ≈ 0,031778
Với ID 1, các vị trí đều là 2 trong hai danh sách:
RRF(ID 1) = 1/62 + 1/62 ≈ 0,032258
Vì vậy ID 1 vượt lên trước ID 0. Sự đồng thuận của hai vị trí thứ hai mang lại nhỉnh hơn một vị trí đầu đi cùng một vị trí thứ năm. Phép tính đúng, nhưng nó không biết chú thích của chúng ta: « đổi email » vẫn là ý định khác với « lấy lại quyền truy cập tài khoản ».
Điểm RRF là tổng các đóng góp, không phải xác suất. Tài liệu Elasticsearch về RRF cũng minh họa công thức này. Nó là tham chiếu cho cơ chế; chúng ta không cài Elasticsearch và vẫn dùng phần triển khai Python trong ZIP.
Đọc phần hợp nhất trong mã
"""Reciprocal Rank Fusion (RRF), rangs commençant à 1."""
import math


def reciprocal_rank_fusion(rankings, k=60):
    if not isinstance(k, (int, float)) or not math.isfinite(k) or k < 0:
        raise ValueError("k doit être fini et positif ou nul")
    scores = {}
    for ranking in rankings:
        seen = set()
        for rank, (document_id, original_score) in enumerate(ranking, start=1):
            if document_id in seen or not math.isfinite(original_score):
                raise ValueError("Classement avec doublon ou score non fini")
            seen.add(document_id)
            contribution = 1.0 / (k + rank)
            scores[document_id] = scores.get(document_id, 0.0) + contribution
    return sorted(scores.items(), key=lambda row: (-row[1], row[0]))
Vòng lặp ngoài duyệt các bảng xếp hạng. enumerate(..., start=1) đưa ra các hạng, rồi contribution tính điểm. Từ điển scores tích lũy đóng góp của cùng một ID từ danh sách này sang danh sách khác.
Ngược lại, seen ngăn đếm hai lần cùng một ID trong một danh sách duy nhất. Điểm không hữu hạn bị từ chối. Hàm cũng kiểm tra k là hữu hạn và dương hoặc bằng không, cho phép thí nghiệm với k=0 ở phần sau.
Hãy chú ý vai trò giới hạn của original_score: nó dùng để từ chối giá trị không hữu hạn, nhưng không đi vào công thức. Nếu chỉ các con số điểm thay đổi mà không đổi thứ tự hoặc ứng viên của từng danh sách, hợp nhất vẫn y hệt. Sắp xếp cuối xếp các đóng góp giảm dần, dùng ID tăng dần để phân giải hòa.
Chạy phần so sánh:
docker compose run --rm --no-deps app -m src.cli compare
Mở outputs/compare.json trước khi kết luận. Hợp nhất có thể không đổi hoặc thụt lùi nếu ứng viên của nó kém, nếu một nhánh đã rất tốt, hoặc nếu k không phù hợp với đánh đổi cần tìm.
| Nhánh | Năm ID đầu | Hạng của bài mong đợi ID 0 |
|---|---|---|
| BM25 | 15, 1, 8, 9, 0 | 5 |
| E5 + Qdrant | 0, 1, 8, 2, 14 | 1 |
| RRF | 1, 0, 8, 11, 9 | 2 |
Hợp nhất đưa ID 0, « Đặt lại mật khẩu », từ hạng từ vựng 5 lên hạng lai 2. Tuy nhiên, nó đẩy bài này lùi so với hạng dense 1. ID 1, « Đổi địa chỉ email », vượt lên nhờ hai vị trí thứ hai.
Một chi tiết đáng dừng lại: ID 11 xuất hiện trong năm đầu của RRF dù không có trong cả hai top 5 hiển thị phía trên. RRF không tạo định danh. Theo mã của nó, một ID chỉ có thể xuất hiện trong hợp nhất nếu có mặt trong ít nhất một danh sách nhận được. Vì vậy năm dòng hiển thị không đủ để dựng lại toàn bộ đầu vào. Để làm lại bảng xếp hạng đầy đủ, hãy xem các danh sách thực sự truyền trong lộ trình và đầu ra so sánh, thay vì chỉ hợp nhất năm phần tử trong bảng.
Bài học không phải « lai hoạt động kém ». Nó chính xác hơn: hợp nhất này cải thiện một nhánh và làm nhánh kia kém hơn với câu hỏi này. Bây giờ cần kiểm tra điều gì xảy ra trên toàn bộ tập đánh giá.
Các trường hợp âm
Trước khi đo mức liên quan, hãy kiểm tra các lỗi hệ thống phải xử lý. Một trường hợp âm là kiểm thử mà ta cố ý đưa ra tình huống trống hoặc không hợp lệ và kiểm soát hành vi mong đợi.
Một collection trống phải tạo danh sách trống. Văn bản vượt 512 token phải bị từ chối sau token hóa, trước khi Transformer tính biểu diễn. Qdrant cũng phải từ chối vector có chiều không phải 384.
Kiểm soát cuối giống một hợp đồng API: ta đã công bố một cấu trúc, và đầu vào không tương thích không được chấp nhận âm thầm. Các kiểm thử này xác minh hành vi kỹ thuật đúng; chúng chưa đo mức liên quan của các bài.
docker compose run --rm --no-deps app -m src.cli negatives
Ba chỉ báo trong outputs/negatives.json phải đúng trước khi tiếp tục. Một lỗi được mong đợi và bị từ chối đúng ở đây là kiểm thử thành công, không phải thất bại của hướng dẫn.
Đo ba nhánh
Chúng ta có các danh sách. Làm sao đánh giá chúng có ích? Điểm tương đồng chưa đủ: cần so sánh các định danh tìm được với bài mong đợi.
Quy tắc đánh giá được xác định trước khi đọc kết quả. 12 câu hỏi có một bài liên quan được tính vào trung bình mức liên quan. Hai câu hỏi ngoài corpus được đếm riêng.
Vì sao tách chúng? Với câu hỏi không có bài liên quan, recall có mẫu số bằng không. Tự gán điểm 0 sẽ trộn hai vấn đề: xếp hạng kém một câu trả lời có tồn tại, và biết dừng khi câu trả lời không tồn tại. Ở đây ta giữ một bộ đếm riêng cho câu hỏi không có câu trả lời liên quan và các kết quả vẫn được trả về.
Recall@5: tìm các bài liên quan
Recall@5, hay recall ở năm kết quả, trả lời câu hỏi: « Trong tất cả bài mong đợi, tôi đã tìm lại được bao nhiêu bài trong năm bài đầu? »
Công thức là:
|top5 ∩ pertinents| / |pertinents|
Phép giao ∩ giữ các định danh có mặt trong cả hai tập. Dấu |…| đếm số phần tử của chúng.
Trong bộ của chúng ta, mỗi câu hỏi có thể đánh giá chỉ có một bài liên quan. Nếu nó ở hạng 4, recall bằng 1; nếu vắng trong năm bài đầu, bằng 0. Vì vậy giá trị cao cho thấy bài hữu ích thường hiện trong top 5.
Lưu ý: Recall@5 không phân biệt hạng 1 và 5. Nó cũng không đo tỷ lệ bài tốt trong năm bài hiển thị. Danh sách có một bài tốt và bốn bài xấu có thể có recall bằng 1 nếu bài tốt đó là bài duy nhất được mong đợi.
MRR@10: đặt câu trả lời đầu tiên
MRR@10, viết tắt của Mean Reciprocal Rank, xét vị trí của bài liên quan đầu tiên trong mười kết quả đầu.
Với một câu hỏi, ta lấy nghịch đảo của hạng đó: 1 ở hạng 1, 1/4 = 0,25 ở hạng 4, và 0 nếu không bài liên quan nào nằm trong mười đầu. MRR của bộ là trung bình các giá trị này, tính từng câu hỏi.
Giá trị cao nghĩa là người dùng nhanh chóng tìm được bài hữu ích đầu tiên. Chỉ số này không thưởng cho các bài liên quan khác đứng sau bài đầu, khi có nhiều bài.
nDCG@10: sắp thứ tự các câu trả lời hữu ích
nDCG@10, viết tắt của normalized Discounted Cumulative Gain, đặt một câu hỏi tổng quát hơn: « Các bài hữu ích của tôi có được đặt tốt như có thể không? »
Với mức liên quan nhị phân của chúng ta, mỗi bài liên quan mang lại một gain giảm theo hạng. Ở hạng r, gain là 1 / log2(r + 1). Ta cộng gain ở mười vị trí đầu rồi chia cho gain của bảng xếp hạng tốt nhất có thể. log2 là logarit cơ số 2; điều quan trọng là nó làm gain giảm khi hạng tăng.
Với một bài liên quan duy nhất, bảng lý tưởng đặt nó ở hạng 1 và có giá trị 1. Ở hạng 2, gain là 1 / log2(2 + 1) ≈ 0,63093. Một bài vắng top 10 không mang lại gì.
Giá trị cao nghĩa là các bài hữu ích tập trung ở đầu. Khác MRR, nDCG có thể đánh giá tốt nhiều bài liên quan được đặt đúng vị trí. Trong corpus này chỉ có một bài cho mỗi câu hỏi có thể đánh giá, nhưng mã vẫn giữ định nghĩa tổng quát đó.
Áp dụng ba quy tắc cho câu hỏi xuyên suốt
Hãy lấy lại các hạng đã quan sát: 5 với BM25, 1 với E5/Qdrant và 2 với RRF. Bảng sau là áp dụng công thức vào các hạng này, không phải lần chạy GPU mới hay trung bình của tập đánh giá.
| Nhánh, chỉ cho câu hỏi xuyên suốt | Hạng ID 0 | Recall@5 | Đóng góp vào MRR@10 | nDCG@10 |
|---|---|---|---|---|
| BM25 | 5 | 1 | 0,2 | 0,386853 |
| E5 + Qdrant | 1 | 1 | 1 | 1 |
| RRF | 2 | 1 | 0,5 | 0,630930 |
Ba nhánh có cùng recall: tất cả đều tìm được bài tốt trong năm đầu. Tuy vậy, chúng không đem lại cùng trải nghiệm đọc. MRR và nDCG làm sự khác biệt này hiện rõ.
Kiểm tra các hàm thực sự đếm gì
"""Pertinence binaire ; les requêtes sans pertinent sont traitées séparément."""
import math


def ranking_metrics(ids, relevant):
    if len(ids) != len(set(ids)):
        raise ValueError("Identifiants dupliqués")
    relevant = set(relevant)
    if not relevant:
        return None
    hits = [
        rank
        for rank, identifier in enumerate(ids[:10], 1)
        if identifier in relevant
    ]
    ideal = sum(
        1 / math.log2(rank + 1)
        for rank in range(1, min(10, len(relevant)) + 1)
    )
    return {
        "recall_at_5": len(set(ids[:5]) & relevant) / len(relevant),
        "mrr_at_10": 1 / hits[0] if hits else 0.0,
        "ndcg_at_10": sum(1 / math.log2(rank + 1) for rank in hits) / ideal,
    }


def summarize(rows):
    result = {}
    for route in ("lexical", "dense", "hybrid"):
        scored = [
            ranking_metrics(
                [hit[0] for hit in row["routes"][route]], row["relevant"]
            )
            for row in rows
        ]
        valid = [score for score in scored if score is not None]
        if not valid:
            raise ValueError("Aucune requête évaluable")
        result[route] = {
            key: sum(score[key] for score in valid) / len(valid)
            for key in valid[0]
        }
        result[route]["evaluated_queries"] = len(valid)
        result[route]["no_relevant_queries"] = len(rows) - len(valid)
        result[route]["no_relevant_with_results"] = sum(
            bool(row["routes"][route])
            for row in rows
            if not row["relevant"]
        )
        result[route]["mean_search_ms"] = (
            1000 * sum(row["seconds"][route] for row in rows) / len(rows)
        )
    return result
ranking_metrics nhận các ID đã xếp hạng và các ID liên quan. Nó từ chối các ID trùng trong danh sách kết quả. Nếu không có bài liên quan nào, nó trả về None, chứ không phải một điểm nhân tạo.
hits chứa các hạng liên quan trong mười đầu. ideal tính gain tốt nhất có thể bằng cách đặt tối đa mười bài liên quan lên đầu. Từ điển trả về sau đó áp dụng ba công thức: giao trong năm đầu, nghịch đảo của hạng liên quan đầu, rồi gain chuẩn hóa.
summarize lặp lại phép tính cho mỗi câu hỏi và từng nhánh lexical, dense, hybrid. Với trung bình mức liên quan, nó chỉ bỏ các giá trị None. Điểm số 0 vẫn được tính. Sự phân biệt này tránh làm biến mất các tìm kiếm đã thất bại.
Các trường evaluated_queries, no_relevant_queries và no_relevant_with_results cho biết có bao nhiêu câu hỏi được đánh giá, bao nhiêu không có bài liên quan và bao nhiêu trong số chúng vẫn nhận kết quả.
Ngược lại, mean_search_ms dùng mọi dòng, tức 14 câu hỏi, gồm cả hai câu ngoài corpus. Đừng gán nó cùng mẫu số với các chỉ số liên quan.
Chạy đánh giá:
docker compose run --rm --no-deps app -m src.cli evaluate
Nếu một giá trị trung bình làm bạn ngạc nhiên, hãy trở lại các danh sách từng câu hỏi. Trung bình tóm tắt hành vi; tự nó không giải thích hành vi.
Hiểu đồng hồ trước khi so sánh thời lượng
Các độ trễ bên dưới là trung bình mili giây trên 14 câu hỏi, sau một lượt làm nóng không tính vào phép đo. Làm nóng là lần dùng đầu nhằm không trộn việc khởi động tính toán với các tìm kiếm được đo. Việc nạp mô hình cũng bị loại trừ.
Thời lượng dense bao gồm mã hóa câu hỏi và gọi Qdrant. Vì thế nó không chỉ là thời gian trong cơ sở dữ liệu vector. Thời lượng lai cộng các bước từ vựng, dense và hợp nhất, chạy tuần tự trong lộ trình này.
Hai giá trị thời gian ở mỗi hàng tương ứng với hai lần tái lập r3 trên cùng máy. Chúng không đặt mục tiêu tốc độ cần đạt trên máy của bạn và không mô tả một ứng dụng web dưới tải.
Kết quả r3
| Phương pháp | Recall@5 | MRR@10 | nDCG@10 | Độ trễ trung bình (ms), 1 / 2 |
|---|---|---|---|---|
| BM25 | 0,833333 | 0,777778 | 0,791667 | 0,067 / 0,059 |
| E5 + Qdrant | 1,000000 | 0,825000 | 0,867053 | 6,613 / 5,749 |
| RRF | 0,916667 | 0,802778 | 0,847993 | 6,695 / 5,820 |
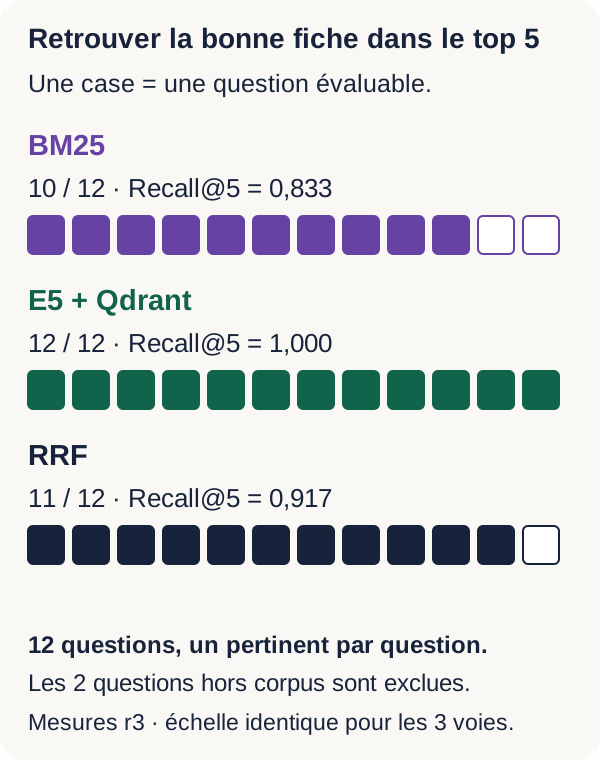
Các phép đo này đến từ hai lần tái lập r3 trên cùng GPU RTX 3090 và cùng máy. Nhánh dense tốt hơn trên cả ba chỉ số liên quan của bộ này. RRF cải thiện BM25, nhưng vẫn dưới E5 đơn lẻ.
Recall được đọc rất cụ thể: BM25 tìm bài tốt trong năm đầu cho 10 câu hỏi trên 12; E5 cho 12 trên 12; RRF cho 11 trên 12. 1,000000 của E5 không có nghĩa « bài tốt luôn đứng đầu ». MRR 0,825000 của nó nhắc rằng không phải lúc nào cũng vậy.
Làm sao hợp nhất có Recall@5 thấp hơn E5 dù nhận ứng viên từ cả hai nhánh? Thêm ứng viên không bảo đảm vị trí của chúng trong năm đầu. Một bài có mặt trong danh sách dense có thể bị đẩy xuống sau hợp nhất. Recall ở một độ sâu nhất định phụ thuộc cả ứng viên giữ lại lẫn thứ tự mới của chúng.
Dù vậy, cả ba nhánh đều trả kết quả cho hai câu hỏi ngoài corpus. Vì thế hướng dẫn không biết quyết định rằng không bài nào trả lời được. Có « kết quả tốt nhất hiện có » không đồng nghĩa có câu trả lời liên quan.
Kết hợp nhiều phương pháp không bảo đảm cải thiện: cần đánh giá kiến trúc lai. Nhận định này áp dụng cho corpus, mô hình và cấu hình này. Nó không dự báo kết quả trên tài liệu khác, GPU khác hoặc câu hỏi chưa chú thích.
Những điều đã học
BM25: khai thác từ vựng
BM25 quan sát các thuật ngữ chung giữa câu hỏi và bài. Tần suất mang tín hiệu, có bão hòa; IDF coi trọng thuật ngữ hiếm; hiệu chỉnh độ dài tránh ưu ái máy móc các văn bản dài.
Một tham chiếu chính xác có thể phân biệt tốt, nhưng cũng phải hiểu cách tách từ vựng đã chọn. BM25 không tạo embedding nào và không trực tiếp đo sự gần nhau được mạng nơ-ron học.
E5: biểu diễn văn bản
E5 dùng việc học trước đó để biến văn bản thành vector. Tiền tố query: và passage: chỉ vai trò của chúng. Tokenizer chuẩn bị đầu vào, Transformer tạo biểu diễn các vị trí, trung bình có mask gom các biểu diễn này, và chuẩn hóa cố định norm vector.
Những cách diễn đạt khác nhau nhờ đó có thể trở nên gần nhau. Sự gần này là tín hiệu cần kiểm tra, không phải bảo đảm rằng văn bản trả lời cùng một nhu cầu.
Qdrant: tìm lại các láng giềng
Trong hướng dẫn này, Qdrant nhận các vector E5 đã tính. Nó lưu chúng cùng định danh và metadata, rồi tìm láng giềng của vector câu hỏi. Python điều phối các thao tác này.
Cơ sở dữ liệu vector không quyết định mức liên quan nghiệp vụ và không soạn câu trả lời. Tùy chọn tìm kiếm chính xác của nó liên quan đến láng giềng, không phải sự thật của nội dung tìm được.
RRF: kết hợp các hạng
RRF không đọc tài liệu và không tính embedding. Nó gán đóng góp cho mỗi hạng quan sát được, rồi cộng các đóng góp của cùng ID.
Hai công cụ có điểm không thể so sánh vì vậy có thể tham gia cùng hợp nhất. Đổi lại, RRF không biết khoảng cách nghĩa giữa hai bài hay lý do một công cụ xếp bài này trước bài kia.
Lai: một giả thuyết cần đo
Trên corpus nhỏ này, hợp nhất cải thiện BM25, nhưng vẫn kém E5 đơn lẻ ở cả ba chỉ số. Kết hợp nhiều phương pháp không bảo đảm cải thiện.
Để chọn kiến trúc, hãy đối chiếu nó với tài liệu, truy vấn, chú thích rõ ràng và ràng buộc độ trễ của bạn. Thí nghiệm dạy ta một phương pháp so sánh, không phải quy tắc phổ quát về công cụ tốt nhất.
Bài tập: thay đổi câu hỏi và k
Bây giờ chúng ta sẽ tác động lên hai yếu tố: cách diễn đạt câu hỏi và tham số k của RRF. Mục tiêu là tách hiệu ứng của chúng thay vì thay mọi thứ cùng lúc mà không biết điều gì quan trọng.
Dự đoán. Trước khi chạy lệnh, hãy viết giả thuyết của bạn cho « Tôi quên mật khẩu ». BM25 nên ưu tiên bài nào? E5 có nên đề xuất cùng kết quả đầu không? Khi k giảm, các vị trí đầu trở nên quan trọng thế nào? Thay đổi k có nhất thiết đổi thứ tự cuối không?
Hãy làm thêm phép tính tay nhỏ này: hợp nhất các danh sách sư phạm A=[0,1] và B=[1,2], trước với k=60, rồi với k=0. Đây là các danh sách giản lược, khác các bảng xếp hạng đo được của câu hỏi xuyên suốt.
Viết đóng góp của mỗi ID trước khi sắp xếp. ID 0 chỉ xuất hiện trong A, ID 2 chỉ trong B, còn ID 1 trong cả hai. Một phần tử vắng nhận 0 cho danh sách liên quan; ngay cả với k=0, các hạng bắt đầu từ 1 nên công thức không chia cho không.
Sửa rồi chạy. Bước exercise của dự án r3 thay câu hỏi xuyên suốt bằng cách diễn đạt mới. Sau đó nó tính hợp nhất thông thường và hợp nhất thứ hai với k=0. Các thay đổi này đã được triển khai trong src/cli.py: bạn không cần sửa mã cho bài tập này.
docker compose run --rm --no-deps app -m src.cli exercise
Quan sát. outputs/exercise.json chứa câu hỏi, ba danh sách trong routes và hợp nhất bổ sung trong hybrid_k0. Hãy ghi hạng của ID 0 và năm ID đầu của hai lần hợp nhất.
Trước hết so sánh kết quả của câu hỏi mới này với outputs/compare.json để khảo sát hiệu ứng của việc diễn đạt lại. Sau đó so sánh routes.hybrid và hybrid_k0 trong cùng exercise.json để tách hiệu ứng của k, với câu hỏi không đổi.
Giải thích. Đối chiếu quan sát với dự đoán và giải thích ít nhất một vị trí bằng đóng góp hạng. Nếu điểm thay đổi nhưng thứ tự vẫn như cũ, đó cũng là kết quả hợp lệ: một tham số có thể thay đổi khoảng cách mà không đảo vị trí.
Lời giải phép tính tay và tiêu chí trả lời nằm trong lesson/SOLUTIONS.md. Những quan sát mà tệp này ghi rõ là r2 là lịch sử. Với lần chạy r3 của bạn, hãy dùng đầu ra trong thư mục outputs/.
Thí nghiệm cá nhân: diễn đạt lại một bài duy nhất
Lần này, chúng ta sẽ thay đổi tài liệu thay vì câu hỏi. Thí nghiệm này được đề xuất cho người đọc; kết quả của nó không thuộc các phép đo r3 công bố phía trên.
Giữ một bản sao đầu ra tham chiếu. Trong bản giải nén ZIP của riêng bạn, chỉ diễn đạt lại văn bản bài ID 0 trong data/corpus.json. Ví dụ, bạn có thể đưa từ « accès » vào mô tả của cùng quy trình.
Giữ nguyên ID, tham chiếu, quy trình và chú thích. Không đổi câu hỏi hay k. Chúng ta muốn nghiên cứu thay đổi cách diễn đạt, không dời kết quả mong đợi hoặc biến đổi nhiều yếu tố cùng lúc.
Trước khi sửa, hãy dự đoán riêng hiệu ứng có thể lên BM25, E5 và RRF. BM25 có thể tìm được thuật ngữ chung nào? Bạn giả định gì về biểu diễn do E5 tạo ra? Một thay đổi hạng ở một nhánh có thể ảnh hưởng hợp nhất ra sao? Ba phương pháp không bắt buộc phải đổi thứ tự.
Lưu ý về build: corpus được sao chép vào image Docker. Vì thế sửa tệp trên máy của bạn chưa đủ để sửa tệp dùng bởi container đã được xây dựng trước đó.
Dừng dự án này bằng lệnh dọn dẹp nêu bên dưới, xây dựng lại image, rồi thực hiện lại các lệnh đã trình bày: khởi động Qdrant và chuẩn bị, BM25, lập chỉ mục, dense và so sánh. Collection tạm sẽ được tạo lại với tài liệu mới của bạn.
So sánh lexical.json, dense.json và compare.json với các bản sao tham chiếu. Giải thích khác biệt mà không giả định có cải thiện. Nếu sau đó bạn mở rộng corpus hoặc đổi chú thích, hãy đánh giá lại: các số tham chiếu không còn mô tả thí nghiệm mới.
Từ hướng dẫn đến ứng dụng thực
Bạn có một công cụ sư phạm, chưa phải ứng dụng sẵn sàng nhận tài liệu nghiệp vụ. Với lập trình viên web, bước tiếp theo gồm việc đặt các hợp đồng và dịch vụ rõ ràng xung quanh tìm kiếm.
Tài liệu và vòng đời của chúng. Cần dự liệu việc nhập các định dạng của bạn, làm sạch và chia thành passage, gọi là chunking. Mỗi passage phải giữ liên kết tới nguồn. Thêm, sửa, xóa và lập chỉ mục lại phải nhất quán, với lưu trữ bền vững, sao lưu và khôi phục đã kiểm thử. Collection tạm của hướng dẫn không đảm nhiệm các chức năng này.
Quyền và hành vi tìm kiếm. Xác thực, phân quyền và cô lập người dùng hoặc tổ chức phải áp dụng cho tài liệu trong cả hai nhánh. Tìm thấy một bài không trao quyền đọc nó. Cũng cần xác định bộ lọc, phân trang và hành vi với câu hỏi ngoài corpus. Hai câu hỏi không có đáp án của chúng ta cho thấy quyết định cuối này chưa được xử lý.
Vận hành và đánh giá. API, nhật ký hữu ích, theo dõi lỗi và độ trễ, giám sát cùng kiểm thử tải hoàn thiện dịch vụ. Về mức liên quan, cần tài liệu thật, truy vấn thật, chú thích được đọc lại và phân tích lỗi. Mỗi thay đổi corpus, mô hình hoặc thiết lập phải so sánh được với tham chiếu để phát hiện hồi quy.
docs/PRODUCTION_GAPS.md nêu rõ giới hạn dự án. Các bổ sung này tùy nhu cầu; không phải tất cả đều cần để hiểu cơ chế được nghiên cứu ở đây.
Khi gặp sự cố
Phản xạ đúng là sửa bước thất bại, thay vì âm thầm thay mô hình, bỏ một kiểm soát hoặc tiếp tục với chỉ mục chưa hoàn chỉnh.
| Triệu chứng | Nguyên nhân có thể | Kiểm tra | Sửa chữa |
|---|---|---|---|
Preflight thất bại dù nvidia-smi hoạt động |
GPU không được đưa vào Docker | Đọc chẩn đoán GPU Docker của preflight | Sửa cấu hình NVIDIA Container Toolkit rồi chạy lại preflight. |
| Mô hình cục bộ không có | Lấy mô hình chưa hoàn tất | Đọc lỗi và kiểm tra models/e5 |
Chạy lại lệnh lấy; các tệp đã hợp lệ được xác minh và tái sử dụng. |
| Quá trình lấy bị dừng | Mạng, dung lượng hoặc kiểm tra toàn vẹn | Đọc lỗi fetch và chẩn đoán đĩa của preflight |
Sửa nguyên nhân rồi chạy lại, không bỏ kiểm soát SHA-256. |
| Qdrant vẫn không sẵn sàng | Dịch vụ chưa khởi động | Kiểm tra bước khởi động Qdrant đã xong | Khởi động lại dịch vụ của dự án này trước lập chỉ mục. |
| Văn bản vượt 512 token | Tài liệu quá dài cho lộ trình | Đọc lỗi rõ ràng của encoder | Chia tài liệu và xây dựng lại thí nghiệm; không âm thầm cắt văn bản. |
| Lập chỉ mục từ chối collection | Collection đã tạo trong dự án đang hoạt động | Đọc lỗi Collection existante |
Dừng dự án bằng lệnh dọn dẹp, khởi động lại Qdrant rồi lập chỉ mục lại. |
| Tìm kiếm dense thất bại vì chiều | Vector khác 384D | Kiểm tra đầu ra và hợp đồng Qdrant | Mã hóa lại bằng E5 R3; không cắt vector. |
| Chỉ số gây ngạc nhiên | Chú thích, hạng hoặc nhánh bị hiểu sai | Đọc các danh sách theo từng truy vấn trước trung bình | Kiểm tra corpus và chú thích, rồi chạy lại đánh giá. |
Khi hoàn thành, chỉ dừng các dịch vụ của dự án này, từ thư mục gốc của bản giải nén:
docker compose down
Lệnh này xóa container và mạng của dự án. Các mô hình và đầu ra mount trên máy chủ vẫn còn, nhưng collection Qdrant tạm biến mất. Vì thế để tìm lại sau một lần khởi động sạch, bạn phải lập chỉ mục lại.
Lệnh không xóa các dự án Docker khác của bạn. Hãy giữ các tệp đầu ra khi còn muốn so sánh bảng xếp hạng hoặc tiếp tục phân tích.
Đi xa hơn
Bạn có thể kéo dài lộ trình bằng cách thay các bài hư cấu bằng tài liệu của mình và chú thích các câu hỏi. Một thí nghiệm khác là thêm bộ lọc tài liệu nhất quán ở cả hai nhánh, hoặc so sánh một mô hình embedding khác trên cùng tập đánh giá.
Hướng thứ tư là thêm một reranker sau bước tìm lại. Công cụ của chúng ta giờ biết tìm ứng viên. Reranker là bước bổ sung xem xét lại các ứng viên tốt nhất để sắp thứ tự lại bằng mô hình chuyên dụng. Đó không phải điều RRF làm: RRF kết hợp các vị trí đã tính mà không đọc lại nội dung.
Hãy đánh giá các phần mở rộng này riêng biệt, giữ điểm so sánh của bạn. Reranking sẽ là chủ đề của hướng dẫn khác; nó không cần thiết để hoàn thành hướng dẫn này.
Giờ bạn có một chuỗi mà các quyết định có thể được xem xét: thuật ngữ, vector, láng giềng, rồi đóng góp hạng. Câu hỏi đúng không còn là « công cụ của tôi có dùng AI không? », mà là « nó có tìm lại bài mong đợi không, ở hạng nào, và tôi giải thích điều đó thế nào? »