





Imagine el centro de ayuda de una aplicación web. Ha redactado una ficha titulada «Restablecer la contraseña de la cuenta». Sin embargo, un usuario no necesariamente escribe esas palabras en la barra de búsqueda. Más bien pregunta: «¿Cómo recuperar el acceso a mi cuenta?»
La información correcta existe. El problema es encontrarla a pesar del cambio de vocabulario y situarla lo bastante arriba para que el usuario la vea. Mostrar una ficha que también habla de cuenta, pero explica cómo cambiar su dirección de correo electrónico, no resuelve su solicitud.
Ese es el problema que vamos a explorar. Nuestra pregunta guía, «¿Cómo recuperar el acceso a mi cuenta?», debe llevar a la ficha ID 0, REF-100, dedicada al restablecimiento de la contraseña. No se refiere a la ficha ID 1, REF-101, dedicada al cambio de dirección de correo electrónico. Ambas pertenecen a la familia Compte, pero responden a intenciones distintas.
Vamos a construir tres clasificaciones, observar sus desacuerdos y entender sus cálculos. Con una sorpresa útil: combinar dos métodos no es automáticamente mejor que usar uno solo.
Descargar el proyecto completo del tutorial — archivo público r3, con el código, los datos, las pruebas y la guía para el lector.
Los comandos, los fragmentos de código y los resultados presentados corresponden al recorrido r3. Los pequeños ejemplos señalados como pedagógicos sirven para entender los cálculos; no constituyen nuevas mediciones del modelo.
Lo que va a construir
Va a construir un pequeño motor de búsqueda que devuelve tres listas de fichas para una misma pregunta.
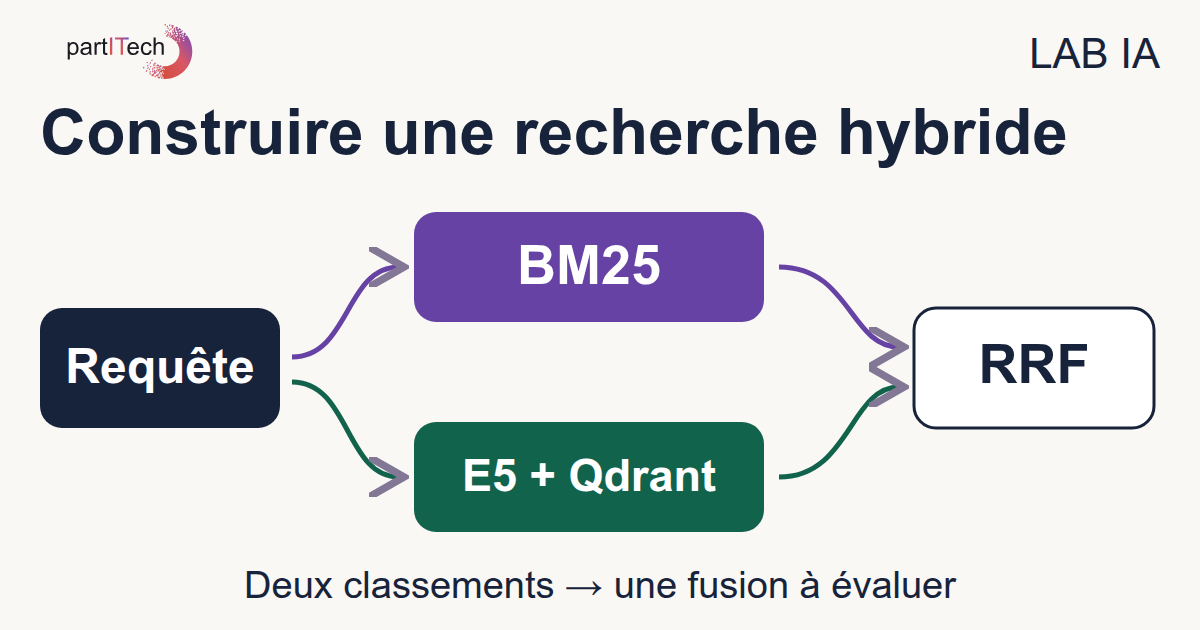
BM25 clasifica las fichas a partir de los términos que comparten con la pregunta. E5 y Qdrant las clasifican a partir de representaciones numéricas de los textos. Después, RRF combina las posiciones obtenidas en las dos listas.
Para un desarrollador web, la salida se parece más a la de una búsqueda en un catálogo que a una conversación: una lista ordenada de identificadores, referencias y textos fuente. El tutorial produce archivos JSON que podrá abrir y comparar. Todavía no proporciona una interfaz web de búsqueda.
No es un chatbot. Ningún modelo redacta una respuesta para el usuario. Buscamos la ficha adecuada; no pedimos a una IA que reformule el procedimiento ni que invente una respuesta cuando el catálogo no la contiene.
Lo que va a aprender
El recorrido sigue tres etapas:
- Preparar un experimento legible: cargar un corpus JSON, conservar identificadores estables y definir las fichas esperadas para cada pregunta.
- Construir las dos búsquedas: calcular BM25, producir embeddings E5 en GPU y almacenarlos y consultarlos con Qdrant.
- Comparar en lugar de suponer: fusionar los rangos con RRF, medir la pertinencia y la latencia, y explicar los resultados ficha por ficha.
Un corpus es simplemente el conjunto de documentos estudiados. Una anotación de pertinencia indica qué ficha se considera una buena respuesta a una pregunta. Ambas nociones serán tan importantes como la elección del modelo.
Requisitos previos
Conocimientos
Sabe utilizar listas y diccionarios de Python, escribir funciones, leer JSON y trabajar en una terminal. Conoce las bases de Docker: imagen, contenedor y volumen. No se presupone ningún conocimiento previo de BM25, embeddings o Qdrant.
No necesita saber entrenar un modelo. En este tutorial usaremos un modelo ya entrenado para calcular representaciones de textos. Indexar las fichas no significa volver a entrenar E5.
Hardware
El perfil previsto es Linux x86_64, con una GPU NVIDIA compatible con CUDA que disponga de 5 Gio de memoria de vídeo libre, 12 Gio de RAM disponible y 20 Gio de disco libre, tanto en el almacenamiento del proyecto como en el de Docker.
La memoria de vídeo, o VRAM, pertenece a la GPU; no debe confundirse con la RAM principal del equipo. CUDA es el entorno utilizado aquí para ejecutar los cálculos del modelo en la GPU NVIDIA.
Estos valores son márgenes de comodidad controlados por el preflight, no mínimos establecidos buscando la configuración más pequeña posible. El recorrido r3 se reprodujo en una RTX 3090. El ZIP no propone un recorrido de CPU: por tanto, no considere una ejecución sin GPU como una variante validada de este ejercicio.
Software
Se necesitan Docker Engine con el complemento Compose, el controlador NVIDIA y NVIDIA Container Toolkit. Internet solo sirve para construir y recuperar las imágenes y adquirir el modelo. Una vez obtenidos esos recursos, el cálculo y la búsqueda utilizan servicios locales.
El recorrido de una consulta
Separemos dos momentos que se confunden fácilmente: preparar los documentos y responder a una búsqueda.
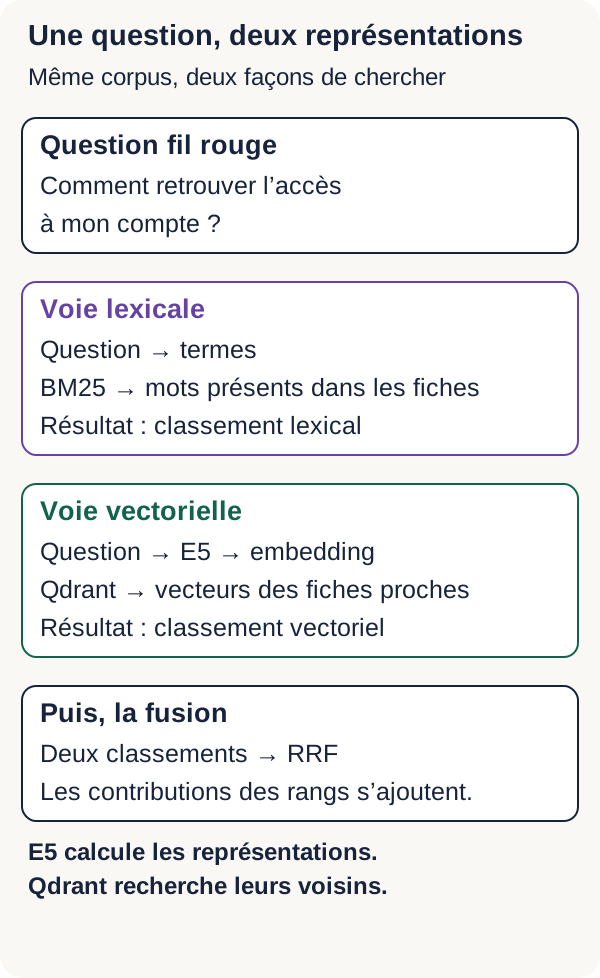
Antes de la primera búsqueda, BM25 prepara contadores de términos. Por su parte, E5 transforma cada ficha en una lista de números, llamada vector o embedding, que Qdrant conserva. Cuando llega una pregunta, BM25 le asigna puntuaciones léxicas y E5 calcula el vector de la pregunta. Qdrant puede entonces buscar los vectores de fichas más cercanos.
Fiches → BM25 : préparation des fréquences
Fiches → E5 passage: → vecteurs → Qdrant : indexation
Question → BM25 → classement lexical
Question → E5 query: → vecteur → Qdrant → classement dense
Classement lexical + classement dense → RRF → classement hybride
RRF llega al final: recibe dos clasificaciones ya calculadas y construye una tercera. No interviene ni en la preparación del modelo ni en la lectura de las fichas por E5.
Atención: una puntuación solo tiene sentido junto con su método de cálculo. BM25 suma contribuciones de términos. La vía densa mide una similitud de coseno, que explicaremos más adelante. RRF suma contribuciones vinculadas a los rangos. Comparar directamente sus números equivaldría a comparar notas obtenidas con tres baremos distintos.
Por ello conservaremos las tres salidas. La pregunta útil no será «¿qué motor produce el número más alto?», sino «¿dónde se encuentra la ficha esperada en cada lista?».
Preparar el equipo y los contenedores
Comprobar que Docker ve su GPU
Descargue y extraiga el ZIP, y luego abra la terminal en su raíz, donde se encuentra README.md. Todos los comandos siguientes parten de ese directorio. No los ejecute desde otro proyecto Docker.
El preflight es una comprobación previa, comparable a verificar los requisitos antes de iniciar una aplicación. Linux debe ver primero la tarjeta con nvidia-smi, y Docker debe hacer accesible esa misma tarjeta al contenedor. Ambas condiciones son distintas: una tarjeta visible en el host puede seguir siendo inaccesible desde Docker.
El script comprueba la GPU elegida, la RAM, el espacio de disco del proyecto y el almacenamiento de Docker. También inicializa CUDA en un contenedor de diagnóstico. El resultado esperado es PREFLIGHT=PASS.
./scripts/preflight.sh
NVIDIA Container Toolkit permite exponer al contenedor la GPU y los elementos necesarios del controlador del host. No reemplaza ese controlador, y el preflight no lo instala por usted. Si el diagnóstico señala una GPU visible en el host pero no en Docker, corrija la configuración indicada antes de continuar. La documentación oficial de NVIDIA Container Toolkit detalla esta instalación.
Después, inicie la preparación del proyecto:
sh scripts/setup.sh
Escribe LOCAL_UID, LOCAL_GID y GPU_DEVICE en .env, y crea los directorios de trabajo. Los dos primeros ajustes sirven para utilizar la identidad local para los archivos; el tercero selecciona la tarjeta que se expondrá. Compruebe esta elección si su equipo tiene varias GPU.
Por último, construya la imagen:
docker compose build
La compilación debe terminar sin errores. La imagen r3 parte de Python 3.12.13 slim-bookworm Linux amd64, fijado por digest. Este digest identifica con precisión la imagen, en lugar de un nombre que más tarde podría designar una versión distinta.
El bloqueo de dependencias instala PyTorch 2.10.0+cu129, Transformers 4.57.6 y Safetensors 0.7.0, con sus URL y huellas SHA-256. PyTorch realiza los cálculos numéricos del modelo; Transformers proporciona, entre otras cosas, las clases para cargar el modelo y su tokenizer. Los componentes CUDA usados por esta pila proceden de los paquetes binarios de PyTorch; el controlador permanece en el host.
Las referencias de distribución son la imagen oficial de Python y las ruedas PyTorch CUDA 12.9. Para reproducir el experimento, conserve las versiones del ZIP en vez de sustituirlas por las últimas disponibles.
Mapa mental de los volúmenes y servicios
Antes de ejecutar el código, identifique dónde se encuentran sus entradas y salidas:
| Elemento | Papel en el tutorial |
|---|---|
app |
Python, PyTorch y la GPU: prepara, codifica, busca y escribe los resultados. |
qdrant |
Índice temporal de vectores y búsqueda de vecinos. |
models/ |
Modelo local en models/e5, adquirido una vez y leído sin conexión. |
outputs/ |
JSON producidos en cada etapa, montados en el host para su lectura. |
El servicio app desempeña el papel del programa principal. Qdrant es un servicio distinto, consultado en la red Docker. Las carpetas models/ y outputs/ siguen visibles en su equipo gracias a los montajes de volúmenes.
El siguiente extracto procede del servicio app. No es un archivo Compose autónomo: el ancla common, reutilizada por <<: *common, está definida en el archivo completo. Conserve el compose.yaml del ZIP para los demás servicios y los límites.
  app:
    <<: *common
    environment:
      MODEL_DIR: /models/e5
      QDRANT_URL: http://qdrant:6333
      HF_HUB_OFFLINE: "1"
      TRANSFORMERS_OFFLINE: "1"
    volumes:
      - ./models:/models:ro
      - ./outputs:/app/outputs
    networks: [isolated]
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              device_ids: ["${GPU_DEVICE:-0}"]
              capabilities: [gpu]
MODEL_DIR es la ruta del modelo vista desde el contenedor. El montaje ./models:/models:ro conecta su carpeta local models/ con /models; :ro significa «solo lectura». El montaje de outputs/, por su parte, permite recuperar los archivos escritos por el programa.
QDRANT_URL utiliza el nombre del servicio, qdrant, en la red Docker. Las variables HF_HUB_OFFLINE y TRANSFORMERS_OFFLINE piden a las bibliotecas correspondientes que trabajen sin conexión. Por último, device_ids expone únicamente la GPU elegida; la documentación de Docker sobre GPU en Compose explica esta reserva.
La imagen construida se llama tutorial-hybride:r3.
A menudo encontrará docker compose run --rm --no-deps app a continuación. Este comando inicia el programa en un contenedor puntual del servicio app, elimina ese contenedor al terminar y no inicia automáticamente sus dependencias. Por eso iniciaremos Qdrant explícitamente antes de las etapas que lo necesitan. Las salidas montadas en el host no desaparecen con este contenedor puntual.
Para ir más lejos — Por qué se refuerzan los contenedores
El compose.yaml completo limita lo que los contenedores pueden modificar o consumir. read_only coloca su raíz en solo lectura, cap_drop: [ALL] elimina las capacidades Linux adicionales y no-new-privileges prohíbe adquirir nuevos privilegios. Una red interna y límites de memoria, CPU, procesos y tmpfs completan estas restricciones. Un tmpfs es un espacio temporal en memoria.
En este recorrido, app lee los modelos y solo escribe las salidas. Qdrant conserva su colección en un almacenamiento temporal. El servicio fetch es una excepción para la red y la escritura de modelos: debe acceder a su repositorio y rellenar models/.
Estas elecciones reducen las posibilidades de acción de los servicios. No constituyen una garantía universal de seguridad ni son ajustes que deba modificar para aprender BM25, E5 o RRF.
Adquirir E5 de forma reproducible
El modelo utilizado es intfloat/multilingual-e5-small, en la revisión fija 614241f622f53c4eeff9890bdc4f31cfecc418b3.
Los pesos de un modelo son los parámetros numéricos adquiridos durante su entrenamiento. Vamos a descargarlos y utilizarlos tal cual. Fijar la revisión equivale a conservar un commit preciso de una dependencia: sabemos qué arquitectura, qué archivos y qué pesos sirvieron para el experimento. Esto hace comparables las ejecuciones, sin prometer que todos los equipos produzcan mediciones estrictamente idénticas.
Los nueve archivos necesarios se describen en configs/models.lock.json, con su tamaño y su huella SHA-256. Una huella es un resumen calculado a partir de los bytes del archivo; compararla con el valor esperado permite detectar un archivo distinto o incompleto.
scripts/fetch_model.py descarga en un archivo parcial, comprueba el tamaño y la huella, y después realiza un renombrado atómico hacia el archivo final de models/e5. En otras palabras, el nombre definitivo solo se utiliza una vez que el control ha tenido éxito.
docker compose --profile acquisition run --rm --no-deps fetch
Un archivo local ya completo se vuelve a verificar y se reutiliza. Durante la adquisición, un archivo ausente o incorrecto se vuelve a descargar y debe superar los controles. Si la verificación falla, la adquisición se detiene.
Al final, los nueve archivos verificados se encuentran en models/e5. Su primera adquisición representa aproximadamente 493 MB. Después ya no se necesita Internet para codificar los textos y buscar las fichas.
La adquisición y la inferencia se mantienen separadas. La inferencia es aquí el uso del modelo para calcular un vector, no su entrenamiento. Si falta un archivo en ese momento, el codificador falla: no descarga discretamente otro modelo. El protocolo y sus límites se describen en docs/MODEL_ACQUISITION.md. No cambie la revisión bloqueada para hacer desaparecer un error.
Antes de indexar, ejecute las pruebas y los puntos de control pedagógicos:
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app scripts/checkpoint.py
Las reproducciones r3 terminan los 18 tests sin fallo ni test omitido, y después confirman los 7 checkpoints. Cubren los cálculos, la adquisición simulada, la inferencia E5 en CUDA y las etapas pedagógicas.
El punto importante es el cálculo E5 real en CUDA: mostrar una tarjeta disponible en Docker no bastaría para probar que el modelo funciona en ella. Trate un fallo antes de continuar; una lista de resultados plausible no sustituye a una prueba superada.
Cargar las fichas
El corpus contiene 16 fichas ficticias. También disponemos de cuatro consultas de desarrollo, cuyas fichas esperadas tienen los ID 0, 1, 14 y 15. Sirven para explorar el funcionamiento, en particular con nuestra pregunta guía.
La evaluación utiliza otro conjunto: 12 preguntas que tienen cada una una ficha pertinente, y dos preguntas fuera del corpus, para las cuales ninguna ficha está anotada como pertinente.
Una anotación es aquí binaria: una ficha es pertinente o no lo es para la pregunta. Son elecciones pedagógicas, no el resultado de una encuesta a usuarios. Las anotaciones sirven para juzgar las clasificaciones; no se usan para entrenar E5 en este tutorial.
Inicie Qdrant y después prepare los datos:
docker compose up -d qdrant
docker compose run --rm --no-deps app -m src.cli prepare
Abra outputs/prepared.json. Debe indicar 16 documentos y mostrar la primera ficha, ID 0, REF-100. En este punto, Qdrant funciona, pero todavía no contiene ningún vector: preparar los datos e indexarlos son dos operaciones distintas.
Datos: una ficha, un identificador, una anotación
Esta es la primera ficha tal como aparece en data/corpus.json:
{
  "id": 0,
  "reference": "REF-100",
  "family": "Compte",
  "text": "REF-100 — Réinitialiser le mot de passe du compte. Cliquez sur Mot de passe oublié puis suivez le lien envoyé par courriel."
}
id identifica la ficha en el código y en el índice. reference es su referencia legible. family indica su tema general. text contiene el contenido que se debe buscar.
En data/development.json, «¿Cómo recuperar el acceso a mi cuenta?» lleva la anotación relevant: [0]. Esto significa: para esta pregunta, esperamos la ficha 0. La ficha ID 1 se anota por separado para «Cambiar mi correo electrónico».
La distinción entre family y relevant es esencial. Dos fichas de la familia Compte pueden ser muy cercanas por el vocabulario y, aun así, responder a dos problemas distintos. El motor no debe limitarse a encontrar el tema correcto: comprobaremos si encuentra el procedimiento correcto.
Estos ID se mantienen estables en las clasificaciones, el índice y las anotaciones, incluso si una interfaz solo muestra un título o un extracto. El corpus no contiene ningún dato de cliente.
BM25: frecuencia, rareza y longitud
Empecemos por un método que se puede seguir sin red neuronal.
BM25 es una regla de clasificación léxica: otorga puntos a una ficha según los términos que comparte con la pregunta. En vez de responder únicamente «¿este texto contiene esta palabra?», distingue las palabras más o menos útiles y tiene en cuenta su repetición.
Tres ideas guían el cálculo: un término presente aporta una señal; un término raro en el corpus aporta una señal más distintiva; repetir un término o escribir un texto muy largo no debe hacer ganar mecánicamente todas las clasificaciones.
Esta vía constituye una primera búsqueda sin modelo neuronal, particularmente interesante cuando una referencia o un código de error es discriminante. Su puntuación no es una probabilidad: sirve para ordenar las fichas de un mismo corpus para una misma consulta.
Primero, decidir qué llamamos un término
El programa normaliza los caracteres Unicode en NFKC, convierte el texto a minúsculas y extrae las secuencias reconocidas por \w+. NFKC armoniza determinadas representaciones de caracteres; este paso no significa «eliminar los acentos».
Así, courriel, se convierte en courriel, y REF-100 se convierte en dos tokens, ref y 100. Los acentos se conservan. El código tampoco reduce automáticamente compte y comptes al mismo término.
Un token es una unidad resultante de esta segmentación. Aquí no es ni una frase ni necesariamente una palabra tal como se ve en pantalla. Esta regla tiene un efecto práctico: BM25 no trata la referencia REF-100 como un identificador indivisible. La validación de una referencia exacta sería otra operación.
Contar en una ficha no es contar en el corpus
Para leer la fórmula, conserve estas correspondencias:
f(t,d): cuántas veces aparece el términoten la fichad;|d|: cuántos tokens contiene esa ficha.N: número total de fichas;df(t): número de fichas que contienen el término, independientemente del número de repeticiones en cada una.avgdl: longitud media de las fichas, medida con la misma segmentación en tokens.
Por ejemplo, si una palabra aparece cinco veces en una sola ficha, su frecuencia en esa ficha es 5, pero esa ficha solo contribuye con 1 a df(t).
La rareza se calcula mediante el IDF, de inverse document frequency:
IDF(t) = log(1 + (N - df(t) + 0,5) / (df(t) + 0,5))
log designa aquí el logaritmo natural, calculado por math.log. No es necesario memorizar la fórmula para entender su efecto: cuanto más comparten un término las fichas, menos permite diferenciarlas.
Tomemos las tres fichas ficticias de un pequeño ejemplo, distinto del corpus del tutorial. Si rare aparece en una sola ficha, df(rare)=1 e IDF≈0,981. Si courant aparece en las tres, df(courant)=3 e IDF≈0,134. Por tanto, el primero aporta más peso, en igualdad de condiciones.
Por qué las repeticiones no aportan indefinidamente
La contribución completa de un término es:
IDF(t) × f(t,d) × (k1 + 1) / (f(t,d) + k1 × (1 - b + b × |d| / avgdl))
El ajuste k1=1,2 controla la saturación: repetir un término aumenta su contribución, pero cada vez menos. El ajuste b=0,75 controla la corrección vinculada a la longitud. Con b=0, se ignora esta corrección; con b=1, se aplica por completo.
Para hacer concreta la saturación, tomemos un cálculo pedagógico en el que la ficha tiene exactamente la longitud media. El factor que multiplica el IDF vale 1 para una aparición, 1,375 para dos apariciones y aproximadamente 1,964 para diez apariciones. Por tanto, diez repeticiones no dan diez veces más puntos.
Los términos de la pregunta, por su parte, se deduplican. Repetir diez veces la misma palabra en la pregunta no multiplica su contribución por diez.
La documentación BM25 de Apache Lucene describe el papel de k1, de b y la variante de IDF utilizada aquí. Es una referencia sobre los conceptos; el código Python del tutorial sigue siendo nuestra implementación que observar.
Leer la implementación
"""BM25 : fréquence des mots, rareté et correction de longueur."""
import math
import re
import unicodedata
from collections import Counter


def validate_query(query):
    if not isinstance(query, str) or not query.strip() or len(query) > 2048:
        raise ValueError(
            "Requête attendue : texte non vide de 2048 caractères maximum"
        )
    return query


def tokens(text):
    return re.findall(r"\w+", unicodedata.normalize("NFKC", text).lower())


class BM25:
    def __init__(self, documents, k1=1.2, b=0.75):
        self.documents = documents
        self.k1 = k1
        self.b = b
        self.terms = [Counter(tokens(doc["text"])) for doc in documents]
        self.lengths = [sum(terms.values()) for terms in self.terms]
        self.average_length = sum(self.lengths) / max(1, len(documents))
        self.document_frequency = Counter(
            term for terms in self.terms for term in terms
        )

    def search(self, query, limit=10):
        validate_query(query)
        if limit <= 0:
            raise ValueError("limit doit être positif")
        result = []
        for doc, frequencies, length in zip(
            self.documents, self.terms, self.lengths
        ):
            score = 0.0
            for term in set(tokens(query)):
                frequency = frequencies[term]
                if not frequency:
                    continue
                count = self.document_frequency[term]
                rarity = math.log(
                    1 + (len(self.documents) - count + 0.5) / (count + 0.5)
                )
                length_factor = (
                    1 - self.b + self.b * length / self.average_length
                )
                score += (
                    rarity * frequency * (self.k1 + 1)
                    / (frequency + self.k1 * length_factor)
                )
            if score > 0:
                result.append((doc["id"], score))
        return sorted(result, key=lambda row: (-row[1], row[0]))[:limit]
En __init__, Counter cuenta los términos de cada ficha. lengths y average_length preparan las longitudes. Después, document_frequency cuenta en cuántas fichas aparece cada término: recorrer las claves de un Counter evita volver a contar varias veces el mismo término en una ficha.
En search, la validación exige una cadena no vacía de 2 048 caracteres como máximo y un límite positivo. El programa visita cada ficha y después cada término distinto de la pregunta. Un término ausente no contribuye. Para los demás, rarity calcula el IDF y length_factor la corrección de longitud, antes de añadir la contribución a la puntuación.
Por último, se omiten las fichas con puntuación nula. La ordenación utiliza -row[1] para colocar primero las puntuaciones más altas, y después row[0] para desempatar por ID creciente. El resultado es una lista de parejas (identifiant, score).
Ahora puede relacionar el código con las tres ideas iniciales: contar, ponderar la rareza, corregir las repeticiones y la longitud. No se ha entrenado ningún modelo para realizar estas operaciones.
Inicie la búsqueda léxica:
docker compose run --rm --no-deps app -m src.cli lexical
Para la pregunta guía, los cinco primeros ID de la clasificación BM25 r3 verificada son [15, 1, 8, 9, 0]. Por tanto, la ficha esperada, ID 0, llega en el puesto 5.
BM25 encuentra términos de la pregunta, pero esta no contiene todas las palabras del procedimiento de restablecimiento. Conservemos esta observación antes de probar la otra vía. No se trata de modificar los parámetros hasta forzar la respuesta deseada, sino de entender qué permite distinguir —y qué no permite distinguir— esta primera señal.
De las palabras a los embeddings
BM25 responde a una pregunta concreta: «¿Qué términos se encuentran en esta ficha?». Ahora vamos a añadir otra forma de comparar los textos.
Un embedding es una lista de números producida por un modelo a partir de un texto. Puede imaginarlo como las coordenadas de un punto. Los textos que el modelo ha aprendido a aproximar pueden tener puntos cercanos, aunque no compartan exactamente las mismas palabras.
El modelo elegido aquí produce 384 coordenadas por texto. Eso es lo que significa «vector de dimensión 384», o «384D». No elegimos manualmente un eje compte, un eje mot_de_passe y un eje facture. Las coordenadas proceden de las representaciones aprendidas por el modelo.
No se debe confundir este vector con el ID de la ficha. El ID sirve para recuperar el mismo documento en el programa. El embedding sirve para compararlo con otros textos. Tampoco es una huella SHA-256: el hash controla bytes, mientras que el embedding sirve para medir una proximidad en un espacio aprendido.
Esta vía se llama búsqueda densa porque utiliza este tipo de representación numérica. Aporta una señal diferente a la de los términos comunes. «Recuperar el acceso» puede así aproximarse a una ficha que habla de «contraseña olvidada».
Pero estar cerca no significa ser pertinente con seguridad. Dos fichas que hablan de la gestión de una cuenta pueden parecerse sin proponer el mismo procedimiento. Por ello compararemos los resultados con nuestras anotaciones, en lugar de confiar solo en la impresión de comprensión.
E5: del texto al vector
E5 es aquí el codificador: transforma los textos en vectores. No redacta una respuesta y no le enseñamos nuevos parámetros con las 16 fichas. Utilizamos los pesos ya adquiridos para realizar un cálculo de inferencia.
Veamos las etapas en orden. Los nombres pueden parecer técnicos; cada uno corresponde a una transformación bastante concreta de los datos.
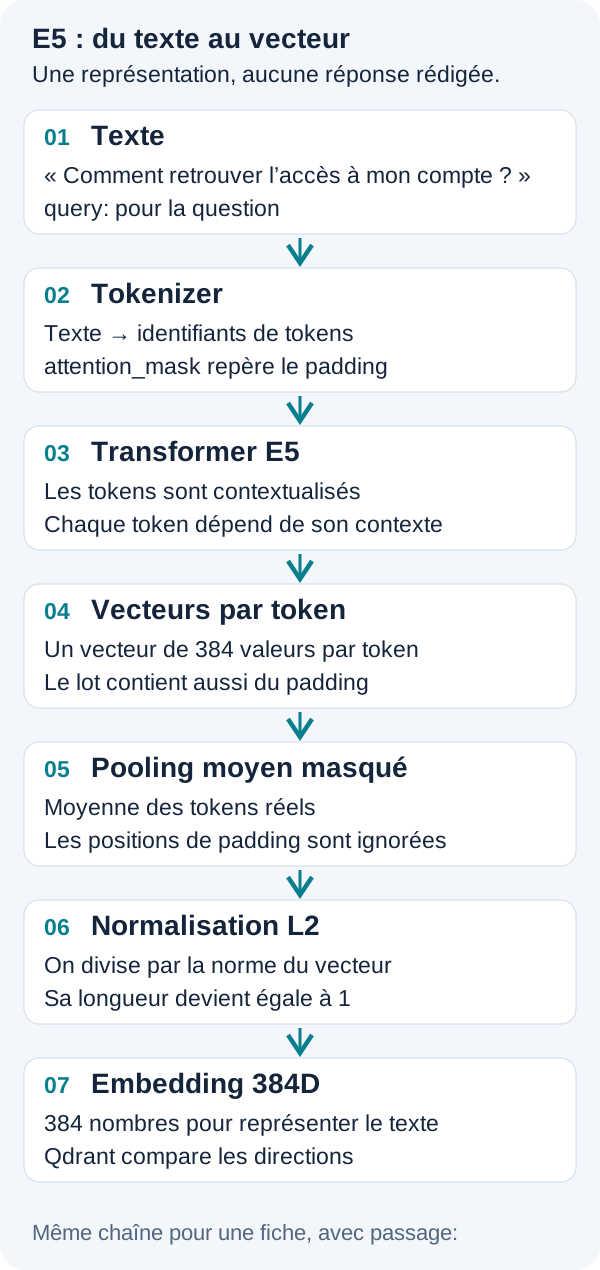
1. Indicar el papel del texto
Una pregunta comienza por query: . Una ficha comienza por passage: . Estos prefijos se mantienen en inglés, incluso cuando el contenido está en francés.
Para nuestro hilo conductor, E5 recibe por tanto la pregunta en la forma query: Comment retrouver l'accès à mon compte ?. La ficha recibe el prefijo passage: antes de su codificación.
El prefijo no traduce el texto. Indica su papel: por un lado, una necesidad expresada; por otro, un contenido que recuperar. La ficha oficial de E5 multilingüe, en la revisión utilizada presenta esta convención y su ejemplo de codificación.
2. Transformar los textos en tokens y preparar un lote
El tokenizer segmenta el texto en unidades reconocidas por el modelo y después las sustituye por sus identificadores numéricos, los input_ids. Un token puede representar una palabra, una parte de palabra o un símbolo. Por tanto, esta segmentación no es la de BM25.
El programa procesa los textos en lotes de 16 como máximo. Para calcular conjuntamente secuencias de longitudes distintas, las completa hasta una anchura común. Esto es el padding, es decir, el relleno.
El modelo también recibe una attention_mask. Por ejemplo, [1, 1, 0] significa que las dos primeras posiciones son válidas y la tercera es relleno. Esta información permite distinguir el texto de las posiciones añadidas para el cálculo por lotes.
3. Obtener una representación para cada posición
El Transformer, la arquitectura del modelo, calcula un vector para cada posición del texto teniendo en cuenta su contexto. El resultado intermedio se llama last_hidden_state en el código.
Por tanto, todavía no tenemos un vector por ficha, sino un vector por posición. La palabra oculto, en «estado oculto», designa simplemente una representación interna del modelo, y no una información secreta.
No es un diccionario que sustituye una palabra por su sinónimo. Las relaciones entre formulaciones provienen del aprendizaje previo del modelo. Esto permite aproximar algunos textos, pero sigue sin garantizar que respondan a la misma necesidad.
4. Pasar de varios vectores a uno solo: la media enmascarada
Ahora necesitamos una representación de todo el texto. El pooling es la operación que reúne las representaciones de las posiciones en un solo vector. Aquí calculamos una media, coordenada por coordenada, excluyendo el padding.
Tomemos un ejemplo pedagógico de dos coordenadas, mucho más pequeño que los vectores reales de E5:
Première position valide : [2, 4]
Deuxième position valide : [4, 4]
Position de remplissage  : ignorée
Masque                   : [1, 1, 0]

Somme des positions valides : [2 + 4, 4 + 4] = [6, 8]
Nombre de positions valides : 2
Moyenne                    : [6 / 2, 8 / 2] = [3, 4]
La máscara sirve para dos cosas en esta etapa: poner a cero la contribución de las posiciones de relleno y contar las posiciones válidas para la división. Así se obtiene la media del texto, no la de un texto completado artificialmente.
Con E5 se aplica el mismo principio a las 384 coordenadas. Ninguna coordenada, tomada por sí sola, debe interpretarse como una etiqueta de negocio como «habla de facturación».
5. Normalizar el vector para comparar su dirección
La normalización L2 lleva la longitud matemática del vector, llamada su norma, a 1. Esta longitud no es el número de coordenadas: un vector sigue siendo 384D después de la normalización.
En nuestro ejemplo de dos coordenadas, [3, 4] tiene una norma de 5, porque 3² + 4² = 25. Dividir las coordenadas por 5 da [0.6, 0.8].
¿Por qué hacerlo? Queremos comparar la dirección de los vectores en vez de su amplitud. El producto escalar consiste en multiplicar las coordenadas correspondientes de dos vectores y sumar después esos productos. Cuando ambos vectores tienen norma 1, este resultado es su similitud de coseno.
Un valor elevado indica proximidad en el espacio aprendido. No es una probabilidad de que la ficha responda a la pregunta. La similitud debe confrontarse con el contenido y la anotación, especialmente cuando varios procedimientos hablan del mismo tema.
Leer el código y después encontrar cada etapa
"""E5 sur un seul GPU CUDA ; les poids sont acquis séparément."""
import os
import torch
from transformers import AutoModel, AutoTokenizer


class Encoder:
    def __init__(self):
        if not torch.cuda.is_available():
            raise RuntimeError(
                "GPU CUDA requis ; vérifier GPU_DEVICE et NVIDIA Container Toolkit"
            )
        torch.manual_seed(42)
        torch.set_num_threads(4)
        directory = os.environ.get("MODEL_DIR", "/models/e5")
        self.tokenizer = AutoTokenizer.from_pretrained(
            directory, local_files_only=True
        )
        self.model = (
            AutoModel.from_pretrained(directory, local_files_only=True)
            .to("cuda")
            .eval()
        )

    def encode(self, texts, kind):
        if kind not in ("query", "passage") or not texts:
            raise ValueError("Préfixe query/passage et liste non vide requis")
        vectors = []
        for offset in range(0, len(texts), 16):
            batch = self.tokenizer(
                [kind + ": " + text for text in texts[offset:offset + 16]],
                padding=True,
                truncation=False,
                return_tensors="pt",
            )
            if batch["input_ids"].shape[1] > 512:
                raise ValueError("Texte dépassant 512 tokens : découpez le document")
            batch = batch.to("cuda")
            with torch.inference_mode():
                hidden = self.model(**batch).last_hidden_state
                mask = batch["attention_mask"].unsqueeze(-1).bool()
                pooled = hidden.masked_fill(~mask, 0).sum(1) / mask.sum(1)
                normalized = torch.nn.functional.normalize(pooled, p=2, dim=1)
            if not torch.isfinite(normalized).all():
                raise ValueError("Embedding non fini")
            vectors.extend(normalized.cpu().tolist())
        return vectors
El constructor comprueba CUDA, fija la semilla en 42, limita los hilos de CPU a 4 y carga el tokenizer y el modelo desde MODEL_DIR. local_files_only=True prohíbe una descarga implícita. El modelo se coloca en la GPU con .to("cuda").
Las llamadas .eval() y torch.inference_mode() tienen dos papeles complementarios. La primera ajusta el comportamiento del modelo para la evaluación. La segunda desactiva los mecanismos de seguimiento de gradientes necesarios para el aprendizaje. La documentación de PyTorch sobre inference_mode precisa que una no sustituye a la otra. Aquí codificamos los textos; no actualizamos ningún peso.
En encode, la lista construida con kind + ": " + text añade el prefijo. El tokenizer prepara los identificadores y la máscara, y después batch.to("cuda") envía esos datos a la GPU.
El pasaje central corresponde exactamente al cálculo explicado antes: hidden contiene las representaciones de las posiciones; unsqueeze(-1) añade un eje a la máscara para aplicarla a las coordenadas; masked_fill anula la contribución del padding; .sum(1) suma las posiciones; la división calcula la media; normalize fija la norma del vector.
Por último, torch.isfinite rechaza valores no válidos, como un infinito o NaN, antes de enviarlos a Qdrant. normalized.cpu().tolist() devuelve los resultados en listas Python ordinarias.
Un límite explícito, en lugar de un texto recortado en silencio
El tokenizador usa truncation=False. Si el lote tokenizado supera las 512 posiciones, el programa rechaza el texto antes del cálculo del Transformer y pide dividir el documento. La comprobación se aplica a la secuencia tokenizada, que incluye el prefijo y los tokens añadidos por el tokenizador.
Así se evita que una parte de la ficha desaparezca silenciosamente antes de la codificación. No confunda este límite con los 2 048 caracteres de la validación léxica: son dos controles expresados en dos unidades distintas.
La salida esperada del codificador es una lista de vectores finitos de longitud 384, nunca texto generado. Las fichas se codifican como pasajes antes de la indexación; la pregunta se codifica como consulta en el momento de buscar. La ficha del modelo E5 multilingüe completa esta presentación.
Almacenar y buscar vectores con Qdrant
E5 acaba de calcular números. Ahora hay que conservarlos y recuperar los que se parecen al vector de una pregunta. En este tutorial, esa es la función de Qdrant.
Para imaginar el almacenamiento, piense en un registro con tres elementos: el identificador de la ficha, su vector y su contenido JSON. Qdrant llama point a ese registro y collection al conjunto de esos puntos. La analogía con una tabla puede ayudar a orientarse, pero aquí la búsqueda se basa en la proximidad de los vectores.
El contenido asociado al vector se llama payload. Conserva, entre otros datos, el ID, la referencia y el texto de la ficha para poder mostrarlos tras la búsqueda. El payload no calcula el embedding: E5 ya lo produjo en Python.
Lo que debe garantizar la indexación
El siguiente extracto procede de la clase VectorStore. Solo contiene los métodos index y search, no la clase completa ni sus métodos de comunicación HTTP.
La indexación exige un vector de dimensión 384 por ficha. Crea una colección configurada con distance: Cosine y añade después las fichas y sus vectores. Si la colección ya existe, se niega a continuar: así el recorrido evita confundir una indexación nueva con el estado dejado por una anterior.
    def index(self, documents, vectors):
        if len(documents) != len(vectors) or any(
            len(vector) != 384 for vector in vectors
        ):
            raise ValueError("Un vecteur de dimension 384 par document est requis")
        self.ready()
        path = "/collections/" + self.collection
        exists = self.request(path + "/exists")["result"]["exists"]
        if exists:
            raise ValueError(
                "Collection existante : arrêter le projet avant une nouvelle indexation"
            )
        self.request(
            path,
            {"vectors": {"size": 384, "distance": "Cosine"}},
            "PUT",
        )
        if documents:
            points = [
                {"id": doc["id"], "vector": vector, "payload": doc}
                for doc, vector in zip(documents, vectors)
            ]
            self.request(path + "/points?wait=true", {"points": points}, "PUT")
        return self.request(path)["result"]

    def search(self, vector, limit=10):
        body = {
            "query": vector,
            "limit": limit,
            "with_payload": True,
            "params": {"exact": True},
        }
        result = self.request(
            "/collections/" + self.collection + "/points/query", body
        )["result"]["points"]
        return sorted(
            [(row["id"], row["score"]) for row in result],
            key=lambda row: (-row[1], row[0]),
        )
En index, el primer control verifica tanto el número de vectores como su dimensión. self.ready() precede las llamadas al servicio. La petición a /exists comprueba la presencia de una colección, y su creación indica la dimensión y la medida de proximidad esperadas.
Cada elemento de points asocia después id, vector y payload. El parámetro wait=true pide esperar a que se aplique la operación de escritura. Después de indexar, la colección debe contener 16 puntos.
Ejecute este paso:
docker compose run --rm --no-deps app -m src.cli index
Abra outputs/index.json. Indica el número de puntos, la dimensión y el dispositivo CUDA. La colección solo debe crearse una vez por inicio del proyecto. Para reconstruirla, hay que detener el proyecto, reiniciar Qdrant y volver a indexar.
«Búsqueda exacta» no significa «respuesta correcta garantizada»
En search, query contiene el vector de la pregunta. limit fija el número máximo de vecinos solicitados. with_payload: True pide adjuntar sus datos; este extracto reduce después los resultados a pares (id, score) para ordenarlos.
El ajuste exact: True solicita una búsqueda exhaustiva de vecinos, en lugar de una búsqueda aproximada. La documentación de Qdrant Search explica esta distinción.
Por tanto, la palabra exacta se refiere al cálculo de vecinos según los vectores y la medida elegidos. No significa que Qdrant compruebe que el procedimiento recuperado sea correcto. Un vecino calculado exactamente puede seguir siendo una ficha poco pertinente para nuestro usuario.
Ejecute ahora la vía densa:
docker compose run --rm --no-deps app -m src.cli dense
Lea los vecinos y sus cosenos en outputs/dense.json. Para el hilo conductor, el top 5 r3 es [0, 1, 8, 2, 14]: la ficha esperada, ID 0, llega al primer puesto, frente al quinto en BM25.
Su puntuación de coseno medida es 0,8599599. Esto no significa «un 85,99599 % de probabilidades de que la respuesta sea correcta». Lo interesante es que la ficha anotada como pertinente queda en cabeza y que puede volver a leer su texto.
Una pausa: ¿cómo combinar estas dos listas?
Estas son las cinco primeras fichas de cada vía para la misma pregunta. Top 5 solo significa «las cinco primeras posiciones de la clasificación».
| Puesto | BM25 | E5 / Qdrant |
|---|---|---|
| 1 | ID 15 · REF-115 Eliminar a un miembro del equipo le quita el acceso al proyecto, pero conserva sus documentos compartidos |
ID 0 · REF-100 Restablecer la contraseña de la cuenta |
| 2 | ID 1 · REF-101 Cambiar la dirección de correo electrónico de la cuenta desde el perfil |
ID 1 · REF-101 Cambiar la dirección de correo electrónico de la cuenta desde el perfil |
| 3 | ID 8 · REF-108 Activar la autenticación de dos factores |
ID 8 · REF-108 Activar la autenticación de dos factores |
| 4 | ID 9 · REF-109 Cerrar todas las sesiones activas desde Seguridad |
ID 2 · REF-102 Descargar una factura PDF desde Facturación y después Historial de pagos |
| 5 | ID 0 · REF-100 Restablecer la contraseña de la cuenta |
ID 14 · REF-114 Invitar a un miembro a un equipo |
E5 coloca el restablecimiento de contraseña en cabeza. BM25 coloca primero una ficha sobre eliminar a un miembro del equipo, que también habla de acceso. Las dos búsquedas usan el mismo corpus, pero no valoran las mismas señales.
Podríamos sentirnos tentados a sumar sus puntuaciones. El problema es su escala: una suma BM25 y un coseno no son dos notas calculadas con el mismo baremo. Sumarlos directamente introduciría un peso arbitrario entre los métodos.
En cambio, las dos listas tienen una información común fácil de leer: el puesto. Primero, segundo, tercero… Usaremos esta posición para combinarlas.
RRF: fusionar sin convertir las puntuaciones
RRF, de Reciprocal Rank Fusion, es una fusión basada en los puestos. Imagine dos clasificaciones propuestas por dos evaluadores: damos puntos a las fichas según su posición en cada una y luego sumamos esos puntos.
RRF no lee ni el texto ni los embeddings. No convierte una puntuación BM25 en coseno ni aprende a reconocer el procedimiento esperado. Aplica una regla aritmética.
Una contribución por cada puesto observado
Para una ficha en el puesto rang de una lista, la contribución vale:
1 / (k + rang)
Los puestos empiezan en 1. La constante k suaviza las diferencias entre posiciones. Con un k grande, los primeros puestos aportan contribuciones bastante parecidas. Con un k pequeño, los primeros lugares pesan más.
Para una ficha d, se suman las contribuciones de las clasificaciones en las que aparece:
RRF(d) = Σ 1 / (k + rang_i(d))
El símbolo Σ solo quiere decir «hacer la suma». Una ficha ausente de una lista recibe 0 para esa lista. No se le inventa un puesto al final.
Repetir el cálculo para nuestras dos fichas de cuenta
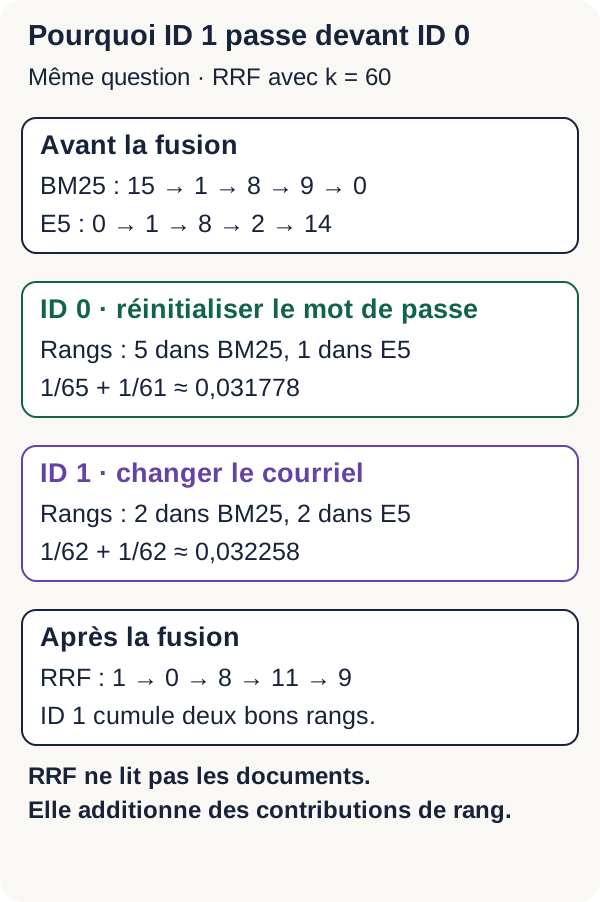
El recorrido usa k=60. Para el ID 0, las posiciones son 5 en BM25 y 1 en densa:
RRF(ID 0) = 1/65 + 1/61 ≈ 0,031778
Para el ID 1, las posiciones son 2 en las dos listas:
RRF(ID 1) = 1/62 + 1/62 ≈ 0,032258
El ID 1 pasa, por tanto, por delante del ID 0. La coincidencia de dos segundos puestos aporta algo más que un primer puesto asociado a un quinto puesto. El cálculo es correcto, pero no conoce nuestra anotación: «cambiar el correo electrónico» sigue siendo una intención distinta de «recuperar el acceso a mi cuenta».
Una puntuación RRF es una suma de contribuciones, no una probabilidad. La documentación de Elasticsearch sobre RRF también ilustra esta fórmula. Sirve aquí como referencia del mecanismo; no instalamos Elasticsearch y conservamos la implementación Python del ZIP.
Leer la fusión en el código
"""Reciprocal Rank Fusion (RRF), rangs commençant à 1."""
import math


def reciprocal_rank_fusion(rankings, k=60):
    if not isinstance(k, (int, float)) or not math.isfinite(k) or k < 0:
        raise ValueError("k doit être fini et positif ou nul")
    scores = {}
    for ranking in rankings:
        seen = set()
        for rank, (document_id, original_score) in enumerate(ranking, start=1):
            if document_id in seen or not math.isfinite(original_score):
                raise ValueError("Classement avec doublon ou score non fini")
            seen.add(document_id)
            contribution = 1.0 / (k + rank)
            scores[document_id] = scores.get(document_id, 0.0) + contribution
    return sorted(scores.items(), key=lambda row: (-row[1], row[0]))
El bucle exterior recorre las clasificaciones. enumerate(..., start=1) proporciona los puestos y contribution calcula los puntos. El diccionario scores acumula las contribuciones de un mismo ID de una lista a otra.
En cambio, seen impide contar dos veces el mismo ID dentro de una sola lista. Se rechazan las puntuaciones no finitas. La función también comprueba que k sea finito y positivo o nulo, lo que permite más adelante el experimento con k=0.
Observe el papel limitado de original_score: sirve para rechazar un valor no finito, pero no entra en la fórmula. Si cambian solo los números de las puntuaciones, sin cambiar el orden ni los candidatos de cada lista, la fusión permanece igual. La ordenación final clasifica las contribuciones descendentes y usa el ID ascendente para desempatar.
Ejecute la comparación:
docker compose run --rm --no-deps app -m src.cli compare
Abra outputs/compare.json antes de sacar conclusiones. Una fusión puede estancarse o empeorar si sus candidatos son malos, si una de las vías ya era muy buena o si k no corresponde al compromiso buscado.
| Vía | Cinco primeros IDs | Puesto de la ficha esperada ID 0 |
|---|---|---|
| BM25 | 15, 1, 8, 9, 0 | 5 |
| E5 + Qdrant | 0, 1, 8, 2, 14 | 1 |
| RRF | 1, 0, 8, 11, 9 | 2 |
La fusión hace subir el ID 0, «Restablecer la contraseña», del puesto 5 léxico al puesto 2 híbrido. Sin embargo, lo hace bajar respecto al puesto 1 denso. El ID 1, «Cambiar la dirección de correo electrónico», pasa por delante gracias a sus dos segundos puestos.
Un detalle merece una pausa: el ID 11 aparece entre los cinco primeros de RRF aunque no figure en los dos top 5 mostrados antes. RRF no crea identificadores. Según su código, un ID solo puede aparecer en la fusión si estaba presente en al menos una lista recibida. Por tanto, las cinco filas mostradas no bastan para reconstruir todas sus entradas. Para rehacer la clasificación completa, inspeccione las listas transmitidas realmente en el recorrido y las salidas de comparación, en vez de fusionar solo los cinco elementos de la tabla.
La lección no es «la búsqueda híbrida funciona mal». Es más precisa: esta fusión mejora una vía y empeora la otra para esta pregunta. Ahora debemos comprobar qué ocurre en todo el conjunto de evaluación.
Casos negativos
Antes de medir la pertinencia, comprobemos los errores que el sistema debe gestionar. Un caso negativo es una prueba en la que presentamos deliberadamente una situación vacía o inválida y comprobamos el comportamiento esperado.
Una colección vacía debe producir una lista vacía. Un texto que supera los 512 tokens debe rechazarse después de la tokenización, antes del cálculo de representaciones por el Transformer. Qdrant también debe rechazar un vector cuya dimensión no sea 384.
Este último control se parece a un contrato de API: hemos anunciado una estructura y una entrada incompatible no debe aceptarse discretamente. Estas pruebas comprueban el comportamiento técnico correcto; todavía no miden la pertinencia de las fichas.
docker compose run --rm --no-deps app -m src.cli negatives
Los tres indicadores de outputs/negatives.json deben ser verdaderos antes de continuar. Un error esperado y correctamente rechazado es aquí una prueba superada, no un fallo del tutorial.
Medir las tres vías
Tenemos listas. ¿Cómo juzgar si son útiles? Una puntuación de similitud no basta: hay que comparar los identificadores recuperados con las fichas esperadas.
Las reglas de evaluación se definen antes de leer los resultados. Las 12 preguntas que tienen una ficha pertinente entran en las medias de pertinencia. Las dos preguntas fuera del corpus se cuentan por separado.
¿Por qué separarlas? Para una pregunta sin ficha pertinente, el recall tendría un denominador nulo. Asignarle automáticamente una puntuación de 0 mezclaría dos problemas: clasificar mal una respuesta que existe y saber abstenerse cuando no existe. Aquí conservamos un contador específico para las preguntas sin respuesta pertinente y para los resultados que se devuelven a pesar de ello.
Recall@5: encontrar las pertinentes
El Recall@5, o recall en cinco resultados, responde a esta pregunta: «De todas las fichas esperadas, ¿cuántas he recuperado entre las cinco primeras?»
La fórmula es:
|top5 ∩ pertinents| / |pertinents|
La intersección ∩ conserva los identificadores presentes en los dos conjuntos. Las barras |…| cuentan sus elementos.
En nuestro conjunto, cada pregunta evaluable tiene una sola ficha pertinente. Si está en el puesto 4, el recall vale 1; si está ausente de las cinco primeras, vale 0. Por tanto, un valor alto indica que la ficha útil suele ser visible en el top 5.
Atención: Recall@5 no distingue los puestos 1 y 5. Tampoco mide la proporción de fichas buenas entre las cinco mostradas. Una lista con una sola ficha buena y cuatro malas puede tener un recall de 1 si esa ficha buena era la única esperada.
MRR@10: colocar la primera respuesta
El MRR@10, de Mean Reciprocal Rank, se interesa por la posición de la primera ficha pertinente entre los diez primeros resultados.
Para una pregunta, se toma el inverso de ese puesto: 1 en el puesto 1, 1/4 = 0,25 en el puesto 4, y 0 si ninguna ficha pertinente figura entre las diez primeras. El MRR del conjunto es después la media de estos valores, calculada pregunta por pregunta.
Un valor alto significa que el usuario encuentra rápidamente una primera ficha útil. Esta métrica no recompensa las demás fichas pertinentes situadas después de la primera, cuando hay varias.
nDCG@10: ordenar las respuestas útiles
El nDCG@10, de normalized Discounted Cumulative Gain, plantea una pregunta algo más general: «¿Mis fichas útiles están tan bien colocadas como podrían estarlo?»
Con nuestra pertinencia binaria, cada ficha pertinente aporta una ganancia que disminuye con su puesto. En el puesto r, esta ganancia vale 1 / log2(r + 1). Se suman las ganancias de las diez primeras posiciones y se divide después por la ganancia de la mejor clasificación posible. log2 es el logaritmo en base 2; recuerde sobre todo que hace disminuir la ganancia cuando el puesto aumenta.
Para una sola ficha pertinente, la clasificación ideal la coloca en el puesto 1 y vale 1. En el puesto 2, su ganancia es 1 / log2(2 + 1) ≈ 0,63093. Una ficha ausente del top 10 no aporta nada.
Un valor alto significa que las fichas útiles se concentran al principio. A diferencia de MRR, nDCG puede valorar varias fichas pertinentes bien colocadas. En este corpus solo hay una por pregunta evaluable, pero el código conserva esta definición general.
Aplicar las tres reglas a nuestra pregunta hilo conductor
Retomemos los puestos ya observados: 5 para BM25, 1 para E5/Qdrant y 2 para RRF. La tabla siguiente es una aplicación de las fórmulas a estos puestos, no una nueva ejecución de GPU ni la media del conjunto de evaluación.
| Vía, para la única pregunta hilo conductor | Puesto del ID 0 | Recall@5 | Contribución al MRR@10 | nDCG@10 |
|---|---|---|---|---|
| BM25 | 5 | 1 | 0,2 | 0,386853 |
| E5 + Qdrant | 1 | 1 | 1 | 1 |
| RRF | 2 | 1 | 0,5 | 0,630930 |
Las tres vías tienen el mismo recall: todas recuperan la ficha correcta entre las cinco primeras. Sin embargo, no ofrecen la misma experiencia de lectura. MRR y nDCG hacen visible esta diferencia.
Comprobar qué cuentan realmente las funciones
"""Pertinence binaire ; les requêtes sans pertinent sont traitées séparément."""
import math


def ranking_metrics(ids, relevant):
    if len(ids) != len(set(ids)):
        raise ValueError("Identifiants dupliqués")
    relevant = set(relevant)
    if not relevant:
        return None
    hits = [
        rank
        for rank, identifier in enumerate(ids[:10], 1)
        if identifier in relevant
    ]
    ideal = sum(
        1 / math.log2(rank + 1)
        for rank in range(1, min(10, len(relevant)) + 1)
    )
    return {
        "recall_at_5": len(set(ids[:5]) & relevant) / len(relevant),
        "mrr_at_10": 1 / hits[0] if hits else 0.0,
        "ndcg_at_10": sum(1 / math.log2(rank + 1) for rank in hits) / ideal,
    }


def summarize(rows):
    result = {}
    for route in ("lexical", "dense", "hybrid"):
        scored = [
            ranking_metrics(
                [hit[0] for hit in row["routes"][route]], row["relevant"]
            )
            for row in rows
        ]
        valid = [score for score in scored if score is not None]
        if not valid:
            raise ValueError("Aucune requête évaluable")
        result[route] = {
            key: sum(score[key] for score in valid) / len(valid)
            for key in valid[0]
        }
        result[route]["evaluated_queries"] = len(valid)
        result[route]["no_relevant_queries"] = len(rows) - len(valid)
        result[route]["no_relevant_with_results"] = sum(
            bool(row["routes"][route])
            for row in rows
            if not row["relevant"]
        )
        result[route]["mean_search_ms"] = (
            1000 * sum(row["seconds"][route] for row in rows) / len(rows)
        )
    return result
ranking_metrics recibe los IDs ordenados y los IDs pertinentes. Rechaza los duplicados en la lista de resultados. Si no hay ninguna ficha pertinente, devuelve None, y no una nota artificial.
hits contiene los puestos pertinentes entre los diez primeros. ideal calcula la mejor ganancia posible, colocando hasta diez fichas pertinentes en cabeza. El diccionario de retorno aplica después las tres fórmulas: intersección entre las cinco primeras, inverso del primer puesto pertinente y ganancia normalizada.
summarize repite este cálculo para cada pregunta y para cada una de las rutas lexical, dense e hybrid. Para las medias de pertinencia, solo descarta los retornos None. Una puntuación numérica de 0 sigue teniéndose en cuenta. Esta distinción evita que desaparezcan las búsquedas que han fallado.
Los campos evaluated_queries, no_relevant_queries y no_relevant_with_results permiten saber cuántas preguntas se evaluaron, cuántas no tenían ninguna ficha pertinente y cuántas de estas últimas recibieron resultados a pesar de todo.
En cambio, mean_search_ms usa todas las filas, es decir, las 14 preguntas, incluidas las dos fuera del corpus. No le atribuya el mismo denominador que a las métricas de pertinencia.
Ejecute la evaluación:
docker compose run --rm --no-deps app -m src.cli evaluate
Si una media le sorprende, vuelva a las listas pregunta por pregunta. La media resume los comportamientos; por sí sola no los explica.
Entender el cronómetro antes de comparar las duraciones
Las latencias siguientes son medias en milisegundos sobre las 14 preguntas, después de una pasada de calentamiento excluida de las mediciones. El calentamiento es un primer uso destinado a no mezclar el inicio del cálculo con las búsquedas medidas. La carga del modelo también queda excluida.
La duración densa incluye la codificación de la pregunta y la llamada a Qdrant. Por tanto, no es solo el tiempo pasado en la base vectorial. La duración híbrida suma las etapas léxicas, densas y de fusión, ejecutadas secuencialmente en este recorrido.
Los dos valores de tiempo de cada línea corresponden a las dos reproducciones r3 en la misma máquina. No fijan un objetivo de rapidez que deba alcanzar en su equipo ni describen una aplicación web bajo carga.
Los resultados r3
| Método | Recall@5 | MRR@10 | nDCG@10 | Latencia media (ms), 1 / 2 |
|---|---|---|---|---|
| BM25 | 0,833333 | 0,777778 | 0,791667 | 0,067 / 0,059 |
| E5 + Qdrant | 1,000000 | 0,825000 | 0,867053 | 6,613 / 5,749 |
| RRF | 0,916667 | 0,802778 | 0,847993 | 6,695 / 5,820 |
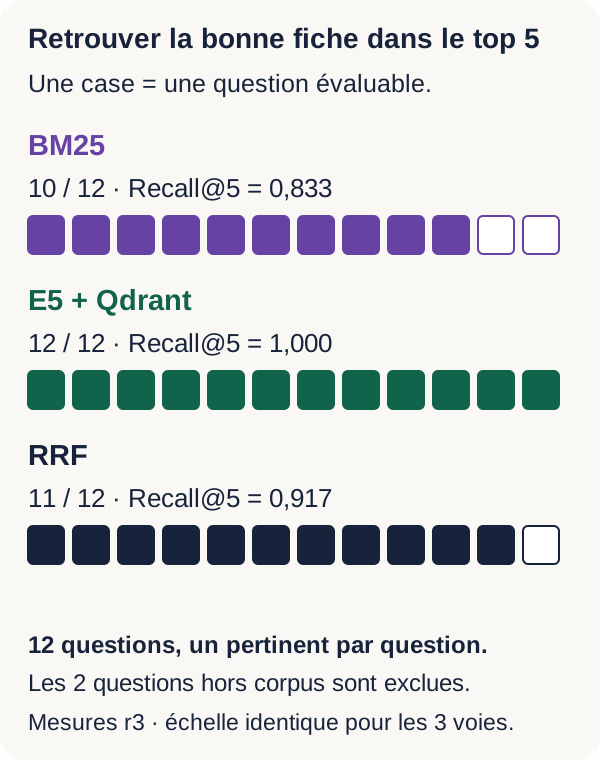
Estas medidas proceden de dos reproducciones r3 en la misma GPU RTX 3090 y la misma máquina. La vía densa es mejor en las tres métricas de pertinencia de este conjunto. RRF mejora BM25, pero sigue por debajo de E5 por sí solo.
El recall se lee de forma muy concreta: BM25 recupera la ficha correcta entre las cinco primeras para 10 preguntas de 12; E5 para 12 de 12; RRF para 11 de 12. El 1,000000 de E5 no quiere decir «la ficha correcta siempre es la primera». Su MRR de 0,825000 recuerda precisamente que no ocupa siempre ese puesto.
¿Cómo puede la fusión tener un Recall@5 inferior al de E5 aunque reciba candidatos de las dos vías? Añadir candidatos no garantiza su puesto entre los cinco primeros. Una ficha presente en la lista densa puede quedar más abajo tras la fusión. El recall a una profundidad dada depende tanto de los candidatos conservados como de su nuevo orden.
Las tres vías devuelven resultados aun así para las dos preguntas fuera del corpus. Por tanto, el tutorial no sabe decidir que ninguna ficha responde. Tener un «mejor resultado disponible» no significa tener una respuesta pertinente.
Combinar varios métodos no garantiza una mejora: hay que evaluar la arquitectura híbrida. Esta conclusión se refiere a este corpus, este modelo y esta configuración. No predice los resultados con otros documentos, otras GPU o preguntas sin anotar.
Lo que hemos aprendido
BM25: aprovechar el vocabulario
BM25 observa los términos comunes entre la pregunta y las fichas. La frecuencia aporta una señal, con saturación; el IDF valora los términos raros; la corrección de longitud evita favorecer mecánicamente los textos largos.
Una referencia exacta puede ser discriminante, pero también hay que comprender la segmentación léxica elegida. BM25 no produce ningún embedding ni mide directamente una proximidad aprendida por una red neuronal.
E5: representar los textos
E5 usa un aprendizaje previo para transformar textos en vectores. Los prefijos query: y passage: indican su función. El tokenizador prepara las entradas, el Transformer produce las representaciones de las posiciones, la media enmascarada reúne esas representaciones y la normalización fija la norma del vector.
Así, formulaciones distintas pueden llegar a estar próximas. Esta proximidad es una señal que hay que comprobar, no una garantía de que los textos respondan a la misma necesidad.
Qdrant: recuperar vecinos
En este tutorial, Qdrant recibe los vectores ya calculados por E5. Los conserva con los identificadores y los metadatos, y recupera después los vecinos del vector de la pregunta. Python coordina estas operaciones.
La base vectorial no decide la pertinencia de negocio ni redacta una respuesta. Su opción de búsqueda exacta concierne a los vecinos, no a la veracidad del contenido recuperado.
RRF: combinar puestos
RRF no lee los documentos ni calcula embeddings. Asigna una contribución a cada puesto observado y suma después las contribuciones de un mismo ID.
Dos motores con puntuaciones incomparables pueden participar así en una misma fusión. A cambio, RRF no conoce ni la diferencia de significado entre dos fichas ni la razón por la que un motor puso una delante de la otra.
Híbrida: una hipótesis que medir
En este pequeño corpus, la fusión mejora BM25, pero sigue siendo peor que E5 solo en las tres métricas. Combinar varios métodos no garantiza una mejora.
Para elegir una arquitectura, compárela con sus documentos, sus consultas, anotaciones explícitas y sus restricciones de latencia. La experiencia nos enseña un método de comparación, no una regla universal sobre el mejor motor.
Ejercicio: cambiar la pregunta y k
Ahora vamos a actuar sobre dos elementos: la formulación de la pregunta y el parámetro k de RRF. El objetivo es separar sus efectos, en lugar de cambiarlo todo a la vez sin saber qué ha influido.
Predecir. Antes de ejecutar la orden, escriba su hipótesis para «He olvidado mi contraseña». ¿Qué ficha debería favorecer BM25? ¿Debería E5 proponer el mismo primer resultado? Cuando k disminuye, ¿qué importancia adquieren las primeras posiciones? ¿Un cambio de k debe cambiar necesariamente el orden final?
Haga también este pequeño cálculo a mano: fusione las listas pedagógicas A=[0,1] y B=[1,2], primero con k=60 y después con k=0. Son listas simplificadas, distintas de las clasificaciones medidas del hilo conductor.
Escriba las contribuciones de cada ID antes de ordenar. El ID 0 solo aparece en A, el ID 2 solo en B y el ID 1 en las dos listas. Un ausente recibe 0 para la lista correspondiente; incluso con k=0, los puestos empiezan en 1, por lo que la fórmula no divide entre cero.
Modificar y ejecutar. La etapa exercise del proyecto r3 sustituye la pregunta hilo conductor por la nueva formulación. Después calcula la fusión habitual y una segunda fusión con k=0. Estos cambios ya están implementados en src/cli.py: no necesita modificar el código para este ejercicio.
docker compose run --rm --no-deps app -m src.cli exercise
Observar. outputs/exercise.json contiene la pregunta, las tres listas en routes y la fusión adicional en hybrid_k0. Anote el puesto del ID 0 y los cinco primeros IDs de las dos fusiones.
Compare primero los resultados de esta nueva pregunta con outputs/compare.json para explorar el efecto de la reformulación. Después compare routes.hybrid y hybrid_k0 en el mismo exercise.json para aislar el efecto de k, con la pregunta idéntica.
Explicar. Confronte sus observaciones con la predicción y justifique al menos una posición mediante las contribuciones de puesto. Si las puntuaciones cambian pero el orden permanece idéntico, también es un resultado válido: un parámetro puede modificar las diferencias sin invertir las posiciones.
La corrección del cálculo manual y los criterios de respuesta figuran en lesson/SOLUTIONS.md. Las observaciones que ese archivo designa explícitamente como r2 son históricas. Para su ejecución r3, use las salidas de su carpeta outputs/.
Experimento personal: reformular una sola ficha
Esta vez vamos a modificar el documento en lugar de la pregunta. Este experimento se propone al lector; sus resultados no forman parte de las mediciones r3 publicadas más arriba.
Conserve una copia de sus salidas de referencia. En su propia extracción del ZIP, reformule solo el texto de la ficha ID 0 en data/corpus.json. Puede, por ejemplo, hacer que aparezca la palabra «acceso» en la descripción del mismo procedimiento.
Conserve el ID, la referencia, el procedimiento y las anotaciones. No cambie ni la pregunta ni k. Queremos estudiar un cambio de formulación, no desplazar el resultado esperado ni transformar varios elementos a la vez.
Antes de modificarlo, prediga por separado el posible efecto en BM25, E5 y RRF. ¿Qué término común podría encontrar ahora BM25? ¿Qué supone sobre la representación producida por E5? ¿Cómo podría afectar a la fusión un cambio de puesto en una vía? Los tres métodos no tienen por qué cambiar de orden.
Atención a la compilación: el corpus se copia en la imagen Docker. Modificar el archivo en su equipo no basta, por tanto, para modificar el utilizado por un contenedor construido previamente.
Detenga este proyecto con la orden de limpieza indicada más abajo, reconstruya la imagen y retome después las órdenes ya presentadas: inicio y preparación de Qdrant, BM25, indexación, densa y comparación. La colección temporal se recreará con sus nuevos documentos.
Compare lexical.json, dense.json y compare.json con sus copias de referencia. Explique las diferencias sin presuponer una mejora. Si después amplía el corpus o cambia las anotaciones, repita la evaluación: las cifras de referencia ya no describen su nueva experiencia.
Del tutorial a una aplicación real
Dispone de un motor pedagógico, no todavía de una aplicación preparada para recibir documentos de negocio. Para un desarrollador web, el siguiente paso consiste, entre otras cosas, en rodear la búsqueda de contratos y servicios explícitos.
Los documentos y su ciclo de vida. Hay que prever la ingestión de sus formatos, su limpieza y su división en pasajes, llamada chunking. Cada pasaje debe conservar un vínculo con su fuente. La incorporación, modificación, eliminación y reindexación deben ser coherentes, con almacenamiento persistente, copias de seguridad y una restauración comprobada. La colección temporal del tutorial no cumple estas funciones.
Los derechos y el comportamiento de búsqueda. La autenticación, las autorizaciones y el aislamiento de usuarios u organizaciones deben aplicarse a los documentos en las dos vías. Recuperar una ficha no da derecho a consultarla. También hay que definir los filtros, la paginación y el comportamiento ante una pregunta fuera del corpus. Nuestras dos preguntas sin respuesta muestran que esta última decisión aún no se ha tratado.
La explotación y la evaluación. Una API, registros útiles, el seguimiento de errores y latencias, la supervisión y las pruebas de carga completan el servicio. En cuanto a pertinencia, se necesitan documentos reales, consultas reales, anotaciones revisadas y análisis de errores. Cada cambio de corpus, modelo o ajuste debe poder compararse con una referencia para detectar regresiones.
docs/PRODUCTION_GAPS.md precisa los límites del proyecto. Estas incorporaciones dependen de la necesidad; no todas son necesarias para comprender el mecanismo estudiado aquí.
En caso de problema
El reflejo adecuado es corregir la etapa que falla, en lugar de sustituir silenciosamente el modelo, eliminar un control o continuar con un índice incompleto.
| Síntoma | Causa probable | Comprobación | Corrección |
|---|---|---|---|
El preflight falla aunque nvidia-smi funciona |
GPU no expuesta a Docker | Leer el diagnóstico de GPU Docker del preflight | Corregir la configuración de NVIDIA Container Toolkit y volver a ejecutar el preflight. |
| El modelo local no está | Adquisición incompleta | Leer el error y comprobar models/e5 |
Volver a ejecutar la orden de adquisición; los archivos ya válidos se comprueban y reutilizan. |
| La adquisición se interrumpe | Red, espacio o control de integridad | Leer el error de fetch y el diagnóstico de disco del preflight |
Corregir la causa y volver a ejecutar la adquisición, sin retirar los controles SHA-256. |
| Qdrant sigue sin estar disponible | Servicio no iniciado | Comprobar que la etapa de inicio de Qdrant ha terminado | Reanudar el inicio del servicio de este proyecto antes de indexar. |
| El texto supera 512 tokens | Documento demasiado largo para el recorrido | Leer el error explícito del codificador | Dividir el documento y reconstruir su experiencia; no lo trunque silenciosamente. |
| La indexación rechaza la colección | Colección ya creada en el proyecto activo | Leer el error Collection existante |
Detener este proyecto con la orden de limpieza, reiniciar Qdrant y volver a indexar. |
| La búsqueda densa falla por la dimensión | Vector distinto de 384D | Comprobar la salida y el contrato de Qdrant | Volver a codificar con E5 R3; no trunque el vector. |
| Las métricas sorprenden | Anotación, puesto o ruta mal interpretados | Leer las listas consulta por consulta antes de la media | Comprobar el corpus y las anotaciones, y volver a ejecutar la evaluación. |
Cuando haya terminado, detenga únicamente los servicios de este proyecto, desde la raíz de esta extracción:
docker compose down
Esta orden elimina los contenedores y la red del proyecto. Los modelos y las salidas montados en el host siguen disponibles, pero la colección temporal de Qdrant desaparece. Para volver a buscar después de un reinicio limpio, tendrá que reindexarla.
La orden no purga sus otros proyectos Docker. Conserve los archivos de salida mientras quiera comparar las clasificaciones o retomar el análisis.
Para ir más lejos
Puede prolongar el recorrido sustituyendo las fichas ficticias por sus documentos y anotando sus preguntas. Otra experiencia consiste en añadir filtros documentales coherentes en las dos vías o comparar otro modelo de embeddings con el mismo conjunto de evaluación.
Una cuarta vía consiste en añadir un reranker después de la recuperación. Nuestro motor ya sabe encontrar candidatos. Un reranker es una etapa adicional que vuelve a examinar los mejores candidatos para reordenarlos con un modelo especializado. No es lo que hace RRF: RRF combina posiciones ya calculadas, sin volver a leer los contenidos.
Evalúe estas ampliaciones por separado y conserve su punto de comparación. El reranking será objeto de otro tutorial; no es necesario para terminar este.
Ahora tiene una cadena cuyas decisiones pueden examinarse: términos, vectores, vecinos y después contribuciones de puesto. La buena pregunta ya no es «¿mi motor usa IA?», sino «¿recupera la ficha esperada, en qué puesto y cómo puedo explicarlo?»