





Immaginate il centro assistenza di un’applicazione web. Avete scritto una scheda intitolata «Reimpostare la password dell’account». Eppure un utente non digita necessariamente queste parole nella barra di ricerca. Piuttosto chiede: «Come posso recuperare l’accesso al mio account?»
L’informazione corretta esiste. Il problema è ritrovarla nonostante il cambio di vocabolario, quindi posizionarla abbastanza in alto perché l’utente la veda. Mostrare una scheda che parla anch’essa dell’account, ma spiega come cambiare indirizzo email, non risolve la richiesta.
Questo è il problema che esploreremo. La nostra domanda guida, «Come posso recuperare l’accesso al mio account?», deve condurre alla scheda ID 0, REF-100, dedicata alla reimpostazione della password. Non riguarda la scheda ID 1, REF-101, dedicata al cambio dell’indirizzo email. Entrambe appartengono alla famiglia Compte, ma rispondono a intenti diversi.
Costruiremo tre classifiche, osserveremo le loro divergenze e ne comprenderemo i calcoli. Con una sorpresa utile: combinare due metodi non è automaticamente meglio che usarne uno solo.
Scaricare il progetto completo del tutorial — archivio pubblico r3, con codice, dati, test e guida per il lettore.
I comandi, gli estratti di codice e i risultati presentati corrispondono al percorso r3. I piccoli esempi indicati come didattici servono a comprendere i calcoli; non costituiscono nuove misurazioni del modello.
Cosa costruirete
Costruirete un piccolo motore di ricerca che restituisce tre liste di schede per la stessa domanda.
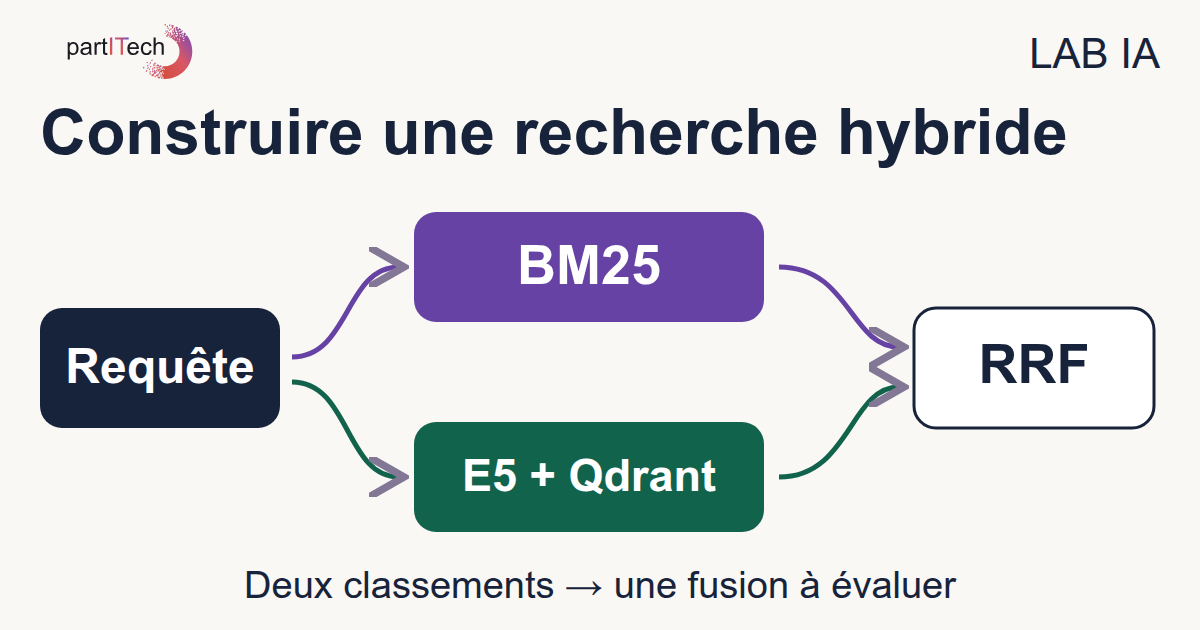
BM25 classifica le schede in base ai termini che condividono con la domanda. E5 e Qdrant le classificano in base a rappresentazioni numeriche dei testi. RRF combina poi le posizioni ottenute nelle due liste.
Per uno sviluppatore web, l’output assomiglia quindi più a una ricerca in un catalogo che a una conversazione: una lista ordinata di identificativi, riferimenti e testi sorgente. Il tutorial produce file JSON che potrete aprire e confrontare. Non fornisce ancora un’interfaccia web di ricerca.
Non è un chatbot. Nessun modello redige una risposta per l’utente. Cerchiamo la scheda giusta; non chiediamo a un’IA di riformulare la procedura o di inventare una risposta quando il catalogo non la contiene.
Cosa imparerete
Il percorso segue tre fasi:
- Preparare un esperimento leggibile: caricare un corpus JSON, mantenere identificativi stabili e definire le schede attese per ogni domanda.
- Costruire le due ricerche: calcolare BM25, produrre embedding E5 su GPU, quindi memorizzarli e interrogarli con Qdrant.
- Confrontare invece di supporre: fondere le posizioni con RRF, misurare pertinenza e latenza, poi spiegare i risultati scheda per scheda.
Un corpus è semplicemente l’insieme dei documenti studiati. Un’annotazione di pertinenza indica quale scheda è considerata una buona risposta a una domanda. Queste due nozioni saranno importanti quanto la scelta del modello.
Prerequisiti
Conoscenze
Sapete usare liste e dizionari Python, scrivere funzioni, leggere JSON e lavorare in un terminale. Conoscete le basi di Docker: immagine, container e volume. Non è richiesta alcuna conoscenza precedente di BM25, embedding o Qdrant.
Non avete bisogno di sapere addestrare un modello. In questo tutorial useremo un modello già addestrato per calcolare rappresentazioni di testi. Indicizzare le schede non significa riaddestrare E5.
Hardware
Il profilo previsto è Linux x86_64, con una GPU NVIDIA compatibile con CUDA che disponga di 5 Gio di memoria video libera, 12 Gio di RAM disponibile e 20 Gio di spazio libero su disco, sia nello spazio del progetto sia in quello di Docker.
La memoria video, o VRAM, appartiene alla GPU; non va confusa con la RAM principale del computer. CUDA è l’ambiente usato qui per eseguire i calcoli del modello sulla GPU NVIDIA.
Questi valori sono margini di comfort controllati dal preflight, non minimi stabiliti cercando la configurazione più piccola possibile. Il percorso r3 è stato riprodotto su una RTX 3090. Lo ZIP non propone un percorso CPU: non considerate quindi un’esecuzione senza GPU una variante convalidata di questo esercizio.
Software
Sono necessari Docker Engine con il plugin Compose, il driver NVIDIA e NVIDIA Container Toolkit. Internet serve soltanto per costruire e recuperare le immagini e per acquisire il modello. Una volta ottenute queste risorse, il calcolo e la ricerca usano servizi locali.
Il percorso di una richiesta
Separiamo due momenti che si confondono facilmente: preparare i documenti e rispondere a una ricerca.
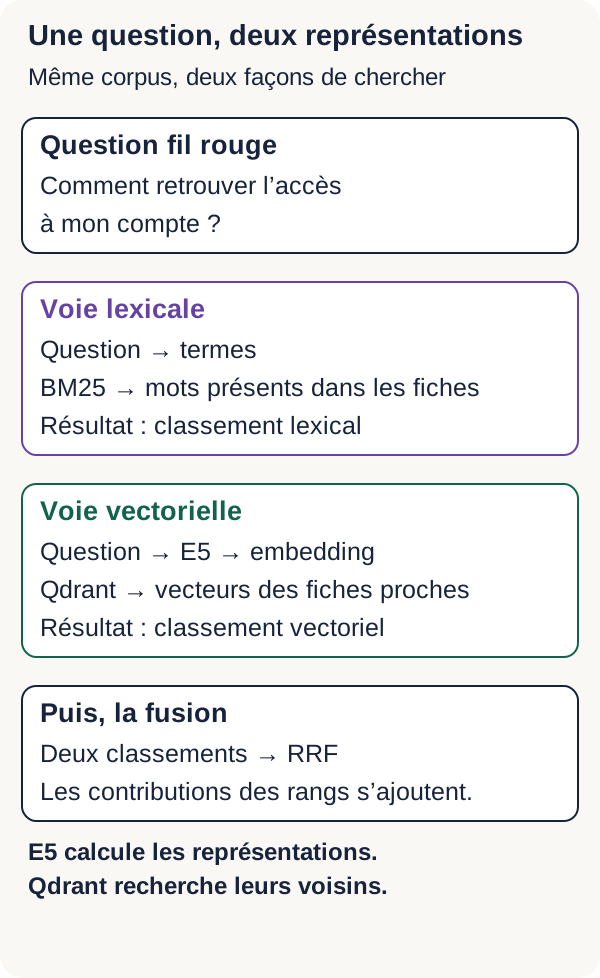
Prima della prima ricerca, BM25 prepara contatori di termini. E5 trasforma ogni scheda in una lista di numeri, detta vettore o embedding, che Qdrant conserva. Quando arriva una domanda, BM25 le assegna punteggi lessicali ed E5 ne calcola il vettore. Qdrant può allora cercare i vettori delle schede più vicini.
Fiches → BM25 : préparation des fréquences
Fiches → E5 passage: → vecteurs → Qdrant : indexation
Question → BM25 → classement lexical
Question → E5 query: → vecteur → Qdrant → classement dense
Classement lexical + classement dense → RRF → classement hybride
RRF interviene alla fine: riceve due classifiche già calcolate e ne costruisce una terza. Non interviene né nella preparazione del modello né nella lettura delle schede da parte di E5.
Attenzione: un punteggio ha senso solo con il suo metodo di calcolo. BM25 somma contributi dei termini. La via densa misura una similarità coseno, che spiegheremo più avanti. RRF somma contributi legati alle posizioni. Confrontare direttamente i loro numeri equivarrebbe a confrontare voti ottenuti con tre scale diverse.
Conserveremo quindi i tre output. La domanda utile non sarà «quale motore produce il numero più grande?», ma «dove si trova la scheda attesa in ciascuna lista?».
Preparare il computer e i container
Verificare che Docker veda la vostra GPU
Scaricate ed estraete lo ZIP, poi aprite il terminale nella sua radice, dove si trova README.md. Tutti i comandi seguenti partono da questa directory. Non eseguiteli da un altro progetto Docker.
Il preflight è un controllo preliminare, simile alla verifica dei prerequisiti prima di avviare un’applicazione. Linux deve prima vedere la scheda con nvidia-smi, poi Docker deve rendere la stessa scheda accessibile al container. Le due condizioni sono distinte: una scheda visibile sull’host può restare inaccessibile da Docker.
Lo script controlla la GPU scelta, la RAM, lo spazio disco del progetto e lo spazio Docker. Inizializza inoltre CUDA in un container diagnostico. Il risultato atteso è PREFLIGHT=PASS.
./scripts/preflight.sh
NVIDIA Container Toolkit consente di esporre al container la GPU e gli elementi necessari del driver dell’host. Non sostituisce quel driver e il preflight non lo installa al posto vostro. Se la diagnostica segnala una GPU visibile sull’host ma non in Docker, correggete la configurazione indicata prima di proseguire. La documentazione ufficiale di NVIDIA Container Toolkit descrive l’installazione.
Avviate quindi la preparazione del progetto:
sh scripts/setup.sh
Scrive LOCAL_UID, LOCAL_GID e GPU_DEVICE in .env, quindi crea le directory di lavoro. Le prime due impostazioni servono a usare l’identità locale per i file; la terza seleziona la scheda da esporre. Verificate questa scelta se la vostra macchina possiede più GPU.
Infine, costruite l’immagine:
docker compose build
Il build deve terminare senza errori. L’immagine r3 parte da Python 3.12.13 slim-bookworm Linux amd64, fissato da digest. Questo digest identifica precisamente l’immagine, invece di un nome che potrebbe indicare più avanti una versione diversa.
Il blocco delle dipendenze installa PyTorch 2.10.0+cu129, Transformers 4.57.6 e Safetensors 0.7.0, con URL e impronte SHA-256. PyTorch esegue i calcoli numerici del modello; Transformers fornisce le classi per caricare modello e tokenizer. I componenti CUDA usati da questo stack provengono dai pacchetti binari PyTorch; il driver resta sull’host.
I riferimenti di distribuzione sono l’immagine Python ufficiale e le wheel PyTorch CUDA 12.9. Per riprodurre l’esperimento, mantenete le versioni dello ZIP invece di sostituirle con le più recenti disponibili.
Mappa mentale di volumi e servizi
Prima di eseguire il codice, individuate dove sono gli input e gli output:
| Elemento | Ruolo nel tutorial |
|---|---|
app |
Python, PyTorch e la GPU: prepara, codifica, cerca e scrive i risultati. |
qdrant |
Indice temporaneo dei vettori e ricerca dei vicini. |
models/ |
Modello locale in models/e5, acquisito una volta e poi letto offline. |
outputs/ |
JSON prodotti a ogni fase, montati sull’host per la lettura. |
Il servizio app svolge il ruolo del programma principale. Qdrant è un servizio distinto, interrogato sulla rete Docker. Le cartelle models/ e outputs/ restano visibili sul vostro computer grazie ai mount dei volumi.
L’estratto seguente proviene dal servizio app. Non è un file Compose autonomo: l’ancora common, riutilizzata da <<: *common, è definita nel file completo. Conservate il compose.yaml dello ZIP per gli altri servizi e i limiti.
  app:
    <<: *common
    environment:
      MODEL_DIR: /models/e5
      QDRANT_URL: http://qdrant:6333
      HF_HUB_OFFLINE: "1"
      TRANSFORMERS_OFFLINE: "1"
    volumes:
      - ./models:/models:ro
      - ./outputs:/app/outputs
    networks: [isolated]
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              device_ids: ["${GPU_DEVICE:-0}"]
              capabilities: [gpu]
MODEL_DIR è il percorso del modello visto dal container. Il mount ./models:/models:ro collega la vostra cartella locale models/ a /models; :ro significa «sola lettura». Il mount di outputs/ permette invece di recuperare i file scritti dal programma.
QDRANT_URL usa il nome del servizio, qdrant, sulla rete Docker. Le variabili HF_HUB_OFFLINE e TRANSFORMERS_OFFLINE chiedono alle librerie interessate di lavorare offline. Infine, device_ids espone soltanto la GPU scelta; la documentazione Docker sulle GPU in Compose spiega questa riservazione.
L’immagine costruita si chiama tutorial-hybride:r3.
In seguito incontrerete spesso docker compose run --rm --no-deps app. Questo comando avvia il programma in un container temporaneo del servizio app, elimina tale container alla fine e non avvia automaticamente le sue dipendenze. Per questo avvieremo Qdrant esplicitamente prima delle fasi che ne hanno bisogno. Gli output montati sull’host non scompaiono con questo container temporaneo.
Per approfondire — Perché i container sono rafforzati
Il compose.yaml completo limita ciò che i container possono modificare o consumare. read_only rende la loro radice in sola lettura, cap_drop: [ALL] rimuove le capacità Linux aggiuntive e no-new-privileges impedisce l’acquisizione di nuovi privilegi. Una rete interna e limiti di memoria, CPU, processi e tmpfs completano queste restrizioni. Un tmpfs è uno spazio temporaneo in memoria.
In questo percorso, app legge i modelli e scrive soltanto gli output. Qdrant conserva la propria raccolta in uno spazio temporaneo. Il servizio fetch fa eccezione per la rete e la scrittura dei modelli: deve raggiungere il loro deposito e riempire models/.
Queste scelte riducono le possibilità d’azione dei servizi. Non costituiscono una garanzia universale di sicurezza e non sono impostazioni da modificare per imparare BM25, E5 o RRF.
Acquisire E5 in modo riproducibile
Il modello usato è intfloat/multilingual-e5-small, alla revisione fissa 614241f622f53c4eeff9890bdc4f31cfecc418b3.
I pesi di un modello sono i parametri numerici acquisiti durante l’addestramento. Li scaricheremo, poi li useremo tali e quali. Fissare la revisione equivale a conservare un commit preciso di una dipendenza: sappiamo quale architettura, quali file e quali pesi sono serviti per l’esperimento. Questo rende le esecuzioni confrontabili, senza promettere che tutti gli hardware produrranno misurazioni strettamente identiche.
I nove file necessari sono descritti in configs/models.lock.json, con dimensione e impronta SHA-256. Un’impronta è un riepilogo calcolato dai byte del file; confrontarla con il valore atteso consente di rilevare un file diverso o incompleto.
scripts/fetch_model.py scarica in un file parziale, verifica dimensione e impronta, poi esegue una rinomina atomica verso il file finale in models/e5. In altre parole, il nome definitivo viene usato solo una volta superato il controllo.
docker compose --profile acquisition run --rm --no-deps fetch
Un file locale già completo viene verificato di nuovo e riutilizzato. Durante l’acquisizione, un file mancante o errato viene riscaricato e deve superare i controlli. Se la verifica fallisce, l’acquisizione si interrompe.
Al termine, i nove file verificati si trovano in models/e5. La loro prima acquisizione rappresenta circa 493 Mo. Internet non è più necessario per codificare i testi e cercare le schede.
Acquisizione e inferenza restano separate. L’inferenza è qui l’uso del modello per calcolare un vettore, non il suo addestramento. Se in quel momento manca un file, l’encoder fallisce: non scarica silenziosamente un altro modello. Il protocollo e i suoi limiti sono descritti in docs/MODEL_ACQUISITION.md. Non cambiate la revisione bloccata per far sparire un errore.
Prima di indicizzare, avviate i test e i checkpoint didattici:
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app scripts/checkpoint.py
Le riproduzioni r3 terminano i 18 test senza errori né test ignorati, poi confermano i 7 checkpoint. Coprono i calcoli, l’acquisizione simulata, l’inferenza E5 su CUDA e le fasi didattiche.
Il punto importante è il vero calcolo E5 su CUDA: mostrare una scheda disponibile in Docker non basterebbe a dimostrare che il modello funziona su di essa. Gestite un errore prima di proseguire; una lista di risultati plausibile non sostituisce un test superato.
Caricare le schede
Il corpus contiene 16 schede fittizie. Disponiamo inoltre di quattro query di sviluppo, le cui schede attese hanno gli ID 0, 1, 14 e 15. Servono a esplorare il funzionamento, in particolare con la nostra domanda guida.
La valutazione usa un altro insieme: 12 domande con ciascuna una scheda pertinente, e due domande fuori corpus, per le quali nessuna scheda è annotata come pertinente.
Qui un’annotazione è binaria: una scheda è pertinente oppure non lo è per la domanda. Sono scelte didattiche, non il risultato di un’indagine sugli utenti. Le annotazioni servono a valutare le classifiche; non sono usate per addestrare E5 in questo tutorial.
Avviate Qdrant, quindi preparate i dati:
docker compose up -d qdrant
docker compose run --rm --no-deps app -m src.cli prepare
Aprite outputs/prepared.json. Deve indicare 16 documenti e mostrare la prima scheda, ID 0, REF-100. A questo punto Qdrant funziona, ma non contiene ancora vettori: preparare i dati e indicizzarli sono due operazioni distinte.
Dati: una scheda, un identificativo, un’annotazione
Ecco la prima scheda così come appare in data/corpus.json:
{
  "id": 0,
  "reference": "REF-100",
  "family": "Compte",
  "text": "REF-100 — Réinitialiser le mot de passe du compte. Cliquez sur Mot de passe oublié puis suivez le lien envoyé par courriel."
}
id identifica la scheda nel codice e nell’indice. reference è il suo riferimento leggibile. family indica il suo tema generale. text contiene il contenuto da cercare.
In data/development.json, «Come posso recuperare l’accesso al mio account?» porta l’annotazione relevant: [0]. Significa: per questa domanda, ci aspettiamo la scheda 0. La scheda ID 1 è annotata separatamente per «Cambiare la mia email».
La distinzione tra family e relevant è essenziale. Due schede della famiglia Compte possono essere molto vicine per vocabolario pur rispondendo a due problemi diversi. Il motore non deve solo trovare il tema giusto: verificheremo se ritrova la procedura giusta.
Questi ID restano stabili nelle classifiche, nell’indice e nelle annotazioni, anche se un’interfaccia mostra solo un titolo o un estratto. Il corpus non contiene dati di clienti.
BM25: frequenza, rarità e lunghezza
Cominciamo con un metodo che si può seguire senza rete neurale.
BM25 è una regola di classificazione lessicale: assegna punti a una scheda in base ai termini che condivide con la domanda. Non si limita a chiedere se un testo contiene una parola: distingue parole più o meno utili e considera le loro ripetizioni.
Tre idee guidano il calcolo: un termine presente apporta un segnale; un termine raro nel corpus è più distintivo; ripetere un termine o scrivere un testo molto lungo non deve far vincere automaticamente tutte le classifiche.
Questa via costituisce una prima ricerca senza modello neurale, utile soprattutto quando un riferimento o un codice d’errore è discriminante. Il suo punteggio non è una probabilità: serve a ordinare le schede di uno stesso corpus per una stessa query.
Prima, decidere che cosa chiamare termine
Il programma normalizza i caratteri Unicode in NFKC, trasforma il testo in minuscolo ed estrae le sequenze riconosciute da \w+. NFKC armonizza alcune rappresentazioni dei caratteri; questa fase non significa «eliminare gli accenti».
Così courriel, diventa courriel e REF-100 diventa due token, ref e 100. Gli accenti restano presenti. Il codice non riporta automaticamente neppure compte e comptes allo stesso termine.
Un token è un’unità prodotta da questa segmentazione. Qui non è né una frase né necessariamente una parola come appare sullo schermo. Questa regola ha un effetto pratico: BM25 non tratta il riferimento REF-100 come un identificativo indivisibile. La convalida di un riferimento esatto sarebbe un’altra operazione.
Contare in una scheda non è contare nel corpus
Per leggere la formula, tenete presenti queste corrispondenze:
f(t,d): quante volte il terminetappare nella schedad;|d|: quanti token contiene la scheda.N: numero totale di schede;df(t): numero di schede contenenti il termine, indipendentemente dalle sue ripetizioni.avgdl: lunghezza media delle schede, misurata con la stessa segmentazione in token.
Per esempio, se una parola appare cinque volte in una sola scheda, la sua frequenza in quella scheda vale 5, ma la scheda contribuisce solo per 1 a df(t).
La rarità è calcolata dall’IDF, per inverse document frequency:
IDF(t) = log(1 + (N - df(t) + 0,5) / (df(t) + 0,5))
log indica qui il logaritmo naturale, calcolato da math.log. Non è necessario memorizzare la formula per comprenderne l’effetto: più un termine è condiviso dalle schede, meno consente di distinguerle.
Prendiamo tre schede fittizie di un piccolo esempio, distinto dal corpus del tutorial. Se rare appare in una sola scheda, df(rare)=1 e IDF≈0,981. Se courant appare in tutte e tre, df(courant)=3 e IDF≈0,134. A parità di condizioni, il primo contribuisce quindi di più.
Perché le ripetizioni non rendono all’infinito
Il contributo completo di un termine è:
IDF(t) × f(t,d) × (k1 + 1) / (f(t,d) + k1 × (1 - b + b × |d| / avgdl))
L’impostazione k1=1,2 controlla la saturazione: ripetere un termine aumenta il contributo, ma sempre meno. b=0,75 controlla la correzione legata alla lunghezza. Con b=0 è ignorata; con b=1 è applicata interamente.
Per rendere concreta la saturazione, prendiamo un calcolo didattico in cui la scheda ha esattamente la lunghezza media. Il fattore che moltiplica l’IDF vale 1 per un’occorrenza, 1,375 per due e circa 1,964 per dieci. Dieci ripetizioni non danno dunque dieci volte più punti.
I termini della domanda vengono invece deduplicati. Ripetere dieci volte la stessa parola nella domanda non ne moltiplica il contributo per dieci.
La documentazione BM25 di Apache Lucene descrive il ruolo di k1, b e della variante IDF usata qui. È un riferimento alle nozioni; il codice Python del tutorial resta l’implementazione da osservare.
Leggere l’implementazione
"""BM25 : fréquence des mots, rareté et correction de longueur."""
import math
import re
import unicodedata
from collections import Counter


def validate_query(query):
    if not isinstance(query, str) or not query.strip() or len(query) > 2048:
        raise ValueError(
            "Requête attendue : texte non vide de 2048 caractères maximum"
        )
    return query


def tokens(text):
    return re.findall(r"\w+", unicodedata.normalize("NFKC", text).lower())


class BM25:
    def __init__(self, documents, k1=1.2, b=0.75):
        self.documents = documents
        self.k1 = k1
        self.b = b
        self.terms = [Counter(tokens(doc["text"])) for doc in documents]
        self.lengths = [sum(terms.values()) for terms in self.terms]
        self.average_length = sum(self.lengths) / max(1, len(documents))
        self.document_frequency = Counter(
            term for terms in self.terms for term in terms
        )

    def search(self, query, limit=10):
        validate_query(query)
        if limit <= 0:
            raise ValueError("limit doit être positif")
        result = []
        for doc, frequencies, length in zip(
            self.documents, self.terms, self.lengths
        ):
            score = 0.0
            for term in set(tokens(query)):
                frequency = frequencies[term]
                if not frequency:
                    continue
                count = self.document_frequency[term]
                rarity = math.log(
                    1 + (len(self.documents) - count + 0.5) / (count + 0.5)
                )
                length_factor = (
                    1 - self.b + self.b * length / self.average_length
                )
                score += (
                    rarity * frequency * (self.k1 + 1)
                    / (frequency + self.k1 * length_factor)
                )
            if score > 0:
                result.append((doc["id"], score))
        return sorted(result, key=lambda row: (-row[1], row[0]))[:limit]
In __init__, Counter conta i termini di ogni scheda. lengths e average_length preparano le lunghezze. document_frequency conta poi in quante schede compare ciascun termine: percorrere le chiavi di un Counter evita di ricontare più volte lo stesso termine in una scheda.
In search, la convalida richiede una stringa non vuota di 2 048 caratteri al massimo e un limite positivo. Il programma visita ogni scheda, poi ogni termine distinto della domanda. Un termine assente non contribuisce. Per gli altri, rarity calcola l’IDF e length_factor la correzione di lunghezza prima di aggiungere il contributo al punteggio.
Infine, le schede con punteggio nullo sono omesse. L’ordinamento usa -row[1] per mettere prima i punteggi maggiori, poi row[0] per risolvere le parità con ID crescente. Il risultato è una lista di coppie (identifiant, score).
Ora potete collegare il codice alle tre idee iniziali: contare, pesare la rarità, correggere ripetizioni e lunghezza. Nessun modello è stato addestrato per svolgere queste operazioni.
Avviate la ricerca lessicale:
docker compose run --rm --no-deps app -m src.cli lexical
Per la domanda guida, i primi cinque ID della classifica BM25 r3 verificata sono [15, 1, 8, 9, 0]. La scheda attesa, ID 0, arriva quindi al posto 5.
BM25 ritrova termini della domanda, ma questa non contiene tutte le parole della procedura di reimpostazione. Conserviamo questa osservazione prima di provare l’altra via. Non si tratta di modificare i parametri fino a forzare la risposta desiderata, ma di comprendere cosa questo primo segnale permette — e non permette — di distinguere.
Dalle parole agli embedding
BM25 risponde a una domanda precisa: «Quali termini si ritrovano in questa scheda?». Ora aggiungeremo un altro modo di confrontare i testi.
Un embedding è una lista di numeri prodotta da un modello a partire da un testo. Potete immaginarlo come le coordinate di un punto. Testi che il modello ha imparato ad avvicinare possono avere punti vicini, anche quando non condividono esattamente le stesse parole.
Il modello scelto qui produce 384 coordinate per testo. È ciò che significa «vettore di dimensione 384», o «384D». Non scegliamo a mano un asse compte, un asse mot_de_passe e un asse facture. Le coordinate derivano dalle rappresentazioni apprese dal modello.
Non bisogna confondere questo vettore con l’ID della scheda. L’ID serve a ritrovare lo stesso documento nel programma. L’embedding serve a confrontarlo con altri testi. Non è neppure un’impronta SHA-256: l’hash controlla byte, mentre l’embedding misura una prossimità in uno spazio appreso.
Chiamiamo questa via ricerca densa perché usa questo tipo di rappresentazione numerica. Fornisce un segnale diverso da quello dei termini comuni. «Recuperare l’accesso» può così avvicinarsi a una scheda che parla di «password dimenticata».
Ma vicino non significa sicuramente pertinente. Due schede sulla gestione di un account possono assomigliarsi senza proporre la stessa procedura. Per questo confronteremo i risultati con le annotazioni, anziché fidarci della sola impressione di comprensione.
E5: dal testo al vettore
E5 è qui l’encoder: trasforma i testi in vettori. Non redige una risposta e non gli insegniamo nuovi parametri con le 16 schede. Usiamo i pesi già acquisiti per eseguire un calcolo d’inferenza.
Vediamo le fasi nell’ordine. I nomi possono sembrare tecnici; ciascuno corrisponde a una trasformazione piuttosto concreta dei dati.
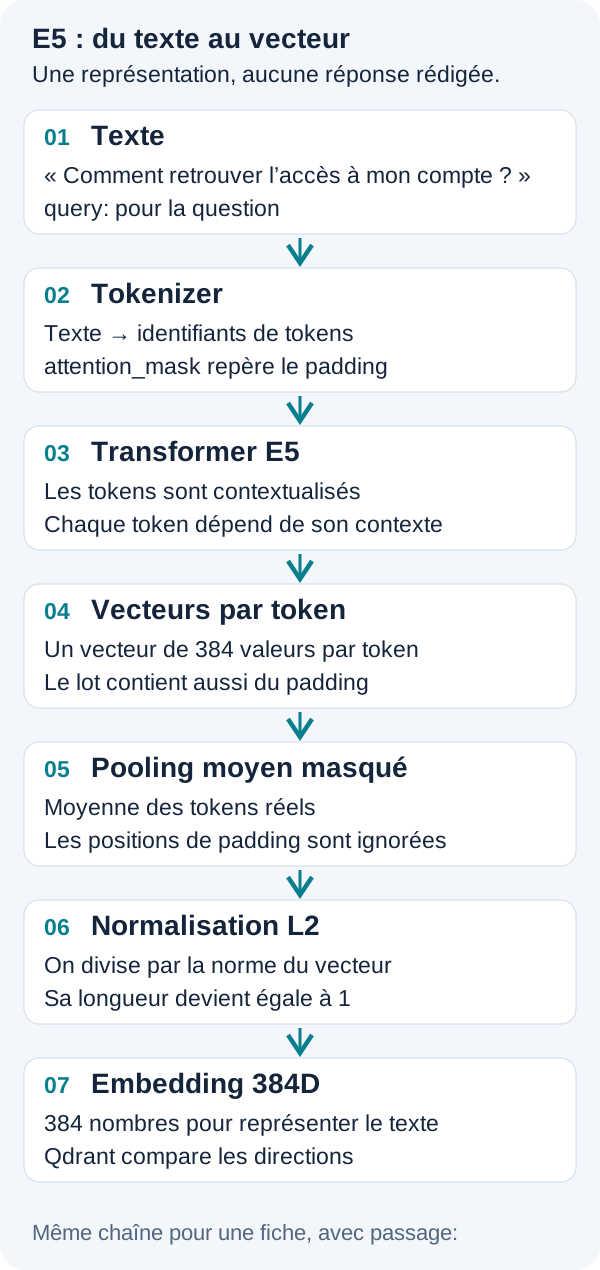
1. Indicare il ruolo del testo
Una domanda inizia con query: . Una scheda inizia con passage: . Questi prefissi restano in inglese, anche quando il contenuto è in francese.
Per la nostra domanda guida, E5 riceve quindi query: Comment retrouver l'accès à mon compte ?. La scheda riceve il prefisso passage: prima della codifica.
Il prefisso non traduce il testo. Ne indica il ruolo: da un lato un bisogno espresso, dall’altro un contenuto da ritrovare. La scheda ufficiale dell’E5 multilingue, alla revisione usata presenta questa convenzione e il suo esempio di codifica.
2. Trasformare i testi in token e preparare un lotto
Il tokenizer divide il testo in unità riconosciute dal modello e le sostituisce con identificativi numerici, gli input_ids. Un token può rappresentare una parola, una parte di parola o un simbolo. Questa segmentazione non è quindi quella di BM25.
Il programma tratta i testi in lotti di 16 al massimo. Per calcolare insieme sequenze di lunghezze diverse, le completa fino a una larghezza comune. Questo è il padding, cioè il riempimento.
Il modello riceve anche un attention_mask. Per esempio, [1, 1, 0] significa che le prime due posizioni sono valide e la terza è riempimento. Questa informazione distingue il testo dalle posizioni aggiunte per il calcolo in lotto.
3. Ottenere una rappresentazione per ogni posizione
Il Transformer, l’architettura del modello, calcola un vettore per ogni posizione del testo considerando il contesto. Il risultato intermedio si chiama last_hidden_state nel codice.
Non abbiamo quindi ancora un vettore per scheda, ma un vettore per posizione. La parola nascosto, in «stato nascosto», indica semplicemente una rappresentazione interna del modello, non un’informazione segreta.
Non è un dizionario che sostituisce una parola con il suo sinonimo. Le relazioni tra formulazioni derivano dall’apprendimento precedente del modello. Questo può avvicinare alcuni testi, ma non garantisce che rispondano allo stesso bisogno.
4. Passare da più vettori a uno solo: la media mascherata
Ora ci serve una rappresentazione dell’intero testo. Il pooling riunisce le rappresentazioni delle posizioni in un unico vettore. Qui calcoliamo una media, coordinata per coordinata, escludendo il padding.
Prendiamo un esempio didattico a due coordinate, molto più piccolo dei vettori reali di E5:
Première position valide : [2, 4]
Deuxième position valide : [4, 4]
Position de remplissage  : ignorée
Masque                   : [1, 1, 0]

Somme des positions valides : [2 + 4, 4 + 4] = [6, 8]
Nombre de positions valides : 2
Moyenne                    : [6 / 2, 8 / 2] = [3, 4]
La maschera serve a due scopi in questa fase: azzerare il contributo delle posizioni di riempimento e contare le posizioni valide per la divisione. Si ottiene così la media del testo, non quella di un testo completato artificialmente.
Con E5, lo stesso principio si applica alle 384 coordinate. Nessuna coordinata presa isolatamente deve essere interpretata come un’etichetta di business quale «parla di fatturazione».
5. Normalizzare il vettore per confrontarne la direzione
La normalizzazione L2 riporta la lunghezza matematica del vettore, detta norma, a 1. Questa lunghezza non è il numero di coordinate: un vettore resta 384D dopo la normalizzazione.
Nel nostro esempio a due coordinate, [3, 4] ha norma 5 perché 3² + 4² = 25. Dividere le coordinate per 5 dà [0.6, 0.8].
Perché farlo? Vogliamo confrontare la direzione dei vettori invece della loro ampiezza. Il prodotto scalare moltiplica le coordinate corrispondenti di due vettori, poi somma tali prodotti. Quando i due vettori hanno norma 1, il risultato è la loro similarità coseno.
Un valore elevato indica una vicinanza nello spazio appreso. Non è una probabilità che la scheda risponda alla domanda. La similarità va confrontata con contenuto e annotazione, soprattutto quando più procedure parlano dello stesso tema.
Leggere il codice, poi ritrovare ogni fase
"""E5 sur un seul GPU CUDA ; les poids sont acquis séparément."""
import os
import torch
from transformers import AutoModel, AutoTokenizer


class Encoder:
    def __init__(self):
        if not torch.cuda.is_available():
            raise RuntimeError(
                "GPU CUDA requis ; vérifier GPU_DEVICE et NVIDIA Container Toolkit"
            )
        torch.manual_seed(42)
        torch.set_num_threads(4)
        directory = os.environ.get("MODEL_DIR", "/models/e5")
        self.tokenizer = AutoTokenizer.from_pretrained(
            directory, local_files_only=True
        )
        self.model = (
            AutoModel.from_pretrained(directory, local_files_only=True)
            .to("cuda")
            .eval()
        )

    def encode(self, texts, kind):
        if kind not in ("query", "passage") or not texts:
            raise ValueError("Préfixe query/passage et liste non vide requis")
        vectors = []
        for offset in range(0, len(texts), 16):
            batch = self.tokenizer(
                [kind + ": " + text for text in texts[offset:offset + 16]],
                padding=True,
                truncation=False,
                return_tensors="pt",
            )
            if batch["input_ids"].shape[1] > 512:
                raise ValueError("Texte dépassant 512 tokens : découpez le document")
            batch = batch.to("cuda")
            with torch.inference_mode():
                hidden = self.model(**batch).last_hidden_state
                mask = batch["attention_mask"].unsqueeze(-1).bool()
                pooled = hidden.masked_fill(~mask, 0).sum(1) / mask.sum(1)
                normalized = torch.nn.functional.normalize(pooled, p=2, dim=1)
            if not torch.isfinite(normalized).all():
                raise ValueError("Embedding non fini")
            vectors.extend(normalized.cpu().tolist())
        return vectors
Il costruttore verifica CUDA, fissa il seed a 42, limita i thread CPU a 4 e carica tokenizer e modello da MODEL_DIR. local_files_only=True vieta un download implicito. Il modello è posto sulla GPU con .to("cuda").
Le chiamate .eval() e torch.inference_mode() hanno due ruoli complementari. La prima regola il comportamento del modello per la valutazione. La seconda disattiva i meccanismi di tracciamento dei gradienti necessari all’apprendimento. La documentazione PyTorch di inference_mode precisa che una non sostituisce l’altra. Qui codifichiamo i testi; non aggiorniamo alcun peso.
In encode, la lista costruita con kind + ": " + text aggiunge il prefisso. Il tokenizer prepara identificativi e maschera, poi batch.to("cuda") invia questi dati alla GPU.
Il passaggio centrale corrisponde esattamente al calcolo spiegato sopra: hidden contiene le rappresentazioni delle posizioni; unsqueeze(-1) aggiunge un asse alla maschera per applicarla alle coordinate; masked_fill annulla il contributo del padding; .sum(1) somma le posizioni; la divisione calcola la media; normalize fissa la norma del vettore.
Infine, torch.isfinite rifiuta valori non validi, come un infinito o NaN, prima dell’invio a Qdrant. normalized.cpu().tolist() riporta i risultati in liste Python ordinarie.
Un limite esplicito, invece di un testo tagliato in silenzio
Il tokenizer usa truncation=False. Se il lotto tokenizzato supera 512 posizioni, il programma rifiuta il testo prima del calcolo del Transformer e chiede di suddividere il documento. Il controllo riguarda la sequenza tokenizzata, inclusi prefisso e token aggiunti dal tokenizer.
Così si evita che una parte della scheda scompaia silenziosamente prima della codifica. Non confuse questo limite con i 2 048 caratteri della convalida lessicale: sono due controlli espressi in unità diverse.
L’output atteso dell’encoder è una lista di vettori finiti di lunghezza 384, mai testo generato. Le schede sono codificate come passaggi prima dell’indicizzazione; la domanda è codificata come query al momento della ricerca. La scheda del modello E5 multilingue completa la presentazione.
Memorizzare e cercare vettori con Qdrant
E5 ha appena calcolato dei numeri. Ora bisogna conservarli e ritrovare quelli simili al vettore di una domanda. In questo tutorial, è il ruolo di Qdrant.
Per rappresentarvi l’archiviazione, immaginate un record con tre elementi: identificativo della scheda, vettore e contenuto JSON. Qdrant chiama questo record un point e l’insieme di questi punti una collection. L’analogia con una tabella aiuta a orientarsi, ma qui la ricerca riguarda la prossimità dei vettori.
Il contenuto associato al vettore è chiamato payload. Conserva ID, riferimento e testo della scheda per visualizzarli dopo la ricerca. Il payload non calcola l’embedding: E5 lo ha già prodotto in Python.
Ciò che l’indicizzazione deve garantire
L’estratto seguente proviene dalla classe VectorStore. Contiene solo i metodi index e search, non la classe completa né i suoi metodi di comunicazione HTTP.
L’indicizzazione impone un vettore di dimensione 384 per scheda. Crea una collection configurata con distance: Cosine, poi vi aggiunge schede e vettori. Se la collection esiste già, rifiuta di continuare: il percorso evita così di confondere una nuova indicizzazione con lo stato lasciato dalla precedente.
    def index(self, documents, vectors):
        if len(documents) != len(vectors) or any(
            len(vector) != 384 for vector in vectors
        ):
            raise ValueError("Un vecteur de dimension 384 par document est requis")
        self.ready()
        path = "/collections/" + self.collection
        exists = self.request(path + "/exists")["result"]["exists"]
        if exists:
            raise ValueError(
                "Collection existante : arrêter le projet avant une nouvelle indexation"
            )
        self.request(
            path,
            {"vectors": {"size": 384, "distance": "Cosine"}},
            "PUT",
        )
        if documents:
            points = [
                {"id": doc["id"], "vector": vector, "payload": doc}
                for doc, vector in zip(documents, vectors)
            ]
            self.request(path + "/points?wait=true", {"points": points}, "PUT")
        return self.request(path)["result"]

    def search(self, vector, limit=10):
        body = {
            "query": vector,
            "limit": limit,
            "with_payload": True,
            "params": {"exact": True},
        }
        result = self.request(
            "/collections/" + self.collection + "/points/query", body
        )["result"]["points"]
        return sorted(
            [(row["id"], row["score"]) for row in result],
            key=lambda row: (-row[1], row[0]),
        )
In index, il primo controllo verifica sia il numero di vettori sia la loro dimensione. self.ready() precede le chiamate al servizio. La richiesta a /exists controlla la presenza di una collection, e la creazione indica dimensione e misura di prossimità attese.
Ogni elemento di points associa poi id, vector e payload. Il parametro wait=true chiede di attendere l’applicazione dell’operazione di scrittura. Dopo l’indicizzazione, la collection deve contenere 16 punti.
Eseguite questa fase:
docker compose run --rm --no-deps app -m src.cli index
Aprite outputs/index.json. Indica numero di punti, dimensione e dispositivo CUDA. La collection deve essere creata una sola volta per avvio del progetto. Per ricostruirla, occorre arrestare il progetto, riavviare Qdrant e indicizzare di nuovo.
«Ricerca esatta» non significa «risposta corretta garantita»
In search, query contiene il vettore della domanda. limit fissa il numero massimo di vicini richiesti. with_payload: True chiede di unire i loro dati; l’estratto riporta poi i risultati a coppie (id, score) per la classifica.
L’impostazione exact: True richiede una ricerca esaustiva dei vicini invece di una ricerca approssimata. La documentazione Qdrant Search spiega questa distinzione.
La parola esatta riguarda quindi il calcolo dei vicini secondo vettori e misura scelti. Non significa che Qdrant verifichi la correttezza della procedura recuperata. Un vicino calcolato esattamente può restare una scheda non pertinente per l’utente.
Avviate ora la via densa:
docker compose run --rm --no-deps app -m src.cli dense
Leggete vicini e coseni in outputs/dense.json. Per il filo conduttore, il top 5 r3 è [0, 1, 8, 2, 14]: la scheda attesa, ID 0, arriva al primo posto, contro il quinto in BM25.
Il suo punteggio coseno misurato è 0,8599599. Non significa «85,99599 % di probabilità che la risposta sia corretta». Il risultato interessante è che la scheda annotata come pertinente è in testa e che potete rileggerne il testo.
Una pausa: come combinare queste due liste?
Ecco le prime cinque schede di ogni via per la stessa domanda. Top 5 significa soltanto «le prime cinque posizioni della classifica».
| Posizione | BM25 | E5 / Qdrant |
|---|---|---|
| 1 | ID 15 · REF-115 Rimuovere un membro del team gli toglie l’accesso al progetto ma conserva i documenti condivisi |
ID 0 · REF-100 Reimpostare la password dell’account |
| 2 | ID 1 · REF-101 Cambiare l’indirizzo email dell’account dal profilo |
ID 1 · REF-101 Cambiare l’indirizzo email dell’account dal profilo |
| 3 | ID 8 · REF-108 Attivare l’autenticazione a due fattori |
ID 8 · REF-108 Attivare l’autenticazione a due fattori |
| 4 | ID 9 · REF-109 Chiudere tutte le sessioni attive da Sicurezza |
ID 2 · REF-102 Scaricare una fattura PDF da Fatturazione e poi Cronologia pagamenti |
| 5 | ID 0 · REF-100 Reimpostare la password dell’account |
ID 14 · REF-114 Invitare un membro in un team |
E5 mette in testa la reimpostazione della password. BM25 mette prima una scheda sulla rimozione di un membro del team, che parla anch’essa di accesso. Le due ricerche usano lo stesso corpus, ma non valorizzano gli stessi segnali.
Si potrebbe essere tentati di sommare i punteggi. Il problema è la loro scala: una somma BM25 e un coseno non sono due voti calcolati con lo stesso metro. Sommarli direttamente introdurrebbe un peso arbitrario tra i metodi.
Le due liste hanno però un’informazione comune facile da leggere: la posizione. Primo, secondo, terzo… Useremo questa posizione per combinarle.
RRF: fondere senza convertire i punteggi
RRF, per Reciprocal Rank Fusion, è una fusione basata sulle posizioni. Immaginate due classifiche proposte da due valutatori: attribuiamo punti alle schede in base alla loro posizione in ciascuna, poi li sommiamo.
RRF non legge né testo né embedding. Non converte un punteggio BM25 in coseno e non impara a riconoscere la procedura attesa. Applica una regola aritmetica.
Un contributo per posizione osservata
Per una scheda alla posizione rang in una lista, il contributo vale:
1 / (k + rang)
Le posizioni iniziano da 1. La costante k attenua gli scarti tra posizioni. Con un k grande, le prime posizioni apportano contributi abbastanza vicini. Con un k piccolo, i primissimi posti pesano di più.
Per una scheda d, si sommano i contributi delle classifiche in cui appare:
RRF(d) = Σ 1 / (k + rang_i(d))
Il simbolo Σ significa semplicemente «fare la somma». Una scheda assente da una lista riceve 0 per quella lista. Non le si inventa una posizione alla fine.
Rifare il calcolo per le nostre due schede account
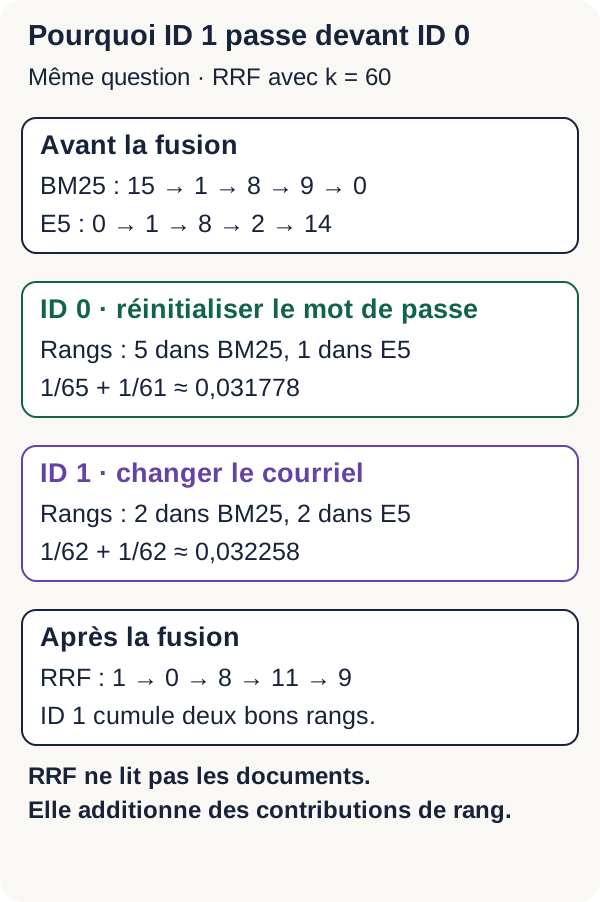
Il percorso usa k=60. Per ID 0, le posizioni sono 5 in BM25 e 1 in densa:
RRF(ID 0) = 1/65 + 1/61 ≈ 0,031778
Per ID 1, le posizioni sono 2 in entrambe le liste:
RRF(ID 1) = 1/62 + 1/62 ≈ 0,032258
ID 1 passa quindi davanti a ID 0. L’accordo di due secondi posti apporta un po’ più di un primo posto associato a un quinto. Il calcolo è corretto, ma non conosce l’annotazione: «cambiare email» resta un intento diverso da «recuperare l’accesso al mio account».
Un punteggio RRF è una somma di contributi, non una probabilità. La documentazione Elasticsearch su RRF illustra anch’essa la formula. È qui un riferimento al meccanismo; non installiamo Elasticsearch e manteniamo l’implementazione Python dello ZIP.
Leggere la fusione nel codice
"""Reciprocal Rank Fusion (RRF), rangs commençant à 1."""
import math


def reciprocal_rank_fusion(rankings, k=60):
    if not isinstance(k, (int, float)) or not math.isfinite(k) or k < 0:
        raise ValueError("k doit être fini et positif ou nul")
    scores = {}
    for ranking in rankings:
        seen = set()
        for rank, (document_id, original_score) in enumerate(ranking, start=1):
            if document_id in seen or not math.isfinite(original_score):
                raise ValueError("Classement avec doublon ou score non fini")
            seen.add(document_id)
            contribution = 1.0 / (k + rank)
            scores[document_id] = scores.get(document_id, 0.0) + contribution
    return sorted(scores.items(), key=lambda row: (-row[1], row[0]))
Il ciclo esterno percorre le classifiche. enumerate(..., start=1) fornisce le posizioni e contribution calcola i punti. Il dizionario scores accumula i contributi di uno stesso ID da una lista all’altra.
Invece, seen impedisce di contare due volte lo stesso ID in una sola lista. I punteggi non finiti sono rifiutati. La funzione controlla anche che k sia finito e positivo o nullo, permettendo più avanti l’esperimento con k=0.
Notate il ruolo limitato di original_score: serve a rifiutare un valore non finito, ma non entra nella formula. Se cambiano solo i numeri dei punteggi, senza cambiare ordine o candidati di ciascuna lista, la fusione resta identica. L’ordinamento finale classifica contributi decrescenti, con ID crescente come spareggio.
Avviate il confronto:
docker compose run --rm --no-deps app -m src.cli compare
Aprite outputs/compare.json prima di concludere. Una fusione può stagnare o peggiorare se i candidati sono cattivi, se una via era già molto buona o se k non corrisponde al compromesso cercato.
| Via | Primi cinque ID | Posizione della scheda attesa ID 0 |
|---|---|---|
| BM25 | 15, 1, 8, 9, 0 | 5 |
| E5 + Qdrant | 0, 1, 8, 2, 14 | 1 |
| RRF | 1, 0, 8, 11, 9 | 2 |
La fusione fa risalire ID 0, «Reimpostare la password», dal rango lessicale 5 al rango ibrido 2. Tuttavia lo fa arretrare rispetto al rango denso 1. ID 1, «Cambiare l’indirizzo email», passa davanti grazie ai suoi due secondi posti.
Un dettaglio merita una pausa: ID 11 compare nei primi cinque di RRF pur non figurando nelle due top 5 mostrate sopra. RRF non crea identificativi. Dal suo codice, un ID può comparire nella fusione solo se era presente in almeno una lista ricevuta. Le cinque righe visualizzate non bastano quindi a ricostruirne tutti gli elementi. Per rifare la classifica completa, esaminate le liste effettivamente trasmesse nel percorso e gli output di confronto, invece di fondere soltanto i cinque elementi della tabella.
La lezione non è «l’ibrido funziona male». È più precisa: questa fusione migliora una via e peggiora l’altra per questa domanda. Dobbiamo ora verificare cosa accade sull’intero insieme di valutazione.
Casi negativi
Prima di misurare la pertinenza, verifichiamo gli errori che il sistema deve gestire. Un caso negativo è un test in cui presentiamo intenzionalmente una situazione vuota o non valida e controlliamo il comportamento atteso.
Una collection vuota deve produrre una lista vuota. Un testo che supera 512 token deve essere rifiutato dopo la tokenizzazione, prima del calcolo delle rappresentazioni da parte del Transformer. Qdrant deve inoltre rifiutare un vettore la cui dimensione non sia 384.
Quest’ultimo controllo assomiglia a un contratto API: abbiamo dichiarato una struttura e un input incompatibile non deve essere accettato silenziosamente. Questi test verificano il corretto comportamento tecnico; non misurano ancora la pertinenza delle schede.
docker compose run --rm --no-deps app -m src.cli negatives
I tre indicatori di outputs/negatives.json devono essere veri prima di proseguire. Un errore atteso e correttamente rifiutato è qui un test riuscito, non un fallimento del tutorial.
Misurare le tre vie
Abbiamo delle liste. Come giudicare se sono utili? Un punteggio di similarità non basta: bisogna confrontare gli identificativi trovati con le schede attese.
Le regole di valutazione sono definite prima di leggere i risultati. Le 12 domande con una scheda pertinente entrano nelle medie di pertinenza. Le due domande fuori corpus sono conteggiate separatamente.
Perché separarle? Per una domanda senza scheda pertinente, il recall avrebbe un denominatore nullo. Assegnarle automaticamente un punteggio di 0 mescolerebbe due problemi: classificare male una risposta esistente e sapersi astenere quando non esiste. Qui manteniamo un contatore dedicato alle domande senza risposta pertinente e ai risultati comunque restituiti.
Recall@5: trovare le pertinenti
Il Recall@5, o recupero nei primi cinque risultati, risponde a questa domanda: «Tra tutte le schede attese, quante ne ho ritrovate nelle prime cinque?»
La formula è:
|top5 ∩ pertinenti| / |pertinenti|
L’intersezione ∩ conserva gli identificativi presenti in entrambi gli insiemi. Le barre |…| ne contano gli elementi.
Nel nostro insieme, ogni domanda valutabile possiede una sola scheda pertinente. Se è al rango 4, il recall vale 1; se è assente dalle prime cinque, vale 0. Un valore alto indica quindi che la scheda utile è generalmente visibile nella top 5.
Attenzione: Recall@5 non distingue i ranghi 1 e 5. Non misura neppure la proporzione di schede corrette tra le cinque mostrate. Una lista con una sola scheda giusta e quattro sbagliate può avere un recall pari a 1 se quella scheda giusta era l’unica attesa.
MRR@10: posizionare la prima risposta
L’MRR@10, per Mean Reciprocal Rank, considera la posizione della prima scheda pertinente nei primi dieci risultati.
Per una domanda, si prende l’inverso di quel rango: 1 al rango 1, 1/4 = 0,25 al rango 4 e 0 se nessuna scheda pertinente compare nelle prime dieci. L’MRR dell’insieme è poi la media di questi valori, calcolata domanda per domanda.
Un valore alto significa che l’utente trova rapidamente una prima scheda utile. Questa metrica non premia le altre schede pertinenti poste dopo la prima, quando ce ne sono più di una.
nDCG@10: ordinare le risposte utili
L’nDCG@10, per normalized Discounted Cumulative Gain, pone una domanda un po’ più generale: «Le mie schede utili sono posizionate nel miglior modo possibile?»
Con la nostra pertinenza binaria, ogni scheda pertinente apporta un guadagno che diminuisce con il rango. Al rango r, questo guadagno vale 1 / log2(r + 1). Si sommano i guadagni nelle prime dieci posizioni, poi si divide per il guadagno della migliore classifica possibile. log2 è il logaritmo in base 2; ricordate soprattutto che fa diminuire il guadagno quando il rango aumenta.
Per una sola scheda pertinente, la classifica ideale la colloca al rango 1 e vale 1. Al rango 2, il suo guadagno è 1 / log2(2 + 1) ≈ 0,63093. Una scheda assente dalla top 10 non apporta nulla.
Un valore alto significa che le schede utili sono concentrate in testa. A differenza di MRR, nDCG può valorizzare più schede pertinenti ben posizionate. In questo corpus ce n’è una sola per ogni domanda valutabile, ma il codice mantiene questa definizione generale.
Applicare le tre regole alla nostra domanda fil rouge
Riprendiamo i ranghi già osservati: 5 per BM25, 1 per E5/Qdrant e 2 per RRF. La tabella seguente è un’applicazione delle formule a questi ranghi, non una nuova esecuzione GPU né la media dell’insieme di valutazione.
| Via, per la sola domanda fil rouge | Rango di ID 0 | Recall@5 | Contributo a MRR@10 | nDCG@10 |
|---|---|---|---|---|
| BM25 | 5 | 1 | 0,2 | 0,386853 |
| E5 + Qdrant | 1 | 1 | 1 | 1 |
| RRF | 2 | 1 | 0,5 | 0,630930 |
Le tre vie hanno lo stesso recall: tutte ritrovano la scheda corretta nelle prime cinque. Eppure non propongono la stessa esperienza di lettura. MRR e nDCG rendono visibile questa differenza.
Verificare cosa contano davvero le funzioni
"""Pertinence binaire ; les requêtes sans pertinent sont traitées séparément."""
import math


def ranking_metrics(ids, relevant):
    if len(ids) != len(set(ids)):
        raise ValueError("Identifiants dupliqués")
    relevant = set(relevant)
    if not relevant:
        return None
    hits = [
        rank
        for rank, identifier in enumerate(ids[:10], 1)
        if identifier in relevant
    ]
    ideal = sum(
        1 / math.log2(rank + 1)
        for rank in range(1, min(10, len(relevant)) + 1)
    )
    return {
        "recall_at_5": len(set(ids[:5]) & relevant) / len(relevant),
        "mrr_at_10": 1 / hits[0] if hits else 0.0,
        "ndcg_at_10": sum(1 / math.log2(rank + 1) for rank in hits) / ideal,
    }


def summarize(rows):
    result = {}
    for route in ("lexical", "dense", "hybrid"):
        scored = [
            ranking_metrics(
                [hit[0] for hit in row["routes"][route]], row["relevant"]
            )
            for row in rows
        ]
        valid = [score for score in scored if score is not None]
        if not valid:
            raise ValueError("Aucune requête évaluable")
        result[route] = {
            key: sum(score[key] for score in valid) / len(valid)
            for key in valid[0]
        }
        result[route]["evaluated_queries"] = len(valid)
        result[route]["no_relevant_queries"] = len(rows) - len(valid)
        result[route]["no_relevant_with_results"] = sum(
            bool(row["routes"][route])
            for row in rows
            if not row["relevant"]
        )
        result[route]["mean_search_ms"] = (
            1000 * sum(row["seconds"][route] for row in rows) / len(rows)
        )
    return result
ranking_metrics riceve gli ID classificati e gli ID pertinenti. Rifiuta i duplicati nella lista dei risultati. Se non c’è alcuna scheda pertinente, restituisce None, non un voto artificiale.
hits contiene i ranghi pertinenti tra i primi dieci. ideal calcola il miglior guadagno possibile, collocando fino a dieci schede pertinenti in testa. Il dizionario restituito applica poi le tre formule: intersezione nelle prime cinque, inverso del primo rango pertinente, quindi guadagno normalizzato.
summarize ripete questo calcolo per ogni domanda e per ciascuna delle vie lexical, dense e hybrid. Per le medie di pertinenza, esclude soltanto i risultati None. Un punteggio numerico pari a 0 viene invece considerato. Questa distinzione evita di far sparire le ricerche fallite.
I campi evaluated_queries, no_relevant_queries e no_relevant_with_results permettono di sapere quante domande sono state valutate, quante non avevano alcuna scheda pertinente e quante di queste ultime hanno comunque ricevuto risultati.
Al contrario, mean_search_ms usa tutte le righe, quindi le 14 domande, comprese le due fuori corpus. Non attribuitegli lo stesso denominatore delle metriche di pertinenza.
Avviate la valutazione:
docker compose run --rm --no-deps app -m src.cli evaluate
Se una media vi sorprende, tornate alle liste domanda per domanda. La media riassume i comportamenti; da sola non li spiega.
Comprendere il cronometro prima di confrontare le durate
Le latenze qui sotto sono medie in millisecondi sulle 14 domande, dopo un passaggio di riscaldamento escluso dalle misure. Il riscaldamento è un primo utilizzo destinato a non confondere l’avvio del calcolo con le ricerche misurate. Anche il caricamento del modello è escluso.
La durata densa include la codifica della domanda e la chiamata a Qdrant. Non è quindi soltanto il tempo trascorso nella base vettoriale. La durata ibrida somma le fasi lessicali, dense e di fusione, eseguite in sequenza in questo percorso.
I due valori temporali di ogni riga corrispondono alle due riproduzioni r3 sulla stessa macchina. Non fissano un obiettivo di rapidità da raggiungere sul vostro computer e non descrivono un’applicazione web sotto carico.
I risultati r3
| Metodo | Recall@5 | MRR@10 | nDCG@10 | Latenza media (ms), 1 / 2 |
|---|---|---|---|---|
| BM25 | 0,833333 | 0,777778 | 0,791667 | 0,067 / 0,059 |
| E5 + Qdrant | 1,000000 | 0,825000 | 0,867053 | 6,613 / 5,749 |
| RRF | 0,916667 | 0,802778 | 0,847993 | 6,695 / 5,820 |
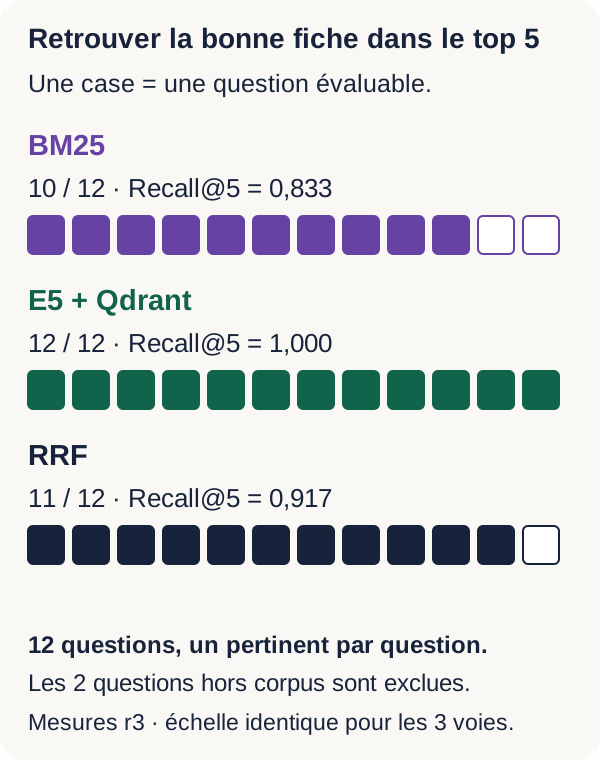
Queste misure provengono da due riproduzioni r3 sulla stessa GPU RTX 3090 e sulla stessa macchina. La via densa è migliore sulle tre metriche di pertinenza di questo insieme. RRF migliora BM25, ma resta sotto E5 da solo.
Il recall si legge in modo molto concreto: BM25 ritrova la scheda corretta nelle prime cinque per 10 domande su 12; E5 per 12 su 12; RRF per 11 su 12. L’1,000000 di E5 non significa «la scheda corretta è sempre prima». Il suo MRR di 0,825000 ricorda proprio che non occupa sistematicamente quel rango.
Come può la fusione avere un Recall@5 inferiore a quello di E5 pur ricevendo candidati dalle due vie? Aggiungere candidati non garantisce la loro posizione nei primi cinque. Una scheda presente nella lista densa può essere spinta più in basso dopo la fusione. Il recall a una profondità data dipende tanto dai candidati conservati quanto dal loro nuovo ordine.
Le tre vie restituiscono comunque risultati per le due domande fuori corpus. Il tutorial non sa dunque decidere che nessuna scheda risponde. Avere un «miglior risultato disponibile» non significa avere una risposta pertinente.
Combinare più metodi non garantisce un miglioramento: bisogna valutare l’architettura ibrida. Questa constatazione riguarda questo corpus, questo modello e questa configurazione. Non predice i risultati su altri documenti, altre GPU o domande non annotate.
Cosa abbiamo imparato
BM25: sfruttare il vocabolario
BM25 osserva i termini comuni alla domanda e alle schede. La frequenza fornisce un segnale, con saturazione; l’IDF valorizza i termini rari; la correzione della lunghezza evita di favorire meccanicamente i testi lunghi.
Un riferimento esatto può essere discriminante, ma bisogna anche comprendere la segmentazione lessicale scelta. BM25 non produce embedding e non misura direttamente una prossimità appresa da una rete neurale.
E5: rappresentare i testi
E5 usa un addestramento precedente per trasformare i testi in vettori. I prefissi query: e passage: ne indicano il ruolo. Il tokenizer prepara gli input, il Transformer produce le rappresentazioni delle posizioni, la media mascherata riunisce queste rappresentazioni e la normalizzazione fissa la norma del vettore.
Formulazioni diverse possono così diventare vicine. Questa prossimità è un segnale da verificare, non una garanzia che i testi rispondano alla stessa esigenza.
Qdrant: ritrovare i vicini
In questo tutorial, Qdrant riceve i vettori già calcolati da E5. Li conserva con gli identificativi e i metadati, poi ritrova i vicini del vettore della domanda. Python coordina queste operazioni.
La base vettoriale non decide la pertinenza di business e non redige una risposta. La sua opzione di ricerca esatta riguarda i vicini, non la verità del contenuto ritrovato.
RRF: combinare i ranghi
RRF non legge i documenti e non calcola embedding. Attribuisce un contributo a ogni rango osservato, poi somma i contributi di uno stesso ID.
Due motori con punteggi non confrontabili possono così partecipare alla stessa fusione. In compenso, RRF non conosce né la distanza di significato tra due schede né il motivo per cui un motore ne ha collocata una davanti a un’altra.
Ibrido: un’ipotesi da misurare
Su questo piccolo corpus, la fusione migliora BM25, ma resta meno buona di E5 da solo sulle tre metriche. Combinare più metodi non garantisce un miglioramento.
Per scegliere un’architettura, confrontatela con i vostri documenti, le vostre query, annotazioni esplicite e vincoli di latenza. L’esperienza ci insegna un metodo di confronto, non una regola universale sul motore migliore.
Esercizio: cambiare la domanda e k
Ora agiremo su due elementi: la formulazione della domanda e il parametro k di RRF. Lo scopo è separarne gli effetti invece di cambiare tutto insieme senza sapere cosa abbia contato.
Prevedere. Prima di lanciare il comando, scrivete la vostra ipotesi per «Ho dimenticato la password». Quale scheda dovrebbe favorire BM25? E5 dovrebbe proporre lo stesso primo risultato? Quando k diminuisce, quale importanza assumono le prime posizioni? Un cambiamento di k deve necessariamente modificare l’ordine finale?
Fate anche questo piccolo calcolo a mano: fondete le liste didattiche A=[0,1] e B=[1,2], prima con k=60, poi con k=0. Sono liste semplificate, distinte dalle classifiche misurate del filo conduttore.
Scrivete i contributi di ogni ID prima di ordinare. L’ID 0 compare soltanto in A, l’ID 2 soltanto in B e l’ID 1 in entrambe le liste. Un assente riceve 0 per la lista interessata; anche con k=0, i ranghi iniziano da 1, quindi la formula non divide per zero.
Modificare poi eseguire. Il passaggio exercise del progetto r3 sostituisce la domanda fil rouge con la nuova formulazione. Calcola poi la fusione abituale e una seconda fusione con k=0. Queste modifiche sono già implementate in src/cli.py: per questo esercizio non dovete modificare il codice.
docker compose run --rm --no-deps app -m src.cli exercise
Osservare. outputs/exercise.json contiene la domanda, le tre liste in routes e la fusione aggiuntiva in hybrid_k0. Annotate il rango di ID 0 e i primi cinque ID delle due fusioni.
Confrontate prima i risultati di questa nuova domanda con outputs/compare.json per esplorare l’effetto della riformulazione. Poi confrontate routes.hybrid e hybrid_k0 nello stesso exercise.json per isolare l’effetto di k, a domanda identica.
Spiegare. Confrontate le osservazioni con la previsione e giustificate almeno una posizione mediante i contributi di rango. Se i punteggi cambiano ma l’ordine resta identico, anche questo è un risultato valido: un parametro può modificare gli scarti senza invertire le posizioni.
La correzione del calcolo manuale e i criteri di risposta si trovano in lesson/SOLUTIONS.md. Le osservazioni che questo file indica esplicitamente come r2 sono storiche. Per la vostra esecuzione r3, usate gli output della cartella outputs/.
Esperienza personale: riformulare una sola scheda
Questa volta modificheremo il documento invece della domanda. Questa esperienza è proposta al lettore; i suoi risultati non fanno parte delle misure r3 pubblicate sopra.
Conservate una copia dei vostri output di riferimento. Nella vostra estrazione dello ZIP, riformulate soltanto il testo della scheda ID 0 in data/corpus.json. Potete, per esempio, far comparire la parola «accesso» nella descrizione della stessa procedura.
Conservate l’ID, il riferimento, la procedura e le annotazioni. Non cambiate né la domanda né k. Vogliamo studiare un cambiamento di formulazione, non spostare il risultato atteso né trasformare più elementi contemporaneamente.
Prima della modifica, prevedete separatamente il possibile effetto su BM25, E5 e RRF. Quale termine comune potrebbe ora trovare BM25? Cosa supponete della rappresentazione prodotta da E5? Come potrebbe un cambiamento di rango in una via influenzare la fusione? I tre metodi non sono obbligati a cambiare ordine.
Attenzione alla build: il corpus viene copiato nell’immagine Docker. Modificare il file sul vostro computer non basta quindi a modificare quello usato da un contenitore costruito in precedenza.
Arrestate questo progetto con il comando di pulizia indicato sotto, ricostruite l’immagine, poi riprendete i comandi già presentati: avvio di Qdrant e preparazione, BM25, indicizzazione, densa e confronto. La collection temporanea verrà ricreata con i vostri nuovi documenti.
Confrontate lexical.json, dense.json e compare.json con le rispettive copie di riferimento. Spiegate le differenze senza presumere un miglioramento. Se poi ampliate il corpus o cambiate le annotazioni, ripetete la valutazione: i dati di riferimento non descrivono più la vostra nuova esperienza.
Dal tutorial a un’applicazione reale
Avete a disposizione un motore didattico, non ancora un’applicazione pronta a ricevere documenti aziendali. Per uno sviluppatore web, il passo successivo consiste in particolare nel circondare la ricerca di contratti e servizi espliciti.
I documenti e il loro ciclo di vita. Occorre prevedere l’ingestione dei vostri formati, la loro pulizia e la suddivisione in passaggi, detta chunking. Ogni passaggio deve conservare un collegamento alla propria fonte. Aggiunta, modifica, eliminazione e reindicizzazione devono restare coerenti, con archiviazione persistente, backup e un ripristino verificato. La collection temporanea del tutorial non svolge queste funzioni.
I diritti e il comportamento di ricerca. Autenticazione, autorizzazioni e isolamento di utenti o organizzazioni devono applicarsi ai documenti in entrambe le vie. Ritrovare una scheda non dà il diritto di consultarla. Occorre inoltre definire filtri, paginazione e comportamento per una domanda fuori corpus. Le nostre due domande senza risposta mostrano che quest’ultima decisione non è ancora affrontata.
L’esercizio e la valutazione. Un’API, log utili, il monitoraggio di errori e latenze, supervisione e test di carico completano il servizio. Sul versante della pertinenza servono documenti reali, query reali, annotazioni rilette e un’analisi degli errori. Ogni cambiamento di corpus, modello o impostazione deve poter essere confrontato con un riferimento per rilevare regressioni.
docs/PRODUCTION_GAPS.md precisa i limiti del progetto. Queste aggiunte dipendono dall’esigenza; non sono tutte necessarie per comprendere il meccanismo studiato qui.
In caso di problema
Il riflesso giusto è correggere il passaggio che fallisce, invece di sostituire silenziosamente il modello, rimuovere un controllo o proseguire con un indice incompleto.
| Sintomo | Causa probabile | Verifica | Correzione |
|---|---|---|---|
Il preflight fallisce anche se nvidia-smi funziona |
GPU non esposta a Docker | Leggere la diagnosi GPU Docker del preflight | Correggere la configurazione di NVIDIA Container Toolkit e rilanciare il preflight. |
| Il modello locale è assente | Acquisizione incompleta | Leggere l’errore e controllare models/e5 |
Rilanciare il comando di acquisizione; i file già validi vengono verificati e riutilizzati. |
| L’acquisizione si interrompe | Rete, spazio o controllo d’integrità | Leggere l’errore di fetch e la diagnosi del disco del preflight |
Correggere la causa e rilanciare l’acquisizione, senza rimuovere i controlli SHA-256. |
| Qdrant resta indisponibile | Servizio non avviato | Verificare che il passaggio di avvio di Qdrant sia terminato | Riprendere l’avvio del servizio di questo progetto prima dell’indicizzazione. |
| Il testo supera 512 token | Documento troppo lungo per il percorso | Leggere l’errore esplicito dell’encoder | Suddividere il documento e ricostruire l’esperienza; non troncare silenziosamente il testo. |
| L’indicizzazione rifiuta la collection | Collection già creata nel progetto attivo | Leggere l’errore Collection existante |
Arrestare questo progetto con il comando di pulizia, riavviare Qdrant e indicizzare di nuovo. |
| La ricerca densa fallisce sulla dimensione | Vettore diverso da 384D | Controllare l’output e il contratto Qdrant | Ricodificare con E5 R3; non troncare il vettore. |
| Le metriche sorprendono | Annotazione, rango o via interpretati male | Leggere le liste per query prima della media | Verificare corpus e annotazioni, poi rieseguire la valutazione. |
Al termine, arrestate soltanto i servizi di questo progetto, dalla radice di questa estrazione:
docker compose down
Questo comando rimuove i contenitori e la rete del progetto. I modelli e gli output montati sull’host restano disponibili, ma la collection temporanea di Qdrant scompare. Per cercare di nuovo dopo un riavvio pulito, dovrete quindi reindicizzarla.
Il comando non elimina gli altri progetti Docker. Conservate i file di output finché desiderate confrontare le classifiche o riprendere l’analisi.
Per andare oltre
Potete prolungare il percorso sostituendo le schede fittizie con i vostri documenti e annotando le vostre domande. Un’altra esperienza consiste nell’aggiungere filtri documentali coerenti nelle due vie o nel confrontare un altro modello di embedding sullo stesso insieme di valutazione.
Una quarta pista consiste nell’aggiungere un reranker dopo il recupero. Il nostro motore sa ora trovare candidati. Un reranker è un passaggio supplementare che riesamina i migliori candidati per riordinarli con un modello specializzato. Non è ciò che fa RRF: RRF combina posizioni già calcolate, senza rileggere i contenuti.
Valutate questi prolungamenti separatamente, conservando il vostro punto di confronto. Il reranking sarà oggetto di un altro tutorial; non è necessario per terminare questo.
Ora avete una catena le cui decisioni possono essere esaminate: termini, vettori, vicini, poi contributi di rango. La domanda giusta non è più «il mio motore usa l’IA?», ma «ritrova la scheda attesa, a quale rango e come posso spiegarlo?»