





Imaginez le centre d’aide d’une application web. Vous avez rédigé une fiche intitulée « Réinitialiser le mot de passe du compte ». Pourtant, un utilisateur ne tape pas forcément ces mots dans la barre de recherche. Il demande plutôt : « Comment retrouver l’accès à mon compte ? »
La bonne information existe. Le problème est de la retrouver malgré le changement de vocabulaire, puis de la placer assez haut pour que l’utilisateur la voie. Afficher une fiche qui parle aussi de compte, mais explique comment changer son adresse de courriel, ne résout pas sa demande.
C’est le problème que nous allons explorer. Notre question fil rouge, « Comment retrouver l'accès à mon compte ? », doit conduire à la fiche ID 0, REF-100, consacrée à la réinitialisation du mot de passe. Elle ne vise pas la fiche ID 1, REF-101, consacrée au changement d’adresse de courriel. Les deux appartiennent à la famille Compte, mais répondent à des intentions différentes.
Nous allons construire trois classements, observer leurs désaccords et comprendre leurs calculs. Avec une surprise utile : combiner deux méthodes n’est pas automatiquement meilleur qu’en utiliser une seule.
Télécharger le projet complet du tutoriel — archive publique r3, avec le code, les données, les tests et le guide lecteur.
Les commandes, les extraits de code et les résultats présentés correspondent au parcours r3. Les petits exemples signalés comme pédagogiques servent à comprendre les calculs ; ils ne constituent pas de nouvelles mesures du modèle.
Ce que vous allez construire
Vous allez construire un petit moteur de recherche qui rend trois listes de fiches pour une même question.
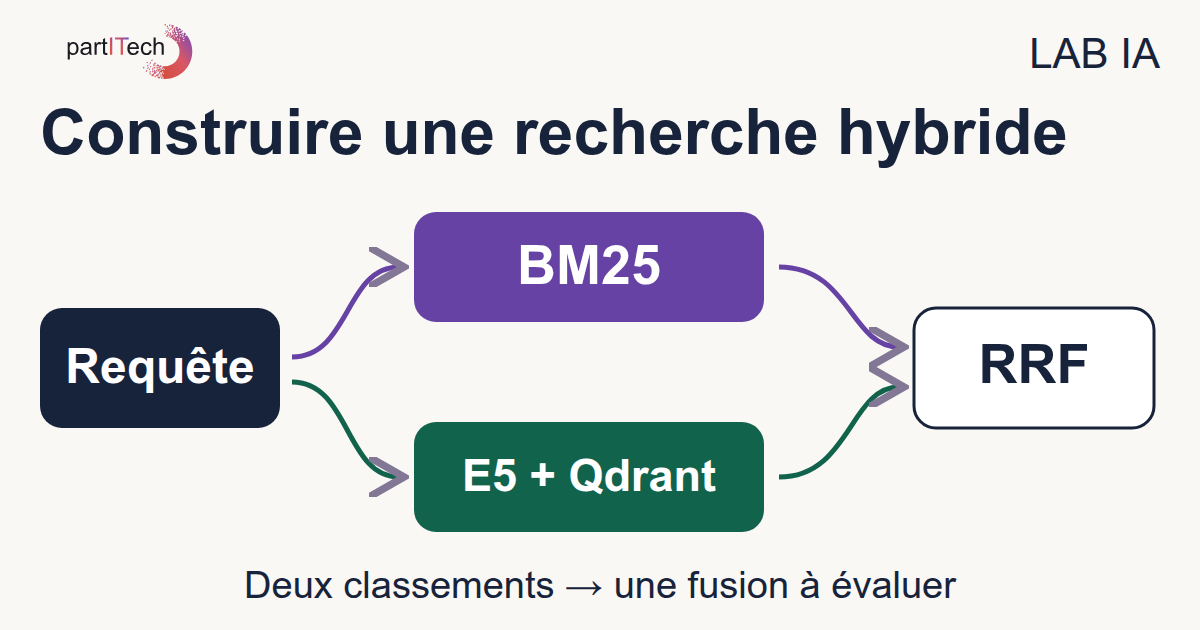
BM25 classe les fiches à partir des termes qu’elles partagent avec la question. E5 et Qdrant les classent à partir de représentations numériques des textes. RRF combine ensuite les positions obtenues dans les deux listes.
Pour un développeur web, la sortie ressemble donc davantage à celle d’une recherche dans un catalogue qu’à une conversation : une liste ordonnée d’identifiants, de références et de textes sources. Le tutoriel produit des fichiers JSON que vous pourrez ouvrir et comparer. Il ne fournit pas encore une interface web de recherche.
Ce n’est pas un chatbot. Aucun modèle ne rédige une réponse à l’utilisateur. Nous cherchons la bonne fiche ; nous ne demandons pas à une IA de reformuler la procédure ou d’inventer une réponse lorsque le catalogue ne la contient pas.
Ce que vous allez apprendre
Le parcours suit trois étapes :
- Préparer une expérience lisible : charger un corpus JSON, conserver des identifiants stables et définir les fiches attendues pour chaque question.
- Construire les deux recherches : calculer BM25, produire des embeddings E5 sur GPU, puis les stocker et les interroger avec Qdrant.
- Comparer plutôt que supposer : fusionner les rangs avec RRF, mesurer la pertinence et la latence, puis expliquer les résultats fiche par fiche.
Un corpus est simplement l’ensemble des documents étudiés. Une annotation de pertinence indique quelle fiche est considérée comme une bonne réponse à une question. Ces deux notions seront aussi importantes que le choix du modèle.
Prérequis
Connaissances
Vous savez utiliser les listes et dictionnaires Python, écrire des fonctions, lire du JSON et travailler dans un terminal. Vous connaissez les bases de Docker : image, conteneur et volume. Aucune connaissance préalable de BM25, des embeddings ou de Qdrant n’est supposée.
Vous n’avez pas besoin de savoir entraîner un modèle. Dans ce tutoriel, nous utiliserons un modèle déjà entraîné pour calculer des représentations de textes. Indexer les fiches ne signifie pas réentraîner E5.
Matériel
Le profil prévu est Linux x86_64, avec un GPU NVIDIA compatible CUDA disposant de 5 Gio de mémoire vidéo libres, 12 Gio de RAM disponibles et 20 Gio de disque libres, aussi bien sur le stockage du projet que sur celui de Docker.
La mémoire vidéo, ou VRAM, appartient au GPU ; elle ne se confond pas avec la RAM principale du poste. CUDA est l’environnement utilisé ici pour effectuer les calculs du modèle sur le GPU NVIDIA.
Ces valeurs sont des marges de confort contrôlées par le préflight, pas des minima établis en cherchant la plus petite configuration possible. Le parcours r3 a été reproduit sur une RTX 3090. Le ZIP ne propose pas de parcours CPU : ne considérez donc pas une exécution sans GPU comme une variante validée de cet exercice.
Logiciels
Docker Engine avec le plugin Compose, le pilote NVIDIA et NVIDIA Container Toolkit sont nécessaires. Internet sert seulement à la construction des images, à leur récupération et à l’acquisition du modèle. Une fois ces ressources obtenues, le calcul et la recherche utilisent les services locaux.
Le chemin d'une requête
Séparons deux moments que l’on confond facilement : préparer les documents et répondre à une recherche.
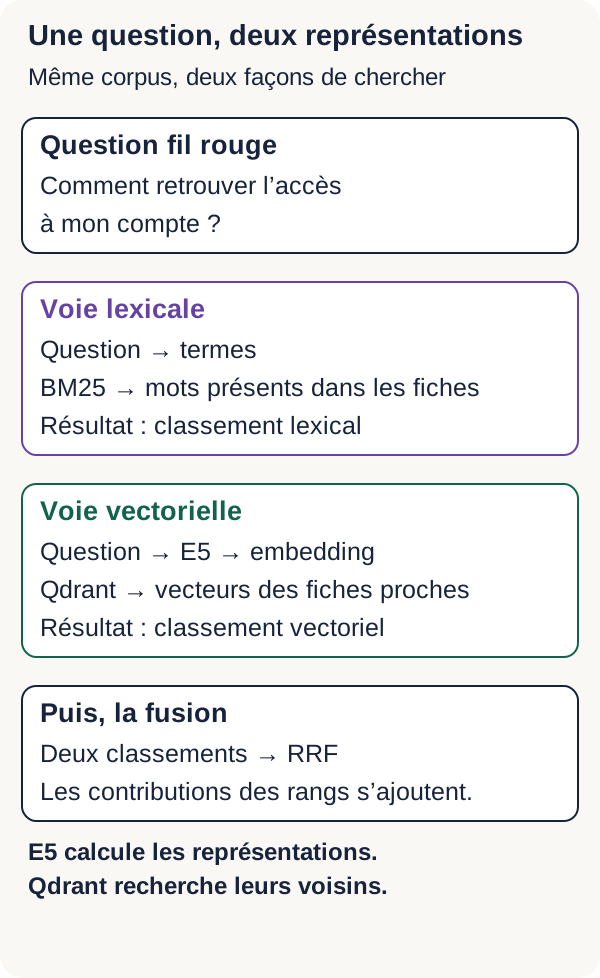
Avant la première recherche, BM25 prépare des compteurs de termes. De son côté, E5 transforme chaque fiche en une liste de nombres, appelée vecteur ou embedding, que Qdrant conserve. Au moment où une question arrive, BM25 lui attribue des scores lexicaux et E5 calcule le vecteur de la question. Qdrant peut alors chercher les vecteurs de fiches les plus proches.
Fiches → BM25 : préparation des fréquences
Fiches → E5 passage: → vecteurs → Qdrant : indexation
Question → BM25 → classement lexical
Question → E5 query: → vecteur → Qdrant → classement dense
Classement lexical + classement dense → RRF → classement hybride
RRF arrive à la fin : il reçoit deux classements déjà calculés et en construit un troisième. Il n’intervient ni dans la préparation du modèle, ni dans la lecture des fiches par E5.
Attention : un score n’a de sens qu’avec sa méthode de calcul. BM25 additionne des contributions de termes. La voie dense mesure une similarité cosinus, que nous expliquerons plus loin. RRF additionne des contributions liées aux rangs. Comparer directement leurs nombres reviendrait à comparer des notes obtenues avec trois barèmes différents.
Nous conserverons donc les trois sorties. La question utile ne sera pas « quel moteur produit le plus gros nombre ? », mais « où se trouve la fiche attendue dans chaque liste ? ».
Préparer le poste et les conteneurs
Vérifier que Docker voit votre GPU
Téléchargez et extrayez le ZIP, puis ouvrez votre terminal à sa racine, là où se trouve README.md. Toutes les commandes suivantes partent de ce répertoire. Ne les lancez pas depuis un autre projet Docker.
Le préflight est un contrôle préalable, comparable à la vérification des prérequis avant de lancer une application. Linux doit d’abord voir la carte avec nvidia-smi, puis Docker doit rendre cette même carte accessible au conteneur. Ces deux conditions sont distinctes : une carte visible sur l’hôte peut rester inaccessible depuis Docker.
Le script contrôle le GPU choisi, la RAM, l’espace disque du projet et le stockage Docker. Il initialise aussi CUDA dans un conteneur de diagnostic. Le résultat attendu est PREFLIGHT=PASS.
./scripts/preflight.sh
NVIDIA Container Toolkit permet d’exposer au conteneur le GPU et les éléments nécessaires du pilote de l’hôte. Il ne remplace pas ce pilote, et le préflight ne l’installe pas à votre place. Si le diagnostic signale un GPU visible sur l’hôte mais pas dans Docker, corrigez la configuration indiquée avant de continuer. La documentation officielle NVIDIA Container Toolkit détaille cette installation.
Lancez ensuite la préparation du projet :
sh scripts/setup.sh
Elle écrit LOCAL_UID, LOCAL_GID et GPU_DEVICE dans .env, puis crée les répertoires de travail. Les deux premiers réglages servent à utiliser l’identité locale pour les fichiers ; le troisième sélectionne la carte à exposer. Vérifiez ce choix si votre machine possède plusieurs GPU.
Construisez enfin l’image :
docker compose build
Le build doit se terminer sans erreur. L’image r3 part de Python 3.12.13 slim-bookworm Linux amd64, fixé par digest. Ce digest identifie précisément l’image, plutôt qu’un nom susceptible de désigner une version différente plus tard.
Le verrou des dépendances installe PyTorch 2.10.0+cu129, Transformers 4.57.6 et Safetensors 0.7.0, avec leurs URL et empreintes SHA-256. PyTorch réalise les calculs numériques du modèle ; Transformers fournit notamment les classes de chargement du modèle et de son tokenizer. Les composants CUDA utilisés par cette pile viennent des paquets binaires PyTorch ; le pilote reste sur l’hôte.
Les références de distribution sont l’image Python officielle et les roues PyTorch CUDA 12.9. Pour reproduire l’expérience, conservez les versions du ZIP au lieu de les remplacer par les dernières disponibles.
Carte mentale des volumes et services
Avant d’exécuter le code, repérez où se trouvent ses entrées et ses sorties :
| Élément | Rôle dans le tutoriel |
|---|---|
app |
Python, PyTorch et le GPU : prépare, encode, cherche et écrit les résultats. |
qdrant |
Index temporaire des vecteurs et recherche de voisins. |
models/ |
Modèle local sous models/e5, acquis une fois puis lu hors ligne. |
outputs/ |
JSON produits à chaque étape, montés sur l'hôte pour lecture. |
Le service app joue le rôle du programme principal. Qdrant est un service distinct, interrogé sur le réseau Docker. Les dossiers models/ et outputs/ restent visibles sur votre poste grâce aux montages de volumes.
L’extrait suivant provient du service app. Ce n’est pas un fichier Compose autonome : l’ancre common, réutilisée par <<: *common, est définie dans le fichier complet. Conservez le compose.yaml du ZIP pour les autres services et les limites.
  app:
    <<: *common
    environment:
      MODEL_DIR: /models/e5
      QDRANT_URL: http://qdrant:6333
      HF_HUB_OFFLINE: "1"
      TRANSFORMERS_OFFLINE: "1"
    volumes:
      - ./models:/models:ro
      - ./outputs:/app/outputs
    networks: [isolated]
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              device_ids: ["${GPU_DEVICE:-0}"]
              capabilities: [gpu]
MODEL_DIR est le chemin du modèle vu depuis le conteneur. Le montage ./models:/models:ro relie votre dossier local models/ à /models ; :ro signifie « lecture seule ». Le montage de outputs/ permet, lui, de récupérer les fichiers écrits par le programme.
QDRANT_URL emploie le nom du service, qdrant, sur le réseau Docker. Les variables HF_HUB_OFFLINE et TRANSFORMERS_OFFLINE demandent aux bibliothèques concernées de travailler hors ligne. Enfin, device_ids expose uniquement le GPU choisi ; la documentation Docker sur les GPU dans Compose explique cette réservation.
L’image construite s’appelle tutorial-hybride:r3.
Vous rencontrerez souvent docker compose run --rm --no-deps app dans la suite. Cette commande lance le programme dans un conteneur ponctuel du service app, supprime ce conteneur à la fin et ne démarre pas automatiquement ses dépendances. C’est pourquoi nous lancerons Qdrant explicitement avant les étapes qui en ont besoin. Les sorties montées sur l’hôte ne disparaissent pas avec ce conteneur ponctuel.
Pour aller plus loin — Pourquoi les conteneurs sont durcis
Le compose.yaml complet limite ce que les conteneurs peuvent modifier ou consommer. read_only place leur racine en lecture seule, cap_drop: [ALL] retire les capacités Linux supplémentaires et no-new-privileges interdit l’acquisition de nouveaux privilèges. Un réseau interne et des limites de mémoire, CPU, processus et tmpfs complètent ces restrictions. Un tmpfs est un espace temporaire en mémoire.
Dans ce parcours, app lit les modèles et écrit seulement les sorties. Qdrant conserve sa collection dans un stockage temporaire. Le service fetch fait exception pour le réseau et l’écriture des modèles : il doit joindre leur dépôt et remplir models/.
Ces choix réduisent les possibilités d’action des services. Ils ne constituent pas une garantie universelle de sécurité et ne sont pas des réglages à modifier pour apprendre BM25, E5 ou RRF.
Acquérir E5 de manière reproductible
Le modèle utilisé est intfloat/multilingual-e5-small, à la révision fixe 614241f622f53c4eeff9890bdc4f31cfecc418b3.
Les poids d’un modèle sont les paramètres numériques acquis pendant son entraînement. Nous allons les télécharger, puis les utiliser tels quels. Fixer la révision revient à conserver un commit précis d’une dépendance : nous savons quelle architecture, quels fichiers et quels poids ont servi à l’expérience. Cela rend les exécutions comparables, sans promettre que tous les matériels produiront des mesures strictement identiques.
Les neuf fichiers nécessaires sont décrits dans configs/models.lock.json, avec leur taille et leur empreinte SHA-256. Une empreinte est un résumé calculé à partir des octets du fichier ; la comparer à la valeur attendue permet de détecter un fichier différent ou incomplet.
scripts/fetch_model.py télécharge dans un fichier partiel, vérifie la taille et l’empreinte, puis effectue un renommage atomique vers le fichier final de models/e5. Autrement dit, le nom définitif n’est utilisé qu’une fois le contrôle réussi.
docker compose --profile acquisition run --rm --no-deps fetch
Un fichier local déjà complet est revérifié et réutilisé. Pendant l’acquisition, un fichier manquant ou incorrect est retéléchargé et doit passer les contrôles. Si la vérification échoue, l’acquisition s’arrête.
À la fin, les neuf fichiers vérifiés se trouvent dans models/e5. Leur première acquisition représente environ 493 Mo. Internet n’est ensuite plus nécessaire pour encoder les textes et rechercher les fiches.
Acquisition et inférence restent séparées. L’inférence est ici l’utilisation du modèle pour calculer un vecteur, pas son entraînement. Si un fichier manque à ce moment-là, l’encodeur échoue : il ne télécharge pas discrètement un autre modèle. Le protocole et ses limites sont décrits dans docs/MODEL_ACQUISITION.md. Ne changez pas la révision verrouillée pour faire disparaître une erreur.
Avant d’indexer, lancez les tests et les points de contrôle pédagogiques :
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app scripts/checkpoint.py
Les reproductions r3 terminent les 18 tests sans échec ni test ignoré, puis confirment les 7 checkpoints. Ils couvrent les calculs, l’acquisition simulée, l’inférence E5 sur CUDA et les étapes pédagogiques.
Le point important est le vrai calcul E5 sur CUDA : afficher une carte disponible dans Docker ne suffirait pas à prouver que le modèle fonctionne dessus. Traitez un échec avant de continuer ; une liste de résultats plausible ne remplace pas un test réussi.
Charger les fiches
Le corpus contient 16 fiches fictives. Nous disposons également de quatre requêtes de développement, dont les fiches attendues ont les IDs 0, 1, 14 et 15. Elles servent à explorer le fonctionnement, notamment avec notre question fil rouge.
L’évaluation utilise un autre ensemble : 12 questions ayant chacune une fiche pertinente, et deux questions hors corpus, pour lesquelles aucune fiche n’est annotée comme pertinente.
Une annotation est ici binaire : une fiche est pertinente ou ne l’est pas pour la question. Ce sont des choix pédagogiques, pas le résultat d’une enquête auprès d’utilisateurs. Les annotations servent à juger les classements ; elles ne sont pas utilisées pour entraîner E5 dans ce tutoriel.
Démarrez Qdrant, puis préparez les données :
docker compose up -d qdrant
docker compose run --rm --no-deps app -m src.cli prepare
Ouvrez outputs/prepared.json. Il doit annoncer 16 documents et afficher la première fiche, ID 0, REF-100. À ce stade, Qdrant fonctionne, mais il ne contient pas encore de vecteur : préparer les données et les indexer sont deux opérations distinctes.
Données : une fiche, un identifiant, une annotation
Voici la première fiche telle qu’elle figure dans data/corpus.json :
{
  "id": 0,
  "reference": "REF-100",
  "family": "Compte",
  "text": "REF-100 — Réinitialiser le mot de passe du compte. Cliquez sur Mot de passe oublié puis suivez le lien envoyé par courriel."
}
id identifie la fiche dans le code et dans l’index. reference est sa référence lisible. family donne son thème général. text contient le contenu à rechercher.
Dans data/development.json, « Comment retrouver l'accès à mon compte ? » porte l’annotation relevant: [0]. Cela signifie : pour cette question, nous attendons la fiche 0. La fiche ID 1 est annotée séparément pour « Changer mon courriel ».
La distinction entre family et relevant est essentielle. Deux fiches de la famille Compte peuvent être très proches par le vocabulaire tout en répondant à deux problèmes différents. Le moteur ne doit pas seulement retrouver le bon thème : nous allons vérifier s’il retrouve la bonne procédure.
Ces IDs restent stables dans les classements, l’index et les annotations, même si une interface affiche seulement un titre ou un extrait. Le corpus ne contient aucune donnée client.
BM25 : fréquence, rareté et longueur
Commençons par une méthode que l’on peut suivre sans réseau neuronal.
BM25 est une règle de classement lexical : elle donne des points à une fiche en fonction des termes qu’elle partage avec la question. Plutôt que de répondre seulement « ce texte contient-il ce mot ? », elle distingue les mots plus ou moins utiles et tient compte de leur répétition.
Trois idées conduisent le calcul : un terme présent apporte un signal ; un terme rare dans le corpus apporte un signal plus distinctif ; répéter un terme ou écrire un texte très long ne doit pas faire gagner mécaniquement tous les classements.
Cette voie constitue une première recherche sans modèle neuronal, notamment intéressante lorsqu’une référence ou un code d’erreur est discriminant. Son score n’est pas une probabilité : il sert à ordonner les fiches d’un même corpus pour une même requête.
D’abord, décider ce que l’on appelle un terme
Le programme normalise les caractères Unicode en NFKC, passe le texte en minuscules et extrait les suites reconnues par \w+. NFKC harmonise certaines représentations de caractères ; cette étape ne signifie pas « supprimer les accents ».
Ainsi, courriel, devient courriel, et REF-100 devient deux tokens, ref et 100. Les accents restent présents. Le code ne ramène pas non plus automatiquement compte et comptes au même terme.
Un token est une unité issue de ce découpage. Ici, ce n’est ni une phrase ni nécessairement un mot tel qu’on le voit à l’écran. Cette règle a un effet pratique : BM25 ne traite pas la référence REF-100 comme un identifiant indivisible. La validation d’une référence exacte serait une autre opération.
Compter dans une fiche n’est pas compter dans le corpus
Pour lire la formule, gardez ces correspondances :
f(t,d): combien de fois le termetapparaît dans la fiched;|d|: combien de tokens contient cette fiche.N: nombre total de fiches ;df(t): nombre de fiches contenant le terme, quel que soit son nombre de répétitions dans chacune.avgdl: longueur moyenne des fiches, mesurée avec le même découpage en tokens.
Par exemple, si un mot apparaît cinq fois dans une seule fiche, sa fréquence dans cette fiche vaut 5, mais cette fiche ne contribue que pour 1 à df(t).
La rareté est calculée par l’IDF, pour inverse document frequency :
IDF(t) = log(1 + (N - df(t) + 0,5) / (df(t) + 0,5))
log désigne ici le logarithme naturel, calculé par math.log. Il n’est pas nécessaire de mémoriser la formule pour comprendre son effet : plus un terme est partagé par les fiches, moins il permet de les départager.
Prenons les trois fiches fictives d’un petit exemple, distinct du corpus du tutoriel. Si rare apparaît dans une seule fiche, df(rare)=1 et IDF≈0,981. Si courant apparaît dans les trois, df(courant)=3 et IDF≈0,134. Le premier apporte donc davantage de poids, toutes choses égales par ailleurs.
Pourquoi les répétitions ne rapportent pas indéfiniment
La contribution complète d’un terme est :
IDF(t) × f(t,d) × (k1 + 1) / (f(t,d) + k1 × (1 - b + b × |d| / avgdl))
Le réglage k1=1,2 contrôle la saturation : répéter un terme augmente sa contribution, mais de moins en moins. Le réglage b=0,75 contrôle la correction liée à la longueur. Avec b=0, cette correction est ignorée ; avec b=1, elle est appliquée entièrement.
Pour rendre la saturation concrète, prenons un calcul pédagogique où la fiche a exactement la longueur moyenne. Le facteur multipliant l’IDF vaut 1 pour une occurrence, 1,375 pour deux occurrences et environ 1,964 pour dix occurrences. Dix répétitions ne donnent donc pas dix fois plus de points.
Les termes de la question sont, eux, dédupliqués. Répéter dix fois le même mot dans la question ne multiplie pas son apport par dix.
La documentation BM25 d’Apache Lucene décrit le rôle de k1, de b et la variante d’IDF utilisée ici. C’est une référence sur les notions ; le code Python du tutoriel reste notre implémentation à observer.
Lire l’implémentation
"""BM25 : fréquence des mots, rareté et correction de longueur."""
import math
import re
import unicodedata
from collections import Counter


def validate_query(query):
    if not isinstance(query, str) or not query.strip() or len(query) > 2048:
        raise ValueError(
            "Requête attendue : texte non vide de 2048 caractères maximum"
        )
    return query


def tokens(text):
    return re.findall(r"\w+", unicodedata.normalize("NFKC", text).lower())


class BM25:
    def __init__(self, documents, k1=1.2, b=0.75):
        self.documents = documents
        self.k1 = k1
        self.b = b
        self.terms = [Counter(tokens(doc["text"])) for doc in documents]
        self.lengths = [sum(terms.values()) for terms in self.terms]
        self.average_length = sum(self.lengths) / max(1, len(documents))
        self.document_frequency = Counter(
            term for terms in self.terms for term in terms
        )

    def search(self, query, limit=10):
        validate_query(query)
        if limit <= 0:
            raise ValueError("limit doit être positif")
        result = []
        for doc, frequencies, length in zip(
            self.documents, self.terms, self.lengths
        ):
            score = 0.0
            for term in set(tokens(query)):
                frequency = frequencies[term]
                if not frequency:
                    continue
                count = self.document_frequency[term]
                rarity = math.log(
                    1 + (len(self.documents) - count + 0.5) / (count + 0.5)
                )
                length_factor = (
                    1 - self.b + self.b * length / self.average_length
                )
                score += (
                    rarity * frequency * (self.k1 + 1)
                    / (frequency + self.k1 * length_factor)
                )
            if score > 0:
                result.append((doc["id"], score))
        return sorted(result, key=lambda row: (-row[1], row[0]))[:limit]
Dans __init__, Counter compte les termes de chaque fiche. lengths et average_length préparent les longueurs. document_frequency compte ensuite dans combien de fiches chaque terme apparaît : parcourir les clés d’un Counter évite de recompter plusieurs fois le même terme dans une fiche.
Dans search, la validation exige une chaîne non vide de 2 048 caractères maximum et une limite positive. Le programme visite chaque fiche, puis chaque terme distinct de la question. Un terme absent ne contribue pas. Pour les autres, rarity calcule l’IDF et length_factor la correction de longueur, avant d’ajouter la contribution au score.
Enfin, les fiches de score nul sont omises. Le tri utilise -row[1] pour placer les scores les plus élevés en premier, puis row[0] pour départager les égalités par ID croissant. Le résultat est une liste de couples (identifiant, score).
Vous pouvez maintenant relier le code aux trois idées de départ : compter, pondérer la rareté, corriger les répétitions et la longueur. Aucun modèle n’a été entraîné pour effectuer ces opérations.
Lancez la recherche lexicale :
docker compose run --rm --no-deps app -m src.cli lexical
Pour la question fil rouge, les cinq premiers IDs du classement BM25 r3 vérifié sont [15, 1, 8, 9, 0]. La fiche attendue, ID 0, arrive donc au rang 5.
BM25 retrouve des termes de la question, mais celle-ci ne contient pas tous les mots de la procédure de réinitialisation. Gardons cette observation avant d’essayer l’autre voie. Il ne s’agit pas de modifier les paramètres jusqu’à forcer la réponse souhaitée, mais de comprendre ce que ce premier signal permet — et ne permet pas — de distinguer.
Des mots aux embeddings
BM25 répond à une question précise : « Quels termes retrouve-t-on dans cette fiche ? » Nous allons maintenant ajouter une autre façon de comparer les textes.
Un embedding est une liste de nombres produite par un modèle à partir d’un texte. Vous pouvez l’imaginer comme les coordonnées d’un point. Des textes que le modèle a appris à rapprocher peuvent avoir des points proches, même lorsqu’ils ne partagent pas exactement les mêmes mots.
Le modèle choisi ici produit 384 coordonnées par texte. C’est ce que signifie « vecteur de dimension 384 », ou « 384D ». Nous ne choisissons pas à la main un axe compte, un axe mot_de_passe et un axe facture. Les coordonnées sont issues des représentations apprises par le modèle.
Il ne faut pas confondre ce vecteur avec l’ID de la fiche. L’ID sert à retrouver le même document dans le programme. L’embedding sert à le comparer à d’autres textes. Il ne s’agit pas non plus d’une empreinte SHA-256 : le hash contrôle des octets, tandis que l’embedding sert à mesurer une proximité dans un espace appris.
On appelle cette voie une recherche dense parce qu’elle utilise ce type de représentation numérique. Elle apporte un signal différent de celui des termes communs. « Retrouver l’accès » peut ainsi se rapprocher d’une fiche parlant de « mot de passe oublié ».
Mais proche ne veut pas dire pertinent à coup sûr. Deux fiches parlant de la gestion d’un compte peuvent se ressembler sans proposer la même procédure. C’est pourquoi nous allons comparer les résultats à nos annotations, plutôt que faire confiance à la seule impression de compréhension.
E5 : de texte à vecteur
E5 est ici l’encodeur : il transforme les textes en vecteurs. Il ne rédige pas de réponse et nous ne lui apprenons pas de nouveaux paramètres avec les 16 fiches. Nous utilisons les poids déjà acquis pour effectuer un calcul d’inférence.
Voyons les étapes dans l’ordre. Les noms peuvent sembler techniques ; chacun correspond à une transformation assez concrète des données.
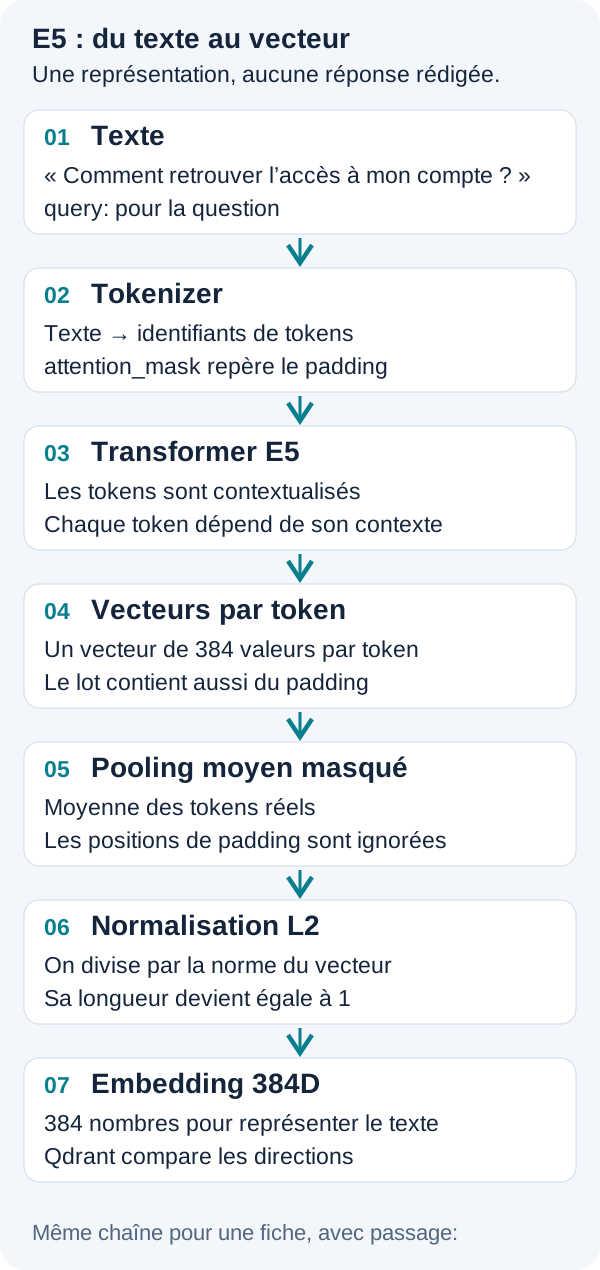
1. Indiquer le rôle du texte
Une question commence par query: . Une fiche commence par passage: . Ces préfixes restent en anglais, même lorsque le contenu est en français.
Pour notre fil rouge, E5 reçoit donc la question sous la forme query: Comment retrouver l'accès à mon compte ?. La fiche est préfixée par passage: avant son encodage.
Le préfixe ne traduit pas le texte. Il indique son rôle : d’un côté, un besoin exprimé ; de l’autre, un contenu à retrouver. La fiche officielle d’E5 multilingue, à la révision utilisée présente cette convention et son exemple d’encodage.
2. Transformer les textes en tokens et préparer un lot
Le tokenizer découpe le texte en unités reconnues par le modèle, puis les remplace par leurs identifiants numériques, les input_ids. Un token peut représenter un mot, un morceau de mot ou un symbole. Ce découpage n’est donc pas celui de BM25.
Le programme traite les textes par lots de 16 au maximum. Pour calculer ensemble sur des séquences de longueurs différentes, il les complète jusqu’à une largeur commune. C’est le padding, autrement dit le remplissage.
Le modèle reçoit aussi un attention_mask. Par exemple, [1, 1, 0] signifie que les deux premières positions sont valides et que la troisième est du remplissage. Cette information permet de distinguer le texte des positions ajoutées pour le calcul en lot.
3. Obtenir une représentation pour chaque position
Le Transformer, l’architecture du modèle, calcule un vecteur pour chaque position du texte en tenant compte de son contexte. Le résultat intermédiaire s’appelle last_hidden_state dans le code.
Nous n’avons donc pas encore un vecteur par fiche, mais un vecteur par position. Le mot caché, dans « état caché », désigne simplement une représentation interne du modèle, et non une information secrète.
Ce n’est pas un dictionnaire qui remplace un mot par son synonyme. Les relations entre formulations viennent de l’apprentissage antérieur du modèle. Cela permet de rapprocher certains textes, mais ne garantit toujours pas qu’ils répondent au même besoin.
4. Passer de plusieurs vecteurs à un seul : la moyenne masquée
Il nous faut maintenant une représentation de tout le texte. Le pooling est l’opération qui rassemble les représentations des positions en un seul vecteur. Ici, nous calculons une moyenne, coordonnée par coordonnée, en excluant le padding.
Prenons un exemple pédagogique à deux coordonnées, bien plus petit que les vecteurs réels d’E5 :
Première position valide : [2, 4]
Deuxième position valide : [4, 4]
Position de remplissage  : ignorée
Masque                   : [1, 1, 0]

Somme des positions valides : [2 + 4, 4 + 4] = [6, 8]
Nombre de positions valides : 2
Moyenne                    : [6 / 2, 8 / 2] = [3, 4]
Le masque sert à deux choses dans cette étape : mettre à zéro la contribution des positions de remplissage et compter les positions valides pour la division. On obtient ainsi la moyenne du texte, pas celle d’un texte artificiellement complété.
Avec E5, le même principe s’applique aux 384 coordonnées. Aucune coordonnée, prise seule, ne doit être interprétée comme une étiquette métier telle que « parle de facturation ».
5. Normaliser le vecteur pour comparer sa direction
La normalisation L2 ramène la longueur mathématique du vecteur, appelée sa norme, à 1. Cette longueur n’est pas le nombre de coordonnées : un vecteur reste 384D après normalisation.
Dans notre exemple à deux coordonnées, [3, 4] a une norme de 5, car 3² + 4² = 25. Diviser les coordonnées par 5 donne [0.6, 0.8].
Pourquoi le faire ? Nous voulons comparer la direction des vecteurs plutôt que leur amplitude. Le produit scalaire consiste à multiplier les coordonnées correspondantes de deux vecteurs, puis à additionner ces produits. Lorsque les deux vecteurs ont une norme de 1, ce résultat est leur similarité cosinus.
Une valeur élevée indique une proximité dans l’espace appris. Ce n’est pas une probabilité que la fiche réponde à la question. La similarité doit être confrontée au contenu et à l’annotation, notamment lorsque plusieurs procédures parlent du même thème.
Lire le code, puis retrouver chaque étape
"""E5 sur un seul GPU CUDA ; les poids sont acquis séparément."""
import os
import torch
from transformers import AutoModel, AutoTokenizer


class Encoder:
    def __init__(self):
        if not torch.cuda.is_available():
            raise RuntimeError(
                "GPU CUDA requis ; vérifier GPU_DEVICE et NVIDIA Container Toolkit"
            )
        torch.manual_seed(42)
        torch.set_num_threads(4)
        directory = os.environ.get("MODEL_DIR", "/models/e5")
        self.tokenizer = AutoTokenizer.from_pretrained(
            directory, local_files_only=True
        )
        self.model = (
            AutoModel.from_pretrained(directory, local_files_only=True)
            .to("cuda")
            .eval()
        )

    def encode(self, texts, kind):
        if kind not in ("query", "passage") or not texts:
            raise ValueError("Préfixe query/passage et liste non vide requis")
        vectors = []
        for offset in range(0, len(texts), 16):
            batch = self.tokenizer(
                [kind + ": " + text for text in texts[offset:offset + 16]],
                padding=True,
                truncation=False,
                return_tensors="pt",
            )
            if batch["input_ids"].shape[1] > 512:
                raise ValueError("Texte dépassant 512 tokens : découpez le document")
            batch = batch.to("cuda")
            with torch.inference_mode():
                hidden = self.model(**batch).last_hidden_state
                mask = batch["attention_mask"].unsqueeze(-1).bool()
                pooled = hidden.masked_fill(~mask, 0).sum(1) / mask.sum(1)
                normalized = torch.nn.functional.normalize(pooled, p=2, dim=1)
            if not torch.isfinite(normalized).all():
                raise ValueError("Embedding non fini")
            vectors.extend(normalized.cpu().tolist())
        return vectors
Le constructeur vérifie CUDA, fixe la graine à 42, limite les threads CPU à 4 et charge le tokenizer et le modèle depuis MODEL_DIR. local_files_only=True interdit un téléchargement implicite. Le modèle est placé sur le GPU avec .to("cuda").
Les appels .eval() et torch.inference_mode() ont deux rôles complémentaires. Le premier règle le comportement du modèle pour l’évaluation. Le second désactive les mécanismes de suivi des gradients nécessaires à l’apprentissage. La documentation PyTorch d’inference_mode précise que l’un ne remplace pas l’autre. Ici, nous encodons les textes ; nous ne mettons aucun poids à jour.
Dans encode, la liste construite avec kind + ": " + text ajoute le préfixe. Le tokenizer prépare les identifiants et le masque, puis batch.to("cuda") envoie ces données au GPU.
Le passage central correspond exactement au calcul expliqué plus haut : hidden contient les représentations des positions ; unsqueeze(-1) ajoute un axe au masque pour l’appliquer aux coordonnées ; masked_fill annule la contribution du padding ; .sum(1) additionne les positions ; la division calcule la moyenne ; normalize fixe la norme du vecteur.
Enfin, torch.isfinite refuse les valeurs invalides, comme un infini ou NaN, avant l’envoi à Qdrant. normalized.cpu().tolist() rapatrie les résultats dans des listes Python ordinaires.
Une limite explicite, plutôt qu’un texte coupé en silence
Le tokenizer utilise truncation=False. Si le lot tokenisé dépasse 512 positions, le programme refuse le texte avant le calcul du Transformer et demande de découper le document. La vérification porte sur la séquence tokenisée, qui inclut le préfixe et les tokens ajoutés par le tokenizer.
Cela évite qu’une partie de la fiche disparaisse silencieusement avant l’encodage. Ne confondez pas cette limite avec les 2 048 caractères de la validation lexicale : ce sont deux contrôles, exprimés dans deux unités différentes.
La sortie attendue de l’encodeur est une liste de vecteurs finis de longueur 384, jamais un texte généré. Les fiches sont encodées comme passages avant l’indexation ; la question est encodée comme requête au moment de la recherche. La fiche du modèle E5 multilingue complète cette présentation.
Stocker et rechercher les vecteurs avec Qdrant
E5 vient de calculer des nombres. Il faut maintenant les conserver et retrouver ceux qui ressemblent au vecteur d’une question. Dans ce tutoriel, c’est le rôle de Qdrant.
Pour vous représenter le stockage, imaginez un enregistrement avec trois éléments : l’identifiant de la fiche, son vecteur et son contenu JSON. Qdrant appelle cet enregistrement un point et l’ensemble de ces points une collection. L’analogie avec une table peut aider à se repérer, mais la recherche porte ici sur la proximité des vecteurs.
Le contenu associé au vecteur est appelé payload. Il conserve notamment l’ID, la référence et le texte de la fiche pour pouvoir les afficher après la recherche. Le payload ne calcule pas l’embedding : E5 l’a déjà produit dans Python.
Ce que l’indexation doit garantir
L’extrait suivant provient de la classe VectorStore. Il contient seulement les méthodes index et search, pas la classe complète ni ses méthodes de communication HTTP.
L’indexation impose un vecteur de dimension 384 par fiche. Elle crée une collection configurée avec distance: Cosine, puis y ajoute les fiches et leurs vecteurs. Si la collection existe déjà, elle refuse de continuer : le parcours évite ainsi de confondre une nouvelle indexation avec l’état laissé par une précédente.
    def index(self, documents, vectors):
        if len(documents) != len(vectors) or any(
            len(vector) != 384 for vector in vectors
        ):
            raise ValueError("Un vecteur de dimension 384 par document est requis")
        self.ready()
        path = "/collections/" + self.collection
        exists = self.request(path + "/exists")["result"]["exists"]
        if exists:
            raise ValueError(
                "Collection existante : arrêter le projet avant une nouvelle indexation"
            )
        self.request(
            path,
            {"vectors": {"size": 384, "distance": "Cosine"}},
            "PUT",
        )
        if documents:
            points = [
                {"id": doc["id"], "vector": vector, "payload": doc}
                for doc, vector in zip(documents, vectors)
            ]
            self.request(path + "/points?wait=true", {"points": points}, "PUT")
        return self.request(path)["result"]

    def search(self, vector, limit=10):
        body = {
            "query": vector,
            "limit": limit,
            "with_payload": True,
            "params": {"exact": True},
        }
        result = self.request(
            "/collections/" + self.collection + "/points/query", body
        )["result"]["points"]
        return sorted(
            [(row["id"], row["score"]) for row in result],
            key=lambda row: (-row[1], row[0]),
        )
Dans index, le premier contrôle vérifie à la fois le nombre de vecteurs et leur dimension. self.ready() précède les appels au service. La requête sur /exists contrôle la présence d’une collection, et la création indique la dimension et la mesure de proximité attendues.
Chaque élément de points associe ensuite id, vector et payload. Le paramètre wait=true demande d’attendre l’application de l’opération d’écriture. Après l’indexation, la collection doit contenir 16 points.
Lancez cette étape :
docker compose run --rm --no-deps app -m src.cli index
Ouvrez outputs/index.json. Il indique le nombre de points, la dimension et le périphérique CUDA. La collection ne doit être créée qu’une fois par démarrage du projet. Pour la reconstruire, il faut arrêter le projet, redémarrer Qdrant et refaire l’indexation.
« Recherche exacte » ne signifie pas « bonne réponse garantie »
Dans search, query contient le vecteur de la question. limit fixe le nombre maximal de voisins demandés. with_payload: True demande de joindre leurs données ; cet extrait ramène ensuite les résultats à des couples (id, score) pour le classement.
Le réglage exact: True demande une recherche exhaustive des voisins, plutôt qu’une recherche approximative. La documentation Qdrant Search explique cette distinction.
Le mot exacte concerne donc le calcul des voisins selon les vecteurs et la mesure choisis. Il ne signifie pas que Qdrant vérifie la justesse de la procédure retrouvée. Un voisin calculé exactement peut rester une fiche non pertinente pour notre utilisateur.
Lancez maintenant la voie dense :
docker compose run --rm --no-deps app -m src.cli dense
Lisez les voisins et leurs cosinus dans outputs/dense.json. Pour le fil rouge, le top 5 r3 est [0, 1, 8, 2, 14] : la fiche attendue, ID 0, arrive au premier rang, contre le cinquième en BM25.
Son score cosinus mesuré est 0,8599599. Cela ne signifie pas « 85,99599 % de chances que la réponse soit correcte ». Le résultat intéressant est que la fiche annotée comme pertinente se trouve en tête, et que vous pouvez en relire le texte.
Une pause : comment combiner ces deux listes ?
Voici les cinq premières fiches de chaque voie pour la même question. Top 5 signifie seulement « les cinq premières positions du classement ».
| Rang | BM25 | E5 / Qdrant |
|---|---|---|
| 1 | ID 15 · REF-115 Retirer un membre de l’équipe supprime son accès au projet mais conserve ses documents partagés |
ID 0 · REF-100 Réinitialiser le mot de passe du compte |
| 2 | ID 1 · REF-101 Changer l’adresse de courriel du compte depuis le profil |
ID 1 · REF-101 Changer l’adresse de courriel du compte depuis le profil |
| 3 | ID 8 · REF-108 Activer l’authentification à deux facteurs |
ID 8 · REF-108 Activer l’authentification à deux facteurs |
| 4 | ID 9 · REF-109 Fermer toutes les sessions actives depuis Sécurité |
ID 2 · REF-102 Télécharger une facture PDF depuis Facturation puis Historique des paiements |
| 5 | ID 0 · REF-100 Réinitialiser le mot de passe du compte |
ID 14 · REF-114 Inviter un membre dans une équipe |
E5 place la réinitialisation du mot de passe en tête. BM25 place d’abord une fiche sur le retrait d’un membre d’équipe, qui parle elle aussi d’accès. Les deux recherches utilisent le même corpus, mais ne valorisent pas les mêmes signaux.
On pourrait être tenté d’additionner leurs scores. Le problème est leur échelle : une somme BM25 et un cosinus ne sont pas deux notes calculées sur le même barème. Les additionner directement introduirait un poids arbitraire entre les méthodes.
En revanche, les deux listes ont une information commune facile à lire : le rang. Premier, deuxième, troisième… Nous allons utiliser cette position pour les combiner.
RRF : fusionner sans convertir les scores
RRF, pour Reciprocal Rank Fusion, est une fusion fondée sur les rangs. Imaginez deux classements proposés par deux évaluateurs : nous accordons des points aux fiches selon leur position dans chacun, puis nous additionnons ces points.
RRF ne lit ni le texte ni les embeddings. Il ne convertit pas un score BM25 en cosinus et n’apprend pas à reconnaître la procédure attendue. Il applique une règle arithmétique.
Une contribution par rang observé
Pour une fiche au rang rang dans une liste, la contribution vaut :
1 / (k + rang)
Les rangs commencent à 1. La constante k adoucit les écarts entre positions. Avec un grand k, les premiers rangs apportent des contributions assez proches. Avec un petit k, les toutes premières places pèsent davantage.
Pour une fiche d, on additionne les contributions des classements dans lesquels elle apparaît :
RRF(d) = Σ 1 / (k + rang_i(d))
Le symbole Σ veut simplement dire « faire la somme ». Une fiche absente d’une liste reçoit 0 pour cette liste. On ne lui invente pas un rang à la fin.
Refaire le calcul pour nos deux fiches de compte
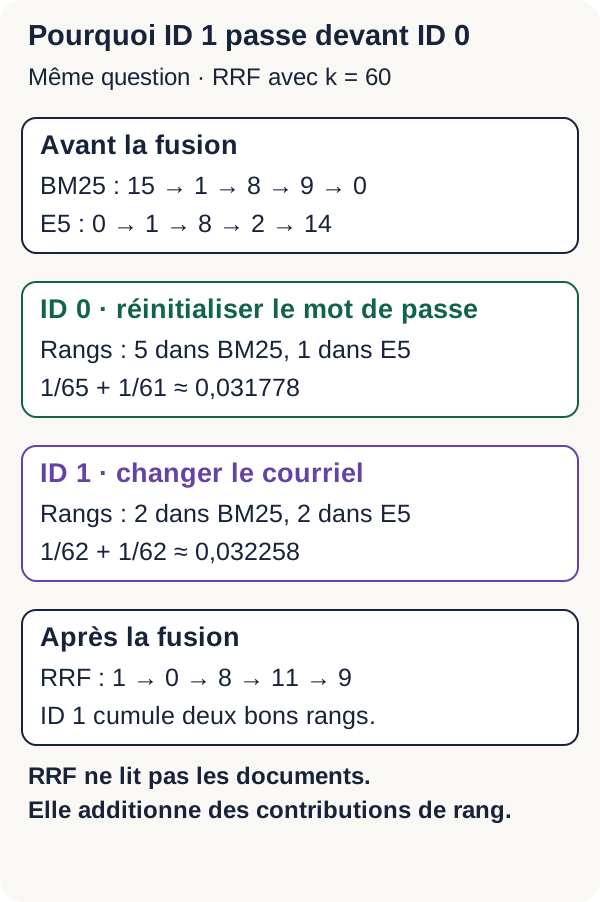
Le parcours utilise k=60. Pour ID 0, les positions sont 5 en BM25 et 1 en dense :
RRF(ID 0) = 1/65 + 1/61 ≈ 0,031778
Pour ID 1, les positions sont 2 dans les deux listes :
RRF(ID 1) = 1/62 + 1/62 ≈ 0,032258
ID 1 passe donc devant ID 0. L’accord des deux deuxièmes places rapporte un peu plus qu’une première place associée à une cinquième place. Le calcul est correct, mais il ne connaît pas notre annotation : « changer son courriel » reste une autre intention que « retrouver l’accès à son compte ».
Un score RRF est une somme de contributions, pas une probabilité. La documentation d’Elasticsearch sur RRF illustre aussi cette formule. Elle sert ici de référence sur le mécanisme ; nous n’installons pas Elasticsearch et conservons l’implémentation Python du ZIP.
Lire la fusion dans le code
"""Reciprocal Rank Fusion (RRF), rangs commençant à 1."""
import math


def reciprocal_rank_fusion(rankings, k=60):
    if not isinstance(k, (int, float)) or not math.isfinite(k) or k < 0:
        raise ValueError("k doit être fini et positif ou nul")
    scores = {}
    for ranking in rankings:
        seen = set()
        for rank, (document_id, original_score) in enumerate(ranking, start=1):
            if document_id in seen or not math.isfinite(original_score):
                raise ValueError("Classement avec doublon ou score non fini")
            seen.add(document_id)
            contribution = 1.0 / (k + rank)
            scores[document_id] = scores.get(document_id, 0.0) + contribution
    return sorted(scores.items(), key=lambda row: (-row[1], row[0]))
La boucle extérieure parcourt les classements. enumerate(..., start=1) donne les rangs, puis contribution calcule les points. Le dictionnaire scores cumule les contributions d’un même ID d’une liste à l’autre.
En revanche, seen empêche de compter deux fois le même ID dans une seule liste. Les scores non finis sont rejetés. La fonction contrôle aussi que k est fini et positif ou nul, ce qui permet l’expérience avec k=0 plus loin.
Remarquez le rôle limité de original_score : il sert à rejeter une valeur non finie, mais n’entre pas dans la formule. Si seuls les nombres des scores changent, sans changer l’ordre ni les candidats de chaque liste, la fusion reste identique. Le tri final classe les contributions décroissantes, avec l’ID croissant comme départage en cas d’égalité.
Lancez la comparaison :
docker compose run --rm --no-deps app -m src.cli compare
Ouvrez outputs/compare.json avant de conclure. Une fusion peut stagner ou régresser si ses candidats sont mauvais, si l’une des voies était déjà très bonne ou si k ne correspond pas au compromis recherché.
| Voie | Cinq premiers IDs | Rang de la fiche attendue ID 0 |
|---|---|---|
| BM25 | 15, 1, 8, 9, 0 | 5 |
| E5 + Qdrant | 0, 1, 8, 2, 14 | 1 |
| RRF | 1, 0, 8, 11, 9 | 2 |
La fusion fait remonter ID 0, « Réinitialiser le mot de passe », du rang 5 lexical au rang 2 hybride. Elle le fait cependant reculer par rapport au rang 1 dense. ID 1, « Changer l’adresse de courriel », passe devant grâce à ses deux deuxièmes places.
Un détail mérite une pause : ID 11 apparaît dans les cinq premiers de RRF alors qu’il ne figure pas dans les deux top 5 affichés plus haut. RRF ne crée pas d’identifiant. D’après son code, un ID ne peut apparaître dans la fusion que s’il était présent dans au moins une liste reçue. Les cinq lignes affichées ne suffisent donc pas à reconstituer toutes ses entrées. Pour refaire le classement complet, inspectez les listes effectivement transmises dans le parcours et les sorties de comparaison, plutôt que fusionner seulement les cinq éléments du tableau.
La leçon n’est pas « l’hybride fonctionne mal ». Elle est plus précise : cette fusion améliore une voie et dégrade l’autre sur cette question. Il nous faut maintenant vérifier ce qui se passe sur l’ensemble d’évaluation.
Cas négatifs
Avant de mesurer la pertinence, vérifions les erreurs que le système doit gérer. Un cas négatif est un test où nous présentons volontairement une situation vide ou invalide et contrôlons le comportement attendu.
Une collection vide doit produire une liste vide. Un texte dépassant 512 tokens doit être refusé après tokenisation, avant le calcul des représentations par le Transformer. Qdrant doit aussi rejeter un vecteur dont la dimension n’est pas 384.
Ce dernier contrôle ressemble à un contrat d’API : nous avons annoncé une structure, et une entrée incompatible ne doit pas être acceptée discrètement. Ces tests vérifient le bon comportement technique ; ils ne mesurent pas encore la pertinence des fiches.
docker compose run --rm --no-deps app -m src.cli negatives
Les trois indicateurs de outputs/negatives.json doivent être vrais avant de poursuivre. Une erreur attendue et correctement rejetée est ici un test réussi, pas un échec du tutoriel.
Mesurer les trois voies
Nous avons des listes. Comment juger si elles sont utiles ? Un score de similarité ne suffit pas : il faut comparer les identifiants retrouvés aux fiches attendues.
Les règles d’évaluation sont définies avant de lire les résultats. Les 12 questions ayant une fiche pertinente entrent dans les moyennes de pertinence. Les deux questions hors corpus sont comptées séparément.
Pourquoi les séparer ? Pour une question sans fiche pertinente, le rappel aurait un dénominateur nul. Lui attribuer automatiquement un score de 0 mélangerait deux problèmes : mal classer une réponse qui existe, et savoir s’abstenir lorsqu’elle n’existe pas. Ici, nous gardons un compteur dédié aux questions sans réponse pertinente et aux résultats pourtant renvoyés.
Recall@5 : trouver les pertinentes
Le Recall@5, ou rappel à cinq résultats, répond à cette question : « Parmi toutes les fiches attendues, combien ai-je retrouvées dans les cinq premières ? »
La formule est :
|top5 ∩ pertinents| / |pertinents|
L’intersection ∩ garde les identifiants présents dans les deux ensembles. Les barres |…| comptent leurs éléments.
Dans notre jeu, chaque question évaluable possède une seule fiche pertinente. Si elle est au rang 4, le rappel vaut 1 ; si elle est absente des cinq premières, il vaut 0. Une valeur élevée indique donc que la fiche utile est généralement visible dans le top 5.
Attention : Recall@5 ne distingue pas les rangs 1 et 5. Il ne mesure pas non plus la proportion de bonnes fiches parmi les cinq affichées. Une liste contenant une seule bonne fiche et quatre mauvaises peut avoir un rappel de 1 si cette bonne fiche était la seule attendue.
MRR@10 : placer la première réponse
Le MRR@10, pour Mean Reciprocal Rank, s’intéresse à la position de la première fiche pertinente dans les dix premiers résultats.
Pour une question, on prend l’inverse de ce rang : 1 au rang 1, 1/4 = 0,25 au rang 4, et 0 si aucune fiche pertinente ne figure dans les dix premières. Le MRR du jeu est ensuite la moyenne de ces valeurs, calculée question par question.
Une valeur élevée signifie que l’utilisateur trouve rapidement une première fiche utile. Cette métrique ne récompense pas les autres fiches pertinentes situées derrière la première, lorsqu’il y en a plusieurs.
nDCG@10 : ordonner les réponses utiles
Le nDCG@10, pour normalized Discounted Cumulative Gain, pose une question un peu plus générale : « Mes fiches utiles sont-elles aussi bien placées qu’elles pourraient l’être ? »
Avec notre pertinence binaire, chaque fiche pertinente apporte un gain qui diminue avec son rang. Au rang r, ce gain vaut 1 / log2(r + 1). On additionne les gains dans les dix premières positions, puis on divise par le gain du meilleur classement possible. log2 est le logarithme en base 2 ; retenez surtout qu’il fait décroître le gain lorsque le rang augmente.
Pour une seule fiche pertinente, le classement idéal la place au rang 1 et vaut 1. Au rang 2, son gain est 1 / log2(2 + 1) ≈ 0,63093. Une fiche absente du top 10 ne rapporte rien.
Une valeur élevée signifie que les fiches utiles sont concentrées en tête. Contrairement à MRR, nDCG peut valoriser plusieurs fiches pertinentes bien placées. Dans ce corpus, il n’y en a qu’une par question évaluable, mais le code conserve cette définition générale.
Appliquer les trois règles à notre question fil rouge
Reprenons les rangs déjà observés : 5 pour BM25, 1 pour E5/Qdrant et 2 pour RRF. Le tableau suivant est une application des formules à ces rangs, pas une nouvelle exécution GPU, ni la moyenne du jeu d’évaluation.
| Voie, pour la seule question fil rouge | Rang d’ID 0 | Recall@5 | Contribution au MRR@10 | nDCG@10 |
|---|---|---|---|---|
| BM25 | 5 | 1 | 0,2 | 0,386853 |
| E5 + Qdrant | 1 | 1 | 1 | 1 |
| RRF | 2 | 1 | 0,5 | 0,630930 |
Les trois voies ont le même rappel : elles retrouvent toutes la bonne fiche dans les cinq premières. Pourtant, elles ne proposent pas la même expérience de lecture. MRR et nDCG rendent cette différence visible.
Vérifier ce que les fonctions comptent réellement
"""Pertinence binaire ; les requêtes sans pertinent sont traitées séparément."""
import math


def ranking_metrics(ids, relevant):
    if len(ids) != len(set(ids)):
        raise ValueError("Identifiants dupliqués")
    relevant = set(relevant)
    if not relevant:
        return None
    hits = [
        rank
        for rank, identifier in enumerate(ids[:10], 1)
        if identifier in relevant
    ]
    ideal = sum(
        1 / math.log2(rank + 1)
        for rank in range(1, min(10, len(relevant)) + 1)
    )
    return {
        "recall_at_5": len(set(ids[:5]) & relevant) / len(relevant),
        "mrr_at_10": 1 / hits[0] if hits else 0.0,
        "ndcg_at_10": sum(1 / math.log2(rank + 1) for rank in hits) / ideal,
    }


def summarize(rows):
    result = {}
    for route in ("lexical", "dense", "hybrid"):
        scored = [
            ranking_metrics(
                [hit[0] for hit in row["routes"][route]], row["relevant"]
            )
            for row in rows
        ]
        valid = [score for score in scored if score is not None]
        if not valid:
            raise ValueError("Aucune requête évaluable")
        result[route] = {
            key: sum(score[key] for score in valid) / len(valid)
            for key in valid[0]
        }
        result[route]["evaluated_queries"] = len(valid)
        result[route]["no_relevant_queries"] = len(rows) - len(valid)
        result[route]["no_relevant_with_results"] = sum(
            bool(row["routes"][route])
            for row in rows
            if not row["relevant"]
        )
        result[route]["mean_search_ms"] = (
            1000 * sum(row["seconds"][route] for row in rows) / len(rows)
        )
    return result
ranking_metrics reçoit les IDs classés et les IDs pertinents. Il refuse les doublons dans la liste de résultats. S’il n’y a aucune fiche pertinente, il renvoie None, et non une note artificielle.
hits contient les rangs pertinents parmi les dix premiers. ideal calcule le meilleur gain possible, en plaçant jusqu’à dix fiches pertinentes en tête. Le dictionnaire de retour applique ensuite les trois formules : intersection dans les cinq premières, inverse du premier rang pertinent, puis gain normalisé.
summarize répète ce calcul pour chaque question et chacune des routes lexical, dense et hybrid. Pour les moyennes de pertinence, il écarte uniquement les retours None. Un score numérique de 0 reste bien pris en compte. Cette distinction évite de faire disparaître les recherches qui ont échoué.
Les champs evaluated_queries, no_relevant_queries et no_relevant_with_results permettent de savoir combien de questions ont été évaluées, combien n’avaient aucune fiche pertinente et combien de ces dernières ont quand même reçu des résultats.
En revanche, mean_search_ms utilise toutes les lignes, donc les 14 questions, y compris les deux hors corpus. Ne lui attribuez pas le même dénominateur qu’aux métriques de pertinence.
Lancez l’évaluation :
docker compose run --rm --no-deps app -m src.cli evaluate
Si une moyenne vous surprend, revenez aux listes question par question. La moyenne résume les comportements ; elle ne les explique pas à elle seule.
Comprendre le chronomètre avant de comparer les durées
Les latences ci-dessous sont des moyennes en millisecondes sur les 14 questions, après un passage d’échauffement exclu des mesures. L’échauffement est une première utilisation destinée à ne pas mélanger le démarrage du calcul avec les recherches mesurées. Le chargement du modèle est lui aussi exclu.
La durée dense inclut l’encodage de la question et l’appel à Qdrant. Ce n’est donc pas uniquement le temps passé dans la base vectorielle. La durée hybride additionne les étapes lexicales, denses et de fusion, exécutées séquentiellement dans ce parcours.
Les deux valeurs de temps de chaque ligne correspondent aux deux reproductions r3 sur la même machine. Elles ne fixent pas un objectif de rapidité à atteindre sur votre poste et ne décrivent pas une application web sous charge.
Les résultats r3
| Méthode | Recall@5 | MRR@10 | nDCG@10 | Latence moyenne (ms), 1 / 2 |
|---|---|---|---|---|
| BM25 | 0,833333 | 0,777778 | 0,791667 | 0,067 / 0,059 |
| E5 + Qdrant | 1,000000 | 0,825000 | 0,867053 | 6,613 / 5,749 |
| RRF | 0,916667 | 0,802778 | 0,847993 | 6,695 / 5,820 |
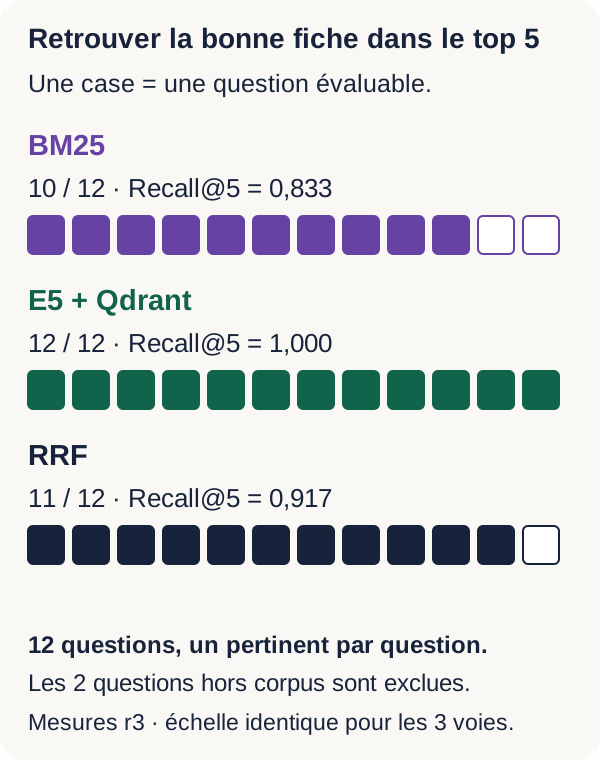
Ces mesures proviennent de deux reproductions r3 sur le même GPU RTX 3090 et la même machine. La voie dense est meilleure sur les trois métriques de pertinence de ce jeu. RRF améliore BM25, mais reste en dessous d’E5 seul.
Le rappel se lit très concrètement : BM25 retrouve la bonne fiche dans les cinq premières pour 10 questions sur 12 ; E5 pour 12 sur 12 ; RRF pour 11 sur 12. Le 1,000000 d’E5 ne veut pas dire « la bonne fiche est toujours première ». Son MRR de 0,825000 rappelle justement qu’elle n’occupe pas systématiquement ce rang.
Comment la fusion peut-elle avoir un Recall@5 inférieur à celui d’E5 alors qu’elle reçoit des candidats des deux voies ? Ajouter des candidats ne garantit pas leur place dans les cinq premiers. Une fiche présente dans la liste dense peut être repoussée plus bas après la fusion. Le rappel à une profondeur donnée dépend autant des candidats conservés que de leur nouvel ordre.
Les trois voies renvoient malgré tout des résultats pour les deux questions hors corpus. Le tutoriel ne sait donc pas décider qu’aucune fiche ne répond. Avoir un « meilleur résultat disponible » ne signifie pas avoir une réponse pertinente.
Combiner plusieurs méthodes ne garantit pas une amélioration : il faut évaluer l’architecture hybride. Ce constat concerne ce corpus, ce modèle et cette configuration. Il ne prédit pas les résultats sur d’autres documents, d’autres GPU ou des questions non annotées.
Ce que nous avons appris
BM25 : exploiter le vocabulaire
BM25 observe les termes communs à la question et aux fiches. La fréquence apporte un signal, avec saturation ; l’IDF valorise les termes rares ; la correction de longueur évite de favoriser mécaniquement les longs textes.
Une référence exacte peut être discriminante, mais le découpage lexical choisi doit aussi être compris. BM25 ne produit aucun embedding et ne mesure pas directement une proximité apprise par un réseau neuronal.
E5 : représenter les textes
E5 utilise un apprentissage antérieur pour transformer les textes en vecteurs. Les préfixes query: et passage: indiquent leur rôle. Le tokenizer prépare les entrées, le Transformer produit les représentations des positions, la moyenne masquée rassemble ces représentations et la normalisation fixe la norme du vecteur.
Des formulations différentes peuvent ainsi devenir proches. Cette proximité est un signal à vérifier, pas une garantie que les textes répondent au même besoin.
Qdrant : retrouver des voisins
Dans ce tutoriel, Qdrant reçoit les vecteurs déjà calculés par E5. Il les conserve avec les identifiants et les métadonnées, puis retrouve les voisins du vecteur de la question. Python coordonne ces opérations.
La base vectorielle ne décide pas de la pertinence métier et ne rédige pas de réponse. Son option de recherche exacte concerne les voisins, pas la vérité du contenu retrouvé.
RRF : combiner des rangs
RRF ne lit pas les documents et ne calcule pas d’embeddings. Il attribue une contribution à chaque rang observé, puis additionne les contributions d’un même ID.
Deux moteurs aux scores incomparables peuvent ainsi participer à une même fusion. En contrepartie, RRF ne connaît ni l’écart de sens entre deux fiches ni la raison pour laquelle un moteur a placé l’une devant l’autre.
Hybride : une hypothèse à mesurer
Sur ce petit corpus, la fusion améliore BM25, mais reste moins bonne qu’E5 seul sur les trois métriques. Combiner plusieurs méthodes ne garantit pas une amélioration.
Pour choisir une architecture, confrontez-la à vos documents, à vos requêtes, à des annotations explicites et à vos contraintes de latence. L’expérience nous apprend une méthode de comparaison, pas une règle universelle sur le meilleur moteur.
Exercice : changer la question et k
Nous allons maintenant agir sur deux éléments : la formulation de la question et le paramètre k de RRF. Le but est de séparer leurs effets plutôt que de tout changer à la fois sans savoir ce qui a compté.
Prédire. Avant de lancer la commande, écrivez votre hypothèse pour « J'ai oublié mon mot de passe ». Quelle fiche BM25 devrait-il favoriser ? E5 devrait-il proposer le même premier résultat ? Quand k diminue, quelle importance prennent les premières positions ? Un changement de k doit-il nécessairement changer l’ordre final ?
Faites aussi ce petit calcul à la main : fusionnez les listes pédagogiques A=[0,1] et B=[1,2], d’abord avec k=60, puis avec k=0. Ce sont des listes simplifiées, distinctes des classements mesurés du fil rouge.
Écrivez les contributions de chaque ID avant de trier. L’ID 0 n’apparaît que dans A, l’ID 2 seulement dans B, et l’ID 1 dans les deux listes. Un absent reçoit 0 pour la liste concernée ; même avec k=0, les rangs commencent à 1, donc la formule ne divise pas par zéro.
Modifier puis exécuter. L’étape exercise du projet r3 remplace la question fil rouge par la nouvelle formulation. Elle calcule ensuite la fusion habituelle et une seconde fusion avec k=0. Ces changements sont déjà implémentés dans src/cli.py : vous n’avez pas besoin de modifier le code pour cet exercice.
docker compose run --rm --no-deps app -m src.cli exercise
Observer. outputs/exercise.json contient la question, les trois listes dans routes et la fusion supplémentaire dans hybrid_k0. Relevez le rang d’ID 0 et les cinq premiers IDs des deux fusions.
Comparez d’abord les résultats de cette nouvelle question à outputs/compare.json pour explorer l’effet de la reformulation. Puis comparez routes.hybrid et hybrid_k0 dans le même exercise.json pour isoler l’effet de k, à question identique.
Expliquer. Confrontez vos observations à la prédiction et justifiez au moins une position par les contributions de rang. Si les scores changent mais que l’ordre reste identique, c’est aussi un résultat valable : un paramètre peut modifier les écarts sans inverser les positions.
La correction du calcul manuel et les critères de réponse figurent dans lesson/SOLUTIONS.md. Les observations que ce fichier désigne explicitement comme r2 sont historiques. Pour votre exécution r3, utilisez les sorties de votre dossier outputs/.
Expérience personnelle : reformuler une seule fiche
Cette fois, nous allons modifier le document plutôt que la question. Cette expérience est proposée au lecteur ; ses résultats ne font pas partie des mesures r3 publiées plus haut.
Conservez une copie de vos sorties de référence. Dans votre propre extraction du ZIP, reformulez seulement le texte de la fiche ID 0 dans data/corpus.json. Vous pouvez, par exemple, faire apparaître le mot « accès » dans la description de la même procédure.
Conservez l’ID, la référence, la procédure et les annotations. Ne changez ni la question ni k. Nous voulons étudier un changement de formulation, pas déplacer le résultat attendu ou transformer plusieurs éléments simultanément.
Avant la modification, prédisez séparément l’effet possible sur BM25, E5 et RRF. Quel terme commun BM25 pourrait-il désormais trouver ? Que supposez-vous de la représentation produite par E5 ? Comment un changement de rang dans une voie pourrait-il affecter la fusion ? Les trois méthodes ne sont pas obligées de changer d’ordre.
Attention au build : le corpus est copié dans l’image Docker. Modifier le fichier sur votre poste ne suffit donc pas à modifier celui utilisé par un conteneur construit précédemment.
Arrêtez ce projet avec la commande de nettoyage donnée ci-dessous, refaites la construction de l’image, puis reprenez les commandes déjà présentées : démarrage de Qdrant et préparation, BM25, indexation, dense et comparaison. La collection temporaire sera recréée avec vos nouveaux documents.
Comparez lexical.json, dense.json et compare.json à leurs copies de référence. Expliquez les différences sans présupposer une amélioration. Si vous élargissez ensuite le corpus ou changez les annotations, refaites l’évaluation : les chiffres de référence ne décrivent plus votre nouvelle expérience.
Du tutoriel à une application réelle
Vous disposez d’un moteur pédagogique, pas encore d’une application prête à recevoir des documents métier. Pour un développeur web, la suite consiste notamment à entourer la recherche de contrats et de services explicites.
Les documents et leur cycle de vie. Il faut prévoir l’ingestion de vos formats, leur nettoyage et leur découpage en passages, appelé chunking. Chaque passage doit conserver un lien vers sa source. Ajout, modification, suppression et réindexation doivent rester cohérents, avec du stockage persistant, des sauvegardes et une restauration testée. La collection temporaire du tutoriel ne remplit pas ces fonctions.
Les droits et le comportement de recherche. Authentification, autorisations et isolation des utilisateurs ou organisations doivent s’appliquer aux documents dans les deux voies. Retrouver une fiche ne donne pas le droit de la consulter. Il faut également définir les filtres, la pagination et le comportement pour une question hors corpus. Nos deux questions sans réponse montrent que cette dernière décision n’est pas encore traitée.
L’exploitation et l’évaluation. Une API, des journaux utiles, le suivi des erreurs et des latences, la supervision et des tests de charge complètent le service. Côté pertinence, il faut de vrais documents, de vraies requêtes, des annotations relues et une analyse des erreurs. Chaque changement de corpus, de modèle ou de réglage doit pouvoir être comparé à une référence pour détecter les régressions.
docs/PRODUCTION_GAPS.md précise les limites du projet. Ces ajouts dépendent du besoin ; ils ne sont pas tous nécessaires pour comprendre le mécanisme étudié ici.
En cas de problème
Le bon réflexe est de corriger l’étape qui échoue, plutôt que de remplacer silencieusement le modèle, supprimer un contrôle ou continuer avec un index incomplet.
| Symptôme | Cause probable | Vérification | Correction |
|---|---|---|---|
Le préflight échoue alors que nvidia-smi fonctionne |
GPU non exposé à Docker | Lire le diagnostic GPU Docker du préflight | Corriger la configuration du NVIDIA Container Toolkit et relancer le préflight. |
| Le modèle local est absent | Acquisition incomplète | Lire l'erreur et contrôler models/e5 |
Relancer la commande d'acquisition ; les fichiers déjà valides sont vérifiés et réutilisés. |
| L'acquisition s'interrompt | Réseau, espace ou contrôle d'intégrité | Lire l'erreur de fetch et le diagnostic disque du préflight |
Corriger la cause et relancer l'acquisition, sans retirer les contrôles SHA-256. |
| Qdrant reste indisponible | Service non démarré | Vérifier que l'étape de démarrage de Qdrant s'est terminée | Reprendre le démarrage du service de ce projet avant l'indexation. |
| Le texte dépasse 512 tokens | Document trop long pour le parcours | Lire l'erreur explicite de l'encodeur | Découper le document et reconstruire votre expérience ; ne tronquez pas silencieusement le texte. |
| L'indexation refuse la collection | Collection déjà créée dans le projet actif | Lire l'erreur Collection existante |
Arrêter ce projet avec la commande de nettoyage, redémarrer Qdrant puis indexer de nouveau. |
| La recherche dense échoue sur la dimension | Vecteur différent de 384D | Contrôler la sortie et le contrat Qdrant | Réencoder avec E5 R3 ; ne tronquez pas le vecteur. |
| Les métriques surprennent | Annotation, rang ou route mal interprétés | Lire les listes par requête avant la moyenne | Vérifier corpus et annotations, puis rejouer l'évaluation. |
Lorsque vous avez terminé, arrêtez uniquement les services de ce projet, depuis la racine de cette extraction :
docker compose down
Cette commande supprime les conteneurs et le réseau du projet. Les modèles et les sorties montés sur l’hôte restent disponibles, mais la collection temporaire de Qdrant disparaît. Pour rechercher de nouveau après un redémarrage propre, il faudra donc la réindexer.
La commande ne purge pas vos autres projets Docker. Gardez les fichiers de sortie tant que vous souhaitez comparer les classements ou reprendre l’analyse.
Pour aller plus loin
Vous pouvez prolonger le parcours en remplaçant les fiches fictives par vos documents et en annotant vos questions. Une autre expérience consiste à ajouter des filtres documentaires cohérents dans les deux voies, ou à comparer un autre modèle d’embeddings sur le même jeu d’évaluation.
Une quatrième piste est d’ajouter un reranker après la récupération. Notre moteur sait maintenant trouver des candidats. Un reranker est une étape supplémentaire qui réexamine les meilleurs candidats pour les réordonner avec un modèle spécialisé. Ce n’est pas ce que fait RRF : RRF combine des positions déjà calculées, sans relire les contenus.
Évaluez ces prolongements séparément, en conservant votre point de comparaison. Le reranking fera l’objet d’un autre tutoriel ; il n’est pas nécessaire pour terminer celui-ci.
Vous avez maintenant une chaîne dont les décisions peuvent être examinées : des termes, des vecteurs, des voisins, puis des contributions de rang. La bonne question n’est plus « mon moteur utilise-t-il de l’IA ? », mais « retrouve-t-il la fiche attendue, à quel rang, et comment puis-je l’expliquer ? »