





Hãy hình dung một chức năng khá quen trong ứng dụng web: người dùng tải bản ghi âm lên và muốn nhận lại văn bản kèm phụ đề. Bạn đã biết nhận tệp, chạy xử lý và trả kết quả. Phần mới là biến giọng nói thành từ ngữ mà không gửi bản ghi tới dịch vụ ngoài.
Ta có thể chỉ gọi mô hình và hiển thị đáp án. Nhưng làm sao biết văn bản đúng với điều đã nói? Làm gì khi phụ đề vượt quá cuối âm thanh? Và « phiên âm nhanh hơn thời gian thực » chính xác nghĩa là gì?
Trong hướng dẫn này, ta xây chuỗi cục bộ bằng Python và Docker rồi trả lời các câu hỏi bằng mã và quan sát. Nó phiên âm 20 đoạn tiếng Pháp của FLEURS với faster-whisper và mô hình Whisper chuyển đổi cho CTranslate2, trên GPU CUDA. Kết quả có outputs/transcription.json, 20 tệp SRT và outputs/evaluation.json.
Kịch bản ứng dụng web là điểm xuất phát: archive cung cấp xử lý dòng lệnh, không có form tải tệp hay API production. Ta dùng mô hình đã huấn luyện; không cần huấn luyện để theo lộ trình.
Dự án đầy đủ nằm trong Tải xuống dự án hoàn chỉnh của hướng dẫn. Kết quả đến từ hai lần tái lập r3 trong thư mục mới. Ví dụ tính toán nhỏ được ghi là sư phạm, không thay các phép đo này.
Những gì bạn sẽ xây dựng
Từ tệp nhận được đến kết quả có thể kiểm tra
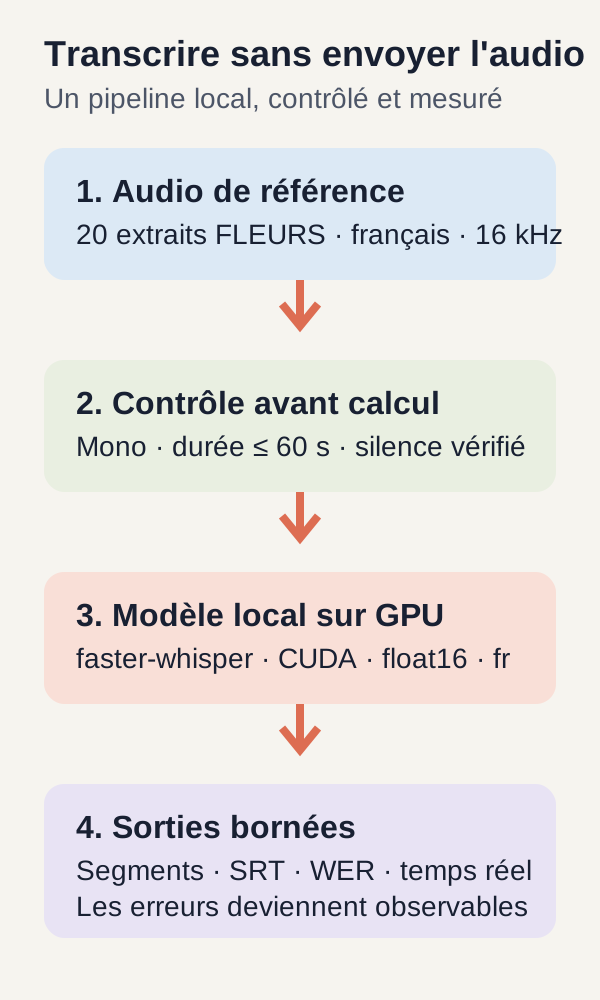
Chương trình bắt đầu từ WAV. Nó giải mã thành chuỗi số, chuẩn bị tín hiệu mono 16 000 mẫu mỗi giây, kiểm tra tín hiệu rồi gọi mô hình cục bộ. Mô hình trả các đoạn văn bản có thời điểm bắt đầu và kết thúc: đó là segment.
Với lập trình viên web, cấu trúc quen thuộc: giải mã đầu vào, xác thực nội dung, gọi thành phần, rồi tuần tự hóa đáp án. Khác biệt là thành phần nhận dạng có thể sai dù mọi xác thực kỹ thuật thành công.
Vì vậy ta giữ hai biểu diễn. Segment thô cho thấy động cơ phiên âm thực sự trả gì. Danh sách thứ hai áp dụng quy tắc thời gian để tạo SRT. Cuối cùng văn bản được so với phiên âm tham chiếu và thời gian tính được đặt cạnh thời lượng âm thanh.
Các tệp cần theo dõi
| Đầu ra | Điều cho phép kiểm tra |
|---|---|
outputs/prepared.json |
20 đoạn đã chuẩn bị và thời lượng. |
outputs/transcription.json |
Văn bản nhận dạng, segment thô và đã giới hạn, ngôn ngữ, thời lượng đo. |
20 tệp .srt trong outputs/ |
Phụ đề có thể mở, đọc lại và đối chiếu âm thanh. |
outputs/evaluation.json |
Lỗi phiên âm, tốc độ tương đối và vượt thời gian thô. |
Tệp phụ đề được giới hạn tốt hơn không phải phiên âm chính xác hơn. Rút ngắn segment vượt cuối âm thanh không sửa từ nào. Sự tách biệt giữa nhận dạng, trình bày và đánh giá là sợi chỉ xuyên suốt.
Điều kiện tiên quyết chính xác
Kiến thức cần có
Bạn cần đọc được hàm Python, thao tác danh sách và từ điển, mở JSON và chạy Docker. Không giả định kiến thức xử lý audio; khái niệm cần thiết được giải thích khi dùng.
Máy dự kiến cho thí nghiệm
Lộ trình xác nhận nhắm Linux amd64 (x86_64), Docker Engine, plugin Docker Compose, driver NVIDIA hoạt động, nvidia-smi và NVIDIA Container Toolkit. Thành phần cuối cho Docker đưa GPU chọn và các phần driver cần thiết vào container.
Suy luận chỉ chạy trên CUDA, môi trường tính toán cho card NVIDIA, với float16. Dự án không công bố đường suy luận CPU. Điều đó không có nghĩa CPU không làm gì: chuẩn bị tệp và phần còn lại chương trình vẫn cần nó.
Chỉ một card được đưa vào container. Nếu máy nhiều GPU, đặt GPU_DEVICE trong .env trước lần chạy đầu nếu card 0 không phải card muốn dùng. Ta không chia phiên âm này trên nhiều card.
Cần ít nhất 20 Gio trống trên đĩa dự án và Docker, cùng 12 Gio RAM khả dụng. Container giới hạn app ở 8 Gio bộ nhớ, 4 CPU, 256 process và /tmp 512 Mio. RAM là bộ nhớ máy; VRAM được quan sát trong kết quả là bộ nhớ GPU.
Các giá trị này là điều kiện script kiểm tra hoặc giới hạn container. Chúng không phải mức tối thiểu phần cứng đã chứng minh cho mọi card CUDA.
Kiểm tra trước khi tải
Sau giải nén ZIP, đứng ở gốc dự án. Preflight là kiểm tra trước: Docker, Compose, GPU chọn, CUDA từ container, RAM, đĩa. Nó không cài hay cấu hình lại máy.
./scripts/preflight.sh
Nếu thành công, dòng cuối là PREFLIGHT=PASS. Nếu card thấy bằng nvidia-smi trên Linux mà không thấy trong Docker, cấu hình NVIDIA Container Toolkit theo hướng dẫn chính thức, rồi chạy lại.
Đừng tiếp tục với GPU khác GPU bạn nghĩ dùng. Card thấy trên máy chủ và card thực sự truy cập được từ chương trình container là hai kiểm tra riêng.
Dữ liệu trước mô hình
Một tham chiếu đã biết, như trong kiểm thử tự động
Để đánh giá phiên âm, cần biết câu đáng lẽ được viết. Câu mong đợi là tham chiếu. Văn bản mô hình tạo gọi là giả thuyết: không phải ý kiến, mà là phiên âm ứng viên đem so với tham chiếu.
Tệp data/audio.json mô tả chính xác 20 tệp thuộc phần kiểm thử tiếng Pháp của FLEURS. Split là một phần được chia ra từ bộ dữ liệu. Ở đây, chúng tôi dùng các tệp kiểm thử để quan sát một mô hình đã được huấn luyện, chứ không dùng chúng để dạy mô hình các câu này.
Mỗi mục cung cấp một mã định danh ổn định, tên tệp WAV, số lượng mẫu âm thanh và câu tham chiếu. Đây là mục đầu tiên:
{
  "id": 0,
  "file": "14682302550249108464.wav",
  "samples": 71040,
  "reference": "Le groupe Aerosmith a annulé les derniers concerts de sa tournée."
}
id giúp tìm lại đúng đoạn trích trong các đầu ra. file chỉ tệp âm thanh tương ứng. reference chứa văn bản mong đợi để đánh giá. Còn samples đếm các giá trị của tín hiệu âm thanh, không phải số câu hay số từ.
Tìm thời lượng bằng phép chia
Ở 16.000 Hz, một giây được biểu diễn bằng 16.000 giá trị. Vì vậy, thời lượng của tệp đầu tiên là:
71 040 / 16 000 = 4,44 secondes.
Hãy chú ý một bẫy nhỏ về từ vựng: trong mục này, samples: 71040 đếm các mẫu âm thanh. Ở phần sau, samples: 20 trong bản tổng kết chuẩn bị lại đếm 20 đoạn trích của kho ngữ liệu. Cùng một thuật ngữ tiếng Anh không chỉ cùng một đơn vị trong hai ngữ cảnh này.
Các đoạn trích là những mục đầu tiên được chọn từ phần kiểm thử fr_fr của FLEURS. Trang bộ dữ liệu FLEURS mô tả một kho ngữ liệu tập trung vào lời nói đọc. Một số câu có nhiều bản ghi âm: vì vậy, trong lựa chọn của chúng tôi, các tệp khác nhau có thể dùng chung một câu tham chiếu.
Điều này đủ để hiểu chuỗi xử lý, nhưng không đủ để đại diện cho mọi giọng vùng miền, cuộc họp, tiếng ồn, tên riêng hoặc nội dung nghiệp vụ của bạn. Hai mươi tệp cũng không đồng nghĩa với hai mươi tình huống âm học độc lập và đa dạng.
Tải cùng mô hình và cùng dữ liệu
Tập lệnh thu thập tải mô hình Systran/faster-whisper-small và các nguồn FLEURS ở những bản sửa đổi được cố định. Trọng số của mô hình là các giá trị số mà mô hình đã học trong quá trình huấn luyện. Chúng tôi tải chúng để sử dụng, không sửa đổi chúng.
Mỗi tệp cần có đều được kiểm tra kích thước và dấu vân tay SHA-256 trước khi dùng. Ở đây, dấu vân tay đóng vai trò như thẻ căn cước của nội dung: nó giúp xác minh rằng ta đang làm việc với đúng các byte mong đợi. Nó không nói gì về độ chính xác của các bản chép lời sau này.
Các nguồn công khai là FLEURS, theo CC-BY-4.0 và faster-whisper-small của Systran, theo MIT. Các tệp lớn không có trong kho lưu trữ: lần thu thập được xác thực đầu tiên chiếm 835 707 397 byte.
Cài đặt, thu thập và chuẩn bị dữ liệu
Từ thư mục gốc của kho lưu trữ đã giải nén, sau khi chọn GPU, hãy chạy các lệnh sau theo đúng thứ tự. Chúng tương ứng với phần đầu của quy trình r3 đã được tái lập thực tế. Preflight được nhắc lại để có thể thực hiện chuỗi này từ đầu.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app -m src.cli prepare
Hiểu từng bước chuẩn bị gì
setup.sh tạo các thư mục và chuẩn bị quyền cho người dùng hiện tại. docker compose build xây dựng ảnh Python 3.12.13 được khóa phiên bản. Tệp khóa phụ thuộc cài đặt, trong đó có faster-whisper 1.2.1, CTranslate2 4.8.2 và PyAV 18.1.0. Đây là các phiên bản của thí nghiệm, không phải lời mời thay chúng bằng các bản mới nhất.
fetch thu thập rõ ràng các tài nguyên công khai. Trong các dịch vụ của dự án, đây là dịch vụ duy nhất có mạng bridge được dự kiến cho việc thu thập đó. Sau đó ứng dụng chạy trên mạng Docker nội bộ, đọc models/ ở chế độ chỉ đọc và ghi kết quả vào outputs/. Việc xây dựng ảnh và tải tài nguyên lần đầu vẫn có thể cần Internet; việc xử lý âm thanh là cục bộ.
Trong các lệnh run, --rm xóa container tạm thời sau khi thực thi; nó không xóa các tệp còn giữ trong những thư mục được gắn kết. --no-deps tránh tự động khởi động các dịch vụ khác. Chẳng hạn, các đối số -m src.cli prepare được chuyển cho Python của ứng dụng để chạy bước được yêu cầu.
Kiểm tra các bài kiểm thử, rồi dữ liệu đã chuẩn bị
18 bài kiểm thử công khai diễn ra trước suy luận trên kho ngữ liệu. Chúng bao quát kiểm tra âm thanh, thu thập được khóa, chuẩn hóa văn bản, Levenshtein, giới hạn SRT và truy cập CUDA. Mục tiêu của chúng không chỉ là xác nhận có thể tạo ra văn bản có vẻ hợp lý: chúng còn kiểm tra các hợp đồng mà chúng ta sẽ dựa vào.
prepare giải mã 20 đoạn trích và ghi outputs/prepared.json. Tệp này phải báo samples: 20 và cho biết thời lượng của từng tệp. Với tệp đầu tiên, bạn có thể đối chiếu thời lượng này với phép tính 4,44 giây ở trên.
Một đầu ra văn bản có vẻ đúng, tự nó, không chứng minh rằng đúng mô hình, đúng GPU hoặc đúng các phép tính chỉ số đã được dùng. Các kiểm tra kỹ thuật và việc đọc kết quả bổ sung cho nhau.
Những khái niệm hữu ích trước khi đọc mã
Một tín hiệu âm thanh là một dãy số
Sau khi giải mã, âm thanh của chúng ta là một mảng số. Mono nghĩa là nó chỉ có một kênh. 16 kHz nghĩa là nó có 16.000 mẫu mỗi giây. Bạn có thể hình dung một chuỗi dài các phép đo cách đều nhau, với các biến thiên biểu diễn tín hiệu âm thanh.
Tần số lấy mẫu này không phải số từ đã nói, cao độ giọng nói hay độ chính xác số của mô hình. Khi nói về float16, số “16” sẽ chỉ cách biểu diễn các số mà công cụ tính toán sử dụng, chứ không phải 16 kHz của bản ghi.
Trước suy luận, quy trình từ chối tín hiệu rỗng, vẫn đa kênh, chứa giá trị không hữu hạn hoặc dài quá 60 giây. Một giá trị không hữu hạn có thể là NaN, biểu diễn một kết quả số không xác định, hoặc một giá trị vô hạn. Giới hạn 60 giây chỉ giới hạn bài thực hành này: nó không phải chiến lược xử lý một cuộc họp dài.
Whisper, faster-whisper, CTranslate2: mỗi công cụ làm gì?
Whisper là mô hình đã học cách liên kết tín hiệu âm thanh với văn bản. Nó tạo ra các đơn vị văn bản gọi là token, rồi các phân đoạn gắn với thời điểm. Một token có thể là một phần của từ: không nên nhầm nó với “từ” mà chỉ số đánh giá của chúng ta sẽ đếm.
faster-whisper là thư viện Python điều khiển việc chép lời này. CTranslate2 là công cụ thực thi các phép tính của mô hình. PyAV tham gia vào việc giải mã âm thanh. Trang mô hình Systran nêu rõ các tệp được dùng là phiên bản chuyển đổi của Whisper small cho CTranslate2: chúng ta không xây dựng một mô hình mới từ 20 đoạn trích.
Từ suy luận chỉ đơn giản là sử dụng một mô hình đã huấn luyện để nhận đầu ra. Ở đây, chúng ta chép lời bằng tiếng Pháp: mục tiêu là viết lại điều được nói, không phải tóm tắt nội dung hay dịch sang ngôn ngữ khác.
Các thiết lập của thí nghiệm, không dùng biệt ngữ không cần thiết
| Thiết lập r3 | Ý nghĩa trong trường hợp này |
|---|---|
language="fr" |
Tiếng Pháp được chỉ định cho công cụ; chúng ta không yêu cầu nó đoán ngôn ngữ. |
device="cuda" |
Mô hình chạy trên GPU NVIDIA được cung cấp cho container. |
compute_type="float16" |
Công cụ dùng chế độ tính toán nửa chính xác. Đây không phải thiết lập định dạng âm thanh. |
beam_size=5 |
Việc giải mã khám phá nhiều chuỗi ứng viên thay vì chỉ giữ một đường đi ở mỗi bước. |
vad_filter=False |
Bộ lọc phát hiện hoạt động giọng nói không được kích hoạt. |
condition_on_previous_text=False |
Văn bản của một cửa sổ âm thanh trước đó không được cung cấp làm ngữ cảnh cho cửa sổ kế tiếp. |
Có thể hình dung beam search như việc khám phá nhiều phần mở đầu của câu trước khi giữ lại một chuỗi. beam_size=5 không có nghĩa là sẽ trả về năm bản chép lời cuối cùng, cũng không có nghĩa là dùng năm GPU. Thay đổi tham số này có thể làm thay đổi chi phí và kết quả; chúng tôi giữ giá trị r3.
Thiết lập condition_on_previous_text liên quan đến các cửa sổ được xử lý bên trong quá trình chép lời. Nó không phải bộ nhớ hội thoại liên kết 20 tệp với nhau. Mã được tài liệu hóa của faster-whisper 1.2.1 trình bày chi tiết các tham số này; tài liệu CTranslate2 giải thích các kiểu tính toán.
Một cơ chế chặn im lặng không phải là VAD
VAD, viết tắt của voice activity detection, sẽ tìm những phần tín hiệu có chứa lời nói. Trong quy trình này, nó bị tắt.
Thay vào đó, mã áp dụng một quy tắc đơn giản hơn nhiều: nếu biên độ của toàn bộ tín hiệu luôn dưới một ngưỡng rất thấp, mã trả về một danh sách rỗng trước khi gọi mô hình. Quy tắc này có thể phát hiện một đoạn im lặng số gần như hoàn hảo. Nó không thể phân biệt giọng nói, nhạc hay tiếng ồn khi ngưỡng đã bị vượt qua. Chúng ta sẽ xem chính xác nơi nó được áp dụng.
Đọc phần lõi của quá trình chép lời
Đây là phần lõi của chương trình. Chúng ta sẽ đọc nó như khi đọc một trình kiểm tra và một dịch vụ nghiệp vụ: trước hết là hợp đồng đầu vào, sau đó là việc tải thành phần, cuối cùng là lời gọi tạo ra kết quả.
"""Whisper local via CTranslate2, CUDA float16, paramètres historiques conservés."""
import numpy as np
import ctranslate2
from faster_whisper import WhisperModel


def validate_audio(audio):
    if (
        not isinstance(audio, np.ndarray)
        or audio.ndim != 1
        or not 0 < len(audio) <= 16000 * 60
    ):
        raise ValueError("Audio mono non vide, de60 secondes maximum à16kHz")
    if not np.isfinite(audio).all():
        raise ValueError("Audio non fini")


class Transcriber:
    def __init__(self):
        if ctranslate2.get_cuda_device_count() != 1:
            raise RuntimeError("Un unique GPU CUDA doit être exposé")
        self.model = WhisperModel(
            "/models/whisper",
            device="cuda",
            compute_type="float16",
            local_files_only=True,
            cpu_threads=4,
        )

    def transcribe(self, audio, guard_silence=True):
        validate_audio(audio)
        if guard_silence and float(np.max(np.abs(audio))) < 1e-5:
            return [], "fr"
        segments, info = self.model.transcribe(
            audio,
            language="fr",
            beam_size=5,
            vad_filter=False,
            condition_on_previous_text=False,
        )
        # The returned generator must be fully consumed before stopping the timer.
        rows = [
            {"start": s.start, "end": s.end, "text": s.text}
            for s in segments
        ]
        return rows, info.language
Hợp đồng thứ nhất: chấp nhận một tín hiệu có thể sử dụng
validate_audio() yêu cầu một mảng NumPy một chiều, không rỗng, có độ dài không vượt quá 16000 * 60, tức 960.000 mẫu. Với tần số 16 kHz dự kiến, điều đó tương ứng tối đa 60 giây. Sau đó np.isfinite(audio).all() yêu cầu mọi giá trị đều hữu hạn.
Một mảng chứa toàn số không không phải là mảng rỗng. Nó biểu diễn một khoảng lặng và vượt qua các kiểm tra này. Ngược lại, một danh sách Python, mảng hai chiều, mảng không có giá trị hoặc tín hiệu chứa NaN sẽ bị từ chối.
Có một điểm cần lưu ý: bản thân trình kiểm tra này không kiểm tra tần số lấy mẫu. Nó chỉ nhận một mảng số, không có siêu dữ liệu để biết các số ấy biểu diễn 16.000 hay 48.000 mẫu mỗi giây. Vì vậy, bước giải mã và chuẩn bị phải thực sự tạo ra tín hiệu mono 16 kHz như mong đợi.
Bạn có thể so sánh điều này với một giá trị tiền tệ nhận qua API: số 100 không cho biết loại tiền của nó. Tương tự, độ dài một mảng âm thanh không đủ để biết thời lượng nếu không có tần số lấy mẫu. Bộ giải mã của faster-whisper 1.2.1 cho thấy việc chuyển sang mono và lấy mẫu lại; những thao tác này diễn ra trước hợp đồng đang đọc ở đây.
Hợp đồng thứ hai: tải đúng mô hình, ở đúng nơi
Hàm dựng Transcriber.__init__() kiểm tra rằng CTranslate2 thấy chính xác một GPU CUDA. Ràng buộc này áp dụng cho những gì được cung cấp cho container: về mặt vật lý, máy có thể có nhiều card.
Sau đó nó tải mô hình từ /models/whisper. Thiết lập local_files_only=True cấm âm thầm bổ sung mô hình bằng một lượt tải xuống trong lúc tải. Nếu thiếu các tệp cần thiết, phải sửa bước thu thập, chứ không nên hy vọng suy luận sẽ lấy chúng về.
device="cuda" và compute_type="float16" giữ nguyên đường tính toán đã chọn. cpu_threads=4 cố định số luồng CPU của công cụ; nó không biến lần chạy này thành suy luận trên CPU.
Hợp đồng thứ ba: xử lý im lặng trước khi nhận dạng
Trong transcribe(), việc xác thực diễn ra trước mọi quyết định. Sau đó chương trình tính np.max(np.abs(audio)): biên độ tuyệt đối lớn nhất trên toàn bộ đoạn trích.
Nếu giá trị này nhỏ hơn nghiêm ngặt 1e-5, tức 0,00001, và guard_silence được bật, hàm trả về ngay ([], "fr"). Không có lời gọi nào đến self.model.transcribe() trong nhánh này.
Đây không phải là trung bình âm lượng, cũng không phải tìm kiếm lời nói. Chỉ một đỉnh nhiễu vượt ngưỡng là đủ để cơ chế chặn không kích hoạt. Ngược lại, lời nói mà mọi mẫu đều dưới ngưỡng sẽ bị loại. Đây là hệ quả của quy tắc được viết trong mã, không phải các phép đo bổ sung của kho ngữ liệu r3.
Vì vậy, chuỗi xử lý có thể trả về đầu ra rỗng đúng cho một đoạn im lặng nhờ bộ điều khiển, mà mô hình chưa nhận dạng gì cả. Chúng ta sẽ giữ sự phân biệt này khi diễn giải kiểm tra âm tính.
Vì sao chuyển các phân đoạn thành danh sách?
Kết quả segments là một generator Python: các phần tử được tạo dần khi ta duyệt qua nó. Nhận đối tượng này không có nghĩa là toàn bộ công việc chép lời đã hoàn thành.
Hãy nghĩ đến một con trỏ cơ sở dữ liệu: lấy được con trỏ và duyệt hết các hàng của nó là hai việc khác nhau. Ở đây, list comprehension duyệt hết generator và giữ lại start, end và text của mỗi phân đoạn.
Điều này rất quan trọng đối với việc đo thời gian. Đồng hồ đặt quanh lời gọi này không được dừng ngay khi generator vừa được tạo; việc tiêu thụ hoàn toàn cho phép đo quá trình chép lời của đoạn trích đến hết. Tài liệu chính thức của faster-whisper nhấn mạnh hành vi này.
Một warm-up, hay lượt khởi động, được thực hiện trên tệp đầu tiên trước 20 lần đo. Nó chuẩn bị việc thực thi mà không được tính vào các thời lượng đo. Việc tải mô hình cũng nằm ngoài RTF mà chúng ta sẽ tính, nhưng vẫn thuộc thời gian đầy đủ cần thiết để thực hiện quy trình.
Chạy và đọc bản chép lời đầu tiên
docker compose run --rm --no-deps app -m src.cli transcribe
Lệnh ghi một đối tượng cho mỗi đoạn trích vào outputs/transcription.json và tạo 20 tệp SRT. Mỗi đối tượng giữ văn bản ghép lại, các phân đoạn thô, các phân đoạn dành cho SRT, thời lượng âm thanh, thời gian suy luận và ngôn ngữ.
Trong các quan sát r3, tệp đầu tiên cho văn bản trùng khớp chính xác với tham chiếu, với một phân đoạn từ 0,000 đến 3,720 giây cho âm thanh dài 4,440 giây. Phân đoạn không cần chiếm toàn bộ thời lượng tệp: chính sách của chúng ta cấm nó vượt quá giới hạn, chứ không buộc nó kết thúc ở mẫu cuối cùng.
Một sắc thái khác khi đọc kết quả: vì chúng ta đã cung cấp language="fr", việc thấy fr trong đầu ra không phải là xác nhận độc lập về phát hiện ngôn ngữ. Trong nhánh im lặng, chuỗi này thậm chí được chính mã của chúng ta trả về trực tiếp.
Tạo SRT mà không che giấu các phân đoạn thô
Phụ đề trông như thế nào?
Một tệp SRT chứa các khối gồm số thứ tự, một khoảng thời gian theo định dạng hh:mm:ss,mmm --> hh:mm:ss,mmm, rồi đến văn bản. Đây là dạng tương ứng với văn bản và mốc thời gian của đoạn trích đầu tiên được nêu ở trên; đó là cách định dạng ví dụ này, không phải một kết quả suy luận mới:
1
00:00:00,000 --> 00:00:03,720
Le groupe Aerosmith a annulé les derniers concerts de sa tournée.
Số thứ tự nhận diện phụ đề. Hai thời điểm chỉ ra khi nào hiển thị và khi nào ẩn nó. Dấu phẩy ngăn cách giây với mili giây: 03,720 nghĩa là 3 giây và 720 mili giây.
Giữ nguồn, rồi áp dụng chính sách đầu ra
Các phân đoạn của mô hình có thể chồng lấn hoặc vượt quá thời lượng âm thanh. Dự án trước hết giữ raw_segments, rồi xây dựng segments theo một quy tắc rõ ràng: không có điểm bắt đầu nào trước điểm kết thúc của phân đoạn đã giữ trước đó, điểm đầu và điểm cuối bị giới hạn theo thời lượng thực, các phân đoạn bị rút xuống thời lượng bằng không sẽ bị loại bỏ.
Đây không phải là sửa lỗi nhận dạng. Đây là biến đổi đầu ra, tương tự như chuẩn bị một đối tượng để hiển thị, đồng thời giữ dữ liệu gốc để hiểu điều gì đã thay đổi.
"""Politique de sortie SRT : conserver le brut et borner à la durée audio."""
import math


def bounded_segments(rows, duration):
    if not math.isfinite(duration) or duration <= 0:
        raise ValueError("Durée positive requise")
    result = []
    previous = 0
    for row in rows:
        start, end = row["start"], row["end"]
        if (
            not all(math.isfinite(value) for value in (start, end))
            or not 0 <= start <= end
        ):
            raise ValueError("Segment invalide")
        start = min(duration, max(previous, start))
        end = min(duration, max(start, end))
        if end > start:
            result.append({"start": start, "end": end, "text": row["text"]})
            previous = end
    return result


def stamp(seconds):
    milliseconds = round(seconds * 1000)
    return f"{milliseconds // 3600000:02d}:{milliseconds // 60000 % 60:02d}:{milliseconds // 1000 % 60:02d},{milliseconds % 1000:03d}"


def to_srt(rows):
    return "\n\n".join(
        f'{i}\n{stamp(row["start"])} --> {stamp(row["end"])}\n{row["text"].strip()}'
        for i, row in enumerate(rows, 1)
    )
Đọc hai giới hạn theo từng dòng
bounded_segments() bắt đầu bằng việc từ chối thời lượng âm thanh không hữu hạn hoặc nhỏ hơn hay bằng không. Với mỗi phân đoạn, nó tiếp tục kiểm tra các thời điểm là hữu hạn và 0 <= start <= end. Do đó, một điểm bắt đầu âm hoặc điểm kết thúc trước điểm bắt đầu sẽ gây lỗi: mã không âm thầm sửa mọi đầu vào có thể có.
previous ghi nhớ điểm kết thúc của phân đoạn cuối cùng được giữ lại. Trong max(previous, start), điểm bắt đầu được đẩy lùi khi cần để tránh chồng lấn. Sau đó min(duration, ...) ngăn điểm bắt đầu này vượt quá cuối âm thanh.
Đối với điểm kết thúc, max(start, end) ngăn việc kết thúc trước điểm bắt đầu mới, rồi min(duration, ...) lại áp dụng giới hạn âm thanh. Phân đoạn chỉ được thêm vào nếu end > start sau các biến đổi này.
Hàm tuân theo thứ tự nhận được: nó không sắp xếp các phân đoạn. Nó cũng tạo một danh sách mới, nhờ đó các hàng thô vẫn sẵn có riêng biệt.
Một ví dụ có thể tính bằng tay
Ba phân đoạn dưới đây là hư cấu, chỉ được xây dựng để hiểu hàm. Hãy lấy một âm thanh dài 4,44 giây:
| Phân đoạn | Khoảng thô, tính bằng giây | Sau khi giới hạn | Giải thích |
|---|---|---|---|
| A | 0,00 → 3,00 | 0,00 → 3,00 | Nó đã nằm trong giới hạn. |
| B | 2,80 → 4,80 | 3,00 → 4,44 | Điểm bắt đầu được đẩy sau A; điểm kết thúc được đưa về thời lượng âm thanh. |
| C | 4,80 → 5,10 | Bị loại | Hai giới hạn đều thành 4,44; thời lượng của nó bằng không. |
Phụ đề B hiện nằm trong khoảng được phép. Tuy vậy, từ đầu tiên của nó có thể đã được nói trước 3,00 giây. Vì vậy, thỏa mãn một ràng buộc thời gian không chứng minh rằng văn bản được đồng bộ tốt.
Văn bản của C biến mất khỏi SRT vì quy tắc này không thể gán cho nó một khoảng dương. Dữ liệu thô của nó vẫn có thể dùng để phân tích: việc loại bỏ này không được xem là nhận dạng tốt hơn.
Định dạng thời gian không đủ để xác thực chúng
stamp() chuyển giây thành mili giây bằng round(), rồi phân bổ chúng thành giờ, phút, giây và mili giây. to_srt() đánh số các phân đoạn bắt đầu từ 1, ghi các khoảng và loại bỏ khoảng trắng thừa ở đầu cuối văn bản bằng strip(). Nó không sửa các từ.
Việc giới hạn làm việc theo giây trước khi làm tròn đến mili giây. Vì vậy, hai thời điểm rất gần nhau có thể hiển thị giống nhau sau khi làm tròn. Chẳng hạn, các giới hạn minh họa 1,0001 và 1,0004 giây đều thành 00:00:01,000. Ví dụ về độ chính xác này không thuộc các lần vượt giới hạn quan sát ở r3; nó cho thấy vì sao hàm không phải là trình xác thực phụ đề hoàn chỉnh.
Chương trình không bảo đảm đồng bộ từng từ, thời lượng đọc dễ chịu hay số ký tự phù hợp trên mỗi dòng. Hãy mở outputs/0.srt trong trình phát hoặc trình biên tập, rồi so sánh với âm thanh. Một tệp trình phát có thể đọc và phụ đề dễ theo dõi vẫn là hai mục tiêu khác nhau.
Hiểu các chỉ số trước khi xem kết quả
Chúng ta sẽ đo hai điều khác nhau: khoảng cách giữa văn bản mong đợi và văn bản nhận được, sau đó là thời gian cần để có văn bản đó. Một chương trình có thể nhanh nhưng mắc lỗi; nó cũng có thể chép lời đúng nhưng tạo phụ đề căn thời gian kém. Không chiều nào trong số này thay thế cho các chiều còn lại.
WER: đếm lỗi từ
WER, viết tắt của word error rate, là tỷ lệ lỗi trên các từ. Để tính nó, dự án dùng khoảng cách Levenshtein: số lần chèn, xóa và thay thế ít nhất cần thiết để đi từ bản tham chiếu đến giả thuyết.
Một phép thay thế đổi một từ thành từ khác. Một phép xóa làm biến mất một từ được mong đợi. Một phép chèn thêm một từ không có trong bản tham chiếu. Phép tính tìm cách căn chỉnh làm tổng này nhỏ nhất: nó không đơn giản so sánh từ thứ nhất với từ thứ nhất rồi từ thứ hai với từ thứ hai. Nếu không, chỉ một từ được thêm ở đầu có thể khiến toàn bộ phần sau trông như sai.
Công thức là:
WER = (substitutions + insertions + suppressions) / nombre de mots de référence.
Hãy lấy một tham chiếu minh họa gồm bốn từ, không liên quan đến các phép đo FLEURS: « bưu kiện đến vào ngày mai ».
| Giả thuyết | Sai khác nhỏ nhất | WER |
|---|---|---|
| « bưu kiện đến vào ngày mai » | Không lỗi | 0 / 4 = 0 % |
| « bưu kiện đến vào thứ Hai » | Một thay thế | 1 / 4 = 25 % |
| « bưu kiện đến » | Một xóa bỏ | 1 / 4 = 25 % |
| « bưu kiện đến đúng vào ngày mai » | Một chèn thêm | 1 / 4 = 25 % |
Mẫu số vẫn là bốn, ngay cả khi giả thuyết có năm từ. Ta chia cho độ dài của bản tham chiếu, không phải độ dài của câu trả lời được tạo ra.
WER thậm chí có thể lớn hơn 1, tức 100 %. Với tham chiếu minh họa « xin chào » và giả thuyết « xin chào cả gia đình », cần bốn phép chèn cho chỉ một từ tham chiếu: WER bằng 4. Đây không phải lỗi phần trăm; công thức đếm các thao tác so với bản tham chiếu.
Chính xác thì chúng ta so sánh những từ nào?
Trước khi đếm, dự án chuẩn hóa văn bản theo NFKC, chuyển về chữ thường và trích các chuỗi Unicode gồm ký tự từ. NFKC là chuẩn hóa các biểu diễn Unicode; nó không phải bản dịch hay trình kiểm tra chính tả. Dấu câu không còn được tính trong phép so sánh này.
Ví dụ, các văn bản minh họa « ÉTÉ ! » và « été » cho cùng đơn vị été. Dấu trọng âm vẫn còn, nhưng chữ hoa và dấu chấm than không còn phân biệt hai văn bản. Vì vậy WER tính theo cách này không đo chất lượng dấu câu.
Tương tự, « L’été, c’est fini ! » được tách thành l, été, c, est, fini. Dấu nháy tách các đơn vị: các “từ” của chỉ số này được xác định bởi quy tắc đó, không chỉ bởi khoảng trắng nhìn thấy trong câu.
Tài liệu Python về chuẩn hóa Unicode và các lớp ký tự trong biểu thức chính quy giúp tìm hiểu sâu hơn hai thao tác này. Để tái tạo các con số r3, hãy giữ quy tắc của kho lưu trữ: thay đổi cách chuẩn hóa sẽ thay đổi điều mà điểm số đo lường.
Vì sao dùng WER “micro” thay vì trung bình theo câu?
WER micro cộng tất cả lỗi và tất cả từ tham chiếu, rồi thực hiện một phép chia duy nhất. Nó không cho một câu hai từ và một câu hai mươi từ cùng trọng số.
Đây là một phép tính minh họa, tách biệt với 20 đoạn trích: một câu 2 từ có 1 lỗi và một câu 8 từ cũng có 1 lỗi. WER tương ứng là 50 % và 12,5 %.
Trung bình đơn giản của hai tỷ lệ là (50 % + 12,5 %) / 2 = 31,25 %. Ngược lại, WER micro là (1 + 1) / (2 + 8) = 20 %.
Hai phép tính mô tả cùng các lỗi nhưng trả lời những câu hỏi khác nhau. Trung bình theo câu cho mỗi câu trọng số như nhau; micro so toàn bộ lỗi với toàn bộ từ được mong đợi. Đó là phép tính thứ hai chúng ta sẽ đọc cho r3.
RTF: đặt thời gian tính toán trong tương quan với thời lượng âm thanh
RTF, hay real-time factor, được tính như sau:
RTF = temps de transcription / durée audio.
Trong một ví dụ minh họa, chép lời 10 giây âm thanh trong 0,25 giây cho 0,25 / 10 = 0,025. Thời gian chép lời khi đó bằng 2,5 % thời lượng âm thanh, tức xử lý nhanh hơn thời gian phát đoạn này 40 lần. RTF nhỏ hơn 1 nghĩa là việc tính toán mất ít thời gian hơn thời lượng âm thanh.
Hãy chú ý đơn vị: 0,025 không phải thời lượng 25 mili giây. Đó là một tỷ số không có đơn vị. Để tìm lại thời gian chép lời, phải nhân nó với thời lượng âm thanh tương ứng.
Điều này cũng không mô tả độ trễ hoàn chỉnh của một ứng dụng: gửi tệp, hàng đợi, tải mô hình và các thao tác khác không phải tất cả đều được đưa vào thời lượng suy luận ở đây. Chép lời một tệp nhanh hơn thời lượng của nó không chứng minh đã xây dựng hay thử nghiệm một dịch vụ chép lời trực tiếp.
RTF trung bình và RTF có trọng số: hai phép tính khác nữa
RTF trung bình tính RTF của từng đoạn trích rồi lấy trung bình các tỷ số đó. RTF có trọng số chia tổng thời gian suy luận cho tổng thời lượng âm thanh: các đoạn trích khi đó có trọng số theo thời lượng âm thanh.
Trong ví dụ minh họa thứ hai, lấy hai đoạn trích: đoạn đầu dài 2 giây và cần 0,2 giây để chép lời; đoạn thứ hai dài 8 giây và cần 0,4 giây. RTF của chúng lần lượt là 0,10 và 0,05.
Trung bình theo đoạn trích là (0,10 + 0,05) / 2 = 0,075. Tỷ số các tổng là (0,2 + 0,4) / (2 + 8) = 0,06. Vì vậy việc hai giá trị không bằng nhau là bình thường. Không giá trị nào là sự sửa chữa của giá trị kia: chúng chỉ không đặt cùng trọng số lên các đoạn trích.
Tạo các kiểm tra và bản tổng kết
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
negatives kiểm tra các đầu vào không hợp lệ và lưu lại quan sát về sự im lặng. Trường hợp âm tính là một thử nghiệm mà ta chờ sự từ chối hoặc một hành vi riêng thay vì bản chép lời thông thường.
evaluate ghi outputs/evaluation.json với WER, RTF và các lần vượt mốc thời gian thô. Hãy đọc các đầu ra này cùng văn bản và các phân đoạn: bản tổng kết cho các mốc tham khảo, không tự động giải thích từng lỗi.
Kết quả quan sát được và phạm vi của chúng
Hai lần tái lập đã đo được gì
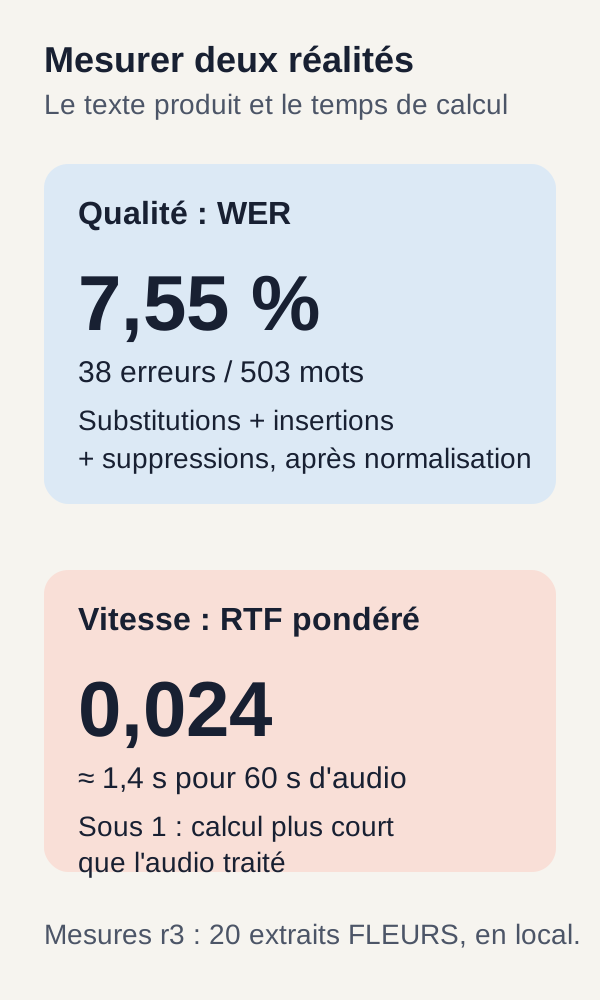
Hai lần tái lập r3 đều thu được chính xác 38 lỗi trên 503 từ tham chiếu, tức WER micro 0,07554671968190854, khoảng 7,55 %. Đây là tổng các thao tác chỉnh sửa được tính sau chuẩn hóa, không phải 38 tệp lỗi hay một điểm do mô hình đưa ra.
| Chỉ số | Lần tái lập 1 | Lần tái lập 2 |
|---|---|---|
| Đoạn trích đã chép lời và đánh giá | 20 | 20 |
| Từ tham chiếu | 503 | 503 |
| Lỗi từ | 38 | 38 |
| WER micro, làm tròn | 7,55 % | 7,55 % |
| Vượt mốc thời gian thô, trước khi giới hạn | 2 | 2 |
| RTF trung bình mỗi đoạn trích | 0,02587 | 0,02565 |
| RTF có trọng số theo thời lượng âm thanh | 0,02396 | 0,02379 |
| VRAM tối đa quan sát được khi lấy mẫu | 1 056 Mio | 1 024 Mio |
Các phép đo này được thực hiện trên một RTX 3090. VRAM được lấy mẫu khoảng một lần mỗi giây: các giá trị trong bảng là mức tối đa quan sát ở các thời điểm đó, không phải phép đo liên tục của đỉnh thực. Vì vậy chúng không cho phép suy ra mức bộ nhớ video tối thiểu được bảo đảm cho mọi lần chạy.
Mô hình được thu thập mới trong từng thư mục tái lập. Tuy nhiên, các lớp Docker công khai có thể đã được dùng lại. “Thư mục mới” không có nghĩa mọi bộ nhớ đệm trên máy đã bị xóa.
Điểm số tổng thể không nói lỗi quan trọng nằm ở đâu
WER 7,55 % không có nghĩa 92,45 % bản ghi hoàn toàn chính xác. Nó cũng không cho phép kết luận mọi tên riêng hay mọi con số đều đáng tin. Đây là tỷ lệ lỗi từ tổng thể trên tập dữ liệu được đánh giá.
Một lỗi về tên, số hoặc phủ định có thể quan trọng cho nghiệp vụ hơn nhiều so với lỗi khác, trong khi phép tính cho chúng cùng một chi phí. Vì vậy để dùng bản chép lời trong một ứng dụng, cần đọc lại những yếu tố quyết định một hành động, chứ không chỉ nhìn tỷ lệ trung bình.
Kho ngữ liệu có ít đoạn trích, nhiều câu lặp lại và không có thử nghiệm đại diện cho điều kiện âm học của riêng bạn. Các con số này mô tả kho ngữ liệu và giao thức này; chúng không phải bảo đảm cho các tệp của bạn.
Sự im lặng cho thấy vai trò của bộ điều khiển
Kiểm tra im lặng đem lại một quan sát đặc biệt hữu ích: không có cơ chế chặn, mô hình tạo ra một câu; có cơ chế chặn, danh sách phân đoạn rỗng.
Kết quả này không có nghĩa mô hình trở nên tốt hơn giữa hai lần thử. Cơ chế chặn chỉ đơn giản ngăn lời gọi đến mô hình. Một câu nghe có vẻ hợp lý được tạo trên im lặng chính là loại kết quả ta có nguy cơ bỏ sót nếu chỉ kiểm tra những đầu ra “trông có vẻ đúng”.
Hai lần vượt mốc thời gian thô cho thấy một giới hạn khác: xử lý SRT đóng khung thời điểm, nhưng không chứng minh nhận dạng tốt hơn hoặc căn chỉnh tốt hơn với lời nói.
Những điều chúng ta đã học
Bây giờ chúng ta biết theo dõi một tệp âm thanh đến ba kết quả riêng biệt: văn bản được nhận dạng, phụ đề đã định dạng và các phép đo để xem xét chúng.
Độ tin cậy của chuỗi này bắt đầu từ các hợp đồng phát triển thông thường: đầu vào có giới hạn, tệp mô hình được kiểm tra, GPU được chọn rõ ràng và dấu vết đầu ra thô. Mô hình thực hiện nhận dạng; bộ điều khiển có thể từ chối đầu vào hoặc bỏ qua im lặng; mã SRT áp dụng các ràng buộc thời gian. Đây không phải cùng một trách nhiệm.
WER phụ thuộc vào tham chiếu và cách chuẩn hóa. RTF phụ thuộc vào thời gian đo được và thời lượng âm thanh. Hiểu mẫu số của chúng tránh biến một kết quả hữu ích thành kết luận quá rộng.
Các lần tái lập r3 chứng minh quy trình này trên 20 đoạn trích FLEURS. Chúng không chứng minh chất lượng chép lời phổ quát hay một dịch vụ sẵn sàng tiếp nhận dữ liệu sản xuất.
Bài tập: dự đoán, sửa đổi, chạy, quan sát, giải thích
Dự đoán trước khi xem kết quả
Hãy quay lại đoạn trích đầu tiên: « Nhóm Aerosmith đã hủy các buổi diễn cuối của chuyến lưu diễn. » Sau chuẩn hóa của dự án, tham chiếu của nó có 11 từ, và giả thuyết ban đầu là chính xác.
Hãy dự đoán điều xảy ra nếu thêm từ intrus vào giả thuyết này. Loại lỗi nào xuất hiện? Mẫu số WER có thành mười hai vì câu trả lời dài hơn không? Có phải chúng ta đang sửa đổi mô hình không?
Hãy viết câu trả lời trước khi chạy bài tập. Ta dự kiến có một phép chèn, nhưng chương trình phải tính lại căn chỉnh: đừng tự ý cộng 1 vào một phép đo mà không thực hiện lại phép so sánh.
Thực hiện sửa đổi đã dự kiến
docker compose run --rm --no-deps app -m src.cli exercise
Lệnh này thực hiện bài tập đã định trong dự án. Nó dùng để quan sát tác động của việc sửa đổi giả thuyết lên chỉ số, không phải để mô hình học một câu mới.
Quan sát, rồi giải thích
Đầu ra r3 báo original_errors: 0, modified_errors: 1 và reference_words: 11.
Tham chiếu không đổi: vì vậy mẫu số vẫn là mười một. Với riêng câu đã sửa này, phép tính cho 1 / 11, khoảng 9,09 %. Phép tính minh họa này không thay thế WER toàn cục 7,55 % của kho tham chiếu.
Thí nghiệm xác minh ý nghĩa của chỉ số. Nó không đo sự suy giảm tự phát của mô hình: chính chúng ta đã chủ ý thêm một từ vào văn bản được đánh giá mà không sửa trọng số của mô hình.
Thử nghiệm riêng của bạn, không báo trước kết quả
Giờ bạn có thể chuẩn bị một thử nghiệm riêng với âm thanh mà bạn có quyền sử dụng và bản chép tham chiếu đã được đọc lại. Đừng ghi đè data/audio.json hoặc các tệp bằng chứng r3. Hãy sao chép dự án vào thư mục mới và giữ riêng kết quả tham chiếu.
Trước hết hãy ghi lại thời lượng, ngôn ngữ, điều kiện âm học, văn bản tham chiếu và các tham số dùng. Một tin nhắn được ghi trong yên tĩnh và một cuộc trò chuyện thu từ xa không đặt ra cùng vấn đề, dù cả hai đều bằng tiếng Pháp.
Các lệnh trình bày tuân theo một manifest và quy trình thu thập được khóa. Chúng tự thân không phải quy trình nhập bất kỳ tệp cá nhân nào. Với bản sao thử nghiệm của bạn, hãy xem trong dự án hoàn chỉnh cách tệp được thu thập, giải mã và gắn với tham chiếu, rồi điều chỉnh rõ ràng luồng đó và các kiểm tra liên quan. Đừng âm thầm thay thế các tệp đã thu thập dưới dấu vân tay gốc của chúng.
Sau đó lặp lại cùng logic: chuẩn bị, chép lời, kiểm tra và đánh giá. So sánh thủ công âm thanh, tham chiếu, JSON thô và SRT. Một đầu ra đúng về mặt cú pháp không được miễn cho bạn việc lắng nghe này.
Đừng công bố điểm số trước khi đo. Nếu bạn thay đổi mô hình, beam_size, VAD, cách cắt đoạn hoặc kho ngữ liệu, bạn đã tạo một thí nghiệm mới. Để nghiên cứu tác động của một tham số, hãy giữ các điều kiện khác giống nhau; để thay kho ngữ liệu, hãy lập tham chiếu so sánh mới. Các số liệu r3 không tự động mô tả biến thể đó.
Với bản ghi dài, cần xác định cách cắt đoạn, khả năng chồng lấn, chiến lược ghép nối và đánh giá riêng. Ví dụ, thời điểm của một phân đoạn được chép trong một mẩu phải được đặt lại trên dòng thời gian của toàn bản ghi. Phần mở rộng này còn phải được xây dựng và đo lường: chỉ nâng giới hạn 60 giây là chưa đủ để xác nhận nó.
Khắc phục sự cố có mục tiêu
nvidia-smi absent. Hãy cài đặt hoặc sửa trình điều khiển NVIDIA, rồi chạy lại preflight. Script kiểm tra không tự làm việc cài đặt này thay bạn.
GPU thấy được trên Linux nhưng không thấy trong Docker. Hãy cài đặt hoặc cấu hình NVIDIA Container Toolkit. Container chẩn đoán phải thấy đúng một card, card được chọn bởi GPU_DEVICE.
fetch thất bại. Kiểm tra kết nối và đọc lỗi thu thập. Đừng tắt kiểm tra dung lượng hoặc SHA-256 để tiếp tục: một lượt tải thiếu hoặc khác tệp mong đợi không phải mô hình được khóa của thí nghiệm.
GPU CUDA requis hoặc kiểm thử CUDA thất bại. Hãy kiểm tra GPU_DEVICE, trình điều khiển, cấu hình Docker và việc thực hiện đầy đủ fetch. Giữ các tham số của quy trình thay vì âm thầm chuyển sang công cụ khác hoặc CPU.
Một âm thanh bị từ chối. Hãy phân biệt tệp đã giải mã với mảng mà validate_audio() mong đợi. Đầu vào rỗng, không mono, không hữu hạn hoặc dài quá 60 giây ở định dạng dự kiến bị từ chối trước mô hình. Thông báo Image modifiée, gặp trong hướng dẫn OCR, không liên quan đến chuỗi âm thanh này.
SRT có vẻ lệch. So sánh raw_segments và segments, rồi nghe đoạn đó. Việc giới hạn có thể rút ngắn một khoảng hoặc bỏ một phân đoạn; nó không thể sửa văn bản nhận dạng sai hay tạo ra đúng thời điểm phát âm.
Từ hướng dẫn đến một dịch vụ
Các xử lý âm thanh còn phải hoàn thiện
Một dịch vụ phải xử lý rõ ràng thời lượng dài, định dạng được chấp nhận, số kênh, tiếng ồn, giọng địa phương và ngôn ngữ cần thiết cho việc sử dụng. Nó cũng phải chọn và đánh giá một chính sách VAD thay vì coi ngưỡng biên độ duy nhất của chúng ta là phát hiện lời nói tổng quát.
Cần phân biệt thêm hai nhu cầu. Diarization tìm cách gán các lượt nói cho những người nói khác nhau: ai nói vào lúc nào, không nhất thiết biết tên họ. Căn chỉnh tìm cách đặt văn bản, có thể đến từng từ, lên dòng thời gian âm thanh. Một bản chép lời tốt không tự động giải quyết hai vấn đề này.
Đối với phụ đề, vẫn cần xác định quy tắc về độ dài dòng và sự thoải mái khi đọc. Mã của hướng dẫn này tập trung vào một chính sách thời gian rõ ràng, không phải phụ đề hoàn thiện cho mọi màn hình và mọi đối tượng.
Những trách nhiệm thông thường của ứng dụng web vẫn còn
Cần thiết kế việc tiếp nhận được kiểm soát, API được xác thực, quyền truy cập, hạn mức, hàng đợi công việc và thời hạn thực thi quanh việc chép lời. RTF cục bộ thấp không đủ để quyết định mỗi xử lý có thể vẫn gắn với một yêu cầu HTTP đồng bộ.
Cũng cần có nhật ký và giám sát hữu ích, mã hóa phù hợp bối cảnh, chính sách lưu giữ và quy trình xóa hoặc khôi phục. Giữ tệp trên máy của mình tránh gửi chúng tới dịch vụ bên ngoài của kịch bản, nhưng tự nó không quản lý quyền đối với âm thanh và bản chép lời.
Đo chất lượng nghiệp vụ và tải thực tế
Chất lượng nghiệp vụ đòi hỏi một kho ngữ liệu đại diện, đã được đọc lại, phân bổ theo các điều kiện âm thanh quan trọng với ứng dụng của bạn, cùng các quy tắc rà soát của con người. Đặc biệt, số và tên cần được kiểm tra phù hợp với mục đích sử dụng.
RTF trung bình cục bộ không cho biết thông lượng khi có tải, cũng không cho biết độ trễ p95 hay p99. Các percentile này mô tả các thời lượng mà lần lượt 95 % hoặc 99 % yêu cầu của một tập đã đo nằm dưới. Muốn biết chúng, cần đo nhiều yêu cầu trong điều kiện cạnh tranh và chờ đợi của dịch vụ.
Các cơ chế sản xuất này không được triển khai hoặc xác nhận bởi kho lưu trữ này. Hướng dẫn cho phép học và tái tạo chuỗi cục bộ; thêm chúng sẽ cần một giai đoạn phát triển và đánh giá khác.
Dọn dẹp đúng những gì đã khởi động
Khi đã xem xong các đầu ra, hãy dừng các dịch vụ của dự án từ gốc kho lưu trữ:
docker compose down
Lệnh này cũng là bước cuối của các lần tái lập r3. Nó dừng tài nguyên Compose của thư mục này; không xóa các mô hình đã thu thập, ảnh đã xây dựng hoặc đầu ra còn giữ trên đĩa.
Giữ outputs/ để có thể đọc lại và so sánh kết quả. Chỉ xóa các thư mục thử nghiệm sau khi đã kiểm tra nội dung; không cần dọn sạch toàn bộ các dự án Docker khác của bạn.
Tài liệu tham khảo để tìm hiểu thêm
Để hiểu các tài nguyên được dùng, hãy xem trang FLEURS và trang Systran/faster-whisper-small. Chúng mô tả kho ngữ liệu và mô hình; các phiên bản và tệp cần thu thập cho thí nghiệm này vẫn là các tệp được khóa trong kho lưu trữ.
Để theo dõi cơ chế, tài liệu chính thức của faster-whisper trình bày API và hành vi của generator. Mã chép lời phiên bản 1.2.1 nêu chi tiết các tham số, còn bộ giải mã của cùng phiên bản cho thấy việc chuẩn bị âm thanh. Các tham khảo này giải thích cơ chế; chúng không mở rộng kết quả đã đo của hướng dẫn sang các thiết lập khác.
Về môi trường và phép tính, tài liệu các kiểu số của CTranslate2, hướng dẫn NVIDIA Container Toolkit và tài liệu Unicode của Python 3.12 bổ sung các giải thích. Hãy giữ các phiên bản và lệnh trong ZIP để tái tạo r3, ngay cả khi tài liệu chung cho thấy những khả năng khác.