





Imaginez une fonctionnalité assez classique dans une application web : une personne dépose un enregistrement audio et souhaite récupérer son texte, accompagné de sous-titres. Vous savez déjà recevoir un fichier, lancer un traitement et renvoyer un résultat. La partie nouvelle, c’est de transformer une voix en mots, sans envoyer l’enregistrement à un service externe.
On pourrait se contenter d’appeler un modèle et d’afficher sa réponse. Mais comment savoir si le texte correspond bien à ce qui a été dit ? Que faire lorsqu’un sous-titre dépasse la fin du son ? Et que signifie exactement « transcrire plus vite que le temps réel » ?
Dans ce tutoriel, nous allons construire une chaîne locale en Python et Docker, puis répondre à ces questions avec du code et des observations. Elle transcrit 20 extraits français du jeu FLEURS avec faster-whisper et un modèle Whisper converti pour CTranslate2, sur un GPU CUDA. À l’arrivée, vous aurez outputs/transcription.json, 20 fichiers SRT et un bilan outputs/evaluation.json.
Le scénario d’application web sert de point de départ : l’archive fournit le traitement en ligne de commande, pas un formulaire de dépôt ni une API de production. Nous utiliserons un modèle déjà entraîné ; aucun entraînement n’est nécessaire pour suivre ce parcours.
Le projet complet est disponible dans l’archive Télécharger le projet complet du tutoriel. Les résultats présentés viennent de deux reproductions r3 de cette archive dans des répertoires neufs. Les petits exemples ajoutés pour expliquer les calculs sont signalés comme pédagogiques : ils ne remplacent pas ces mesures.
Ce que vous allez construire
Du fichier reçu à un résultat que l’on peut vérifier
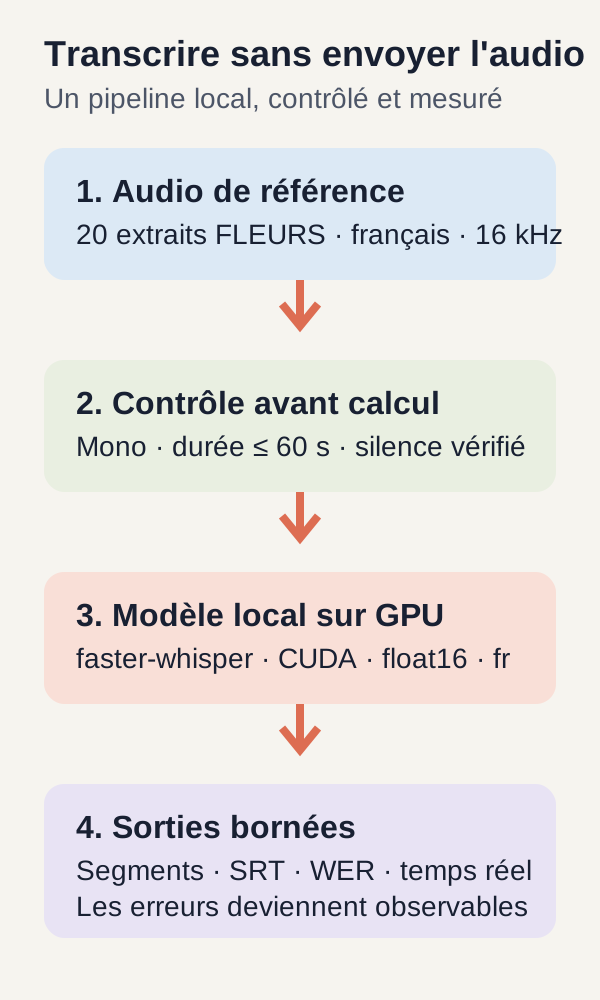
Le programme part d’un fichier WAV. Il le décode en une suite de valeurs numériques, prépare un signal mono à 16 000 échantillons par seconde, vérifie ce signal, puis appelle le modèle local. Le modèle renvoie des morceaux de texte associés à des temps de début et de fin : ce sont les segments.
Pour un développeur web, la structure est familière : décoder l’entrée, valider son contenu, appeler un composant, puis sérialiser la réponse. La différence est que le composant de reconnaissance peut se tromper, même lorsque toutes les validations techniques réussissent.
Nous allons donc conserver deux représentations. Les segments bruts montrent ce que le moteur de transcription a réellement retourné. Une seconde liste applique des règles temporelles pour produire les sous-titres SRT. Enfin, le texte est comparé à une transcription de référence et le temps de calcul est rapporté à la durée du son.
Les fichiers à garder sous les yeux
| Sortie | Ce qu’elle permet de vérifier |
|---|---|
outputs/prepared.json |
Les 20 extraits préparés et leur durée. |
outputs/transcription.json |
Le texte reconnu, les segments bruts et bornés, la langue et les durées mesurées. |
Les 20 fichiers .srt dans outputs/ |
Les sous-titres que vous pouvez ouvrir, relire et confronter à l’audio. |
outputs/evaluation.json |
Les erreurs de transcription, la vitesse relative et les dépassements temporels bruts. |
Un fichier de sous-titres mieux borné n’est pas une transcription plus exacte. Raccourcir un segment qui dépasse la fin du son ne corrige aucun mot. Cette séparation entre reconnaissance, présentation et évaluation est le fil conducteur de l’article.
Prérequis exacts
Ce qu’il faut connaître
Vous devez pouvoir lire une fonction Python, manipuler des listes et des dictionnaires, ouvrir du JSON et lancer des commandes Docker. Aucune connaissance préalable du traitement audio n’est supposée : les notions nécessaires seront expliquées au moment de les utiliser.
Le poste prévu pour l’expérience
Le parcours validé vise Linux amd64, c’est-à-dire l’architecture x86_64, avec Docker Engine, le plugin Docker Compose, un pilote NVIDIA fonctionnel, nvidia-smi et NVIDIA Container Toolkit. Ce dernier permet à Docker d’exposer au conteneur le GPU sélectionné et les composants nécessaires du pilote.
L’inférence est exécutée uniquement sur CUDA, l’environnement de calcul utilisé ici pour la carte NVIDIA, avec le type numérique float16. Le projet n’annonce pas de chemin d’inférence CPU. Cela ne signifie pas que le processeur de la machine ne travaille jamais : la préparation des fichiers et le reste du programme en ont toujours besoin.
Une seule carte doit être exposée au conteneur. Sur une machine qui possède plusieurs GPU, définissez GPU_DEVICE dans le fichier .env fourni avant le premier lancement si la carte 0 n’est pas celle que vous souhaitez utiliser. Nous ne répartissons pas cette transcription sur plusieurs cartes.
Il faut au moins 20 Gio libres sur le disque du projet et sur le stockage Docker, ainsi que 12 Gio de RAM disponible. Le conteneur limite l’application à 8 Gio de mémoire, 4 CPU, 256 processus et un /tmp de 512 Mio. La RAM est la mémoire de la machine ; la VRAM, que nous observerons dans les résultats, est celle du GPU.
Ces valeurs sont des conditions vérifiées par le script ou des limites du conteneur. Elles ne sont pas des minima matériels démontrés pour toutes les cartes CUDA.
Vérifier avant de télécharger
Après extraction du ZIP, placez-vous à la racine du projet. Le préflight est simplement un contrôle préalable : il vérifie Docker, Compose, le GPU choisi, l’accès CUDA depuis un conteneur, la RAM et l’espace disque. Il n’installe rien et ne reconfigure pas votre machine.
./scripts/preflight.sh
En cas de succès, la dernière ligne indique PREFLIGHT=PASS. Si la carte est visible avec nvidia-smi sur Linux mais absente dans Docker, configurez NVIDIA Container Toolkit en suivant son guide officiel, puis relancez le contrôle.
Ne poursuivez pas avec un GPU différent de celui que vous pensez utiliser. Une carte visible sur l’hôte et une carte réellement accessible au programme dans le conteneur sont deux vérifications distinctes.
Les données avant le modèle
Une référence connue, comme dans un test automatisé
Pour évaluer une transcription, il faut disposer de ce qui aurait dû être écrit. Cette phrase attendue est la référence. Le texte produit par le modèle sera appelé l’hypothèse : ce mot ne désigne pas une opinion, mais la transcription candidate que l’on va comparer à la référence.
Le fichier data/audio.json décrit exactement 20 fichiers du split de test français de FLEURS. Un split est une division d’un jeu de données. Ici, nous utilisons les fichiers de test pour observer un modèle déjà entraîné, pas pour lui apprendre ces phrases.
Chaque entrée donne un identifiant stable, un nom de fichier WAV, un nombre d’échantillons audio et la phrase de référence. Voici la première :
{
  "id": 0,
  "file": "14682302550249108464.wav",
  "samples": 71040,
  "reference": "Le groupe Aerosmith a annulé les derniers concerts de sa tournée."
}
id permet de retrouver le même extrait dans les sorties. file désigne son fichier audio. reference contient le texte attendu pour l’évaluation. Quant à samples, il compte les valeurs du signal sonore, pas le nombre de phrases ni le nombre de mots.
Retrouver la durée avec une division
À 16 000 Hz, une seconde est représentée par 16 000 valeurs. La durée du premier fichier est donc :
71 040 / 16 000 = 4,44 secondes.
Attention à un petit piège de vocabulaire : dans cette entrée, samples: 71040 compte des échantillons sonores. Plus loin, samples: 20 dans le bilan de préparation compte les 20 extraits du corpus. Le même terme anglais ne désigne pas la même unité dans ces deux contextes.
Les extraits sont les premières entrées retenues du test fr_fr de FLEURS. La fiche du jeu FLEURS décrit un corpus centré sur de la parole lue. Certaines phrases possèdent plusieurs enregistrements : dans notre sélection, des fichiers distincts peuvent donc partager la même référence.
Cela suffit pour comprendre la chaîne, mais pas pour représenter tous les accents, les réunions, le bruit, les noms propres ou vos contenus métier. Vingt fichiers ne signifient pas non plus vingt situations acoustiques indépendantes et variées.
Télécharger le même modèle et les mêmes données
Le script d’acquisition télécharge à des révisions figées le modèle Systran/faster-whisper-small et les sources FLEURS. Les poids d’un modèle sont les valeurs numériques apprises pendant son entraînement. Nous les chargeons pour les utiliser, sans les modifier.
Chaque fichier attendu est contrôlé par sa taille et son empreinte SHA-256 avant emploi. L’empreinte joue ici le rôle d’une carte d’identité du contenu : elle permet de vérifier que l’on travaille avec les octets attendus. Elle ne dit rien sur la justesse des futures transcriptions.
Les sources publiques sont FLEURS, sous CC-BY-4.0 et faster-whisper-small de Systran, sous MIT. Les fichiers lourds ne sont pas inclus dans l’archive : la première acquisition validée représente 835 707 397 octets.
Installer, acquérir et préparer les données
Depuis la racine de l’archive extraite, après avoir choisi le GPU, lancez les commandes suivantes dans cet ordre. Elles correspondent au début du parcours r3 réellement reproduit. Le préflight est rappelé pour que cette séquence puisse être suivie depuis son commencement.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app -m src.cli prepare
Comprendre ce que chaque étape prépare
setup.sh crée les répertoires et prépare les droits pour l’utilisateur courant. docker compose build construit l’image Python 3.12.13 verrouillée. Le verrou de dépendances installe notamment faster-whisper 1.2.1, CTranslate2 4.8.2 et PyAV 18.1.0. Ce sont les versions de l’expérience, pas une invitation à les remplacer par les dernières disponibles.
fetch acquiert explicitement les ressources publiques. Parmi les services du projet, c’est le seul qui dispose du réseau bridge prévu pour cette acquisition. L’application s’exécute ensuite sur un réseau Docker interne, lit models/ en lecture seule et écrit ses résultats dans outputs/. La construction de l’image et le téléchargement initial des ressources restent des étapes qui peuvent nécessiter Internet ; c’est le traitement des audios qui est local.
Dans les commandes run, --rm retire le conteneur temporaire après son exécution ; il ne supprime pas les fichiers conservés dans les répertoires montés. --no-deps évite de démarrer automatiquement d’autres services. Les arguments -m src.cli prepare, par exemple, sont transmis au Python de l’application pour lancer l’étape demandée.
Vérifier les tests, puis les données préparées
Les 18 tests publics précèdent l’inférence du corpus. Ils couvrent notamment les contrôles audio, l’acquisition verrouillée, la normalisation du texte, Levenshtein, le bornage SRT et l’accès CUDA. Leur objectif n’est pas seulement de constater qu’un texte plausible peut être produit : ils vérifient aussi les contrats sur lesquels nous allons nous appuyer.
prepare décode les 20 extraits et écrit outputs/prepared.json. Ce fichier doit annoncer samples: 20 et donner la durée de chaque fichier. Pour le premier, vous pouvez confronter cette durée au calcul de 4,44 secondes effectué plus haut.
Une sortie textuelle qui semble correcte ne prouve pas, à elle seule, que le bon modèle, le bon GPU ou les bons calculs de métriques ont été utilisés. Les contrôles techniques et la lecture du résultat se complètent.
Les concepts utiles avant de lire le code
Un signal audio est une suite de nombres
Après décodage, notre audio est un tableau numérique. Mono signifie qu’il ne contient qu’un canal. 16 kHz signifie qu’il comporte 16 000 échantillons par seconde. On peut imaginer une longue série de mesures régulièrement espacées, dont les variations représentent le signal sonore.
Cette fréquence d’échantillonnage n’est ni le nombre de mots prononcés, ni la hauteur de la voix, ni la précision numérique du modèle. Quand nous parlerons de float16, le « 16 » concernera une représentation des nombres utilisés par le moteur de calcul, pas les 16 kHz de l’enregistrement.
Le parcours refuse avant l’inférence un signal vide, encore multicanal, contenant des valeurs non finies ou dépassant 60 secondes. Une valeur non finie est par exemple NaN, qui représente un résultat numérique indéfini, ou une valeur infinie. La limite de 60 secondes borne cet exercice : elle ne constitue pas une stratégie de traitement d’une longue réunion.
Whisper, faster-whisper, CTranslate2 : qui fait quoi ?
Whisper est le modèle qui a appris à relier un signal audio à du texte. Il produit des unités textuelles appelées tokens, puis des segments associés à des temps. Un token peut être une partie de mot : il ne faut pas le confondre avec le « mot » que comptera notre métrique d’évaluation.
faster-whisper est la bibliothèque Python qui pilote cette transcription. CTranslate2 est le moteur qui exécute les calculs du modèle. PyAV intervient dans le décodage de l’audio. La fiche du modèle Systran précise que les fichiers utilisés sont une conversion de Whisper small pour CTranslate2 : nous ne construisons pas un nouveau modèle à partir des 20 extraits.
Le mot inférence désigne simplement l’utilisation d’un modèle déjà entraîné pour obtenir une sortie. Ici, nous faisons de la transcription en français : nous cherchons à écrire ce qui est dit, pas à résumer le propos ni à le traduire dans une autre langue.
Les réglages de l’expérience, sans jargon inutile
| Réglage r3 | Ce qu’il signifie ici |
|---|---|
language="fr" |
Le français est indiqué au moteur ; nous ne lui demandons pas de deviner la langue. |
device="cuda" |
Le modèle est exécuté sur le GPU NVIDIA exposé au conteneur. |
compute_type="float16" |
Le moteur utilise son mode de calcul en demi-précision. Ce n’est pas un réglage du format audio. |
beam_size=5 |
Le décodage explore plusieurs suites candidates au lieu de ne conserver qu’un seul chemin à chaque étape. |
vad_filter=False |
Le filtre de détection d’activité vocale n’est pas activé. |
condition_on_previous_text=False |
Le texte d’une fenêtre audio précédente n’est pas fourni comme contexte à la suivante. |
Le beam search peut se représenter comme l’exploration de plusieurs débuts de phrase avant de retenir une suite. beam_size=5 ne signifie pas que cinq transcriptions finales seront rendues, ni que cinq GPU seront utilisés. Modifier ce paramètre peut changer le coût et le résultat ; nous conservons sa valeur r3.
Le réglage condition_on_previous_text concerne les fenêtres traitées au sein de la transcription. Ce n’est pas une mémoire de conversation qui relierait les 20 fichiers entre eux. Le code documenté de faster-whisper 1.2.1 détaille ces paramètres ; la documentation CTranslate2 explique les types de calcul.
Une garde de silence n’est pas une VAD
La VAD, pour voice activity detection, chercherait les portions du signal qui contiennent de la parole. Elle est désactivée dans ce parcours.
Le code applique à la place une règle beaucoup plus simple : si l’amplitude de tout le signal reste sous un seuil très faible, il renvoie une liste vide avant d’appeler le modèle. Cette règle peut repérer un silence numérique presque parfait. Elle ne sait pas distinguer une voix, de la musique ou un bruit dès lors que le seuil est dépassé. Nous allons voir exactement où elle intervient.
Lire le cœur de la transcription
Voici le cœur du programme. Nous allons le lire comme nous lirions un validateur et un service métier : d’abord le contrat d’entrée, puis le chargement du composant et enfin l’appel qui produit le résultat.
"""Whisper local via CTranslate2, CUDA float16, paramètres historiques conservés."""
import numpy as np
import ctranslate2
from faster_whisper import WhisperModel


def validate_audio(audio):
    if (
        not isinstance(audio, np.ndarray)
        or audio.ndim != 1
        or not 0 < len(audio) <= 16000 * 60
    ):
        raise ValueError("Audio mono non vide, de60 secondes maximum à16kHz")
    if not np.isfinite(audio).all():
        raise ValueError("Audio non fini")


class Transcriber:
    def __init__(self):
        if ctranslate2.get_cuda_device_count() != 1:
            raise RuntimeError("Un unique GPU CUDA doit être exposé")
        self.model = WhisperModel(
            "/models/whisper",
            device="cuda",
            compute_type="float16",
            local_files_only=True,
            cpu_threads=4,
        )

    def transcribe(self, audio, guard_silence=True):
        validate_audio(audio)
        if guard_silence and float(np.max(np.abs(audio))) < 1e-5:
            return [], "fr"
        segments, info = self.model.transcribe(
            audio,
            language="fr",
            beam_size=5,
            vad_filter=False,
            condition_on_previous_text=False,
        )
        # The returned generator must be fully consumed before stopping the timer.
        rows = [
            {"start": s.start, "end": s.end, "text": s.text}
            for s in segments
        ]
        return rows, info.language
Premier contrat : accepter un signal exploitable
validate_audio() exige un tableau NumPy à une dimension, non vide, dont la longueur ne dépasse pas 16000 * 60, soit 960 000 échantillons. Avec la fréquence prévue de 16 kHz, cela correspond à 60 secondes au maximum. np.isfinite(audio).all() exige ensuite que toutes les valeurs soient finies.
Un tableau rempli de zéros n’est pas un tableau vide. Il représente une durée de silence et passe ces contrôles. Une liste Python, un tableau à deux dimensions, un tableau sans valeur ou un signal contenant NaN est en revanche refusé.
Il existe une nuance importante : ce validateur ne vérifie pas lui-même la fréquence d’échantillonnage. Il ne reçoit qu’un tableau de nombres, sans métadonnée lui permettant de savoir si ces nombres représentent 16 000 ou 48 000 échantillons par seconde. Le décodage et la préparation doivent donc avoir réellement produit le signal mono à 16 kHz attendu.
Vous pouvez rapprocher ce point d’une valeur monétaire reçue par une API : le nombre 100 ne permet pas de deviner sa devise. De même, la longueur d’un tableau audio ne suffit pas à connaître sa durée sans fréquence d’échantillonnage. Le décodeur de faster-whisper 1.2.1 montre la conversion mono et le rééchantillonnage ; ces opérations précèdent le contrat que nous lisons ici.
Deuxième contrat : charger le modèle prévu, au bon endroit
Le constructeur Transcriber.__init__() vérifie que CTranslate2 voit exactement un GPU CUDA. Cette contrainte porte sur ce qui est exposé au conteneur : la machine peut physiquement posséder plusieurs cartes.
Il charge ensuite le modèle depuis /models/whisper. Le réglage local_files_only=True interdit de compléter discrètement le modèle par un téléchargement pendant son chargement. Si les fichiers nécessaires manquent, il faut corriger l’acquisition, pas espérer que l’inférence les récupère.
device="cuda" et compute_type="float16" conservent le chemin de calcul choisi. cpu_threads=4 fixe les threads CPU du moteur ; il ne transforme pas cette exécution en inférence CPU.
Troisième contrat : traiter le silence avant la reconnaissance
Dans transcribe(), la validation précède toute décision. Le programme calcule ensuite np.max(np.abs(audio)) : la plus grande amplitude en valeur absolue, sur tout l’extrait.
Si cette valeur est strictement inférieure à 1e-5, c’est-à-dire 0,00001, et si guard_silence est activé, le retour est immédiatement ([], "fr"). Il n’y a aucun appel à self.model.transcribe() dans cette branche.
Ce n’est ni une moyenne du volume, ni une recherche de parole. Un seul pic de bruit au-dessus du seuil suffit à ne pas déclencher cette garde. Inversement, une parole dont tous les échantillons resteraient sous le seuil serait écartée. Ce sont des conséquences de la règle écrite dans le code, pas des mesures supplémentaires du corpus r3.
La chaîne peut donc renvoyer une sortie vide correcte sur un silence grâce au contrôleur, sans que le modèle ait reconnu quoi que ce soit. Nous garderons cette distinction au moment d’interpréter le test négatif.
Pourquoi convertir les segments en liste ?
Le résultat segments est un générateur Python : ses éléments sont produits au fur et à mesure de son parcours. Recevoir cet objet ne signifie pas que tout le travail de transcription est terminé.
Pensez à un curseur de base de données : obtenir le curseur et parcourir toutes ses lignes ne sont pas la même opération. Ici, la compréhension de liste parcourt entièrement le générateur et conserve, pour chaque segment, start, end et text.
C’est essentiel pour le chronométrage. Le chronomètre placé autour de cet appel ne doit pas s’arrêter à la seule création du générateur ; la consommation complète permet de mesurer la transcription de l’extrait jusqu’au bout. La documentation officielle de faster-whisper souligne ce comportement.
Un warm-up, ou passage d’échauffement, est effectué sur le premier fichier avant les 20 mesures. Il prépare l’exécution sans entrer dans les durées mesurées. Le chargement du modèle reste lui aussi hors du RTF que nous calculerons, mais appartient au temps complet nécessaire pour réaliser le parcours.
Lancer et lire la première transcription
docker compose run --rm --no-deps app -m src.cli transcribe
La commande écrit un objet par extrait dans outputs/transcription.json et crée les 20 fichiers SRT. Chaque objet conserve le texte joint, les segments bruts, les segments destinés au SRT, la durée audio, le temps d’inférence et la langue.
Dans les observations r3, le premier fichier donne le texte exact de sa référence, avec un segment de 0,000 à 3,720 secondes pour un audio de 4,440 secondes. Le segment n’a pas besoin d’occuper toute la durée du fichier : notre politique lui interdit de déborder, elle ne l’oblige pas à finir au dernier échantillon.
Autre nuance de lecture : puisque nous avons fourni language="fr", retrouver fr dans les sorties n’est pas une validation indépendante de la détection de langue. Dans la branche de silence, cette chaîne est même renvoyée directement par notre propre code.
Produire un SRT sans maquiller les segments bruts
À quoi ressemble un sous-titre ?
Un fichier SRT contient des blocs composés d’un numéro, d’un intervalle au format hh:mm:ss,mmm --> hh:mm:ss,mmm, puis du texte. Voici la forme correspondant au texte et aux horodatages du premier extrait rapportés ci-dessus ; c’est une mise en forme de cet exemple, pas un nouveau résultat d’inférence :
1
00:00:00,000 --> 00:00:03,720
Le groupe Aerosmith a annulé les derniers concerts de sa tournée.
Le numéro identifie le sous-titre. Les deux temps indiquent quand l’afficher et quand le retirer. La virgule sépare les secondes des millisecondes : 03,720 signifie 3 secondes et 720 millisecondes.
Conserver la source, puis appliquer une politique de sortie
Les segments du modèle peuvent se chevaucher ou dépasser la durée audio. Le projet conserve d’abord raw_segments, puis construit segments avec une règle explicite : pas de début avant la fin du segment précédent conservé, début et fin bornés à la durée réelle, suppression des segments réduits à une durée nulle.
Ce n’est pas une correction de la reconnaissance. C’est une transformation de sortie, comparable à la préparation d’un objet pour son affichage, tout en conservant la donnée d’origine pour comprendre ce qui a changé.
"""Politique de sortie SRT : conserver le brut et borner à la durée audio."""
import math


def bounded_segments(rows, duration):
    if not math.isfinite(duration) or duration <= 0:
        raise ValueError("Durée positive requise")
    result = []
    previous = 0
    for row in rows:
        start, end = row["start"], row["end"]
        if (
            not all(math.isfinite(value) for value in (start, end))
            or not 0 <= start <= end
        ):
            raise ValueError("Segment invalide")
        start = min(duration, max(previous, start))
        end = min(duration, max(start, end))
        if end > start:
            result.append({"start": start, "end": end, "text": row["text"]})
            previous = end
    return result


def stamp(seconds):
    milliseconds = round(seconds * 1000)
    return f"{milliseconds // 3600000:02d}:{milliseconds // 60000 % 60:02d}:{milliseconds // 1000 % 60:02d},{milliseconds % 1000:03d}"


def to_srt(rows):
    return "\n\n".join(
        f'{i}\n{stamp(row["start"])} --> {stamp(row["end"])}\n{row["text"].strip()}'
        for i, row in enumerate(rows, 1)
    )
Lire les deux bornages ligne par ligne
bounded_segments() commence par refuser une durée audio non finie ou inférieure ou égale à zéro. Pour chaque segment, il vérifie ensuite que les temps sont finis et que 0 <= start <= end. Un début négatif ou une fin antérieure au début provoque donc une erreur : le code ne répare pas silencieusement toutes les entrées possibles.
previous mémorise la fin du dernier segment conservé. Dans max(previous, start), le début est repoussé si nécessaire pour éviter un chevauchement. Le min(duration, ...) empêche ensuite ce début de dépasser la fin de l’audio.
Pour la fin, max(start, end) empêche de finir avant le nouveau début, puis min(duration, ...) applique à nouveau la borne audio. Le segment n’est ajouté que si end > start après ces transformations.
La fonction suit l’ordre reçu : elle ne trie pas les segments. Elle produit aussi une nouvelle liste, ce qui laisse les lignes brutes disponibles séparément.
Un exemple que l’on peut calculer à la main
Les trois segments ci-dessous sont fictifs, construits uniquement pour comprendre la fonction. Prenons un audio de 4,44 secondes :
| Segment | Intervalle brut, en secondes | Après bornage | Explication |
|---|---|---|---|
| A | 0,00 → 3,00 | 0,00 → 3,00 | Il est déjà dans les limites. |
| B | 2,80 → 4,80 | 3,00 → 4,44 | Le début est repoussé après A ; la fin est ramenée à la durée audio. |
| C | 4,80 → 5,10 | Supprimé | Les deux bornes deviennent 4,44 ; sa durée devient nulle. |
Le sous-titre B est maintenant dans l’intervalle autorisé. Pourtant, son premier mot a peut-être été prononcé avant 3,00 secondes. Une contrainte temporelle satisfaite ne prouve donc pas que le texte est bien synchronisé.
Le texte de C disparaît du SRT puisqu’aucun intervalle positif ne peut lui être attribué par cette règle. Ses données brutes restent disponibles pour l’analyse : ce retrait ne doit pas passer pour une meilleure reconnaissance.
Mettre les temps en forme ne suffit pas à les valider
stamp() convertit les secondes en millisecondes avec round(), puis les répartit en heures, minutes, secondes et millisecondes. to_srt() numérote les segments à partir de 1, écrit les intervalles et retire les espaces superflus aux extrémités du texte avec strip(). Elle ne corrige pas les mots.
Le bornage travaille en secondes avant l’arrondi à la milliseconde. Deux temps très proches peuvent donc être affichés de la même façon après arrondi. Par exemple, les bornes pédagogiques 1,0001 et 1,0004 seconde deviennent toutes deux 00:00:01,000. Cet exemple de précision ne fait pas partie des dépassements observés r3 ; il montre pourquoi la fonction n’est pas un validateur complet de sous-titres.
Le programme ne garantit ni le synchronisme mot à mot, ni une durée de lecture confortable, ni un nombre de caractères adapté à chaque ligne. Ouvrez outputs/0.srt dans un lecteur ou un éditeur, puis comparez-le au son. Un fichier lisible par un lecteur et des sous-titres agréables à suivre restent deux objectifs distincts.
Comprendre les métriques avant les résultats
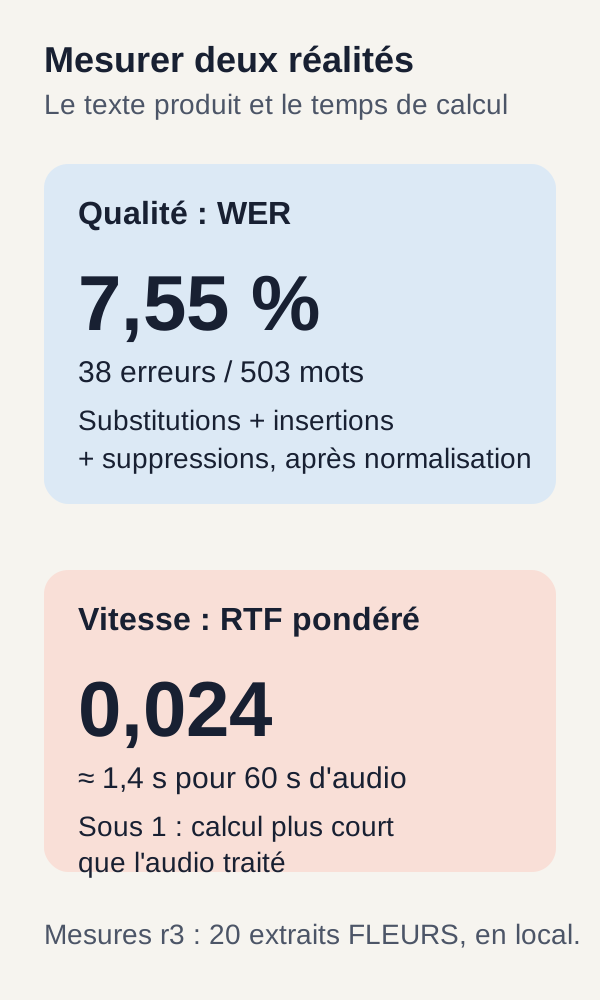
Nous allons mesurer deux choses différentes : l’écart entre le texte attendu et le texte obtenu, puis le temps nécessaire pour obtenir ce texte. Un programme peut être rapide et se tromper ; il peut aussi transcrire correctement tout en produisant des sous-titres mal calés. Aucune de ces dimensions ne remplace les autres.
Le WER : compter les erreurs de mots
Le WER, pour word error rate, est un taux d’erreur sur les mots. Pour le calculer, le projet utilise la distance de Levenshtein : le nombre minimal d’insertions, de suppressions et de substitutions nécessaires pour passer de la référence à l’hypothèse.
Une substitution remplace un mot par un autre. Une suppression fait disparaître un mot attendu. Une insertion ajoute un mot absent de la référence. Le calcul cherche un alignement qui minimise le total : il ne compare pas simplement le premier mot avec le premier, puis le deuxième avec le deuxième. Sinon, un seul mot ajouté au début pourrait faire croire que toute la suite est erronée.
La formule est :
WER = (substitutions + insertions + suppressions) / nombre de mots de référence.
Prenons cette référence pédagogique de quatre mots, sans lien avec les mesures FLEURS : « le colis arrive demain ».
| Hypothèse | Écart minimal | WER |
|---|---|---|
| « le colis arrive demain » | Aucune erreur | 0 / 4 = 0 % |
| « le colis arrive lundi » | Une substitution | 1 / 4 = 25 % |
| « le colis arrive » | Une suppression | 1 / 4 = 25 % |
| « le colis arrive bien demain » | Une insertion | 1 / 4 = 25 % |
Le dénominateur reste quatre, même lorsque l’hypothèse contient cinq mots. On divise par la longueur de la référence, pas par celle de la réponse produite.
Le WER peut même dépasser 1, donc 100 %. Avec la référence pédagogique « bonjour » et l’hypothèse « bonjour à toute la famille », il faut quatre insertions pour un seul mot de référence : le WER vaut 4. Ce n’est pas un bug de pourcentage ; la formule compte des opérations rapportées à la référence.
Quels mots compare-t-on exactement ?
Avant de compter, le projet normalise les textes en NFKC, les met en minuscules et extrait les suites Unicode de caractères de mot. NFKC est une normalisation des représentations Unicode ; elle n’est ni une traduction ni un correcteur orthographique. La ponctuation ne compte plus dans cette comparaison.
Par exemple, les textes pédagogiques « ÉTÉ ! » et « été » donnent la même unité été. L’accent reste présent, mais la majuscule et le point d’exclamation ne distinguent plus les deux textes. Le WER ainsi calculé ne mesure donc pas la qualité de la ponctuation.
De même, « L’été, c’est fini ! » se décompose en l, été, c, est, fini. Les apostrophes séparent des unités : les « mots » de cette métrique sont définis par cette règle, pas uniquement par les espaces visibles dans la phrase.
Les documentations Python de la normalisation Unicode et des classes de caractères des expressions régulières permettent d’approfondir ces deux opérations. Pour reproduire les chiffres r3, conservez la règle de l’archive : changer la normalisation change ce que le score mesure.
Pourquoi un WER « micro » plutôt qu’une moyenne de phrases ?
Le WER micro additionne toutes les erreurs et tous les mots de référence, puis effectue une seule division. Il ne donne pas le même poids à une phrase de deux mots et à une phrase de vingt mots.
Voici un calcul pédagogique, distinct des 20 extraits : une phrase de 2 mots comporte 1 erreur, et une phrase de 8 mots comporte également 1 erreur. Leurs WER respectifs valent 50 % et 12,5 %.
La moyenne simple des deux taux vaut (50 % + 12,5 %) / 2 = 31,25 %. Le WER micro vaut au contraire (1 + 1) / (2 + 8) = 20 %.
Les deux calculs décrivent les mêmes erreurs, mais répondent à des questions différentes. La moyenne par phrase donne le même poids à chaque phrase ; le micro rapporte l’ensemble des erreurs à l’ensemble des mots attendus. C’est ce second calcul que nous lirons pour r3.
Le RTF : rapporter le temps de calcul à la durée sonore
Le RTF, ou real-time factor, se calcule ainsi :
RTF = temps de transcription / durée audio.
Dans un exemple pédagogique, transcrire 10 secondes de son en 0,25 seconde donne 0,25 / 10 = 0,025. Le temps de transcription représente alors 2,5 % de la durée sonore, soit un traitement 40 fois plus rapide que la durée de lecture de cet extrait. Un RTF inférieur à 1 signifie que le calcul prend moins de temps que l’audio n’en dure.
Attention à l’unité : 0,025 n’est pas une durée de 25 millisecondes. C’est un rapport sans unité. Pour retrouver le temps de transcription, il faut le multiplier par la durée audio concernée.
Cela ne décrit pas non plus la latence complète d’une application : l’envoi du fichier, la file d’attente, le chargement du modèle et les autres opérations ne sont pas tous inclus dans la durée d’inférence utilisée ici. Transcrire un fichier plus vite que sa durée n’établit pas qu’un service de transcription en direct a été construit ou testé.
RTF moyen et RTF pondéré : encore deux calculs différents
Le RTF moyen calcule le RTF de chaque extrait, puis fait la moyenne de ces rapports. Le RTF pondéré divise le temps total d’inférence par la durée audio totale : les extraits pèsent alors selon leur durée sonore.
Pour un second exemple pédagogique, prenons deux extraits : le premier dure 2 secondes et demande 0,2 seconde de transcription ; le second dure 8 secondes et demande 0,4 seconde. Leurs RTF valent respectivement 0,10 et 0,05.
La moyenne par extrait vaut (0,10 + 0,05) / 2 = 0,075. Le rapport des totaux vaut (0,2 + 0,4) / (2 + 8) = 0,06. Il est donc normal que les deux valeurs ne soient pas égales. Aucune n’est une correction de l’autre : elles n’accordent simplement pas le même poids aux extraits.
Produire les contrôles et le bilan
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
negatives vérifie les entrées invalides et conserve l’observation sur le silence. Un cas négatif est un essai où l’on attend un refus ou un comportement particulier plutôt qu’une transcription ordinaire.
evaluate écrit outputs/evaluation.json avec le WER, les RTF et les dépassements bruts d’horodatage. Lisez ces sorties avec les textes et les segments : le bilan donne des repères, pas une explication automatique de chaque erreur.
Résultats observés, puis leur portée
Ce que les deux reproductions ont mesuré
Les deux reproductions r3 ont obtenu exactement 38 erreurs sur 503 mots de référence, soit un WER micro de 0,07554671968190854, environ 7,55 %. Il s’agit du total des opérations d’édition calculées après normalisation, pas de 38 fichiers erronés ni d’une note donnée par le modèle.
| Indicateur | Reproduction 1 | Reproduction 2 |
|---|---|---|
| Extraits transcrits et évalués | 20 | 20 |
| Mots de référence | 503 | 503 |
| Erreurs de mots | 38 | 38 |
| WER micro, arrondi | 7,55 % | 7,55 % |
| Dépassements d’horodatages bruts, avant bornage | 2 | 2 |
| RTF moyen par extrait | 0,02587 | 0,02565 |
| RTF pondéré par durée audio | 0,02396 | 0,02379 |
| Maximum de VRAM observé par échantillonnage | 1 056 Mio | 1 024 Mio |
Ces mesures ont été prises sur une RTX 3090. La VRAM a été échantillonnée environ une fois par seconde : les valeurs du tableau sont les maximums observés à ces instants, pas une mesure continue du pic réel. Elles ne permettent donc pas de déduire un minimum de mémoire vidéo garanti pour toutes les exécutions.
Le modèle a été acquis à neuf dans chaque répertoire de reproduction. En revanche, des couches Docker publiques ont pu être réemployées. « Répertoire neuf » ne signifie pas que tous les caches de la machine avaient été vidés.
Un score global ne dit pas où se trouve l’erreur importante
Un WER de 7,55 % ne signifie pas que 92,45 % des enregistrements sont entièrement corrects. Il ne permet pas non plus de conclure que tous les noms ou tous les nombres sont fiables. C’est un rapport global d’erreurs de mots sur la population évaluée.
Une erreur sur un nom, un nombre ou une négation peut avoir une importance métier bien supérieure à une autre erreur, alors que le calcul lui attribue le même coût. Pour utiliser une transcription dans une application, il faut donc relire les éléments qui déterminent une action, pas seulement regarder le taux moyen.
Le corpus contient peu d’extraits, plusieurs répétitions de phrases et aucun test représentatif de votre propre acoustique. Ces chiffres décrivent ce corpus et ce protocole ; ils ne sont pas une garantie sur vos fichiers.
Le silence révèle le rôle du contrôleur
Le contrôle de silence apporte une observation particulièrement instructive : sans la garde, le modèle a produit une phrase ; avec la garde, la liste des segments est vide.
Ce résultat ne signifie pas que le modèle est devenu meilleur entre les deux essais. La garde a simplement empêché son appel. Une phrase plausible produite sur du silence est précisément le type de résultat que l’on risque de manquer en ne vérifiant que les sorties qui « ont l’air correctes ».
Les deux dépassements d’horodatages bruts illustrent une autre limite : le traitement SRT encadre des temps, mais ne prouve ni une meilleure reconnaissance ni un meilleur alignement avec la parole.
Ce que nous avons appris
Nous savons maintenant suivre un fichier audio jusqu’à trois résultats distincts : le texte reconnu, les sous-titres mis en forme et les mesures qui permettent de les examiner.
La fiabilité de cette chaîne commence par des contrats ordinaires de développement : une entrée bornée, des fichiers de modèle vérifiés, un GPU explicitement choisi et une trace des sorties brutes. Le modèle effectue la reconnaissance ; le contrôleur peut refuser une entrée ou court-circuiter un silence ; le code SRT applique des contraintes de temps. Ce ne sont pas les mêmes responsabilités.
Le WER dépend de la référence et de la normalisation. Le RTF dépend du temps mesuré et de la durée sonore. Comprendre leurs dénominateurs évite de transformer un résultat utile en conclusion trop générale.
Les reproductions r3 démontrent ce parcours sur 20 extraits FLEURS. Elles ne démontrent ni une qualité universelle de transcription ni un service prêt à recevoir des données de production.
Exercice : prédire, modifier, lancer, observer, expliquer
Prédire avant de regarder le résultat
Revenons au premier extrait : « Le groupe Aerosmith a annulé les derniers concerts de sa tournée. » Après la normalisation du projet, sa référence contient 11 mots, et l’hypothèse initiale est exacte.
Prédisez ce qui se passe si l’on ajoute le mot intrus à cette hypothèse. Quel type d’erreur apparaît ? Le dénominateur du WER passe-t-il à douze parce que la réponse est devenue plus longue ? Est-ce le modèle que l’on est en train de modifier ?
Écrivez votre réponse avant de lancer l’exercice. On s’attend à une insertion, mais c’est au programme de recalculer l’alignement : n’ajoutez pas arbitrairement 1 à une mesure sans refaire sa comparaison.
Exécuter la modification prévue
docker compose run --rm --no-deps app -m src.cli exercise
La commande réalise l’exercice prévu dans le projet. Elle sert à observer l’effet d’une modification de l’hypothèse sur la métrique, pas à apprendre une nouvelle phrase au modèle.
Observer, puis expliquer
La sortie r3 rapporte original_errors: 0, modified_errors: 1 et reference_words: 11.
La référence n’a pas changé : le dénominateur reste donc onze. Pour cette seule phrase modifiée, le calcul donne 1 / 11, soit environ 9,09 %. Ce calcul pédagogique ne remplace pas le WER global de 7,55 % du corpus de référence.
L’expérience vérifie le sens de la métrique. Elle ne mesure pas une dégradation spontanée du modèle : c’est nous qui avons volontairement ajouté un mot au texte évalué, sans modifier ses poids.
Votre propre expérience, sans résultat préannoncé
Vous pouvez maintenant préparer une expérience séparée avec un audio dont vous avez les droits et une transcription de référence relue. N’écrasez ni data/audio.json ni les fichiers de preuve r3. Copiez le projet dans un nouveau dossier et conservez les résultats de référence à part.
Documentez d’abord la durée, la langue, les conditions acoustiques, le texte de référence et les paramètres utilisés. Un message enregistré au calme et une conversation captée à distance ne posent pas le même problème, même si les deux sont en français.
Les commandes présentées suivent un manifeste et une acquisition verrouillés. Elles ne constituent pas, à elles seules, une procédure d’import de n’importe quel fichier personnel. Pour votre copie expérimentale, examinez dans le projet complet comment le fichier est acquis, décodé et associé à sa référence, puis adaptez explicitement ce chemin et les contrôles concernés. Ne remplacez pas silencieusement les fichiers acquis sous leurs empreintes d’origine.
Reprenez ensuite la même logique : préparer, transcrire, contrôler et évaluer. Comparez manuellement l’audio, la référence, le JSON brut et le SRT. Une sortie correcte sur le plan syntaxique ne doit pas dispenser de cette écoute.
N’annoncez aucun score avant la mesure. Si vous changez le modèle, beam_size, la VAD, le découpage ou le corpus, vous avez créé une nouvelle expérience. Pour étudier l’effet d’un paramètre, gardez les autres conditions identiques ; pour changer de corpus, établissez une nouvelle référence de comparaison. Les chiffres r3 ne décrivent pas automatiquement cette variante.
Pour des enregistrements longs, il faudra définir un découpage, un éventuel chevauchement, une stratégie de concaténation et une évaluation spécifique. Par exemple, les temps d’un segment transcrit dans un morceau devront être replacés sur la chronologie de l’enregistrement complet. Ce prolongement reste à construire et à mesurer : relever simplement la limite de 60 secondes ne suffit pas à le valider.
Dépannage ciblé
nvidia-smi absent. Installez ou réparez le pilote NVIDIA, puis relancez le préflight. Le script de contrôle ne fait pas cette installation à votre place.
Le GPU est visible sur Linux, mais pas dans Docker. Installez ou configurez NVIDIA Container Toolkit. Le conteneur de diagnostic doit voir exactement une carte, celle sélectionnée par GPU_DEVICE.
fetch échoue. Contrôlez la connexion et lisez l’erreur d’acquisition. Ne désactivez pas les vérifications de taille ou de SHA-256 pour poursuivre : un téléchargement partiel ou différent du fichier attendu ne constitue pas le modèle verrouillé de l’expérience.
GPU CUDA requis ou échec des tests CUDA. Vérifiez GPU_DEVICE, le pilote, la configuration Docker et l’exécution complète de fetch. Conservez les paramètres du parcours plutôt que de basculer silencieusement sur un autre moteur ou sur le CPU.
Un audio est refusé. Distinguez le fichier décodé du tableau attendu par validate_audio(). Une entrée vide, non mono, non finie ou dépassant 60 secondes dans le format prévu est rejetée avant le modèle. Le message Image modifiée, rencontré dans le tutoriel OCR, ne concerne pas cette chaîne audio.
Le SRT paraît mal calé. Comparez raw_segments et segments, puis écoutez le passage. Le bornage peut raccourcir un intervalle ou retirer un segment ; il ne peut pas corriger un texte mal reconnu ni inventer les bons instants de prononciation.
Passer d’un tutoriel à un service
Les traitements audio à compléter
Un service doit traiter explicitement les durées longues, les formats acceptés, les canaux, le bruit, les accents et les langues nécessaires à son usage. Il doit aussi choisir et évaluer une politique de VAD plutôt que considérer notre seul seuil d’amplitude comme une détection générale de parole.
Deux autres besoins doivent être distingués. La diarisation cherche à attribuer les prises de parole à des locuteurs distincts : qui parle à quel moment, sans nécessairement connaître le nom des personnes. L’alignement cherche à positionner le texte, éventuellement mot par mot, sur la chronologie sonore. Une bonne transcription ne résout pas automatiquement ces deux problèmes.
Pour les sous-titres, il reste également à définir des règles de longueur de ligne et de confort de lecture. Le code de ce tutoriel se concentre sur une politique temporelle explicite, pas sur un sous-titrage finalisé pour tous les écrans et tous les publics.
Les responsabilités habituelles d’une application web restent présentes
Une ingestion contrôlée, une API authentifiée, des droits d’accès, des quotas, une file de travaux et des délais d’exécution doivent être conçus autour de la transcription. Un faible RTF local ne suffit pas à décider que chaque traitement peut rester attaché à une requête HTTP synchrone.
Il faut aussi prévoir des journaux et une supervision utiles, du chiffrement adapté au contexte, une politique de rétention et des procédures d’effacement ou de restauration. Garder les fichiers sur sa machine évite leur envoi au service externe du scénario, mais ne gère pas à lui seul les droits sur les audios et les transcriptions.
Mesurer la qualité métier et la charge réelle
La qualité métier demande un corpus représentatif et relu, réparti selon les conditions audio importantes pour votre application, ainsi que des règles de revue humaine. Les nombres et les noms méritent notamment des vérifications propres à l’usage visé.
La moyenne locale du RTF ne donne ni un débit sous charge ni une latence p95 ou p99. Ces percentiles décrivent les durées sous lesquelles se situent respectivement 95 % ou 99 % des requêtes d’un ensemble mesuré. Pour les connaître, il faut mesurer de nombreuses requêtes dans les conditions de concurrence et d’attente du service.
Ces mécanismes de production ne sont ni implémentés ni validés par cette archive. Le tutoriel permet d’apprendre et de reproduire la chaîne locale ; les ajouter demanderait une autre étape de développement et d’évaluation.
Nettoyer exactement ce qui a été démarré
Quand vous avez fini de consulter les sorties, arrêtez les services du projet depuis la racine de l’archive :
docker compose down
Cette commande est aussi la dernière étape des reproductions r3. Elle arrête les ressources Compose de ce dossier ; elle ne supprime pas les modèles acquis, l’image construite ni les sorties conservées sur disque.
Gardez outputs/ pour pouvoir relire les résultats et les comparer. Ne supprimez vos dossiers d’essai qu’après avoir vérifié leur contenu ; aucune purge globale de vos autres projets Docker n’est nécessaire.
Le mécanisme en vidéo
Cette animation reprend le parcours : préparer l’audio, transcrire localement, conserver les segments bruts, produire les sous-titres et lire les mesures. Gardez sa limite principale en tête : rendre un résultat exploitable ne suffit pas à en démontrer l’exactitude.
Références pour approfondir
Pour comprendre les ressources utilisées, consultez la fiche FLEURS et la fiche Systran/faster-whisper-small. Elles décrivent le corpus et le modèle ; les révisions et fichiers à acquérir pour cette expérience restent ceux verrouillés dans l’archive.
Pour suivre les mécanismes, la documentation officielle de faster-whisper présente l’API et le comportement du générateur. Le code de transcription de la version 1.2.1 détaille les paramètres, tandis que le décodeur de cette même version montre la préparation audio. Ces références expliquent des mécanismes ; elles n’étendent pas les résultats mesurés du tutoriel à d’autres réglages.
Pour l’environnement et les calculs, la documentation des types numériques CTranslate2, le guide NVIDIA Container Toolkit et la documentation Unicode de Python 3.12 complètent les explications. Conservez les versions et commandes du ZIP pour reproduire r3, même si une documentation générale montre d’autres possibilités.