





Immaginate una funzionalità piuttosto comune in un'applicazione web: una persona carica una registrazione audio e desidera ottenerne il testo, accompagnato da sottotitoli. Sapete già ricevere un file, avviare un'elaborazione e restituire un risultato. La novità consiste nel trasformare una voce in parole, senza inviare la registrazione a un servizio esterno.
Potremmo limitarci a chiamare un modello e visualizzarne la risposta. Ma come sapere se il testo corrisponde davvero a ciò che è stato detto? Cosa fare quando un sottotitolo supera la fine dell'audio? E cosa significa esattamente «trascrivere più velocemente del tempo reale»?
In questo tutorial costruiremo una pipeline locale in Python e Docker, quindi risponderemo a queste domande con codice e osservazioni. Trascrive 20 estratti francesi del dataset FLEURS con faster-whisper e un modello Whisper convertito per CTranslate2, su una GPU CUDA. Al termine avrete outputs/transcription.json, 20 file SRT e un riepilogo outputs/evaluation.json.
Lo scenario dell'applicazione web è il punto di partenza: l'archivio fornisce l'elaborazione a riga di comando, non un modulo di caricamento né un'API di produzione. Useremo un modello già addestrato; non è necessario alcun addestramento per seguire il percorso.
Il progetto completo è disponibile nell'archivio Scarica il progetto completo del tutorial. I risultati presentati provengono da due riproduzioni r3 di questo archivio in directory nuove. I piccoli esempi aggiunti per spiegare i calcoli sono indicati come didattici: non sostituiscono queste misure.
Cosa costruirete
Dal file ricevuto a un risultato verificabile
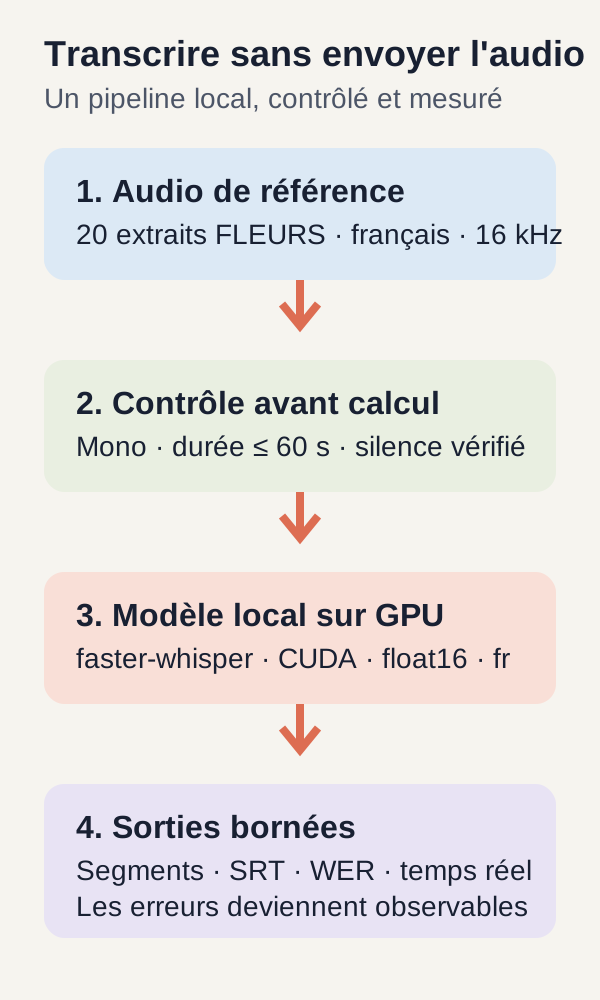
Il programma parte da un file WAV. Lo decodifica in una sequenza di valori numerici, prepara un segnale mono a 16.000 campioni al secondo, verifica il segnale e poi chiama il modello locale. Il modello restituisce porzioni di testo associate a tempi di inizio e fine: sono i segmenti.
Per uno sviluppatore web, la struttura è familiare: decodificare l'input, convalidarne il contenuto, chiamare un componente e serializzare la risposta. La differenza è che il componente di riconoscimento può sbagliarsi, anche quando tutte le convalide tecniche riescono.
Manterremo quindi due rappresentazioni. I segmenti grezzi mostrano ciò che il motore di trascrizione ha realmente restituito. Una seconda lista applica regole temporali per produrre i sottotitoli SRT. Infine, il testo viene confrontato con una trascrizione di riferimento e il tempo di calcolo è rapportato alla durata dell'audio.
I file da tenere sott'occhio
| Output | Cosa permette di verificare |
|---|---|
outputs/prepared.json |
I 20 estratti preparati e la loro durata. |
outputs/transcription.json |
Il testo riconosciuto, i segmenti grezzi e delimitati, la lingua e le durate misurate. |
I 20 file .srt in outputs/ |
I sottotitoli che potete aprire, rileggere e confrontare con l'audio. |
outputs/evaluation.json |
Gli errori di trascrizione, la velocità relativa e gli sforamenti temporali grezzi. |
Un file di sottotitoli delimitato meglio non è una trascrizione più accurata. Accorciare un segmento che supera la fine dell'audio non corregge alcuna parola. Questa separazione tra riconoscimento, presentazione e valutazione è il filo conduttore dell'articolo.
Prerequisiti esatti
Cosa occorre conoscere
Dovete saper leggere una funzione Python, manipolare liste e dizionari, aprire JSON ed eseguire comandi Docker. Non è richiesta alcuna conoscenza preliminare dell'elaborazione audio: le nozioni necessarie saranno spiegate nel momento in cui verranno usate.
La postazione prevista per l'esperimento
Il percorso convalidato richiede Linux amd64, cioè l'architettura x86_64, Docker Engine, il plugin Docker Compose, un driver NVIDIA funzionante, nvidia-smi e NVIDIA Container Toolkit. Quest'ultimo consente a Docker di esporre al contenitore la GPU selezionata e i componenti necessari del driver.
L'inferenza viene eseguita esclusivamente su CUDA, l'ambiente di calcolo qui usato per la scheda NVIDIA, con il tipo numerico float16. Il progetto non propone un percorso di inferenza CPU. Ciò non significa che il processore della macchina non lavori mai: la preparazione dei file e il resto del programma ne hanno comunque bisogno.
Al contenitore deve essere esposta una sola scheda. Su una macchina con più GPU, definite GPU_DEVICE nel file .env fornito prima del primo avvio se la scheda 0 non è quella che desiderate usare. Non distribuiamo questa trascrizione su più schede.
Servono almeno 20 Gio liberi sul disco del progetto e nello spazio Docker, oltre a 12 Gio di RAM disponibile. Il contenitore limita l'applicazione a 8 Gio di memoria, 4 CPU, 256 processi e un /tmp di 512 Mio. La RAM è la memoria della macchina; la VRAM, che osserveremo nei risultati, è quella della GPU.
Questi valori sono condizioni verificate dallo script o limiti del contenitore. Non sono requisiti hardware minimi dimostrati per tutte le schede CUDA.
Verificare prima di scaricare
Dopo aver estratto lo ZIP, posizionatevi nella radice del progetto. Il preflight è semplicemente un controllo preliminare: verifica Docker, Compose, la GPU scelta, l'accesso CUDA da un contenitore, la RAM e lo spazio disco. Non installa nulla e non riconfigura la vostra macchina.
./scripts/preflight.sh
In caso di successo, l'ultima riga indica PREFLIGHT=PASS. Se la scheda è visibile con nvidia-smi su Linux ma assente in Docker, configurate NVIDIA Container Toolkit seguendo la sua guida ufficiale, quindi rilanciate il controllo.
Non proseguite con una GPU diversa da quella che pensate di usare. Una scheda visibile sull'host e una scheda realmente accessibile al programma nel contenitore sono due verifiche distinte.
I dati prima del modello
Un riferimento noto, come in un test automatizzato
Per valutare una trascrizione, bisogna disporre di ciò che avrebbe dovuto essere scritto. Questa frase attesa è il riferimento. Il testo prodotto dal modello sarà chiamato ipotesi: questa parola non indica un'opinione, ma la trascrizione candidata che confronteremo con il riferimento.
Il file data/audio.json descrive esattamente 20 file del test split francese di FLEURS. Uno split è una divisione di un dataset. Qui usiamo i file di test per osservare un modello già addestrato, non per insegnargli queste frasi.
Ogni voce fornisce un identificatore stabile, un nome di file WAV, un numero di campioni audio e la frase di riferimento. Ecco la prima:
{
  "id": 0,
  "file": "14682302550249108464.wav",
  "samples": 71040,
  "reference": "Le groupe Aerosmith a annulé les derniers concerts de sa tournée."
}
id permette di ritrovare lo stesso estratto negli output. file indica il file audio. reference contiene il testo atteso per la valutazione. Quanto a samples, conta i valori del segnale sonoro, non il numero di frasi né il numero di parole.
Ricavare la durata con una divisione
A 16.000 Hz, un secondo è rappresentato da 16.000 valori. La durata del primo file è quindi:
71 040 / 16 000 = 4,44 secondi.
Attenzione a una piccola trappola di vocabolario: in questa voce, samples: 71040 conta campioni sonori. Più avanti, samples: 20 nel riepilogo della preparazione conta i 20 estratti del corpus. Lo stesso termine inglese non indica la stessa unità in questi due contesti.
Gli estratti sono le prime voci selezionate del test fr_fr di FLEURS. La scheda del dataset FLEURS descrive un corpus incentrato su parlato letto. Alcune frasi hanno più registrazioni: nella nostra selezione, file distinti possono quindi condividere lo stesso riferimento.
Questo basta per comprendere la pipeline, ma non per rappresentare tutti gli accenti, le riunioni, il rumore, i nomi propri o i vostri contenuti professionali. Venti file non significano nemmeno venti situazioni acustiche indipendenti e varie.
Scaricare lo stesso modello e gli stessi dati
Lo script di acquisizione scarica a revisioni bloccate il modello Systran/faster-whisper-small e le fonti FLEURS. I pesi di un modello sono i valori numerici appresi durante l'addestramento. Li carichiamo per usarli, senza modificarli.
Ogni file atteso viene controllato per dimensione e impronta SHA-256 prima dell'uso. L'impronta svolge qui il ruolo di carta d'identità del contenuto: permette di verificare che si stiano usando i byte attesi. Non dice nulla sulla correttezza delle future trascrizioni.
Le fonti pubbliche sono FLEURS, con licenza CC-BY-4.0 e faster-whisper-small di Systran, con licenza MIT. I file pesanti non sono inclusi nell'archivio: la prima acquisizione convalidata rappresenta 835 707 397 byte.
Installare, acquisire e preparare i dati
Dalla radice dell'archivio estratto, dopo aver scelto la GPU, eseguite i seguenti comandi nell'ordine indicato. Corrispondono all'inizio del percorso r3 realmente riprodotto. Il preflight è richiamato affinché questa sequenza possa essere seguita fin dall'inizio.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app -m src.cli prepare
Capire cosa prepara ogni fase
setup.sh crea le directory e prepara i permessi per l'utente corrente. docker compose build costruisce l'immagine Python 3.12.13 bloccata. Il lock delle dipendenze installa in particolare faster-whisper 1.2.1, CTranslate2 4.8.2 e PyAV 18.1.0. Sono le versioni dell'esperimento, non un invito a sostituirle con le più recenti disponibili.
fetch acquisisce esplicitamente le risorse pubbliche. Tra i servizi del progetto, è l'unico a disporre della rete bridge prevista per questa acquisizione. L'applicazione viene poi eseguita su una rete Docker interna, legge models/ in sola lettura e scrive i risultati in outputs/. La costruzione dell'immagine e il primo download delle risorse possono richiedere Internet; è l'elaborazione degli audio a essere locale.
Nei comandi run, --rm rimuove il contenitore temporaneo dopo l'esecuzione; non cancella i file conservati nelle directory montate. --no-deps evita di avviare automaticamente altri servizi. Gli argomenti -m src.cli prepare, per esempio, vengono passati al Python dell'applicazione per avviare la fase richiesta.
Verificare i test, poi i dati preparati
I 18 test pubblici precedono l'inferenza del corpus. Coprono tra l'altro i controlli audio, l'acquisizione bloccata, la normalizzazione del testo, Levenshtein, la delimitazione SRT e l'accesso CUDA. Il loro obiettivo non è soltanto constatare che possa essere prodotto un testo plausibile: verificano anche i contratti su cui faremo affidamento.
prepare decodifica i 20 estratti e scrive outputs/prepared.json. Questo file deve indicare samples: 20 e fornire la durata di ogni file. Per il primo, potete confrontare questa durata con il calcolo di 4,44 secondi eseguito sopra.
Un output testuale che sembra corretto non dimostra da solo che siano stati usati il modello giusto, la GPU giusta o i calcoli metrici giusti. I controlli tecnici e la lettura del risultato si completano a vicenda.
I concetti utili prima di leggere il codice
Un segnale audio è una sequenza di numeri
Dopo la decodifica, il nostro audio è un array numerico. Mono significa che contiene un solo canale. 16 kHz significa che contiene 16.000 campioni al secondo. Possiamo immaginare una lunga serie di misure regolarmente distanziate, le cui variazioni rappresentano il segnale sonoro.
Questa frequenza di campionamento non è né il numero di parole pronunciate, né l'altezza della voce, né la precisione numerica del modello. Quando parleremo di float16, il «16» riguarderà una rappresentazione dei numeri usata dal motore di calcolo, non i 16 kHz della registrazione.
Il percorso rifiuta prima dell'inferenza un segnale vuoto, ancora multicanale, contenente valori non finiti o superiore a 60 secondi. Un valore non finito è per esempio NaN, che rappresenta un risultato numerico indefinito, oppure un valore infinito. Il limite di 60 secondi delimita questo esercizio: non costituisce una strategia per elaborare una lunga riunione.
Whisper, faster-whisper, CTranslate2: chi fa cosa?
Whisper è il modello che ha imparato a collegare un segnale audio a testo. Produce unità testuali chiamate token, quindi segmenti associati a tempi. Un token può essere una parte di parola: non va confuso con la «parola» che conterà la nostra metrica di valutazione.
faster-whisper è la libreria Python che pilota questa trascrizione. CTranslate2 è il motore che esegue i calcoli del modello. PyAV interviene nella decodifica dell'audio. La scheda del modello Systran precisa che i file usati sono una conversione di Whisper small per CTranslate2: non costruiamo un nuovo modello a partire dai 20 estratti.
La parola inferenza indica semplicemente l'uso di un modello già addestrato per ottenere un output. Qui trascriviamo in francese: cerchiamo di scrivere ciò che viene detto, non di riassumere il discorso né di tradurlo in un'altra lingua.
Le impostazioni dell'esperimento, senza gergo inutile
| Impostazione r3 | Cosa significa qui |
|---|---|
language="fr" |
Il francese è indicato al motore; non gli chiediamo di indovinare la lingua. |
device="cuda" |
Il modello viene eseguito sulla GPU NVIDIA esposta al contenitore. |
compute_type="float16" |
Il motore usa la modalità di calcolo a mezza precisione. Non è un'impostazione del formato audio. |
beam_size=5 |
La decodifica esplora più sequenze candidate invece di conservare un solo percorso a ogni fase. |
vad_filter=False |
Il filtro di rilevamento dell'attività vocale non è attivato. |
condition_on_previous_text=False |
Il testo di una finestra audio precedente non viene fornito come contesto alla successiva. |
La beam search può essere rappresentata come l'esplorazione di più inizi di frase prima di trattenere una sequenza. beam_size=5 non significa che verranno restituite cinque trascrizioni finali, né che verranno usate cinque GPU. Modificare questo parametro può cambiare il costo e il risultato; ne manteniamo il valore r3.
L'impostazione condition_on_previous_text riguarda le finestre elaborate all'interno della trascrizione. Non è una memoria di conversazione che collegherebbe i 20 file tra loro. Il codice documentato di faster-whisper 1.2.1 dettaglia questi parametri; la documentazione CTranslate2 spiega i tipi di calcolo.
Una protezione dal silenzio non è una VAD
La VAD, per voice activity detection, cercherebbe le porzioni del segnale che contengono parlato. In questo percorso è disattivata.
Il codice applica invece una regola molto più semplice: se l'ampiezza dell'intero segnale resta sotto una soglia molto bassa, restituisce una lista vuota prima di chiamare il modello. Questa regola può individuare un silenzio digitale quasi perfetto. Non sa distinguere una voce, la musica o un rumore non appena la soglia viene superata. Vedremo esattamente dove interviene.
Leggere il cuore della trascrizione
Ecco il cuore del programma. Lo leggeremo come leggeremmo un validatore e un servizio di business: prima il contratto d'ingresso, poi il caricamento del componente e infine la chiamata che produce il risultato.
"""Whisper local via CTranslate2, CUDA float16, paramètres historiques conservés."""
import numpy as np
import ctranslate2
from faster_whisper import WhisperModel


def validate_audio(audio):
    if (
        not isinstance(audio, np.ndarray)
        or audio.ndim != 1
        or not 0 < len(audio) <= 16000 * 60
    ):
        raise ValueError("Audio mono non vide, de60 secondes maximum à16kHz")
    if not np.isfinite(audio).all():
        raise ValueError("Audio non fini")


class Transcriber:
    def __init__(self):
        if ctranslate2.get_cuda_device_count() != 1:
            raise RuntimeError("Un unique GPU CUDA doit être exposé")
        self.model = WhisperModel(
            "/models/whisper",
            device="cuda",
            compute_type="float16",
            local_files_only=True,
            cpu_threads=4,
        )

    def transcribe(self, audio, guard_silence=True):
        validate_audio(audio)
        if guard_silence and float(np.max(np.abs(audio))) < 1e-5:
            return [], "fr"
        segments, info = self.model.transcribe(
            audio,
            language="fr",
            beam_size=5,
            vad_filter=False,
            condition_on_previous_text=False,
        )
        # The returned generator must be fully consumed before stopping the timer.
        rows = [
            {"start": s.start, "end": s.end, "text": s.text}
            for s in segments
        ]
        return rows, info.language
Primo contratto: accettare un segnale utilizzabile
validate_audio() richiede un array NumPy monodimensionale, non vuoto, la cui lunghezza non superi 16000 * 60, cioè 960.000 campioni. Con la frequenza prevista di 16 kHz, corrisponde a un massimo di 60 secondi. np.isfinite(audio).all() richiede poi che tutti i valori siano finiti.
Un array pieno di zeri non è un array vuoto. Rappresenta una durata di silenzio e supera questi controlli. Una lista Python, un array bidimensionale, un array senza valori o un segnale che contiene NaN viene invece rifiutato.
C'è una sfumatura importante: questo validatore non verifica da solo la frequenza di campionamento. Riceve soltanto un array di numeri, senza metadati che gli permettano di sapere se tali numeri rappresentano 16.000 o 48.000 campioni al secondo. La decodifica e la preparazione devono quindi avere realmente prodotto il segnale mono a 16 kHz atteso.
Potete avvicinare questo punto a un valore monetario ricevuto da un'API: il numero 100 non consente di indovinarne la valuta. Allo stesso modo, la lunghezza di un array audio non basta a conoscerne la durata senza frequenza di campionamento. Il decoder di faster-whisper 1.2.1 mostra la conversione mono e il ricampionamento; queste operazioni precedono il contratto che leggiamo qui.
Secondo contratto: caricare il modello previsto, nel posto giusto
Il costruttore Transcriber.__init__() verifica che CTranslate2 veda esattamente una GPU CUDA. Questo vincolo riguarda ciò che è esposto al contenitore: la macchina può avere fisicamente più schede.
Carica quindi il modello da /models/whisper. L'impostazione local_files_only=True vieta di completare silenziosamente il modello con un download durante il caricamento. Se mancano i file necessari, bisogna correggere l'acquisizione, non sperare che l'inferenza li recuperi.
device="cuda" e compute_type="float16" mantengono il percorso di calcolo scelto. cpu_threads=4 fissa i thread CPU del motore; non trasforma questa esecuzione in inferenza CPU.
Terzo contratto: trattare il silenzio prima del riconoscimento
In transcribe(), la convalida precede ogni decisione. Il programma calcola poi np.max(np.abs(audio)): la massima ampiezza in valore assoluto sull'intero estratto.
Se questo valore è strettamente inferiore a 1e-5, cioè 0,00001, e se guard_silence è attivo, il valore restituito è subito ([], "fr"). In questo ramo non c'è alcuna chiamata a self.model.transcribe().
Non è né una media del volume né una ricerca di parlato. Basta un singolo picco di rumore sopra la soglia per non attivare questa protezione. Al contrario, un parlato i cui campioni restassero tutti sotto la soglia verrebbe scartato. Sono conseguenze della regola scritta nel codice, non misure aggiuntive del corpus r3.
La pipeline può quindi restituire un output vuoto corretto su un silenzio grazie al controllore, senza che il modello abbia riconosciuto alcunché. Manterremo questa distinzione nell'interpretare il test negativo.
Perché convertire i segmenti in lista?
Il risultato segments è un generatore Python: i suoi elementi vengono prodotti man mano che viene percorso. Ricevere questo oggetto non significa che tutto il lavoro di trascrizione sia terminato.
Pensate a un cursore di database: ottenere il cursore e percorrerne tutte le righe non sono la stessa operazione. Qui, la list comprehension percorre interamente il generatore e conserva, per ogni segmento, start, end e text.
Questo è essenziale per la misurazione del tempo. Il cronometro posto attorno a questa chiamata non deve fermarsi alla sola creazione del generatore; il consumo completo permette di misurare la trascrizione dell'estratto fino in fondo. La documentazione ufficiale di faster-whisper sottolinea questo comportamento.
Sul primo file viene eseguito un warm-up, cioè un passaggio di riscaldamento, prima delle 20 misure. Prepara l'esecuzione senza rientrare nelle durate misurate. Anche il caricamento del modello resta fuori dall'RTF che calcoleremo, ma fa parte del tempo completo necessario per eseguire il percorso.
Avviare e leggere la prima trascrizione
docker compose run --rm --no-deps app -m src.cli transcribe
Il comando scrive un oggetto per estratto in outputs/transcription.json e crea i 20 file SRT. Ogni oggetto conserva il testo unito, i segmenti grezzi, i segmenti destinati a SRT, la durata audio, il tempo di inferenza e la lingua.
Nelle osservazioni r3, il primo file restituisce il testo esatto del suo riferimento, con un segmento da 0,000 a 3,720 secondi per un audio di 4,440 secondi. Il segmento non deve occupare tutta la durata del file: la nostra politica gli vieta di sforare, non gli impone di finire all'ultimo campione.
Un'altra sfumatura di lettura: poiché abbiamo fornito language="fr", ritrovare fr negli output non è una convalida indipendente del rilevamento della lingua. Nel ramo del silenzio, questa stringa viene persino restituita direttamente dal nostro codice.
Produrre un SRT senza mascherare i segmenti grezzi
Che aspetto ha un sottotitolo?
Un file SRT contiene blocchi composti da un numero, un intervallo nel formato hh:mm:ss,mmm --> hh:mm:ss,mmm, poi il testo. Ecco la forma corrispondente al testo e alle marcature temporali del primo estratto riportati sopra; è una formattazione di questo esempio, non un nuovo risultato di inferenza:
1
00:00:00,000 --> 00:00:03,720
Le groupe Aerosmith a annulé les derniers concerts de sa tournée.
Il numero identifica il sottotitolo. I due tempi indicano quando visualizzarlo e quando rimuoverlo. La virgola separa i secondi dai millisecondi: 03,720 significa 3 secondi e 720 millisecondi.
Conservare la sorgente, poi applicare una politica di output
I segmenti del modello possono sovrapporsi o superare la durata dell'audio. Il progetto conserva prima raw_segments, poi costruisce segments con una regola esplicita: nessun inizio prima della fine del precedente segmento conservato, inizio e fine delimitati dalla durata reale, eliminazione dei segmenti ridotti a durata nulla.
Non è una correzione del riconoscimento. È una trasformazione dell'output, paragonabile alla preparazione di un oggetto per la visualizzazione, mantenendo al contempo il dato originario per capire cosa è cambiato.
"""Politique de sortie SRT : conserver le brut et borner à la durée audio."""
import math


def bounded_segments(rows, duration):
    if not math.isfinite(duration) or duration <= 0:
        raise ValueError("Durée positive requise")
    result = []
    previous = 0
    for row in rows:
        start, end = row["start"], row["end"]
        if (
            not all(math.isfinite(value) for value in (start, end))
            or not 0 <= start <= end
        ):
            raise ValueError("Segment invalide")
        start = min(duration, max(previous, start))
        end = min(duration, max(start, end))
        if end > start:
            result.append({"start": start, "end": end, "text": row["text"]})
            previous = end
    return result


def stamp(seconds):
    milliseconds = round(seconds * 1000)
    return f"{milliseconds // 3600000:02d}:{milliseconds // 60000 % 60:02d}:{milliseconds // 1000 % 60:02d},{milliseconds % 1000:03d}"


def to_srt(rows):
    return "\n\n".join(
        f'{i}\n{stamp(row["start"])} --> {stamp(row["end"])}\n{row["text"].strip()}'
        for i, row in enumerate(rows, 1)
    )
Leggere le due delimitazioni riga per riga
bounded_segments() inizia rifiutando una durata audio non finita o minore o uguale a zero. Per ogni segmento, verifica poi che i tempi siano finiti e che 0 <= start <= end. Un inizio negativo o una fine precedente all'inizio provoca quindi un errore: il codice non ripara silenziosamente tutti gli input possibili.
previous memorizza la fine dell'ultimo segmento conservato. In max(previous, start), l'inizio viene spostato se necessario per evitare una sovrapposizione. min(duration, ...) impedisce poi che questo inizio superi la fine dell'audio.
Per la fine, max(start, end) impedisce di terminare prima del nuovo inizio, poi min(duration, ...) applica nuovamente il limite audio. Il segmento viene aggiunto solo se end > start dopo queste trasformazioni.
La funzione segue l'ordine ricevuto: non ordina i segmenti. Produce inoltre una nuova lista, lasciando le righe grezze disponibili separatamente.
Un esempio calcolabile a mano
I tre segmenti seguenti sono fittizi, costruiti unicamente per comprendere la funzione. Prendiamo un audio di 4,44 secondi:
| Segmento | Intervallo grezzo, in secondi | Dopo la delimitazione | Spiegazione |
|---|---|---|---|
| A | 0,00 → 3,00 | 0,00 → 3,00 | È già entro i limiti. |
| B | 2,80 → 4,80 | 3,00 → 4,44 | L'inizio viene spostato dopo A; la fine viene riportata alla durata audio. |
| C | 4,80 → 5,10 | Eliminato | Entrambi i limiti diventano 4,44; la sua durata diventa nulla. |
Il sottotitolo B è ora nell'intervallo autorizzato. Eppure la sua prima parola potrebbe essere stata pronunciata prima di 3,00 secondi. Un vincolo temporale soddisfatto non dimostra quindi che il testo sia ben sincronizzato.
Il testo di C scompare dall'SRT poiché questa regola non può assegnargli alcun intervallo positivo. I suoi dati grezzi restano disponibili per l'analisi: questa rimozione non deve sembrare un riconoscimento migliore.
Formattare i tempi non basta a convalidarli
stamp() converte i secondi in millisecondi con round(), poi li distribuisce in ore, minuti, secondi e millisecondi. to_srt() numera i segmenti a partire da 1, scrive gli intervalli e rimuove gli spazi superflui alle estremità del testo con strip(). Non corregge le parole.
La delimitazione lavora in secondi prima dell'arrotondamento al millisecondo. Due tempi molto vicini possono quindi essere visualizzati allo stesso modo dopo l'arrotondamento. Per esempio, i limiti didattici 1,0001 e 1,0004 secondi diventano entrambi 00:00:01,000. Questo esempio di precisione non fa parte degli sforamenti r3 osservati; mostra perché la funzione non è un validatore completo di sottotitoli.
Il programma non garantisce né il sincronismo parola per parola, né una durata di lettura confortevole, né un numero di caratteri adatto a ogni riga. Aprite outputs/0.srt in un lettore o un editor, poi confrontatelo con l'audio. Un file leggibile da un lettore e sottotitoli piacevoli da seguire restano due obiettivi distinti.
Comprendere le metriche prima dei risultati
Misureremo due cose diverse: lo scarto tra il testo atteso e quello ottenuto, poi il tempo necessario per ottenere questo testo. Un programma può essere rapido e sbagliarsi; può anche trascrivere correttamente producendo sottotitoli mal sincronizzati. Nessuna di queste dimensioni sostituisce le altre.
Il WER: contare gli errori di parola
Il WER, ovvero word error rate, è un tasso di errore sulle parole. Per calcolarlo, il progetto usa la distanza di Levenshtein: il numero minimo di inserimenti, eliminazioni e sostituzioni necessari per passare dal riferimento all'ipotesi.
Una sostituzione rimpiazza una parola con un'altra. Un'eliminazione fa sparire una parola attesa. Un inserimento aggiunge una parola assente dal riferimento. Il calcolo cerca un allineamento che minimizzi il totale: non confronta semplicemente la prima parola con la prima, poi la seconda con la seconda. Altrimenti, una sola parola aggiunta all'inizio potrebbe far credere che tutto il seguito sia errato.
La formula è:
WER = (sostituzioni + inserimenti + eliminazioni) / numero di parole di riferimento.
Prendiamo questo riferimento didattico di quattro parole, senza legame con le misure FLEURS: «il pacco arriva domani».
| Ipotesi | Scarto minimo | WER |
|---|---|---|
| «il pacco arriva domani» | Nessun errore | 0 / 4 = 0 % |
| «il pacco arriva lunedì» | Una sostituzione | 1 / 4 = 25 % |
| «il pacco arriva» | Un'eliminazione | 1 / 4 = 25 % |
| «il pacco arriva proprio domani» | Un inserimento | 1 / 4 = 25 % |
Il denominatore resta quattro, anche quando l'ipotesi contiene cinque parole. Si divide per la lunghezza del riferimento, non per quella della risposta prodotta.
Il WER può persino superare 1, dunque il 100%. Con il riferimento didattico «ciao» e l'ipotesi «ciao a tutta la famiglia», occorrono quattro inserimenti per una sola parola di riferimento: il WER vale 4. Non è un errore di percentuale; la formula conta operazioni rapportate al riferimento.
Quali parole vengono confrontate esattamente?
Prima di contare, il progetto normalizza i testi in NFKC, li trasforma in minuscolo ed estrae le sequenze Unicode di caratteri di parola. NFKC è una normalizzazione delle rappresentazioni Unicode; non è né una traduzione né un correttore ortografico. La punteggiatura non conta più in questo confronto.
Per esempio, i testi didattici «ÉTÉ !» e «été» danno la stessa unità été. L'accento resta presente, ma la maiuscola e il punto esclamativo non distinguono più i due testi. Il WER così calcolato non misura quindi la qualità della punteggiatura.
Allo stesso modo, «L'estate è finita!» si scompone in l, estate, è, finita. Gli apostrofi separano le unità: le «parole» di questa metrica sono definite da questa regola, non soltanto dagli spazi visibili nella frase.
La documentazione Python sulla normalizzazione Unicode e sulle classi di caratteri delle espressioni regolari permette di approfondire queste due operazioni. Per riprodurre le cifre r3, mantenete la regola dell'archivio: modificare la normalizzazione cambia ciò che il punteggio misura.
Perché un WER «micro» invece di una media delle frasi?
Il WER micro somma tutti gli errori e tutte le parole di riferimento, poi esegue una sola divisione. Non attribuisce lo stesso peso a una frase di due parole e a una frase di venti parole.
Ecco un calcolo didattico, distinto dai 20 estratti: una frase di 2 parole ha 1 errore, e una frase di 8 parole ha anch'essa 1 errore. I rispettivi WER sono 50% e 12,5%.
La media semplice dei due tassi è (50 % + 12,5 %) / 2 = 31,25 %. Il WER micro è invece (1 + 1) / (2 + 8) = 20 %.
I due calcoli descrivono gli stessi errori, ma rispondono a domande diverse. La media per frase attribuisce lo stesso peso a ogni frase; il micro rapporta l'insieme degli errori all'insieme delle parole attese. È questo secondo calcolo che leggeremo per r3.
L'RTF: rapportare il tempo di calcolo alla durata sonora
L'RTF, o real-time factor, si calcola così:
RTF = tempo di trascrizione / durata audio.
In un esempio didattico, trascrivere 10 secondi di audio in 0,25 secondi dà 0,25 / 10 = 0,025. Il tempo di trascrizione rappresenta allora il 2,5% della durata sonora, cioè un'elaborazione 40 volte più rapida della durata di riproduzione di questo estratto. Un RTF inferiore a 1 significa che il calcolo richiede meno tempo della durata dell'audio.
Attenzione all'unità: 0,025 non è una durata di 25 millisecondi. È un rapporto senza unità. Per ritrovare il tempo di trascrizione, occorre moltiplicarlo per la durata audio interessata.
Questo non descrive nemmeno la latenza completa di un'applicazione: l'invio del file, la coda, il caricamento del modello e le altre operazioni non sono tutti inclusi nella durata di inferenza usata qui. Trascrivere un file più rapidamente della sua durata non dimostra che sia stato costruito o testato un servizio di trascrizione in tempo reale.
RTF medio e RTF ponderato: ancora due calcoli diversi
L'RTF medio calcola l'RTF di ogni estratto, poi fa la media di questi rapporti. L'RTF ponderato divide il tempo totale di inferenza per la durata audio totale: gli estratti pesano quindi secondo la loro durata sonora.
Per un secondo esempio didattico, prendiamo due estratti: il primo dura 2 secondi e richiede 0,2 secondi di trascrizione; il secondo dura 8 secondi e richiede 0,4 secondi. I rispettivi RTF sono 0,10 e 0,05.
La media per estratto è (0,10 + 0,05) / 2 = 0,075. Il rapporto dei totali è (0,2 + 0,4) / (2 + 8) = 0,06. È quindi normale che i due valori non siano uguali. Nessuno corregge l'altro: semplicemente non attribuiscono lo stesso peso agli estratti.
Produrre i controlli e il riepilogo
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
negatives verifica gli input non validi e conserva l'osservazione sul silenzio. Un caso negativo è una prova in cui si attende un rifiuto o un comportamento particolare, anziché una trascrizione ordinaria.
evaluate scrive outputs/evaluation.json con WER, RTF e sforamenti grezzi delle marcature temporali. Leggete questi output insieme ai testi e ai segmenti: il riepilogo fornisce riferimenti, non una spiegazione automatica di ogni errore.
Risultati osservati, poi la loro portata
Cosa hanno misurato le due riproduzioni
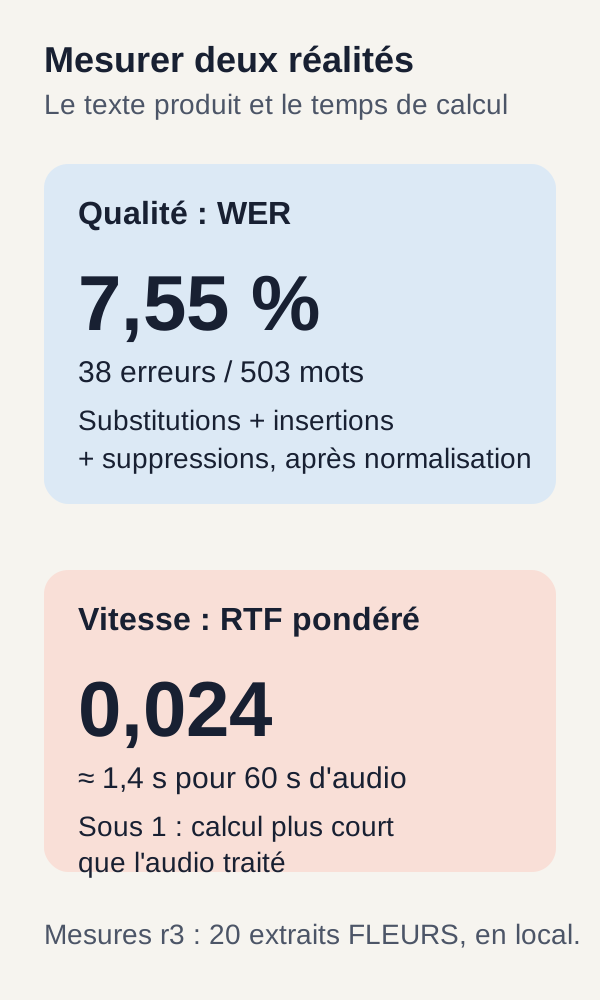
Le due riproduzioni r3 hanno ottenuto esattamente 38 errori su 503 parole di riferimento, cioè un WER micro di 0,07554671968190854, circa 7,55%. Si tratta del totale delle operazioni di modifica calcolate dopo la normalizzazione, non di 38 file errati né di un voto dato dal modello.
| Indicatore | Riproduzione 1 | Riproduzione 2 |
|---|---|---|
| Estratti trascritti e valutati | 20 | 20 |
| Parole di riferimento | 503 | 503 |
| Errori di parola | 38 | 38 |
| WER micro, arrotondato | 7,55 % | 7,55 % |
| Sforamenti grezzi delle marcature temporali, prima della delimitazione | 2 | 2 |
| RTF medio per estratto | 0,02587 | 0,02565 |
| RTF ponderato per durata audio | 0,02396 | 0,02379 |
| Massimo VRAM osservato tramite campionamento | 1 056 Mio | 1 024 Mio |
Queste misure sono state prese su una RTX 3090. La VRAM è stata campionata circa una volta al secondo: i valori della tabella sono i massimi osservati in quegli istanti, non una misurazione continua del picco reale. Non permettono quindi di dedurre una memoria video minima garantita per tutte le esecuzioni.
Il modello è stato acquisito da zero in ogni directory di riproduzione. Tuttavia, i layer Docker pubblici potrebbero essere stati riutilizzati. «Directory nuova» non significa che tutte le cache della macchina fossero state svuotate.
Un punteggio globale non dice dove si trova l'errore importante
Un WER del 7,55% non significa che il 92,45% delle registrazioni sia interamente corretto. Non permette nemmeno di concludere che tutti i nomi o tutti i numeri siano affidabili. È un rapporto globale di errori di parole sulla popolazione valutata.
Un errore su un nome, un numero o una negazione può avere un'importanza professionale molto maggiore di un altro errore, mentre il calcolo gli attribuisce lo stesso costo. Per usare una trascrizione in un'applicazione, occorre quindi rileggere gli elementi che determinano un'azione, non soltanto guardare il tasso medio.
Il corpus contiene pochi estratti, più ripetizioni di frasi e nessun test rappresentativo della vostra acustica. Queste cifre descrivono questo corpus e questo protocollo; non sono una garanzia sui vostri file.
Il silenzio rivela il ruolo del controllore
Il controllo del silenzio fornisce un'osservazione particolarmente istruttiva: senza la protezione, il modello ha prodotto una frase; con la protezione, la lista dei segmenti è vuota.
Questo risultato non significa che il modello sia diventato migliore tra le due prove. La protezione ha semplicemente impedito la sua chiamata. Una frase plausibile prodotta sul silenzio è proprio il tipo di risultato che si rischia di non notare verificando soltanto gli output che «sembrano corretti».
I due sforamenti grezzi delle marcature temporali illustrano un altro limite: l'elaborazione SRT inquadra dei tempi, ma non dimostra né un riconoscimento migliore né un migliore allineamento con il parlato.
Cosa abbiamo imparato
Ora sappiamo seguire un file audio fino a tre risultati distinti: il testo riconosciuto, i sottotitoli formattati e le misure che permettono di esaminarli.
L'affidabilità di questa pipeline comincia da contratti ordinari di sviluppo: un input delimitato, file modello verificati, una GPU scelta esplicitamente e una traccia degli output grezzi. Il modello esegue il riconoscimento; il controllore può rifiutare un input o interrompere un silenzio; il codice SRT applica vincoli temporali. Non sono le stesse responsabilità.
Il WER dipende dal riferimento e dalla normalizzazione. L'RTF dipende dal tempo misurato e dalla durata sonora. Comprendere i loro denominatori evita di trasformare un risultato utile in una conclusione troppo generale.
Le riproduzioni r3 dimostrano questo percorso su 20 estratti FLEURS. Non dimostrano né una qualità universale di trascrizione né un servizio pronto a ricevere dati di produzione.
Esercizio: prevedere, modificare, eseguire, osservare, spiegare
Prevedere prima di guardare il risultato
Torniamo al primo estratto: «Il gruppo Aerosmith ha annullato gli ultimi concerti del suo tour.» Dopo la normalizzazione del progetto, il suo riferimento contiene 11 parole, e l'ipotesi iniziale è esatta.
Prevedete cosa succede se si aggiunge la parola intrus a questa ipotesi. Quale tipo di errore compare? Il denominatore del WER passa a dodici perché la risposta è diventata più lunga? È il modello che state modificando?
Scrivete la vostra risposta prima di eseguire l'esercizio. Ci aspettiamo un inserimento, ma spetta al programma ricalcolare l'allineamento: non aggiungete arbitrariamente 1 a una misura senza rifare il confronto.
Eseguire la modifica prevista
docker compose run --rm --no-deps app -m src.cli exercise
Il comando svolge l'esercizio previsto nel progetto. Serve a osservare l'effetto di una modifica dell'ipotesi sulla metrica, non a insegnare una nuova frase al modello.
Osservare, poi spiegare
L'output r3 riporta original_errors: 0, modified_errors: 1 e reference_words: 11.
Il riferimento non è cambiato: il denominatore resta quindi undici. Per questa sola frase modificata, il calcolo dà 1 / 11, cioè circa 9,09%. Questo calcolo didattico non sostituisce il WER globale del 7,55% del corpus di riferimento.
L'esperimento verifica il significato della metrica. Non misura un peggioramento spontaneo del modello: siamo noi ad aver aggiunto volontariamente una parola al testo valutato, senza modificarne i pesi.
La vostra esperienza, senza risultato annunciato in anticipo
Ora potete preparare un esperimento separato con un audio di cui possedete i diritti e una trascrizione di riferimento riletta. Non sovrascrivete né data/audio.json né i file di prova r3. Copiate il progetto in una nuova cartella e conservate separatamente i risultati di riferimento.
Documentate prima la durata, la lingua, le condizioni acustiche, il testo di riferimento e i parametri usati. Un messaggio registrato in un ambiente tranquillo e una conversazione registrata a distanza non pongono lo stesso problema, anche se sono entrambi in francese.
I comandi presentati seguono un manifesto e un'acquisizione bloccati. Non costituiscono da soli una procedura d'importazione di qualsiasi file personale. Per la vostra copia sperimentale, esaminate nel progetto completo come il file viene acquisito, decodificato e associato al suo riferimento, quindi adattate esplicitamente questo percorso e i relativi controlli. Non sostituite silenziosamente i file acquisiti con le loro impronte originali.
Riprendete poi la stessa logica: preparare, trascrivere, controllare e valutare. Confrontate manualmente l'audio, il riferimento, il JSON grezzo e l'SRT. Un output corretto dal punto di vista sintattico non deve dispensare da questo ascolto.
Non annunciate alcun punteggio prima della misurazione. Se cambiate il modello, beam_size, la VAD, il ritaglio o il corpus, avete creato un nuovo esperimento. Per studiare l'effetto di un parametro, mantenete identiche le altre condizioni; per cambiare corpus, stabilite un nuovo riferimento di confronto. Le cifre r3 non descrivono automaticamente questa variante.
Per registrazioni lunghe, occorrerà definire un ritaglio, un'eventuale sovrapposizione, una strategia di concatenazione e una valutazione specifica. Per esempio, i tempi di un segmento trascritto in una porzione dovranno essere ricollocati sulla cronologia della registrazione completa. Questa estensione resta da costruire e misurare: limitarsi ad alzare il limite di 60 secondi non basta a convalidarla.
Risoluzione mirata dei problemi
nvidia-smi absent. Installate o riparate il driver NVIDIA, poi rilanciate il preflight. Lo script di controllo non esegue questa installazione al posto vostro.
La GPU è visibile su Linux, ma non in Docker. Installate o configurate NVIDIA Container Toolkit. Il contenitore diagnostico deve vedere esattamente una scheda, quella selezionata da GPU_DEVICE.
fetch fallisce. Controllate la connessione e leggete l'errore di acquisizione. Non disattivate le verifiche di dimensione o SHA-256 per proseguire: un download parziale o diverso dal file atteso non costituisce il modello bloccato dell'esperimento.
GPU CUDA requis o fallimento dei test CUDA. Verificate GPU_DEVICE, il driver, la configurazione Docker e l'esecuzione completa di fetch. Mantenete i parametri del percorso invece di passare silenziosamente a un altro motore o alla CPU.
Un audio viene rifiutato. Distinguete il file decodificato dall'array atteso da validate_audio(). Un input vuoto, non mono, non finito o superiore a 60 secondi nel formato previsto viene rifiutato prima del modello. Il messaggio Image modifiée, incontrato nel tutorial OCR, non riguarda questa pipeline audio.
L'SRT sembra mal sincronizzato. Confrontate raw_segments e segments, poi ascoltate il passaggio. La delimitazione può accorciare un intervallo o rimuovere un segmento; non può correggere un testo mal riconosciuto né inventare i corretti istanti di pronuncia.
Passare da un tutorial a un servizio
Le elaborazioni audio da completare
Un servizio deve gestire esplicitamente le durate lunghe, i formati accettati, i canali, il rumore, gli accenti e le lingue necessarie al suo uso. Deve anche scegliere e valutare una politica VAD invece di considerare la nostra sola soglia di ampiezza come un rilevamento generale del parlato.
Vanno distinti altri due bisogni. La diarizzazione cerca di attribuire gli interventi a parlanti distinti: chi parla in quale momento, senza necessariamente conoscere il nome delle persone. L'allineamento cerca di posizionare il testo, eventualmente parola per parola, sulla cronologia sonora. Una buona trascrizione non risolve automaticamente questi due problemi.
Per i sottotitoli, resta anche da definire regole di lunghezza delle righe e di comfort di lettura. Il codice di questo tutorial si concentra su una politica temporale esplicita, non su una sottotitolazione definitiva per tutti gli schermi e tutti i pubblici.
Restano presenti le responsabilità abituali di un'applicazione web
Un'acquisizione controllata, un'API autenticata, diritti di accesso, quote, una coda di lavori e tempi di esecuzione devono essere progettati attorno alla trascrizione. Un basso RTF locale non basta a decidere che ogni elaborazione possa rimanere collegata a una richiesta HTTP sincrona.
Occorre anche prevedere log e supervisione utili, cifratura adatta al contesto, una politica di conservazione e procedure di cancellazione o ripristino. Conservare i file sulla propria macchina evita di inviarli al servizio esterno dello scenario, ma non gestisce da solo i diritti sugli audio e sulle trascrizioni.
Misurare la qualità professionale e il carico reale
La qualità professionale richiede un corpus rappresentativo e riletto, ripartito secondo le condizioni audio importanti per la vostra applicazione, oltre a regole di revisione umana. Numeri e nomi meritano in particolare verifiche proprie dell'uso previsto.
La media locale dell'RTF non fornisce né una portata sotto carico né una latenza p95 o p99. Questi percentili descrivono le durate entro cui rientrano rispettivamente il 95% o il 99% delle richieste di un insieme misurato. Per conoscerli, bisogna misurare molte richieste nelle condizioni di concorrenza e attesa del servizio.
Questi meccanismi di produzione non sono né implementati né convalidati da questo archivio. Il tutorial permette di imparare e riprodurre la pipeline locale; aggiungerli richiederebbe un'altra fase di sviluppo e valutazione.
Pulire esattamente ciò che è stato avviato
Quando avete finito di consultare gli output, fermate i servizi del progetto dalla radice dell'archivio:
docker compose down
Questo comando è anche l'ultima fase delle riproduzioni r3. Arresta le risorse Compose di questa cartella; non elimina i modelli acquisiti, l'immagine costruita né gli output conservati sul disco.
Conservate outputs/ per poter rileggere i risultati e confrontarli. Non eliminate le vostre cartelle di prova prima di averne verificato il contenuto; non è necessaria alcuna pulizia globale degli altri progetti Docker.
Riferimenti per approfondire
Per comprendere le risorse usate, consultate la scheda FLEURS e la scheda Systran/faster-whisper-small. Descrivono il corpus e il modello; le revisioni e i file da acquisire per questo esperimento restano quelli bloccati nell'archivio.
Per seguire i meccanismi, la documentazione ufficiale di faster-whisper presenta l'API e il comportamento del generatore. Il codice di trascrizione della versione 1.2.1 dettaglia i parametri, mentre il decoder della stessa versione mostra la preparazione audio. Questi riferimenti spiegano meccanismi; non estendono i risultati misurati r3 ad altre impostazioni.
Per l'ambiente e i calcoli, la documentazione dei tipi numerici CTranslate2, la guida NVIDIA Container Toolkit e la documentazione Unicode di Python 3.12 completano le spiegazioni. Mantenete le versioni e i comandi dello ZIP per riprodurre r3, anche se una documentazione generale mostra altre possibilità.