





Imagine una función bastante habitual en una aplicación web: una persona sube una grabación de audio y quiere recuperar su texto, acompañado de subtítulos. Ya sabe recibir un archivo, ejecutar un proceso y devolver un resultado. Lo nuevo consiste en transformar una voz en palabras sin enviar la grabación a un servicio externo.
Podríamos limitarnos a llamar a un modelo y mostrar su respuesta. Pero ¿cómo saber si el texto corresponde realmente a lo que se dijo? ¿Qué hacer cuando un subtítulo rebasa el final del audio? ¿Y qué significa exactamente «transcribir más rápido que el tiempo real»?
En este tutorial construiremos una cadena local con Python y Docker, y responderemos a estas preguntas mediante código y observaciones. Transcribe 20 fragmentos franceses del conjunto FLEURS con faster-whisper y un modelo Whisper convertido para CTranslate2, en una GPU CUDA. Al final tendrá outputs/transcription.json, 20 archivos SRT y un informe outputs/evaluation.json.
El escenario de aplicación web sirve como punto de partida: el archivo proporciona procesamiento por línea de comandos, no un formulario de carga ni una API de producción. Usaremos un modelo ya entrenado; no es necesario ningún entrenamiento para seguir este recorrido.
El proyecto completo está disponible en el archivo Descargar el proyecto completo del tutorial. Los resultados presentados proceden de dos reproducciones r3 de este archivo en directorios nuevos. Los pequeños ejemplos añadidos para explicar los cálculos se identifican como pedagógicos: no sustituyen dichas mediciones.
Lo que va a construir
Del archivo recibido a un resultado verificable
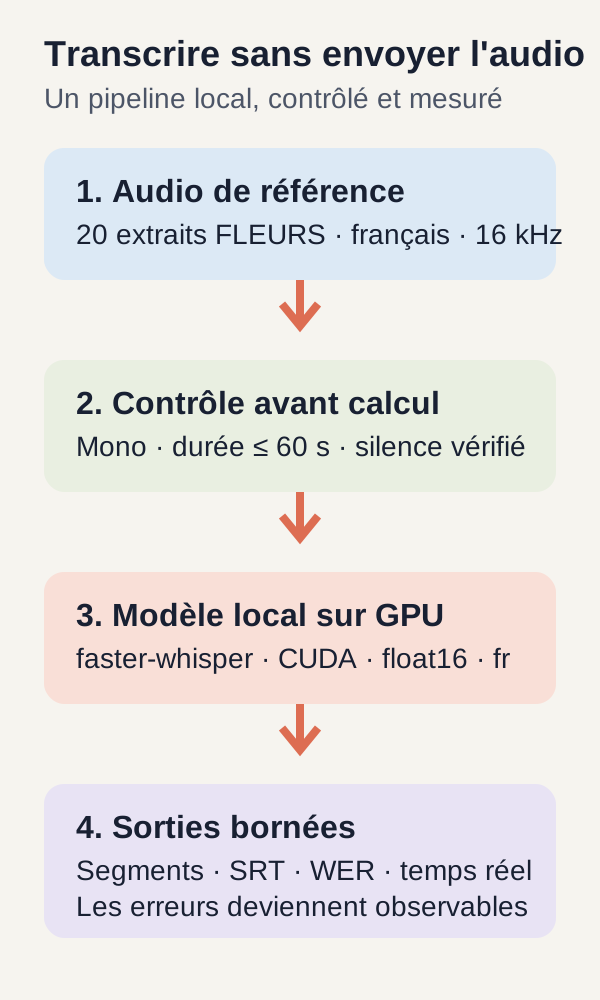
El programa parte de un archivo WAV. Lo decodifica como una serie de valores numéricos, prepara una señal mono de 16 000 muestras por segundo, verifica esa señal y después llama al modelo local. El modelo devuelve fragmentos de texto asociados a tiempos de inicio y final: son los segmentos.
Para un desarrollador web, la estructura resulta familiar: decodificar la entrada, validar su contenido, llamar a un componente y serializar la respuesta. La diferencia es que el componente de reconocimiento puede equivocarse incluso cuando todas las validaciones técnicas tienen éxito.
Por tanto, conservaremos dos representaciones. Los segmentos en bruto muestran lo que el motor de transcripción devolvió realmente. Una segunda lista aplica reglas temporales para generar los subtítulos SRT. Por último, el texto se compara con una transcripción de referencia y el tiempo de cálculo se relaciona con la duración del audio.
Los archivos que debe tener a la vista
| Salida | Lo que permite comprobar |
|---|---|
outputs/prepared.json |
Los 20 fragmentos preparados y su duración. |
outputs/transcription.json |
El texto reconocido, los segmentos en bruto y acotados, el idioma y las duraciones medidas. |
Los 20 archivos .srt de outputs/ |
Los subtítulos que puede abrir, releer y comparar con el audio. |
outputs/evaluation.json |
Los errores de transcripción, la velocidad relativa y los rebasamientos temporales en bruto. |
Un archivo de subtítulos mejor acotado no es una transcripción más exacta. Acortar un segmento que rebasa el final del audio no corrige ninguna palabra. Esta separación entre reconocimiento, presentación y evaluación es el hilo conductor del artículo.
Requisitos exactos
Lo que debe conocer
Debe poder leer una función de Python, manejar listas y diccionarios, abrir JSON y ejecutar comandos Docker. No se presupone ningún conocimiento previo de procesamiento de audio: las nociones necesarias se explicarán cuando se utilicen.
El equipo previsto para la experiencia
El recorrido validado se dirige a Linux amd64, es decir, la arquitectura x86_64, con Docker Engine, el complemento Docker Compose, un controlador NVIDIA operativo, nvidia-smi y NVIDIA Container Toolkit. Este último permite que Docker exponga al contenedor la GPU seleccionada y los componentes necesarios del controlador.
La inferencia se ejecuta únicamente en CUDA, el entorno de cálculo usado aquí para la tarjeta NVIDIA, con el tipo numérico float16. El proyecto no anuncia una vía de inferencia por CPU. Esto no significa que el procesador de la máquina no trabaje nunca: la preparación de los archivos y el resto del programa siempre lo necesitan.
Debe exponerse una sola tarjeta al contenedor. En una máquina con varias GPU, defina GPU_DEVICE en el archivo .env suministrado antes de la primera ejecución si la tarjeta 0 no es la que desea utilizar. No distribuimos esta transcripción entre varias tarjetas.
Se necesitan al menos 20 Gio libres en el disco del proyecto y en el almacenamiento Docker, así como 12 Gio de RAM disponibles. El contenedor limita la aplicación a 8 Gio de memoria, 4 CPU, 256 procesos y un /tmp de 512 Mio. La RAM es la memoria de la máquina; la VRAM, que observaremos en los resultados, es la de la GPU.
Estos valores son condiciones comprobadas por el script o límites del contenedor. No son mínimos de hardware demostrados para todas las tarjetas CUDA.
Comprobar antes de descargar
Tras extraer el ZIP, sitúese en la raíz del proyecto. El preflight es simplemente una comprobación previa: verifica Docker, Compose, la GPU elegida, el acceso a CUDA desde un contenedor, la RAM y el espacio de disco. No instala nada ni reconfigura su máquina.
./scripts/preflight.sh
Cuando tiene éxito, la última línea indica PREFLIGHT=PASS. Si la tarjeta es visible con nvidia-smi en Linux pero no aparece en Docker, configure NVIDIA Container Toolkit siguiendo su guía oficial, y vuelva a ejecutar la comprobación.
No continúe con una GPU distinta de la que cree utilizar. Una tarjeta visible en el host y una tarjeta realmente accesible para el programa dentro del contenedor son dos comprobaciones diferentes.
Los datos antes que el modelo
Una referencia conocida, como en una prueba automatizada
Para evaluar una transcripción, hay que disponer de lo que debería haberse escrito. Esta frase esperada es la referencia. El texto producido por el modelo se llamará la hipótesis: este término no designa una opinión, sino la transcripción candidata que vamos a comparar con la referencia.
El archivo data/audio.json describe exactamente 20 archivos del split de prueba francés de FLEURS. Un split es una división de un conjunto de datos. Aquí usamos los archivos de prueba para observar un modelo ya entrenado, no para enseñarle esas frases.
Cada entrada proporciona un identificador estable, un nombre de archivo WAV, un número de muestras de audio y la frase de referencia. Esta es la primera:
{
  "id": 0,
  "file": "14682302550249108464.wav",
  "samples": 71040,
  "reference": "Le groupe Aerosmith a annulé les derniers concerts de sa tournée."
}
id permite recuperar el mismo fragmento en las salidas. file designa su archivo de audio. reference contiene el texto esperado para la evaluación. En cuanto a samples, cuenta los valores de la señal sonora, no el número de frases ni el número de palabras.
Hallar la duración mediante una división
A 16 000 Hz, un segundo se representa mediante 16 000 valores. La duración del primer archivo es por tanto:
71 040 / 16 000 = 4,44 segundos.
Atención a una pequeña trampa de vocabulario: en esta entrada, samples: 71040 cuenta muestras sonoras. Más adelante, samples: 20 en el informe de preparación cuenta los 20 fragmentos del corpus. El mismo término inglés no designa la misma unidad en ambos contextos.
Los fragmentos son las primeras entradas seleccionadas de la prueba fr_fr de FLEURS. La ficha del conjunto FLEURS describe un corpus centrado en habla leída. Algunas frases tienen varias grabaciones: en nuestra selección, archivos distintos pueden compartir por tanto la misma referencia.
Esto basta para comprender la cadena, pero no para representar todos los acentos, las reuniones, el ruido, los nombres propios o sus contenidos profesionales. Veinte archivos tampoco significan veinte situaciones acústicas independientes y variadas.
Descargar el mismo modelo y los mismos datos
El script de adquisición descarga en revisiones fijadas el modelo Systran/faster-whisper-small y las fuentes FLEURS. Los pesos de un modelo son los valores numéricos aprendidos durante su entrenamiento. Los cargamos para usarlos, sin modificarlos.
Cada archivo esperado se controla por su tamaño y su huella SHA-256 antes de usarlo. La huella desempeña aquí el papel de documento de identidad del contenido: permite comprobar que se trabaja con los bytes esperados. No dice nada sobre la corrección de las futuras transcripciones.
Las fuentes públicas son FLEURS, bajo CC-BY-4.0 y faster-whisper-small de Systran, bajo MIT. Los archivos pesados no se incluyen en el archivo: la primera adquisición validada representa 835 707 397 bytes.
Instalar, adquirir y preparar los datos
Desde la raíz del archivo extraído, después de elegir la GPU, ejecute los comandos siguientes en este orden. Corresponden al inicio del recorrido r3 reproducido realmente. Se repite el preflight para que esta secuencia pueda seguirse desde el comienzo.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app -m src.cli prepare
Comprender qué prepara cada etapa
setup.sh crea los directorios y prepara los permisos para el usuario actual. docker compose build construye la imagen Python 3.12.13 fijada. El bloqueo de dependencias instala, entre otros, faster-whisper 1.2.1, CTranslate2 4.8.2 y PyAV 18.1.0. Son las versiones de la experiencia, no una invitación a sustituirlas por las últimas disponibles.
fetch adquiere explícitamente los recursos públicos. Entre los servicios del proyecto, es el único que dispone de la red bridge prevista para esta adquisición. La aplicación se ejecuta después en una red Docker interna, lee models/ en solo lectura y escribe sus resultados en outputs/. La construcción de la imagen y la descarga inicial de recursos pueden requerir Internet; el procesamiento de los audios es local.
En los comandos run, --rm elimina el contenedor temporal tras su ejecución; no borra los archivos conservados en los directorios montados. --no-deps evita iniciar automáticamente otros servicios. Los argumentos -m src.cli prepare, por ejemplo, se transmiten al Python de la aplicación para ejecutar la etapa solicitada.
Verificar las pruebas y después los datos preparados
Las 18 pruebas públicas preceden a la inferencia del corpus. Cubren, entre otras cosas, los controles de audio, la adquisición fijada, la normalización del texto, Levenshtein, el acotamiento SRT y el acceso a CUDA. Su objetivo no es solo comprobar que puede producirse un texto plausible: también verifican los contratos en los que vamos a apoyarnos.
prepare decodifica los 20 fragmentos y escribe outputs/prepared.json. Este archivo debe indicar samples: 20 y proporcionar la duración de cada archivo. Para el primero, puede comparar esa duración con el cálculo de 4,44 segundos realizado antes.
Una salida textual que parece correcta no demuestra por sí sola que se hayan utilizado el modelo, la GPU o los cálculos de métricas correctos. Los controles técnicos y la lectura del resultado se complementan.
Conceptos útiles antes de leer el código
Una señal de audio es una serie de números
Tras la decodificación, nuestro audio es una matriz numérica. Mono significa que contiene un solo canal. 16 kHz significa que incluye 16 000 muestras por segundo. Puede imaginar una larga serie de mediciones espaciadas regularmente, cuyas variaciones representan la señal sonora.
Esta frecuencia de muestreo no es ni el número de palabras pronunciadas, ni el tono de voz, ni la precisión numérica del modelo. Cuando hablemos de float16, el «16» se referirá a una representación de los números que usa el motor de cálculo, no a los 16 kHz de la grabación.
Antes de la inferencia, el recorrido rechaza una señal vacía, todavía multicanal, que contenga valores no finitos o que supere 60 segundos. Un valor no finito es, por ejemplo, NaN, que representa un resultado numérico indefinido, o un valor infinito. El límite de 60 segundos acota este ejercicio: no constituye una estrategia para procesar una reunión larga.
Whisper, faster-whisper y CTranslate2: ¿qué hace cada uno?
Whisper es el modelo que ha aprendido a relacionar una señal de audio con texto. Produce unidades textuales llamadas tokens, y después segmentos asociados a tiempos. Un token puede ser una parte de palabra: no debe confundirse con la «palabra» que contará nuestra métrica de evaluación.
faster-whisper es la biblioteca Python que controla esta transcripción. CTranslate2 es el motor que ejecuta los cálculos del modelo. PyAV interviene en la decodificación de audio. La ficha del modelo Systran precisa que los archivos utilizados son una conversión de Whisper small para CTranslate2: no construimos un modelo nuevo a partir de los 20 fragmentos.
La palabra inferencia designa simplemente el uso de un modelo ya entrenado para obtener una salida. Aquí hacemos transcripción en francés: buscamos escribir lo que se dice, no resumir el discurso ni traducirlo a otra lengua.
Los ajustes de la experiencia, sin jerga innecesaria
| Ajuste r3 | Lo que significa aquí |
|---|---|
language="fr" |
Se indica francés al motor; no se le pide adivinar el idioma. |
device="cuda" |
El modelo se ejecuta en la GPU NVIDIA expuesta al contenedor. |
compute_type="float16" |
El motor usa su modo de cálculo de media precisión. No es un ajuste del formato de audio. |
beam_size=5 |
La decodificación explora varias secuencias candidatas en vez de conservar una sola ruta en cada etapa. |
vad_filter=False |
El filtro de detección de actividad de voz no está activado. |
condition_on_previous_text=False |
El texto de una ventana de audio anterior no se proporciona como contexto a la siguiente. |
La búsqueda en haz puede imaginarse como la exploración de varios comienzos de frase antes de conservar una secuencia. beam_size=5 no significa que se devolverán cinco transcripciones finales ni que se utilizarán cinco GPU. Modificar este parámetro puede cambiar el coste y el resultado; conservamos su valor r3.
El ajuste condition_on_previous_text se refiere a las ventanas procesadas dentro de la transcripción. No es una memoria de conversación que conecte entre sí los 20 archivos. El código documentado de faster-whisper 1.2.1 detalla estos parámetros; la documentación de CTranslate2 explica los tipos de cálculo.
Una protección de silencio no es una VAD
La VAD, de voice activity detection, buscaría las partes de la señal que contienen voz. Está desactivada en este recorrido.
En su lugar, el código aplica una regla mucho más sencilla: si la amplitud de toda la señal se mantiene bajo un umbral muy bajo, devuelve una lista vacía antes de llamar al modelo. Esta regla puede detectar un silencio digital casi perfecto. No sabe distinguir una voz, música o ruido cuando se supera el umbral. Veremos exactamente dónde interviene.
Leer el núcleo de la transcripción
Este es el núcleo del programa. Lo leeremos como leeríamos un validador y un servicio de negocio: primero el contrato de entrada, después la carga del componente y por último la llamada que produce el resultado.
"""Whisper local via CTranslate2, CUDA float16, paramètres historiques conservés."""
import numpy as np
import ctranslate2
from faster_whisper import WhisperModel


def validate_audio(audio):
    if (
        not isinstance(audio, np.ndarray)
        or audio.ndim != 1
        or not 0 < len(audio) <= 16000 * 60
    ):
        raise ValueError("Audio mono non vide, de60 secondes maximum à16kHz")
    if not np.isfinite(audio).all():
        raise ValueError("Audio non fini")


class Transcriber:
    def __init__(self):
        if ctranslate2.get_cuda_device_count() != 1:
            raise RuntimeError("Un unique GPU CUDA doit être exposé")
        self.model = WhisperModel(
            "/models/whisper",
            device="cuda",
            compute_type="float16",
            local_files_only=True,
            cpu_threads=4,
        )

    def transcribe(self, audio, guard_silence=True):
        validate_audio(audio)
        if guard_silence and float(np.max(np.abs(audio))) < 1e-5:
            return [], "fr"
        segments, info = self.model.transcribe(
            audio,
            language="fr",
            beam_size=5,
            vad_filter=False,
            condition_on_previous_text=False,
        )
        # The returned generator must be fully consumed before stopping the timer.
        rows = [
            {"start": s.start, "end": s.end, "text": s.text}
            for s in segments
        ]
        return rows, info.language
Primer contrato: aceptar una señal utilizable
validate_audio() exige una matriz NumPy de una dimensión, no vacía, cuya longitud no supere 16000 * 60, es decir, 960 000 muestras. Con la frecuencia prevista de 16 kHz, esto corresponde a un máximo de 60 segundos. Después, np.isfinite(audio).all() exige que todos los valores sean finitos.
Una matriz llena de ceros no es una matriz vacía. Representa una duración de silencio y supera estos controles. En cambio, se rechazan una lista Python, una matriz de dos dimensiones, una matriz sin valores o una señal que contenga NaN.
Hay un matiz importante: este validador no comprueba por sí mismo la frecuencia de muestreo. Solo recibe una matriz de números, sin metadatos que le permitan saber si representan 16 000 o 48 000 muestras por segundo. Por tanto, la decodificación y preparación deben haber producido realmente la señal mono esperada a 16 kHz.
Puede comparar este punto con un importe monetario recibido por una API: el número 100 no permite adivinar su divisa. Del mismo modo, la longitud de una matriz de audio no basta para conocer su duración sin frecuencia de muestreo. El decodificador de faster-whisper 1.2.1 muestra la conversión a mono y el remuestreo; estas operaciones preceden al contrato que leemos aquí.
Segundo contrato: cargar el modelo previsto, en el lugar correcto
El constructor Transcriber.__init__() comprueba que CTranslate2 ve exactamente una GPU CUDA. Esta restricción se refiere a lo expuesto al contenedor: la máquina puede poseer físicamente varias tarjetas.
A continuación carga el modelo desde /models/whisper. El ajuste local_files_only=True prohíbe completar discretamente el modelo con una descarga durante su carga. Si faltan los archivos necesarios, hay que corregir la adquisición, no esperar que la inferencia los recupere.
device="cuda" y compute_type="float16" mantienen la vía de cálculo elegida. cpu_threads=4 fija los hilos de CPU del motor; no convierte esta ejecución en una inferencia por CPU.
Tercer contrato: tratar el silencio antes del reconocimiento
En transcribe(), la validación precede a toda decisión. Después el programa calcula np.max(np.abs(audio)): la mayor amplitud en valor absoluto de todo el fragmento.
Si este valor es estrictamente menor que 1e-5, es decir, 0,00001, y guard_silence está activado, devuelve inmediatamente ([], "fr"). No hay ninguna llamada a self.model.transcribe() en esta rama.
No es ni una media de volumen ni una búsqueda de voz. Un solo pico de ruido por encima del umbral basta para no activar esta protección. A la inversa, se descartaría una voz cuyas muestras permanecieran todas bajo el umbral. Son consecuencias de la regla escrita en el código, no mediciones adicionales del corpus r3.
Por tanto, la cadena puede devolver correctamente una salida vacía ante un silencio gracias al controlador, sin que el modelo haya reconocido nada. Conservaremos esta distinción al interpretar la prueba negativa.
¿Por qué convertir los segmentos en lista?
El resultado segments es un generador Python: sus elementos se producen a medida que se recorren. Recibir este objeto no significa que todo el trabajo de transcripción haya terminado.
Piense en un cursor de base de datos: obtener el cursor y recorrer todas sus filas no son la misma operación. Aquí, la comprensión de lista recorre por completo el generador y conserva, para cada segmento, start, end y text.
Esto es esencial para la medición del tiempo. El cronómetro situado alrededor de esta llamada no debe detenerse al crear solo el generador; consumirlo por completo permite medir la transcripción del fragmento hasta el final. La documentación oficial de faster-whisper destaca este comportamiento.
Se realiza un warm-up, o pasada de calentamiento, sobre el primer archivo antes de las 20 mediciones. Prepara la ejecución sin entrar en las duraciones medidas. La carga del modelo también queda fuera del RTF que calcularemos, aunque forma parte del tiempo completo necesario para realizar el recorrido.
Ejecutar y leer la primera transcripción
docker compose run --rm --no-deps app -m src.cli transcribe
El comando escribe un objeto por fragmento en outputs/transcription.json y crea los 20 archivos SRT. Cada objeto conserva el texto unido, los segmentos en bruto, los segmentos destinados a SRT, la duración del audio, el tiempo de inferencia y el idioma.
En las observaciones r3, el primer archivo da el texto exacto de su referencia, con un segmento de 0,000 a 3,720 segundos para un audio de 4,440 segundos. El segmento no necesita ocupar toda la duración del archivo: nuestra política le prohíbe rebasarla, pero no le obliga a terminar en la última muestra.
Otro matiz de lectura: puesto que proporcionamos language="fr", recuperar fr en las salidas no es una validación independiente de la detección de idioma. En la rama de silencio, esta cadena es incluso devuelta directamente por nuestro propio código.
Generar un SRT sin maquillar los segmentos en bruto
¿Qué aspecto tiene un subtítulo?
Un archivo SRT contiene bloques formados por un número, un intervalo con el formato hh:mm:ss,mmm --> hh:mm:ss,mmm, y texto. Esta es la forma correspondiente al texto y a las marcas temporales del primer fragmento indicados arriba; es un formato de ese ejemplo, no un resultado nuevo de inferencia:
1
00:00:00,000 --> 00:00:03,720
Le groupe Aerosmith a annulé les derniers concerts de sa tournée.
El número identifica el subtítulo. Los dos tiempos indican cuándo mostrarlo y cuándo retirarlo. La coma separa los segundos de los milisegundos: 03,720 significa 3 segundos y 720 milisegundos.
Conservar la fuente y luego aplicar una política de salida
Los segmentos del modelo pueden solaparse o rebasar la duración del audio. El proyecto conserva primero raw_segments, y después construye segments con una regla explícita: ningún inicio antes del final del segmento anterior conservado, inicio y final acotados a la duración real, y eliminación de los segmentos reducidos a una duración nula.
No es una corrección del reconocimiento. Es una transformación de salida, comparable a preparar un objeto para mostrarlo, conservando a la vez el dato original para comprender qué cambió.
"""Politique de sortie SRT : conserver le brut et borner à la durée audio."""
import math


def bounded_segments(rows, duration):
    if not math.isfinite(duration) or duration <= 0:
        raise ValueError("Durée positive requise")
    result = []
    previous = 0
    for row in rows:
        start, end = row["start"], row["end"]
        if (
            not all(math.isfinite(value) for value in (start, end))
            or not 0 <= start <= end
        ):
            raise ValueError("Segment invalide")
        start = min(duration, max(previous, start))
        end = min(duration, max(start, end))
        if end > start:
            result.append({"start": start, "end": end, "text": row["text"]})
            previous = end
    return result


def stamp(seconds):
    milliseconds = round(seconds * 1000)
    return f"{milliseconds // 3600000:02d}:{milliseconds // 60000 % 60:02d}:{milliseconds // 1000 % 60:02d},{milliseconds % 1000:03d}"


def to_srt(rows):
    return "\n\n".join(
        f'{i}\n{stamp(row["start"])} --> {stamp(row["end"])}\n{row["text"].strip()}'
        for i, row in enumerate(rows, 1)
    )
Leer los dos acotamientos línea por línea
bounded_segments() comienza rechazando una duración de audio no finita o menor o igual que cero. Para cada segmento, comprueba después que los tiempos son finitos y que 0 <= start <= end. Por tanto, un inicio negativo o un final anterior al inicio provoca un error: el código no repara silenciosamente todas las entradas posibles.
previous memoriza el final del último segmento conservado. En max(previous, start), el inicio se retrasa si es necesario para evitar un solapamiento. Después, min(duration, ...) evita que ese inicio rebase el final del audio.
Para el final, max(start, end) evita terminar antes del nuevo inicio, y luego min(duration, ...) aplica de nuevo el límite de audio. El segmento solo se añade si end > start tras estas transformaciones.
La función sigue el orden recibido: no ordena los segmentos. También produce una lista nueva, lo que mantiene disponibles por separado las filas en bruto.
Un ejemplo que puede calcularse a mano
Los tres segmentos siguientes son ficticios, construidos únicamente para comprender la función. Tomemos un audio de 4,44 segundos:
| Segmento | Intervalo en bruto, en segundos | Tras el acotamiento | Explicación |
|---|---|---|---|
| A | 0,00 → 3,00 | 0,00 → 3,00 | Ya está dentro de los límites. |
| B | 2,80 → 4,80 | 3,00 → 4,44 | El inicio se retrasa después de A; el final vuelve a la duración del audio. |
| C | 4,80 → 5,10 | Eliminado | Los dos límites pasan a ser 4,44; su duración se vuelve nula. |
El subtítulo B está ahora dentro del intervalo permitido. Sin embargo, su primera palabra quizá se pronunció antes de los 3,00 segundos. Por tanto, una restricción temporal satisfecha no demuestra que el texto esté bien sincronizado.
El texto de C desaparece del SRT porque esta regla no puede asignarle ningún intervalo positivo. Sus datos en bruto siguen disponibles para el análisis: esta retirada no debe presentarse como un reconocimiento mejor.
Dar formato a los tiempos no basta para validarlos
stamp() convierte segundos en milisegundos con round(), y después los distribuye en horas, minutos, segundos y milisegundos. to_srt() numera los segmentos desde 1, escribe los intervalos y elimina espacios superfluos en los extremos del texto con strip(). No corrige las palabras.
El acotamiento trabaja en segundos antes del redondeo al milisegundo. Por tanto, dos tiempos muy próximos pueden mostrarse igual después del redondeo. Por ejemplo, los límites pedagógicos 1,0001 y 1,0004 segundos se convierten ambos en 00:00:01,000. Este ejemplo de precisión no forma parte de los rebasamientos observados en r3; muestra por qué la función no es un validador completo de subtítulos.
El programa no garantiza ni sincronismo palabra por palabra, ni una duración de lectura cómoda, ni un número de caracteres adecuado para cada línea. Abra outputs/0.srt en un reproductor o editor y compárelo con el audio. Un archivo legible por un reproductor y unos subtítulos agradables de seguir siguen siendo dos objetivos distintos.
Comprender las métricas antes de los resultados
Mediremos dos cosas diferentes: la diferencia entre el texto esperado y el texto obtenido, y después el tiempo necesario para obtener ese texto. Un programa puede ser rápido y equivocarse; también puede transcribir correctamente mientras produce subtítulos mal sincronizados. Ninguna de estas dimensiones sustituye a las demás.
WER: contar los errores de palabras
El WER, de word error rate, es una tasa de error de palabras. Para calcularla, el proyecto usa la distancia de Levenshtein: el número mínimo de inserciones, eliminaciones y sustituciones necesarias para pasar de la referencia a la hipótesis.
Una sustitución reemplaza una palabra por otra. Una eliminación hace desaparecer una palabra esperada. Una inserción añade una palabra ausente de la referencia. El cálculo busca una alineación que minimice el total: no compara simplemente la primera palabra con la primera y luego la segunda con la segunda. De lo contrario, una sola palabra añadida al principio podría hacer pensar que todo lo siguiente es erróneo.
La fórmula es:
WER = (sustituciones + inserciones + eliminaciones) / número de palabras de referencia.
Tomemos esta referencia pedagógica de cuatro palabras, sin relación con las mediciones FLEURS: «el paquete llega mañana».
| Hipótesis | Diferencia mínima | WER |
|---|---|---|
| «el paquete llega mañana» | Ningún error | 0 / 4 = 0 % |
| «el paquete llega el lunes» | Una sustitución | 1 / 4 = 25 % |
| «el paquete llega» | Una eliminación | 1 / 4 = 25 % |
| «el paquete llega bien mañana» | Una inserción | 1 / 4 = 25 % |
El denominador sigue siendo cuatro, incluso cuando la hipótesis contiene cinco palabras. Se divide por la longitud de la referencia, no por la de la respuesta producida.
El WER puede incluso superar 1, es decir, el 100 %. Con la referencia pedagógica «hola» y la hipótesis «hola a toda la familia», hacen falta cuatro inserciones para una sola palabra de referencia: el WER vale 4. No es un error de porcentaje; la fórmula cuenta operaciones relacionadas con la referencia.
¿Qué palabras se comparan exactamente?
Antes de contar, el proyecto normaliza los textos en NFKC, los pasa a minúsculas y extrae secuencias Unicode de caracteres de palabra. NFKC es una normalización de representaciones Unicode; no es ni una traducción ni un corrector ortográfico. La puntuación deja de contar en esta comparación.
Por ejemplo, los textos pedagógicos franceses «ÉTÉ !» y «été» producen la misma unidad été. El acento permanece, pero la mayúscula y el signo de exclamación ya no distinguen ambos textos. Por tanto, el WER calculado así no mide la calidad de la puntuación.
Del mismo modo, el ejemplo francés «L’été, c’est fini !» se descompone en l, été, c, est, fini. Los apóstrofes separan unidades: las «palabras» de esta métrica se definen mediante esta regla, no solo por los espacios visibles en la frase.
Las documentaciones Python de la normalización Unicode y de las clases de caracteres de expresiones regulares permiten profundizar en estas dos operaciones. Para reproducir las cifras r3, conserve la regla del archivo: cambiar la normalización cambia lo que mide la puntuación.
¿Por qué un WER «micro» en lugar de una media de frases?
El WER micro suma todos los errores y todas las palabras de referencia, y después realiza una sola división. No da el mismo peso a una frase de dos palabras y a una frase de veinte palabras.
Este es un cálculo pedagógico, distinto de los 20 fragmentos: una frase de 2 palabras tiene 1 error, y una frase de 8 palabras también tiene 1 error. Sus WER respectivos son 50 % y 12,5 %.
La media simple de las dos tasas es (50 % + 12,5 %) / 2 = 31,25 %. El WER micro es, en cambio, (1 + 1) / (2 + 8) = 20 %.
Los dos cálculos describen los mismos errores, pero responden a preguntas distintas. La media por frase da el mismo peso a cada frase; el micro relaciona el conjunto de errores con el conjunto de palabras esperadas. Es este segundo cálculo el que leeremos para r3.
RTF: relacionar el tiempo de cálculo con la duración sonora
El RTF, o real-time factor, se calcula así:
RTF = tiempo de transcripción / duración del audio.
En un ejemplo pedagógico, transcribir 10 segundos de audio en 0,25 segundos da 0,25 / 10 = 0,025. El tiempo de transcripción representa entonces el 2,5 % de la duración sonora, es decir, un procesamiento 40 veces más rápido que la duración de reproducción de ese fragmento. Un RTF inferior a 1 significa que el cálculo tarda menos que el audio.
Atención a la unidad: 0,025 no es una duración de 25 milisegundos. Es una relación sin unidad. Para recuperar el tiempo de transcripción, hay que multiplicarla por la duración del audio correspondiente.
Tampoco describe la latencia completa de una aplicación: el envío del archivo, la cola, la carga del modelo y otras operaciones no se incluyen todos en la duración de inferencia utilizada aquí. Transcribir un archivo más rápido que su duración no establece que se haya construido o probado un servicio de transcripción en directo.
RTF medio y RTF ponderado: de nuevo, dos cálculos distintos
El RTF medio calcula el RTF de cada fragmento y luego obtiene la media de esas relaciones. El RTF ponderado divide el tiempo total de inferencia entre la duración total de audio: los fragmentos pesan entonces según su duración sonora.
Para un segundo ejemplo pedagógico, tomemos dos fragmentos: el primero dura 2 segundos y exige 0,2 segundos de transcripción; el segundo dura 8 segundos y exige 0,4 segundos. Sus RTF son respectivamente 0,10 y 0,05.
La media por fragmento vale (0,10 + 0,05) / 2 = 0,075. La relación de los totales vale (0,2 + 0,4) / (2 + 8) = 0,06. Es normal que ambos valores no sean iguales. Ninguno corrige al otro: simplemente no dan el mismo peso a los fragmentos.
Generar los controles y el informe
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
negatives verifica las entradas inválidas y conserva la observación sobre el silencio. Un caso negativo es una prueba en la que se espera un rechazo o un comportamiento particular, en lugar de una transcripción ordinaria.
evaluate escribe outputs/evaluation.json con el WER, los RTF y los rebasamientos de marcas temporales en bruto. Lea estas salidas junto con los textos y los segmentos: el informe da referencias, no una explicación automática de cada error.
Resultados observados y su alcance
Lo que midieron las dos reproducciones
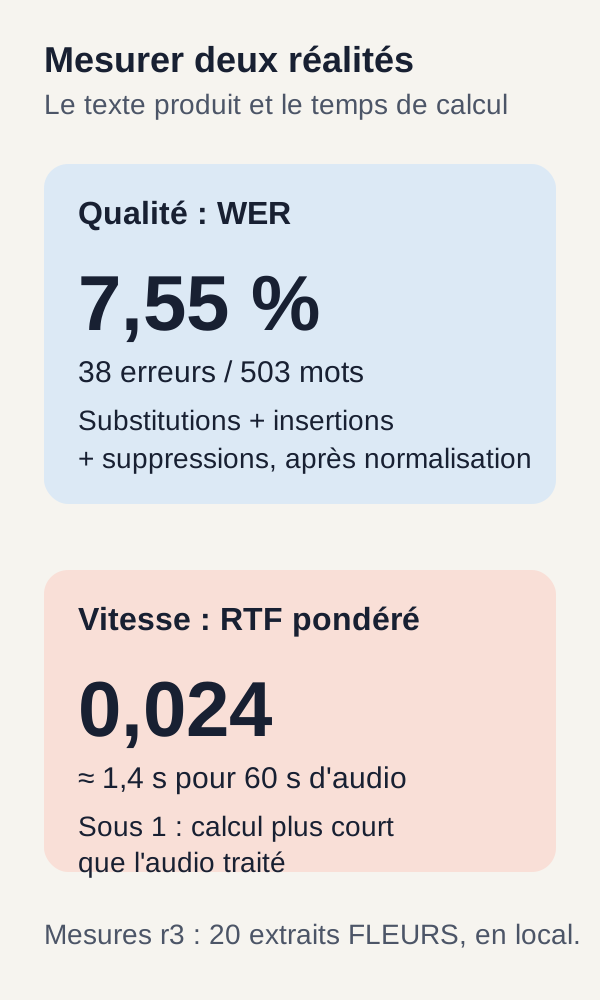
Las dos reproducciones r3 obtuvieron exactamente 38 errores en 503 palabras de referencia, es decir, un WER micro de 0,07554671968190854, aproximadamente 7,55 %. Se trata del total de operaciones de edición calculadas tras la normalización, no de 38 archivos erróneos ni de una nota otorgada por el modelo.
| Indicador | Reproducción 1 | Reproducción 2 |
|---|---|---|
| Fragmentos transcritos y evaluados | 20 | 20 |
| Palabras de referencia | 503 | 503 |
| Errores de palabras | 38 | 38 |
| WER micro, redondeado | 7,55 % | 7,55 % |
| Rebasamientos de marcas temporales en bruto, antes de acotar | 2 | 2 |
| RTF medio por fragmento | 0,02587 | 0,02565 |
| RTF ponderado por duración de audio | 0,02396 | 0,02379 |
| Máximo de VRAM observado por muestreo | 1 056 Mio | 1 024 Mio |
Estas mediciones se tomaron en una RTX 3090. La VRAM se muestreó aproximadamente una vez por segundo: los valores de la tabla son los máximos observados en esos instantes, no una medición continua del pico real. Por tanto, no permiten deducir un mínimo de memoria de vídeo garantizado para todas las ejecuciones.
El modelo se adquirió de nuevo en cada directorio de reproducción. Sin embargo, pudieron reutilizarse capas Docker públicas. «Directorio nuevo» no significa que se hubieran vaciado todas las cachés de la máquina.
Una puntuación global no dice dónde está el error importante
Un WER del 7,55 % no significa que el 92,45 % de las grabaciones sean completamente correctas. Tampoco permite concluir que todos los nombres o números sean fiables. Es una relación global de errores de palabras en la población evaluada.
Un error en un nombre, un número o una negación puede tener una importancia profesional muy superior a otro error, aunque el cálculo le atribuya el mismo coste. Para usar una transcripción en una aplicación, hay que releer los elementos que determinan una acción, no mirar solo la tasa media.
El corpus contiene pocos fragmentos, varias repeticiones de frases y ninguna prueba representativa de su propia acústica. Estas cifras describen este corpus y este protocolo; no son una garantía para sus archivos.
El silencio revela el papel del controlador
El control de silencio aporta una observación especialmente instructiva: sin la protección, el modelo produjo una frase; con la protección, la lista de segmentos está vacía.
Este resultado no significa que el modelo se haya vuelto mejor entre los dos ensayos. La protección simplemente impidió su llamada. Una frase plausible producida sobre silencio es precisamente el tipo de resultado que se corre el riesgo de pasar por alto al comprobar solo las salidas que «parecen correctas».
Los dos rebasamientos de marcas temporales en bruto ilustran otro límite: el procesamiento SRT encuadra tiempos, pero no demuestra ni un reconocimiento mejor ni una mejor alineación con el habla.
Lo que hemos aprendido
Ahora sabemos seguir un archivo de audio hasta tres resultados distintos: el texto reconocido, los subtítulos formateados y las mediciones que permiten examinarlos.
La fiabilidad de esta cadena empieza con contratos de desarrollo ordinarios: una entrada acotada, archivos de modelo verificados, una GPU elegida explícitamente y un registro de las salidas en bruto. El modelo realiza el reconocimiento; el controlador puede rechazar una entrada o cortar un silencio; el código SRT aplica restricciones de tiempo. No son las mismas responsabilidades.
El WER depende de la referencia y de la normalización. El RTF depende del tiempo medido y de la duración sonora. Comprender sus denominadores evita transformar un resultado útil en una conclusión demasiado general.
Las reproducciones r3 demuestran este recorrido en 20 fragmentos FLEURS. No demuestran ni una calidad de transcripción universal ni un servicio preparado para recibir datos de producción.
Ejercicio: predecir, modificar, ejecutar, observar y explicar
Predecir antes de mirar el resultado
Volvamos al primer fragmento: «El grupo Aerosmith canceló los últimos conciertos de su gira». Tras la normalización del proyecto, su referencia contiene 11 palabras, y la hipótesis inicial es exacta.
Prediga qué ocurre si se añade la palabra intrus a esta hipótesis. ¿Qué tipo de error aparece? ¿El denominador del WER pasa a doce porque la respuesta se ha alargado? ¿Es el modelo lo que se está modificando?
Escriba su respuesta antes de ejecutar el ejercicio. Se espera una inserción, pero corresponde al programa recalcular la alineación: no añada arbitrariamente 1 a una medida sin rehacer su comparación.
Ejecutar la modificación prevista
docker compose run --rm --no-deps app -m src.cli exercise
El comando realiza el ejercicio previsto en el proyecto. Sirve para observar el efecto de una modificación de la hipótesis sobre la métrica, no para enseñar una frase nueva al modelo.
Observar y explicar
La salida r3 informa original_errors: 0, modified_errors: 1 y reference_words: 11.
La referencia no ha cambiado: el denominador sigue siendo once. Para esta única frase modificada, el cálculo da 1 / 11, aproximadamente 9,09 %. Este cálculo pedagógico no sustituye al WER global de 7,55 % del corpus de referencia.
El experimento verifica el sentido de la métrica. No mide un deterioro espontáneo del modelo: hemos añadido deliberadamente una palabra al texto evaluado, sin modificar sus pesos.
Su propia experiencia, sin resultado anunciado de antemano
Ahora puede preparar una experiencia independiente con un audio sobre el que tenga derechos y una transcripción de referencia revisada. No sobrescriba ni data/audio.json ni los archivos de prueba r3. Copie el proyecto en una carpeta nueva y conserve aparte los resultados de referencia.
Documente primero la duración, el idioma, las condiciones acústicas, el texto de referencia y los parámetros utilizados. Un mensaje grabado en calma y una conversación captada a distancia no plantean el mismo problema, aunque ambos estén en francés.
Los comandos presentados siguen un manifiesto y una adquisición fijados. No constituyen por sí solos un procedimiento de importación de cualquier archivo personal. Para su copia experimental, examine en el proyecto completo cómo se adquiere, decodifica y asocia el archivo a su referencia, y adapte explícitamente esa ruta y los controles correspondientes. No sustituya silenciosamente los archivos adquiridos bajo sus huellas originales.
Retome después la misma lógica: preparar, transcribir, controlar y evaluar. Compare manualmente el audio, la referencia, el JSON en bruto y el SRT. Una salida correcta en el plano sintáctico no debe dispensar de esta escucha.
No anuncie ninguna puntuación antes de medir. Si cambia el modelo, beam_size, la VAD, la segmentación o el corpus, ha creado una experiencia nueva. Para estudiar el efecto de un parámetro, mantenga idénticas las demás condiciones; para cambiar de corpus, establezca una nueva referencia de comparación. Las cifras r3 no describen automáticamente esa variante.
Para grabaciones largas habrá que definir una segmentación, un posible solapamiento, una estrategia de concatenación y una evaluación específica. Por ejemplo, los tiempos de un segmento transcrito en una parte deberán volver a situarse en la cronología de la grabación completa. Esta ampliación queda por construir y medir: elevar simplemente el límite de 60 segundos no basta para validarla.
Solución de problemas dirigida
nvidia-smi absent. Instale o repare el controlador NVIDIA y vuelva a ejecutar el preflight. El script de control no realiza esa instalación por usted.
La GPU es visible en Linux, pero no en Docker. Instale o configure NVIDIA Container Toolkit. El contenedor de diagnóstico debe ver exactamente una tarjeta, la seleccionada por GPU_DEVICE.
fetch falla. Compruebe la conexión y lea el error de adquisición. No desactive las comprobaciones de tamaño o SHA-256 para continuar: una descarga parcial o distinta del archivo esperado no constituye el modelo fijado de la experiencia.
GPU CUDA requis o fallo de las pruebas CUDA. Compruebe GPU_DEVICE, el controlador, la configuración Docker y la ejecución completa de fetch. Conserve los parámetros del recorrido en lugar de cambiar silenciosamente a otro motor o a la CPU.
Se rechaza un audio. Distinga el archivo decodificado de la matriz esperada por validate_audio(). Una entrada vacía, no mono, no finita o que supera 60 segundos en el formato previsto se rechaza antes del modelo. El mensaje Image modifiée, encontrado en el tutorial OCR, no corresponde a esta cadena de audio.
El SRT parece mal sincronizado. Compare raw_segments y segments, y luego escuche el pasaje. El acotamiento puede acortar un intervalo o eliminar un segmento; no puede corregir un texto mal reconocido ni inventar los instantes correctos de pronunciación.
Pasar de un tutorial a un servicio
Procesamientos de audio por completar
Un servicio debe tratar explícitamente las duraciones largas, los formatos aceptados, los canales, el ruido, los acentos y los idiomas necesarios para su uso. También debe elegir y evaluar una política de VAD, en lugar de considerar nuestro único umbral de amplitud como una detección general de voz.
Hay que distinguir otras dos necesidades. La diarización busca atribuir las intervenciones a hablantes distintos: quién habla en qué momento, sin conocer necesariamente los nombres de las personas. La alineación busca situar el texto, posiblemente palabra por palabra, en la cronología sonora. Una buena transcripción no resuelve automáticamente estos dos problemas.
Para los subtítulos, también queda por definir reglas de longitud de línea y comodidad de lectura. El código de este tutorial se centra en una política temporal explícita, no en un subtitulado finalizado para todas las pantallas y todos los públicos.
Las responsabilidades habituales de una aplicación web siguen presentes
Hay que diseñar alrededor de la transcripción una ingesta controlada, una API autenticada, derechos de acceso, cuotas, una cola de trabajos y plazos de ejecución. Un RTF local bajo no basta para decidir que todo procesamiento puede permanecer ligado a una petición HTTP síncrona.
También hay que prever registros y supervisión útiles, cifrado adaptado al contexto, una política de conservación y procedimientos de borrado o restauración. Conservar los archivos en su máquina evita enviarlos al servicio externo del escenario, pero no gestiona por sí solo los derechos sobre los audios y las transcripciones.
Medir la calidad profesional y la carga real
La calidad profesional exige un corpus representativo y revisado, distribuido según las condiciones de audio importantes para su aplicación, además de reglas de revisión humana. Los números y los nombres merecen en especial comprobaciones adaptadas al uso previsto.
La media local del RTF no proporciona ni rendimiento bajo carga ni una latencia p95 o p99. Estos percentiles describen las duraciones por debajo de las cuales se sitúan respectivamente el 95 % o el 99 % de las solicitudes de un conjunto medido. Para conocerlos, hay que medir muchas solicitudes en condiciones de concurrencia y espera del servicio.
Estos mecanismos de producción no están ni implementados ni validados por este archivo. El tutorial permite aprender y reproducir la cadena local; añadirlos requeriría otra etapa de desarrollo y evaluación.
Limpiar exactamente lo que se inició
Cuando haya terminado de consultar las salidas, detenga los servicios del proyecto desde la raíz del archivo:
docker compose down
Este comando es también la última etapa de las reproducciones r3. Detiene los recursos Compose de esta carpeta; no elimina los modelos adquiridos, la imagen construida ni las salidas conservadas en el disco.
Conserve outputs/ para poder releer los resultados y compararlos. No elimine sus carpetas de prueba hasta verificar su contenido; no es necesaria ninguna limpieza global de sus otros proyectos Docker.
Referencias para profundizar
Para comprender los recursos utilizados, consulte la ficha de FLEURS y la ficha de Systran/faster-whisper-small. Describen el corpus y el modelo; las revisiones y archivos que se adquirirán para esta experiencia siguen siendo los fijados en el archivo.
Para seguir los mecanismos, la documentación oficial de faster-whisper presenta la API y el comportamiento del generador. El código de transcripción de la versión 1.2.1 detalla los parámetros, mientras que el decodificador de esa misma versión muestra la preparación de audio. Estas referencias explican mecanismos; no extienden los resultados medidos del tutorial a otros ajustes.
Para el entorno y los cálculos, la documentación de tipos numéricos de CTranslate2, la guía de NVIDIA Container Toolkit y la documentación Unicode de Python 3.12 completan las explicaciones. Conserve las versiones y comandos del ZIP para reproducir r3, aunque una documentación general muestre otras posibilidades.