





Bạn đang phát triển một tính năng biến yêu cầu thành dữ liệu mà ứng dụng có thể sử dụng. Ví dụ: xác định mã sản phẩm, số lượng và danh mục, rồi trả về dưới dạng JSON. Đến đây, nhu cầu có vẻ giống một API thông thường. Điểm khác biệt là câu trả lời do mô hình ngôn ngữ tạo ra.
Khi chuẩn bị chạy trên máy của mình, bạn thấy nhiều tệp cho cùng một mô hình: Q4_K_M, Q8_0… Nên chọn tệp nào? Tệp lớn hơn có nhất thiết đáng tin cậy hơn không? Bản gọn hơn có đủ chính xác để cung cấp dữ liệu cho ứng dụng không?
Chúng ta sẽ xem xét hai đợt đo với Qwen2.5 7B, sử dụng hai phiên bản lượng tử hóa. Mục tiêu không phải tìm người chiến thắng cho mọi tình huống, mà là học cách đọc kết quả, hiểu kiểm thử thực sự kiểm tra điều gì và liên hệ các quan sát với nhu cầu phát triển phần mềm.
Câu hỏi trọng tâm rất cụ thể: một câu trả lời giữ đúng số lượng nhưng bỏ mất một phần mã sản phẩm có dùng được trong chương trình của bạn không?
Biết đọc Python, thao tác với JSON và sử dụng Docker là đủ để theo dõi phần giải thích. Chúng ta không huấn luyện lại mô hình. Tuy nhiên, quy trình chạy bên dưới giả định bạn đã có môi trường Lab và các tệp của thí nghiệm: đây không phải hướng dẫn cài đặt độc lập từ một máy trống.
Hai đợt đo theo cùng một quy trình
Trước hết, «lượng tử hóa mô hình» nghĩa là gì?
Mô hình chứa các giá trị số, gọi là trọng số hoặc tham số, tham gia vào phép tính. Lượng tử hóa biểu diễn các giá trị này với độ chính xác thấp hơn để giảm dung lượng. Đây là một trong những cách giúp chạy mô hình với ít bộ nhớ hơn. Hướng dẫn lượng tử hóa của Hugging Face trình bày nguyên lý và những đánh đổi này.
Để hình dung, hãy nghĩ đến việc làm tròn: giữ 0,12 thay vì 0,123456 vẫn giữ một giá trị gần đúng nhưng làm mất thông tin. Đây chỉ là phép so sánh, không phải công thức dùng trong các tệp của thí nghiệm. Các phương pháp thực tế mã hóa những nhóm giá trị và thông tin bổ sung.
Trong phép so sánh này, hai tên gọi chỉ hai cách lượng tử hóa khác nhau:
| Biến thể | Điều cần nhớ khi đọc thí nghiệm |
|---|---|
Q4_K_M |
Một phương án thuộc họ lượng tử hóa 4 bit, kết hợp các mức độ chính xác tùy theo trọng số. Không nên hiểu tên này là «đúng 4 bit cho mỗi tham số, không có thông tin nào khác». |
Q8_0 |
Một phương án lượng tử hóa 8 bit, giữ biểu diễn trọng số chi tiết hơn các định dạng có độ chính xác thấp hơn. Tên gọi này không bảo đảm thành công với mọi truy vấn. |
Tài liệu Qwen về llama.cpp giải thích lượng tử hóa trọng số và việc kết hợp các kiểu. Tài liệu công cụ lượng tử hóa của llama.cpp mô tả các biến thể hiện có.
Điều quan trọng là phân biệt độ chính xác của các số được lưu với độ đúng của câu trả lời mà ứng dụng mong đợi. Thí nghiệm này đo yếu tố thứ hai trong một phạm vi cụ thể; không thể đánh đồng hai khái niệm.
Mô hình, tệp và bộ máy thực thi có vai trò khác nhau
Qwen2.5-7B-Instruct là mô hình. 7B chỉ quy mô khoảng bảy tỷ tham số, còn Instruct là biến thể được điều chỉnh để làm theo chỉ dẫn. Thẻ mô hình chính thức ở bản sửa đổi được dùng mô tả mô hình được phân phối.
GGUF là định dạng tệp: nó chứa trọng số và siêu dữ liệu cần để nạp chúng. Đây không phải tên mô hình, cũng không tự nó xác định mức lượng tử hóa. Đặc tả GGUF mô tả vai trò này.
llama.cpp là bộ máy nạp các tệp và chạy mô hình. Sử dụng mô hình đã huấn luyện để tạo câu trả lời được gọi là suy luận. Trong quy trình này, chương trình Python gửi yêu cầu đến máy chủ llama.cpp cục bộ; tài liệu máy chủ trình bày giao diện đó.
Những yếu tố giữ nguyên giữa hai biến thể
Các đợt đo so sánh Q4_K_M và Q8_0 của cùng mô hình, cùng bản sửa đổi, trong một image llama.cpp được cố định phiên bản. «Cố định» ở đây nghĩa là giữ một phiên bản được xác định rõ, thay vì tự động lấy bản mới nhất.
Quy trình công bố 80 trường hợp tổng hợp cho mỗi chế độ trong mỗi đợt đo. Trường hợp tổng hợp là ví dụ được tạo phục vụ kiểm thử, không phải yêu cầu lấy nguyên dạng từ lưu lượng thực của ứng dụng. Hai đợt chạy GPU đầy đủ đã được ghi lại; hồ sơ thí nghiệm cho biết các chỉ số sau đó đã được tính lại.
Phạm vi được ghi nhận là chủ đề 006, với các chế độ ['q4', 'q8'], hai lần chạy sạch và một lần rà soát xác định ngoài tiến trình. Nói cách khác, kết quả được kiểm tra bằng mã từ các đầu ra đã lưu, không nhờ mô hình khác chấm điểm. Không yêu cầu trước rằng phải có cải thiện: quy trình phải có thể báo cáo lợi thế, không có lợi thế hoặc giới hạn.
Các phép đo chỉ thuộc một máy. Bộ nhớ GPU, gọi là VRAM, được ghi nhận mỗi giây một lần, tức 1 Hz. Không có tuyên bố rằng câu trả lời được con người hoặc LLM đọc lại để đánh giá. Độ trễ mang tính mô tả, không bảo đảm hiệu năng.
Chương trình nhỏ điều phối các yêu cầu
Đây là phần cốt lõi của quy trình. Đoạn trích giữ nguyên logic của mã đã ghi nhận, với cách trình bày thoáng hơn. Các hàm ready(), llm() và emit(), cùng DATA và SCHEMA, được định nghĩa ở nơi khác trong dự án: khối này không phải chương trình độc lập.
Nguồn cố định: poc/experiment.py, dòng 99–107. SHA-256 của tệp nguồn đã ghi nhận: f50240fa92614d1399c672ed91574bacacc805d2c0c377b6830c8831733bf17d.
def quant():
    elapsed = ready('http://server:8080', '/health')
    emit('load', ready_seconds=elapsed)

    llm(DATA['queries'][0]['query'], SCHEMA)

    for q in DATA['queries']:
        r = llm(q['query'], SCHEMA)
        emit('sample', sample_id=q['id'], **r)

    try:
        llm('mot ' * 10000, SCHEMA)
    except urllib.error.HTTPError as e:
        assert e.code in (400, 413)
        emit('test', test_id='context-limit', status='passed')
    else:
        raise AssertionError('oversize accepted')

    emit('complete', samples=len(DATA['queries']))
Chương trình đợi máy chủ, thực hiện một yêu cầu khởi động làm nóng, rồi duyệt các truy vấn trong bộ dữ liệu. Với mỗi truy vấn, nó ghi sự kiện sample gắn với mã định danh tương ứng. Cuối cùng, chương trình kiểm tra việc từ chối đầu vào cố ý quá dài và báo kết thúc quy trình.
Các dấu vân tay SHA-256 trong bài xác định các tệp nguồn của hồ sơ thí nghiệm. Chúng không phải dấu vân tay của các khối mã đã được trình bày lại trên trang này. Chúng ta sẽ trở lại tác dụng của chúng khi nói về tái hiện.
Các phép đo có thể tái hiện qua hai đợt
Trước khi đọc số liệu, hãy phân biệt ba câu hỏi. Khớp nghiêm ngặt kiểm tra đầu ra có khớp chính xác kết quả mong đợi theo bộ so sánh của dự án hay không. Độ trễ mô tả thời gian phản hồi được đo. Thông lượng, tính bằng token mỗi giây, mô tả tốc độ xử lý hoặc sinh nội dung tùy phép đo được chọn.
Token là đơn vị văn bản mà mô hình xử lý; không nhất thiết là một từ trọn vẹn. Tài liệu máy chủ llama.cpp phân biệt thông tin xử lý prompt với thông tin sinh nội dung. Vì vậy phải giữ định nghĩa thông lượng mà thí nghiệm sử dụng, không chỉ đơn vị đo.
Dưới đây là các giá trị được báo cáo, giữ nguyên độ chính xác:
| Đợt đo | Biến thể | Khớp nghiêm ngặt | Độ trễ được báo cáo | Thông lượng được báo cáo |
|---|---|---|---|---|
| 1 | Q4_K_M | 1,00 | 0,251324 s | Khoảng 131 token/s |
| 2 | Q4_K_M | 1,00 | 0,252973 s | Khoảng 130 token/s |
| 1 | Q8_0 | 0,0666667 | 0,333810 s | Khoảng 93 token/s |
| 2 | Q8_0 | 0,0666667 | 0,333744 s | Khoảng 93 token/s |
Để hình dung thời gian, Q4 ở đây mất khoảng một phần tư giây, còn Q8 khoảng một phần ba giây. Điểm khớp nghiêm ngặt là 100% với Q4 và khoảng 6,67% với Q8, theo chỉ số được báo cáo, không phải đối với «mọi năng lực của mô hình».
Các giá trị của hai đợt đo gần nhau. Đây là quan sát hữu ích về các lần chạy này, nhưng hai đợt chưa đủ bảo đảm mức ổn định tương tự dưới tải khác hoặc trên máy khác.
Bản tóm tắt không nêu cách tổng hợp độ trễ. Vì vậy chúng ta gọi chúng là «độ trễ được báo cáo», không đổi tên thành trung bình, trung vị hay thời gian chờ token đầu tiên.
Chỉ số nghiêm ngặt thực sự đo điều gì
JSON đọc được chưa chắc đã là JSON dùng được
Báo cáo cho biết Q8 giữ đúng số lượng và danh mục trong 60 trường hợp, nhưng thường bỏ tiền tố REF-. Thiếu sót này khiến kiểm tra khớp chính xác thất bại. Sự chênh lệch điểm trở nên dễ hiểu hơn nhiều khi nhìn vào chi tiết đó.
Hãy lấy ví dụ để thấy vấn đề. Hai đối tượng sau chỉ là minh họa phục vụ học tập: chúng không tái tạo đầu ra đã ghi nhận hay lược đồ chính xác của POC.
Ứng dụng của bạn có thể chờ:
{
  "reference": "REF-042",
  "quantite": 3,
  "categorie": "accessoires"
}
Nhưng nhận được:
{
  "reference": "042",
  "quantite": 3,
  "categorie": "accessoires"
}
Cả hai đối tượng đều là JSON đúng cú pháp. Số lượng và danh mục giống nhau. Tuy nhiên, mã tham chiếu khác nhau.
Nếu ứng dụng tìm sản phẩm theo mã chính xác, nó không thể tự giả định 042 và REF-042 chỉ cùng một thứ. Vì thế kiểm thử nghiêm ngặt không nhất thiết «quá khắt khe»: nó có thể chỉ đang kiểm tra hợp đồng mà phần mềm cần.
Đây là cách suy luận quen thuộc trong phát triển web. Một endpoint có thể trả trạng thái HTTP thành công và JSON giải mã được, nhưng vẫn trả sai giá trị nghiệp vụ. Thành công ở khâu truyền tải, tính hợp lệ của cấu trúc và độ đúng của nội dung là ba câu hỏi riêng biệt.
Điểm số cho phép kết luận điều gì — và không cho phép điều gì
Trong thí nghiệm này, Q4 đạt kết quả tốt hơn về khớp nghiêm ngặt. Điều đó không chứng minh Q8 «hiểu kém hơn» mọi yêu cầu, hay Q4 sẽ tốt hơn cho mục đích khác. Quan sát về số lượng và danh mục chính là minh chứng rằng điểm nghiêm ngặt không tóm tắt mọi đặc tính của câu trả lời.
Ngược lại, thấy một số trường đúng chưa đủ để tuyên bố toàn bộ câu trả lời đúng. Mã tham chiếu không đầy đủ có thể chặn việc tích hợp, dù phần còn lại có vẻ hợp lý.
Mã của bộ so sánh chính xác không xuất hiện trong các đoạn trích trên trang. Vì vậy không thể suy ra, chẳng hạn, cách nó xử lý thứ tự khóa JSON, khoảng trắng hoặc bước chuẩn hóa. Tác động của việc thiếu REF- đã được báo cáo; các quy tắc khác cần được đọc trong bộ so sánh của bộ công cụ.
Vì sao có cả 80 và 60 trường hợp?
Quy trình công bố 80 trường hợp cho mỗi chế độ trong mỗi đợt. Nhận xét về số lượng và danh mục, cùng hình bên dưới, lại nhắc đến 60 trường hợp. Văn bản hiện có không giải thích mối liên hệ giữa hai phạm vi này.
Chúng ta giữ nguyên các thông tin đó, không tự đặt ra cách chia thành tập con. Đặc biệt, không biến điểm 0,0666667 thành số trường hợp thành công trên 80 trường hợp. Muốn xác định số đếm này, phải tìm mã định danh của những trường hợp được đánh giá và mẫu số chính xác của điểm trong kết quả chi tiết.
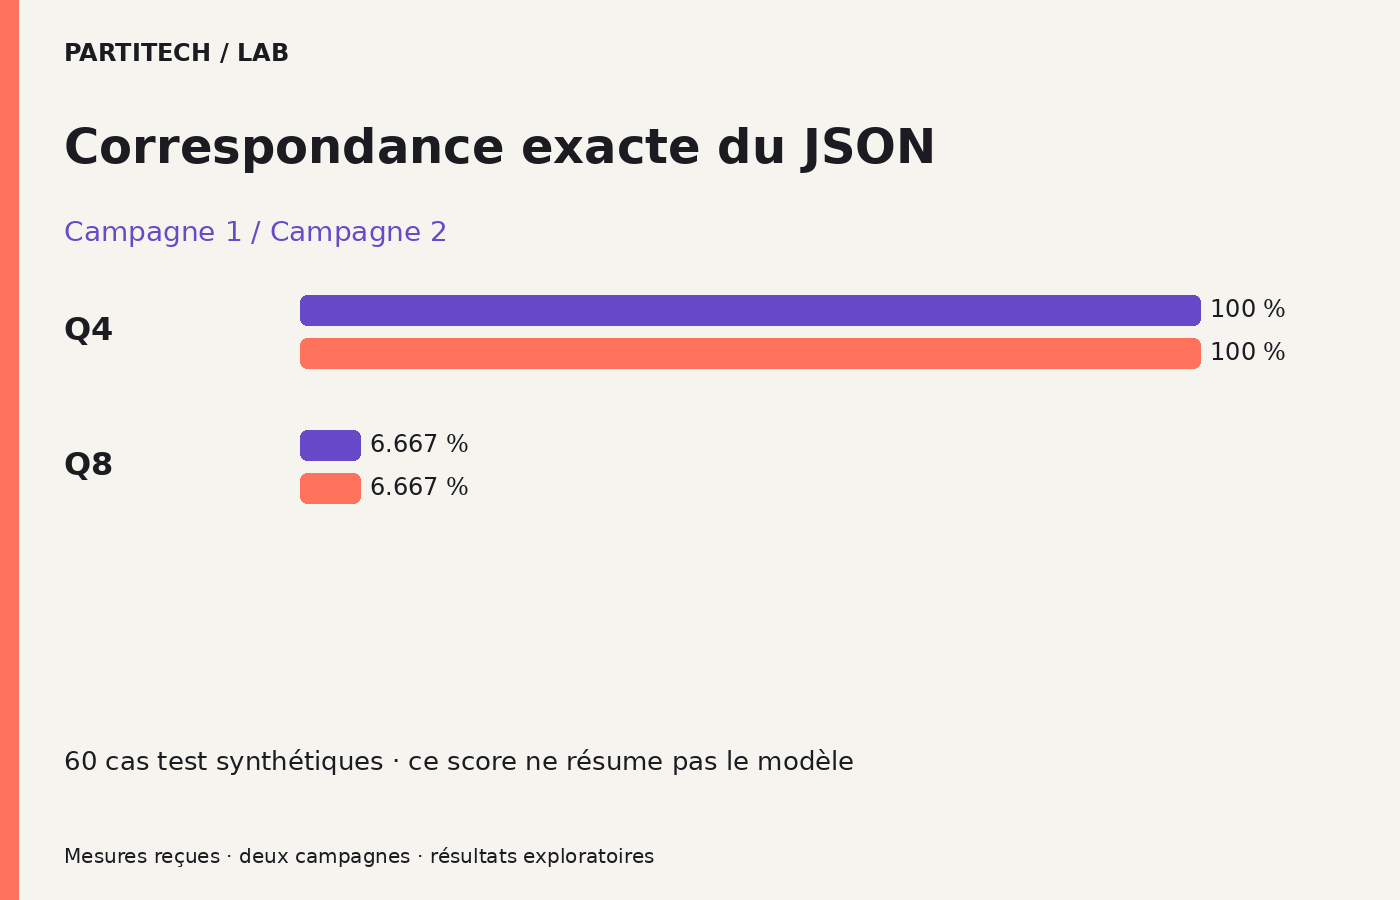
Dòng «60 trường hợp kiểm thử tổng hợp» trên hình thuộc tài liệu gốc. Nó không thay thế phạm vi 80 trường hợp được công bố cho mỗi chế độ.
Phạm vi và cách chạy lại được ghi chép
Các quan sát dựa trên dữ liệu tổng hợp, một máy duy nhất và bộ phần mềm được cố định. Việc chạy lại thí nghiệm phụ thuộc vào nền tảng Lab cục bộ, image llama.cpp và các mô hình được cố định.
Điều này giống kiểm thử tích hợp mà bạn giữ lại mã, bộ dữ liệu và phiên bản dịch vụ. Đọc lại kết quả không đồng nghĩa chạy lại; chạy với các phụ thuộc khác cũng chưa chắc tái hiện cùng thí nghiệm.
Dự án còn chứa các hàm tính chỉ số và kiểm thử đầu vào của chúng. Đây là đoạn trích được cung cấp, cũng được trình bày lại mà không đổi logic.
Nguồn cố định: poc/metrics.py, dòng 30–44. SHA-256 của tệp nguồn đã ghi nhận: 9d39a8d113cc112f5ece7ecbf6454f0cbe46ceddd847c4af25789ead12171899.
def valid_query(q):
    if not isinstance(q, str) or not q.strip() or len(q) > 2048:
        raise ValueError('invalid query')
    return q


def unit():
    assert (
        distance('chat', 'chats') == 1
        and distance([], ['x']) == 1
        and distance('abc', 'adc') == 1
    )
    assert normalize('ÉTÉ, bonjour!') == 'été bonjour'
    assert rank_metrics([2, 1], [1]) == {
        'recall5': 1.0,
        'mrr10': .5,
        'ndcg10': 1 / math.log2(3),
    }
    assert rank_metrics([2], []) == {
        'recall5': 0,
        'mrr10': 0,
        'ndcg10': 0,
    }
    assert bm25(
        [{'id': 0, 'text': 'chat'}, {'id': 1, 'text': 'chien'}],
        'chat',
    )[0][0] == 0
    assert bm25([], 'x') == [] and rrf([(1, 1)], [(2, 1)])[0][1] == 1 / 61

    for x in ['', None, {}, 42, 'x' * 2049]:
        try:
            valid_query(x)
        except ValueError:
            pass
        else:
            raise AssertionError('query guard')
Đọc valid_query() như kiểm tra biểu mẫu
Hàm này yêu cầu chuỗi ký tự, từ chối chuỗi rỗng hoặc chỉ có khoảng trắng và giới hạn độ dài tối đa 2.048 ký tự. Khi một điều kiện không được đáp ứng, nó phát sinh ValueError('invalid query').
Một chi tiết đáng chú ý: q.strip() chỉ được dùng để kiểm tra. Hàm trả về q, không phải q.strip(). Vì thế nó không xóa khoảng trắng khỏi giá trị trả cho bên gọi.
Trong unit(), vòng lặp thử nhiều đầu vào bị cấm: chuỗi rỗng, None, từ điển, số và chuỗi dài 2.049 ký tự. Nếu một đầu vào đi qua mà không phát sinh lỗi, kiểm thử thất bại với AssertionError('query guard'). Logic này giống kiểm thử backend xác nhận việc từ chối trường thiếu hoặc quá dài.
Vì sao còn có kiểm thử tìm kiếm và xếp hạng?
Các khẳng định còn lại kiểm tra những hàm khoảng cách, chuẩn hóa, xếp hạng và tìm kiếm trong mô-đun chỉ số. Ví dụ, kiểm thử normalize() chờ ÉTÉ, bonjour! trở thành été bonjour: trong ví dụ này, kiểu chữ hoa/thường và dấu câu thay đổi, nhưng dấu thanh vẫn được giữ.
Các tên rank_metrics, bm25 và rrf xuất hiện trong đoạn trích. Sự hiện diện của chúng không có nghĩa điểm Q4/Q8 là tổng hợp mọi kiểm thử này, hay thí nghiệm xây dựng một công cụ tìm kiếm. Khối này kiểm tra các hàm tiện ích; riêng nó không cho thấy toàn bộ cách tính khớp nghiêm ngặt.
Điều cần nhớ rất đơn giản: chương trình thực hiện phép đo cũng phải được kiểm thử. Nhưng vượt qua các kiểm thử đơn vị không chứng minh chất lượng tổng quát của mô hình hay tính đại diện của bộ dữ liệu.
Tài nguyên cục bộ và phiên bản đã ghi nhận
Để chạy lại thí nghiệm, chỉ có mã Python là chưa đủ. Còn cần các tệp trọng số, image Docker và nền tảng Lab đúng phiên bản đã ghi chép. Đó là tài nguyên cục bộ được nhắc trong hồ sơ: những thành phần cần để chạy, đã có sẵn trên máy.
Tệp khóa môi trường ghi lại trình điều khiển và image llama.cpp cùng các thành phần khác. Tệp khóa mô hình xác định Qwen2.5 7B và các tệp GGUF Q4_K_M, Q8_0 qua dấu vân tay. Gói này không tự động tải gì.
Bạn có thể liên hệ nguyên tắc này với composer.lock hoặc tệp khóa phụ thuộc JavaScript: mục tiêu là khôi phục một cấu hình chính xác, không chỉ các thành phần cùng tên.
Dấu vân tay SHA-256 là giá trị tính từ nội dung tệp. Nó giúp so sánh tệp hiện có với tệp mong đợi thay vì tin vào tên. Tài liệu Python về hashlib trình bày nhóm hàm này. Ở đây, dấu vân tay xác định tài nguyên của thí nghiệm; tự chúng không chứng minh chất lượng tài nguyên hay kết quả.
Trình khởi chạy chuẩn bị thí nghiệm như thế nào
README gắn chủ đề này với lệnh labctl, chạy từ Lab đã cài sẵn. labctl là trình khởi chạy của môi trường đó, không phải lệnh do Python hay Docker cung cấp.
Theo quy trình được ghi nhận, nó điều chỉnh đường dẫn trong mẫu Docker Compose, kiểm tra dấu vân tay tài nguyên, rồi khởi động chương trình Python trong container. Mẫu là cấu hình ban đầu; việc điều chỉnh cung cấp các vị trí tệp phù hợp trên máy sử dụng.
Cần chú ý đến đường dẫn. /poc và /assets là đường dẫn bên trong container. Các đường dẫn bắt đầu bằng /llm, thấy trong bản ghi, thuộc máy gốc. Chép nguyên chúng sang máy khác không bảo đảm chúng trỏ đến đúng tệp.
Lệnh chạy chính xác được giữ trong phần tái hiện cùng các điều kiện cần có. Mô tả quy trình chỉ cho biết cách chạy lại thí nghiệm; không có nghĩa một lần chạy mới đã được thực hiện khi chuẩn bị bài viết.
Các bước bảo vệ phép đo nhìn thấy trong mã cố định
Trở lại quant(). Mỗi bước trả lời một câu hỏi khá giống những câu bạn đặt ra khi kiểm thử API.
Dịch vụ đã sẵn sàng nhận yêu cầu chưa?
ready('http://server:8080', '/health') chờ dịch vụ cục bộ. Thời gian trả về được ghi trong sự kiện load, ở trường ready_seconds.
Tên load không nên khiến ta quên điều đoạn mã thực sự thể hiện: chờ dịch vụ sẵn sàng. Nếu chưa đọc cách triển khai ready(), không thể coi giá trị này chỉ là thời gian nạp trọng số lên GPU.
Yêu cầu đầu tiên có được tách khỏi vòng lặp đo không?
Trước vòng lặp, chương trình gọi llm() với truy vấn đầu tiên của bộ dữ liệu. Đây là yêu cầu làm nóng được công bố trong quy trình. Nó chuẩn bị trước các lời gọi được ghi nhận thành mẫu.
Trong đoạn trích, dòng này không đi kèm emit('sample', ...). Vòng lặp sau đó xử lý mọi truy vấn, kể cả truy vấn đầu tiên, và phát một sự kiện sample cho mỗi truy vấn. Vì vậy phải phân biệt số trường hợp trong bộ dữ liệu với tổng số lời gọi, vốn còn gồm bước làm nóng và kiểm thử đầu vào quá dài.
Có thể liên kết câu trả lời với câu hỏi không?
Trong vòng lặp, q['query'] cung cấp yêu cầu và q['id'] cung cấp mã định danh. Cú pháp **r chuyển các trường kết quả vào emit().
Mã định danh rất quan trọng: nó giúp tìm đầu ra tương ứng với từng trường hợp rồi xem xét sai khác. Chỉ một điểm tổng hợp mà không có liên kết này sẽ không đủ để tìm các mã bị thiếu tiền tố REF-.
Yêu cầu cố ý quá lớn có bị từ chối không?
Tiếp theo chương trình gửi 'mot ' * 10000, tức chuỗi mot lặp 10.000 lần. Nó chờ ngoại lệ HTTP có mã 400 hoặc 413. Nếu lời gọi được chấp nhận, chương trình phát sinh AssertionError('oversize accepted').
Đây là kiểm thử âm tính: chủ động gửi đầu vào mà quy trình phải từ chối. Vì vậy trả về không lỗi không phải kiểm thử thành công, mà là thất bại.
Có hai giới hạn khi đọc. Thứ nhất, 10.000 lần lặp không nhất thiết tương đương 10.000 token. Thứ hai, đoạn trích kiểm tra hai mã HTTP này; riêng nó không chứng minh cách xử lý mọi kích thước đầu vào hay mọi lỗi có thể xảy ra.
Giới hạn 2.048 ký tự trong valid_query() và kiểm thử ngữ cảnh này cũng không thay thế cho nhau. Bước đầu kiểm tra đầu vào văn bản ở cấp hàm Python. Bước sau yêu cầu quy trình suy luận từ chối đầu vào quá lớn. Vì phần thân llm() không được trích lại, không nên tự suy diễn cách tất cả kiểm tra nối tiếp nhau bên trong.
Cuối cùng, chỉ khi quy trình đi đến câu lệnh đó thì emit('complete', ...) mới được thực thi. Tìm được sự kiện này là hữu ích, nhưng vẫn phải kiểm tra số lượng và mã định danh mẫu: dấu hiệu kết thúc không thay thế việc kiểm tra dữ liệu.
Kiểm tra, xuất và dọn dấu vết làm việc
Bằng chứng được xuất gồm chỉ số của hai đợt, các kiểm tra xác nhận và nhật ký ghi nhận được tham chiếu trong hồ sơ. Chúng giúp đọc lại các quan sát mà không cần đăng nội dung hay lập tức chạy lại mô hình.
Để xem xét, hãy bắt đầu từ một kết quả, lần ngược đến truy vấn, câu trả lời đã lưu và quy tắc tạo ra điểm của nó. Sau đó kiểm tra mọi trường hợp đã công bố đều được bao phủ, lỗi được giữ lại và dung sai của quy trình được đáp ứng. Đặc biệt, chính ở bước này cần làm rõ quan hệ giữa phạm vi 80 và 60 trường hợp.
Gói được mô tả ở đây không thực hiện thao tác CMS, media hay mạng xã hội nào. Tệp làm việc và tài nguyên cục bộ vẫn do môi trường Lab quản lý. Không nên nhầm việc xuất và dọn chúng với việc xuất bản bài viết này.
Điểm được tính độc lập với câu trả lời của mô hình
Hãy tưởng tượng endpoint tự quyết định kiểm thử tích hợp của nó có thành công không. Đó sẽ không phải kiểm tra độc lập. Cần áp dụng cùng sự thận trọng ở đây: mô hình tạo câu trả lời; một đoạn mã khác so sánh nó với điều mong đợi.
Mô-đun chỉ số công bố các hàm chấm điểm thuần, được dùng ngoại tuyến bởi recorder, công cụ ghi và xử lý kết quả. Trong ngữ cảnh này, «thuần» nghĩa là phép tính điểm phụ thuộc vào đầu vào, không yêu cầu mô hình tự đánh giá. Vì vậy hồ sơ nói đến rà soát xác định, không phải ý kiến con người hay điểm do LLM chấm.
Sự tách biệt này cho phép tính lại điểm từ câu trả lời đã ghi. Nó không tự động khiến việc sinh nội dung của mô hình trở nên xác định. Tính lại trên cùng đầu ra và dùng mô hình tạo đầu ra mới là hai thao tác khác nhau.
Mô-đun có hàm chuẩn hóa và kiểm tra đầu vào, nhưng sự hiện diện của chúng chưa đủ xác định mọi phép biến đổi áp dụng cho điểm nghiêm ngặt của chủ đề này. Điểm được ghi chép vẫn là: thiếu REF- khiến phép so sánh bằng nhau thất bại, dù số lượng và danh mục có thể được giữ đúng.
Bài tập nhỏ: ứng dụng của bạn có chấp nhận câu trả lời không?
Xem lại hai JSON minh họa ở trên. Trước khi đọc lại lời giải thích, hãy tự hỏi bạn chấp nhận điều gì cho một màn hình trình diễn, rồi điều gì cho việc tìm sản phẩm bằng mã định danh chính xác.
Thêm tình huống giả định thứ ba: mã đúng là REF-042, nhưng số lượng đổi từ 3 thành 30. JSON vẫn giải mã dễ dàng. Tuy nhiên câu trả lời không còn đúng với nhu cầu đã mô tả.
Bài tập yêu cầu giải thích riêng phần thuộc cú pháp, định dạng mã tham chiếu và giá trị nghiệp vụ. Nó không tạo ra kết quả benchmark mới.
Có thể đề xuất quy tắc tự thêm REF- vào mã chưa đầy đủ. Đó là thay đổi cách xử lý, không chỉ đọc lại kết quả hiện tại. Trước khi sử dụng, phải xác định khi nào được phép sửa, kiểm tra không gây mơ hồ và kiểm thử riêng. Các điểm công bố ở đây không đo biến thể đó.
Đọc độ trễ và thông lượng cùng nhau
Với ứng dụng của bạn, thời lượng trả lời câu hỏi «lời gọi này mất bao lâu?». Thông lượng trả lời «văn bản được xử lý hay tạo ra nhanh đến mức nào?». Hai thông tin bổ sung cho nhau, không thể thay thế nhau.
Vì thế, 93 token mỗi giây không có nghĩa 93 yêu cầu mỗi giây. Để quy đổi, cần biết độ dài yêu cầu và câu trả lời cũng như cách tổ chức các lời gọi, cùng những yếu tố khác. Các phép đo công bố không mô tả năng lực phục vụ dưới tải này.
Ở đây Q4 có độ trễ thấp hơn và thông lượng cao hơn Q8. Điều đó mô tả các trường hợp này trên máy này với bộ phần mềm này. Hai đợt không bao phủ người dùng đồng thời, prompt thực không tổng hợp, thay đổi phần cứng hay mức tiêu thụ năng lượng.
VRAM là vấn đề khác. Đo ở 1 Hz chỉ cho một quan sát mỗi giây: đỉnh ngắn hơn có thể xuất hiện giữa hai lần đo. Bản tóm tắt không cung cấp số liệu bộ nhớ đủ để định lượng lợi ích Q4/Q8 ở đây. Vì vậy chúng ta không suy ra mức tiết kiệm VRAM cụ thể hay yêu cầu phần cứng tối thiểu đã được xác nhận.
Để đọc bảng mà không suy diễn quá mức, luôn giữ cùng nhau biến thể, bộ trường hợp, hợp đồng đầu ra và phương pháp đo. Một con số riêng lẻ chưa đủ để chọn cấu hình cho sản phẩm khác.
Nguồn và giới hạn về xuất xứ
Kết quả đến từ đâu?
Tài liệu gốc cho biết quá trình biên soạn đã đối chiếu báo cáo, chỉ số, quy trình, tệp khóa và xác nhận cuối của gói lưu trữ. Tài liệu cũng nói phép tính kiểm tra lại thu được các giá trị đã ghi nhận. Kết quả trình bày ở đây thuộc hồ sơ đó, không phải đợt chạy mới dành cho phiên bản hướng dẫn này.
Một giới hạn cần được nêu rõ: mã nguồn dùng lúc ghi nhận thuộc các phiên bản lịch sử khác với nền tảng Lab đang cài. Phải giữ sự khác biệt này trong hồ sơ kiểm tra. Riêng điều đó không phủ nhận tính nhất quán nội bộ được báo cáo giữa các quan sát; nhưng không được giả định nền tảng hiện tại tự động tái tạo mã lịch sử.
Điều này giống khác biệt giữa commit tạo ra kết quả CI và nhánh đang mở trong trình soạn thảo. Muốn hiểu kết quả cũ, cần giữ danh tính của mã đã tạo ra nó.
Hai ghi chú chưa rõ quan hệ với chủ đề
Phiếu gốc còn có dòng «Dữ liệu tổng hợp trừ FLEURS» và ghi chú mang mã 010: so sánh khả năng ngữ cảnh, prompt xác định dưới giới hạn và sinh 64 token.
Trong khi đó chủ đề Q4/Q8 mang mã 006. Các tài liệu được cung cấp không giải thích hai ghi chú liên quan thế nào đến phép đo của nó. Chúng được giữ như thông tin xuất xứ, nhưng không suy ra FLEURS thuộc các trường hợp Q4/Q8 hay đầu ra của so sánh này bị giới hạn 64 token. Những điểm đó phải được xác định trong quy trình tương ứng, không bổ sung bằng phỏng đoán.
Các tài liệu tham khảo bổ sung dùng để làm gì?
Các liên kết đến tài liệu Qwen, GGUF, llama.cpp, Python và Docker giúp giải thích khái niệm. Chúng không thay thế phiên bản được cố định trong thí nghiệm và không bổ sung xác nhận GPU nào. Tài liệu hiện hành có thể trình bày mô hình hoặc lệnh khác: không được dùng chúng để thay thế quy trình đã đo.
Truy vết thí nghiệm này
Phần này tập hợp những yếu tố cần để xác định đợt chạy và hiểu điều kiện chạy lại. Bạn có thể đọc như hồ sơ kỹ thuật của một kiểm thử: đã chạy bằng gì, khi nào và từ những tệp nào?
Mô hình và các tệp
Hai biến thể đến từ Qwen/Qwen2.5-7B-Instruct-GGUF, ở bản sửa đổi:
bb5d59e06d9551d752d08b292a50eb208b07ab1f
Giấy phép khai báo trong hồ sơ là Apache-2.0 cho q4 và apache-2.0 cho q8. Dấu vân tay riêng của các tệp được giữ trong locks/models.lock.json.
Thông tin này xác định tài nguyên đã kiểm thử, không chỉ một phiên bản hiện tại được khuyến nghị. Kho ở đúng bản sửa đổi này giúp phân biệt các tệp đó với tệp của nhánh có thể đã thay đổi.
Phần cứng và môi trường được ghi nhận
Phép tính của chủ đề này dùng một RTX 3090. Cả hai GPU trên máy được dành riêng trong lúc đo: điều đó không có nghĩa phép tính được chia trên hai card.
Trình điều khiển được ghi nhận là 580.95.05. Image máy khách được chạy có mã định danh:
sha256:545518febcd04dce9c9d8b1168af1ce518508901adb517489028ccb5b456ecc2
Không được gọi lại dấu vân tay image máy khách này là dấu vân tay của máy chủ llama.cpp. Hồ sơ ghi riêng các thành phần môi trường.
Bản phân phối và phiên bản Linux chính xác không được ghi trong tệp khóa này. Do đó các thông tin này không chứng minh khả năng tương thích với mọi bản cài Linux.
Hai lần chạy ngày 11 tháng 9 năm 2026
Đợt thứ nhất. Mã run_id: 20260911t123640-73f55072a554. Thời điểm bắt đầu được ghi: 2026-09-11T12:36:40.823741+00:00. Thời lượng ghi nhận: 63.48 s.
Đợt thứ hai. Mã run_id: 20260911t123744-fc0c359a445d. Thời điểm bắt đầu được ghi: 2026-09-11T12:37:44.604541+00:00. Thời lượng ghi nhận: 63.99 s.
Hậu tố +00:00 cho biết dấu thời gian dùng UTC. Thời lượng áp dụng cho các lệnh được ghi nhận, không phải tổng thời gian cài đặt, tải xuống hay thao tác của con người.
Bản bàn giao mang mã r1. Dấu vân tay mã được ghi nhận là:
e94fd5ca24d24d216757e79747f1c555bd142b3a81f39a0c81346a07d3eebfea
Đợt thứ hai bắt đầu từ không gian làm việc và các volume ứng dụng mới. Tài nguyên bất biến đã được kiểm tra được tái sử dụng: vì vậy «lần chạy sạch» không có nghĩa «tải lại mọi tệp từ đầu».
Hai đợt vẫn chỉ là quan sát trên máy đã khai báo. Hồ sơ cho biết các phép tính được kiểm tra từ đầu ra nhận được; không có huấn luyện hay suy luận GPU nào được chạy lại trên máy biên tập.
Trước khi chạy: có sẵn Lab và tài nguyên
Điểm khởi đầu là Lab đi kèm POC, dự án thử nghiệm minh họa, đã được cài trên máy GPU. Nó gồm labctl, lab/, batchkit/, scripts/ và các tệp khóa.
ZIP chứa chương trình và bằng chứng, nhưng không chứa image Docker hay trọng số mô hình. Bản bàn giao này không tạo URL công khai để tải POC. Toàn bộ mã nằm trong bộ công cụ làm việc; riêng các đoạn trích trên trang không đủ để dựng lại một bản cài đã được xác nhận.
Cần có Docker Compose và quyền truy cập GPU qua NVIDIA, rồi lấy tài nguyên đúng bản sửa đổi và dấu vân tay được chỉ định. Mẫu Compose dùng đường dẫn riêng của máy và pull_policy: never: image phải có sẵn. Theo tài liệu chính thức Docker Compose, chính sách này cấm tự động tải image và gây lỗi nếu image chưa có cục bộ.
Trọng số và dữ liệu được gắn ở chế độ chỉ đọc. Đừng thay bản sửa đổi bằng main, image cụ thể bằng latest, hay tệp đã kiểm tra bằng trọng số khác chỉ để vượt qua việc thiếu tài nguyên: như vậy bạn đã thay đổi thí nghiệm.
Chạy lệnh đã ghi chép
Chuyển vào thư mục Lab đã cài. Lệnh dưới đây được trích từ README; trình khởi chạy chuẩn bị đường dẫn và dự án Compose rồi chạy chương trình trong container.
Nguồn cố định: poc/README.md, dòng 4. SHA-256 của tệp nguồn đã ghi nhận: ad09840e896cada8ad36cfc3bc888a6aca9492a857591026d9c59964795324ee.
./labctl run --machine gpu --batch 2026-09-11 --topic gguf-q4-q8-mesures
Các tùy chọn xác định máy GPU, lô ngày 2026-09-11 và chủ đề gguf-q4-q8-mesures. Ngày này chỉ lô công việc, không phải lịch chạy trong tương lai.
Sau khi chạy, hãy giữ đầu ra, lỗi và tệp kiểm thử. Kiểm tra mẫu, mức bao phủ và dung sai của hai đợt từ các dữ liệu đã lưu, thay vì chỉ dựa vào việc terminal không báo lỗi.
Trạng thái đã là PACKAGED không nhất thiết kích hoạt thí nghiệm mới khi resume. Muốn biết đã thực sự chạy lại phép tính hay chưa, hãy tìm lần chạy và run_id của nó. Hai lần chạy lại sạch được ghi chép ở đây chính là những lần đã nêu phía trên.
Mọi thay đổi mã, dữ liệu, mô hình hoặc quy trình đều cần bản sửa đổi mới và bản ghi mới. Không được gán điểm cũ cho biến thể đó.
Khi gặp lỗi và khi dọn dẹp
Thiếu image, điểm gắn không tồn tại hoặc hết thời gian chờ đều cho thấy một điều kiện cần giải quyết. Hãy dừng quy trình và xác định thành phần thiếu. Âm thầm đổi bộ máy suy luận hoặc tham số để chạy thành công sẽ không tái hiện kiểm thử đã ghi chép.
Việc dọn quy trình này thuộc trình khởi chạy và dự án Compose của nó. Makefile nhận được không có mục tiêu clean độc lập; vì vậy không đề xuất lệnh xóa toàn cục nào. Hãy giữ các gói lưu trữ riêng và trọng số dùng chung, vì chúng có thể phục vụ thí nghiệm khác.
Những điều đã học
Ở đây Q4 đạt điểm nghiêm ngặt tốt hơn cùng độ trễ và thông lượng tốt hơn Q8. Kết quả thuộc hai đợt đo, một mô hình ở bản sửa đổi cụ thể, dữ liệu tổng hợp và một hợp đồng đầu ra xác định.
Điểm hữu ích nhất cho lập trình viên nằm trong các câu trả lời: số lượng đúng không nhất thiết bù được mã tham chiếu thiếu. Cần biết ứng dụng mong đợi gì trước khi quyết định «điểm tốt» nghĩa là gì.
Chúng ta cũng phân biệt ba việc: đọc lại câu trả lời đã lưu, tính lại điểm và chạy lại mô hình. Chúng bổ sung cho nhau nhưng không phải cùng một kiểu xác nhận.
Để áp dụng phương pháp cho dự án khác, hãy bắt đầu bằng hợp đồng đầu ra và các trường hợp kiểm thử. Xem những lỗi cụ thể, rồi đo hiệu năng trong điều kiện bạn quan tâm. Lựa chọn đúng không phải lựa chọn có tên nghe đáng tin nhất, mà là lựa chọn bạn đã kiểm tra hành vi cho nhu cầu của mình.