





Vous développez une fonctionnalité qui transforme une demande en données exploitables par votre application. Par exemple : retrouver une référence produit, une quantité et une catégorie, puis les retourner en JSON. Jusqu'ici, le besoin ressemble à celui d'une API classique. La différence, c'est qu'un modèle de langage produit la réponse.
Au moment de l'exécuter sur votre machine, vous découvrez plusieurs fichiers pour le même modèle : Q4_K_M, Q8_0… Lequel choisir ? Le plus volumineux sera-t-il forcément le plus fiable ? Le plus compact sera-t-il assez précis pour alimenter votre application ?
Nous allons examiner deux campagnes de mesure réalisées avec Qwen2.5 7B, dans deux versions quantifiées. L'objectif n'est pas de couronner un vainqueur universel : il est d'apprendre à lire les résultats, à comprendre ce qu'un test vérifie et à relier ces observations à un besoin de développement.
La question centrale sera très concrète : une réponse qui conserve une quantité, mais oublie une partie de la référence produit, est-elle utilisable par votre code ?
Savoir lire du Python, manipuler du JSON et utiliser Docker suffit pour suivre les explications. Nous ne réentraînons pas de modèle. Le parcours d'exécution présenté plus loin suppose toutefois de disposer du Lab et des fichiers de l'expérience : ce n'est pas une installation autonome depuis une machine vierge.
Deux campagnes sur un protocole identique
D'abord, que signifie « quantifier un modèle » ?
Un modèle contient des valeurs numériques, appelées poids ou paramètres, qui interviennent dans ses calculs. La quantification consiste à représenter ces valeurs avec une précision réduite pour diminuer leur encombrement. C'est notamment ce qui permet d'utiliser des modèles avec moins de mémoire. Le guide de Hugging Face sur la quantification présente ce principe et ses compromis.
Pour vous en faire une image, pensez à un arrondi : conserver 0,12 plutôt que 0,123456 préserve une approximation, mais perd de l'information. C'est une analogie, pas la formule utilisée par les fichiers de cette expérience. Les méthodes réelles encodent des groupes de valeurs et des informations supplémentaires.
Dans cette comparaison, les deux noms désignent des recettes de quantification différentes :
| Variante | Ce qu'il faut retenir pour lire l'expérience |
|---|---|
Q4_K_M |
Une recette de la famille des quantifications à 4 bits, avec un mélange de précisions selon les poids. Il ne faut pas lire ce nom comme « exactement 4 bits pour chaque paramètre, sans autre information ». |
Q8_0 |
Une recette de quantification à 8 bits, qui conserve une représentation plus fine des poids que les formats à plus faible précision. Ce nom ne constitue pas une garantie de réussite sur chaque requête. |
La documentation de Qwen consacrée à llama.cpp explique la quantification des poids et les mélanges de types. La documentation de l'outil de quantification de llama.cpp décrit les variantes disponibles.
Retenez surtout la différence entre précision des nombres stockés et exactitude d'une réponse attendue par votre application. Notre expérience mesure la seconde dans un cadre précis ; elle ne permet pas de les confondre.
Le modèle, le fichier et le moteur ont des rôles différents
Qwen2.5-7B-Instruct est le modèle. 7B indique sa classe de taille, de l'ordre de sept milliards de paramètres, et Instruct désigne une variante adaptée au suivi d'instructions. Sa fiche officielle à la révision utilisée documente le modèle distribué.
GGUF est le format des fichiers : il contient les poids et les métadonnées nécessaires à leur chargement. Ce n'est ni le nom du modèle ni, à lui seul, un niveau de quantification. La spécification GGUF décrit ce rôle.
llama.cpp est le moteur qui charge ces fichiers et exécute le modèle. Utiliser un modèle déjà entraîné pour produire une réponse s'appelle l'inférence. Dans notre parcours, un programme Python adresse ses demandes à un serveur local llama.cpp ; la documentation du serveur présente cette interface.
Ce qui reste identique entre les deux variantes
Les campagnes comparent Q4_K_M et Q8_0 du même modèle, à la même révision, dans une image llama.cpp verrouillée. « Verrouillée » signifie ici que l'on conserve une version identifiée, plutôt que de récupérer automatiquement la dernière disponible.
Le protocole annonce 80 cas synthétiques par mode et par campagne. Un cas synthétique est un exemple construit pour le test, et non une demande prélevée telle quelle dans le trafic réel d'une application. Deux campagnes GPU complètes ont été capturées ; le dossier d'expérience indique que leurs métriques ont ensuite été recalculées.
Le périmètre enregistré est le sujet 006, avec les modes ['q4', 'q8'], deux exécutions propres et une revue déterministe hors processus. Autrement dit, les résultats sont contrôlés par du code à partir des sorties enregistrées, sans demander à un autre modèle de leur attribuer une note. Aucun gain n'est exigé à l'avance : le protocole doit pouvoir rapporter un avantage, une absence d'avantage ou une limite.
Les mesures restent celles d'un seul poste. La mémoire du GPU, appelée VRAM, est relevée une fois par seconde, soit à 1 Hz. Il n'y a pas de relecture humaine ou par LLM revendiquée pour l'évaluation des réponses. Les latences sont descriptives, pas des garanties de performance.
Le petit programme qui orchestre les demandes
Voici le cœur du parcours. L'extrait conserve la logique du code enregistré, avec une mise en forme plus aérée. Les fonctions ready(), llm() et emit(), ainsi que DATA et SCHEMA, sont définies ailleurs dans le projet : ce bloc ne constitue pas un programme autonome.
Source figée : poc/experiment.py, lignes 99–107. SHA-256 du fichier source enregistré : f50240fa92614d1399c672ed91574bacacc805d2c0c377b6830c8831733bf17d.
def quant():
    elapsed = ready('http://server:8080', '/health')
    emit('load', ready_seconds=elapsed)

    llm(DATA['queries'][0]['query'], SCHEMA)

    for q in DATA['queries']:
        r = llm(q['query'], SCHEMA)
        emit('sample', sample_id=q['id'], **r)

    try:
        llm('mot ' * 10000, SCHEMA)
    except urllib.error.HTTPError as e:
        assert e.code in (400, 413)
        emit('test', test_id='context-limit', status='passed')
    else:
        raise AssertionError('oversize accepted')

    emit('complete', samples=len(DATA['queries']))
Le programme attend le serveur, effectue une première demande de chauffe, puis parcourt les requêtes du jeu de données. Pour chacune, il enregistre un événement sample associé à son identifiant. Enfin, il vérifie le refus d'une entrée volontairement trop longue et signale la fin du parcours.
Les empreintes SHA-256 citées dans cet article identifient les fichiers sources du dossier d'expérience. Elles ne sont pas les empreintes des blocs de code remis en forme sur cette page. Nous reviendrons sur leur utilité lors de la reproduction.
Des mesures reproductibles sur les deux campagnes
Avant de lire les chiffres, distinguons trois questions. L'égalité stricte demande si la sortie correspond exactement au résultat attendu selon le comparateur du projet. La latence décrit un temps de réponse mesuré. Le débit, exprimé en tokens par seconde, décrit une vitesse de traitement ou de génération selon la mesure retenue.
Un token est une unité de texte manipulée par le modèle ; ce n'est pas nécessairement un mot entier. La documentation du serveur llama.cpp distingue notamment les informations de traitement du prompt et de génération. Il faut donc conserver la définition du débit employée par l'expérience, et pas seulement son unité.
Voici les valeurs rapportées, sans modifier leur précision :
| Campagne | Variante | Égalité stricte | Latence reportée | Débit reporté |
|---|---|---|---|---|
| 1 | Q4_K_M | 1,00 | 0,251324 s | Environ 131 tokens/s |
| 2 | Q4_K_M | 1,00 | 0,252973 s | Environ 130 tokens/s |
| 1 | Q8_0 | 0,0666667 | 0,333810 s | Environ 93 tokens/s |
| 2 | Q8_0 | 0,0666667 | 0,333744 s | Environ 93 tokens/s |
Pour se représenter les durées, Q4 se situe ici autour d'un quart de seconde, contre environ un tiers de seconde pour Q8. Le score strict vaut 100 % pour Q4 et environ 6,67 % pour Q8, sur la métrique rapportée, pas sur « toutes les capacités du modèle ».
Les valeurs des deux campagnes sont proches. C'est une observation utile sur ces exécutions, mais deux campagnes ne suffisent pas à garantir la même stabilité sous d'autres charges ou sur d'autres machines.
Le résumé fourni ne précise pas l'agrégation des latences. Nous les appelons donc « latences reportées », sans les rebaptiser moyennes, médianes ou temps d'attente avant le premier token.
Ce que la métrique stricte mesure réellement
Du JSON lisible n'est pas forcément du JSON utilisable
Le rapport indique que Q8 conserve les quantités et les catégories dans 60 cas, mais omet souvent le préfixe REF-. Cette omission fait échouer l'égalité exacte. Le contraste entre les scores devient beaucoup plus compréhensible lorsqu'on regarde ce détail.
Prenons un exemple pour voir le problème. Les deux objets suivants sont des illustrations pédagogiques : ils ne reproduisent ni une sortie capturée ni le schéma exact du POC.
Votre application pourrait attendre :
{
  "reference": "REF-042",
  "quantite": 3,
  "categorie": "accessoires"
}
Et recevoir :
{
  "reference": "042",
  "quantite": 3,
  "categorie": "accessoires"
}
Les deux objets sont du JSON syntaxiquement valide. La quantité et la catégorie sont identiques. Pourtant, les références sont différentes.
Si votre application recherche un produit par sa référence exacte, elle ne peut pas supposer que 042 et REF-042 désignent la même chose. Le test strict ne se montre donc pas nécessairement « trop sévère » : il peut simplement vérifier le contrat dont le logiciel a besoin.
C'est un raisonnement familier en développement web. Un endpoint peut retourner un statut HTTP de succès et un JSON décodable, tout en renvoyant une mauvaise valeur métier. Le succès du transport, la validité de la structure et l'exactitude du contenu sont trois questions distinctes.
Ce que le score permet de dire — et ce qu'il ne permet pas de dire
Dans cette expérience, Q4 obtient un meilleur résultat sur l'égalité stricte. Cela ne démontre pas que Q8 « comprend moins bien » toutes les demandes, ni que Q4 sera supérieur pour un autre usage. L'observation sur les quantités et les catégories montre justement que le score strict ne résume pas toutes les propriétés des réponses.
À l'inverse, constater que certains champs sont corrects ne suffit pas à déclarer la réponse globalement correcte. Une référence incomplète peut bloquer l'intégration, même lorsque le reste semble plausible.
Le code du comparateur exact n'est pas reproduit dans les extraits de cette page. Nous ne pouvons donc pas en déduire, par exemple, comment il traite l'ordre des clés JSON, les espaces ou une éventuelle normalisation. L'effet de l'omission de REF- est rapporté ; les autres règles doivent être lues dans le comparateur du kit.
Pourquoi trouve-t-on à la fois 80 et 60 cas ?
Le protocole annonce 80 cas par mode et par campagne. Le commentaire sur les quantités et catégories, ainsi que le visuel ci-dessous, mentionnent 60 cas. Le texte disponible ne précise pas le lien entre ces deux périmètres.
Nous conservons donc ces indications, sans inventer une répartition entre sous-ensembles. En particulier, nous ne transformons pas le score 0,0666667 en un nombre de réussites sur 80 cas. Pour établir ce décompte, il faut retrouver dans les résultats détaillés les identifiants évalués et le dénominateur exact du score.
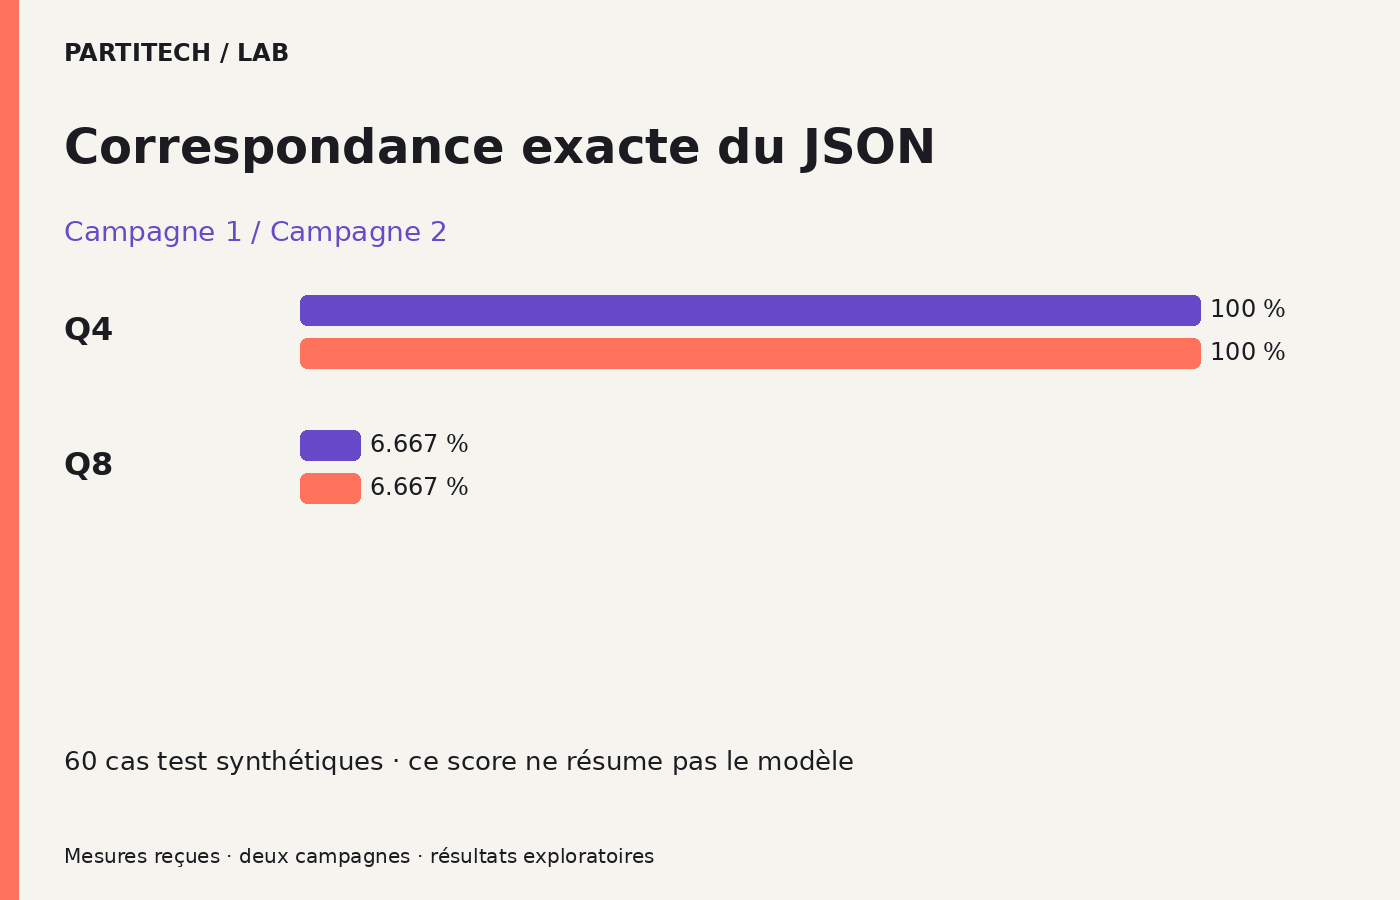
La mention « 60 cas test synthétiques » du visuel appartient au document d'origine. Elle ne remplace pas le périmètre de 80 cas annoncé pour chaque mode.
Portée et reprise documentée
Les observations portent sur des données synthétiques, un seul hôte et une pile logicielle figée. La reprise de l'expérience dépend du socle Lab local, de l'image llama.cpp et des modèles verrouillés.
Cela ressemble à un test d'intégration dont vous conservez le code, les jeux de données et les versions des services. Relire ses résultats ne revient pas à l'exécuter à nouveau ; le lancer avec d'autres dépendances ne reproduit pas nécessairement la même expérience.
Le projet contient aussi des fonctions de métriques et des tests de leurs entrées. Voici l'extrait fourni, lui aussi remis en forme sans changer sa logique.
Source figée : poc/metrics.py, lignes 30–44. SHA-256 du fichier source enregistré : 9d39a8d113cc112f5ece7ecbf6454f0cbe46ceddd847c4af25789ead12171899.
def valid_query(q):
    if not isinstance(q, str) or not q.strip() or len(q) > 2048:
        raise ValueError('invalid query')
    return q


def unit():
    assert (
        distance('chat', 'chats') == 1
        and distance([], ['x']) == 1
        and distance('abc', 'adc') == 1
    )
    assert normalize('ÉTÉ, bonjour!') == 'été bonjour'
    assert rank_metrics([2, 1], [1]) == {
        'recall5': 1.0,
        'mrr10': .5,
        'ndcg10': 1 / math.log2(3),
    }
    assert rank_metrics([2], []) == {
        'recall5': 0,
        'mrr10': 0,
        'ndcg10': 0,
    }
    assert bm25(
        [{'id': 0, 'text': 'chat'}, {'id': 1, 'text': 'chien'}],
        'chat',
    )[0][0] == 0
    assert bm25([], 'x') == [] and rrf([(1, 1)], [(2, 1)])[0][1] == 1 / 61

    for x in ['', None, {}, 42, 'x' * 2049]:
        try:
            valid_query(x)
        except ValueError:
            pass
        else:
            raise AssertionError('query guard')
Lire valid_query() comme une validation de formulaire
Cette fonction exige une chaîne de caractères, refuse une chaîne vide ou composée uniquement d'espaces et impose une longueur maximale de 2 048 caractères. Lorsqu'une de ces conditions échoue, elle lève ValueError('invalid query').
Un détail mérite l'attention : q.strip() sert seulement au contrôle. La fonction retourne q, pas q.strip(). Elle ne supprime donc pas les espaces dans la valeur rendue à l'appelant.
Dans unit(), la boucle essaie plusieurs entrées interdites : une chaîne vide, None, un dictionnaire, un nombre et une chaîne de 2 049 caractères. Si l'une d'elles passe sans erreur, le test échoue avec AssertionError('query guard'). C'est la même logique qu'un test backend vérifiant le refus d'un champ manquant ou trop long.
Pourquoi voit-on aussi des tests de recherche et de classement ?
Les autres assertions contrôlent des fonctions de distance, de normalisation, de classement et de recherche présentes dans le module de métriques. Par exemple, le test de normalize() attend que ÉTÉ, bonjour! devienne été bonjour : dans cet exemple, la casse et la ponctuation changent, mais les accents restent présents.
Les noms rank_metrics, bm25 et rrf apparaissent dans l'extrait. Leur présence ne signifie pas que le score Q4/Q8 est une combinaison de tous ces tests, ni que l'expérience met en place un moteur de recherche. Ce bloc vérifie des utilitaires ; il ne montre pas à lui seul le calcul complet de l'égalité stricte.
L'idée à retenir est simple : le programme chargé de mesurer doit lui aussi être testé. Mais réussir ses tests unitaires ne démontre ni la qualité générale du modèle ni la représentativité du jeu de données.
Actifs locaux et versions enregistrées
Pour reprendre cette expérience, le code Python ne suffit pas. Il faut également les fichiers de poids, les images Docker et le socle Lab dans les versions documentées. Ce sont les actifs locaux mentionnés dans le dossier : les éléments nécessaires à l'exécution, déjà présents sur le poste.
Le verrou d'environnement enregistre notamment le pilote et l'image llama.cpp. Le verrou des modèles identifie Qwen2.5 7B et les fichiers GGUF Q4_K_M et Q8_0 par leurs empreintes. Le paquet ne télécharge rien automatiquement.
Vous pouvez rapprocher ce principe d'un fichier composer.lock ou d'un verrou de dépendances JavaScript : on cherche à retrouver une configuration précise, pas seulement des composants portant le même nom.
Une empreinte SHA-256 est une valeur calculée à partir du contenu d'un fichier. Elle permet de comparer le fichier présent à celui attendu, au lieu de se fier à son nom. La documentation de Python sur hashlib présente cette famille de fonctions. Ici, les empreintes servent à identifier les actifs de l'expérience ; elles ne prouvent pas à elles seules leur qualité ou celle des résultats.
Comment le lanceur prépare l'expérience
Le README associe ce sujet à une commande labctl, à lancer depuis le Lab déjà installé. labctl est le lanceur de cet environnement : ce n'est pas une commande fournie par Python ou par Docker.
D'après la procédure enregistrée, il adapte les chemins du gabarit Docker Compose, vérifie les empreintes des actifs, puis démarre le programme Python dans le conteneur. Le gabarit est la configuration de départ ; l'adaptation permet de lui fournir les emplacements attendus sur le poste concerné.
Les chemins demandent un peu d'attention. /poc et /assets sont des chemins à l'intérieur du conteneur. Les chemins commençant par /llm, visibles dans les captures, appartiennent au poste d'origine. Les recopier tels quels sur une autre machine ne garantit pas qu'ils y désignent les bons fichiers.
Le lancement exact est conservé dans la section de reproduction, avec les prérequis. La description de cette procédure indique comment reprendre l'expérience ; elle ne signifie pas qu'une nouvelle exécution a été effectuée pendant la préparation de l'article.
Les gardes de mesure visibles dans le code gelé
Revenons à quant(). Chaque étape répond à une question assez proche de celles que vous poseriez en testant une API.
Le service est-il prêt à recevoir la demande ?
ready('http://server:8080', '/health') attend le service local. La durée retournée est enregistrée dans un événement load, avec le champ ready_seconds.
Le nom load ne doit pas faire oublier ce que l'extrait montre réellement : une attente de disponibilité. Sans lire l'implémentation de ready(), nous ne pouvons pas assimiler cette valeur au seul temps de chargement des poids sur le GPU.
La première requête est-elle distinguée de la boucle de mesure ?
Avant la boucle, le programme appelle llm() avec la première requête du jeu de données. C'est la demande de chauffe annoncée dans le protocole. Elle prépare le parcours avant les appels enregistrés comme échantillons.
Cette ligne n'est pas accompagnée d'un emit('sample', ...) dans l'extrait. La boucle reprend ensuite toutes les requêtes, y compris la première, et émet un événement sample pour chacune. Il faut donc distinguer le nombre de cas du jeu de données du nombre total d'appels effectués, qui comprend aussi la chauffe et le test d'entrée trop longue.
Peut-on rattacher une réponse à sa question ?
Dans la boucle, q['query'] fournit la demande et q['id'] son identifiant. La notation **r transmet les champs du résultat à emit().
L'identifiant est important : il permet de retrouver quelle sortie correspond à quel cas, puis d'examiner les désaccords. Un score global sans ce lien ne permettrait pas, à lui seul, de retrouver les références auxquelles il manque le préfixe REF-.
Une demande volontairement excessive est-elle refusée ?
Le programme envoie ensuite 'mot ' * 10000, c'est-à-dire la chaîne mot répétée 10 000 fois. Il attend une exception HTTP dont le code vaut 400 ou 413. Si cet appel est accepté, il lève AssertionError('oversize accepted').
C'est un test négatif : on envoie volontairement une entrée que le parcours doit refuser. Un retour sans erreur n'est donc pas une réussite du test, mais son échec.
Attention à deux limites de lecture. D'abord, 10 000 répétitions ne signifient pas nécessairement 10 000 tokens. Ensuite, l'extrait vérifie ces deux codes HTTP ; il ne prouve pas à lui seul le traitement de toutes les tailles d'entrée, ni de toutes les erreurs possibles.
La garde de 2 048 caractères dans valid_query() et ce test de contexte ne sont pas non plus interchangeables. La première vérifie une entrée textuelle au niveau d'une fonction Python. Le second demande au parcours d'inférence de refuser une entrée excessive. Le corps de llm() n'étant pas reproduit, il ne faut pas inventer la manière dont tous les contrôles s'enchaînent à l'intérieur.
Enfin, emit('complete', ...) n'est atteint que si le parcours arrive jusqu'à cette instruction. Retrouver cet événement est utile, mais il faut aussi contrôler le nombre et les identifiants des échantillons : un marqueur de fin ne remplace pas la vérification des données.
Vérifier, exporter et retirer les traces de travail
Les preuves exportées comprennent les métriques des deux campagnes, les contrôles de validation et les journaux de capture référencés dans le dossier. Leur rôle est de permettre une relecture des observations, sans devoir publier du contenu ni relancer immédiatement le modèle.
Pour les examiner, partez d'un résultat et remontez à sa requête, à sa réponse enregistrée, puis à la règle qui a produit son score. Vérifiez ensuite que tous les cas annoncés sont couverts, que les erreurs sont conservées et que les tolérances prévues par le protocole sont respectées. C'est notamment à cette étape que doit être clarifié le lien entre les périmètres de 80 et de 60 cas.
Le paquet décrit ici ne réalise aucune opération CMS, média ou réseau social. Les fichiers de travail et les actifs locaux restent gérés dans l'environnement Lab. Leur export et leur nettoyage ne doivent pas être confondus avec la publication de cet article.
Un score calculé hors de la réponse du modèle
Imaginez que votre endpoint puisse décider lui-même si son test d'intégration est réussi. Ce ne serait pas un contrôle indépendant. La même précaution s'applique ici : le modèle produit une réponse ; un autre morceau de code la compare à ce qui est attendu.
Le module de métriques annonce des scoreurs purs, utilisés hors ligne par le recorder, l'outil qui enregistre et traite les résultats. Dans ce contexte, « purs » signifie que le calcul du score dépend de ses entrées, sans demander au modèle de s'autoévaluer. Le dossier parle donc d'une revue déterministe, pas d'un avis humain ni d'une notation par un LLM.
Cette séparation permet de recalculer un score à partir d'une réponse déjà capturée. Elle ne rend pas la génération du modèle automatiquement déterministe. Refaire le calcul sur les mêmes sorties et obtenir de nouvelles sorties avec le modèle sont deux opérations différentes.
Le module contient une fonction de normalisation et des validations d'entrée, mais leur présence ne suffit pas à établir toutes les transformations appliquées au score strict de ce sujet. Le point documenté reste le suivant : l'omission de REF- fait échouer cette égalité, même lorsque des quantités et catégories sont conservées.
Petit exercice : votre application accepterait-elle la réponse ?
Reprenez les deux JSON illustratifs présentés plus haut. Avant de relire l'explication, demandez-vous ce que vous accepteriez pour un écran de démonstration, puis pour une recherche de produit par identifiant exact.
Ajoutons une troisième situation imaginaire : la référence est bien REF-042, mais la quantité passe de 3 à 30. Le JSON peut encore se décoder sans difficulté. La réponse n'est pourtant plus correcte pour le besoin décrit.
L'exercice consiste à expliquer séparément ce qui relève de la syntaxe, du format de la référence et de la valeur métier. Il ne produit aucun nouveau résultat de benchmark.
On pourrait proposer une règle qui ajoute automatiquement REF- aux références incomplètes. Ce serait une modification du traitement, pas une simple relecture des résultats actuels. Avant de l'utiliser, il faudrait définir les cas où cette correction est autorisée, vérifier qu'elle n'introduit pas d'ambiguïté et la tester séparément. Les scores publiés ici ne mesurent pas cette variante.
Lire latence et débit ensemble
Pour votre application, une durée répond à la question « combien de temps cet appel prend-il ? ». Un débit répond plutôt à « à quelle vitesse le texte est-il traité ou produit ? ». Ces informations se complètent ; elles ne sont pas interchangeables.
Ainsi, 93 tokens par seconde ne signifient pas 93 requêtes par seconde. Pour passer de l'un à l'autre, il faudrait notamment connaître la longueur des demandes et des réponses, ainsi que l'organisation des appels. Les mesures publiées ne décrivent pas cette capacité de service sous charge.
Q4 présente ici des latences plus faibles et un débit plus élevé que Q8. Cela décrit ces cas, sur ce poste, avec cette pile. Les deux campagnes ne couvrent ni des utilisateurs simultanés, ni des prompts réels non synthétiques, ni des changements de matériel, ni la consommation énergétique.
La VRAM est un autre sujet. Un relevé à 1 Hz ne donne qu'une observation par seconde : un pic plus bref peut se produire entre deux relevés. Le résumé ne fournit pas de valeurs de consommation mémoire permettant de chiffrer ici un gain Q4/Q8. Nous n'en déduisons donc ni économie précise de VRAM ni minimum matériel validé.
Pour lire le tableau sans lui faire dire davantage, gardez toujours ensemble la variante, le jeu de cas, le contrat de sortie et la méthode de mesure. Le nombre seul ne suffit pas à choisir une configuration pour un autre produit.
Sources et limite de provenance
D'où viennent les résultats ?
Le document d'origine indique que la rédaction a recoupé le rapport, les métriques, le protocole, les verrous et la validation finale de l'archive. Il rapporte aussi qu'un recalcul de contrôle retrouve les valeurs capturées. Les résultats présentés ici sont ceux de ce dossier, pas ceux d'une nouvelle campagne exécutée pour cette version pédagogique.
Une limite doit rester visible : les sources utilisées lors des captures correspondent à des versions historiques distinctes du socle Lab installé. Il faut conserver cette différence dans le dossier d'audit. Elle n'annule pas, à elle seule, la cohérence interne rapportée entre les observations ; elle interdit en revanche de supposer que le socle présent reproduit automatiquement le code historique.
C'est comparable à une différence entre le commit qui a produit un résultat de CI et la branche actuellement ouverte dans votre éditeur. Pour comprendre le résultat ancien, on conserve l'identité du code qui l'a produit.
Deux notes dont le rattachement au sujet reste à préciser
La fiche d'origine comporte aussi la mention « Données synthétiques sauf FLEURS » et une note identifiée 010 : capacités de contexte comparées, prompts déterministes sous la limite et génération de 64 tokens.
Le sujet Q4/Q8 est, lui, identifié 006. Les éléments fournis n'expliquent pas comment ces deux notes se rattachent à ses mesures. Elles sont conservées comme indications de provenance, mais nous n'en déduisons ni que FLEURS fait partie des cas Q4/Q8, ni que les générations de ce comparatif ont une limite de 64 tokens. Ces points doivent être établis dans le protocole concerné, pas complétés par supposition.
À quoi servent les références complémentaires ?
Les liens vers les documentations de Qwen, de GGUF, de llama.cpp, de Python et de Docker servent à expliquer les concepts. Ils ne remplacent pas les versions verrouillées de l'expérience et n'ajoutent aucune validation GPU. Une documentation actuelle peut montrer d'autres modèles ou d'autres commandes : elle n'autorise pas à les substituer au parcours mesuré.
Traçabilité de cette expérience
Cette section rassemble les éléments nécessaires pour identifier la campagne et comprendre les conditions de sa reprise. Vous pouvez la lire comme la fiche technique d'un test : avec quoi a-t-il été exécuté, quand, et à partir de quels fichiers ?
Le modèle et ses fichiers
Les deux variantes proviennent de Qwen/Qwen2.5-7B-Instruct-GGUF, à la révision :
bb5d59e06d9551d752d08b292a50eb208b07ab1f
Les licences déclarées dans le dossier sont Apache-2.0 pour q4 et apache-2.0 pour q8. Les empreintes individuelles des fichiers sont conservées dans locks/models.lock.json.
Ces informations identifient les actifs testés. Elles ne désignent pas une version actuelle recommandée. Le dépôt à cette révision précise permet de distinguer ces fichiers de ceux d'une branche qui aurait évolué.
Le matériel et l'environnement enregistrés
Le calcul de ce sujet utilise une RTX 3090. Les deux GPU du poste sont réservés pendant les mesures : cela ne signifie pas que le calcul est réparti sur deux cartes.
Le pilote enregistré est 580.95.05. L'image cliente exécutée est identifiée par :
sha256:545518febcd04dce9c9d8b1168af1ce518508901adb517489028ccb5b456ecc2
Cette empreinte d'image cliente ne doit pas être rebaptisée empreinte du serveur llama.cpp. Le dossier enregistre séparément les éléments de l'environnement.
La distribution et la version exacte de Linux ne sont pas consignées dans ce verrou. Ces informations ne démontrent donc pas une compatibilité avec toute installation Linux.
Les deux exécutions du 11 septembre 2026
Première campagne. Identifiant run_id : 20260911t123640-73f55072a554. Début enregistré : 2026-09-11T12:36:40.823741+00:00. Durée capturée : 63.48 s.
Seconde campagne. Identifiant run_id : 20260911t123744-fc0c359a445d. Début enregistré : 2026-09-11T12:37:44.604541+00:00. Durée capturée : 63.99 s.
Le suffixe +00:00 indique que ces horodatages sont exprimés en UTC. Les durées concernent les commandes capturées, pas le temps total d'installation, de téléchargement ou d'intervention.
La livraison est identifiée r1. L'empreinte du code enregistrée est :
e94fd5ca24d24d216757e79747f1c555bd142b3a81f39a0c81346a07d3eebfea
La seconde campagne repart d'un espace de travail et de volumes applicatifs neufs. Les actifs immuables vérifiés sont réutilisés : « exécution propre » ne signifie donc pas « téléchargement de tous les fichiers depuis zéro ».
Les deux campagnes restent des observations sur le poste déclaré. Le dossier indique que les calculs ont été contrôlés à partir des sorties reçues ; aucun entraînement ni aucune inférence GPU n'a été relancé sur le poste éditorial.
Avant de lancer : disposer du Lab et des actifs
Le point de départ est le Lab fourni avec le POC, le projet expérimental de démonstration, déjà installé sur le poste GPU. Il comprend labctl, lab/, batchkit/, scripts/ et les verrous.
Le ZIP contient le programme et les preuves, mais pas les images Docker ni les poids du modèle. Aucune URL publique de téléchargement du POC n'a été créée dans cette livraison. Le code complet se trouve dans le kit de travail ; les extraits de cette page ne permettent pas, à eux seuls, de reconstruire une installation validée.
Il faut disposer de Docker Compose et de l'accès NVIDIA aux GPU, puis acquérir les actifs aux révisions et empreintes indiquées. Le gabarit Compose utilise des chemins propres au poste et pull_policy: never : les images doivent déjà être présentes. Selon la référence officielle Docker Compose, cette politique interdit le téléchargement automatique de l'image et provoque un échec si elle manque localement.
Les poids et les données sont montés en lecture seule. Ne remplacez pas une révision par main, une image précise par latest ou un fichier vérifié par d'autres poids simplement pour contourner un actif manquant : vous changeriez l'expérience.
Lancer la commande documentée
Placez-vous dans le répertoire du Lab installé. La commande suivante est celle extraite du README ; le lanceur prépare les chemins et le projet Compose, puis exécute le programme dans le conteneur.
Source figée : poc/README.md, ligne 4. SHA-256 du fichier source enregistré : ad09840e896cada8ad36cfc3bc888a6aca9492a857591026d9c59964795324ee.
./labctl run --machine gpu --batch 2026-09-11 --topic gguf-q4-q8-mesures
Les options identifient la machine GPU, le lot du 2026-09-11 et le sujet gguf-q4-q8-mesures. Cette date désigne le lot de travail ; elle ne constitue pas une programmation future.
Après l'exécution, conservez les sorties, les erreurs et les fichiers de tests. Vérifiez les échantillons, leur couverture et les tolérances des deux campagnes à partir des éléments enregistrés, plutôt que de vous limiter à l'absence d'erreur dans le terminal.
Un état déjà PACKAGED ne déclenche pas nécessairement une nouvelle expérience lors d'un resume. Pour savoir si vous avez réellement rejoué le calcul, retrouvez l'exécution et son run_id. Les deux rejeux propres documentés ici sont ceux identifiés plus haut.
Toute modification du code, des données, du modèle ou du protocole demande une nouvelle révision et de nouvelles captures. Les anciens scores ne doivent pas être réattribués à cette variante.
En cas d'erreur, puis pour nettoyer
Une image absente, un montage inexistant ou un délai d'attente dépassé signale un prérequis à résoudre. Arrêtez le parcours et identifiez ce qui manque. Changer silencieusement de moteur d'inférence ou de paramètres pour obtenir une exécution réussie ne reproduirait pas le test documenté.
Le nettoyage de ce parcours appartient au lanceur et à son projet Compose. Le Makefile reçu ne fournit pas de cible clean autonome ; aucune commande de purge globale n'est donc proposée. Conservez les archives privées et les poids partagés, qui peuvent servir à d'autres expériences.
Ce que nous avons appris
Q4 obtient ici un meilleur score strict et de meilleures mesures de latence et de débit que Q8. Ce résultat porte sur deux campagnes, un modèle à une révision précise, des données synthétiques et un contrat de sortie donné.
Le point le plus utile pour un développeur se trouve dans les réponses : une quantité correcte ne compense pas nécessairement une référence incomplète. Il faut savoir ce que votre application attend avant de décider ce qu'un « bon score » signifie.
Nous avons aussi distingué trois démarches : relire des réponses enregistrées, recalculer leurs scores et rejouer le modèle. Elles sont complémentaires, mais elles ne constituent pas la même validation.
Pour transposer cette méthode à un autre projet, commencez par définir votre contrat de sortie et vos cas de test. Examinez les erreurs concrètes, puis mesurez les performances dans les conditions qui vous intéressent. Le bon choix n'est pas celui dont le nom paraît le plus rassurant : c'est celui dont vous avez vérifié le comportement pour votre usage.