





Está desarrollando una función que transforma una solicitud en datos que su aplicación puede utilizar. Por ejemplo: recuperar una referencia de producto, una cantidad y una categoría, y devolverlas en JSON. Hasta aquí, la necesidad se parece a la de una API clásica. La diferencia es que un modelo de lenguaje produce la respuesta.
Al ejecutarlo en su máquina, descubre varios archivos para el mismo modelo: Q4_K_M, Q8_0… ¿Cuál elegir? ¿El más voluminoso será necesariamente el más fiable? ¿El más compacto será lo bastante preciso para alimentar su aplicación?
Examinaremos dos campañas de medición realizadas con Qwen2.5 7B, en dos versiones cuantizadas. El objetivo no es coronar a un ganador universal: es aprender a leer los resultados, comprender qué verifica una prueba y relacionar estas observaciones con una necesidad de desarrollo.
La pregunta central será muy concreta: ¿una respuesta que conserva una cantidad, pero olvida una parte de la referencia del producto, puede utilizarla su código?
Saber leer Python, manipular JSON y usar Docker basta para seguir las explicaciones. No reentrenamos un modelo. Sin embargo, el recorrido de ejecución presentado más adelante presupone disponer del Lab y de los archivos del experimento: no es una instalación autónoma desde una máquina nueva.
Dos campañas con un protocolo idéntico
Antes que nada, ¿qué significa "cuantizar un modelo"?
Un modelo contiene valores numéricos, llamados pesos o parámetros, que intervienen en sus cálculos. La cuantización consiste en representar estos valores con una precisión reducida para disminuir su tamaño. Es, entre otras cosas, lo que permite usar modelos con menos memoria. La guía de Hugging Face sobre cuantización presenta este principio y sus compromisos.
Para hacerse una idea, piense en un redondeo: conservar 0,12 en vez de 0,123456 mantiene una aproximación, pero pierde información. Es una analogía, no la fórmula utilizada por los archivos de este experimento. Los métodos reales codifican grupos de valores e información adicional.
En esta comparación, los dos nombres designan recetas de cuantización diferentes:
| Variante | Qué hay que recordar para leer el experimento |
|---|---|
Q4_K_M |
Una receta de la familia de las cuantizaciones de 4 bits, con una mezcla de precisiones según los pesos. Este nombre no debe leerse como "exactamente 4 bits para cada parámetro, sin ninguna otra información". |
Q8_0 |
Una receta de cuantización de 8 bits, que conserva una representación más fina de los pesos que los formatos de menor precisión. Este nombre no garantiza que tenga éxito en cada solicitud. |
La documentación de Qwen dedicada a llama.cpp explica la cuantización de los pesos y las mezclas de tipos. La documentación de la herramienta de cuantización de llama.cpp describe las variantes disponibles.
Sobre todo, recuerde la diferencia entre la precisión de los números almacenados y la exactitud de una respuesta esperada por su aplicación. Nuestro experimento mide la segunda en un marco concreto; no permite confundirlas.
El modelo, el archivo y el motor tienen funciones diferentes
Qwen2.5-7B-Instruct es el modelo. 7B indica su clase de tamaño, del orden de siete mil millones de parámetros, e Instruct designa una variante adaptada al seguimiento de instrucciones. Su ficha oficial en la revisión utilizada documenta el modelo distribuido.
GGUF es el formato de los archivos: contiene los pesos y los metadatos necesarios para cargarlos. No es ni el nombre del modelo ni, por sí solo, un nivel de cuantización. La especificación GGUF describe esta función.
llama.cpp es el motor que carga estos archivos y ejecuta el modelo. Usar un modelo ya entrenado para producir una respuesta se llama inferencia. En nuestro recorrido, un programa Python dirige sus solicitudes a un servidor local llama.cpp; la documentación del servidor presenta esta interfaz.
Lo que se mantiene idéntico entre las dos variantes
Las campañas comparan Q4_K_M y Q8_0 del mismo modelo, en la misma revisión y en una imagen de llama.cpp bloqueada. "Bloqueada" significa aquí que se conserva una versión identificada, en vez de recuperar automáticamente la última disponible.
El protocolo anuncia 80 casos sintéticos por modo y por campaña. Un caso sintético es un ejemplo construido para la prueba, y no una solicitud extraída tal cual del tráfico real de una aplicación. Se capturaron dos campañas completas de GPU; la carpeta del experimento indica que sus métricas se recalcularon posteriormente.
El perímetro registrado es el tema 006, con los modos ['q4', 'q8'], dos ejecuciones limpias y una revisión determinista fuera del proceso. En otras palabras, los resultados se controlan mediante código a partir de las salidas registradas, sin pedir a otro modelo que les asigne una nota. No se exige ninguna ganancia de antemano: el protocolo debe poder informar de una ventaja, de la ausencia de ventaja o de un límite.
Las mediciones siguen siendo las de un único equipo. La memoria de la GPU, llamada VRAM, se registra una vez por segundo, es decir, a 1 Hz. No se declara ninguna relectura humana o por LLM para evaluar las respuestas. Las latencias son descriptivas, no garantías de rendimiento.
El pequeño programa que organiza las solicitudes
Este es el núcleo del recorrido. El extracto conserva la lógica del código registrado, con un formato más aireado. Las funciones ready(), llm() y emit(), así como DATA y SCHEMA, se definen en otra parte del proyecto: este bloque no constituye un programa autónomo.
Fuente fijada: poc/experiment.py, líneas 99–107. SHA-256 del archivo fuente registrado: f50240fa92614d1399c672ed91574bacacc805d2c0c377b6830c8831733bf17d.
def quant():
    elapsed = ready('http://server:8080', '/health')
    emit('load', ready_seconds=elapsed)

    llm(DATA['queries'][0]['query'], SCHEMA)

    for q in DATA['queries']:
        r = llm(q['query'], SCHEMA)
        emit('sample', sample_id=q['id'], **r)

    try:
        llm('mot ' * 10000, SCHEMA)
    except urllib.error.HTTPError as e:
        assert e.code in (400, 413)
        emit('test', test_id='context-limit', status='passed')
    else:
        raise AssertionError('oversize accepted')

    emit('complete', samples=len(DATA['queries']))
El programa espera al servidor, realiza una primera solicitud de calentamiento y después recorre las consultas del conjunto de datos. Para cada una registra un evento sample asociado a su identificador. Por último, verifica el rechazo de una entrada deliberadamente demasiado larga y señala el final del recorrido.
Las huellas SHA-256 citadas en este artículo identifican los archivos fuente de la carpeta del experimento. No son las huellas de los bloques de código reformateados en esta página. Volveremos a su utilidad al hablar de la reproducción.
Mediciones reproducibles en las dos campañas
Antes de leer las cifras, distingamos tres preguntas. La igualdad estricta pregunta si la salida coincide exactamente con el resultado esperado según el comparador del proyecto. La latencia describe un tiempo de respuesta medido. El rendimiento, expresado en tokens por segundo, describe una velocidad de procesamiento o generación según la medida elegida.
Un token es una unidad de texto manipulada por el modelo; no es necesariamente una palabra completa. La documentación del servidor llama.cpp distingue, entre otros, la información de procesamiento del prompt y de generación. Por tanto, hay que conservar la definición de rendimiento utilizada por el experimento, y no solo su unidad.
Estos son los valores comunicados, sin modificar su precisión:
| Campaña | Variante | Igualdad estricta | Latencia comunicada | Rendimiento comunicado |
|---|---|---|---|---|
| 1 | Q4_K_M | 1,00 | 0,251324 s | Aproximadamente 131 tokens/s |
| 2 | Q4_K_M | 1,00 | 0,252973 s | Aproximadamente 130 tokens/s |
| 1 | Q8_0 | 0,0666667 | 0,333810 s | Aproximadamente 93 tokens/s |
| 2 | Q8_0 | 0,0666667 | 0,333744 s | Aproximadamente 93 tokens/s |
Para representar las duraciones, Q4 se sitúa aquí en torno a un cuarto de segundo, frente a aproximadamente un tercio de segundo para Q8. La puntuación estricta es del 100 % para Q4 y de aproximadamente el 6,67 % para Q8, en la métrica comunicada, no en "todas las capacidades del modelo".
Los valores de las dos campañas son cercanos. Es una observación útil sobre estas ejecuciones, pero dos campañas no bastan para garantizar la misma estabilidad con otras cargas o en otras máquinas.
El resumen proporcionado no precisa la agregación de las latencias. Por eso las llamamos "latencias comunicadas", sin rebautizarlas como medias, medianas o tiempo de espera antes del primer token.
Lo que realmente mide la métrica estricta
Un JSON legible no es necesariamente un JSON utilizable
El informe indica que Q8 conserva las cantidades y las categorías en 60 casos, pero suele omitir el prefijo REF-. Esta omisión hace fallar la igualdad exacta. El contraste entre las puntuaciones se vuelve mucho más comprensible al observar este detalle.
Tomemos un ejemplo para ver el problema. Los dos objetos siguientes son ilustraciones pedagógicas: no reproducen ni una salida capturada ni el esquema exacto del POC.
Su aplicación podría esperar:
{
  "reference": "REF-042",
  "quantite": 3,
  "categorie": "accessoires"
}
Y recibir:
{
  "reference": "042",
  "quantite": 3,
  "categorie": "accessoires"
}
Los dos objetos son JSON sintácticamente válido. La cantidad y la categoría son idénticas. Sin embargo, las referencias son diferentes.
Si su aplicación busca un producto por su referencia exacta, no puede suponer que 042 y REF-042 designan lo mismo. Por tanto, la prueba estricta no es necesariamente "demasiado severa": puede simplemente verificar el contrato que necesita el software.
Es un razonamiento habitual en el desarrollo web. Un endpoint puede devolver un estado HTTP de éxito y un JSON decodificable, y aun así devolver un valor de negocio incorrecto. El éxito del transporte, la validez de la estructura y la exactitud del contenido son tres cuestiones distintas.
Lo que permite decir la puntuación, y lo que no permite decir
En este experimento, Q4 obtiene un mejor resultado en igualdad estricta. Esto no demuestra que Q8 "comprenda peor" todas las solicitudes, ni que Q4 sea superior para otro uso. La observación sobre las cantidades y las categorías muestra precisamente que la puntuación estricta no resume todas las propiedades de las respuestas.
A la inversa, constatar que algunos campos son correctos no basta para declarar la respuesta globalmente correcta. Una referencia incompleta puede bloquear la integración, incluso cuando el resto parece plausible.
El código del comparador exacto no se reproduce en los extractos de esta página. Por tanto, no podemos deducir, por ejemplo, cómo trata el orden de las claves JSON, los espacios o una posible normalización. El efecto de la omisión de REF- está documentado; las demás reglas deben leerse en el comparador del kit.
¿Por qué aparecen a la vez 80 y 60 casos?
El protocolo anuncia 80 casos por modo y por campaña. El comentario sobre las cantidades y categorías, así como la imagen de abajo, mencionan 60 casos. El texto disponible no precisa la relación entre estos dos perímetros.
Por tanto, conservamos estas indicaciones sin inventar una distribución entre subconjuntos. En particular, no transformamos la puntuación 0,0666667 en un número de aciertos sobre 80 casos. Para establecer este recuento, hay que recuperar en los resultados detallados los identificadores evaluados y el denominador exacto de la puntuación.
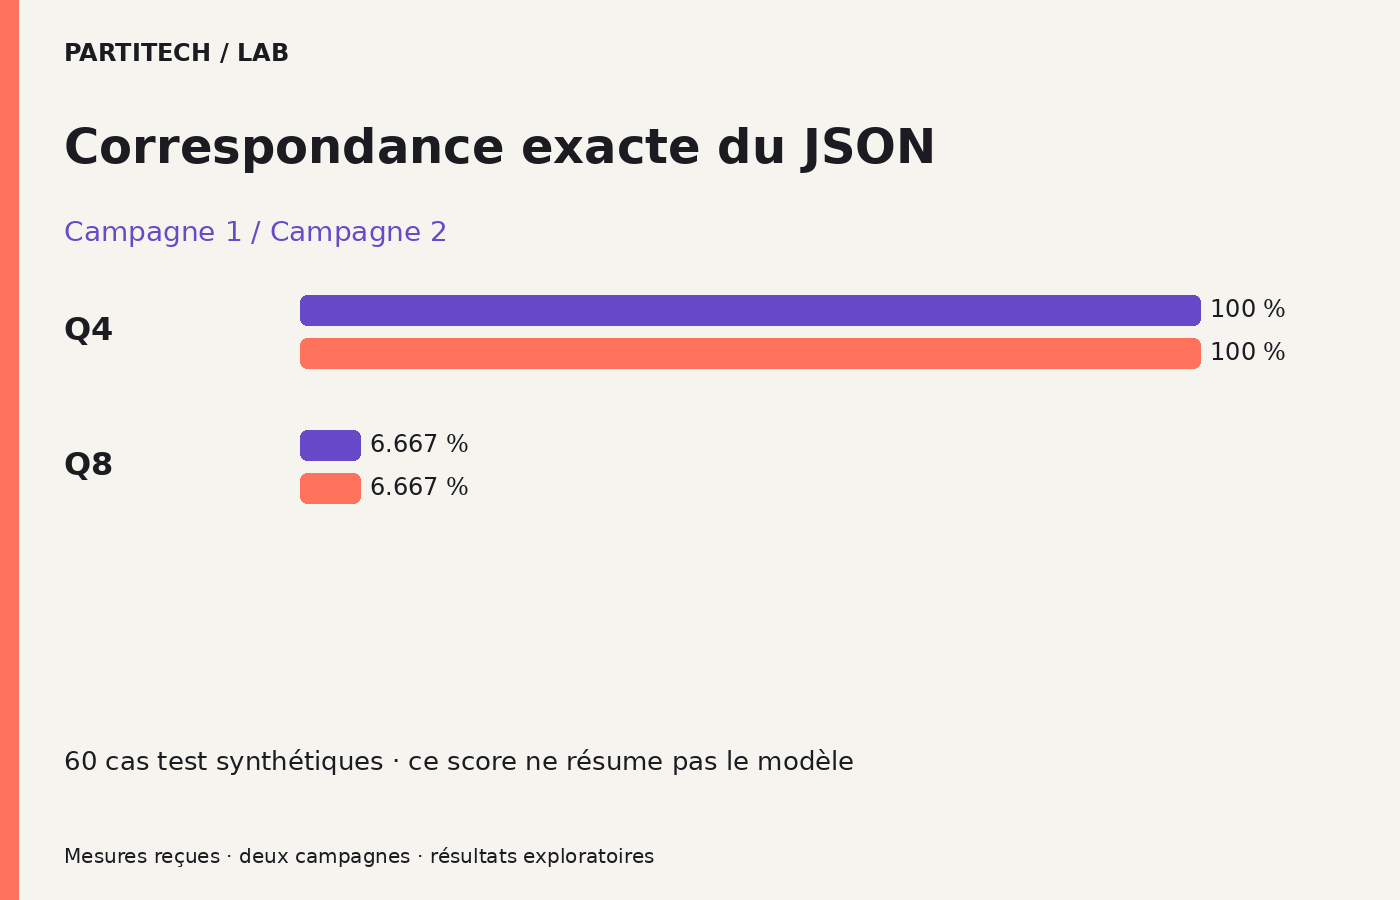
La mención "60 casos de prueba sintéticos" de la imagen pertenece al documento original. No sustituye el perímetro de 80 casos anunciado para cada modo.
Alcance y repetición documentada
Las observaciones se refieren a datos sintéticos, un único host y una pila de software fijada. La repetición del experimento depende de la base local del Lab, de la imagen llama.cpp y de los modelos bloqueados.
Se parece a una prueba de integración de la que conserva el código, los conjuntos de datos y las versiones de los servicios. Volver a leer sus resultados no equivale a ejecutarla de nuevo; lanzarla con otras dependencias no reproduce necesariamente el mismo experimento.
El proyecto también contiene funciones de métricas y pruebas de sus entradas. Este es el extracto proporcionado, también reformateado sin cambiar su lógica.
Fuente fijada: poc/metrics.py, líneas 30–44. SHA-256 del archivo fuente registrado: 9d39a8d113cc112f5ece7ecbf6454f0cbe46ceddd847c4af25789ead12171899.
def valid_query(q):
    if not isinstance(q, str) or not q.strip() or len(q) > 2048:
        raise ValueError('invalid query')
    return q


def unit():
    assert (
        distance('chat', 'chats') == 1
        and distance([], ['x']) == 1
        and distance('abc', 'adc') == 1
    )
    assert normalize('ÉTÉ, bonjour!') == 'été bonjour'
    assert rank_metrics([2, 1], [1]) == {
        'recall5': 1.0,
        'mrr10': .5,
        'ndcg10': 1 / math.log2(3),
    }
    assert rank_metrics([2], []) == {
        'recall5': 0,
        'mrr10': 0,
        'ndcg10': 0,
    }
    assert bm25(
        [{'id': 0, 'text': 'chat'}, {'id': 1, 'text': 'chien'}],
        'chat',
    )[0][0] == 0
    assert bm25([], 'x') == [] and rrf([(1, 1)], [(2, 1)])[0][1] == 1 / 61

    for x in ['', None, {}, 42, 'x' * 2049]:
        try:
            valid_query(x)
        except ValueError:
            pass
        else:
            raise AssertionError('query guard')
Leer valid_query() como una validación de formulario
Esta función exige una cadena de caracteres, rechaza una cadena vacía o compuesta únicamente de espacios e impone una longitud máxima de 2 048 caracteres. Cuando falla una de estas condiciones, lanza ValueError('invalid query').
Un detalle merece atención: q.strip() sirve únicamente para el control. La función devuelve q, no q.strip(). Por tanto, no elimina los espacios del valor devuelto a quien llama.
En unit(), el bucle prueba varias entradas prohibidas: una cadena vacía, None, un diccionario, un número y una cadena de 2 049 caracteres. Si una de ellas pasa sin error, la prueba falla con AssertionError('query guard'). Es la misma lógica que una prueba de backend que verifica el rechazo de un campo ausente o demasiado largo.
¿Por qué también vemos pruebas de búsqueda y clasificación?
Las demás aserciones controlan funciones de distancia, normalización, clasificación y búsqueda presentes en el módulo de métricas. Por ejemplo, la prueba de normalize() espera que ÉTÉ, bonjour! se convierta en été bonjour: en este ejemplo cambian las mayúsculas y la puntuación, pero los acentos se mantienen.
Los nombres rank_metrics, bm25 y rrf aparecen en el extracto. Su presencia no significa que la puntuación Q4/Q8 sea una combinación de todas estas pruebas, ni que el experimento implemente un motor de búsqueda. Este bloque verifica utilidades; por sí solo no muestra el cálculo completo de la igualdad estricta.
La idea que hay que recordar es sencilla: el programa encargado de medir también debe probarse. Pero superar sus pruebas unitarias no demuestra ni la calidad general del modelo ni la representatividad del conjunto de datos.
Activos locales y versiones registradas
Para repetir este experimento, el código Python no basta. También se necesitan los archivos de pesos, las imágenes Docker y la base del Lab en las versiones documentadas. Son los activos locales mencionados en la carpeta: los elementos necesarios para ejecutar, ya presentes en el equipo.
El bloqueo del entorno registra, entre otras cosas, el controlador y la imagen llama.cpp. El bloqueo de los modelos identifica Qwen2.5 7B y los archivos GGUF Q4_K_M y Q8_0 mediante sus huellas. El paquete no descarga nada automáticamente.
Puede comparar este principio con un archivo composer.lock o un bloqueo de dependencias JavaScript: se busca recuperar una configuración concreta, no solo componentes con el mismo nombre.
Una huella SHA-256 es un valor calculado a partir del contenido de un archivo. Permite comparar el archivo presente con el esperado, en vez de confiar en su nombre. La documentación de Python sobre hashlib presenta esta familia de funciones. Aquí, las huellas sirven para identificar los activos del experimento; por sí solas no prueban su calidad ni la de los resultados.
Cómo prepara el lanzador el experimento
El README asocia este tema a un comando labctl, que debe ejecutarse desde el Lab ya instalado. labctl es el lanzador de este entorno: no es un comando proporcionado por Python ni por Docker.
Según el procedimiento registrado, adapta las rutas de la plantilla Docker Compose, verifica las huellas de los activos y luego inicia el programa Python en el contenedor. La plantilla es la configuración de partida; la adaptación permite proporcionarle las ubicaciones esperadas en el equipo correspondiente.
Las rutas requieren un poco de atención. /poc y /assets son rutas dentro del contenedor. Las rutas que empiezan por /llm, visibles en las capturas, pertenecen al equipo de origen. Copiarlas tal cual en otra máquina no garantiza que allí designen los archivos correctos.
El lanzamiento exacto se conserva en la sección de reproducción, con los requisitos previos. La descripción de este procedimiento indica cómo repetir el experimento; no significa que se haya realizado una nueva ejecución durante la preparación del artículo.
Las salvaguardas de medición visibles en el código fijado
Volvamos a quant(). Cada etapa responde a una pregunta bastante cercana a las que se plantearía al probar una API.
¿Está el servicio listo para recibir la solicitud?
ready('http://server:8080', '/health') espera al servicio local. La duración devuelta se registra en un evento load, con el campo ready_seconds.
El nombre load no debe hacernos olvidar lo que realmente muestra el extracto: una espera de disponibilidad. Sin leer la implementación de ready(), no podemos equiparar este valor únicamente al tiempo de carga de los pesos en la GPU.
¿Se distingue la primera consulta del bucle de medición?
Antes del bucle, el programa llama a llm() con la primera consulta del conjunto de datos. Es la solicitud de calentamiento anunciada en el protocolo. Prepara el recorrido antes de las llamadas registradas como muestras.
Esta línea no va acompañada de un emit('sample', ...) en el extracto. Después, el bucle retoma todas las consultas, incluida la primera, y emite un evento sample para cada una. Por tanto, hay que distinguir el número de casos del conjunto de datos del número total de llamadas realizadas, que también comprende el calentamiento y la prueba de entrada demasiado larga.
¿Puede vincularse una respuesta a su pregunta?
En el bucle, q['query'] proporciona la solicitud y q['id'] su identificador. La notación **r transmite los campos del resultado a emit().
El identificador es importante: permite recuperar qué salida corresponde a qué caso y examinar después las discrepancias. Una puntuación global sin este vínculo no permitiría, por sí sola, recuperar las referencias a las que les falta el prefijo REF-.
¿Se rechaza una solicitud deliberadamente excesiva?
El programa envía después 'mot ' * 10000, es decir, la cadena mot repetida 10 000 veces. Espera una excepción HTTP cuyo código sea 400 o 413. Si esta llamada se acepta, lanza AssertionError('oversize accepted').
Es una prueba negativa: se envía deliberadamente una entrada que el recorrido debe rechazar. Por tanto, una devolución sin error no es un éxito de la prueba, sino su fallo.
Atención a dos límites de lectura. Primero, 10 000 repeticiones no significan necesariamente 10 000 tokens. Segundo, el extracto verifica estos dos códigos HTTP; por sí solo no prueba el tratamiento de todos los tamaños de entrada ni de todos los errores posibles.
La protección de 2 048 caracteres en valid_query() y esta prueba de contexto tampoco son intercambiables. La primera verifica una entrada de texto en una función Python. La segunda pide al recorrido de inferencia que rechace una entrada excesiva. Como no se reproduce el cuerpo de llm(), no hay que inventar cómo se encadenan todos los controles internamente.
Por último, emit('complete', ...) solo se alcanza si el recorrido llega hasta esta instrucción. Recuperar este evento es útil, pero también hay que controlar el número y los identificadores de las muestras: un marcador de final no sustituye la verificación de los datos.
Verificar, exportar y retirar las huellas de trabajo
Las pruebas exportadas incluyen las métricas de las dos campañas, los controles de validación y los registros de captura referenciados en la carpeta. Su función es permitir una relectura de las observaciones, sin tener que publicar contenido ni relanzar inmediatamente el modelo.
Para examinarlas, parta de un resultado y retroceda hasta su solicitud, su respuesta registrada y la regla que produjo su puntuación. Compruebe después que se cubren todos los casos anunciados, que se conservan los errores y que se respetan las tolerancias previstas por el protocolo. En esta etapa debe aclararse, en particular, el vínculo entre los perímetros de 80 y de 60 casos.
El paquete descrito aquí no realiza ninguna operación de CMS, medios ni redes sociales. Los archivos de trabajo y los activos locales siguen gestionándose en el entorno Lab. Su exportación y su limpieza no deben confundirse con la publicación de este artículo.
Una puntuación calculada fuera de la respuesta del modelo
Imagine que su endpoint pudiera decidir por sí mismo si su prueba de integración ha tenido éxito. No sería un control independiente. La misma precaución se aplica aquí: el modelo produce una respuesta; otro fragmento de código la compara con lo esperado.
El módulo de métricas anuncia evaluadores puros, utilizados sin conexión por el recorder, la herramienta que registra y trata los resultados. En este contexto, "puros" significa que el cálculo de la puntuación depende de sus entradas, sin pedir al modelo que se autoevalúe. La carpeta habla, por tanto, de una revisión determinista, no de una opinión humana ni de una calificación por un LLM.
Esta separación permite recalcular una puntuación a partir de una respuesta ya capturada. No hace que la generación del modelo sea automáticamente determinista. Rehacer el cálculo sobre las mismas salidas y obtener nuevas salidas con el modelo son dos operaciones diferentes.
El módulo contiene una función de normalización y validaciones de entrada, pero su presencia no basta para establecer todas las transformaciones aplicadas a la puntuación estricta de este tema. El punto documentado sigue siendo el siguiente: la omisión de REF- hace fallar esta igualdad, incluso cuando se conservan cantidades y categorías.
Pequeño ejercicio: ¿aceptaría su aplicación la respuesta?
Retome los dos JSON ilustrativos presentados más arriba. Antes de releer la explicación, pregúntese qué aceptaría para una pantalla de demostración y después para una búsqueda de producto por identificador exacto.
Añadamos una tercera situación imaginaria: la referencia sí es REF-042, pero la cantidad pasa de 3 a 30. El JSON todavía puede decodificarse sin dificultad. Sin embargo, la respuesta ya no es correcta para la necesidad descrita.
El ejercicio consiste en explicar por separado lo que corresponde a la sintaxis, al formato de la referencia y al valor de negocio. No produce ningún resultado nuevo de benchmark.
Podría proponerse una regla que añada automáticamente REF- a las referencias incompletas. Sería una modificación del tratamiento, no una simple relectura de los resultados actuales. Antes de utilizarla, habría que definir los casos en que esta corrección está autorizada, comprobar que no introduce ambigüedad y probarla por separado. Las puntuaciones publicadas aquí no miden esta variante.
Leer juntos latencia y rendimiento
Para su aplicación, una duración responde a la pregunta "¿cuánto tarda esta llamada?". Un rendimiento responde más bien a "¿a qué velocidad se trata o produce el texto?". Estas informaciones se complementan; no son intercambiables.
Así, 93 tokens por segundo no significan 93 solicitudes por segundo. Para pasar de uno a otro, habría que conocer, entre otras cosas, la longitud de las solicitudes y de las respuestas, así como la organización de las llamadas. Las mediciones publicadas no describen esta capacidad de servicio bajo carga.
Q4 presenta aquí latencias más bajas y un rendimiento más alto que Q8. Esto describe estos casos, en este equipo, con esta pila. Las dos campañas no cubren ni usuarios simultáneos, ni prompts reales no sintéticos, ni cambios de hardware, ni el consumo energético.
La VRAM es otro asunto. Un registro a 1 Hz solo ofrece una observación por segundo: puede producirse un pico más breve entre dos registros. El resumen no proporciona valores de consumo de memoria que permitan cuantificar aquí una ganancia Q4/Q8. Por tanto, no deducimos ni un ahorro preciso de VRAM ni un mínimo de hardware validado.
Para leer la tabla sin hacerle decir más, mantenga siempre juntos la variante, el conjunto de casos, el contrato de salida y el método de medición. El número por sí solo no basta para elegir una configuración para otro producto.
Fuentes y límite de procedencia
¿De dónde proceden los resultados?
El documento original indica que la redacción contrastó el informe, las métricas, el protocolo, los bloqueos y la validación final del archivo. También informa de que un recálculo de control recupera los valores capturados. Los resultados presentados aquí son los de esta carpeta, no los de una nueva campaña ejecutada para esta versión pedagógica.
Un límite debe permanecer visible: las fuentes utilizadas durante las capturas corresponden a versiones históricas distintas de la base Lab instalada. Esta diferencia debe conservarse en la carpeta de auditoría. Por sí sola no anula la coherencia interna comunicada entre las observaciones; en cambio, impide suponer que la base actual reproduce automáticamente el código histórico.
Es comparable a la diferencia entre el commit que produjo un resultado de CI y la rama actualmente abierta en su editor. Para comprender el resultado antiguo, se conserva la identidad del código que lo produjo.
Dos notas cuya vinculación con el tema aún debe precisarse
La ficha original también incluye la mención "Datos sintéticos salvo FLEURS" y una nota identificada como 010: capacidades de contexto comparadas, prompts deterministas por debajo del límite y generación de 64 tokens.
El tema Q4/Q8, por su parte, se identifica como 006. Los elementos proporcionados no explican cómo se vinculan estas dos notas con sus mediciones. Se conservan como indicaciones de procedencia, pero no deducimos ni que FLEURS forme parte de los casos Q4/Q8 ni que las generaciones de esta comparación tengan un límite de 64 tokens. Estos puntos deben establecerse en el protocolo correspondiente, no completarse por suposición.
¿Para qué sirven las referencias complementarias?
Los enlaces a las documentaciones de Qwen, GGUF, llama.cpp, Python y Docker sirven para explicar los conceptos. No sustituyen las versiones bloqueadas del experimento ni añaden validación de GPU alguna. Una documentación actual puede mostrar otros modelos u otros comandos: no autoriza a sustituirlos por el recorrido medido.
Trazabilidad de este experimento
Esta sección reúne los elementos necesarios para identificar la campaña y comprender las condiciones de su repetición. Puede leerla como la ficha técnica de una prueba: ¿con qué se ejecutó, cuándo y a partir de qué archivos?
El modelo y sus archivos
Las dos variantes proceden de Qwen/Qwen2.5-7B-Instruct-GGUF, en la revisión:
bb5d59e06d9551d752d08b292a50eb208b07ab1f
Las licencias declaradas en la carpeta son Apache-2.0 para q4 y apache-2.0 para q8. Las huellas individuales de los archivos se conservan en locks/models.lock.json.
Esta información identifica los activos probados. No designa una versión actual recomendada. El repositorio en esta revisión precisa permite distinguir estos archivos de los de una rama que hubiera evolucionado.
El hardware y el entorno registrados
El cálculo de este tema utiliza una RTX 3090. Las dos GPU del equipo se reservan durante las mediciones: esto no significa que el cálculo se distribuya entre dos tarjetas.
El controlador registrado es 580.95.05. La imagen cliente ejecutada se identifica mediante:
sha256:545518febcd04dce9c9d8b1168af1ce518508901adb517489028ccb5b456ecc2
Esta huella de imagen cliente no debe rebautizarse como huella del servidor llama.cpp. La carpeta registra por separado los elementos del entorno.
La distribución y la versión exacta de Linux no se consignan en este bloqueo. Por tanto, esta información no demuestra compatibilidad con cualquier instalación Linux.
Las dos ejecuciones del 11 de septiembre de 2026
Primera campaña. Identificador run_id: 20260911t123640-73f55072a554. Inicio registrado: 2026-09-11T12:36:40.823741+00:00. Duración capturada: 63.48 s.
Segunda campaña. Identificador run_id: 20260911t123744-fc0c359a445d. Inicio registrado: 2026-09-11T12:37:44.604541+00:00. Duración capturada: 63.99 s.
El sufijo +00:00 indica que estas marcas de tiempo se expresan en UTC. Las duraciones se refieren a los comandos capturados, no al tiempo total de instalación, descarga o intervención.
La entrega se identifica como r1. La huella de código registrada es:
e94fd5ca24d24d216757e79747f1c555bd142b3a81f39a0c81346a07d3eebfea
La segunda campaña parte de un espacio de trabajo y de volúmenes de aplicación nuevos. Los activos inmutables verificados se reutilizan: por tanto, "ejecución limpia" no significa "descarga de todos los archivos desde cero".
Las dos campañas siguen siendo observaciones en el equipo declarado. La carpeta indica que los cálculos se controlaron a partir de las salidas recibidas; no se reanudó ningún entrenamiento ni inferencia GPU en el equipo editorial.
Antes de lanzar: disponer del Lab y de los activos
El punto de partida es el Lab proporcionado con el POC, el proyecto experimental de demostración, ya instalado en el equipo GPU. Incluye labctl, lab/, batchkit/, scripts/ y los bloqueos.
El ZIP contiene el programa y las pruebas, pero no las imágenes Docker ni los pesos del modelo. En esta entrega no se creó ninguna URL pública de descarga del POC. El código completo se encuentra en el kit de trabajo; los extractos de esta página no permiten por sí solos reconstruir una instalación validada.
Debe disponer de Docker Compose y del acceso NVIDIA a las GPU, y después adquirir los activos en las revisiones y huellas indicadas. La plantilla Compose usa rutas propias del equipo y pull_policy: never: las imágenes ya deben estar presentes. Según la referencia oficial de Docker Compose, esta política impide la descarga automática de la imagen y provoca un error si falta localmente.
Los pesos y los datos se montan en solo lectura. No sustituya una revisión por main, una imagen concreta por latest ni un archivo verificado por otros pesos solo para sortear un activo ausente: cambiaría el experimento.
Lanzar el comando documentado
Sitúese en el directorio del Lab instalado. El comando siguiente es el extraído del README; el lanzador prepara las rutas y el proyecto Compose, y luego ejecuta el programa en el contenedor.
Fuente fijada: poc/README.md, línea 4. SHA-256 del archivo fuente registrado: ad09840e896cada8ad36cfc3bc888a6aca9492a857591026d9c59964795324ee.
./labctl run --machine gpu --batch 2026-09-11 --topic gguf-q4-q8-mesures
Las opciones identifican la máquina GPU, el lote del 2026-09-11 y el tema gguf-q4-q8-mesures. Esta fecha designa el lote de trabajo; no constituye una programación futura.
Después de la ejecución, conserve las salidas, los errores y los archivos de pruebas. Verifique las muestras, su cobertura y las tolerancias de las dos campañas a partir de los elementos registrados, en vez de limitarse a la ausencia de error en el terminal.
Un estado ya PACKAGED no desencadena necesariamente un nuevo experimento durante un resume. Para saber si realmente volvió a ejecutar el cálculo, recupere la ejecución y su run_id. Las dos repeticiones limpias documentadas aquí son las identificadas más arriba.
Toda modificación del código, de los datos, del modelo o del protocolo requiere una nueva revisión y nuevas capturas. Las puntuaciones antiguas no deben reasignarse a esta variante.
En caso de error, y después para limpiar
Una imagen ausente, un montaje inexistente o un tiempo de espera agotado señalan un requisito previo que debe resolverse. Detenga el recorrido e identifique qué falta. Cambiar silenciosamente de motor de inferencia o de parámetros para obtener una ejecución correcta no reproduciría la prueba documentada.
La limpieza de este recorrido corresponde al lanzador y a su proyecto Compose. El Makefile recibido no proporciona un objetivo clean autónomo; por tanto, no se propone ningún comando de purga global. Conserve los archivos privados y los pesos compartidos, que pueden servir para otros experimentos.
Lo que hemos aprendido
Q4 obtiene aquí una mejor puntuación estricta y mejores mediciones de latencia y rendimiento que Q8. Este resultado se refiere a dos campañas, un modelo en una revisión precisa, datos sintéticos y un contrato de salida determinado.
El punto más útil para una persona desarrolladora se encuentra en las respuestas: una cantidad correcta no compensa necesariamente una referencia incompleta. Hay que saber qué espera su aplicación antes de decidir qué significa una "buena puntuación".
También hemos distinguido tres enfoques: releer respuestas registradas, recalcular sus puntuaciones y volver a ejecutar el modelo. Son complementarios, pero no constituyen la misma validación.
Para trasladar este método a otro proyecto, empiece por definir su contrato de salida y sus casos de prueba. Examine los errores concretos y después mida el rendimiento en las condiciones que le interesan. La buena elección no es aquella cuyo nombre parece más tranquilizador: es aquella cuyo comportamiento ha verificado para su uso.