





State sviluppando una funzionalità che trasforma una richiesta in dati utilizzabili dalla vostra applicazione. Per esempio: trovare un riferimento prodotto, una quantità e una categoria, quindi restituirli in JSON. Finora, l'esigenza assomiglia a quella di una classica API. La differenza è che la risposta è prodotta da un modello linguistico.
Quando lo eseguite sulla vostra macchina, scoprite più file per lo stesso modello: Q4_K_M, Q8_0… Quale scegliere? Quello più grande sarà necessariamente il più affidabile? Quello più compatto sarà abbastanza preciso per alimentare la vostra applicazione?
Esamineremo due campagne di misurazione svolte con Qwen2.5 7B, in due versioni quantizzate. L'obiettivo non è incoronare un vincitore universale: è imparare a leggere i risultati, capire cosa verifica un test e collegare queste osservazioni a un'esigenza di sviluppo.
La domanda centrale sarà molto concreta: una risposta che conserva una quantità, ma dimentica una parte del riferimento prodotto, è utilizzabile dal vostro codice?
Saper leggere Python, manipolare JSON e usare Docker basta per seguire le spiegazioni. Non riaddestriamo alcun modello. Il percorso di esecuzione presentato più avanti presuppone tuttavia di disporre del Lab e dei file dell'esperimento: non è un'installazione autonoma da una macchina vuota.
Due campagne con un protocollo identico
Innanzitutto, cosa significa «quantizzare un modello»?
Un modello contiene valori numerici, chiamati pesi o parametri, che intervengono nei suoi calcoli. La quantizzazione consiste nel rappresentare questi valori con una precisione ridotta per diminuirne l'ingombro. È anche ciò che permette di usare modelli con meno memoria. La guida di Hugging Face sulla quantizzazione presenta questo principio e i suoi compromessi.
Per visualizzarlo, pensate a un arrotondamento: conservare 0,12 invece di 0,123456 mantiene un'approssimazione, ma perde informazione. È un'analogia, non la formula usata dai file di questo esperimento. I metodi reali codificano gruppi di valori e informazioni aggiuntive.
In questo confronto, i due nomi indicano ricette di quantizzazione diverse:
| Variante | Cosa tenere a mente per leggere l'esperimento |
|---|---|
Q4_K_M |
Una ricetta della famiglia delle quantizzazioni a 4 bit, con un insieme di precisioni a seconda dei pesi. Non si deve leggere questo nome come «esattamente 4 bit per ogni parametro, senza altre informazioni». |
Q8_0 |
Una ricetta di quantizzazione a 8 bit, che conserva una rappresentazione dei pesi più fine dei formati a precisione inferiore. Questo nome non garantisce il successo di ogni richiesta. |
La documentazione di Qwen dedicata a llama.cpp spiega la quantizzazione dei pesi e le combinazioni di tipi. La documentazione dello strumento di quantizzazione di llama.cpp descrive le varianti disponibili.
Ricordate soprattutto la differenza tra precisione dei numeri memorizzati ed esattezza di una risposta attesa dalla vostra applicazione. Il nostro esperimento misura la seconda in un contesto preciso; non permette di confonderle.
Il modello, il file e il motore hanno ruoli diversi
Qwen2.5-7B-Instruct è il modello. 7B indica la sua classe di dimensione, dell'ordine di sette miliardi di parametri, e Instruct designa una variante adatta a seguire istruzioni. La sua scheda ufficiale alla revisione usata documenta il modello distribuito.
GGUF è il formato dei file: contiene i pesi e i metadati necessari al loro caricamento. Non è né il nome del modello né, da solo, un livello di quantizzazione. La specifica GGUF descrive questo ruolo.
llama.cpp è il motore che carica questi file ed esegue il modello. Usare un modello già addestrato per produrre una risposta si chiama inferenza. Nel nostro percorso, un programma Python invia le sue richieste a un server locale llama.cpp; la documentazione del server presenta questa interfaccia.
Ciò che rimane identico fra le due varianti
Le campagne confrontano Q4_K_M e Q8_0 dello stesso modello, alla stessa revisione, in un'immagine llama.cpp bloccata. «Bloccata» significa qui che si conserva una versione identificata, anziché recuperare automaticamente l'ultima disponibile.
Il protocollo annuncia 80 casi sintetici per modalità e per campagna. Un caso sintetico è un esempio costruito per il test, e non una richiesta estratta tale e quale dal traffico reale di un'applicazione. Sono state catturate due campagne GPU complete; la cartella dell'esperimento indica che le loro metriche sono poi state ricalcolate.
L'ambito registrato è il soggetto 006, con le modalità ['q4', 'q8'], due esecuzioni pulite e una revisione deterministica fuori processo. In altre parole, i risultati sono controllati dal codice a partire dagli output registrati, senza chiedere a un altro modello di assegnare loro un voto. Nessun guadagno è richiesto in anticipo: il protocollo deve poter riportare un vantaggio, l'assenza di vantaggio oppure un limite.
Le misurazioni restano quelle di un'unica postazione. La memoria della GPU, chiamata VRAM, è rilevata una volta al secondo, cioè a 1 Hz. Non è dichiarata alcuna rilettura umana o tramite LLM per la valutazione delle risposte. Le latenze sono descrittive, non garanzie di prestazioni.
Il piccolo programma che orchestra le richieste
Ecco il cuore del percorso. L'estratto conserva la logica del codice registrato, con una formattazione più ariosa. Le funzioni ready(), llm() e emit(), così come DATA e SCHEMA, sono definite altrove nel progetto: questo blocco non costituisce un programma autonomo.
Fonte bloccata: poc/experiment.py, righe 99–107. SHA-256 del file sorgente registrato: f50240fa92614d1399c672ed91574bacacc805d2c0c377b6830c8831733bf17d.
def quant():
    elapsed = ready('http://server:8080', '/health')
    emit('load', ready_seconds=elapsed)

    llm(DATA['queries'][0]['query'], SCHEMA)

    for q in DATA['queries']:
        r = llm(q['query'], SCHEMA)
        emit('sample', sample_id=q['id'], **r)

    try:
        llm('mot ' * 10000, SCHEMA)
    except urllib.error.HTTPError as e:
        assert e.code in (400, 413)
        emit('test', test_id='context-limit', status='passed')
    else:
        raise AssertionError('oversize accepted')

    emit('complete', samples=len(DATA['queries']))
Il programma attende il server, esegue una prima richiesta di riscaldamento, poi percorre le richieste del set di dati. Per ciascuna registra un evento sample associato al suo identificativo. Infine verifica il rifiuto di un input volutamente troppo lungo e segnala la fine del percorso.
Le impronte SHA-256 citate in questo articolo identificano i file sorgente della cartella dell'esperimento. Non sono le impronte dei blocchi di codice riformattati in questa pagina. Torneremo alla loro utilità durante la riproduzione.
Misure riproducibili nelle due campagne
Prima di leggere i numeri, distinguiamo tre domande. L'uguaglianza stretta chiede se l'output corrisponde esattamente al risultato atteso secondo il comparatore del progetto. La latenza descrive un tempo di risposta misurato. Il throughput, espresso in token al secondo, descrive una velocità di elaborazione o generazione secondo la misura adottata.
Un token è un'unità di testo manipolata dal modello; non è necessariamente una parola intera. La documentazione del server llama.cpp distingue in particolare le informazioni sull'elaborazione del prompt e sulla generazione. Bisogna quindi mantenere la definizione di throughput impiegata dall'esperimento, non soltanto la sua unità.
Ecco i valori riportati, senza modificarne la precisione:
| Campagna | Variante | Uguaglianza stretta | Latenza riportata | Throughput riportato |
|---|---|---|---|---|
| 1 | Q4_K_M | 1,00 | 0,251324 s | Circa 131 token/s |
| 2 | Q4_K_M | 1,00 | 0,252973 s | Circa 130 token/s |
| 1 | Q8_0 | 0,0666667 | 0,333810 s | Circa 93 token/s |
| 2 | Q8_0 | 0,0666667 | 0,333744 s | Circa 93 token/s |
Per rappresentarsi le durate, Q4 si colloca qui intorno a un quarto di secondo, contro circa un terzo di secondo per Q8. Il punteggio stretto è del 100% per Q4 e di circa il 6,67% per Q8, sulla metrica riportata, non su «tutte le capacità del modello».
I valori delle due campagne sono vicini. È un'osservazione utile su queste esecuzioni, ma due campagne non bastano a garantire la stessa stabilità sotto altri carichi o su altre macchine.
Il riepilogo fornito non precisa l'aggregazione delle latenze. Per questo le chiamiamo «latenze riportate», senza ribattezzarle medie, mediane o tempo d'attesa prima del primo token.
Cosa misura realmente la metrica stretta
Un JSON leggibile non è necessariamente un JSON utilizzabile
Il rapporto indica che Q8 conserva quantità e categorie in 60 casi, ma omette spesso il prefisso REF-. Questa omissione fa fallire l'uguaglianza esatta. Il contrasto fra i punteggi diventa molto più comprensibile osservando questo dettaglio.
Prendiamo un esempio per osservare il problema. I due oggetti seguenti sono illustrazioni didattiche: non riproducono né un output catturato né lo schema esatto del POC.
La vostra applicazione potrebbe aspettarsi:
{
  "reference": "REF-042",
  "quantite": 3,
  "categorie": "accessoires"
}
E ricevere:
{
  "reference": "042",
  "quantite": 3,
  "categorie": "accessoires"
}
I due oggetti sono JSON sintatticamente validi. La quantità e la categoria sono identiche. Eppure, i riferimenti sono diversi.
Se la vostra applicazione cerca un prodotto tramite il suo riferimento esatto, non può presumere che 042 e REF-042 indichino la stessa cosa. Il test stretto non è quindi necessariamente «troppo severo»: può semplicemente verificare il contratto di cui il software ha bisogno.
È un ragionamento familiare nello sviluppo web. Un endpoint può restituire uno stato HTTP di successo e un JSON decodificabile, pur rinviando un valore di business errato. Il successo del trasporto, la validità della struttura e l'esattezza del contenuto sono tre questioni distinte.
Cosa permette di dire il punteggio — e cosa non permette di dire
In questo esperimento Q4 ottiene un risultato migliore sull'uguaglianza stretta. Ciò non dimostra che Q8 «comprenda meno bene» tutte le richieste, né che Q4 sarà superiore per un altro utilizzo. L'osservazione su quantità e categorie mostra proprio che il punteggio stretto non riassume tutte le proprietà delle risposte.
Al contrario, constatare che alcuni campi sono corretti non basta per dichiarare la risposta globalmente corretta. Un riferimento incompleto può bloccare l'integrazione, anche quando il resto sembra plausibile.
Il codice del comparatore esatto non è riprodotto negli estratti di questa pagina. Non possiamo quindi dedurre, per esempio, come tratti l'ordine delle chiavi JSON, gli spazi o un'eventuale normalizzazione. L'effetto dell'omissione di REF- è riportato; le altre regole devono essere lette nel comparatore del kit.
Perché compaiono sia 80 sia 60 casi?
Il protocollo annuncia 80 casi per modalità e per campagna. Il commento sulle quantità e le categorie, così come la visualizzazione qui sotto, cita 60 casi. Il testo disponibile non precisa il legame fra questi due perimetri.
Conserviamo quindi queste indicazioni, senza inventare una ripartizione fra sottoinsiemi. In particolare, non trasformiamo il punteggio 0,0666667 in un numero di successi su 80 casi. Per stabilire questo conteggio, occorre ritrovare nei risultati dettagliati gli identificativi valutati e il denominatore esatto del punteggio.
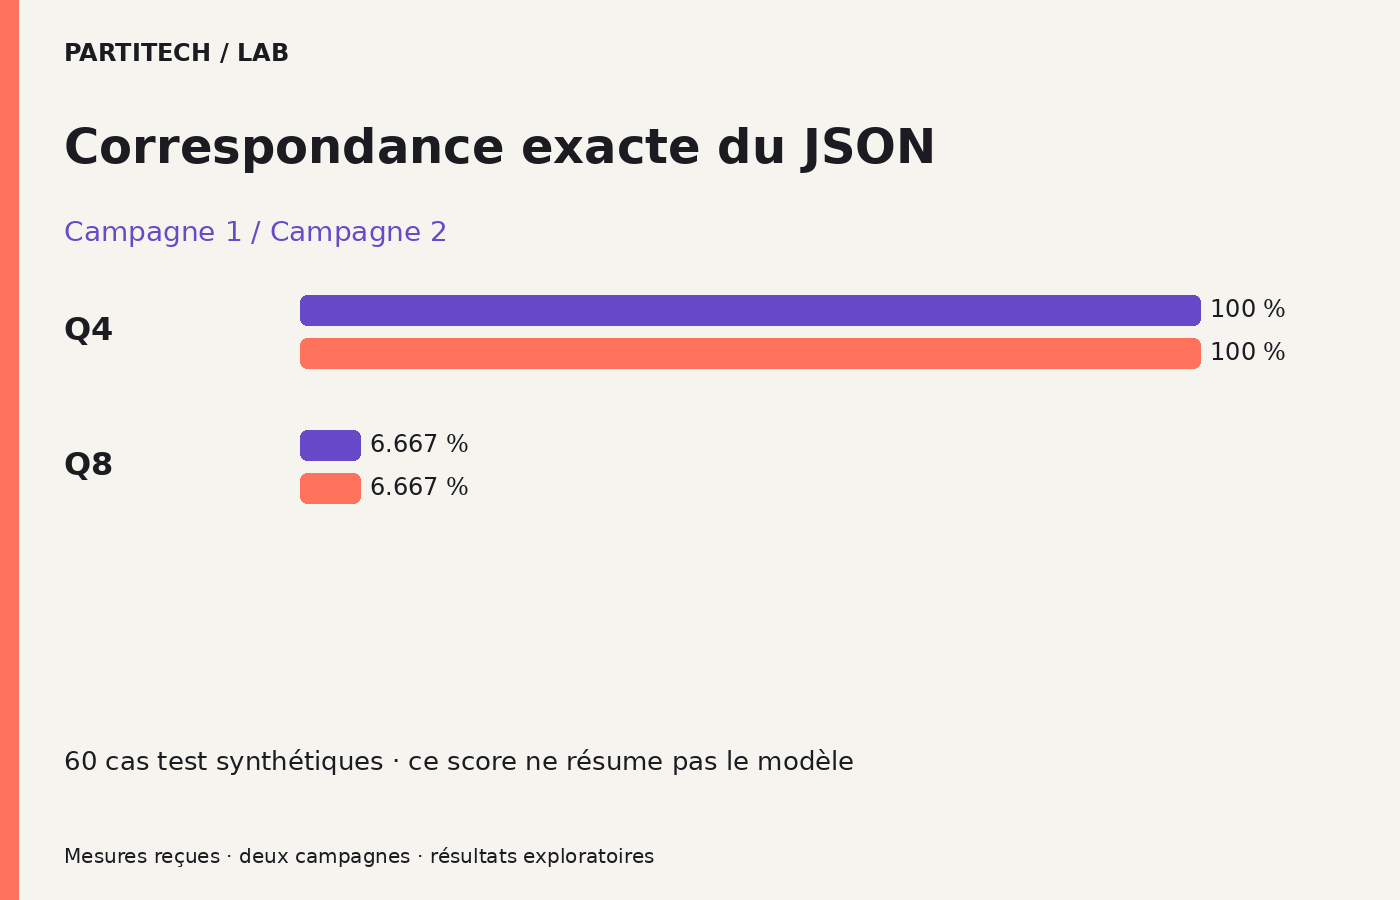
La dicitura «60 casi di test sintetici» della visualizzazione appartiene al documento originale. Non sostituisce il perimetro di 80 casi annunciato per ciascuna modalità.
Ambito e ripresa documentata
Le osservazioni riguardano dati sintetici, un solo host e uno stack software bloccato. La ripresa dell'esperimento dipende dalla base Lab locale, dall'immagine llama.cpp e dai modelli bloccati.
Somiglia a un test di integrazione del quale conservate il codice, i set di dati e le versioni dei servizi. Rileggere i suoi risultati non equivale a rieseguirlo; lanciarlo con dipendenze diverse non riproduce necessariamente lo stesso esperimento.
Il progetto contiene anche funzioni di metriche e test dei loro input. Ecco l'estratto fornito, anch'esso riformattato senza modificarne la logica.
Fonte bloccata: poc/metrics.py, righe 30–44. SHA-256 del file sorgente registrato: 9d39a8d113cc112f5ece7ecbf6454f0cbe46ceddd847c4af25789ead12171899.
def valid_query(q):
    if not isinstance(q, str) or not q.strip() or len(q) > 2048:
        raise ValueError('invalid query')
    return q


def unit():
    assert (
        distance('chat', 'chats') == 1
        and distance([], ['x']) == 1
        and distance('abc', 'adc') == 1
    )
    assert normalize('ÉTÉ, bonjour!') == 'été bonjour'
    assert rank_metrics([2, 1], [1]) == {
        'recall5': 1.0,
        'mrr10': .5,
        'ndcg10': 1 / math.log2(3),
    }
    assert rank_metrics([2], []) == {
        'recall5': 0,
        'mrr10': 0,
        'ndcg10': 0,
    }
    assert bm25(
        [{'id': 0, 'text': 'chat'}, {'id': 1, 'text': 'chien'}],
        'chat',
    )[0][0] == 0
    assert bm25([], 'x') == [] and rrf([(1, 1)], [(2, 1)])[0][1] == 1 / 61

    for x in ['', None, {}, 42, 'x' * 2049]:
        try:
            valid_query(x)
        except ValueError:
            pass
        else:
            raise AssertionError('query guard')
Leggere valid_query() come una validazione di modulo
Questa funzione richiede una stringa di caratteri, rifiuta una stringa vuota o composta solo da spazi e impone una lunghezza massima di 2.048 caratteri. Quando una di queste condizioni fallisce, solleva ValueError('invalid query').
Un dettaglio merita attenzione: q.strip() serve soltanto al controllo. La funzione restituisce q, non q.strip(). Non elimina dunque gli spazi nel valore restituito al chiamante.
In unit(), il ciclo prova diversi input vietati: una stringa vuota, None, un dizionario, un numero e una stringa di 2.049 caratteri. Se uno di essi passa senza errore, il test fallisce con AssertionError('query guard'). È la stessa logica di un test backend che verifica il rifiuto di un campo mancante o troppo lungo.
Perché compaiono anche test di ricerca e classificazione?
Le altre asserzioni controllano funzioni di distanza, normalizzazione, classificazione e ricerca presenti nel modulo delle metriche. Per esempio, il test di normalize() attende che ÉTÉ, bonjour! diventi été bonjour: in questo esempio cambiano maiuscole/minuscole e punteggiatura, ma gli accenti restano presenti.
I nomi rank_metrics, bm25 e rrf compaiono nell'estratto. La loro presenza non significa che il punteggio Q4/Q8 sia una combinazione di tutti questi test, né che l'esperimento implementi un motore di ricerca. Questo blocco verifica utility; da solo non mostra il calcolo completo dell'uguaglianza stretta.
L'idea da ricordare è semplice: anche il programma incaricato di misurare deve essere testato. Ma superare i suoi test unitari non dimostra né la qualità generale del modello né la rappresentatività del set di dati.
Asset locali e versioni registrate
Per riprendere questo esperimento, il codice Python non basta. Servono anche i file dei pesi, le immagini Docker e la base Lab nelle versioni documentate. Sono gli asset locali citati nella cartella: gli elementi necessari all'esecuzione, già presenti sulla postazione.
Il blocco dell'ambiente registra in particolare il driver e l'immagine llama.cpp. Il blocco dei modelli identifica Qwen2.5 7B e i file GGUF Q4_K_M e Q8_0 tramite le loro impronte. Il pacchetto non scarica nulla automaticamente.
Potete avvicinare questo principio a un file composer.lock o a un blocco delle dipendenze JavaScript: si cerca di ritrovare una configurazione precisa, non soltanto componenti con lo stesso nome.
Un'impronta SHA-256 è un valore calcolato dal contenuto di un file. Permette di confrontare il file presente con quello atteso, invece di fidarsi del suo nome. La documentazione Python su hashlib presenta questa famiglia di funzioni. Qui le impronte servono a identificare gli asset dell'esperimento; non provano da sole né la loro qualità né quella dei risultati.
Come il launcher prepara l'esperimento
Il README associa questo soggetto a un comando labctl, da lanciare dal Lab già installato. labctl è il launcher di questo ambiente: non è un comando fornito da Python o Docker.
Secondo la procedura registrata, adatta i percorsi del modello Docker Compose, verifica le impronte degli asset, quindi avvia il programma Python nel contenitore. Il modello è la configurazione di partenza; l'adattamento permette di fornirgli i percorsi attesi sulla postazione interessata.
I percorsi richiedono un po' di attenzione. /poc e /assets sono percorsi all'interno del contenitore. I percorsi che iniziano con /llm, visibili nelle catture, appartengono alla postazione originale. Copiarli tali e quali su un'altra macchina non garantisce che vi indichino i file corretti.
Il lancio esatto è conservato nella sezione di riproduzione, con i prerequisiti. La descrizione di questa procedura indica come riprendere l'esperimento; non significa che una nuova esecuzione sia stata svolta durante la preparazione dell'articolo.
Le protezioni di misura visibili nel codice bloccato
Torniamo a quant(). Ogni passaggio risponde a una domanda molto simile a quelle che porreste testando un'API.
Il servizio è pronto a ricevere la richiesta?
ready('http://server:8080', '/health') attende il servizio locale. La durata restituita è registrata in un evento load, con il campo ready_seconds.
Il nome load non deve far dimenticare ciò che l'estratto mostra realmente: un'attesa di disponibilità. Senza leggere l'implementazione di ready(), non possiamo assimilare questo valore al solo tempo di caricamento dei pesi sulla GPU.
La prima richiesta è distinta dal ciclo di misurazione?
Prima del ciclo, il programma chiama llm() con la prima richiesta del set di dati. È la richiesta di riscaldamento annunciata nel protocollo. Prepara il percorso prima delle chiamate registrate come campioni.
Questa riga non è accompagnata da un emit('sample', ...) nell'estratto. Il ciclo riprende poi tutte le richieste, compresa la prima, ed emette un evento sample per ciascuna. Bisogna quindi distinguere il numero di casi del set di dati dal numero totale di chiamate eseguite, che comprende anche il riscaldamento e il test dell'input troppo lungo.
Si può collegare una risposta alla sua domanda?
Nel ciclo, q['query'] fornisce la richiesta e q['id'] il suo identificativo. La notazione **r trasmette i campi del risultato a emit().
L'identificativo è importante: permette di ritrovare quale output corrisponde a quale caso, quindi di esaminare le divergenze. Un punteggio globale senza questo legame non permetterebbe, da solo, di ritrovare i riferimenti ai quali manca il prefisso REF-.
Una richiesta volutamente eccessiva viene rifiutata?
Il programma invia poi 'mot ' * 10000, cioè la stringa mot ripetuta 10.000 volte. Si aspetta un'eccezione HTTP il cui codice sia 400 o 413. Se questa chiamata è accettata, solleva AssertionError('oversize accepted').
È un test negativo: si invia deliberatamente un input che il percorso deve rifiutare. Un ritorno senza errore non è quindi un successo del test, ma il suo fallimento.
Attenzione a due limiti di lettura. Innanzitutto, 10.000 ripetizioni non significano necessariamente 10.000 token. Inoltre, l'estratto verifica questi due codici HTTP; da solo non prova il trattamento di tutte le dimensioni di input, né di tutti i possibili errori.
La protezione di 2.048 caratteri in valid_query() e questo test di contesto non sono neppure intercambiabili. La prima verifica un input testuale a livello di una funzione Python. Il secondo chiede al percorso di inferenza di rifiutare un input eccessivo. Poiché il corpo di llm() non è riprodotto, non bisogna inventare in che modo tutti i controlli si concatenino all'interno.
Infine, emit('complete', ...) viene raggiunto soltanto se il percorso arriva fino a questa istruzione. Ritrovare questo evento è utile, ma occorre anche controllare il numero e gli identificativi dei campioni: un indicatore di fine non sostituisce la verifica dei dati.
Verificare, esportare e rimuovere le tracce di lavoro
Le prove esportate comprendono le metriche delle due campagne, i controlli di validazione e i registri di cattura referenziati nella cartella. Il loro ruolo è permettere una rilettura delle osservazioni, senza dover pubblicare contenuto né rilanciare immediatamente il modello.
Per esaminarle, partite da un risultato e risalite alla sua richiesta, alla sua risposta registrata, quindi alla regola che ha prodotto il suo punteggio. Verificate poi che tutti i casi annunciati siano coperti, che gli errori siano conservati e che siano rispettate le tolleranze previste dal protocollo. È in particolare in questa fase che deve essere chiarito il legame fra i perimetri di 80 e 60 casi.
Il pacchetto descritto qui non esegue alcuna operazione CMS, media o social network. I file di lavoro e gli asset locali restano gestiti nell'ambiente Lab. La loro esportazione e pulizia non devono essere confuse con la pubblicazione di questo articolo.
Un punteggio calcolato al di fuori della risposta del modello
Immaginate che il vostro endpoint possa decidere da sé se il suo test di integrazione è riuscito. Non sarebbe un controllo indipendente. La stessa precauzione si applica qui: il modello produce una risposta; un altro frammento di codice la confronta con ciò che è atteso.
Il modulo delle metriche annuncia scorer puri, usati offline dal recorder, lo strumento che registra ed elabora i risultati. In questo contesto, «puri» significa che il calcolo del punteggio dipende dai suoi input, senza chiedere al modello di autovalutarsi. La cartella parla quindi di una revisione deterministica, non di un parere umano né di una valutazione tramite LLM.
Questa separazione permette di ricalcolare un punteggio da una risposta già catturata. Non rende automaticamente deterministica la generazione del modello. Rifare il calcolo sugli stessi output e ottenere nuovi output con il modello sono due operazioni diverse.
Il modulo contiene una funzione di normalizzazione e validazioni di input, ma la loro presenza non basta a stabilire tutte le trasformazioni applicate al punteggio stretto di questo soggetto. Il punto documentato resta il seguente: l'omissione di REF- fa fallire questa uguaglianza, anche quando quantità e categorie sono conservate.
Piccolo esercizio: la vostra applicazione accetterebbe la risposta?
Riprendete i due JSON illustrativi presentati più sopra. Prima di rileggere la spiegazione, chiedetevi cosa accettereste per una schermata dimostrativa, poi per una ricerca di prodotto tramite identificativo esatto.
Aggiungiamo una terza situazione immaginaria: il riferimento è proprio REF-042, ma la quantità passa da 3 a 30. Il JSON può ancora essere decodificato senza difficoltà. Tuttavia la risposta non è più corretta per l'esigenza descritta.
L'esercizio consiste nello spiegare separatamente ciò che riguarda la sintassi, il formato del riferimento e il valore di business. Non produce alcun nuovo risultato di benchmark.
Si potrebbe proporre una regola che aggiunga automaticamente REF- ai riferimenti incompleti. Sarebbe una modifica del trattamento, non una semplice rilettura dei risultati attuali. Prima di usarla, bisognerebbe definire i casi in cui questa correzione è autorizzata, verificare che non introduca ambiguità e testarla separatamente. I punteggi pubblicati qui non misurano questa variante.
Leggere insieme latenza e throughput
Per la vostra applicazione, una durata risponde alla domanda «quanto tempo richiede questa chiamata?». Un throughput risponde piuttosto a «a quale velocità viene elaborato o prodotto il testo?». Queste informazioni si completano; non sono intercambiabili.
Quindi, 93 token al secondo non significano 93 richieste al secondo. Per passare dall'uno all'altro, bisognerebbe conoscere in particolare la lunghezza delle richieste e delle risposte, oltre all'organizzazione delle chiamate. Le misure pubblicate non descrivono questa capacità di servizio sotto carico.
Q4 presenta qui latenze più basse e un throughput più elevato di Q8. Ciò descrive questi casi, su questa postazione, con questo stack. Le due campagne non coprono né utenti simultanei, né prompt reali non sintetici, né cambiamenti di hardware, né il consumo energetico.
La VRAM è un altro tema. Un rilevamento a 1 Hz fornisce una sola osservazione al secondo: un picco più breve può verificarsi fra due rilevamenti. Il riepilogo non fornisce valori di consumo memoria che permettano di quantificare qui un guadagno Q4/Q8. Non ne deduciamo quindi né un risparmio preciso di VRAM né un minimo hardware convalidato.
Per leggere la tabella senza farle dire di più, tenete sempre insieme la variante, il set di casi, il contratto di output e il metodo di misura. Il numero da solo non basta per scegliere una configurazione per un altro prodotto.
Fonti e limite di provenienza
Da dove provengono i risultati?
Il documento originale indica che la redazione ha confrontato il rapporto, le metriche, il protocollo, i blocchi e la validazione finale dell'archivio. Riporta inoltre che un ricalcolo di controllo ritrova i valori catturati. I risultati presentati qui sono quelli di questa cartella, non quelli di una nuova campagna eseguita per questa versione didattica.
Un limite deve restare visibile: le fonti usate durante le catture corrispondono a versioni storiche distinte della base Lab installata. Questa differenza deve essere conservata nella cartella di audit. Non annulla da sola la coerenza interna riportata fra le osservazioni; vieta però di supporre che la base presente riproduca automaticamente il codice storico.
È paragonabile a una differenza fra il commit che ha prodotto un risultato di CI e il ramo attualmente aperto nel vostro editor. Per comprendere il risultato precedente, si conserva l'identità del codice che lo ha prodotto.
Due note il cui collegamento al soggetto resta da precisare
La scheda originale comporta anche la menzione «Dati sintetici salvo FLEURS» e una nota identificata 010: capacità di contesto confrontate, prompt deterministici sotto il limite e generazione di 64 token.
Il soggetto Q4/Q8 è invece identificato 006. Gli elementi forniti non spiegano come queste due note si colleghino alle sue misure. Sono conservate come indicazioni di provenienza, ma non ne deduciamo né che FLEURS faccia parte dei casi Q4/Q8, né che le generazioni di questo confronto abbiano un limite di 64 token. Questi punti devono essere stabiliti nel protocollo interessato, non completati per supposizione.
A cosa servono i riferimenti complementari?
I link alle documentazioni di Qwen, GGUF, llama.cpp, Python e Docker servono a spiegare i concetti. Non sostituiscono le versioni bloccate dell'esperimento e non aggiungono alcuna validazione GPU. Una documentazione attuale può mostrare altri modelli o altri comandi: non autorizza a sostituirli al percorso misurato.
Tracciabilità di questo esperimento
Questa sezione riunisce gli elementi necessari per identificare la campagna e comprendere le condizioni della sua ripresa. Potete leggerla come la scheda tecnica di un test: con cosa è stato eseguito, quando e a partire da quali file?
Il modello e i suoi file
Le due varianti provengono da Qwen/Qwen2.5-7B-Instruct-GGUF, alla revisione:
bb5d59e06d9551d752d08b292a50eb208b07ab1f
Le licenze dichiarate nella cartella sono Apache-2.0 per q4 e apache-2.0 per q8. Le impronte individuali dei file sono conservate in locks/models.lock.json.
Queste informazioni identificano gli asset testati. Non indicano una versione attuale consigliata. Il repository a questa revisione precisa permette di distinguere questi file da quelli di un ramo che sarebbe cambiato.
Hardware e ambiente registrati
Il calcolo di questo soggetto utilizza una RTX 3090. Le due GPU della postazione sono riservate durante le misure: questo non significa che il calcolo sia distribuito su due schede.
Il driver registrato è 580.95.05. L'immagine client eseguita è identificata da:
sha256:545518febcd04dce9c9d8b1168af1ce518508901adb517489028ccb5b456ecc2
Questa impronta dell'immagine client non deve essere ribattezzata impronta del server llama.cpp. La cartella registra separatamente gli elementi dell'ambiente.
La distribuzione e la versione esatta di Linux non sono registrate in questo blocco. Queste informazioni non dimostrano quindi una compatibilità con qualsiasi installazione Linux.
Le due esecuzioni dell'11 settembre 2026
Prima campagna. Identificativo run_id: 20260911t123640-73f55072a554. Inizio registrato: 2026-09-11T12:36:40.823741+00:00. Durata catturata: 63.48 s.
Seconda campagna. Identificativo run_id: 20260911t123744-fc0c359a445d. Inizio registrato: 2026-09-11T12:37:44.604541+00:00. Durata catturata: 63.99 s.
Il suffisso +00:00 indica che questi timestamp sono espressi in UTC. Le durate riguardano i comandi catturati, non il tempo totale di installazione, download o intervento.
La consegna è identificata r1. L'impronta del codice registrata è:
e94fd5ca24d24d216757e79747f1c555bd142b3a81f39a0c81346a07d3eebfea
La seconda campagna riparte da uno spazio di lavoro e da volumi applicativi nuovi. Gli asset immutabili verificati sono riutilizzati: «esecuzione pulita» non significa quindi «download di tutti i file da zero».
Le due campagne restano osservazioni sulla postazione dichiarata. La cartella indica che i calcoli sono stati controllati a partire dagli output ricevuti; nessun addestramento né inferenza GPU è stata rilanciata sulla postazione editoriale.
Prima del lancio: disporre del Lab e degli asset
Il punto di partenza è il Lab fornito con il POC, il progetto sperimentale dimostrativo, già installato sulla postazione GPU. Comprende labctl, lab/, batchkit/, scripts/ e i blocchi.
Lo ZIP contiene il programma e le prove, ma non le immagini Docker né i pesi del modello. In questa consegna non è stato creato alcun URL pubblico di download del POC. Il codice completo si trova nel kit di lavoro; gli estratti di questa pagina non permettono da soli di ricostruire un'installazione validata.
Occorre disporre di Docker Compose e dell'accesso NVIDIA alle GPU, poi acquisire gli asset alle revisioni e impronte indicate. Il modello Compose usa percorsi propri della postazione e pull_policy: never: le immagini devono già essere presenti. Secondo la riferimento ufficiale Docker Compose, questa politica vieta il download automatico dell'immagine e provoca un errore se manca localmente.
I pesi e i dati sono montati in sola lettura. Non sostituite una revisione con main, un'immagine precisa con latest o un file verificato con altri pesi soltanto per aggirare un asset mancante: cambiereste l'esperimento.
Lanciare il comando documentato
Posizionatevi nella directory del Lab installato. Il comando seguente è quello estratto dal README; il launcher prepara i percorsi e il progetto Compose, poi esegue il programma nel contenitore.
Fonte bloccata: poc/README.md, riga 4. SHA-256 del file sorgente registrato: ad09840e896cada8ad36cfc3bc888a6aca9492a857591026d9c59964795324ee.
./labctl run --machine gpu --batch 2026-09-11 --topic gguf-q4-q8-mesures
Le opzioni identificano la macchina GPU, il lotto del 2026-09-11 e il soggetto gguf-q4-q8-mesures. Questa data designa il lotto di lavoro; non costituisce una pianificazione futura.
Dopo l'esecuzione, conservate gli output, gli errori e i file di test. Verificate i campioni, la loro copertura e le tolleranze delle due campagne a partire dagli elementi registrati, invece di limitarvi all'assenza di errore nel terminale.
Uno stato già PACKAGED non avvia necessariamente un nuovo esperimento durante un resume. Per sapere se avete realmente rieseguito il calcolo, ritrovate l'esecuzione e il suo run_id. Le due riesecuzioni pulite documentate qui sono quelle identificate più sopra.
Qualsiasi modifica del codice, dei dati, del modello o del protocollo richiede una nuova revisione e nuove catture. I vecchi punteggi non devono essere riassegnati a questa variante.
In caso di errore, poi per pulire
Un'immagine assente, un montaggio inesistente o un timeout superato segnala un prerequisito da risolvere. Fermate il percorso e identificate ciò che manca. Cambiare silenziosamente motore di inferenza o parametri per ottenere un'esecuzione riuscita non riprodurrebbe il test documentato.
La pulizia di questo percorso appartiene al launcher e al suo progetto Compose. Il Makefile ricevuto non fornisce una destinazione clean autonoma; non è quindi proposto alcun comando di eliminazione globale. Conservate gli archivi privati e i pesi condivisi, che possono servire ad altri esperimenti.
Cosa abbiamo imparato
Q4 ottiene qui un punteggio stretto migliore e misure di latenza e throughput migliori di Q8. Questo risultato riguarda due campagne, un modello a una revisione precisa, dati sintetici e un dato contratto di output.
Il punto più utile per uno sviluppatore si trova nelle risposte: una quantità corretta non compensa necessariamente un riferimento incompleto. Bisogna sapere cosa si aspetta la vostra applicazione prima di decidere cosa significhi un «buon punteggio».
Abbiamo anche distinto tre approcci: rileggere risposte registrate, ricalcolarne i punteggi e rieseguire il modello. Sono complementari, ma non costituiscono la stessa validazione.
Per trasporre questo metodo a un altro progetto, iniziate definendo il vostro contratto di output e i vostri casi di test. Esaminate gli errori concreti, poi misurate le prestazioni nelle condizioni che vi interessano. La scelta giusta non è quella il cui nome sembra più rassicurante: è quella di cui avete verificato il comportamento per il vostro utilizzo.