





Hãy hình dung hộp thư của bộ phận hỗ trợ khách hàng. Ứng dụng của bạn phải chuyển mỗi tin nhắn tới đúng nhóm: hóa đơn cần tìm, sự cố cần xử lý, vấn đề truy cập hoặc yêu cầu thông tin. Bạn đã biết cách nhận tin nhắn, kiểm tra JSON và lưu kết quả. Phần chúng ta sẽ tìm hiểu là biến một văn bản tự do thành một nhóm có thể dùng được.
Hãy lấy một ví dụ sư phạm được tạo ra để minh họa nhu cầu: « Từ sáng nay, trang thanh toán trả về lỗi 500. » Chúng ta muốn nhận được câu trả lời dạng sau:
{
  "label": "INCIDENT",
  "explication": "Le message signale une erreur technique sur la page de paiement."
}
Tin nhắn và JSON này không phải một dòng trong corpus, cũng không phải đầu ra đã đo. Chúng chỉ cho thấy hợp đồng mong đợi: một lớp trong bốn lớp, kèm một lời giải thích ngắn.
Chúng ta đã có một mô hình ngôn ngữ chạy cục bộ. Thay vì dạy lại nó cách viết, chúng ta sẽ điều chỉnh một phần nhỏ tham số của nó cho nhiệm vụ này. Phương pháp được dùng gọi là QLoRA. Chúng ta sẽ hiểu cách nó hoạt động, theo dõi mã, tái tạo quá trình huấn luyện, rồi xem các điểm số thực sự chứng minh điều gì.
Mục tiêu không phải hứa hẹn một mô hình tốt hơn trong mọi trường hợp. Mục tiêu là trả lời hai câu hỏi riêng: huấn luyện có thực sự thay đổi điều gì không, và thay đổi đó có cải thiện điều ứng dụng của chúng ta cần không?
Tải toàn bộ dự án của hướng dẫn. Trọng số cơ sở không được kèm theo: bước thu nhận sẽ tải chúng rồi kiểm tra kích thước và dấu vân tay SHA-256. Các lệnh trong bài này tương ứng với quy trình r3; các ví dụ giải thích không làm thay đổi giao thức đó.
Từ vựng cần nắm trước khi chạy mã
Một cơ sở đã được huấn luyện, không phải mô hình tạo từ đầu
Một mô hình ngôn ngữ dùng các tham số, còn gọi là trọng số: những giá trị số ảnh hưởng đến văn bản nó tạo ra. Tên gọi 7B chỉ quy mô khoảng bảy tỷ tham số. Nó không có nghĩa là bảy tỷ tài liệu có thể tra cứu, cũng không phải bảy gigabyte bộ nhớ.
Cơ sở ở đây là mô hình trước khi chúng ta điều chỉnh. Nó đã biết sinh văn bản; chúng ta muốn nó tạo các câu trả lời mong đợi cho nhiệm vụ của mình. Điều chỉnh một mô hình có sẵn từ các ví dụ là fine-tuning, hay tinh chỉnh. Chúng ta không thực hiện tiền huấn luyện ban đầu của nó.
Chỉ thay đổi chỉ dẫn gửi tới mô hình, tức prompt, không thay đổi trọng số của nó. Fine-tuning toàn bộ sẽ cập nhật mọi trọng số liên quan đến huấn luyện. Trong hướng dẫn này, chúng ta chọn đường khác: giữ nguyên cơ sở và học các tham số nhỏ bổ sung. Đây là nguyên tắc của các phương pháp điều chỉnh tiết kiệm tham số, được PEFT tài liệu hóa.
Lựa chọn này cho phép nghiên cứu một sự điều chỉnh với mức dùng bộ nhớ thấp hơn. Nó không chứng minh rằng huấn luyện cần thiết cho mọi bài toán phân loại: so sánh với cơ sở chưa điều chỉnh vẫn là điều bắt buộc.
Học từ tin nhắn và câu trả lời mong đợi
Học có giám sát là cung cấp một đầu vào và câu trả lời muốn nhận. Ở đây, đầu vào là một tin nhắn; mục tiêu là JSON chứa label và explication. Bốn lớp được phép là FACTURE, INCIDENT, ACCES và INFORMATION.
Mô hình không xử lý trực tiếp các chuỗi ký tự của chúng ta. Một tokenizer cắt văn bản thành các đơn vị, tức token hay mã thông báo, rồi biến chúng thành các định danh số. Một token không nhất thiết là cả một từ.
Trong lúc huấn luyện, mô hình gán xác suất cho các token tiếp theo. Loss, gọi là loss trong mã, phạt những dự đoán đặt xác suất quá thấp cho token mong đợi. Đó là tín hiệu số để học, chưa phải điểm chất lượng nghiệp vụ.
Lan truyền ngược, được kích hoạt bởi backward(), tính loss thay đổi thế nào theo các tham số có thể huấn luyện. Các biến thiên này là gradient. Bộ tối ưu AdamW dùng chúng để điều chỉnh tham số. Một bước tối ưu hóa là một lần cập nhật; không nhất thiết là cập nhật sau từng tin nhắn.
Hãy nhớ chuỗi này: mô hình dự đoán, loss đo độ lệch, gradient chỉ cách tác động và bộ tối ưu thực hiện thay đổi.
QLoRA: lưu cơ sở nhẹ hơn và học một adapter
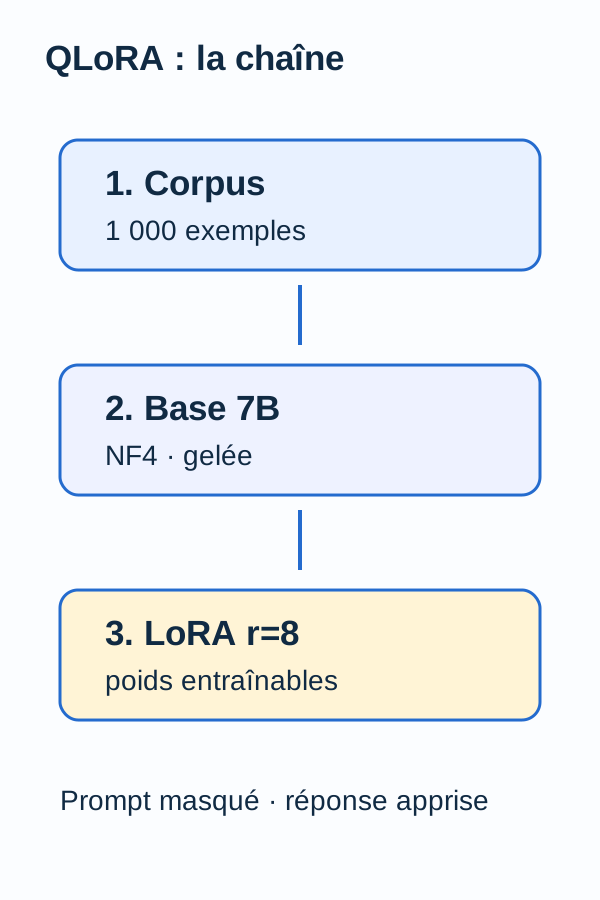
LoRA, viết tắt của Low-Rank Adaptation, thêm các ma trận nhỏ có thể huấn luyện vào những lớp mục tiêu của mô hình, thay vì sửa trọng số gốc. Ma trận ở đây là bảng số; một lớp tuyến tính dùng các bảng đó để biến đổi biểu diễn số của văn bản. Phương pháp được mô tả trong bài nghiên cứu LoRA.
Có thể hình dung adapter là một hiệu chỉnh đã học được cộng vào cách hoạt động của cơ sở. Nó không phải prompt mới hay danh sách quy tắc if/else: đó là các tham số số thực sự.
QLoRA kết hợp các adapter này với một cơ sở đã lượng tử hóa. Lượng tử hóa dùng ít bit hơn để biểu diễn các trọng số mục tiêu, nhờ đó giảm chỗ chiếm trong bộ nhớ. Trong thí nghiệm này, cơ sở được nạp ở 4 bit, theo định dạng NF4, với lượng tử hóa kép. NF4 là biểu diễn dành cho trọng số có phân bố gần chuẩn. Lượng tử hóa kép cũng giảm chỗ dành cho các hệ số của biểu diễn đó; nó không chỉ hai lần huấn luyện liên tiếp. Các cơ chế này được trình bày trong bài QLoRA.
Cần phân biệt rõ: lưu trọng số ở 4 bit không có nghĩa mọi phép tính đều dùng 4 bit. Việc tính toán các lớp lượng tử hóa ở đây được cấu hình là bfloat16, một định dạng số 16 bit. Tài liệu Transformers về bitsandbytes phân biệt việc lưu lượng tử hóa với kiểu tính toán.
Trọng số cơ sở vẫn đóng băng: chúng tiếp tục tham gia tính toán nhưng không được bộ tối ưu cập nhật. Chỉ adapter LoRA được huấn luyện. Thiết lập của chúng trong dự án này như sau:
| Thiết lập | Giá trị trong hướng dẫn | Điều nó điều khiển |
|---|---|---|
Hạng, r |
8 |
Kích thước bên trong của các ma trận hiệu chỉnh nhỏ. Đây không phải số lớp. |
lora_alpha |
16 |
Thang đo phần đóng góp của adapter. |
lora_dropout |
0.0 |
Không có dropout trên nhánh LoRA: ở đây không có vô hiệu hóa ngẫu nhiên. |
target_modules |
all-linear |
Các mô-đun tuyến tính đủ điều kiện do PEFT chọn. Điều này không làm mọi trọng số cơ sở trở nên có thể huấn luyện. |
Trong công thức LoRA chuẩn, thang đo dùng alpha / r, tức 16 / 8 = 2 ở đây. Điều đó không có nghĩa là « chính xác gấp hai ». Chi tiết và quy tắc chọn all-linear có trong tham chiếu LoraConfig. Để tái tạo thí nghiệm, hãy giữ giá trị trong ZIP thay vì dùng giá trị từ một ví dụ tài liệu khác.
Mô hình đọc chỉ dẫn, nhưng chúng ta chấm câu trả lời
Hãy hình dung một bài tập có đề bài và câu trả lời cần viết. Học sinh phải đọc đề; điểm số dựa trên câu trả lời, không dựa trên khả năng chép lại chỉ dẫn.
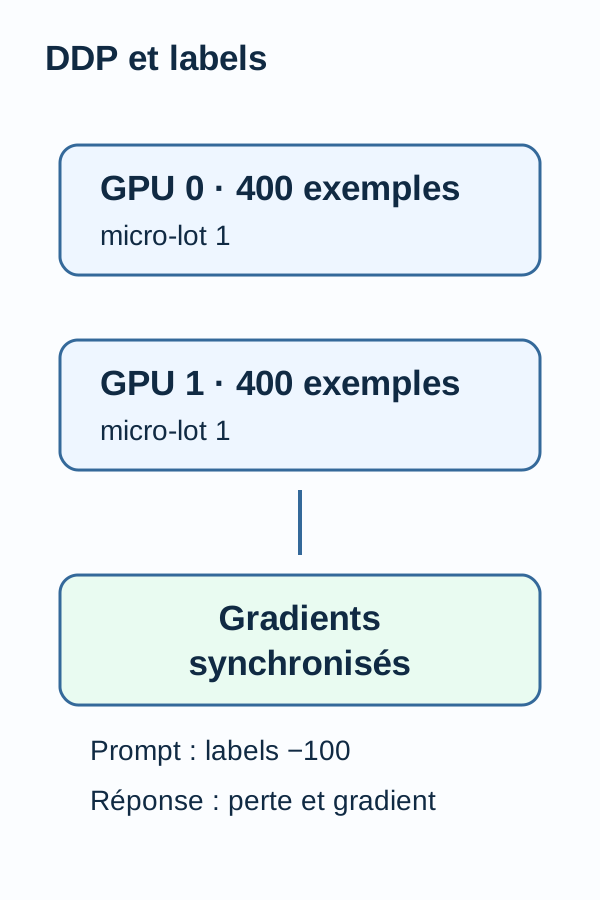
Nguyên tắc ấy cũng áp dụng ở đây. Hàm encode() giữ prompt trong đầu vào, nhưng đánh dấu vị trí của nó bằng -100 trong mục tiêu huấn luyện labels. Các vị trí đó bị bỏ qua trong loss. Bị bỏ qua khi chấm không có nghĩa bị giấu khỏi mô hình. Chúng ta sẽ thấy cơ chế này trong mã.
Hai GPU: chia ví dụ, không gộp bộ nhớ
DDP, viết tắt của DistributedDataParallel, cho nhiều bản sao của mô hình làm việc bằng cách đồng bộ gradient của chúng. Trong dự án này, hai tiến trình dùng mỗi tiến trình một RTX 3090. Mỗi card mang bản sao riêng: chúng ta không tạo ra một card hư cấu 48 Gio.
Mỗi GPU xử lý 400 trong 800 ví dụ huấn luyện. Micro-batch bằng 1: mỗi lần một ví dụ trên mỗi card. Tích lũy gradient bằng 4: mỗi tiến trình tích lũy công việc của bốn ví dụ trước lần cập nhật chung.
Vì vậy số ví dụ góp vào một bước là 1 × 2 × 4 = 8. Với 800 ví dụ, ta có 800 / 8 = 100 bước tối ưu hóa. Đây không phải 100 lượt đi hết corpus.
Sau mỗi cập nhật, giao thức kiểm tra chênh lệch tối đa giữa các bản sao được theo dõi bằng không. Tài liệu DDP của PyTorch mô tả sự đồng bộ này và nhắc rằng việc phân chia dữ liệu vẫn do chương trình đảm nhiệm.
Dữ liệu và pipeline
Corpus chứa 1.000 ví dụ tổng hợp, phân bổ giữa bốn lớp. « Tổng hợp » nghĩa là chúng ta nghiên cứu một tập được xây cho thí nghiệm, không phải mẫu yêu cầu thật đã được dịch vụ khách hàng xác nhận.
Dữ liệu được chia thành ba tập, thường gọi là split:
| Tập | Số ví dụ | Vai trò trong thí nghiệm |
|---|---|---|
Huấn luyện, train |
800 | Cung cấp ví dụ dùng cho cập nhật. |
| Phát triển | 100 | Quan sát loss trên ví dụ tách khỏi huấn luyện. |
| Kiểm thử | 100 | So sánh đầu ra của cơ sở và adapter đã nạp lại. |
Việc tách không chỉ áp dụng cho các dòng: các họ tin nhắn không trùng giữa các tập. Để hiểu vấn đề, hãy hình dung hai yêu cầu giống nhau chỉ khác số hóa đơn. Đặt một trong huấn luyện và một trong kiểm thử có thể tạo ấn tượng phóng đại về tính mới. Ví dụ này minh họa rủi ro; nó không mô tả một họ cụ thể của corpus.
Ta gọi là rò rỉ dữ liệu khi thông tin lẽ ra chỉ dành cho đánh giá lại hỗ trợ nhân tạo việc học hoặc chọn mô hình. Ở đây validate_data() kiểm tra định danh, kích thước 800/100/100, nhãn, văn bản và việc không chồng lấp họ trước khi nạp mô hình. Đây tương đương kiểm tra dữ liệu trước một xử lý tốn kém.
Pipeline, tức chuỗi xử lý, theo thứ tự này: xác thực dữ liệu, đánh giá riêng cơ sở, chuẩn bị cơ sở NF4 để huấn luyện, rồi thêm LoRA. Sau đó ta huấn luyện adapter, kiểm tra gradient và trọng số đã đổi, lưu adapter rồi nạp nó lên một cơ sở mới trước khi đánh giá lại.
Vì sao phải nhấn mạnh việc nạp lại? Kết quả thu được từ một đối tượng còn trong bộ nhớ không đủ chứng minh tệp đã lưu hoạt động. Mô hình được đánh giá sau điều chỉnh phải dùng adapter đọc lại từ đĩa.
train.py đặc biệt từ chối dữ liệu không hợp lệ, rò rỉ họ, ngữ cảnh dài hơn 1.024 token hoặc adapter vắng mặt. Các kiểm thử âm này xác minh đầu vào sai thực sự bị từ chối. Như với API, thành công của trường hợp danh nghĩa là chưa đủ.
Các hàm trung tâm cần đọc trước khi chạy
Bốn trích đoạn sau cho thấy cơ chế thiết yếu. Chúng không tạo thành một script tự chạy: import, khởi tạo phân tán, tokenizer, dữ liệu và các hàm khác nằm trong dự án hoàn chỉnh. Hãy dùng lệnh trong kho lưu trữ để chạy quy trình.
Trong các trích đoạn này, RANK xác định tiến trình và card của nó trong cấu hình hai GPU; WORLD bằng 2, số tiến trình tham gia. tok là tokenizer và DATA chứa corpus đã nạp.
Nạp cơ sở cục bộ ở 4 bit
load_base() đọc trọng số trong /models/qlora, một đường dẫn bên trong container. Cấu hình yêu cầu NF4, lượng tử hóa kép và tính toán bằng bfloat16.
quant = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type='nf4',
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.bfloat16,
)


def load_base():
    m = AutoModelForCausalLM.from_pretrained(
        '/models/qlora',
        local_files_only=True,
        quantization_config=quant,
        device_map={'': RANK},
        torch_dtype=torch.bfloat16,
        attn_implementation='sdpa',
    )
    assert m.is_loaded_in_4bit
    m.config.use_cache = False
    return m
local_files_only=True ngăn lần nạp này đi tìm các tệp thiếu trên mạng. Thu nhận là một bước riêng. device_map={'': RANK} đặt bản sao này trên card gắn với tiến trình: đây không phải chia sẻ tự động mô hình giữa hai card.
Assertion m.is_loaded_in_4bit kiểm tra việc nạp 4 bit đã xảy ra; NF4 được yêu cầu ngay trong cấu hình phía trên. Chỉ riêng nó không phải kiểm toán mọi tham số nội bộ. use_cache=False tắt bộ đệm sinh trong quy trình huấn luyện này; attn_implementation='sdpa' giữ cơ chế attention đã chọn trong môi trường được kiểm thử.
Việc vừa làm là nạp cơ sở, chưa huấn luyện nó. Chuẩn bị cho huấn luyện lượng tử hóa và thêm adapter thuộc các bước tiếp theo của chương trình hoàn chỉnh.
Biến một ví dụ thành đầu vào và mục tiêu
Hàm encode() chuẩn bị phần mô hình sẽ đọc và các vị trí dùng để tính loss.
def encode(row):
    answer = json.dumps(
        {'label': row['label'], 'explication': row['explanation']},
        ensure_ascii=False,
    )
    a = tok(prompt(row), add_special_tokens=False)['input_ids']
    b = tok(answer + tok.eos_token, add_special_tokens=False)['input_ids']
    ids = a + b

    if not 0 < len(ids) <= 1024:
        raise ValueError('context >1024')

    return {
        'input_ids': torch.tensor([ids], device=RANK),
        'attention_mask': torch.ones(
            (1, len(ids)),
            device=RANK,
            dtype=torch.long,
        ),
        'labels': torch.tensor([[-100] * len(a) + b], device=RANK),
    }
Bắt đầu với tên gọi. Trong dữ liệu nguồn, phần giải thích tên là explanation. JSON chúng ta muốn học dùng khóa tiếng Pháp explication. Dòng đầu của hàm thực hiện ánh xạ này mà không đổi lớp mong đợi.
a chứa định danh của chỉ dẫn và tin nhắn. b chứa định danh của JSON mong đợi, theo sau bởi eos_token, dấu kết thúc chuỗi. ids = a + b tạo thành chuỗi hoàn chỉnh.
Để hình dung việc che, hãy lấy các định danh giả không liên quan đến tokenizer thật:
Prompt :       [11,   12,   13]
Réponse :      [21,   22]
input_ids :    [11,   12,   13, 21, 22]
labels :       [-100, -100, -100, 21, 22]
Các định danh của prompt vẫn ở input_ids, nhưng được thay bằng -100 trong labels. Quy ước ignore_index=-100 của loss entropy chéo PyTorch cho phép bỏ qua các mục tiêu này. Đây không phải hình phạt âm một trăm, cũng không phải token cần sinh.
Vì sao câu trả lời cũng xuất hiện trong đầu vào khi huấn luyện? Trong mô hình ngôn ngữ nhân quả, mỗi vị trí học dự đoán token kế tiếp từ các token trước đó, không truy cập token sau. Mô hình xử lý sự dịch chuyển giữa dự đoán và mục tiêu. Khi sử dụng, câu trả lời mong đợi không còn được cung cấp: mô hình tự sinh nó. Khóa học Hugging Face về mô hình nhân quả giải thích cơ chế này.
attention_mask ở đây chứa 1 cho mọi vị trí có mặt. Không được nhầm nó với việc che loss trong labels, cũng không suy ra rằng mô hình có thể đọc token tương lai.
Cuối cùng, giới hạn 1.024 token áp dụng cho toàn bộ prompt + câu trả lời + dấu kết thúc. Chương trình từ chối chuỗi vượt giới hạn thay vì cắt im lặng câu trả lời. Đây là giới hạn của giao thức được thử; nó không nhất thiết mô tả khả năng tối đa của mô hình trong cách dùng khác.
Thêm LoRA và thực hiện cập nhật
get_peft_model() thêm các adapter. Danh sách trainable chỉ giữ tham số có requires_grad đúng, sau đó assertion yêu cầu tên của chúng chứa lora_. Nói cách khác, chương trình kiểm soát thứ mình cho phép học trước khi tối ưu hóa.
Một tensor là mảng số có thể có nhiều chiều. before sao chép các tensor có thể huấn luyện trước lần cập nhật đầu; initial_hash tính dấu vân tay byte của chúng. Các phần này cho phép so sánh trạng thái ban đầu với trạng thái đã huấn luyện.
model = get_peft_model(
    base,
    LoraConfig(
        r=8,
        lora_alpha=16,
        lora_dropout=0.0,
        target_modules='all-linear',
        bias='none',
        task_type='CAUSAL_LM',
    ),
)
model.config.use_cache = False
trainable = [p for p in model.parameters() if p.requires_grad]
assert trainable and all(
    ('lora_' in n for n, p in model.named_parameters() if p.requires_grad)
)
before = [p.detach().cpu().clone() for p in trainable]
initial_hash = hashlib.sha256(
    b''.join((p.numpy().tobytes() for p in before))
).hexdigest()

# Répliques DDP :400 exemples par GPU, accumulation4, batch global8.
wrapped = DDP(
    model,
    device_ids=[RANK],
    output_device=RANK,
    find_unused_parameters=False,
    broadcast_buffers=False,
)
optimizer = torch.optim.AdamW(trainable, lr=0.0002, weight_decay=0.01)
train = [q for q in DATA['queries'] if q['split'] == 'train']
random.Random(42).shuffle(train)
own = train[RANK::WORLD]
assert len(own) == 400
partitions = [None] * WORLD
dist.all_gather_object(partitions, [q['id'] for q in own])
emit('training-partition', rank_ids=partitions)
accum = 4
losses = []
start = time.monotonic()
optimizer.zero_grad(set_to_none=True)
wrapped.train()
maxnorm = 0

for i, row in enumerate(own):
    sync = (i + 1) % accum == 0
    with contextlib.nullcontext() if sync else wrapped.no_sync():
        loss = wrapped(**encode(row)).loss
        assert torch.isfinite(loss)
        (loss / accum).backward()

    losses.append(float(loss.detach()))
    if sync:
        norm = torch.nn.utils.clip_grad_norm_(trainable, 1.0)
        assert torch.isfinite(norm)
        maxnorm = max(maxnorm, float(norm))
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)
        both = torch.tensor(sum(losses[-4:]) / 4, device=RANK)
        dist.all_reduce(both)
        emit(
            'train-step',
            step=(i + 1) // 4,
            loss=float(both) / WORLD,
            rank0_example_ids=[r['id'] for r in own[i - 3:i + 1]],
            gradient_norm=float(norm),
        )
Trích đoạn dài hơn, nhưng nó theo ba thao tác quen thuộc: phân chia công việc, thực hiện nó, rồi ghi nhật ký những gì đã xảy ra.
Phân chia các ví dụ. random.Random(42).shuffle(train) trộn dữ liệu với một seed cố định. Sau đó train[RANK::WORLD] lấy mỗi hai dòng một: một tiến trình xử lý vị trí chẵn, tiến trình kia vị trí lẻ trong danh sách đã trộn này. Mỗi bên phải nhận chính xác 400 ví dụ. all_gather_object() tập hợp các định danh của chúng cho sự kiện training-partition.
Tích lũy rồi cập nhật. Với mỗi ví dụ, wrapped(**encode(row)).loss tính hàm mất mát. Khẳng định isfinite từ chối giá trị vô hạn hoặc không xác định. (loss / accum).backward() tích lũy đóng góp vào gradient sau khi chia cho 4. Ba ví dụ đầu dùng no_sync(); ví dụ thứ tư kích hoạt đồng bộ trước khi cập nhật. Đây là cơ chế tích lũy được mô tả trong tài liệu DDP.no_sync().
clip_grad_norm_(trainable, 1.0) giới hạn chuẩn tổng thể của gradient, một thước đo độ lớn của chúng, để tránh cập nhật từ các gradient quá lớn. Giá trị được trả về và ghi nhật ký là chuẩn trước khi giới hạn: vì vậy giá trị lớn hơn 1 trong nhật ký không tự động có nghĩa kiểm soát đã thất bại. Xem tham chiếu PyTorch về clip_grad_norm_.
Sau đó optimizer.step() áp dụng cập nhật. Bộ tối ưu AdamW ở đây dùng lr=0.0002, tốc độ học điều khiển quy mô điều chỉnh, và weight_decay=0.01, một hạng chính quy hóa trọng số. zero_grad(set_to_none=True) đặt lại gradient cho nhóm tiếp theo. Dự án thực sự dùng torch.optim.AdamW như hiển thị, không thay bằng bộ tối ưu khác.
Ghi nhật ký. Các dòng cuối tính loss trung bình và ghi nó cùng số bước và chuẩn gradient. Lời gọi rõ ràng dist.all_reduce(both) ở đây gộp loss cho nhật ký: DDP đồng bộ gradient trong quá trình lan truyền ngược.
Các kiểm tra sau vòng lặp trong chương trình hoàn chỉnh yêu cầu trọng số đã thay đổi, gradient khác không và các bản sao giống hệt. Không phải tất cả đều được đưa vào trích đoạn này. Sau khi lưu, adapter_hash() đọc lại tham số LoRA: dấu vân tay giống nhau trước và sau khi nạp lại kiểm tra adapter đánh giá đúng là adapter đã lưu. Như checksum của một artefact, SHA-256 xác nhận nhận dạng các byte so sánh, không xác nhận chất lượng câu trả lời.
Đếm câu trả lời đúng mà không che lỗi định dạng
Hàm classification() của metrics.py đọc đầu ra sinh và so sánh chúng với các lớp mong đợi. Đây là phần giải mã và đếm; việc tính cuối và trả metric nằm trong hàm hoàn chỉnh của ZIP.
def classification(rows, expected):
    matrix = [[0] * 5 for _ in range(4)]
    correct = 0

    for row in rows:
        truth = LABELS.index(expected[row['sample_id']]['label'])
        try:
            obj = json.loads(row['raw'])
            label = obj['label']
            pred = (
                LABELS.index(label)
                if isinstance(obj.get('explication'), str)
                and obj['explication'].strip()
                else 4
            )
        except (ValueError, KeyError, TypeError):
            pred = 4

        matrix[truth][pred] += 1
        correct += pred == truth
matrix có bốn hàng, một cho mỗi lớp thật, và năm cột: bốn lớp có thể có cùng một cột lỗi. Vì thế một câu trả lời không hợp lệ vẫn nằm trong báo cáo; nó không bị bỏ đi để điểm trông đẹp hơn.
Mã bắt đầu bằng việc giải mã row['raw'] bằng json.loads(). Sau đó nó tìm giá trị label trong LABELS. Để chấp nhận dự đoán này, explication phải là chuỗi không rỗng sau khi bỏ khoảng trắng đầu cuối. Những lỗi except xử lý được tính vào cột thứ năm.
Hãy chú ý chi tiết: strip() được áp dụng cho lời giải thích, nhưng không áp dụng cho label trong đánh giá nghiêm ngặt này. Vì thế label có khoảng trắng cuối không bằng giá trị được phép không có khoảng trắng đó.
Điều này không có nghĩa chương trình so sánh từng byte của JSON. Trình phân tích chấp nhận khoảng trắng thụt lề; nhưng một khoảng trắng trong giá trị label sẽ đổi chuỗi được so sánh. Chúng ta sẽ trở lại khác biệt này trong bài tập.
Một giới hạn khác cần nhớ: kiểm tra này xác nhận lời giải thích tồn tại và không rỗng. Nó không đánh giá mức liên quan, tính đúng đắn hay độ ngắn gọn. Có văn bản không phải là xác thực nội dung của văn bản.
Tái tạo theo đúng thứ tự
Để theo phần thực hành, bạn cần biết đọc Python, dùng terminal và nhận ra đối tượng JSON. Script chạy từ gốc của một bản giải nén mới của kho lưu trữ; đừng dựng lại dự án bằng cách chỉ ghép các trích đoạn bài viết.
Cấu hình đã xác nhận dùng Linux x86_64, Docker/Compose, driver NVIDIA và NVIDIA Container Toolkit, với hai RTX 3090. Mức cấp phát công bố là 48 Gio RAM, 40 Gio đĩa và 20 Gio VRAM trống trên mỗi card. RAM thuộc máy; VRAM là bộ nhớ của từng GPU. Những giá trị này là mức cấp phát, không phải mức tối thiểu đã đo.
Không có quy trình CPU nào được xác nhận. Chương trình yêu cầu hai GPU cho lần tái tạo này; giảm số lượng của chúng không phải chỉ là một biến thể đơn giản của cùng cách chạy.
1. Kiểm tra máy chủ rồi chuẩn bị image
Preflight là kiểm tra điều kiện tiên quyết. Nó phải xác nhận Docker, Compose, sự hiện diện của hai card và truy cập CUDA từ container. CUDA là môi trường tính toán NVIDIA dùng trong stack này; nhìn thấy card trên Linux chưa đủ chứng minh Docker sử dụng được chúng. Hướng dẫn NVIDIA Container Toolkit mô tả cách cấu hình quyền truy cập này.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
setup.sh chuẩn bị quyền cục bộ mà Compose dùng. Sau đó docker compose build dựng image của dự án.
Cần quan sát: các kiểm tra đều qua và build kết thúc không lỗi. Nếu GPU chỉ hiện từ máy chủ, hãy sửa truy cập từ Docker trước khi thu nhận và huấn luyện.
2. Thu nhận cơ sở và kiểm tra các hàng rào bảo vệ
Dịch vụ fetch tải một bản sửa đổi cố định của mô hình, kiểm tra kích thước và SHA-256, rồi đặt tệp cuối cùng. Một bản sửa đổi cố định ở đây đóng vai trò phiên bản phụ thuộc chính xác: nó cho biết thí nghiệm đã dùng đúng những tệp nào.
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
Lệnh thứ hai chạy bộ kiểm thử. Nó đặc biệt bao phủ các trường hợp âm liên quan đến dữ liệu và ngữ cảnh.
Cần quan sát: 15 kiểm thử công khai thành công. Lỗi hash không phải cảnh báo để vượt qua. Một mô hình khác lấy từ cache không xác định sẽ không còn tái tạo thí nghiệm được mô tả.
3. Chuẩn bị rồi huấn luyện adapter
prepare xác thực corpus và tạo dữ liệu đã chuẩn bị. train thực hiện đánh giá cơ sở, 100 bước DDP và nạp lại adapter. Đây là bước dùng cả hai GPU.
docker compose run --rm --no-deps app -m src.cli prepare
docker compose run --rm --no-deps app -m src.cli train
Cần quan sát: các sự kiện JSON training-complete, adapter-roundtrip và complete, với 800 ví dụ, 100 bước và replica_max_difference bằng 0.
Round-trip là lưu rồi nạp lại. Nếu thiếu sự kiện này, đừng kết luận adapter đã đọc lại được đánh giá đúng. Loss giảm trong nhật ký không thay thế được kiểm tra đó.
4. Tạo các metric
Bây giờ chúng ta có thể lập báo cáo phân loại và ma trận nhầm lẫn.
docker compose run --rm --no-deps app -m src.cli evaluate
Cần quan sát: một JSON phân loại cho cơ sở và một JSON khác cho adapter đã nạp lại. Trước khi chạy exercise, hãy dành thời gian hiểu các điểm số dưới đây: bài tập sẽ yêu cầu bạn dự đoán tác động của thay đổi cách đọc kết quả.
Cách đọc metric trước khi xem kết quả
Accuracy và macro-F1: hai cách đọc bổ sung
Accuracy là tỷ lệ ví dụ được phân loại đúng theo quy tắc của chương trình. Điểm 0,90 trên 100 trường hợp nghĩa là 90 câu trả lời đáp ứng các quy tắc này. Ở đây lỗi định dạng hoặc giải thích rỗng là đủ làm một trường hợp thất bại.
F1 kết hợp hai khái niệm. Với một lớp, precision hỏi: « Trong các câu trả lời công bố lớp này, bao nhiêu câu đúng? » Recall hỏi: « Trong các tin nhắn thực sự thuộc lớp này, bao nhiêu tin được tìm thấy? » F1 là trung bình điều hòa, tính bằng 2 × precision × recall / (precision + recall) khi mẫu số khác không.
Macro-F1 tính F1 cho từng trong bốn lớp rồi lấy trung bình. Vì thế mỗi lớp có cùng trọng số bất kể quy mô của nó. Tài liệu metric scikit-learn giải thích sâu hơn các định nghĩa này; điểm của hướng dẫn vẫn do mô-đun metrics.py của chính nó tính.
Ma trận nhầm lẫn giúp hiểu lỗi. Nó đối chiếu lớp mong đợi với lớp dự đoán, đồng thời giữ thêm một cột cho đầu ra bị từ chối. Nhầm FACTURE với INCIDENT không kể cùng câu chuyện với câu trả lời INCIDENT bị loại vì khoảng trắng cuối.
Loss thấp không thay thế các kiểm tra này
Loss phát triển đo xác suất mô hình khớp các token mong đợi trong tập phát triển đến mức nào. Nó không phải phần trăm lỗi nghiệp vụ, cũng không phải thước đo độc lập về chất lượng giải thích.
Hơn nữa, điểm tốt không đủ chứng minh chuỗi huấn luyện đã hoạt động như dự kiến. Dự án kiểm tra riêng 392 tensor LoRA đã thay đổi, 20 185 088 tham số có thể huấn luyện, 100 bước tối ưu hóa, gradient khác không và sự bằng nhau của adapter trên hai bản sao.
Hai con số đầu không đếm cùng một thứ: tensor là các mảng, tham số là các giá trị số trong chúng. Kiểm tra xác lập adapter đã đổi và được đồng bộ; điểm số sau đó cho biết đầu ra của chúng hoạt động ra sao trên corpus.
Kết quả quan sát được và điều chúng cho phép kết luận
Các giá trị sau là giá trị báo cáo cho quy trình r3. Đánh giá áp dụng cho 100 trường hợp kiểm thử, không phải 800 ví dụ dùng để cập nhật.
| Phép đo trên kiểm thử | Cơ sở chưa điều chỉnh | Cơ sở với adapter đã nạp lại |
|---|---|---|
| Accuracy nghiêm ngặt | 0,90 | 1,00 |
| Macro-F1 | 0,9167 | 1,00 |
Trường hợp INCIDENT trong cột lỗi định dạng |
10 | 0 |
Thoạt nhìn, chuyển từ 0,90 lên 1,00 có vẻ kể câu chuyện đơn giản: « Chúng ta đã dạy mô hình phân loại tốt hơn. » Nhưng ma trận đòi hỏi cách đọc chính xác hơn. 10 thất bại của cơ sở nằm ở cột lỗi định dạng, không nằm trong một lớp nghiệp vụ khác.
Vì thế kết luận được hỗ trợ trực tiếp là adapter nạp lại đáp ứng hợp đồng nghiêm ngặt của thí nghiệm tốt hơn. Ta không thể biến kết quả này thành bằng chứng hiểu sự cố tốt hơn, nhất là khi bài tập cho thấy tác động của việc làm sạch label của cơ sở.
Huấn luyện mất 139,5 s trong lần tái tạo đầu và 141,6 s trong lần thứ hai. Các thời lượng này thuộc huấn luyện được báo cáo, không hứa hẹn tổng thời gian gồm cài đặt và tải xuống. Loss phát triển quan sát được là 1,4785609673708677e-05, tức khoảng 0,0000148: dạng thập phân này là chuyển đổi làm tròn của cùng giá trị, không phải phép đo mới.
Mức VRAM tối đa ghi được xấp xỉ 14 145 Mio và 13 722 Mio tùy GPU. Bộ nhớ được lấy mẫu khoảng một lần mỗi giây: đỉnh giữa hai lần đo có thể không được thấy. Vì vậy các giá trị này không thay thế mức cấp phát 20 Gio trống mỗi card công bố cho tái tạo.
Kết quả này mô tả corpus, thiết lập và máy này. Chúng không chứng minh khả năng khái quát sang tin nhắn thật, ưu thế trước mô hình khác hay chất lượng sản xuất. Cache Docker công khai và hoạt động chung của máy cũng thuộc bối cảnh tài nguyên quan sát.
Điều chúng ta đã học
Chúng ta đã theo một chuỗi hoàn chỉnh: dữ liệu tách theo họ, cơ sở lượng tử hóa và đóng băng, adapter LoRA có thể huấn luyện, gradient đồng bộ, lưu, rồi nạp lại trên một cơ sở mới. Huấn luyện không chỉ là đường cong loss: còn cần biết tham số nào đã đổi và artefact nào được đánh giá.
Chúng ta cũng phân biệt học và đo. Sửa trọng số thay đổi hành vi mô hình. Sửa cách đọc đầu ra của nó có thể đổi điểm mà không chạm vào mô hình.
Điểm 1,00 của adapter vẫn chỉ là kết quả trên 100 ca kiểm thử tổng hợp. Việc cơ sở đi từ 0,90 lên 1,00 sau khi bỏ khoảng trắng là thao tác khác: câu trả lời không đổi, nhưng so sánh trở nên khoan dung hơn. Nhầm lẫn hai việc sẽ dẫn đến công bố lợi ích ngữ nghĩa mà thí nghiệm không xác lập.
Bài tập chủ động: dự đoán, sửa, chạy, quan sát, giải thích
Giờ bạn ở vị trí nhà phát triển nhận JSON. Trước khi chạy lệnh, hãy xem hai đối tượng này, được tạo để giải thích chứ không sao từ ảnh chụp:
{
  "label": "INCIDENT",
  "explication": "Un problème technique est signalé."
}
{
  "label": "INCIDENT ",
  "explication": "Un problème technique est signalé."
}
Cả hai đối tượng đều là JSON hợp lệ. Tuy nhiên trong đối tượng thứ hai, giá trị label có khoảng trắng cuối. Hãy dự đoán LABELS.index(label) sẽ làm gì, rồi điều gì thay đổi khi so sánh label.strip().
Phương thức Python strip() bỏ ký tự khoảng trắng ở đầu và cuối chuỗi; nó không huấn luyện lại mô hình và không thay một lớp nghiệp vụ sai bằng lớp đúng.
Bây giờ hãy chạy bài tập có sẵn. Thay đổi đang nghiên cứu liên quan đến cách đọc label, không phải trọng số mô hình:
docker compose run --rm --no-deps app -m src.cli exercise
Kết quả cần quan sát: baseline nghiêm ngặt 0,90; baseline với label đã làm sạch 1,00. Từ baseline ở đây chỉ mốc so sánh, tức cơ sở chưa điều chỉnh.
Một giả thuyết hấp dẫn là: « Điểm tăng, nên mô hình hiểu tin nhắn tốt hơn. » Kết quả không xác nhận điều đó. Không trọng số nào đổi; bài tập làm lộ sự nhạy cảm với định dạng.
Hãy diễn đạt kết luận như sau: « Label của cơ sở đáp ứng phép so sánh sau chuẩn hóa. Điểm khoan dung này phải được trình bày riêng với điểm nghiêm ngặt. » Chuẩn hóa có thể hữu ích cho ứng dụng, nhưng không được âm thầm xóa hợp đồng đã đánh giá.
Để kiểm tra bạn đã hiểu, hãy giải thích vì sao cùng thao tác đó không sửa được label FACTURE gán cho một tin nhắn thực sự là INCIDENT. Khi đó bạn đã phân biệt sửa định dạng với sửa phân loại.
Khắc phục sự cố và dọn dẹp
Chỉ thấy một card. Kiểm tra GPU_DEVICE và GPU_DEVICE_2, rồi chạy lại preflight. Nếu WORLD_SIZE hoặc số GPU không bằng 2, huấn luyện chủ động dừng. Việc phân chia 800 ví dụ và batch toàn cục nói trên dựa trên hợp đồng này.
Một chuỗi vượt 1.024 token. Kiểm tra tổng độ dài chỉ dẫn, tin nhắn, câu trả lời và dấu kết thúc. Trong thí nghiệm riêng dùng ví dụ của bạn, hãy rút ngắn ví dụ thay vì cắt im lặng câu trả lời. Nếu corpus tham chiếu gây lỗi này, trước tiên hãy kiểm tra tệp và cấu hình tái tạo trước khi sửa chúng.
Adapter không nạp lại được. Kiểm tra thư mục outputs/artifacts/adapter và bắt đầu từ bản giải nén mới, không phải tập hợp tệp từng phần. Không có nạp lại được xác nhận, đánh giá đã điều chỉnh không thể được diễn giải là đánh giá artefact đã lưu.
Kết thúc quy trình, từ gốc dự án, hãy dừng tài nguyên Compose:
docker compose down
Lệnh này không xóa mô hình hay đầu ra. Hãy giữ kết quả cần cho so sánh. Để bỏ tệp làm việc, chỉ xóa thư mục giải nén bạn đã tạo sau khi kiểm tra nội dung, không xóa tài nguyên dùng chung với dự án khác.
Đi xa hơn
Bước tiếp theo thú vị không phải lập tức tìm điểm số ngoạn mục hơn. Đó là xây một kiểm thử mà lỗi không còn được giải quyết bằng việc đơn giản bỏ một khoảng trắng.
Trong một thí nghiệm riêng, hãy giữ nguyên nguyên tắc giao thức này và thay corpus tổng hợp bằng tập được gán nhãn đại diện cho tin nhắn của bạn. Giữ tách theo khách hàng, họ hoặc giai đoạn để tránh gặp trong kiểm thử các biến thể quá gần ví dụ huấn luyện. Luôn so sánh cơ sở chưa điều chỉnh và adapter trên cùng prompt và cùng trường hợp.
Cũng hãy dự kiến abstention: câu trả lời nghĩa là hệ thống không thể phân loại tin nhắn ở mức chấp nhận được và phải chuyển nó cho con người. Khả năng này không thuộc bốn lớp của hợp đồng hiện tại; thêm nó đòi hỏi sửa dữ liệu, định dạng mong đợi, xác thực và metric, rồi đo lại.
Hãy nhờ những người hiểu nghiệp vụ xem lại lỗi trong ma trận và các lời giải thích. Phân biệt lỗi định dạng, nhầm nhóm và lý giải sai. Những hướng mở rộng này không phải kết quả r3 đã đạt: chúng xác định công việc cần thiết để đo tính hữu ích vượt khỏi ví dụ được kiểm soát.
Giới hạn trước khi dùng thực tế
Tập dữ liệu tổng hợp và nhỏ, kiểm thử có 100 trường hợp và không tuyên bố có đánh giá độc lập bởi con người. Loss rất thấp và điểm hoàn hảo trên kiểm thử này không xác thực các tin nhắn mơ hồ, cách diễn đạt bất ngờ hay chất lượng giải thích trong ứng dụng của bạn.
DDP đồng bộ việc học trên hai GPU; tự nó không cung cấp chiến lược triển khai. Trước mọi quyết định nghiệp vụ, cần dữ liệu đại diện, tiêu chí từ chối, xem xét lỗi theo lớp và đánh giá độc lập, với phân tách theo thời gian hoặc khách hàng phù hợp nhu cầu.
Cũng hãy giữ phiên bản corpus, mô hình cơ sở, tokenizer, phụ thuộc, quy tắc tính và adapter. So sánh hai điểm chỉ có ý nghĩa khi biết điều gì đã thay đổi giữa hai thí nghiệm.
Tài liệu PEFT chính thức về lượng tử hóa trình bày sâu hơn việc kết hợp cơ sở lượng tử hóa với adapter có thể huấn luyện. Tham chiếu của bài viết giải thích cơ chế; chúng không thay thế các phiên bản và tham số cố định trong ZIP để tái tạo hướng dẫn này.