





Imaginez la boîte de réception d'un support client. Votre application doit orienter chaque message vers la bonne catégorie : une facture à retrouver, un incident à résoudre, un problème d'accès ou une demande d'information. Vous savez déjà recevoir le message, valider un JSON et enregistrer le résultat. La partie que nous allons explorer est celle qui transforme un texte libre en une catégorie exploitable.
Prenons un exemple pédagogique, inventé pour illustrer le besoin : « Depuis ce matin, la page de paiement renvoie une erreur 500. » Nous aimerions obtenir une réponse de ce type :
{
  "label": "INCIDENT",
  "explication": "Le message signale une erreur technique sur la page de paiement."
}
Ce message et ce JSON ne sont ni une ligne du corpus ni une sortie mesurée. Ils montrent simplement le contrat attendu : une classe parmi quatre, accompagnée d'une brève explication.
Nous disposons déjà d'un modèle de langage local. Plutôt que de lui réapprendre à écrire, nous allons adapter une petite partie de ses paramètres à cette tâche. La méthode utilisée s'appelle QLoRA. Nous allons comprendre son fonctionnement, suivre le code, reproduire l'entraînement, puis examiner ce que les scores démontrent réellement.
Le but n'est pas de promettre un modèle meilleur dans l'absolu. Il est de savoir répondre à deux questions distinctes : l'entraînement a-t-il réellement modifié quelque chose, et cette modification améliore-t-elle ce dont notre application a besoin ?
Télécharger le projet complet du tutoriel. Les poids de base ne sont pas inclus : l'acquisition les télécharge puis vérifie leur taille et leur empreinte SHA-256. Les commandes de cet article correspondent au parcours r3 ; les exemples explicatifs ne changent pas ce protocole.
Le vocabulaire à maîtriser avant de lancer le code
Une base déjà entraînée, pas un modèle à créer de zéro
Un modèle de langage utilise des paramètres, aussi appelés poids : des valeurs numériques qui influencent les textes qu'il produit. L'appellation 7B désigne une taille d'environ sept milliards de paramètres. Elle ne signifie ni sept milliards de documents consultables ni sept gigaoctets de mémoire.
La base est ici le modèle avant notre adaptation. Il sait déjà générer du texte ; nous cherchons à lui faire produire les réponses attendues pour notre tâche. Adapter un modèle existant à partir d'exemples est un fine-tuning, ou ajustement fin. Nous ne réalisons pas son préentraînement initial.
Changer seulement l'instruction envoyée au modèle, le prompt, ne modifie pas ses poids. Un fine-tuning complet mettrait à jour l'ensemble des poids concernés par l'entraînement. Dans ce tutoriel, nous choisissons une autre voie : conserver la base et apprendre de petits paramètres supplémentaires. C'est le principe des méthodes d'adaptation économes en paramètres, documentées par PEFT.
Ce choix permet d'étudier une adaptation avec une empreinte mémoire réduite. Il ne prouve pas qu'un entraînement soit nécessaire pour toute classification : la comparaison avec la base non adaptée reste indispensable.
Apprendre à partir de messages et de réponses attendues
L'apprentissage supervisé consiste à fournir une entrée et la réponse que l'on souhaite obtenir. Ici, l'entrée est un message ; la cible est un JSON contenant label et explication. Les quatre classes autorisées sont FACTURE, INCIDENT, ACCES et INFORMATION.
Le modèle ne manipule pas directement nos chaînes de caractères. Un tokenizer découpe le texte en unités, les tokens ou jetons, puis les transforme en identifiants numériques. Un jeton n'est pas nécessairement un mot entier.
Pendant l'entraînement, le modèle attribue des probabilités aux prochains jetons. La perte, appelée loss dans le code, pénalise les prédictions qui donnent trop peu de probabilité aux jetons attendus. C'est un signal numérique pour apprendre, pas encore une note de qualité métier.
La rétropropagation, déclenchée par backward(), calcule comment cette perte varie avec les paramètres entraînables. Ces variations sont les gradients. L'optimiseur AdamW s'en sert pour ajuster les paramètres. Un pas d'optimisation correspond à une mise à jour ; ce n'est pas nécessairement une mise à jour après chaque message.
Retenez la chaîne : le modèle prédit, la perte mesure l'écart, les gradients indiquent comment agir et l'optimiseur effectue la modification.
QLoRA : stocker la base plus légèrement et apprendre un adaptateur
LoRA, pour Low-Rank Adaptation, ajoute de petites matrices entraînables aux couches ciblées du modèle, au lieu de modifier leurs poids d'origine. Une matrice est ici un tableau de nombres ; une couche linéaire utilise de tels tableaux pour transformer les représentations numériques du texte. La méthode est décrite dans l'article de recherche LoRA.
On peut se représenter l'adaptateur comme une correction apprise qui s'ajoute au fonctionnement de la base. Ce n'est ni un nouveau prompt ni une liste de règles if/else : ce sont de véritables paramètres numériques.
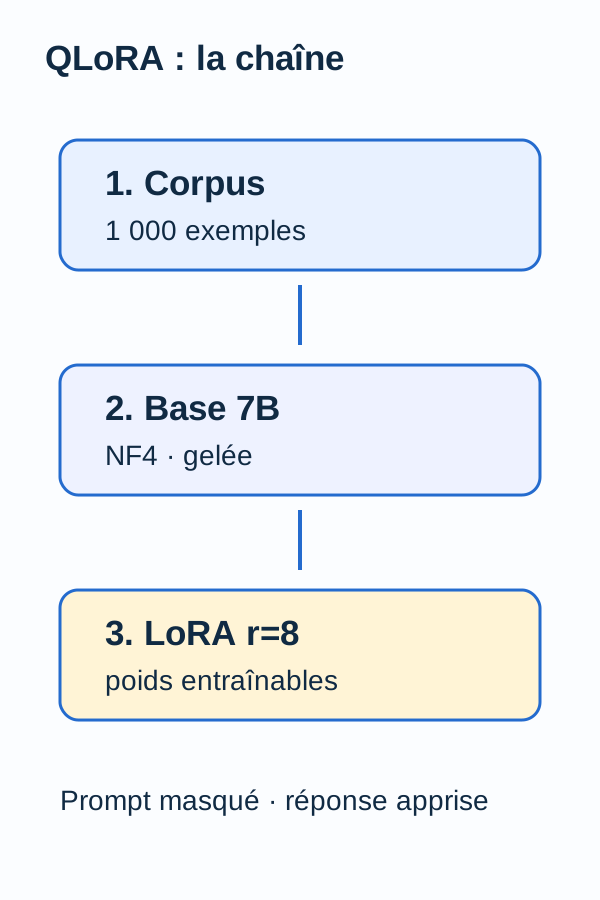
QLoRA associe ces adaptateurs à une base quantifiée. La quantification utilise moins de bits pour représenter les poids ciblés et réduit ainsi leur place en mémoire. Dans notre expérience, la base est chargée en 4 bits, au format NF4, avec double quantification. NF4 est une représentation prévue pour des poids dont la distribution est proche d'une loi normale. La double quantification réduit aussi la place des coefficients utilisés par cette représentation ; elle ne désigne pas deux entraînements successifs. Ces mécanismes sont présentés dans l'article QLoRA.
Attention à une distinction essentielle : stocker des poids en 4 bits ne signifie pas effectuer tous les calculs en 4 bits. Le calcul des couches quantifiées est configuré ici en bfloat16, un format numérique sur 16 bits. La documentation Transformers sur bitsandbytes distingue bien stockage quantifié et type de calcul.
Les poids de la base restent gelés : ils continuent à participer aux calculs, mais ne sont pas mis à jour par l'optimiseur. Seuls les adaptateurs LoRA sont entraînés. Leurs réglages dans ce projet sont les suivants :
| Réglage | Valeur du tutoriel | Ce qu'il règle |
|---|---|---|
Rang, r |
8 |
La dimension interne des petites matrices de correction. Ce n'est pas le nombre de classes. |
lora_alpha |
16 |
L'échelle de la contribution de l'adaptateur. |
lora_dropout |
0.0 |
Aucun dropout dans la branche LoRA : pas de désactivation aléatoire à ce titre. |
target_modules |
all-linear |
Les modules linéaires éligibles sélectionnés par PEFT. Cela ne rend pas tous les poids de la base entraînables. |
Dans la formulation LoRA standard, l'échelle utilise alpha / r, soit 16 / 8 = 2 ici. Cela ne signifie pas « deux fois plus précis ». Les détails et les règles de sélection de all-linear sont précisés dans la référence de LoraConfig. Pour reproduire l'expérience, gardez les valeurs du ZIP plutôt que celles d'un autre exemple documentaire.
Le modèle lit l'instruction, mais nous notons sa réponse
Imaginez un exercice avec un énoncé et une réponse à rédiger. L'élève doit lire l'énoncé ; la note porte sur sa réponse, pas sur sa capacité à recopier la consigne.
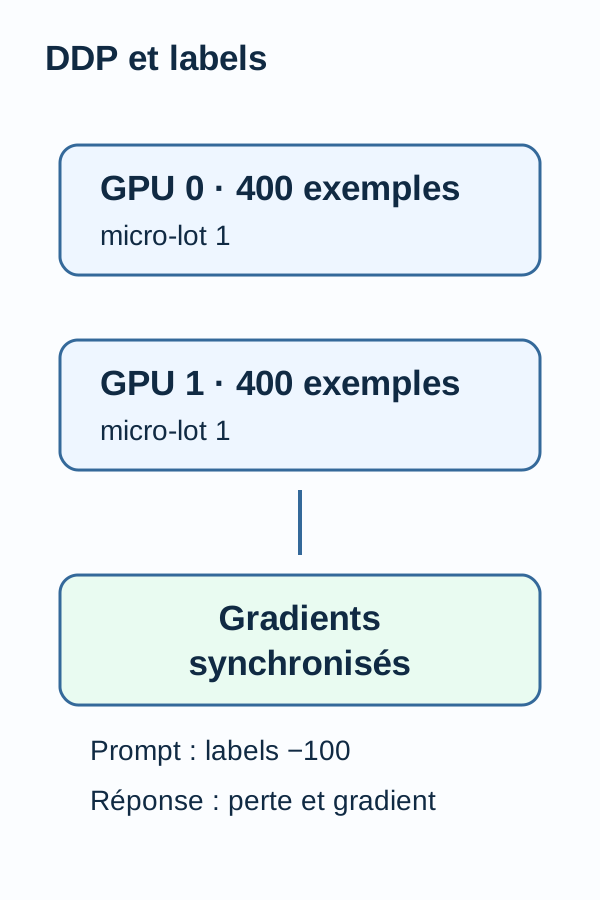
Le même principe s'applique ici. La fonction encode() conserve le prompt dans l'entrée, mais marque ses positions avec -100 dans les cibles d'entraînement, labels. Ces positions sont ignorées dans la perte. Ignorées pour la note ne veut pas dire cachées au modèle. Nous verrons ce mécanisme dans le code.
Deux GPU : partager les exemples, pas fusionner les mémoires
DDP, pour DistributedDataParallel, fait travailler plusieurs répliques du modèle en synchronisant leurs gradients. Dans ce projet, deux processus utilisent chacun une RTX 3090. Chaque carte porte sa propre réplique : nous ne créons pas une carte fictive de 48 Gio.
Chaque GPU traite 400 des 800 exemples d'entraînement. Le micro-lot vaut 1 : un exemple à la fois sur chaque carte. L'accumulation de gradients vaut 4 : chaque processus accumule le travail de quatre exemples avant la mise à jour commune.
Le nombre d'exemples contribuant à un pas est donc 1 × 2 × 4 = 8. Pour 800 exemples, cela donne 800 / 8 = 100 pas d'optimisation. Il ne s'agit pas de 100 passages complets sur le corpus.
Le protocole vérifie après chaque mise à jour que la différence maximale entre les répliques contrôlées est nulle. La documentation DDP de PyTorch décrit cette synchronisation et rappelle que la répartition des données reste à la charge du programme.
Les données et le pipeline
Le corpus contient 1 000 exemples synthétiques, répartis entre les quatre classes. « Synthétique » signifie que nous étudions un jeu construit pour l'expérience, pas un échantillon de demandes réelles validé par un service client.
Les données sont réparties en trois ensembles, souvent appelés splits :
| Ensemble | Nombre d'exemples | Rôle dans l'expérience |
|---|---|---|
Entraînement, train |
800 | Fournir les exemples qui servent aux mises à jour. |
| Développement | 100 | Observer la perte sur des exemples séparés de l'entraînement. |
| Test | 100 | Comparer les sorties de la base et de l'adaptateur rechargé. |
La séparation ne porte pas seulement sur des lignes : les familles de messages ne se recouvrent pas entre ensembles. Pour comprendre l'enjeu, imaginez deux demandes identiques dont seul un numéro de facture change. Mettre l'une dans l'entraînement et l'autre dans le test pourrait donner une impression exagérée de nouveauté. Cet exemple illustre le risque ; ce n'est pas la description d'une famille précise du corpus.
On parle de fuite de données lorsque des informations qui devraient rester réservées à l'évaluation facilitent artificiellement l'apprentissage ou le choix du modèle. Ici, validate_data() vérifie les identifiants, les tailles 800/100/100, les labels, le texte et l'absence de chevauchement de familles avant de charger le modèle. C'est l'équivalent d'une validation de données avant un traitement coûteux.
Le pipeline, c'est-à-dire la succession des traitements, suit cet ordre : on valide les données, on évalue la base seule, on prépare la base NF4 pour l'entraînement, puis on lui ajoute LoRA. On entraîne ensuite les adaptateurs, on vérifie les gradients et les poids modifiés, on sauvegarde l'adaptateur et on le recharge sur une nouvelle base avant de réévaluer.
Pourquoi insister sur le rechargement ? Un résultat obtenu avec un objet encore présent en mémoire ne suffit pas à montrer que le fichier sauvegardé fonctionne. Le modèle évalué après adaptation doit utiliser l'adaptateur relu depuis le disque.
train.py refuse notamment une donnée invalide, une fuite de famille, un contexte supérieur à 1 024 jetons ou un adaptateur absent. Ces tests négatifs vérifient que les mauvaises entrées sont bien rejetées. Comme pour une API, le succès du cas nominal ne suffit pas.
Les fonctions centrales à lire avant l'exécution
Les quatre extraits suivants montrent les mécanismes essentiels. Ils ne forment pas un script autonome : les imports, l'initialisation distribuée, le tokenizer, les données et les autres fonctions se trouvent dans le projet complet. Utilisez les commandes de l'archive pour exécuter le parcours.
Dans ces extraits, RANK identifie le processus et sa carte dans ce montage à deux GPU ; WORLD vaut 2, le nombre de processus participants. tok est le tokenizer et DATA contient le corpus chargé.
Charger la base locale en 4 bits
load_base() lit les poids dans /models/qlora, un chemin à l'intérieur du conteneur. La configuration demande NF4, la double quantification et un calcul en bfloat16.
quant = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type='nf4',
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.bfloat16,
)


def load_base():
    m = AutoModelForCausalLM.from_pretrained(
        '/models/qlora',
        local_files_only=True,
        quantization_config=quant,
        device_map={'': RANK},
        torch_dtype=torch.bfloat16,
        attn_implementation='sdpa',
    )
    assert m.is_loaded_in_4bit
    m.config.use_cache = False
    return m
local_files_only=True empêche ce chargement d'aller chercher des fichiers manquants en ligne. L'acquisition est une étape distincte. device_map={'': RANK} place cette réplique sur la carte associée au processus : ce n'est pas un partage automatique du modèle entre les deux cartes.
L'assertion m.is_loaded_in_4bit vérifie qu'un chargement en 4 bits a bien eu lieu ; NF4 est demandé par la configuration juste au-dessus. Elle ne constitue pas à elle seule un audit de chaque paramètre interne. use_cache=False désactive le cache de génération dans ce parcours d'entraînement ; attn_implementation='sdpa' conserve le mécanisme d'attention choisi dans l'environnement testé.
Ce que nous venons de faire : charger la base, pas encore l'entraîner. La préparation pour l'entraînement quantifié et l'ajout des adaptateurs appartiennent aux étapes suivantes du programme complet.
Transformer un exemple en entrée et en cible
La fonction encode() prépare ce que le modèle va lire et les positions sur lesquelles calculer la perte.
def encode(row):
    answer = json.dumps(
        {'label': row['label'], 'explication': row['explanation']},
        ensure_ascii=False,
    )
    a = tok(prompt(row), add_special_tokens=False)['input_ids']
    b = tok(answer + tok.eos_token, add_special_tokens=False)['input_ids']
    ids = a + b

    if not 0 < len(ids) <= 1024:
        raise ValueError('context >1024')

    return {
        'input_ids': torch.tensor([ids], device=RANK),
        'attention_mask': torch.ones(
            (1, len(ids)),
            device=RANK,
            dtype=torch.long,
        ),
        'labels': torch.tensor([[-100] * len(a) + b], device=RANK),
    }
Commençons par les noms. Dans la donnée source, l'explication s'appelle explanation. Le JSON que nous voulons apprendre utilise la clé française explication. La première ligne de la fonction réalise cette correspondance sans changer la classe attendue.
a contient les identifiants de l'instruction et du message. b contient ceux du JSON attendu, suivis de eos_token, le marqueur de fin de séquence. ids = a + b forme la séquence complète.
Pour visualiser le masquage, prenons des identifiants fictifs, sans rapport avec le tokenizer réel :
Prompt :       [11,   12,   13]
Réponse :      [21,   22]
input_ids :    [11,   12,   13, 21, 22]
labels :       [-100, -100, -100, 21, 22]
Les identifiants du prompt restent dans input_ids, mais sont remplacés par -100 dans labels. La convention ignore_index=-100 de la perte d'entropie croisée de PyTorch permet d'ignorer ces cibles. Ce n'est ni une pénalité de moins cent ni un jeton à générer.
Pourquoi la réponse figure-t-elle aussi dans l'entrée pendant l'entraînement ? Dans un modèle de langage causal, chaque position apprend à prédire le jeton suivant à partir des précédents, sans accès aux suivants. Le décalage entre prédictions et cibles est géré par le modèle. À l'utilisation, la réponse attendue n'est plus fournie : le modèle la génère. Le cours Hugging Face sur les modèles causaux détaille ce mécanisme.
attention_mask est ici rempli de 1 pour les positions présentes. Il ne faut pas le confondre avec le masquage de la perte dans labels, ni en déduire que le modèle peut lire les futurs jetons.
Enfin, la limite de 1 024 jetons concerne l'ensemble prompt + réponse + marqueur de fin. Le programme refuse la séquence hors limite au lieu de couper silencieusement la réponse. Cette limite appartient au protocole testé ; elle ne décrit pas nécessairement la capacité maximale du modèle dans d'autres usages.
Ajouter LoRA et effectuer les mises à jour
get_peft_model() ajoute les adaptateurs. La liste trainable ne retient que les paramètres dont requires_grad est vrai, puis une assertion exige que leurs noms contiennent lora_. Autrement dit, le programme contrôle ce qu'il autorise à apprendre avant de lancer l'optimisation.
Un tenseur est un tableau numérique pouvant avoir plusieurs dimensions. before copie les tenseurs entraînables avant la première mise à jour ; initial_hash calcule une empreinte de leurs octets. Ces éléments permettent de comparer l'état initial à l'état entraîné.
model = get_peft_model(
    base,
    LoraConfig(
        r=8,
        lora_alpha=16,
        lora_dropout=0.0,
        target_modules='all-linear',
        bias='none',
        task_type='CAUSAL_LM',
    ),
)
model.config.use_cache = False
trainable = [p for p in model.parameters() if p.requires_grad]
assert trainable and all(
    ('lora_' in n for n, p in model.named_parameters() if p.requires_grad)
)
before = [p.detach().cpu().clone() for p in trainable]
initial_hash = hashlib.sha256(
    b''.join((p.numpy().tobytes() for p in before))
).hexdigest()

# Répliques DDP :400 exemples par GPU, accumulation4, batch global8.
wrapped = DDP(
    model,
    device_ids=[RANK],
    output_device=RANK,
    find_unused_parameters=False,
    broadcast_buffers=False,
)
optimizer = torch.optim.AdamW(trainable, lr=0.0002, weight_decay=0.01)
train = [q for q in DATA['queries'] if q['split'] == 'train']
random.Random(42).shuffle(train)
own = train[RANK::WORLD]
assert len(own) == 400
partitions = [None] * WORLD
dist.all_gather_object(partitions, [q['id'] for q in own])
emit('training-partition', rank_ids=partitions)
accum = 4
losses = []
start = time.monotonic()
optimizer.zero_grad(set_to_none=True)
wrapped.train()
maxnorm = 0

for i, row in enumerate(own):
    sync = (i + 1) % accum == 0
    with contextlib.nullcontext() if sync else wrapped.no_sync():
        loss = wrapped(**encode(row)).loss
        assert torch.isfinite(loss)
        (loss / accum).backward()

    losses.append(float(loss.detach()))
    if sync:
        norm = torch.nn.utils.clip_grad_norm_(trainable, 1.0)
        assert torch.isfinite(norm)
        maxnorm = max(maxnorm, float(norm))
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)
        both = torch.tensor(sum(losses[-4:]) / 4, device=RANK)
        dist.all_reduce(both)
        emit(
            'train-step',
            step=(i + 1) // 4,
            loss=float(both) / WORLD,
            rank0_example_ids=[r['id'] for r in own[i - 3:i + 1]],
            gradient_norm=float(norm),
        )
L'extrait est plus long, mais il suit trois opérations familières : répartir du travail, l'exécuter, puis journaliser ce qui s'est passé.
Répartir les exemples. random.Random(42).shuffle(train) mélange les données avec une graine fixée. train[RANK::WORLD] en prend ensuite une ligne sur deux : un processus traite les positions paires, l'autre les impaires, dans cette liste mélangée. Chacun doit obtenir exactement 400 exemples. all_gather_object() rassemble leurs identifiants pour l'événement training-partition.
Accumuler puis mettre à jour. À chaque exemple, wrapped(**encode(row)).loss calcule la perte. L'assertion isfinite refuse une valeur infinie ou indéfinie. (loss / accum).backward() accumule la contribution aux gradients en la divisant par 4. Les trois premiers exemples utilisent no_sync() ; le quatrième déclenche la synchronisation avant la mise à jour. C'est le mécanisme d'accumulation décrit dans la documentation de DDP.no_sync().
clip_grad_norm_(trainable, 1.0) limite la norme globale des gradients, une mesure de leur amplitude, pour éviter une mise à jour alimentée par des gradients trop grands. La valeur renvoyée et journalisée correspond à la norme avant cette limitation : une valeur supérieure à 1 dans le journal ne signifie donc pas automatiquement que le contrôle a échoué. Voir la référence PyTorch de clip_grad_norm_.
optimizer.step() applique ensuite la mise à jour. L'optimiseur AdamW utilise ici lr=0.0002, le taux d'apprentissage qui règle l'échelle des ajustements, et weight_decay=0.01, un terme de régularisation des poids. zero_grad(set_to_none=True) réinitialise les gradients pour le groupe suivant. Le projet emploie bien torch.optim.AdamW tel qu'affiché, pas un autre optimiseur substitué à celui du parcours validé.
Journaliser. Les dernières lignes calculent une moyenne de perte et l'enregistrent avec le numéro de pas et la norme des gradients. L'appel explicite à dist.all_reduce(both) agrège ici la perte pour le journal : la synchronisation des gradients est assurée par DDP pendant la rétropropagation.
Les contrôles qui suivent cette boucle dans le programme complet exigent des poids modifiés, des gradients non nuls et des répliques identiques. Ils ne sont pas tous reproduits dans cet extrait. Après la sauvegarde, adapter_hash() relit les paramètres LoRA : une empreinte identique avant et après le rechargement contrôle que l'adaptateur évalué est bien celui qui a été sauvegardé. Comme une somme de contrôle d'artefact, le SHA-256 vérifie l'identité des octets comparés, pas la qualité des réponses.
Compter les bonnes réponses sans cacher les erreurs de format
La fonction classification() de metrics.py lit les sorties générées et les compare aux classes attendues. Voici sa partie consacrée au décodage et au comptage ; le calcul final et le retour des métriques se trouvent dans la fonction complète du ZIP.
def classification(rows, expected):
    matrix = [[0] * 5 for _ in range(4)]
    correct = 0

    for row in rows:
        truth = LABELS.index(expected[row['sample_id']]['label'])
        try:
            obj = json.loads(row['raw'])
            label = obj['label']
            pred = (
                LABELS.index(label)
                if isinstance(obj.get('explication'), str)
                and obj['explication'].strip()
                else 4
            )
        except (ValueError, KeyError, TypeError):
            pred = 4

        matrix[truth][pred] += 1
        correct += pred == truth
matrix possède quatre lignes, une par classe réelle, et cinq colonnes : les quatre classes possibles, plus une colonne d'erreur. Une réponse invalide reste donc dans le bilan ; elle n'est pas retirée pour rendre le score plus flatteur.
Le code commence par décoder row['raw'] avec json.loads(). Il cherche ensuite la valeur de label dans LABELS. Pour accepter cette prédiction, explication doit être une chaîne non vide après retrait des espaces de début et de fin. Les erreurs prises en charge par le except sont comptées dans la cinquième colonne.
Remarquez le détail : strip() est appliqué à l'explication, mais pas au label dans cette évaluation stricte. Un label contenant un espace final ne correspond donc pas à la valeur autorisée sans cet espace.
Cela ne signifie pas que le programme compare tous les octets du JSON. Les espaces d'indentation sont acceptés par le parseur ; un espace dans la valeur du label change en revanche la chaîne comparée. Nous reviendrons sur cette distinction dans l'exercice.
Autre limite à garder en tête : ce contrôle vérifie que l'explication existe et n'est pas vide. Il ne juge ni sa pertinence, ni sa véracité, ni sa brièveté. La présence d'un texte n'est pas une validation de son contenu.
Reproduction dans l'ordre
Pour suivre la partie pratique, il faut savoir lire du Python, utiliser un terminal et reconnaître un objet JSON. Les scripts s'exécutent depuis la racine d'une extraction neuve de l'archive ; ne reconstruisez pas le projet en assemblant seulement les extraits de l'article.
Le profil validé utilise Linux x86_64, Docker/Compose, un pilote NVIDIA et NVIDIA Container Toolkit, avec deux RTX 3090. Les provisions annoncées sont 48 Gio de RAM, 40 Gio de disque et 20 Gio de VRAM libre sur chaque carte. La RAM appartient à la machine ; la VRAM est la mémoire de chaque GPU. Ces valeurs sont des provisions, pas des minima mesurés.
Aucun parcours CPU n'a été validé. Le programme impose deux GPU pour cette reproduction ; réduire leur nombre ne constitue pas une simple variante du même lancement.
1. Vérifier l'hôte puis préparer l'image
Le préflight est un contrôle des prérequis. Il doit confirmer Docker, Compose, la présence des deux cartes et l'accès CUDA depuis un conteneur. CUDA est l'environnement de calcul NVIDIA utilisé par cette pile ; voir les cartes sur Linux ne suffit pas à montrer que Docker peut les utiliser. Le guide NVIDIA Container Toolkit décrit la configuration de cet accès.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
setup.sh prépare les droits locaux utilisés par Compose. docker compose build construit ensuite l'image du projet.
À observer : les vérifications passent et le build se termine sans erreur. Si le GPU est visible uniquement depuis l'hôte, corrigez l'accès depuis Docker avant l'acquisition et l'entraînement.
2. Acquérir la base et vérifier les garde-fous
Le service fetch télécharge une révision figée du modèle, vérifie la taille et le SHA-256, puis place le fichier final. Une révision figée joue ici le rôle d'une version précise de dépendance : elle permet de savoir exactement avec quels fichiers l'expérience a été réalisée.
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
La seconde commande lance la suite de tests. Elle couvre notamment les cas négatifs liés aux données et au contexte.
À observer : 15 tests publics réussis. Un échec de hash n'est pas un avertissement à contourner. Un autre modèle récupéré dans un cache non identifié ne reproduirait plus l'expérience décrite.
3. Préparer puis entraîner l'adaptateur
prepare valide le corpus et produit les données préparées. train réalise l'évaluation de base, les 100 pas DDP et le rechargement de l'adaptateur. C'est l'étape qui sollicite les deux GPU.
docker compose run --rm --no-deps app -m src.cli prepare
docker compose run --rm --no-deps app -m src.cli train
À observer : les événements JSON training-complete, adapter-roundtrip et complete, avec 800 exemples, 100 pas et replica_max_difference égal à 0.
Le round-trip est l'aller-retour sauvegarde puis rechargement. Si cet événement manque, ne concluez pas que l'adaptateur relu a été correctement évalué. Une baisse de perte dans le journal ne remplace pas cette vérification.
4. Produire les métriques
Nous pouvons maintenant construire le bilan de classification et les matrices de confusion.
docker compose run --rm --no-deps app -m src.cli evaluate
À observer : un JSON de classification pour la base et un autre pour l'adaptateur rechargé. Avant de lancer exercise, prenez le temps de comprendre les scores ci-dessous : l'exercice vous demandera de prédire l'effet d'un changement de lecture des résultats.
Comment lire les métriques avant les résultats
Accuracy et macro-F1 : deux lectures complémentaires
L'accuracy est la proportion d'exemples correctement classés selon les règles du programme. Un score de 0,90 sur 100 cas signifie que 90 réponses satisfont ces règles. Ici, une erreur de format ou une explication vide suffit à faire échouer un cas.
Le F1 combine deux notions. Pour une classe donnée, la précision demande : « Parmi les réponses qui annoncent cette classe, combien ont raison ? » Le rappel demande : « Parmi les messages qui appartiennent réellement à cette classe, combien ont été retrouvés ? » Le F1 en est la moyenne harmonique, calculée par 2 × précision × rappel / (précision + rappel) lorsque le dénominateur n'est pas nul.
Le macro-F1 calcule un F1 pour chacune des quatre classes, puis en fait la moyenne. Chaque classe a ainsi le même poids dans cette moyenne, quelle que soit sa population. La documentation des métriques de scikit-learn approfondit ces définitions ; le score de ce tutoriel reste calculé par son propre module metrics.py.
La matrice de confusion permet ensuite de comprendre les erreurs. Elle croise la classe attendue avec la classe prédite, en conservant ici une colonne supplémentaire pour les sorties refusées. Une confusion entre FACTURE et INCIDENT ne raconte pas la même chose qu'une réponse INCIDENT rejetée à cause d'un espace final.
Une perte faible ne remplace pas ces contrôles
La perte de développement mesure à quel point les probabilités du modèle correspondent aux jetons attendus dans le jeu de développement. Ce n'est ni un pourcentage d'erreurs métier ni une mesure indépendante de la qualité des explications.
En outre, un bon score ne suffit pas à prouver que la chaîne d'entraînement a fonctionné comme prévu. Le projet contrôle séparément 392 tenseurs LoRA modifiés, 20 185 088 paramètres entraînables, 100 pas d'optimisation, des gradients non nuls et l'égalité des adaptateurs sur les deux répliques.
Les deux premiers nombres ne comptent pas la même chose : les tenseurs sont les tableaux, les paramètres sont les valeurs numériques qu'ils contiennent. Les contrôles établissent que les adaptateurs ont été modifiés et synchronisés ; les scores indiquent ensuite comment leurs sorties se comportent sur le corpus.
Résultats observés, et ce qu'ils autorisent à conclure
Les valeurs suivantes sont celles rapportées pour le parcours r3. L'évaluation porte sur les 100 cas de test, pas sur les 800 exemples utilisés pour les mises à jour.
| Mesure sur le test | Base non adaptée | Base avec adaptateur rechargé |
|---|---|---|
| Accuracy stricte | 0,90 | 1,00 |
| Macro-F1 | 0,9167 | 1,00 |
Cas INCIDENT dans la colonne d'erreur de format |
10 | 0 |
À première vue, le passage de 0,90 à 1,00 semble raconter une histoire simple : « Nous avons appris au modèle à mieux classer. » Mais la matrice demande une lecture plus précise. Les 10 échecs de la base sont dans la colonne d'erreur de format, pas dans une autre classe métier.
La conclusion directement soutenue est donc que l'adaptateur rechargé satisfait mieux le contrat strict de cette expérience. Nous ne pouvons pas transformer ce résultat en preuve d'une meilleure compréhension des incidents, d'autant que l'exercice montre l'effet du nettoyage des labels de la base.
L'entraînement a duré 139,5 s lors de la première reproduction et 141,6 s lors de la seconde. Ces durées concernent l'entraînement rapporté, pas une promesse de temps total incluant installation et téléchargement. La perte de développement observée est 1,4785609673708677e-05, soit environ 0,0000148 : cette écriture décimale est une conversion arrondie de la même valeur, pas une nouvelle mesure.
Les maximums de VRAM relevés sont d'environ 14 145 Mio et 13 722 Mio selon le GPU. La mémoire a été échantillonnée environ une fois par seconde : un pic entre deux relevés peut échapper à la mesure. Ces valeurs ne remplacent donc pas la provision de 20 Gio libres par carte annoncée pour la reproduction.
Ces résultats décrivent ce corpus, ces réglages et cette machine. Ils ne démontrent ni une généralisation à des messages réels, ni une supériorité sur un autre modèle, ni une qualité de production. Les caches Docker publics et l'activité générale du poste font également partie du contexte des ressources observées.
Ce que nous avons appris
Nous avons suivi une chaîne complète : données séparées par famille, base quantifiée et gelée, adaptateurs LoRA entraînables, gradients synchronisés, sauvegarde, puis rechargement sur une nouvelle base. L'entraînement ne se résume pas à une courbe de perte : il faut aussi savoir quels paramètres ont changé et quel artefact a été évalué.
Nous avons également distingué apprendre et mesurer. Modifier des poids change le comportement du modèle. Modifier la façon de lire ses sorties peut changer un score sans toucher au modèle.
Le score de 1,00 de l'adaptateur reste un résultat sur 100 cas de test synthétiques. Le passage de la base de 0,90 à 1,00 après retrait d'espaces correspond à une autre opération : ses réponses sont les mêmes, mais leur comparaison devient plus tolérante. Confondre les deux conduirait à annoncer un gain sémantique que l'expérience n'établit pas.
Exercice actif : prédire, modifier, exécuter, observer, expliquer
Vous êtes maintenant du côté du développeur qui reçoit le JSON. Avant de lancer la commande, prenez ces deux objets, construits pour l'explication et non copiés d'une capture :
{
  "label": "INCIDENT",
  "explication": "Un problème technique est signalé."
}
{
  "label": "INCIDENT ",
  "explication": "Un problème technique est signalé."
}
Les deux objets sont du JSON valide. Pourtant, dans le second, la valeur du label contient un espace final. Prédisez ce que fera LABELS.index(label), puis ce qui changerait en comparant label.strip().
La méthode Python strip() retire les caractères d'espacement au début et à la fin de la chaîne ; elle ne réentraîne pas le modèle et ne remplace pas une mauvaise classe métier par la bonne.
Lancez maintenant l'exercice fourni. Le changement étudié concerne la lecture des labels, pas les poids du modèle :
docker compose run --rm --no-deps app -m src.cli exercise
Résultats à observer : baseline stricte 0,90 ; baseline avec label nettoyé 1,00. Le mot baseline désigne ici la référence de comparaison, c'est-à-dire la base non adaptée.
Une hypothèse tentante serait : « Le score monte, donc le modèle comprend mieux les messages. » Le résultat ne la confirme pas. Aucun poids n'a changé ; l'exercice met en évidence une sensibilité au formatage.
Formulez plutôt votre conclusion ainsi : « Les labels de la base satisfont la comparaison après normalisation. Ce score tolérant doit être présenté séparément du score strict. » La normalisation peut avoir un intérêt pour une application, mais elle ne doit pas effacer silencieusement le contrat évalué.
Pour vérifier que vous avez compris, expliquez pourquoi la même opération ne corrigerait pas un label FACTURE attribué à un message réellement INCIDENT. Vous aurez alors distingué une correction de format d'une correction de classification.
Dépannage et nettoyage
Une seule carte est visible. Vérifiez GPU_DEVICE et GPU_DEVICE_2, puis recommencez par le préflight. Si WORLD_SIZE ou le nombre de GPU ne vaut pas 2, l'entraînement s'arrête volontairement. La répartition des 800 exemples et le lot global décrit plus haut reposent sur ce contrat.
Une séquence dépasse 1 024 jetons. Vérifiez la longueur totale de l'instruction, du message, de la réponse et du marqueur de fin. Dans une expérience séparée utilisant vos propres exemples, raccourcissez l'exemple plutôt que de tronquer silencieusement sa réponse. Si le corpus de référence déclenche cette erreur, contrôlez d'abord les fichiers et la configuration de la reproduction avant de les modifier.
L'adaptateur ne se recharge pas. Contrôlez le répertoire outputs/artifacts/adapter et repartez d'une extraction neuve, pas d'un assemblage de fichiers partiels. Sans rechargement validé, l'évaluation adaptée ne peut pas être interprétée comme celle de l'artefact sauvegardé.
À la fin du parcours, depuis la racine du projet, arrêtez les ressources Compose :
docker compose down
Cette commande ne supprime ni les modèles ni les sorties. Conservez les résultats nécessaires à votre comparaison. Pour retirer vos fichiers de travail, supprimez seulement le dossier d'extraction que vous avez créé après avoir vérifié son contenu, pas des ressources partagées avec d'autres projets.
Pour aller plus loin
La suite intéressante n'est pas de chercher immédiatement un score plus spectaculaire. C'est de construire un test où une erreur ne se résout plus par un simple retrait d'espace.
Dans une expérience distincte, conservez les principes de ce protocole et remplacez le corpus synthétique par un jeu annoté représentatif de vos messages. Gardez une séparation par client, famille ou période pour éviter de retrouver dans le test des variantes trop proches des exemples d'entraînement. Comparez toujours la base non adaptée et l'adaptateur sur les mêmes prompts et les mêmes cas.
Prévoyez aussi une abstention : une réponse qui signifie que le système ne peut pas classer le message de manière acceptable et doit le transmettre à une personne. Cette possibilité n'appartient pas aux quatre classes du contrat actuel ; l'ajouter demande de modifier les données, le format attendu, les validations et les métriques, puis de mesurer à nouveau.
Faites relire les erreurs de la matrice et les explications par des personnes qui connaissent le métier. Distinguez les erreurs de format, les mauvaises catégories et les justifications incorrectes. Ces prolongements ne sont pas des résultats déjà obtenus par r3 : ils définissent le travail nécessaire pour mesurer une utilité au-delà de notre exemple contrôlé.
Limites avant un usage réel
Le jeu est synthétique et réduit, le test comporte 100 cas et aucune revue humaine indépendante n'est revendiquée. Une perte très basse et un score parfait sur ce test ne valident pas les messages ambigus, les formulations inattendues ou la qualité des explications dans votre application.
DDP synchronise l'apprentissage sur deux GPU ; il ne fournit pas à lui seul une stratégie de déploiement. Avant toute décision métier, il faut des données représentatives, des critères de refus, une revue des erreurs par classe et une évaluation indépendante, avec une séparation temporelle ou par client adaptée au besoin.
Conservez également la version du corpus, du modèle de base, du tokenizer, des dépendances, des règles de calcul et de l'adaptateur. Comparer deux scores n'a de sens que si l'on sait ce qui a changé entre les deux expériences.
La documentation officielle PEFT sur la quantification approfondit l'association d'une base quantifiée et d'adaptateurs entraînables. Les références de cet article expliquent les mécanismes ; elles ne remplacent pas les versions et paramètres figés du ZIP pour reproduire ce tutoriel.