





Immaginate la casella di posta di un servizio di assistenza clienti. La vostra applicazione deve indirizzare ogni messaggio alla categoria corretta: una fattura da ritrovare, un incidente da risolvere, un problema di accesso o una richiesta di informazioni. Sapete già ricevere il messaggio, convalidare un JSON e registrare il risultato. La parte che esploreremo trasforma un testo libero in una categoria utilizzabile.
Prendiamo un esempio didattico, inventato per illustrare l'esigenza: «Da questa mattina, la pagina di pagamento restituisce un errore 500». Vorremmo ottenere una risposta di questo tipo:
{
  "label": "INCIDENT",
  "explication": "Le message signale une erreur technique sur la page de paiement."
}
Questo messaggio e questo JSON non sono né una riga del corpus né un output misurato. Mostrano semplicemente il contratto previsto: una classe fra quattro, accompagnata da una breve spiegazione.
Disponiamo già di un modello linguistico locale. Invece di insegnargli di nuovo a scrivere, adatteremo a questo compito una piccola parte dei suoi parametri. Il metodo usato si chiama QLoRA. Ne comprenderemo il funzionamento, seguiremo il codice, riprodurremo l'addestramento e poi esamineremo ciò che i punteggi dimostrano davvero.
L'obiettivo non è promettere un modello migliore in assoluto. È saper rispondere a due domande distinte: l'addestramento ha davvero modificato qualcosa e tale modifica migliora ciò di cui ha bisogno la nostra applicazione?
Scarica il progetto completo del tutorial. I pesi di base non sono inclusi: l'acquisizione li scarica e ne verifica poi dimensione e impronta SHA-256. I comandi di questo articolo corrispondono al percorso r3; gli esempi esplicativi non modificano questo protocollo.
Il vocabolario da padroneggiare prima di eseguire il codice
Una base già addestrata, non un modello da creare da zero
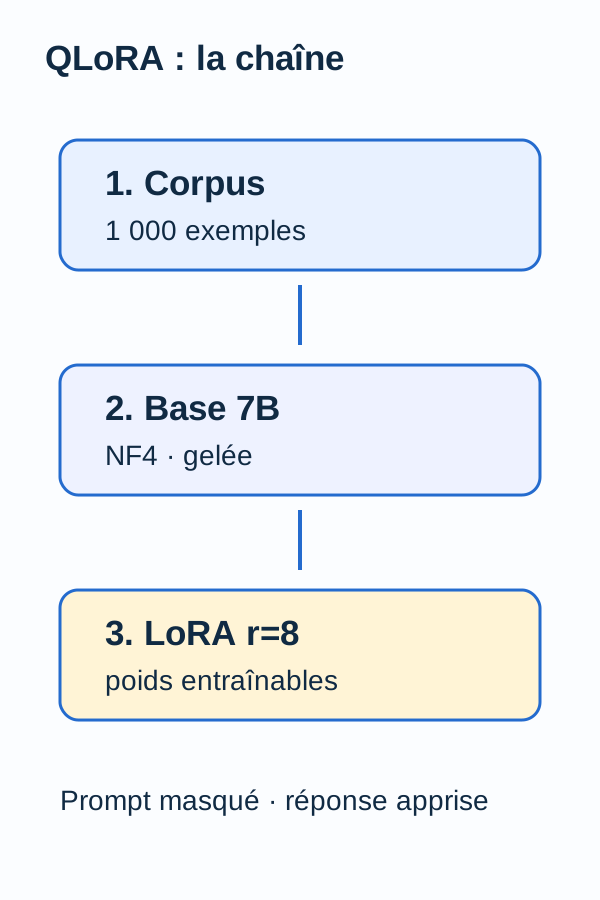
Un modello linguistico usa parametri, chiamati anche pesi: valori numerici che influenzano i testi prodotti. La sigla 7B indica una dimensione di circa sette miliardi di parametri. Non significa né sette miliardi di documenti consultabili né sette gigabyte di memoria.
La base è qui il modello prima del nostro adattamento. Sa già generare testo; cerchiamo di fargli produrre le risposte attese per il nostro compito. Adattare un modello esistente a partire da esempi è un fine-tuning, o regolazione fine. Non eseguiamo il suo preaddestramento iniziale.
Cambiare soltanto l'istruzione inviata al modello, il prompt, non modifica i suoi pesi. Un fine-tuning completo aggiornerebbe tutti i pesi coinvolti nell'addestramento. In questo tutorial scegliamo un'altra strada: conservare la base e apprendere piccoli parametri aggiuntivi. È il principio dei metodi di adattamento efficiente in termini di parametri, documentati da PEFT.
Questa scelta permette di studiare un adattamento con un minore impiego di memoria. Non dimostra che un addestramento sia necessario per ogni classificazione: il confronto con la base non adattata resta indispensabile.
Apprendere da messaggi e risposte attese
L'apprendimento supervisionato consiste nel fornire un input e la risposta che si desidera ottenere. Qui l'input è un messaggio; il target è un JSON contenente label e explication. Le quattro classi autorizzate sono FACTURE, INCIDENT, ACCES e INFORMATION.
Il modello non manipola direttamente le nostre stringhe di caratteri. Un tokenizer suddivide il testo in unità, i token o getttoni, e li trasforma poi in identificativi numerici. Un gettone non è necessariamente una parola intera.
Durante l'addestramento, il modello assegna probabilità ai token successivi. La perdita, chiamata loss nel codice, penalizza le predizioni che assegnano una probabilità troppo bassa ai token attesi. È un segnale numerico per apprendere, non ancora una valutazione della qualità aziendale.
La retropropagazione, attivata da backward(), calcola come questa perdita varia rispetto ai parametri addestrabili. Queste variazioni sono i gradienti. L'ottimizzatore AdamW li utilizza per regolare i parametri. Un passo di ottimizzazione corrisponde a un aggiornamento; non è necessariamente un aggiornamento dopo ogni messaggio.
Ricordate la catena: il modello predice, la perdita misura lo scarto, i gradienti indicano come agire e l'ottimizzatore applica la modifica.
QLoRA: memorizzare la base in modo più leggero e apprendere un adattatore
LoRA, da Low-Rank Adaptation, aggiunge piccole matrici addestrabili agli strati mirati del modello, invece di modificare i relativi pesi originali. Una matrice è qui una tabella di numeri; uno strato lineare usa tali tabelle per trasformare le rappresentazioni numeriche del testo. Il metodo è descritto nell'articolo di ricerca LoRA.
Si può immaginare l'adattatore come una correzione appresa che si aggiunge al funzionamento della base. Non è né un nuovo prompt né una lista di regole if/else: sono veri parametri numerici.
QLoRA associa questi adattatori a una base quantizzata. La quantizzazione usa meno bit per rappresentare i pesi interessati, riducendo così lo spazio che occupano in memoria. Nella nostra esperienza, la base è caricata in 4 bit, nel formato NF4, con doppia quantizzazione. NF4 è una rappresentazione prevista per pesi la cui distribuzione è vicina a una distribuzione normale. La doppia quantizzazione riduce anche lo spazio occupato dai coefficienti usati da questa rappresentazione; non indica due addestramenti successivi. Questi meccanismi sono presentati nell'articolo QLoRA.
Attenzione a una distinzione essenziale: memorizzare pesi in 4 bit non significa effettuare tutti i calcoli in 4 bit. Qui il calcolo degli strati quantizzati è configurato in bfloat16, un formato numerico a 16 bit. La documentazione Transformers su bitsandbytes distingue chiaramente la memorizzazione quantizzata dal tipo di calcolo.
I pesi della base rimangono congelati: continuano a partecipare ai calcoli, ma non sono aggiornati dall'ottimizzatore. Vengono addestrati soltanto gli adattatori LoRA. Le loro impostazioni in questo progetto sono le seguenti:
| Impostazione | Valore del tutorial | Che cosa regola |
|---|---|---|
Rango, r |
8 |
La dimensione interna delle piccole matrici di correzione. Non è il numero di classi. |
lora_alpha |
16 |
La scala del contributo dell'adattatore. |
lora_dropout |
0.0 |
Nessun dropout nel ramo LoRA: nessuna disattivazione casuale per questo motivo. |
target_modules |
all-linear |
I moduli lineari idonei selezionati da PEFT. Ciò non rende addestrabili tutti i pesi della base. |
Nella formulazione LoRA standard, la scala usa alpha / r, cioè qui 16 / 8 = 2. Questo non significa «due volte più preciso». I dettagli e le regole di selezione di all-linear sono precisati nel riferimento di LoraConfig. Per riprodurre l'esperienza, mantenete i valori dello ZIP anziché quelli di un altro esempio documentale.
Il modello legge l'istruzione, ma valutiamo la sua risposta
Immaginate un esercizio con una consegna e una risposta da redigere. Lo studente deve leggere la consegna; la valutazione riguarda la sua risposta, non la capacità di ricopiare l'istruzione.
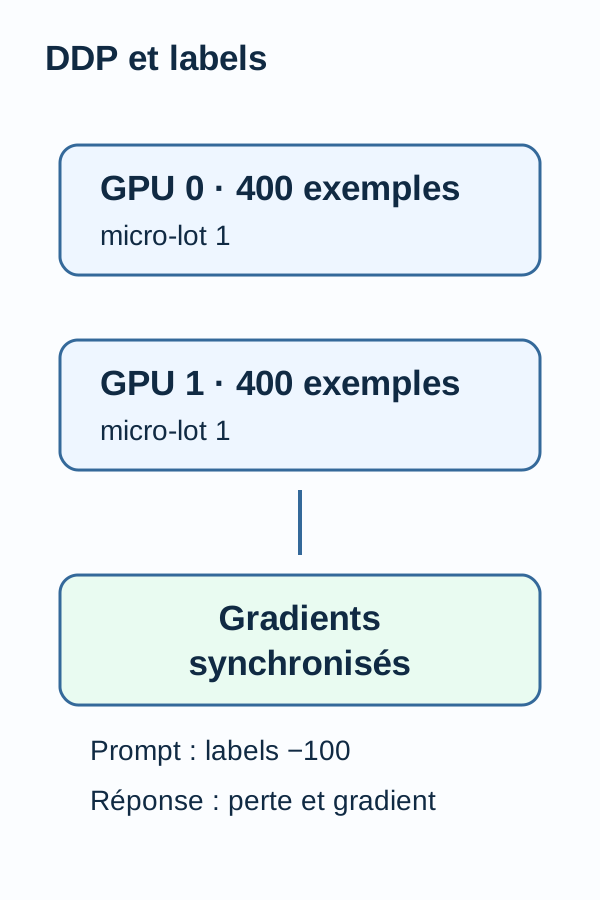
Lo stesso principio vale qui. La funzione encode() conserva il prompt nell'input, ma contrassegna le sue posizioni con -100 nei target di addestramento, labels. Queste posizioni sono ignorate nella perdita. Ignorate per la valutazione non significa nascoste al modello. Vedremo questo meccanismo nel codice.
Due GPU: distribuire gli esempi, non fondere le memorie
DDP, da DistributedDataParallel, fa lavorare più repliche del modello sincronizzandone i gradienti. In questo progetto, due processi usano ciascuno una RTX 3090. Ogni scheda porta la propria replica: non creiamo una scheda fittizia da 48 GiB.
Ogni GPU elabora 400 degli 800 esempi di addestramento. Il micro-batch vale 1: un esempio alla volta su ciascuna scheda. L'accumulo dei gradienti vale 4: ogni processo accumula il lavoro di quattro esempi prima dell'aggiornamento comune.
Il numero di esempi che contribuiscono a un passo è quindi 1 × 2 × 4 = 8. Per 800 esempi, questo dà 800 / 8 = 100 passi di ottimizzazione. Non si tratta di 100 passaggi completi sul corpus.
Dopo ogni aggiornamento, il protocollo verifica che la differenza massima tra le repliche controllate sia nulla. La documentazione DDP di PyTorch descrive questa sincronizzazione e ricorda che la distribuzione dei dati resta responsabilità del programma.
I dati e la pipeline
Il corpus contiene 1.000 esempi sintetici, distribuiti fra le quattro classi. «Sintetico» significa che studiamo un insieme costruito per l'esperimento, non un campione di richieste reali convalidate da un servizio clienti.
I dati sono suddivisi in tre insiemi, spesso chiamati split:
| Insieme | Numero di esempi | Ruolo nell'esperimento |
|---|---|---|
Addestramento, train |
800 | Fornire gli esempi utilizzati per gli aggiornamenti. |
| Sviluppo | 100 | Osservare la perdita su esempi separati dall'addestramento. |
| Test | 100 | Confrontare gli output della base e dell'adattatore ricaricato. |
La separazione non riguarda soltanto le righe: le famiglie di messaggi non si sovrappongono tra gli insiemi. Per capire la posta in gioco, immaginate due richieste identiche in cui cambia soltanto un numero di fattura. Metterne una nell'addestramento e l'altra nel test potrebbe dare un'impressione esagerata di novità. Questo esempio illustra il rischio; non descrive una famiglia precisa del corpus.
Si parla di fuga di dati quando informazioni che dovrebbero restare riservate alla valutazione facilitano artificialmente l'apprendimento o la scelta del modello. Qui validate_data() verifica gli identificativi, le dimensioni 800/100/100, le etichette, il testo e l'assenza di sovrapposizione delle famiglie prima di caricare il modello. È l'equivalente di una convalida dei dati prima di un trattamento costoso.
La pipeline, cioè la successione dei trattamenti, segue quest'ordine: si convalidano i dati, si valuta la sola base, si prepara la base NF4 per l'addestramento e poi le si aggiunge LoRA. Si addestrano quindi gli adattatori, si verificano gradienti e pesi modificati, si salva l'adattatore e lo si ricarica su una nuova base prima di rivalutare.
Perché insistere sul ricaricamento? Un risultato ottenuto con un oggetto ancora presente in memoria non basta a mostrare che il file salvato funziona. Il modello valutato dopo l'adattamento deve usare l'adattatore riletto dal disco.
train.py rifiuta in particolare un dato non valido, una fuga di famiglia, un contesto superiore a 1.024 token o un adattatore assente. Questi test negativi verificano che gli input errati siano realmente respinti. Come per un'API, il successo del caso nominale non basta.
Le funzioni centrali da leggere prima dell'esecuzione
I quattro estratti seguenti mostrano i meccanismi essenziali. Non formano uno script autonomo: gli import, l'inizializzazione distribuita, il tokenizer, i dati e le altre funzioni si trovano nel progetto completo. Usate i comandi dell'archivio per eseguire il percorso.
In questi estratti, RANK identifica il processo e la sua scheda in questa configurazione a due GPU; WORLD vale 2, il numero di processi partecipanti. tok è il tokenizer e DATA contiene il corpus caricato.
Caricare la base locale in 4 bit
load_base() legge i pesi da /models/qlora, un percorso interno al contenitore. La configurazione richiede NF4, la doppia quantizzazione e calcoli in bfloat16.
quant = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type='nf4',
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.bfloat16,
)


def load_base():
    m = AutoModelForCausalLM.from_pretrained(
        '/models/qlora',
        local_files_only=True,
        quantization_config=quant,
        device_map={'': RANK},
        torch_dtype=torch.bfloat16,
        attn_implementation='sdpa',
    )
    assert m.is_loaded_in_4bit
    m.config.use_cache = False
    return m
local_files_only=True impedisce a questo caricamento di cercare online file mancanti. L'acquisizione è una fase distinta. device_map={'': RANK} colloca questa replica sulla scheda associata al processo: non è una condivisione automatica del modello tra le due schede.
L'asserzione m.is_loaded_in_4bit verifica che sia effettivamente avvenuto un caricamento in 4 bit; NF4 è richiesto dalla configurazione immediatamente sopra. Da sola, non costituisce un audit di ogni parametro interno. use_cache=False disattiva la cache di generazione in questo percorso di addestramento; attn_implementation='sdpa' conserva il meccanismo di attenzione scelto nell'ambiente testato.
Ciò che abbiamo appena fatto: caricare la base, non ancora addestrarla. La preparazione per l'addestramento quantizzato e l'aggiunta degli adattatori appartengono alle fasi successive del programma completo.
Trasformare un esempio in input e target
La funzione encode() prepara ciò che il modello leggerà e le posizioni su cui calcolare la perdita.
def encode(row):
    answer = json.dumps(
        {'label': row['label'], 'explication': row['explanation']},
        ensure_ascii=False,
    )
    a = tok(prompt(row), add_special_tokens=False)['input_ids']
    b = tok(answer + tok.eos_token, add_special_tokens=False)['input_ids']
    ids = a + b

    if not 0 < len(ids) <= 1024:
        raise ValueError('context >1024')

    return {
        'input_ids': torch.tensor([ids], device=RANK),
        'attention_mask': torch.ones(
            (1, len(ids)),
            device=RANK,
            dtype=torch.long,
        ),
        'labels': torch.tensor([[-100] * len(a) + b], device=RANK),
    }
Cominciamo dai nomi. Nel dato sorgente, la spiegazione si chiama explanation. Il JSON che vogliamo apprendere usa la chiave francese explication. La prima riga della funzione esegue questa corrispondenza senza cambiare la classe attesa.
a contiene gli identificativi dell'istruzione e del messaggio. b contiene quelli del JSON atteso, seguiti da eos_token, il marcatore di fine sequenza. ids = a + b forma la sequenza completa.
Per visualizzare il mascheramento, prendiamo identificativi fittizi, senza rapporto con il tokenizer reale:
Prompt :       [11,   12,   13]
Réponse :      [21,   22]
input_ids :    [11,   12,   13, 21, 22]
labels :       [-100, -100, -100, 21, 22]
Gli identificativi del prompt restano in input_ids, ma sono sostituiti da -100 in labels. La convenzione ignore_index=-100 della perdita di entropia incrociata di PyTorch permette di ignorare questi target. Non è né una penalità di meno cento né un token da generare.
Perché la risposta compare anche nell'input durante l'addestramento? In un modello linguistico causale, ogni posizione impara a predire il token successivo a partire dai precedenti, senza accesso a quelli futuri. Lo scarto tra predizioni e target è gestito dal modello. Durante l'uso, la risposta attesa non viene più fornita: il modello la genera. Il corso Hugging Face sui modelli causali spiega in dettaglio questo meccanismo.
Qui attention_mask è riempito di 1 per le posizioni presenti. Non va confuso con il mascheramento della perdita in labels, né se ne deve dedurre che il modello possa leggere i token futuri.
Infine, il limite di 1.024 token riguarda l'insieme prompt + risposta + marcatore di fine. Il programma rifiuta la sequenza fuori limite invece di troncare silenziosamente la risposta. Questo limite appartiene al protocollo testato; non descrive necessariamente la capacità massima del modello in altri utilizzi.
Aggiungere LoRA ed eseguire gli aggiornamenti
get_peft_model() aggiunge gli adattatori. La lista trainable mantiene soltanto i parametri per cui requires_grad è vero, poi un'asserzione richiede che i loro nomi contengano lora_. In altre parole, il programma controlla ciò a cui consente di apprendere prima di avviare l'ottimizzazione.
Un tensore è una tabella numerica che può avere più dimensioni. before copia i tensori addestrabili prima del primo aggiornamento; initial_hash calcola un'impronta dei loro byte. Questi elementi consentono di confrontare lo stato iniziale con quello addestrato.
model = get_peft_model(
    base,
    LoraConfig(
        r=8,
        lora_alpha=16,
        lora_dropout=0.0,
        target_modules='all-linear',
        bias='none',
        task_type='CAUSAL_LM',
    ),
)
model.config.use_cache = False
trainable = [p for p in model.parameters() if p.requires_grad]
assert trainable and all(
    ('lora_' in n for n, p in model.named_parameters() if p.requires_grad)
)
before = [p.detach().cpu().clone() for p in trainable]
initial_hash = hashlib.sha256(
    b''.join((p.numpy().tobytes() for p in before))
).hexdigest()

# Répliques DDP :400 exemples par GPU, accumulation4, batch global8.
wrapped = DDP(
    model,
    device_ids=[RANK],
    output_device=RANK,
    find_unused_parameters=False,
    broadcast_buffers=False,
)
optimizer = torch.optim.AdamW(trainable, lr=0.0002, weight_decay=0.01)
train = [q for q in DATA['queries'] if q['split'] == 'train']
random.Random(42).shuffle(train)
own = train[RANK::WORLD]
assert len(own) == 400
partitions = [None] * WORLD
dist.all_gather_object(partitions, [q['id'] for q in own])
emit('training-partition', rank_ids=partitions)
accum = 4
losses = []
start = time.monotonic()
optimizer.zero_grad(set_to_none=True)
wrapped.train()
maxnorm = 0

for i, row in enumerate(own):
    sync = (i + 1) % accum == 0
    with contextlib.nullcontext() if sync else wrapped.no_sync():
        loss = wrapped(**encode(row)).loss
        assert torch.isfinite(loss)
        (loss / accum).backward()

    losses.append(float(loss.detach()))
    if sync:
        norm = torch.nn.utils.clip_grad_norm_(trainable, 1.0)
        assert torch.isfinite(norm)
        maxnorm = max(maxnorm, float(norm))
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)
        both = torch.tensor(sum(losses[-4:]) / 4, device=RANK)
        dist.all_reduce(both)
        emit(
            'train-step',
            step=(i + 1) // 4,
            loss=float(both) / WORLD,
            rank0_example_ids=[r['id'] for r in own[i - 3:i + 1]],
            gradient_norm=float(norm),
        )
L'estratto è più lungo, ma segue tre operazioni familiari: distribuire il lavoro, eseguirlo e poi registrare ciò che è accaduto.
Distribuire gli esempi. random.Random(42).shuffle(train) mescola i dati con un seme fisso. train[RANK::WORLD] ne prende poi una riga su due: un processo tratta le posizioni pari, l'altro le dispari, in questa lista mescolata. Ciascuno deve ottenere esattamente 400 esempi. all_gather_object() raccoglie i loro identificativi per l'evento training-partition.
Accumulare e poi aggiornare. Per ogni esempio, wrapped(**encode(row)).loss calcola la perdita. L'asserzione isfinite rifiuta un valore infinito o indefinito. (loss / accum).backward() accumula il contributo ai gradienti dividendolo per 4. I primi tre esempi usano no_sync(); il quarto attiva la sincronizzazione prima dell'aggiornamento. È il meccanismo di accumulo descritto nella documentazione di DDP.no_sync().
clip_grad_norm_(trainable, 1.0) limita la norma globale dei gradienti, una misura della loro ampiezza, per evitare un aggiornamento alimentato da gradienti troppo grandi. Il valore restituito e registrato corrisponde alla norma prima di questa limitazione: un valore superiore a 1 nel registro non significa quindi automaticamente che il controllo sia fallito. Vedere il riferimento PyTorch di clip_grad_norm_.
optimizer.step() applica quindi l'aggiornamento. L'ottimizzatore AdamW usa qui lr=0.0002, il tasso di apprendimento che regola la scala degli aggiustamenti, e weight_decay=0.01, un termine di regolarizzazione dei pesi. zero_grad(set_to_none=True) reimposta i gradienti per il gruppo successivo. Il progetto utilizza proprio torch.optim.AdamW come mostrato, non un altro ottimizzatore sostituito a quello del percorso convalidato.
Registrare. Le ultime righe calcolano una media della perdita e la registrano con il numero del passo e la norma dei gradienti. La chiamata esplicita a dist.all_reduce(both) aggrega qui la perdita per il registro: la sincronizzazione dei gradienti è assicurata da DDP durante la retropropagazione.
I controlli che seguono questo ciclo nel programma completo richiedono pesi modificati, gradienti non nulli e repliche identiche. Non sono tutti riprodotti in questo estratto. Dopo il salvataggio, adapter_hash() rilegge i parametri LoRA: un'impronta identica prima e dopo il ricaricamento controlla che l'adattatore valutato sia effettivamente quello salvato. Come una somma di controllo di un artefatto, SHA-256 verifica l'identità dei byte confrontati, non la qualità delle risposte.
Contare le risposte corrette senza nascondere gli errori di formato
La funzione classification() di metrics.py legge gli output generati e li confronta con le classi attese. Ecco la parte dedicata alla decodifica e al conteggio; il calcolo finale e la restituzione delle metriche si trovano nella funzione completa dello ZIP.
def classification(rows, expected):
    matrix = [[0] * 5 for _ in range(4)]
    correct = 0

    for row in rows:
        truth = LABELS.index(expected[row['sample_id']]['label'])
        try:
            obj = json.loads(row['raw'])
            label = obj['label']
            pred = (
                LABELS.index(label)
                if isinstance(obj.get('explication'), str)
                and obj['explication'].strip()
                else 4
            )
        except (ValueError, KeyError, TypeError):
            pred = 4

        matrix[truth][pred] += 1
        correct += pred == truth
matrix ha quattro righe, una per classe reale, e cinque colonne: le quattro classi possibili più una colonna di errore. Una risposta non valida resta quindi nel bilancio; non viene rimossa per rendere il punteggio più lusinghiero.
Il codice inizia decodificando row['raw'] con json.loads(). Cerca poi il valore di label in LABELS. Per accettare questa predizione, explication deve essere una stringa non vuota dopo la rimozione degli spazi iniziali e finali. Gli errori gestiti dall'except sono conteggiati nella quinta colonna.
Notate il dettaglio: strip() viene applicato alla spiegazione, ma non all'etichetta in questa valutazione rigorosa. Un'etichetta contenente uno spazio finale non corrisponde quindi al valore autorizzato senza quello spazio.
Questo non significa che il programma confronti tutti i byte del JSON. Gli spazi di indentazione sono accettati dal parser; uno spazio nel valore dell'etichetta modifica invece la stringa confrontata. Torneremo su questa distinzione nell'esercizio.
Un altro limite da tenere presente: questo controllo verifica che la spiegazione esista e non sia vuota. Non ne giudica né la pertinenza, né la veridicità, né la brevità. La presenza di un testo non è una convalida del suo contenuto.
Riproduzione nell'ordine corretto
Per seguire la parte pratica, bisogna saper leggere Python, usare un terminale e riconoscere un oggetto JSON. Gli script vengono eseguiti dalla radice di una nuova estrazione dell'archivio; non ricostruite il progetto assemblando soltanto gli estratti dell'articolo.
Il profilo convalidato usa Linux x86_64, Docker/Compose, un driver NVIDIA e NVIDIA Container Toolkit, con due RTX 3090. Le risorse dichiarate sono 48 GiB di RAM, 40 GiB di disco e 20 GiB di VRAM libera su ciascuna scheda. La RAM appartiene alla macchina; la VRAM è la memoria di ogni GPU. Questi valori sono risorse previste, non minimi misurati.
Non è stato convalidato alcun percorso CPU. Il programma richiede due GPU per questa riproduzione; ridurne il numero non è una semplice variante dello stesso avvio.
1. Verificare l'host e poi preparare l'immagine
Il preflight è un controllo dei prerequisiti. Deve confermare Docker, Compose, la presenza delle due schede e l'accesso CUDA da un contenitore. CUDA è l'ambiente di calcolo NVIDIA usato da questo stack; vedere le schede su Linux non basta a dimostrare che Docker possa usarle. La guida NVIDIA Container Toolkit descrive la configurazione di questo accesso.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
setup.sh prepara i permessi locali usati da Compose. docker compose build costruisce poi l'immagine del progetto.
Da osservare: le verifiche passano e la build termina senza errore. Se la GPU è visibile solo dall'host, correggete l'accesso da Docker prima dell'acquisizione e dell'addestramento.
2. Acquisire la base e verificare le protezioni
Il servizio fetch scarica una revisione fissata del modello, ne verifica dimensione e SHA-256 e poi colloca il file finale. Una revisione fissata svolge qui il ruolo di una versione precisa di dipendenza: permette di sapere esattamente con quali file è stata condotta l'esperienza.
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
Il secondo comando esegue la suite di test. Copre in particolare i casi negativi legati ai dati e al contesto.
Da osservare: 15 test pubblici superati. Un errore di hash non è un avvertimento da aggirare. Un altro modello recuperato da una cache non identificata non riprodurrebbe più l'esperienza descritta.
3. Preparare e poi addestrare l'adattatore
prepare convalida il corpus e produce i dati preparati. train esegue la valutazione della base, i 100 passi DDP e il ricaricamento dell'adattatore. È la fase che utilizza le due GPU.
docker compose run --rm --no-deps app -m src.cli prepare
docker compose run --rm --no-deps app -m src.cli train
Da osservare: gli eventi JSON training-complete, adapter-roundtrip e complete, con 800 esempi, 100 passi e replica_max_difference uguale a 0.
Il round-trip è l'andata e ritorno di salvataggio e successivo ricaricamento. Se questo evento manca, non concludete che l'adattatore riletto sia stato valutato correttamente. Una diminuzione della perdita nel registro non sostituisce questa verifica.
4. Produrre le metriche
Ora possiamo costruire il riepilogo della classificazione e le matrici di confusione.
docker compose run --rm --no-deps app -m src.cli evaluate
Da osservare: un JSON di classificazione per la base e un altro per l'adattatore ricaricato. Prima di eseguire exercise, dedicate il tempo necessario a comprendere i punteggi seguenti: l'esercizio vi chiederà di prevedere l'effetto di una modifica nella lettura dei risultati.
Come leggere le metriche prima dei risultati
Accuracy e macro-F1: due letture complementari
L'accuracy è la proporzione di esempi classificati correttamente secondo le regole del programma. Un punteggio di 0,90 su 100 casi significa che 90 risposte rispettano tali regole. Qui basta un errore di formato o una spiegazione vuota per far fallire un caso.
L'F1 combina due nozioni. Per una data classe, la precisione chiede: «Fra le risposte che dichiarano questa classe, quante sono corrette?» Il richiamo chiede: «Fra i messaggi che appartengono realmente a questa classe, quanti sono stati ritrovati?» L'F1 ne è la media armonica, calcolata con 2 × precisione × richiamo / (precisione + richiamo) quando il denominatore non è nullo.
Il macro-F1 calcola un F1 per ciascuna delle quattro classi, poi ne fa la media. Ogni classe ha quindi lo stesso peso in questa media, qualunque sia la sua numerosità. La documentazione delle metriche di scikit-learn approfondisce queste definizioni; il punteggio di questo tutorial resta calcolato dal proprio modulo metrics.py.
La matrice di confusione permette poi di comprendere gli errori. Incrocia la classe attesa con quella predetta, mantenendo qui una colonna aggiuntiva per gli output rifiutati. Una confusione tra FACTURE e INCIDENT non racconta la stessa cosa di una risposta INCIDENT rifiutata a causa di uno spazio finale.
Una perdita bassa non sostituisce questi controlli
La perdita di sviluppo misura quanto le probabilità del modello corrispondano ai token attesi nell'insieme di sviluppo. Non è né una percentuale di errori aziendali né una misura indipendente della qualità delle spiegazioni.
Inoltre, un buon punteggio non basta a dimostrare che la catena di addestramento abbia funzionato come previsto. Il progetto controlla separatamente 392 tensori LoRA modificati, 20.185.088 parametri addestrabili, 100 passi di ottimizzazione, gradienti non nulli e l'uguaglianza degli adattatori sulle due repliche.
I primi due numeri non contano la stessa cosa: i tensori sono le tabelle, i parametri sono i valori numerici che contengono. I controlli stabiliscono che gli adattatori sono stati modificati e sincronizzati; i punteggi indicano poi come si comportano i loro output sul corpus.
Risultati osservati e ciò che consentono di concludere
I valori seguenti sono quelli riportati per il percorso r3. La valutazione riguarda i 100 casi di test, non gli 800 esempi usati per gli aggiornamenti.
| Misura sul test | Base non adattata | Base con adattatore ricaricato |
|---|---|---|
| Accuracy rigorosa | 0,90 | 1,00 |
| Macro-F1 | 0,9167 | 1,00 |
Casi INCIDENT nella colonna di errore di formato |
10 | 0 |
A prima vista, il passaggio da 0,90 a 1,00 sembra raccontare una storia semplice: «Abbiamo insegnato al modello a classificare meglio». Ma la matrice richiede una lettura più precisa. I 10 fallimenti della base sono nella colonna di errore di formato, non in un'altra classe aziendale.
La conclusione direttamente supportata è dunque che l'adattatore ricaricato soddisfa meglio il contratto rigoroso di questa esperienza. Non possiamo trasformare questo risultato in una prova di migliore comprensione degli incidenti, tanto più che l'esercizio mostra l'effetto della pulizia delle etichette della base.
L'addestramento è durato 139,5 s nella prima riproduzione e 141,6 s nella seconda. Queste durate riguardano l'addestramento riportato, non una promessa sul tempo totale che includa installazione e download. La perdita di sviluppo osservata è 1,4785609673708677e-05, ovvero circa 0,0000148: questa scrittura decimale è una conversione arrotondata dello stesso valore, non una nuova misurazione.
I massimi di VRAM rilevati sono circa 14.145 MiB e 13.722 MiB a seconda della GPU. La memoria è stata campionata circa una volta al secondo: un picco tra due rilevamenti può sfuggire alla misurazione. Questi valori non sostituiscono quindi la risorsa prevista di 20 GiB liberi per scheda annunciata per la riproduzione.
Questi risultati descrivono questo corpus, queste impostazioni e questa macchina. Non dimostrano né una generalizzazione a messaggi reali, né una superiorità rispetto a un altro modello, né una qualità di produzione. Anche le cache Docker pubbliche e l'attività generale della postazione fanno parte del contesto delle risorse osservate.
Ciò che abbiamo imparato
Abbiamo seguito una catena completa: dati separati per famiglia, base quantizzata e congelata, adattatori LoRA addestrabili, gradienti sincronizzati, salvataggio, poi ricaricamento su una nuova base. L'addestramento non si riduce a una curva di perdita: occorre sapere anche quali parametri sono cambiati e quale artefatto è stato valutato.
Abbiamo inoltre distinto apprendere e misurare. Modificare i pesi cambia il comportamento del modello. Modificare il modo in cui se ne leggono gli output può cambiare un punteggio senza toccare il modello.
Il punteggio di 1,00 dell'adattatore resta un risultato su 100 casi di test sintetici. Il passaggio della base da 0,90 a 1,00 dopo la rimozione degli spazi corrisponde a un'altra operazione: le sue risposte sono le stesse, ma il loro confronto diventa più tollerante. Confondere le due cose porterebbe ad annunciare un guadagno semantico che l'esperienza non stabilisce.
Esercizio attivo: prevedere, modificare, eseguire, osservare, spiegare
Ora siete dalla parte dello sviluppatore che riceve il JSON. Prima di eseguire il comando, considerate questi due oggetti, costruiti per la spiegazione e non copiati da una schermata:
{
  "label": "INCIDENT",
  "explication": "Un problème technique est signalé."
}
{
  "label": "INCIDENT ",
  "explication": "Un problème technique est signalé."
}
Entrambi gli oggetti sono JSON validi. Tuttavia, nel secondo il valore dell'etichetta contiene uno spazio finale. Prevedete ciò che farà LABELS.index(label), poi ciò che cambierebbe confrontando label.strip().
Il metodo Python strip() rimuove i caratteri di spaziatura all'inizio e alla fine della stringa; non riaddestra il modello e non sostituisce una classe aziendale errata con quella corretta.
Eseguite ora l'esercizio fornito. La modifica studiata riguarda la lettura delle etichette, non i pesi del modello:
docker compose run --rm --no-deps app -m src.cli exercise
Risultati da osservare: baseline rigorosa 0,90; baseline con etichetta pulita 1,00. La parola baseline indica qui il riferimento di confronto, cioè la base non adattata.
Un'ipotesi allettante sarebbe: «Il punteggio sale, quindi il modello capisce meglio i messaggi». Il risultato non la conferma. Nessun peso è cambiato; l'esercizio mette in evidenza una sensibilità alla formattazione.
Formulate piuttosto la conclusione così: «Le etichette della base soddisfano il confronto dopo la normalizzazione. Questo punteggio tollerante deve essere presentato separatamente dal punteggio rigoroso». La normalizzazione può essere utile per un'applicazione, ma non deve cancellare silenziosamente il contratto valutato.
Per verificare di aver compreso, spiegate perché la stessa operazione non correggerebbe un'etichetta FACTURE assegnata a un messaggio che è realmente INCIDENT. Avrete così distinto una correzione di formato da una correzione di classificazione.
Risoluzione dei problemi e pulizia
È visibile una sola scheda. Verificate GPU_DEVICE e GPU_DEVICE_2, poi ricominciate dal preflight. Se WORLD_SIZE o il numero di GPU non vale 2, l'addestramento si interrompe volutamente. La distribuzione degli 800 esempi e il batch globale descritto sopra si basano su questo contratto.
Una sequenza supera 1.024 token. Verificate la lunghezza totale dell'istruzione, del messaggio, della risposta e del marcatore di fine. In un'esperienza separata con i vostri esempi, accorciate l'esempio invece di troncarne silenziosamente la risposta. Se il corpus di riferimento genera questo errore, controllate prima i file e la configurazione della riproduzione prima di modificarli.
L'adattatore non si ricarica. Controllate la directory outputs/artifacts/adapter e ripartite da una nuova estrazione, non da un assemblaggio di file parziali. Senza un ricaricamento convalidato, la valutazione adattata non può essere interpretata come quella dell'artefatto salvato.
Al termine del percorso, dalla radice del progetto, arrestate le risorse Compose:
docker compose down
Questo comando non elimina né i modelli né gli output. Conservate i risultati necessari al confronto. Per rimuovere i file di lavoro, eliminate soltanto la directory di estrazione che avete creato dopo averne verificato il contenuto, non risorse condivise con altri progetti.
Per andare oltre
Il seguito interessante non è cercare subito un punteggio più spettacolare. È costruire un test in cui un errore non si risolva più con una semplice rimozione di spazio.
In un'esperienza distinta, mantenete i principi di questo protocollo e sostituite il corpus sintetico con un insieme annotato rappresentativo dei vostri messaggi. Conservate una separazione per cliente, famiglia o periodo per evitare di ritrovare nel test varianti troppo vicine agli esempi di addestramento. Confrontate sempre la base non adattata e l'adattatore sugli stessi prompt e sugli stessi casi.
Prevedete anche un'astensione: una risposta che indica che il sistema non può classificare il messaggio in modo accettabile e deve trasmetterlo a una persona. Questa possibilità non appartiene alle quattro classi del contratto attuale; aggiungerla richiede di modificare i dati, il formato atteso, le convalide e le metriche, poi di misurare di nuovo.
Fate rileggere gli errori della matrice e le spiegazioni da persone che conoscono il settore. Distinguete gli errori di formato, le categorie errate e le giustificazioni scorrette. Questi sviluppi non sono risultati già ottenuti da r3: definiscono il lavoro necessario per misurare un'utilità oltre il nostro esempio controllato.
Limiti prima di un uso reale
L'insieme è sintetico e ridotto, il test comprende 100 casi e non viene rivendicata alcuna revisione umana indipendente. Una perdita molto bassa e un punteggio perfetto su questo test non convalidano i messaggi ambigui, le formulazioni inattese o la qualità delle spiegazioni nella vostra applicazione.
DDP sincronizza l'apprendimento su due GPU; da solo non fornisce una strategia di distribuzione. Prima di ogni decisione aziendale, servono dati rappresentativi, criteri di rifiuto, una revisione degli errori per classe e una valutazione indipendente, con una separazione temporale o per cliente adatta all'esigenza.
Conservate anche la versione del corpus, del modello di base, del tokenizer, delle dipendenze, delle regole di calcolo e dell'adattatore. Confrontare due punteggi ha senso soltanto se si sa che cosa è cambiato tra le due esperienze.
La documentazione ufficiale PEFT sulla quantizzazione approfondisce l'associazione di una base quantizzata e di adattatori addestrabili. I riferimenti di questo articolo spiegano i meccanismi; non sostituiscono le versioni e i parametri fissati dello ZIP per riprodurre questo tutorial.