





Imagine la bandeja de entrada de un servicio de atención al cliente. Su aplicación debe dirigir cada mensaje a la categoría correcta: una factura que localizar, una incidencia que resolver, un problema de acceso o una solicitud de información. Ya sabe recibir el mensaje, validar un JSON y guardar el resultado. Aquí exploraremos la parte que transforma un texto libre en una categoría utilizable.
Tomemos este ejemplo didáctico, inventado para ilustrar la necesidad: «Desde esta mañana, la página de pago devuelve un error 500». Nos gustaría obtener una respuesta de este tipo:
{
  "label": "INCIDENT",
  "explication": "Le message signale une erreur technique sur la page de paiement."
}
Este mensaje y este JSON no son ni una fila del corpus ni una salida medida. Simplemente muestran el contrato esperado: una clase entre cuatro, acompañada de una breve explicación.
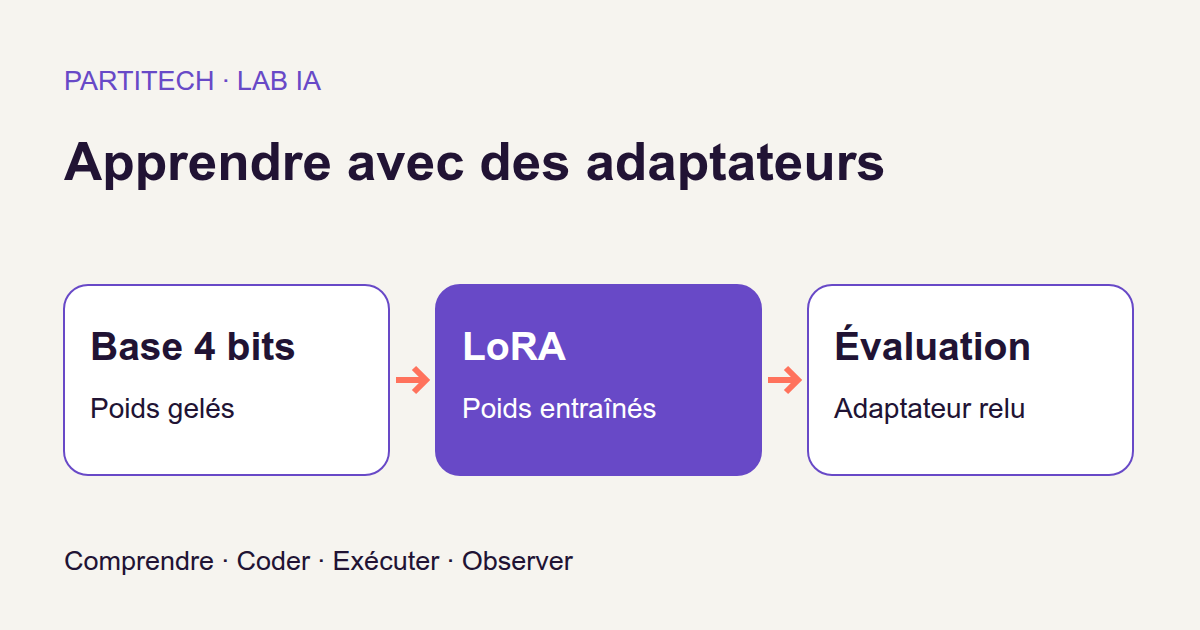
Ya disponemos de un modelo de lenguaje local. En lugar de volver a enseñarle a escribir, adaptaremos una pequeña parte de sus parámetros a esta tarea. El método se llama QLoRA. Comprenderemos cómo funciona, seguiremos el código, reproduciremos el entrenamiento y examinaremos después qué demuestran realmente las puntuaciones.
El objetivo no es prometer un modelo mejor en términos absolutos. Se trata de responder a dos preguntas distintas: ¿el entrenamiento ha modificado realmente algo y esa modificación mejora lo que necesita nuestra aplicación?
Descargar el proyecto completo del tutorial. Los pesos base no están incluidos: la adquisición los descarga y comprueba después su tamaño y su huella SHA-256. Los comandos de este artículo corresponden al recorrido r3; los ejemplos explicativos no modifican ese protocolo.
Vocabulario que debe conocer antes de ejecutar el código
Una base ya entrenada, no un modelo creado desde cero
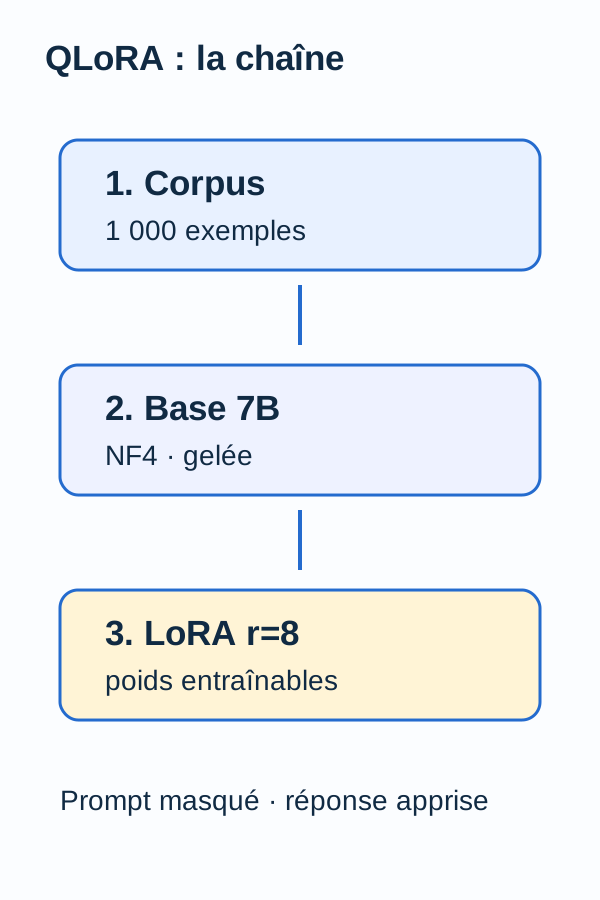
Un modelo de lenguaje utiliza parámetros, también llamados pesos: valores numéricos que influyen en los textos que produce. La denominación 7B indica un tamaño de unos siete mil millones de parámetros. No significa ni siete mil millones de documentos consultables ni siete gigabytes de memoria.
La base es aquí el modelo anterior a nuestra adaptación. Ya sabe generar texto; buscamos que produzca las respuestas esperadas para nuestra tarea. Adaptar un modelo existente a partir de ejemplos es un fine-tuning, o ajuste fino. No realizamos su preentrenamiento inicial.
Cambiar solamente la instrucción enviada al modelo, el prompt, no modifica sus pesos. Un fine-tuning completo actualizaría todos los pesos implicados en el entrenamiento. En este tutorial elegimos otra vía: conservar la base y aprender pequeños parámetros adicionales. Es el principio de los métodos de adaptación eficientes en parámetros documentados por PEFT.
Esta elección permite estudiar una adaptación con una huella de memoria menor. No demuestra que el entrenamiento sea necesario para toda clasificación: la comparación con la base no adaptada sigue siendo indispensable.
Aprender a partir de mensajes y respuestas esperadas
El aprendizaje supervisado consiste en proporcionar una entrada y la respuesta que se desea obtener. Aquí la entrada es un mensaje; el objetivo es un JSON que contiene label y explication. Las cuatro clases permitidas son FACTURE, INCIDENT, ACCES e INFORMATION.
El modelo no maneja directamente nuestras cadenas de caracteres. Un tokenizer divide el texto en unidades, los tokens o fichas, y los transforma después en identificadores numéricos. Un token no es necesariamente una palabra completa.
Durante el entrenamiento, el modelo asigna probabilidades a los tokens siguientes. La pérdida, llamada loss en el código, penaliza las predicciones que dan poca probabilidad a los tokens esperados. Es una señal numérica para aprender, no todavía una nota de calidad de negocio.
La retropropagación, activada por backward(), calcula cómo varía esta pérdida con los parámetros entrenables. Esas variaciones son los gradientes. El optimizador AdamW los utiliza para ajustar los parámetros. Un paso de optimización corresponde a una actualización; no es necesariamente una actualización después de cada mensaje.
Recuerde la cadena: el modelo predice, la pérdida mide la diferencia, los gradientes indican cómo actuar y el optimizador realiza la modificación.
QLoRA: almacenar la base de forma más ligera y aprender un adaptador
LoRA, por Low-Rank Adaptation, añade pequeñas matrices entrenables a las capas objetivo del modelo, en lugar de modificar sus pesos originales. Una matriz es aquí una tabla de números; una capa lineal utiliza tales tablas para transformar representaciones numéricas del texto. El método se describe en el artículo de investigación de LoRA.
Puede imaginar el adaptador como una corrección aprendida que se añade al funcionamiento de la base. No es ni un nuevo prompt ni una lista de reglas if/else: son verdaderos parámetros numéricos.
QLoRA asocia estos adaptadores a una base cuantificada. La cuantificación utiliza menos bits para representar los pesos seleccionados y reduce así el espacio que ocupan en memoria. En nuestro experimento, la base se carga en 4 bits, en formato NF4, con doble cuantificación. NF4 es una representación prevista para pesos cuya distribución se aproxima a una distribución normal. La doble cuantificación también reduce el espacio de los coeficientes utilizados por esa representación; no designa dos entrenamientos sucesivos. Estos mecanismos se presentan en el artículo QLoRA.
Atención a una distinción esencial: almacenar pesos en 4 bits no significa realizar todos los cálculos en 4 bits. Aquí el cálculo de las capas cuantificadas se configura en bfloat16, un formato numérico de 16 bits. La documentación de Transformers sobre bitsandbytes distingue claramente el almacenamiento cuantificado del tipo de cálculo.
Los pesos de la base permanecen congelados: siguen participando en los cálculos, pero el optimizador no los actualiza. Solo se entrenan los adaptadores LoRA. Sus ajustes en este proyecto son los siguientes:
| Ajuste | Valor del tutorial | Lo que controla |
|---|---|---|
Rango, r |
8 |
La dimensión interna de las pequeñas matrices de corrección. No es el número de clases. |
lora_alpha |
16 |
La escala de la contribución del adaptador. |
lora_dropout |
0.0 |
Ningún dropout en la rama LoRA: no hay desactivación aleatoria por este motivo. |
target_modules |
all-linear |
Los módulos lineales aptos seleccionados por PEFT. Esto no hace entrenables todos los pesos de la base. |
En la formulación LoRA estándar, la escala utiliza alpha / r, es decir, 16 / 8 = 2 aquí. Eso no significa «dos veces más preciso». Los detalles y las reglas de selección de all-linear se precisan en la referencia de LoraConfig. Para reproducir el experimento, conserve los valores del ZIP en vez de los de otro ejemplo documental.
El modelo lee la instrucción, pero evaluamos su respuesta
Imagine un ejercicio con un enunciado y una respuesta que redactar. El alumno debe leer el enunciado; la nota se refiere a su respuesta, no a su capacidad de copiar las instrucciones.
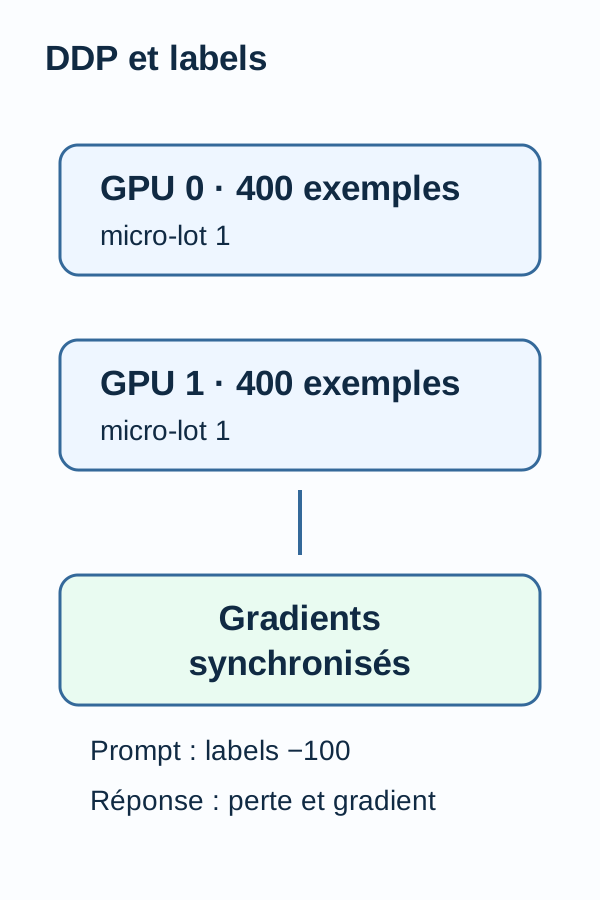
Aquí se aplica el mismo principio. La función encode() conserva el prompt en la entrada, pero marca sus posiciones con -100 en los objetivos de entrenamiento, labels. Esas posiciones se ignoran en la pérdida. Que se ignoren para la nota no significa que estén ocultas para el modelo. Veremos este mecanismo en el código.
Dos GPU: repartir los ejemplos, no fusionar las memorias
DDP, por DistributedDataParallel, hace trabajar varias réplicas del modelo sincronizando sus gradientes. En este proyecto, dos procesos utilizan cada uno una RTX 3090. Cada tarjeta tiene su propia réplica: no creamos una tarjeta ficticia de 48 GiB.
Cada GPU procesa 400 de los 800 ejemplos de entrenamiento. El microlote vale 1: un ejemplo cada vez en cada tarjeta. La acumulación de gradientes vale 4: cada proceso acumula el trabajo de cuatro ejemplos antes de la actualización común.
El número de ejemplos que contribuyen a un paso es por tanto 1 × 2 × 4 = 8. Para 800 ejemplos, obtenemos 800 / 8 = 100 pasos de optimización. No se trata de 100 pasadas completas por el corpus.
El protocolo comprueba después de cada actualización que la diferencia máxima entre las réplicas controladas sea nula. La documentación DDP de PyTorch describe esta sincronización y recuerda que el reparto de los datos sigue siendo responsabilidad del programa.
Los datos y el pipeline
El corpus contiene 1.000 ejemplos sintéticos, repartidos entre las cuatro clases. «Sintético» significa que estudiamos un conjunto construido para el experimento, no una muestra de solicitudes reales validada por un servicio de atención al cliente.
Los datos se reparten en tres conjuntos, a menudo llamados splits:
| Conjunto | Número de ejemplos | Papel en el experimento |
|---|---|---|
Entrenamiento, train |
800 | Proporcionar los ejemplos que sirven para las actualizaciones. |
| Desarrollo | 100 | Observar la pérdida en ejemplos separados del entrenamiento. |
| Prueba | 100 | Comparar las salidas de la base y del adaptador recargado. |
La separación no se refiere solo a las filas: las familias de mensajes no se solapan entre conjuntos. Para entender lo que está en juego, imagine dos solicitudes idénticas en las que solo cambia un número de factura. Poner una en el entrenamiento y la otra en la prueba podría dar una impresión exagerada de novedad. Este ejemplo ilustra el riesgo; no describe una familia concreta del corpus.
Se habla de fuga de datos cuando información que debería permanecer reservada para la evaluación facilita artificialmente el aprendizaje o la elección del modelo. Aquí, validate_data() comprueba los identificadores, los tamaños 800/100/100, las etiquetas, el texto y la ausencia de solapamiento de familias antes de cargar el modelo. Es el equivalente a validar los datos antes de un proceso costoso.
El pipeline, es decir, la sucesión de tratamientos, sigue este orden: se validan los datos, se evalúa la base sola, se prepara la base NF4 para el entrenamiento y se le añade LoRA. A continuación se entrenan los adaptadores, se comprueban los gradientes y los pesos modificados, se guarda el adaptador y se recarga sobre una nueva base antes de volver a evaluar.
¿Por qué insistir en la recarga? Un resultado obtenido con un objeto aún presente en memoria no basta para demostrar que el archivo guardado funciona. El modelo evaluado después de la adaptación debe utilizar el adaptador vuelto a leer desde el disco.
train.py rechaza, entre otras cosas, datos no válidos, una fuga de familias, un contexto superior a 1.024 tokens o un adaptador ausente. Estas pruebas negativas verifican que las entradas incorrectas se rechacen correctamente. Como en una API, el éxito del caso nominal no basta.
Funciones centrales que leer antes de la ejecución
Los cuatro extractos siguientes muestran los mecanismos esenciales. No forman un script autónomo: las importaciones, la inicialización distribuida, el tokenizer, los datos y las demás funciones están en el proyecto completo. Utilice los comandos del archivo para ejecutar el recorrido.
En estos extractos, RANK identifica el proceso y su tarjeta en esta configuración de dos GPU; WORLD vale 2, el número de procesos participantes. tok es el tokenizer y DATA contiene el corpus cargado.
Cargar la base local en 4 bits
load_base() lee los pesos en /models/qlora, una ruta dentro del contenedor. La configuración solicita NF4, doble cuantificación y cálculo en bfloat16.
quant = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type='nf4',
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.bfloat16,
)


def load_base():
    m = AutoModelForCausalLM.from_pretrained(
        '/models/qlora',
        local_files_only=True,
        quantization_config=quant,
        device_map={'': RANK},
        torch_dtype=torch.bfloat16,
        attn_implementation='sdpa',
    )
    assert m.is_loaded_in_4bit
    m.config.use_cache = False
    return m
local_files_only=True impide que esta carga busque en línea archivos que falten. La adquisición es una etapa distinta. device_map={'': RANK} coloca esta réplica en la tarjeta asociada al proceso: no es un reparto automático del modelo entre las dos tarjetas.
La aserción m.is_loaded_in_4bit verifica que se ha realizado una carga en 4 bits; NF4 se solicita en la configuración inmediatamente anterior. Por sí sola, no constituye una auditoría de cada parámetro interno. use_cache=False desactiva la caché de generación en este recorrido de entrenamiento; attn_implementation='sdpa' conserva el mecanismo de atención elegido en el entorno probado.
Lo que acabamos de hacer: cargar la base, todavía no entrenarla. La preparación para el entrenamiento cuantificado y la adición de adaptadores pertenecen a las etapas siguientes del programa completo.
Transformar un ejemplo en entrada y objetivo
La función encode() prepara lo que leerá el modelo y las posiciones sobre las que calcular la pérdida.
def encode(row):
    answer = json.dumps(
        {'label': row['label'], 'explication': row['explanation']},
        ensure_ascii=False,
    )
    a = tok(prompt(row), add_special_tokens=False)['input_ids']
    b = tok(answer + tok.eos_token, add_special_tokens=False)['input_ids']
    ids = a + b

    if not 0 < len(ids) <= 1024:
        raise ValueError('context >1024')

    return {
        'input_ids': torch.tensor([ids], device=RANK),
        'attention_mask': torch.ones(
            (1, len(ids)),
            device=RANK,
            dtype=torch.long,
        ),
        'labels': torch.tensor([[-100] * len(a) + b], device=RANK),
    }
Empecemos por los nombres. En el dato fuente, la explicación se llama explanation. El JSON que queremos aprender utiliza la clave francesa explication. La primera línea de la función realiza esta correspondencia sin cambiar la clase esperada.
a contiene los identificadores de la instrucción y del mensaje. b contiene los del JSON esperado, seguidos de eos_token, el marcador de fin de secuencia. ids = a + b forma la secuencia completa.
Para visualizar el enmascaramiento, tomemos identificadores ficticios, sin relación con el tokenizer real:
Prompt :       [11,   12,   13]
Réponse :      [21,   22]
input_ids :    [11,   12,   13, 21, 22]
labels :       [-100, -100, -100, 21, 22]
Los identificadores del prompt permanecen en input_ids, pero se sustituyen por -100 en labels. La convención ignore_index=-100 de la pérdida de entropía cruzada de PyTorch permite ignorar esos objetivos. No es ni una penalización de menos cien ni un token que generar.
¿Por qué la respuesta figura también en la entrada durante el entrenamiento? En un modelo de lenguaje causal, cada posición aprende a predecir el token siguiente a partir de los anteriores, sin acceso a los posteriores. El modelo gestiona el desplazamiento entre predicciones y objetivos. Durante el uso, ya no se proporciona la respuesta esperada: el modelo la genera. El curso de Hugging Face sobre modelos causales explica este mecanismo.
Aquí, attention_mask se rellena con 1 en las posiciones presentes. No lo confunda con el enmascaramiento de la pérdida en labels, ni deduzca que el modelo puede leer los tokens futuros.
Por último, el límite de 1.024 tokens se aplica al conjunto prompt + respuesta + marcador de fin. El programa rechaza la secuencia fuera de límite en vez de cortar silenciosamente la respuesta. Este límite pertenece al protocolo probado; no describe necesariamente la capacidad máxima del modelo en otros usos.
Añadir LoRA y realizar las actualizaciones
get_peft_model() añade los adaptadores. La lista trainable conserva únicamente los parámetros cuyo requires_grad es verdadero, y una aserción exige después que sus nombres contengan lora_. En otras palabras, el programa controla lo que autoriza a aprender antes de iniciar la optimización.
Un tensor es una matriz numérica que puede tener varias dimensiones. before copia los tensores entrenables antes de la primera actualización; initial_hash calcula una huella de sus bytes. Estos elementos permiten comparar el estado inicial con el estado entrenado.
model = get_peft_model(
    base,
    LoraConfig(
        r=8,
        lora_alpha=16,
        lora_dropout=0.0,
        target_modules='all-linear',
        bias='none',
        task_type='CAUSAL_LM',
    ),
)
model.config.use_cache = False
trainable = [p for p in model.parameters() if p.requires_grad]
assert trainable and all(
    ('lora_' in n for n, p in model.named_parameters() if p.requires_grad)
)
before = [p.detach().cpu().clone() for p in trainable]
initial_hash = hashlib.sha256(
    b''.join((p.numpy().tobytes() for p in before))
).hexdigest()

# Répliques DDP :400 exemples par GPU, accumulation4, batch global8.
wrapped = DDP(
    model,
    device_ids=[RANK],
    output_device=RANK,
    find_unused_parameters=False,
    broadcast_buffers=False,
)
optimizer = torch.optim.AdamW(trainable, lr=0.0002, weight_decay=0.01)
train = [q for q in DATA['queries'] if q['split'] == 'train']
random.Random(42).shuffle(train)
own = train[RANK::WORLD]
assert len(own) == 400
partitions = [None] * WORLD
dist.all_gather_object(partitions, [q['id'] for q in own])
emit('training-partition', rank_ids=partitions)
accum = 4
losses = []
start = time.monotonic()
optimizer.zero_grad(set_to_none=True)
wrapped.train()
maxnorm = 0

for i, row in enumerate(own):
    sync = (i + 1) % accum == 0
    with contextlib.nullcontext() if sync else wrapped.no_sync():
        loss = wrapped(**encode(row)).loss
        assert torch.isfinite(loss)
        (loss / accum).backward()

    losses.append(float(loss.detach()))
    if sync:
        norm = torch.nn.utils.clip_grad_norm_(trainable, 1.0)
        assert torch.isfinite(norm)
        maxnorm = max(maxnorm, float(norm))
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)
        both = torch.tensor(sum(losses[-4:]) / 4, device=RANK)
        dist.all_reduce(both)
        emit(
            'train-step',
            step=(i + 1) // 4,
            loss=float(both) / WORLD,
            rank0_example_ids=[r['id'] for r in own[i - 3:i + 1]],
            gradient_norm=float(norm),
        )
El extracto es más largo, pero sigue tres operaciones conocidas: repartir el trabajo, realizarlo y registrar después lo que ha ocurrido.
Repartir los ejemplos. random.Random(42).shuffle(train) mezcla los datos con una semilla fija. Después, train[RANK::WORLD] toma una fila de cada dos: un proceso maneja las posiciones pares y el otro las impares de esa lista mezclada. Cada uno debe recibir exactamente 400 ejemplos. all_gather_object() reúne sus identificadores para el evento training-partition.
Acumular y después actualizar. Para cada ejemplo, wrapped(**encode(row)).loss calcula la pérdida. La aserción isfinite rechaza un valor infinito o indefinido. (loss / accum).backward() acumula la contribución del gradiente tras dividirla por 4. Los tres primeros ejemplos utilizan no_sync(); el cuarto activa la sincronización antes de la actualización. Es el mecanismo de acumulación descrito en la documentación de DDP.no_sync().
clip_grad_norm_(trainable, 1.0) limita la norma global de los gradientes, una medida de su magnitud, para impedir una actualización impulsada por gradientes demasiado grandes. El valor devuelto y registrado corresponde a la norma antes de esa limitación: un valor superior a 1 en el registro no significa automáticamente que el control haya fallado. Consulte la referencia de PyTorch para clip_grad_norm_.
optimizer.step() aplica después la actualización. El optimizador AdamW utiliza aquí lr=0.0002, la tasa de aprendizaje que regula la escala de los ajustes, y weight_decay=0.01, un término de regularización de los pesos. zero_grad(set_to_none=True) reinicializa los gradientes para el grupo siguiente. El proyecto utiliza efectivamente torch.optim.AdamW tal como se muestra, no otro optimizador sustituido por el del recorrido validado.
Registrar. Las últimas líneas calculan una pérdida media y la registran con el número de paso y la norma de los gradientes. La llamada explícita a dist.all_reduce(both) agrega aquí la pérdida para el registro: DDP sincroniza los gradientes durante la retropropagación.
Los controles que siguen a este bucle en el programa completo exigen pesos modificados, gradientes no nulos y réplicas idénticas. No todos se reproducen en este extracto. Tras el guardado, adapter_hash() vuelve a leer los parámetros LoRA: una huella idéntica antes y después de la recarga comprueba que el adaptador evaluado es realmente el que se guardó. Como una suma de comprobación de un artefacto, SHA-256 verifica la identidad de los bytes comparados, no la calidad de las respuestas.
Contar las respuestas correctas sin ocultar los errores de formato
La función classification() de metrics.py lee las salidas generadas y las compara con las clases esperadas. Esta es su parte dedicada a la decodificación y al recuento; el cálculo final y el retorno de las métricas se encuentran en la función completa del ZIP.
def classification(rows, expected):
    matrix = [[0] * 5 for _ in range(4)]
    correct = 0

    for row in rows:
        truth = LABELS.index(expected[row['sample_id']]['label'])
        try:
            obj = json.loads(row['raw'])
            label = obj['label']
            pred = (
                LABELS.index(label)
                if isinstance(obj.get('explication'), str)
                and obj['explication'].strip()
                else 4
            )
        except (ValueError, KeyError, TypeError):
            pred = 4

        matrix[truth][pred] += 1
        correct += pred == truth
matrix tiene cuatro filas, una por clase real, y cinco columnas: las cuatro clases posibles más una columna de error. Por tanto, una respuesta no válida permanece en el informe; no se elimina para que la puntuación parezca mejor.
El código empieza decodificando row['raw'] con json.loads(). Después busca el valor de label en LABELS. Para aceptar esta predicción, explication debe ser una cadena no vacía tras retirar los espacios iniciales y finales. Los errores gestionados por except se cuentan en la quinta columna.
Observe el detalle: strip() se aplica a la explicación, pero no a la etiqueta en esta evaluación estricta. Por tanto, una etiqueta que contiene un espacio final no coincide con el valor permitido sin ese espacio.
Eso no significa que el programa compare todos los bytes del JSON. El analizador acepta los espacios de sangría; sin embargo, un espacio dentro del valor de la etiqueta cambia la cadena comparada. Volveremos a esta distinción en el ejercicio.
Conviene tener presente otra limitación: este control verifica que la explicación existe y no está vacía. No juzga ni su pertinencia, ni su veracidad, ni su brevedad. La presencia de un texto no valida su contenido.
Reproducir el recorrido en orden
Para seguir la parte práctica, debe saber leer Python, utilizar un terminal y reconocer un objeto JSON. Los scripts se ejecutan desde la raíz de una extracción nueva del archivo; no reconstruya el proyecto ensamblando solamente los extractos del artículo.
El perfil validado utiliza Linux x86_64, Docker/Compose, un controlador NVIDIA y NVIDIA Container Toolkit, con dos RTX 3090. Las provisiones anunciadas son 48 GiB de RAM, 40 GiB de disco y 20 GiB de VRAM libre en cada tarjeta. La RAM pertenece a la máquina; la VRAM es la memoria de cada GPU. Estos valores son provisiones, no mínimos medidos.
No se ha validado ningún recorrido en CPU. El programa exige dos GPU para esta reproducción; reducir su número no constituye una simple variante de la misma ejecución.
1. Comprobar el host y preparar la imagen
El preflight es una comprobación de requisitos previos. Debe confirmar Docker, Compose, la presencia de las dos tarjetas y el acceso a CUDA desde un contenedor. CUDA es el entorno de cálculo NVIDIA utilizado por esta pila; ver las tarjetas en Linux no basta para demostrar que Docker puede utilizarlas. La guía de NVIDIA Container Toolkit describe la configuración de este acceso.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
setup.sh prepara los permisos locales utilizados por Compose. docker compose build construye después la imagen del proyecto.
Qué observar: las comprobaciones se superan y la construcción termina sin error. Si la GPU solo es visible desde el host, corrija el acceso desde Docker antes de la adquisición y el entrenamiento.
2. Adquirir la base y comprobar las salvaguardas
El servicio fetch descarga una revisión fijada del modelo, comprueba el tamaño y el SHA-256, y luego coloca el archivo final. Una revisión fijada desempeña aquí el papel de una versión precisa de dependencia: permite saber exactamente con qué archivos se realizó el experimento.
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
El segundo comando ejecuta la suite de pruebas. Cubre en particular los casos negativos relacionados con los datos y el contexto.
Qué observar: se superan 15 pruebas públicas. Un fallo de hash no es una advertencia que se deba sortear. Otro modelo recuperado de una caché no identificada ya no reproduciría el experimento descrito.
3. Preparar y entrenar el adaptador
prepare valida el corpus y produce los datos preparados. train realiza la evaluación de la base, los 100 pasos DDP y la recarga del adaptador. Es la etapa que utiliza las dos GPU.
docker compose run --rm --no-deps app -m src.cli prepare
docker compose run --rm --no-deps app -m src.cli train
Qué observar: los eventos JSON training-complete, adapter-roundtrip y complete, con 800 ejemplos, 100 pasos y replica_max_difference igual a 0.
El round-trip es el recorrido de guardar y recargar. Si falta este evento, no concluya que el adaptador recargado se ha evaluado correctamente. Una pérdida decreciente en el registro no sustituye esta comprobación.
4. Producir las métricas
Ahora podemos construir el informe de clasificación y las matrices de confusión.
docker compose run --rm --no-deps app -m src.cli evaluate
Qué observar: un JSON de clasificación para la base y otro para el adaptador recargado. Antes de ejecutar exercise, tómese tiempo para comprender las puntuaciones siguientes: el ejercicio le pedirá predecir el efecto de un cambio en la lectura de los resultados.
Cómo leer las métricas antes de los resultados
Accuracy y macro-F1: dos lecturas complementarias
La accuracy es la proporción de ejemplos clasificados correctamente según las reglas del programa. Una puntuación de 0,90 en 100 casos significa que 90 respuestas satisfacen esas reglas. Aquí un error de formato o una explicación vacía basta para que falle un caso.
El F1 combina dos nociones. Para una clase dada, la precisión pregunta: «Entre las respuestas que anuncian esta clase, ¿cuántas tienen razón?». El recall pregunta: «Entre los mensajes que pertenecen realmente a esta clase, ¿cuántos se han encontrado?». El F1 es su media armónica, calculada mediante 2 × precisión × recall / (precisión + recall) cuando el denominador no es nulo.
El macro-F1 calcula un F1 para cada una de las cuatro clases y después obtiene su media. Así, cada clase tiene el mismo peso en esa media, sea cual sea su población. La documentación de métricas de scikit-learn profundiza en estas definiciones; la puntuación de este tutorial sigue calculándose mediante su propio módulo metrics.py.
La matriz de confusión permite después comprender los errores. Cruza la clase esperada con la clase predicha, conservando aquí una columna adicional para las salidas rechazadas. Una confusión entre FACTURE e INCIDENT no cuenta lo mismo que una respuesta INCIDENT rechazada por un espacio final.
Una pérdida baja no sustituye estos controles
La pérdida de desarrollo mide en qué medida las probabilidades del modelo corresponden a los tokens esperados en el conjunto de desarrollo. No es ni un porcentaje de errores de negocio ni una medida independiente de la calidad de las explicaciones.
Además, una buena puntuación no basta para demostrar que la cadena de entrenamiento ha funcionado como se esperaba. El proyecto controla por separado 392 tensores LoRA modificados, 20.185.088 parámetros entrenables, 100 pasos de optimización, gradientes no nulos y la igualdad de los adaptadores en las dos réplicas.
Los dos primeros números no cuentan lo mismo: los tensores son las matrices; los parámetros son los valores numéricos que contienen. Los controles establecen que los adaptadores se han modificado y sincronizado; las puntuaciones indican después cómo se comportan sus salidas en el corpus.
Resultados observados y lo que permiten concluir
Los valores siguientes son los comunicados para el recorrido r3. La evaluación se refiere a los 100 casos de prueba, no a los 800 ejemplos utilizados para las actualizaciones.
| Medida en la prueba | Base no adaptada | Base con adaptador recargado |
|---|---|---|
| Accuracy estricta | 0,90 | 1,00 |
| Macro-F1 | 0,9167 | 1,00 |
Casos INCIDENT en la columna de error de formato |
10 | 0 |
A primera vista, el paso de 0,90 a 1,00 parece contar una historia sencilla: «Hemos enseñado al modelo a clasificar mejor». Pero la matriz exige una lectura más precisa. Los 10 fallos de la base están en la columna de error de formato, no en otra clase de negocio.
La conclusión respaldada directamente es, por tanto, que el adaptador recargado cumple mejor el contrato estricto de este experimento. No podemos transformar este resultado en una prueba de una mejor comprensión de las incidencias, sobre todo porque el ejercicio muestra el efecto de limpiar las etiquetas de la base.
El entrenamiento duró 139,5 s en la primera reproducción y 141,6 s en la segunda. Estas duraciones se refieren al entrenamiento comunicado, no a una promesa de tiempo total que incluya instalación y descarga. La pérdida de desarrollo observada es 1,4785609673708677e-05, es decir, aproximadamente 0,0000148: esta escritura decimal es una conversión redondeada del mismo valor, no una nueva medida.
Los máximos de VRAM registrados son de unos 14.145 MiB y 13.722 MiB según la GPU. La memoria se muestreó aproximadamente una vez por segundo: un pico entre dos mediciones puede escapar a la medida. Por tanto, estos valores no sustituyen la provisión anunciada de 20 GiB libres por tarjeta para la reproducción.
Estos resultados describen este corpus, estos ajustes y esta máquina. No demuestran ni una generalización a mensajes reales, ni superioridad sobre otro modelo, ni calidad de producción. Las cachés públicas de Docker y la actividad general del equipo también forman parte del contexto de recursos observado.
Lo que hemos aprendido
Hemos seguido una cadena completa: datos separados por familia, base cuantificada y congelada, adaptadores LoRA entrenables, gradientes sincronizados, guardado y recarga en una nueva base. El entrenamiento no se reduce a una curva de pérdida: también hay que saber qué parámetros han cambiado y qué artefacto se ha evaluado.
También hemos distinguido entre aprender y medir. Modificar los pesos cambia el comportamiento del modelo. Modificar la forma de leer sus salidas puede cambiar una puntuación sin tocar el modelo.
La puntuación de 1,00 del adaptador sigue siendo un resultado sobre 100 casos de prueba sintéticos. El paso de la base de 0,90 a 1,00 después de eliminar espacios corresponde a otra operación: sus respuestas son las mismas, pero su comparación se vuelve más tolerante. Confundir ambas cosas llevaría a anunciar una mejora semántica que el experimento no establece.
Ejercicio activo: predecir, modificar, ejecutar, observar y explicar
Ahora está del lado del desarrollador que recibe el JSON. Antes de ejecutar el comando, examine estos dos objetos, construidos para la explicación y no copiados de una captura:
{
  "label": "INCIDENT",
  "explication": "Un problème technique est signalé."
}
{
  "label": "INCIDENT ",
  "explication": "Un problème technique est signalé."
}
Los dos objetos son JSON válido. Sin embargo, en el segundo, el valor de la etiqueta contiene un espacio final. Prediga lo que hará LABELS.index(label) y qué cambiaría al comparar label.strip().
El método Python strip() elimina los caracteres de espacio al principio y al final de la cadena; no vuelve a entrenar el modelo ni sustituye una clase de negocio equivocada por la correcta.
Ejecute ahora el ejercicio proporcionado. El cambio estudiado se refiere a la lectura de las etiquetas, no a los pesos del modelo:
docker compose run --rm --no-deps app -m src.cli exercise
Resultados que observar: baseline estricta 0,90; baseline con etiqueta limpiada 1,00. La palabra baseline designa aquí la referencia de comparación, es decir, la base no adaptada.
Una hipótesis tentadora sería: «La puntuación sube, así que el modelo entiende mejor los mensajes». El resultado no la confirma. No ha cambiado ningún peso; el ejercicio pone de manifiesto una sensibilidad al formato.
Formule más bien su conclusión así: «Las etiquetas de la base satisfacen la comparación tras la normalización. Esta puntuación tolerante debe presentarse por separado de la puntuación estricta». La normalización puede ser útil para una aplicación, pero no debe borrar silenciosamente el contrato evaluado.
Para comprobar que lo ha entendido, explique por qué la misma operación no corregiría una etiqueta FACTURE asignada a un mensaje que en realidad es INCIDENT. Así habrá distinguido una corrección de formato de una corrección de clasificación.
Resolución de problemas y limpieza
Solo se ve una tarjeta. Compruebe GPU_DEVICE y GPU_DEVICE_2, y vuelva a empezar por el preflight. Si WORLD_SIZE o el número de GPU no vale 2, el entrenamiento se detiene deliberadamente. El reparto de los 800 ejemplos y el lote global descrito antes se basan en este contrato.
Una secuencia supera 1.024 tokens. Compruebe la longitud total de la instrucción, el mensaje, la respuesta y el marcador de fin. En un experimento independiente que utilice sus propios ejemplos, acorte el ejemplo en vez de truncar silenciosamente su respuesta. Si el corpus de referencia provoca este error, controle primero los archivos y la configuración de reproducción antes de modificarlos.
El adaptador no se recarga. Controle el directorio outputs/artifacts/adapter y vuelva a partir de una extracción nueva, no de un ensamblaje de archivos parciales. Sin una recarga validada, la evaluación adaptada no puede interpretarse como la del artefacto guardado.
Al final del recorrido, desde la raíz del proyecto, detenga los recursos de Compose:
docker compose down
Este comando no elimina ni los modelos ni las salidas. Conserve los resultados necesarios para su comparación. Para eliminar sus archivos de trabajo, borre únicamente la carpeta de extracción que creó tras comprobar su contenido, no recursos compartidos con otros proyectos.
Para ir más lejos
El siguiente paso interesante no es buscar de inmediato una puntuación más espectacular. Es construir una prueba en la que un error ya no se resuelva con una simple eliminación de espacio.
En un experimento distinto, conserve los principios de este protocolo y sustituya el corpus sintético por un conjunto anotado representativo de sus mensajes. Mantenga una separación por cliente, familia o periodo para evitar encontrar en la prueba variantes demasiado próximas a los ejemplos de entrenamiento. Compare siempre la base no adaptada y el adaptador con los mismos prompts y los mismos casos.
Prevea también una abstención: una respuesta que signifique que el sistema no puede clasificar el mensaje de manera aceptable y debe transmitirlo a una persona. Esta posibilidad no pertenece a las cuatro clases del contrato actual; añadirla exige modificar los datos, el formato esperado, las validaciones y las métricas, y volver a medir.
Haga que personas que conocen el negocio revisen los errores de la matriz y las explicaciones. Distinga los errores de formato, las categorías equivocadas y las justificaciones incorrectas. Estas ampliaciones no son resultados ya obtenidos por r3: definen el trabajo necesario para medir una utilidad más allá de nuestro ejemplo controlado.
Límites antes de un uso real
El conjunto es sintético y reducido, la prueba comprende 100 casos y no se reivindica ninguna revisión humana independiente. Una pérdida muy baja y una puntuación perfecta en esta prueba no validan los mensajes ambiguos, las formulaciones inesperadas ni la calidad de las explicaciones en su aplicación.
DDP sincroniza el aprendizaje en dos GPU; por sí solo no proporciona una estrategia de despliegue. Antes de cualquier decisión de negocio se necesitan datos representativos, criterios de rechazo, una revisión de errores por clase y una evaluación independiente, con una separación temporal o por cliente adaptada a la necesidad.
Conserve también la versión del corpus, el modelo base, el tokenizer, las dependencias, las reglas de cálculo y el adaptador. Comparar dos puntuaciones solo tiene sentido si se sabe qué ha cambiado entre los dos experimentos.
La documentación oficial de PEFT sobre cuantificación profundiza en la asociación de una base cuantificada y adaptadores entrenables. Las referencias de este artículo explican los mecanismos; no sustituyen las versiones y los parámetros fijados del ZIP necesarios para reproducir este tutorial.