





Bạn đang phát triển một back-office, nơi một nhóm đưa lên và phân loại tài liệu. Một biên bản can thiệp vừa đến: nên xếp nó vào Bảo trì, Chất lượng, hay cả hai? Một danh sách thả xuống chỉ cho phép một lựa chọn không còn đủ. Bạn cần nhiều nhãn, được tổ chức trong một cây phân cấp.
Một GED (hệ thống quản lý tài liệu điện tử) có thể gặp đúng vấn đề này. Cùng một tài liệu có thể thuộc maintenance/interventions và qualite/controles. Cũng cần tuân thủ kế hoạch tài liệu: đề xuất qualite/controles mà không có cha qualite sẽ tạo ra một gợi ý không nhất quán.
Chúng ta sẽ huấn luyện CamemBERT trên tập dữ liệu hư cấu Vesta để đề xuất các phân loại này. Lộ trình là: văn bản → biểu diễn số → điểm số danh mục → đề xuất tương thích với phân cấp. Bản mẫu không di chuyển tệp và không cấp quyền truy cập nào. Nó chuẩn bị một gợi ý cần được xác nhận.
Chúng ta sẽ theo dõi trường hợp D-031 để xem xét cơ chế. Ví dụ này đến từ dữ liệu huấn luyện; các chú thích của nó có thể truy cập để giải thích. 360 tài liệu kiểm thử sẽ được đánh giá riêng.
Cạm bẫy chính giống một lỗi biểu mẫu quen thuộc: một ô chưa được điền không nhất thiết có nghĩa là « không ». Trong quá trình huấn luyện này, nhầm một chú thích chưa biết với câu trả lời phủ định sẽ dạy cho mô hình một thông tin mà chưa ai xác lập. Bài tập cuối sẽ cho phép quan sát hệ quả của sự nhầm lẫn đó.
Từ vựng và chỉ số trước khi viết mã
Một taxonomy: các danh mục và liên kết của chúng
Ở đây, taxonomy là kế hoạch phân loại. Mỗi danh mục là một nút. Một danh mục có thể có các nút con: achats là cha của achats/factures. Một danh mục không có con là một lá. Tổ tiên của một nút là các danh mục gặp được khi đi ngược lên đỉnh cây.
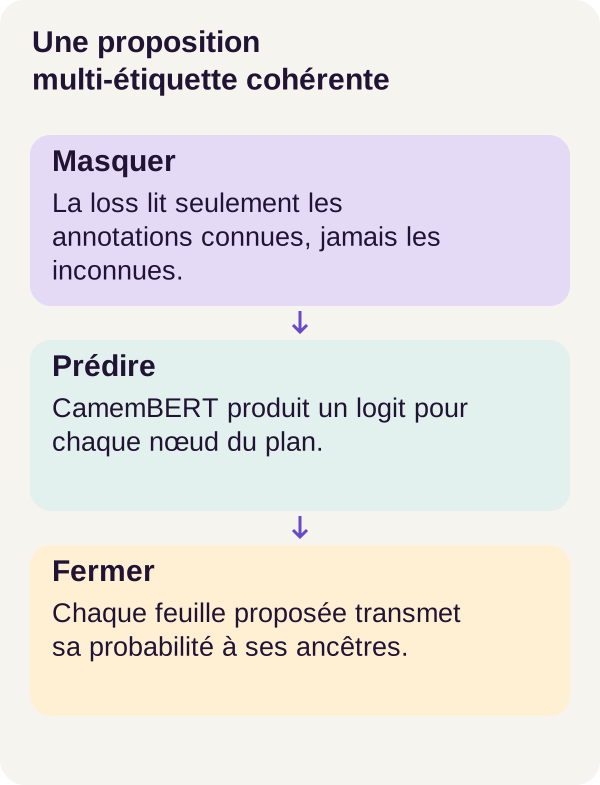
Dự án có 12 lá, nhưng mô hình cũng tạo điểm cho các nút cha. Vì vậy, có một đầu ra cho mỗi nút của taxonomy, chứ không chỉ mười hai đầu ra.
Phân loại là đa nhãn: một tài liệu có thể đồng thời thuộc nhiều danh mục. Hãy hình dung nhiều ô chọn thay vì các nút radio buộc phải chọn một. Các lá maintenance/interventions và qualite/controles không nhất thiết loại trừ nhau.
Cấu trúc phân cấp thêm một ràng buộc: một đề xuất trong qualite/controles phải bao gồm qualite. Ngược lại, đề xuất qualite không bắt buộc phải đề xuất tất cả các lá của nó. Một nút cha không phải là lối tắt để đánh dấu từng nút con.
Từ văn bản đến các con số: vai trò của CamemBERT
CamemBERT là mô hình được tiền huấn luyện trên văn bản tiếng Pháp. Chúng ta dùng nó như một bộ mã hóa: nó biến một chuỗi văn bản thành các biểu diễn số. Trong dự án này, nó không soạn câu trả lời hội thoại. Tài liệu CamemBERT của Hugging Face trình bày cách hoạt động và các cách dùng của nó cho phân loại.
Trước hết, tokenizer chia văn bản thành các đơn vị gọi là token, hay thẻ từ. Một token có thể là một phần của từ; không nhất thiết là cả một từ. Tokenizer biến các đơn vị này thành định danh và thêm các token đặc biệt để cấu trúc chuỗi.
Sau đó bộ mã hóa tạo ra một vector cho mỗi vị trí: một danh sách số biểu diễn vị trí đó trong bối cảnh văn bản xung quanh. Các số này là đặc trưng do mô hình tính ra, chứ không phải các danh mục có thể đọc trực tiếp như « hóa đơn » hay « kiểm tra ».
Được tiền huấn luyện không có nghĩa là mô hình đã biết kế hoạch phân loại của chúng ta. Việc điều chỉnh từ các chú thích Vesta dạy nó tác vụ tài liệu cần thực hiện: đó là nguyên tắc fine-tuning, hay điều chỉnh một mô hình tiền huấn luyện cho một tác vụ. Trọng số là các tham số số được điều chỉnh trong lúc học; chúng không phải là danh sách tài liệu để tra cứu.
Để xử lý nhiều tài liệu cùng lúc, ta tạo một lô, hay batch. Vì các chuỗi không có cùng độ dài, các chuỗi ngắn hơn được bổ sung bằng padding, tức phần đệm. Mặt nạ chú ý cho biết vị trí nào cần tính đến và vị trí nào là phần đệm. Các token đặc biệt trong chuỗi không tự động là padding: chính mặt nạ mới tạo ra sự phân biệt. Bảng thuật ngữ Transformers giải thích chi tiết khái niệm này.
Lấy trung bình mà không để phần đệm quyết định
Bộ phân loại của chúng ta cần một vector cho mỗi tài liệu, không phải một số lượng vector thay đổi. Vì vậy dự án dùng pooling có mặt nạ: nó lấy trung bình biểu diễn của các vị trí hợp lệ.
Hãy lấy một minh họa hai chiều, không liên quan đến đầu ra đo được của CamemBERT. Ba vị trí hợp lệ có các vector [2 ; 4], [4 ; 2] và [6 ; 6]. Tổng của chúng là [12 ; 12], nên trung bình là [4 ; 4].
Thêm hai vị trí đệm, được biểu diễn bằng [0 ; 0] để đơn giản hóa. Lấy trung bình trên năm vị trí sẽ cho [2,4 ; 2,4]. Nội dung không thay đổi, nhưng biểu diễn của nó bị giảm một cách giả tạo. Cần loại phần đệm khỏi tổng và chia cho số vị trí hợp lệ. Trên thực tế, cũng không được giả định rằng các biểu diễn tính tại vị trí padding bằng không.
Các mảng do PyTorch xử lý được gọi là tensor. Với B tài liệu, T vị trí mỗi chuỗi và H số mỗi vector, các biểu diễn có dạng B × T × H. Pooling cho B × H. Đầu phân loại, phần biến vector này thành điểm danh mục, cuối cùng tạo ra B × K, trong đó K là tổng số nút.
Logit, xác suất và quyết định là ba thứ khác nhau
Mỗi đầu ra của đầu phân loại là một logit: số thô có thể âm hoặc dương. Sigmoid biến đổi nó theo p = 1 / (1 + exp(-z)), trong đó z là logit và exp là hàm mũ. Chẳng hạn, các logit -2, 0 và 2 lần lượt cho xấp xỉ 0,1192, 0,5 và 0,8808. Công thức được ghi trong tài liệu PyTorch về Sigmoid.
Biến đổi này được áp dụng cho từng danh mục. Hai lá có thể cùng nhận điểm cao: xác suất của chúng không cần cộng lại thành 1, vì nhiều thuộc tính có thể đồng thời đúng.
Sau đó cần một quy tắc quyết định để biến các điểm này thành đề xuất. Ngưỡng 0,5 sẽ được dùng trong các ví dụ số, chỉ để dễ tính; nó không thay thế cấu hình của lộ trình r001. Tương tự, điểm 0,8 tự nó không chứng minh rằng tám gợi ý tương đương trên mười sẽ đúng.
Sau sigmoid, đóng tổ tiên nâng điểm từ các nút con lên nút cha bằng cách lấy giá trị lớn nhất. Nó làm các điểm tương thích với cấu trúc phân cấp. Nó không sửa các logit dùng để học và không biến một danh mục sai thành đúng.
Một chú thích có hai thông tin: giá trị của nó và việc nó có được biết hay không
Một chú thích cho biết tài liệu có thuộc một danh mục hay không. Trong dự án này, chúng ta phân biệt ba tình huống:
| Tình huống | Giá trị mục tiêu | Dùng để học? |
|---|---|---|
| Thuộc tính đã xác nhận | 1 |
Có. |
| Không thuộc đã xác nhận | 0 |
Có. |
| Thuộc tính chưa biết | Giá trị bị bỏ qua | Không. |
Với một lập trình viên web, có thể liên hệ sự phân biệt này với một boolean nullable: true, false và không có thông tin. Đây là một phép so sánh, không phải mô tả về một lược đồ cơ sở dữ liệu do dự án cung cấp.
Hàm mất mát, gọi là loss trong mã, đo chênh lệch giữa đầu ra mô hình và các chú thích đã biết. Việc huấn luyện điều chỉnh tham số để giảm mất mát này. Ở đây, chúng ta dùng entropy chéo nhị phân, hay BCE, chỉ trên các cặp tài liệu–nhãn thực sự được quan sát.
Lưu ý: giờ chúng ta có hai mặt nạ khác nhau. Mặt nạ chú ý áp dụng cho các vị trí văn bản, có dạng B × T. Mặt nạ chú thích áp dụng cho các danh mục đã biết, có dạng B × K. Loại một chú thích khỏi mất mát không xóa các từ của tài liệu.
Đo từng nhãn, rồi đo toàn bộ tài liệu
Một dương tính thật là lá được mong đợi và được đề xuất. Một dương tính giả là lá được đề xuất sai. Một âm tính giả là lá được mong đợi nhưng bị bỏ sót. Độ chính xác đo các đề xuất đúng trong số đề xuất được đưa ra; độ bao phủ đo các thuộc tính mong đợi đã được tìm thấy.
F1 kết hợp độ chính xác và độ bao phủ. Với VP dương tính thật, FP dương tính giả và FN âm tính giả, nó bằng 2 × VP / (2 × VP + FP + FN). F1 micro gộp số đếm của mọi lá trước phép tính này. F1 macro tính F1 của từng trong 12 lá, rồi lấy trung bình không trọng số. Các quy ước này được mô tả trong tài liệu f1_score.
Một minh họa nhỏ giải thích khác biệt giữa chúng. Giả sử chỉ có hai lá: lá thứ nhất được tìm lại 90 lần trên 90, không lỗi; lá thứ hai bị bỏ sót mười lần trên mười và không bao giờ được đề xuất. F1 micro bằng 180 / 190, xấp xỉ 0,9474. Nhưng F1 macro là (1 + 0) / 2 = 0,5. Vì vậy, thành công ở một danh mục thường gặp có thể che lấp thất bại hoàn toàn của danh mục khác.
Tập lá chính xác đặt ra câu hỏi nghiêm ngặt hơn: tất cả lá của tài liệu này có đúng, không thêm hay bỏ sót? Tập nút chính xác đòi hỏi điều tương tự cho lá và nút cha. Đây là so sánh các tập hợp, không phải thứ tự hiển thị; khái niệm chính xác trong đa nhãn cũng được giải thích bởi scikit-learn.
Cuối cùng, tỷ lệ vi phạm cha–con kiểm tra tính nhất quán của kế hoạch: có nút con nào được đề xuất mà không có nút cha không? Tỷ lệ bằng không là điều mong muốn, nhưng một nhánh hoàn toàn sai vẫn có thể nhất quán hoàn hảo.
Chuẩn bị lộ trình GPU
Kiểm tra điều kiện cần và giữ cấu hình tham chiếu
Bạn cần biết dùng Python, terminal và Docker. PyTorch sẽ thực hiện các phép tính trên tensor; các khái niệm cần thiết về phân loại nhị phân vừa được giới thiệu.
Cấu hình tham chiếu là Linux với RTX 3090 có 24 Gio bộ nhớ đồ họa. Cũng cần dự kiến 24 Gio RAM và 35 Gio dung lượng làm việc, cộng thêm phần lưu trữ Docker. Đây là khuyến nghị chuẩn bị, không phải mức tối thiểu hay mức tiêu thụ được bảo đảm trên mọi máy.
Lộ trình chính dùng ba epoch: một epoch tương ứng một lần đi qua các ví dụ huấn luyện. Bài tập sẽ chạy hai lần huấn luyện mới, mỗi lần ba epoch. Bản xác thực r001 được mô tả trong bài này đã dùng GPU; các lệnh sau tái tạo lộ trình đó, không phải chế độ CPU thay thế. Tuy vậy, tham chiếu từ vựng sẽ được tính trên CPU.
Sáu tài nguyên công khai cần thiết được tải với kiểm tra kích thước và dấu vân tay SHA-256. Dấu vân tay này xác định nội dung tệp được mong đợi. Không có trọng số tiền huấn luyện hay kho riêng nào trong ZIP: tải các tài nguyên là một phần của khâu chuẩn bị.
Giải nén kho lưu trữ và đặt terminal tại thư mục gốc của nó. Mọi lệnh trong bài đều được chạy từ thư mục này, theo thứ tự đã trình bày. Giữ nguyên các phụ thuộc và cấu hình configs/minimum.yaml trong ZIP để tái tạo r001.
Kiểm tra máy chủ và xây dựng các dịch vụ
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference
Preflight kiểm tra Docker, Compose, bộ nhớ, dung lượng đĩa và GPU. Kiểm tra config --quiet thành công mà không hiển thị văn bản khi cấu hình Compose hợp lệ. Vì vậy một lệnh im lặng không nhất thiết là lệnh không làm gì.
GPU hiện diện với nvidia-smi trên máy chủ vẫn chưa chứng minh rằng một chương trình trong Docker có thể tính trên đó. NVIDIA Container Toolkit cung cấp tích hợp với container. Preflight chỉ ra tài liệu cần thiết nếu tích hợp này thiếu, mà không tự thay đổi hệ thống của bạn. Để chọn card khác, hãy đặt GPU_DEVICE=1 trước lộ trình.
Tải tệp, rồi kiểm thử từ Docker
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Quá trình tải kiểm tra sáu tệp trước khi cài đặt chúng theo cách nguyên tử: nhờ vậy, một tệp tải dở không bị coi là tệp cuối cùng. Sau đó check_environment.py tải trọng số và thực hiện một phép tính CUDA từ container. Như vậy nó kiểm tra khả năng thực thi thực sự, chứ không chỉ sự hiện diện của phần cứng.
Các kiểm thử bao gồm mặt nạ chú thích, đóng phân cấp và các trường hợp âm. Một trường hợp âm xác minh rằng đầu vào không hợp lệ bị từ chối. Đừng bắt đầu huấn luyện bằng cách bỏ qua lỗi của những kiểm tra này: trước hết cần hiểu nguyên nhân.
Tạo dữ liệu và làm cơ chế có thể kiểm tra
Chuẩn bị Vesta và một phương pháp so sánh
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli prepare --config configs/minimum.yaml
docker compose run --rm learning python -m ged_classement_hierarchique.cli baseline --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli inspect-mechanism --config configs/minimum.yaml
prepare tạo tập dữ liệu hư cấu và taxonomy của nó. baseline chạy một tham chiếu từ vựng, tức phương pháp dựa trên các dấu hiệu văn bản do dự án quy định. So sánh này trả lời một câu hỏi hữu ích: mạng có đóng góp gì so với giải pháp đơn giản hơn không? Việc lệnh dùng dịch vụ learning không thay đổi cấu hình CPU của tham chiếu này.
inspect-mechanism làm trường hợp D-031 có thể kiểm tra. Các logit của phần trình diễn này chỉ là minh họa và được nêu rõ như vậy. Chúng giúp theo dõi phép tính; không được trình bày chúng như dự đoán của mô hình đã huấn luyện. Các phép tính nhỏ bổ sung dưới đây cũng là minh họa độc lập, không phải phép đo mới trên D-031.
masked_bce: chọn trước khi tính
Hãy xem hàng rào bảo vệ trung tâm. logits chứa điểm thô, targets chứa các giá trị mong đợi và mask chỉ ra các cặp tài liệu–nhãn đã biết.
def masked_bce(logits, targets, mask):
    if (
        logits.shape != targets.shape
        or logits.shape != mask.shape
        or mask.dtype != torch.bool
    ):
        raise ValueError("Expected matching B x labels tensors and a boolean mask")
    count = int(mask.sum())
    if count == 0:
        return None, 0
    # Index first: unknown targets may even be NaN and never enter BCE.
    selected = targets[mask]
    if (
        not torch.isfinite(selected).all()
        or not ((selected == 0) | (selected == 1)).all()
    ):
        raise ValueError("Known target is not binary")
    return (
        F.binary_cross_entropy_with_logits(logits[mask], selected, reduction="sum"),
        count,
    )
Hàm bắt đầu bằng cách yêu cầu ba tensor có cùng hình dạng và mặt nạ thuộc kiểu torch.bool. Trong lộ trình, các bảng này tương ứng B × K: một hàng cho mỗi tài liệu, một cột cho mỗi nút. Kiểm tra được hiển thị so sánh hình dạng; nó không tái tạo liên kết giữa tên danh mục và các cột. Vì thế thứ tự này phải nhất quán trong đầu vào.
count = int(mask.sum()) đếm các chú thích đã biết, cả dương lẫn âm. Nó không phải số tài liệu, cũng không phải số danh mục hiện diện.
Khi không có chú thích nào được biết, hàm trả về (None, 0). Điều này có nghĩa « không có hạng tử giám sát để tính », không phải « dự đoán hoàn hảo với mất mát bằng không ». Mã gọi phải xử lý trường hợp này mà không chia cho không hay cố lan truyền ngược trên None.
Dòng quyết định là selected = targets[mask]. Lập chỉ mục boolean chỉ giữ những giá trị được phép tham gia tính toán. Các mục tiêu được chọn phải hữu hạn và đúng bằng 0 hoặc 1. Ví dụ, một mục tiêu đã biết bằng 0,5 bị hợp đồng này từ chối.
Lời gọi cuối nhận logit, không phải sigmoid tính trước của chúng. binary_cross_entropy_with_logits kết hợp phép biến đổi và mất mát theo cách ổn định về số học. Tài liệu PyTorch về BCEWithLogitsLoss giải thích nguyên tắc này.
Với reduction="sum", hàm trả về tổng mất mát và số hạng tử, chứ không phải trung bình. Hai thông tin này giúp mã gọi chuẩn hóa theo số chú thích được giữ lại. Để hiểu cách chuẩn hóa chính xác trong toàn bộ huấn luyện, cần theo dõi cách chúng được dùng trong dự án, chứ không giả định đoạn trích này đã thực hiện phép chia.
Vì sao « tính rồi nhân với không » là chưa đủ
Lấy một tài liệu và ba điểm: các logit là [2 ; -2 ; 0], mục tiêu [1 ; 0 ; NaN] và mặt nạ [True ; True ; False]. NaN, viết tắt của Not a Number, ở đây biểu diễn một giá trị số không xác định được đặt trong một ô chưa biết.
Sau khi chọn, hai mục tiêu duy nhất là 1 và 0. Xác suất của chúng xấp xỉ 0,8808 và 0,1192. Trong cả hai trường hợp, dự đoán ưu tiên câu trả lời đúng. Mỗi mất mát xấp xỉ 0,126928: vì vậy hàm trả về tổng xấp xỉ 0,253856 và bộ đếm 2. Trung bình tương ứng là 0,126928.
Hạng tử thứ ba không bao giờ được tính. Ngược lại, tính BCE trên cả ba mục tiêu rồi nhân mất mát thứ ba với không chưa chắc xóa được vấn đề: NaN × 0 vẫn là NaN. Mặt nạ phải can thiệp trước phép toán có thể bị nhiễm.
Việc chọn này không ép điểm thứ ba về không. Nó loại bỏ đóng góp trực tiếp của nó vào mất mát. Các tham số chung của mô hình vẫn có thể thay đổi nhờ các chú thích khác và làm thay đổi điểm này trong một dự đoán sau.
Giới hạn quan trọng cuối cùng: hàm tin vào mặt nạ. Nếu một chú thích chưa biết bị biến thành 0 và được đánh dấu là đã biết ở phía trước, nó trông giống một chú thích âm hợp lệ. Không kiểm tra hình dạng nào có thể đoán ra lỗi về nghĩa này. Chính điều đó bài tập sẽ kiểm tra.
Nâng điểm lên trên mà không đánh dấu cả một nhánh
Sau học là đến suy luận, tức tính các dự đoán bằng mô hình đã huấn luyện. Việc đóng chỉ được áp dụng ở bước này.
Hãy tưởng tượng các điểm sau, với ngưỡng chung 0,5 chỉ được chọn để minh họa:
| Nút | Điểm trước khi đóng | Điểm sau khi đóng |
|---|---|---|
qualite |
0,2 | 0,8 |
qualite/controles |
0,8 | 0,8 |
qualite/audits |
0,1 | 0,1 |
Trước khi đóng, nút kiểm tra sẽ được đề xuất mà không có cha của nó. Chương trình nâng điểm của nó lên qualite, điểm này thành 0,8. Nó không thay đổi qualite/audits: thuộc nhánh Chất lượng không có nghĩa là thuộc một cuộc kiểm toán.
Đây là vòng lặp chính xác của dự án. Đây là đoạn trích thân hàm: return cuối cùng thuộc về hàm này trong mã hoàn chỉnh.
for node in reversed(topological_order(parents)):
    parent = parents[node]
    if parent is not None:
        output[..., parent] = torch.maximum(output[..., parent], output[..., node])
return output
Một thứ tự topo đặt các nút cha trước các nút con. reversed(...) đảo thứ tự đó để xử lý hậu duệ trước. Với mỗi nút, parents[node] tìm lại nút cha; None chỉ ra rằng nó không có.
Ký hiệu output[..., parent] chọn nút cha trên chiều cuối cùng của tensor, đồng thời giữ các chiều trước đó, nhất là các tài liệu của lô. torch.maximum so sánh hai điểm theo từng phần tử. Vì vậy nút cha giữ giá trị lớn hơn giữa điểm riêng của nó và điểm của nút con.
Vì sao bắt đầu từ dưới lên? Lấy chuỗi trừu tượng đỉnh → nhánh → lá, có các điểm 0,1, 0,2 và 0,9. Khi đi ngược từ lá, nhánh thành 0,9, rồi đỉnh cũng vậy. Nếu chỉ duyệt một lần theo chiều ngược lại, ban đầu đỉnh chỉ nhận 0,2, trước khi nhánh nhận lại 0,9 của lá.
Việc đóng không làm giảm điểm nào và không sửa các điểm của lá. Khi mọi tổ tiên đã được cập nhật, làm lại không còn thay đổi kết quả. Nó cũng không tính tổng xác suất của các nút con: hai điểm 0,8 không cho một nút cha bằng 1,6.
Cơ chế này áp đặt tính nhất quán, chứ không hiệu chỉnh xác suất. Với một ngưỡng chung, một nút con được giữ sẽ kéo theo các nút cha vì điểm của chúng ít nhất cũng cao bằng. Với phần mở rộng dùng ngưỡng khác nhau theo danh mục, bảo đảm này phải được kiểm tra lại: nút cha 0,8 với ngưỡng 0,9 sẽ bị từ chối, dù nút con 0,8 vượt ngưỡng 0,5. Ví dụ này không mô tả một sửa đổi cho lộ trình r001.
Huấn luyện, tiếp tục, dự đoán và đo lường
Phân biệt học, tiếp tục và đánh giá
Dữ liệu huấn luyện dùng để điều chỉnh tham số. Xác thực dùng để kiểm soát các lựa chọn phát triển mà không dùng tập kiểm thử. Kiểm thử mô tả hành vi cuối cùng trên các tài liệu dành riêng cho đo lường.
Lộ trình cũng tách vai trò các container: learning có các chú thích huấn luyện và xác thực cần thiết để học; inference không mount bất kỳ chú thích nào. Sau đó, đánh giá thực hiện riêng có thể so sánh dự đoán với tham chiếu của 360 tài liệu kiểm thử.
docker compose run --rm learning python -m ged_classement_hierarchique.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_classement_hierarchique.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_classement_hierarchique.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_classement_hierarchique.cli verify-resume --config configs/minimum.yaml
Chế độ interrupt tạo một lộ trình bị ngắt. continuous thực hiện bản đối chứng liên tục từ cùng dữ liệu. resume tiếp tục trạng thái bị ngắt, rồi verify-resume so sánh trạng thái nhận được với trạng thái đối chứng.
Checkpoint là trạng thái đã lưu cho phép tiếp tục một phép tính. Vì vậy tiếp tục không có nghĩa là bắt đầu từ khởi tạo mới hay tùy tiện chạy lại thêm ba epoch. Mục tiêu của kiểm tra là xác minh quy trình tiếp tục. Tự nó không đo chất lượng của các phân loại.
Bây giờ hãy tạo các gợi ý, rồi các phép đo:
docker compose run --rm inference python -m ged_classement_hierarchique.cli predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli evaluate --config configs/minimum.yaml
Dự đoán chính được thực hiện trước đánh giá. Hãy xem các đề xuất và outputs/evaluation.json: một giá trị trung bình toàn cục không đủ để giải thích một lá được thêm hoặc bị bỏ sót trong một tài liệu cụ thể.
Kết quả của lộ trình chính
Đây là các kết quả công bố cho 360 tài liệu kiểm thử:
| Chỉ số | Kết quả |
|---|---|
| F1 micro của các lá | 0,95658 |
| F1 macro của 12 lá | 0,95619 |
| Tài liệu có tập lá chính xác | 306 / 360 |
| Tài liệu có tập tất cả nút chính xác | 195 / 360 |
| Âm tính giả của lá | 26 |
| Dương tính giả của lá | 37 |
| Vi phạm cha–con sau khi đóng | 0 |
Trong kiểm thử này, việc đóng không thay đổi chỉ số so với đầu ra thô. Tỷ lệ vi phạm vẫn bằng không. Cơ chế này hữu ích để xác định tính nhất quán mong đợi, nhưng thí nghiệm này không chứng minh chất lượng tăng lên nhờ áp dụng nó.
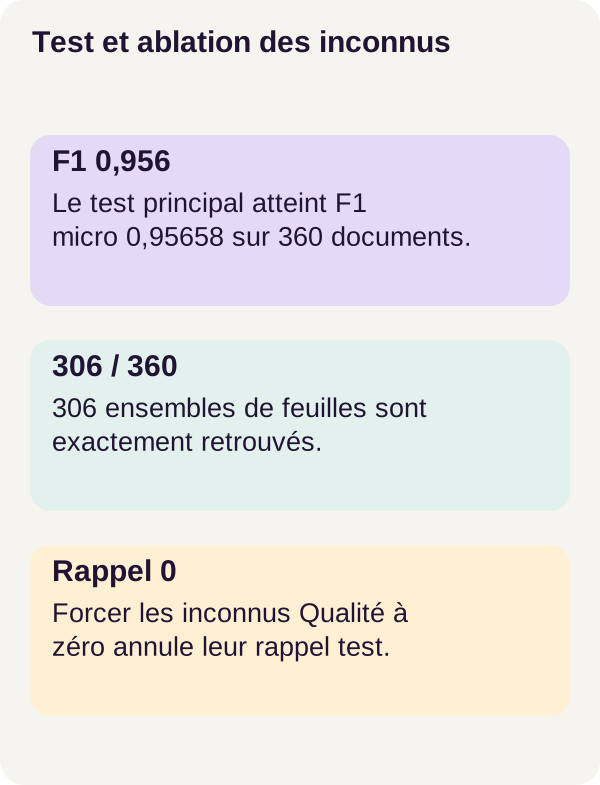
Các số đếm tập hợp chính xác mang lại một cách đọc khác: 306 / 360 tương ứng 85 % tài liệu có các lá hoàn toàn đúng, so với khoảng 54,17 % cho tập đầy đủ các nút. Các tỷ lệ này được tính từ số đếm đã công bố; chúng không phải là phép đo bổ sung.
Vì sao hai độ chính xác có thể khác nhau? Mạng cũng tạo điểm cho các nút cha. Trong một ví dụ minh họa, mọi lá của tài liệu có thể đúng, nhưng nút cha achats lại bị đề xuất thừa. Việc đóng không xóa nút cha này vì nó chỉ nâng điểm. Gợi ý khi đó không vi phạm nào nhưng vẫn có một danh mục không cần thiết.
Ví dụ này cho thấy một khả năng của cơ chế. Chỉ các số liệu tổng hợp không cho phép quy từng lỗi của tập dữ liệu vào đúng trường hợp này: cần xem đầu ra theo từng tài liệu.
Xem các lá khó và tham chiếu đơn giản
Hai F1 toàn cục gần nhau, nhưng điều đó không có nghĩa mọi lá đều hoạt động giống nhau. achats/factures mong manh nhất: F1 bằng 0,82759, với 12 âm tính giả và 8 dương tính giả. achats/fournisseurs đạt 0,89320. qualite/audits đạt 0,90647, nhưng có 13 dương tính giả.
Nhánh Chất lượng không bỏ sót lá mong đợi nào trong kiểm thử chính; tuy vậy nó thêm 17 dương tính giả. Vì thế, độ bao phủ hoàn hảo vẫn có thể đi cùng những danh mục được gợi ý sai.
Cuối cùng, baseline từ vựng đạt 1,00 trên tập dữ liệu tổng hợp có các mẫu rõ ràng này. Sẽ gây hiểu lầm nếu kết luận CamemBERT là cần thiết cho dữ liệu này. Hướng dẫn cho phép nghiên cứu việc học với chú thích một phần và cấu trúc phân cấp; nó không chứng minh mô hình vượt trội so với tham chiếu này, cũng không chứng minh khả năng chuyển tự động sang một GED thực tế.
Bài tập: dự đoán tác động của các chú thích bị che
Nêu giả thuyết trước khi chạy lệnh
Chúng ta sẽ che 40 % chú thích đã biết của nhánh Chất lượng trong huấn luyện, không thay đổi xác thực hay kiểm thử. Đây là các cặp tài liệu–nhãn, không phải 40 % văn bản bị xóa, cũng không nhất thiết là 40 % chỉ các chú thích dương.
Hãy dành một lúc để dự đoán kết quả. Nếu thông tin này trở nên chưa biết, liệu vẫn nên phạt mô hình khi nó gợi ý một lá Chất lượng? Chuyện gì xảy ra nếu ta sai lầm nói với nó rằng mọi thuộc tính đó đều là âm? Bạn mong đợi nhiều bỏ sót hơn, nhiều thêm vào hơn, hay cả hai?
Thí nghiệm so sánh hai mô hình mới, xuất phát từ cùng mô hình ban đầu và dùng cùng định danh. exercise-correct loại các hạng tử chưa biết khỏi mất mát. exercise-wrong biến chúng thành mục tiêu âm bằng không. Mỗi biến thể được huấn luyện trong ba epoch.
Đây không phải thay đổi chỉ áp dụng cho các điểm sau huấn luyện: hai mô hình học với các giám sát khác nhau. Lộ trình cũng kiểm tra đánh giá chính không đổi, để không nhầm bài tập với kết quả r001 ban đầu.
docker compose run --rm learning python -m ged_classement_hierarchique.cli exercise --config configs/minimum.yaml
docker compose run --rm inference python -m ged_classement_hierarchique.cli predict --config configs/minimum.yaml --variant exercise-correct
docker compose run --rm inference python -m ged_classement_hierarchique.cli predict --config configs/minimum.yaml --variant exercise-wrong
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli evaluate-exercise --config configs/minimum.yaml
Hiểu hướng mà một mục tiêu sai đẩy mô hình
Hãy lấy lại một minh họa độc lập với các phép đo: điểm xác suất p = 0,8 cho một danh mục thực sự hiện diện. Với mục tiêu đúng y = 1, BCE bằng -ln(0,8), tức xấp xỉ 0,2231. Khi thay mục tiêu bằng y = 0, nó thành -ln(0,2), tức xấp xỉ 1,6094. ln là logarit tự nhiên. Khi ấy mô hình bị phạt nặng vì đã ưu tiên một thuộc tính thực sự đúng.
Ta có thể đi sâu thêm một bước với gradient: nó cho biết mất mát thay đổi thế nào khi sửa một điểm hoặc tham số. Với BCE này, đạo hàm theo logit bằng p - y. Với mục tiêu đúng, nó bằng -0,2; với mục tiêu âm sai, nó bằng 0,8.
Trong lập luận điều chỉnh trực tiếp logit này để giảm mất mát, trường hợp đầu đẩy nó lên, trường hợp thứ hai đẩy nó xuống. Cập nhật trong một mạng có tham số chung phức tạp hơn, nhưng ví dụ giải thích hướng của tín hiệu sai. Che mục tiêu chưa biết loại bỏ tín hiệu đó; nó không tiết lộ sự thật còn thiếu.
So sánh với các kết quả quan sát
Phần sửa của lộ trình xác nhận logit Chất lượng giảm khi các giá trị chưa biết biến thành âm. Trên kiểm thử không đổi:
| Chỉ số | Mặt nạ đúng | Giá trị chưa biết bị ép về không |
|---|---|---|
| Độ bao phủ của các lá Chất lượng | 0,59149 | 0 |
| Âm tính giả Chất lượng | 96 | 235 |
| F1 macro của mọi lá kiểm thử | 0,85430 | 0,65244 |
Với mặt nạ đúng, mô hình tìm lại 139 dương tính thật, bỏ sót 96 thuộc tính và tạo 92 dương tính giả trên các lá Chất lượng. Độ bao phủ được tìm trực tiếp: 139 / (139 + 96) = 139 / 235, tức xấp xỉ 0,59149.
235 lá Chất lượng mong đợi ở đây chỉ 235 thuộc tính dương theo cặp tài liệu–lá, không phải 235 danh mục khác nhau hay nhất thiết 235 tài liệu riêng. Với chính sách sai, tất cả chúng thành âm tính giả: độ bao phủ của nhánh này giảm về không.
Vì sao F1 macro toàn cục vẫn là 0,65244 thay vì không? Vì nó bao phủ 12 lá, không chỉ các lá Chất lượng. Thành công ở các danh mục khác vẫn có thể giữ trung bình khác không khi cả một nhánh bị bỏ sót hoàn toàn.
Mặt nạ đúng cũng vẫn kém mô hình chính: F1 macro 0,85430 so với 0,95619. Nó đã mất thông tin giám sát. Nó tránh tạo âm tính giả tạo, nhưng không khôi phục các chú thích bị che. Không có sự tăng F1 nào được mong đợi từ việc loại bỏ này.
Bài học vì thế rất chính xác: giữ lại giá trị chưa biết bảo vệ ý nghĩa của dữ liệu huấn luyện; điều đó không thay thế thông tin vắng mặt.
Tạo hình và dọn dẹp mà không mất bằng chứng
Liên hệ các giá trị trung bình với ví dụ
Hãy tạo các hình từ kết quả đã tính, rồi kiểm tra các mốc sư phạm:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Các hình biểu diễn kết quả hiện có; chúng không phải các thử nghiệm mới. Kiểm tra mốc xác minh tài liệu sư phạm. Hãy xem PNG, outputs/evaluation.json và outputs/exercise-comparison.json trước khi xóa bất cứ thứ gì.
Hãy quay lại D-031: nó giải thích cơ chế bằng ví dụ từ huấn luyện. Tính dễ đọc của nó không thay thế các phép đo trên 360 tài liệu riêng biệt. Để đánh giá phân loại, hãy xem các đề xuất sai cũng như các trường hợp thành công.
Chỉ dọn dẹp đầu ra của lộ trình
Hãy sao chép các chỉ số và hình cần giữ trước các lệnh này. Thứ tự dưới đây là một phần của lộ trình: lần dừng đầu tiên diễn ra trước khi dọn dẹp; lần cuối lại để dự án ở trạng thái dừng sau khi container dọn dẹp chạy xong.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
clean --outputs-only hiển thị rồi chỉ xóa các đầu ra. Tập dữ liệu, mô hình và checkpoint được giữ lại. Dọn dẹp có mục tiêu này không đòi hỏi dọn Docker toàn cục hay xóa tài nguyên của dự án khác.
Khi gặp sự cố
GPU hiện trên máy chủ nhưng phép tính lỗi trong Docker? Hãy quay lại preflight và check_environment.py. Kiểm tra thứ hai xác minh quyền truy cập thực tế từ container; kiểm tra đầu không thay thế nó.
Một mục tiêu bị từ chối hoặc mất mát không dùng được? Hãy kiểm tra sự khớp nhau của hình dạng, kiểu boolean của mặt nạ và giá trị của riêng các chú thích đã biết. Đừng thay giá trị chưa biết bằng không để làm lỗi biến mất. Bộ đếm bằng không đòi hỏi xử lý lô không giám sát, không phải cố tính một trung bình.
Cấu trúc phân cấp có vẻ đúng nhưng phân loại vẫn kém? Hãy xem các lá được thêm hoặc bỏ sót, các nút cha thừa và lỗi theo danh mục. Không vi phạm không kiểm tra tính phù hợp của nội dung. Cũng cần kiểm tra rằng mỗi cột luôn tương ứng cùng một nút của taxonomy.
Từ bản mẫu đến một ứng dụng hữu ích
Hãy bắt đầu với một taxonomy có phiên bản, các chú thích đã kiểm toán và đánh giá tách riêng theo dịch vụ, ngôn ngữ và loại tài liệu. Một danh mục mới hay tổ chức lại nhánh làm thay đổi hợp đồng phân loại: cần giữ sự tương ứng giữa dữ liệu, đầu ra và phiên bản của kế hoạch.
Khi chú thích, hãy phân biệt trong giao diện « có », « không » và « chưa xem xét ». Một ô để trống không nên tự động trở thành ví dụ âm nếu không có quy tắc rõ ràng. Đây là lựa chọn sản phẩm cần thiết kế cho một bản điều chỉnh, không phải giao diện đã được cung cấp trong bản mẫu này.
Hãy trình bày cho người duyệt các lá được đề xuất và tổ tiên của chúng. Dự liệu việc cần làm với các điểm thấp và các lá mà mô hình không bao giờ đề xuất. Nút xác nhận không được che đi một danh mục bị bỏ sót chỉ vì trung bình toàn cục có vẻ tốt.
Việc đóng phân cấp bảo đảm tương thích với kế hoạch; nó không chứng nhận tính phù hợp nội dung hay quyền phân loại. Quyền truy cập và hành động có thể diễn ra trên tài liệu vẫn là các quyết định riêng. POC vẫn không di chuyển tệp và không cấp quyền nào.
Chúng ta đã học cách tách biệt văn bản có sẵn, chú thích đã biết, điểm đã học, tính nhất quán phân cấp và độ đúng được đo lường. Sự tách biệt này giúp hiểu một lỗi và quyết định điều cần cải thiện, thay vì dựa vào một điểm duy nhất.
Tài liệu tham khảo để tìm hiểu thêm
Các liên kết đến CamemBERT, bảng thuật ngữ Transformers và PyTorch làm rõ bộ mã hóa, mặt nạ, sigmoid và mất mát. Các tham chiếu scikit-learn nêu các quy ước chỉ số; chúng không khẳng định dự án gọi các hàm đó. Những ví dụ số nhỏ trong bài giải thích các phép toán và vẫn tách biệt với kết quả của tập Vesta.
Để tái tạo r001, hãy giữ các tệp và phiên bản trong ZIP. Tài liệu trực tuyến có thể thay đổi; các ví dụ chung của chúng không thay thế cấu hình đã được xác thực của hướng dẫn.
Tải khóa học r001: ZIP r001.