





Está desarrollando un back office en el que un equipo carga y clasifica documentos. Llega un informe de intervención: ¿debe archivarse en Mantenimiento, en Calidad o en ambos? Una lista desplegable de opción única ya no basta. Necesita varias etiquetas organizadas en una jerarquía.
Una GED, o gestión electrónica de documentos, puede encontrarse precisamente con este problema. Un mismo documento puede pertenecer a maintenance/interventions y a qualite/controles. También hay que respetar el plan documental: proponer qualite/controles sin incluir su padre qualite genera una sugerencia incoherente.
Entrenaremos CamemBERT con el corpus ficticio Vesta para proponer estas clasificaciones. El recorrido será: texto → representaciones numéricas → puntuaciones de categorías → propuestas compatibles con la jerarquía. El prototipo no mueve archivos ni asigna derechos de acceso. Prepara una sugerencia que debe confirmarse.
Descargar el ZIP del tutorial r001
Seguiremos el caso D-031 para inspeccionar el mecanismo. Este ejemplo procede del entrenamiento; sus anotaciones están disponibles para la explicación. Los 360 documentos de prueba se evaluarán por separado.
La principal trampa se parece a un error clásico de formulario: una casilla sin completar no significa necesariamente «no». En nuestro entrenamiento, confundir una anotación desconocida con una respuesta negativa enseñaría al modelo una información que nadie ha establecido. El ejercicio final permitirá observar las consecuencias de esta confusión.
Vocabulario y métricas antes del código
Una taxonomía: categorías y sus relaciones
Una taxonomía es aquí el plan de clasificación. Cada categoría es un nodo. Una categoría puede tener hijos: achats es el padre de achats/factures. Una categoría sin hijos es una hoja. Los antecesores de un nodo son las categorías que se encuentran al subir hacia la cima del árbol.
El proyecto incluye 12 hojas, pero el modelo también produce puntuaciones para los padres. Por tanto, hay una salida por nodo de la taxonomía, y no solo doce salidas.
La clasificación es multietiqueta: varias categorías pueden ser verdaderas para un mismo documento. Piense en varias casillas de verificación, en lugar de botones de opción que obligan a una única elección. Las hojas maintenance/interventions y qualite/controles no son necesariamente excluyentes.
La jerarquía añade una restricción: una propuesta en qualite/controles debe incluir qualite. En cambio, proponer qualite no obliga a proponer todas sus hojas. Un padre no es un atajo para marcar cada uno de sus hijos.
Del texto a los números: el papel de CamemBERT
CamemBERT es un modelo preentrenado con texto francés. Lo usamos como codificador: transforma una secuencia de texto en representaciones numéricas. No redacta una respuesta conversacional en este proyecto. La documentación de CamemBERT de Hugging Face presenta su funcionamiento y usos de clasificación.
El tokenizer primero divide el texto en unidades llamadas tokens, o fichas. Un token puede corresponder a una parte de una palabra; no necesariamente a una palabra completa. El tokenizer convierte estas unidades en identificadores y añade fichas especiales para estructurar la secuencia.
El codificador produce después un vector por posición: una lista de números que representa esa posición teniendo en cuenta el texto circundante. Estos números son características calculadas por el modelo, no categorías directamente legibles como «factura» o «control».
Preentrenado no significa que ya conozca nuestro plan de clasificación. La adaptación a partir de las anotaciones de Vesta le enseña la tarea documental buscada: es el principio del fine-tuning, o ajuste de un modelo preentrenado a una tarea. Los pesos son los parámetros numéricos ajustados durante el aprendizaje; no son una lista de documentos que consultar.
Para procesar varios documentos juntos se forma un lote, o batch. Como las secuencias no tienen todas la misma longitud, las más cortas se completan con padding, es decir, relleno. La máscara de atención indica las posiciones que deben tenerse en cuenta y las que corresponden al relleno. Las fichas especiales de la secuencia no son automáticamente padding: la máscara establece la diferencia. El glosario de Transformers detalla esta noción.
Calcular la media sin dejar que decida el relleno
Nuestro clasificador espera un vector por documento, y no un número variable de vectores. Por eso el proyecto usa un pooling enmascarado: calcula la media de las representaciones de las posiciones válidas.
Tomemos una ilustración en dos dimensiones, sin relación con una salida medida de CamemBERT. Las tres posiciones válidas tienen los vectores [2 ; 4], [4 ; 2] y [6 ; 6]. Su suma es [12 ; 12], así que su media es [4 ; 4].
Añadamos dos posiciones de relleno, representadas por [0 ; 0] para simplificar. Una media sobre las cinco posiciones daría [2,4 ; 2,4]. El contenido no ha cambiado, pero su representación quedaría reducida artificialmente. Hay que excluir el relleno de la suma y dividir por el número de posiciones válidas. En la práctica, tampoco hay que suponer que las representaciones calculadas en las posiciones de padding sean nulas.
Las tablas que manipula PyTorch se llaman tensores. Con B documentos, T posiciones por secuencia y H números por vector, las representaciones tienen la forma B × T × H. El pooling produce B × H. La cabeza de clasificación, la parte que transforma este vector en puntuaciones de categorías, produce finalmente B × K, donde K es el número total de nodos.
Un logit, una probabilidad y una decisión son tres cosas distintas
Cada salida de la cabeza es un logit: un número bruto que puede ser negativo o positivo. La sigmoide lo transforma según p = 1 / (1 + exp(-z)), donde z es el logit y exp la función exponencial. Por ejemplo, los logits -2, 0 y 2 dan respectivamente aproximadamente 0,1192, 0,5 y 0,8808. La fórmula está documentada por PyTorch para Sigmoid.
Esta transformación se aplica a cada categoría. Se puede obtener una puntuación alta para dos hojas: sus probabilidades no tienen por qué sumar 1, ya que varias pertenencias pueden ser verdaderas simultáneamente.
Después hace falta una regla de decisión para transformar estas puntuaciones en propuestas. En nuestros ejemplos numéricos se usará un umbral de 0,5, únicamente para facilitar el cálculo; no sustituye la configuración del recorrido r001. Del mismo modo, una puntuación de 0,8 no demuestra por sí sola que ocho sugerencias comparables de cada diez sean correctas.
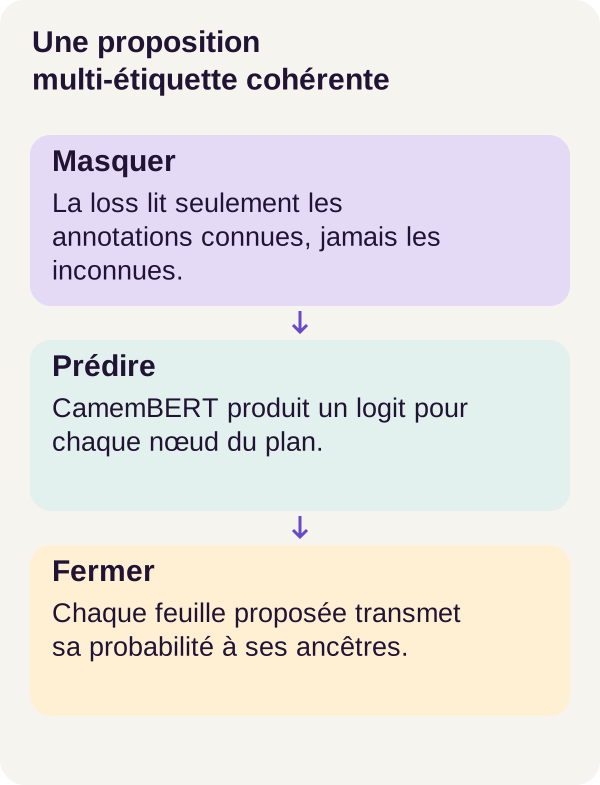
Después de las sigmoides, el cierre de antecesores eleva las puntuaciones de los hijos hacia sus padres tomando el máximo. Hace que las puntuaciones sean compatibles con la jerarquía. No modifica los logits usados para aprender ni convierte una categoría incorrecta en una correcta.
Una anotación contiene dos informaciones: su valor y el hecho de que se conoce
Una anotación indica si un documento pertenece a una categoría. En este proyecto distinguimos tres situaciones:
| Situación | Valor objetivo | ¿Se usa para aprender? |
|---|---|---|
| Pertenencia confirmada | 1 |
Sí. |
| No pertenencia confirmada | 0 |
Sí. |
| Pertenencia desconocida | Valor ignorado | No. |
Para un desarrollador web, esta distinción puede compararse con un booleano nullable: true, false y ausencia de información. Es una analogía, no la descripción de un esquema de base de datos proporcionado por el proyecto.
La función de pérdida, llamada loss en el código, mide la diferencia entre las salidas del modelo y las anotaciones conocidas. El entrenamiento ajusta los parámetros para reducir esta pérdida. Aquí usamos una entropía cruzada binaria, o BCE, únicamente en los pares documento-etiqueta realmente observados.
Atención: ahora tenemos dos máscaras diferentes. La máscara de atención se refiere a las posiciones del texto, de forma B × T. La máscara de anotaciones se refiere a las categorías conocidas, de forma B × K. Retirar una anotación de la pérdida no elimina las palabras del documento.
Medir las etiquetas y después el documento completo
Un verdadero positivo es una hoja esperada y propuesta. Un falso positivo es una hoja propuesta por error. Un falso negativo es una hoja esperada pero olvidada. La precisión mide las propuestas correctas entre las emitidas; el recall mide las pertenencias esperadas que se han recuperado.
El F1 combina precisión y recall. Con VP verdaderos positivos, FP falsos positivos y FN falsos negativos, vale 2 × VP / (2 × VP + FP + FN). El F1 micro reúne los recuentos de todas las hojas antes de este cálculo. El F1 macro calcula el F1 de cada una de las 12 hojas y luego su media sin ponderación. Estas convenciones se describen en la documentación de f1_score.
Una pequeña ilustración explica su diferencia. Supongamos solo dos hojas: la primera se recupera 90 veces de 90, sin error; la segunda se olvida diez veces de diez y nunca se propone. El F1 micro vale 180 / 190, es decir, aproximadamente 0,9474. Sin embargo, el F1 macro vale (1 + 0) / 2 = 0,5. El éxito en una categoría frecuente puede ocultar el fracaso completo en otra.
El conjunto exacto de hojas plantea una pregunta más estricta: ¿todas las hojas de este documento son correctas, sin añadidos ni omisiones? El conjunto exacto de nodos exige lo mismo para las hojas y los padres. Es una comparación de conjuntos, no de su orden de visualización; la noción de exactitud multietiqueta también se explica en scikit-learn.
Por último, la tasa de violaciones padre-hijo examina la coherencia del plan: ¿se ha propuesto un hijo sin su padre? Es deseable una tasa nula, pero una rama completamente errónea puede seguir siendo perfectamente coherente.
Preparar el recorrido con GPU
Verificar los requisitos y conservar la configuración de referencia
Debe saber utilizar Python, un terminal y Docker. PyTorch realizará los cálculos con tensores; las nociones necesarias de clasificación binaria se han introducido antes.
El perfil de referencia es Linux con una RTX 3090 de 24 Gio de memoria gráfica. Prevea también 24 Gio de RAM y 35 Gio de disco de trabajo, además del almacenamiento de Docker. Son recomendaciones de preparación, no mínimos ni consumos garantizados en cualquier máquina.
El recorrido principal utiliza tres épocas: una época corresponde a un paso por los ejemplos de entrenamiento. El ejercicio lanzará dos nuevos entrenamientos de tres épocas cada uno. La validación r001 descrita en este artículo utilizó una GPU; los comandos siguientes reproducen este recorrido, no un modo alternativo de CPU. La referencia léxica se calculará en CPU.
Los seis recursos públicos necesarios se adquieren verificando su tamaño y su huella SHA-256. Esta huella identifica el contenido esperado de un archivo. El ZIP no incluye pesos preentrenados ni repositorio privado: la descarga de recursos forma parte de la preparación.
Descomprima el archivo y sitúe el terminal en su raíz. Todos los comandos del artículo se ejecutan desde este directorio, en el orden presentado. Conserve las dependencias y la configuración configs/minimum.yaml del ZIP para reproducir r001.
Controlar el host y construir los servicios
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference
El preflight comprueba Docker, Compose, memoria, disco y GPU. El control config --quiet se completa sin mostrar texto cuando la configuración Compose es válida. Por tanto, un comando silencioso no es necesariamente un comando que no ha hecho nada.
Que una GPU sea visible con nvidia-smi en el host todavía no demuestra que un programa dentro de Docker pueda calcular con ella. El NVIDIA Container Toolkit proporciona la integración con los contenedores. El preflight indica la documentación necesaria si falta esta integración, sin modificar el sistema por usted. Para seleccionar otra tarjeta, defina GPU_DEVICE=1 antes del recorrido.
Adquirir los archivos y luego probar desde Docker
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
La adquisición controla los seis archivos antes de instalarlos de forma atómica: evita considerar un archivo parcialmente adquirido como el archivo final. A continuación, check_environment.py carga los pesos y realiza un cálculo CUDA desde el contenedor. Así verifica una capacidad real de ejecución, no solo la presencia del hardware.
Las pruebas cubren, entre otros aspectos, la máscara de anotaciones, el cierre jerárquico y los casos negativos. Un caso negativo comprueba que se rechaza una entrada no válida. No inicie el entrenamiento sorteando el fallo de estos controles: primero hay que entender su causa.
Crear los datos y hacer inspeccionable el mecanismo
Preparar Vesta y un método de comparación
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli prepare --config configs/minimum.yaml
docker compose run --rm learning python -m ged_classement_hierarchique.cli baseline --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli inspect-mechanism --config configs/minimum.yaml
prepare crea el corpus ficticio y su taxonomía. baseline ejecuta una referencia léxica, es decir, un método basado en los indicios textuales previstos por el proyecto. Esta comparación responde a una pregunta útil: ¿la red aporta algo frente a una solución más sencilla? El hecho de que el comando use el servicio learning no cambia el perfil de CPU de esta referencia.
inspect-mechanism hace inspeccionable el caso D-031. Los logits de esta demostración son ilustrativos y se señalan explícitamente como tales. Sirven para seguir el cálculo; no deben presentarse como la predicción de un modelo ya entrenado. Los pequeños cálculos añadidos más abajo también son ilustraciones independientes, no nuevas mediciones sobre D-031.
masked_bce: seleccionar antes de calcular
Veamos la protección central. logits contiene las puntuaciones brutas, targets los valores esperados y mask indica los pares documento-etiqueta conocidos.
def masked_bce(logits, targets, mask):
    if (
        logits.shape != targets.shape
        or logits.shape != mask.shape
        or mask.dtype != torch.bool
    ):
        raise ValueError("Expected matching B x labels tensors and a boolean mask")
    count = int(mask.sum())
    if count == 0:
        return None, 0
    # Index first: unknown targets may even be NaN and never enter BCE.
    selected = targets[mask]
    if (
        not torch.isfinite(selected).all()
        or not ((selected == 0) | (selected == 1)).all()
    ):
        raise ValueError("Known target is not binary")
    return (
        F.binary_cross_entropy_with_logits(logits[mask], selected, reduction="sum"),
        count,
    )
La función empieza por exigir formas idénticas para los tres tensores y una máscara de tipo torch.bool. En el recorrido, estas tablas corresponden a B × K: una fila por documento, una columna por nodo. El control mostrado compara las formas; no reconstruye la asociación entre los nombres de categorías y las columnas. Por tanto, este orden debe mantenerse coherente en las entradas.
count = int(mask.sum()) cuenta las anotaciones conocidas, positivas y negativas. No es ni el número de documentos ni el número de categorías presentes.
Cuando no se conoce ninguna anotación, la función devuelve (None, 0). Significa «ningún término supervisado que calcular», no «predicción perfecta con pérdida nula». El código que llama debe tratar este caso sin dividir por cero ni intentar una retropropagación sobre None.
La línea decisiva es selected = targets[mask]. La indexación booleana conserva solo los valores autorizados a participar en el cálculo. Los objetivos seleccionados deben ser finitos y valer exactamente 0 o 1. Un objetivo conocido igual a 0,5, por ejemplo, es rechazado por este contrato.
La llamada final recibe los logits, no su sigmoide calculada de antemano. binary_cross_entropy_with_logits combina la transformación y la pérdida de forma numéricamente estable. La documentación de PyTorch sobre BCEWithLogitsLoss explica este principio.
Con reduction="sum", la función devuelve una suma de pérdidas y el número de términos, no una media. Estas dos informaciones permiten al código que llama normalizar sobre el número de anotaciones conservadas. Para entender la normalización exacta del entrenamiento completo, hay que seguir su uso en el proyecto, no suponer que este extracto ya realiza la división.
Por qué «calcular y luego multiplicar por cero» no basta
Tomemos un documento y tres puntuaciones: los logits son [2 ; -2 ; 0], los objetivos [1 ; 0 ; NaN] y la máscara [True ; True ; False]. NaN, por Not a Number, representa aquí un valor numérico no definido situado en una casilla desconocida.
Después de la selección, los dos únicos objetivos son 1 y 0. Sus probabilidades son aproximadamente 0,8808 y 0,1192. En ambos casos, la predicción favorece la respuesta correcta. Cada pérdida vale aproximadamente 0,126928: por tanto, la función devuelve una suma de aproximadamente 0,253856 y un contador de 2. La media correspondiente sería 0,126928.
El tercer término nunca se evalúa. En cambio, calcular la BCE sobre los tres objetivos y luego multiplicar la tercera pérdida por cero no eliminaría necesariamente el problema: NaN × 0 sigue siendo NaN. El enmascaramiento debe intervenir antes de la operación que puede contaminarse.
Esta selección no fuerza la tercera puntuación a cero. Retira su contribución directa a la pérdida. Los parámetros compartidos del modelo pueden seguir evolucionando gracias a las demás anotaciones y modificar esta puntuación en una predicción posterior.
Último límite importante: la función confía en la máscara. Si una anotación desconocida se transforma en 0 y se marca como conocida antes, parece una anotación negativa válida. Ningún control de forma puede adivinar este error de significado. Eso es exactamente lo que pondrá a prueba el ejercicio.
Elevar las puntuaciones sin marcar toda una rama
Después del aprendizaje llega la inferencia, el cálculo de las predicciones con el modelo entrenado. El cierre se aplica solo en esta etapa.
Imaginemos las siguientes puntuaciones, con un umbral común de 0,5 elegido únicamente para la ilustración:
| Nodo | Puntuación antes del cierre | Puntuación después del cierre |
|---|---|---|
qualite |
0,2 | 0,8 |
qualite/controles |
0,8 | 0,8 |
qualite/audits |
0,1 | 0,1 |
Antes del cierre, el control se propondría sin su padre. El programa eleva su puntuación hacia qualite, que pasa a 0,8. No cambia qualite/audits: pertenecer a la rama Calidad no implica pertenecer a una auditoría.
Este es el bucle exacto del proyecto. Es un extracto del cuerpo de la función: el return final pertenece a esta función en el código completo.
for node in reversed(topological_order(parents)):
    parent = parents[node]
    if parent is not None:
        output[..., parent] = torch.maximum(output[..., parent], output[..., node])
return output
Un orden topológico coloca a los padres antes que a sus hijos. reversed(...) invierte este orden para tratar primero los descendientes. Para cada nodo, parents[node] encuentra a su padre; None indica que no lo tiene.
La notación output[..., parent] selecciona el padre en la última dimensión del tensor, conservando al mismo tiempo las dimensiones anteriores, incluidos los documentos del lote. torch.maximum compara las dos puntuaciones elemento a elemento. Por tanto, el padre conserva el mayor valor entre su propia puntuación y la del hijo.
¿Por qué empezar por abajo? Tomemos una cadena abstracta cima → rama → hoja, con puntuaciones 0,1, 0,2 y 0,9. Al subir desde la hoja, la rama pasa a 0,9 y después la cima también. Si se recorriera una sola vez en el otro sentido, la cima recibiría primero solo 0,2, antes de que la rama hubiera recuperado el 0,9 de su hoja.
El cierre no disminuye ninguna puntuación ni modifica las de las hojas. Cuando todos los antecesores se han actualizado, repetirlo ya no cambia el resultado. Tampoco calcula la suma de las probabilidades de los hijos: dos puntuaciones de 0,8 no dan un padre en 1,6.
Este mecanismo impone coherencia, no una calibración de las probabilidades. Con un umbral común, un hijo retenido arrastra a sus padres porque sus puntuaciones son al menos igual de altas. Para una extensión que use umbrales distintos por categoría, esta garantía deberá comprobarse de nuevo: un padre en 0,8 con un umbral de 0,9 se rechazaría, aunque su hijo en 0,8 supere un umbral de 0,5. Este ejemplo no describe una modificación del recorrido r001.
Entrenar, reanudar, predecir y medir
Distinguir aprendizaje, reanudación y evaluación
Los datos de entrenamiento sirven para ajustar los parámetros. La validación sirve para controlar las decisiones de desarrollo sin utilizar la prueba. La prueba describe el comportamiento final sobre los documentos reservados para la medición.
El recorrido también separa los roles de los contenedores: learning dispone de las anotaciones de entrenamiento y validación necesarias para aprender; inference no monta ninguna anotación. La evaluación, realizada por separado, puede después comparar las predicciones con las referencias de los 360 documentos de prueba.
docker compose run --rm learning python -m ged_classement_hierarchique.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_classement_hierarchique.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_classement_hierarchique.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_classement_hierarchique.cli verify-resume --config configs/minimum.yaml
El modo interrupt produce un recorrido interrumpido. continuous realiza la referencia continua a partir de los mismos datos. resume reanuda el estado interrumpido y después verify-resume compara el estado obtenido con el de la referencia.
Un checkpoint es un estado guardado que permite continuar un cálculo. Por tanto, reanudar no significa partir de una nueva inicialización ni reiniciar arbitrariamente tres épocas adicionales. El objetivo del control es verificar el procedimiento de reanudación. Por sí solo no mide la calidad de las clasificaciones.
Produzcamos ahora las sugerencias y después las mediciones:
docker compose run --rm inference python -m ged_classement_hierarchique.cli predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli evaluate --config configs/minimum.yaml
La predicción principal llega antes de la evaluación. Consulte las propuestas y outputs/evaluation.json: una media global no basta para explicar una hoja añadida u olvidada en un documento determinado.
Los resultados del recorrido principal
Estos son los resultados publicados para los 360 documentos de prueba:
| Medida | Resultado |
|---|---|
| F1 micro de las hojas | 0,95658 |
| F1 macro de las 12 hojas | 0,95619 |
| Documentos cuyo conjunto de hojas es exacto | 306 / 360 |
| Documentos cuyo conjunto de todos los nodos es exacto | 195 / 360 |
| Falsos negativos de hojas | 26 |
| Falsos positivos de hojas | 37 |
| Violaciones padre-hijo después del cierre | 0 |
En esta prueba, el cierre no modifica las métricas respecto a las salidas brutas. La tasa de violaciones sigue siendo nula. El mecanismo es útil para definir la coherencia esperada, pero este experimento no demuestra una mejora de calidad gracias a su aplicación.
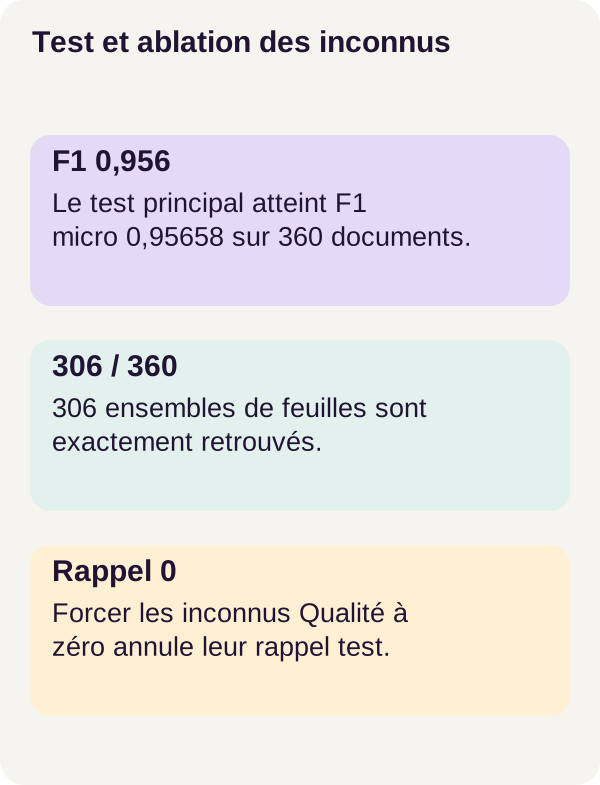
Los recuentos de conjuntos exactos ofrecen otra lectura: 306 / 360 corresponde al 85 % de documentos con hojas completamente correctas, frente a aproximadamente 54,17 % para el conjunto completo de nodos. Estos porcentajes se calculan a partir de los recuentos publicados; no son mediciones adicionales.
¿Por qué pueden diferir las dos exactitudes? La red también produce puntuaciones para los padres. En un ejemplo ilustrativo, todas las hojas de un documento pueden ser correctas, pero el padre achats puede proponerse de más. El cierre no elimina este padre, porque solo eleva puntuaciones. La sugerencia puede entonces no tener ninguna violación y aun así incluir una categoría innecesaria.
Este ejemplo muestra una posibilidad del mecanismo. Las cifras agregadas no permiten por sí solas atribuir cada error del corpus a este caso concreto: hay que examinar las salidas documento por documento.
Observar las hojas difíciles y la referencia sencilla
Los dos F1 globales son cercanos, pero eso no significa que todas las hojas se comporten igual. achats/factures es la más frágil: su F1 vale 0,82759, con 12 falsos negativos y 8 falsos positivos. achats/fournisseurs obtiene 0,89320. qualite/audits alcanza 0,90647, pero cuenta con 13 falsos positivos.
La rama Calidad no omite ninguna hoja esperada en la prueba principal; sin embargo, añade 17 falsos positivos. Un recall perfecto puede acompañarse de categorías sugeridas por error.
Por último, la baseline léxica obtiene 1,00 en este corpus sintético de patrones explícitos. Sería engañoso concluir que CamemBERT es necesario para estos datos. El tutorial permite estudiar el aprendizaje con anotaciones parciales y la jerarquía; no demuestra ni la superioridad del modelo frente a esta referencia ni una transferencia automática a una GED real.
Ejercicio: predecir el efecto de las anotaciones ocultas
Formular la hipótesis antes de ejecutar los comandos
Vamos a ocultar el 40 % de las anotaciones conocidas de la rama Calidad en el entrenamiento, sin cambiar la validación ni la prueba. Se trata de pares documento-etiqueta, no del 40 % de los textos eliminados ni necesariamente del 40 % de las anotaciones positivas solamente.
Tómese un momento para prever el resultado. Si estas informaciones pasan a ser desconocidas, ¿hay que seguir penalizando al modelo cuando sugiere una hoja de Calidad? ¿Qué ocurriría si le dijéramos por error que todas estas pertenencias son negativas? ¿Esperaría más omisiones, más añadidos o ambos?
El experimento compara dos modelos nuevos, procedentes del mismo modelo inicial y que usan los mismos identificadores. exercise-correct retira los términos desconocidos de la pérdida. exercise-wrong los transforma en objetivos negativos iguales a cero. Cada variante se entrena durante tres épocas.
No es un cambio aplicado solo a las puntuaciones después del entrenamiento: los dos modelos aprenden con supervisiones distintas. El recorrido también comprueba que la evaluación principal siga sin cambios, para no confundir el ejercicio con el resultado r001 inicial.
docker compose run --rm learning python -m ged_classement_hierarchique.cli exercise --config configs/minimum.yaml
docker compose run --rm inference python -m ged_classement_hierarchique.cli predict --config configs/minimum.yaml --variant exercise-correct
docker compose run --rm inference python -m ged_classement_hierarchique.cli predict --config configs/minimum.yaml --variant exercise-wrong
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli evaluate-exercise --config configs/minimum.yaml
Comprender en qué sentido un objetivo incorrecto empuja el modelo
Retomemos una ilustración independiente de las mediciones: una puntuación de probabilidad p = 0,8 para una categoría realmente presente. Con el objetivo correcto y = 1, la BCE vale -ln(0,8), aproximadamente 0,2231. Al reemplazar el objetivo por y = 0, pasa a ser -ln(0,2), aproximadamente 1,6094. ln designa el logaritmo natural. El modelo recibe entonces una fuerte penalización por haber favorecido una pertenencia que sí es real.
Podemos avanzar un paso con el gradiente: indica cómo varía la pérdida cuando se modifica una puntuación o un parámetro. Para esta BCE, la derivada respecto al logit vale p - y. Con el objetivo correcto vale -0,2; con el objetivo negativo falso vale 0,8.
En un razonamiento en el que se ajusta directamente este logit para disminuir la pérdida, el primer caso lo empuja hacia arriba y el segundo hacia abajo. Las actualizaciones de una red compartida son más complejas, pero este ejemplo explica el sentido de la señal errónea. Enmascarar el objetivo desconocido elimina esta señal; no revela la verdad que falta.
Comparar con los resultados observados
La corrección del recorrido confirma la disminución de los logits de Calidad cuando los desconocidos se convierten en negativos. En la prueba sin cambios:
| Medida | Máscara correcta | Desconocidos forzados a cero |
|---|---|---|
| Recall de las hojas de Calidad | 0,59149 | 0 |
| Falsos negativos de Calidad | 96 | 235 |
| F1 macro de todas las hojas de la prueba | 0,85430 | 0,65244 |
Con la máscara correcta, el modelo recupera 139 verdaderos positivos, omite 96 pertenencias y produce 92 falsos positivos en las hojas de Calidad. El recall se obtiene directamente: 139 / (139 + 96) = 139 / 235, es decir, aproximadamente 0,59149.
Las 235 hojas de Calidad esperadas designan aquí 235 pertenencias positivas documento-hoja, no 235 categorías distintas ni necesariamente 235 documentos diferentes. Con la política errónea, todas se convierten en falsos negativos: el recall de esta rama cae a cero.
¿Por qué el F1 macro global se mantiene en 0,65244 en lugar de caer a cero? Porque cubre las 12 hojas, no solo las de Calidad. El éxito en otras categorías puede conservar una media no nula aunque una rama se omita por completo.
La máscara correcta también es peor que el modelo principal: 0,85430 de F1 macro frente a 0,95619. Ha perdido información supervisada. Evita fabricar negativos, pero no recupera las anotaciones ocultas. No se esperaba ninguna subida de F1 de esta eliminación.
La lección es, por tanto, precisa: conservar lo desconocido protege el significado de los datos de entrenamiento; no reemplaza la información ausente.
Producir las figuras y limpiar sin perder las pruebas
Relacionar las medias con los ejemplos
Genere las figuras a partir de los resultados ya calculados y luego compruebe los hitos pedagógicos:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Las figuras representan los resultados existentes; no constituyen nuevos ensayos. El control de hitos verifica el material pedagógico. Consulte los PNG, outputs/evaluation.json y outputs/exercise-comparison.json antes de borrar nada.
Vuelva también a D-031: explica el mecanismo con un ejemplo procedente del entrenamiento. Su legibilidad no sustituye las mediciones de los 360 documentos separados. Para juzgar la clasificación, observe las propuestas erróneas además de los casos logrados.
Limpiar únicamente las salidas del recorrido
Copie las métricas y figuras que quiera conservar antes de estos comandos. El orden siguiente forma parte del recorrido: la primera parada precede a la limpieza; la última vuelve a dejar el proyecto detenido después de ejecutar el contenedor de limpieza.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
clean --outputs-only muestra y luego elimina únicamente las salidas. El corpus, el modelo y los checkpoints se conservan. Esta limpieza dirigida no requiere una purga global de Docker ni borrar recursos de otros proyectos.
En caso de problema
¿La GPU es visible en el host, pero el cálculo falla en Docker? Vuelva al preflight y a check_environment.py. El segundo control verifica el acceso efectivo desde el contenedor; el primero no lo sustituye.
¿Se rechaza un objetivo o la pérdida no se puede usar? Verifique la correspondencia de las formas, el tipo booleano de la máscara y los valores de las anotaciones conocidas solamente. No sustituya los desconocidos por cero para ocultar el problema. Un contador nulo requiere tratar el lote sin supervisión, no calcular una media a la fuerza.
¿La jerarquía parece correcta, pero la clasificación es mala? Examine las hojas añadidas u omitidas, los padres de más y los errores por categoría. La ausencia de violación no prueba la pertinencia del contenido. Compruebe también que cada columna siga correspondiendo al mismo nodo de la taxonomía.
Pasar del prototipo a una aplicación útil
Empiece por una taxonomía versionada, anotaciones auditadas y una evaluación separada por servicio, idioma y tipo documental. Una nueva categoría o una reorganización de rama cambia el contrato de clasificación: hay que mantener la correspondencia entre los datos, las salidas y la versión del plan.
Para la anotación, distinga en la interfaz entre «sí», «no» y «no examinado». Una casilla vacía no debería convertirse automáticamente en un ejemplo negativo sin una regla explícita. Es una decisión de producto que debe diseñarse para una adaptación, no una interfaz ya entregada en este prototipo.
Presente al revisor las hojas propuestas y sus antecesores. Prevea qué debe ocurrir con las puntuaciones bajas y con las hojas que el modelo nunca propone. Un botón de confirmación no debe ocultar una categoría omitida solo porque la media global parezca buena.
El cierre jerárquico garantiza compatibilidad con el plan; no certifica ni la pertinencia del contenido ni los derechos de clasificación. Las autorizaciones de acceso y una posible acción sobre el documento siguen siendo decisiones separadas. El POC sigue sin mover ningún archivo ni conceder ningún derecho.
Hemos aprendido a separar el texto disponible, las anotaciones conocidas, las puntuaciones aprendidas, la coherencia jerárquica y la corrección medida. Esta separación permite comprender un error y decidir qué mejorar, en lugar de confiar en una puntuación única.
Referencias para profundizar
Los enlaces a CamemBERT, el glosario de Transformers y PyTorch aclaran la codificación, las máscaras, la sigmoide y la pérdida. Las referencias de scikit-learn precisan las convenciones de métricas; no afirman que el proyecto llame a estas funciones. Los pequeños ejemplos numéricos del artículo explican las operaciones y siguen siendo distintos de los resultados del corpus Vesta.
Para reproducir r001, conserve los archivos y las versiones del ZIP. Las documentaciones en línea pueden evolucionar; sus ejemplos genéricos no sustituyen la configuración validada del tutorial.
Descargue el curso r001: ZIP r001.