





State sviluppando un back office in cui un team deposita e classifica documenti. Arriva un rapporto di intervento: va archiviato in Manutenzione, in Qualità o in entrambe? Un menu a discesa a scelta singola non basta più. Servono più etichette, organizzate in una struttura ad albero.
Una GED, ossia gestione elettronica dei documenti, può incontrare proprio questo problema. Lo stesso documento può appartenere a maintenance/interventions e a qualite/controles. Occorre inoltre rispettare il piano documentale: proporre qualite/controles senza includere il suo padre qualite produce un suggerimento incoerente.
Addestreremo CamemBERT sul corpus fittizio Vesta per proporre queste classificazioni. Il percorso sarà: testo → rappresentazioni numeriche → punteggi delle categorie → proposte compatibili con la gerarchia. Il prototipo non sposta alcun file e non assegna diritti di accesso. Prepara un suggerimento da confermare.
Scaricare lo ZIP del tutorial r001
Seguiremo il caso D-031 per esaminare il meccanismo. Questo esempio proviene dall'addestramento; le sue annotazioni sono accessibili per la spiegazione. I 360 documenti di test saranno valutati separatamente.
La trappola principale assomiglia a un classico errore di modulo: una casella non compilata non significa necessariamente «no». Nel nostro addestramento, confondere un'annotazione sconosciuta con una risposta negativa insegnerebbe al modello un'informazione che nessuno ha stabilito. L'esercizio finale permetterà di osservare le conseguenze di questa confusione.
Vocabolario e metriche prima del codice
Una tassonomia: categorie e legami
Una tassonomia è qui il piano di classificazione. Ogni categoria è un nodo. Una categoria può avere figli: achats è il padre di achats/factures. Una categoria senza figli è una foglia. Gli antenati di un nodo sono le categorie che si incontrano risalendo verso la sommità dell'albero.
Il progetto comprende 12 foglie, ma il modello produce punteggi anche per i nodi padre. C'è quindi un output per ogni nodo della tassonomia, non soltanto dodici output.
La classificazione è multi-etichetta: più categorie possono essere vere per lo stesso documento. Pensate a più caselle di controllo anziché a pulsanti radio che impongono una scelta unica. Le foglie maintenance/interventions e qualite/controles non sono necessariamente in concorrenza.
La gerarchia aggiunge un vincolo: una proposta in qualite/controles deve includere qualite. Al contrario, proporre qualite non obbliga a proporre tutte le sue foglie. Un padre non è una scorciatoia per selezionare ciascuno dei suoi figli.
Dal testo ai numeri: il ruolo di CamemBERT
CamemBERT è un modello preaddestrato su testo francese. Lo usiamo come codificatore: trasforma una sequenza di testo in rappresentazioni numeriche. In questo progetto non redige una risposta conversazionale. La documentazione di CamemBERT su Hugging Face ne presenta il funzionamento e gli usi per la classificazione.
Il tokenizer scompone anzitutto il testo in unità chiamate token, o gettoni. Un token può corrispondere a una parte di parola; non è necessariamente una parola intera. Il tokenizer converte queste unità in identificatori e aggiunge token speciali per strutturare la sequenza.
Il codificatore produce poi un vettore per posizione: un elenco di numeri che rappresenta quella posizione tenendo conto del testo circostante. Questi numeri sono caratteristiche calcolate dal modello, non categorie direttamente leggibili come «fattura» o «controllo».
Preaddestrato non significa che conosca già il nostro piano di classificazione. L'adattamento a partire dalle annotazioni Vesta gli insegna il compito documentale previsto: è il principio del fine-tuning, ossia l'adattamento di un modello preaddestrato a un compito. I pesi sono i parametri numerici regolati durante l'addestramento; non sono un elenco di documenti da consultare.
Per trattare più documenti insieme si forma un lotto, o batch. Poiché le sequenze non hanno tutte la stessa lunghezza, le più corte vengono completate con il padding, cioè il riempimento. La maschera di attenzione indica le posizioni da prendere in considerazione e quelle che corrispondono al riempimento. I token speciali della sequenza non sono automaticamente padding: è la maschera a fare la distinzione. Il glossario di Transformers dettaglia questa nozione.
Fare la media senza lasciare che sia il riempimento a decidere
Il nostro classificatore si aspetta un vettore per documento, non un numero variabile di vettori. Il progetto usa quindi un pooling mascherato: calcola la media delle rappresentazioni delle posizioni valide.
Prendiamo un'illustrazione in due dimensioni, senza relazione con un output misurato di CamemBERT. Le tre posizioni valide hanno vettori [2 ; 4], [4 ; 2] e [6 ; 6]. La loro somma è [12 ; 12], quindi la loro media è [4 ; 4].
Aggiungiamo due posizioni di riempimento, rappresentate da [0 ; 0] per semplificare. Una media sulle cinque posizioni darebbe [2,4 ; 2,4]. Il contenuto non è cambiato, ma la sua rappresentazione sarebbe ridotta artificialmente. Bisogna escludere il riempimento dalla somma e dividere per il numero di posizioni valide. In pratica, non bisogna nemmeno supporre che le rappresentazioni calcolate nelle posizioni di padding siano nulle.
Le tabelle manipolate da PyTorch sono chiamate tensori. Con B documenti, T posizioni per sequenza e H numeri per vettore, le rappresentazioni hanno forma B × T × H. Il pooling fornisce B × H. La testa di classificazione, la parte che trasforma questo vettore in punteggi di categoria, produce infine B × K, dove K è il numero totale di nodi.
Un logit, una probabilità e una decisione sono tre cose diverse
Ogni uscita della testa è un logit: un numero grezzo che può essere negativo o positivo. La sigmoide lo trasforma secondo p = 1 / (1 + exp(-z)), dove z è il logit ed exp la funzione esponenziale. Per esempio, i logit -2, 0 e 2 danno rispettivamente circa 0,1192, 0,5 e 0,8808. La formula è documentata da PyTorch per Sigmoid.
Questa trasformazione viene applicata a ogni categoria. Si può ottenere un punteggio elevato per due foglie: le loro probabilità non devono sommare a 1, poiché più appartenenze possono essere vere simultaneamente.
Serve poi una regola decisionale per trasformare questi punteggi in proposte. Una soglia di 0,5 sarà usata nei nostri esempi numerici, soltanto per facilitare il calcolo; non sostituisce la configurazione del percorso r001. Allo stesso modo, un punteggio di 0,8 non dimostra da solo che otto suggerimenti comparabili su dieci saranno corretti.
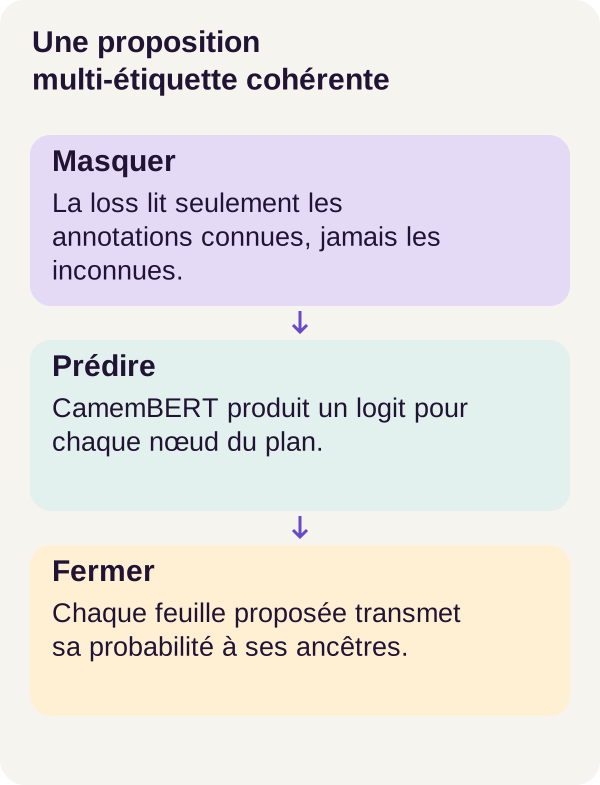
Dopo le sigmoidi, la chiusura degli antenati fa risalire i punteggi dei figli ai padri prendendo il massimo. Rende i punteggi compatibili con la gerarchia. Non modifica i logit usati per apprendere e non trasforma una categoria sbagliata in una categoria corretta.
Un'annotazione contiene due informazioni: il suo valore e il fatto che sia nota
Un'annotazione indica se un documento appartiene a una categoria. In questo progetto si distinguono tre situazioni:
| Situazione | Valore target | Usata per apprendere? |
|---|---|---|
| Appartenenza confermata | 1 |
Sì. |
| Non appartenenza confermata | 0 |
Sì. |
| Appartenenza sconosciuta | Valore ignorato | No. |
Per uno sviluppatore web, questa distinzione può essere avvicinata a un booleano nullable: true, false e assenza di informazione. È un'analogia, non la descrizione di uno schema di database fornito dal progetto.
La funzione di perdita, chiamata loss nel codice, misura lo scarto tra gli output del modello e le annotazioni note. L'addestramento regola i parametri per ridurre questa perdita. Qui usiamo un'entropia incrociata binaria, o BCE, soltanto sulle coppie documento–etichetta effettivamente osservate.
Attenzione: ora abbiamo due maschere diverse. La maschera di attenzione riguarda le posizioni del testo, di forma B × T. La maschera delle annotazioni riguarda le categorie note, di forma B × K. Rimuovere un'annotazione dalla perdita non elimina le parole del documento.
Misurare le etichette, poi il documento intero
Un vero positivo è una foglia attesa e proposta. Un falso positivo è una foglia proposta erroneamente. Un falso negativo è una foglia attesa ma dimenticata. La precisione misura le proposte corrette tra quelle emesse; il richiamo misura le appartenenze attese che sono state ritrovate.
L'F1 combina precisione e richiamo. Con VP veri positivi, FP falsi positivi e FN falsi negativi, vale 2 × VP / (2 × VP + FP + FN). L'F1 micro riunisce i conteggi di tutte le foglie prima di questo calcolo. L'F1 macro calcola l'F1 di ciascuna delle 12 foglie, poi la loro media senza ponderazione. Queste convenzioni sono descritte nella documentazione di f1_score.
Una piccola illustrazione spiega la differenza. Supponiamo solo due foglie: la prima viene ritrovata 90 volte su 90, senza errori; la seconda viene dimenticata dieci volte su dieci e non è mai proposta. L'F1 micro vale 180 / 190, cioè circa 0,9474. L'F1 macro vale tuttavia (1 + 0) / 2 = 0,5. Il successo su una categoria frequente può quindi nascondere il fallimento completo di un'altra.
L'insieme esatto delle foglie pone una domanda più rigorosa: tutte le foglie di questo documento sono corrette, senza aggiunte né omissioni? L'insieme esatto dei nodi richiede la stessa cosa per le foglie e i padri. È un confronto di insiemi, non del loro ordine di visualizzazione; la nozione di accuratezza multi-etichetta è spiegata anche da scikit-learn.
Infine, il tasso di violazioni padre–figlio esamina la coerenza del piano: un figlio è stato proposto senza il suo padre? Un tasso nullo è auspicabile, ma un intero ramo errato può rimanere perfettamente coerente.
Preparare il percorso GPU
Verificare i prerequisiti e mantenere la configurazione di riferimento
Dovete saper usare Python, un terminale e Docker. PyTorch eseguirà i calcoli sui tensori; sono state appena introdotte le nozioni necessarie di classificazione binaria.
Il profilo di riferimento è Linux con una RTX 3090 e 24 GiB di memoria grafica. Prevedete anche 24 GiB di RAM e 35 GiB di spazio di lavoro su disco, oltre allo spazio di archiviazione Docker. Sono raccomandazioni di preparazione, non minimi né consumi garantiti su ogni macchina.
Il percorso principale usa tre epoche: un'epoca corrisponde a un passaggio sugli esempi di addestramento. L'esercizio avvierà due nuovi addestramenti di tre epoche ciascuno. La validazione r001 descritta in questo articolo ha usato una GPU; i comandi seguenti riproducono questo percorso, non una modalità CPU alternativa. Il riferimento lessicale sarà invece calcolato su CPU.
Le sei risorse pubbliche necessarie vengono acquisite verificandone dimensione e impronta SHA-256. Questa impronta identifica il contenuto atteso di un file. Nello ZIP non sono inclusi né pesi preaddestrati né un repository privato: il download delle risorse fa parte della preparazione.
Decomprimete l'archivio e collocate il terminale nella sua radice. Tutti i comandi dell'articolo vanno eseguiti da questa directory, nell'ordine presentato. Conservate le dipendenze e la configurazione configs/minimum.yaml dello ZIP per riprodurre r001.
Controllare l'host e costruire i servizi
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference
Il preflight verifica Docker, Compose, memoria, disco e GPU. Il controllo config --quiet riesce senza mostrare testo quando la configurazione Compose è valida. Un comando silenzioso non è quindi necessariamente un comando che non ha fatto nulla.
Una GPU visibile con nvidia-smi sull'host non dimostra ancora che un programma in Docker possa calcolarci sopra. Il NVIDIA Container Toolkit fornisce l'integrazione con i container. Il preflight indica la documentazione necessaria se manca questa integrazione, senza modificare il sistema al posto vostro. Per selezionare un'altra scheda, definite GPU_DEVICE=1 prima del percorso.
Acquisire i file, quindi testare da Docker
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
L'acquisizione controlla i sei file prima della loro installazione atomica: evita di considerare un file acquisito parzialmente come file finale. check_environment.py carica poi i pesi ed esegue un calcolo CUDA dal container. Verifica così una capacità reale di esecuzione, non solo la presenza dell'hardware.
I test coprono in particolare la maschera delle annotazioni, la chiusura gerarchica e i casi negativi. Un caso negativo verifica che un input non valido venga rifiutato. Non iniziate l'addestramento aggirando il fallimento di questi controlli: occorre prima comprenderne la causa.
Creare i dati e rendere il meccanismo ispezionabile
Preparare Vesta e un metodo di confronto
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli prepare --config configs/minimum.yaml
docker compose run --rm learning python -m ged_classement_hierarchique.cli baseline --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli inspect-mechanism --config configs/minimum.yaml
prepare crea il corpus fittizio e la sua tassonomia. baseline esegue un riferimento lessicale, cioè un metodo basato sugli indizi testuali previsti dal progetto. Questo confronto risponde a una domanda utile: la rete apporta qualcosa rispetto a una soluzione più semplice? Il fatto che il comando usi il servizio learning non cambia il profilo CPU di questo riferimento.
inspect-mechanism rende ispezionabile il caso D-031. I logit di questa dimostrazione sono illustrativi, esplicitamente indicati come tali. Servono a seguire il calcolo; non devono essere presentati come la predizione di un modello già addestrato. Anche i piccoli calcoli aggiunti sotto sono illustrazioni indipendenti, non nuove misure su D-031.
masked_bce: selezionare prima di calcolare
Osserviamo la protezione centrale. logits contiene i punteggi grezzi, targets i valori attesi e mask indica le coppie documento–etichetta note.
def masked_bce(logits, targets, mask):
    if (
        logits.shape != targets.shape
        or logits.shape != mask.shape
        or mask.dtype != torch.bool
    ):
        raise ValueError("Expected matching B x labels tensors and a boolean mask")
    count = int(mask.sum())
    if count == 0:
        return None, 0
    # Index first: unknown targets may even be NaN and never enter BCE.
    selected = targets[mask]
    if (
        not torch.isfinite(selected).all()
        or not ((selected == 0) | (selected == 1)).all()
    ):
        raise ValueError("Known target is not binary")
    return (
        F.binary_cross_entropy_with_logits(logits[mask], selected, reduction="sum"),
        count,
    )
La funzione inizia richiedendo forme identiche per i tre tensori e una maschera di tipo torch.bool. Nel percorso, queste tabelle corrispondono a B × K: una riga per documento, una colonna per nodo. Il controllo mostrato confronta le forme; non ricostruisce l'associazione tra nomi delle categorie e colonne. Questo ordine deve quindi rimanere coerente negli input.
count = int(mask.sum()) conta le annotazioni note, positive e negative. Non è né il numero di documenti né il numero di categorie presenti.
Quando nessuna annotazione è nota, la funzione restituisce (None, 0). Significa «nessun termine supervisionato da calcolare», non «predizione perfetta con perdita nulla». Il codice chiamante deve gestire questo caso senza dividere per zero né tentare una retropropagazione su None.
La riga decisiva è selected = targets[mask]. L'indicizzazione booleana conserva solo i valori autorizzati a partecipare al calcolo. I target selezionati devono essere finiti e valere esattamente 0 o 1. Un target noto pari a 0,5, per esempio, viene rifiutato da questo contratto.
La chiamata finale riceve i logit, non la loro sigmoide calcolata in anticipo. binary_cross_entropy_with_logits combina la trasformazione e la perdita in modo numericamente stabile. La documentazione PyTorch di BCEWithLogitsLoss spiega questo principio.
Con reduction="sum", la funzione restituisce una somma di perdite e il numero di termini, non una media. Queste due informazioni consentono al codice chiamante di normalizzare sul numero di annotazioni mantenute. Per comprendere la normalizzazione esatta dell'addestramento completo, bisogna seguirne l'uso nel progetto, senza supporre che questo estratto esegua già la divisione.
Perché «calcolare poi moltiplicare per zero» non basta
Prendiamo un documento e tre punteggi: i logit sono [2 ; -2 ; 0], i target [1 ; 0 ; NaN] e la maschera [True ; True ; False]. NaN, da Not a Number, rappresenta qui un valore numerico non definito collocato in una casella sconosciuta.
Dopo la selezione, gli unici due target sono 1 e 0. Le loro probabilità sono circa 0,8808 e 0,1192. In entrambi i casi, la predizione favorisce la risposta giusta. Ogni perdita vale circa 0,126928: la funzione restituisce dunque una somma di circa 0,253856 e un contatore pari a 2. La media corrispondente sarebbe 0,126928.
Il terzo termine non viene mai valutato. Al contrario, calcolare la BCE sui tre target e poi moltiplicare la terza perdita per zero non eliminerebbe necessariamente il problema: NaN × 0 resta NaN. Il mascheramento deve intervenire prima dell'operazione che può essere contaminata.
Questa selezione non forza il terzo punteggio a zero. Rimuove il suo contributo diretto alla perdita. I parametri condivisi del modello possono comunque evolvere grazie alle altre annotazioni e modificare questo punteggio in una predizione successiva.
Ultimo limite importante: la funzione si fida della maschera. Se un'annotazione sconosciuta viene trasformata in 0 e contrassegnata come nota a monte, assomiglia a una valida annotazione negativa. Nessun controllo di forma può indovinare questo errore di significato. È esattamente ciò che l'esercizio metterà alla prova.
Far risalire i punteggi, senza selezionare un intero ramo
Dopo l'addestramento arriva l'inferenza, il calcolo delle predizioni con il modello addestrato. La chiusura si applica solo in questa fase.
Immaginiamo i seguenti punteggi, con una soglia comune di 0,5 scelta soltanto per l'illustrazione:
| Nodo | Punteggio prima della chiusura | Punteggio dopo la chiusura |
|---|---|---|
qualite |
0,2 | 0,8 |
qualite/controles |
0,8 | 0,8 |
qualite/audits |
0,1 | 0,1 |
Prima della chiusura, il controllo sarebbe proposto senza il suo padre. Il programma ne fa risalire il punteggio verso qualite, che passa a 0,8. Non modifica qualite/audits: appartenere al ramo Qualità non implica rientrare in un audit.
Ecco il ciclo esatto del progetto. Si tratta di un estratto del corpo della funzione: il return finale appartiene a questa funzione nel codice completo.
for node in reversed(topological_order(parents)):
    parent = parents[node]
    if parent is not None:
        output[..., parent] = torch.maximum(output[..., parent], output[..., node])
return output
Un ordine topologico colloca i padri prima dei figli. reversed(...) inverte questo ordine per trattare prima i discendenti. Per ogni nodo, parents[node] ritrova il suo padre; None indica che non ne ha.
La notazione output[..., parent] seleziona il padre sull'ultima dimensione del tensore, conservando al contempo le dimensioni precedenti, in particolare i documenti del lotto. torch.maximum confronta i due punteggi elemento per elemento. Il padre conserva quindi il maggiore tra il proprio punteggio e quello del figlio.
Perché iniziare dal basso? Prendiamo una catena astratta cima → ramo → foglia, con punteggi 0,1, 0,2 e 0,9. Risalendo dalla foglia, il ramo passa a 0,9, poi anche la cima. Percorrendo una sola volta nell'altro senso, la cima riceverebbe dapprima solo 0,2, prima che il ramo abbia recuperato il 0,9 della sua foglia.
La chiusura non diminuisce alcun punteggio e non modifica quelli delle foglie. Una volta aggiornati tutti gli antenati, rifarla non cambia più il risultato. Non calcola nemmeno la somma delle probabilità dei figli: due punteggi di 0,8 non danno un padre a 1,6.
Questo meccanismo impone coerenza, non una calibrazione delle probabilità. Con una soglia comune, un figlio mantenuto trascina con sé i suoi padri poiché i loro punteggi sono almeno altrettanto alti. Per un'estensione che usi soglie diverse per categoria, questa garanzia dovrà essere riverificata: un padre a 0,8 con soglia 0,9 sarebbe rifiutato, anche se il figlio a 0,8 supera una soglia di 0,5. Questo esempio non descrive una modifica del percorso r001.
Addestrare, riprendere, predire e misurare
Distinguere addestramento, ripresa e valutazione
I dati di addestramento servono a regolare i parametri. La validazione serve a controllare le scelte di sviluppo senza usare il test. Il test descrive il comportamento finale sui documenti riservati alla misura.
Il percorso separa anche i ruoli dei container: learning dispone delle annotazioni di addestramento e validazione necessarie all'apprendimento; inference non monta alcuna annotazione. La valutazione, eseguita separatamente, può poi confrontare le predizioni con i riferimenti dei 360 documenti di test.
docker compose run --rm learning python -m ged_classement_hierarchique.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_classement_hierarchique.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_classement_hierarchique.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_classement_hierarchique.cli verify-resume --config configs/minimum.yaml
La modalità interrupt produce un percorso interrotto. continuous realizza il riferimento continuo a partire dagli stessi dati. resume riprende lo stato interrotto, poi verify-resume confronta lo stato ottenuto con quello del riferimento.
Un checkpoint è uno stato salvato che permette di proseguire un calcolo. Riprendere non significa quindi partire da una nuova inizializzazione né ricominciare arbitrariamente tre epoche supplementari. L'obiettivo del controllo è verificare la procedura di ripresa. Non misura da solo la qualità delle classificazioni.
Produciamo ora i suggerimenti, poi le misure:
docker compose run --rm inference python -m ged_classement_hierarchique.cli predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli evaluate --config configs/minimum.yaml
La predizione principale viene prima della valutazione. Consultate le proposte e outputs/evaluation.json: una media globale non basta a spiegare una foglia aggiunta o dimenticata in un dato documento.
I risultati del percorso principale
Ecco i risultati pubblicati per i 360 documenti di test:
| Misura | Risultato |
|---|---|
| F1 micro delle foglie | 0,95658 |
| F1 macro delle 12 foglie | 0,95619 |
| Documenti con insieme di foglie esatto | 306 / 360 |
| Documenti con insieme di tutti i nodi esatto | 195 / 360 |
| Falsi negativi delle foglie | 26 |
| Falsi positivi delle foglie | 37 |
| Violazioni padre–figlio dopo la chiusura | 0 |
In questo test, la chiusura non modifica le metriche rispetto agli output grezzi. Il tasso di violazioni resta nullo. Il meccanismo è utile per definire la coerenza attesa, ma questa esperienza non dimostra un guadagno di qualità grazie alla sua applicazione.
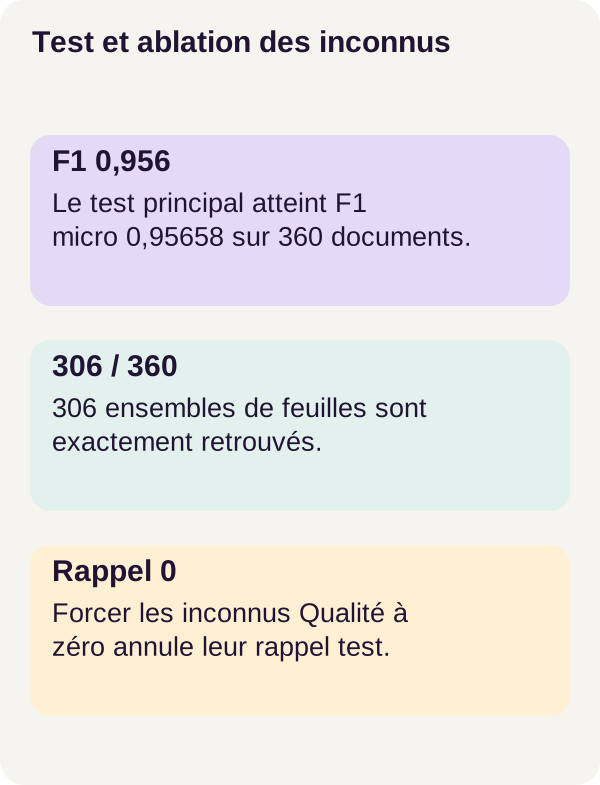
I conteggi degli insiemi esatti offrono un'altra lettura: 306 / 360 corrisponde all'85 % di documenti con foglie interamente corrette, contro circa 54,17 % per l'insieme completo dei nodi. Queste percentuali sono calcolate a partire dai conteggi pubblicati; non sono misure aggiuntive.
Perché le due accuratezze possono differire? Anche la rete produce punteggi per i padri. In un esempio illustrativo, tutte le foglie di un documento possono essere giuste, ma il padre achats proposto in eccesso. La chiusura non elimina questo padre, poiché si limita a far risalire i punteggi. Il suggerimento può quindi non avere alcuna violazione pur contenendo una categoria inutile.
Questo esempio mostra una possibilità del meccanismo. I dati aggregati non consentono da soli di attribuire ogni errore del corpus a questo caso preciso: occorre esaminare gli output documento per documento.
Osservare le foglie difficili e il riferimento semplice
I due F1 globali sono vicini, ma questo non significa che tutte le foglie si comportino allo stesso modo. achats/factures è la più fragile: il suo F1 vale 0,82759, con 12 falsi negativi e 8 falsi positivi. achats/fournisseurs ottiene 0,89320. qualite/audits raggiunge 0,90647, ma conta 13 falsi positivi.
Il ramo Qualità non dimentica alcuna foglia attesa nel test principale; aggiunge però 17 falsi positivi. Un richiamo perfetto può quindi accompagnarsi a categorie suggerite erroneamente.
Infine, la baseline lessicale ottiene 1,00 in questo corpus sintetico con schemi espliciti. Sarebbe fuorviante concluderne che CamemBERT sia necessario per questi dati. Il tutorial permette di studiare l'apprendimento con annotazioni parziali e la gerarchia; non dimostra né una superiorità del modello su questo riferimento né un trasferimento automatico a una GED reale.
Esercizio: prevedere l'effetto delle annotazioni nascoste
Formulare l'ipotesi prima di eseguire i comandi
Maschereremo il 40 % delle annotazioni note del ramo Qualità nell'addestramento, senza modificare né la validazione né il test. Si tratta di coppie documento–etichetta, non del 40 % dei testi eliminati, né necessariamente del 40 % delle sole annotazioni positive.
Prendetevi un momento per prevedere il risultato. Se queste informazioni diventano sconosciute, bisogna ancora penalizzare il modello quando suggerisce una foglia Qualità? Cosa accadrebbe se gli dicessimo, erroneamente, che tutte queste appartenenze sono negative? Vi aspettate più omissioni, più aggiunte o entrambe?
L'esperimento confronta due modelli nuovi, derivati dallo stesso modello iniziale e che usano gli stessi identificatori. exercise-correct rimuove i termini sconosciuti dalla perdita. exercise-wrong li trasforma in target negativi uguali a zero. Ogni variante si addestra per tre epoche.
Non è una modifica applicata solo ai punteggi dopo l'addestramento: i due modelli apprendono con supervisioni diverse. Il percorso verifica anche che la valutazione principale resti invariata, per non confondere l'esercizio con il risultato r001 iniziale.
docker compose run --rm learning python -m ged_classement_hierarchique.cli exercise --config configs/minimum.yaml
docker compose run --rm inference python -m ged_classement_hierarchique.cli predict --config configs/minimum.yaml --variant exercise-correct
docker compose run --rm inference python -m ged_classement_hierarchique.cli predict --config configs/minimum.yaml --variant exercise-wrong
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli evaluate-exercise --config configs/minimum.yaml
Capire in che direzione un target sbagliato spinge il modello
Riprendiamo un'illustrazione indipendente dalle misure: un punteggio di probabilità p = 0,8 per una categoria realmente presente. Con il target corretto y = 1, la BCE vale -ln(0,8), cioè circa 0,2231. Sostituendo il target con y = 0, diventa -ln(0,2), cioè circa 1,6094. ln indica il logaritmo naturale. Il modello viene allora fortemente penalizzato per avere favorito un'appartenenza comunque reale.
Possiamo spingerci un passo oltre con il gradiente: indica come la perdita varia quando si modifica un punteggio o un parametro. Per questa BCE, la derivata rispetto al logit vale p - y. Con il target corretto vale -0,2; con il falso target negativo vale 0,8.
In un ragionamento in cui si regola direttamente questo logit per diminuire la perdita, il primo caso lo spinge verso l'alto, il secondo verso il basso. Gli aggiornamenti di una rete condivisa sono più complessi, ma questo esempio spiega il verso del segnale errato. Mascherare il target sconosciuto rimuove questo segnale; non rivela la verità mancante.
Confrontare con i risultati osservati
La correzione del percorso conferma la diminuzione dei logit Qualità quando gli sconosciuti diventano negativi. Sul test invariato:
| Misura | Maschera corretta | Sconosciuti forzati a zero |
|---|---|---|
| Richiamo delle foglie Qualità | 0,59149 | 0 |
| Falsi negativi Qualità | 96 | 235 |
| F1 macro di tutte le foglie del test | 0,85430 | 0,65244 |
Con la maschera corretta, il modello ritrova 139 veri positivi, dimentica 96 appartenenze e produce 92 falsi positivi sulle foglie Qualità. Il richiamo si ricava direttamente: 139 / (139 + 96) = 139 / 235, cioè circa 0,59149.
Le 235 foglie Qualità attese designano qui 235 appartenenze positive documento–foglia, non 235 categorie diverse né necessariamente 235 documenti distinti. Con la politica errata, diventano tutte falsi negativi: il richiamo di questo ramo scende a zero.
Perché l'F1 macro globale resta a 0,65244 anziché a zero? Perché copre le 12 foglie, non soltanto quelle di Qualità. Il successo su altre categorie può conservare una media non nulla anche quando un ramo viene completamente mancato.
Anche la maschera corretta resta meno buona del modello principale: 0,85430 di F1 macro contro 0,95619. Ha perso informazione supervisionata. Evita di fabbricare negativi, ma non recupera le annotazioni nascoste. Da questa rimozione non era atteso alcun aumento di F1.
La lezione è dunque precisa: conservare l'ignoto protegge il significato dei dati di addestramento; non sostituisce l'informazione assente.
Produrre le figure e pulire senza perdere le prove
Collegare le medie agli esempi
Generate le figure a partire dai risultati già calcolati, poi verificate le tappe pedagogiche:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Le figure rappresentano i risultati esistenti; non costituiscono nuovi esperimenti. Il controllo delle tappe verifica il materiale pedagogico. Consultate i PNG, outputs/evaluation.json e outputs/exercise-comparison.json prima di eliminare qualsiasi cosa.
Tornate anche a D-031: spiega il meccanismo con un esempio tratto dall'addestramento. La sua leggibilità non sostituisce le misure sui 360 documenti separati. Per giudicare la classificazione, osservate proposte errate oltre ai casi riusciti.
Pulire soltanto gli output del percorso
Copiate le metriche e le figure da conservare prima di questi comandi. L'ordine qui sotto fa parte del percorso: il primo arresto precede la pulizia; l'ultimo lascia di nuovo il progetto fermo dopo l'esecuzione del container di pulizia.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
clean --outputs-only mostra, poi rimuove soltanto gli output. Il corpus, il modello e i checkpoint vengono conservati. Questa pulizia mirata non richiede una pulizia Docker globale né la rimozione di risorse di altri progetti.
In caso di problema
La GPU è visibile sull'host, ma il calcolo fallisce in Docker? Tornate al preflight e a check_environment.py. Il secondo controllo verifica l'accesso effettivo dal container; il primo non lo sostituisce.
Un target viene rifiutato o la perdita non è utilizzabile? Verificate la corrispondenza delle forme, il tipo booleano della maschera e i valori delle sole annotazioni note. Non sostituite gli sconosciuti con zero per far sparire il problema. Un contatore nullo richiede un trattamento del lotto senza supervisione, non una media calcolata forzatamente.
La gerarchia sembra corretta, ma la classificazione è sbagliata? Esaminate le foglie aggiunte o mancate, i padri in eccesso e gli errori per categoria. L'assenza di violazioni non verifica la pertinenza del contenuto. Verificate anche che ogni colonna corrisponda sempre allo stesso nodo della tassonomia.
Passare dal prototipo a un'applicazione utile
Iniziate con una tassonomia versionata, annotazioni sottoposte ad audit e una valutazione separata per servizio, lingua e tipo documentale. Una nuova categoria o una riorganizzazione di ramo modifica il contratto della classificazione: occorre mantenere la corrispondenza tra dati, output e versione del piano.
Per l'annotazione, distinguete nell'interfaccia «sì», «no» e «non esaminato». Una casella lasciata vuota non dovrebbe diventare automaticamente un esempio negativo senza una regola esplicita. È una scelta di prodotto da progettare per un adattamento, non un'interfaccia già fornita in questo prototipo.
Presentate al revisore le foglie proposte e i loro antenati. Prevedete cosa deve accadere per i punteggi bassi e per le foglie che il modello non propone mai. Un pulsante di conferma non deve nascondere una categoria dimenticata solo perché la media globale sembra buona.
La chiusura gerarchica garantisce compatibilità con il piano; non certifica né la pertinenza del contenuto né i diritti di classificazione. Le autorizzazioni di accesso e l'eventuale azione sul documento restano decisioni separate. Il POC non sposta ancora alcun file e non concede alcun diritto.
Abbiamo imparato a separare il testo disponibile, le annotazioni note, i punteggi appresi, la coerenza gerarchica e la correttezza misurata. È questa separazione che consente di comprendere un errore e decidere cosa migliorare, anziché affidarsi a un punteggio unico.
Riferimenti per approfondire
I collegamenti a CamemBERT, al glossario Transformers e a PyTorch chiariscono la codifica, le maschere, la sigmoide e la perdita. I riferimenti a scikit-learn precisano le convenzioni delle metriche; non affermano che il progetto chiami queste funzioni. I piccoli esempi numerici dell'articolo spiegano le operazioni e restano distinti dai risultati del corpus Vesta.
Per riprodurre r001, conservate i file e le versioni dello ZIP. Le documentazioni online possono evolvere; i loro esempi generici non sostituiscono la configurazione validata del tutorial.
Scaricate il corso r001: ZIP r001.