





Vous développez un back-office dans lequel une équipe dépose et classe des documents. Un compte rendu d’intervention arrive : faut-il le ranger dans Maintenance, dans Qualité, ou dans les deux ? Une liste déroulante à choix unique ne suffit plus. Vous avez besoin de plusieurs étiquettes, organisées dans une arborescence.
Une GED, ou gestion électronique des documents, peut précisément rencontrer ce problème. Une même pièce peut relever de maintenance/interventions et de qualite/controles. Il faut aussi respecter le plan documentaire : proposer qualite/controles sans inclure son parent qualite produit une suggestion incohérente.
Nous allons entraîner CamemBERT sur le corpus fictif Vesta pour proposer ces classements. Le parcours sera : texte → représentations numériques → scores de catégories → propositions compatibles avec la hiérarchie. Le prototype ne déplace aucun fichier et n’attribue aucun droit d’accès. Il prépare une suggestion à confirmer.
Télécharger le ZIP du tutoriel r001
Nous suivrons le cas D-031 pour inspecter le mécanisme. Cet exemple provient de l’entraînement ; ses annotations sont accessibles pour l’explication. Les 360 documents de test seront évalués séparément.
Le piège principal ressemble à une erreur classique de formulaire : une case qui n’a pas été renseignée ne signifie pas forcément « non ». Dans notre entraînement, confondre une annotation inconnue avec une réponse négative apprendrait au modèle une information que personne n’a établie. L’exercice final permettra d’observer les conséquences de cette confusion.
Vocabulaire et métriques avant le code
Une taxonomie : des catégories et leurs liens
Une taxonomie est ici le plan de classement. Chaque catégorie est un nœud. Une catégorie peut avoir des enfants : achats est le parent de achats/factures. Une catégorie sans enfant est une feuille. Les ancêtres d’un nœud sont les catégories que l’on rencontre en remontant vers le sommet de l’arbre.
Le projet comporte 12 feuilles, mais le modèle produit aussi des scores pour les parents. Il y a donc une sortie par nœud de la taxonomie, et pas uniquement douze sorties.
La classification est multi-étiquette : plusieurs catégories peuvent être vraies pour un même document. Pensez à plusieurs cases à cocher plutôt qu’à des boutons radio qui imposent un choix unique. Les feuilles maintenance/interventions et qualite/controles ne sont pas nécessairement concurrentes.
La hiérarchie ajoute une contrainte : une proposition dans qualite/controles doit inclure qualite. En revanche, proposer qualite n’impose pas de proposer toutes ses feuilles. Un parent n’est pas un raccourci pour cocher chacun de ses enfants.
Du texte aux nombres : le rôle de CamemBERT
CamemBERT est un modèle préentraîné sur du texte français. Nous l’utilisons comme encodeur : il transforme une séquence de texte en représentations numériques. Il ne rédige pas une réponse conversationnelle dans ce projet. La documentation CamemBERT de Hugging Face présente son fonctionnement et ses usages de classification.
Le tokenizer découpe d’abord le texte en unités appelées tokens, ou jetons. Un token peut correspondre à un morceau de mot ; ce n’est pas nécessairement un mot entier. Le tokenizer convertit ces unités en identifiants et ajoute des jetons spéciaux pour structurer la séquence.
L’encodeur produit ensuite un vecteur par position : une liste de nombres qui représente cette position en tenant compte du texte environnant. Ces nombres sont des caractéristiques calculées par le modèle, pas des catégories directement lisibles comme « facture » ou « contrôle ».
Préentraîné ne signifie pas qu’il connaît déjà notre plan de classement. L’adaptation à partir des annotations Vesta lui apprend la tâche documentaire visée : c’est le principe du fine-tuning, ou ajustement d’un modèle préentraîné à une tâche. Les poids sont les paramètres numériques ajustés pendant l’apprentissage ; ils ne sont pas une liste de documents à consulter.
Pour traiter plusieurs documents ensemble, on forme un lot, ou batch. Les séquences n’ayant pas toutes la même longueur, on complète les plus courtes avec du padding, c’est-à-dire du remplissage. Le masque d’attention indique les positions à prendre en compte et celles qui correspondent au remplissage. Les jetons spéciaux de la séquence ne sont pas automatiquement du padding : c’est le masque qui fait la distinction. Le glossaire de Transformers détaille cette notion.
Moyenner sans laisser le remplissage décider
Notre classifieur attend un vecteur par document, et non un nombre variable de vecteurs. Le projet utilise donc un pooling masqué : il fait la moyenne des représentations des positions valides.
Prenons une illustration à deux dimensions, sans rapport avec une sortie mesurée de CamemBERT. Les trois positions valides ont pour vecteurs [2 ; 4], [4 ; 2] et [6 ; 6]. Leur somme est [12 ; 12], donc leur moyenne est [4 ; 4].
Ajoutons deux positions de remplissage, représentées par [0 ; 0] pour simplifier. Une moyenne sur les cinq positions donnerait [2,4 ; 2,4]. Le contenu n’a pas changé, mais sa représentation serait artificiellement réduite. Il faut exclure le remplissage de la somme et diviser par le nombre de positions valides. En pratique, il ne faut pas non plus supposer que les représentations calculées aux positions de padding sont nulles.
Les tableaux manipulés par PyTorch s’appellent des tenseurs. Avec B documents, T positions par séquence et H nombres par vecteur, les représentations ont la forme B × T × H. Le pooling donne B × H. La tête de classification, la partie qui transforme ce vecteur en scores de catégories, produit enfin B × K, où K est le nombre total de nœuds.
Un logit, une probabilité et une décision sont trois choses différentes
Chaque sortie de la tête est un logit : un nombre brut qui peut être négatif ou positif. La sigmoïde le transforme selon p = 1 / (1 + exp(-z)), où z est le logit et exp la fonction exponentielle. Par exemple, les logits -2, 0 et 2 donnent respectivement environ 0,1192, 0,5 et 0,8808. La formule est documentée par PyTorch pour Sigmoid.
Cette transformation est appliquée à chaque catégorie. On peut obtenir un score élevé pour deux feuilles : leurs probabilités n’ont pas à totaliser 1, puisque plusieurs appartenances peuvent être vraies simultanément.
Il faut ensuite une règle de décision pour transformer ces scores en propositions. Un seuil de 0,5 servira dans nos exemples numériques, uniquement pour faciliter le calcul ; il ne remplace pas la configuration du parcours r001. De même, un score de 0,8 ne démontre pas à lui seul que huit suggestions comparables sur dix seront correctes.
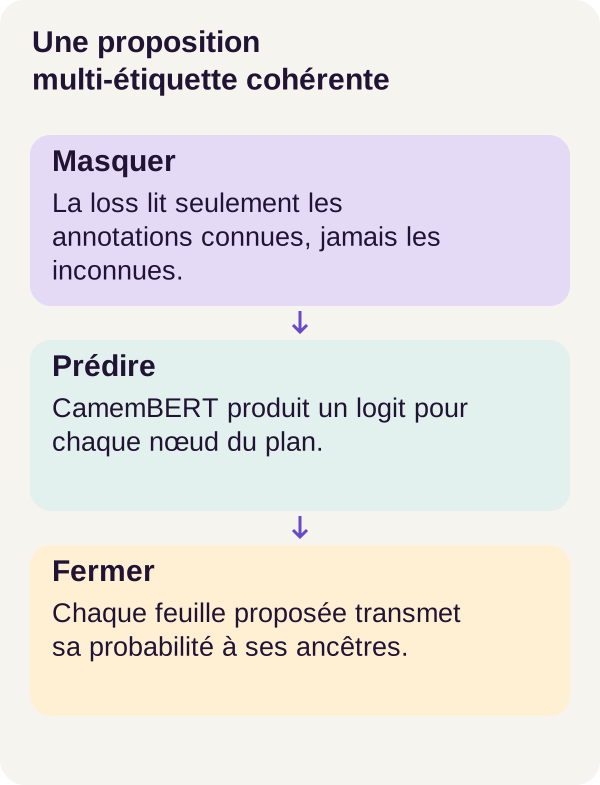
Après les sigmoïdes, la fermeture d’ancêtres fait remonter les scores des enfants vers leurs parents en prenant le maximum. Elle rend les scores compatibles avec la hiérarchie. Elle ne modifie pas les logits utilisés pour apprendre et ne transforme pas une mauvaise catégorie en bonne catégorie.
Une annotation possède deux informations : sa valeur et le fait qu’elle soit connue
Une annotation indique si un document appartient à une catégorie. Dans ce projet, on distingue trois situations :
| Situation | Valeur cible | Utilisée pour apprendre ? |
|---|---|---|
| Appartenance confirmée | 1 |
Oui. |
| Non-appartenance confirmée | 0 |
Oui. |
| Appartenance inconnue | Valeur ignorée | Non. |
Pour un développeur web, on peut rapprocher cette distinction d’un booléen nullable : true, false et une absence d’information. C’est une analogie, pas la description d’un schéma de base de données fourni par le projet.
La fonction de perte, appelée loss dans le code, mesure l’écart entre les sorties du modèle et les annotations connues. L’entraînement ajuste les paramètres pour réduire cette perte. Ici, nous utilisons une entropie croisée binaire, ou BCE, uniquement sur les couples document–étiquette effectivement observés.
Attention : nous avons maintenant deux masques différents. Le masque d’attention porte sur les positions du texte, de forme B × T. Le masque d’annotations porte sur les catégories connues, de forme B × K. Retirer une annotation de la perte ne supprime pas les mots du document.
Mesurer les étiquettes, puis le document entier
Un vrai positif est une feuille attendue et proposée. Un faux positif est une feuille proposée à tort. Un faux négatif est une feuille attendue mais oubliée. La précision mesure les bonnes propositions parmi celles émises ; le rappel mesure les appartenances attendues qui ont été retrouvées.
Le F1 combine précision et rappel. Avec VP vrais positifs, FP faux positifs et FN faux négatifs, il vaut 2 × VP / (2 × VP + FP + FN). Le F1 micro rassemble les comptes de toutes les feuilles avant ce calcul. Le F1 macro calcule le F1 de chacune des 12 feuilles, puis leur moyenne sans pondération. Ces conventions sont décrites dans la documentation de f1_score.
Une petite illustration explique leur différence. Supposons deux feuilles seulement : la première est retrouvée 90 fois sur 90, sans erreur ; la seconde est oubliée dix fois sur dix et n’est jamais proposée. Le F1 micro vaut 180 / 190, soit environ 0,9474. Le F1 macro vaut pourtant (1 + 0) / 2 = 0,5. Une réussite sur une catégorie fréquente peut donc masquer l’échec complet d’une autre.
L’ensemble exact de feuilles pose une question plus stricte : toutes les feuilles de ce document sont-elles correctes, sans ajout ni oubli ? L’ensemble exact de nœuds exige la même chose pour les feuilles et les parents. C’est une comparaison d’ensembles, pas de leur ordre d’affichage ; la notion d’exactitude multi-étiquette est également expliquée par scikit-learn.
Enfin, le taux de violations parent–enfant examine la cohérence du plan : un enfant a-t-il été proposé sans son parent ? Un taux nul est souhaitable, mais une branche entièrement erronée peut rester parfaitement cohérente.
Préparer le parcours GPU
Vérifier les prérequis et garder la configuration de référence
Vous devez savoir utiliser Python, un terminal et Docker. PyTorch réalisera les calculs sur les tenseurs ; les notions nécessaires de classification binaire viennent d’être introduites.
Le profil de référence est Linux avec une RTX 3090 de 24 Gio de mémoire graphique. Prévoyez aussi 24 Gio de RAM et 35 Gio de disque de travail, plus le stockage Docker. Ce sont des recommandations de préparation, pas des minima ni des consommations garantis sur toute machine.
Le parcours principal utilise trois époques : une époque correspond à un passage sur les exemples d’entraînement. L’exercice lancera deux nouveaux entraînements de trois époques chacun. La validation r001 décrite dans cet article a utilisé un GPU ; les commandes suivantes reproduisent ce parcours, pas un mode CPU alternatif. La référence lexicale sera, elle, calculée sur CPU.
Les six actifs publics nécessaires sont acquis avec vérification de leur taille et de leur empreinte SHA-256. Cette empreinte identifie le contenu attendu d’un fichier. Aucun poids préentraîné ni dépôt privé n’est inclus dans le ZIP : le téléchargement des actifs fait partie de la préparation.
Décompressez l’archive et placez votre terminal à sa racine. Toutes les commandes de l’article se lancent depuis ce répertoire, dans l’ordre présenté. Conservez les dépendances et la configuration configs/minimum.yaml du ZIP pour reproduire r001.
Contrôler l’hôte et construire les services
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference
Le préflight vérifie Docker, Compose, la mémoire, le disque et le GPU. Le contrôle config --quiet réussit sans afficher de texte lorsque la configuration Compose est valide. Une commande silencieuse n’est donc pas nécessairement une commande qui n’a rien fait.
Un GPU visible avec nvidia-smi sur l’hôte ne prouve pas encore qu’un programme dans Docker pourra calculer dessus. Le NVIDIA Container Toolkit fournit l’intégration avec les conteneurs. Le préflight indique la documentation nécessaire si cette intégration manque, sans modifier le système à votre place. Pour sélectionner une autre carte, définissez GPU_DEVICE=1 avant le parcours.
Acquérir les fichiers, puis tester depuis Docker
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
L’acquisition contrôle les six fichiers avant leur mise en place atomique : elle évite de considérer un fichier partiellement acquis comme le fichier final. check_environment.py charge ensuite les poids et réalise un calcul CUDA depuis le conteneur. Il vérifie ainsi une capacité réelle d’exécution, pas seulement la présence du matériel.
Les tests couvrent notamment le masque d’annotations, la fermeture hiérarchique et les cas négatifs. Un cas négatif vérifie qu’une entrée invalide est refusée. Ne commencez pas l’entraînement en contournant un échec de ces contrôles : il faut d’abord en comprendre la cause.
Créer les données et rendre le mécanisme inspectable
Préparer Vesta et une méthode de comparaison
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli prepare --config configs/minimum.yaml
docker compose run --rm learning python -m ged_classement_hierarchique.cli baseline --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli inspect-mechanism --config configs/minimum.yaml
prepare crée le corpus fictif et sa taxonomie. baseline exécute une référence lexicale, c’est-à-dire une méthode fondée sur les indices textuels prévus par le projet. Cette comparaison répond à une question utile : le réseau apporte-t-il quelque chose par rapport à une solution plus simple ? Le fait que la commande utilise le service learning ne change pas le profil CPU de cette référence.
inspect-mechanism rend le cas D-031 inspectable. Les logits de cette démonstration sont illustratifs, explicitement signalés comme tels. Ils servent à suivre le calcul ; ils ne doivent pas être présentés comme la prédiction d’un modèle déjà entraîné. Les petits calculs ajoutés ci-dessous sont eux aussi des illustrations indépendantes, pas de nouvelles mesures sur D-031.
masked_bce : sélectionner avant de calculer
Regardons le garde-fou central. logits contient les scores bruts, targets les valeurs attendues et mask indique les couples document–étiquette connus.
def masked_bce(logits, targets, mask):
    if (
        logits.shape != targets.shape
        or logits.shape != mask.shape
        or mask.dtype != torch.bool
    ):
        raise ValueError("Expected matching B x labels tensors and a boolean mask")
    count = int(mask.sum())
    if count == 0:
        return None, 0
    # Index first: unknown targets may even be NaN and never enter BCE.
    selected = targets[mask]
    if (
        not torch.isfinite(selected).all()
        or not ((selected == 0) | (selected == 1)).all()
    ):
        raise ValueError("Known target is not binary")
    return (
        F.binary_cross_entropy_with_logits(logits[mask], selected, reduction="sum"),
        count,
    )
La fonction commence par exiger des formes identiques pour les trois tenseurs et un masque de type torch.bool. Dans le parcours, ces tableaux correspondent à B × K : une ligne par document, une colonne par nœud. Le contrôle montré compare les formes ; il ne reconstruit pas l’association entre les noms de catégories et les colonnes. Cet ordre doit donc rester cohérent dans les entrées.
count = int(mask.sum()) compte les annotations connues, positives comme négatives. Ce n’est ni le nombre de documents, ni le nombre de catégories présentes.
Lorsqu’aucune annotation n’est connue, la fonction renvoie (None, 0). Cela signifie « aucun terme supervisé à calculer », pas « prédiction parfaite avec une perte nulle ». Le code appelant doit traiter ce cas sans diviser par zéro ni tenter une rétropropagation sur None.
La ligne décisive est selected = targets[mask]. L’indexation booléenne ne garde que les valeurs autorisées à participer au calcul. Les cibles sélectionnées doivent être finies et valoir exactement 0 ou 1. Une cible connue égale à 0,5, par exemple, est rejetée par ce contrat.
L’appel final reçoit les logits, pas leur sigmoïde calculée à l’avance. binary_cross_entropy_with_logits combine la transformation et la perte de manière numériquement stable. La documentation PyTorch de BCEWithLogitsLoss explique ce principe.
Avec reduction="sum", la fonction renvoie une somme de pertes et le nombre de termes, pas une moyenne. Ces deux informations permettent au code appelant de normaliser sur le nombre d’annotations retenues. Pour comprendre la normalisation exacte de l’entraînement complet, il faut suivre leur utilisation dans le projet, et non supposer que cet extrait effectue déjà la division.
Pourquoi « calculer puis multiplier par zéro » ne suffit pas
Prenons un document et trois scores : les logits sont [2 ; -2 ; 0], les cibles [1 ; 0 ; NaN] et le masque [True ; True ; False]. NaN, pour Not a Number, représente ici une valeur numérique non définie placée dans une case inconnue.
Après sélection, les deux seules cibles sont 1 et 0. Leurs probabilités sont environ 0,8808 et 0,1192. Dans les deux cas, la prédiction favorise la bonne réponse. Chaque perte vaut environ 0,126928 : la fonction renvoie donc une somme d’environ 0,253856 et un compteur de 2. La moyenne correspondante serait 0,126928.
Le troisième terme n’est jamais évalué. À l’inverse, calculer la BCE sur les trois cibles puis multiplier la troisième perte par zéro n’effacerait pas forcément le problème : NaN × 0 reste NaN. Le masquage doit intervenir avant l’opération susceptible d’être contaminée.
Cette sélection ne force pas le troisième score à zéro. Elle retire sa contribution directe à la perte. Les paramètres partagés du modèle peuvent toujours évoluer grâce aux autres annotations et modifier ce score lors d’une prédiction ultérieure.
Dernière limite importante : la fonction fait confiance au masque. Si une annotation inconnue est transformée en 0 et marquée connue en amont, elle ressemble à une annotation négative valide. Aucun contrôle de forme ne peut deviner cette erreur de sens. C’est exactement ce que l’exercice mettra à l’épreuve.
Faire remonter les scores, sans cocher toute une branche
Après l’apprentissage vient l’inférence, le calcul des prédictions avec le modèle entraîné. La fermeture s’applique à cette étape seulement.
Imaginons les scores suivants, avec un seuil commun de 0,5 choisi uniquement pour l’illustration :
| Nœud | Score avant fermeture | Score après fermeture |
|---|---|---|
qualite |
0,2 | 0,8 |
qualite/controles |
0,8 | 0,8 |
qualite/audits |
0,1 | 0,1 |
Avant fermeture, le contrôle serait proposé sans son parent. Le programme remonte son score vers qualite, qui passe à 0,8. Il ne change pas qualite/audits : appartenir à la branche Qualité n’implique pas de relever d’un audit.
Voici la boucle exacte du projet. Il s’agit d’un extrait de corps de fonction : le return final appartient à cette fonction dans le code complet.
for node in reversed(topological_order(parents)):
    parent = parents[node]
    if parent is not None:
        output[..., parent] = torch.maximum(output[..., parent], output[..., node])
return output
Un ordre topologique place les parents avant leurs enfants. reversed(...) inverse cet ordre pour traiter les descendants d’abord. Pour chaque nœud, parents[node] retrouve son parent ; None indique qu’il n’en a pas.
La notation output[..., parent] sélectionne le parent sur la dernière dimension du tenseur, tout en conservant les dimensions précédentes, notamment les documents du lot. torch.maximum compare les deux scores élément par élément. Le parent conserve donc le plus grand entre son propre score et celui de l’enfant.
Pourquoi commencer par le bas ? Prenons une chaîne abstraite sommet → branche → feuille, de scores 0,1, 0,2 et 0,9. En remontant depuis la feuille, la branche passe à 0,9, puis le sommet aussi. En parcourant une seule fois dans l’autre sens, le sommet ne recevrait d’abord que 0,2, avant que la branche ait récupéré le 0,9 de sa feuille.
La fermeture ne diminue aucun score et ne modifie pas ceux des feuilles. Une fois tous les ancêtres mis à jour, la refaire ne change plus le résultat. Elle ne calcule pas non plus la somme des probabilités des enfants : deux scores de 0,8 ne donnent pas un parent à 1,6.
Ce mécanisme impose une cohérence, pas une calibration des probabilités. Avec un seuil commun, un enfant retenu entraîne ses parents puisque leurs scores sont au moins aussi élevés. Pour une extension utilisant des seuils différents par catégorie, cette garantie devra être revérifiée : un parent à 0,8 avec un seuil de 0,9 serait refusé, même si son enfant à 0,8 dépasse un seuil de 0,5. Cet exemple ne décrit pas une modification du parcours r001.
Entraîner, reprendre, prédire et mesurer
Distinguer apprentissage, reprise et évaluation
Les données d’entraînement servent à ajuster les paramètres. La validation sert à contrôler les choix de développement sans utiliser le test. Le test décrit le comportement final sur les documents réservés à la mesure.
Le parcours sépare aussi les rôles des conteneurs : learning dispose des annotations d’entraînement et de validation nécessaires à l’apprentissage ; inference ne monte aucune annotation. L’évaluation, effectuée séparément, peut ensuite comparer les prédictions aux références des 360 documents de test.
docker compose run --rm learning python -m ged_classement_hierarchique.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_classement_hierarchique.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_classement_hierarchique.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_classement_hierarchique.cli verify-resume --config configs/minimum.yaml
Le mode interrupt produit un parcours interrompu. continuous réalise le témoin continu à partir des mêmes données. resume reprend l’état interrompu, puis verify-resume compare l’état obtenu à celui du témoin.
Un checkpoint est un état sauvegardé qui permet de poursuivre un calcul. Reprendre ne signifie donc pas repartir d’une nouvelle initialisation ni recommencer arbitrairement trois époques supplémentaires. L’objectif du contrôle est de vérifier la procédure de reprise. Il ne mesure pas, à lui seul, la qualité des classements.
Produisons maintenant les suggestions, puis les mesures :
docker compose run --rm inference python -m ged_classement_hierarchique.cli predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli evaluate --config configs/minimum.yaml
La prédiction principale vient avant l’évaluation. Consultez les propositions et outputs/evaluation.json : une moyenne globale ne suffit pas à expliquer une feuille ajoutée ou oubliée dans un document donné.
Les résultats du parcours principal
Voici les résultats publiés pour les 360 documents de test :
| Mesure | Résultat |
|---|---|
| F1 micro des feuilles | 0,95658 |
| F1 macro des 12 feuilles | 0,95619 |
| Documents dont l’ensemble de feuilles est exact | 306 / 360 |
| Documents dont l’ensemble de tous les nœuds est exact | 195 / 360 |
| Faux négatifs de feuilles | 26 |
| Faux positifs de feuilles | 37 |
| Violations parent–enfant après fermeture | 0 |
Sur ce test, la fermeture ne modifie pas les métriques par rapport aux sorties brutes. Le taux de violations reste nul. Le mécanisme est utile pour définir la cohérence attendue, mais cette expérience ne démontre pas de gain de qualité grâce à son application.
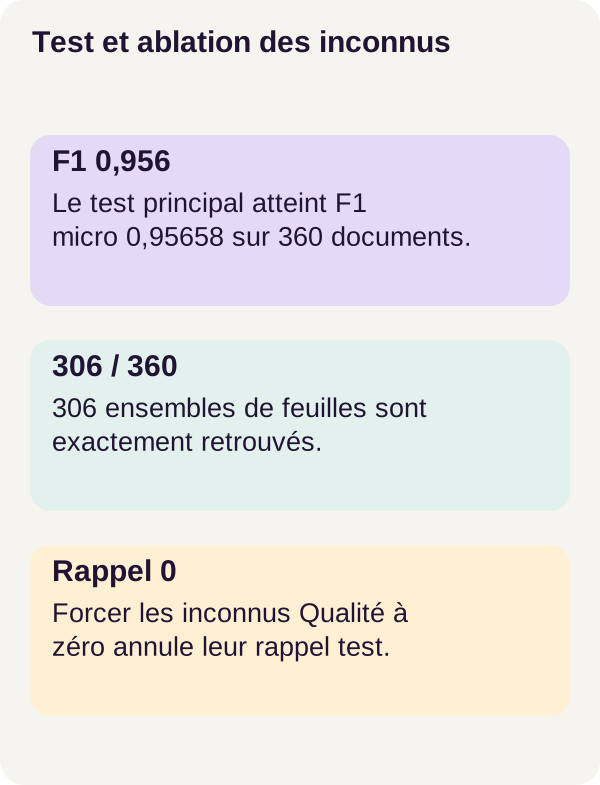
Les comptes d’ensembles exacts donnent une autre lecture : 306 / 360 correspond à 85 % de documents aux feuilles entièrement correctes, contre environ 54,17 % pour l’ensemble complet des nœuds. Ces pourcentages sont calculés à partir des comptes publiés ; ce ne sont pas des mesures supplémentaires.
Pourquoi les deux exactitudes peuvent-elles différer ? Le réseau produit des scores pour les parents aussi. Dans un exemple illustratif, toutes les feuilles d’un document peuvent être justes, mais le parent achats être proposé en trop. La fermeture ne supprime pas ce parent, car elle ne fait que remonter des scores. La suggestion peut alors n’avoir aucune violation tout en comportant une catégorie inutile.
Cet exemple montre une possibilité du mécanisme. Les chiffres agrégés ne permettent pas, à eux seuls, d’attribuer chaque erreur du corpus à ce cas précis : il faut examiner les sorties document par document.
Regarder les feuilles difficiles et la référence simple
Les deux F1 globaux sont proches, mais cela ne signifie pas que toutes les feuilles se comportent pareil. achats/factures est la plus fragile : son F1 vaut 0,82759, avec 12 faux négatifs et 8 faux positifs. achats/fournisseurs obtient 0,89320. qualite/audits atteint 0,90647, mais compte 13 faux positifs.
La branche Qualité ne manque aucune feuille attendue dans le test principal ; elle ajoute pourtant 17 faux positifs. Un rappel parfait peut donc accompagner des catégories suggérées à tort.
Enfin, la baseline lexicale obtient 1,00 dans ce corpus synthétique à patrons explicites. Il serait trompeur d’en conclure que CamemBERT est nécessaire pour ces données. Le tutoriel permet d’étudier l’apprentissage avec annotations partielles et la hiérarchie ; il ne démontre ni une supériorité du modèle sur cette référence, ni un transfert automatique vers une GED réelle.
Exercice : prédire l'effet des annotations cachées
Formuler l’hypothèse avant de lancer les commandes
Nous allons masquer 40 % des annotations connues de la branche Qualité dans l’entraînement, sans changer la validation ni le test. Il s’agit de couples document–étiquette, pas de 40 % des textes supprimés, ni nécessairement de 40 % des seules annotations positives.
Prenez un instant pour prévoir le résultat. Si ces informations deviennent inconnues, faut-il encore pénaliser le modèle lorsqu’il suggère une feuille Qualité ? Que se passerait-il si nous lui disions, à tort, que toutes ces appartenances sont négatives ? Attendez-vous davantage d’oublis, davantage d’ajouts, ou les deux ?
L’expérience compare deux modèles neufs, issus du même modèle initial et utilisant les mêmes identifiants. exercise-correct retire les termes inconnus de la perte. exercise-wrong les transforme en cibles négatives égales à zéro. Chaque variante s’entraîne pendant trois époques.
Ce n’est pas un changement appliqué seulement aux scores après l’entraînement : les deux modèles apprennent avec des supervisions différentes. Le parcours vérifie aussi que l’évaluation principale reste inchangée, pour ne pas confondre l’exercice avec le résultat r001 de départ.
docker compose run --rm learning python -m ged_classement_hierarchique.cli exercise --config configs/minimum.yaml
docker compose run --rm inference python -m ged_classement_hierarchique.cli predict --config configs/minimum.yaml --variant exercise-correct
docker compose run --rm inference python -m ged_classement_hierarchique.cli predict --config configs/minimum.yaml --variant exercise-wrong
docker compose run --rm tutorial python -m ged_classement_hierarchique.cli evaluate-exercise --config configs/minimum.yaml
Comprendre dans quel sens une mauvaise cible pousse le modèle
Reprenons une illustration indépendante des mesures : un score de probabilité p = 0,8 pour une catégorie réellement présente. Avec la cible correcte y = 1, la BCE vaut -ln(0,8), soit environ 0,2231. En remplaçant la cible par y = 0, elle devient -ln(0,2), soit environ 1,6094. ln désigne le logarithme naturel. Le modèle est alors fortement pénalisé pour avoir favorisé une appartenance pourtant réelle.
On peut aller un cran plus loin avec le gradient : il indique comment la perte varie quand on modifie un score ou un paramètre. Pour cette BCE, la dérivée par rapport au logit vaut p - y. Avec la bonne cible, elle vaut -0,2 ; avec la fausse cible négative, elle vaut 0,8.
Dans un raisonnement où l’on ajuste directement ce logit pour diminuer la perte, le premier cas le pousse vers le haut, le second vers le bas. Les mises à jour d’un réseau partagé sont plus complexes, mais cet exemple explique le sens du signal erroné. Masquer la cible inconnue retire ce signal ; cela ne révèle pas la vérité manquante.
Comparer avec les résultats observés
La correction du parcours confirme la baisse des logits Qualité lorsque les inconnus deviennent des négatifs. Sur le test inchangé :
| Mesure | Masque correct | Inconnus forcés à zéro |
|---|---|---|
| Rappel des feuilles Qualité | 0,59149 | 0 |
| Faux négatifs Qualité | 96 | 235 |
| F1 macro de toutes les feuilles du test | 0,85430 | 0,65244 |
Avec le masque correct, le modèle retrouve 139 vrais positifs, manque 96 appartenances et produit 92 faux positifs sur les feuilles Qualité. Le rappel se retrouve directement : 139 / (139 + 96) = 139 / 235, soit environ 0,59149.
Les 235 feuilles Qualité attendues désignent ici 235 appartenances positives document–feuille, pas 235 catégories différentes ni nécessairement 235 documents distincts. Avec la politique erronée, elles deviennent toutes des faux négatifs : le rappel de cette branche tombe à zéro.
Pourquoi le F1 macro global reste-t-il à 0,65244 plutôt qu’à zéro ? Parce qu’il couvre les 12 feuilles, pas seulement celles de Qualité. La réussite sur d’autres catégories peut conserver une moyenne non nulle alors qu’une branche est entièrement manquée.
Le masque correct reste, lui aussi, moins bon que le modèle principal : 0,85430 de F1 macro contre 0,95619. Il a perdu de l’information supervisée. Il évite de fabriquer des négatifs, mais ne récupère pas les annotations cachées. Aucune hausse de F1 n’était attendue de cette suppression.
La leçon est donc précise : conserver l’inconnu protège le sens des données d’apprentissage ; cela ne remplace pas l’information absente.
Produire les figures et nettoyer sans perdre les preuves
Relier les moyennes aux exemples
Générez les figures à partir des résultats déjà calculés, puis vérifiez les jalons pédagogiques :
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Les figures représentent les résultats existants ; elles ne constituent pas de nouveaux essais. Le contrôle des jalons vérifie le matériel pédagogique. Consultez les PNG, outputs/evaluation.json et outputs/exercise-comparison.json avant de supprimer quoi que ce soit.
Revenez aussi à D-031 : il explique le mécanisme avec un exemple issu de l’entraînement. Sa lisibilité ne remplace pas les mesures des 360 documents séparés. Pour juger le classement, regardez des propositions erronées aussi bien que des cas réussis.
Nettoyer uniquement les sorties du parcours
Copiez les métriques et figures à conserver avant ces commandes. L’ordre ci-dessous fait partie du parcours : le premier arrêt précède le nettoyage ; le dernier laisse de nouveau le projet arrêté après l’exécution du conteneur de nettoyage.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
clean --outputs-only affiche puis retire seulement les sorties. Le corpus, le modèle et les checkpoints sont conservés. Ce nettoyage ciblé ne demande pas de purge Docker globale ni de suppression des ressources d’autres projets.
En cas de problème
Le GPU est visible sur l’hôte, mais le calcul échoue dans Docker ? Revenez au préflight et à check_environment.py. Le second contrôle vérifie l’accès effectif depuis le conteneur ; le premier ne le remplace pas.
Une cible est refusée ou la perte n’est pas exploitable ? Vérifiez la correspondance des formes, le type booléen du masque et les valeurs des seules annotations connues. Ne remplacez pas les inconnus par zéro pour faire disparaître le problème. Un compteur nul appelle un traitement du lot sans supervision, pas une moyenne calculée de force.
La hiérarchie paraît correcte, mais le classement est mauvais ? Examinez les feuilles ajoutées ou manquées, les parents en trop et les erreurs par catégorie. Une absence de violation ne teste pas la pertinence du contenu. Vérifiez aussi que chaque colonne correspond toujours au même nœud de taxonomie.
Passer du prototype à une application utile
Commencez par une taxonomie versionnée, des annotations auditées et une évaluation séparée par service, langue et type documentaire. Une nouvelle catégorie ou une réorganisation de branche change le contrat du classement : il faut garder la correspondance entre les données, les sorties et la version du plan.
Pour l’annotation, distinguez dans l’interface « oui », « non » et « non examiné ». Une case laissée vide ne devrait pas devenir automatiquement un exemple négatif sans règle explicite. C’est un choix de produit à concevoir pour une adaptation, pas une interface déjà livrée dans ce prototype.
Présentez au relecteur les feuilles proposées et leurs ancêtres. Prévoyez ce qu’il doit se passer pour les scores faibles et pour les feuilles que le modèle ne propose jamais. Un bouton de confirmation ne doit pas cacher une catégorie oubliée simplement parce que la moyenne globale semble bonne.
La fermeture hiérarchique assure une compatibilité avec le plan ; elle ne certifie ni la pertinence du contenu, ni les droits de classement. Les autorisations d’accès et l’éventuelle action sur le document restent des décisions séparées. Le POC ne déplace toujours aucun fichier et n’accorde aucun droit.
Nous avons appris à séparer le texte disponible, les annotations connues, les scores appris, la cohérence hiérarchique et la justesse mesurée. C’est cette séparation qui permet de comprendre une erreur et de décider ce qu’il faut améliorer, plutôt que de compter sur un score unique.
Références pour approfondir
Les liens vers CamemBERT, le glossaire Transformers et PyTorch éclairent l’encodage, les masques, la sigmoïde et la perte. Les références scikit-learn précisent les conventions de métriques ; elles n’affirment pas que le projet appelle ces fonctions. Les petits exemples chiffrés de l’article expliquent les opérations et restent distincts des résultats du corpus Vesta.
Pour reproduire r001, conservez les fichiers et versions du ZIP. Les documentations en ligne peuvent évoluer ; leurs exemples génériques ne remplacent pas la configuration validée du tutoriel.
Téléchargez le cours r001 : ZIP r001.