





Hãy hình dung bảng điều khiển của bạn hiển thị thời gian trung bình để hai máy chủ xử lý yêu cầu. Máy chủ thứ nhất nhận ít yêu cầu, máy chủ thứ hai nhận nhiều hơn hẳn. Để tính trung bình chung, cộng hai giá trị trung bình rồi chia đôi là chưa đủ: bạn còn phải tính đến số yêu cầu đứng sau mỗi con số.
Cạm bẫy tương tự xuất hiện khi hai GPU huấn luyện một mô hình trên các chuỗi có độ dài khác nhau. Mỗi card có thể tính một giá trị trung bình hoàn toàn đúng trên dữ liệu của mình, rồi cùng tham gia vào một phép tính tổng thể không còn phản ánh mục tiêu đã chọn.
Chúng ta sẽ làm rõ vấn đề này bằng một mô hình nhỏ và dữ liệu tổng hợp. Chúng ta sẽ so sánh phép tính trên hai GPU với kết quả tham chiếu trên một GPU, rồi ngắt quá trình huấn luyện để kiểm tra khả năng tiếp tục. Mục tiêu không phải vượt qua một mô hình nổi tiếng hay đo mức tăng tốc: chúng ta muốn thu được gradient của giá trị trung bình tính trên tất cả token hợp lệ trong cùng một cửa sổ huấn luyện.
Dự án không yêu cầu trọng số đã huấn luyện sẵn hay bộ dữ liệu bên ngoài. Bạn có thể theo dõi lập luận với kiến thức Python cơ bản và vài phép tính trung bình; phần thực hành chạy được thì sử dụng Docker và hai GPU. Các con số trong phần tổng kết vẫn là số liệu của lần chạy tham chiếu r1. Những ví dụ nhỏ bổ sung chỉ nhằm giải thích phép tính, không phải công bố phép đo mới của mô hình.
Vấn đề: trung bình của các giá trị trung bình bị lệch
Trước hết, chúng ta muốn mô hình học điều gì?
Mô hình có các tham số, còn gọi là trọng số: đó là những con số được điều chỉnh trong quá trình huấn luyện. Với một lô dữ liệu, mô hình đưa ra dự đoán để chương trình so sánh với câu trả lời mong đợi. Hàm mất mát, hay loss, tổng hợp chi phí của các sai sót theo quy tắc đã chọn.
Trong bài hướng dẫn này, giá trị mất mát được tách thành phần đóng góp của từng token được giám sát. Token là một đơn vị của chuỗi, được biểu diễn trong chương trình bằng một mã số. Với văn bản, token có thể tương ứng với một từ, một phần của từ hoặc một ký hiệu; ở đây, các chuỗi là dữ liệu tổng hợp. “Được giám sát” nghĩa là câu trả lời mong đợi thực sự đóng góp vào phép tính mất mát tại vị trí đó.
Gradient cho biết giá trị mất mát thay đổi ra sao khi các tham số thay đổi một chút. Nó chứa một đạo hàm cho mỗi tham số. Việc tính các đạo hàm này gọi là lan truyền ngược, hay backward. Sau đó, một bộ tối ưu hóa sử dụng các gradient để thay đổi trọng số. Chúng ta sẽ gặp hai thao tác này trong mã: tính gradient chưa đồng nghĩa với áp dụng bước cập nhật.
Lựa chọn của chúng ta rất cụ thể: mỗi token được giám sát có trọng số như nhau trong giá trị trung bình của cửa sổ. Vì vậy, chuỗi dài đóng góp nhiều hơn chuỗi ngắn. Ở đây, chúng ta không tìm cách gán cùng một tổng trọng số cho mỗi chuỗi.
Hai tiến trình, hai số lượng token
Hạng, hay rank, chỉ một tiến trình tham gia phép tính phân tán. Trong thí nghiệm này, hạng 0 làm việc trên một GPU và hạng 1 trên GPU còn lại. Mỗi tiến trình có một bản sao của cùng mô hình, nhưng nhận các chuỗi khác nhau.
Hãy quay lại phản ví dụ của dự án. Hạng thứ nhất xử lý 12 token và thu được tổng mất mát bằng 12. Hạng thứ hai xử lý 36 token và thu được tổng mất mát bằng 108.
Trên thiết bị di động, hãy cuộn bảng theo chiều ngang.
| Hạng | Token hợp lệ | Tổng mất mát | Trung bình cục bộ | Tỷ lệ token trong cửa sổ |
|---|---|---|---|---|
| 0 | 12 | 12 | 12 / 12 = 1 |
12 / 48 = 25 % |
| 1 | 36 | 108 | 108 / 36 = 3 |
36 / 48 = 75 % |
Trung bình của hai giá trị trung bình cục bộ là:
(1 + 3) / 2 = 2.
Nhưng trung bình của tất cả token là:
(12 + 108) / (12 + 36) = 120 / 48 = 2,5.
Chúng ta cũng có thể tìm lại kết quả này bằng cách gán trọng số cho các giá trị trung bình cục bộ:
25 % × 1 + 75 % × 3 = 2,5.
Điều gì đã xảy ra trong phép tính đầu tiên? Hạng có chuỗi ngắn nhận một nửa tổng trọng số dù chỉ chứa một phần tư số token. Mỗi token của hạng 0 có trọng số 1 / (2 × 12), so với 1 / (2 × 36) của một token ở hạng 1: token ở hạng thứ nhất có trọng số gấp ba token ở hạng thứ hai.
Vì vậy, đây không phải lỗi làm tròn. Chúng ta đã thay đổi câu hỏi đặt ra cho phép tính: “trung bình của hai hạng là bao nhiêu?” đã thay cho “trung bình của tất cả token là bao nhiêu?”.
Khi các hạng chứa cùng số token, hai công thức cho cùng kết quả. Các giá trị trung bình cục bộ giống nhau cũng có thể che giấu sự khác biệt. Đó là lý do chỉ kiểm thử các lô cân bằng không thể phát hiện vấn đề này.
DDP tham gia ở đâu?
DistributedDataParallel, viết tắt là DDP, đồng bộ gradient giữa các bản sao của mô hình. Với cách hoạt động được sử dụng ở đây, phép tổng hợp tương ứng với việc lấy trung bình giữa các hạng. Tuy nhiên, DDP không biết mục tiêu của bạn là trung bình theo token, và cũng không phân chia đầu vào thay bạn. Việc chọn các chuỗi vẫn là trách nhiệm của ứng dụng, như tài liệu PyTorch về DDP nêu rõ.
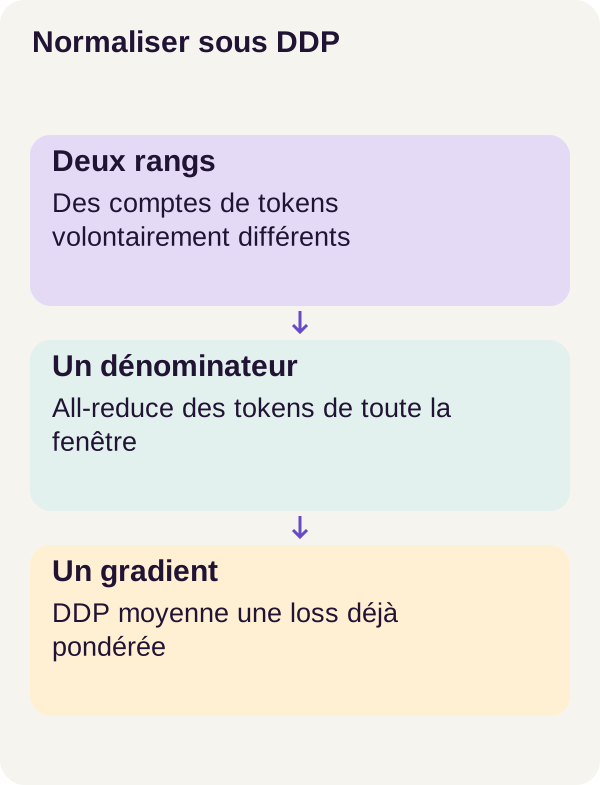
Do đó, ý tưởng của bài hướng dẫn là chuẩn bị giá trị mất mát có trọng số đúng trên mỗi hạng trước bước backward. Khi ấy, DDP có thể đồng bộ gradient mà không thay đổi mục tiêu tổng thể cần đạt.
Điều kiện cần: Docker và hai GPU
Quy trình đã được kiểm chứng yêu cầu Linux x86_64, Docker với Compose, NVIDIA Container Toolkit và hai RTX 3090 có bộ nhớ 24 GiB được nhận diện trong container. Bạn cũng cần 16 GiB RAM và 16 GiB dung lượng đĩa, chưa tính các lớp Docker dùng chung.
VRAM là bộ nhớ riêng của mỗi card đồ họa. Hai card 24 GiB vẫn là hai bộ nhớ riêng biệt: DDP đặt một bản sao mô hình trên mỗi card, chứ không tạo ra một card ảo 48 GiB. Ở đây, CUDA cho phép thực hiện các phép tính trên GPU NVIDIA. NCCL là backend dùng cho giao tiếp giữa các tiến trình GPU; quy trình này không kiểm chứng một quy trình CPU hoặc Gloo thay thế.
Về phía Docker, dịch vụ gpu thực hiện các bước chuẩn bị và kiểm tra đơn giản. Dịch vụ dual phục vụ quy trình hai tiến trình. torchrun, mà chúng ta sẽ dùng ở phần sau, sẽ khởi chạy các tiến trình này bên trong container.
Script setup.sh tạo các thư mục và chỉ ghi UID/GID vào .env. Các mã này tương ứng với người dùng và nhóm của người dùng trên máy chủ. outputs/ nhận các số liệu đo; artifacts/ nhận checkpoint, tức là các trạng thái đã lưu để tiếp tục huấn luyện.
Không có trọng số đã huấn luyện sẵn hay dữ liệu bên ngoài cần tải: vì vậy, acquire kiểm tra một bước thu nhận rỗng. Điều đó không có nghĩa việc dựng image Docker không cần tài nguyên; riêng dữ liệu thí nghiệm sẽ do dự án tạo ra.
Giải nén gói lưu trữ và chuyển terminal đến thư mục gốc của dự án. Tất cả lệnh tiếp theo đều phải chạy từ cùng thư mục này. Bắt đầu bằng việc dựng image và kiểm tra khả năng truy cập một GPU, rồi cả hai GPU:
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu dual
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm dual python scripts/check_environment.py --config configs/minimum.yaml --dual
docker compose config --quiet kiểm tra cấu hình Compose. Các script kiểm tra môi trường thực sự khởi tạo CUDA và kiểm tra những card được nhận diện: việc máy chủ có GPU chưa đủ để chứng minh Docker truy cập được GPU đó.
Cả hai bước kiểm tra môi trường phải thành công trước khi tiếp tục. Nếu thất bại, hãy sửa vấn đề này trước khi chạy torchrun; hướng dẫn chính thức của NVIDIA Container Toolkit mô tả cách tích hợp với Docker.
Các lớp Docker đã có sẵn có thể rút ngắn thời gian dựng image. Chúng không thay đổi công thức chuẩn hóa mà chúng ta sẽ so sánh.
Kiểm tra chương trình trước phép tính phân tán
Trước khi khởi chạy hai tiến trình, hãy chạy các bài kiểm thử công khai. Chúng bao phủ các hàm chuẩn hóa và tiếp tục huấn luyện của dự án:
docker compose run --rm gpu python -m pytest -q
Đây cũng là logic của một bài kiểm thử đơn vị cho phép tính giỏ hàng trước khi thử đặt hàng hoàn chỉnh: trước hết chúng ta kiểm tra các hàm, rồi kiểm tra hành vi của chúng trong quy trình thực tế.
Việc bộ kiểm thử này thành công không thay thế phép so sánh số học với tham chiếu một GPU. Nó cũng không thay thế thử nghiệm dừng và tiếp tục. Các kiểm tra này đến sau và trả lời những câu hỏi khác.
Dữ liệu: chủ động tạo ra sự mất cân bằng
Chuỗi ngắn ở một bên, chuỗi dài ở bên kia
Bộ dữ liệu gồm 1 024 chuỗi huấn luyện, 128 chuỗi xác thực và 256 chuỗi kiểm thử. Trong mỗi cửa sổ huấn luyện, rank 0 nhận các chuỗi từ 16 đến 64 token, còn rank 1 nhận các chuỗi từ 65 đến 128 token.
Sự mất cân bằng này là có chủ ý. Nó buộc chương trình phải phân biệt số lượng chuỗi với số lượng token. Dù mỗi card có cùng số chuỗi, hai rank vẫn không mang cùng lượng dữ liệu giám sát.
Một microbatch, hay lô vi mô, là lô nhỏ được xử lý trong một lần đi qua mô hình. Một cửa sổ tích lũy tập hợp nhiều microbatch mà gradient được cộng lại trước một lần cập nhật trọng số duy nhất. Ở đây, mỗi cửa sổ có hai microbatch cho mỗi rank.
Kế hoạch sau chọn các định danh của những chuỗi này. Nó chưa tính loss, chưa chuyển gì lên GPU và cũng chưa tự xây dựng các mảng padding.
def make_rank_batches(rows, config):
    pools = [
        [
            r["id"]
            for r in rows
            if r["split"] == "train" and (len(r["tokens"]) <= 64) == (rank == 0)
        ]
        for rank in range(2)
    ]
    rng = random.Random(config["seed"] + 10)
    plan = []
    for step in range(config["updates"]):
        selected = [
            rng.sample(pool, config["accumulation"] * config["batch_size_per_rank"])
            for pool in pools
        ]
        plan.append(
            [
                [
                    ids[i : i + config["batch_size_per_rank"]]
                    for i in range(0, len(ids), config["batch_size_per_rank"])
                ]
                for ids in selected
            ]
        )
    return plan
Đọc kế hoạch như một cấu trúc dữ liệu Python
Biến pools chứa hai danh sách định danh. Bộ lọc chỉ giữ các dòng train. Biểu thức (len(r["tokens"]) <= 64) == (rank == 0) đưa chuỗi ngắn vào nhóm thứ nhất và chuỗi dài vào nhóm thứ hai. Các giới hạn 16 và 128 thuộc về bộ dữ liệu đã chuẩn bị; hàm này chỉ dùng ngưỡng 64.
Bộ sinh random.Random(config["seed"] + 10) tách riêng việc rút mẫu cho kế hoạch này. Với dữ liệu, thứ tự danh sách và cấu hình giống nhau, ta có thể tái tạo các lựa chọn của nó.
Ở mỗi lần cập nhật, rng.sample lấy accumulation × batch_size_per_rank định danh trong mỗi nhóm. Sau đó phần cắt ids[i : i + batch_size_per_rank] phân chúng vào các microbatch. Cấu trúc được đọc như sau: plan[step][rank][microbatch] trả về danh sách định danh cần xử lý.
Trong một cửa sổ, việc rút mẫu không hoàn lại: một định danh không được chọn hai lần cho cùng một rank. Vì các nhóm rời nhau, nó cũng không được chia sẻ giữa hai rank. Tuy nhiên, ở cửa sổ tiếp theo cùng một định danh có thể xuất hiện lại. Mã không loại bỏ vĩnh viễn các phần tử khỏi nhóm. Đó là hành vi của random.sample, được dùng ở mỗi cửa sổ mới.
Vì vậy, chúng ta không nhất thiết duyệt hết bộ dữ liệu một lần trước khi gặp lại một ví dụ. Kế hoạch được xác định bởi các lần cập nhật, không phải bởi giả định ngầm về một lượt đi qua trọn vẹn không lặp lại.
Hai kiểu “đệm” không nên nhầm lẫn
Padding token bổ sung vào các chuỗi ngắn để tạo thành một mảng hình chữ nhật. Để hình dung bằng ví dụ nhỏ, tách biệt với bộ dữ liệu: [7, 4, 9] và [5, 2] có thể thành [7, 4, 9] và [5, 2, PAD]. Mảng có sáu ô nhưng chỉ có năm token gốc. Ô được thêm vào không được làm tăng mẫu số của loss.
Padding của sampler chỉ một vấn đề khác: hoàn chỉnh kế hoạch dữ liệu bằng cách lặp một số định danh để cân bằng các tiến trình. Ở đây, kế hoạch không đưa các bản sao như vậy giữa các rank trong một cửa sổ. Sự mất cân bằng token vẫn hiển thị thay vì bị che giấu.
Bây giờ hãy xây dựng bộ dữ liệu, kế hoạch và tham chiếu một GPU:
docker compose run --rm gpu python -m ddp_tokens.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m ddp_tokens.cli reference --config configs/minimum.yaml
docker compose run --rm gpu python -m ddp_tokens.cli check-loss --config configs/minimum.yaml
prepare cố định các chuỗi và cửa sổ. reference bắt đầu từ cùng trạng thái ban đầu với phép so sánh phân tán và làm tính toán đối chứng. check-loss hiển thị hai giá trị của phản ví dụ, 2 và 2,5, trước khi chạy bất kỳ lệnh nào với torchrun.
Đến đây, chúng ta đã có dữ liệu và kết quả để so sánh. Còn cần hiểu cách cân trọng số các loss cục bộ để tìm lại kết quả đó.
Phép tính cốt lõi: mẫu số toàn cục
Một mẫu số cho toàn bộ cửa sổ
Hãy đặt tên cho các đại lượng để đọc công thức:
W là số rank, tức 2 trong dự án này. S_r là tổng loss của rank r trên toàn cửa sổ. N_r là số token được giám sát của nó. Cuối cùng, N = tổng các N_r là tổng số token được giám sát của hai rank, trên hai microbatch.
Mục tiêu mong muốn là:
L = (S_0 + S_1) / N.
Ta có thể muốn để mỗi rank tính S_r / N. Nhưng sau đó DDP lấy trung bình gradient giữa hai tiến trình: việc này sẽ thêm một phép chia cho 2 mà ta không cần.
Do đó mỗi rank dùng:
L_r = W × S_r / N.
Sau khi DDP lấy trung bình, hệ số W triệt tiêu:
(1 / W) × somme_r gradient(W × S_r / N) = gradient(somme_r S_r / N).
Ký hiệu “gradient” ở đây là các đạo hàm theo trọng số. Lập luận dựa trên một mẫu số được dữ liệu của cửa sổ xác định, không phụ thuộc vào trọng số, và trên trung bình gradient mà DDP này sử dụng. Nhân với W không nhằm “học nhanh gấp đôi”: nó bù cho một phép chia vốn đã có trong phép gộp.
Trong phản ví dụ của chúng ta, W / N = 2 / 48 = 1 / 24. Vì thế rank 0 dùng 12 / 24 = 0,5 và rank 1 dùng 108 / 24 = 4,5. Trung bình của các đóng góp này là (0,5 + 4,5) / 2 = 2,5.
Hai vô hướng cục bộ này không còn là các trung bình cục bộ 1 và 3. Điều đó bình thường: chúng được chuẩn bị cho phép gộp. Nhầm chúng với một chỉ số trung bình đã tính trên toàn bộ dữ liệu sẽ làm nhật ký gây hiểu lầm.
Đếm trước khi backpropagate
def global_token_loss(local_sum, global_count, world_size):
    if global_count <= 0:
        raise ValueError(
            "No supervised token in the global accumulation window; all ranks must skip or stop together"
        )
    return local_sum * (world_size / global_count)


def global_count(local_count, device):
    count = torch.tensor(local_count, device=device, dtype=torch.long)
    dist.all_reduce(count, op=dist.ReduceOp.SUM)
    return int(count)
global_token_loss nhận một tổng, không phải một loss đã lấy trung bình. Nó nhân tổng đó với hệ số chung world_size / global_count. Thay bằng một trung bình cục bộ sẽ làm thay đổi trọng số lần thứ hai.
Hàm global_count biến bộ đếm cục bộ thành một tensor số nguyên trên thiết bị đang dùng. Tensor ở đây đơn giản là một giá trị số mà PyTorch có thể thao tác và truyền đi. dist.all_reduce(..., SUM) cộng các bộ đếm và để lại tổng trong tensor của mỗi rank: 12 và 36 thành 48 trên cả hai tiến trình. int(count) lấy tổng này dưới dạng số nguyên Python. Tài liệu collective của PyTorch mô tả phép toán tại chỗ này.
Một collective là giao tiếp mà các tiến trình trong nhóm cùng tham gia. Vì vậy bộ đếm không được gửi đến một “trưởng nhóm” duy nhất giữ kết quả: cả hai rank đều cần cùng mẫu số trước backward.
Cần ghi nhớ hai thao tác khác nhau: chương trình trước hết cộng số lượng token, rồi DDP đồng bộ gradient. Mã trên không tự động đồng bộ một chỉ số loss toàn cục.
Nếu cửa sổ không có token được giám sát thì sao?
Một trung bình trên không token là không xác định. Vì vậy nhánh global_count <= 0 ném ra lỗi thay vì tạo một loss bằng không.
Trong dự án này, các rank cùng từ chối một cửa sổ. Tuy vậy, riêng hàm này không thiết lập toàn bộ điều phối: nơi gọi phải tính cùng một số đếm toàn cục và giữ luồng thực thi tương thích giữa các tiến trình.
Hãy hình dung hai worker cần gặp nhau ở một bước trao đổi. Nếu một worker tự quyết định thoát vòng lặp còn worker kia vẫn chờ trao đổi đó, worker thứ hai có thể bị treo. Vì thế một điều kiện cục bộ không được tự mình bỏ qua một collective hoặc một backward mà các rank khác vẫn chờ.
Một rank rỗng cục bộ không giống một cửa sổ rỗng toàn cục. Nếu các rank khác có giám sát, mẫu số toàn cục có thể dương. Điều chỉnh dự án cho trường hợp này đòi hỏi kiểm thử sự tham gia đúng của nó vào phép tính và giao tiếp; chỉ riêng chốt chặn N <= 0 không chứng minh mọi trường hợp rỗng cục bộ đều được xử lý.
check_loss() kiểm tra chính xác điều gì
def check_loss(config):
    local_sums = [12.0, 108.0]
    counts = [12, 36]
    wrong = sum(s / n for s, n in zip(local_sums, counts)) / 2
    correct = sum(global_token_loss(s, sum(counts), 2) for s in local_sums) / 2
    assert correct == 2.5 and wrong == 2.0
    return {
        "local_tokens": counts,
        "local_loss_sums": local_sums,
        "mean_of_means": wrong,
        "global_mean": correct,
    }
wrong tái tạo trung bình của các trung bình: 2. correct áp dụng công thức có trọng số rồi lấy trung bình giữa hai rank: 2,5. Tham số config không được dùng trong kiểm tra nhỏ này; các giá trị được cố ý cố định trong hàm.
Bài kiểm thử chạy trên các số Python. Nó không chạy mạng nơ-ron, backward hay giao tiếp DDP. Nó kiểm tra đồng nhất thức số học; phép so sánh gradient thực sự nằm trong giao thức GPU.
Biến thể wrong phải tiếp tục sai. Nó đóng vai trò kiểm soát âm: một kiểm thử chấp nhận được công thức đúng nhưng không thể từ chối công thức sai sẽ không bảo vệ cơ chế đang nghiên cứu. Một phép chia thêm theo số microbatch không sửa được trọng số này.
Vì sao loss giống nhau chưa đủ chứng minh gradient giống nhau
Đây là một ví dụ sư phạm độc lập với mô hình r1, có một tham số duy nhất θ và sai số bình phương.
Rank 0 có 12 đích bằng +1: tổng loss của nó là 12 × (θ − 1)². Rank 1 có 36 đích bằng −1: tổng của nó là 36 × (θ + 1)².
Tại θ = 0, mọi token đều có loss bằng 1. Do đó hai phương pháp đều hiển thị loss trung bình là 1. Chỉ nhìn con số này, chúng ta không thấy khác biệt nào.
Nhưng đạo hàm của (θ − 1)² là 2 × (θ − 1), tức −2 tại điểm này. Đạo hàm của (θ + 1)² là +2. Khi đó trung bình các trung bình tạo gradient (-2 + 2) / 2 = 0. Trung bình toàn cục tạo (12 × -2 + 36 × 2) / 48 = 1.
Loss hiển thị giống nhau, gradient khác nhau. Đó chính là lý do kiểm chứng của chúng ta so sánh trực tiếp các gradient, không chỉ hai giá trị loss trong nhật ký.
Tích lũy: bao gồm forward và backward
Hai microbatch, một lần cập nhật
Thay vì tính toàn bộ cửa sổ trong một lần, chúng ta xử lý lần lượt các microbatch. Mỗi lệnh gọi backward() thêm đóng góp của nó vào các gradient hiện có. Tài liệu Tensor.backward mô tả sự tích lũy này: vì vậy cần xóa gradient cũ đúng lúc, chứ không phải sau mỗi microbatch.
Trong cửa sổ này, trọng số không được cập nhật giữa các microbatch. Nếu không, các đóng góp sẽ được tính trên những trạng thái mô hình khác nhau và không còn đại diện cho gradient của cùng một tổng.
Forward tính các dự đoán từ đầu vào. Backward tính các đạo hàm của loss. no_sync() không loại bỏ phép tính nào trong số đó: nó hoãn việc đồng bộ gradient giữa các rank đối với các microbatch trung gian.
def accumulate(model, batches, mapping, rank, denominator, world, wrong=False):
    model.zero_grad(set_to_none=True)
    local_n = sum(len(mapping[i]["tokens"]) for micro in batches for i in micro)
    for index, ids in enumerate(batches):
        # The context deliberately includes the forward as well as the backward.
        context = (
            model.no_sync() if index < len(batches) - 1 else contextlib.nullcontext()
        )
        with context:
            tokens, labels = padded(ids, mapping, rank)
            summed = loss_sum(model(tokens), labels)
            loss = (
                summed / local_n
                if wrong
                else global_token_loss(summed, denominator, world)
            )
            loss.backward()
    return local_n
Theo dõi trách nhiệm của từng dòng
model.zero_grad(set_to_none=True) xóa gradient của cửa sổ trước. Lệnh này được đặt trước vòng lặp để hai backward tiếp theo có thể đóng góp vào cùng một phép tích lũy.
local_n đếm token gốc của các chuỗi thuộc rank này trong toàn cửa sổ. mapping cho phép tìm lại một chuỗi từ định danh của nó. Còn mẫu số toàn cục đã đến trong tham số denominator: accumulate() không lấy nó bằng cách gọi global_count() trong vòng lặp này.
Với mỗi microbatch, padded() chuẩn bị đầu vào và nhãn giám sát. model(tokens) thực hiện forward, sau đó loss_sum() cho tổng loss của các vị trí được giữ lại. Mạng nhỏ, padding và hàm loss này thuộc về dự án hoàn chỉnh; các trích đoạn bài viết tập trung vào chuẩn hóa và tích lũy.
Lựa chọn wrong=True chia mỗi tổng microbatch cho local_n. Sau khi cộng các microbatch, nó trở thành trung bình cục bộ của rank. DDP sau đó sẽ lấy trung bình giữa các rank: đó chính là tham chiếu sai mà bài kiểm thử phải phát hiện.
Trên nhánh đúng, ngược lại mỗi microbatch dùng cùng một số đếm toàn cục của cửa sổ. Ta không chuẩn hóa theo độ dài riêng của nó hay theo một mẫu số tính lại chỉ cho lần đi qua này.
Cuối cùng, hàm trả về local_n. Nó không có lời gọi optimizer.step(): việc cập nhật trọng số thuộc về vòng lặp huấn luyện bao quanh nó. Dự án không thêm một phép chia mới tại thời điểm cập nhật này.
Vì sao đặt forward trong no_sync()?
Với microbatch đầu tiên, context là model.no_sync(). Với microbatch cuối, nó là contextlib.nullcontext(), một ngữ cảnh không thay đổi gì. Vì thế đồng bộ DDP hoạt động trong lượt cuối.
Điểm tinh tế là phạm vi của with: cả forward lẫn backward đều phải ở bên trong. Chỉ bao loss.backward() không đủ để loại bỏ đồng bộ như dự kiến. Đây là điều kiện rõ ràng trong tài liệu no_sync().
Cuối backward cuối cùng, các đóng góp đã tích lũy tham gia vào đồng bộ. Đây là một điểm đồng bộ logic của cửa sổ; điều đó không có nghĩa mọi gradient nhất thiết nằm trong một thông điệp mạng duy nhất.
Tự tính lại phép tích lũy
Hãy phân rã phản ví dụ 12/36 thành hai microbatch giả định cho mỗi rank. Bảng này minh họa phép tính; đây không phải độ dài lô được ghi nhận trong r1.
Trên thiết bị di động, hãy cuộn bảng theo chiều ngang.
| Rank | Microbatch | Token hợp lệ | Tổng loss | Đóng góp với W / N = 2 / 48 |
|---|---|---|---|---|
| 0 | Thứ nhất | 4 | 4 | 4 / 24 ≈ 0,1667 |
| 0 | Thứ hai | 8 | 8 | 8 / 24 ≈ 0,3333 |
| 1 | Thứ nhất | 12 | 36 | 36 / 24 = 1,5 |
| 1 | Thứ hai | 24 | 72 | 72 / 24 = 3 |
Hai đóng góp của rank 0 có tổng 0,5; các đóng góp của rank 1 có tổng 4,5. Trung bình của chúng vẫn là 2,5. Việc chia thành các microbatch không thay đổi định nghĩa của trung bình.
Chia thêm mỗi đóng góp cho accumulation = 2 sẽ cho 1,25 sau gộp và cũng chia gradient cho hai. Mẫu số toàn cục của cửa sổ đã tính đến cả bốn microbatch.
Vì vậy quy tắc không phải là “không bao giờ chia theo số microbatch”. Quy tắc là: không thêm một phép chia đã được chứa trong chuẩn hóa đã chọn. Một cách làm bắt đầu từ trung bình các microbatch có kích thước bằng nhau cần được lý giải khác với cách này, vốn bắt đầu từ tổng và một số đếm toàn cục.
Chạy dừng, chạy liên tục và tiếp tục
Bây giờ chúng ta có thể chạy ba lượt phân tán: một lượt dừng ở bước 50, một lượt huấn luyện liên tục đến 100, rồi một lượt tiếp tục từ 50 đến 100.
docker compose run --rm dual torchrun --rdzv-backend=static --master-addr=127.0.0.1 --master-port=29500 --nnodes=1 --nproc-per-node=2 -m ddp_tokens.train --config configs/minimum.yaml
docker compose run --rm dual torchrun --rdzv-backend=static --master-addr=127.0.0.1 --master-port=29500 --nnodes=1 --nproc-per-node=2 -m ddp_tokens.train --config configs/minimum.yaml --continuous
docker compose run --rm dual torchrun --rdzv-backend=static --master-addr=127.0.0.1 --master-port=29500 --nnodes=1 --nproc-per-node=2 -m ddp_tokens.train --config configs/minimum.yaml --resume artifacts/checkpoints/step-0050
Hãy chạy các lệnh này lần lượt. --nnodes=1 mô tả một nút tính toán duy nhất, còn --nproc-per-node=2 khởi chạy hai tiến trình. Điểm hẹn tĩnh tại địa chỉ 127.0.0.1, cổng 29500, phục vụ điều phối cục bộ của chúng. Cổng này không phải cổng của API nghiệp vụ. Tài liệu torchrun giải thích vai trò của trình khởi chạy và các rank.
Quy trình không có tùy chọn bổ sung tạo điểm dừng dự kiến ở 50. --continuous tạo đối chứng ở 100 lần cập nhật. --resume artifacts/checkpoints/step-0050 tải trạng thái đã dừng để tiếp tục cùng quy trình đến 100.
Checkpoint không chỉ là một tệp trọng số
Hãy nghĩ đến một xử lý dữ liệu bị gián đoạn: giữ kết quả một phần mà không biết các phần tử nào đã được đọc thì không đủ để tiếp tục đúng chỗ. Huấn luyện cũng cần sự liên tục như vậy.
Checkpoint chung của dự án chứa mô hình, optimizer, cấu hình và khóa dữ liệu. Khóa này nhận diện dữ liệu được mong đợi; không nên nhầm nó với khóa ngăn hai tiến trình vào một vùng tới hạn.
Mỗi rank cũng lưu trạng thái ngẫu nhiên, rank và lịch sử của mình. Chương trình giữ lịch sử của sampler, tức cơ chế chọn chuỗi. Việc tiếp tục phải tìm lại cả trọng số lẫn phần tiếp theo của lộ trình dữ liệu.
Một seed khởi tạo bộ sinh giả ngẫu nhiên. Trạng thái hiện tại của nó cho biết nó đang ở đâu sau các lần rút mẫu đã thực hiện. Chỉ đặt lại seed ban đầu có thể khởi động lại chuỗi rút mẫu thay vì tiếp tục tại điểm dừng. Ghi chú PyTorch về khả năng tái lập giúp phân biệt việc kiểm soát ngẫu nhiên với các bảo đảm giữa môi trường.
Việc tiếp tục ở đây diễn ra tại một ranh giới cập nhật do giao thức xác định. Nó không chứng minh có thể khôi phục một lần dừng tùy ý giữa backward hoặc giao tiếp.
Các phép đo cần đọc trước kết quả
Ba câu hỏi, ba kiểm tra
Câu hỏi thứ nhất là: gradient DDP có khớp với gradient một GPU không? Dự án nối tiếp các giá trị gradient để tạo một vector, rồi so sánh vector này với tham chiếu thu được từ cùng trạng thái ban đầu và cùng token. Kiểm tra bao gồm 282 628 giá trị, với dung sai atol=1e-6 và rtol=1e-4. Con số này mô tả các thành phần được so sánh, không phải kích thước bộ dữ liệu.
Câu hỏi thứ hai là: việc tiếp tục có tìm lại cùng tham số như huấn luyện liên tục không? Khi đó chúng ta so sánh trọng số ở bước 100, chứ không phải gradient của kiểm tra ban đầu. Công thức đúng và việc tiếp tục đúng là hai thuộc tính riêng biệt.
Câu hỏi thứ ba là: mô hình được huấn luyện trên dữ liệu kiểm thử cho kết quả gì? Quy trình thực hiện 100 lần cập nhật bằng SGD, FP32 và tích lũy hai microbatch cho mỗi rank. SGD là optimizer dùng để áp dụng gradient. FP32 chỉ phép tính dấu phẩy động 32 bit. Kiểm thử cuối bao gồm 256 chuỗi và 18 231 token hợp lệ.
Loss token test là loss trung bình theo token. Nó không phải tỷ lệ thành công. Độ chính xác token đo tỷ lệ token dự đoán đúng trong các vị trí được đánh giá; không có nghĩa cùng tỷ lệ chuỗi hoàn chỉnh là đúng.
Đọc dung sai số như thế nào?
Dung sai tuyệt đối giới hạn các sai lệch nhỏ, đặc biệt gần không. Dung sai tương đối điều chỉnh theo độ lớn của giá trị tham chiếu. Quy ước mô tả cho torch.allclose là, theo từng thành phần:
abs(gradient_DDP - gradient_reference) <= atol + rtol × abs(gradient_reference).
Với dung sai của chúng ta, tham chiếu bằng 0 cho phép sai lệch tới 0,000001. Tham chiếu bằng 1 cho phép 0,000001 + 0,0001 = 0,000101. Đây là ví dụ để đọc các ngưỡng, không phải thành phần gradient r1 được công bố.
Vì sao không yêu cầu mọi nơi đều bằng không? Thứ tự thao tác có thể khác giữa tính toán một GPU và tính toán phân tán. Các phép cộng ở độ chính xác hữu hạn không hoàn toàn có tính kết hợp. Ghi chú PyTorch về độ chính xác số nhắc rằng một đồng nhất thức toán học không bảo đảm bằng nhau từng bit giữa hai đường tính toán.
Kiểm tra đúng áp dụng dung sai cho mọi thành phần. Sai số tuyệt đối tối đa tóm tắt sai lệch lớn nhất, nhưng riêng nó không thay thế phép so sánh đầy đủ này.
Đọc báo cáo của quy trình
Hãy tính đánh giá:
docker compose run --rm gpu python -m ddp_tokens.cli evaluate --config configs/minimum.yaml
Các giá trị sau là các phép đo cục bộ quan sát trong quy trình r1. Chúng không dự đoán chất lượng của kiến trúc khác, dữ liệu thật, optimizer khác hay huấn luyện trên nhiều nút.
Trên thiết bị di động, hãy cuộn bảng theo chiều ngang.
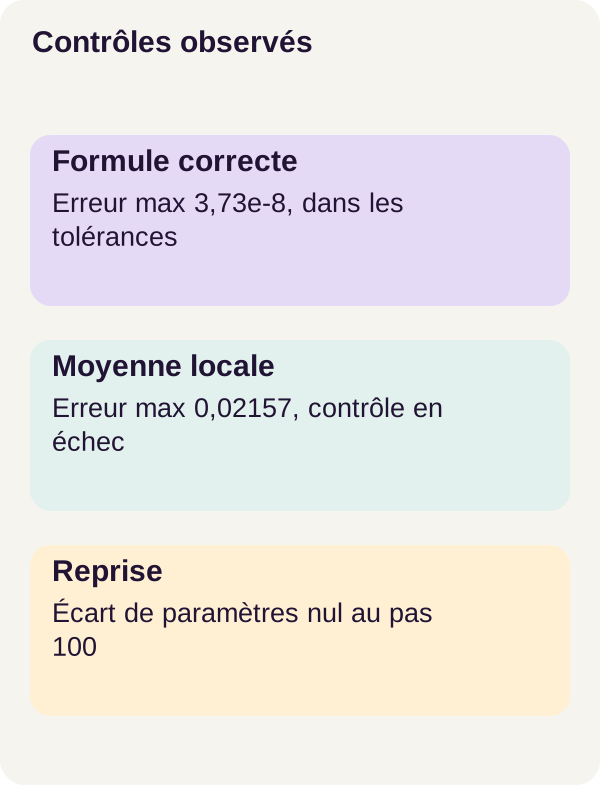
| Kiểm tra quan sát | Kết quả |
|---|---|
| Sai số tuyệt đối tối đa, chuẩn hóa đúng | 3,73e-8 |
| Chuẩn hóa đúng trong dung sai | Có |
| Sai số tuyệt đối tối đa, trung bình các trung bình | 0,02157 |
| Chuẩn hóa sai trong dung sai | Không |
| Chênh lệch tham số tối đa, tiếp tục so với liên tục | 0 |
| Loss token test | 1,31525 |
| Độ chính xác token test | 36,22 % |
Chuẩn hóa đúng tìm lại tham chiếu trong dung sai, với sai số tuyệt đối tối đa 3,73e-8. Trung bình các trung bình thất bại ở cùng kiểm tra, với sai số tối đa 0,02157. Vì vậy chúng ta vừa có một trường hợp được chấp nhận vừa có một lỗi chủ ý thực sự được phát hiện.
Kiểm thử tiếp tục trả lời một câu hỏi khác: chênh lệch tối đa giữa tham số được tiếp tục và tham số của quy trình liên tục là 0 tại bước 100. Việc giữ lịch sử sampler và các bộ sinh ngẫu nhiên theo rank là một phần của việc tiếp tục này. Số không không mâu thuẫn với sai khác nhỏ của gradient một GPU/DDP: hai phép so sánh không xét cùng đối tượng hay cùng quy trình.
Hai rank cũng cùng từ chối một cửa sổ có không token được giám sát. Kiểm tra này bổ sung cho đường đi thông thường: nó xác minh việc vắng mặt giám sát toàn cục không bị coi là một trung bình hợp lệ.
Cuối cùng, loss test 1,31525 và độ chính xác token 36,22 % không phải là bằng chứng về lợi ích kinh doanh. Kết quả trọng tâm của hướng dẫn là tính tương đương của phép tính đã chọn. Đây không phải xếp hạng mô hình hay phép đo tăng tốc trên hai GPU.
Việc tiếp tục chính xác thiết lập cơ chế trong giao thức này. Nó không chứng minh độ vững của việc tiếp tục bị ngắt tại bất kỳ thời điểm nào trên hạ tầng phân tán.
Những gì chúng ta đã học
Một trung bình bắt đầu bằng một câu hỏi: đơn vị nào phải có trọng số như nhau? Ở đây, câu trả lời là token được giám sát. Trung bình các trung bình theo rank cho các token này trọng số khác khi số lượng của chúng khác nhau.
DDP đồng bộ gradient nhưng không biết ý định này. Hệ số world_size / global_count chuẩn bị các đóng góp cục bộ để trung bình của chúng khớp với gradient mong muốn. Số GPU không phải hệ số cần thêm hoặc bớt theo thói quen: cần theo dõi các phép chia thực sự diễn ra.
Tích lũy không thay đổi mục tiêu. Nó chia phép tính thành các microbatch, với một mẫu số phủ toàn bộ cửa sổ và trọng số không đổi giữa các lượt. no_sync() hoãn đồng bộ; nó không thay thế việc đếm token hay backward.
Cuối cùng, checkpoint phải cho phép tiếp tục quỹ đạo, không chỉ tải lại mô hình. Dữ liệu sắp tới, trạng thái optimizer và các bộ sinh ngẫu nhiên cũng thuộc về tính liên tục này.
Bài tập: giả thuyết trước lệnh
Rank 0 giữ 12 token hợp lệ. Rank 1 tăng từ 12 lên 36 token, không đổi phân bố loss theo token mà chúng ta muốn so sánh. Trước khi chạy chương trình, hãy dự đoán trung bình các trung bình và trung bình toàn cục sẽ thay đổi ra sao. Cách nào cho rank ngắn trọng số quá lớn?
Để làm phép tính rõ ràng, hãy dùng giả thuyết sư phạm: loss là 1 cho mỗi token ở rank 0 và 3 cho mỗi token ở rank 1, trước và sau thay đổi. Giả thuyết này phục vụ tính tay; gradient của bài tập là các giá trị do chương trình chạy cung cấp.
Với 12 token trên mỗi rank, các tổng là 12 và 36. Cả hai trung bình đều cho 2. Khi rank thứ hai tăng lên 36 token, tổng của nó thành 108: trung bình các trung bình vẫn là 2, còn trung bình toàn cục thành 2,5.
Vì thế trung bình các trung bình không thấy rằng nhóm có loss cao nhất giờ có số token gấp ba lần. Rank ngắn vẫn giữ một nửa trọng số thay vì một phần tư.
Hãy viết cả dự đoán của bạn về chuẩn hóa: có cần đổi W, đổi N hay chia lần nữa theo số microbatch không? Cả hai rank vẫn hiện diện nên W vẫn là 2; số token toàn cục mới là thứ thay đổi.
Sau đó hãy chạy bài tập của quy trình:
docker compose run --rm gpu python -m ddp_tokens.cli exercise --config configs/exercise.yaml
So sánh các phép tính và gradient được cung cấp với giả thuyết của bạn. Đừng chờ sai số loss 0,5 tự động tạo ra sai khác gradient 0,5: giá trị của một hàm và đạo hàm của nó là hai đối tượng khác nhau.
Giữ sự thất bại của biến thể sai như một kiểm tra không hồi quy. Mục tiêu không phải làm mọi chế độ đều qua bằng cách nới lỏng ngưỡng, mà là xác minh một thay đổi mã trong tương lai không làm trọng số sai trở nên vô hình.
Điều chỉnh mô hình và chuẩn bị sản xuất
Chọn đơn vị trước khi chép lại công thức
Trong dự án khác, đơn vị để gán trọng số có thể là một chuỗi, ví dụ, tài liệu hoặc chi phí kinh doanh. Gán cùng tổng trọng số cho mỗi tài liệu, bất kể độ dài, không giống với gán cùng trọng số cho từng token của nó. Hai lựa chọn có thể đáp ứng các nhu cầu khác nhau; cần nêu rõ cái nào được huấn luyện.
Bộ đếm trong mã ở đây cộng len(mapping[i]["tokens"]). Điều này phù hợp với token được giám sát trong bộ dữ liệu này. Lối tắt này không mang tính phổ quát. Trong huấn luyện khác, một số vị trí đầu vào có thể bị loại khỏi loss: prompt không được giám sát, nhãn bị bỏ qua hoặc đích bị dịch. Cần đếm các vị trí thực sự đóng góp vào mục tiêu, không chỉ độ dài đầu vào.
Như một tham chiếu chung, CrossEntropyLoss ghi nhận các nhãn bị bỏ qua và ảnh hưởng của trọng số đến phép giảm. Điều đó không thay thế định nghĩa loss_sum() trong ứng dụng của bạn. Thêm trọng số lớp hoặc hạng điều chuẩn cũng đòi hỏi suy ra lại chuẩn hóa của từng hạng, không áp máy móc cùng mẫu số lên toàn bộ loss.
Công thức trình bày cũng giả định phép gộp DDP của quy trình tham chiếu. Chiến lược giao tiếp tùy chỉnh, số người tham gia thay đổi hoặc các rank không còn thực hiện cùng số lượt đều đòi hỏi xem lại giả định và kiểm thử.
Kiểm thử một điều chỉnh mà không đổi đối chứng
Giữ quy trình tham chiếu, sau đó làm việc trong một bản sao để sửa bộ dữ liệu hoặc mô hình. Luôn so sánh gradient nhận được từ cùng trạng thái ban đầu và các vị trí được giám sát giống nhau. Chủ động đưa vào các kích thước không bằng nhau: một kiểm thử chỉ có các số đếm giống nhau có thể bỏ lọt lỗi được nghiên cứu ở đây.
Kiểm tra riêng một cửa sổ rỗng toàn cục và các nhánh chỉ một rank không có giám sát. Đừng kết luận một nhánh an toàn vì phép tính đại số của đường bình thường đúng: cũng phải xác minh thứ tự tham gia vào giao tiếp.
Điều phần minh họa không cung cấp
Triển khai phân tán trong môi trường sản xuất cần một điểm hẹn vững giữa các tiến trình, thời hạn, chính sách tiếp tục, nhật ký và chỉ số theo rank, xử lý tiền nhiệm, kiểm thử nhiều nút và chiến lược dữ liệu.
Đặc biệt, phải xác định được rank nào thất bại, nó đang ở bước nào và trạng thái nhất quán nào có thể khôi phục. Đây là các yêu cầu bổ sung, không phải hệ quả tự động của chênh lệch bằng không quan sát ở bước 100. Minh họa trên một máy chủ không tuyên bố bao phủ chúng.
Khắc phục sự cố và dọn dẹp
Kiểm tra dual thất bại. Đừng chạy torchrun ngay. Hãy kiểm tra hai GPU được cấp cho container và mỗi tiến trình chọn card riêng của nó. Sửa môi trường trước khi sửa công thức huấn luyện.
Các tiến trình có vẻ bị treo. So sánh thông báo cuối cùng và thứ tự collective của chúng. Một rank không được tự bỏ qua all_reduce hoặc backward mà rank kia vẫn tham gia. Số token không bằng nhau được dự kiến ở đây; số bước giao tiếp không tương thích là vấn đề khác.
Tính tương đương gradient thất bại. Trước hết hãy kiểm tra số đếm toàn cục của toàn cửa sổ, rồi xác minh loss_sum() trả về một tổng, no_sync() bao gồm forward và backward, và không có phép chia bổ sung. Cũng so sánh trạng thái ban đầu và dữ liệu của hai đường.
Mô hình tải lại nhưng việc tiếp tục khác. Tải lại trọng số không chứng minh việc tiếp tục hoàn chỉnh. Hãy kiểm tra cả optimizer, cấu hình, khóa dữ liệu, vị trí trong kế hoạch và trạng thái ngẫu nhiên theo rank trước khi quy sai khác cho DDP.
Sau khi quan sát, hãy tạo hình, kiểm tra checkpoint, xem trước dọn dẹp và dừng các dịch vụ:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
Dọn dẹp cố ý vẫn ở chế độ --dry-run: nó hiển thị những gì sẽ bị ảnh hưởng mà không thực hiện xóa. Hãy xem trước này trước bất kỳ quyết định xóa nào. Lệnh cuối dừng các dịch vụ Compose của dự án này; nó không yêu cầu dọn sạch toàn bộ môi trường Docker của bạn.
Nguồn chính
Các liên kết sau cho phép tìm hiểu sâu hơn về cơ chế. Chúng không thay thế các tệp và tham số trong ZIP để tái lập r1; tài liệu tham khảo không phải là bản ghi bổ sung về các phiên bản đã chạy.
- PyTorch 2.8 — DistributedDataParallel : các bản sao, phép gộp gradient và phạm vi của
no_sync(). - PyTorch — collective phân tán : vai trò của giao tiếp collective và
all_reduce. - NVIDIA Container Toolkit — hướng dẫn cài đặt : cấp GPU cho container.
Để đọc các phép tính: tích lũy với Tensor.backward, dung sai của torch.allclose, độ chính xác số và phép giảm của CrossEntropyLoss.
Để hiểu các tiến trình và trạng thái của chúng: trình khởi chạy torchrun, khả năng tái lập PyTorch và rút mẫu không hoàn lại với random.sample.