





Imagine que su panel muestra la duración media de las solicitudes procesadas por dos servidores. El primero recibió pocas solicitudes; el segundo, muchas más. Para obtener la media conjunta, no basta con sumar ambas medias y dividir entre dos: también hay que tener en cuenta cuántas solicitudes hay detrás de cada cifra.
La misma trampa aparece cuando dos GPU entrenan un modelo con secuencias de longitudes distintas. Cada tarjeta puede calcular una media perfectamente correcta sobre sus datos y, después, participar en un cálculo global que ya no representa el objetivo elegido.
Haremos visible este problema con un modelo pequeño y datos sintéticos. Compararemos un cálculo con dos GPU con una referencia en una sola GPU y luego interrumpiremos el entrenamiento para comprobar su reanudación. El objetivo no es superar a un modelo conocido ni medir una aceleración: queremos recuperar el gradiente de una media calculada sobre todos los tokens válidos de una misma ventana de entrenamiento.
Descargar el proyecto completo
El proyecto no requiere pesos preentrenados ni corpus externo. Puede seguir el razonamiento con bases de Python y algunos cálculos de medias; el recorrido ejecutable usa Docker y dos GPU. Las cifras del balance siguen siendo las de la ejecución de referencia r1. Los pequeños ejemplos adicionales explican los cálculos, no anuncian nuevas mediciones del modelo.
El problema: una media de medias está sesgada
Primero, ¿qué queremos que aprenda?
Un modelo tiene parámetros, también llamados pesos: son los números que se ajustan durante el entrenamiento. Para un lote de datos, produce predicciones que el programa compara con las respuestas esperadas. La pérdida, o loss, resume el coste de los errores según la regla elegida.
En este tutorial, la pérdida se descompone en contribuciones por token supervisado. Un token es una unidad de una secuencia, representada en el programa por un identificador numérico. En texto puede corresponder a una palabra, parte de una palabra o un símbolo; aquí las secuencias son sintéticas. «Supervisado» significa que una respuesta esperada contribuye realmente al cálculo de la pérdida en esa posición.
El gradiente indica cómo varía la pérdida cuando los parámetros cambian ligeramente. Contiene una derivada para cada parámetro. El cálculo de esas derivadas se llama retropropagación, o backward. Un optimizador usa después esos gradientes para modificar los pesos. Veremos ambas operaciones en el código: calcular el gradiente todavía no es aplicar la actualización.
Nuestra elección es precisa: cada token supervisado cuenta igual que los demás en la media de la ventana. Por tanto, una secuencia larga aporta más contribuciones que una corta. Aquí no buscamos dar el mismo peso total a cada secuencia.
Dos procesos, dos cantidades de tokens
Un rango, o rank, designa un proceso que participa en el cálculo distribuido. En nuestro experimento, el rango 0 trabaja en una GPU y el rango 1 en la otra. Cada uno tiene una copia del mismo modelo, pero recibe secuencias distintas.
Retomemos el contraejemplo del proyecto. El primer rango procesa 12 tokens y obtiene una suma de pérdidas de 12. El segundo procesa 36 tokens y obtiene una suma de pérdidas de 108.
En móvil, desplace la tabla horizontalmente.
| Rango | Tokens válidos | Suma de pérdidas | Media local | Proporción de tokens de la ventana |
|---|---|---|---|---|
| 0 | 12 | 12 | 12 / 12 = 1 |
12 / 48 = 25 % |
| 1 | 36 | 108 | 108 / 36 = 3 |
36 / 48 = 75 % |
La media de las medias locales da:
(1 + 3) / 2 = 2.
Pero la media de todos los tokens da:
(12 + 108) / (12 + 36) = 120 / 48 = 2,5.
También podemos recuperar este resultado ponderando las medias locales:
25 % × 1 + 75 % × 3 = 2,5.
¿Qué ocurrió en el primer cálculo? El rango corto recibió la mitad del peso total cuando solo contiene una cuarta parte de los tokens. Cada token del rango 0 pesa 1 / (2 × 12), frente a 1 / (2 × 36) para un token del rango 1: el primero pesa tres veces más que el segundo.
No es, por tanto, un error de redondeo. Hemos cambiado la pregunta planteada al cálculo: «¿cuál es la media de los dos rangos?» sustituyó a «¿cuál es la media de todos los tokens?» .
Cuando los rangos contienen el mismo número de tokens, ambas fórmulas coinciden. Medias locales idénticas también pueden ocultar la diferencia. Por eso probar únicamente lotes equilibrados no permite detectar este problema.
¿Dónde interviene DDP?
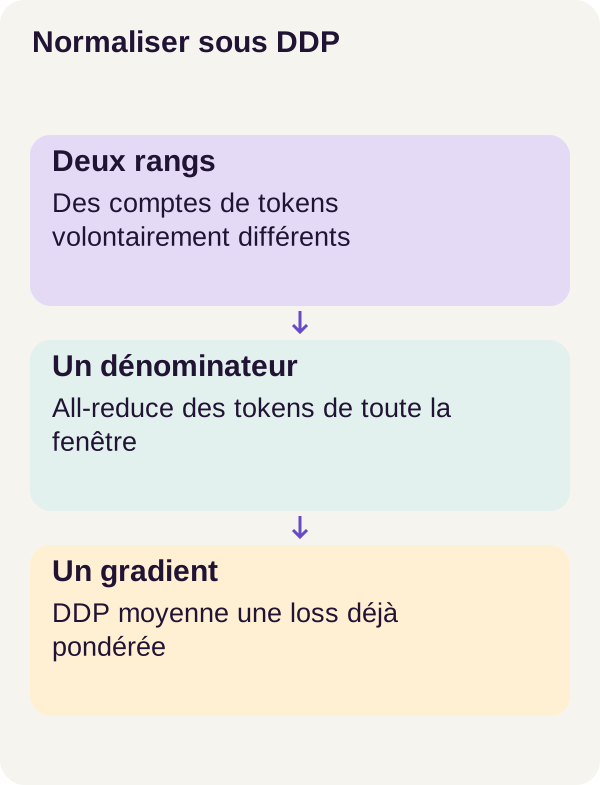
DistributedDataParallel, abreviado DDP, sincroniza los gradientes entre las copias del modelo. En el funcionamiento usado aquí, su agregación equivale a una media entre rangos. Sin embargo, DDP no sabe que su objetivo es una media por token ni distribuye las entradas por usted. La elección de las secuencias sigue siendo responsabilidad de la aplicación, como precisa la documentación de PyTorch sobre DDP.
Por tanto, la idea del tutorial es preparar en cada rango una pérdida correctamente ponderada antes del backward. DDP podrá entonces sincronizar los gradientes sin alterar el objetivo global buscado.
Requisitos: Docker y dos GPU
El recorrido validado requiere Linux x86_64, Docker con Compose, NVIDIA Container Toolkit y dos RTX 3090 de 24 GiB visibles en el contenedor. Prevea también 16 GiB de RAM y 16 GiB de disco, sin contar las capas Docker compartidas.
La VRAM es la memoria propia de cada tarjeta gráfica. Dos tarjetas de 24 GiB siguen siendo dos memorias separadas: DDP coloca una réplica del modelo en cada una, no crea una tarjeta virtual de 48 GiB. CUDA permite aquí ejecutar cálculos en GPU NVIDIA. NCCL es el backend usado para las comunicaciones entre procesos GPU; este protocolo no valida en su lugar un recorrido de CPU o Gloo.
En Docker, el servicio gpu ejecuta las preparaciones y comprobaciones simples. El servicio dual sirve para el recorrido de dos procesos. torchrun, que usaremos más adelante, lanzará estos procesos dentro del contenedor.
El script setup.sh crea los directorios y solo escribe UID/GID en .env. Esos identificadores corresponden al usuario y su grupo en el host. outputs/ recibe las mediciones; artifacts/ recibe los checkpoints, es decir, los estados guardados para reanudar el entrenamiento.
No hay pesos preentrenados ni datos externos que adquirir: acquire comprueba por tanto una adquisición vacía. Esto no significa que construir las imágenes Docker no necesite recursos; los datos del experimento serán generados por el proyecto.
Extraiga el archivo y sitúe su terminal en su raíz. Todos los comandos siguientes deben ejecutarse desde esa misma carpeta. Empiece construyendo las imágenes y comprobando el acceso a una GPU, y después a las dos GPU:
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu dual
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm dual python scripts/check_environment.py --config configs/minimum.yaml --dual
docker compose config --quiet comprueba la configuración de Compose. Los scripts de entorno inicializan realmente CUDA y comprueban las tarjetas visibles: la presencia de una GPU en el host no basta para demostrar su acceso desde Docker.
Ambas comprobaciones de entorno deben tener éxito antes de continuar. Si fallan, corrija este punto antes de lanzar torchrun; la guía oficial de NVIDIA Container Toolkit describe la integración con Docker.
Las capas Docker ya disponibles pueden acortar una compilación. No cambian la fórmula de normalización que compararemos.
Comprobar el programa antes del cálculo distribuido
Antes de lanzar los dos procesos, ejecutemos las pruebas públicas. Cubren las funciones de normalización y reanudación del proyecto:
docker compose run --rm gpu python -m pytest -q
Es la misma lógica que una prueba unitaria de cálculo de cesta antes de probar un pedido completo: primero verificamos las funciones y después su comportamiento en el recorrido real.
Que esta suite tenga éxito no sustituye la comparación numérica con la referencia mono-GPU. Tampoco sustituye la prueba de interrupción y reanudación. Esos controles llegan después y responden a preguntas distintas.
Datos: crear deliberadamente un desequilibrio
Secuencias cortas de un lado, largas del otro
El corpus contiene 1 024 secuencias de entrenamiento, 128 de validación y 256 de prueba. En cada ventana de entrenamiento, el rango 0 recibe secuencias de 16 a 64 tokens, mientras que el rango 1 recibe secuencias de 65 a 128 tokens.
Este desequilibrio es intencional. Obliga al programa a distinguir el número de secuencias del número de tokens. Incluso con el mismo número de secuencias en cada tarjeta, los dos rangos no llevan la misma cantidad de supervisión.
Un microbatch, o microlote, es el pequeño lote procesado en un paso por el modelo. Una ventana de acumulación agrupa varios microbatches cuyos gradientes se suman antes de una única actualización de pesos. Aquí cada ventana contiene dos microbatches por rango.
El siguiente plan elige los identificadores de estas secuencias. Aún no calcula la pérdida, no mueve nada a las GPU ni construye por sí mismo los arrays de padding.
def make_rank_batches(rows, config):
    pools = [
        [
            r["id"]
            for r in rows
            if r["split"] == "train" and (len(r["tokens"]) <= 64) == (rank == 0)
        ]
        for rank in range(2)
    ]
    rng = random.Random(config["seed"] + 10)
    plan = []
    for step in range(config["updates"]):
        selected = [
            rng.sample(pool, config["accumulation"] * config["batch_size_per_rank"])
            for pool in pools
        ]
        plan.append(
            [
                [
                    ids[i : i + config["batch_size_per_rank"]]
                    for i in range(0, len(ids), config["batch_size_per_rank"])
                ]
                for ids in selected
            ]
        )
    return plan
Leer el plan como una estructura de datos Python
La variable pools contiene dos listas de identificadores. El filtro solo conserva las filas train. La expresión (len(r["tokens"]) <= 64) == (rank == 0) coloca las secuencias cortas en el primer grupo y las largas en el segundo. Los límites 16 y 128 pertenecen al corpus preparado; esta función solo usa el corte en 64.
El generador random.Random(config["seed"] + 10) aísla el sorteo de este plan. Con datos, orden de listas y configuración idénticos, se pueden reproducir sus elecciones.
Para cada actualización, rng.sample toma accumulation × batch_size_per_rank identificadores de cada grupo. El corte ids[i : i + batch_size_per_rank] los distribuye después en microbatches. La estructura se lee así: plan[step][rank][microbatch] devuelve la lista de identificadores a procesar.
En una ventana, el sorteo se hace sin reemplazo: un identificador no se selecciona dos veces para el mismo rango. Como los grupos son disjuntos, tampoco se comparte entre ambos rangos. En la ventana siguiente puede volver el mismo identificador. El código no retira definitivamente los elementos del grupo. Es el comportamiento de random.sample, usado aquí en cada ventana nueva.
Por tanto, no recorremos necesariamente todo el corpus una vez antes de volver a ver un ejemplo. El plan lo definen las actualizaciones, no la hipótesis implícita de una pasada completa sin repeticiones.
Dos «rellenos» que no hay que confundir
El padding de tokens completa secuencias cortas para formar un array rectangular. Para visualizarlo con un ejemplo mínimo, distinto del corpus: [7, 4, 9] y [5, 2] pueden convertirse en [7, 4, 9] y [5, 2, PAD]. El array tiene seis posiciones, pero solo cinco tokens originales. La posición añadida no debe aumentar el denominador de la pérdida.
El padding de un sampler designa otro problema: completar un plan de datos repitiendo algunos identificadores para equilibrar procesos. Aquí el plan no introduce tales duplicados entre rangos en una ventana. El desequilibrio de tokens permanece visible en lugar de ocultarse.
Construyamos ahora el corpus, el plan y la referencia mono-GPU:
docker compose run --rm gpu python -m ddp_tokens.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m ddp_tokens.cli reference --config configs/minimum.yaml
docker compose run --rm gpu python -m ddp_tokens.cli check-loss --config configs/minimum.yaml
prepare fija las secuencias y las ventanas. reference parte del mismo estado inicial que la comparación distribuida y sirve de cálculo testigo. check-loss muestra los dos valores del contraejemplo, 2 y 2,5, antes de cualquier lanzamiento con torchrun.
En este punto tenemos los datos y un resultado con el que comparar. Falta entender cómo ponderar las pérdidas locales para recuperarlo.
El cálculo central: el denominador global
Un denominador para toda la ventana
Demos nombre a las cantidades para poder leer la fórmula:
W es el número de rangos, 2 en este proyecto. S_r es la suma de pérdidas del rango r en toda su ventana. N_r es su número de tokens supervisados. Por último, N = suma de los N_r es el número total de tokens supervisados de los dos rangos, en los dos microbatches.
El objetivo deseado es:
L = (S_0 + S_1) / N.
La tentación sería hacer que cada rango calcule S_r / N. Pero DDP promedia después los gradientes entre ambos procesos: eso añadiría una división por 2 que no necesitamos.
Por tanto, cada rango usa:
L_r = W × S_r / N.
Después de la media DDP, el factor W se cancela:
(1 / W) × suma_r gradiente(W × S_r / N) = gradiente(suma_r S_r / N).
El símbolo «gradiente» designa aquí las derivadas respecto a los pesos. El razonamiento se basa en un denominador fijado por los datos de la ventana, que no depende de los pesos, y en la media de gradientes usada por este DDP. Multiplicar por W no pretende «aprender dos veces más rápido»: compensa una división ya presente en la agregación.
En nuestro contraejemplo, W / N = 2 / 48 = 1 / 24. Por tanto, el rango 0 usa 12 / 24 = 0,5 y el rango 1 108 / 24 = 4,5. La media de estas contribuciones es (0,5 + 4,5) / 2 = 2,5.
Estos dos escalares locales ya no son las medias locales 1 y 3. Es normal: se preparan para la agregación. Confundirlos con una métrica media ya calculada sobre todo el corpus haría engañosos los registros.
Contar antes de retropropagar
def global_token_loss(local_sum, global_count, world_size):
    if global_count <= 0:
        raise ValueError(
            "No supervised token in the global accumulation window; all ranks must skip or stop together"
        )
    return local_sum * (world_size / global_count)


def global_count(local_count, device):
    count = torch.tensor(local_count, device=device, dtype=torch.long)
    dist.all_reduce(count, op=dist.ReduceOp.SUM)
    return int(count)
global_token_loss recibe una suma, no una pérdida ya promediada. La multiplica por el factor común world_size / global_count. Darle en su lugar una media local modificaría la ponderación por segunda vez.
La función global_count transforma el contador local en un tensor entero en el dispositivo usado. Un tensor es aquí simplemente un valor numérico que PyTorch puede manipular y comunicar. dist.all_reduce(..., SUM) suma los contadores y deja el total en el tensor de cada rango: 12 y 36 se convierten en 48 en ambos procesos. int(count) recupera ese total como entero Python. La documentación sobre colectivas de PyTorch describe esta operación in situ.
Una colectiva es una comunicación en la que los procesos del grupo participan juntos. Por tanto, el contador no se envía a un único «jefe» que guardaría el resultado: ambos rangos necesitan el mismo denominador antes de su backward.
Hay que recordar dos operaciones distintas: el programa suma primero los conteos de tokens y DDP sincroniza después los gradientes. El código anterior no sincroniza automáticamente una métrica global de pérdida.
¿Y si la ventana no contiene ningún token supervisado?
Una media sobre cero tokens no está definida. Por eso la rama global_count <= 0 lanza un error en lugar de fabricar una pérdida igual a cero.
En este proyecto, los rangos rechazan colectivamente la misma ventana. Sin embargo, la función no implementa por sí sola toda la coordinación: quien la llama debe haber calculado el mismo conteo global y seguir un recorrido compatible entre procesos.
Imagine dos workers que deben encontrarse en una etapa de intercambio. Si uno decide por sí solo salir del bucle y el otro aún espera ese intercambio, el segundo puede quedar bloqueado. Una condición local no debe saltarse aisladamente una colectiva o un backward esperado por los demás rangos.
Un rango localmente vacío no es lo mismo que una ventana globalmente vacía. Si los otros rangos tienen supervisión, el denominador global puede ser positivo. Adaptar el proyecto a este caso exigiría probar su participación correcta en el cálculo y las comunicaciones; la única guarda sobre N <= 0 no demuestra que se gestionen todos los casos localmente vacíos.
Qué comprueba exactamente check_loss()
def check_loss(config):
    local_sums = [12.0, 108.0]
    counts = [12, 36]
    wrong = sum(s / n for s, n in zip(local_sums, counts)) / 2
    correct = sum(global_token_loss(s, sum(counts), 2) for s in local_sums) / 2
    assert correct == 2.5 and wrong == 2.0
    return {
        "local_tokens": counts,
        "local_loss_sums": local_sums,
        "mean_of_means": wrong,
        "global_mean": correct,
    }
wrong reproduce la media de medias: 2. correct aplica la fórmula ponderada y después la media entre ambos rangos: 2,5. El parámetro config no se usa en esta pequeña comprobación; los valores están fijados deliberadamente en la función.
La prueba se ejecuta sobre números Python. No lanza ni una red neuronal, ni backward, ni comunicación DDP. Comprueba la identidad aritmética; la comparación real de gradientes llega en el protocolo GPU.
La variante wrong debe seguir siendo errónea. Actúa como control negativo: una prueba capaz de aceptar la fórmula correcta pero incapaz de rechazar la incorrecta no protegería el mecanismo estudiado. Una división adicional por el número de microbatches no corregiría esta ponderación.
Por qué una pérdida idéntica no basta para demostrar un gradiente idéntico
Este es un ejemplo pedagógico independiente del modelo r1, con un único parámetro θ y un error cuadrático.
El rango 0 tiene 12 objetivos iguales a +1: su suma de pérdidas es 12 × (θ − 1)². El rango 1 tiene 36 objetivos iguales a −1: su suma es 36 × (θ + 1)².
En θ = 0, todos los tokens tienen una pérdida igual a 1. Por tanto, ambos métodos muestran una pérdida media de 1. Si solo miramos esta cifra, no vemos ninguna diferencia.
Pero la derivada de (θ − 1)² es 2 × (θ − 1), es decir, −2 en ese punto. La de (θ + 1)² es +2. La media de medias produce entonces un gradiente (-2 + 2) / 2 = 0. La media global produce (12 × -2 + 36 × 2) / 48 = 1.
Misma pérdida mostrada, gradientes distintos. Precisamente por eso nuestra validación compara los propios gradientes, no solo dos valores de loss en un registro.
Acumulación: abarcar forward y backward
Dos microbatches, una sola actualización
En lugar de calcular toda una ventana en un único paso, procesamos sus microbatches sucesivamente. Cada llamada a backward() añade su contribución a los gradientes ya presentes. La documentación de Tensor.backward describe esta acumulación: por tanto, hay que vaciar los gradientes antiguos en el momento adecuado, no después de cada microbatch.
Durante esta ventana, los pesos no deben actualizarse entre microbatches. De lo contrario, las contribuciones se calcularían sobre estados distintos del modelo y dejarían de representar el gradiente de la misma suma.
El forward calcula predicciones a partir de las entradas. El backward calcula las derivadas de la pérdida. no_sync() no elimina ninguno de estos cálculos: aplaza la sincronización de gradientes entre rangos para los microbatches intermedios.
def accumulate(model, batches, mapping, rank, denominator, world, wrong=False):
    model.zero_grad(set_to_none=True)
    local_n = sum(len(mapping[i]["tokens"]) for micro in batches for i in micro)
    for index, ids in enumerate(batches):
        # The context deliberately includes the forward as well as the backward.
        context = (
            model.no_sync() if index < len(batches) - 1 else contextlib.nullcontext()
        )
        with context:
            tokens, labels = padded(ids, mapping, rank)
            summed = loss_sum(model(tokens), labels)
            loss = (
                summed / local_n
                if wrong
                else global_token_loss(summed, denominator, world)
            )
            loss.backward()
    return local_n
Seguir las responsabilidades de cada línea
model.zero_grad(set_to_none=True) elimina los gradientes de la ventana anterior. Esta instrucción se coloca antes del bucle, para que los dos backward siguientes puedan contribuir a la misma acumulación.
local_n cuenta los tokens originales de las secuencias de este rango en toda la ventana. mapping permite recuperar una secuencia a partir de su identificador. El denominador global ya llega en el parámetro denominator: accumulate() no lo obtiene llamando a global_count() dentro de este bucle.
Para cada microbatch, padded() prepara las entradas y las etiquetas de supervisión. model(tokens) realiza el forward y loss_sum() devuelve la suma de pérdidas de las posiciones retenidas. La red pequeña, el padding y esta función de pérdida pertenecen al proyecto completo; los extractos del artículo se centran en la normalización y la acumulación.
La elección wrong=True divide cada suma de microbatch por local_n. Tras sumar los microbatches, se convierte en la media local del rango. DDP hará después la media entre rangos: es exactamente la referencia errónea que debe detectar la prueba.
En el camino correcto, cada microbatch usa en cambio el mismo conteo global de la ventana. No se normaliza ni por su propia longitud ni por un denominador recalculado solo para ese paso.
Por último, la función devuelve local_n. No contiene ninguna llamada a optimizer.step(): la actualización de pesos pertenece al bucle de entrenamiento que la rodea. El proyecto no añade una nueva división al realizar esa actualización.
¿Por qué colocar el forward dentro de no_sync()?
Para el primer microbatch, context vale model.no_sync(). Para el último, vale contextlib.nullcontext(), un contexto que no modifica nada. Así, la sincronización DDP está activa en el último paso.
El punto sutil es el alcance de with: el forward y el backward deben estar ambos dentro. Rodear solo loss.backward() no basta para suprimir la sincronización como se espera. Es una condición explícita de la documentación de no_sync().
Al final del último backward, las contribuciones acumuladas participan en la sincronización. Es un punto lógico de sincronización de la ventana; no significa que todos los gradientes quepan necesariamente en un único mensaje de red.
Rehacer la acumulación a mano
Descompongamos el contraejemplo 12/36 en dos microbatches ficticios por rango. Esta tabla ilustra el cálculo; no son longitudes de lotes capturadas en r1.
En móvil, desplace la tabla horizontalmente.
| Rango | Microbatch | Tokens válidos | Suma de pérdidas | Contribución con W / N = 2 / 48 |
|---|---|---|---|---|
| 0 | Primero | 4 | 4 | 4 / 24 ≈ 0,1667 |
| 0 | Segundo | 8 | 8 | 8 / 24 ≈ 0,3333 |
| 1 | Primero | 12 | 36 | 36 / 24 = 1,5 |
| 1 | Segundo | 24 | 72 | 72 / 24 = 3 |
Las dos contribuciones del rango 0 suman 0,5; las del rango 1 suman 4,5. Su media sigue siendo 2,5. La división en microbatches no ha cambiado la definición de la media.
Dividir de nuevo cada contribución por accumulation = 2 daría 1,25 tras la agregación y también dividiría el gradiente entre dos. El denominador global de la ventana ya había tenido en cuenta los cuatro microbatches.
La regla no es «no dividir nunca por el número de microbatches». Es: no añadir una división que ya está contenida en la normalización elegida. Una receta que parte de medias de microbatches de igual tamaño se razona de otra forma que esta, que parte de sumas y un conteo global.
Ejecutar la interrupción, el recorrido continuo y la reanudación
Ahora podemos lanzar los tres recorridos distribuidos: una interrupción en el paso 50, un entrenamiento continuo hasta 100 y, después, una reanudación de 50 a 100.
docker compose run --rm dual torchrun --rdzv-backend=static --master-addr=127.0.0.1 --master-port=29500 --nnodes=1 --nproc-per-node=2 -m ddp_tokens.train --config configs/minimum.yaml
docker compose run --rm dual torchrun --rdzv-backend=static --master-addr=127.0.0.1 --master-port=29500 --nnodes=1 --nproc-per-node=2 -m ddp_tokens.train --config configs/minimum.yaml --continuous
docker compose run --rm dual torchrun --rdzv-backend=static --master-addr=127.0.0.1 --master-port=29500 --nnodes=1 --nproc-per-node=2 -m ddp_tokens.train --config configs/minimum.yaml --resume artifacts/checkpoints/step-0050
Ejecute estos comandos uno tras otro. --nnodes=1 describe un único nodo de cálculo y --nproc-per-node=2 lanza dos procesos. El encuentro estático en la dirección 127.0.0.1, puerto 29500, sirve para su coordinación local. Este puerto no es el de una API de negocio. La documentación de torchrun explica las funciones del lanzador y los rangos.
El recorrido sin opción adicional crea la interrupción prevista en 50. --continuous produce el testigo en 100 actualizaciones. --resume artifacts/checkpoints/step-0050 carga el estado interrumpido para continuar el mismo recorrido hasta 100.
Un checkpoint es más que un archivo de pesos
Piense en un tratamiento de datos interrumpido: conservar su resultado parcial sin saber qué elementos ya se leyeron no basta para reanudar en el lugar correcto. El entrenamiento necesita la misma continuidad.
El checkpoint común del proyecto contiene el modelo, el optimizador, la configuración y el bloqueo de datos. Este bloqueo identifica los datos esperados; no debe confundirse con un bloqueo que impide a dos procesos entrar en una sección crítica.
Cada rango también conserva su estado aleatorio, su rango y su historial. El programa conserva el historial del sampler, es decir, del mecanismo que selecciona las secuencias. La reanudación debe recuperar tanto los pesos como la continuación del recorrido de datos.
Una semilla inicializa un generador pseudoaleatorio. Su estado actual indica dónde se encuentra tras los sorteos ya realizados. Restaurar solo la semilla inicial puede reiniciar la secuencia de sorteos en vez de continuar desde la interrupción. La nota de PyTorch sobre reproducibilidad ayuda a distinguir el control de la aleatoriedad de las garantías entre entornos.
La reanudación presentada aquí se realiza en una frontera de actualización definida por el protocolo. No demuestra la recuperación de una interrupción arbitraria en medio de un backward o una comunicación.
Métricas que leer antes de los resultados
Tres preguntas, tres controles
La primera pregunta es: ¿corresponde el gradiente DDP al gradiente mono-GPU? El proyecto coloca seguidos los valores de los gradientes para formar un vector y compara ese vector con la referencia obtenida con el mismo estado inicial y los mismos tokens. La prueba cubre 282 628 valores, con tolerancias atol=1e-6 y rtol=1e-4. Esta cifra describe los componentes comparados, no el tamaño del corpus.
La segunda pregunta es: ¿la reanudación recupera los mismos parámetros que el entrenamiento continuo? Entonces comparamos los pesos en el paso 100, no los gradientes del control inicial. Una fórmula correcta y una reanudación correcta son propiedades diferentes.
La tercera pregunta es: ¿qué obtiene el modelo entrenado sobre los datos de prueba? El recorrido realiza 100 actualizaciones con SGD, en FP32 y con acumulación de dos microbatches por rango. SGD es el optimizador usado para aplicar los gradientes. FP32 designa un cálculo con números de coma flotante de 32 bits. La prueba final cubre 256 secuencias y 18 231 tokens válidos.
La loss token test es una pérdida media por token. No es un porcentaje de acierto. La exactitud por token mide la proporción de tokens predichos correctamente entre las posiciones evaluadas; no significa que la misma proporción de secuencias completas sea correcta.
¿Cómo leer las tolerancias numéricas?
Una tolerancia absoluta limita las pequeñas diferencias, especialmente cerca de cero. Una tolerancia relativa se ajusta a la magnitud del valor de referencia. La convención descrita para torch.allclose es, componente a componente:
abs(gradient_DDP - gradient_reference) <= atol + rtol × abs(gradient_reference).
Con nuestras tolerancias, una referencia igual a 0 permite una diferencia de hasta 0,000001. Una referencia igual a 1 permite 0,000001 + 0,0001 = 0,000101. Son ejemplos para leer los umbrales, no componentes publicados del gradiente r1.
¿Por qué no exigir cero en todas partes? El orden de las operaciones puede diferir entre el cálculo mono-GPU y el distribuido. Las sumas en precisión finita no son perfectamente asociativas. La nota de PyTorch sobre precisión numérica recuerda que una identidad matemática no garantiza igualdad bit a bit entre dos caminos de cálculo.
La comprobación correcta aplica las tolerancias a todos los componentes. El error absoluto máximo resume la mayor diferencia, pero no sustituye por sí solo esta comparación completa.
Leer el balance del recorrido
Calcule la evaluación:
docker compose run --rm gpu python -m ddp_tokens.cli evaluate --config configs/minimum.yaml
Los valores siguientes son mediciones locales observadas en el recorrido r1. No predicen la calidad de otra arquitectura, datos reales, otro optimizador ni un entrenamiento en varios nodos.
En móvil, desplace la tabla horizontalmente.
| Control observado | Resultado |
|---|---|
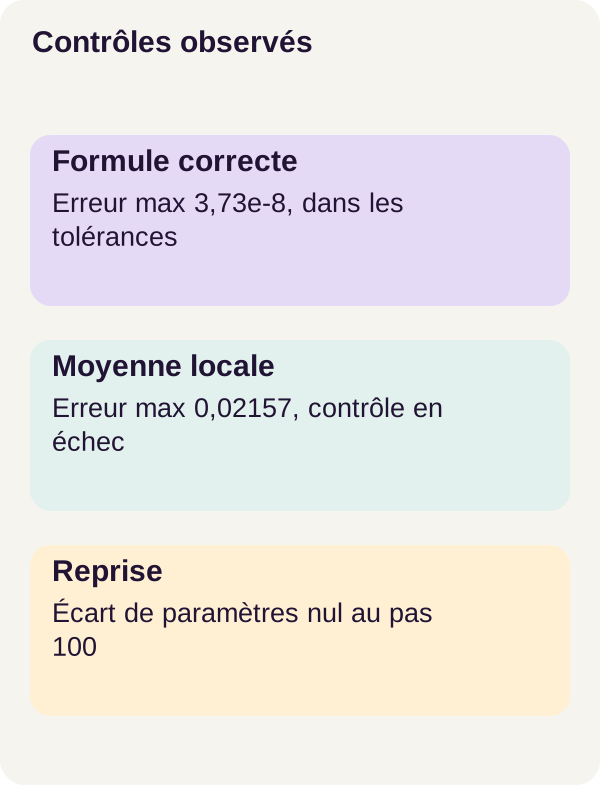
| Error absoluto máx., normalización correcta | 3,73e-8 |
| Normalización correcta dentro de las tolerancias | Sí |
| Error absoluto máx., media de medias | 0,02157 |
| Normalización errónea dentro de las tolerancias | No |
| Diferencia máx. de parámetros, reanudado vs. continuo | 0 |
| Loss token test | 1,31525 |
| Exactitud token test | 36,22 % |
La normalización correcta recupera la referencia dentro de las tolerancias, con un error absoluto máximo de 3,73e-8. La media de medias falla en el mismo control, con un error máximo de 0,02157. Tenemos por tanto a la vez un caso aceptado y un error deliberado efectivamente detectado.
La prueba de reanudación responde a otra pregunta: la diferencia máxima entre los parámetros reanudados y los del recorrido continuo es 0 en el paso 100. Conservar el historial del sampler y los generadores aleatorios por rango forma parte de esta reanudación. El cero no contradice la pequeña diferencia del gradiente mono/DDP: ambas comparaciones no abarcan ni los mismos objetos ni los mismos recorridos.
Ambos rangos también rechazan una ventana con cero tokens supervisados. Este control completa el camino normal: comprueba que la ausencia global de supervisión no se trata como una media válida.
Por último, 1,31525 de loss test y 36,22 % de exactitud por token no constituyen una demostración de beneficio de negocio. El resultado central del tutorial es la paridad del cálculo elegido. No se trata ni de una clasificación de modelos ni de una medición de aceleración con dos GPU.
La reanudación exacta establece el mecanismo en este protocolo. No prueba la solidez de una reanudación tras una preempción en cualquier instante de una infraestructura distribuida.
Lo que hemos aprendido
Una media empieza con una pregunta: ¿qué unidad debe contar igual que las demás? Aquí la respuesta es el token supervisado. Una media de medias por rango da otro peso a estos tokens cuando sus cantidades difieren.
DDP sincroniza los gradientes, pero no conoce esta intención. El factor world_size / global_count prepara las contribuciones locales para que su media corresponda al gradiente deseado. El número de GPU no es un coeficiente que se añade o se quita por costumbre: hay que seguir las divisiones realmente aplicadas.
La acumulación no cambia el objetivo. Divide el cálculo en microbatches, con un denominador que cubre toda la ventana y pesos sin cambios entre sus pasos. no_sync() aplaza la sincronización; no sustituye ni el conteo de tokens ni el backward.
Por último, un checkpoint debe permitir reanudar la trayectoria, no solo recargar un modelo. Los datos que vienen, el estado del optimizador y los generadores aleatorios también forman parte de esa continuidad.
Ejercicio: hipótesis antes del comando
El rango 0 conserva 12 tokens válidos. El rango 1 pasa de 12 a 36 tokens, sin cambiar la distribución de pérdidas por token que queremos comparar. Antes de ejecutar el programa, prediga qué ocurre con la media de medias y la media global. ¿Cuál concede demasiado peso al rango corto?
Para hacer explícito su cálculo, tomemos como hipótesis pedagógica una pérdida de 1 por token en el rango 0 y de 3 por token en el rango 1, antes y después del cambio. Esta hipótesis sirve para el cálculo manual; los gradientes del ejercicio son los que proporciona su ejecución.
Con 12 tokens en cada rango, las sumas son 12 y 36. Ambas medias dan 2. Cuando el segundo rango pasa a 36 tokens, su suma se vuelve 108: la media de medias se mantiene en 2, mientras que la media global pasa a 2,5.
La media de medias no ve que el grupo cuya pérdida es más alta contiene ahora tres veces más tokens. El rango corto conserva la mitad del peso en vez de una cuarta parte.
Escriba también su predicción sobre la normalización: ¿hay que cambiar W, cambiar N o dividir una segunda vez por el número de microbatches? Ambos rangos siguen presentes, así que W sigue siendo 2; lo que cambia es el número global de tokens.
Ejecute después el ejercicio del recorrido:
docker compose run --rm gpu python -m ddp_tokens.cli exercise --config configs/exercise.yaml
Compare los cálculos y los gradientes proporcionados con su hipótesis. No espere que un error de loss de 0,5 produzca automáticamente una diferencia de gradiente de 0,5: el valor de una función y su derivada son objetos distintos.
Conserve el fallo de la variante incorrecta como control de no regresión. El objetivo no es hacer que todos los modos pasen relajando los umbrales, sino comprobar que un cambio futuro del código no vuelve invisible la ponderación incorrecta.
Adaptar el modelo y preparar la producción
Elegir la unidad antes de copiar la fórmula
En otro proyecto, la unidad de ponderación podría ser una secuencia, un ejemplo, un documento o un coste de negocio. Dar el mismo peso total a cada documento, cualquiera que sea su longitud, no es lo mismo que dar el mismo peso a cada uno de sus tokens. Ambas elecciones pueden responder a necesidades distintas; hay que indicar cuál se entrena.
El contador del código suma aquí len(mapping[i]["tokens"]). Es coherente con los tokens supervisados de este corpus. Este atajo no es universal. En otro entrenamiento, algunas posiciones de entrada pueden excluirse de la pérdida: prompt no supervisado, etiquetas ignoradas u objetivos desplazados. Habrá que contar las posiciones que contribuyen realmente al objetivo, no solo la longitud de la entrada.
Como referencia general, CrossEntropyLoss documenta las etiquetas ignoradas y los efectos de la ponderación sobre la reducción. Esto no sustituye la definición de loss_sum() en su propia aplicación. Añadir pesos de clase o un término de regularización exige volver a derivar la normalización de cada término, no aplicar mecánicamente el mismo denominador a toda la pérdida.
La fórmula presentada también supone la agregación DDP del recorrido de referencia. Una estrategia de comunicación personalizada, un número variable de participantes o rangos que ya no realizan el mismo número de pasos obligan a revisar las hipótesis y las pruebas.
Probar una adaptación sin cambiar el testigo
Conserve el recorrido de referencia y trabaje después en una copia para modificar el corpus o el modelo. Compare siempre gradientes obtenidos con el mismo estado inicial y las mismas posiciones supervisadas. Introduzca deliberadamente tamaños desiguales: una prueba que solo contiene conteos idénticos puede dejar pasar el error estudiado aquí.
Controle por separado una ventana globalmente vacía y las ramas en las que un solo rango no tiene supervisión. No concluya que una rama es segura porque el cálculo algebraico del camino normal sea correcto: también hay que comprobar el orden de participación en las comunicaciones.
Lo que no proporciona la demostración
Una puesta en producción distribuida exige un encuentro robusto entre procesos, tiempos de espera, una política de reanudación, registros y métricas por rango, gestión de preempciones, pruebas multinodo y una estrategia de datos.
En particular, debe ser posible determinar qué rango falló, en qué paso se encontraba y qué estado coherente puede restaurarse. Son requisitos adicionales, no consecuencias automáticas de la diferencia nula observada en el paso 100. La demostración en un host no pretende cubrirlos.
Resolución de problemas y limpieza
El control dual falla. No lance todavía torchrun. Compruebe que dos GPU están expuestas al contenedor y que cada proceso selecciona su propia tarjeta. Repare el entorno antes de modificar la fórmula de entrenamiento.
Los procesos parecen bloqueados. Compare sus últimos mensajes y el orden de las colectivas. Un rango no debe saltarse por sí solo all_reduce ni un backward en el que el otro aún participa. Aquí se prevé un número desigual de tokens; un número incompatible de etapas de comunicación es otro problema.
La paridad de gradientes falla. Inspeccione primero el conteo global de toda la ventana, y compruebe después que loss_sum() proporciona una suma, que no_sync() abarca el forward y el backward y que no se aplica ninguna división adicional. Compare también el estado inicial y los datos usados por ambos caminos.
El modelo se recarga, pero la reanudación difiere. Recargar pesos no demuestra la reanudación completa. Examine también el optimizador, la configuración, el bloqueo de datos, la posición en el plan y los estados aleatorios por rango antes de atribuir la diferencia a DDP.
Después de sus observaciones, genere la figura, compruebe los checkpoints, previsualice la limpieza y detenga los servicios:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
La limpieza se mantiene deliberadamente en --dry-run: muestra lo que se vería afectado sin ejecutar la eliminación. Examine esta previsualización antes de decidir borrar nada. El último comando detiene los servicios Compose de este proyecto; no es una solicitud de purga global de su entorno Docker.
Fuentes primarias
Los siguientes enlaces permiten profundizar en los mecanismos. No sustituyen los archivos y parámetros del ZIP para reproducir r1; las referencias de documentación no constituyen un registro adicional de las versiones ejecutadas.
- PyTorch 2.8 — DistributedDataParallel: réplicas, agregación de gradientes y alcance de
no_sync(). - PyTorch — colectivas distribuidas: función de las comunicaciones colectivas y de
all_reduce. - NVIDIA Container Toolkit — guía de instalación: exposición de las GPU a los contenedores.
Para leer los cálculos: acumulación con Tensor.backward, tolerancias de torch.allclose, precisión numérica y reducciones de CrossEntropyLoss.
Para comprender los procesos y su estado: lanzador torchrun, reproducibilidad de PyTorch y sorteo sin reemplazo con random.sample.