





Imaginez que votre tableau de bord affiche la durée moyenne des requêtes traitées par deux serveurs. Le premier a reçu peu de requêtes, le second beaucoup plus. Pour obtenir la moyenne de l'ensemble, additionner les deux moyennes puis diviser par deux ne suffit pas : il faut aussi tenir compte du nombre de requêtes derrière chaque chiffre.
Le même piège existe lorsque deux GPU entraînent un modèle sur des séquences de longueurs différentes. Chaque carte peut calculer une moyenne parfaitement juste sur ses données, puis participer à un calcul global qui ne représente plus l'objectif choisi.
Nous allons rendre ce problème visible avec un petit modèle et des données synthétiques. Nous comparerons un calcul sur deux GPU à une référence sur un seul GPU, puis nous interromprons l'entraînement pour vérifier sa reprise. L'objectif n'est ni de battre un modèle connu ni de mesurer une accélération : nous voulons retrouver le gradient d'une moyenne calculée sur tous les tokens valides d'une même fenêtre d'entraînement.
Le projet ne demande aucun poids préentraîné ni corpus externe. Vous pouvez suivre le raisonnement avec les bases de Python et quelques calculs de moyenne ; le parcours exécutable, lui, utilise Docker et deux GPU. Les nombres du bilan restent ceux de l'exécution de référence r1. Les petits exemples supplémentaires servent à expliquer les calculs, pas à annoncer de nouvelles mesures du modèle.
Le problème : une moyenne de moyennes est biaisée
D'abord, que cherche-t-on à faire apprendre ?
Un modèle possède des paramètres, aussi appelés poids : ce sont les nombres ajustés pendant l'entraînement. Pour un lot de données, il produit des prédictions que le programme compare aux réponses attendues. La perte, ou loss, résume le coût des erreurs selon la règle choisie.
Dans ce tutoriel, cette perte se décompose en contributions par token supervisé. Un token est une unité d'une séquence, représentée dans le programme par un identifiant numérique. Pour du texte, il pourrait correspondre à un mot, une partie de mot ou un symbole ; ici, les séquences sont synthétiques. « Supervisé » signifie qu'une réponse attendue contribue effectivement au calcul de la perte à cette position.
Le gradient indique comment la perte varie lorsque les paramètres changent légèrement. Il contient une dérivée pour chaque paramètre. Le calcul de ces dérivées s'appelle la rétropropagation, ou backward. Un optimiseur utilise ensuite ces gradients pour modifier les poids. Nous retrouverons ces deux opérations dans le code : calculer le gradient n'est pas encore appliquer la mise à jour.
Notre choix est précis : chaque token supervisé compte autant que les autres dans la moyenne de la fenêtre. Une séquence longue apporte donc davantage de contributions qu'une séquence courte. Nous ne cherchons pas, ici, à donner le même poids total à chaque séquence.
Deux processus, deux nombres de tokens
Un rang, ou rank, désigne un processus participant au calcul distribué. Dans notre expérience, le rang 0 travaille sur un GPU et le rang 1 sur l'autre. Chacun possède une copie du même modèle, mais reçoit des séquences différentes.
Reprenons le contre-exemple du projet. Le premier rang traite 12 tokens et obtient une somme de pertes de 12. Le second traite 36 tokens et obtient une somme de pertes de 108.
Sur mobile, faites défiler le tableau horizontalement.
| Rang | Tokens valides | Somme des pertes | Moyenne locale | Part des tokens de la fenêtre |
|---|---|---|---|---|
| 0 | 12 | 12 | 12 / 12 = 1 |
12 / 48 = 25 % |
| 1 | 36 | 108 | 108 / 36 = 3 |
36 / 48 = 75 % |
La moyenne des moyennes locales donne :
(1 + 3) / 2 = 2.
Mais la moyenne de tous les tokens donne :
(12 + 108) / (12 + 36) = 120 / 48 = 2,5.
Nous pouvons aussi retrouver ce résultat en pondérant les moyennes locales :
25 % × 1 + 75 % × 3 = 2,5.
Que s'est-il passé dans le premier calcul ? Le rang court a reçu la moitié du poids total alors qu'il ne contient qu'un quart des tokens. Chaque token du rang 0 pèse 1 / (2 × 12), contre 1 / (2 × 36) pour un token du rang 1 : le premier pèse trois fois plus que le second.
Ce n'est donc pas une erreur d'arrondi. Nous avons changé la question posée au calcul : « quelle est la moyenne des deux rangs ? » a remplacé « quelle est la moyenne de tous les tokens ? ».
Lorsque les rangs contiennent autant de tokens, les deux formules coïncident. Des moyennes locales identiques peuvent également cacher la différence. Voilà pourquoi tester uniquement des lots équilibrés ne permet pas de détecter ce problème.
Où intervient DDP ?
DistributedDataParallel, abrégé DDP, synchronise les gradients entre les copies du modèle. Dans le fonctionnement utilisé ici, leur agrégation correspond à une moyenne entre rangs. En revanche, DDP ne sait pas que votre objectif est une moyenne par token, et il ne répartit pas les entrées à votre place. Le choix des séquences reste la responsabilité de l'application, comme le précise la documentation PyTorch de DDP.
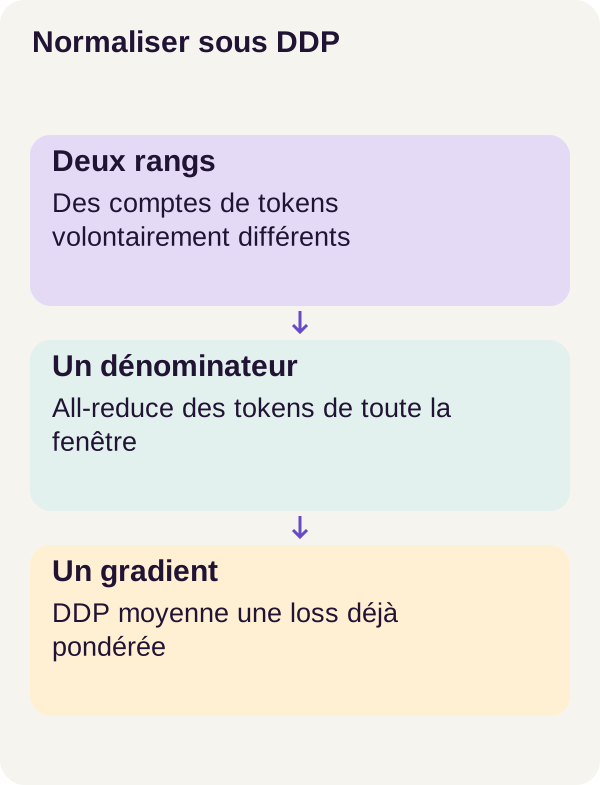
L'idée du tutoriel sera donc de préparer sur chaque rang une perte correctement pondérée avant le backward. DDP pourra alors synchroniser les gradients sans modifier l'objectif global recherché.
Prérequis : Docker et deux GPU
Le parcours validé exige Linux x86_64, Docker avec Compose, NVIDIA Container Toolkit et deux RTX 3090 de 24 Gio visibles dans le conteneur. Prévoyez également 16 Gio de RAM et 16 Gio de disque, hors couches Docker partagées.
La VRAM est la mémoire propre à chaque carte graphique. Deux cartes de 24 Gio restent deux mémoires séparées : DDP place une réplique du modèle sur chacune, il ne fabrique pas une carte virtuelle de 48 Gio. CUDA permet ici d'exécuter les calculs sur les GPU NVIDIA. NCCL est le backend utilisé pour les communications entre les processus GPU ; ce protocole ne valide pas un parcours CPU ou Gloo à sa place.
Côté Docker, le service gpu exécute les préparations et les contrôles simples. Le service dual sert au parcours à deux processus. torchrun, que nous utiliserons plus loin, lancera ces processus à l'intérieur du conteneur.
Le script setup.sh crée les répertoires et écrit seulement UID/GID dans .env. Ces identifiants correspondent à l'utilisateur et à son groupe sur l'hôte. outputs/ reçoit les mesures ; artifacts/ reçoit les checkpoints, c'est-à-dire les états sauvegardés pour reprendre l'entraînement.
Il n'y a ni poids préentraîné ni donnée externe à acquérir : acquire contrôle donc une acquisition vide. Cela ne signifie pas que construire les images Docker ne demande aucune ressource ; les données de l'expérience seront, elles, générées par le projet.
Extrayez l'archive et placez votre terminal dans sa racine. Toutes les commandes suivantes sont à lancer depuis ce même dossier. Commencez par construire les images et vérifier l'accès à un GPU, puis aux deux GPU :
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu dual
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm dual python scripts/check_environment.py --config configs/minimum.yaml --dual
docker compose config --quiet vérifie la configuration Compose. Les scripts d'environnement initialisent réellement CUDA et contrôlent les cartes visibles : la présence d'un GPU sur l'hôte ne suffit pas à démontrer son accès depuis Docker.
Les deux contrôles d'environnement doivent réussir avant la suite. En cas d'échec, corrigez ce point avant de lancer torchrun ; le guide officiel NVIDIA Container Toolkit décrit l'intégration avec Docker.
Les couches Docker déjà disponibles peuvent raccourcir un build. Elles ne changent pas la formule de normalisation que nous allons comparer.
Vérifier le programme avant le calcul distribué
Avant de lancer les deux processus, exécutons les tests publics. Ils couvrent les fonctions de normalisation et de reprise du projet :
docker compose run --rm gpu python -m pytest -q
C'est la même logique qu'un test unitaire de calcul de panier avant un essai de commande complet : nous vérifions d'abord les fonctions, puis leur comportement dans le parcours réel.
Une réussite de cette suite ne remplace pas la comparaison numérique à la référence mono-GPU. Elle ne remplace pas non plus l'essai d'interruption et de reprise. Ces contrôles arrivent ensuite et répondent à des questions différentes.
Données : créer volontairement un déséquilibre
Des séquences courtes d'un côté, longues de l'autre
Le corpus contient 1 024 séquences d'entraînement, 128 de validation et 256 de test. Dans chaque fenêtre d'entraînement, le rang 0 reçoit des séquences de 16 à 64 tokens, tandis que le rang 1 reçoit des séquences de 65 à 128 tokens.
Ce déséquilibre est voulu. Il oblige le programme à distinguer le nombre de séquences du nombre de tokens. Même avec autant de séquences sur chaque carte, les deux rangs ne portent pas la même quantité de supervision.
Un microbatch, ou micro-lot, est le petit lot traité lors d'un passage dans le modèle. Une fenêtre d'accumulation regroupe plusieurs microbatches dont les gradients sont additionnés avant une seule mise à jour des poids. Ici, chaque fenêtre contient deux microbatches par rang.
Le plan suivant choisit les identifiants de ces séquences. Il ne calcule pas encore la perte, ne déplace rien sur les GPU et ne construit pas lui-même les tableaux de padding.
def make_rank_batches(rows, config):
    pools = [
        [
            r["id"]
            for r in rows
            if r["split"] == "train" and (len(r["tokens"]) <= 64) == (rank == 0)
        ]
        for rank in range(2)
    ]
    rng = random.Random(config["seed"] + 10)
    plan = []
    for step in range(config["updates"]):
        selected = [
            rng.sample(pool, config["accumulation"] * config["batch_size_per_rank"])
            for pool in pools
        ]
        plan.append(
            [
                [
                    ids[i : i + config["batch_size_per_rank"]]
                    for i in range(0, len(ids), config["batch_size_per_rank"])
                ]
                for ids in selected
            ]
        )
    return plan
Lire le plan comme une structure de données Python
La variable pools contient deux listes d'identifiants. Le filtre ne retient que les lignes train. L'expression (len(r["tokens"]) <= 64) == (rank == 0) met les séquences courtes dans le premier groupe et les longues dans le second. Les bornes 16 et 128 appartiennent au corpus préparé ; cette fonction utilise seulement la coupure à 64.
Le générateur random.Random(config["seed"] + 10) isole le tirage de ce plan. À données, ordre des listes et configuration identiques, on peut reproduire ses choix.
Pour chaque mise à jour, rng.sample prend accumulation × batch_size_per_rank identifiants dans chaque groupe. Le découpage ids[i : i + batch_size_per_rank] les répartit ensuite en microbatches. La structure se lit ainsi : plan[step][rank][microbatch] donne la liste des identifiants à traiter.
Dans une fenêtre, le tirage est sans remise : un identifiant n'est pas sélectionné deux fois pour le même rang. Les groupes étant disjoints, il n'est pas partagé entre les deux rangs non plus. À la fenêtre suivante, le même identifiant peut en revanche revenir. Le code ne retire pas définitivement les éléments du groupe. C'est le comportement de random.sample, utilisé ici à chaque nouvelle fenêtre.
Nous ne parcourons donc pas nécessairement tout le corpus une fois avant de revoir un exemple. Le plan est défini par les mises à jour, pas par l'hypothèse implicite d'un passage intégral sans répétition.
Deux « remplissages » à ne pas confondre
Le padding des tokens complète des séquences courtes pour former un tableau rectangulaire. Pour visualiser l'idée sur un exemple miniature, distinct du corpus : [7, 4, 9] et [5, 2] peuvent devenir [7, 4, 9] et [5, 2, PAD]. Le tableau possède six cases, mais seulement cinq tokens d'origine. La case ajoutée ne doit pas augmenter le dénominateur de la perte.
Le padding d'un sampler désigne un autre problème : compléter un plan de données en répétant certains identifiants pour équilibrer les processus. Ici, le plan n'introduit pas de tels doublons entre rangs dans une fenêtre. Le déséquilibre de tokens reste visible au lieu d'être masqué.
Construisons maintenant le corpus, le plan et la référence mono-GPU :
docker compose run --rm gpu python -m ddp_tokens.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m ddp_tokens.cli reference --config configs/minimum.yaml
docker compose run --rm gpu python -m ddp_tokens.cli check-loss --config configs/minimum.yaml
prepare fixe les séquences et les fenêtres. reference part du même état initial que la comparaison distribuée et sert de calcul témoin. check-loss expose les deux valeurs du contre-exemple, 2 et 2,5, avant tout lancement avec torchrun.
À ce stade, nous avons les données et un résultat auquel nous comparer. Il reste à comprendre comment pondérer les pertes locales pour le retrouver.
Le calcul central : le dénominateur global
Un dénominateur pour toute la fenêtre
Nommons les quantités une fois pour pouvoir lire la formule :
W est le nombre de rangs, donc 2 dans ce projet. S_r est la somme des pertes du rang r sur toute sa fenêtre. N_r est son nombre de tokens supervisés. Enfin, N = somme des N_r est le nombre total de tokens supervisés des deux rangs, sur les deux microbatches.
L'objectif souhaité est :
L = (S_0 + S_1) / N.
La tentation serait de faire calculer S_r / N à chaque rang. Mais DDP moyenne ensuite les gradients entre les deux processus : cela ajouterait une division par 2 dont nous n'avons pas besoin.
Chaque rang utilise donc :
L_r = W × S_r / N.
Après la moyenne DDP, le facteur W s'annule :
(1 / W) × somme_r gradient(W × S_r / N) = gradient(somme_r S_r / N).
Le symbole « gradient » désigne ici les dérivées par rapport aux poids. Le raisonnement repose sur un dénominateur fixé par les données de la fenêtre, qui ne dépend pas des poids, et sur la moyenne des gradients utilisée par ce DDP. Multiplier par W ne vise pas à « apprendre deux fois plus vite » : cela compense une division déjà présente dans l'agrégation.
Sur notre contre-exemple, W / N = 2 / 48 = 1 / 24. Le rang 0 utilise donc 12 / 24 = 0,5 et le rang 1 108 / 24 = 4,5. La moyenne de ces contributions vaut (0,5 + 4,5) / 2 = 2,5.
Ces deux scalaires locaux ne sont plus les moyennes locales 1 et 3. C'est normal : ils sont préparés pour l'agrégation. Les confondre avec une métrique moyenne déjà calculée sur tout le corpus rendrait les journaux trompeurs.
Compter avant de rétropropager
def global_token_loss(local_sum, global_count, world_size):
    if global_count <= 0:
        raise ValueError(
            "No supervised token in the global accumulation window; all ranks must skip or stop together"
        )
    return local_sum * (world_size / global_count)


def global_count(local_count, device):
    count = torch.tensor(local_count, device=device, dtype=torch.long)
    dist.all_reduce(count, op=dist.ReduceOp.SUM)
    return int(count)
global_token_loss reçoit une somme, pas une perte déjà moyennée. Elle la multiplie par le facteur commun world_size / global_count. Fournir à sa place une moyenne locale modifierait une seconde fois la pondération.
La fonction global_count transforme le compteur local en tenseur entier sur le périphérique utilisé. Un tenseur est ici simplement une valeur numérique que PyTorch peut manipuler et communiquer. dist.all_reduce(..., SUM) additionne les compteurs et laisse le total dans le tenseur de chaque rang : 12 et 36 deviennent 48 sur les deux processus. int(count) récupère ce total sous forme d'entier Python. La documentation des collectives PyTorch décrit cette opération en place.
Une collective est une communication à laquelle les processus du groupe participent ensemble. Le compteur n'est donc pas envoyé à un seul « chef » qui garderait le résultat pour lui : les deux rangs ont besoin du même dénominateur avant leur backward.
Deux opérations distinctes sont à retenir : le programme additionne d'abord les comptes de tokens, puis DDP synchronise les gradients. Le code ci-dessus ne synchronise pas automatiquement une métrique globale de perte.
Et si la fenêtre ne contient aucun token supervisé ?
Une moyenne sur zéro token n'est pas définie. La branche global_count <= 0 lève donc une erreur au lieu de fabriquer une perte égale à zéro.
Dans ce projet, les rangs rejettent collectivement la même fenêtre. La fonction ne met toutefois pas en place, à elle seule, toute la coordination : l'appelant doit avoir calculé le même compte global et faire suivre un parcours compatible aux processus.
Imaginez deux workers devant se retrouver à une étape d'échange. Si l'un décide seul de quitter la boucle et que l'autre attend encore cet échange, le second peut rester bloqué. Une condition locale ne doit donc pas faire sauter isolément une collective ou un backward attendu par les autres rangs.
Un rang localement vide n'est pas la même chose qu'une fenêtre globalement vide. Si les autres rangs ont de la supervision, le dénominateur global peut être positif. Adapter le projet à ce cas demanderait de tester sa participation correcte au calcul et aux communications ; la seule garde sur N <= 0 ne prouve pas que tous les cas localement vides sont gérés.
Ce que vérifie exactement check_loss()
def check_loss(config):
    local_sums = [12.0, 108.0]
    counts = [12, 36]
    wrong = sum(s / n for s, n in zip(local_sums, counts)) / 2
    correct = sum(global_token_loss(s, sum(counts), 2) for s in local_sums) / 2
    assert correct == 2.5 and wrong == 2.0
    return {
        "local_tokens": counts,
        "local_loss_sums": local_sums,
        "mean_of_means": wrong,
        "global_mean": correct,
    }
wrong reproduit la moyenne des moyennes : 2. correct applique la formule pondérée puis la moyenne entre les deux rangs : 2,5. Le paramètre config ne sert pas dans ce petit contrôle ; les valeurs sont volontairement fixées dans la fonction.
Le test s'exécute sur des nombres Python. Il ne lance ni réseau neuronal, ni backward, ni communication DDP. Il vérifie l'identité arithmétique ; la comparaison réelle des gradients vient dans le protocole GPU.
La variante wrong doit rester erronée. Elle joue le rôle d'un contrôle négatif : un test capable d'accepter la bonne formule mais incapable de refuser la mauvaise ne protégerait pas le mécanisme étudié. Une division supplémentaire par le nombre de microbatches ne corrigerait pas cette pondération.
Pourquoi une perte identique ne suffit pas à prouver un gradient identique
Voici un exemple pédagogique indépendant du modèle r1, avec un seul paramètre θ et une erreur au carré.
Le rang 0 possède 12 cibles égales à +1 : sa somme de pertes est 12 × (θ − 1)². Le rang 1 possède 36 cibles égales à −1 : sa somme est 36 × (θ + 1)².
À θ = 0, tous les tokens ont une perte égale à 1. Les deux méthodes affichent donc une perte moyenne de 1. En regardant uniquement ce chiffre, nous ne voyons aucune différence.
Mais la dérivée de (θ − 1)² vaut 2 × (θ − 1), soit −2 à cet endroit. Celle de (θ + 1)² vaut +2. La moyenne de moyennes produit alors un gradient (-2 + 2) / 2 = 0. La moyenne globale produit (12 × -2 + 36 × 2) / 48 = 1.
Même perte affichée, gradients différents. C'est précisément pourquoi notre validation compare les gradients eux-mêmes, pas seulement deux valeurs de loss dans un journal.
Accumulation : englober forward et backward
Deux microbatches, une seule mise à jour
Au lieu de calculer toute une fenêtre en un seul passage, nous traitons ses microbatches successivement. Chaque appel à backward() ajoute sa contribution aux gradients déjà présents. La documentation de Tensor.backward décrit cette accumulation : il faut donc vider les anciens gradients au bon moment, pas après chaque microbatch.
Pendant cette fenêtre, les poids ne doivent pas être mis à jour entre les microbatches. Sinon, les contributions seraient calculées sur des états différents du modèle et ne représenteraient plus le gradient de la même somme.
Le forward calcule les prédictions à partir des entrées. Le backward calcule les dérivées de la perte. no_sync() ne supprime aucun de ces calculs : il reporte la synchronisation des gradients entre rangs pour les microbatches intermédiaires.
def accumulate(model, batches, mapping, rank, denominator, world, wrong=False):
    model.zero_grad(set_to_none=True)
    local_n = sum(len(mapping[i]["tokens"]) for micro in batches for i in micro)
    for index, ids in enumerate(batches):
        # The context deliberately includes the forward as well as the backward.
        context = (
            model.no_sync() if index < len(batches) - 1 else contextlib.nullcontext()
        )
        with context:
            tokens, labels = padded(ids, mapping, rank)
            summed = loss_sum(model(tokens), labels)
            loss = (
                summed / local_n
                if wrong
                else global_token_loss(summed, denominator, world)
            )
            loss.backward()
    return local_n
Suivre les responsabilités de chaque ligne
model.zero_grad(set_to_none=True) retire les gradients de la fenêtre précédente. Cette instruction est placée avant la boucle, afin que les deux backward suivants puissent contribuer à la même accumulation.
local_n compte les tokens d'origine des séquences de ce rang dans toute la fenêtre. mapping permet de retrouver une séquence à partir de son identifiant. Le dénominateur global, lui, arrive déjà dans le paramètre denominator : accumulate() ne l'obtient pas en appelant global_count() dans cette boucle.
Pour chaque microbatch, padded() prépare les entrées et les labels de supervision. model(tokens) effectue le forward, puis loss_sum() donne la somme de pertes des positions retenues. Le petit réseau, le padding et cette fonction de perte appartiennent au projet complet ; les extraits de l'article se concentrent sur la normalisation et l'accumulation.
Le choix wrong=True divise chaque somme de microbatch par local_n. Après addition des microbatches, cela devient la moyenne locale du rang. DDP en fera ensuite la moyenne entre rangs : c'est précisément la référence erronée que le test doit détecter.
Dans la voie correcte, chaque microbatch utilise au contraire le même compte global de fenêtre. On ne normalise ni par sa longueur propre ni par un dénominateur recalculé pour ce seul passage.
Enfin, la fonction retourne local_n. Elle ne contient pas d'appel à optimizer.step() : la mise à jour des poids appartient à la boucle d'entraînement qui l'entoure. Le projet n'ajoute pas de nouvelle division au moment de cette mise à jour.
Pourquoi placer le forward dans no_sync() ?
Pour le premier microbatch, context vaut model.no_sync(). Pour le dernier, il vaut contextlib.nullcontext(), un contexte qui ne modifie rien. La synchronisation DDP est ainsi active sur le dernier passage.
Le point subtil est la portée du with : le forward et le backward doivent tous les deux être dedans. Entourer seulement loss.backward() ne suffit pas à supprimer la synchronisation comme prévu. C'est une condition explicite de la documentation de no_sync().
À la fin du dernier backward, les contributions accumulées participent à la synchronisation. Il s'agit d'un point de synchronisation logique de la fenêtre ; cela ne signifie pas que tous les gradients tiennent nécessairement dans un unique message réseau.
Refaire l'accumulation à la main
Décomposons le contre-exemple 12/36 en deux microbatches fictifs par rang. Ce tableau illustre le calcul ; ce ne sont pas des longueurs de lots capturées dans r1.
Sur mobile, faites défiler le tableau horizontalement.
| Rang | Microbatch | Tokens valides | Somme des pertes | Contribution avec W / N = 2 / 48 |
|---|---|---|---|---|
| 0 | Premier | 4 | 4 | 4 / 24 ≈ 0,1667 |
| 0 | Second | 8 | 8 | 8 / 24 ≈ 0,3333 |
| 1 | Premier | 12 | 36 | 36 / 24 = 1,5 |
| 1 | Second | 24 | 72 | 72 / 24 = 3 |
Les deux contributions du rang 0 totalisent 0,5 ; celles du rang 1 totalisent 4,5. Leur moyenne est toujours 2,5. Le découpage en microbatches n'a pas changé la définition de la moyenne.
Diviser encore chaque contribution par accumulation = 2 donnerait 1,25 après agrégation et diviserait également le gradient par deux. Le dénominateur global de fenêtre avait déjà pris en compte les quatre microbatches.
La règle n'est donc pas « ne jamais diviser par le nombre de microbatches ». Elle est : ne pas ajouter une division déjà contenue dans la normalisation choisie. Une recette qui part de moyennes de microbatches de tailles égales se raisonne autrement que celle-ci, qui part de sommes et d'un compte global.
Exécuter l'arrêt, le parcours continu et la reprise
Nous pouvons maintenant lancer les trois passages distribués : un arrêt au pas 50, un entraînement continu jusqu'à 100, puis une reprise de 50 à 100.
docker compose run --rm dual torchrun --rdzv-backend=static --master-addr=127.0.0.1 --master-port=29500 --nnodes=1 --nproc-per-node=2 -m ddp_tokens.train --config configs/minimum.yaml
docker compose run --rm dual torchrun --rdzv-backend=static --master-addr=127.0.0.1 --master-port=29500 --nnodes=1 --nproc-per-node=2 -m ddp_tokens.train --config configs/minimum.yaml --continuous
docker compose run --rm dual torchrun --rdzv-backend=static --master-addr=127.0.0.1 --master-port=29500 --nnodes=1 --nproc-per-node=2 -m ddp_tokens.train --config configs/minimum.yaml --resume artifacts/checkpoints/step-0050
Lancez ces commandes l'une après l'autre. --nnodes=1 décrit un seul nœud de calcul, et --nproc-per-node=2 lance deux processus. Le rendez-vous statique à l'adresse 127.0.0.1, port 29500, sert à leur coordination locale. Ce port n'est pas celui d'une API métier. La documentation de torchrun explique les rôles du lanceur et des rangs.
Le parcours sans option supplémentaire crée l'arrêt prévu à 50. --continuous produit le témoin à 100 mises à jour. --resume artifacts/checkpoints/step-0050 charge l'état interrompu pour poursuivre le même parcours jusqu'à 100.
Un checkpoint est plus qu'un fichier de poids
Pensez à un traitement de données interrompu : conserver son résultat partiel sans savoir quels éléments ont déjà été lus ne suffit pas à reprendre au bon endroit. L'entraînement a le même besoin de continuité.
Le checkpoint commun du projet contient le modèle, l'optimiseur, la configuration et le verrou de données. Ce verrou identifie les données attendues ; il ne faut pas le confondre avec un verrou empêchant deux processus d'entrer dans une section critique.
Chaque rang conserve aussi son état aléatoire, son rang et son historique. Le programme préserve l'historique du sampler, c'est-à-dire du mécanisme de sélection des séquences. La reprise doit retrouver à la fois les poids et la suite du parcours de données.
Une graine initialise un générateur pseudo-aléatoire. Son état courant indique où il en est après les tirages déjà effectués. Remettre seulement la graine initiale peut recommencer la séquence de tirages au lieu de poursuivre à l'endroit de l'arrêt. La note PyTorch sur la reproductibilité aide à distinguer contrôle de l'aléatoire et garanties entre environnements.
La reprise présentée ici se fait à une frontière de mise à jour définie par le protocole. Elle ne démontre pas la récupération d'un arrêt arbitraire au milieu d'un backward ou d'une communication.
Mesures à lire avant les résultats
Trois questions, trois contrôles
La première question est : le gradient DDP correspond-il au gradient mono-GPU ? Le projet place les valeurs des gradients à la suite pour former un vecteur, puis compare ce vecteur à la référence obtenue sur le même état initial et les mêmes tokens. Le test porte sur 282 628 valeurs, avec les tolérances atol=1e-6 et rtol=1e-4. Ce nombre décrit les composantes comparées, pas la taille du corpus.
La deuxième question est : la reprise retrouve-t-elle les mêmes paramètres que l'entraînement continu ? Nous comparons alors les poids à l'étape 100, et non les gradients du contrôle initial. Une formule correcte et une reprise correcte sont deux propriétés distinctes.
La troisième question est : qu'obtient le modèle entraîné sur les données de test ? Le parcours réalise 100 mises à jour avec SGD, en FP32 et avec accumulation de deux microbatches par rang. SGD est l'optimiseur utilisé pour appliquer les gradients. FP32 désigne un calcul en nombres flottants sur 32 bits. Le test final porte sur 256 séquences et 18 231 tokens valides.
La loss token test est une perte moyenne par token. Ce n'est pas un pourcentage de réussite. L'exactitude token mesure la proportion de tokens correctement prédits parmi les positions évaluées ; elle ne signifie pas que la même proportion de séquences entières est correcte.
Comment lire les tolérances numériques ?
Une tolérance absolue borne les petits écarts, notamment près de zéro. Une tolérance relative s'ajuste à la grandeur de la valeur de référence. La convention décrite pour torch.allclose est, composante par composante :
abs(gradient_DDP - gradient_reference) <= atol + rtol × abs(gradient_reference).
Avec nos tolérances, une référence égale à 0 autorise un écart allant jusqu'à 0,000001. Une référence égale à 1 autorise 0,000001 + 0,0001 = 0,000101. Ce sont des exemples de lecture des seuils, pas des composantes publiées du gradient r1.
Pourquoi ne pas exiger zéro partout ? L'ordre des opérations peut différer entre calcul mono-GPU et calcul distribué. Or les additions en précision finie ne sont pas parfaitement associatives. La note PyTorch sur la précision numérique rappelle qu'une identité mathématique ne garantit pas une égalité bit à bit entre deux chemins de calcul.
La bonne vérification applique les tolérances à toutes les composantes. L'erreur absolue maximale résume le plus grand écart, mais ne remplace pas à elle seule cette comparaison complète.
Lire le bilan du parcours
Calculez l'évaluation :
docker compose run --rm gpu python -m ddp_tokens.cli evaluate --config configs/minimum.yaml
Les valeurs suivantes sont des mesures locales observées dans le parcours r1. Elles ne prédisent pas la qualité d'une autre architecture, de données réelles, d'un autre optimiseur ou d'un entraînement sur plusieurs nœuds.
Sur mobile, faites défiler le tableau horizontalement.
| Contrôle observé | Résultat |
|---|---|
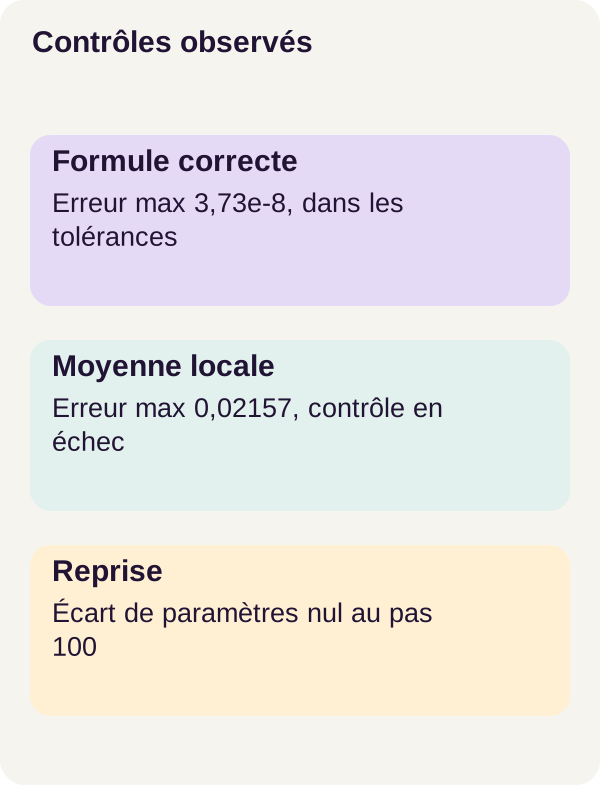
| Erreur absolue max, normalisation correcte | 3,73e-8 |
| Normalisation correcte dans les tolérances | Oui |
| Erreur absolue max, moyenne de moyennes | 0,02157 |
| Normalisation erronée dans les tolérances | Non |
| Écart max des paramètres, reprise vs continu | 0 |
| Loss token test | 1,31525 |
| Exactitude token test | 36,22 % |
La normalisation correcte retrouve la référence dans les tolérances, avec une erreur absolue maximale de 3,73e-8. La moyenne de moyennes échoue au même contrôle, avec une erreur maximale de 0,02157. Nous avons donc à la fois un cas accepté et une erreur volontaire effectivement détectée.
Le test de reprise répond à une autre question : l'écart maximal entre les paramètres repris et ceux du parcours continu est 0 à l'étape 100. La conservation de l'historique du sampler et des générateurs aléatoires par rang fait partie de cette reprise. Le zéro n'est pas en contradiction avec le petit écart du gradient mono/DDP : les deux comparaisons ne portent ni sur les mêmes objets ni sur les mêmes parcours.
Les deux rangs rejettent également une fenêtre à zéro token supervisé. Ce contrôle complète le chemin normal : il vérifie que l'absence globale de supervision n'est pas traitée comme une moyenne valide.
Enfin, 1,31525 de loss test et 36,22 % d'exactitude token ne constituent pas une démonstration de gain métier. Le résultat central du tutoriel est la parité du calcul choisi. Il ne s'agit ni d'un classement de modèles ni d'une mesure d'accélération sur deux GPU.
La reprise exacte établit le mécanisme dans ce protocole. Elle ne prouve pas la robustesse d'une reprise préemptée à n'importe quel instant sur une infrastructure distribuée.
Ce que nous avons appris
Une moyenne commence par une question : quelle unité doit compter autant que les autres ? Ici, la réponse est le token supervisé. Une moyenne de moyennes par rang donne un autre poids à ces tokens lorsque leurs nombres diffèrent.
DDP synchronise les gradients, mais ne connaît pas cette intention. Le facteur world_size / global_count prépare les contributions locales pour que leur moyenne corresponde au gradient souhaité. Le nombre de GPU n'est pas un coefficient à ajouter ou retirer par habitude : il faut suivre les divisions réellement effectuées.
L'accumulation ne change pas l'objectif. Elle découpe le calcul en microbatches, avec un dénominateur couvrant toute la fenêtre et des poids inchangés entre ses passages. no_sync() reporte la synchronisation ; il ne remplace ni le comptage des tokens ni le backward.
Enfin, un checkpoint doit permettre de reprendre la trajectoire, pas seulement de recharger un modèle. Les données à venir, l'état de l'optimiseur et les générateurs aléatoires appartiennent aussi à cette continuité.
Exercice : hypothèse avant la commande
Le rang 0 conserve 12 tokens valides. Le rang 1 passe de 12 à 36 tokens, sans changer la répartition des pertes par token que nous voulons comparer. Avant d'exécuter le programme, prédisez ce que deviennent la moyenne de moyennes et la moyenne globale. Laquelle accorde trop de poids au rang court ?
Pour rendre votre calcul explicite, prenons comme hypothèse pédagogique une perte de 1 par token sur le rang 0 et de 3 par token sur le rang 1, avant et après le changement. Cette hypothèse sert au calcul manuel ; les gradients de l'exercice sont ceux fournis par son exécution.
Avec 12 tokens sur chaque rang, les sommes valent 12 et 36. Les deux moyennes donnent 2. Quand le second rang passe à 36 tokens, sa somme devient 108 : la moyenne des moyennes reste 2, tandis que la moyenne globale passe à 2,5.
La moyenne de moyennes ne voit donc pas que le groupe où la perte est la plus élevée contient désormais trois fois plus de tokens. Le rang court garde la moitié du poids au lieu du quart.
Écrivez également votre prédiction sur la normalisation : faut-il changer W, changer N ou diviser une seconde fois par le nombre de microbatches ? Les deux rangs restent présents, donc W reste 2 ; c'est le nombre global de tokens qui change.
Exécutez ensuite l'exercice du parcours :
docker compose run --rm gpu python -m ddp_tokens.cli exercise --config configs/exercise.yaml
Comparez les calculs et les gradients fournis à votre hypothèse. N'attendez pas qu'une erreur de loss de 0,5 produise automatiquement un écart de gradient de 0,5 : une valeur de fonction et sa dérivée sont deux objets différents.
Gardez l'échec de la variante incorrecte comme contrôle de non-régression. Le but n'est pas de faire passer tous les modes en assouplissant les seuils, mais de vérifier qu'une modification future du code ne rend pas la mauvaise pondération invisible.
Adapter le modèle et préparer la production
Choisir l'unité avant de recopier la formule
Sur un autre projet, l'unité de pondération pourrait être une séquence, un exemple, un document ou un coût métier. Donner le même poids total à chaque document, quelle que soit sa longueur, n'est pas la même chose que donner le même poids à chacun de ses tokens. Les deux choix peuvent répondre à des besoins différents ; il faut annoncer lequel est entraîné.
Le compteur du code additionne ici len(mapping[i]["tokens"]). C'est cohérent avec les tokens supervisés de ce corpus. Ce raccourci n'est pas universel. Dans un autre entraînement, certaines positions d'entrée peuvent être exclues de la perte : prompt non supervisé, labels ignorés ou cibles décalées. Il faudra compter les positions qui contribuent réellement à l'objectif, pas seulement la longueur de l'entrée.
À titre de référence générale, CrossEntropyLoss documente les labels ignorés et les effets de la pondération sur la réduction. Cela ne remplace pas la définition de loss_sum() dans votre propre application. Ajouter des poids de classes ou un terme de régularisation demande également de redériver la normalisation de chaque terme, pas d'appliquer mécaniquement le même dénominateur à toute la perte.
La formule présentée suppose aussi l'agrégation DDP du parcours de référence. Une stratégie de communication personnalisée, un nombre variable de participants ou des rangs qui n'effectuent plus le même nombre de passages demandent de revoir les hypothèses et les tests.
Tester une adaptation sans changer le témoin
Conservez le parcours de référence, puis travaillez dans une copie pour modifier le corpus ou le modèle. Comparez toujours des gradients obtenus avec le même état initial et les mêmes positions supervisées. Introduisez volontairement des tailles inégales : un test qui ne contient que des comptes identiques peut laisser passer l'erreur étudiée ici.
Contrôlez séparément une fenêtre globalement vide et les branches où un seul rang n'a aucune supervision. Ne concluez pas qu'une branche est sûre parce que le calcul algébrique de la voie normale est correct : il faut également vérifier l'ordre de participation aux communications.
Ce que la démonstration ne fournit pas
Une mise en production distribuée demande un rendez-vous robuste entre processus, des délais, une politique de reprise, des journaux et métriques par rang, une gestion des préemptions, des tests multi-nœuds et une stratégie de données.
Il faut notamment pouvoir déterminer quel rang a échoué, à quelle étape il se trouvait et quel état cohérent peut être restauré. Ce sont des exigences supplémentaires, pas des conséquences automatiques de l'écart nul observé à l'étape 100. La démonstration sur un hôte ne prétend pas les couvrir.
Dépannage et nettoyage
Le contrôle dual échoue. Ne lancez pas encore torchrun. Vérifiez que deux GPU sont exposés au conteneur et que chaque processus sélectionne sa propre carte. Réparez l'environnement avant de modifier la formule d'entraînement.
Les processus semblent bloqués. Comparez leurs derniers messages et l'ordre des collectives. Un rang ne doit pas sauter seul all_reduce ou un backward auquel l'autre participe encore. Un nombre inégal de tokens est prévu ici ; un nombre incompatible d'étapes de communication est un autre problème.
La parité des gradients échoue. Inspectez d'abord le compte global de toute la fenêtre, puis vérifiez que loss_sum() fournit une somme, que no_sync() englobe le forward et le backward, et qu'aucune division supplémentaire n'est appliquée. Comparez également l'état initial et les données utilisés par les deux voies.
Le modèle se recharge, mais la reprise diffère. Recharger des poids ne démontre pas la reprise complète. Examinez aussi l'optimiseur, la configuration, le verrou de données, la position dans le plan et les états aléatoires par rang avant d'attribuer l'écart à DDP.
Après vos observations, générez la figure, contrôlez les checkpoints, prévisualisez le nettoyage et arrêtez les services :
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
Le nettoyage reste volontairement en --dry-run : il affiche ce qui serait concerné sans exécuter la suppression. Examinez cette prévisualisation avant toute décision d'effacement. La dernière commande arrête les services Compose de ce projet ; elle n'est pas une demande de purge globale de votre environnement Docker.
Sources primaires
Les liens suivants permettent d'approfondir les mécanismes. Ils ne remplacent pas les fichiers et paramètres du ZIP pour reproduire r1 ; les références de documentation ne constituent pas un relevé supplémentaire des versions exécutées.
- PyTorch 2.8 — DistributedDataParallel : répliques, agrégation des gradients et portée de
no_sync(). - PyTorch — collectives distributed : rôle des communications collectives et de
all_reduce. - NVIDIA Container Toolkit — guide d’installation : exposition des GPU aux conteneurs.
Pour lire les calculs : accumulation avec Tensor.backward, tolérances de torch.allclose, précision numérique et réductions de CrossEntropyLoss.
Pour comprendre les processus et leur état : lanceur torchrun, reproductibilité PyTorch et tirage sans remise avec random.sample.