





Immaginate che il vostro cruscotto mostri la durata media delle richieste elaborate da due server. Il primo ne ha ricevute poche, il secondo molte di più. Per ottenere la media complessiva, non basta sommare le due medie e dividere per due: bisogna considerare anche il numero di richieste dietro ogni cifra.
La stessa insidia esiste quando due GPU addestrano un modello su sequenze di lunghezze diverse. Ogni scheda può calcolare una media perfettamente corretta sui propri dati e poi partecipare a un calcolo globale che non rappresenta più l'obiettivo scelto.
Renderemo visibile questo problema con un piccolo modello e dati sintetici. Confronteremo un calcolo su due GPU con un riferimento su una sola GPU, quindi interromperemo l'addestramento per verificarne la ripresa. L'obiettivo non è superare un modello noto né misurare un'accelerazione: vogliamo ritrovare il gradiente di una media calcolata su tutti i token validi della stessa finestra di addestramento.
Scaricare il progetto completo
Il progetto non richiede pesi preaddestrati né corpus esterni. Potete seguire il ragionamento con le basi di Python e qualche calcolo di medie; il percorso eseguibile usa invece Docker e due GPU. I numeri del bilancio restano quelli dell'esecuzione di riferimento r1. I piccoli esempi aggiuntivi servono a spiegare i calcoli, non ad annunciare nuove misure del modello.
Il problema: una media di medie è distorta
Prima di tutto, che cosa vogliamo far apprendere?
Un modello possiede parametri, chiamati anche pesi: sono i numeri modificati durante l'addestramento. Per un lotto di dati, produce previsioni che il programma confronta con le risposte attese. La perdita, o loss, riassume il costo degli errori secondo la regola scelta.
In questo tutorial, la perdita si scompone in contributi per token supervisionato. Un token è un'unità di una sequenza, rappresentata nel programma da un identificatore numerico. Per un testo può corrispondere a una parola, a una parte di parola o a un simbolo; qui le sequenze sono sintetiche. «Supervisionato» significa che una risposta attesa contribuisce effettivamente al calcolo della perdita in quella posizione.
Il gradiente indica come varia la perdita quando i parametri cambiano leggermente. Contiene una derivata per ogni parametro. Il calcolo di queste derivate si chiama retropropagazione, o backward. Un ottimizzatore usa poi questi gradienti per modificare i pesi. Ritroveremo entrambe le operazioni nel codice: calcolare il gradiente non significa ancora applicare l'aggiornamento.
La nostra scelta è precisa: ogni token supervisionato conta quanto gli altri nella media della finestra. Una sequenza lunga apporta quindi più contributi di una sequenza corta. Qui non cerchiamo di attribuire lo stesso peso totale a ogni sequenza.
Due processi, due numeri di token
Un rank indica un processo che partecipa al calcolo distribuito. Nella nostra esperienza, il rank 0 lavora su una GPU e il rank 1 sull'altra. Ognuno possiede una copia dello stesso modello, ma riceve sequenze diverse.
Riprendiamo il controesempio del progetto. Il primo rank elabora 12 token e ottiene una somma delle perdite pari a 12. Il secondo elabora 36 token e ottiene una somma delle perdite pari a 108.
Su mobile, scorrete la tabella orizzontalmente.
| Rank | Token validi | Somma delle perdite | Media locale | Quota dei token della finestra |
|---|---|---|---|---|
| 0 | 12 | 12 | 12 / 12 = 1 |
12 / 48 = 25 % |
| 1 | 36 | 108 | 108 / 36 = 3 |
36 / 48 = 75 % |
La media delle medie locali dà:
(1 + 3) / 2 = 2.
Ma la media di tutti i token dà:
(12 + 108) / (12 + 36) = 120 / 48 = 2,5.
Possiamo ritrovare questo risultato anche ponderando le medie locali:
25 % × 1 + 75 % × 3 = 2,5.
Che cosa è accaduto nel primo calcolo? Il rank corto ha ricevuto metà del peso totale pur contenendo solo un quarto dei token. Ogni token del rank 0 pesa 1 / (2 × 12), contro 1 / (2 × 36) per un token del rank 1: il primo pesa tre volte più del secondo.
Non si tratta quindi di un errore di arrotondamento. Abbiamo cambiato la domanda posta al calcolo: «qual è la media dei due rank?» ha sostituito «qual è la media di tutti i token?».
Quando i rank contengono lo stesso numero di token, le due formule coincidono. Medie locali identiche possono anche nascondere la differenza. Ecco perché testare solo lotti equilibrati non consente di rilevare questo problema.
Dove interviene DDP?
DistributedDataParallel, abbreviato DDP, sincronizza i gradienti fra le copie del modello. Nel funzionamento usato qui, la loro aggregazione corrisponde a una media fra rank. DDP però non sa che il vostro obiettivo è una media per token e non distribuisce gli input al posto vostro. La scelta delle sequenze resta responsabilità dell'applicazione, come precisa la documentazione PyTorch di DDP.
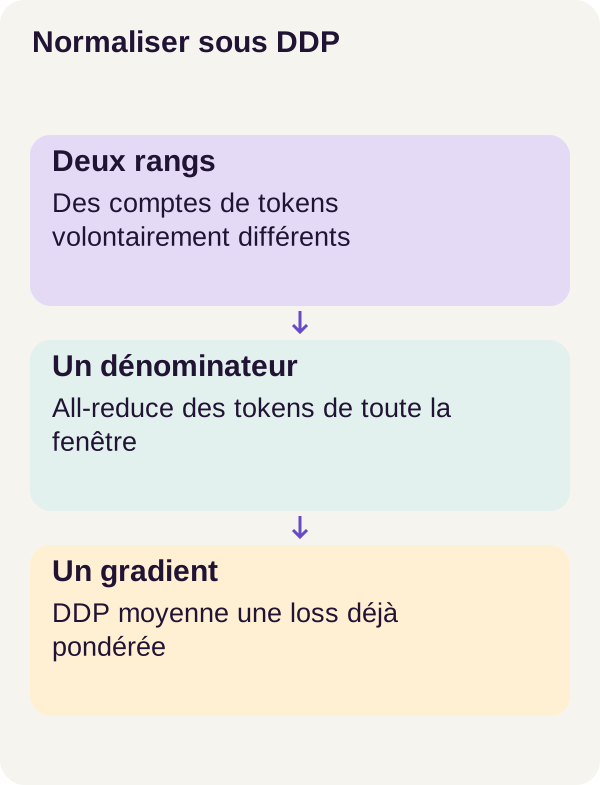
L'idea del tutorial è quindi preparare su ogni rank una perdita correttamente ponderata prima del backward. DDP potrà così sincronizzare i gradienti senza modificare l'obiettivo globale desiderato.
Prerequisiti: Docker e due GPU
Il percorso convalidato richiede Linux x86_64, Docker con Compose, NVIDIA Container Toolkit e due RTX 3090 da 24 GiB visibili nel container. Prevedete inoltre 16 GiB di RAM e 16 GiB di spazio su disco, esclusi i layer Docker condivisi.
La VRAM è la memoria propria di ciascuna scheda grafica. Due schede da 24 GiB restano due memorie separate: DDP colloca una replica del modello su ciascuna, non crea una scheda virtuale da 48 GiB. CUDA permette qui di eseguire i calcoli sulle GPU NVIDIA. NCCL è il backend usato per le comunicazioni fra i processi GPU; questo protocollo non convalida al suo posto un percorso CPU o Gloo.
Sul lato Docker, il servizio gpu esegue le preparazioni e i controlli semplici. Il servizio dual serve al percorso a due processi. torchrun, che useremo più avanti, avvierà questi processi all'interno del container.
Lo script setup.sh crea le directory e scrive solo UID/GID in .env. Questi identificatori corrispondono all'utente e al suo gruppo sull'host. outputs/ riceve le misure; artifacts/ riceve i checkpoint, cioè gli stati salvati per riprendere l'addestramento.
Non vi sono né pesi preaddestrati né dati esterni da acquisire: acquire controlla quindi un'acquisizione vuota. Questo non significa che la costruzione delle immagini Docker non richieda risorse; i dati dell'esperimento saranno generati dal progetto.
Estraete l'archivio e posizionate il terminale nella sua radice. Tutti i comandi seguenti vanno eseguiti dalla stessa cartella. Iniziate costruendo le immagini e verificando l'accesso a una GPU, poi a entrambe le GPU:
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu dual
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm dual python scripts/check_environment.py --config configs/minimum.yaml --dual
docker compose config --quiet verifica la configurazione Compose. Gli script d'ambiente inizializzano realmente CUDA e controllano le schede visibili: la presenza di una GPU sull'host non basta a dimostrarne l'accesso da Docker.
I due controlli d'ambiente devono riuscire prima di proseguire. In caso di errore, correggete questo punto prima di avviare torchrun; la guida ufficiale di NVIDIA Container Toolkit descrive l'integrazione con Docker.
I layer Docker già disponibili possono accorciare una build. Non cambiano la formula di normalizzazione che confronteremo.
Verificare il programma prima del calcolo distribuito
Prima di avviare i due processi, eseguiamo i test pubblici. Coprono le funzioni di normalizzazione e ripresa del progetto:
docker compose run --rm gpu python -m pytest -q
È la stessa logica di un test unitario del calcolo di un carrello prima di una prova completa dell'ordine: prima verifichiamo le funzioni, poi il loro comportamento nel percorso reale.
Il successo di questa suite non sostituisce il confronto numerico con il riferimento mono-GPU. Non sostituisce neppure la prova di interruzione e ripresa. Questi controlli arrivano dopo e rispondono a domande diverse.
Dati: creare deliberatamente uno squilibrio
Sequenze corte da un lato, lunghe dall'altro
Il corpus contiene 1 024 sequenze di addestramento, 128 di convalida e 256 di test. In ogni finestra di addestramento, il rank 0 riceve sequenze da 16 a 64 token, mentre il rank 1 riceve sequenze da 65 a 128 token.
Questo squilibrio è voluto. Obbliga il programma a distinguere il numero di sequenze dal numero di token. Anche con lo stesso numero di sequenze su ciascuna scheda, i due rank non portano la stessa quantità di supervisione.
Un microbatch, o micro-lotto, è il piccolo lotto elaborato in un passaggio nel modello. Una finestra di accumulo raggruppa più microbatch i cui gradienti sono sommati prima di un solo aggiornamento dei pesi. Qui ogni finestra contiene due microbatch per rank.
Il piano seguente seleziona gli identificatori di queste sequenze. Non calcola ancora la perdita, non sposta nulla sulle GPU e non costruisce da sé gli array di padding.
def make_rank_batches(rows, config):
    pools = [
        [
            r["id"]
            for r in rows
            if r["split"] == "train" and (len(r["tokens"]) <= 64) == (rank == 0)
        ]
        for rank in range(2)
    ]
    rng = random.Random(config["seed"] + 10)
    plan = []
    for step in range(config["updates"]):
        selected = [
            rng.sample(pool, config["accumulation"] * config["batch_size_per_rank"])
            for pool in pools
        ]
        plan.append(
            [
                [
                    ids[i : i + config["batch_size_per_rank"]]
                    for i in range(0, len(ids), config["batch_size_per_rank"])
                ]
                for ids in selected
            ]
        )
    return plan
Leggere il piano come una struttura dati Python
La variabile pools contiene due liste di identificatori. Il filtro conserva solo le righe train. L'espressione (len(r["tokens"]) <= 64) == (rank == 0) mette le sequenze corte nel primo gruppo e quelle lunghe nel secondo. I limiti 16 e 128 appartengono al corpus preparato; questa funzione usa solo il limite di 64.
Il generatore random.Random(config["seed"] + 10) isola l'estrazione di questo piano. Con dati, ordine delle liste e configurazione identici, è possibile riprodurne le scelte.
A ogni aggiornamento, rng.sample preleva accumulation × batch_size_per_rank identificatori in ciascun gruppo. Il taglio ids[i : i + batch_size_per_rank] li ripartisce poi in microbatch. La struttura si legge così: plan[step][rank][microbatch] fornisce la lista degli identificatori da elaborare.
In una finestra, l'estrazione avviene senza reinserimento: un identificatore non viene selezionato due volte per lo stesso rank. Poiché i gruppi sono disgiunti, non è condiviso neppure fra i due rank. Nella finestra successiva lo stesso identificatore può invece ricomparire. Il codice non rimuove definitivamente gli elementi dal gruppo. È il comportamento di random.sample, usato qui a ogni nuova finestra.
Non percorriamo quindi necessariamente tutto il corpus una volta prima di rivedere un esempio. Il piano è definito dagli aggiornamenti, non dall'ipotesi implicita di un passaggio completo senza ripetizioni.
Due tipi di «riempimento» da non confondere
Il padding dei token completa sequenze corte per formare un array rettangolare. Per visualizzare l'idea con un esempio minimo, distinto dal corpus: [7, 4, 9] e [5, 2] possono diventare [7, 4, 9] e [5, 2, PAD]. L'array possiede sei celle, ma solo cinque token originari. La cella aggiunta non deve aumentare il denominatore della perdita.
Il padding di un sampler indica un altro problema: completare un piano dati ripetendo alcuni identificatori per equilibrare i processi. Qui il piano non introduce tali duplicati fra rank in una finestra. Lo squilibrio dei token resta visibile invece di essere mascherato.
Costruiamo ora il corpus, il piano e il riferimento mono-GPU:
docker compose run --rm gpu python -m ddp_tokens.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m ddp_tokens.cli reference --config configs/minimum.yaml
docker compose run --rm gpu python -m ddp_tokens.cli check-loss --config configs/minimum.yaml
prepare fissa le sequenze e le finestre. reference parte dallo stesso stato iniziale del confronto distribuito e funge da calcolo di controllo. check-loss mostra i due valori del controesempio, 2 e 2,5, prima di qualsiasi avvio con torchrun.
A questo punto abbiamo i dati e un risultato con cui confrontarci. Resta da capire come ponderare le perdite locali per ritrovarlo.
Il calcolo centrale: il denominatore globale
Un denominatore per l'intera finestra
Diamo un nome alle quantità per poter leggere la formula:
W è il numero di rank, quindi 2 in questo progetto. S_r è la somma delle perdite del rank r sull'intera finestra. N_r è il suo numero di token supervisionati. Infine, N = somma degli N_r è il numero totale di token supervisionati dei due rank, sui due microbatch.
L'obiettivo desiderato è:
L = (S_0 + S_1) / N.
La tentazione sarebbe far calcolare S_r / N a ogni rank. Ma DDP fa poi la media dei gradienti fra i due processi: ciò aggiungerebbe una divisione per 2 di cui non abbiamo bisogno.
Ogni rank usa quindi:
L_r = W × S_r / N.
Dopo la media DDP, il fattore W si annulla:
(1 / W) × somma_r gradiente(W × S_r / N) = gradiente(somma_r S_r / N).
Il simbolo «gradiente» indica qui le derivate rispetto ai pesi. Il ragionamento si basa su un denominatore fissato dai dati della finestra, che non dipende dai pesi, e sulla media dei gradienti usata da questo DDP. Moltiplicare per W non serve a «imparare due volte più velocemente»: compensa una divisione già presente nell'aggregazione.
Nel nostro controesempio, W / N = 2 / 48 = 1 / 24. Il rank 0 usa quindi 12 / 24 = 0,5 e il rank 1 108 / 24 = 4,5. La media di questi contributi è (0,5 + 4,5) / 2 = 2,5.
Questi due scalari locali non sono più le medie locali 1 e 3. È normale: sono preparati per l'aggregazione. Confonderli con una metrica media già calcolata sull'intero corpus renderebbe i log fuorvianti.
Contare prima della retropropagazione
def global_token_loss(local_sum, global_count, world_size):
    if global_count <= 0:
        raise ValueError(
            "No supervised token in the global accumulation window; all ranks must skip or stop together"
        )
    return local_sum * (world_size / global_count)


def global_count(local_count, device):
    count = torch.tensor(local_count, device=device, dtype=torch.long)
    dist.all_reduce(count, op=dist.ReduceOp.SUM)
    return int(count)
global_token_loss riceve una somma, non una perdita già mediata. La moltiplica per il fattore comune world_size / global_count. Fornire al suo posto una media locale modificherebbe la ponderazione una seconda volta.
La funzione global_count trasforma il contatore locale in un tensore intero sul dispositivo usato. Un tensore è qui semplicemente un valore numerico che PyTorch può manipolare e comunicare. dist.all_reduce(..., SUM) somma i contatori e lascia il totale nel tensore di ogni rank: 12 e 36 diventano 48 su entrambi i processi. int(count) recupera questo totale come intero Python. La documentazione delle collettive PyTorch descrive questa operazione in-place.
Una collettiva è una comunicazione a cui partecipano insieme i processi del gruppo. Il contatore non viene dunque inviato a un solo «capo» che conserva il risultato: entrambi i rank hanno bisogno dello stesso denominatore prima del loro backward.
Vanno ricordate due operazioni distinte: il programma somma prima i conteggi dei token, poi DDP sincronizza i gradienti. Il codice sopra non sincronizza automaticamente una metrica globale della perdita.
E se la finestra non contiene alcun token supervisionato?
Una media su zero token non è definita. Il ramo global_count <= 0 solleva quindi un errore invece di fabbricare una perdita uguale a zero.
In questo progetto, i rank rifiutano collettivamente la stessa finestra. La funzione, però, non realizza da sola tutto il coordinamento: il chiamante deve aver calcolato lo stesso conteggio globale e far seguire ai processi un percorso compatibile.
Immaginate due worker che devono incontrarsi in una fase di scambio. Se uno decide da solo di uscire dal ciclo mentre l'altro attende ancora quello scambio, il secondo può restare bloccato. Una condizione locale non deve quindi saltare isolatamente una collettiva o un backward previsto dagli altri rank.
Un rank localmente vuoto non è la stessa cosa di una finestra globalmente vuota. Se gli altri rank hanno supervisione, il denominatore globale può essere positivo. Adattare il progetto a questo caso richiederebbe di testare la sua corretta partecipazione al calcolo e alle comunicazioni; la sola guardia su N <= 0 non dimostra che tutti i casi localmente vuoti siano gestiti.
Che cosa verifica esattamente check_loss()
def check_loss(config):
    local_sums = [12.0, 108.0]
    counts = [12, 36]
    wrong = sum(s / n for s, n in zip(local_sums, counts)) / 2
    correct = sum(global_token_loss(s, sum(counts), 2) for s in local_sums) / 2
    assert correct == 2.5 and wrong == 2.0
    return {
        "local_tokens": counts,
        "local_loss_sums": local_sums,
        "mean_of_means": wrong,
        "global_mean": correct,
    }
wrong riproduce la media delle medie: 2. correct applica la formula ponderata e poi la media fra i due rank: 2,5. Il parametro config non serve in questo piccolo controllo; i valori sono deliberatamente fissati nella funzione.
Il test viene eseguito su numeri Python. Non avvia né una rete neurale, né il backward, né una comunicazione DDP. Verifica l'identità aritmetica; il confronto reale dei gradienti arriva nel protocollo GPU.
La variante wrong deve restare errata. Svolge il ruolo di controllo negativo: un test capace di accettare la formula corretta ma incapace di rifiutare quella sbagliata non proteggerebbe il meccanismo studiato. Un'ulteriore divisione per il numero di microbatch non correggerebbe questa ponderazione.
Perché una perdita identica non basta a dimostrare un gradiente identico
Ecco un esempio didattico indipendente dal modello r1, con un solo parametro θ e un errore quadratico.
Il rank 0 possiede 12 target uguali a +1: la sua somma delle perdite è 12 × (θ − 1)². Il rank 1 possiede 36 target uguali a −1: la sua somma è 36 × (θ + 1)².
A θ = 0, tutti i token hanno una perdita pari a 1. I due metodi mostrano quindi una perdita media di 1. Guardando solo questa cifra, non vediamo alcuna differenza.
Ma la derivata di (θ − 1)² è 2 × (θ − 1), cioè −2 in quel punto. Quella di (θ + 1)² è +2. La media delle medie produce allora un gradiente (-2 + 2) / 2 = 0. La media globale produce (12 × -2 + 36 × 2) / 48 = 1.
Stessa perdita mostrata, gradienti diversi. È proprio per questo che la nostra convalida confronta i gradienti stessi, non soltanto due valori di loss in un log.
Accumulo: includere forward e backward
Due microbatch, un solo aggiornamento
Invece di calcolare un'intera finestra in un solo passaggio, elaboriamo i suoi microbatch in successione. Ogni chiamata a backward() aggiunge il proprio contributo ai gradienti già presenti. La documentazione di Tensor.backward descrive questo accumulo: occorre quindi svuotare i vecchi gradienti al momento giusto, non dopo ogni microbatch.
Durante questa finestra, i pesi non devono essere aggiornati fra i microbatch. Altrimenti i contributi sarebbero calcolati su stati diversi del modello e non rappresenterebbero più il gradiente della stessa somma.
Il forward calcola le previsioni dagli input. Il backward calcola le derivate della perdita. no_sync() non elimina nessuno di questi calcoli: rinvia la sincronizzazione dei gradienti fra rank per i microbatch intermedi.
def accumulate(model, batches, mapping, rank, denominator, world, wrong=False):
    model.zero_grad(set_to_none=True)
    local_n = sum(len(mapping[i]["tokens"]) for micro in batches for i in micro)
    for index, ids in enumerate(batches):
        # The context deliberately includes the forward as well as the backward.
        context = (
            model.no_sync() if index < len(batches) - 1 else contextlib.nullcontext()
        )
        with context:
            tokens, labels = padded(ids, mapping, rank)
            summed = loss_sum(model(tokens), labels)
            loss = (
                summed / local_n
                if wrong
                else global_token_loss(summed, denominator, world)
            )
            loss.backward()
    return local_n
Seguire le responsabilità di ogni riga
model.zero_grad(set_to_none=True) rimuove i gradienti della finestra precedente. Questa istruzione è posta prima del ciclo, affinché i due backward successivi possano contribuire allo stesso accumulo.
local_n conta i token originari delle sequenze di questo rank nell'intera finestra. mapping permette di ritrovare una sequenza dal suo identificatore. Il denominatore globale arriva invece già nel parametro denominator: accumulate() non lo ottiene chiamando global_count() in questo ciclo.
Per ogni microbatch, padded() prepara gli input e le label di supervisione. model(tokens) esegue il forward, poi loss_sum() restituisce la somma delle perdite delle posizioni selezionate. La piccola rete, il padding e questa funzione di perdita appartengono al progetto completo; gli estratti dell'articolo si concentrano sulla normalizzazione e sull'accumulo.
La scelta wrong=True divide ogni somma di microbatch per local_n. Dopo l'addizione dei microbatch, questo diventa la media locale del rank. DDP ne farà poi la media fra rank: è proprio il riferimento errato che il test deve rilevare.
Nel percorso corretto, ogni microbatch usa invece lo stesso conteggio globale della finestra. Non si normalizza né con la propria lunghezza né con un denominatore ricalcolato per quel solo passaggio.
Infine la funzione restituisce local_n. Non contiene alcuna chiamata a optimizer.step(): l'aggiornamento dei pesi appartiene al ciclo di addestramento che la circonda. Il progetto non aggiunge una nuova divisione al momento di questo aggiornamento.
Perché collocare il forward in no_sync()?
Per il primo microbatch, context vale model.no_sync(). Per l'ultimo vale contextlib.nullcontext(), un contesto che non modifica nulla. La sincronizzazione DDP è quindi attiva sull'ultimo passaggio.
Il punto sottile è l'estensione del with: forward e backward devono essere entrambi al suo interno. Circondare solo loss.backward() non basta a sopprimere la sincronizzazione come previsto. È una condizione esplicita della documentazione di no_sync().
Alla fine dell'ultimo backward, i contributi accumulati partecipano alla sincronizzazione. Si tratta di un punto di sincronizzazione logico della finestra; non significa che tutti i gradienti siano necessariamente contenuti in un unico messaggio di rete.
Rifare l'accumulo a mano
Scomponiamo il controesempio 12/36 in due microbatch fittizi per rank. Questa tabella illustra il calcolo; non sono lunghezze di lotti registrate in r1.
Su mobile, scorrete la tabella orizzontalmente.
| Rank | Microbatch | Token validi | Somma delle perdite | Contributo con W / N = 2 / 48 |
|---|---|---|---|---|
| 0 | Primo | 4 | 4 | 4 / 24 ≈ 0,1667 |
| 0 | Secondo | 8 | 8 | 8 / 24 ≈ 0,3333 |
| 1 | Primo | 12 | 36 | 36 / 24 = 1,5 |
| 1 | Secondo | 24 | 72 | 72 / 24 = 3 |
I due contributi del rank 0 totalizzano 0,5; quelli del rank 1 totalizzano 4,5. La loro media è sempre 2,5. La suddivisione in microbatch non ha cambiato la definizione della media.
Dividere ancora ogni contributo per accumulation = 2 darebbe 1,25 dopo l'aggregazione e dividerebbe anche il gradiente per due. Il denominatore globale della finestra aveva già considerato i quattro microbatch.
La regola non è quindi «non dividere mai per il numero di microbatch». È: non aggiungere una divisione già contenuta nella normalizzazione scelta. Una ricetta che parte da medie di microbatch di uguali dimensioni si ragiona diversamente da questa, che parte da somme e da un conteggio globale.
Eseguire l'arresto, il percorso continuo e la ripresa
Possiamo ora avviare i tre passaggi distribuiti: un arresto al passo 50, un addestramento continuo fino a 100, poi una ripresa da 50 a 100.
docker compose run --rm dual torchrun --rdzv-backend=static --master-addr=127.0.0.1 --master-port=29500 --nnodes=1 --nproc-per-node=2 -m ddp_tokens.train --config configs/minimum.yaml
docker compose run --rm dual torchrun --rdzv-backend=static --master-addr=127.0.0.1 --master-port=29500 --nnodes=1 --nproc-per-node=2 -m ddp_tokens.train --config configs/minimum.yaml --continuous
docker compose run --rm dual torchrun --rdzv-backend=static --master-addr=127.0.0.1 --master-port=29500 --nnodes=1 --nproc-per-node=2 -m ddp_tokens.train --config configs/minimum.yaml --resume artifacts/checkpoints/step-0050
Eseguite questi comandi uno dopo l'altro. --nnodes=1 descrive un solo nodo di calcolo e --nproc-per-node=2 avvia due processi. Il rendez-vous statico all'indirizzo 127.0.0.1, porta 29500, serve al loro coordinamento locale. Questa porta non è quella di un'API aziendale. La documentazione di torchrun spiega i ruoli del launcher e dei rank.
Il percorso senza opzione aggiuntiva crea l'arresto previsto a 50. --continuous produce il riferimento a 100 aggiornamenti. --resume artifacts/checkpoints/step-0050 carica lo stato interrotto per proseguire lo stesso percorso fino a 100.
Un checkpoint è più di un file di pesi
Pensate a un'elaborazione dati interrotta: conservare il risultato parziale senza sapere quali elementi sono già stati letti non basta per riprendere nel punto giusto. L'addestramento ha la stessa necessità di continuità.
Il checkpoint comune del progetto contiene il modello, l'ottimizzatore, la configurazione e il lock dei dati. Questo lock identifica i dati attesi; non va confuso con un lock che impedisce a due processi di entrare in una sezione critica.
Ogni rank conserva anche il proprio stato casuale, il rank e la cronologia. Il programma preserva la cronologia del sampler, cioè del meccanismo di selezione delle sequenze. La ripresa deve ritrovare sia i pesi sia la continuazione del percorso dei dati.
Un seme inizializza un generatore pseudo-casuale. Il suo stato corrente indica a che punto è dopo le estrazioni già effettuate. Reimpostare solo il seme iniziale può ricominciare la sequenza di estrazioni anziché proseguirla dal punto dell'arresto. La nota PyTorch sulla riproducibilità aiuta a distinguere il controllo della casualità dalle garanzie fra ambienti.
La ripresa presentata qui avviene a un confine di aggiornamento definito dal protocollo. Non dimostra il recupero da un arresto arbitrario nel mezzo di un backward o di una comunicazione.
Misure da leggere prima dei risultati
Tre domande, tre controlli
La prima domanda è: il gradiente DDP corrisponde al gradiente mono-GPU? Il progetto mette in sequenza i valori dei gradienti per formare un vettore, poi confronta questo vettore con il riferimento ottenuto dallo stesso stato iniziale e dagli stessi token. Il test riguarda 282 628 valori, con le tolleranze atol=1e-6 e rtol=1e-4. Questo numero descrive le componenti confrontate, non la dimensione del corpus.
La seconda domanda è: la ripresa ritrova gli stessi parametri dell'addestramento continuo? Confrontiamo allora i pesi al passo 100, non i gradienti del controllo iniziale. Una formula corretta e una ripresa corretta sono due proprietà distinte.
La terza domanda è: che cosa ottiene il modello addestrato sui dati di test? Il percorso esegue 100 aggiornamenti con SGD, in FP32 e con accumulo di due microbatch per rank. SGD è l'ottimizzatore usato per applicare i gradienti. FP32 indica un calcolo in numeri in virgola mobile a 32 bit. Il test finale riguarda 256 sequenze e 18 231 token validi.
La loss token test è una perdita media per token. Non è una percentuale di successo. L'accuratezza dei token misura la proporzione di token previsti correttamente fra le posizioni valutate; non significa che la stessa proporzione di sequenze intere sia corretta.
Come leggere le tolleranze numeriche?
Una tolleranza assoluta limita i piccoli scarti, soprattutto vicino allo zero. Una tolleranza relativa si adatta alla grandezza del valore di riferimento. La convenzione descritta per torch.allclose è, componente per componente:
abs(gradient_DDP - gradient_reference) <= atol + rtol × abs(gradient_reference).
Con le nostre tolleranze, un riferimento uguale a 0 consente uno scarto fino a 0,000001. Un riferimento uguale a 1 consente 0,000001 + 0,0001 = 0,000101. Sono esempi per leggere le soglie, non componenti pubblicate del gradiente r1.
Perché non richiedere zero ovunque? L'ordine delle operazioni può differire fra calcolo mono-GPU e calcolo distribuito. Le addizioni in precisione finita non sono infatti perfettamente associative. La nota PyTorch sulla precisione numerica ricorda che un'identità matematica non garantisce un'uguaglianza bit per bit fra due percorsi di calcolo.
La verifica corretta applica le tolleranze a tutte le componenti. L'errore assoluto massimo riassume lo scarto più grande, ma non sostituisce da solo questo confronto completo.
Leggere il bilancio del percorso
Calcolate la valutazione:
docker compose run --rm gpu python -m ddp_tokens.cli evaluate --config configs/minimum.yaml
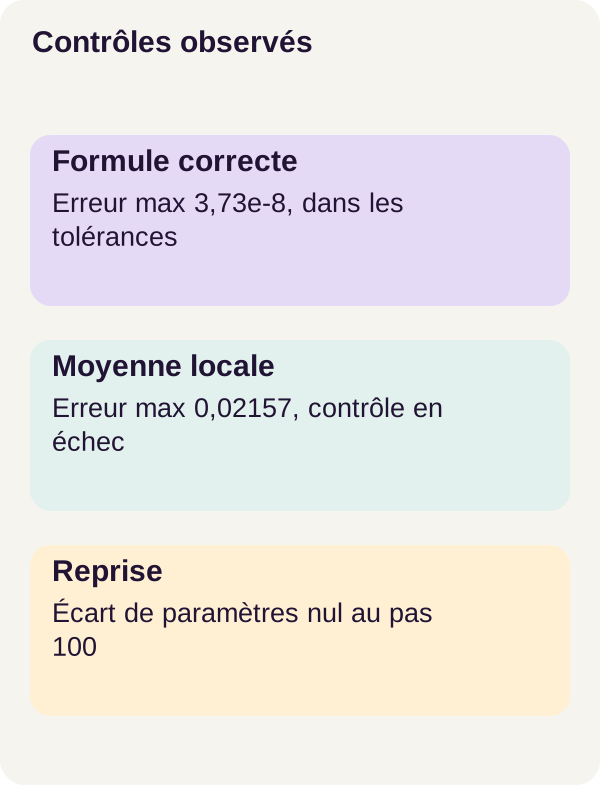
I valori seguenti sono misure locali osservate nel percorso r1. Non predicono la qualità di un'altra architettura, di dati reali, di un altro ottimizzatore o di un addestramento su più nodi.
Su mobile, scorrete la tabella orizzontalmente.
| Controllo osservato | Risultato |
|---|---|
| Errore assoluto max, normalizzazione corretta | 3,73e-8 |
| Normalizzazione corretta entro le tolleranze | Sì |
| Errore assoluto max, media di medie | 0,02157 |
| Normalizzazione errata entro le tolleranze | No |
| Scarto max dei parametri, ripresa vs continuo | 0 |
| Loss token test | 1,31525 |
| Accuratezza token test | 36,22 % |
La normalizzazione corretta ritrova il riferimento entro le tolleranze, con un errore assoluto massimo di 3,73e-8. La media di medie fallisce lo stesso controllo, con un errore massimo di 0,02157. Abbiamo quindi sia un caso accettato sia un errore volontario effettivamente rilevato.
Il test di ripresa risponde a un'altra domanda: lo scarto massimo fra i parametri ripresi e quelli del percorso continuo è 0 al passo 100. La conservazione della cronologia del sampler e dei generatori casuali per rank fa parte di questa ripresa. Lo zero non contraddice il piccolo scarto del gradiente mono/DDP: i due confronti non riguardano né gli stessi oggetti né gli stessi percorsi.
I due rank rifiutano anche una finestra con zero token supervisionati. Questo controllo completa il percorso normale: verifica che l'assenza globale di supervisione non venga trattata come una media valida.
Infine, 1,31525 di loss test e 36,22 % di accuratezza token non costituiscono una dimostrazione di guadagno aziendale. Il risultato centrale del tutorial è la parità del calcolo scelto. Non si tratta né di una classifica di modelli né di una misura di accelerazione su due GPU.
La ripresa esatta stabilisce il meccanismo in questo protocollo. Non prova la robustezza di una ripresa preempted in qualsiasi momento su un'infrastruttura distribuita.
Ciò che abbiamo imparato
Una media inizia con una domanda: quale unità deve contare quanto le altre? Qui la risposta è il token supervisionato. Una media di medie per rank attribuisce un peso diverso a questi token quando i loro numeri differiscono.
DDP sincronizza i gradienti, ma non conosce questa intenzione. Il fattore world_size / global_count prepara i contributi locali affinché la loro media corrisponda al gradiente desiderato. Il numero di GPU non è un coefficiente da aggiungere o togliere per abitudine: bisogna seguire le divisioni realmente eseguite.
L'accumulo non cambia l'obiettivo. Suddivide il calcolo in microbatch, con un denominatore che copre l'intera finestra e pesi invariati fra i passaggi. no_sync() rinvia la sincronizzazione; non sostituisce né il conteggio dei token né il backward.
Infine, un checkpoint deve permettere di riprendere la traiettoria, non solo di ricaricare un modello. Anche i dati successivi, lo stato dell'ottimizzatore e i generatori casuali fanno parte di questa continuità.
Esercizio: ipotesi prima del comando
Il rank 0 conserva 12 token validi. Il rank 1 passa da 12 a 36 token, senza cambiare la distribuzione delle perdite per token che vogliamo confrontare. Prima di eseguire il programma, prevedete come diventano la media di medie e la media globale. Quale attribuisce troppo peso al rank corto?
Per rendere esplicito il calcolo, assumiamo a fini didattici una perdita di 1 per token sul rank 0 e di 3 per token sul rank 1, prima e dopo il cambiamento. Questa ipotesi serve al calcolo manuale; i gradienti dell'esercizio sono quelli forniti dalla sua esecuzione.
Con 12 token su ciascun rank, le somme sono 12 e 36. Le due medie danno 2. Quando il secondo rank passa a 36 token, la sua somma diventa 108: la media di medie resta 2, mentre la media globale passa a 2,5.
La media di medie non vede quindi che il gruppo in cui la perdita è più alta contiene ormai tre volte più token. Il rank corto conserva metà del peso invece di un quarto.
Scrivete anche la vostra previsione sulla normalizzazione: occorre cambiare W, cambiare N oppure dividere una seconda volta per il numero di microbatch? I due rank restano presenti, quindi W resta 2; cambia il numero globale di token.
Eseguite quindi l'esercizio del percorso:
docker compose run --rm gpu python -m ddp_tokens.cli exercise --config configs/exercise.yaml
Confrontate i calcoli e i gradienti forniti con la vostra ipotesi. Non aspettatevi che un errore di loss di 0,5 produca automaticamente uno scarto di gradiente di 0,5: un valore di funzione e la sua derivata sono due oggetti diversi.
Conservate il fallimento della variante errata come controllo di non regressione. L'obiettivo non è far passare tutte le modalità allentando le soglie, ma verificare che una modifica futura del codice non renda invisibile la ponderazione sbagliata.
Adattare il modello e preparare la produzione
Scegliere l'unità prima di copiare la formula
In un altro progetto, l'unità di ponderazione potrebbe essere una sequenza, un esempio, un documento o un costo aziendale. Dare lo stesso peso totale a ogni documento, qualunque sia la sua lunghezza, non è la stessa cosa che dare lo stesso peso a ciascuno dei suoi token. Le due scelte possono rispondere a esigenze diverse; bisogna dichiarare quale viene addestrata.
Il contatore del codice somma qui len(mapping[i]["tokens"]). È coerente con i token supervisionati di questo corpus. Questa scorciatoia non è universale. In un altro addestramento, alcune posizioni di input possono essere escluse dalla perdita: prompt non supervisionato, label ignorate o target spostati. Occorrerà contare le posizioni che contribuiscono realmente all'obiettivo, non solo la lunghezza dell'input.
Come riferimento generale, CrossEntropyLoss documenta le label ignorate e gli effetti della ponderazione sulla riduzione. Ciò non sostituisce la definizione di loss_sum() nella vostra applicazione. Aggiungere pesi di classe o un termine di regolarizzazione richiede anche di ridedurre la normalizzazione di ogni termine, non di applicare meccanicamente lo stesso denominatore a tutta la perdita.
La formula presentata presuppone anche l'aggregazione DDP del percorso di riferimento. Una strategia di comunicazione personalizzata, un numero variabile di partecipanti o rank che non eseguono più lo stesso numero di passaggi richiedono di riesaminare ipotesi e test.
Testare un adattamento senza cambiare il riferimento
Conservate il percorso di riferimento, poi lavorate in una copia per modificare il corpus o il modello. Confrontate sempre gradienti ottenuti con lo stesso stato iniziale e le stesse posizioni supervisionate. Introducete deliberatamente dimensioni disuguali: un test che contiene solo conteggi identici può lasciar passare l'errore studiato qui.
Controllate separatamente una finestra globalmente vuota e i rami in cui un solo rank non ha alcuna supervisione. Non concludete che un ramo sia sicuro perché il calcolo algebrico del percorso normale è corretto: bisogna verificare anche l'ordine di partecipazione alle comunicazioni.
Ciò che la dimostrazione non fornisce
Una messa in produzione distribuita richiede un rendez-vous robusto fra processi, timeout, una politica di ripresa, log e metriche per rank, gestione delle preemption, test multi-nodo e una strategia dati.
Bisogna in particolare poter determinare quale rank è fallito, a quale fase si trovava e quale stato coerente può essere ripristinato. Sono requisiti aggiuntivi, non conseguenze automatiche dello scarto nullo osservato al passo 100. La dimostrazione su un host non pretende di coprirli.
Risoluzione dei problemi e pulizia
Il controllo dual fallisce. Non avviate ancora torchrun. Verificate che due GPU siano esposte al container e che ogni processo selezioni la propria scheda. Correggete l'ambiente prima di modificare la formula di addestramento.
I processi sembrano bloccati. Confrontate i loro ultimi messaggi e l'ordine delle collettive. Un rank non deve saltare da solo all_reduce o un backward a cui l'altro partecipa ancora. Un numero disuguale di token è previsto qui; un numero incompatibile di fasi di comunicazione è un altro problema.
La parità dei gradienti fallisce. Ispezionate prima il conteggio globale dell'intera finestra, poi verificate che loss_sum() fornisca una somma, che no_sync() includa forward e backward e che non venga applicata alcuna divisione aggiuntiva. Confrontate anche lo stato iniziale e i dati usati dai due percorsi.
Il modello viene ricaricato, ma la ripresa differisce. Ricaricare i pesi non dimostra una ripresa completa. Esaminate anche l'ottimizzatore, la configurazione, il lock dei dati, la posizione nel piano e gli stati casuali per rank prima di attribuire lo scarto a DDP.
Dopo le vostre osservazioni, generate la figura, controllate i checkpoint, visualizzate in anteprima la pulizia e fermate i servizi:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
La pulizia resta volutamente in --dry-run: mostra ciò che sarebbe interessato senza eseguire la rimozione. Esaminate questa anteprima prima di qualsiasi decisione di eliminazione. L'ultimo comando arresta i servizi Compose di questo progetto; non è una richiesta di pulizia globale dell'ambiente Docker.
Fonti primarie
I seguenti link permettono di approfondire i meccanismi. Non sostituiscono i file e i parametri dello ZIP per riprodurre r1; i riferimenti alla documentazione non costituiscono un ulteriore elenco delle versioni eseguite.
- PyTorch 2.8 — DistributedDataParallel : repliche, aggregazione dei gradienti e ambito di
no_sync(). - PyTorch — collettive distributed : ruolo delle comunicazioni collettive e di
all_reduce. - NVIDIA Container Toolkit — guida d'installazione : esposizione delle GPU ai container.
Per leggere i calcoli: accumulo con Tensor.backward, tolleranze di torch.allclose, precisione numerica e riduzioni di CrossEntropyLoss.
Per comprendere i processi e il loro stato: launcher torchrun, riproducibilità PyTorch e estrazione senza reinserimento con random.sample.