





Bạn đang phát triển trung tâm trợ giúp cho một ứng dụng web. Người dùng đặt câu hỏi, công cụ trả về danh sách bài… nhưng câu trả lời đúng ở vị trí thứ mười hai. Nó tồn tại, đã được tìm thấy, nhưng vẫn xa những kết quả đầu mà giao diện hiển thị.
Có cần thay toàn bộ công cụ tìm kiếm không? Không nhất thiết. Trước hết phải tách hai vấn đề: tìm các tài liệu hữu ích, rồi đặt chúng theo đúng thứ tự.
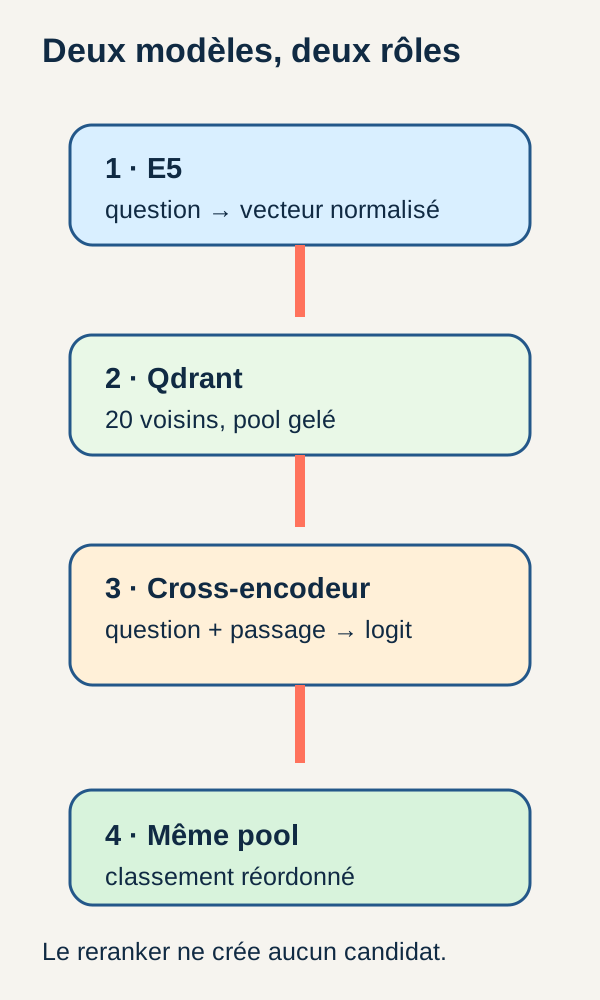
Đó chính là điều chúng ta sẽ thử nghiệm. Mô hình đầu tiên, E5, chuẩn bị một lựa chọn tài liệu. Mô hình thứ hai, gọi là reranker, đọc lại từng ứng viên cùng câu hỏi để đề xuất thứ tự mới. Ta sẽ đo điều nó cải thiện, điều nó không thể sửa và thời gian mà lần đọc thứ hai này thêm vào.
Tình huống trung tâm trợ giúp chỉ là minh họa. Các kết quả trình bày phía sau đến từ corpus hư cấu và lộ trình r3 của hướng dẫn; các ví dụ tính toán nhỏ được ghi riêng.
Bạn có thể tải hướng dẫn thực thi tại đây: Tải xuống dự án hoàn chỉnh của hướng dẫn.
Mục tiêu và kết quả mong đợi
Những gì chúng ta sẽ xây dựng
Corpus, tức tập tài liệu nơi ta tìm kiếm, gồm 200 tài liệu hư cấu. Nó đi kèm 80 câu hỏi: 20 câu phát triển và 60 câu kiểm thử.
Các câu hỏi phát triển giúp làm quen lộ trình và khảo sát hành vi của nó. Câu hỏi kiểm thử phục vụ đánh giá được công bố. Sự tách biệt này không có nghĩa ta sẽ huấn luyện mô hình: ở đây, ta dùng các mô hình đã huấn luyện để tính toán, gọi là suy luận.
Với mỗi câu hỏi, tìm kiếm dense E5 tạo một pool gồm 20 ứng viên. Từ pool không có gì bí ẩn: đó là danh sách 20 tài liệu được giữ cho bước sau. Dense ở đây chỉ tìm kiếm dựa trên các vector số đã học, điều chúng ta sẽ giải thích.
Reranker bge-reranker-v2-m3 sau đó nhận các ứng viên này. Nó không duyệt lại 200 tài liệu: nó chỉ sắp xếp lại 20 tài liệu đã được chọn.
Những gì bạn sẽ biết cách đọc khi kết thúc
Ba tệp làm thí nghiệm có thể quan sát. outputs/candidates.json giữ lựa chọn đầu; outputs/reranked.json chứa thứ tự mới và điểm của các cặp câu hỏi-tài liệu; outputs/evaluation.json tập hợp các phép đo.
Bạn sẽ trả lời được ba câu hỏi cụ thể: tài liệu hữu ích có sẵn trong lựa chọn không? Thứ tự mới có làm chúng dễ thấy hơn trong năm kết quả đầu không? Sự cải thiện này đòi hỏi thêm bao nhiêu thời gian?
Ta xây dựng cơ chế tìm kiếm và xếp hạng, không phải chatbot viết câu trả lời. Nó có thể là một thành phần của ứng dụng khác, nhưng việc tạo văn bản không thuộc thí nghiệm này.
Điều cần có để theo dõi
Bạn cần có thể đọc một hàm Python, thao tác danh sách và từ điển, mở JSON và chạy lệnh trong terminal. Các khái niệm về tìm kiếm và mô hình được giới thiệu dần trong lộ trình.
Việc chạy yêu cầu Linux x86_64, Docker Compose, trình điều khiển NVIDIA và NVIDIA Container Toolkit. Hướng dẫn đã được kiểm tra với RTX 3090. Hãy dự liệu 8 Gio VRAM trống, 12 Gio RAM khả dụng và 25 Gio đĩa cho dự án và Docker. VRAM là bộ nhớ card đồ họa; không được nhầm với RAM máy.
Các tài nguyên này là dự phòng thận trọng, không phải mức tối thiểu được xác lập bằng thí nghiệm. Hướng dẫn không công bố chế độ CPU: ta giữ lộ trình GPU đã xác nhận.
Vì sao hai mô hình?
E5: biểu diễn từng văn bản riêng rẽ
Một embedding là danh sách số được tính từ văn bản. Có thể hình dung như tọa độ của một điểm: các văn bản mà mô hình đã học cách đưa gần nhau có thể ở gần trong không gian này.
Ở đây, mỗi embedding có 384 tọa độ, hay chiều. Đây không phải 384 danh mục do ta tự định nghĩa. Một tọa độ đơn lẻ không có nghĩa « hóa đơn » hay « mật khẩu ».
E5 được dùng làm bi-encoder: nó biến câu hỏi ở một phía và từng tài liệu ở phía khác. Tiền tố query: chỉ câu hỏi; passage: chỉ văn bản cần tìm. Những tiền tố này cho văn bản một vai trò, không dịch nó.
Sự tách biệt này cho phép chuẩn bị vector của 200 tài liệu một lần khi corpus không đổi. Khi có câu hỏi mới, chỉ cần mã hóa câu hỏi đó rồi tìm các láng giềng.
Qdrant không phải mô hình AI. E5 tạo vector; Qdrant lưu chúng trong collection và tìm vector gần vector câu hỏi. So sánh ở đây dùng độ tương đồng cosine, một phép đo độ gần giữa hướng vector.
Kết quả là danh sách đầu có vẻ hợp lý. Nhưng sự gần nhau trong không gian này không bảo đảm một passage trả lời chính xác yêu cầu.
Cross-encoder: đọc câu hỏi và passage cùng nhau
Mô hình thứ hai hoạt động khác. Một cross-encoder nhận một cặp đầy đủ: câu hỏi và văn bản ứng viên. Nhờ vậy nó có thể tính tương tác giữa hai văn bản trong lúc xử lý, thay vì chỉ so sánh hai biểu diễn được tạo riêng.
Hãy lấy ví dụ giả định để hiểu khác biệt, không coi nó là đầu ra corpus:
Question : « Comment récupérer l’accès à mon compte ? »

Paire A : cette question + une fiche sur le changement d’adresse de courriel
Paire B : cette question + une fiche sur la réinitialisation du mot de passe
Cả hai bài đều nói về tài khoản. Tuy nhiên, chúng không mô tả cùng hành động. Vai trò cross-encoder là đưa ra tín hiệu mới để phân xử các ứng viên này; sau đó thứ tự của nó phải được đối chiếu với chú thích, không mặc nhiên xem là đúng.
Việc đọc chung này phải lặp lại cho từng cặp. Với câu hỏi của ta, 20 ứng viên tạo 20 cặp cần đánh giá. Mã xử lý theo batch 4: tức năm batch cho pool đầy đủ, không phải chỉ bốn tài liệu được giữ.
Vì sao không đưa thẳng 200 tài liệu? Điều đó đòi tính 200 cặp cho mỗi câu hỏi thay vì 20. Tầng đầu chính là để giới hạn công việc của tầng sau. Đây là nguyên lý retrieve rồi rerank do Sentence Transformers mô tả.
Một điểm để sắp xếp, không phải xác suất chân lý
Reranker trả về một logit, tức điểm số thô. Trong lộ trình này, điểm cao hơn đứng trước điểm thấp hơn.
Ví dụ, các điểm hư cấu 4,2, 1,4 và -0,6 đủ để sắp ba ứng viên. Chúng không có nghĩa « 420 % », « 140 % » hay « mức liên quan âm ». Con số phục vụ xếp hạng, không trực tiếp biểu thị phần trăm độ tin cậy.
Tài liệu chính thức BGE cho thấy có thể dùng hàm sigmoid để đưa điểm về giữa 0 và 1. Mã của chúng ta không làm vậy. Và đổi thang đo cũng không đủ chứng minh một điểm là xác suất được hiệu chuẩn đúng trên tài liệu nghiệp vụ của bạn.
Vì vậy đừng cộng cosine E5 với logit BGE. Chúng không cùng ý nghĩa hay thang đo. Trong hướng dẫn này, E5 chọn ứng viên; điểm BGE quyết định thứ tự mới.
Giới hạn cần ghi nhớ
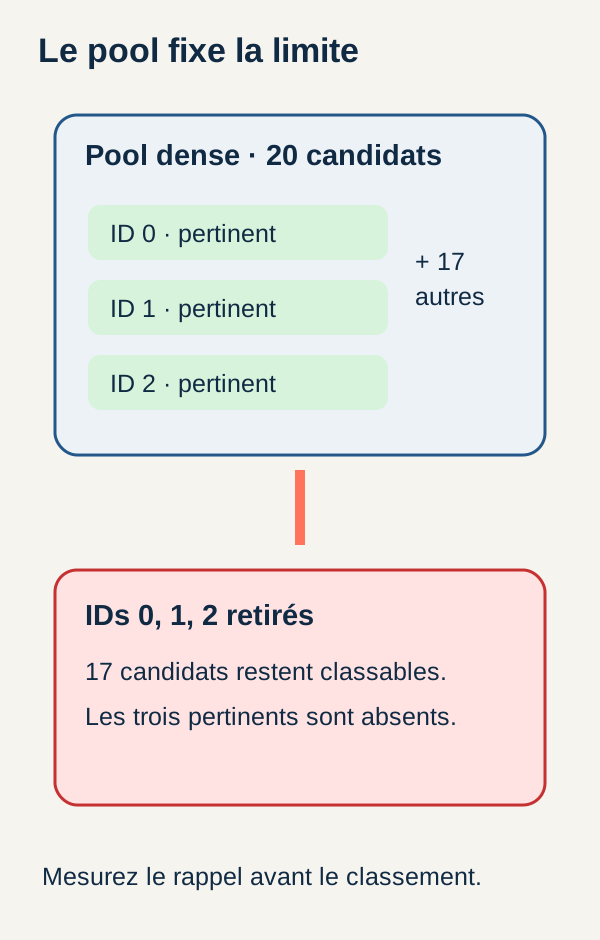
Trở lại bài đúng ở vị trí thứ mười hai. Nếu nó có trong 20 ứng viên, reranker có thể đưa nó lên. Nếu vắng khỏi lựa chọn này, nó không thể tìm lại.
Vì vậy ta lưu danh sách trước reranking: đó là pool được đóng băng. Đóng băng ở đây nghĩa là giữ làm tham chiếu so sánh, không phải làm nó không thể sửa về mặt kỹ thuật. Ta so sánh hai thứ tự của cùng tập, không phải hai lượt tìm kiếm mà kết quả có thể thay đổi giữa chừng.
Kiến trúc lộ trình
Xử lý diễn ra qua các bước riêng biệt, mỗi bước có vai trò có thể kiểm tra:
preparekiểm tra 200 tài liệu và 80 câu hỏi.indexmã hóa tài liệu thành 384 chiều rồi đưa vào collection Qdrant chuyên dụng.retrievemã hóa từng câu hỏi và đóng băng 20 láng giềng trongoutputs/candidates.json.reranktính một logit cho mỗi cặp câu hỏi-tài liệu, theo batch 4, rồi ghioutputs/reranked.json.evaluatetính metric trên câu hỏi kiểm thử có thể đánh giá;exercisechủ động loại tài liệu liên quan củaREF-000để kiểm tra giới hạn reranker.
Với lập trình viên web, JSON trung gian giống phản hồi API được ghi trong lúc kiểm thử: chúng giúp hiểu bước trước đã truyền gì cho bước sau, thay vì chỉ nhìn trang cuối.
Qdrant là tạm thời trong dự án này. Lệnh dọn dẹp docker compose down xóa index. Mô hình đã lấy và đầu ra vẫn còn: bạn có thể đọc JSON mà không giữ Qdrant hoạt động, hoặc xây lại index để chạy lại các bước sau.
Sự khác biệt về tính bền vững này là lựa chọn của hướng dẫn, không phải thuộc tính chung cho mọi triển khai Qdrant hoặc Docker.
Đọc mã trung tâm trước khi xem kết quả
Các đoạn sau trình bày phần lõi cơ chế. Chúng dùng các đối tượng được khởi tạo ở nơi khác, như self.model, self.tokenizer hoặc store. Tự chúng không phải script độc lập: để chạy toàn bộ lộ trình, hãy dùng các tệp trong ZIP.
1. Biến văn bản thành vector E5
Trước khi đọc hàm, hãy làm rõ ba từ sắp gặp.
Tokenizer tách văn bản thành các đơn vị mô hình nhận ra, gọi là token, rồi thay bằng định danh số. Token có thể là từ, phần từ hoặc dấu: 512 token không có nghĩa 512 ký tự, cũng không nhất thiết 512 từ.
Để tính nhiều văn bản cùng lúc, chúng được gom vào một batch. Vì độ dài khác nhau, văn bản ngắn được thêm padding. Attention mask chỉ vị trí thuộc văn bản và vị trí thuộc phần điền.
Cuối cùng, pooling gom biểu diễn của các vị trí thành một vector cho mỗi văn bản. Ở đây là trung bình bỏ qua padding. Đừng nhầm hai từ gần nhau: pooling tạo vector; pool ứng viên là danh sách tài liệu.
def encode(self, texts, kind):
    if kind not in ("query", "passage") or not texts:
        raise ValueError("Préfixe query/passage et liste non vide requis")

    vectors = []

    for offset in range(0, len(texts), 16):
        batch = self.tokenizer(
            [kind + ": " + text for text in texts[offset:offset + 16]],
            padding=True,
            truncation=False,
            return_tensors="pt",
        )

        if batch["input_ids"].shape[1] > 512:
            raise ValueError("Texte dépassant 512 tokens : découpez le document")

        batch = batch.to("cuda")

        with torch.inference_mode():
            hidden = self.model(**batch).last_hidden_state
            mask = batch["attention_mask"].unsqueeze(-1).bool()
            pooled = hidden.masked_fill(~mask, 0).sum(1) / mask.sum(1)
            normalized = torch.nn.functional.normalize(pooled, p=2, dim=1)

        if not torch.isfinite(normalized).all():
            raise ValueError("Embedding non fini")

        vectors.extend(normalized.cpu().tolist())

    return vectors
Điều gì xảy ra trong hàm này?
kind phải là query hoặc passage, và danh sách văn bản không được trống. Vòng lặp lấy tối đa 16 văn bản một lần, thêm tiền tố phù hợp rồi token hóa.
padding=True căn chỉnh độ dài batch. Ngược lại, truncation=False cấm rút ngắn đầu vào âm thầm. Độ rộng batch["input_ids"].shape[1] là chuỗi dài nhất sau token hóa và điền. Nếu vượt 512 token, hàm dừng trước tính toán mô hình. Tiền tố và token đặc biệt cũng thuộc đầu vào này.
batch.to("cuda") chuyển dữ liệu sang GPU. Mô hình tạo last_hidden_state, biểu diễn số cho từng vị trí. torch.inference_mode() tránh chuẩn bị gradient phục vụ huấn luyện; nó không tự thay thế chế độ đánh giá trong lúc khởi tạo.
Ba dòng quanh mask, pooled và normalized là lõi chuyển đổi: chúng triệt padding, cộng các biểu diễn hữu ích, chia cho số lượng rồi chuẩn hóa vector.
Để hiểu trung bình, hãy tưởng tượng hai tọa độ và hai vị trí hữu ích: [2, 4] và [4, 4]. Trung bình là [3, 4]. Padding không được thêm giá trị hay làm số chia từ 2 thành 3. Đây là tính toán minh họa, không phải biểu diễn E5 thực.
Chuẩn hóa L2 đưa độ dài vector về 1. Với [3, 4], độ dài là √(3² + 4²) = 5, nên vector thành [0,6 ; 0,8]. Ta so sánh hướng thay vì độ dài tùy ý. Nguyên lý này áp dụng cho 384 tọa độ.
Cuối cùng, torch.isfinite từ chối giá trị vô hạn hoặc NaN, vốn báo kết quả số không xác định. .cpu().tolist() đưa vector về bộ nhớ CPU dưới dạng danh sách Python để chương trình dùng tiếp.
Tài liệu E5 đa ngôn ngữ minh họa tiền tố, trung bình có mask và chuẩn hóa. Nó bổ sung khái niệm: để tái lập thí nghiệm, hãy giữ các tệp và thiết lập khóa trong ZIP, nhất là việc từ chối rõ ràng đầu vào quá dài.
2. Lưu ứng viên trước khi xếp lại
Lúc này vector tài liệu đã được lập chỉ mục. Với mỗi câu hỏi, ta tính vector và yêu cầu Qdrant trả 20 láng giềng.
store.search(encoder.encode([data["queries"][0]["query"]], "query")[0], 20)

rows = []

for query in data["queries"]:
    start = time.perf_counter()
    candidates = store.search(encoder.encode([query["query"]], "query")[0], 20)
    rows.append(
        {
            **query,
            "candidates": candidates,
            "seconds": {"dense": time.perf_counter() - start},
        }
    )

save("candidates", {"rows": rows})
Dòng đầu chạy tìm kiếm warm-up trước vòng lặp tính giờ. Kết quả không được thêm vào rows: câu hỏi đầu vẫn được xử lý lại trong phép đo thường.
Trong vòng lặp, đồng hồ chạy trước khi mã hóa câu hỏi. Vì vậy seconds.dense gồm mã hóa và gọi tìm kiếm Qdrant, không chỉ thời gian so vector trong cơ sở dữ liệu.
Biểu thức {**query, ...} giữ thông tin câu hỏi rồi thêm ứng viên và thời lượng. Cuối cùng save ghi tệp tham chiếu.
Đây là hợp đồng giữa hai mô hình: reranker đọc danh sách đã lưu này. Chạy lại tìm kiếm với pool khác giữa lúc so sánh sẽ không thể cô lập hiệu ứng xếp lại.
3. Tính điểm cho từng cặp
Reranker không nhận embedding E5 để cải thiện. Nó lấy lại văn bản của từng ứng viên và ghép với câu hỏi. Định danh dùng để tìm tài liệu và theo dõi vị trí mới.
def score(self, query, candidates, documents):
    if not candidates:
        return {"ranked": [], "pairs": [], "truncated": False}

    if not isinstance(query, str) or not query.strip():
        raise ValueError("Question non vide requise")

    rank_scores(candidates, [0.] * len(candidates))
    pairs = [[query, documents[identifier]["text"]] for identifier, _ in candidates]
    scores = []
    truncated = False

    for offset in range(0, len(pairs), 4):
        part = pairs[offset:offset + 4]
        lengths = [len(self.tokenizer(a, b)["input_ids"]) for a, b in part]
        truncated |= any(length > 512 for length in lengths)

        batch = self.tokenizer(
            part,
            padding=True,
            truncation=True,
            max_length=512,
            return_tensors="pt",
        ).to("cuda")

        with torch.inference_mode():
            scores.extend(self.model(**batch).logits.view(-1).float().cpu().tolist())

    return {
        "ranked": rank_scores(candidates, scores),
        "truncated": truncated,
        "pairs": [
            {
                "query": query,
                "document_id": identifier,
                "text": documents[identifier]["text"],
                "score": score,
            }
            for (identifier, _), score in zip(candidates, scores)
        ],
    }
Hành vi đầu tiên là trả về rõ ràng khi pool rỗng. Hàm trả danh sách xếp hạng rỗng, không cặp nào và truncated: False. Điều này diễn ra trước kiểm tra câu hỏi: với pool rỗng, đoạn mã không yêu cầu câu hỏi không rỗng. Với pool không rỗng, câu hỏi không hợp lệ gây lỗi.
rank_scores(candidates, [0.] * len(candidates)) xác thực ứng viên lần đầu, nhất là định danh. Các số 0 là tạm thời: không phải cosine E5 hay dự đoán BGE. Hàm phụ đầy đủ nằm trong ZIP; nó còn sắp xếp cuối và từ chối kết quả scoring không hữu hạn.
List comprehension pairs tạo một cặp cho mỗi ứng viên. Vòng lặp xử lý batch 4. Một lần token hóa đầu kiểm tra độ dài; lần thứ hai chuẩn bị batch gửi CUDA, giới hạn 512 token.
Mô hình tạo logits. view(-1) đưa chúng thành danh sách điểm, .float() đổi sang số thực, rồi .cpu().tolist() cho Python dùng. Sắp xếp cuối giảm dần theo điểm, dùng định danh làm phân giải ổn định khi hòa.
Kết quả trả hai góc nhìn: ranked, danh sách đã sắp lại, và pairs, chi tiết ghép câu hỏi-tài liệu cùng văn bản và điểm. Ở đoạn này, pairs theo thứ tự ứng viên đầu vào; phải đọc ranked để biết thứ tự mới.
Hai chính sách khác nhau với văn bản quá dài
Chi tiết này đáng dừng lại vì hai bước không phản ứng giống nhau.
E5 từ chối đầu vào quá 512 token. Chương trình yêu cầu bạn tách tài liệu rõ ràng, thay vì âm thầm đổi chất liệu tìm kiếm.
Reranker chấp nhận cắt một cặp quá dài, nhưng báo truncated: True. Giới hạn áp dụng cho đầu vào ghép: câu hỏi, passage và token đặc biệt. Hai văn bản E5 chấp nhận riêng có thể thành cặp quá dài cho mô hình thứ hai; tokenizer cũng có thể tách cùng từ theo cách khác.
Theo tài liệu Transformers về truncation, truncation=True dùng longest_first: token bị bỏ từ chuỗi dài nhất cho đến khi đạt giới hạn. Vì vậy không bảo đảm chỉ passage bị rút ngắn. Ở đây 512 là giới hạn do mã hướng dẫn chọn, không phải khẳng định về mọi khả năng BGE.
Boolean truncated tích lũy quan sát qua batch: nó đúng ngay khi ít nhất một cặp vượt giới hạn. Nó không cho biết số cặp bị ảnh hưởng hay chính xác vị trí bị bỏ.
Một sắc thái nữa: trường text giữ tài liệu gốc, không tái dựng văn bản sau khi cắt. Đầu ra cho phép tìm cặp nguồn và điểm của nó; chúng không chứng minh mô hình đã đọc mọi từ của văn bản giữ lại. Khi có truncation, cần xem tokenization thực tế trước khi giải thích kết quả bằng câu cuối tài liệu.
Chuẩn bị và chạy hướng dẫn
Đứng đúng chỗ
Tải ZIP, giải nén, rồi mở terminal ở thư mục gốc dự án đã giải nén. Mọi lệnh bên dưới chạy từ thư mục này. Cần có mã hoàn chỉnh, không chỉ đoạn trích bài viết, để thực hiện chúng.
GPU_DEVICE=1 chọn card thứ hai; index 0 được dùng mặc định. Hãy kiểm tra GPU trong cấu hình dự án trước khi tính.
Preflight là kiểm tra môi trường trước. Nó thực sự khởi tạo CUDA trong container và kiểm tra Docker dùng được card. nvidia-smi đúng trên máy chủ chưa đủ: card có thể thấy ở Linux nhưng không ở container.
NVIDIA Container Toolkit đảm bảo GPU được đưa vào container; hướng dẫn chính thức bổ sung điều kiện tiên quyết. Preflight dự án không cài đặt hay sửa cấu hình hệ thống.
Xây môi trường và lấy mô hình
Chạy năm lệnh này theo thứ tự. Tất cả phải kết thúc không lỗi trước bước sau.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
setup.sh chuẩn bị môi trường cục bộ; build xây image. Dịch vụ fetch, bật bởi profile acquisition, lấy mô hình một cách rõ ràng. Nó kiểm tra kích thước và SHA-256 trước khi đổi tên nguyên tử.
SHA-256 là dấu vân tay tính từ byte của tệp. So với giá trị mong đợi giúp kiểm tra mô hình nhận được đúng tài sản dự kiến. Đổi tên nguyên tử chỉ đặt tên cuối sau xác nhận, thay vì trình bày tải dang dở như mô hình hoàn chỉnh. Đây là kiểm tra toàn vẹn tệp, không phải đo chất lượng mô hình.
Lệnh cuối chạy bộ kiểm thử công khai của dự án. Kết quả mong đợi lộ trình đã xác nhận là 17 kiểm thử công khai thành công. Cần hiểu lỗi trước khi tiếp tục: kết quả tìm kiếm có vẻ đáng tin không bù được kiểm tra lỗi.
Xây index, truy xuất, xếp lại, đánh giá
Sau đó khởi động Qdrant và chạy các bước sau:
docker compose up -d qdrant
docker compose run --rm --no-deps app -m src.cli prepare
docker compose run --rm --no-deps app -m src.cli index
docker compose run --rm --no-deps app -m src.cli retrieve
docker compose run --rm --no-deps app -m src.cli rerank
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
Sau prepare, kiểm tra quần thể: 200 tài liệu, 80 câu hỏi, trong đó 20 phát triển và 60 kiểm thử.
Sau index, đầu ra phải có documents: 200, dimension: 384, device: "cuda" và points_count: 200. Cần có số point bằng số tài liệu với chiều mong đợi.
Sau retrieve, mở outputs/candidates.json. Với một câu hỏi, xác định 20 ứng viên và thứ tự đầu của chúng. Đây là điểm so sánh.
Sau rerank, mở outputs/reranked.json. Tìm lại cùng câu hỏi, so định danh ranked với pool, rồi đọc cặp, logits và cờ truncation. Tài liệu không được đổi chỉ vì thứ tự đổi.
Sau negatives, kiểm tra pool rỗng, truncation được báo và collection rỗng phải được xác nhận. Kiểm thử âm xác minh một giới hạn hoặc trường hợp đặc biệt được chủ ý gây ra, không chỉ đường đi mọi thứ đều tốt.
Sau evaluate, outputs/evaluation.json có metric tham chiếu. Bây giờ ta xem cách diễn giải chúng.
Việc lấy và suy luận tách biệt. Khi mô hình đã có, suy luận vẫn cục bộ và không dùng mạng ngoài. Điều này không ngăn ứng dụng giao tiếp Qdrant bên trong dự án Docker.
Xác định phép đo trước khi xem
Tài liệu « liên quan » là gì?
Để đánh giá tìm kiếm, cần biết nó lẽ ra phải tìm gì. Chú thích mức liên quan cho tham chiếu này: với mỗi câu hỏi, chúng chỉ tài liệu được xem là hữu ích trong thí nghiệm.
Điểm mô hình không tạo ra chân lý tham chiếu. Nếu không, ta yêu cầu công cụ tự chấm. Chú thích ở đây thuộc corpus sư phạm hư cấu; chúng không thay thế xác nhận nghiệp vụ độc lập trên tài liệu thật.
Vì sao 80, 60 và 48 không chỉ cùng một thứ
80 câu hỏi gồm 20 phát triển và 60 kiểm thử. Trong 60 câu kiểm thử, 48 có ít nhất một tài liệu liên quan trong chú thích; 12 còn lại ngoài corpus.
Metric liên quan áp dụng cho 48 câu có thể đánh giá. Độ trễ công bố áp dụng cho 60 câu kiểm thử, kể cả 12 câu ngoài corpus.
Vì sao tách chúng? Với câu không có tài liệu liên quan, recall có mẫu số bằng không và thứ tự lý tưởng nDCG không có gain. Gán tùy ý 0 sẽ trộn việc xếp sai đáp án có sẵn với việc tìm trong corpus không có đáp án mong đợi.
12 câu này vẫn không biến mất khỏi quan sát: chúng nhận ứng viên. Có danh sách, dù đã xếp, không chứng minh một bài trả lời được câu hỏi. Lộ trình không chứng minh khả năng tự quyết « không có câu trả lời ».
Trên màn hình nhỏ, hãy cuộn bảng theo chiều ngang.
| Chỉ số | Điều nó quan sát |
|---|---|
| Recall@20 | Tỷ phần tài liệu liên quan trong pool dense 20. Nó giới hạn điều reranker có thể làm. |
| MRR@5 | Hạng tài liệu liên quan đầu trong năm vị trí đầu. |
| nDCG@5 | Vị trí mọi tài liệu liên quan trong năm vị trí đầu, giảm theo hạng. |
| Độ trễ dense | Mã hóa câu hỏi và tìm kiếm Qdrant. |
| Độ trễ reranker | Chi phí bổ sung scoring 20 cặp, không gồm nạp mô hình. |
Recall@20: tài liệu hữu ích có sẵn không?
Recall đo độ bao phủ. Với câu hỏi có ít nhất một tài liệu liên quan:
Rappel@20 = nombre de documents pertinents dans les 20 candidats / nombre total de documents pertinents attendus.
Với ba tài liệu liên quan, tìm được hai cho 2 / 3 ≈ 0,667. Tìm hết cho 1, dù chúng ở hạng 12, 16, 20. Recall@20 không nói các dòng đầu giao diện tốt không; nó cho biết reranker có gì để dùng.
Nếu reranker chỉ hoán vị 20 ứng viên ấy, recall không đổi. Nó có thể cải thiện hiện diện trong top 5, nhưng không thêm tài liệu vào pool 20.
MRR@5: câu trả lời hữu ích đầu xuất hiện ở đâu?
Với một câu hỏi, ta tìm hạng tài liệu liên quan đầu trong năm vị trí đầu. Hạng nghịch đảo, ký hiệu RR@5, là nghịch đảo vị trí: hạng 1 → 1; hạng 2 → 1 / 2 = 0,5; hạng 5 → 1 / 5 = 0,2.
Nếu không có tài liệu liên quan trong năm đầu, RR@5 bằng 0, ngay cả khi tài liệu hữu ích đến hạng 6.
MRR, hay Mean Reciprocal Rank, là trung bình các giá trị này trên câu hỏi có thể đánh giá. Nó không phải nghịch đảo của hạng trung bình. Ví dụ hai câu có tài liệu đầu ở hạng 1 và 5 cho (1 + 0,2) / 2 = 0,6, không phải 1 / 3.
Chỉ số này trả lời « gặp câu trả lời hữu ích đầu tiên nhanh đến đâu? ». Nó không mô tả vị trí các tài liệu liên quan khác.
nDCG@5: nhiều câu trả lời hữu ích có được đặt tốt?
Tên gọi ấn tượng hơn ý tưởng. nDCG là normalized Discounted Cumulative Gain: cộng gain liên quan, giảm trọng số vị trí xa, rồi so với thứ tự tốt nhất có thể.
Với chú thích nhị phân, tài liệu liên quan ở hạng r đóng góp 1 / log2(r + 1); tài liệu không liên quan đóng góp 0. log2 là logarit cơ số 2. Chỉ giữ năm vị trí đầu.
Với một tài liệu liên quan ở hạng 2, đóng góp là 1 / log2(3) ≈ 0,631. Thứ tự lý tưởng đặt nó hạng 1, gain 1: nDCG@5 cũng khoảng 0,631.
Với nhiều tài liệu liên quan, không chỉ cộng đóng góp mà còn chia cho gain của thứ tự lý tưởng. Chuẩn hóa này giúp đọc 1 là kết quả tốt nhất theo chú thích và cutoff.
Ví dụ có thể tính tay
Bảng sau là ví dụ sư phạm, không phải đầu ra tái lập r3. Hãy tưởng tượng một câu hỏi có ba tài liệu liên quan, đều trong pool 20. Ta chỉ đổi vị trí.
Trên màn hình nhỏ, hãy cuộn bảng theo chiều ngang.
| Vị trí ba tài liệu liên quan | Recall@20 | RR@5 cho câu hỏi | nDCG@5 |
|---|---|---|---|
| Hạng 2, 4 và 8 | 1,0000 | 0,5000 | ≈ 0,4982 |
| Hạng 1, 8 và 9 | 1,0000 | 1,0000 | ≈ 0,4693 |
| Hạng 1, 2 và 3 | 1,0000 | 1,0000 | 1,0000 |
Với dòng đầu, chỉ hạng 2 và 4 đóng góp gain top-5:
DCG@5 = 1 / log2(3) + 1 / log2(5) ≈ 1,0616.
Với ba tài liệu liên quan, thứ tự lý tưởng đặt chúng ở hạng 1, 2, 3:
IDCG@5 = 1 + 1 / log2(3) + 1 / log2(4) ≈ 2,1309.
Kết quả chuẩn hóa là 1,0616 / 2,1309 ≈ 0,4982.
So sánh hai dòng đầu. Hạng nghịch đảo tốt hơn vì câu trả lời hữu ích lên đầu, nhưng nDCG giảm vì chỉ một câu trả lời hữu ích còn trong năm đầu. Hai metric có thể thay đổi ngược chiều mà tính toán vẫn nhất quán. Chúng quan sát khía cạnh khác nhau.
Recall pool vẫn bằng 1 trong ba trường hợp. Nó cố định tập tài liệu sẵn có; tự nó không tóm tắt chất lượng thứ tự.
Độ trễ: đồng hồ đo thời gian nào?
Độ trễ là thời gian trôi qua để thực hiện thao tác. Ở đây độ trễ dense gồm mã hóa câu hỏi và tìm Qdrant. Độ trễ reranker là chi phí bổ sung để xử lý 20 cặp; không gồm nạp mô hình.
Phép đo r3 thực hiện sau warm-up. Chúng không mô tả lần khởi động hoàn chỉnh đầu, tải mô hình, hay tổng chờ của trang web tương lai có mạng, xác thực và hiển thị.
Kết quả R3 đã quan sát
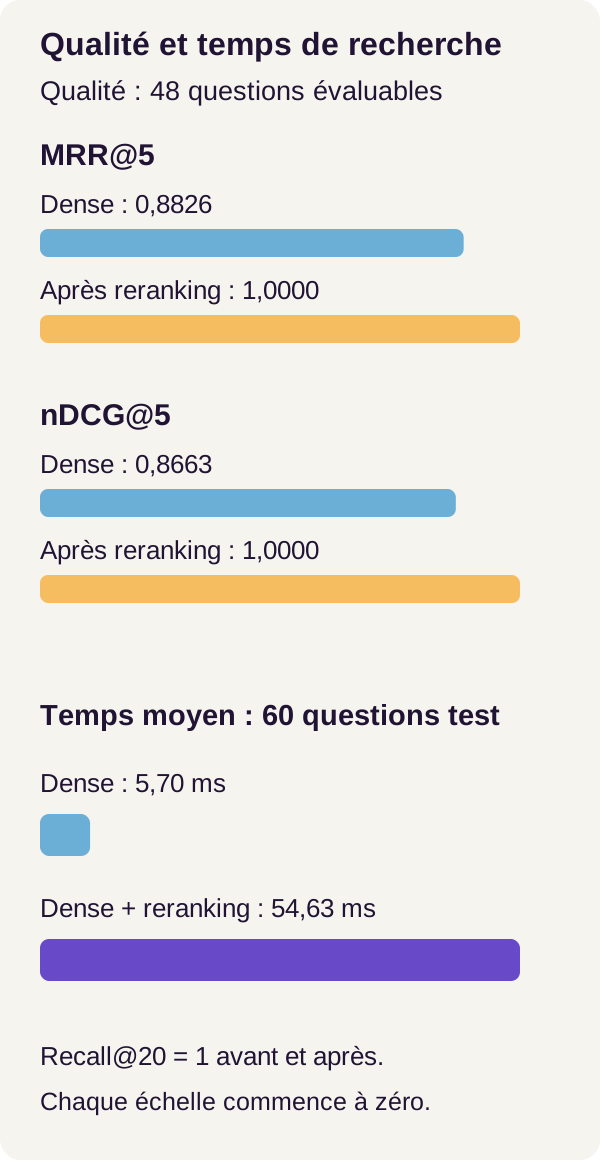
Hai lần tái lập r3 cho cùng metric chất lượng. Độ trễ dưới đây thuộc lần tái lập thứ hai, trung bình trên 60 câu test, sau warm-up và không tính nạp mô hình.
Chất lượng xếp hạng
Trên màn hình nhỏ, hãy cuộn bảng theo chiều ngang.
| Nhánh | MRR@5 | nDCG@5 | Recall@20 | Quần thể |
|---|---|---|---|---|
| Ứng viên dense | 0,8826 | 0,8663 | 1,0000 | 48 có thể đánh giá |
| Sau reranking | 1,0000 | 1,0000 | 1,0000 | 48 có thể đánh giá |
Số đầu cần đọc là recall@20: 1,0000 ở cả hai dòng. Mọi tài liệu liên quan của 48 câu có thể đánh giá đã có trong pool dense. Vì vậy reranker không tăng coverage: coverage đã đầy đủ ở độ sâu này.
Cải thiện nằm ở vị trí. MRR@5 tăng từ 0,8826 lên 1,0000, nDCG@5 từ 0,8663 lên 1,0000. Kết quả báo cáo là tối ưu cho metric trên bộ này; không chứng minh mô hình hoàn hảo với câu hỏi khác.
Đừng đọc MRR@5 = 0,8826 là « 88,26 % tài liệu đúng ». Đây là trung bình hạng nghịch đảo. nDCG cũng đo thứ tự, không phải xác suất chân lý.
Thời gian bổ sung
Trên màn hình nhỏ, hãy cuộn bảng theo chiều ngang.
| Thời gian trung bình | Mili giây |
|---|---|
| Dense | 5,70 ms |
| Reranking bổ sung | 48,92 ms |
| Tổng | 54,63 ms |
Re-ranking ở đây thêm trung bình 48,92 ms cho tìm kiếm dense 5,70 ms. Tổng báo cáo là 54,63 ms, khoảng 54,63 / 5,70 ≈ 9,6 lần thời gian dense đơn lẻ.
Thời lượng công bố giữ hai chữ số thập phân. Tổng hiển thị là 54,62 ms, khác 54,63 ms tổng báo cáo; chênh 0,01 ms phù hợp làm tròn độc lập. Cần giá trị chưa làm tròn để xác nhận nguyên nhân: đừng xem đó là chi phí bổ sung đo riêng.
Suy luận đúng không phải « 49 ms chắc chắn không đáng kể », cũng không phải « gần mười lần chậm hơn chắc chắn không dùng được ». Câu hỏi là: đổi thứ tự có đáng thời gian thêm này trong ứng dụng đích không?
Các kết quả mô tả corpus hư cấu, máy và cấu hình nhất định. Chúng không hứa hẹn lợi ích nghiệp vụ, không phải kiểm thử tải hay ước lượng hiệu năng dịch vụ tương lai.
Những điều đã học
Truy xuất và xếp lại là hai thao tác khác nhau
E5 và Qdrant tạo danh sách ứng viên. Cross-encoder so sánh tốn kém hơn giữa câu hỏi và từng ứng viên. Nó có thể đổi thứ tự, nhưng không tìm tài liệu nằm ngoài pool.
Trước khi trách reranker vì câu trả lời kém, hãy nhìn danh sách đầu vào. Bài vắng mặt và bài xếp sai cần chẩn đoán khác nhau.
Điểm mô hình và metric đánh giá không giống nhau
Cosine E5 và logit BGE tạo bảng xếp hạng. Recall, MRR và nDCG so bảng đó với chú thích đã biết. Logit cao không thay đánh giá, MRR tốt không có nghĩa mọi kết quả hữu ích.
Kết quả đầu không phải bằng chứng có đáp án
Câu hỏi ngoài corpus cũng nhận ứng viên. Phần tử tốt nhất có thể chỉ ít xa nhất với yêu cầu không tài liệu nào trả lời. Biết từ chối tìm kiếm không đáp án là bài toán khác mà điểm hoàn hảo trên 48 câu không giải quyết.
Chất lượng ở đây có chi phí đã đo
Trong thí nghiệm này top-5 tốt hơn và tổng thời gian tăng. Kích thước pool, mô hình, độ dài văn bản, phần cứng đều thuộc đánh đổi cần nghiên cứu. Không điều gì cho phép chuyển thẳng 54,63 ms sang bối cảnh khác.
Bài tập: dự đoán, sửa, chạy, quan sát, giải thích
Dự đoán trước khi chạy
Với REF-000, tài liệu liên quan có định danh 0, 1, 2. Chúng có trong pool tham chiếu.
Ta sẽ loại chúng trước reranking. Hãy dự đoán: còn tài liệu liên quan để xếp không? Mô hình có thể đưa lên đầu một định danh không còn được truyền không? Recall của pool sửa đổi là gì?
Sửa và chạy
Không sửa mã cho bài tập này. Lệnh có sẵn thực hiện đúng thay đổi trên pool đóng băng của câu hỏi đầu:
docker compose run --rm --no-deps app -m src.cli exercise
Quan sát đầu ra
Trong outputs/exercise.json, kiểm tra removed_relevant: [0, 1, 2]. Pool phải giữ 17 ứng viên, và không định danh nào trong ba cái bị xóa được xuất hiện lại trong ranked.
Đừng nhầm 17 ứng viên với 17 kiểm thử công khai: số đầu từ 20 - 3, số sau chỉ bộ kiểm thử dự án.
Giải thích điều đã xảy ra
Cross-encoder có thể ưu tiên tài liệu 3 trong ứng viên còn lại, nhưng không thể xếp tài liệu vắng. Với câu này, không tài liệu nào trong ba tài liệu liên quan còn trong pool sửa đổi: recall bằng không, bất kể sắp xếp 17 tài liệu khác tốt đến đâu.
Điều này không biến REF-000 thành câu ngoài corpus: đáp án vẫn tồn tại trong corpus và chú thích. Ta đã gây lỗi truy xuất, không xóa sự tồn tại của đáp án mong đợi.
Tăng pool hoặc cải thiện truy xuất là các hướng thử riêng. Chúng cần đo mới coverage, xếp hạng top-5 và độ trễ; không phải cải thiện đã được bài tập này chứng minh.
Thí nghiệm của bạn, khác bài tập
Bài tập trước kiểm tra một giới hạn cụ thể. Để khảo sát đánh đổi chất lượng-độ trễ, trước hết giữ đầu ra tham chiếu, rồi làm trong bản sao dự án. Kết quả biến thể này không thuộc tái lập r3 trình bày ở đây.
Một biến đáng quan tâm là số láng giềng yêu cầu từ Qdrant. Ví dụ, so pool nhỏ hơn với pool tham chiếu 20, không đổi đồng thời tài liệu, câu hỏi và reranker. Mã hiển thị dùng 20 trong warm-up và vòng đo: hãy giữ biến thể nhất quán, gồm kiểm tra có thể có của chương trình hoàn chỉnh.
Trước khi chạy, viết hai giả thuyết: điều bạn mong về sự hiện diện của pertinent, và điều bạn mong về thời gian. Pool nhỏ loại cặp phải đánh giá nhưng cũng có thể loại tài liệu hữu ích. Pool lớn cho nhiều ứng viên hơn; không bảo đảm thứ tự cuối tốt hơn.
Chạy lại retrieve, rerank, evaluate bằng lệnh đã trình bày. Nếu sửa chạm tệp được chép vào image Docker, hãy build lại theo mount dự án: sửa trên máy chủ không bảo đảm container chạy phiên bản mới.
So sánh số ứng viên, recall pool, MRR@5, nDCG@5, thời gian dense, reranker, tổng. Ghi cả khả năng có truncation. Nếu đổi độ sâu truy xuất, hãy nêu độ sâu trong báo cáo: recall đo với pool 10 không thể chỉ đổi tên thành recall@20 tham chiếu.
Đừng thay kết quả cũ bằng mới mà không giữ cấu hình. So sánh phải làm rõ điều thay đổi. Hãy dùng câu phát triển để khảo sát thiết lập, thay vì chọn cấu hình chỉ vì tối đa hóa tập kiểm thử.
Giới hạn khi đưa vào production
Dữ liệu được kiểm soát, không phải xác thực nghiệp vụ
Corpus và câu hỏi là hư cấu. 48 câu có thể đánh giá và chú thích không thay truy vấn đại diện người dùng hay phân tích lỗi trên tài liệu thật. Kết quả hoàn hảo trong bộ này không xác thực tìm kiếm tổng quát.
Đặc biệt cần xử lý riêng yêu cầu không có đáp án trong corpus. Ngưỡng điểm BGE sẽ là quy tắc mới cần đánh giá, không phải khả năng từ chối đã được lộ trình xác nhận.
Tài nguyên quan sát với giới hạn
Hướng dẫn được thử trên RTX 3090. Nó không công bố chế độ CPU hay công cụ production. Dự phòng phần cứng vẫn thận trọng, không có nghiên cứu mức tối thiểu.
VRAM được lấy mẫu khoảng một lần mỗi giây: đỉnh ngắn có thể lọt giữa hai lần đọc. Docker cache có sẵn, biến động đĩa không chỉ do hướng dẫn. Trung bình độ trễ máy này không tự nói được độ trễ khi đồng thời hay truy vấn chậm nhất.
Kiến trúc cần bổ sung theo ứng dụng
Chọn pool và ngân sách độ trễ từ truy vấn đại diện. Theo dõi cặp dài và truncation, giữ phiên bản corpus, mô hình, metric, rồi đo truy xuất trước khi quy thay đổi cho reranker.
Trong ứng dụng tài liệu có quyền truy cập, phạm vi cho phép phải được tôn trọng trước khi gửi văn bản sang reranking. Bộ lọc Qdrant là thành phần kỹ thuật giới hạn ứng viên; chỉ có chúng chưa phải chính sách phân quyền đầy đủ.
Bảo mật container, acquisition khóa và giới hạn triển khai được ghi trong archive. Hãy đọc trước khi điều chỉnh; chúng không biến hướng dẫn thành dịch vụ sẵn sàng production.
Khắc phục sự cố và dọn dẹp
Preflight thất bại trên CUDA. Kiểm tra driver NVIDIA, NVIDIA Container Toolkit và card GPU_DEVICE, rồi chạy lại preflight. Nó không cài gì. Card được phát hiện trên máy chủ chưa đủ nếu không được đưa vào container.
Qdrant không sẵn sàng. Chạy lại docker compose up -d qdrant trước index. Nếu lỗi còn, xem Docker logs của dự án này thay vì tiếp tục tìm kiếm chưa hoàn chỉnh.
E5 từ chối tài liệu quá 512 token. Đây là hành vi dự kiến: hãy tách tài liệu rõ ràng. Nếu việc tách đổi đơn vị index, định danh hay chú thích, đó là thí nghiệm mới cần xây lại, không phải tái lập corpus r3 không đổi.
Reranker báo truncation. Đọc lại cặp liên quan và độ dài token hóa. Cờ báo rút ngắn nhưng không tự giữ token đã bỏ. Có văn bản đầy đủ trong pairs không có nghĩa mô hình đã đọc hết.
Thời lượng biến động mạnh. Đừng chạy hai benchmark cùng lúc trên một GPU. Hãy kiểm tra cũng đang so cùng pool và cùng phạm vi tính giờ.
Khi lưu quan sát xong, từ gốc dự án chạy:
docker compose down
Lệnh này dừng dịch vụ dự án và index Qdrant tạm của nó. Mô hình và đầu ra vẫn còn. Muốn chạy lại tìm kiếm sau dọn dẹp, khởi động Qdrant và xây lại index trước khi retrieve.
Tổng kết
Tìm kiếm dense trả lời « nên xem xét tài liệu nào? ». Reranker trả lời « nên trình bày tài liệu đó theo thứ tự nào? ». Cái sau có thể cải thiện kết quả đầu, nhưng không sửa được passage vắng trong pool.
Trong lộ trình r3, mọi pertinent đã có trong 20 ứng viên: recall giữ 1,0000, còn MRR@5 và nDCG@5 đạt 1,0000 sau reranking. Cải thiện này đi cùng tổng thời gian trung bình báo cáo 54,63 ms trên máy thử.
Kết quả hữu ích nhất không chỉ là bảng này. Đó là phương pháp hiểu nó: đóng băng ứng viên, đọc danh sách trước trung bình, tách câu ngoài corpus và đo chi phí thêm. Bạn có thể áp dụng cách làm này cho dữ liệu riêng mà không nhầm sắp xếp tốt hơn với coverage tài liệu tốt hơn.
Tìm hiểu thêm
Tài liệu reranker BGE trình bày scoring cặp và logits. Tài liệu E5 đa ngôn ngữ cho thấy tiền tố, pooling có mask và chuẩn hóa embedding.
Để đặt các thành phần vào kiến trúc, xem lộ trình Retrieve & Re-Rank của Sentence Transformers. Tài liệu đánh giá cross-encoder cũng nhấn mạnh khác biệt giữa chỉ đánh giá ứng viên truy xuất và thêm lại mọi pertinent một cách nhân tạo. So sánh của chúng ta dựa trên pool dense đã lưu, không reranker nào thêm tài liệu.
Tài liệu Transformers về padding và truncation giúp hiểu xử lý cặp dài. Bộ lọc Qdrant là hướng giới hạn tìm kiếm theo phạm vi tài liệu.
Các tham chiếu này giải thích cơ chế; chúng không thay thế mã, mô hình và phiên bản ZIP để tái lập kết quả. Ví dụ sư phạm minh họa tính toán, còn bảng « Kết quả R3 đã quan sát » lấy các phép đo từ hai lần tái lập hướng dẫn.