





Vous développez le centre d’aide d’une application web. Un utilisateur pose une question, votre moteur renvoie une liste de fiches… et la bonne réponse se trouve en douzième position. Elle existe, elle a été retrouvée, mais elle reste loin des premiers résultats que votre interface affiche.
Faut-il changer tout le moteur de recherche ? Pas forcément. Il faut d’abord séparer deux problèmes : retrouver les documents utiles, puis les placer dans le bon ordre.
C’est précisément ce que nous allons expérimenter. Un premier modèle, E5, prépare une sélection de documents. Un second, appelé reranker, relit chaque candidat avec la question pour proposer un nouveau classement. Nous mesurerons ce qu’il améliore, ce qu’il ne peut pas réparer et le temps que cette seconde lecture ajoute.
La situation du centre d’aide est une illustration. Les résultats présentés plus loin proviennent du corpus fictif et du parcours r3 du tutoriel ; les petits exemples de calcul sont signalés séparément.
Le téléchargement du tutoriel exécutable est disponible ici : Télécharger le projet complet du tutoriel.
Objectif et résultat attendu
Ce que nous allons construire
Le corpus, c’est-à-dire l’ensemble des documents dans lesquels nous cherchons, contient 200 documents fictifs. Il est accompagné de 80 questions : 20 de développement et 60 de test.
Les questions de développement permettent de prendre en main le parcours et d’étudier ses comportements. Les questions de test servent à l’évaluation annoncée. Cette séparation ne signifie pas que nous allons entraîner un modèle : ici, nous utilisons des modèles déjà entraînés pour effectuer des calculs, ce que l’on appelle l’inférence.
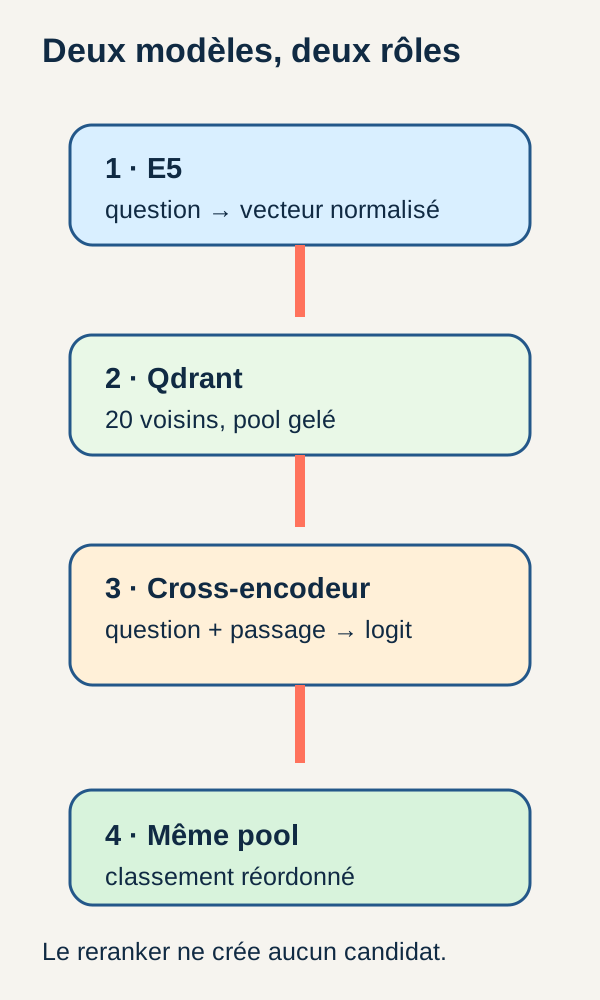
Pour chaque question, la recherche dense E5 constitue un pool de 20 candidats. Derrière le mot pool, il n’y a rien de mystérieux : c’est la liste des 20 documents retenus pour l’étape suivante. Dense désigne ici une recherche fondée sur des vecteurs numériques appris, que nous allons expliquer.
Le reranker bge-reranker-v2-m3 reçoit ensuite ces candidats. Il ne parcourt pas à nouveau les 200 documents : il réordonne seulement les 20 documents déjà sélectionnés.
Ce que vous saurez lire à la fin
Trois fichiers rendent l’expérience observable. outputs/candidates.json conserve la sélection initiale ; outputs/reranked.json contient le nouveau classement et les scores des paires question-document ; outputs/evaluation.json rassemble les mesures.
Vous saurez répondre à trois questions concrètes : les documents utiles étaient-ils disponibles dans la sélection ? Le nouveau classement les rend-il plus visibles parmi les cinq premiers résultats ? Combien de temps supplémentaire cette amélioration demande-t-elle ?
Nous construisons un mécanisme de recherche et de classement, pas un chatbot qui rédige une réponse. Il pourra servir de brique à une autre application, mais la génération de texte n’appartient pas à cette expérience.
Ce qu’il faut pour suivre
Vous devez pouvoir lire une fonction Python, manipuler des listes et des dictionnaires, ouvrir du JSON et lancer des commandes dans un terminal. Les notions propres à la recherche et aux modèles sont introduites au fil du parcours.
L’exécution exige Linux x86_64, Docker Compose, un pilote NVIDIA et NVIDIA Container Toolkit. Le tutoriel a été vérifié avec une RTX 3090. Prévoyez 8 Gio de VRAM libres, 12 Gio de RAM disponibles et 25 Gio de disque pour le projet et Docker. La VRAM est la mémoire de la carte graphique ; elle ne se confond pas avec la RAM de votre machine.
Ces ressources sont des provisions prudentes, pas des minima établis expérimentalement. Le tutoriel n’annonce pas de mode CPU : nous conserverons le parcours GPU validé.
Pourquoi deux modèles ?
E5 : représenter chaque texte séparément
Un embedding est une liste de nombres calculée à partir d’un texte. On peut le voir comme les coordonnées d’un point : des textes que le modèle a appris à rapprocher peuvent se retrouver proches dans cet espace.
Ici, chaque embedding possède 384 coordonnées, ou dimensions. Ce ne sont pas 384 catégories que nous aurions définies à la main. Une coordonnée ne signifie pas à elle seule « facture » ou « mot de passe ».
E5 est utilisé comme bi-encodeur : il transforme la question d’un côté et chaque document de l’autre. Le préfixe query: indique une question ; passage: indique un texte à retrouver. Ces préfixes donnent un rôle au texte, ils ne le traduisent pas.
Cette séparation permet de préparer les vecteurs des 200 documents une fois pour un corpus inchangé. À l’arrivée d’une nouvelle question, il reste à encoder cette question puis à rechercher ses voisins.
Qdrant n’est pas le modèle d’IA. E5 produit les vecteurs ; Qdrant les stocke dans une collection et recherche les vecteurs proches de celui de la question. La comparaison utilise ici la similarité cosinus, une mesure de proximité entre directions de vecteurs.
Le résultat est une première liste plausible. Mais une proximité dans cet espace ne garantit pas qu’un passage réponde précisément à la demande.
Le cross-encodeur : lire une question et un passage ensemble
Le second modèle fonctionne autrement. Un cross-encodeur reçoit une paire complète : la question et le texte d’un candidat. Il peut ainsi calculer des interactions entre les deux textes pendant son traitement, au lieu de comparer uniquement deux représentations produites séparément.
Prenons un exemple inventé pour comprendre la différence, sans l’assimiler à une sortie du corpus :
Question : « Comment récupérer l’accès à mon compte ? »

Paire A : cette question + une fiche sur le changement d’adresse de courriel
Paire B : cette question + une fiche sur la réinitialisation du mot de passe
Les deux fiches parlent d’un compte. Pourtant, elles ne décrivent pas la même action. Le rôle du cross-encodeur est de fournir un nouveau signal pour départager ces candidats ; son classement devra ensuite être confronté aux annotations, pas considéré comme juste par principe.
Cette lecture commune doit être refaite pour chaque paire. Pour notre question, les 20 candidats donnent donc 20 paires à évaluer. Le code les traite par lots de 4 : cela représente cinq lots pour un pool complet, pas seulement quatre documents retenus.
Pourquoi ne pas lui soumettre directement les 200 documents ? Cela demanderait de calculer 200 paires par question au lieu de 20. Le premier étage sert justement à limiter le travail du second. C’est le principe du parcours récupération puis reclassement décrit par Sentence Transformers.
Un score pour trier, pas une probabilité de vérité
Le reranker renvoie un logit, c’est-à-dire un score numérique brut. Dans ce parcours, un score plus élevé passe devant un score plus faible.
Par exemple, des scores fictifs de 4,2, 1,4 et -0,6 suffisent à ordonner trois candidats. Ils ne signifient pas « 420 % », « 140 % » ou « une pertinence négative ». Le nombre sert au classement, pas à exprimer directement un pourcentage de fiabilité.
La fiche officielle de BGE montre que l’on peut appliquer une fonction sigmoïde pour ramener ces scores entre 0 et 1. Notre code ne le fait pas. Et changer l’échelle ne suffirait pas à démontrer qu’un score est une probabilité correctement calibrée sur vos documents métier.
Ne cherchez donc pas à additionner le cosinus E5 et le logit BGE. Ils n’ont pas la même signification ni la même échelle. Dans ce tutoriel, E5 choisit les candidats ; le score BGE détermine leur nouvel ordre.
La limite à garder en tête
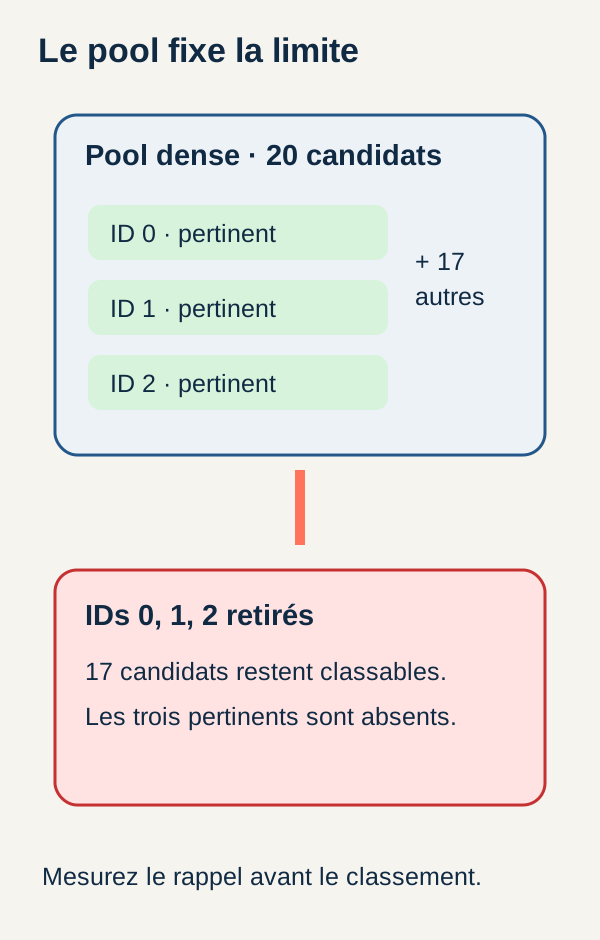
Revenons à notre bonne fiche en douzième position. Si elle figure dans les 20 candidats, le reranker peut la faire remonter. Si elle est absente de cette sélection, il ne peut pas la retrouver.
Nous enregistrons donc la liste avant le reranking : c’est le pool gelé. Gelé signifie ici conservé comme référence de comparaison, et non rendu techniquement impossible à modifier. Nous comparons deux ordres du même ensemble, pas deux recherches dont les résultats auraient changé entre-temps.
Architecture du parcours
Le traitement se déroule en étapes distinctes, chacune avec un rôle vérifiable :
preparevérifie les 200 documents et les 80 questions.indexencode les documents en 384 dimensions et les dépose dans une collection Qdrant dédiée.retrieveencode chaque question et fige ses 20 voisins dansoutputs/candidates.json.rerankcalcule un logit par paire question-document, par lots de 4, puis écritoutputs/reranked.json.evaluatecalcule les métriques sur les questions test évaluables ;exerciseretire volontairement les documents pertinents deREF-000pour tester la limite du reranker.
Pour un développeur web, les JSON intermédiaires jouent un rôle comparable à des réponses d’API enregistrées pendant un test : ils permettent de comprendre ce qu’une étape a transmis à la suivante, au lieu de ne regarder que la page finale.
Qdrant est temporaire dans ce projet. La commande de nettoyage docker compose down enlève l’index. Les modèles acquis et les sorties restent disponibles : vous pouvez relire les JSON sans garder Qdrant actif, ou reconstruire l’index pour rejouer les étapes suivantes.
Cette persistance différente est un choix du tutoriel, pas une propriété générale de tous les déploiements Qdrant ou Docker.
Lire le code central avant les résultats
Les extraits ci-dessous montrent le cœur du mécanisme. Ils utilisent des objets initialisés ailleurs dans le projet, comme self.model, self.tokenizer ou store. Ils ne constituent pas, à eux seuls, un script autonome : pour exécuter le parcours complet, utilisez les fichiers du ZIP.
1. Transformer un texte en vecteur E5
Avant de lire la fonction, clarifions trois mots que vous allez rencontrer.
Le tokenizer découpe le texte en unités reconnues par le modèle, les tokens, puis les remplace par des identifiants numériques. Un token peut être un mot, une partie de mot ou un signe : 512 tokens ne signifie donc pas 512 caractères, ni nécessairement 512 mots.
Pour calculer plusieurs textes en même temps, on les rassemble dans un lot, ou batch. Comme ils n’ont pas tous la même longueur, les plus courts reçoivent du padding, un remplissage technique. Le masque d’attention indique quelles positions correspondent au texte et lesquelles correspondent à ce remplissage.
Enfin, le pooling rassemble les représentations des différentes positions en un seul vecteur par texte. Ici, il s’agit d’une moyenne qui ignore le padding. Attention aux deux mots proches : le pooling fabrique un vecteur ; le pool de candidats est une liste de documents.
def encode(self, texts, kind):
    if kind not in ("query", "passage") or not texts:
        raise ValueError("Préfixe query/passage et liste non vide requis")

    vectors = []

    for offset in range(0, len(texts), 16):
        batch = self.tokenizer(
            [kind + ": " + text for text in texts[offset:offset + 16]],
            padding=True,
            truncation=False,
            return_tensors="pt",
        )

        if batch["input_ids"].shape[1] > 512:
            raise ValueError("Texte dépassant 512 tokens : découpez le document")

        batch = batch.to("cuda")

        with torch.inference_mode():
            hidden = self.model(**batch).last_hidden_state
            mask = batch["attention_mask"].unsqueeze(-1).bool()
            pooled = hidden.masked_fill(~mask, 0).sum(1) / mask.sum(1)
            normalized = torch.nn.functional.normalize(pooled, p=2, dim=1)

        if not torch.isfinite(normalized).all():
            raise ValueError("Embedding non fini")

        vectors.extend(normalized.cpu().tolist())

    return vectors
Que se passe-t-il dans cette fonction ?
kind doit valoir query ou passage, et la liste de textes ne doit pas être vide. La boucle prend ensuite au maximum 16 textes à la fois, ajoute le bon préfixe, puis les tokenise.
padding=True aligne les longueurs du lot. En revanche, truncation=False interdit de raccourcir silencieusement une entrée. La largeur du lot, batch["input_ids"].shape[1], correspond à sa séquence la plus longue après tokenisation et remplissage. Si elle dépasse 512 tokens, la fonction s’arrête avant le calcul du modèle. Les préfixes et les tokens spéciaux ajoutés par le tokenizer font partie de cette entrée.
batch.to("cuda") déplace les données de calcul vers le GPU. Le modèle produit ensuite last_hidden_state : une représentation numérique pour chaque position de chaque texte. torch.inference_mode() évite de préparer le calcul des gradients, les indications nécessaires pour ajuster les paramètres pendant l’entraînement. Ce mode ne remplace pas, à lui seul, la mise en mode évaluation du modèle dans son initialisation.
Les trois lignes autour de mask, pooled et normalized sont le cœur de la conversion : elles mettent à zéro les positions de padding, additionnent les représentations utiles, divisent par leur nombre, puis normalisent le vecteur obtenu.
Pour comprendre la moyenne, imaginons seulement deux coordonnées et deux positions utiles : [2, 4] et [4, 4]. Leur moyenne vaut [3, 4]. Une position de padding ne doit ni ajouter une valeur, ni faire passer le diviseur de 2 à 3. Cet exemple est un calcul miniature, pas une représentation réellement produite par E5.
La normalisation L2 ramène ensuite la longueur du vecteur à 1. Pour [3, 4], cette longueur vaut √(3² + 4²) = 5 : le vecteur devient donc [0,6 ; 0,8]. Nous comparons ainsi des directions plutôt que des longueurs arbitraires. Le même principe s’applique aux 384 coordonnées de notre parcours.
Enfin, torch.isfinite refuse les valeurs infinies ou NaN, qui signale un résultat numérique indéfini. .cpu().tolist() ramène les vecteurs en mémoire côté CPU sous forme de listes Python utilisables par le reste du programme.
La fiche officielle d’E5 multilingue illustre les préfixes, la moyenne masquée et la normalisation. Elle sert de complément conceptuel : pour reproduire cette expérience, gardez les fichiers et réglages verrouillés du ZIP, notamment son refus explicite des entrées trop longues.
2. Enregistrer les candidats avant de les reclasser
À ce stade, les vecteurs des documents sont indexés. Pour chaque question, nous calculons son vecteur et demandons 20 voisins à Qdrant.
store.search(encoder.encode([data["queries"][0]["query"]], "query")[0], 20)

rows = []

for query in data["queries"]:
    start = time.perf_counter()
    candidates = store.search(encoder.encode([query["query"]], "query")[0], 20)
    rows.append(
        {
            **query,
            "candidates": candidates,
            "seconds": {"dense": time.perf_counter() - start},
        }
    )

save("candidates", {"rows": rows})
La première ligne exécute une recherche d’échauffement, ou warm-up. Elle intervient avant la boucle chronométrée. Son résultat n’est pas ajouté à rows : la première question sera ensuite traitée de nouveau dans les mesures normales.
Dans la boucle, le chronomètre démarre avant l’encodage de la question. La durée seconds.dense inclut donc cet encodage et l’appel de recherche à Qdrant. Elle ne mesure pas seulement le temps passé à comparer des vecteurs dans la base.
L’expression {**query, ...} conserve les informations de la question et leur ajoute les candidats ainsi que la durée. À la fin, save écrit le fichier de référence.
Voilà le contrat entre les deux modèles : le reranker relira cette liste enregistrée. Relancer une recherche avec un autre pool au milieu de la comparaison empêcherait d’isoler l’effet du reclassement.
3. Calculer un score pour chaque paire
Le reranker ne reçoit pas les embeddings E5 pour les améliorer. Il reprend le texte de chaque candidat et l’associe à la question. Les identifiants servent à retrouver les documents et à suivre leur nouvelle position.
def score(self, query, candidates, documents):
    if not candidates:
        return {"ranked": [], "pairs": [], "truncated": False}

    if not isinstance(query, str) or not query.strip():
        raise ValueError("Question non vide requise")

    rank_scores(candidates, [0.] * len(candidates))
    pairs = [[query, documents[identifier]["text"]] for identifier, _ in candidates]
    scores = []
    truncated = False

    for offset in range(0, len(pairs), 4):
        part = pairs[offset:offset + 4]
        lengths = [len(self.tokenizer(a, b)["input_ids"]) for a, b in part]
        truncated |= any(length > 512 for length in lengths)

        batch = self.tokenizer(
            part,
            padding=True,
            truncation=True,
            max_length=512,
            return_tensors="pt",
        ).to("cuda")

        with torch.inference_mode():
            scores.extend(self.model(**batch).logits.view(-1).float().cpu().tolist())

    return {
        "ranked": rank_scores(candidates, scores),
        "truncated": truncated,
        "pairs": [
            {
                "query": query,
                "document_id": identifier,
                "text": documents[identifier]["text"],
                "score": score,
            }
            for (identifier, _), score in zip(candidates, scores)
        ],
    }
Le premier comportement est un retour explicite sur pool vide. La fonction renvoie alors une liste classée vide, aucune paire et truncated: False. Ce retour a lieu avant le contrôle de la question : avec un pool vide, cet extrait n’exige donc pas que la question soit non vide. Pour un pool non vide, une question invalide déclenche bien une erreur.
rank_scores(candidates, [0.] * len(candidates)) effectue un premier passage de validation des candidats, notamment de leurs identifiants. Les zéros sont provisoires : ils ne sont ni les cosinus E5 ni les prédictions BGE. La fonction auxiliaire complète fait partie du ZIP ; elle assure aussi le tri final et le refus des résultats de scoring non finis.
La compréhension de liste pairs construit une paire par candidat. Puis la boucle les traite par lots de 4. Une première tokenisation examine les longueurs ; une seconde prépare le lot envoyé sur CUDA, avec une limite de 512 tokens.
Le modèle produit les logits. view(-1) les présente sous forme d’une liste de scores, .float() les convertit en nombres flottants, puis .cpu().tolist() les rend exploitables en Python. Le tri final est décroissant sur le score, avec l’identifiant comme départage stable en cas d’égalité.
Le retour contient deux vues complémentaires : ranked, la liste remise en ordre, et pairs, le détail des associations question-document avec leur texte et leur score. Dans cet extrait, pairs suit l’ordre des candidats d’entrée ; c’est ranked qu’il faut lire pour connaître le nouveau classement.
Deux politiques différentes face à un texte trop long
Le détail mérite une pause, car les deux étapes ne réagissent pas de la même manière.
E5 refuse une entrée de plus de 512 tokens. Le programme vous demande de découper le document explicitement, plutôt que de modifier silencieusement la matière de la recherche.
Le reranker accepte de tronquer une paire trop longue, mais le signale avec truncated: True. Sa limite concerne l’entrée combinée : question, passage et tokens spéciaux. Deux textes acceptables séparément pour E5 peuvent donc former une paire trop longue pour le second modèle ; leurs tokenizers peuvent aussi découper différemment les mêmes mots.
Selon la documentation Transformers sur la troncature, truncation=True applique la stratégie longest_first : les tokens sont retirés de la séquence la plus longue de la paire jusqu’au respect de la limite. Ce réglage ne garantit donc pas que seul le passage sera raccourci. Ici, 512 est la limite choisie par le code du tutoriel, pas une affirmation sur toutes les capacités possibles de BGE.
Le booléen truncated cumule l’observation sur les lots : il devient vrai dès qu’au moins une paire dépasse la limite. Il ne donne ni le nombre de paires concernées ni les positions exactes supprimées.
Autre nuance importante : le champ text conserve le document original, pas une reconstruction du texte après troncature. Les sorties permettent de retrouver la paire source et son score ; elles ne prouvent pas que le modèle a consommé chaque mot du texte conservé. Lorsqu’une troncature est signalée, il faut examiner la tokenisation effective avant d’expliquer un résultat par une phrase située en fin de document.
Préparer et exécuter le tutoriel
Se placer au bon endroit
Téléchargez le ZIP, extrayez-le, puis ouvrez le terminal à la racine du projet extrait. Toutes les commandes ci-dessous partent de ce répertoire. Le code complet, et non les seuls extraits de l’article, est nécessaire à leur exécution.
GPU_DEVICE=1 choisirait la seconde carte ; l’index 0 est utilisé par défaut. Vérifiez le choix du GPU dans la configuration du projet avant les calculs.
Le préflight est un contrôle préalable de l’environnement. Il initialise réellement CUDA dans un conteneur et vérifie que Docker peut utiliser la carte. Voir un résultat correct avec nvidia-smi sur l’hôte ne suffit pas : la carte peut être accessible à Linux, mais pas au conteneur.
NVIDIA Container Toolkit assure cette exposition du GPU aux conteneurs ; son guide officiel complète les prérequis. Le préflight du projet n’installe rien et ne modifie pas la configuration de votre système.
Construire l’environnement et acquérir les modèles
Lancez ces cinq commandes dans l’ordre. Elles doivent toutes terminer sans erreur avant la suite.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
setup.sh prépare l’environnement local du projet ; build construit l’image. Le service fetch, activé par le profil acquisition, acquiert explicitement les modèles. Il vérifie la taille et le SHA-256 des fichiers avant leur renommage atomique.
Un SHA-256 est une empreinte calculée à partir des octets d’un fichier. Ici, le comparer à la valeur attendue sert à vérifier que le modèle acquis correspond à l’actif prévu. Le renommage atomique permet de placer le fichier sous son nom final après validation, plutôt que de présenter un téléchargement partiel comme un modèle terminé. C’est un contrôle d’intégrité des fichiers, pas une mesure de qualité du modèle.
La dernière commande lance la suite publique du projet. Le résultat attendu du parcours validé est 17 tests publics réussis. Un échec doit être compris avant de continuer : des résultats de recherche apparemment crédibles ne compensent pas un contrôle en erreur.
Construire l’index, récupérer, reclasser, évaluer
Démarrez ensuite Qdrant et exécutez les étapes suivantes :
docker compose up -d qdrant
docker compose run --rm --no-deps app -m src.cli prepare
docker compose run --rm --no-deps app -m src.cli index
docker compose run --rm --no-deps app -m src.cli retrieve
docker compose run --rm --no-deps app -m src.cli rerank
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
Après prepare, vérifiez la population annoncée : 200 documents, 80 questions, dont 20 de développement et 60 de test.
Après index, la sortie doit notamment afficher documents: 200, dimension: 384, device: "cuda" et points_count: 200. Nous voulons autant de points indexés que de documents, avec la dimension attendue.
Après retrieve, ouvrez outputs/candidates.json. Pour une question, repérez ses 20 candidats et leur ordre initial. Ce sera votre point de comparaison.
Après rerank, ouvrez outputs/reranked.json. Retrouvez la même question, comparez les identifiants de ranked à ceux du pool, puis lisez les paires, les logits et l’indicateur de troncature. Les documents ne doivent pas changer simplement parce que leur ordre change.
Après negatives, les contrôles doivent confirmer le comportement sur pool vide, la troncature signalée et la collection vide. Un test négatif vérifie une limite ou un cas particulier volontairement provoqué, pas seulement le chemin où tout se passe bien.
Après evaluate, outputs/evaluation.json contient les métriques de référence. Nous allons maintenant voir comment les interpréter.
L’acquisition et l’inférence sont séparées. Une fois les modèles acquis, l’inférence reste locale et hors réseau extérieur. Cela n’empêche pas l’application de communiquer avec Qdrant à l’intérieur du projet Docker.
Définir les mesures avant de les regarder
Qu’est-ce qu’un document « pertinent » ?
Pour évaluer une recherche, il faut savoir ce qu’elle aurait dû retrouver. Les annotations de pertinence donnent cette référence : pour chaque question, elles indiquent les documents considérés comme utiles dans l’expérience.
Ce n’est pas le score du modèle qui crée cette vérité de référence. Sinon, nous demanderions au moteur de se noter lui-même. Ici, les annotations sont celles d’un corpus pédagogique fictif ; elles ne remplacent pas une validation métier indépendante sur de vrais documents.
Pourquoi 80, 60 et 48 ne désignent pas la même chose
Les 80 questions comprennent 20 questions de développement et 60 questions de test. Parmi ces 60 questions de test, 48 possèdent au moins un document pertinent dans les annotations ; les 12 autres sont hors corpus.
Les métriques de pertinence portent sur les 48 questions évaluables. Les latences publiées plus loin portent sur les 60 questions de test, y compris les 12 hors corpus.
Pourquoi séparer ces dernières ? Pour une question sans document pertinent, le rappel aurait un dénominateur nul et le classement idéal de nDCG n’aurait aucun gain. Lui attribuer arbitrairement un zéro mélangerait deux problèmes : mal classer une réponse disponible, et chercher dans un corpus qui ne contient pas de réponse attendue.
Ces 12 questions ne disparaissent pas pour autant de l’observation : elles reçoivent des candidats. Le fait d’obtenir une liste, même classée, ne prouve donc pas qu’une fiche répond à la question. Le parcours ne démontre pas une capacité à décider automatiquement « aucune réponse disponible ».
Sur petit écran, faites défiler le tableau horizontalement.
| Mesure | Ce qu’elle observe |
|---|---|
| Rappel@20 | Part des documents pertinents présents dans le pool dense de 20. Il borne ce que peut faire le reranker. |
| MRR@5 | Rang du premier document pertinent dans les cinq premières positions. |
| nDCG@5 | Position de tous les documents pertinents dans les cinq premières positions, avec une décroissance selon le rang. |
| Latence dense | Encodage de la question et recherche Qdrant. |
| Latence reranker | Coût additionnel du scoring des 20 paires, hors chargement du modèle. |
Rappel@20 : les documents utiles sont-ils disponibles ?
Le rappel, ou Recall, mesure une couverture. Pour une question ayant au moins un document pertinent :
Rappel@20 = nombre de documents pertinents dans les 20 candidats / nombre total de documents pertinents attendus.
Avec trois documents pertinents, en retrouver deux donne 2 / 3 ≈ 0,667. Les retrouver tous donne 1, même s’ils sont aux rangs 12, 16 et 20. Le rappel@20 ne vous dit donc pas si les premières lignes de l’interface sont bonnes ; il vous dit ce que le reranker a à sa disposition.
Si le reranker ne fait que permuter ces mêmes 20 candidats, ce rappel reste identique. Il peut améliorer leur présence dans le top 5, mais pas ajouter un document au pool de 20.
MRR@5 : où apparaît la première réponse utile ?
Pour une question, on cherche le rang du premier document pertinent parmi les cinq premiers. Son rang réciproque, noté ici RR@5, vaut l’inverse de cette position : rang 1 → 1 ; rang 2 → 1 / 2 = 0,5 ; rang 5 → 1 / 5 = 0,2.
S’il n’y a aucun pertinent dans les cinq premiers, RR@5 vaut 0, même si un document utile arrive au rang 6.
Le MRR, pour Mean Reciprocal Rank, est la moyenne de ces valeurs sur les questions évaluables. Ce n’est pas l’inverse du rang moyen. Par exemple, deux questions dont les premiers pertinents sont aux rangs 1 et 5 donnent (1 + 0,2) / 2 = 0,6, et non 1 / 3.
Cette métrique répond bien à « à quelle vitesse rencontre-t-on une première réponse utile ? ». Elle ne décrit pas la position des autres documents pertinents.
nDCG@5 : plusieurs réponses utiles sont-elles bien placées ?
Le nom est plus impressionnant que l’idée. nDCG signifie normalized Discounted Cumulative Gain : on additionne des gains de pertinence, en donnant moins de poids aux positions éloignées, puis on compare au meilleur classement possible.
Pour comprendre le calcul avec des annotations binaires, un document pertinent au rang r apporte 1 / log2(r + 1) ; un document non pertinent apporte 0. log2 désigne le logarithme en base 2. On ne garde ici que les cinq premières positions.
Avec un seul pertinent, placé au rang 2, la contribution vaut 1 / log2(3) ≈ 0,631. Le classement idéal le placerait au rang 1, pour un gain de 1 : le nDCG@5 vaut donc aussi environ 0,631.
Avec plusieurs pertinents, il ne suffit pas d’additionner leurs contributions : il faut aussi diviser par le gain du classement idéal. C’est cette normalisation qui permet de lire 1 comme le meilleur résultat possible selon les annotations et la coupure considérée.
Un exemple que l’on peut refaire à la main
Le tableau suivant est un exemple pédagogique, pas une sortie des reproductions r3. Imaginons une question ayant trois documents pertinents, tous présents dans un pool de 20. Nous ne changeons que leurs positions.
Sur petit écran, faites défiler le tableau horizontalement.
| Positions des trois pertinents | Rappel@20 | RR@5 pour cette question | nDCG@5 |
|---|---|---|---|
| Rangs 2, 4 et 8 | 1,0000 | 0,5000 | ≈ 0,4982 |
| Rangs 1, 8 et 9 | 1,0000 | 1,0000 | ≈ 0,4693 |
| Rangs 1, 2 et 3 | 1,0000 | 1,0000 | 1,0000 |
Pour la première ligne, seuls les rangs 2 et 4 contribuent au gain top-5 :
DCG@5 = 1 / log2(3) + 1 / log2(5) ≈ 1,0616.
Avec trois pertinents, le classement idéal les placerait aux rangs 1, 2 et 3 :
IDCG@5 = 1 + 1 / log2(3) + 1 / log2(4) ≈ 2,1309.
Le résultat normalisé vaut donc 1,0616 / 2,1309 ≈ 0,4982.
Comparez maintenant les deux premières lignes. Le rang réciproque s’améliore parce qu’une réponse utile arrive en tête, mais le nDCG diminue parce qu’une seule réponse utile reste dans les cinq premiers résultats. Deux métriques peuvent évoluer dans des sens différents sans que le calcul soit incohérent. Elles observent des aspects différents du classement.
Le rappel du pool reste égal à 1 dans les trois cas. Il fixe l’ensemble des documents disponibles ; il ne résume pas à lui seul la qualité de leur ordre.
Latence : quel temps chronomètre-t-on ?
La latence est le temps écoulé pour effectuer une opération. Dans ce tutoriel, la latence dense inclut l’encodage de la question et la recherche Qdrant. La latence du reranker est un coût additionnel pour traiter les 20 paires ; le chargement du modèle en est exclu.
Les mesures r3 sont prises après échauffement. Elles ne décrivent ni le premier démarrage complet, ni le téléchargement des modèles, ni le délai total d’une future page web avec réseau, authentification et affichage.
Résultats R3 observés
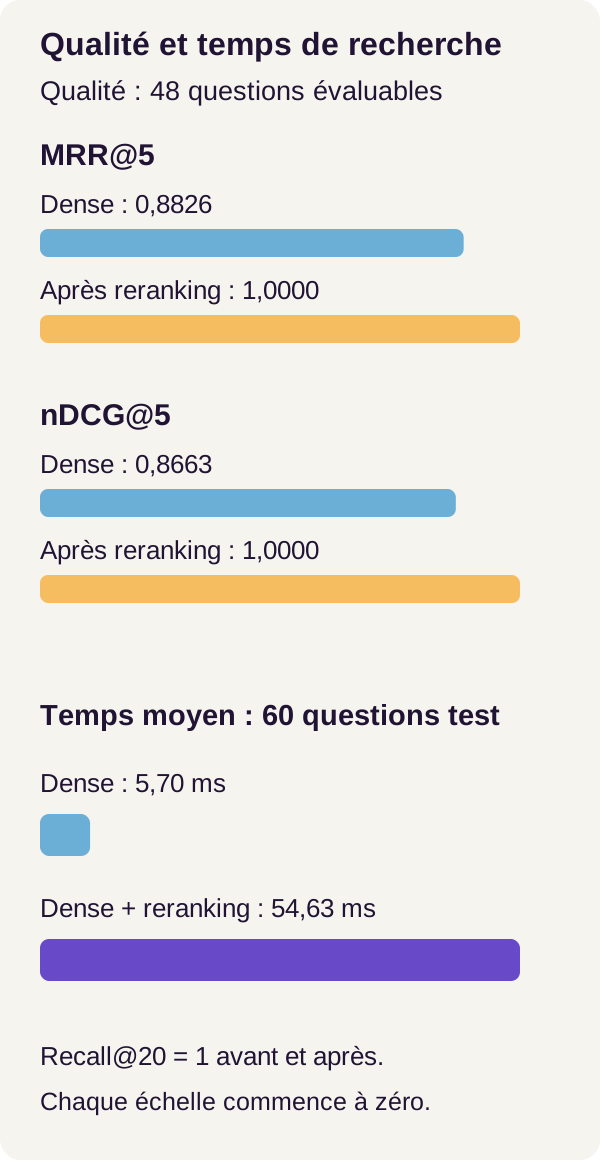
Deux reproductions du parcours r3 ont donné les mêmes métriques de qualité. Les latences ci-dessous sont celles de la seconde reproduction, moyennées sur les 60 questions de test, après warm-up et sans le chargement des modèles.
La qualité du classement
Sur petit écran, faites défiler le tableau horizontalement.
| Route | MRR@5 | nDCG@5 | Rappel@20 | Population |
|---|---|---|---|---|
| Candidats denses | 0,8826 | 0,8663 | 1,0000 | 48 évaluables |
| Après reranking | 1,0000 | 1,0000 | 1,0000 | 48 évaluables |
Le premier nombre à lire est le rappel@20 : 1,0000 dans les deux lignes. Tous les documents pertinents des 48 questions évaluables étaient déjà présents dans les pools denses. Le reranker n’améliore donc pas la couverture : elle était complète à cette profondeur de recherche.
L’amélioration porte sur les positions. Le MRR@5 passe de 0,8826 à 1,0000, et le nDCG@5 de 0,8663 à 1,0000. Le résultat rapporté est optimal pour ces métriques sur ce jeu évalué ; ce n’est pas une démonstration que le modèle sera parfait sur d’autres questions.
Ne lisez pas non plus MRR@5 = 0,8826 comme « 88,26 % des documents sont corrects ». C’est une moyenne de rangs réciproques. Le nDCG mesure lui aussi un classement, pas une probabilité de vérité.
Le temps supplémentaire
Sur petit écran, faites défiler le tableau horizontalement.
| Temps moyen | Millisecondes |
|---|---|
| Dense | 5,70 ms |
| Reranking additionnel | 48,92 ms |
| Total | 54,63 ms |
Le reclassement ajoute ici 48,92 ms en moyenne à une recherche dense de 5,70 ms. Le total rapporté atteint 54,63 ms, soit environ 54,63 / 5,70 ≈ 9,6 fois le temps de la voie dense seule.
Les durées publiées sont conservées à deux décimales. Leur addition visible donne 54,62 ms, contre 54,63 ms pour le total rapporté ; cet écart de 0,01 ms est compatible avec des arrondis indépendants. Les valeurs non arrondies seraient nécessaires pour en confirmer l’origine : il ne faut pas y voir un coût supplémentaire mesuré séparément.
Le bon raisonnement n’est donc ni « 49 ms, c’est forcément négligeable », ni « presque dix fois plus lent, c’est forcément inutilisable ». La question est : le changement de classement justifie-t-il ce temps supplémentaire dans l’application visée ?
Ces résultats décrivent un corpus fictif, un poste et une configuration donnés. Ils ne constituent pas une promesse de gain métier, un test de charge ou une estimation des performances de votre futur service.
Ce que nous avons appris
Récupérer et reclasser sont deux opérations différentes
E5 et Qdrant constituent une liste de candidats. Le cross-encodeur apporte une comparaison plus coûteuse entre la question et chacun de ces candidats. Il peut modifier l’ordre, mais pas retrouver un document resté en dehors du pool.
Avant d’accuser le reranker d’une mauvaise réponse, regardez donc la liste d’entrée. Une fiche absente et une fiche mal classée ne demandent pas le même diagnostic.
Le score d’un modèle et une métrique d’évaluation ne sont pas la même chose
Le cosinus E5 et le logit BGE servent à produire des classements. Le rappel, le MRR et le nDCG servent à comparer ces classements à des annotations connues. Un logit élevé ne remplace pas une évaluation, et un bon MRR ne signifie pas que tous les résultats sont utiles.
Un premier résultat n’est pas une preuve de réponse
Les questions hors corpus reçoivent elles aussi des candidats. Le meilleur élément d’une liste peut donc être simplement le moins éloigné d’une demande à laquelle aucun document ne répond. Savoir refuser une recherche sans réponse est un problème distinct, que les scores parfaits sur les 48 questions évaluables ne résolvent pas.
La qualité a ici un coût mesuré
Dans cette expérience, le top-5 s’améliore et le temps total augmente. La taille du pool, le modèle, la longueur des textes et le matériel font partie du compromis à étudier. Rien ne permet de transposer automatiquement les 54,63 ms à un autre contexte.
Exercice : prédire, modifier, exécuter, observer, expliquer
Prédire avant de lancer
Pour REF-000, les documents pertinents sont les identifiants 0, 1 et 2. Ils figurent dans le pool de référence.
Nous allons les retirer avant le reranking. Notez votre prédiction : restera-t-il un document pertinent à classer ? Un modèle peut-il remettre en tête un identifiant qui ne lui est plus transmis ? Quel rappel le pool modifié aura-t-il pour cette question ?
Modifier et exécuter
N’éditez pas le code pour cet exercice. La commande fournie applique précisément cette modification au pool gelé de la première question :
docker compose run --rm --no-deps app -m src.cli exercise
Observer les sorties
Dans outputs/exercise.json, vérifiez removed_relevant: [0, 1, 2]. Le pool doit conserver 17 candidats, et aucun des trois identifiants supprimés ne doit réapparaître dans ranked.
Ne confondez pas les 17 candidats avec les 17 tests publics : le premier nombre vient de 20 - 3, le second désigne la suite de tests du projet.
Expliquer ce qui s’est passé
Le cross-encodeur peut préférer le document 3 parmi les candidats restants, mais il ne peut pas classer un document absent. Pour cette question, aucun des trois pertinents attendus ne reste dans le pool modifié : son rappel est donc nul, quelle que soit la qualité du tri des 17 autres documents.
Cela ne transforme pas REF-000 en question hors corpus : ses réponses existent toujours dans le corpus et dans les annotations. Nous avons provoqué un échec de récupération, pas supprimé l’existence d’une réponse attendue.
Augmenter le pool ou améliorer la récupération sont des pistes à expérimenter séparément. Elles demandent de nouvelles mesures de couverture, de classement top-5 et de latence ; elles ne sont pas des améliorations déjà démontrées par cet exercice.
Votre expérience, distincte de l’exercice
L’exercice précédent testait une limite précise. Pour explorer le compromis qualité-latence, conservez d’abord les sorties de référence, puis travaillez dans une copie du projet. Les résultats de cette variante ne font pas partie des reproductions r3 présentées ici.
Une variable intéressante est le nombre de voisins demandé à Qdrant. Par exemple, vous pouvez comparer un pool plus petit au pool de référence de 20, sans changer simultanément les documents, les questions et le reranker. Le code visible utilise la valeur 20 dans la recherche d’échauffement et dans la boucle mesurée : assurez-vous que la variante reste cohérente, ainsi que les éventuels contrôles du programme complet.
Avant d’exécuter, écrivez deux hypothèses séparées : ce que vous attendez sur la présence des pertinents, et ce que vous attendez sur le temps de traitement. Un pool réduit retire des paires à évaluer, mais il peut aussi écarter un document utile. Un pool plus grand donne davantage de candidats ; il ne garantit pas un meilleur classement final.
Rejouez retrieve, rerank et evaluate avec les commandes déjà présentées. Si la modification touche un fichier copié dans l’image Docker, reconstruisez l’image selon le montage du projet : changer un fichier sur l’hôte ne garantit pas que le conteneur exécute cette nouvelle version.
Comparez le nombre de candidats, le rappel du pool, MRR@5, nDCG@5 et les temps dense, reranker et total. Notez également l’apparition éventuelle de troncatures. Si vous changez la profondeur de récupération, nommez cette profondeur dans le bilan : un rappel mesuré sur un pool de 10 n’est pas, par simple renommage, le rappel@20 de référence.
Ne remplacez pas les anciens résultats par les nouveaux sans conserver leur configuration. La comparaison doit rendre visible ce qui a changé. Et gardez les questions de développement pour explorer vos réglages, plutôt que de choisir une configuration uniquement parce qu’elle maximise le jeu de test.
Limites pour une mise en production
Des données contrôlées, pas une validation métier
Le corpus et les questions sont fictifs. Les 48 questions évaluables et leurs annotations ne remplacent ni des requêtes représentatives de vos utilisateurs, ni une analyse d’erreurs sur de vrais documents. Un résultat parfait sur ce jeu ne valide pas une recherche générale.
Il faut notamment traiter séparément les demandes sans réponse dans le corpus. Un seuil sur le score BGE serait une nouvelle règle à évaluer, pas une capacité d’abstention déjà validée par ce parcours.
Des ressources observées avec des limites
Le tutoriel a été testé sur un poste équipé d’une RTX 3090. Il n’annonce ni mode CPU ni moteur de production. Les provisions matérielles restent prudentes, sans étude du minimum nécessaire.
La VRAM a été échantillonnée environ une fois par seconde : un pic bref peut passer entre deux relevés. Les caches Docker étaient disponibles, et les variations d’espace disque ne sont pas attribuables uniquement au tutoriel. Une moyenne de latence sur cette machine ne renseigne pas à elle seule sur les délais sous concurrence ou les requêtes les plus lentes.
Une architecture à compléter selon l’application
Choisissez la taille du pool et le budget de latence à partir de requêtes représentatives. Surveillez les paires longues et leurs troncatures, conservez les versions du corpus, des modèles et des métriques, puis mesurez la récupération avant d’attribuer un changement au reranker.
Dans une application documentaire avec des droits d’accès, le périmètre autorisé doit également être respecté avant de transmettre les textes au reclassement. Les filtres Qdrant constituent une brique technique pour limiter les candidats ; leur seule présence ne représente pas une politique d’autorisation complète.
La sécurité du conteneur, l’acquisition verrouillée et les limites de déploiement sont documentées dans l’archive. Elles doivent être lues avant une adaptation ; elles ne transforment pas le tutoriel en service prêt pour la production.
Dépannage et nettoyage
Le préflight échoue sur CUDA. Vérifiez le pilote NVIDIA, NVIDIA Container Toolkit et la carte choisie par GPU_DEVICE, puis relancez le préflight. Il ne fait aucune installation. Une carte détectée sur l’hôte ne suffit pas si elle n’est pas exposée au conteneur.
Qdrant est indisponible. Relancez docker compose up -d qdrant avant index. Si l’échec persiste, consultez les journaux Docker de ce projet plutôt que de poursuivre avec une recherche incomplète.
E5 refuse un document de plus de 512 tokens. C’est le comportement prévu : découpez le document explicitement. Si ce découpage change les unités indexées, les identifiants ou les annotations, vous avez une nouvelle expérience à reconstruire, pas la reproduction inchangée du corpus r3.
Le reranker signale une troncature. Relisez la paire concernée et sa longueur tokenisée. L’indicateur signale un raccourcissement, sans conserver à lui seul les tokens retirés. La présence du texte complet dans pairs ne veut pas dire qu’il a été lu en entier par le modèle.
Les durées varient fortement. Ne lancez pas deux benchmarks simultanément sur le même GPU. Vérifiez aussi que vous comparez le même pool et le même périmètre de chronométrage.
Quand vos observations sont conservées, terminez depuis la racine du projet par :
docker compose down
Cette commande retire les services du projet et son index Qdrant temporaire. Les modèles et les sorties restent disponibles. Pour rejouer une recherche après ce nettoyage, redémarrez Qdrant et reconstruisez l’index avant la récupération.
Synthèse
Une recherche dense répond à « quels documents considérer ? ». Un reranker répond à « dans quel ordre présenter ces documents ? ». Le second peut améliorer les premiers résultats, mais il ne répare pas l’absence d’un passage dans le pool.
Dans le parcours r3, tous les pertinents étaient déjà disponibles parmi les 20 candidats : le rappel reste à 1,0000, tandis que MRR@5 et nDCG@5 atteignent 1,0000 après reclassement. Cette amélioration s’accompagne d’un temps total moyen rapporté de 54,63 ms sur le poste testé.
Le résultat le plus utile n’est pas seulement ce tableau. C’est la méthode pour le comprendre : figer les candidats, lire les listes avant les moyennes, séparer les questions hors corpus et mesurer le coût supplémentaire. Vous pourrez reprendre cette démarche sur vos propres données sans confondre un meilleur tri et une meilleure couverture documentaire.
Pour approfondir
La fiche officielle du reranker BGE présente le scoring des paires et les logits. La fiche d’E5 multilingue montre les préfixes, le pooling masqué et la normalisation des embeddings.
Pour replacer ces composants dans une architecture, consultez le parcours Retrieve & Re-Rank de Sentence Transformers. Sa documentation sur l’évaluation des cross-encodeurs souligne aussi une différence importante entre évaluer seulement les candidats récupérés et réintroduire artificiellement tous les pertinents. Notre comparaison repose sur le pool dense enregistré, sans ajout de document par le reranker.
La documentation Transformers sur padding et troncature aide à comprendre le traitement des paires longues. Les filtres Qdrant offrent une piste pour limiter la recherche à un périmètre documentaire.
Ces références expliquent les mécanismes ; elles ne remplacent pas le code, les modèles et les versions du ZIP pour reproduire les résultats présentés. Les exemples pédagogiques de cet article illustrent les calculs, tandis que les tableaux « Résultats R3 observés » reprennent les mesures des deux reproductions du tutoriel.