





State sviluppando il centro assistenza di un'applicazione web. Un utente pone una domanda, il motore restituisce un elenco di schede… e la risposta corretta è al dodicesimo posto. Esiste, è stata trovata, ma resta lontana dai primi risultati mostrati dall'interfaccia.
Bisogna cambiare tutto il motore di ricerca? Non necessariamente. Occorre prima separare due problemi: trovare i documenti utili, poi metterli nell'ordine giusto.
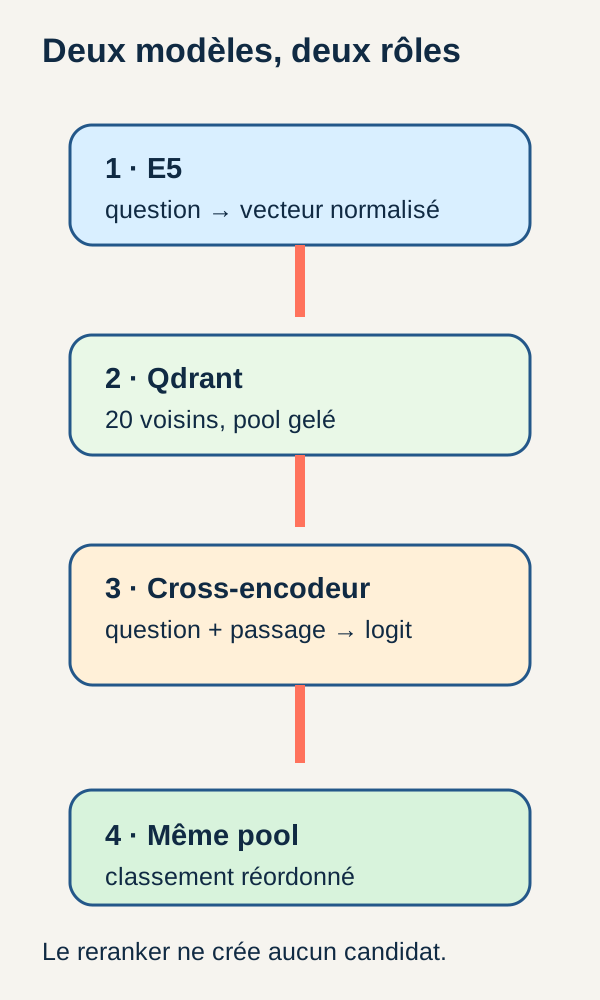
È proprio ciò che sperimenteremo. Un primo modello, E5, prepara una selezione di documenti. Un secondo, chiamato reranker, rilegge ogni candidato insieme alla domanda per proporre una nuova classifica. Misureremo ciò che migliora, ciò che non può correggere e il tempo aggiunto da questa seconda lettura.
La situazione del centro assistenza è un'illustrazione. I risultati presentati più avanti provengono dal corpus fittizio e dal percorso r3 del tutorial; i piccoli esempi di calcolo sono indicati separatamente.
Il download del tutorial eseguibile è disponibile qui: Scaricare il progetto completo del tutorial.
Obiettivo e risultato atteso
Ciò che costruiremo
Il corpus, ossia l'insieme dei documenti in cui cerchiamo, contiene 200 documenti fittizi. È accompagnato da 80 domande: 20 di sviluppo e 60 di test.
Le domande di sviluppo permettono di prendere confidenza con il percorso e di studiarne i comportamenti. Le domande di test servono alla valutazione annunciata. Questa separazione non significa che addestreremo un modello: qui usiamo modelli già addestrati per effettuare calcoli, operazione chiamata inferenza.
Per ogni domanda, la ricerca densa E5 costituisce un pool di 20 candidati. Dietro la parola pool non c'è nulla di misterioso: è l'elenco dei 20 documenti scelti per la fase successiva. Densa indica qui una ricerca basata su vettori numerici appresi, che spiegheremo.
Il reranker bge-reranker-v2-m3 riceve quindi questi candidati. Non esamina di nuovo tutti i 200 documenti: riordina soltanto i 20 documenti già selezionati.
Cosa saprete leggere alla fine
Tre file rendono osservabile l'esperimento. outputs/candidates.json conserva la selezione iniziale; outputs/reranked.json contiene la nuova classifica e i punteggi delle coppie domanda-documento; outputs/evaluation.json raccoglie le misure.
Saprete rispondere a tre domande concrete: i documenti utili erano disponibili nella selezione? La nuova classifica li rende più visibili fra i primi cinque risultati? Quanto tempo aggiuntivo richiede questo miglioramento?
Costruiamo un meccanismo di ricerca e classificazione, non un chatbot che redige una risposta. Potrà fungere da componente di un'altra applicazione, ma la generazione di testo non rientra in questo esperimento.
Cosa serve per seguire
Dovete saper leggere una funzione Python, manipolare elenchi e dizionari, aprire JSON ed eseguire comandi in un terminale. Le nozioni specifiche della ricerca e dei modelli vengono introdotte lungo il percorso.
L'esecuzione richiede Linux x86_64, Docker Compose, un driver NVIDIA e NVIDIA Container Toolkit. Il tutorial è stato verificato con una RTX 3090. Prevedete 8 GiB di VRAM liberi, 12 GiB di RAM disponibili e 25 GiB di spazio disco per il progetto e Docker. La VRAM è la memoria della scheda grafica; non va confusa con la RAM della macchina.
Queste risorse sono previsioni prudenti, non minimi stabiliti sperimentalmente. Il tutorial non annuncia una modalità CPU: manterremo il percorso GPU validato.
Perché due modelli?
E5: rappresentare ciascun testo separatamente
Un embedding è un elenco di numeri calcolato a partire da un testo. Lo si può vedere come le coordinate di un punto: testi che il modello ha imparato ad avvicinare possono risultare vicini in questo spazio.
Qui ogni embedding possiede 384 coordinate, o dimensioni. Non sono 384 categorie definite a mano. Una coordinata non significa da sola «fattura» o «password».
E5 è usato come bi-encoder: trasforma la domanda da un lato e ogni documento dall'altro. Il prefisso query: indica una domanda; passage: indica un testo da ritrovare. Questi prefissi assegnano un ruolo al testo, non lo traducono.
Questa separazione permette di preparare una sola volta i vettori dei 200 documenti per un corpus invariato. Quando arriva una nuova domanda, resta da codificare quella domanda e cercarne i vicini.
Qdrant non è il modello di IA. E5 produce i vettori; Qdrant li memorizza in una raccolta e cerca i vettori vicini a quello della domanda. Il confronto usa qui la similarità coseno, una misura di vicinanza fra direzioni di vettori.
Il risultato è un primo elenco plausibile. Ma la vicinanza in questo spazio non garantisce che un passaggio risponda precisamente alla richiesta.
Il cross-encoder: leggere insieme una domanda e un passaggio
Il secondo modello funziona diversamente. Un cross-encoder riceve una coppia completa: la domanda e il testo di un candidato. Può così calcolare interazioni fra i due testi durante l'elaborazione, invece di confrontare soltanto due rappresentazioni prodotte separatamente.
Prendiamo un esempio inventato per capire la differenza, senza assimilarlo a un risultato del corpus:
Question : « Comment récupérer l’accès à mon compte ? »

Paire A : cette question + une fiche sur le changement d’adresse de courriel
Paire B : cette question + une fiche sur la réinitialisation du mot de passe
Le due schede parlano entrambe di un account. Eppure non descrivono la stessa azione. Il ruolo del cross-encoder è fornire un nuovo segnale per distinguere questi candidati; la sua classifica dovrà poi essere confrontata con le annotazioni, non considerata corretta per principio.
Questa lettura congiunta deve essere ripetuta per ogni coppia. Per la nostra domanda, i 20 candidati producono quindi 20 coppie da valutare. Il codice le tratta in lotti di 4: per un pool completo ciò rappresenta cinque lotti, non soltanto quattro documenti scelti.
Perché non sottoporgli direttamente i 200 documenti? Richiederebbe di calcolare 200 coppie per domanda invece di 20. Il primo livello serve proprio a limitare il lavoro del secondo. È il principio del percorso recupero e poi riclassificazione descritto da Sentence Transformers.
Un punteggio per ordinare, non una probabilità di verità
Il reranker restituisce un logit, cioè un punteggio numerico grezzo. In questo percorso, un punteggio più alto precede un punteggio più basso.
Per esempio, punteggi fittizi di 4,2, 1,4 e -0,6 bastano per ordinare tre candidati. Non significano «420%», «140%» o «una pertinenza negativa». Il numero serve alla classifica, non esprime direttamente una percentuale di affidabilità.
La scheda ufficiale di BGE mostra che si può applicare una funzione sigmoide per riportare questi punteggi fra 0 e 1. Il nostro codice non lo fa. E cambiare scala non basterebbe a dimostrare che un punteggio sia una probabilità correttamente calibrata sui vostri documenti aziendali.
Non cercate quindi di sommare il coseno E5 e il logit BGE. Non hanno lo stesso significato né la stessa scala. In questo tutorial, E5 sceglie i candidati; il punteggio BGE ne determina il nuovo ordine.
Il limite da tenere a mente
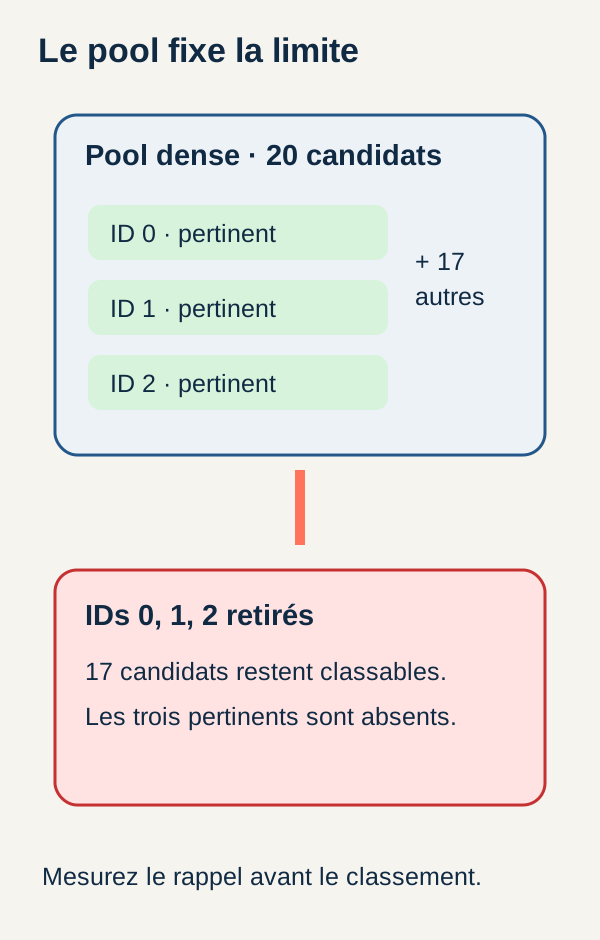
Torniamo alla nostra scheda corretta in dodicesima posizione. Se figura fra i 20 candidati, il reranker può farla risalire. Se è assente da questa selezione, non può ritrovarla.
Registriamo quindi l'elenco prima del reranking: è il pool congelato. Congelato significa qui conservato come riferimento di confronto, non reso tecnicamente impossibile da modificare. Confrontiamo due ordini dello stesso insieme, non due ricerche i cui risultati sarebbero cambiati nel frattempo.
Architettura del percorso
L'elaborazione si svolge in fasi distinte, ciascuna con un ruolo verificabile:
prepareverifica i 200 documenti e le 80 domande.indexcodifica i documenti in 384 dimensioni e li inserisce in una raccolta Qdrant dedicata.retrievecodifica ogni domanda e fissa i suoi 20 vicini inoutputs/candidates.json.rerankcalcola un logit per coppia domanda-documento, in lotti di 4, poi scriveoutputs/reranked.json.evaluatecalcola le metriche sulle domande di test valutabili;exerciserimuove deliberatamente i documenti pertinenti daREF-000per testare il limite del reranker.
Per uno sviluppatore web, i JSON intermedi hanno un ruolo paragonabile a risposte API registrate durante un test: permettono di capire ciò che una fase ha trasmesso alla successiva, invece di guardare soltanto la pagina finale.
Qdrant è temporaneo in questo progetto. Il comando di pulizia docker compose down rimuove l'indice. I modelli acquisiti e gli output restano disponibili: potete rileggere i JSON senza tenere Qdrant attivo, oppure ricostruire l'indice per ripetere le fasi successive.
Questa diversa persistenza è una scelta del tutorial, non una proprietà generale di tutte le distribuzioni Qdrant o Docker.
Leggere il codice centrale prima dei risultati
Gli estratti seguenti mostrano il cuore del meccanismo. Usano oggetti inizializzati altrove nel progetto, come self.model, self.tokenizer o store. Non costituiscono da soli uno script autonomo: per eseguire il percorso completo, usate i file dello ZIP.
1. Trasformare un testo in un vettore E5
Prima di leggere la funzione, chiariamo tre parole che incontrerete.
Il tokenizer suddivide il testo in unità riconosciute dal modello, i token, poi le sostituisce con identificatori numerici. Un token può essere una parola, una parte di parola o un segno: 512 token non significano quindi 512 caratteri, né necessariamente 512 parole.
Per calcolare più testi contemporaneamente, li si riunisce in un lotto, o batch. Poiché non hanno tutti la stessa lunghezza, ai più brevi viene aggiunto il padding, un riempimento tecnico. La maschera di attenzione indica quali posizioni corrispondono al testo e quali a questo riempimento.
Infine, il pooling riunisce le rappresentazioni delle diverse posizioni in un unico vettore per testo. Qui si tratta di una media che ignora il padding. Attenzione ai due termini simili: il pooling produce un vettore; il pool di candidati è un elenco di documenti.
def encode(self, texts, kind):
    if kind not in ("query", "passage") or not texts:
        raise ValueError("Préfixe query/passage et liste non vide requis")

    vectors = []

    for offset in range(0, len(texts), 16):
        batch = self.tokenizer(
            [kind + ": " + text for text in texts[offset:offset + 16]],
            padding=True,
            truncation=False,
            return_tensors="pt",
        )

        if batch["input_ids"].shape[1] > 512:
            raise ValueError("Texte dépassant 512 tokens : découpez le document")

        batch = batch.to("cuda")

        with torch.inference_mode():
            hidden = self.model(**batch).last_hidden_state
            mask = batch["attention_mask"].unsqueeze(-1).bool()
            pooled = hidden.masked_fill(~mask, 0).sum(1) / mask.sum(1)
            normalized = torch.nn.functional.normalize(pooled, p=2, dim=1)

        if not torch.isfinite(normalized).all():
            raise ValueError("Embedding non fini")

        vectors.extend(normalized.cpu().tolist())

    return vectors
Cosa accade in questa funzione?
kind deve valere query oppure passage, e l'elenco dei testi non deve essere vuoto. Il ciclo prende poi al massimo 16 testi alla volta, aggiunge il prefisso corretto e li trasforma in token.
padding=True allinea le lunghezze del lotto. Al contrario, truncation=False vieta di accorciare silenziosamente un input. La larghezza del lotto, batch["input_ids"].shape[1], corrisponde alla sua sequenza più lunga dopo la tokenizzazione e il riempimento. Se supera 512 token, la funzione si ferma prima del calcolo del modello. I prefissi e i token speciali aggiunti dal tokenizer fanno parte di questo input.
batch.to("cuda") sposta i dati di calcolo sulla GPU. Il modello produce poi last_hidden_state: una rappresentazione numerica per ogni posizione di ogni testo. torch.inference_mode() evita di preparare il calcolo dei gradienti, le informazioni necessarie per regolare i parametri durante l'addestramento. Questa modalità non sostituisce da sola l'impostazione del modello in modalità valutazione durante la sua inizializzazione.
Le tre righe che riguardano mask, pooled e normalized sono il cuore della conversione: azzerano le posizioni di padding, sommano le rappresentazioni utili, dividono per il loro numero e poi normalizzano il vettore ottenuto.
Per comprendere la media, immaginiamo soltanto due coordinate e due posizioni utili: [2, 4] e [4, 4]. La loro media è [3, 4]. Una posizione di padding non deve né aggiungere un valore né far passare il divisore da 2 a 3. Questo esempio è un calcolo in miniatura, non una rappresentazione effettivamente prodotta da E5.
La normalizzazione L2 riporta poi la lunghezza del vettore a 1. Per [3, 4], questa lunghezza vale √(3² + 4²) = 5: il vettore diventa dunque [0,6 ; 0,8]. Confrontiamo così direzioni anziché lunghezze arbitrarie. Lo stesso principio si applica alle 384 coordinate del nostro percorso.
Infine, torch.isfinite rifiuta valori infiniti o NaN, che segnala un risultato numerico indefinito. .cpu().tolist() riporta i vettori nella memoria lato CPU sotto forma di elenchi Python utilizzabili dal resto del programma.
La scheda ufficiale di E5 multilingue illustra i prefissi, la media mascherata e la normalizzazione. Serve da complemento concettuale: per riprodurre questo esperimento, mantenete i file e le impostazioni bloccate nello ZIP, in particolare il suo rifiuto esplicito degli input troppo lunghi.
2. Registrare i candidati prima di riclassificarli
A questo punto, i vettori dei documenti sono indicizzati. Per ogni domanda calcoliamo il suo vettore e chiediamo a Qdrant 20 vicini.
store.search(encoder.encode([data["queries"][0]["query"]], "query")[0], 20)

rows = []

for query in data["queries"]:
    start = time.perf_counter()
    candidates = store.search(encoder.encode([query["query"]], "query")[0], 20)
    rows.append(
        {
            **query,
            "candidates": candidates,
            "seconds": {"dense": time.perf_counter() - start},
        }
    )

save("candidates", {"rows": rows})
La prima riga esegue una ricerca di riscaldamento, o warm-up. Avviene prima del ciclo cronometrato. Il suo risultato non viene aggiunto a rows: la prima domanda sarà poi elaborata nuovamente nelle misure normali.
Nel ciclo, il cronometro parte prima della codifica della domanda. La durata seconds.dense include quindi questa codifica e la chiamata di ricerca a Qdrant. Non misura soltanto il tempo impiegato a confrontare vettori nel database.
L'espressione {**query, ...} conserva le informazioni della domanda e aggiunge i candidati e la durata. Alla fine, save scrive il file di riferimento.
Ecco il contratto fra i due modelli: il reranker rileggerà questo elenco registrato. Rilanciare una ricerca con un pool diverso nel mezzo del confronto impedirebbe di isolare l'effetto della riclassificazione.
3. Calcolare un punteggio per ogni coppia
Il reranker non riceve gli embedding E5 per migliorarli. Riprende il testo di ogni candidato e lo associa alla domanda. Gli identificatori servono a ritrovare i documenti e a seguirne la nuova posizione.
def score(self, query, candidates, documents):
    if not candidates:
        return {"ranked": [], "pairs": [], "truncated": False}

    if not isinstance(query, str) or not query.strip():
        raise ValueError("Question non vide requise")

    rank_scores(candidates, [0.] * len(candidates))
    pairs = [[query, documents[identifier]["text"]] for identifier, _ in candidates]
    scores = []
    truncated = False

    for offset in range(0, len(pairs), 4):
        part = pairs[offset:offset + 4]
        lengths = [len(self.tokenizer(a, b)["input_ids"]) for a, b in part]
        truncated |= any(length > 512 for length in lengths)

        batch = self.tokenizer(
            part,
            padding=True,
            truncation=True,
            max_length=512,
            return_tensors="pt",
        ).to("cuda")

        with torch.inference_mode():
            scores.extend(self.model(**batch).logits.view(-1).float().cpu().tolist())

    return {
        "ranked": rank_scores(candidates, scores),
        "truncated": truncated,
        "pairs": [
            {
                "query": query,
                "document_id": identifier,
                "text": documents[identifier]["text"],
                "score": score,
            }
            for (identifier, _), score in zip(candidates, scores)
        ],
    }
Il primo comportamento è un ritorno esplicito su pool vuoto. La funzione restituisce allora una lista classificata vuota, nessuna coppia e truncated: False. Questo ritorno avviene prima del controllo della domanda: con un pool vuoto, questo estratto non richiede quindi che la domanda non sia vuota. Per un pool non vuoto, una domanda non valida genera invece un errore.
rank_scores(candidates, [0.] * len(candidates)) effettua un primo passaggio di convalida dei candidati, in particolare dei loro identificatori. Gli zeri sono provvisori: non sono né i coseni E5 né le predizioni BGE. La funzione ausiliaria completa fa parte dello ZIP; garantisce anche l'ordinamento finale e il rifiuto di risultati di scoring non finiti.
La list comprehension pairs costruisce una coppia per candidato. Il ciclo le tratta poi in lotti di 4. Una prima tokenizzazione esamina le lunghezze; una seconda prepara il lotto inviato su CUDA, con un limite di 512 token.
Il modello produce i logit. view(-1) li presenta come un elenco di punteggi, .float() li converte in numeri in virgola mobile, poi .cpu().tolist() li rende utilizzabili in Python. L'ordinamento finale è decrescente sul punteggio, con l'identificatore come criterio stabile in caso di parità.
Il ritorno contiene due viste complementari: ranked, l'elenco riordinato, e pairs, il dettaglio delle associazioni domanda-documento con testo e punteggio. In questo estratto, pairs segue l'ordine dei candidati in ingresso; per conoscere la nuova classifica bisogna leggere ranked.
Due politiche diverse di fronte a un testo troppo lungo
Il dettaglio merita una pausa, perché le due fasi non reagiscono allo stesso modo.
E5 rifiuta un input di oltre 512 token. Il programma vi chiede di dividere esplicitamente il documento, anziché modificare silenziosamente il materiale della ricerca.
Il reranker accetta di troncare una coppia troppo lunga, ma lo segnala con truncated: True. Il suo limite riguarda l'input combinato: domanda, passaggio e token speciali. Due testi accettabili separatamente per E5 possono quindi formare una coppia troppo lunga per il secondo modello; i loro tokenizer possono anche suddividere diversamente le stesse parole.
Secondo la documentazione Transformers sul troncamento, truncation=True applica la strategia longest_first: i token vengono rimossi dalla sequenza più lunga della coppia finché non si rispetta il limite. Questa impostazione non garantisce quindi che venga accorciato soltanto il passaggio. Qui 512 è il limite scelto dal codice del tutorial, non un'affermazione su tutte le possibili capacità di BGE.
Il booleano truncated accumula l'osservazione sui lotti: diventa vero appena almeno una coppia supera il limite. Non indica né il numero di coppie coinvolte né le esatte posizioni rimosse.
Un'altra importante sfumatura: il campo text conserva il documento originale, non una ricostruzione del testo dopo il troncamento. Gli output permettono di ritrovare la coppia sorgente e il suo punteggio; non provano che il modello abbia elaborato ogni parola del testo conservato. Quando viene segnalato un troncamento, occorre esaminare la tokenizzazione effettiva prima di spiegare un risultato con una frase situata alla fine del documento.
Preparare ed eseguire il tutorial
Posizionarsi nel posto giusto
Scaricate lo ZIP, estraetelo, poi aprite il terminale nella radice del progetto estratto. Tutti i comandi seguenti partono da questa directory. Per eseguirli servono il codice completo, non soltanto gli estratti dell'articolo.
GPU_DEVICE=1 sceglierebbe la seconda scheda; per impostazione predefinita viene usato l'indice 0. Verificate la scelta della GPU nella configurazione del progetto prima dei calcoli.
Il preflight è un controllo preliminare dell'ambiente. Inizializza realmente CUDA in un contenitore e verifica che Docker possa usare la scheda. Un risultato corretto con nvidia-smi sull'host non basta: la scheda può essere accessibile a Linux ma non al contenitore.
NVIDIA Container Toolkit assicura questa esposizione della GPU ai contenitori; la sua guida ufficiale integra i prerequisiti. Il preflight del progetto non installa nulla e non modifica la configurazione del sistema.
Costruire l'ambiente e acquisire i modelli
Eseguite questi cinque comandi nell'ordine indicato. Devono tutti terminare senza errore prima di proseguire.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
setup.sh prepara l'ambiente locale del progetto; build costruisce l'immagine. Il servizio fetch, attivato dal profilo acquisition, acquisisce esplicitamente i modelli. Verifica la dimensione e lo SHA-256 dei file prima della loro rinomina atomica.
Uno SHA-256 è un'impronta calcolata a partire dai byte di un file. Qui confrontarlo con il valore atteso serve a verificare che il modello acquisito corrisponda all'asset previsto. La rinomina atomica consente di assegnare al file il nome finale dopo la convalida, anziché presentare un download parziale come un modello completo. È un controllo d'integrità dei file, non una misura della qualità del modello.
L'ultimo comando esegue la suite pubblica del progetto. Il risultato atteso del percorso validato è 17 test pubblici riusciti. Un errore deve essere compreso prima di continuare: risultati di ricerca apparentemente credibili non compensano un controllo in errore.
Costruire l'indice, recuperare, riclassificare, valutare
Avviate quindi Qdrant ed eseguite le fasi seguenti:
docker compose up -d qdrant
docker compose run --rm --no-deps app -m src.cli prepare
docker compose run --rm --no-deps app -m src.cli index
docker compose run --rm --no-deps app -m src.cli retrieve
docker compose run --rm --no-deps app -m src.cli rerank
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
Dopo prepare, verificate la popolazione annunciata: 200 documenti, 80 domande, di cui 20 di sviluppo e 60 di test.
Dopo index, l'output deve mostrare in particolare documents: 200, dimension: 384, device: "cuda" e points_count: 200. Vogliamo tanti punti indicizzati quanti sono i documenti, con la dimensione prevista.
Dopo retrieve, aprite outputs/candidates.json. Per una domanda, individuate i suoi 20 candidati e il loro ordine iniziale. Sarà il vostro punto di confronto.
Dopo rerank, aprite outputs/reranked.json. Ritrovate la stessa domanda, confrontate gli identificatori in ranked con quelli del pool, poi leggete le coppie, i logit e l'indicatore di troncamento. I documenti non devono cambiare semplicemente perché cambia il loro ordine.
Dopo negatives, i controlli devono confermare il comportamento con pool vuoto, il troncamento segnalato e la raccolta vuota. Un test negativo verifica un limite o un caso particolare provocato volontariamente, non solo il percorso in cui tutto va bene.
Dopo evaluate, outputs/evaluation.json contiene le metriche di riferimento. Vedremo ora come interpretarle.
L'acquisizione e l'inferenza sono separate. Una volta acquisiti i modelli, l'inferenza resta locale e senza rete esterna. Ciò non impedisce all'applicazione di comunicare con Qdrant all'interno del progetto Docker.
Definire le misure prima di guardarle
Che cos'è un documento «pertinente»?
Per valutare una ricerca, bisogna sapere ciò che avrebbe dovuto ritrovare. Le annotazioni di pertinenza forniscono questo riferimento: per ogni domanda indicano i documenti considerati utili nell'esperimento.
Non è il punteggio del modello a creare questa verità di riferimento. Altrimenti chiederemmo al motore di valutare se stesso. Qui le annotazioni sono quelle di un corpus didattico fittizio; non sostituiscono una validazione aziendale indipendente su documenti reali.
Perché 80, 60 e 48 non indicano la stessa cosa
Le 80 domande comprendono 20 domande di sviluppo e 60 domande di test. Fra queste 60 domande di test, 48 possiedono almeno un documento pertinente nelle annotazioni; le 12 altre sono fuori corpus.
Le metriche di pertinenza riguardano le 48 domande valutabili. Le latenze pubblicate più avanti riguardano le 60 domande di test, incluse le 12 fuori corpus.
Perché separare queste ultime? Per una domanda senza documento pertinente, il recall avrebbe un denominatore nullo e la classifica ideale di nDCG non avrebbe alcun guadagno. Attribuirle arbitrariamente uno zero mescolerebbe due problemi: classificare male una risposta disponibile e cercare in un corpus che non contiene la risposta attesa.
Queste 12 domande non scompaiono comunque dall'osservazione: ricevono dei candidati. Il fatto di ottenere un elenco, anche classificato, non prova quindi che una scheda risponda alla domanda. Il percorso non dimostra la capacità di decidere automaticamente «nessuna risposta disponibile».
Su schermo piccolo, scorrete il riquadro orizzontalmente.
| Misura | Cosa osserva |
|---|---|
| Recall@20 | Quota di documenti pertinenti presenti nel pool denso di 20. Limita ciò che il reranker può fare. |
| MRR@5 | Posizione del primo documento pertinente nelle prime cinque posizioni. |
| nDCG@5 | Posizione di tutti i documenti pertinenti nelle prime cinque posizioni, con un peso decrescente in base alla posizione. |
| Latenza densa | Codifica della domanda e ricerca Qdrant. |
| Latenza reranker | Costo aggiuntivo dello scoring delle 20 coppie, escluso il caricamento del modello. |
Recall@20: i documenti utili sono disponibili?
Il recall, o Recall, misura una copertura. Per una domanda con almeno un documento pertinente:
Recall@20 = numero di documenti pertinenti nei 20 candidati / numero totale di documenti pertinenti attesi.
Con tre documenti pertinenti, trovarne due dà 2 / 3 ≈ 0,667. Trovarli tutti dà 1, anche se sono alle posizioni 12, 16 e 20. Il recall@20 non dice quindi se le prime righe dell'interfaccia sono buone; dice ciò che il reranker ha a disposizione.
Se il reranker si limita a permutare questi stessi 20 candidati, questo recall resta identico. Può migliorare la loro presenza nella top 5, ma non aggiungere un documento al pool di 20.
MRR@5: dove appare la prima risposta utile?
Per una domanda, cerchiamo la posizione del primo documento pertinente fra i primi cinque. Il suo rango reciproco, qui indicato come RR@5, vale l'inverso di questa posizione: rango 1 → 1; rango 2 → 1 / 2 = 0,5; rango 5 → 1 / 5 = 0,2.
Se non c'è alcun documento pertinente nei primi cinque, RR@5 vale 0, anche se un documento utile arriva alla posizione 6.
L'MRR, per Mean Reciprocal Rank, è la media di questi valori sulle domande valutabili. Non è l'inverso del rango medio. Per esempio, due domande i cui primi pertinenti sono alle posizioni 1 e 5 danno (1 + 0,2) / 2 = 0,6, e non 1 / 3.
Questa metrica risponde bene a «quanto rapidamente si incontra una prima risposta utile?». Non descrive la posizione degli altri documenti pertinenti.
nDCG@5: più risposte utili sono ben posizionate?
Il nome è più impressionante dell'idea. nDCG significa normalized Discounted Cumulative Gain: si sommano guadagni di pertinenza, dando meno peso alle posizioni lontane, poi li si confronta con la migliore classifica possibile.
Per capire il calcolo con annotazioni binarie, un documento pertinente alla posizione r apporta 1 / log2(r + 1); un documento non pertinente apporta 0. log2 indica il logaritmo in base 2. Qui si considerano soltanto le prime cinque posizioni.
Con un solo pertinente, posto al rango 2, il contributo vale 1 / log2(3) ≈ 0,631. La classifica ideale lo porrebbe al rango 1, con un guadagno di 1: nDCG@5 vale quindi anch'esso circa 0,631.
Con più pertinenti, non basta sommare i loro contributi: bisogna anche dividere per il guadagno della classifica ideale. È questa normalizzazione che permette di leggere 1 come il miglior risultato possibile secondo le annotazioni e il taglio considerato.
Un esempio ripetibile a mano
La tabella seguente è un esempio didattico, non un output delle riproduzioni r3. Immaginiamo una domanda con tre documenti pertinenti, tutti presenti in un pool di 20. Cambiamo soltanto le loro posizioni.
Su schermo piccolo, scorrete il riquadro orizzontalmente.
| Posizioni dei tre pertinenti | Recall@20 | RR@5 per questa domanda | nDCG@5 |
|---|---|---|---|
| Ranghi 2, 4 e 8 | 1,0000 | 0,5000 | ≈ 0,4982 |
| Ranghi 1, 8 e 9 | 1,0000 | 1,0000 | ≈ 0,4693 |
| Ranghi 1, 2 e 3 | 1,0000 | 1,0000 | 1,0000 |
Per la prima riga, soltanto i ranghi 2 e 4 contribuiscono al guadagno top-5:
DCG@5 = 1 / log2(3) + 1 / log2(5) ≈ 1,0616.
Con tre pertinenti, la classifica ideale li porrebbe ai ranghi 1, 2 e 3:
IDCG@5 = 1 + 1 / log2(3) + 1 / log2(4) ≈ 2,1309.
Il risultato normalizzato vale quindi 1,0616 / 2,1309 ≈ 0,4982.
Confrontate ora le prime due righe. Il rango reciproco migliora perché una risposta utile arriva in testa, ma nDCG diminuisce perché una sola risposta utile rimane nei primi cinque risultati. Due metriche possono evolvere in direzioni diverse senza che il calcolo sia incoerente. Osservano aspetti diversi della classifica.
Il recall del pool resta uguale a 1 in tutti e tre i casi. Fissa l'insieme dei documenti disponibili; non riassume da solo la qualità del loro ordine.
Latenza: quale tempo si cronometra?
La latenza è il tempo trascorso per eseguire un'operazione. In questo tutorial, la latenza densa include la codifica della domanda e la ricerca Qdrant. La latenza del reranker è un costo aggiuntivo per elaborare le 20 coppie; il caricamento del modello ne è escluso.
Le misure r3 vengono rilevate dopo il riscaldamento. Non descrivono né il primo avvio completo, né il download dei modelli, né il ritardo totale di una futura pagina web con rete, autenticazione e visualizzazione.
Risultati R3 osservati
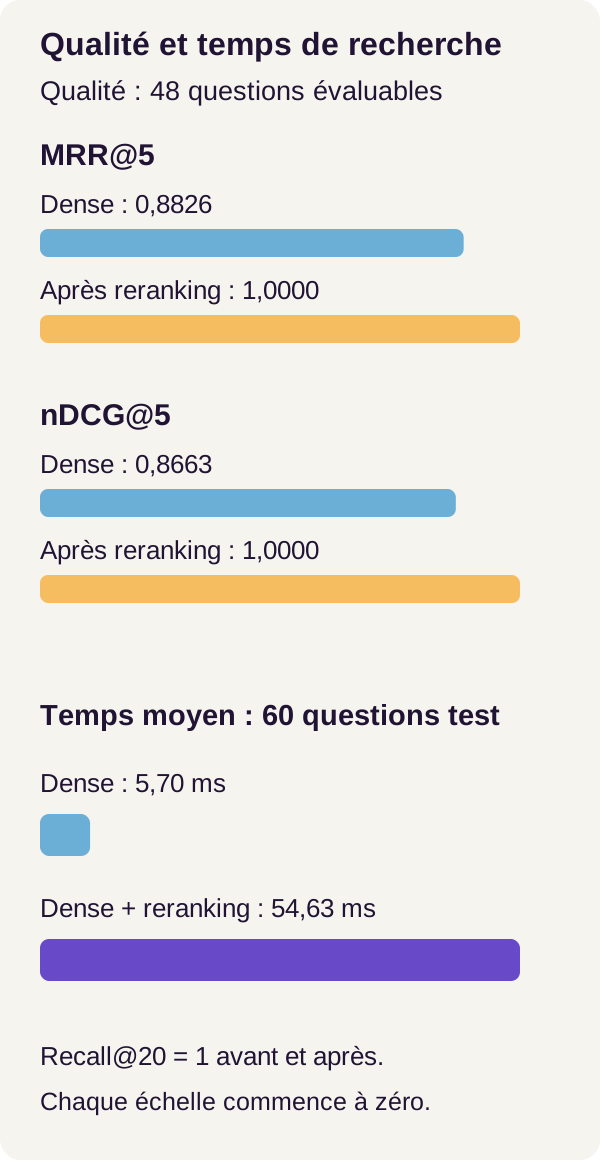
Due riproduzioni del percorso r3 hanno prodotto le stesse metriche di qualità. Le latenze qui sotto sono quelle della seconda riproduzione, mediate sulle 60 domande di test, dopo il warm-up e senza il caricamento dei modelli.
La qualità della classifica
Su schermo piccolo, scorrete il riquadro orizzontalmente.
| Percorso | MRR@5 | nDCG@5 | Recall@20 | Popolazione |
|---|---|---|---|---|
| Candidati densi | 0,8826 | 0,8663 | 1,0000 | 48 valutabili |
| Dopo il reranking | 1,0000 | 1,0000 | 1,0000 | 48 valutabili |
Il primo numero da leggere è il recall@20: 1,0000 in entrambe le righe. Tutti i documenti pertinenti delle 48 domande valutabili erano già presenti nei pool densi. Il reranker non migliora quindi la copertura: a questa profondità di ricerca era già completa.
Il miglioramento riguarda le posizioni. MRR@5 passa da 0,8826 a 1,0000, e nDCG@5 da 0,8663 a 1,0000. Il risultato riportato è ottimale per queste metriche su questo set valutato; non dimostra che il modello sarà perfetto su altre domande.
Non leggete nemmeno MRR@5 = 0,8826 come «l'88,26% dei documenti è corretto». È una media di ranghi reciproci. Anche nDCG misura una classifica, non una probabilità di verità.
Il tempo aggiuntivo
Su schermo piccolo, scorrete il riquadro orizzontalmente.
| Tempo medio | Millisecondi |
|---|---|
| Denso | 5,70 ms |
| Reranking aggiuntivo | 48,92 ms |
| Totale | 54,63 ms |
La riclassificazione aggiunge qui in media 48,92 ms a una ricerca densa di 5,70 ms. Il totale riportato raggiunge 54,63 ms, ossia circa 54,63 / 5,70 ≈ 9,6 volte il tempo del solo percorso denso.
Le durate pubblicate sono conservate con due decimali. La loro somma visibile dà 54,62 ms, contro 54,63 ms per il totale riportato; questa differenza di 0,01 ms è compatibile con arrotondamenti indipendenti. Per confermarne l'origine sarebbero necessari i valori non arrotondati: non va interpretata come un costo aggiuntivo misurato separatamente.
Il ragionamento corretto non è quindi né «49 ms sono necessariamente trascurabili», né «quasi dieci volte più lento è necessariamente inutilizzabile». La domanda è: il cambiamento di classifica giustifica questo tempo aggiuntivo nell'applicazione prevista?
Questi risultati descrivono un corpus fittizio, una postazione e una configurazione dati. Non costituiscono una promessa di guadagno aziendale, un test di carico o una stima delle prestazioni del vostro futuro servizio.
Cosa abbiamo imparato
Recuperare e riclassificare sono due operazioni diverse
E5 e Qdrant costituiscono un elenco di candidati. Il cross-encoder apporta un confronto più costoso fra la domanda e ciascuno di questi candidati. Può modificarne l'ordine, ma non ritrovare un documento rimasto fuori dal pool.
Prima di accusare il reranker di una risposta sbagliata, guardate quindi l'elenco in ingresso. Una scheda assente e una scheda mal classificata non richiedono la stessa diagnosi.
Il punteggio di un modello e una metrica di valutazione non sono la stessa cosa
Il coseno E5 e il logit BGE servono a produrre classifiche. Recall, MRR e nDCG servono a confrontare queste classifiche con annotazioni note. Un logit alto non sostituisce una valutazione, e un buon MRR non significa che tutti i risultati siano utili.
Un primo risultato non è una prova di risposta
Anche le domande fuori corpus ricevono candidati. Il miglior elemento di un elenco può quindi essere semplicemente quello meno distante da una richiesta cui nessun documento risponde. Saper rifiutare una ricerca senza risposta è un problema distinto, che i punteggi perfetti sulle 48 domande valutabili non risolvono.
La qualità qui ha un costo misurato
In questo esperimento, la top-5 migliora e il tempo totale aumenta. La dimensione del pool, il modello, la lunghezza dei testi e l'hardware fanno parte del compromesso da studiare. Nulla consente di trasferire automaticamente i 54,63 ms a un altro contesto.
Esercizio: prevedere, modificare, eseguire, osservare, spiegare
Prevedere prima di eseguire
Per REF-000, i documenti pertinenti sono gli identificatori 0, 1 e 2. Figurano nel pool di riferimento.
Li rimuoveremo prima del reranking. Annotate la vostra previsione: resterà un documento pertinente da classificare? Un modello può riportare in testa un identificatore che non gli viene più trasmesso? Quale recall avrà il pool modificato per questa domanda?
Modificare ed eseguire
Non modificate il codice per questo esercizio. Il comando fornito applica precisamente questa modifica al pool congelato della prima domanda:
docker compose run --rm --no-deps app -m src.cli exercise
Osservare gli output
In outputs/exercise.json, verificate removed_relevant: [0, 1, 2]. Il pool deve conservare 17 candidati, e nessuno dei tre identificatori rimossi deve ricomparire in ranked.
Non confondete i 17 candidati con i 17 test pubblici: il primo numero deriva da 20 - 3, il secondo indica la suite di test del progetto.
Spiegare ciò che è accaduto
Il cross-encoder può preferire il documento 3 fra i candidati rimasti, ma non può classificare un documento assente. Per questa domanda, nessuno dei tre pertinenti attesi resta nel pool modificato: il suo recall è quindi nullo, qualunque sia la qualità dell'ordinamento degli altri 17 documenti.
Questo non trasforma REF-000 in una domanda fuori corpus: le sue risposte esistono ancora nel corpus e nelle annotazioni. Abbiamo provocato un fallimento del recupero, non eliminato l'esistenza di una risposta attesa.
Aumentare il pool o migliorare il recupero sono piste da sperimentare separatamente. Richiedono nuove misure di copertura, di classifica top-5 e di latenza; non sono miglioramenti già dimostrati da questo esercizio.
La vostra esperienza, distinta dall'esercizio
L'esercizio precedente testava un limite preciso. Per esplorare il compromesso qualità-latenza, conservate prima gli output di riferimento, poi lavorate in una copia del progetto. I risultati di questa variante non fanno parte delle riproduzioni r3 presentate qui.
Una variabile interessante è il numero di vicini richiesti a Qdrant. Per esempio, potete confrontare un pool più piccolo con il pool di riferimento di 20, senza cambiare contemporaneamente documenti, domande e reranker. Il codice visibile usa il valore 20 nella ricerca di riscaldamento e nel ciclo misurato: assicuratevi che la variante resti coerente, così come gli eventuali controlli del programma completo.
Prima di eseguire, scrivete due ipotesi separate: ciò che vi aspettate sulla presenza dei pertinenti e ciò che vi aspettate sul tempo di elaborazione. Un pool ridotto rimuove coppie da valutare, ma può anche escludere un documento utile. Un pool più grande fornisce più candidati; non garantisce una migliore classifica finale.
Ripetete retrieve, rerank e evaluate con i comandi già presentati. Se la modifica tocca un file copiato nell'immagine Docker, ricostruite l'immagine secondo il montaggio del progetto: cambiare un file sull'host non garantisce che il contenitore esegua questa nuova versione.
Confrontate il numero di candidati, il recall del pool, MRR@5, nDCG@5 e i tempi denso, reranker e totale. Annotate anche l'eventuale comparsa di troncamenti. Se cambiate la profondità di recupero, indicate questa profondità nel bilancio: un recall misurato su un pool di 10 non è, con un semplice cambio di nome, il recall@20 di riferimento.
Non sostituite i vecchi risultati con i nuovi senza conservarne la configurazione. Il confronto deve rendere visibile ciò che è cambiato. E mantenete le domande di sviluppo per esplorare le impostazioni, invece di scegliere una configurazione solo perché massimizza il set di test.
Limiti per una messa in produzione
Dati controllati, non una validazione aziendale
Il corpus e le domande sono fittizi. Le 48 domande valutabili e le loro annotazioni non sostituiscono né query rappresentative dei vostri utenti né un'analisi degli errori su documenti reali. Un risultato perfetto su questo set non convalida una ricerca generale.
Occorre in particolare trattare separatamente le richieste senza risposta nel corpus. Una soglia sul punteggio BGE sarebbe una nuova regola da valutare, non una capacità di astensione già validata da questo percorso.
Risorse osservate con limiti
Il tutorial è stato testato su una postazione dotata di RTX 3090. Non annuncia né una modalità CPU né un motore di produzione. Le previsioni hardware restano prudenti, senza uno studio del minimo necessario.
La VRAM è stata campionata circa una volta al secondo: un picco breve può cadere fra due rilevazioni. Le cache Docker erano disponibili, e le variazioni dello spazio disco non sono attribuibili soltanto al tutorial. Una media di latenza su questa macchina non informa da sola sui ritardi sotto concorrenza o sulle query più lente.
Un'architettura da completare secondo l'applicazione
Scegliete la dimensione del pool e il budget di latenza in base a query rappresentative. Monitorate le coppie lunghe e i loro troncamenti, conservate le versioni del corpus, dei modelli e delle metriche, poi misurate il recupero prima di attribuire un cambiamento al reranker.
In un'applicazione documentale con diritti di accesso, il perimetro autorizzato deve essere rispettato anche prima di trasmettere i testi alla riclassificazione. I filtri Qdrant sono un componente tecnico per limitare i candidati; la loro sola presenza non costituisce una politica di autorizzazione completa.
La sicurezza del contenitore, l'acquisizione bloccata e i limiti di distribuzione sono documentati nell'archivio. Devono essere letti prima di un adattamento; non trasformano il tutorial in un servizio pronto per la produzione.
Risoluzione dei problemi e pulizia
Il preflight fallisce su CUDA. Verificate il driver NVIDIA, NVIDIA Container Toolkit e la scheda scelta da GPU_DEVICE, poi rilanciate il preflight. Non effettua alcuna installazione. Una scheda rilevata sull'host non basta se non è esposta al contenitore.
Qdrant non è disponibile. Rilanciate docker compose up -d qdrant prima di index. Se l'errore persiste, consultate i log Docker di questo progetto invece di proseguire con una ricerca incompleta.
E5 rifiuta un documento di oltre 512 token. È il comportamento previsto: dividete esplicitamente il documento. Se questa divisione cambia le unità indicizzate, gli identificatori o le annotazioni, avete un nuovo esperimento da ricostruire, non la riproduzione invariata del corpus r3.
Il reranker segnala un troncamento. Rileggete la coppia interessata e la sua lunghezza tokenizzata. L'indicatore segnala un accorciamento senza conservare da solo i token rimossi. La presenza del testo completo in pairs non significa che il modello l'abbia letto interamente.
Le durate variano molto. Non eseguite due benchmark contemporaneamente sulla stessa GPU. Verificate anche di confrontare lo stesso pool e lo stesso perimetro di cronometraggio.
Quando avete conservato le osservazioni, terminate dalla radice del progetto con:
docker compose down
Questo comando rimuove i servizi del progetto e il suo indice Qdrant temporaneo. I modelli e gli output restano disponibili. Per ripetere una ricerca dopo questa pulizia, riavviate Qdrant e ricostruite l'indice prima del recupero.
Sintesi
Una ricerca densa risponde a «quali documenti considerare?». Un reranker risponde a «in quale ordine presentare questi documenti?». Il secondo può migliorare i primi risultati, ma non corregge l'assenza di un passaggio dal pool.
Nel percorso r3, tutti i pertinenti erano già disponibili fra i 20 candidati: il recall resta a 1,0000, mentre MRR@5 e nDCG@5 raggiungono 1,0000 dopo la riclassificazione. Questo miglioramento si accompagna a un tempo totale medio riportato di 54,63 ms sulla postazione testata.
Il risultato più utile non è soltanto questa tabella. È il metodo per comprenderla: congelare i candidati, leggere gli elenchi prima delle medie, separare le domande fuori corpus e misurare il costo aggiuntivo. Potrete riprendere questo approccio sui vostri dati senza confondere un ordinamento migliore con una migliore copertura documentale.
Per approfondire
La scheda ufficiale del reranker BGE presenta lo scoring delle coppie e i logit. La scheda di E5 multilingue mostra i prefissi, il pooling mascherato e la normalizzazione degli embedding.
Per collocare questi componenti in un'architettura, consultate il percorso Retrieve & Re-Rank di Sentence Transformers. La sua documentazione sulla valutazione dei cross-encoder evidenzia anche una differenza importante fra valutare soltanto i candidati recuperati e reintrodurre artificialmente tutti i pertinenti. Il nostro confronto si basa sul pool denso registrato, senza aggiunta di documenti da parte del reranker.
La documentazione Transformers su padding e troncamento aiuta a comprendere il trattamento delle coppie lunghe. I filtri Qdrant offrono una pista per limitare la ricerca a un perimetro documentale.
Questi riferimenti spiegano i meccanismi; non sostituiscono il codice, i modelli e le versioni dello ZIP per riprodurre i risultati presentati. Gli esempi didattici di questo articolo illustrano i calcoli, mentre le tabelle «Risultati R3 osservati» riportano le misure delle due riproduzioni del tutorial.