





Está desarrollando el centro de ayuda de una aplicación web. Un usuario hace una pregunta, el buscador devuelve una lista de fichas… y la respuesta correcta aparece en duodécima posición. Existe y se ha recuperado, pero queda lejos de los primeros resultados que muestra la interfaz.
¿Hace falta cambiar todo el buscador? No necesariamente. Primero hay que separar dos problemas: recuperar los documentos útiles y colocarlos en el orden adecuado.
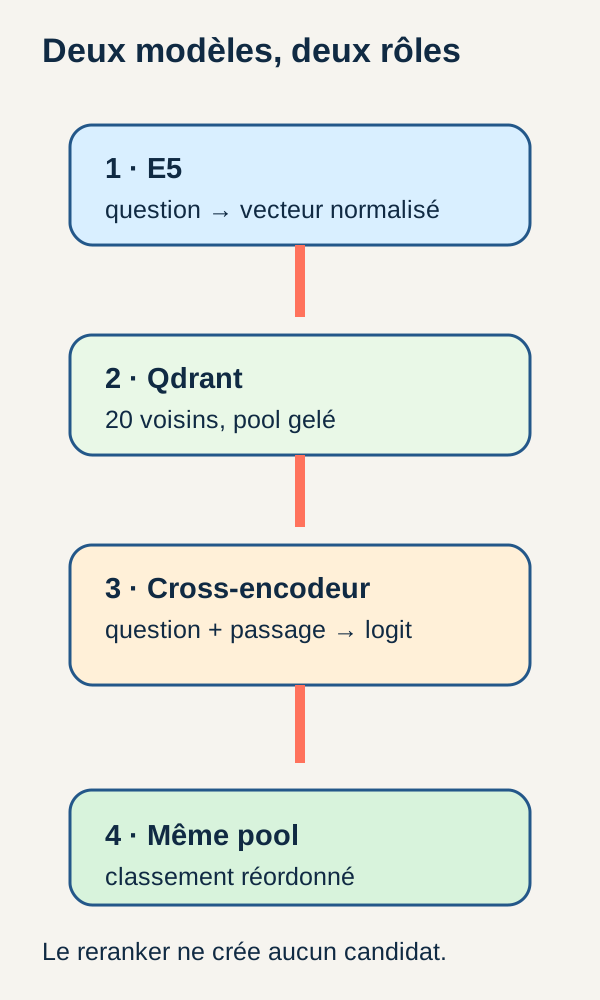
Eso es precisamente lo que vamos a experimentar. Un primer modelo, E5, prepara una selección de documentos. Un segundo, llamado reranker, vuelve a leer cada candidato junto con la pregunta para proponer una nueva clasificación. Mediremos qué mejora, qué no puede corregir y cuánto tiempo añade esta segunda lectura.
La situación del centro de ayuda es una ilustración. Los resultados presentados más adelante proceden del corpus ficticio y del recorrido r3 del tutorial; los pequeños ejemplos de cálculo se señalan por separado.
El tutorial ejecutable está disponible aquí: Descargar el proyecto completo del tutorial.
Objetivo y resultado esperado
Qué vamos a construir
El corpus, es decir, el conjunto de documentos en el que buscamos, contiene 200 documentos ficticios. Lo acompañan 80 preguntas: 20 de desarrollo y 60 de prueba.
Las preguntas de desarrollo permiten familiarizarse con el recorrido y estudiar su comportamiento. Las preguntas de prueba sirven para la evaluación anunciada. Esta separación no significa que vayamos a entrenar un modelo: aquí utilizamos modelos ya entrenados para realizar cálculos, lo que se denomina inferencia.
Para cada pregunta, la búsqueda densa E5 forma un conjunto de 20 candidatos, o pool. Este término no tiene nada de misterioso: es la lista de los 20 documentos seleccionados para la siguiente etapa. Densa designa aquí una búsqueda basada en vectores numéricos aprendidos, que explicaremos a continuación.
El reranker bge-reranker-v2-m3 recibe después esos candidatos. No vuelve a recorrer los 200 documentos: solo reordena los 20 documentos ya seleccionados.
Qué sabrá interpretar al terminar
Tres archivos permiten observar el experimento. outputs/candidates.json conserva la selección inicial; outputs/reranked.json contiene la nueva clasificación y las puntuaciones de los pares pregunta-documento; outputs/evaluation.json reúne las mediciones.
Podrá responder a tres preguntas concretas: ¿estaban disponibles los documentos útiles en la selección? ¿La nueva clasificación los hace más visibles entre los cinco primeros resultados? ¿Cuánto tiempo adicional requiere esta mejora?
Construimos un mecanismo de búsqueda y clasificación, no un chatbot que redacta una respuesta. Podrá servir como componente de otra aplicación, pero la generación de texto no forma parte de este experimento.
Qué necesita para seguir el tutorial
Debe saber leer una función Python, manejar listas y diccionarios, abrir JSON y ejecutar comandos en una terminal. Los conceptos propios de la búsqueda y de los modelos se introducen a lo largo del recorrido.
La ejecución requiere Linux x86_64, Docker Compose, un controlador NVIDIA y NVIDIA Container Toolkit. El tutorial se ha verificado con una RTX 3090. Reserve 8 GiB de VRAM libres, 12 GiB de RAM disponibles y 25 GiB de disco para el proyecto y Docker. La VRAM es la memoria de la tarjeta gráfica; no es lo mismo que la RAM del equipo.
Estos recursos son previsiones prudentes, no mínimos establecidos experimentalmente. El tutorial no anuncia un modo CPU: mantendremos el recorrido GPU validado.
¿Por qué dos modelos?
E5: representar cada texto por separado
Un embedding es una lista de números calculada a partir de un texto. Puede imaginarlo como las coordenadas de un punto: los textos que el modelo ha aprendido a relacionar pueden quedar próximos en ese espacio.
Aquí, cada embedding tiene 384 coordenadas, o dimensiones. No son 384 categorías que hayamos definido a mano. Una coordenada, por sí sola, no significa «factura» ni «contraseña».
E5 se utiliza como bi-encoder: transforma la pregunta por un lado y cada documento por otro. El prefijo query: indica una pregunta; passage: indica un texto que se debe recuperar. Estos prefijos asignan un papel al texto, no lo traducen.
Esta separación permite preparar una vez los vectores de los 200 documentos mientras el corpus no cambie. Cuando llega una nueva pregunta, solo queda codificarla y buscar sus vecinos.
Qdrant no es el modelo de IA. E5 produce los vectores; Qdrant los almacena en una colección y busca vectores próximos al de la pregunta. La comparación utiliza aquí la similitud coseno, una medida de proximidad entre las direcciones de los vectores.
El resultado es una primera lista plausible. Sin embargo, la proximidad en este espacio no garantiza que un pasaje responda con precisión a la solicitud.
El codificador cruzado: leer juntos una pregunta y un pasaje
El segundo modelo funciona de otra manera. Un cross-encoder, o codificador cruzado, recibe un par completo: la pregunta y el texto de un candidato. Así puede calcular interacciones entre ambos textos durante el procesamiento, en lugar de comparar únicamente dos representaciones producidas por separado.
Veamos un ejemplo inventado para entender la diferencia, sin confundirlo con una salida del corpus:
Question : « Comment récupérer l’accès à mon compte ? »

Paire A : cette question + une fiche sur le changement d’adresse de courriel
Paire B : cette question + une fiche sur la réinitialisation du mot de passe
Ambas fichas hablan de una cuenta. Sin embargo, no describen la misma acción. La función del codificador cruzado es aportar una nueva señal para distinguir esos candidatos; después habrá que contrastar su clasificación con las anotaciones, no darla por correcta de antemano.
Esta lectura conjunta debe repetirse para cada par. Para nuestra pregunta, los 20 candidatos dan 20 pares que evaluar. El código los procesa en lotes de 4: son cinco lotes para un conjunto completo, no solo cuatro documentos seleccionados.
¿Por qué no enviarle directamente los 200 documentos? Habría que calcular 200 pares por pregunta en lugar de 20. La primera etapa sirve precisamente para limitar el trabajo de la segunda. Es el principio del recorrido de recuperación y reclasificación descrito por Sentence Transformers.
Una puntuación para ordenar, no una probabilidad de verdad
El reranker devuelve un logit, es decir, una puntuación numérica bruta. En este recorrido, una puntuación más alta se coloca por delante de una más baja.
Por ejemplo, unas puntuaciones ficticias de 4,2, 1,4 y -0,6 bastan para ordenar tres candidatos. No significan «420 %», «140 %» ni «relevancia negativa». El número sirve para clasificar, no para expresar directamente un porcentaje de fiabilidad.
La ficha oficial de BGE muestra que puede aplicarse una función sigmoide para situar esas puntuaciones entre 0 y 1. Nuestro código no lo hace. Además, cambiar la escala no demostraría que una puntuación sea una probabilidad bien calibrada para sus documentos de negocio.
Por tanto, no intente sumar el coseno E5 y el logit BGE. No tienen el mismo significado ni la misma escala. En este tutorial, E5 elige los candidatos; la puntuación BGE determina su nuevo orden.
La limitación que debe recordar
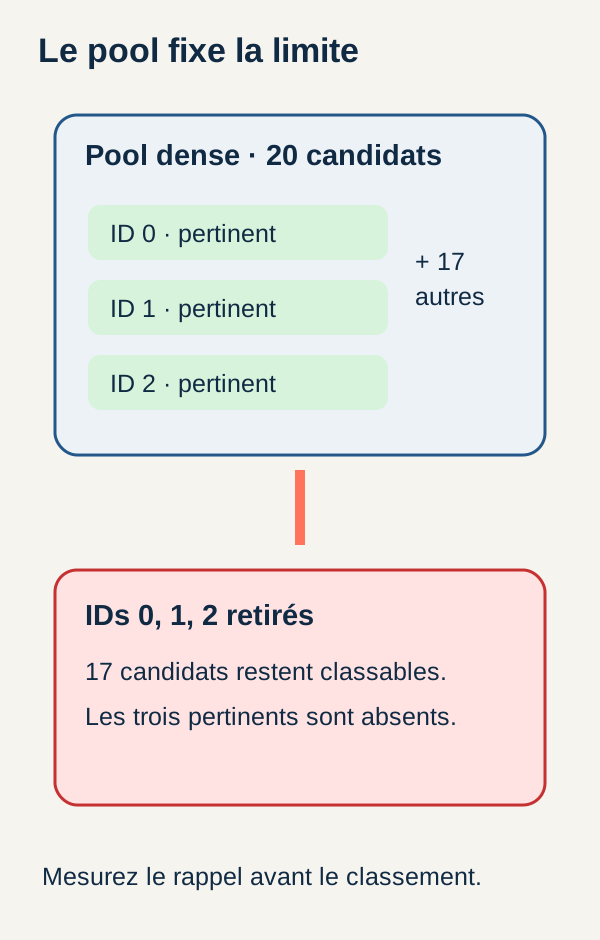
Volvamos a nuestra ficha correcta en duodécima posición. Si figura entre los 20 candidatos, el reranker puede hacerla subir. Si no está en esa selección, no puede recuperarla.
Por eso guardamos la lista antes de reclasificarla: es el conjunto congelado, o pool congelado. Aquí, congelado significa conservado como referencia de comparación, no técnicamente imposible de modificar. Comparamos dos órdenes del mismo conjunto, no dos búsquedas cuyos resultados hayan cambiado entre tanto.
Arquitectura del recorrido
El procesamiento se divide en etapas, cada una con una función verificable:
prepareverifica los 200 documentos y las 80 preguntas.indexcodifica los documentos en 384 dimensiones y los almacena en una colección Qdrant dedicada.retrievecodifica cada pregunta y fija sus 20 vecinos enoutputs/candidates.json.rerankcalcula un logit por par pregunta-documento, en lotes de 4, y escribeoutputs/reranked.json.evaluatecalcula las métricas de las preguntas de prueba evaluables;exerciseelimina deliberadamente los documentos relevantes deREF-000para comprobar la limitación del reranker.
Para un desarrollador web, los JSON intermedios desempeñan un papel parecido al de las respuestas de API guardadas durante una prueba: permiten entender qué ha transmitido una etapa a la siguiente, en lugar de mirar únicamente la página final.
Qdrant es temporal en este proyecto. El comando de limpieza docker compose down elimina el índice. Los modelos adquiridos y las salidas siguen disponibles: puede releer los JSON sin mantener Qdrant activo o reconstruir el índice para repetir las etapas posteriores.
Esta diferencia de persistencia es una decisión del tutorial, no una propiedad general de todos los despliegues de Qdrant o Docker.
Leer el código central antes de los resultados
Los fragmentos siguientes muestran el núcleo del mecanismo. Utilizan objetos inicializados en otras partes del proyecto, como self.model, self.tokenizer o store. Por sí solos no forman un script autónomo: para ejecutar el recorrido completo, utilice los archivos del ZIP.
1. Transformar un texto en un vector E5
Antes de leer la función, aclaremos tres términos que aparecerán.
El tokenizador divide el texto en unidades reconocidas por el modelo, los tokens, y después las sustituye por identificadores numéricos. Un token puede ser una palabra, parte de ella o un signo: 512 tokens no significan 512 caracteres ni necesariamente 512 palabras.
Para calcular varios textos a la vez, se agrupan en un lote, o batch. Como no tienen la misma longitud, los más cortos reciben padding, un relleno técnico. La máscara de atención indica qué posiciones corresponden al texto y cuáles a ese relleno.
Por último, el pooling reúne las representaciones de las distintas posiciones en un único vector por texto. Aquí se utiliza una media que ignora el padding. No confunda los dos términos parecidos: el pooling produce un vector; el pool de candidatos es una lista de documentos.
def encode(self, texts, kind):
    if kind not in ("query", "passage") or not texts:
        raise ValueError("Préfixe query/passage et liste non vide requis")

    vectors = []

    for offset in range(0, len(texts), 16):
        batch = self.tokenizer(
            [kind + ": " + text for text in texts[offset:offset + 16]],
            padding=True,
            truncation=False,
            return_tensors="pt",
        )

        if batch["input_ids"].shape[1] > 512:
            raise ValueError("Texte dépassant 512 tokens : découpez le document")

        batch = batch.to("cuda")

        with torch.inference_mode():
            hidden = self.model(**batch).last_hidden_state
            mask = batch["attention_mask"].unsqueeze(-1).bool()
            pooled = hidden.masked_fill(~mask, 0).sum(1) / mask.sum(1)
            normalized = torch.nn.functional.normalize(pooled, p=2, dim=1)

        if not torch.isfinite(normalized).all():
            raise ValueError("Embedding non fini")

        vectors.extend(normalized.cpu().tolist())

    return vectors
¿Qué ocurre en esta función?
kind debe valer query o passage, y la lista de textos no debe estar vacía. El bucle toma después un máximo de 16 textos a la vez, añade el prefijo adecuado y los tokeniza.
padding=True iguala las longitudes del lote. En cambio, truncation=False impide acortar una entrada silenciosamente. La anchura del lote, batch["input_ids"].shape[1], corresponde a su secuencia más larga tras la tokenización y el relleno. Si supera los 512 tokens, la función se detiene antes del cálculo del modelo. Los prefijos y los tokens especiales añadidos por el tokenizador forman parte de esa entrada.
batch.to("cuda") mueve los datos de cálculo a la GPU. El modelo produce después last_hidden_state: una representación numérica para cada posición de cada texto. torch.inference_mode() evita preparar el cálculo de gradientes, la información necesaria para ajustar los parámetros durante el entrenamiento. Por sí solo, este modo no sustituye la activación del modo de evaluación durante la inicialización del modelo.
Las tres líneas relacionadas con mask, pooled y normalized son el núcleo de la conversión: ponen a cero las posiciones de padding, suman las representaciones útiles, dividen por su número y normalizan el vector obtenido.
Para entender la media, imaginemos solo dos coordenadas y dos posiciones útiles: [2, 4] y [4, 4]. Su media es [3, 4]. Una posición de padding no debe añadir ningún valor ni aumentar el divisor de 2 a 3. Es un cálculo en miniatura, no una representación realmente producida por E5.
La normalización L2 reduce después la longitud del vector a 1. Para [3, 4], esa longitud es √(3² + 4²) = 5: el vector pasa a ser [0,6 ; 0,8]. Así comparamos direcciones en lugar de longitudes arbitrarias. El mismo principio se aplica a las 384 coordenadas del recorrido.
Por último, torch.isfinite rechaza valores infinitos o NaN, que indica un resultado numérico indefinido. .cpu().tolist() devuelve los vectores a la memoria del lado CPU como listas Python utilizables por el resto del programa.
La ficha oficial de E5 multilingüe ilustra los prefijos, la media enmascarada y la normalización. Sirve como complemento conceptual: para reproducir este experimento, conserve los archivos y ajustes fijados en el ZIP, especialmente su rechazo explícito de entradas demasiado largas.
2. Guardar los candidatos antes de reclasificarlos
En este punto, los vectores de los documentos están indexados. Para cada pregunta, calculamos su vector y pedimos 20 vecinos a Qdrant.
store.search(encoder.encode([data["queries"][0]["query"]], "query")[0], 20)

rows = []

for query in data["queries"]:
    start = time.perf_counter()
    candidates = store.search(encoder.encode([query["query"]], "query")[0], 20)
    rows.append(
        {
            **query,
            "candidates": candidates,
            "seconds": {"dense": time.perf_counter() - start},
        }
    )

save("candidates", {"rows": rows})
La primera línea ejecuta una búsqueda de calentamiento, o warm-up. Tiene lugar antes del bucle cronometrado. Su resultado no se añade a rows: la primera pregunta se procesará de nuevo en las mediciones normales.
En el bucle, el cronómetro empieza antes de codificar la pregunta. Por tanto, la duración seconds.dense incluye esa codificación y la llamada de búsqueda a Qdrant. No mide únicamente el tiempo de comparación de vectores en la base de datos.
La expresión {**query, ...} conserva la información de la pregunta y le añade los candidatos y la duración. Al terminar, save escribe el archivo de referencia.
Este es el contrato entre ambos modelos: el reranker volverá a leer esta lista guardada. Repetir la búsqueda con otro conjunto de candidatos durante la comparación impediría aislar el efecto de la reclasificación.
3. Calcular una puntuación para cada par
El reranker no recibe los embeddings E5 para mejorarlos. Recupera el texto de cada candidato y lo asocia a la pregunta. Los identificadores sirven para localizar los documentos y seguir su nueva posición.
def score(self, query, candidates, documents):
    if not candidates:
        return {"ranked": [], "pairs": [], "truncated": False}

    if not isinstance(query, str) or not query.strip():
        raise ValueError("Question non vide requise")

    rank_scores(candidates, [0.] * len(candidates))
    pairs = [[query, documents[identifier]["text"]] for identifier, _ in candidates]
    scores = []
    truncated = False

    for offset in range(0, len(pairs), 4):
        part = pairs[offset:offset + 4]
        lengths = [len(self.tokenizer(a, b)["input_ids"]) for a, b in part]
        truncated |= any(length > 512 for length in lengths)

        batch = self.tokenizer(
            part,
            padding=True,
            truncation=True,
            max_length=512,
            return_tensors="pt",
        ).to("cuda")

        with torch.inference_mode():
            scores.extend(self.model(**batch).logits.view(-1).float().cpu().tolist())

    return {
        "ranked": rank_scores(candidates, scores),
        "truncated": truncated,
        "pairs": [
            {
                "query": query,
                "document_id": identifier,
                "text": documents[identifier]["text"],
                "score": score,
            }
            for (identifier, _), score in zip(candidates, scores)
        ],
    }
El primer comportamiento es un retorno explícito cuando el conjunto está vacío. La función devuelve entonces una lista clasificada vacía, ningún par y truncated: False. Este retorno ocurre antes de comprobar la pregunta: con un conjunto vacío, el fragmento no exige que la pregunta contenga texto. Con un conjunto no vacío, una pregunta inválida sí provoca un error.
rank_scores(candidates, [0.] * len(candidates)) realiza una primera validación de los candidatos, especialmente de sus identificadores. Los ceros son provisionales: no son ni los cosenos E5 ni las predicciones BGE. La función auxiliar completa forma parte del ZIP; también realiza la ordenación final y rechaza resultados de puntuación no finitos.
La comprensión de lista pairs construye un par por candidato. Después, el bucle los procesa en lotes de 4. Una primera tokenización examina las longitudes; una segunda prepara el lote enviado a CUDA, con un límite de 512 tokens.
El modelo produce los logits. view(-1) los presenta como una lista de puntuaciones, .float() los convierte en números de coma flotante y .cpu().tolist() permite utilizarlos en Python. La ordenación final es descendente por puntuación, con el identificador como criterio estable de desempate.
El resultado contiene dos vistas complementarias: ranked, la lista reordenada, y pairs, el detalle de las asociaciones pregunta-documento con su texto y puntuación. En este fragmento, pairs sigue el orden de los candidatos de entrada; para conocer la nueva clasificación, hay que leer ranked.
Dos políticas distintas ante un texto demasiado largo
Este detalle merece una pausa, porque las dos etapas no reaccionan de la misma forma.
E5 rechaza una entrada de más de 512 tokens. El programa le pide que divida explícitamente el documento, en vez de modificar silenciosamente el material de la búsqueda.
El reranker acepta truncar un par demasiado largo, pero lo indica con truncated: True. Su límite se aplica a la entrada combinada: pregunta, pasaje y tokens especiales. Por tanto, dos textos aceptables por separado para E5 pueden formar un par demasiado largo para el segundo modelo; además, sus tokenizadores pueden segmentar de forma distinta las mismas palabras.
Según la documentación de Transformers sobre truncamiento, truncation=True aplica la estrategia longest_first: se retiran tokens de la secuencia más larga del par hasta respetar el límite. Por ello, este ajuste no garantiza que solo se acorte el pasaje. Aquí, 512 es el límite elegido por el código del tutorial, no una afirmación sobre todas las capacidades posibles de BGE.
El booleano truncated acumula la observación de los lotes: pasa a ser verdadero en cuanto al menos un par supera el límite. No indica ni cuántos pares están afectados ni las posiciones exactas eliminadas.
Otro matiz importante: el campo text conserva el documento original, no una reconstrucción del texto tras el truncamiento. Las salidas permiten localizar el par fuente y su puntuación; no prueban que el modelo haya consumido todas las palabras del texto conservado. Cuando se señala un truncamiento, hay que examinar la tokenización real antes de explicar un resultado por una frase situada al final del documento.
Preparar y ejecutar el tutorial
Situarse en el lugar adecuado
Descargue el ZIP, extráigalo y abra la terminal en la raíz del proyecto extraído. Todos los comandos siguientes parten de ese directorio. Para ejecutarlos se necesita el código completo, no solo los extractos del artículo.
GPU_DEVICE=1 elegiría la segunda tarjeta; por defecto se usa el índice 0. Compruebe la elección de la GPU en la configuración del proyecto antes de realizar los cálculos.
El preflight es una comprobación previa del entorno. Inicializa CUDA realmente dentro de un contenedor y verifica que Docker puede usar la tarjeta. Que nvidia-smi dé un resultado correcto en el host no basta: la tarjeta puede ser accesible para Linux, pero no para el contenedor.
NVIDIA Container Toolkit permite esta exposición de la GPU a los contenedores; su guía oficial completa los requisitos previos. El preflight del proyecto no instala nada ni modifica la configuración de su sistema.
Construir el entorno y obtener los modelos
Ejecute estos cinco comandos en orden. Todos deben terminar sin errores antes de continuar.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
setup.sh prepara el entorno local del proyecto; build construye la imagen. El servicio fetch, activado por el perfil acquisition, obtiene explícitamente los modelos. Comprueba el tamaño y el SHA-256 de los archivos antes de renombrarlos de forma atómica.
Un SHA-256 es una huella calculada a partir de los bytes de un archivo. Aquí, compararlo con el valor esperado permite comprobar que el modelo obtenido corresponde al recurso previsto. El renombrado atómico sitúa el archivo bajo su nombre final después de validarlo, en vez de presentar una descarga parcial como un modelo terminado. Es un control de integridad de archivos, no una medida de calidad del modelo.
El último comando ejecuta la suite pública del proyecto. El resultado esperado del recorrido validado es 17 pruebas públicas superadas. Un fallo debe entenderse antes de continuar: resultados de búsqueda aparentemente creíbles no compensan un control con error.
Construir el índice, recuperar, reclasificar y evaluar
A continuación, inicie Qdrant y ejecute los pasos siguientes:
docker compose up -d qdrant
docker compose run --rm --no-deps app -m src.cli prepare
docker compose run --rm --no-deps app -m src.cli index
docker compose run --rm --no-deps app -m src.cli retrieve
docker compose run --rm --no-deps app -m src.cli rerank
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
Después de prepare, compruebe la población anunciada: 200 documentos, 80 preguntas, de las cuales 20 son de desarrollo y 60 de prueba.
Después de index, la salida debe mostrar, entre otros valores, documents: 200, dimension: 384, device: "cuda" y points_count: 200. Queremos tantos puntos indexados como documentos, con la dimensión esperada.
Después de retrieve, abra outputs/candidates.json. Para una pregunta, localice sus 20 candidatos y su orden inicial. Será su punto de comparación.
Después de rerank, abra outputs/reranked.json. Encuentre la misma pregunta, compare los identificadores de ranked con los del pool y lea después los pares, los logits y el indicador de truncamiento. Los documentos no deben cambiar solo porque cambie su orden.
Después de negatives, los controles deben confirmar el comportamiento con un pool vacío, el truncamiento señalado y la colección vacía. Una prueba negativa verifica un límite o un caso particular provocado deliberadamente, no solo el camino en el que todo funciona.
Después de evaluate, outputs/evaluation.json contiene las métricas de referencia. Ahora veremos cómo interpretarlas.
La adquisición y la inferencia están separadas. Una vez obtenidos los modelos, la inferencia sigue siendo local y no usa una red externa. Esto no impide que la aplicación se comunique con Qdrant dentro del proyecto Docker.
Definir las medidas antes de observarlas
¿Qué es un documento «relevante»?
Para evaluar una búsqueda, hay que saber qué debería haber recuperado. Las anotaciones de relevancia proporcionan esa referencia: para cada pregunta, indican los documentos considerados útiles en el experimento.
No es la puntuación del modelo la que crea esta verdad de referencia. De lo contrario, pediríamos al motor que se calificara a sí mismo. Aquí, las anotaciones pertenecen a un corpus pedagógico ficticio; no sustituyen una validación independiente de negocio con documentos reales.
Por qué 80, 60 y 48 no designan lo mismo
Las 80 preguntas incluyen 20 preguntas de desarrollo y 60 preguntas de prueba. Entre estas 60 preguntas de prueba, 48 tienen al menos un documento relevante en las anotaciones; las 12 restantes están fuera del corpus.
Las métricas de relevancia se aplican a las 48 preguntas evaluables. Las latencias publicadas más adelante se aplican a las 60 preguntas de prueba, incluidas las 12 fuera del corpus.
¿Por qué separar estas últimas? Para una pregunta sin documento relevante, el recall tendría un denominador nulo y la clasificación ideal de nDCG no tendría ganancia. Asignarle arbitrariamente un cero mezclaría dos problemas: clasificar mal una respuesta disponible y buscar en un corpus que no contiene la respuesta esperada.
No obstante, estas 12 preguntas no desaparecen de la observación: reciben candidatos. Por tanto, obtener una lista, incluso ordenada, no prueba que una ficha responda a la pregunta. El recorrido no demuestra una capacidad para decidir automáticamente «no hay respuesta disponible».
En pantalla pequeña, desplácese horizontalmente por la tabla.
| Medida | Lo que observa |
|---|---|
| Recall@20 | Proporción de documentos relevantes presentes en el pool denso de 20. Limita lo que puede hacer el reranker. |
| MRR@5 | Posición del primer documento relevante entre las cinco primeras. |
| nDCG@5 | Posición de todos los documentos relevantes entre las cinco primeras, con una disminución según el rango. |
| Latencia densa | Codificación de la pregunta y búsqueda en Qdrant. |
| Latencia del reranker | Coste adicional de puntuar los 20 pares, sin contar la carga del modelo. |
Recall@20: ¿están disponibles los documentos útiles?
El recall, o Recall, mide una cobertura. Para una pregunta que tiene al menos un documento relevante:
Recall@20 = número de documentos relevantes entre los 20 candidatos / número total de documentos relevantes esperados.
Con tres documentos relevantes, encontrar dos da 2 / 3 ≈ 0,667. Encontrarlos todos da 1, aunque estén en las posiciones 12, 16 y 20. Por tanto, el recall@20 no le dice si las primeras líneas de la interfaz son buenas; le indica de qué dispone el reranker.
Si el reranker solo permuta esos mismos 20 candidatos, este recall permanece idéntico. Puede mejorar su presencia en el top 5, pero no añadir un documento al pool de 20.
MRR@5: ¿dónde aparece la primera respuesta útil?
Para una pregunta, se busca la posición del primer documento relevante entre los cinco primeros. Su rango recíproco, denominado aquí RR@5, vale la inversa de esa posición: rango 1 → 1; rango 2 → 1 / 2 = 0,5; rango 5 → 1 / 5 = 0,2.
Si no hay ningún documento relevante entre los cinco primeros, RR@5 vale 0, aunque un documento útil llegue en la posición 6.
El MRR, por Mean Reciprocal Rank, es la media de estos valores para las preguntas evaluables. No es la inversa del rango medio. Por ejemplo, dos preguntas cuyos primeros relevantes están en los rangos 1 y 5 dan (1 + 0,2) / 2 = 0,6, y no 1 / 3.
Esta métrica responde bien a «¿con qué rapidez se encuentra una primera respuesta útil?». No describe la posición de los demás documentos relevantes.
nDCG@5: ¿están bien colocadas varias respuestas útiles?
El nombre impresiona más que la idea. nDCG significa normalized Discounted Cumulative Gain: se suman ganancias de relevancia, dando menos peso a las posiciones lejanas, y después se compara con la mejor clasificación posible.
Para entender el cálculo con anotaciones binarias, un documento relevante en el rango r aporta 1 / log2(r + 1); un documento no relevante aporta 0. log2 designa el logaritmo en base 2. Aquí solo se conservan las cinco primeras posiciones.
Con un único documento relevante, situado en el rango 2, la contribución vale 1 / log2(3) ≈ 0,631. La clasificación ideal lo situaría en el rango 1, con una ganancia de 1: por tanto, el nDCG@5 también vale aproximadamente 0,631.
Con varios documentos relevantes, no basta con sumar sus contribuciones: también hay que dividir por la ganancia de la clasificación ideal. Esta normalización permite leer 1 como el mejor resultado posible según las anotaciones y el corte considerado.
Un ejemplo que puede repetirse a mano
La tabla siguiente es un ejemplo pedagógico, no una salida de las reproducciones r3. Imaginemos una pregunta con tres documentos relevantes, todos presentes en un pool de 20. Solo cambiamos sus posiciones.
En pantalla pequeña, desplácese horizontalmente por la tabla.
| Posiciones de los tres relevantes | Recall@20 | RR@5 para esta pregunta | nDCG@5 |
|---|---|---|---|
| Rangos 2, 4 y 8 | 1,0000 | 0,5000 | ≈ 0,4982 |
| Rangos 1, 8 y 9 | 1,0000 | 1,0000 | ≈ 0,4693 |
| Rangos 1, 2 y 3 | 1,0000 | 1,0000 | 1,0000 |
Para la primera fila, solo los rangos 2 y 4 contribuyen a la ganancia top-5:
DCG@5 = 1 / log2(3) + 1 / log2(5) ≈ 1,0616.
Con tres documentos relevantes, la clasificación ideal los situaría en los rangos 1, 2 y 3:
IDCG@5 = 1 + 1 / log2(3) + 1 / log2(4) ≈ 2,1309.
El resultado normalizado vale por tanto 1,0616 / 2,1309 ≈ 0,4982.
Compare ahora las dos primeras filas. El rango recíproco mejora porque una respuesta útil llega a la cabeza, pero el nDCG disminuye porque solo una respuesta útil permanece entre los cinco primeros resultados. Dos métricas pueden evolucionar en sentidos distintos sin que el cálculo sea incoherente. Observan aspectos distintos de la clasificación.
El recall del pool sigue siendo igual a 1 en los tres casos. Fija el conjunto de documentos disponibles; por sí solo no resume la calidad de su orden.
Latencia: ¿qué tiempo se cronometra?
La latencia es el tiempo transcurrido para realizar una operación. En este tutorial, la latencia densa incluye la codificación de la pregunta y la búsqueda en Qdrant. La latencia del reranker es un coste adicional para procesar los 20 pares; la carga del modelo queda excluida.
Las mediciones r3 se realizan tras el calentamiento. No describen ni el primer inicio completo, ni la descarga de los modelos, ni el retraso total de una futura página web con red, autenticación y visualización.
Resultados R3 observados
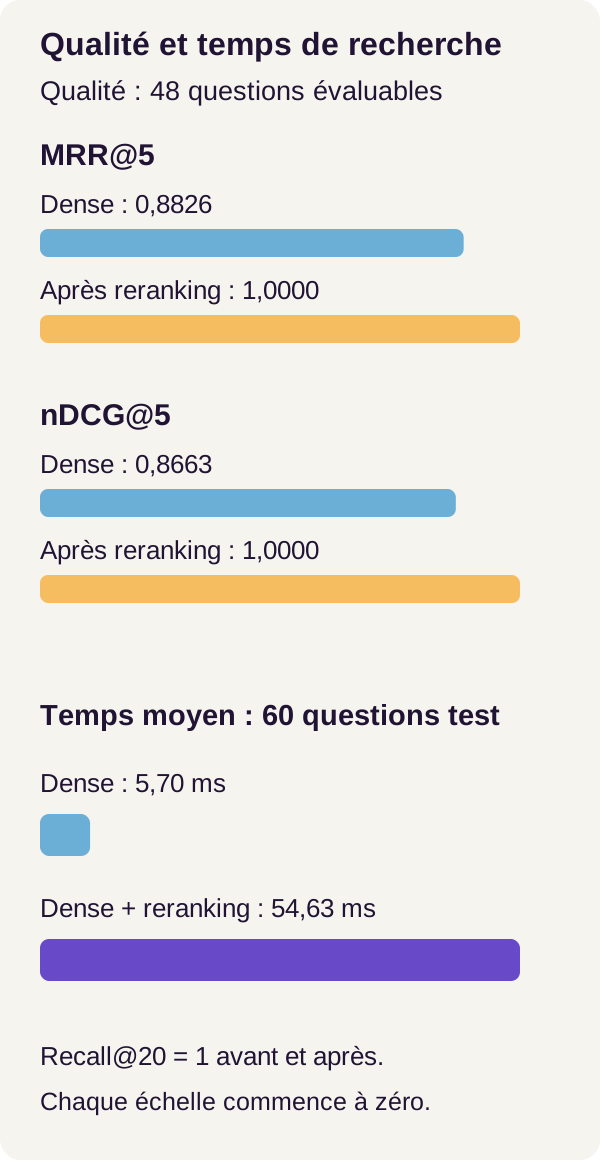
Dos reproducciones del recorrido r3 dieron las mismas métricas de calidad. Las latencias siguientes corresponden a la segunda reproducción, promediadas sobre las 60 preguntas de prueba, tras warm-up y sin la carga de los modelos.
La calidad de la clasificación
En pantalla pequeña, desplácese horizontalmente por la tabla.
| Ruta | MRR@5 | nDCG@5 | Recall@20 | Población |
|---|---|---|---|---|
| Candidatos densos | 0,8826 | 0,8663 | 1,0000 | 48 evaluables |
| Tras el reranking | 1,0000 | 1,0000 | 1,0000 | 48 evaluables |
El primer número que hay que leer es el recall@20: 1,0000 en ambas filas. Todos los documentos relevantes de las 48 preguntas evaluables ya estaban presentes en los pools densos. Por tanto, el reranker no mejora la cobertura: era completa a esta profundidad de búsqueda.
La mejora se refiere a las posiciones. El MRR@5 pasa de 0,8826 a 1,0000, y el nDCG@5 de 0,8663 a 1,0000. El resultado comunicado es óptimo para estas métricas en este conjunto evaluado; no demuestra que el modelo sea perfecto con otras preguntas.
Tampoco lea MRR@5 = 0,8826 como «el 88,26 % de los documentos son correctos». Es una media de rangos recíprocos. El nDCG también mide una clasificación, no una probabilidad de verdad.
El tiempo adicional
En pantalla pequeña, desplácese horizontalmente por la tabla.
| Tiempo medio | Milisegundos |
|---|---|
| Denso | 5,70 ms |
| Reranking adicional | 48,92 ms |
| Total | 54,63 ms |
La reclasificación añade aquí 48,92 ms de media a una búsqueda densa de 5,70 ms. El total comunicado alcanza 54,63 ms, es decir, aproximadamente 54,63 / 5,70 ≈ 9,6 veces el tiempo de la vía densa sola.
Las duraciones publicadas se conservan con dos decimales. Su suma visible da 54,62 ms, frente a 54,63 ms para el total comunicado; esta diferencia de 0,01 ms es compatible con redondeos independientes. Harían falta los valores sin redondear para confirmar su origen: no debe verse como un coste adicional medido por separado.
Por tanto, el razonamiento correcto no es ni «49 ms es necesariamente insignificante» ni «casi diez veces más lento es necesariamente inutilizable». La pregunta es: ¿justifica el cambio de clasificación este tiempo adicional en la aplicación prevista?
Estos resultados describen un corpus ficticio, un equipo y una configuración determinados. No constituyen una promesa de ganancia de negocio, una prueba de carga ni una estimación del rendimiento de su futuro servicio.
Lo que hemos aprendido
Recuperar y reclasificar son dos operaciones distintas
E5 y Qdrant constituyen una lista de candidatos. El cross-encoder aporta una comparación más costosa entre la pregunta y cada uno de esos candidatos. Puede modificar el orden, pero no recuperar un documento que se quedó fuera del pool.
Antes de culpar al reranker de una mala respuesta, observe la lista de entrada. Una ficha ausente y una ficha mal clasificada no requieren el mismo diagnóstico.
La puntuación de un modelo y una métrica de evaluación no son lo mismo
El coseno de E5 y el logit de BGE sirven para producir clasificaciones. El recall, el MRR y el nDCG sirven para comparar estas clasificaciones con anotaciones conocidas. Un logit alto no sustituye una evaluación, y un buen MRR no significa que todos los resultados sean útiles.
Un primer resultado no prueba que haya respuesta
Las preguntas fuera del corpus también reciben candidatos. El mejor elemento de una lista puede ser simplemente el menos alejado de una petición a la que ningún documento responde. Saber rechazar una búsqueda sin respuesta es un problema distinto, que las puntuaciones perfectas en las 48 preguntas evaluables no resuelven.
La calidad tiene aquí un coste medido
En este experimento, el top-5 mejora y el tiempo total aumenta. El tamaño del pool, el modelo, la longitud de los textos y el hardware forman parte del compromiso que hay que estudiar. Nada permite trasladar automáticamente los 54,63 ms a otro contexto.
Ejercicio: predecir, modificar, ejecutar, observar y explicar
Predecir antes de ejecutar
Para REF-000, los documentos relevantes son los identificadores 0, 1 y 2. Figuran en el pool de referencia.
Vamos a retirarlos antes del reranking. Anote su predicción: ¿quedará algún documento relevante que clasificar? ¿Puede un modelo volver a poner en cabeza un identificador que ya no recibe? ¿Qué recall tendrá el pool modificado para esta pregunta?
Modificar y ejecutar
No edite el código para este ejercicio. El comando proporcionado aplica exactamente esta modificación al pool congelado de la primera pregunta:
docker compose run --rm --no-deps app -m src.cli exercise
Observar las salidas
En outputs/exercise.json, compruebe removed_relevant: [0, 1, 2]. El pool debe conservar 17 candidatos, y ninguno de los tres identificadores eliminados debe reaparecer en ranked.
No confunda los 17 candidatos con las 17 pruebas públicas: el primer número procede de 20 - 3; el segundo designa la suite de pruebas del proyecto.
Explicar lo ocurrido
El cross-encoder puede preferir el documento 3 entre los candidatos restantes, pero no puede clasificar un documento ausente. Para esta pregunta, ninguno de los tres relevantes esperados queda en el pool modificado: su recall es por tanto nulo, sea cual sea la calidad de la clasificación de los otros 17 documentos.
Esto no transforma REF-000 en una pregunta fuera del corpus: sus respuestas siguen existiendo en el corpus y en las anotaciones. Hemos provocado un fallo de recuperación, no eliminado la existencia de una respuesta esperada.
Aumentar el pool o mejorar la recuperación son vías que deben experimentarse por separado. Exigen nuevas mediciones de cobertura, clasificación top-5 y latencia; no son mejoras ya demostradas por este ejercicio.
Su experimento, distinto del ejercicio
El ejercicio anterior probaba un límite concreto. Para explorar el compromiso calidad-latencia, conserve primero las salidas de referencia y trabaje después en una copia del proyecto. Los resultados de esta variante no forman parte de las reproducciones r3 presentadas aquí.
Una variable interesante es el número de vecinos solicitado a Qdrant. Por ejemplo, puede comparar un pool más pequeño con el pool de referencia de 20, sin cambiar a la vez los documentos, las preguntas y el reranker. El código visible usa el valor 20 en la búsqueda de calentamiento y en el bucle medido: asegúrese de que la variante sigue siendo coherente, así como los posibles controles del programa completo.
Antes de ejecutar, escriba dos hipótesis separadas: lo que espera respecto a la presencia de los relevantes y lo que espera respecto al tiempo de procesamiento. Un pool reducido elimina pares que evaluar, pero también puede descartar un documento útil. Un pool mayor ofrece más candidatos; no garantiza una mejor clasificación final.
Vuelva a ejecutar retrieve, rerank y evaluate con los comandos ya presentados. Si la modificación afecta a un archivo copiado en la imagen Docker, reconstruya la imagen según el montaje del proyecto: cambiar un archivo en el host no garantiza que el contenedor ejecute esa nueva versión.
Compare el número de candidatos, el recall del pool, MRR@5, nDCG@5 y los tiempos denso, del reranker y total. Anote también la posible aparición de truncamientos. Si cambia la profundidad de recuperación, nombre esa profundidad en el informe: un recall medido sobre un pool de 10 no es, por simple cambio de nombre, el recall@20 de referencia.
No sustituya los resultados antiguos por los nuevos sin conservar su configuración. La comparación debe hacer visible qué ha cambiado. Y reserve las preguntas de desarrollo para explorar sus ajustes, en lugar de elegir una configuración solo porque maximiza el conjunto de prueba.
Límites para una puesta en producción
Datos controlados, no una validación de negocio
El corpus y las preguntas son ficticios. Las 48 preguntas evaluables y sus anotaciones no sustituyen ni consultas representativas de sus usuarios ni un análisis de errores sobre documentos reales. Un resultado perfecto en este conjunto no valida una búsqueda general.
En particular, hay que tratar por separado las peticiones sin respuesta en el corpus. Un umbral sobre la puntuación BGE sería una nueva regla que evaluar, no una capacidad de abstención ya validada por este recorrido.
Recursos observados con límites
El tutorial se probó en un equipo equipado con una RTX 3090. No anuncia ni modo CPU ni motor de producción. Las previsiones de hardware siguen siendo prudentes, sin un estudio del mínimo necesario.
La VRAM se muestreó aproximadamente una vez por segundo: un pico breve puede quedar entre dos mediciones. Las cachés de Docker estaban disponibles, y las variaciones del espacio en disco no son atribuibles únicamente al tutorial. Una media de latencia en esta máquina no informa por sí sola sobre los retrasos bajo concurrencia ni sobre las solicitudes más lentas.
Una arquitectura que debe completarse según la aplicación
Elija el tamaño del pool y el presupuesto de latencia a partir de consultas representativas. Vigile los pares largos y sus truncamientos, conserve las versiones del corpus, los modelos y las métricas, y mida la recuperación antes de atribuir un cambio al reranker.
En una aplicación documental con derechos de acceso, el perímetro autorizado también debe respetarse antes de transmitir los textos a la reclasificación. Los filtros de Qdrant son un componente técnico para limitar los candidatos; su sola presencia no constituye una política de autorización completa.
La seguridad del contenedor, la adquisición bloqueada y los límites de despliegue están documentados en el archivo ZIP. Deben leerse antes de una adaptación; no transforman el tutorial en un servicio listo para producción.
Solución de problemas y limpieza
El preflight falla en CUDA. Compruebe el controlador NVIDIA, NVIDIA Container Toolkit y la tarjeta elegida por GPU_DEVICE, y vuelva a ejecutar el preflight. No realiza ninguna instalación. Una tarjeta detectada en el host no basta si no está expuesta al contenedor.
Qdrant no está disponible. Vuelva a ejecutar docker compose up -d qdrant antes de index. Si el fallo persiste, consulte los registros Docker de este proyecto en vez de continuar con una búsqueda incompleta.
E5 rechaza un documento de más de 512 tokens. Es el comportamiento previsto: divida explícitamente el documento. Si esta división modifica las unidades indexadas, los identificadores o las anotaciones, tendrá un nuevo experimento que reconstruir, no la reproducción sin cambios del corpus r3.
El reranker señala un truncamiento. Vuelva a leer el par afectado y su longitud tokenizada. El indicador señala un acortamiento, sin conservar por sí solo los tokens eliminados. Que el texto completo aparezca en pairs no significa que el modelo lo haya leído por entero.
Las duraciones varían mucho. No ejecute dos benchmarks a la vez en la misma GPU. Compruebe también que compara el mismo pool y el mismo perímetro de cronometraje.
Cuando haya conservado sus observaciones, termine desde la raíz del proyecto con:
docker compose down
Este comando elimina los servicios del proyecto y su índice temporal de Qdrant. Los modelos y las salidas siguen disponibles. Para volver a ejecutar una búsqueda después de esta limpieza, inicie Qdrant de nuevo y reconstruya el índice antes de recuperar.
Síntesis
Una búsqueda densa responde a «¿qué documentos considerar?». Un reranker responde a «¿en qué orden presentar estos documentos?». El segundo puede mejorar los primeros resultados, pero no corrige la ausencia de un pasaje en el pool.
En el recorrido r3, todos los relevantes ya estaban disponibles entre los 20 candidatos: el recall permanece en 1,0000, mientras que MRR@5 y nDCG@5 alcanzan 1,0000 después de la reclasificación. Esta mejora se acompaña de un tiempo total medio comunicado de 54,63 ms en el equipo probado.
El resultado más útil no es solo esta tabla. Es el método para comprenderla: congelar los candidatos, leer las listas antes que las medias, separar las preguntas fuera del corpus y medir el coste adicional. Podrá aplicar este enfoque a sus propios datos sin confundir una mejor clasificación con una mejor cobertura documental.
Para profundizar
La ficha oficial del reranker BGE presenta la puntuación de los pares y los logits. La ficha de E5 multilingüe muestra los prefijos, el pooling enmascarado y la normalización de los embeddings.
Para situar estos componentes en una arquitectura, consulte el recorrido Retrieve & Re-Rank de Sentence Transformers. Su documentación sobre la evaluación de cross-encoders también subraya una diferencia importante entre evaluar solo los candidatos recuperados y reintroducir artificialmente todos los relevantes. Nuestra comparación se basa en el pool denso registrado, sin añadir ningún documento mediante el reranker.
La documentación de Transformers sobre padding y truncamiento ayuda a comprender el tratamiento de los pares largos. Los filtros de Qdrant ofrecen una pista para limitar la búsqueda a un perímetro documental.
Estas referencias explican los mecanismos; no sustituyen el código, los modelos ni las versiones del ZIP para reproducir los resultados presentados. Los ejemplos pedagógicos de este artículo ilustran los cálculos, mientras que las tablas «Resultados R3 observados» recogen las mediciones de las dos reproducciones del tutorial.