





Bạn đang phát triển một bảng điều khiển hiển thị mức tải dự kiến cho ngày mai. Chỉ có một giá trị hiện ra: « 50 kW lúc 14 giờ ». Đó là một khởi đầu, nhưng lập tức xuất hiện câu hỏi: cần chuẩn bị cho một giá trị gần 50, hay cho một biến động lớn hơn nhiều?
Một đường cong trung tâm không trả lời được câu hỏi này. Vì vậy, chúng ta sẽ học cách tạo ba ước lượng cho mỗi giờ: thấp, trung vị và cao. Mục tiêu không phải là biến tương lai thành điều chắc chắn, mà là đo lường được hình dạng của bất định.
Trường hợp ban đầu chỉ là minh họa. Trong thử nghiệm, chúng tôi chỉ dùng các chuỗi mô phỏng: không có công tơ thực nào hay quyết định năng lượng nào phụ thuộc vào các dự báo của chúng tôi.
Tải xuống kho lưu trữ của hướng dẫn.
Những gì chúng ta xây dựng
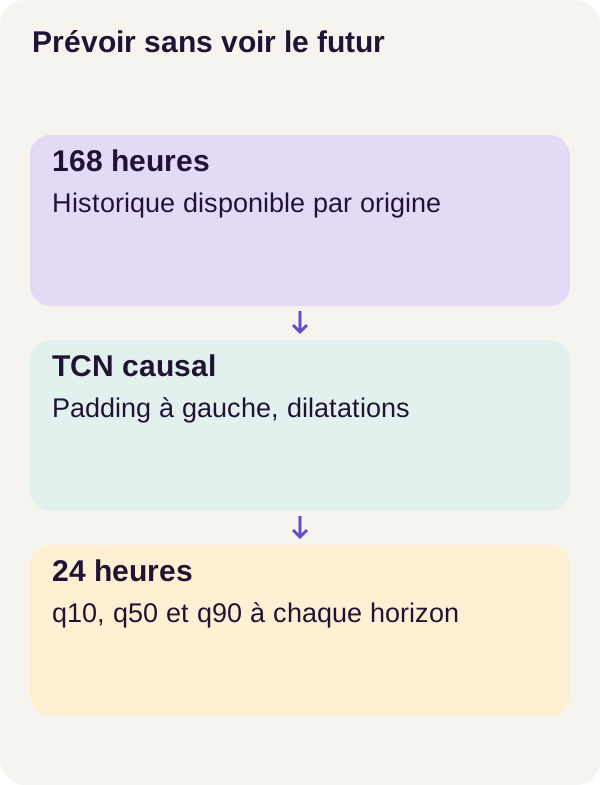
Chương trình mô phỏng mười hai chuỗi theo giờ, rồi huấn luyện một mạng dùng 168 giờ trước đó, tức bảy ngày, để dự báo 24 giờ tiếp theo. Với mỗi giờ tương lai, nó tạo ra q10, q50 và q90.
Bạn có thể hình dung đầu vào của nó như kết quả một truy vấn trên bảng đo lường: một địa điểm, các giờ được sắp xếp và những giá trị đã có. Đầu ra là một bảng gồm 24 dòng, mỗi dòng có ba ước lượng. So sánh này giúp hiểu hợp đồng dữ liệu; dự án không cung cấp API nghiệp vụ hay kết nối tới cơ sở dữ liệu sản xuất.
Chúng ta so sánh ba phương pháp: một tham chiếu theo mùa, gọi là baseline, một mạng có đầu ra độc lập và một mạng có đầu ra có thứ tự. Hai mạng đều dùng TCN nhân quả, mà chúng ta sẽ giải thích cách hoạt động. Khác biệt giữa các « đầu » của chúng nằm ở cách tạo ba giá trị cuối cùng.
Cuối cùng, bạn sẽ biết theo dõi quá trình từ dữ liệu đến dự đoán, tính tổn thất quantile, kiểm tra sự tuân thủ thời gian và diễn giải kết quả. Các con số vẫn là kW mô phỏng: hướng dẫn này không phải là một dự báo năng lượng vận hành.
Khái niệm: quantile đảm bảo điều gì và không đảm bảo điều gì
Ba ngưỡng thay vì một giá trị và biên độ tùy ý
Một quantile là ngưỡng gắn với một tỷ lệ. Ở đây, chúng ta tìm các quantile có điều kiện: chúng phụ thuộc vào lịch sử sẵn có và áp dụng cho một giờ tương lai cụ thể.
Hãy lấy một ví dụ sư phạm, khác với đầu ra của mô hình:
| Ước lượng | Giá trị minh họa | Điều chúng ta muốn ước lượng |
|---|---|---|
q10 |
42 kW | Ngưỡng mà dưới đó sẽ có khoảng 10 % giá trị, trong các điều kiện đang xét. |
q50 |
50 kW | Trung vị: một giá trị chia phân phối thành hai nửa. |
q90 |
63 kW | Ngưỡng mà dưới đó sẽ có khoảng 90 % giá trị, trong các điều kiện đang xét. |
Dải đi từ 42 đến 63 kW. Vì vậy, độ rộng của nó là 63 − 42 = 21 kW. Dải này hướng đến mức bao phủ 90 % − 10 % = 80 %.
Lưu ý rằng trung vị không nhất thiết nằm giữa dải: ở đây nó cách biên dưới 8 kW và cách biên trên 13 kW. Chúng ta không áp đặt một biên độ đối xứng kiểu « giá trị trung tâm ± 5 ».
q90 không có nghĩa là « một dự đoán chính xác 90 % ». Con số này chỉ mức quantile cần tìm, chứ không phải điểm tin cậy gán cho câu trả lời. Tương tự, q50 chỉ trung vị, không nhất thiết là trung bình.
Mạng ước lượng các ngưỡng này cho tương lai. Nó không chỉ sắp xếp 168 giá trị quá khứ rồi trích ra ba vị trí. Ví dụ chính thức về hồi quy quantile của scikit-learn minh họa sự khác biệt giữa dự đoán trung tâm, quantile và mức bao phủ quan sát được.
Làm sao học một quantile với chỉ một giá trị thực?
Với một giờ cho trước, chúng ta không có một trăm tương lai khả dĩ: chỉ quan sát được một giá trị. Làm thế nào dạy mạng ba quantile?
Ta đưa cho mạng nhiều lịch sử, mỗi lịch sử kèm theo các giá trị thực sự xảy ra sau đó. Một hàm mất mát gán chi phí cho các sai số. Khi cộng dồn các chi phí trên các ví dụ, quá trình huấn luyện điều chỉnh tham số của mạng.
Để học một trung vị, sai số cao hơn và sai số thấp hơn có cùng biên độ bị phạt như nhau. Để học một quantile cao, chúng ta phạt mạnh hơn một ước lượng quá thấp. Đó là vai trò của pinball loss, hay tổn thất quantile.
Gọi y là giá trị quan sát, q là giá trị dự đoán và τ — chữ cái Hy Lạp « tau » — là mức quantile. Trong trường hợp của chúng ta, τ là 0,1, 0,5 hoặc 0,9.
Công thức là:
sai số = y − q
tổn thất = max(τ × sai số, (τ − 1) × sai số)
Không cần ghi nhớ cách viết này trước khi hiểu nó. Với mục tiêu là 50, đây là chi phí của hai dự đoán giả định:
| Dự đoán | Sai số y − q |
Chi phí cho q10 |
Chi phí cho q50 |
Chi phí cho q90 |
|---|---|---|---|---|
| 48: thấp hơn 2 | +2 | 0,2 | 1,0 | 1,8 |
| 52: cao hơn 2 | −2 | 1,8 | 1,0 | 0,2 |
Với q90, đánh giá thấp 2 có chi phí 0,9 × 2 = 1,8. Đánh giá cao 2 chỉ có chi phí 0,1 × 2 = 0,2. Với q10, điều ngược lại đúng. Các khoản phạt vẫn dương hoặc bằng không; điều thay đổi là trọng số theo chiều của sai số.
Tại sao mạng không đẩy q90 lên vô hạn? Vì đánh giá cao tốn ít hơn, nhưng không bằng không. Tổn thất tìm một thỏa hiệp trên toàn bộ ví dụ, không phải một biên bao trùm mọi thứ với bất kỳ giá nào. Tài liệu về pinball loss dùng cùng quy ước tính toán.
TCN: các bộ lọc đi dọc thời gian
TCN là viết tắt của Temporal Convolutional Network, hay mạng tích chập theo thời gian. Một phép tích chập kết hợp nhiều giá trị lân cận bằng các hệ số được học. Bạn có thể liên hệ nó với trung bình trượt, với một khác biệt quan trọng: mạng học các hệ số và kết hợp nhiều phép xử lý, thay vì nhận một quy tắc lấy trung bình được cố định sẵn.
Một bộ lọc thời gian nhân quả chỉ làm việc với vị trí hiện tại và các vị trí trước đó. Trong ví dụ có ba giá trị, đầu ra ở thời điểm 10 có thể đọc các thời điểm 8, 9 và 10, nhưng không thể đọc thời điểm 11.
Dilation giãn cách các vị trí được đọc. Vẫn trong ví dụ ba giá trị này:
Dilatation 1, sortie au temps 10 : lecture des temps 8, 9 et 10.
Dilatation 2, sortie au temps 10 : lecture des temps 6, 8 et 10.
Dilatation 4, sortie au temps 10 : lecture des temps 2, 6 et 10.
Các chỉ số này minh họa cơ chế, không phải cấu hình chính xác của mạng được cung cấp. Khi xếp chồng các lớp, ta mở rộng trường tiếp nhận, tức tập hợp các vị trí có thể ảnh hưởng đến một đầu ra. Cung cấp 168 giờ cho chương trình và chứng minh kiến trúc của nó có thể khai thác toàn bộ chúng là hai kiểm tra riêng biệt.
Nguyên lý của các phép tích chập nhân quả có dilation được mô tả trong nghiên cứu của Bai, Kolter và Koltun. Ở đây, « nhân quả » có nghĩa là tôn trọng thứ tự thời gian của thông tin. Điều đó không có nghĩa mô hình đã xác định được các nguyên nhân vật lý của biến động tải.
Padding: bổ sung một biên mà không đọc phía sau nó
Ở đầu một chuỗi, một số vị trí mà bộ lọc cần không tồn tại. Padding là việc bổ sung biên đó bằng các giá trị đệm. TCN của hướng dẫn dùng padding bên trái, về phía quá khứ, để giữ hành vi nhân quả.
Ngược lại, một phép tích chập có tâm có thể sử dụng vị trí nằm bên phải vị trí nó tính. Ở thời điểm 9, một bộ lọc có tâm trên ba vị trí sẽ đọc 8, 9 và 10: giá trị 10 khi đó có thể thay đổi đầu ra gán cho thời điểm 9. Bài tập cuối giúp quan sát được khác biệt này.
Kiểm soát nội bộ này không thay thế việc kiểm soát dữ liệu. Một mạng nhân quả vẫn có thể nhận một lịch sử được xây dựng sai, chứa thông tin chưa có vào thời điểm dự báo. Vì vậy, chúng ta cũng sẽ kiểm tra cách cắt các cửa sổ và tính toán tiền xử lý.
Hai đầu: ước lượng tự do hoặc áp đặt thứ tự
Đầu là phần cuối của mạng, biến những gì nó đã tính thành các giá trị đầu ra.
Với đầu độc lập, ba đầu ra không bị ràng buộc phải giữ một thứ tự. Ví dụ, mạng có thể đề xuất q10 = 52, q50 = 50 và q90 = 49. Đó sẽ là một giao cắt: cận dưới được gọi như vậy lại vượt quá cận trên. « Độc lập » ở đây mô tả sự vắng mặt của ràng buộc này; không có nghĩa các giờ hoặc các chuỗi độc lập về thống kê.
Đầu có thứ tự bắt đầu từ q10, rồi thêm các gia số nhận được bằng softplus. Nguyên lý của nó được đọc như sau; các chữ a, b và c là ký hiệu sư phạm cho ba đầu ra thô:
q10 = a
q50 = q10 + softplus(b)
q90 = q50 + softplus(c)
Ở dạng thông thường, softplus(x) = log(1 + exp(x)). Nó biến một giá trị thành gia số dương, đồng thời vẫn phù hợp để tính gradient. Tài liệu PyTorch về softplus trình bày chi tiết phép toán này và cách triển khai số của nó.
Ví dụ, softplus(0) = log(2) ≈ 0,6931. Với a = 48, b = 0 và c = 0, ba đầu ra lần lượt xấp xỉ 48, 48,6931 và 49,3863. Ví dụ này giải thích cách xây dựng; nó không phải là dự đoán được ghi nhận trong thử nghiệm.
Với các đầu ra hữu hạn, cách xây dựng này áp đặt q10 ≤ q50 ≤ q90. Nó không áp đặt tải phải tăng dần trong 24 giờ, cũng không áp đặt q10 tự nó dương, hay dải phải chứa đúng tỷ lệ quan sát.
Hãy nghĩ tới một kiểm tra biểu mẫu áp đặt « ngày bắt đầu ≤ ngày kết thúc ». Nó kiểm tra thứ tự nhất quán; nó không chứng minh ngày tháng khớp với cuộc hẹn thực tế. Một dải có thứ tự không tự động là một dải được hiệu chuẩn tốt.
Điều kiện tiên quyết về Docker và GPU
Bạn cần quen với hàm Python, mảng, terminal và các kiến thức cơ bản về Docker. Các khái niệm học máy được giới thiệu trong lộ trình; không cần biết TCN từ trước.
Lộ trình yêu cầu Linux x86_64, Docker Compose, NVIDIA Container Toolkit và một RTX 3090 24 Gio, cùng 16 Gio RAM và 16 Gio dung lượng đĩa trống, không tính các lớp Docker dùng chung. Nó dùng một card; sở hữu hai GPU không bắt buộc phải dùng cả hai cho bài tập này.
GPU là bộ xử lý đồ họa được dùng cho các tính toán của mạng. CUDA cho phép PyTorch khai thác nó ở đây. Kiểm tra môi trường khởi tạo CUDA từ trong container và thực hiện một phép tính: nhìn thấy một card trên máy chủ là chưa đủ. Kiểm tra này phải thành công trước khi huấn luyện. Tài liệu Docker về truy cập GPU và hướng dẫn NVIDIA Container Toolkit mô tả việc tích hợp này.
Để chọn card, hãy export GPU_DEVICE=0 hoặc UUID của một card trước các lệnh. UUID là định danh của card; đó là một cách chọn khác với chỉ mục của nó. Hãy giữ lộ trình GPU được cung cấp để tái tạo kết quả: ở đây không trình bày kết quả CPU tương đương.
Việc tính toán GPU diễn ra không cần mạng. Các container dùng hệ thống tệp chỉ đọc, no-new-privileges, các capability Linux bị loại bỏ và giới hạn CPU, RAM và PID. Theo ngôn ngữ phát triển web, đó là giới hạn những gì một tiến trình có thể làm và tiêu thụ, không phải chứng nhận cho các dự đoán của nó.
Một checkpoint là trạng thái được lưu để có thể nạp lại hoặc tiếp tục một phép tính. Đừng nạp checkpoint Torch từ một nguồn không đáng tin cậy.
Dữ liệu: tách thời gian trước khi huấn luyện
Một thế giới nhỏ mà ta biết các quy tắc
Trình mô phỏng tạo 12 chuỗi trong 180 ngày, tức 180 × 24 = 4 320 giá trị theo giờ cho mỗi địa điểm. Mỗi chuỗi kết hợp một mức cơ sở, một chu kỳ hằng ngày, một chu kỳ hằng tuần, các dao động ngẫu nhiên và một số sự kiện điểm.
Các chu kỳ đem lại cho mạng những quy luật để học. Dao động ngăn tương lai bị thu gọn thành một sự lặp lại hoàn toàn tất định. Chúng ta biết công thức dữ liệu, điều này tạo thuận lợi cho kiểm tra; nó không làm chúng đại diện cho các địa điểm thực.
Việc phân chia theo thứ tự thời gian, với đánh số ngày bắt đầu từ không:
| Phần dữ liệu | Ngày | Vai trò |
|---|---|---|
Huấn luyện, hay train |
0–119 | Học các tham số của mạng và điều chỉnh scaler. |
| Xác thực | 120–149 | Kiểm tra mô hình trên một giai đoạn muộn hơn, tách biệt với huấn luyện. |
| Kiểm thử | 150–179 | Đo kết quả trên giai đoạn cuối được dành riêng. |
Một scaler biến đổi thang đo của các con số trước khi mô hình sử dụng. Khi biến đổi như vậy học các thống kê, chúng chỉ phải đến từ train. Dùng cả 180 ngày để tính sẽ đã truyền thông tin về các giai đoạn tương lai, ngay cả khi không trực tiếp đưa các mục tiêu của chúng vào mạng. Rủi ro rò rỉ qua tiền xử lý này được giải thích trong tài liệu scikit-learn về rò rỉ dữ liệu.
Vì vậy, quy tắc của dự án là: điều chỉnh trên train, rồi giữ nguyên biến đổi này cho các giai đoạn khác. Loại scaler chính xác vẫn là loại trong mã được cung cấp; không cần thay nó bằng một cách chuẩn hóa khác để theo hướng dẫn.
Đọc trình mô phỏng
Đoạn trích sau tạo các chuỗi và giữ lại các tham số đã sinh ra chúng. np chỉ NumPy và TEST_END là mốc giờ được xác định trong dự án. Đây là các trích đoạn từ chương trình hoàn chỉnh: các lệnh Docker bên dưới chạy toàn bộ chương trình, cùng import và cấu hình của nó.
def simulate(seed=17):
    rng = np.random.default_rng(seed)
    t = np.arange(TEST_END)
    series = []
    parameters = []
    for site in range(12):
        baseline = 35 + 2 * site
        daily = 5 + 0.3 * site
        weekly = 3 + 0.1 * site
        phase = 0.17 * site
        noise = 1.2 + 0.05 * site
        value = (
            baseline
            + daily * np.sin(2 * np.pi * t / 24 + phase)
            + weekly * np.cos(2 * np.pi * t / 168)
            + rng.normal(0, noise, len(t))
        )
        events = []
        for day in (25 + site, 75 + site, 125 + site, 155 + site):
            start = day * 24 + 8
            amplitude = 4 + site / 3
            value[start : start + 8] += amplitude
            events.append({"start": start, "duration": 8, "amplitude": amplitude})
        series.append(value)
        parameters.append(
            {
                "site": site,
                "baseline": baseline,
                "daily_amplitude": daily,
                "weekly_amplitude": weekly,
                "phase": phase,
                "noise_std": noise,
                "events": events,
            }
        )
    return np.asarray(series, dtype="float32"), parameters
Điều gì vừa xảy ra?
np.random.default_rng(seed) khởi tạo bộ sinh số giả ngẫu nhiên. Seed mặc định là 17. Trong một môi trường không thay đổi, chạy lại các thao tác giống nhau với seed này cho phép tìm lại các lần rút thăm giống nhau.
Vòng lặp đi qua các địa điểm từ 0 đến 11. baseline = 35 + 2 * site cho mỗi địa điểm một mức nền khác nhau. Hãy chú ý từ vựng: biến baseline này là mức cơ sở của tín hiệu, không phải mô hình tham chiếu theo mùa được so sánh ở phần sau.
Các hạng tử sin(... / 24 ...) và cos(... / 168 ...) thêm dao động theo ngày và theo tuần. Biên độ daily và weekly điều chỉnh tầm quan trọng của chúng, còn phase dịch chu kỳ hằng ngày. rng.normal(0, noise, len(t)) thêm nhiễu Gaussian có tâm bằng không; noise điều chỉnh độ lệch chuẩn của nó, tức biên độ dao động.
Vòng lặp thứ hai thêm bốn sự kiện kéo dài tám giờ cho mỗi địa điểm. Chẳng hạn với địa điểm 0, sự kiện ngày 25 bắt đầu ở chỉ số 25 × 24 + 8 = 608. Lát 608:616 tăng tám giá trị thêm 4. Đây là cách đọc công thức của trình mô phỏng, không phải dự báo mà mạng đã học.
Cuối cùng, hàm trả về một mảng float32 và danh sách parameters, dùng để ghi lại quá trình sinh dữ liệu. float32 cho biết các số được lưu ở dạng dấu phẩy động 32 bit.
Phạm vi của đoạn trích: simulate() tạo các giá trị và tham số của chúng; nó không chứa việc xây dựng cửa sổ hay chọn các điểm gốc. Các thao tác này thuộc bước chuẩn bị đầy đủ. Biết các sự kiện trong trình mô phỏng cũng không cho phép đưa chúng cho mô hình như thông tin tương lai.
Một điểm gốc: thời điểm ta đứng để dự báo
Một điểm gốc dự báo là điểm bắt đầu của một dự báo. Để đọc các chỉ số, ở đây gọi T là giờ đầu tiên cần dự đoán. Quy ước giải thích này cho:
Historique visible : T − 168, ..., T − 1   → 168 valeurs déjà connues.
Cibles à prévoir   : T, ..., T + 23       → 24 valeurs futures.
Trong khi huấn luyện, chương trình biết các mục tiêu này và dùng chúng để tính sai số. Chúng không được trộn với lịch sử đưa vào đầu vào. Nguyên lý này giống một bộ kiểm thử: đáp án mong đợi dùng để sửa kết quả, không dùng để điền dữ liệu cho hàm đang được kiểm thử.
Các cửa sổ huấn luyện tiến từng giờ. Mục tiêu của chúng phải nằm hoàn toàn trong train. Xác thực và kiểm thử dùng một điểm gốc mỗi ngày và mỗi địa điểm:
12 địa điểm × 30 ngày = 360 điểm gốc cho mỗi phần
360 điểm gốc × 24 giờ = 8 640 mục tiêu theo giờ cho mỗi phần
Điều đó tương ứng với 8 640 giá trị cần kiểm tra, không phải 8 640 ngày. Mỗi giá trị nhận ba ước lượng, tức 8 640 × 3 = 25 920 đóng góp cơ bản vào tổn thất quantile.
Vượt qua một ranh giới bằng lịch sử không nhất thiết là rò rỉ
Hãy lấy điểm gốc xác thực đầu tiên, vào đầu ngày 120. Các ngày 113 đến 119 tạo thành lịch sử bảy ngày đã có sẵn. Việc các giá trị này thuộc train không gây vấn đề: chúng nằm trong quá khứ của dự báo này.
Ngược lại, một cửa sổ huấn luyện có mục tiêu đầu tiên là giờ cuối cùng của ngày 119 sẽ tràn sang ngày 120 cho các mục tiêu khác. Nó sẽ trộn huấn luyện với xác thực và phải bị loại trừ.
Cùng logic đó áp dụng cho kiểm thử. Đầu ngày 150, các ngày 143 đến 149 đã được biết. Sau đó, các quan sát đầu giai đoạn kiểm thử có thể phục vụ làm lịch sử cho một điểm gốc muộn hơn, nếu chúng thực sự sẵn có vào ngày đó. Điều này không có nghĩa ta huấn luyện lại mạng hay điều chỉnh lại scaler trên kiểm thử.
Như vậy, quá trình đánh giá tái diễn các dự báo kế tiếp. Nó không dự đoán ba mươi ngày kiểm thử chỉ một lần từ buổi sáng đầu tiên của chúng.
Mã trung tâm: tổn thất quantile
Hiểu các chiều trước các phép toán
Một tensor ở đây là một mảng số có nhiều chiều. Trong một lô B ví dụ, với B là số cửa sổ được xử lý cùng lúc, ta có:
prediction : B × 24 × 3   → un triplet q10, q50, q90 pour chaque heure.
target     : B × 24       → une seule valeur observée pour chaque heure.
Vì vậy, với một ví dụ duy nhất, mạng đề xuất 72 số và chúng ta có 24 giá trị tham chiếu. Ba dự đoán của một giờ được so sánh với cùng một mục tiêu, với ba mức phạt khác nhau.
def pinball_loss(prediction, target):
    tau = torch.tensor(
        [0.1, 0.5, 0.9], device=prediction.device, dtype=prediction.dtype
    )
    error = target[..., None] - prediction
    return torch.maximum(tau * error, (tau - 1) * error).mean()


def check_loss(config):
    p = torch.zeros(1, 1, 3)
    positive = pinball_loss(p, torch.ones(1, 1))
    negative = pinball_loss(p, -torch.ones(1, 1))
    assert torch.allclose(positive, torch.tensor(0.5)) and torch.allclose(
        negative, torch.tensor(0.5)
    )
    return {
        "e_plus_1": [0.1, 0.5, 0.9],
        "e_minus_1": [0.9, 0.5, 0.1],
        "mean_positive": float(positive),
        "mean_negative": float(negative),
    }
Đọc ba phép toán trong pinball_loss()
tau chứa các mức [0.1, 0.5, 0.9], theo cùng thứ tự với ba đầu ra. device và dtype gán cho nó cùng nơi tính toán và cùng kiểu số như prediction.
target[..., None] thêm một chiều có kích thước 1 ở cuối mảng: B × 24 trở thành B × 24 × 1. Khi đó PyTorch có thể so sánh từng mục tiêu với ba dự đoán tương ứng. Việc mở rộng ngầm các chiều tương thích này gọi là broadcasting; tài liệu PyTorch mô tả các quy tắc của nó.
Cuối cùng, torch.maximum(...) chọn chi phí thích hợp cho mỗi sai số. .mean() lấy trung bình tất cả chi phí này: trên các ví dụ trong lô, 24 giờ và ba quantile. Kết quả là một scalar, tức một số duy nhất.
Hàm tính tổn thất nhưng không tự điều chỉnh tham số. Trong huấn luyện, gradient cho biết một thay đổi của tham số sẽ ảnh hưởng thế nào đến tổn thất này, rồi optimizer áp dụng các cập nhật. Trong đánh giá, ta có thể tính cùng tổn thất mà không huấn luyện gì cả.
Một phép tính có thể làm lại bằng tay
Hãy lấy một giờ giả định với y = 50 và các dự đoán q10 = 47, q50 = 51, q90 = 55.
Quantile thấp đánh giá thấp 3: chi phí là 0,1 × 3 = 0,3. Trung vị đánh giá cao 1: chi phí là 0,5 × 1 = 0,5. Quantile cao đánh giá cao 5: chi phí là 0,1 × 5 = 0,5.
Vì vậy, tổn thất trung bình cho giờ này là:
(0,3 + 0,5 + 0,5) / 3 = 0,4333…
Giá trị thực nằm trong dải [47, 55], nhưng tổn thất không bằng không. Điều này không mâu thuẫn: được bao phủ và có điểm quantile tốt không phải là cùng một kiểm tra.
Ở τ = 0,5, pinball bằng một nửa sai số tuyệt đối. Đồng nhất thức này áp dụng cho thành phần trung vị, không phải trung bình của ba quantile. Tham chiếu mean_pinball_loss giúp tìm lại tính chất này.
Tổn thất có đơn vị của các số được đưa vào nó. Các phép đo công bố bên dưới được biểu thị bằng kW mô phỏng; không được so sánh trực tiếp một tổn thất tính trên thang đã biến đổi với các giá trị này nếu không tính đến scaler.
check_loss() kiểm tra điều gì và không kiểm tra điều gì
Bộ kiểm tra tạo ba dự đoán bằng không, rồi một mục tiêu +1 và một mục tiêu −1. Các đóng góp mong đợi lần lượt là [0,1 ; 0,5 ; 0,9] và [0,9 ; 0,5 ; 0,1]. Trung bình của chúng là 0,5 trong cả hai trường hợp.
Assertion thực sự kiểm tra hai trung bình này bằng torch.allclose, vốn so sánh các giá trị với sai số dung sai số học. Ngược lại, các danh sách e_plus_1 và e_minus_1 mà hàm trả về được viết cứng, không được tính lại từ các đóng góp trung gian.
Điểm cần lưu ý: trung bình này không đủ để phát hiện một sự đảo dấu. Với ba mức đối xứng này và các dự đoán giống nhau, thay
target − predictionbằngprediction − targetsẽ hoán đổi đóng góp của quantile thấp và cao mà không thay đổi trung bình0,5. Công thức hiển thị thực sự dùng đúng chiều; điều cần phân biệt là phạm vi của assertion này với một kiểm tra theo từng quantile.
Để tăng cường kiểm tra này trong một thử nghiệm riêng, cần so sánh đóng góp của từng mức hoặc thêm các dự đoán khác nhau theo quantile. Mã tham chiếu ở trên không thay đổi. Nhận xét này không dự đoán trước nội dung của các kiểm tra khác trong dự án.
Cài đặt và kiểm tra môi trường
Giải nén kho lưu trữ, rồi đặt terminal ở thư mục gốc của nó, nơi có các script và cấu hình Compose. Mọi lệnh sau đây đều bắt đầu từ cùng thư mục này.
Dự án này không có trọng số tiền huấn luyện để tải về: ở đây acquire xác thực một manifest không có trọng số. Các chuỗi sẽ được tạo bởi prepare, và mạng sẽ được huấn luyện trên dữ liệu đó. Vai trò của bước này khác với việc thu thập một mô hình ngôn ngữ lớn.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
Hãy đọc chuỗi này như việc chuẩn bị một môi trường phát triển. setup.sh chuẩn bị dự án; config --quiet kiểm tra cấu hình Compose; build acquire gpu xây dựng hình ảnh của hai dịch vụ. Sau đó là xác thực manifest, phép tính kiểm tra CUDA trong container và bộ kiểm thử với pytest.
Quan sát mong đợi: mỗi lệnh phải kết thúc mà không lỗi. Kiểm tra môi trường phải thành công trước khi huấn luyện. Một bộ kiểm thử thành công kiểm tra chương trình trên các trường hợp dự kiến; nó chưa đo chất lượng dự báo trên tập kiểm thử.
Giữ nguyên các phiên bản và thiết lập của kho lưu trữ để tái tạo. Các tham chiếu ở cuối bài giúp hiểu cơ chế, không phải để thay các phụ thuộc của dự án bằng phiên bản mới nhất.
Chuẩn bị, so sánh và huấn luyện
Bây giờ chúng ta có thể tạo dữ liệu, thiết lập tham chiếu theo mùa, kiểm tra mạng, xác minh tổn thất và huấn luyện hai đầu. Chuỗi này cũng gồm một lần dừng chủ ý, một lần tiếp tục và so sánh trạng thái trước khi đánh giá.
Các kết quả được công bố tiếp theo đến từ bản tái tạo do người đọc xác thực của lộ trình r1 này.
docker compose run --rm gpu python -m quantile_forecast.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli baseline --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli inspect-model --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli check-loss --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml --variant independent
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml --stop-after 1000 --run-name interrupted
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m quantile_forecast.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli evaluate --config configs/minimum.yaml
Chuẩn bị một tham chiếu trước khi đòi hỏi mạng tốt hơn
prepare chuẩn bị các chuỗi và cửa sổ theo các quy tắc thời gian đã mô tả. baseline thiết lập tham chiếu theo mùa: một điểm so sánh khai thác sự lặp lại của các mẫu theo thời gian.
Lợi ích của baseline không phải là tạo ra một đối thủ dễ đánh bại. Nó giúp đặt một câu hỏi hữu ích: mạng mang lại gì so với một phương pháp tham chiếu? Chi tiết baseline vẫn theo kho lưu trữ; các trích đoạn trong bài này không đưa công thức hoàn chỉnh của nó.
inspect-model diễn ra trước các lần huấn luyện và cho phép kiểm tra mạng. check-loss chạy kiểm tra số học mà chúng ta vừa đọc. Hãy xem kết quả của chúng trước khi khởi động phần tốn kém nhất của lộ trình.
So sánh hai cách xây dựng đầu ra
Lệnh train của lộ trình huấn luyện đầu có thứ tự; --variant independent khởi động biến thể độc lập. Việc so sánh của chúng đặc biệt xét sai số quantile, trung vị, mức bao phủ, độ rộng và các giao cắt.
Đừng thay một đầu bằng việc chỉ sắp xếp kết quả trước khi đánh giá. Sắp xếp sau đó sẽ tạo một xử lý khác, cần giữ đầu ra của nó và đo tác động một cách riêng biệt.
Tiếp tục: tiếp nối một trạng thái, không khởi động lại một lần chạy
Lệnh có --stop-after 1000 --run-name interrupted cố ý dừng huấn luyện ở bước 1 000. Một bước là một giai đoạn của huấn luyện; con số này không chỉ một nghìn giờ dự báo cũng không phải một nghìn ngày dữ liệu.
Lệnh tiếp theo nạp lại artifacts/checkpoints/interrupted/state.pt và tiếp tục dưới tên resumed. Sau đó compare-resume so sánh lần tiếp tục với lộ trình tham chiếu.
Bạn có thể liên hệ thao tác này với một xử lý hàng đợi có thể tiếp tục: tìm lại tệp cuối cùng được ghi là chưa đủ nếu ta mất trạng thái cần thiết để tiếp tục đúng tại cùng một điểm. Kiểm tra tiếp tục của dự án giúp xác minh tính liên tục này, thay vì giả định nó.
Cuối cùng, evaluate tạo các thước đo cho những phương pháp được so sánh. Sai số tối đa bằng không khi tiếp tục và độ chính xác dự báo tốt là hai kết quả khác nhau: một kết quả liên quan đến tính liên tục của phép tính, kết quả kia liên quan đến chất lượng đầu ra.
Các thước đo trước khi xem kết quả
Mỗi kết quả tổng hợp 360 điểm gốc và 8 640 mục tiêu theo giờ. Trước khi so sánh các con số, hãy xác định ý nghĩa của từng thước đo.
Pinball: chất lượng của ba ngưỡng
Pinball trung bình áp dụng phép tính trước đó cho ba quantile. Ở đây nó được biểu thị bằng kW mô phỏng. Thấp hơn là tốt hơn, với cùng tập hợp, cùng quantile và cùng quy ước đơn vị. Nó không phải là tỷ lệ phần trăm dự báo chính xác.
MAE: chỉ sai số của trung vị
MAE, viết tắt của Mean Absolute Error, là trung bình các độ lệch tuyệt đối. Trong hướng dẫn này, nó liên quan đến q50:
MAE = trung bình của |giá trị quan sát − q50|
Một trung vị 50 trước quan sát 53 đóng góp 3 kW. Cận dưới và cận trên không tham gia vào phép tính này. Vì vậy, « MAE của trung vị » nghĩa là trung bình các sai số của q50, chứ không phải trung vị của mọi sai số.
Mức bao phủ: có bao nhiêu giá trị rơi vào dải?
Một mục tiêu được bao phủ khi q10 ≤ y ≤ q90, gồm cả các biên. Mức bao phủ là số mục tiêu được bao phủ chia cho tổng số mục tiêu.
Mục tiêu danh nghĩa là 80 %, không phải 100 %. Mức bao phủ quá thấp cho thấy dải thường bỏ lỡ các quan sát trong mẫu; mức rất cao có thể tương ứng với một dải quá thận trọng so với mức đã công bố. Vì vậy, cần đọc thước đo này cùng độ rộng và các điểm số khác.
Độ rộng: ta công bố biên độ nào?
Độ rộng là q90 − q10, rồi chương trình lấy trung bình. Với mức bao phủ tương đương, một dải hẹp hơn chính xác hơn về điều nó công bố. Nhưng một dải rất nhỏ bỏ lỡ phần lớn quan sát không phải là thành công.
Ngược lại, mở rộng một dải đến mức bao phủ gần như mọi giá trị không đủ để tạo ra dự báo hữu ích. Nếu khoảng quá rộng để định hướng một quyết định, riêng mức bao phủ không giải quyết được vấn đề ban đầu.
Giao cắt: ba giá trị có đúng thứ tự không?
Tỷ lệ giao cắt đếm các bộ ba không tuân theo q10 ≤ q50 ≤ q90. Nó áp dụng cho 8 640 bộ ba, không phải cho 25 920 số của chúng được xét riêng lẻ.
Một đầu có thứ tự nhằm loại bỏ vấn đề này ngay từ cách xây dựng. Một đầu độc lập cũng có thể không có giao cắt nào trên một tập nhất định; quan sát đó không trở thành bảo đảm cho dữ liệu tiếp theo.
Năm giờ để hiểu các khác biệt
Đây là một lô nhỏ hoàn toàn mang tính sư phạm. Chúng ta cố ý chọn cùng dải [48, 52] và cùng trung vị 50 cho cả năm giờ, để các phép tính rõ ràng ngay lập tức. Đây không phải là trích đoạn từ kết quả r1.
Trên màn hình nhỏ, hãy cuộn bảng theo chiều ngang.
| Giờ minh họa | Giá trị quan sát | q10 |
q50 |
q90 |
Trong dải? | Sai số tuyệt đối của q50 |
|---|---|---|---|---|---|---|
| 1 | 49 | 48 | 50 | 52 | Có | 1 |
| 2 | 50 | 48 | 50 | 52 | Có | 0 |
| 3 | 51 | 48 | 50 | 52 | Có | 1 |
| 4 | 52 | 48 | 50 | 52 | Có, gồm biên | 2 |
| 5 | 55 | 48 | 50 | 52 | Không | 5 |
Mức bao phủ là 4 / 5 = 80 %. Độ rộng trung bình là 52 − 48 = 4. MAE là (1 + 0 + 1 + 2 + 5) / 5 = 1,8. Tỷ lệ giao cắt bằng không: mỗi bộ ba đều có thứ tự.
Với giờ cuối, pinball nhận các đóng góp 0,7, 2,5 và 2,7, tức trung bình khoảng 1,9667. Trên năm giờ và ba quantile, tổng đóng góp là 9,5 và pinball trung bình là 9,5 / 15 = 0,6333….
Vì vậy, chúng ta có 80 % mức bao phủ, không giao cắt mà vẫn có sai số khác không. Các metric mô tả các thuộc tính bổ sung cho nhau, không phải năm cách diễn đạt cùng một điểm số.
Một giá trị trung bình tốt có thể che giấu một phân đoạn kém
Hiệu chuẩn là kiểm tra xem các tỷ lệ công bố có khớp điều ta quan sát không, trên đủ dự báo phù hợp với mục đích sử dụng. Mức bao phủ gần 80 % trên lô mô phỏng này là một quan sát, không bao giờ là bảo đảm cho tương lai.
Một ví dụ giả định khác cho thấy điều đó: nếu nhóm đầu gồm 30 giá trị được bao phủ trên 50 và nhóm thứ hai 50 trên 50, mức bao phủ toàn cục là 80 / 100 = 80 %. Tuy vậy, các nhóm lần lượt ở mức 60 % và 100 %. Giá trị trung bình che giấu hai hành vi rất khác nhau.
Tương tự, mức bao phủ toàn cục 80 % không chứng minh các lần vượt biên phân bố 10 % dưới q10 và 10 % trên q90. Cần xem xét cả hai phía cũng như trung vị. Và 24 dải theo giờ không phải là lời hứa rằng cả ngày sẽ ở trong dải với xác suất 80 %: bao phủ theo giờ và bao phủ đồng thời cả ngày là hai câu hỏi khác nhau.
Những phân biệt này giải thích vì sao một đánh giá thực tế cũng nên xem xét địa điểm, giờ cần dự báo và giai đoạn. Các điểm gốc liên tiếp dùng chung phần lớn lịch sử: không được đồng nhất 8 640 mục tiêu với từng ấy thử nghiệm độc lập nếu không có lý do.
Kết quả quan sát
Đây là các giá trị của bản tái tạo r1, được tập hợp để so sánh các phương pháp. Sai số và độ rộng được biểu thị bằng kW mô phỏng.
Trên màn hình nhỏ, hãy cuộn bảng theo chiều ngang.
| Phương pháp | Pinball | MAE của q50 |
Mức bao phủ | Độ rộng trung bình | Giao cắt quan sát được |
|---|---|---|---|---|---|
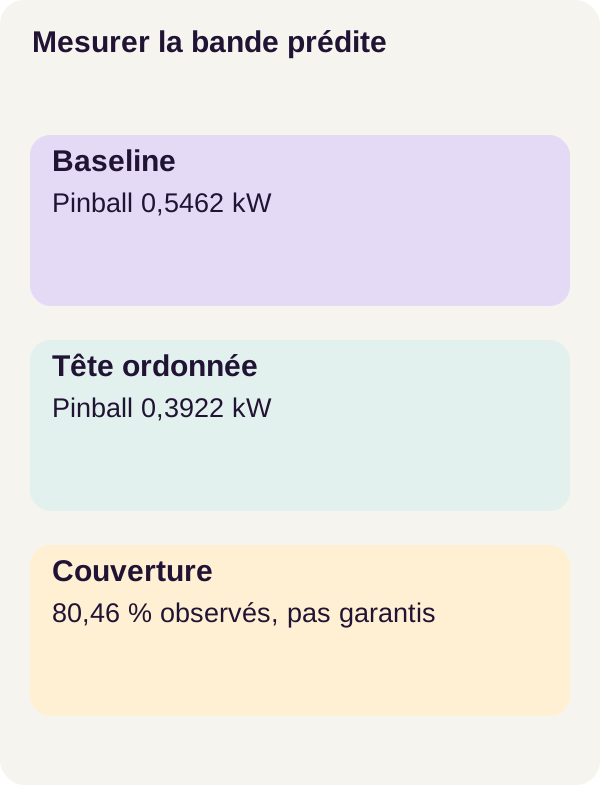
| Baseline theo mùa | 0,5462 | 1,7130 | 80,53 % | 5,4649 | 0 % |
| Đầu độc lập | 0,3939 | 1,2350 | 80,25 % | 3,9847 | 0 % |
| Đầu có thứ tự | 0,3922 | 1,2313 | 80,46 % | 3,9824 | 0 % |
Hai mạng ở đây giảm pinball và sai số trung vị so với tham chiếu theo mùa. Chúng cũng tạo các dải hẹp hơn, trong khi vẫn giữ mức bao phủ toàn cục gần 80 %.
Đầu có thứ tự tốt hơn một chút so với đầu độc lập về pinball và MAE. Để định lượng « một chút », chênh lệch pinball là 0,3939 − 0,3922 = 0,0017 kW, còn chênh lệch MAE là 1,2350 − 1,2313 = 0,0037 kW. Đây là phép trừ các giá trị đã công bố, không phải phép đo mới.
Độ rộng của đầu có thứ tự thấp hơn 5,4649 − 3,9824 = 1,4825 kW so với baseline theo mùa. Tuy nhiên, sẽ gây hiểu lầm nếu kết luận « mức bao phủ càng tăng, mô hình càng tốt »: mức bao phủ danh nghĩa vẫn là 80 %, và cả ba phương pháp đều gần mức đó trên mẫu này.
Cả ba phương pháp đều không có giao cắt quan sát được. Vì vậy, bảng không cho thấy việc sửa các giao cắt thực sự có trong biến thể độc lập. Khác biệt là về cấu trúc: thứ tự được áp đặt trong đầu có thứ tự, trong khi số không ở đầu độc lập chỉ mô tả đánh giá này.
Lần tiếp tục tất định tìm lại cùng tham số với sai số tối đa bằng không, cũng như scaler và khởi tạo dùng chung. Kết quả này liên quan đến việc tái tạo phép tính trong điều kiện được kiểm soát. Tài liệu PyTorch về khả năng tái lập nhắc lý do không nên biến một sự bằng nhau cục bộ thành bảo đảm giữa mọi phiên bản và nền tảng.
Điều chúng ta đã học
Bây giờ chúng ta biết thay một dự báo duy nhất bằng ba ngưỡng được học và hiểu ý nghĩa của dải đi kèm. Pinball dạy quantile các hành vi khác nhau; softplus áp đặt thứ tự của chúng; sau đó các metric kiểm tra giá trị của các đầu ra trên dữ liệu được dành riêng.
Kỷ luật thời gian xuất hiện ở nhiều cấp độ. Lịch sử phải có sẵn tại điểm gốc dự báo, mục tiêu phải ở trong phần dữ liệu của chúng, scaler không được học từ tương lai và khối nhân quả không được dùng vị trí muộn hơn để tính một đầu ra sớm hơn.
Trong thử nghiệm này, mô hình có thứ tự tốt hơn một chút về pinball và MAE, với dải hẹp hơn tham chiếu theo mùa. Nhận xét này không tự động biến nó thành lựa chọn tốt nhất trong sản xuất. Chưa xác thực hiệu chuẩn sau đó, trôi dạt theo mùa hay phân tích chi phí nghiệp vụ của một dự báo thấp.
Vì vậy, kết luận hữu ích không phải « mạng này biết dự báo tải thực », mà là: chúng ta có một lộ trình được kiểm soát để huấn luyện, tiếp tục và so sánh các dự báo quantile mà không nhầm lẫn thứ tự, độ chính xác và hiệu chuẩn.
Bài tập: giả thuyết trước khi chạy lệnh
Hãy trở lại với padding. Chúng ta sẽ sửa một giá trị đầu vào ở thời điểm 10, rồi xem các đầu ra được gán cho thời điểm 0 đến 9.
Trước khi chạy, hãy viết giả thuyết của bạn: một khối nhân quả có được phép thay đổi một đầu ra quá khứ sau thay đổi này không? Và một phép tích chập đối xứng có thể để giá trị ở thời điểm 10 ảnh hưởng đến phép tính ở thời điểm 9 không?
Bộ kiểm tra được cung cấp so sánh hai biến thể. Hãy chạy nó mà không thay thế mạng của lộ trình tham chiếu:
docker compose run --rm gpu python -m quantile_forecast.cli exercise --config configs/exercise.yaml
Đầu ra quan sát được cho 0,0 đối với sai số quá khứ của khối nhân quả và 1,0 đối với biến thể đối xứng. Khối thứ nhất không đổi tại các vị trí được xem xét; biến thể thứ hai cho phép ảnh hưởng từ một vị trí muộn hơn đi qua. Vì vậy, kiểm tra thực sự phát hiện rò rỉ từ tương lai về quá khứ bên trong khối.
1,0 này không phải là tỷ lệ sai số dự báo 100 %: nó là giá trị chênh lệch được báo cáo bởi kiểm tra nhiễu loạn này.
Một sắc thái quan trọng: ta đang nói về tương lai nào? Thời điểm 10 là tương lai so với các đầu ra 0 đến 9 của khối. Nếu nó đã thuộc 168 giờ được biết tại điểm gốc dự báo, việc đọc nó tự nó không phải bằng chứng rằng 24 mục tiêu tương lai đã được dùng. Kiểm tra này xác minh tính nhân quả nội bộ của khối; kiểm tra cửa sổ xác minh riêng ranh giới giữa lịch sử và chân trời cần dự báo.
Để giải thích kết quả, hãy quay lại một bộ lọc có tâm đọc 8, 9 và 10 để tính đầu ra 9. Hãy so sánh nó với một bộ lọc nhân quả ba vị trí chỉ đọc 7, 8 và 9. Cách đọc các phụ thuộc này có giá trị hơn câu nói đơn thuần « kiểm tra đạt ».
Điều chỉnh và đưa vào sử dụng
Thay trình mô phỏng mà không mất hợp đồng thời gian
Với dữ liệu thực, trước hết hãy xác định mỗi dòng đại diện cho điều gì: địa điểm, dấu thời gian, đơn vị và tần suất dự kiến. Một giá trị bị thiếu không tự động là tải bằng không. Một phép đo nhận muộn không nhất thiết đã sẵn có tại thời điểm dự báo của bạn cần được thực hiện.
Vì vậy cần dữ liệu được cho phép và lập phiên bản, chiến lược rõ ràng cho dữ liệu đến muộn và giá trị bị thiếu, cùng cách chia thời gian có thể kiểm tra. Hãy đánh giá điều hệ thống biết vào ngày dự báo, không phải điều một cơ sở dữ liệu được chỉnh sửa sau đó cho phép thấy hôm nay.
Hướng dẫn không xác thực những lựa chọn này trên dữ liệu vận hành. Một sự điều chỉnh tạo thành một thử nghiệm mới: hãy giữ các đầu ra r1, làm việc trên một bản sao và ghi lại mọi thay đổi về dữ liệu, tần suất, chân trời hoặc mô hình.
Liên kết các dải với một quyết định
Một bảng điều khiển có thể hiển thị trung vị và dải mà không kích hoạt hành động. Ngay khi một hành động phụ thuộc vào một biên, cần nêu rõ chi phí của dự báo thấp, dự báo cao và cảnh báo không cần thiết.
Mức q90 không phải là chính sách thận trọng phổ quát. Một ứng dụng có thể cần mức khác, xác thực của con người hoặc quy tắc từ chối khi dải trở nên quá rộng. Đó là các lựa chọn nghiệp vụ cần xác định và kiểm thử, không phải những bảo đảm do softplus mang lại.
Cũng cần kiểm tra hiệu chuẩn theo phân đoạn và theo dõi trôi dạt, tức sự thay đổi của dữ liệu và sai số theo thời gian. Mức bao phủ tốt có được trong thế giới được kiểm soát của trình mô phỏng không đủ khi thói quen, thiết bị hay điều kiện thay đổi.
Xây dựng dịch vụ quanh mô hình
Phần web vẫn là một công việc đầy đủ: truy cập đã xác thực, quyền theo địa điểm, xác thực đầu vào, ghi nhật ký phù hợp, quản lý tải và lỗi, khả năng quan sát, sao lưu và khôi phục. Ngưỡng cảnh báo và hành động gắn với mỗi dải phải rõ ràng.
Mã cung cấp một lộ trình sư phạm về dự báo. Nó không cung cấp dự báo được chứng nhận cũng không phải API nghiệp vụ sẵn sàng triển khai.
Khắc phục sự cố và dọn dẹp
Nếu CUDA thất bại, hãy bắt đầu bằng kiểm tra môi trường và hướng dẫn NVIDIA Container Toolkit. Hãy xác minh truy cập vào card đã chọn từ trong container trước khi thay đổi mô hình.
Nếu kiểm tra tính nhân quả thất bại, hãy xem xét padding và các vị trí được đọc. Đừng sửa điểm số để làm thất bại bớt rõ. Nếu mức bao phủ gây ngạc nhiên dù các quantile có thứ tự, đó không nhất thiết là vấn đề thứ tự: hãy kiểm tra mục tiêu, đơn vị, scaler và tập hợp được đánh giá.
Sau bài tập, hãy tạo các hình, kiểm tra checkpoint, xem trước việc dọn dẹp, rồi dừng các dịch vụ:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
plot.py tạo các hình của lộ trình và check_checkpoints.py kiểm tra checkpoint của nó. Lệnh có --dry-run là một bản xem trước: nó giữ lại các tệp được tạo. Hãy đọc điều nó thông báo trước khi cân nhắc một việc xóa riêng biệt.
Lệnh cuối cùng dừng các tài nguyên Compose của dự án. Nó không thay bản xem trước bằng việc dọn dẹp thực sự các kết quả của bạn. Hãy giữ các đầu ra hữu ích để so sánh các thử nghiệm.
Nguồn chính và tài liệu
Các tham chiếu khởi đầu của hướng dẫn mô tả cơ chế và môi trường của nó:
- Bai, Kolter, Koltun — Temporal Convolutional Networks
- Scikit-learn — pinball loss
- Docker Compose — hỗ trợ GPU
- NVIDIA Container Toolkit — hướng dẫn cài đặt
Để tìm hiểu sâu hơn các giải thích, tham chiếu PyTorch về softplus trình bày chi tiết các gia số, còn quy tắc broadcasting giải thích việc chuyển từ một mục tiêu mỗi giờ sang ba so sánh.
Ví dụ scikit-learn về khoảng dự đoán dùng một mô hình khác: nó bổ sung cho giải thích về quantile, nhưng không là bằng chứng cho kết quả của TCN chúng ta. Trang về rò rỉ dữ liệu đi sâu vào vai trò của tiền xử lý, và tài liệu PyTorch về khả năng tái lập nêu rõ giới hạn của việc tái tạo giữa các môi trường.
Các giá trị thử nghiệm của bài viết này vẫn là các giá trị của lộ trình r1. Các ví dụ số được nêu là sư phạm dùng để làm lại các phép tính; chúng không tạo thành đầu ra GPU mới.
Tải kho lưu trữ và theo toàn bộ lộ trình: mở hướng dẫn.