





Está desarrollando un panel que muestra la carga prevista para mañana. Solo aparece un valor: «50 kW a las 14 horas». Es un comienzo, pero enseguida surge una pregunta: ¿hay que prepararse para un valor cercano a 50 o para una variación mucho mayor?
Una curva central no responde a esta pregunta. Por ello aprenderemos a producir tres estimaciones para cada hora: una baja, una mediana y una alta. El objetivo no es hacer que el futuro sea seguro, sino dar una forma medible a la incertidumbre.
El caso inicial es una ilustración. En el experimento usamos únicamente series simuladas: ningún contador real ni ninguna decisión energética depende de nuestras previsiones.
Descargar el archivo del tutorial.
Lo que construimos
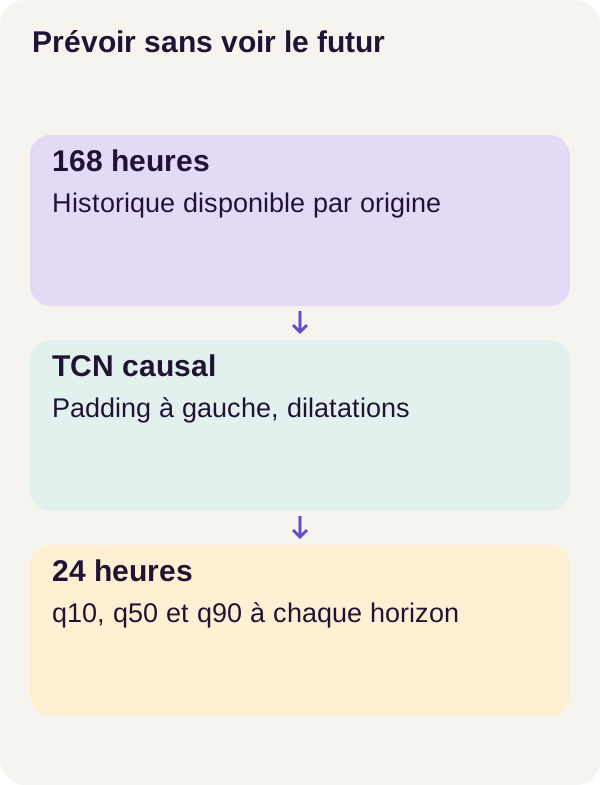
El programa simula doce series horarias y entrena una red para usar las 168 horas anteriores, es decir, siete días, con el fin de prever las 24 horas siguientes. Para cada hora futura produce q10, q50 y q90.
Puede imaginar su entrada como el resultado de una consulta a una tabla de mediciones: un sitio, horas ordenadas y valores ya disponibles. Su salida es una tabla de 24 filas, con tres estimaciones por fila. Esta comparación ayuda a comprender el contrato de datos; el proyecto no proporciona una API de negocio ni conexión a una base de datos de producción.
Comparamos tres métodos: una referencia estacional, denominada baseline, una red con salidas independientes y una red con salidas ordenadas. Las dos redes usan un TCN causal, cuyo funcionamiento explicaremos. La diferencia entre sus «cabezas» se refiere a cómo construyen los tres valores finales.
Al final podrá seguir el paso de los datos a las predicciones, calcular la pérdida de cuantiles, comprobar el respeto del tiempo e interpretar los resultados. Los números siguen siendo kW simulados: este tutorial no es una previsión energética operativa.
Conceptos: qué garantizan los cuantiles y qué no
Tres umbrales en lugar de un valor y un margen arbitrario
Un cuantil es un umbral asociado a una proporción. Aquí buscamos cuantiles condicionales: dependen del historial disponible y se refieren a una hora futura concreta.
Tomemos un ejemplo pedagógico, distinto de las salidas del modelo:
| Estimación | Valor ilustrativo | Lo que buscamos estimar |
|---|---|---|
q10 |
42 kW | Un umbral por debajo del cual se situarían aproximadamente el 10 % de los valores, en las condiciones consideradas. |
q50 |
50 kW | La mediana: un valor que divide la distribución en dos mitades. |
q90 |
63 kW | Un umbral por debajo del cual se situarían aproximadamente el 90 % de los valores, en las condiciones consideradas. |
La banda va de 42 a 63 kW. Por tanto, su anchura es 63 − 42 = 21 kW. Busca una cobertura de 90 % − 10 % = 80 %.
Observe que la mediana no está necesariamente en el centro de la banda: aquí está a 8 kW del límite bajo y a 13 kW del límite alto. No hemos impuesto un margen simétrico como «valor central ± 5».
q90 no significa «una predicción exacta al 90 %». Este número designa el nivel del cuantil buscado, no una calificación de confianza atribuida a la respuesta. Del mismo modo, q50 designa la mediana, no necesariamente la media.
La red estima estos umbrales para el futuro. No se limita a ordenar los 168 valores pasados y extraer tres posiciones. El ejemplo oficial de regresión cuantílica de scikit-learn ilustra esta diferencia entre predicción central, cuantiles y cobertura observada.
¿Cómo aprender un cuantil con un único valor real?
Para una hora dada no disponemos de cien futuros posibles: observamos un solo valor. ¿Cómo enseñar tres cuantiles a la red?
Le presentamos muchos historiales, cada uno acompañado de los valores que realmente siguieron. Una función de pérdida asigna un coste a los errores. Al acumular esos costes en los ejemplos, el entrenamiento ajusta los parámetros de la red.
Para aprender una mediana, un error hacia arriba y otro de igual amplitud hacia abajo se penalizan igual. Para aprender un cuantil alto, penalizamos más una estimación demasiado baja. Ese es el papel de la pinball loss, o pérdida de cuantiles.
Llamemos y al valor observado, q al valor predicho y τ —la letra griega «tau»— al nivel del cuantil. En nuestro caso, τ vale 0,1, 0,5 o 0,9.
La fórmula es:
erreur = y − q
perte = max(τ × erreur, (τ − 1) × erreur)
No necesita memorizar esta escritura antes de entenderla. Para un objetivo de 50, estos son los costes de dos predicciones ficticias:
| Predicción | Error y − q |
Coste para q10 |
Coste para q50 |
Coste para q90 |
|---|---|---|---|---|
| 48: demasiado baja en 2 | +2 | 0,2 | 1,0 | 1,8 |
| 52: demasiado alta en 2 | −2 | 1,8 | 1,0 | 0,2 |
Para q90, subestimar en 2 cuesta 0,9 × 2 = 1,8. Sobreestimar en 2 solo cuesta 0,1 × 2 = 0,2. Para q10 ocurre lo contrario. Las penalizaciones siguen siendo positivas o nulas; cambia su peso según el sentido del error.
¿Por qué la red no elevaría q90 indefinidamente? Porque sobreestimar cuesta menos, pero no cuesta cero. La pérdida busca un compromiso en todos los ejemplos, no un límite que lo abarque todo a cualquier precio. La documentación de la pinball loss usa la misma convención de cálculo.
Un TCN: filtros que recorren el tiempo
TCN significa Temporal Convolutional Network, o red de convoluciones temporales. Una convolución combina varios valores cercanos con coeficientes aprendidos. Puede relacionarla con una media móvil, con una diferencia esencial: la red aprende los coeficientes y combina varios tratamientos, en lugar de recibir una regla de media fijada a mano.
Un filtro temporal causal trabaja solo con la posición actual y las anteriores. En un ejemplo de tres valores, la salida en el tiempo 10 puede leer los tiempos 8, 9 y 10, pero no el tiempo 11.
La dilatación separa las posiciones leídas. Siempre en este ejemplo de tres valores:
Dilatation 1, sortie au temps 10 : lecture des temps 8, 9 et 10.
Dilatation 2, sortie au temps 10 : lecture des temps 6, 8 et 10.
Dilatation 4, sortie au temps 10 : lecture des temps 2, 6 et 10.
Estos índices ilustran el mecanismo, no la configuración exacta de la red entregada. Al apilar capas se amplía el campo receptivo, es decir, el conjunto de posiciones que pueden influir en una salida. Proporcionar 168 horas al programa y demostrar que su arquitectura puede aprovecharlas todas son dos comprobaciones distintas.
El principio de las convoluciones causales dilatadas se describe en el estudio de Bai, Kolter y Koltun. Aquí «causal» significa respetar el orden temporal de la información. No significa que el modelo haya identificado las causas físicas de una variación de carga.
El padding: completar un borde sin leer después de él
Al inicio de una secuencia, algunas posiciones requeridas por un filtro no existen. El padding consiste en completar ese borde con valores de relleno. El TCN del tutorial usa padding a la izquierda, del lado del pasado, para mantener el comportamiento causal.
Una convolución centrada puede, por el contrario, usar una posición situada a la derecha de la que calcula. En el tiempo 9, un filtro centrado en tres posiciones leería 8, 9 y 10: el valor 10 podría entonces modificar una salida atribuida al tiempo 9. El ejercicio final hace observable esta diferencia.
Este control interno no sustituye al de los datos. Una red causal puede recibir un historial mal construido que contenga información no disponible en el momento de prever. Por tanto, también comprobaremos el corte de las ventanas y el cálculo del preprocesamiento.
Dos cabezas: estimar libremente o imponer un orden
La cabeza es la parte final de la red que transforma lo que ha calculado en valores de salida.
Con la cabeza independiente, las tres salidas no están obligadas a respetar un orden. La red podría proponer, por ejemplo, q10 = 52, q50 = 50 y q90 = 49. Sería un cruce: el supuesto límite bajo superaría el límite alto. «Independiente» describe aquí la ausencia de esta restricción; no significa que las horas o las series sean estadísticamente independientes.
La cabeza ordenada parte de q10 y añade incrementos obtenidos con softplus. Su principio se lee así; las letras a, b y c son una notación pedagógica para tres salidas brutas:
q10 = a
q50 = q10 + softplus(b)
q90 = q50 + softplus(c)
En su forma habitual, softplus(x) = log(1 + exp(x)). Transforma un valor en un incremento positivo y sigue siendo adecuada para calcular gradientes. La documentación de PyTorch sobre softplus detalla esta operación y su implementación numérica.
Por ejemplo, softplus(0) = log(2) ≈ 0,6931. Con a = 48, b = 0 y c = 0, las tres salidas se convierten aproximadamente en 48, 48,6931 y 49,3863. Este ejemplo explica la construcción; no es una predicción recogida en el experimento.
Para salidas finitas, esta construcción impone q10 ≤ q50 ≤ q90. No impone que la carga aumente a lo largo de las 24 horas, que q10 sea positivo ni que la banda contenga la proporción correcta de observaciones.
Piense en una validación de formulario que impone «fecha de inicio ≤ fecha de fin». Comprueba un orden coherente; no demuestra que las fechas correspondan a la cita real. Una banda ordenada no es automáticamente una banda bien calibrada.
Requisitos previos de Docker y GPU
Debe sentirse cómodo con las funciones de Python, los arrays, una terminal y los fundamentos de Docker. Las nociones de aprendizaje se introducen en el recorrido; no es necesario conocer ya los TCN.
El recorrido requiere Linux x86_64, Docker Compose, NVIDIA Container Toolkit y una RTX 3090 de 24 GiB, además de 16 GiB de RAM y 16 GiB de disco disponibles, sin contar las capas Docker compartidas. Usa una tarjeta; tener dos GPU no obliga a solicitar ambas para este ejercicio.
La GPU es el procesador gráfico usado para los cálculos de la red. CUDA permite aquí a PyTorch utilizarlo. La comprobación de entorno inicializa CUDA desde el contenedor y ejecuta un cálculo: ver una tarjeta en el host no basta. Esta comprobación debe tener éxito antes del entrenamiento. La documentación de Docker sobre acceso a GPU y la guía de NVIDIA Container Toolkit describen esta integración.
Para elegir la tarjeta, exporte GPU_DEVICE=0 o el UUID de una tarjeta antes de los comandos. El UUID es su identificador; es otra forma de seleccionarla además de su índice. Mantenga el recorrido GPU proporcionado para reproducir los resultados: aquí no se presenta ningún resultado equivalente en CPU.
El cálculo GPU se realiza sin red. Los contenedores usan un sistema de archivos de solo lectura, no-new-privileges, capacidades Linux eliminadas y límites de CPU, RAM y PID. En desarrollo web, esto equivale a limitar lo que un proceso puede hacer y consumir, no a certificar sus predicciones.
Un checkpoint es un estado guardado que permite recargar o reanudar un cálculo. No cargue un checkpoint de Torch procedente de una fuente no fiable.
Datos: separar el tiempo antes de entrenar
Un pequeño mundo cuyas reglas conocemos
El simulador produce 12 series de 180 días, es decir, 180 × 24 = 4 320 valores horarios por sitio. Cada serie combina un nivel base, un ciclo diario, un ciclo semanal, fluctuaciones aleatorias y algunos eventos puntuales.
Los ciclos dan a la red regularidades que aprender. Las fluctuaciones impiden que el futuro se reduzca a una repetición perfectamente determinista. Conocemos la receta de los datos, lo que facilita los controles; no por ello son representativos de sitios reales.
La división es cronológica, con una numeración de días que empieza en cero:
| Parte de los datos | Días | Función |
|---|---|---|
Entrenamiento, o train |
0–119 | Aprender los parámetros de la red y ajustar el scaler. |
| Validación | 120–149 | Examinar el modelo en un periodo posterior, distinto del entrenamiento. |
| Prueba | 150–179 | Medir el resultado en el último periodo reservado. |
Un scaler transforma la escala de los números antes de que el modelo los use. Cuando una transformación así aprende estadísticas, estas deben proceder solo de train. Usar los 180 días para calcularlas ya transmitiría información sobre periodos futuros, incluso sin proporcionar directamente sus objetivos a la red. Este riesgo de fuga en el preprocesamiento se explica en la documentación de scikit-learn sobre fugas de datos.
La regla del proyecto es, por tanto: ajustar en train y conservar esta transformación para los demás periodos. El tipo exacto de scaler es el del código entregado; no hace falta sustituirlo por otra normalización para seguir el tutorial.
Leer el simulador
El siguiente extracto crea las series y conserva los parámetros que las produjeron. np designa NumPy y TEST_END el límite horario definido en el proyecto. Son extractos del programa completo: los comandos Docker de más abajo ejecutan todo el conjunto, con sus importaciones y configuración.
def simulate(seed=17):
    rng = np.random.default_rng(seed)
    t = np.arange(TEST_END)
    series = []
    parameters = []
    for site in range(12):
        baseline = 35 + 2 * site
        daily = 5 + 0.3 * site
        weekly = 3 + 0.1 * site
        phase = 0.17 * site
        noise = 1.2 + 0.05 * site
        value = (
            baseline
            + daily * np.sin(2 * np.pi * t / 24 + phase)
            + weekly * np.cos(2 * np.pi * t / 168)
            + rng.normal(0, noise, len(t))
        )
        events = []
        for day in (25 + site, 75 + site, 125 + site, 155 + site):
            start = day * 24 + 8
            amplitude = 4 + site / 3
            value[start : start + 8] += amplitude
            events.append({"start": start, "duration": 8, "amplitude": amplitude})
        series.append(value)
        parameters.append(
            {
                "site": site,
                "baseline": baseline,
                "daily_amplitude": daily,
                "weekly_amplitude": weekly,
                "phase": phase,
                "noise_std": noise,
                "events": events,
            }
        )
    return np.asarray(series, dtype="float32"), parameters
¿Qué acaba de ocurrir?
np.random.default_rng(seed) inicializa el generador seudoaleatorio. La semilla predeterminada es 17. En un entorno sin cambios, repetir las mismas operaciones con esta semilla permite recuperar los mismos sorteos.
El bucle recorre los sitios del 0 al 11. baseline = 35 + 2 * site da a cada uno un nivel de fondo distinto. Atención al vocabulario: esta variable baseline es el nivel base de la señal, no el modelo de referencia estacional comparado más adelante.
Los términos sin(... / 24 ...) y cos(... / 168 ...) añaden oscilaciones diarias y semanales. Las amplitudes daily y weekly regulan su importancia, mientras phase desplaza el ciclo diario. rng.normal(0, noise, len(t)) añade ruido gaussiano centrado en cero; noise regula su desviación estándar y, por tanto, la amplitud de sus fluctuaciones.
El segundo bucle añade cuatro eventos de ocho horas por sitio. Para el sitio 0, por ejemplo, el evento del día 25 comienza en el índice 25 × 24 + 8 = 608. El tramo 608:616 aumenta ocho valores en 4. Es una lectura de la fórmula del simulador, no de la previsión aprendida por la red.
Por último, la función devuelve un array float32 y la lista parameters, que documenta la generación. float32 indica que los números se almacenan en coma flotante de 32 bits.
Alcance del extracto: simulate() crea los valores y sus parámetros; no contiene la construcción de las ventanas ni la elección de los orígenes. Estas operaciones pertenecen a la preparación completa. Conocer los eventos en el simulador tampoco autoriza a proporcionarlos como información futura al modelo.
Un origen: el instante desde el que se prevé
Un origen de previsión es el punto de partida de una previsión. Para leer los índices, llamemos aquí T a la primera hora que se debe prever. Esta convención explicativa da:
Historique visible : T − 168, ..., T − 1   → 168 valeurs déjà connues.
Cibles à prévoir   : T, ..., T + 23       → 24 valeurs futures.
Durante el entrenamiento, estos objetivos son conocidos por el programa y sirven para calcular el error. No deben mezclarse con el historial proporcionado como entrada. Es el mismo principio que en un conjunto de pruebas: la respuesta esperada sirve para corregir el resultado, no para rellenar los datos de la función que se prueba.
Las ventanas de entrenamiento avanzan una hora. Sus objetivos deben permanecer por completo en train. La validación y la prueba usan un origen por día y por sitio:
12 sites × 30 jours = 360 origines par partie
360 origines × 24 heures = 8 640 cibles horaires par partie
Representa 8 640 valores que comprobar, no 8 640 días. Cada valor recibe tres estimaciones: 8 640 × 3 = 25 920 contribuciones elementales a la pérdida de cuantiles.
Cruzar una frontera con el historial no es necesariamente una fuga
Tomemos el primer origen de validación, al comienzo del día 120. Los días 113 a 119 forman un historial de siete días ya disponible. Que esos valores pertenezcan a train no plantea problema: están en el pasado de esta previsión.
En cambio, una ventana de entrenamiento cuyo primer objetivo fuera la última hora del día 119 se extendería al día 120 para sus demás objetivos. Mezclaría entrenamiento y validación, por lo que debe excluirse.
La misma lógica se aplica a la prueba. Al inicio del día 150, los días 143 a 149 ya se conocen. Más tarde, observaciones del inicio de la prueba pueden servir de historial a un origen posterior, si estaban realmente disponibles en esa fecha. Eso no significa reentrenar la red ni reajustar el scaler con la prueba.
Así, la evaluación reproduce previsiones sucesivas. No predice los treinta días de prueba de una vez desde su primera mañana.
El código central: la pérdida de cuantiles
Comprender las dimensiones antes de las operaciones
Un tensor es aquí un array de números de varias dimensiones. En un lote de B ejemplos, donde B es el número de ventanas tratadas juntas, tenemos:
prediction : B × 24 × 3   → un triplet q10, q50, q90 pour chaque heure.
target     : B × 24       → une seule valeur observée pour chaque heure.
Para un único ejemplo, la red propone 72 números y disponemos de 24 valores de referencia. Las tres predicciones de una hora se comparan con el mismo objetivo, con tres penalizaciones distintas.
def pinball_loss(prediction, target):
    tau = torch.tensor(
        [0.1, 0.5, 0.9], device=prediction.device, dtype=prediction.dtype
    )
    error = target[..., None] - prediction
    return torch.maximum(tau * error, (tau - 1) * error).mean()


def check_loss(config):
    p = torch.zeros(1, 1, 3)
    positive = pinball_loss(p, torch.ones(1, 1))
    negative = pinball_loss(p, -torch.ones(1, 1))
    assert torch.allclose(positive, torch.tensor(0.5)) and torch.allclose(
        negative, torch.tensor(0.5)
    )
    return {
        "e_plus_1": [0.1, 0.5, 0.9],
        "e_minus_1": [0.9, 0.5, 0.1],
        "mean_positive": float(positive),
        "mean_negative": float(negative),
    }
Leer las tres operaciones de pinball_loss()
tau contiene los niveles [0.1, 0.5, 0.9], en el mismo orden que las tres salidas. device y dtype le asignan la misma ubicación de cálculo y el mismo tipo numérico que prediction.
target[..., None] añade una dimensión de tamaño 1 al final del array: B × 24 pasa a ser B × 24 × 1. PyTorch puede comparar entonces cada objetivo con las tres predicciones correspondientes. Esta ampliación implícita de dimensiones compatibles se llama broadcasting; la documentación de PyTorch explica sus reglas.
Por último, torch.maximum(...) elige el coste adecuado para cada error. .mean() promedia todos estos costes: en los ejemplos del lote, las 24 horas y los tres cuantiles. El resultado es un escalar, es decir, un solo número.
La función calcula la pérdida, pero no modifica por sí misma los parámetros. Durante el entrenamiento, los gradientes indican cómo afectaría a esta pérdida una variación de parámetros y el optimizador aplica las actualizaciones. Durante la evaluación se puede calcular la misma pérdida sin entrenar nada.
Un cálculo que puede rehacer a mano
Tomemos una hora ficticia con y = 50 y las predicciones q10 = 47, q50 = 51, q90 = 55.
El cuantil bajo subestima en 3: su coste es 0,1 × 3 = 0,3. La mediana sobreestima en 1: su coste es 0,5 × 1 = 0,5. El cuantil alto sobreestima en 5: su coste es 0,1 × 5 = 0,5.
La pérdida media de esta hora es, por tanto:
(0,3 + 0,5 + 0,5) / 3 = 0,4333…
El valor real está dentro de la banda [47, 55], pero la pérdida no es nula. No es una contradicción: estar cubierto y obtener una buena puntuación de cuantiles no son el mismo control.
Con τ = 0,5, la pinball equivale a la mitad del error absoluto. Esta identidad se refiere al componente mediano, no a la media de los tres cuantiles. La referencia mean_pinball_loss permite comprobar esta propiedad.
La pérdida tiene la unidad de los números que recibe. Las medidas publicadas más abajo se expresan en kW simulados; una pérdida calculada en una escala transformada no debe compararse directamente con ellas sin considerar el scaler.
Qué comprueba check_loss() y qué no
El control construye tres predicciones nulas y después un objetivo +1 y otro −1. Las contribuciones esperadas son respectivamente [0,1 ; 0,5 ; 0,9] y [0,9 ; 0,5 ; 0,1]. Su media vale 0,5 en ambos casos.
La aserción comprueba estas dos medias con torch.allclose, que compara valores con tolerancia numérica. En cambio, las listas e_plus_1 y e_minus_1 que devuelve la función están codificadas de forma fija, no se recalculan a partir de contribuciones intermedias.
Atención: esta media no basta para detectar una inversión del signo. Con estos tres niveles simétricos y predicciones idénticas, reemplazar
target − predictionporprediction − targetintercambiaría las contribuciones de los cuantiles bajo y alto sin cambiar la media de0,5. La fórmula visible usa el sentido correcto; hay que distinguir el alcance de esta aserción del de un control por cuantil.
Para reforzar este control en un experimento separado habría que comparar las contribuciones de cada nivel o añadir predicciones distintas por cuantil. El código de referencia anterior no cambia. Esta observación no prejuzga el contenido de las demás pruebas del proyecto.
Instalar y comprobar el entorno
Extraiga el archivo y sitúe su terminal en su raíz, donde están los scripts y la configuración Compose. Todos los comandos siguientes parten de ese mismo directorio.
Este proyecto no tiene pesos preentrenados que descargar: aquí acquire valida un manifiesto sin pesos. Las series las fabricará prepare y la red se entrenará con esos datos. El papel de este paso es distinto de adquirir un modelo de lenguaje grande.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
Lea esta secuencia como la preparación de un entorno de desarrollo. setup.sh prepara el proyecto; config --quiet comprueba la configuración Compose; build acquire gpu construye las imágenes de los dos servicios. Después vienen la validación del manifiesto, el cálculo de control CUDA en el contenedor y la batería de pruebas con pytest.
Observación esperada: cada comando debe terminar sin error. La comprobación de entorno debe tener éxito antes del entrenamiento. Una batería de pruebas correcta comprueba el programa en los casos previstos; todavía no ha medido la calidad de las previsiones en la prueba.
Conserve las versiones y ajustes del archivo para la reproducción. Las referencias al final del artículo sirven para entender los mecanismos, no para sustituir las dependencias del proyecto por sus versiones más recientes.
Preparar, comparar y entrenar
Ahora podemos crear los datos, establecer la referencia estacional, inspeccionar la red, comprobar la pérdida y entrenar las dos cabezas. La secuencia incluye también una parada voluntaria, una reanudación y una comparación de estados antes de la evaluación.
Los resultados publicados a continuación proceden de la reproducción para lectores validada de este recorrido r1.
docker compose run --rm gpu python -m quantile_forecast.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli baseline --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli inspect-model --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli check-loss --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml --variant independent
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml --stop-after 1000 --run-name interrupted
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m quantile_forecast.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli evaluate --config configs/minimum.yaml
Preparar una referencia antes de pedir más a la red
prepare prepara las series y ventanas según las reglas temporales descritas. baseline establece la referencia estacional: un punto de comparación que aprovecha la repetición de patrones en el tiempo.
El interés de una baseline no es fabricar un adversario fácil de vencer. Permite plantear una pregunta útil: ¿qué aporta la red frente a un método de referencia? El detalle de esta baseline es el del archivo; los extractos del artículo no dan su fórmula completa.
inspect-model precede a los entrenamientos y permite comprobar la red. check-loss ejecuta el control numérico que acabamos de leer. Consulte sus resultados antes de iniciar la parte más costosa del recorrido.
Comparar dos construcciones de salida
El comando train del recorrido entrena la cabeza ordenada; --variant independent inicia la variante independiente. Su comparación se centra, entre otros aspectos, en el error de cuantiles, la mediana, la cobertura, la anchura y los cruces.
No sustituya una cabeza por una simple ordenación de resultados antes de evaluar. Ordenar después crearía otro tratamiento, cuyas salidas habría que conservar y medir por separado.
Reanudar: continuar un estado, no reiniciar un ensayo
El comando con --stop-after 1000 --run-name interrupted detiene voluntariamente el entrenamiento en el paso 1 000. Un paso es una etapa del entrenamiento; este número no designa mil horas de previsión ni mil días de datos.
El comando siguiente recarga artifacts/checkpoints/interrupted/state.pt y continúa con el nombre resumed. Después, compare-resume compara la reanudación con el recorrido de referencia.
Puede relacionar esta operación con un procesamiento de cola reanudable: recuperar el último archivo escrito no basta si se ha perdido el estado necesario para continuar exactamente en el mismo punto. La prueba de reanudación del proyecto hace comprobable esta continuidad, en lugar de suponerla.
Por último, evaluate produce las medidas de los métodos comparados. Un error máximo nulo durante la reanudación y una buena precisión de previsión son resultados distintos: uno se refiere a la continuidad del cálculo y el otro a la calidad de las salidas.
Medidas antes de los resultados
Cada resultado agrega 360 orígenes y 8 640 objetivos horarios. Antes de comparar las cifras, fijemos el sentido de cada medida.
Pinball: la calidad de los tres umbrales
La pinball media aplica el cálculo anterior a los tres cuantiles. Aquí se expresa en kW simulados. Más bajo es mejor, para una misma población, los mismos cuantiles y la misma convención de unidad. No es un porcentaje de previsiones exactas.
MAE: el error de la mediana solamente
La MAE, por Mean Absolute Error, es la media de las desviaciones absolutas. En este tutorial se refiere a q50:
MAE = moyenne de |valeur observée − q50|
Una mediana de 50 ante una observación de 53 contribuye 3 kW. El límite bajo y el alto no intervienen en este cálculo. «MAE de la mediana» significa media de los errores de q50, no mediana de todos los errores.
Cobertura: ¿cuántos valores caen dentro de la banda?
Un objetivo queda cubierto cuando q10 ≤ y ≤ q90, límites incluidos. La cobertura es el número de objetivos cubiertos dividido por el número total de objetivos.
El objetivo nominal es 80 %, no 100 %. Una cobertura demasiado baja indica que la banda omite observaciones con demasiada frecuencia; una cobertura muy alta puede corresponder a una banda demasiado prudente para el nivel anunciado. Por tanto, hay que leer esta medida junto con la anchura y las demás puntuaciones.
Anchura: ¿qué margen se anuncia?
La anchura es q90 − q10 y el programa calcula después su media. Con una cobertura comparable, una banda más estrecha es más precisa en lo que anuncia. Pero una banda diminuta que falla en la mayoría de observaciones no es un éxito.
A la inversa, ensanchar una banda hasta cubrir casi todos los valores no basta para producir una previsión útil. Si el intervalo es demasiado amplio para orientar una decisión, su cobertura por sí sola no resuelve el problema inicial.
Cruces: ¿están los tres valores en el orden correcto?
La tasa de cruces cuenta los tripletes que no respetan q10 ≤ q50 ≤ q90. Se aplica a los 8 640 tripletes, no a sus 25 920 números por separado.
Una cabeza ordenada pretende eliminar este problema por construcción. Una cabeza independiente también puede no presentar cruces en un conjunto dado; esta observación no se convierte en garantía para datos futuros.
Cinco horas para entender las diferencias
Aquí tiene un pequeño lote completamente pedagógico. Elegimos deliberadamente la misma banda [48, 52] y la misma mediana 50 en las cinco horas para que los cálculos sean inmediatos. No es un extracto de los resultados r1.
En pantallas pequeñas, desplace la tabla horizontalmente.
| Hora ilustrativa | Valor observado | q10 |
q50 |
q90 |
¿En la banda? | Error absoluto de q50 |
|---|---|---|---|---|---|---|
| 1 | 49 | 48 | 50 | 52 | Sí | 1 |
| 2 | 50 | 48 | 50 | 52 | Sí | 0 |
| 3 | 51 | 48 | 50 | 52 | Sí | 1 |
| 4 | 52 | 48 | 50 | 52 | Sí, límite incluido | 2 |
| 5 | 55 | 48 | 50 | 52 | No | 5 |
La cobertura es 4 / 5 = 80 %. La anchura media es 52 − 48 = 4. La MAE es (1 + 0 + 1 + 2 + 5) / 5 = 1,8. La tasa de cruces es nula: cada triplete está ordenado.
Para la última hora, la pinball recibe contribuciones 0,7, 2,5 y 2,7, una media aproximada de 1,9667. En las cinco horas y los tres cuantiles, el total de contribuciones es 9,5 y la pinball media 9,5 / 15 = 0,6333….
Tenemos, por tanto, 80 % de cobertura, cero cruces y aun así errores no nulos. Las métricas describen propiedades complementarias, no cinco formulaciones de una misma puntuación.
Una buena media puede ocultar un segmento malo
La calibración consiste en comprobar si las proporciones anunciadas corresponden a lo que se observa, en suficientes previsiones pertinentes para el uso previsto. Una cobertura cercana al 80 % en este lote simulado es una observación, nunca una garantía de futuro.
Otro ejemplo ficticio lo muestra: si un primer grupo contiene 30 valores cubiertos de 50 y un segundo 50 de 50, la cobertura global es 80 / 100 = 80 %. Sin embargo, los grupos están respectivamente al 60 % y al 100 %. La media oculta dos comportamientos muy distintos.
Asimismo, una cobertura global del 80 % no demuestra que los rebasamientos se distribuyan en un 10 % por debajo de q10 y un 10 % por encima de q90. Hay que examinar ambos lados, así como la mediana. Además, las 24 bandas horarias no prometen que todo el día permanezca dentro de la banda con probabilidad del 80 %: la cobertura por hora y la cobertura simultánea del día son preguntas diferentes.
Estas distinciones explican por qué una evaluación real también debería observar los sitios, las horas que prever y los periodos. Los orígenes sucesivos comparten gran parte de su historial: no se deben considerar sin justificación 8 640 objetivos como otros tantos ensayos independientes.
Resultados observados
Estos son los valores de la reproducción r1, reunidos para comparar los métodos. Los errores y las anchuras se expresan en kW simulados.
En pantallas pequeñas, desplace la tabla horizontalmente.
| Método | Pinball | MAE de q50 |
Cobertura | Anchura media | Cruces observados |
|---|---|---|---|---|---|
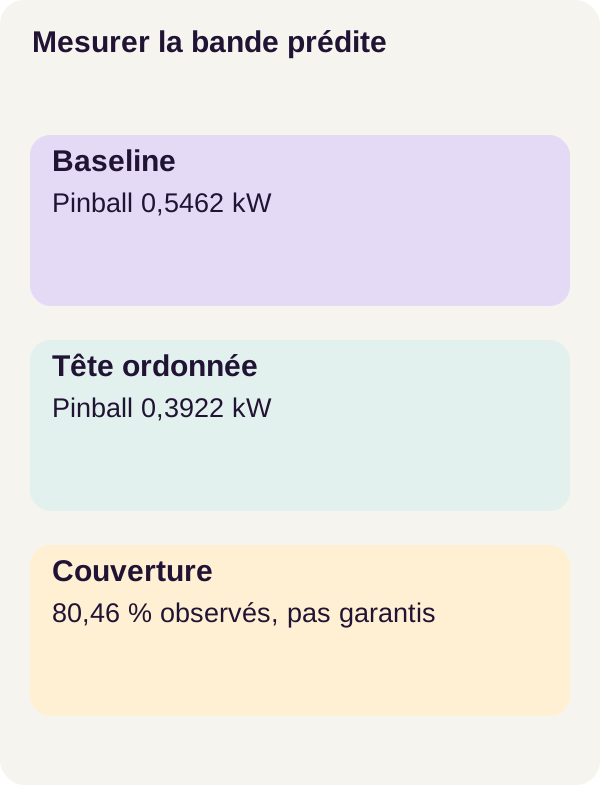
| Baseline estacional | 0,5462 | 1,7130 | 80,53 % | 5,4649 | 0 % |
| Cabeza independiente | 0,3939 | 1,2350 | 80,25 % | 3,9847 | 0 % |
| Cabeza ordenada | 0,3922 | 1,2313 | 80,46 % | 3,9824 | 0 % |
Aquí, las dos redes reducen la pinball y el error de la mediana respecto a la referencia estacional. También producen bandas más estrechas y conservan una cobertura global cercana al 80 %.
La cabeza ordenada es ligeramente mejor que la independiente en pinball y MAE. Para dar escala a «ligeramente», la diferencia de pinball es 0,3939 − 0,3922 = 0,0017 kW, y la de MAE 1,2350 − 1,2313 = 0,0037 kW. Son restas de valores publicados, no medidas nuevas.
La anchura de la cabeza ordenada es 5,4649 − 3,9824 = 1,4825 kW menor que la baseline estacional. Sin embargo, sería engañoso concluir que «cuanto más sube la cobertura, mejor es el modelo»: la cobertura nominal sigue siendo 80 % y los tres métodos se acercan a ella en esta muestra.
Los tres métodos tienen cero cruces observados. Por tanto, la tabla no muestra una corrección de cruces realmente presentes en la variante independiente. La diferencia es estructural: el orden se impone en la cabeza ordenada, mientras que el cero de la cabeza independiente solo describe esta evaluación.
La repetición determinista recupera los mismos parámetros con un error máximo nulo, además del scaler y la inicialización compartida. Este resultado se refiere a la reproducción controlada del cálculo. La documentación de PyTorch sobre reproducibilidad recuerda por qué no se debe convertir una igualdad local en garantía entre todas las versiones y plataformas.
Lo que hemos aprendido
Ahora sabemos sustituir una previsión única por tres umbrales aprendidos y dar sentido a la banda que los acompaña. La pinball enseña comportamientos distintos a los cuantiles; softplus impone su orden; las métricas comprueban después el valor de esas salidas en los datos reservados.
La disciplina temporal interviene en varios niveles. El historial debe estar disponible en el origen de previsión, los objetivos deben permanecer en su parte de los datos, el scaler no debe aprender del futuro y el bloque causal no debe usar una posición posterior para calcular una salida anterior.
En este experimento, el modelo ordenado es ligeramente mejor en pinball y MAE, con una banda más estrecha que la referencia estacional. Esta constatación no lo convierte automáticamente en la mejor elección en producción. No se ha validado ninguna calibración posterior, deriva estacional ni análisis del coste de negocio de una subestimación.
La conclusión útil no es «esta red sabe prever una carga real», sino: disponemos de un recorrido controlado para entrenar, reanudar y comparar previsiones por cuantiles sin confundir orden, precisión y calibración.
Ejercicio: hipótesis antes del comando
Volvamos al padding. Modificaremos un valor de entrada situado en el tiempo 10 y examinaremos las salidas atribuidas a los tiempos 0 a 9.
Antes de ejecutar, escriba su hipótesis: ¿un bloque causal puede modificar una salida pasada después de este cambio? ¿Y una convolución simétrica puede dejar que el valor del tiempo 10 influya en el cálculo del tiempo 9?
El control proporcionado compara las dos variantes. Ejecútelo sin sustituir la red del recorrido de referencia:
docker compose run --rm gpu python -m quantile_forecast.cli exercise --config configs/exercise.yaml
La salida observada da 0,0 para el error pasado del bloque causal y 1,0 para la variante simétrica. El primero permanece sin cambios en las posiciones examinadas; la segunda deja pasar una influencia de una posición posterior. Por tanto, la prueba detecta bien la fuga del futuro hacia el pasado dentro del bloque.
Este 1,0 no es una tasa de error de previsión del 100 %: es el valor de diferencia comunicado por este control de perturbación.
Matiz importante: ¿de qué futuro hablamos? El tiempo 10 es futuro respecto a las salidas 0 a 9 del bloque. Si ya pertenece a las 168 horas conocidas en el origen de previsión, leerlo no prueba por sí solo que se hayan usado los 24 objetivos futuros. La prueba verifica la causalidad interna del bloque; el control de ventanas verifica por separado la frontera entre historial y horizonte que prever.
Para explicar el resultado, vuelva a un filtro centrado que lee 8, 9 y 10 para calcular la salida 9. Compárelo con un filtro causal de tres posiciones que solo leería 7, 8 y 9. Esta lectura de dependencias vale más que la única frase «la prueba pasa».
Adaptar y producir
Sustituir el simulador sin perder el contrato temporal
Con datos reales, comience por definir qué representa cada fila: el sitio, la marca temporal, la unidad y la frecuencia esperada. Un valor ausente no equivale automáticamente a una carga nula. Una medición recibida con retraso no estaba necesariamente disponible cuando habría debido hacerse la previsión.
Por tanto, hacen falta datos autorizados y versionados, una estrategia explícita para retrasos y valores ausentes, y una división temporal verificable. Evalúe lo que el sistema sabía en la fecha de previsión, no lo que una base corregida posteriormente permite ver hoy.
El tutorial no valida estas decisiones con datos operativos. Una adaptación constituye un experimento nuevo: conserve las salidas r1, trabaje en una copia y documente cada cambio de datos, frecuencia, horizonte o modelo.
Vincular las bandas a una decisión
Un panel puede mostrar una mediana y una banda sin desencadenar acción. Desde que una acción depende de un límite, hay que precisar el coste de una subestimación, una sobreestimación y una alerta inútil.
El nivel q90 no es una política universal de prudencia. Una aplicación puede necesitar otro nivel, validación humana o una regla de rechazo cuando la banda se hace demasiado amplia. Son decisiones de negocio que deben definirse y probarse, no garantías proporcionadas por softplus.
También habrá que comprobar la calibración por segmento y seguir la deriva, es decir, la evolución de los datos y los errores en el tiempo. Una buena cobertura obtenida en el mundo controlado del simulador no basta cuando cambian los hábitos, los equipos o las condiciones.
Construir el servicio alrededor del modelo
La parte web sigue siendo un trabajo completo: acceso autenticado, autorizaciones por sitio, validación de entradas, registro adaptado, gestión de carga y errores, observabilidad, copia de seguridad y restauración. Los umbrales de alerta y la acción asociada a cada banda deben ser explícitos.
El código ofrece un recorrido pedagógico de previsión. No ofrece ni una previsión certificada ni una API de negocio lista para desplegar.
Solución de problemas y limpieza
Si CUDA falla, empiece por la comprobación de entorno y la guía de NVIDIA Container Toolkit. Compruebe el acceso a la tarjeta seleccionada desde el contenedor antes de cambiar el modelo.
Si falla el control de causalidad, inspeccione el padding y las posiciones leídas. No modifique la puntuación para hacer menos visible el fallo. Si la cobertura sorprende aunque los cuantiles estén ordenados, no es necesariamente un problema de orden: compruebe los objetivos, las unidades, el scaler y la población evaluada.
Tras el ejercicio, produzca las figuras, controle los checkpoints, previsualice la limpieza y luego detenga los servicios:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
plot.py produce las figuras del recorrido y check_checkpoints.py controla sus checkpoints. El comando con --dry-run es una previsualización: conserva los archivos generados. Lea lo que anuncia antes de considerar una eliminación independiente.
El último comando detiene los recursos Compose del proyecto. No sustituye la previsualización por una limpieza efectiva de sus resultados. Conserve las salidas útiles para comparar sus experimentos.
Fuentes primarias y documentación
Las referencias iniciales del tutorial describen el mecanismo y su entorno:
- Bai, Kolter, Koltun — Temporal Convolutional Networks
- Scikit-learn — pinball loss
- Docker Compose — soporte GPU
- NVIDIA Container Toolkit — guía de instalación
Para profundizar en las explicaciones, la referencia PyTorch de softplus detalla los incrementos y las reglas de broadcasting explican el paso de un objetivo por hora a tres comparaciones.
El ejemplo de scikit-learn sobre intervalos de predicción usa otro modelo: completa la explicación de los cuantiles, sin servir de prueba para los resultados de nuestro TCN. La página sobre fugas de datos profundiza en el papel del preprocesamiento y la documentación de PyTorch sobre reproducibilidad precisa los límites de las reproducciones entre entornos.
Los valores experimentales de este artículo siguen siendo los del recorrido r1. Los ejemplos numéricos señalados como pedagógicos sirven para rehacer los cálculos; no constituyen nuevas salidas GPU.
Descargue el archivo y siga el recorrido completo: abrir el tutorial.