





State sviluppando una dashboard che mostra il carico previsto per domani. Compare un solo valore: «50 kW alle 14». È un inizio, ma nasce subito una domanda: bisogna prepararsi a un valore vicino a 50, oppure a una variazione molto più ampia?
Una curva centrale non risponde a questa domanda. Impareremo quindi a produrre tre stime per ogni ora: una bassa, una mediana e una alta. L'obiettivo non è rendere certo il futuro, ma dare all'incertezza una forma misurabile.
Il caso iniziale è un'illustrazione. Nell'esperimento utilizziamo soltanto serie simulate: nessun contatore reale e nessuna decisione energetica dipendono dalle nostre previsioni.
Scaricare l'archivio del tutorial.
Che cosa costruiamo
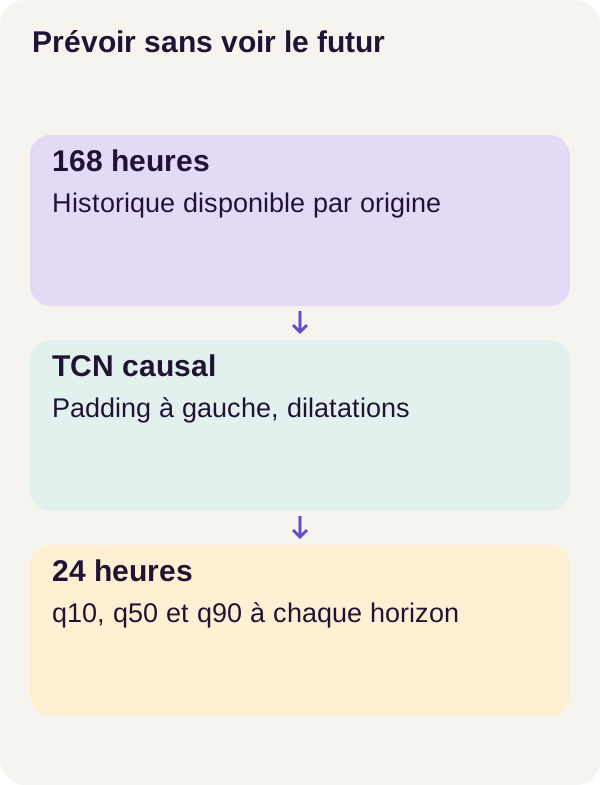
Il programma simula dodici serie orarie, poi addestra una rete a usare le 168 ore precedenti, cioè sette giorni, per prevedere le 24 ore successive. Per ogni ora futura produce q10, q50 e q90.
Potete immaginare l'ingresso come il risultato di una query su una tabella di misure: un sito, ore ordinate e valori già disponibili. L'uscita è una tabella di 24 righe, con tre stime per riga. Il paragone aiuta a capire il contratto dei dati; il progetto non fornisce un'API di business né un collegamento a un database di produzione.
Confrontiamo tre metodi: un riferimento stagionale, chiamato baseline, una rete con uscite indipendenti e una rete con uscite ordinate. Entrambe le reti usano una TCN causale, di cui spiegheremo il funzionamento. La differenza tra le loro «teste» riguarda il modo in cui costruiscono i tre valori finali.
Alla fine saprete seguire il passaggio dai dati alle previsioni, calcolare la perdita dei quantili, verificare il rispetto del tempo e interpretare i risultati. I numeri restano kW simulati: questo tutorial non è una previsione energetica operativa.
Concetti: che cosa garantiscono i quantili, e che cosa non garantiscono
Tre soglie invece di un valore e di un margine arbitrario
Un quantile è una soglia associata a una proporzione. Qui cerchiamo quantili condizionati: dipendono dallo storico disponibile e riguardano una specifica ora futura.
Prendiamo un esempio didattico, distinto dalle uscite del modello:
| Stima | Valore illustrativo | Che cosa cerchiamo di stimare |
|---|---|---|
q10 |
42 kW | Una soglia sotto la quale si troverebbe circa il 10% dei valori, nelle condizioni considerate. |
q50 |
50 kW | La mediana: un valore che divide la distribuzione in due metà. |
q90 |
63 kW | Una soglia sotto la quale si troverebbe circa il 90% dei valori, nelle condizioni considerate. |
La fascia va da 42 a 63 kW. La sua ampiezza è quindi 63 − 42 = 21 kW. Mira a una copertura di 90 % − 10 % = 80 %.
Notate che la mediana non è necessariamente al centro della fascia: qui dista 8 kW dal limite inferiore e 13 kW da quello superiore. Non abbiamo imposto un margine simmetrico del tipo «valore centrale ± 5».
q90 non significa «una previsione esatta al 90%». Quel numero indica il livello del quantile cercato, non un voto di fiducia assegnato alla risposta. Analogamente, q50 indica la mediana, non necessariamente la media.
La rete stima queste soglie per il futuro. Non si limita a ordinare i 168 valori passati e a estrarne tre posizioni. L'esempio ufficiale di regressione quantile di scikit-learn illustra questa distinzione tra previsione centrale, quantili e copertura osservata.
Come imparare un quantile da un solo valore reale?
Per una determinata ora non abbiamo cento futuri possibili: osserviamo un solo valore. Come insegnare tre quantili alla rete?
Le presentiamo molti storici, ciascuno accompagnato dai valori realmente successivi. Una funzione di perdita assegna un costo agli errori. Accumulando questi costi sugli esempi, l'addestramento regola i parametri della rete.
Per imparare una mediana, un errore verso l'alto e uno della stessa ampiezza verso il basso ricevono la stessa penalità. Per imparare un quantile alto, penalizziamo maggiormente una stima troppo bassa. È il ruolo della pinball loss, o perdita dei quantili.
Chiamiamo y il valore osservato, q quello previsto e τ — la lettera greca «tau» — il livello del quantile. Nel nostro caso, τ vale 0,1, 0,5 oppure 0,9.
La formula è:
errore = y − q
perdita = max(τ × errore, (τ − 1) × errore)
Non serve memorizzarla prima di capirla. Per un obiettivo di 50, ecco i costi di due previsioni fittizie:
| Previsione | Errore y − q |
Costo per q10 |
Costo per q50 |
Costo per q90 |
|---|---|---|---|---|
| 48: troppo bassa di 2 | +2 | 0,2 | 1,0 | 1,8 |
| 52: troppo alta di 2 | −2 | 1,8 | 1,0 | 0,2 |
Per q90, sottostimare di 2 costa quindi 0,9 × 2 = 1,8. Sovrastimare di 2 costa soltanto 0,1 × 2 = 0,2. Per q10 avviene il contrario. Le penalità restano positive o nulle; cambia il loro peso in base al verso dell'errore.
Perché la rete non dovrebbe aumentare q90 all'infinito? Perché sovrastimare costa meno, ma non costa zero. La perdita cerca un compromesso sull'insieme degli esempi, non un limite che comprenda tutto a qualsiasi prezzo. La documentazione della pinball loss usa la stessa convenzione di calcolo.
Una TCN: filtri che percorrono il tempo
TCN significa Temporal Convolutional Network, cioè rete a convoluzioni temporali. Una convoluzione combina valori vicini con coefficienti appresi. Potete paragonarla a una media mobile, con una differenza fondamentale: la rete impara i coefficienti e combina più elaborazioni, invece di ricevere una regola di media fissata manualmente.
Un filtro temporale causale usa soltanto la posizione corrente e quelle precedenti. In un esempio a tre valori, l'uscita al tempo 10 può leggere i tempi 8, 9 e 10, ma non il tempo 11.
La dilatazione distanzia le posizioni lette. Sempre in questo esempio a tre valori:
Dilatation 1, sortie au temps 10 : lecture des temps 8, 9 et 10.
Dilatation 2, sortie au temps 10 : lecture des temps 6, 8 et 10.
Dilatation 4, sortie au temps 10 : lecture des temps 2, 6 et 10.
Questi indici illustrano il meccanismo, non la configurazione esatta della rete fornita. Sovrapponendo gli strati si amplia il campo ricettivo, cioè l'insieme delle posizioni che possono influenzare un'uscita. Fornire 168 ore al programma e dimostrare che la sua architettura può sfruttarle tutte sono due verifiche distinte.
Il principio delle convoluzioni causali dilatate è descritto nello studio di Bai, Kolter e Koltun. Qui «causale» significa rispettare l'ordine temporale delle informazioni. Non significa che il modello abbia identificato le cause fisiche di una variazione del carico.
Il padding: completare un bordo senza leggere oltre
All'inizio di una sequenza, alcune posizioni richieste dal filtro non esistono. Il padding completa quel bordo con valori di riempimento. La TCN del tutorial usa padding a sinistra, dal lato del passato, per conservare il comportamento causale.
Una convoluzione centrata può invece usare una posizione a destra di quella che sta calcolando. Al tempo 9, un filtro centrato su tre posizioni leggerebbe 8, 9 e 10: il valore 10 potrebbe quindi modificare un'uscita attribuita al tempo 9. L'esercizio finale rende osservabile questa differenza.
Questo controllo interno non sostituisce quello sui dati. Una rete causale può comunque ricevere uno storico costruito male, contenente informazioni non disponibili al momento della previsione. Verificheremo quindi anche la suddivisione delle finestre e il calcolo del pretrattamento.
Due teste: stimare liberamente o imporre un ordine
La testa è la parte finale della rete che trasforma ciò che ha calcolato in valori di uscita.
Con la testa indipendente, le tre uscite non sono obbligate a rispettare un ordine. La rete potrebbe, per esempio, proporre q10 = 52, q50 = 50 e q90 = 49. Sarebbe un incrocio: il presunto limite inferiore supererebbe quello superiore. «Indipendente» descrive qui l'assenza di questo vincolo; non significa che le ore o le serie siano statisticamente indipendenti.
La testa ordinata parte da q10, poi aggiunge incrementi ottenuti con softplus. Il principio è questo; le lettere a, b e c sono una notazione didattica per tre uscite grezze:
q10 = a
q50 = q10 + softplus(b)
q90 = q50 + softplus(c)
Nella sua forma abituale, softplus(x) = log(1 + exp(x)). Trasforma un valore in un incremento positivo, restando adatta al calcolo dei gradienti. La documentazione PyTorch su softplus descrive questa operazione e la sua implementazione numerica.
Per esempio, softplus(0) = log(2) ≈ 0,6931. Con a = 48, b = 0 e c = 0, le tre uscite diventano circa 48, 48,6931 e 49,3863. Questo esempio spiega la costruzione; non è una previsione registrata nell'esperimento.
Per uscite finite, questa costruzione impone q10 ≤ q50 ≤ q90. Non impone né che il carico aumenti nelle 24 ore, né che q10 sia positivo, né che la fascia contenga la giusta proporzione di osservazioni.
Pensate a una convalida di modulo che impone «data di inizio ≤ data di fine». Verifica un ordine coerente; non prova che le date corrispondano all'appuntamento reale. Una fascia ordinata non è automaticamente ben calibrata.
Prerequisiti Docker e GPU
Dovete avere dimestichezza con funzioni Python, array, terminale e basi di Docker. I concetti di apprendimento sono introdotti nel percorso; non è necessario conoscere già le TCN.
Il percorso richiede Linux x86_64, Docker Compose, NVIDIA Container Toolkit e una RTX 3090 da 24 GiB, oltre a 16 GiB di RAM e 16 GiB di spazio libero su disco, esclusi i layer Docker condivisi. Usa una scheda; possedere due GPU non obbliga a usarle entrambe per questo esercizio.
La GPU è il processore grafico usato per i calcoli della rete. CUDA permette qui a PyTorch di utilizzarla. Il controllo dell'ambiente inizializza CUDA dal contenitore ed esegue un calcolo: vedere una scheda sull'host non basta. Il controllo deve riuscire prima dell'addestramento. La documentazione Docker sull'accesso alle GPU e la guida NVIDIA Container Toolkit descrivono questa integrazione.
Per scegliere la scheda, esportate GPU_DEVICE=0 oppure l'UUID di una scheda prima dei comandi. L'UUID è il suo identificatore; è un altro modo di selezionarla rispetto al suo indice. Conservate il percorso GPU fornito per riprodurre i risultati: qui non viene presentato alcun risultato CPU equivalente.
Il calcolo GPU avviene senza rete. I contenitori usano un file system in sola lettura, no-new-privileges, capacità Linux rimosse e limiti di CPU, RAM e PID. In termini di sviluppo web, significa limitare ciò che un processo può fare e consumare, non certificare le sue previsioni.
Un checkpoint è uno stato salvato per poter ricaricare o riprendere un calcolo. Non caricate checkpoint Torch provenienti da una fonte non affidabile.
Dati: separare il tempo prima di addestrare
Un piccolo mondo di cui conosciamo le regole
Il simulatore produce 12 serie di 180 giorni, cioè 180 × 24 = 4 320 valori orari per sito. Ogni serie combina un livello di base, un ciclo giornaliero, un ciclo settimanale, fluttuazioni casuali e alcuni eventi puntuali.
I cicli danno alla rete regolarità da apprendere. Le fluttuazioni impediscono che il futuro si riduca a una ripetizione perfettamente deterministica. Conosciamo la ricetta dei dati, cosa che facilita i controlli; non per questo rappresentano siti reali.
La suddivisione è cronologica, con una numerazione dei giorni che inizia da zero:
| Parte dei dati | Giorni | Ruolo |
|---|---|---|
Addestramento, o train |
0–119 | Apprendere i parametri della rete e adattare lo scaler. |
| Validazione | 120–149 | Esaminare il modello su un periodo successivo, distinto dall'addestramento. |
| Test | 150–179 | Misurare il risultato sull'ultimo periodo riservato. |
Uno scaler trasforma la scala dei numeri prima del loro uso nel modello. Quando una tale trasformazione apprende statistiche, queste devono provenire solo da train. Usare tutti i 180 giorni per calcolarle trasmetterebbe già un'informazione sui periodi futuri, anche senza fornire direttamente le loro destinazioni alla rete. Questo rischio di perdita attraverso il pretrattamento è spiegato nella documentazione scikit-learn sulle fughe di dati.
La regola del progetto è quindi: adattare su train, poi mantenere questa trasformazione per gli altri periodi. Il tipo esatto di scaler resta quello del codice fornito; non occorre sostituirlo con una normalizzazione diversa per seguire il tutorial.
Leggere il simulatore
Il seguente estratto crea le serie e conserva i parametri che le hanno prodotte. np indica NumPy e TEST_END il limite orario definito nel progetto. Sono estratti del programma completo: i comandi Docker più sotto eseguono l'insieme, con le sue importazioni e la sua configurazione.
def simulate(seed=17):
    rng = np.random.default_rng(seed)
    t = np.arange(TEST_END)
    series = []
    parameters = []
    for site in range(12):
        baseline = 35 + 2 * site
        daily = 5 + 0.3 * site
        weekly = 3 + 0.1 * site
        phase = 0.17 * site
        noise = 1.2 + 0.05 * site
        value = (
            baseline
            + daily * np.sin(2 * np.pi * t / 24 + phase)
            + weekly * np.cos(2 * np.pi * t / 168)
            + rng.normal(0, noise, len(t))
        )
        events = []
        for day in (25 + site, 75 + site, 125 + site, 155 + site):
            start = day * 24 + 8
            amplitude = 4 + site / 3
            value[start : start + 8] += amplitude
            events.append({"start": start, "duration": 8, "amplitude": amplitude})
        series.append(value)
        parameters.append(
            {
                "site": site,
                "baseline": baseline,
                "daily_amplitude": daily,
                "weekly_amplitude": weekly,
                "phase": phase,
                "noise_std": noise,
                "events": events,
            }
        )
    return np.asarray(series, dtype="float32"), parameters
Che cosa è appena successo?
np.random.default_rng(seed) inizializza il generatore pseudo-casuale. Il seed predefinito è 17. In un ambiente invariato, ripetere le stesse operazioni con questo seed consente di ritrovare le stesse estrazioni.
Il ciclo percorre i siti da 0 a 11. baseline = 35 + 2 * site assegna a ciascuno un livello di fondo diverso. Attenzione al vocabolario: questa variabile baseline è il livello di base del segnale, non il modello stagionale di riferimento confrontato più avanti.
I termini sin(... / 24 ...) e cos(... / 168 ...) aggiungono oscillazioni giornaliere e settimanali. Le ampiezze daily e weekly ne regolano l'importanza, mentre phase sposta il ciclo giornaliero. rng.normal(0, noise, len(t)) aggiunge rumore gaussiano centrato su zero; noise ne regola la deviazione standard, quindi l'ampiezza delle fluttuazioni.
Il secondo ciclo aggiunge quattro eventi di otto ore per sito. Per il sito 0, per esempio, l'evento del giorno 25 inizia all'indice 25 × 24 + 8 = 608. La fetta 608:616 aumenta otto valori di 4. È una lettura della formula del simulatore, non della previsione appresa dalla rete.
Infine, la funzione restituisce un array float32 e l'elenco parameters, che documenta la generazione. float32 indica che i numeri sono memorizzati in virgola mobile su 32 bit.
Ambito dell'estratto: simulate() crea i valori e i loro parametri; non contiene la costruzione delle finestre né la scelta delle origini. Queste operazioni appartengono alla preparazione completa. Conoscere gli eventi nel simulatore non autorizza neppure a fornirli come informazioni future al modello.
Un'origine: l'istante dal quale si prevede
Un'origine di previsione è il punto di partenza di una previsione. Per leggere gli indici, chiamiamo qui T la prima ora da prevedere. Questa convenzione esplicativa dà:
Historique visible : T − 168, ..., T − 1   → 168 valeurs déjà connues.
Cibles à prévoir   : T, ..., T + 23       → 24 valeurs futures.
Durante l'addestramento, queste destinazioni sono note al programma e servono a calcolare l'errore. Non devono essere mescolate con lo storico fornito in ingresso. È lo stesso principio di un set di test: la risposta attesa serve a correggere il risultato, non a riempire i dati della funzione testata.
Le finestre di addestramento avanzano di un'ora. Le loro destinazioni devono rimanere interamente in train. Validazione e test usano un'origine al giorno e per sito:
12 siti × 30 giorni = 360 origini per parte
360 origini × 24 ore = 8 640 destinazioni orarie per parte
Rappresentano 8 640 valori da verificare, non 8 640 giornate. Ogni valore riceve tre stime, cioè 8 640 × 3 = 25 920 contributi elementari alla perdita dei quantili.
Attraversare un confine con lo storico non è necessariamente una fuga
Prendiamo la prima origine di validazione, all'inizio del giorno 120. I giorni da 113 a 119 costituiscono uno storico di sette giorni già disponibile. Il fatto che questi valori appartengano a train non pone un problema: sono nel passato di questa previsione.
Al contrario, una finestra di addestramento la cui prima destinazione fosse l'ultima ora del giorno 119 sconfinerebbe nel giorno 120 per le altre destinazioni. Mescolerebbe addestramento e validazione e deve essere esclusa.
La stessa logica si applica al test. All'inizio del giorno 150, i giorni da 143 a 149 sono già noti. Più tardi, osservazioni dell'inizio del periodo di test possono servire da storico per un'origine successiva, se erano effettivamente disponibili a quella data. Ciò non significa riaddestrare la rete o riadattare lo scaler sul test.
La valutazione riproduce così previsioni successive. Non prevede i trenta giorni di test tutti insieme dalla loro prima mattina.
Il codice centrale: la perdita dei quantili
Comprendere le dimensioni prima delle operazioni
Un tensore è qui un array di numeri a più dimensioni. In un batch di B esempi, dove B è il numero di finestre elaborate insieme, abbiamo:
prediction : B × 24 × 3   → un triplet q10, q50, q90 pour chaque heure.
target     : B × 24       → une seule valeur observée pour chaque heure.
Per un solo esempio, la rete propone quindi 72 numeri e disponiamo di 24 valori di riferimento. Le tre previsioni di un'ora vengono confrontate con la stessa destinazione, con tre penalizzazioni differenti.
def pinball_loss(prediction, target):
    tau = torch.tensor(
        [0.1, 0.5, 0.9], device=prediction.device, dtype=prediction.dtype
    )
    error = target[..., None] - prediction
    return torch.maximum(tau * error, (tau - 1) * error).mean()


def check_loss(config):
    p = torch.zeros(1, 1, 3)
    positive = pinball_loss(p, torch.ones(1, 1))
    negative = pinball_loss(p, -torch.ones(1, 1))
    assert torch.allclose(positive, torch.tensor(0.5)) and torch.allclose(
        negative, torch.tensor(0.5)
    )
    return {
        "e_plus_1": [0.1, 0.5, 0.9],
        "e_minus_1": [0.9, 0.5, 0.1],
        "mean_positive": float(positive),
        "mean_negative": float(negative),
    }
Leggere le tre operazioni di pinball_loss()
tau contiene i livelli [0.1, 0.5, 0.9], nello stesso ordine delle tre uscite. device e dtype gli assegnano la stessa posizione di calcolo e lo stesso tipo numerico di prediction.
target[..., None] aggiunge una dimensione di taglia 1 alla fine dell'array: B × 24 diventa B × 24 × 1. PyTorch può allora confrontare ogni destinazione con le tre previsioni corrispondenti. Questa estensione implicita di dimensioni compatibili si chiama broadcasting; la documentazione PyTorch ne descrive le regole.
Infine, torch.maximum(...) sceglie il costo adatto a ogni errore. .mean() fa la media di tutti questi costi: sugli esempi del batch, sulle 24 ore e sui tre quantili. Il risultato è uno scalare, cioè un solo numero.
La funzione calcola la perdita, ma non modifica da sola i parametri. Durante l'addestramento, i gradienti indicano come una variazione dei parametri influirebbe su questa perdita, poi l'ottimizzatore applica gli aggiornamenti. Durante la valutazione, si può calcolare la stessa perdita senza addestrare nulla.
Un calcolo che si può rifare a mano
Prendiamo un'ora fittizia con y = 50 e le previsioni q10 = 47, q50 = 51, q90 = 55.
Il quantile basso sottostima di 3: il suo costo è 0,1 × 3 = 0,3. La mediana sovrastima di 1: il suo costo è 0,5 × 1 = 0,5. Il quantile alto sovrastima di 5: il suo costo è 0,1 × 5 = 0,5.
La perdita media per questa ora è dunque:
(0,3 + 0,5 + 0,5) / 3 = 0,4333…
Il valore reale rientra nella fascia [47, 55], ma la perdita non è zero. Non è una contraddizione: essere coperto e avere un buon punteggio dei quantili non sono lo stesso controllo.
A τ = 0,5, la pinball vale metà dell'errore assoluto. Questa identità riguarda la componente mediana, non la media dei tre quantili. Il riferimento mean_pinball_loss permette di ritrovare questa proprietà.
La perdita ha l'unità dei numeri che riceve. Le misure pubblicate più sotto sono espresse in kW simulati; una perdita calcolata su una scala trasformata non deve essere confrontata direttamente con tali valori senza tenere conto dello scaler.
Ciò che check_loss() verifica, e ciò che non verifica
Il controllo costruisce tre previsioni nulle, poi una destinazione +1 e una destinazione −1. I contributi attesi sono rispettivamente [0,1 ; 0,5 ; 0,9] e [0,9 ; 0,5 ; 0,1]. La loro media vale 0,5 in entrambi i casi.
L'asserzione verifica bene queste due medie con torch.allclose, che confronta i valori con una tolleranza numerica. Tuttavia, gli elenchi e_plus_1 e e_minus_1 restituiti dalla funzione sono scritti a mano, e non ricalcolati dai contributi intermedi.
Punto di attenzione: questa media non basta a rilevare un'inversione del segno. Con questi tre livelli simmetrici e previsioni identiche, sostituire
target − predictionconprediction − targetscambierebbe i contributi dei quantili basso e alto, senza cambiare la media di0,5. La formula visibile usa il verso corretto; occorre distinguere la portata di questa asserzione da quella di un controllo per quantile.
Per rafforzare questo controllo in un esperimento separato, bisognerebbe confrontare i contributi di ogni livello o aggiungere previsioni diverse secondo il quantile. Il codice di riferimento qui sopra resta invariato. Questa osservazione non anticipa il contenuto degli altri test del progetto.
Installare e verificare l'ambiente
Estraete l'archivio, poi posizionate il terminale nella sua radice, dove si trovano gli script e la configurazione Compose. Tutti i comandi seguenti partono da questa stessa directory.
Questo progetto non ha pesi preaddestrati da scaricare: qui acquire convalida un manifesto senza pesi. Le serie saranno create da prepare e la rete verrà addestrata su questi dati. Il ruolo di questa fase è diverso dall'acquisizione di un grande modello linguistico.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
Leggete questa sequenza come la preparazione di un ambiente di sviluppo. setup.sh prepara il progetto; config --quiet controlla la configurazione Compose; build acquire gpu costruisce le immagini dei due servizi. Seguono la convalida del manifesto, il calcolo di controllo CUDA nel contenitore e la suite di test con pytest.
Osservazione attesa: ogni comando deve terminare senza errore. Il controllo dell'ambiente deve riuscire prima dell'addestramento. Una suite di test riuscita controlla il programma sui casi previsti; non ha ancora misurato la qualità delle previsioni sul test.
Conservate versioni e impostazioni dell'archivio per la riproduzione. I riferimenti alla fine dell'articolo servono a comprendere i meccanismi, non a sostituire le dipendenze del progetto con le loro versioni più recenti.
Preparare, confrontare e addestrare
Possiamo ora creare i dati, stabilire il riferimento stagionale, ispezionare la rete, verificare la perdita e addestrare le due teste. La sequenza contiene anche un arresto volontario, una ripresa e un confronto degli stati prima della valutazione.
I risultati pubblicati di seguito provengono dalla riproduzione lettore convalidata di questo percorso r1.
docker compose run --rm gpu python -m quantile_forecast.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli baseline --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli inspect-model --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli check-loss --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml --variant independent
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml --stop-after 1000 --run-name interrupted
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m quantile_forecast.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli evaluate --config configs/minimum.yaml
Preparare un riferimento prima di chiedere di meglio alla rete
prepare prepara serie e finestre secondo le regole temporali descritte. baseline stabilisce il riferimento stagionale: un punto di confronto che sfrutta la ripetizione dei motivi nel tempo.
L'interesse di una baseline non è creare un avversario facile da battere. Permette di porre una domanda utile: che cosa apporta la rete rispetto a un metodo di riferimento? Il dettaglio di questa baseline resta quello dell'archivio; gli estratti dell'articolo non ne forniscono la formula completa.
inspect-model precede gli addestramenti e permette di controllare la rete. check-loss esegue il controllo numerico appena esaminato. Consultate i loro risultati prima di avviare la parte più costosa del percorso.
Confrontare due costruzioni di uscita
Il comando train del percorso addestra la testa ordinata; --variant independent avvia la variante indipendente. Il confronto riguarda in particolare l'errore dei quantili, la mediana, la copertura, la larghezza e gli incroci.
Non sostituite una testa con un semplice ordinamento dei risultati prima della valutazione. Ordinare a posteriori creerebbe un altro trattamento, di cui bisognerebbe conservare le uscite e misurare separatamente gli effetti.
Riprendere: continuare uno stato, non ricominciare una prova
Il comando con --stop-after 1000 --run-name interrupted arresta volontariamente l'addestramento al passo 1 000. Un passo è una fase dell'addestramento; questo numero non indica né mille ore di previsione né mille giorni di dati.
Il comando seguente ricarica artifacts/checkpoints/interrupted/state.pt e prosegue con il nome resumed. compare-resume confronta poi la ripresa con il percorso di riferimento.
Potete avvicinare questa operazione a un'elaborazione di coda riprendibile: ritrovare l'ultimo file scritto non basta se si è perso lo stato necessario a continuare esattamente nello stesso punto. Il test di ripresa del progetto rende verificabile questa continuità, invece di supporla.
Infine, evaluate produce le misure dei metodi confrontati. Un errore massimo nullo durante la ripresa e una buona accuratezza di previsione sono due risultati distinti: uno riguarda la continuità del calcolo, l'altro la qualità delle uscite.
Misure prima dei risultati
Ogni risultato aggrega 360 origini e 8 640 destinazioni orarie. Prima di confrontare i numeri, fissiamo il significato di ogni misura.
Pinball: la qualità delle tre soglie
La pinball media applica il calcolo precedente ai tre quantili. Qui è espressa in kW simulati. Più bassa è meglio, per la stessa popolazione, gli stessi quantili e la stessa convenzione di unità. Non è una percentuale di previsioni esatte.
MAE: l'errore della sola mediana
La MAE, per Mean Absolute Error, è la media degli scarti assoluti. In questo tutorial riguarda q50:
MAE = media di |valore osservato − q50|
Una mediana di 50 davanti a un'osservazione di 53 contribuisce per 3 kW. Il limite basso e quello alto non intervengono in questo calcolo. «MAE della mediana» significa quindi media degli errori di q50, non mediana di tutti gli errori.
Copertura: quanti valori cadono nella fascia?
Una destinazione è coperta quando q10 ≤ y ≤ q90, limiti inclusi. La copertura è il numero di destinazioni coperte diviso per il numero totale di destinazioni.
La destinazione nominale è l'80%, non il 100%. Una copertura troppo bassa indica che la fascia manca troppo spesso le osservazioni sul campione; una copertura molto alta può corrispondere a una fascia troppo prudente per il livello annunciato. Bisogna quindi leggere questa misura insieme alla larghezza e agli altri punteggi.
Larghezza: quale margine annunciamo?
La larghezza vale q90 − q10, poi il programma ne calcola una media. A copertura comparabile, una fascia meno larga è più precisa in ciò che annuncia. Ma una fascia minuscola che manca la maggior parte delle osservazioni non è un successo.
Al contrario, allargare una fascia fino a coprire quasi tutti i valori non basta a produrre una previsione utile. Se l'intervallo è troppo ampio per orientare una decisione, la sola copertura non risolve il problema iniziale.
Incroci: i tre valori sono nel giusto ordine?
Il tasso di incrocio conta le triplette che non rispettano q10 ≤ q50 ≤ q90. Riguarda le 8 640 triplette, non i loro 25 920 numeri considerati separatamente.
Una testa ordinata mira a eliminare questo problema per costruzione. Una testa indipendente può anch'essa non avere incroci su un dato set; questa osservazione non diventa una garanzia per i dati successivi.
Cinque ore per comprendere le differenze
Ecco un piccolo lotto interamente didattico. Scegliamo deliberatamente la stessa fascia [48, 52] e la stessa mediana 50 nelle cinque ore, per rendere immediati i calcoli. Non è un estratto dei risultati r1.
Su schermo piccolo, scorrete orizzontalmente la tabella.
| Ora illustrativa | Valore osservato | q10 |
q50 |
q90 |
Nella fascia? | Errore assoluto di q50 |
|---|---|---|---|---|---|---|
| 1 | 49 | 48 | 50 | 52 | Sì | 1 |
| 2 | 50 | 48 | 50 | 52 | Sì | 0 |
| 3 | 51 | 48 | 50 | 52 | Sì | 1 |
| 4 | 52 | 48 | 50 | 52 | Sì, limite incluso | 2 |
| 5 | 55 | 48 | 50 | 52 | No | 5 |
La copertura vale 4 / 5 = 80 %. La larghezza media è 52 − 48 = 4. La MAE vale (1 + 0 + 1 + 2 + 5) / 5 = 1,8. Il tasso di incrocio è nullo: ogni tripletta è ordinata.
Per l'ultima ora, la pinball riceve i contributi 0,7, 2,5 e 2,7, cioè una media di circa 1,9667. Sulle cinque ore e i tre quantili, il totale dei contributi è 9,5 e la pinball media 9,5 / 15 = 0,6333….
Abbiamo dunque l'80% di copertura, zero incroci e tuttavia errori non nulli. Le metriche descrivono proprietà complementari, non cinque formulazioni dello stesso punteggio.
Una buona media può nascondere un segmento cattivo
La calibrazione consiste nel verificare se le proporzioni annunciate corrispondono a ciò che osserviamo, su un numero sufficiente di previsioni pertinenti per l'uso previsto. Una copertura vicina all'80% su questo lotto simulato è un'osservazione, mai una garanzia per il futuro.
Un altro esempio fittizio lo mostra: se un primo gruppo contiene 30 valori coperti su 50 e un secondo 50 su 50, la copertura globale vale 80 / 100 = 80 %. Eppure i gruppi sono rispettivamente al 60% e al 100%. La media nasconde due comportamenti molto diversi.
Allo stesso modo, una copertura globale dell'80% non prova che i superamenti siano ripartiti in 10% sotto q10 e 10% sopra q90. Bisogna esaminare entrambi i lati, oltre alla mediana. E le 24 fasce orarie non promettono che l'intera giornata resterà nella fascia con una probabilità dell'80%: la copertura per ora e quella simultanea della giornata sono domande diverse.
Queste distinzioni spiegano perché una valutazione reale dovrebbe esaminare anche siti, ore da prevedere e periodi. Le origini successive condividono gran parte del loro storico: 8 640 destinazioni non devono essere assimilate senza giustificazione a altrettanti esperimenti indipendenti.
Risultati osservati
Ecco i valori della riproduzione r1, riuniti per confrontare i metodi. Errori e larghezze sono espressi in kW simulati.
Su schermo piccolo, scorrete orizzontalmente la tabella.
| Metodo | Pinball | MAE di q50 |
Copertura | Larghezza media | Incroci osservati |
|---|---|---|---|---|---|
| Baseline stagionale | 0,5462 | 1,7130 | 80,53 % | 5,4649 | 0 % |
| Testa indipendente | 0,3939 | 1,2350 | 80,25 % | 3,9847 | 0 % |
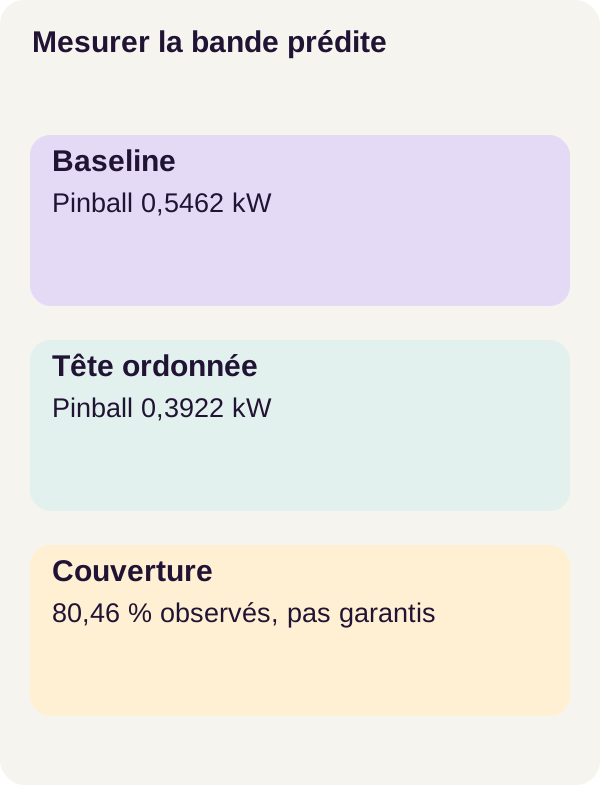
| Testa ordinata | 0,3922 | 1,2313 | 80,46 % | 3,9824 | 0 % |
Le due reti riducono qui la pinball e l'errore della mediana rispetto al riferimento stagionale. Producono anche fasce più strette, mantenendo una copertura globale vicina all'80%.
La testa ordinata è leggermente migliore dell'indipendente sulla pinball e sulla MAE. Per dare una scala a «leggermente», la differenza di pinball vale 0,3939 − 0,3922 = 0,0017 kW, e quella di MAE 1,2350 − 1,2313 = 0,0037 kW. Sono sottrazioni dei valori pubblicati, non nuove misure.
La larghezza della testa ordinata è inferiore di 5,4649 − 3,9824 = 1,4825 kW a quella della baseline stagionale. Sarebbe invece fuorviante concludere che «più la copertura sale, migliore è il modello»: la copertura nominale resta l'80%, e i tre metodi le sono vicini su questo campione.
Tutti e tre i metodi hanno zero incroci osservati. La tabella non mostra quindi una correzione di incroci effettivamente presenti nella variante indipendente. La differenza è strutturale: l'ordine è imposto nella testa ordinata, mentre lo zero della testa indipendente descrive soltanto questa valutazione.
La ripresa deterministica ritrova gli stessi parametri con un errore massimo nullo, oltre allo scaler e all'inizializzazione condivisa. Questo risultato riguarda la riproduzione controllata del calcolo. La documentazione PyTorch sulla riproducibilità ricorda perché non si deve trasformare un'uguaglianza locale in una garanzia tra tutte le versioni e le piattaforme.
Che cosa abbiamo imparato
Ora sappiamo sostituire una previsione unica con tre soglie apprese e dare un senso alla fascia che le accompagna. La pinball insegna ai quantili comportamenti diversi; softplus ne impone l'ordine; le metriche verificano poi che cosa valgono queste uscite sui dati riservati.
La disciplina temporale interviene a più livelli. Lo storico deve essere disponibile all'origine della previsione, le destinazioni devono restare nella loro parte dei dati, lo scaler non deve apprendere dal futuro e il blocco causale non deve usare una posizione successiva per calcolare un'uscita precedente.
In questo esperimento, il modello ordinato è leggermente migliore sulla pinball e sulla MAE, con una fascia più stretta del riferimento stagionale. Questa osservazione non lo rende automaticamente la scelta migliore in produzione. Non sono state convalidate né una calibrazione successiva, né una deriva stagionale, né l'analisi del costo aziendale di una sottoprevisione.
La conclusione utile non è quindi «questa rete sa prevedere un carico reale», ma: disponiamo di un percorso controllato per addestrare, riprendere e confrontare previsioni per quantili senza confondere ordine, precisione e calibrazione.
Esercizio: ipotesi prima del comando
Torniamo al padding. Modificheremo un valore di ingresso posto al tempo 10, poi esamineremo le uscite attribuite ai tempi da 0 a 9.
Prima di eseguire, scrivete la vostra ipotesi: un blocco causale ha il diritto di modificare un'uscita passata dopo questa modifica? E una convoluzione simmetrica può lasciare che il valore al tempo 10 influenzi il calcolo del tempo 9?
Il controllo fornito confronta le due varianti. Eseguitelo senza sostituire la rete del percorso di riferimento:
docker compose run --rm gpu python -m quantile_forecast.cli exercise --config configs/exercise.yaml
L'uscita osservata restituisce 0,0 per l'errore passato del blocco causale e 1,0 per la variante simmetrica. Il primo rimane invariato sulle posizioni esaminate; la seconda lascia passare un'influenza proveniente da una posizione successiva. Il test rileva quindi bene la fuga del futuro verso il passato all'interno del blocco.
Questo 1,0 non è un tasso di errore di previsione del 100%: è il valore della differenza riportato da questo controllo di perturbazione.
Importante sfumatura: di quale futuro parliamo? Il tempo 10 è futuro rispetto alle uscite da 0 a 9 del blocco. Se appartiene già alle 168 ore note all'origine della previsione, leggerlo non prova di per sé che siano state usate le 24 destinazioni future. Il test verifica la causalità interna del blocco; il controllo delle finestre verifica separatamente il confine tra storico e orizzonte da prevedere.
Per spiegare il risultato, tornate a un filtro centrato che legge 8, 9 e 10 per calcolare l'uscita 9. Confrontatelo con un filtro causale a tre posizioni che leggerebbe soltanto 7, 8 e 9. Questa lettura delle dipendenze vale più della sola frase «il test passa».
Adattare e produrre
Sostituire il simulatore senza perdere il contratto temporale
Con dati reali, cominciate definendo che cosa rappresenta ogni riga: il sito, la marca temporale, l'unità e la frequenza attesa. Un valore mancante non è automaticamente un carico nullo. Una misura ricevuta in ritardo non era necessariamente disponibile nell'istante in cui la previsione avrebbe dovuto essere fatta.
Servono quindi dati autorizzati e versionati, una strategia esplicita per ritardi e valori mancanti, oltre a una suddivisione temporale verificabile. Valutate ciò che il sistema sapeva alla data della previsione, non ciò che un database corretto a posteriori permette di vedere oggi.
Il tutorial non convalida queste scelte su dati operativi. Un adattamento costituisce un nuovo esperimento: conservate le uscite r1, lavorate in una copia e documentate ogni modifica di dati, frequenza, orizzonte o modello.
Collegare le fasce a una decisione
Un cruscotto può mostrare una mediana e una fascia senza attivare un'azione. Non appena un'azione dipende da un limite, occorre precisare il costo di una sottoprevisione, di una sovraprevisione e di un avviso inutile.
Il livello q90 non è una politica universale di prudenza. Un'applicazione può aver bisogno di un altro livello, di una convalida umana o di una regola di rifiuto quando la fascia diventa troppo ampia. Sono scelte aziendali da definire e testare, non garanzie fornite da softplus.
Bisognerà anche verificare la calibrazione per segmento e seguire la deriva, cioè l'evoluzione nel tempo dei dati e degli errori. Una buona copertura ottenuta nel mondo controllato del simulatore non basta quando abitudini, apparecchiature o condizioni cambiano.
Costruire il servizio attorno al modello
La parte web resta un lavoro a sé: accesso autenticato, autorizzazioni per sito, convalida degli ingressi, registrazione appropriata, gestione del carico e degli errori, osservabilità, salvataggio e ripristino. Le soglie di allerta e l'azione associata a ogni fascia devono essere esplicite.
Il codice fornisce un percorso didattico di previsione. Non fornisce né una previsione certificata né un'API aziendale pronta da distribuire.
Risoluzione dei problemi e pulizia
Se CUDA fallisce, iniziate dal controllo dell'ambiente e dalla guida NVIDIA Container Toolkit. Verificate l'accesso alla scheda selezionata dal contenitore prima di cambiare il modello.
Se il controllo di causalità fallisce, ispezionate padding e posizioni lette. Non modificate il punteggio per rendere il fallimento meno visibile. Se la copertura sorprende pur avendo quantili ordinati, non è necessariamente un problema di ordine: verificate destinazioni, unità, scaler e popolazione valutata.
Dopo l'esercizio, producete le figure, controllate i checkpoint, visualizzate in anteprima la pulizia, poi fermate i servizi:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
plot.py produce le figure del percorso e check_checkpoints.py controlla i suoi checkpoint. Il comando con --dry-run è un'anteprima: conserva i file generati. Leggete ciò che annuncia prima di considerare una cancellazione distinta.
L'ultimo comando ferma le risorse Compose del progetto. Non sostituisce l'anteprima con una pulizia effettiva dei vostri risultati. Conservate le uscite utili per confrontare i vostri esperimenti.
Fonti primarie e documentazione
I riferimenti di partenza del tutorial descrivono il meccanismo e il suo ambiente:
- Bai, Kolter, Koltun — Temporal Convolutional Networks
- Scikit-learn — pinball loss
- Docker Compose — supporto GPU
- NVIDIA Container Toolkit — guida all'installazione
Per approfondire le spiegazioni, il riferimento PyTorch di softplus descrive gli incrementi, e le regole di broadcasting spiegano il passaggio da una destinazione per ora a tre confronti.
L'esempio scikit-learn sugli intervalli di previsione usa un altro modello: completa la spiegazione dei quantili, senza essere una prova per i risultati della nostra TCN. La pagina sulle fughe di dati approfondisce il ruolo del pretrattamento, e la documentazione PyTorch sulla riproducibilità precisa i limiti delle riproduzioni fra ambienti.
I valori sperimentali di questo articolo restano quelli del percorso r1. Gli esempi numerici indicati come didattici servono a rifare i calcoli; non costituiscono nuove uscite GPU.
Scaricare l'archivio e seguire il percorso completo: aprire il tutorial.