





Vous développez un tableau de bord qui affiche la charge prévue pour demain. Une seule valeur apparaît : « 50 kW à 14 heures ». C'est un début, mais une question arrive aussitôt : faut-il se préparer à une valeur proche de 50, ou à une variation beaucoup plus importante ?
Une courbe centrale ne répond pas à cette question. Nous allons donc apprendre à produire trois estimations pour chaque heure : une basse, une médiane et une haute. L'objectif n'est pas de rendre le futur certain, mais de donner une forme mesurable à l'incertitude.
Le cas de départ est une illustration. Dans l'expérience, nous utilisons uniquement des séries simulées : aucun compteur réel ni aucune décision énergétique ne dépend de nos prévisions.
Télécharger l'archive du tutoriel.
Ce que nous construisons
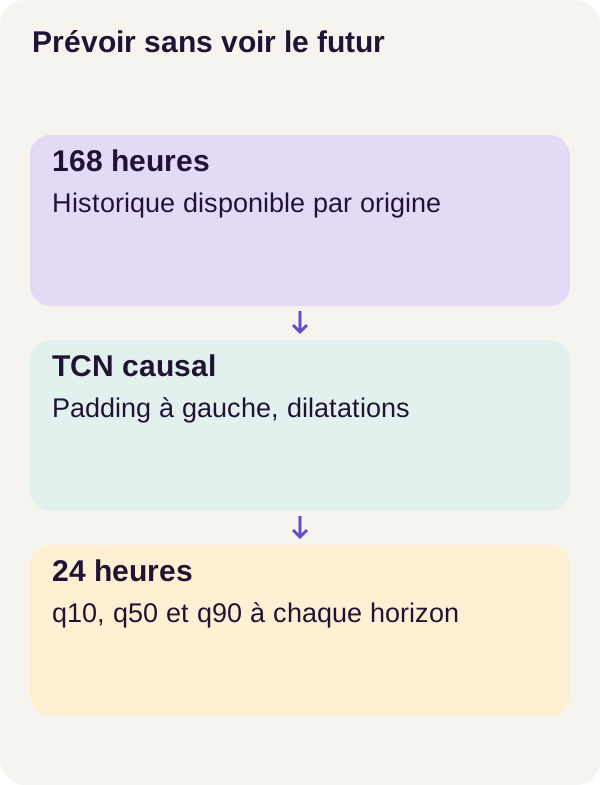
Le programme simule douze séries horaires, puis entraîne un réseau à utiliser les 168 heures précédentes, soit sept jours, pour prévoir les 24 prochaines heures. Pour chaque heure future, il produit q10, q50 et q90.
Vous pouvez vous représenter son entrée comme le résultat d'une requête sur une table de mesures : un site, des heures ordonnées et les valeurs déjà disponibles. Sa sortie est un tableau de 24 lignes, avec trois estimations par ligne. Cette comparaison sert à comprendre le contrat de données ; le projet ne fournit pas d'API métier ni de connexion à une base de production.
Nous comparons trois méthodes : une référence saisonnière, appelée baseline, un réseau à sorties indépendantes et un réseau à sorties ordonnées. Les deux réseaux utilisent un TCN causal, dont nous allons expliquer le fonctionnement. La différence entre leurs « têtes » concerne la manière de construire les trois valeurs finales.
À la fin, vous saurez suivre le passage des données aux prédictions, calculer la perte de quantiles, vérifier le respect du temps et interpréter les résultats. Les nombres restent des kW simulés : ce tutoriel n'est pas une prévision énergétique opérationnelle.
Concepts : ce que les quantiles garantissent, et ce qu'ils ne garantissent pas
Trois seuils plutôt qu'une valeur et une marge arbitraire
Un quantile est un seuil associé à une proportion. Ici, nous cherchons des quantiles conditionnels : ils dépendent de l'historique disponible, et concernent une heure future précise.
Prenons un exemple pédagogique, distinct des sorties du modèle :
| Estimation | Valeur illustrative | Ce que nous cherchons à estimer |
|---|---|---|
q10 |
42 kW | Un seuil sous lequel se situeraient environ 10 % des valeurs, dans les conditions considérées. |
q50 |
50 kW | La médiane : une valeur qui partage la distribution en deux moitiés. |
q90 |
63 kW | Un seuil sous lequel se situeraient environ 90 % des valeurs, dans les conditions considérées. |
La bande va de 42 à 63 kW. Sa largeur vaut donc 63 − 42 = 21 kW. Elle vise une couverture de 90 % − 10 % = 80 %.
Remarquez que la médiane n'est pas nécessairement au milieu de la bande : ici, elle est à 8 kW de la borne basse et à 13 kW de la borne haute. Nous n'avons pas imposé une marge symétrique du type « valeur centrale ± 5 ».
q90 ne signifie pas « une prédiction exacte à 90 % ». Ce nombre désigne le niveau du quantile recherché, pas une note de confiance attribuée à la réponse. De même, q50 désigne la médiane, pas nécessairement la moyenne.
Le réseau estime ces seuils pour le futur. Il ne se contente pas de trier les 168 valeurs passées et d'en extraire trois positions. L'exemple officiel de régression quantile de scikit-learn illustre cette distinction entre prédiction centrale, quantiles et couverture observée.
Comment apprendre un quantile avec une seule valeur réelle ?
Pour une heure donnée, nous ne disposons pas de cent futurs possibles : nous n'observons qu'une seule valeur. Comment enseigner trois quantiles au réseau ?
Nous lui présentons de nombreux historiques, chacun accompagné des valeurs qui ont réellement suivi. Une fonction de perte attribue un coût aux erreurs. En accumulant ces coûts sur les exemples, l'entraînement ajuste les paramètres du réseau.
Pour apprendre une médiane, une erreur vers le haut et une erreur de même amplitude vers le bas sont pénalisées de la même manière. Pour apprendre un quantile haut, nous pénalisons davantage une estimation trop basse. C'est le rôle de la pinball loss, ou perte de quantiles.
Appelons y la valeur observée, q la valeur prédite et τ — la lettre grecque « tau » — le niveau du quantile. Dans notre cas, τ vaut 0,1, 0,5 ou 0,9.
La formule est :
erreur = y − q
perte = max(τ × erreur, (τ − 1) × erreur)
Pas besoin de mémoriser cette écriture avant de la comprendre. Pour une cible de 50, voici les coûts de deux prédictions fictives :
| Prédiction | Erreur y − q |
Coût pour q10 |
Coût pour q50 |
Coût pour q90 |
|---|---|---|---|---|
| 48 : trop basse de 2 | +2 | 0,2 | 1,0 | 1,8 |
| 52 : trop haute de 2 | −2 | 1,8 | 1,0 | 0,2 |
Pour q90, sous-estimer de 2 coûte donc 0,9 × 2 = 1,8. Surestimer de 2 coûte seulement 0,1 × 2 = 0,2. Pour q10, c'est l'inverse. Les pénalités restent positives ou nulles ; c'est leur poids selon le sens de l'erreur qui change.
Pourquoi le réseau ne ferait-il pas monter q90 indéfiniment ? Parce que surestimer coûte moins cher, mais ne coûte pas zéro. La perte cherche un compromis sur l'ensemble des exemples, pas une borne qui englobe tout à n'importe quel prix. La documentation de la pinball loss donne la même convention de calcul.
Un TCN : des filtres qui parcourent le temps
TCN signifie Temporal Convolutional Network, ou réseau de convolutions temporelles. Une convolution combine plusieurs valeurs voisines avec des coefficients appris. Vous pouvez la rapprocher d'une moyenne glissante, à une différence essentielle : le réseau apprend les coefficients et combine plusieurs traitements, au lieu de recevoir une règle de moyenne fixée à la main.
Un filtre temporel causal travaille seulement avec la position courante et les positions précédentes. Dans un exemple à trois valeurs, la sortie au temps 10 peut lire les temps 8, 9 et 10, mais pas le temps 11.
La dilatation espace les positions lues. Toujours dans cet exemple à trois valeurs :
Dilatation 1, sortie au temps 10 : lecture des temps 8, 9 et 10.
Dilatation 2, sortie au temps 10 : lecture des temps 6, 8 et 10.
Dilatation 4, sortie au temps 10 : lecture des temps 2, 6 et 10.
Ces indices illustrent le mécanisme, pas la configuration exacte du réseau livré. En empilant les couches, on élargit le champ réceptif, c'est-à-dire l'ensemble des positions susceptibles d'influencer une sortie. Fournir 168 heures au programme et démontrer que son architecture peut toutes les exploiter sont deux vérifications distinctes.
Le principe des convolutions causales dilatées est décrit dans l'étude de Bai, Kolter et Koltun. Ici, « causal » signifie respecter l'ordre temporel des informations. Cela ne signifie pas que le modèle a identifié les causes physiques d'une variation de charge.
Le padding : compléter un bord sans lire après lui
Au début d'une séquence, certaines positions requises par un filtre n'existent pas. Le padding consiste à compléter ce bord avec des valeurs de remplissage. Le TCN du tutoriel utilise un padding à gauche, du côté du passé, afin de conserver le comportement causal.
Une convolution centrée peut, au contraire, utiliser une position située à droite de celle qu'elle calcule. Au temps 9, un filtre centré sur trois positions lirait 8, 9 et 10 : la valeur 10 pourrait alors modifier une sortie attribuée au temps 9. L'exercice final rend cette différence observable.
Ce contrôle interne ne remplace pas celui des données. Un réseau causal peut tout de même recevoir un historique mal construit contenant des informations indisponibles au moment de prévoir. Nous vérifierons donc aussi le découpage des fenêtres et le calcul du prétraitement.
Deux têtes : estimer librement ou imposer un ordre
La tête est la partie finale du réseau qui transforme ce qu'il a calculé en valeurs de sortie.
Avec la tête indépendante, les trois sorties ne sont pas contraintes à respecter un ordre. Le réseau pourrait, par exemple, proposer q10 = 52, q50 = 50 et q90 = 49. Ce serait un croisement : la prétendue borne basse dépasserait la borne haute. « Indépendante » décrit ici l'absence de cette contrainte ; cela ne veut pas dire que les heures ou les séries sont statistiquement indépendantes.
La tête ordonnée part de q10, puis ajoute des incréments obtenus avec softplus. Son principe se lit ainsi ; les lettres a, b et c sont une notation pédagogique pour trois sorties brutes :
q10 = a
q50 = q10 + softplus(b)
q90 = q50 + softplus(c)
Dans sa forme usuelle, softplus(x) = log(1 + exp(x)). Elle transforme une valeur en incrément positif, tout en restant adaptée au calcul des gradients. La documentation PyTorch de softplus détaille cette opération et son implémentation numérique.
Par exemple, softplus(0) = log(2) ≈ 0,6931. Avec a = 48, b = 0 et c = 0, les trois sorties deviennent environ 48, 48,6931 et 49,3863. Cet exemple explique la construction ; ce n'est pas une prédiction capturée dans l'expérience.
Pour des sorties finies, cette construction impose q10 ≤ q50 ≤ q90. Elle n'impose ni que la charge augmente au fil des 24 heures, ni que q10 soit lui-même positif, ni que la bande contienne la bonne proportion d'observations.
Pensez à une validation de formulaire qui impose « date de début ≤ date de fin ». Elle vérifie un ordre cohérent ; elle ne prouve pas que les dates correspondent au rendez-vous réel. Une bande ordonnée n'est pas automatiquement une bande bien calibrée.
Prérequis Docker et GPU
Vous devez être à l'aise avec les fonctions Python, les tableaux, un terminal et les bases de Docker. Les notions d'apprentissage sont introduites dans le parcours ; il n'est pas nécessaire de connaître déjà les TCN.
Le parcours attend Linux x86_64, Docker Compose, NVIDIA Container Toolkit et une RTX 3090 de 24 Gio, ainsi que 16 Gio de RAM et 16 Gio de disque disponibles, hors couches Docker partagées. Il utilise une carte ; posséder deux GPU n'oblige pas à solliciter les deux pour cet exercice.
Le GPU est le processeur graphique utilisé pour les calculs du réseau. CUDA permet ici à PyTorch de l'exploiter. Le contrôle d'environnement initialise CUDA depuis le conteneur et exécute un calcul : voir une carte sur l'hôte n'est pas suffisant. Ce contrôle doit réussir avant l'entraînement. La documentation Docker sur l'accès aux GPU et le guide NVIDIA Container Toolkit décrivent cette intégration.
Pour choisir la carte, exportez GPU_DEVICE=0 ou l'UUID d'une carte avant les commandes. L'UUID est son identifiant ; c'est une autre manière de la sélectionner que son index. Conservez le parcours GPU fourni pour reproduire les résultats : aucun résultat CPU équivalent n'est présenté ici.
Le calcul GPU se déroule sans réseau. Les conteneurs utilisent un système de fichiers en lecture seule, no-new-privileges, des capacités Linux supprimées et des limites CPU, RAM et PID. En termes de développement web, il s'agit de borner ce qu'un processus peut faire et consommer, pas de certifier ses prédictions.
Un checkpoint est un état enregistré pour pouvoir recharger ou reprendre un calcul. Ne chargez pas de checkpoint Torch provenant d'une source non fiable.
Données : séparer le temps avant d'entraîner
Un petit monde dont nous connaissons les règles
Le simulateur produit 12 séries de 180 jours, soit 180 × 24 = 4 320 valeurs horaires par site. Chaque série combine un niveau de base, un cycle quotidien, un cycle hebdomadaire, des fluctuations aléatoires et quelques événements ponctuels.
Les cycles donnent au réseau des régularités à apprendre. Les fluctuations empêchent le futur de se réduire à une répétition parfaitement déterministe. Nous connaissons la recette des données, ce qui facilite les contrôles ; cela ne les rend pas représentatives de sites réels.
Le découpage est chronologique, avec une numérotation des jours qui commence à zéro :
| Partie des données | Jours | Rôle |
|---|---|---|
Entraînement, ou train |
0–119 | Apprendre les paramètres du réseau et ajuster le scaler. |
| Validation | 120–149 | Examiner le modèle sur une période ultérieure, distincte de l'entraînement. |
| Test | 150–179 | Mesurer le résultat sur la dernière période réservée. |
Un scaler transforme l'échelle des nombres avant leur utilisation par le modèle. Lorsqu'une telle transformation apprend des statistiques, celles-ci doivent venir de train seulement. Utiliser les 180 jours pour les calculer transmettrait déjà une information sur les périodes futures, même sans fournir directement leurs cibles au réseau. Ce risque de fuite par le prétraitement est expliqué dans la documentation scikit-learn sur les fuites de données.
La règle du projet est donc : ajuster sur train, puis conserver cette transformation pour les autres périodes. Le type exact de scaler reste celui du code livré ; il n'est pas nécessaire de lui substituer une normalisation différente pour suivre le tutoriel.
Lire le simulateur
L'extrait suivant crée les séries et conserve les paramètres qui les ont produites. np désigne NumPy et TEST_END la borne horaire définie dans le projet. Ce sont des extraits du programme complet : les commandes Docker plus bas exécutent l'ensemble, avec ses imports et sa configuration.
def simulate(seed=17):
    rng = np.random.default_rng(seed)
    t = np.arange(TEST_END)
    series = []
    parameters = []
    for site in range(12):
        baseline = 35 + 2 * site
        daily = 5 + 0.3 * site
        weekly = 3 + 0.1 * site
        phase = 0.17 * site
        noise = 1.2 + 0.05 * site
        value = (
            baseline
            + daily * np.sin(2 * np.pi * t / 24 + phase)
            + weekly * np.cos(2 * np.pi * t / 168)
            + rng.normal(0, noise, len(t))
        )
        events = []
        for day in (25 + site, 75 + site, 125 + site, 155 + site):
            start = day * 24 + 8
            amplitude = 4 + site / 3
            value[start : start + 8] += amplitude
            events.append({"start": start, "duration": 8, "amplitude": amplitude})
        series.append(value)
        parameters.append(
            {
                "site": site,
                "baseline": baseline,
                "daily_amplitude": daily,
                "weekly_amplitude": weekly,
                "phase": phase,
                "noise_std": noise,
                "events": events,
            }
        )
    return np.asarray(series, dtype="float32"), parameters
Que vient-il de se passer ?
np.random.default_rng(seed) initialise le générateur pseudo-aléatoire. La graine par défaut est 17. Dans un environnement inchangé, rejouer les mêmes opérations avec cette graine permet de retrouver les mêmes tirages.
La boucle visite les sites de 0 à 11. baseline = 35 + 2 * site donne un niveau de fond différent à chacun. Attention au vocabulaire : cette variable baseline est le niveau de base du signal, pas le modèle de référence saisonnier comparé plus loin.
Les termes sin(... / 24 ...) et cos(... / 168 ...) ajoutent des oscillations quotidiennes et hebdomadaires. Les amplitudes daily et weekly règlent leur importance, tandis que phase décale le cycle quotidien. rng.normal(0, noise, len(t)) ajoute un bruit gaussien centré sur zéro ; noise règle son écart-type, donc l'ampleur de ses fluctuations.
La seconde boucle ajoute quatre événements de huit heures par site. Pour le site 0, par exemple, l'événement du jour 25 commence à l'indice 25 × 24 + 8 = 608. La tranche 608:616 augmente huit valeurs de 4. Il s'agit d'une lecture de la formule du simulateur, pas de la prévision apprise par le réseau.
Enfin, la fonction renvoie un tableau float32 et la liste parameters, qui documente la génération. float32 indique que les nombres sont stockés en virgule flottante sur 32 bits.
Périmètre de l'extrait : simulate() crée les valeurs et leurs paramètres ; il ne contient pas la construction des fenêtres ni le choix des origines. Ces opérations appartiennent à la préparation complète. Connaître les événements dans le simulateur n'autorise pas non plus à les fournir comme informations futures au modèle.
Une origine : l'instant où l'on se place pour prévoir
Une origine de prévision est le point de départ d'une prévision. Pour lire les indices, appelons ici T la première heure à prédire. Cette convention explicative donne :
Historique visible : T − 168, ..., T − 1   → 168 valeurs déjà connues.
Cibles à prévoir   : T, ..., T + 23       → 24 valeurs futures.
Durant l'entraînement, ces cibles sont connues du programme et servent à calculer l'erreur. Elles ne doivent pas être mélangées à l'historique fourni en entrée. C'est le même principe qu'un jeu de tests : la réponse attendue sert à corriger le résultat, pas à remplir les données de la fonction que l'on teste.
Les fenêtres d'entraînement avancent d'une heure. Leurs cibles doivent rester entièrement dans train. Validation et test utilisent une origine par jour et par site :
12 sites × 30 jours = 360 origines par partie
360 origines × 24 heures = 8 640 cibles horaires par partie
Cela représente 8 640 valeurs à vérifier, pas 8 640 journées. Chaque valeur reçoit trois estimations, soit 8 640 × 3 = 25 920 contributions élémentaires à la perte de quantiles.
Traverser une frontière avec l'historique n'est pas forcément une fuite
Prenons la première origine de validation, au début du jour 120. Les jours 113 à 119 constituent un historique de sept jours déjà disponible. Le fait que ces valeurs appartiennent à train ne pose pas de problème : elles sont dans le passé de cette prévision.
En revanche, une fenêtre d'entraînement dont la première cible serait la dernière heure du jour 119 débordera sur le jour 120 pour ses autres cibles. Elle mélangerait entraînement et validation et doit être exclue.
La même logique s'applique au test. Au début du jour 150, les jours 143 à 149 sont déjà connus. Plus tard, des observations du début de la période de test peuvent servir d'historique à une origine ultérieure, si elles sont effectivement disponibles à cette date. Cela ne signifie pas que l'on réentraîne le réseau ou que l'on réajuste le scaler sur le test.
L'évaluation rejoue ainsi des prévisions successives. Elle ne prédit pas les trente jours de test en une seule fois depuis leur premier matin.
Le code central : la perte de quantiles
Comprendre les dimensions avant les opérations
Un tenseur est ici un tableau de nombres à plusieurs dimensions. Dans un lot de B exemples, B étant le nombre de fenêtres traitées ensemble, nous avons :
prediction : B × 24 × 3   → un triplet q10, q50, q90 pour chaque heure.
target     : B × 24       → une seule valeur observée pour chaque heure.
Pour un seul exemple, le réseau propose donc 72 nombres et nous disposons de 24 valeurs de référence. Les trois prédictions d'une heure sont comparées à la même cible, avec trois pénalisations différentes.
def pinball_loss(prediction, target):
    tau = torch.tensor(
        [0.1, 0.5, 0.9], device=prediction.device, dtype=prediction.dtype
    )
    error = target[..., None] - prediction
    return torch.maximum(tau * error, (tau - 1) * error).mean()


def check_loss(config):
    p = torch.zeros(1, 1, 3)
    positive = pinball_loss(p, torch.ones(1, 1))
    negative = pinball_loss(p, -torch.ones(1, 1))
    assert torch.allclose(positive, torch.tensor(0.5)) and torch.allclose(
        negative, torch.tensor(0.5)
    )
    return {
        "e_plus_1": [0.1, 0.5, 0.9],
        "e_minus_1": [0.9, 0.5, 0.1],
        "mean_positive": float(positive),
        "mean_negative": float(negative),
    }
Lire les trois opérations de pinball_loss()
tau contient les niveaux [0.1, 0.5, 0.9], dans le même ordre que les trois sorties. device et dtype lui donnent le même emplacement de calcul et le même type numérique que prediction.
target[..., None] ajoute une dimension de taille 1 à la fin du tableau : B × 24 devient B × 24 × 1. PyTorch peut alors comparer chaque cible aux trois prédictions correspondantes. Cette extension implicite des dimensions compatibles s'appelle le broadcasting ; la documentation PyTorch en décrit les règles.
Enfin, torch.maximum(...) choisit le coût approprié pour chaque erreur. .mean() moyenne tous ces coûts : sur les exemples du lot, les 24 heures et les trois quantiles. Le résultat est un scalaire, c'est-à-dire un seul nombre.
La fonction calcule la perte, mais ne modifie pas elle-même les paramètres. Pendant l'entraînement, les gradients indiquent comment une variation des paramètres affecterait cette perte, puis l'optimiseur applique les mises à jour. Pendant l'évaluation, on peut calculer la même perte sans entraîner quoi que ce soit.
Un calcul que l'on peut refaire à la main
Prenons une heure fictive avec y = 50 et les prédictions q10 = 47, q50 = 51, q90 = 55.
Le quantile bas sous-estime de 3 : son coût vaut 0,1 × 3 = 0,3. La médiane surestime de 1 : son coût vaut 0,5 × 1 = 0,5. Le quantile haut surestime de 5 : son coût vaut 0,1 × 5 = 0,5.
La perte moyenne pour cette heure est donc :
(0,3 + 0,5 + 0,5) / 3 = 0,4333…
La valeur réelle est bien dans la bande [47, 55], mais la perte n'est pas nulle. Ce n'est pas une contradiction : être couvert et avoir un bon score de quantiles ne sont pas le même contrôle.
À τ = 0,5, la pinball vaut la moitié de l'erreur absolue. Cette identité concerne la composante médiane, pas la moyenne des trois quantiles. La référence mean_pinball_loss permet de retrouver cette propriété.
La perte a l'unité des nombres qu'on lui fournit. Les mesures publiées plus bas sont exprimées en kW simulés ; une perte calculée sur une échelle transformée ne doit pas être comparée directement à ces valeurs sans tenir compte du scaler.
Ce que check_loss() vérifie, et ce qu'il ne vérifie pas
Le contrôle construit trois prédictions nulles, puis une cible +1 et une cible −1. Les contributions attendues sont respectivement [0,1 ; 0,5 ; 0,9] et [0,9 ; 0,5 ; 0,1]. Leur moyenne vaut 0,5 dans les deux cas.
L'assertion vérifie bien ces deux moyennes, avec torch.allclose, qui compare les valeurs avec une tolérance numérique. En revanche, les listes e_plus_1 et e_minus_1 retournées par la fonction sont écrites en dur, et non recalculées à partir des contributions intermédiaires.
Point de vigilance : cette moyenne ne suffit pas à détecter une inversion du signe. Avec ces trois niveaux symétriques et ces prédictions identiques, remplacer
target − predictionparprediction − targetéchangerait les contributions des quantiles bas et haut, sans changer la moyenne de0,5. La formule visible utilise bien le bon sens ; c'est la portée de cette assertion qu'il faut distinguer de celle d'un contrôle par quantile.
Pour renforcer ce contrôle dans une expérience séparée, il faudrait comparer les contributions de chaque niveau, ou ajouter des prédictions différentes selon le quantile. Le code de référence ci-dessus reste inchangé. Cette remarque ne préjuge pas du contenu des autres tests du projet.
Installer et vérifier l'environnement
Extrayez l'archive, puis placez votre terminal à sa racine, là où se trouvent les scripts et la configuration Compose. Toutes les commandes qui suivent partent de ce même répertoire.
Ce projet n'a pas de poids préentraînés à télécharger : acquire valide ici un manifeste sans poids. Les séries seront fabriquées par prepare, et le réseau sera entraîné sur ces données. Le rôle de cette étape est différent de l'acquisition d'un grand modèle de langage.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
Lisez cette séquence comme la préparation d'un environnement de développement. setup.sh prépare le projet ; config --quiet contrôle la configuration Compose ; build acquire gpu construit les images des deux services. Viennent ensuite la validation du manifeste, le calcul de contrôle CUDA dans le conteneur et la suite de tests avec pytest.
Observation attendue : chaque commande doit terminer sans erreur. Le contrôle d'environnement doit réussir avant l'entraînement. Une suite de tests réussie contrôle le programme sur ses cas prévus ; elle n'a pas encore mesuré la qualité des prévisions sur le test.
Conservez les versions et réglages de l'archive pour la reproduction. Les références en fin d'article servent à comprendre les mécanismes, pas à remplacer les dépendances du projet par leurs dernières versions.
Préparer, comparer et entraîner
Nous pouvons maintenant créer les données, établir la référence saisonnière, inspecter le réseau, vérifier la perte et entraîner les deux têtes. La séquence contient aussi un arrêt volontaire, une reprise et une comparaison des états avant l'évaluation.
Les résultats publiés dans la suite viennent de la reproduction lecteur validée de ce parcours r1.
docker compose run --rm gpu python -m quantile_forecast.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli baseline --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli inspect-model --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli check-loss --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml --variant independent
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml --stop-after 1000 --run-name interrupted
docker compose run --rm gpu python -m quantile_forecast.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m quantile_forecast.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m quantile_forecast.cli evaluate --config configs/minimum.yaml
Préparer une référence avant de demander mieux au réseau
prepare prépare les séries et les fenêtres selon les règles temporelles décrites. baseline établit la référence saisonnière : un point de comparaison qui exploite la répétition des motifs dans le temps.
L'intérêt d'une baseline n'est pas de fabriquer un adversaire facile à battre. Elle permet de poser une question utile : qu'apporte le réseau par rapport à une méthode de référence ? Le détail de cette baseline reste celui de l'archive ; les extraits de cet article ne donnent pas sa formule complète.
inspect-model précède les entraînements et permet de contrôler le réseau. check-loss exécute le contrôle numérique que nous venons de lire. Consultez leurs résultats avant de lancer la partie la plus coûteuse du parcours.
Comparer deux constructions de sortie
La commande train du parcours entraîne la tête ordonnée ; --variant independent lance la variante indépendante. Leur comparaison porte notamment sur l'erreur de quantiles, la médiane, la couverture, la largeur et les croisements.
Ne remplacez pas une tête par un simple tri des résultats avant l'évaluation. Trier après coup créerait un autre traitement, dont il faudrait conserver les sorties et mesurer les effets séparément.
Reprendre : continuer un état, pas recommencer un essai
La commande avec --stop-after 1000 --run-name interrupted arrête volontairement l'entraînement au pas 1 000. Un pas est une étape de l'entraînement ; ce nombre ne désigne ni mille heures de prévision ni mille jours de données.
La commande suivante recharge artifacts/checkpoints/interrupted/state.pt et poursuit sous le nom resumed. compare-resume compare ensuite la reprise au parcours de référence.
Vous pouvez rapprocher cette opération d'un traitement de file d'attente reprenable : retrouver le dernier fichier écrit ne suffit pas si l'on a perdu l'état nécessaire pour continuer exactement au même point. Le test de reprise du projet rend cette continuité vérifiable, au lieu de la supposer.
Enfin, evaluate produit les mesures des méthodes comparées. Une erreur maximale nulle lors de la reprise et une bonne précision de prévision sont deux résultats distincts : l'un concerne la continuité du calcul, l'autre la qualité des sorties.
Mesures avant les résultats
Chaque résultat agrège 360 origines et 8 640 cibles horaires. Avant de comparer les chiffres, fixons le sens de chaque mesure.
Pinball : la qualité des trois seuils
La pinball moyenne applique le calcul précédent aux trois quantiles. Elle s'exprime ici en kW simulés. Plus bas est meilleur, pour une même population, les mêmes quantiles et la même convention d'unité. Ce n'est pas un pourcentage de prévisions exactes.
MAE : l'erreur de la médiane seulement
La MAE, pour Mean Absolute Error, est la moyenne des écarts absolus. Dans ce tutoriel, elle concerne q50 :
MAE = moyenne de |valeur observée − q50|
Une médiane à 50 face à une observation de 53 contribue pour 3 kW. La borne basse et la borne haute n'interviennent pas dans ce calcul. « MAE de la médiane » signifie donc moyenne des erreurs de q50, et non médiane de toutes les erreurs.
Couverture : combien de valeurs tombent dans la bande ?
Une cible est couverte lorsque q10 ≤ y ≤ q90, bornes incluses. La couverture est le nombre de cibles couvertes divisé par le nombre total de cibles.
La cible nominale est 80 %, pas 100 %. Une couverture trop basse indique que la bande manque trop souvent les observations sur l'échantillon ; une couverture très haute peut correspondre à une bande trop prudente pour le niveau annoncé. Il faut donc lire cette mesure avec la largeur et les autres scores.
Largeur : quelle marge annonce-t-on ?
La largeur vaut q90 − q10, puis le programme en donne une moyenne. À couverture comparable, une bande moins large est plus précise sur ce qu'elle annonce. Mais une bande minuscule qui manque la plupart des observations n'est pas une réussite.
Inversement, élargir une bande jusqu'à couvrir presque toutes les valeurs ne suffit pas à produire une prévision utile. Si l'intervalle est trop large pour orienter une décision, sa couverture seule ne résout pas le problème de départ.
Croisements : les trois valeurs sont-elles dans le bon ordre ?
Le taux de croisement compte les triplets qui ne respectent pas q10 ≤ q50 ≤ q90. Il porte sur les 8 640 triplets, pas sur leurs 25 920 nombres pris séparément.
Une tête ordonnée vise à supprimer ce problème par construction. Une tête indépendante peut également n'avoir aucun croisement sur un jeu donné ; cette observation ne devient pas une garantie pour les prochaines données.
Cinq heures pour comprendre les différences
Voici un petit lot entièrement pédagogique. Nous choisissons volontairement la même bande [48, 52] et la même médiane 50 aux cinq heures, pour rendre les calculs immédiats. Ce n'est pas un extrait des résultats r1.
Sur petit écran, faites défiler le tableau horizontalement.
| Heure illustrative | Valeur observée | q10 |
q50 |
q90 |
Dans la bande ? | Erreur absolue de q50 |
|---|---|---|---|---|---|---|
| 1 | 49 | 48 | 50 | 52 | Oui | 1 |
| 2 | 50 | 48 | 50 | 52 | Oui | 0 |
| 3 | 51 | 48 | 50 | 52 | Oui | 1 |
| 4 | 52 | 48 | 50 | 52 | Oui, borne incluse | 2 |
| 5 | 55 | 48 | 50 | 52 | Non | 5 |
La couverture vaut 4 / 5 = 80 %. La largeur moyenne est 52 − 48 = 4. La MAE vaut (1 + 0 + 1 + 2 + 5) / 5 = 1,8. Le taux de croisement est nul : chaque triplet est ordonné.
Pour la dernière heure, la pinball reçoit les contributions 0,7, 2,5 et 2,7, soit une moyenne de 1,9667 environ. Sur les cinq heures et les trois quantiles, le total des contributions vaut 9,5 et la pinball moyenne 9,5 / 15 = 0,6333….
Nous avons donc 80 % de couverture, zéro croisement et pourtant des erreurs non nulles. Les métriques décrivent des propriétés complémentaires, pas cinq formulations d'un même score.
Une bonne moyenne peut cacher un mauvais segment
La calibration consiste à vérifier si les proportions annoncées correspondent à ce que l'on observe, sur suffisamment de prévisions pertinentes pour l'usage visé. Une couverture proche de 80 % sur ce lot simulé est une observation, jamais une garantie pour le futur.
Un autre exemple fictif le montre : si un premier groupe contient 30 valeurs couvertes sur 50 et un second 50 sur 50, la couverture globale vaut 80 / 100 = 80 %. Pourtant, les groupes sont respectivement à 60 % et 100 %. La moyenne cache deux comportements très différents.
De même, une couverture globale de 80 % ne prouve pas que les dépassements se répartissent à raison de 10 % sous q10 et 10 % au-dessus de q90. Il faut examiner les deux côtés, ainsi que la médiane. Et les 24 bandes horaires ne constituent pas une promesse que toute la journée restera dans la bande avec une probabilité de 80 % : une couverture par heure et une couverture simultanée de la journée sont des questions différentes.
Ces distinctions expliquent pourquoi une évaluation réelle devrait aussi regarder les sites, les heures à prévoir et les périodes. Les origines successives partagent une grande partie de leur historique : 8 640 cibles ne doivent pas être assimilées sans justification à autant d'essais indépendants.
Résultats observés
Voici les valeurs de la reproduction r1, rassemblées pour comparer les méthodes. Les erreurs et largeurs sont exprimées en kW simulés.
Sur petit écran, faites défiler le tableau horizontalement.
| Méthode | Pinball | MAE de q50 |
Couverture | Largeur moyenne | Croisements observés |
|---|---|---|---|---|---|
| Baseline saisonnier | 0,5462 | 1,7130 | 80,53 % | 5,4649 | 0 % |
| Tête indépendante | 0,3939 | 1,2350 | 80,25 % | 3,9847 | 0 % |
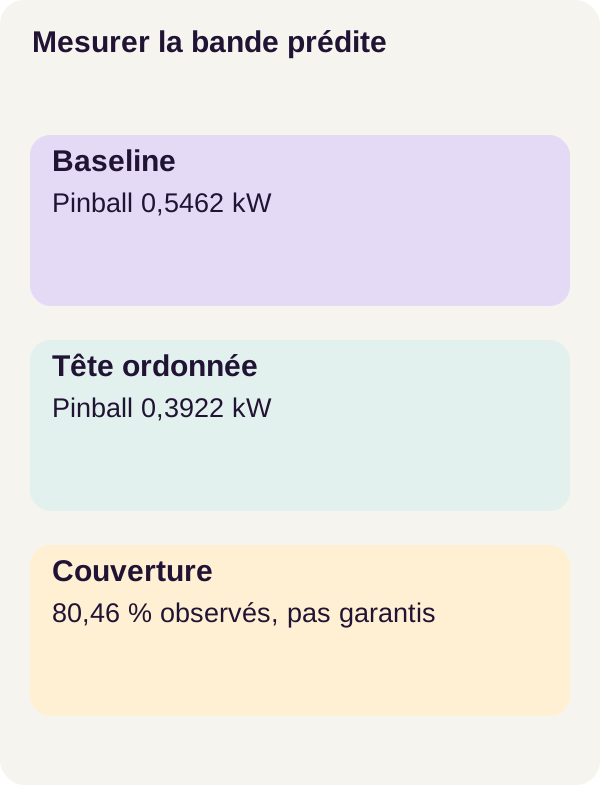
| Tête ordonnée | 0,3922 | 1,2313 | 80,46 % | 3,9824 | 0 % |
Les deux réseaux réduisent ici la pinball et l'erreur de la médiane par rapport à la référence saisonnière. Ils produisent aussi des bandes plus étroites, tout en conservant une couverture globale proche de 80 %.
La tête ordonnée est légèrement meilleure que l'indépendante sur la pinball et la MAE. Pour donner une échelle à « légèrement », la différence de pinball vaut 0,3939 − 0,3922 = 0,0017 kW, et celle de MAE 1,2350 − 1,2313 = 0,0037 kW. Ce sont des soustractions des valeurs publiées, pas de nouvelles mesures.
La largeur de la tête ordonnée est inférieure de 5,4649 − 3,9824 = 1,4825 kW à celle de la baseline saisonnière. En revanche, il serait trompeur de conclure que « plus la couverture monte, meilleur est le modèle » : la couverture nominale reste 80 %, et les trois méthodes en sont proches sur cet échantillon.
Les trois méthodes ont zéro croisement observé. Le tableau ne montre donc pas une correction de croisements effectivement présents dans la variante indépendante. La différence est structurelle : l'ordre est imposé dans la tête ordonnée, tandis que le zéro de la tête indépendante décrit seulement cette évaluation.
La reprise déterministe retrouve les mêmes paramètres avec une erreur maximale nulle, ainsi que le scaler et l'initialisation partagée. Ce résultat concerne la reproduction contrôlée du calcul. La documentation PyTorch sur la reproductibilité rappelle pourquoi on ne doit pas transformer une égalité locale en garantie entre toutes les versions et toutes les plateformes.
Ce que nous avons appris
Nous savons maintenant remplacer une prévision unique par trois seuils appris et donner un sens à la bande qui les accompagne. La pinball enseigne aux quantiles des comportements différents ; softplus impose leur ordre ; les métriques vérifient ensuite ce que ces sorties valent sur les données réservées.
La discipline temporelle intervient à plusieurs niveaux. L'historique doit être disponible à l'origine de prévision, les cibles doivent rester dans leur partie des données, le scaler ne doit pas apprendre sur le futur et le bloc causal ne doit pas utiliser une position ultérieure pour calculer une sortie antérieure.
Dans cette expérience, le modèle ordonné est légèrement meilleur sur la pinball et la MAE, avec une bande plus étroite que la référence saisonnière. Ce constat n'en fait pas automatiquement le meilleur choix en production. Aucune calibration postérieure, dérive saisonnière ni analyse du coût métier d'une sous-prévision n'a été validée.
La conclusion utile n'est donc pas « ce réseau sait prévoir une charge réelle », mais : nous disposons d'un parcours contrôlé pour entraîner, reprendre et comparer des prévisions par quantiles sans confondre ordre, précision et calibration.
Exercice : hypothèse avant commande
Revenons au padding. Nous allons modifier une valeur d'entrée située au temps 10, puis examiner les sorties attribuées aux temps 0 à 9.
Avant d'exécuter, écrivez votre hypothèse : un bloc causal a-t-il le droit de modifier une sortie passée après ce changement ? Et une convolution symétrique peut-elle laisser la valeur du temps 10 influencer le calcul du temps 9 ?
Le contrôle fourni compare les deux variantes. Exécutez-le sans remplacer le réseau du parcours de référence :
docker compose run --rm gpu python -m quantile_forecast.cli exercise --config configs/exercise.yaml
La sortie observée donne 0,0 pour l'erreur passée du bloc causal et 1,0 pour la variante symétrique. Le premier reste inchangé sur les positions examinées ; la seconde laisse passer une influence provenant d'une position ultérieure. Le test détecte donc bien la fuite du futur vers le passé à l'intérieur du bloc.
Ce 1,0 n'est pas un taux d'erreur de prévision de 100 % : c'est la valeur de différence rapportée par ce contrôle de perturbation.
Nuance importante : de quel futur parlons-nous ? Le temps 10 est futur par rapport aux sorties 0 à 9 du bloc. S'il appartient déjà aux 168 heures connues à l'origine de prévision, le fait de le lire n'est pas, à lui seul, la preuve que les 24 cibles futures ont été utilisées. Le test vérifie la causalité interne du bloc ; le contrôle des fenêtres vérifie séparément la frontière entre historique et horizon à prévoir.
Pour expliquer le résultat, revenez à un filtre centré qui lit 8, 9 et 10 pour calculer la sortie 9. Comparez-le à un filtre causal à trois positions qui ne lirait que 7, 8 et 9. Cette lecture des dépendances vaut mieux que la seule phrase « le test passe ».
Adapter et produire
Remplacer le simulateur sans perdre le contrat temporel
Avec des données réelles, commencez par définir ce que représente chaque ligne : le site, l'horodatage, l'unité et la fréquence attendue. Une valeur manquante n'est pas automatiquement une charge nulle. Une mesure reçue en retard n'était pas nécessairement disponible à l'instant où votre prévision aurait dû être faite.
Il faut donc des données autorisées et versionnées, une stratégie explicite pour les retards et les valeurs manquantes, ainsi qu'un découpage temporel vérifiable. Évaluez ce que le système savait à la date de prévision, pas ce qu'une base corrigée après coup permet de voir aujourd'hui.
Le tutoriel ne valide pas ces choix sur des données opérationnelles. Une adaptation constitue une nouvelle expérience : conservez les sorties r1, travaillez dans une copie et documentez chaque changement de données, de fréquence, d'horizon ou de modèle.
Relier les bandes à une décision
Un tableau de bord peut afficher une médiane et une bande sans déclencher d'action. Dès qu'une action dépend d'une borne, il faut préciser le coût d'une sous-prévision, d'une sur-prévision et d'une alerte inutile.
Le niveau q90 n'est pas une politique universelle de prudence. Une application peut avoir besoin d'un autre niveau, d'une validation humaine ou d'une règle de rejet lorsque la bande devient trop large. Ce sont des choix métier à définir et à tester, pas des garanties apportées par softplus.
Il faudra aussi vérifier la calibration par segment et suivre la dérive, c'est-à-dire l'évolution des données et des erreurs dans le temps. Une bonne couverture obtenue dans le monde contrôlé du simulateur ne suffit pas lorsque les habitudes, les équipements ou les conditions changent.
Construire le service autour du modèle
La partie web reste un travail à part entière : accès authentifié, autorisations par site, validation des entrées, journalisation adaptée, gestion de la charge et des erreurs, observabilité, sauvegarde et restauration. Les seuils d'alerte et l'action associée à chaque bande doivent être explicites.
Le code fournit un parcours pédagogique de prévision. Il ne fournit ni prévision certifiée ni API métier prête à déployer.
Dépannage et nettoyage
Si CUDA échoue, commencez par le contrôle d'environnement et le guide NVIDIA Container Toolkit. Vérifiez l'accès à la carte sélectionnée depuis le conteneur avant de changer le modèle.
Si le contrôle de causalité échoue, inspectez le padding et les positions lues. Ne modifiez pas le score pour rendre l'échec moins visible. Si la couverture surprend alors que les quantiles sont ordonnés, ce n'est pas nécessairement un problème d'ordre : vérifiez les cibles, les unités, le scaler et la population évaluée.
Après l'exercice, produisez les figures, contrôlez les checkpoints, prévisualisez le nettoyage, puis arrêtez les services :
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
plot.py produit les figures du parcours et check_checkpoints.py contrôle ses checkpoints. La commande avec --dry-run est une prévisualisation : elle conserve les fichiers générés. Lisez ce qu'elle annonce avant d'envisager une suppression distincte.
La dernière commande arrête les ressources Compose du projet. Elle ne remplace pas la prévisualisation par un nettoyage effectif de vos résultats. Conservez les sorties utiles pour comparer vos expériences.
Sources primaires et documentation
Les références de départ du tutoriel décrivent le mécanisme et son environnement :
- Bai, Kolter, Koltun — Temporal Convolutional Networks
- Scikit-learn — pinball loss
- Docker Compose — support GPU
- NVIDIA Container Toolkit — guide d'installation
Pour approfondir les explications, la référence PyTorch de softplus détaille les incréments, et les règles de broadcasting expliquent le passage d'une cible par heure à trois comparaisons.
L'exemple scikit-learn sur les intervalles de prédiction utilise un autre modèle : il complète l'explication des quantiles, sans servir de preuve pour les résultats de notre TCN. La page sur les fuites de données approfondit le rôle du prétraitement, et la documentation PyTorch sur la reproductibilité précise les limites des reproductions entre environnements.
Les valeurs expérimentales de cet article restent celles du parcours r1. Les exemples chiffrés signalés comme pédagogiques servent à refaire les calculs ; ils ne constituent pas de nouvelles sorties GPU.
Télécharger l'archive et suivre le parcours complet : ouvrir le tutoriel.