





Hãy hình dung một biểu mẫu trong ứng dụng của bạn: người dùng tải lên ảnh của một tài liệu, và bạn muốn điền sẵn một mã tham chiếu cùng một số tiền. Với mã nghiệp vụ của bạn, đó là hai chuỗi cần kiểm tra. Nhưng trong tệp được gửi, các thông tin ấy vẫn chỉ là những điểm ảnh. Làm sao chuyển từ cái này sang cái kia?
Đó là vai trò của OCR, nhận dạng ký tự quang học. Chúng ta sẽ xây dựng một chuỗi xử lý cục bộ nhỏ bằng Python, Docker và EasyOCR, rồi xem nó thực sự đọc được gì. Không chỉ là văn bản trông có vẻ đúng trên màn hình: chúng ta cũng sẽ giữ lại các vùng được phát hiện, điểm số của công cụ và các lỗi đã đo.
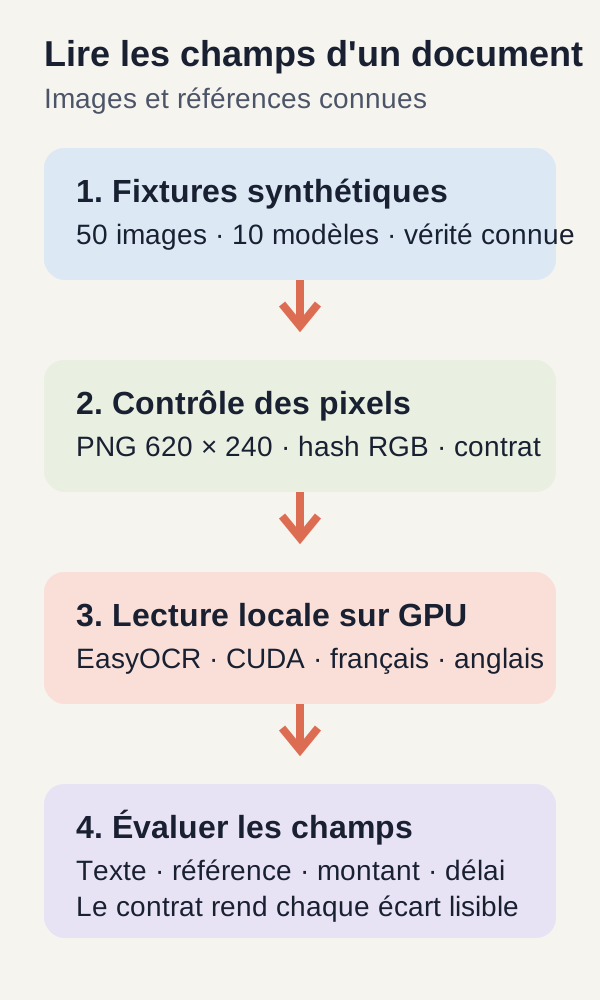
Để bắt đầu mà không xử lý tài liệu riêng tư, dự án tạo 50 ảnh tổng hợp mà nội dung của chúng ta đã biết. Dự án đọc chúng trên GPU CUDA, rồi tính báo cáo trên 40 ảnh dành riêng cho kiểm thử. Sự khác biệt giữa điều ta chờ đợi và điều mô hình tạo ra sẽ là sợi chỉ xuyên suốt của chúng ta.
Tải xuống toàn bộ dự án của hướng dẫn.
Các kết quả được trình bày đến từ hai lần tái tạo đã được xác thực của kho lưu trữ r3 này, trong các thư mục mới. Những ví dụ được thêm vào để giải thích một khái niệm được đánh dấu như vậy: chúng không thay thế các đầu ra đã đo của dự án.
Vấn đề và kết quả mong đợi
Đọc văn bản vẫn chưa phải là hiểu tài liệu
OCR, viết tắt của optical character recognition, trả lời hai câu hỏi liên tiếp: văn bản nằm ở đâu trong ảnh?, rồi những ký tự nào nằm trong các vùng đó?
Bước đầu là phát hiện. Bước thứ hai là nhận dạng. Sau đó, văn bản cuối cùng có thể được tạo thành bằng cách ghép các đoạn thu được. Đây là sự tách biệt xuất hiện trong API của EasyOCR, với các thao tác phát hiện và nhận dạng.
Hãy lấy một tình huống minh họa: bạn thấy « Total EUR 10.00 » trên một ảnh. Với ứng dụng của bạn, vẫn còn vài câu hỏi. Công cụ đã đọc đủ mọi chữ số chưa? Nó có giữ lại dấu phân cách thập phân không? Số tiền này là tổng, tổng phụ hay một giá trị khác có trong tài liệu?
Nhận dạng ký tự và trích xuất một trường nghiệp vụ vì thế là hai bước khác nhau. Hướng dẫn của chúng ta xây dựng và đánh giá chuỗi thứ nhất; các kiểm tra mã tham chiếu và số tiền của nó được cố ý giữ đơn giản.
Các tệp bạn sẽ nhận được
Khi kết thúc lộ trình, outputs/images/ sẽ chứa 50 PNG. outputs/prepared.json sẽ liên kết các ảnh với văn bản mong đợi và dấu vết kiểm tra của chúng. outputs/ocr.json sẽ lưu, cho mỗi ảnh, các hộp văn bản, văn bản được nhận dạng, độ tin cậy và thời gian đo được. Cuối cùng, outputs/evaluation.json sẽ chứa báo cáo của chỉ 40 ảnh kiểm thử.
Với một lập trình viên web, hãy nghĩ tới kiểm thử tích hợp: bạn chuẩn bị dữ liệu đã biết, cho một đầu vào đi qua hệ thống, rồi so sánh phản hồi với điều đã mong đợi. Ở đây, đầu vào không phải biểu mẫu JSON mà là một ảnh, và kết quả có thể có lỗi đọc.
Điều kiện tiên quyết về GPU, Docker và tài nguyên
Lộ trình r3 đã được xác thực trên Linux amd64, tức kiến trúc x86_64, với Docker Engine, Docker Compose, trình điều khiển NVIDIA, nvidia-smi và NVIDIA Container Toolkit. Các phép đo của bài này được thực hiện trên RTX 3090.
GPU là card dùng để tăng tốc các phép tính của mô hình. CUDA là môi trường tính toán NVIDIA được dùng trong dự án này. NVIDIA Container Toolkit cho phép Docker sử dụng quyền truy cập đó; một card hiển thị trên Linux chưa chắc hiển thị trong container. Cách cài đặt được mô tả trong hướng dẫn chính thức của NVIDIA.
Lộ trình suy luận này chỉ dùng CUDA. Nó không có phương án dự phòng CPU đã được xác thực. Trong tệp .env đi kèm, hãy đặt GPU_DEVICE trước khi khởi động nếu bạn phải sử dụng một card khác ngoài card 0.
Preflight, tức kiểm tra trước, yêu cầu 20 GiB trống trên đĩa của dự án và vùng lưu trữ Docker, cùng 12 GiB RAM khả dụng. Container của ứng dụng bị giới hạn ở 8 GiB bộ nhớ, 4 CPU và 256 tiến trình. GiB và MiB là các đơn vị nhị phân về dung lượng bộ nhớ hoặc đĩa.
Đừng nhầm các giá trị này: ngưỡng preflight liên quan đến tài nguyên sẵn có trên máy chủ; giới hạn container hạn chế điều ứng dụng có thể sử dụng. RAM là bộ nhớ chính của máy, không phải VRAM của card đồ họa.
Sau khi giải nén ZIP, tại thư mục gốc của dự án, hãy bắt đầu bằng:
./scripts/preflight.sh
Tập lệnh này kiểm tra Linux, Docker, Compose, card được chọn, việc khởi tạo CUDA từ Docker, RAM và dung lượng đĩa. Nó không tự cấu hình hệ thống của bạn. Nếu phát hiện GPU trên máy chủ nhưng không trong Docker, hãy cấu hình NVIDIA Container Toolkit rồi chạy lại kiểm tra.
Các kiểm tra này xác định các điều kiện của lộ trình. Chúng không hứa hẹn tương thích với mọi card CUDA, cũng không hứa hẹn thời gian giống nhau trên mọi máy.
Dữ liệu trước OCR
Vì sao tự tạo tài liệu?
Trước khi đo khả năng đọc, chúng ta cần một câu trả lời tham chiếu. Trong học máy, điều này thường được gọi là sự thật nền: thông tin được xem là đúng, để ta so sánh với đầu ra của mô hình.
Tệp data/fixtures.json chứa 50 phiếu tổng hợp. Một fixture đơn giản là bộ dữ liệu được chuẩn bị cho kiểm thử, như các bộ bạn dùng để điền vào cơ sở dữ liệu phát triển. Đây là phiếu đầu tiên của dự án:
{
  "id": 0,
  "template": 0,
  "split": "dev",
  "variant": "clean",
  "ref": "REF-000",
  "amount": "10.00"
}
id nhận diện ảnh. template chỉ mẫu của ảnh. split cho biết tập hợp mà nó thuộc về, ở đây là phát triển. variant chọn diện mạo của ảnh. Cuối cùng, ref và amount cho các giá trị mong đợi trước mọi nhận dạng.
src/images.py biến phiếu này thành ba dòng:
BOUTIQUE 0
Reference REF-000
Total EUR 10.00
Đây không phải đầu ra OCR mà là văn bản do trình tạo vẽ. Vì vậy chúng ta biết câu trả lời mà không cần hỏi công cụ cần đánh giá. OCR nhận các điểm ảnh; tham chiếu vẫn sẵn có để so sánh sau đó.
Các biến thể có kiểm soát, không phải hóa đơn thật
Mỗi ảnh RGB có kích thước 620 × 240 pixel và dùng phông DejaVu Sans ở 28 pixel. RGB nghĩa là mỗi pixel được biểu diễn bởi thành phần đỏ, lục và lam.
Trình tạo áp dụng một trong bốn biến thể: ảnh sạch, xoay 3 độ, độ tương phản đặt ở 0,4, hoặc nhiễu Gaussian có độ lệch chuẩn 12. Nhiễu thêm các biến động vào giá trị pixel. Hạt giống của nó, 42 + id, cho phép tái tạo cùng nhiễu cho một phiếu xác định trong môi trường đã cố định.
Từ mẫu không có nghĩa là mười bố cục hóa đơn thực tế. Trong mã được trình bày phía sau, số này đặc biệt thay đổi dòng « BOUTIQUE » và độ lệch ngang của văn bản. Mọi ảnh vẫn là các phiếu đơn giản gồm ba dòng.
Vì sao tách phát triển và kiểm thử?
Mười mẫu được chia thành hai tập không chồng lấp: hai mẫu cho phát triển, tức 10 ảnh, và tám mẫu cho kiểm thử, tức 40 ảnh. Một mẫu không thuộc cả hai tập.
Ý tưởng là phân biệt các ví dụ phục vụ hoàn thiện lộ trình với các ví dụ phục vụ đo kết quả. Điều này không có nghĩa chúng ta huấn luyện EasyOCR trên mười ảnh phát triển: ở đây chúng ta dùng các mô hình đã huấn luyện sẵn, không sửa đổi trọng số của chúng.
Cũng cần chú ý tới kích thước các nhóm kiểm thử:
| Biến thể | Ảnh trên mỗi mẫu kiểm thử | Tổng trên 8 mẫu kiểm thử |
|---|---|---|
clean: ảnh sạch |
2 | 16 |
rotation: xoay 3 độ |
1 | 8 |
noise: nhiễu Gaussian |
1 | 8 |
contrast: độ tương phản 0,4 |
1 | 8 |
| Tổng | 5 | 40 |
Các chú thích và ảnh hoàn toàn là tổng hợp: không tài liệu riêng tư nào bị lộ. Đổi lại, bộ này không đại diện cho hóa đơn được số hóa, bố cục phức tạp hay chữ viết tay. Việc tách các mẫu không xóa bỏ giới hạn này.
Cài đặt, tải và chuẩn bị ảnh
Giải nén kho lưu trữ rồi chuyển tới thư mục gốc của nó. Các lệnh sau được chạy từ thư mục này, theo đúng thứ tự. Chúng tương ứng với phần đầu của mỗi trong hai lần tái tạo r3; kiểm tra trước được nhắc lại để trình bày toàn bộ lộ trình:
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app -m src.cli prepare
Mỗi bước làm gì?
setup.sh chuẩn bị các thư mục với định danh của người dùng hiện tại. docker compose build xây dựng ảnh Python 3.12.13 được khóa bởi dự án. Các phụ thuộc gồm PyTorch 2.10.0+cu129, torchvision 0.25.0+cu129 và EasyOCR 1.7.2.
PyTorch cung cấp công cụ tính toán mà EasyOCR dùng; torchvision là một phần của ngăn xếp được cài cho xử lý thị giác. Các phiên bản trên là của lộ trình đã xác thực, không phải lời mời thay bằng bản mới nhất. Ảnh Python được ghi trong Docker Hub, còn các gói PyTorch CUDA liên quan được công bố trong chỉ mục cu129.
Dịch vụ fetch lấy các tài nguyên công khai. Đáng chú ý, nó tải trọng số EasyOCR craft_mlt_25k và latin_g2 từ các bản phát hành chính thức của JaidedAI. Trọng số là các tham số số mà mô hình đã học trước hướng dẫn này. Tải chúng cho phép thực hiện suy luận: áp dụng một mô hình đã huấn luyện vào ảnh mới.
Dự án kiểm tra kích thước và SHA-256 của kho lưu trữ cũng như trọng số đã giải nén. Dấu vết này cho phép xác minh tệp khớp với tệp được mong đợi. Lần tải đầu tiên đã xác thực chiếm 91 536 692 byte.
fetch là dịch vụ duy nhất có mạng bridge cho lần tải này. Sau đó ứng dụng dùng mạng Docker nội bộ, gắn các mô hình chỉ đọc và chỉ ghi đầu ra. Sự tách biệt này tránh trộn việc tải tài nguyên với xử lý ảnh.
Các kiểm thử đến trước lộ trình được đo
Lệnh unittest phải làm thành công 15 kiểm thử công khai. Chúng kiểm tra đặc biệt việc tạo dữ liệu, tách các mẫu, kết xuất xác định, tính toán thước đo và lỗi ảnh. Chúng cũng bao gồm một lần phát hiện và nhận dạng thực sự trên CUDA.
Điểm cuối này quan trọng: thấy một card trong Docker không chứng minh bộ phát hiện đang sử dụng nó. Kiểm thử kiểm tra thiết bị mà nó đang chạy trên đó. Vì vậy các kiểm tra này có thể đã dùng mô hình; chúng diễn ra trước các lần đọc có bấm giờ của lộ trình chính.
Cuối cùng, prepare ghi 50 PNG và outputs/prepared.json, cùng hash RGB và văn bản tham chiếu gắn với từng ảnh. Ở giai đoạn này, bạn có thể xem các ảnh mà công cụ sẽ phải đọc.
Trong các lệnh Compose, run khởi chạy một tác vụ một lần, --rm xóa container sau khi thực thi và --no-deps tránh tự động khởi chạy các dịch vụ liên quan. Kết quả lưu trong các thư mục được gắn vẫn khả dụng. Các tùy chọn này được trình bày trong tài liệu Docker Compose.
Từ vựng hữu ích trước khi đọc mã
Một hộp, một văn bản và một độ tin cậy
Trong dự án này, EasyOCR dùng CRAFT để định vị các vùng văn bản và bộ nhận dạng latin_g2 để đọc ký tự của chúng. Trình đọc được cấu hình với các ngôn ngữ fr và en. Điều cần nhớ là sự tách biệt vai trò: định vị một vùng chưa phải là đọc được nó.
Với mỗi vùng trả về, chúng ta giữ một hộp xác định bởi bốn điểm, văn bản được nhận dạng và điểm độ tin cậy. Để hình dung cấu trúc này, đây là một đối tượng được tạo ra nhằm mục đích sư phạm. Tọa độ và độ tin cậy của nó không phải các phép đo r3:
{
  "box": [[20.0, 80.0], [330.0, 80.0], [330.0, 110.0], [20.0, 110.0]],
  "text": "Reference REF-000",
  "confidence": 0.98
}
Bốn điểm giới hạn vùng liên quan. Văn bản cho biết công cụ đã đọc gì ở đó. Độ tin cậy là điểm nội bộ: 0.98 không có nghĩa trường nghiệp vụ của bạn có 98 % khả năng đúng.
Để diễn giải điểm này như xác suất chính xác, cần xác minh sự tương ứng đó trên dữ liệu đại diện: đó là vai trò của hiệu chuẩn. Lộ trình r3 không thực hiện công việc này và không xác định ngưỡng tin cậy đảm bảo số tiền chính xác.
CER: đếm lỗi ký tự
CER, viết tắt của character error rate, so sánh văn bản nhận dạng với văn bản mong đợi. Nó dùng khoảng cách Levenshtein: số lần chèn, xóa và thay thế ký tự tối thiểu cần thiết để chuyển từ văn bản này sang văn bản kia.
Minh họa độc lập với kết quả r3: chuyển REF-000 thành REF-00O cần thay số không cuối cùng bằng chữ O. Đó là một thay thế. Tuy nhiên trong tìm kiếm sản phẩm, chỉ ký tự này vẫn có thể khiến không tìm được đúng mã tham chiếu.
CER chia số lỗi cho số ký tự mong đợi. CER bằng không nghĩa là không có khác biệt nào được đếm theo các quy tắc so sánh đã dùng. Những quy tắc này quan trọng: r3 chuẩn hóa văn bản trước khi so sánh, như chúng ta sẽ thấy trong mã.
Báo cáo dùng CER vi mô: cộng lỗi của mọi ảnh kiểm thử rồi chia cho tổng ký tự tham chiếu của chúng. Đây không phải trung bình đơn giản của CER theo ảnh. Văn bản mong đợi dài hơn có trọng số lớn hơn trong tổng.
Kiểm tra trường: hữu ích nhưng có giới hạn
Chương trình kiểm tra riêng liệu REF-xxx và số tiền mong đợi có xuất hiện trong văn bản thô hay không. Đây là tìm kiếm chuỗi con, không phải trình phân tích hóa đơn.
Các kiểm tra này không xác minh vị trí của giá trị trên trang, tiền tệ, định dạng số hay liên kết giữa nhãn và nội dung. Một giá trị có thể xuất hiện ở đâu đó nhưng không phải trường mà ứng dụng cần trích xuất. Hãy ghi nhớ sắc thái này khi đọc các phần trăm.
Tạo ảnh và kiểm tra byte của chúng
Hàm render biến một fixture thành pixel. Nó trả về ảnh, văn bản mong đợi và dấu vết SHA-256 tính trên các byte RGB. Đây là mã của dự án, với định dạng thoáng hơn:
"""Fiches synthétiques déterministes ; annotations indépendantes de l’OCR."""
import hashlib
import numpy as np
from PIL import Image, ImageDraw, ImageFont, ImageEnhance


def render(fixture):
    lines = [
        f'BOUTIQUE {fixture["template"]}',
        f'Reference {fixture["ref"]}',
        f'Total EUR {fixture["amount"]}',
    ]
    image = Image.new("RGB", (620, 240), "white")
    draw = ImageDraw.Draw(image)
    font = ImageFont.truetype("data/DejaVuSans.ttf", 28)

    for index, text in enumerate(lines):
        draw.text(
            (20 + fixture["template"] * 3, 20 + index * 60),
            text,
            font=font,
            fill="black",
        )

    if fixture["variant"] == "rotation":
        image = image.rotate(
            3,
            resample=Image.Resampling.BICUBIC,
            fillcolor="white",
        )

    if fixture["variant"] == "contrast":
        image = ImageEnhance.Contrast(image).enhance(0.4)

    array = np.array(image)

    if fixture["variant"] == "noise":
        noise = np.random.default_rng(42 + fixture["id"]).normal(
            0, 12, array.shape
        )
        array = np.clip(array.astype(float) + noise, 0, 255).astype("uint8")

    return (
        Image.fromarray(array),
        " ".join(lines),
        hashlib.sha256(array.tobytes()).hexdigest(),
    )


def load_image(path):
    with Image.open(path) as image:
        if not 0 < image.width <= 4096 or not 0 < image.height <= 4096:
            raise ValueError("Dimensions image hors plage")
        return np.array(image.convert("RGB"))
Từ JSON đến pixel
Danh sách lines tạo ba dòng từ fixture. Image.new tạo nền trắng 620 × 240 pixel, rồi ImageDraw vẽ văn bản lên đó. Vị trí ngang phụ thuộc vào mẫu; vị trí dọc tăng 60 pixel ở mỗi dòng.
Các điều kiện sau chọn phép biến đổi. Một phiếu rotation được xoay 3 độ; một phiếu contrast nhận hệ số 0,4. Với nhiễu, ảnh trở thành mảng NumPy: khi đó màu pixel là những số mà ta có thể thực hiện thao tác.
np.random.default_rng(42 + fixture["id"]) khởi tạo bộ tạo ngẫu nhiên từ một hạt giống gắn với ảnh. normal(0, 12, array.shape) tạo nhiễu Gaussian theo giao thức. Sau khi thêm nó, np.clip đưa giá trị về trong khoảng 0 đến 255, rồi uint8 biểu diễn chúng dưới dạng số nguyên không dấu trên tám bit.
Điểm quan trọng không phải ghi nhớ từng lời gọi: với fixture giống nhau, chúng ta muốn có lại đúng các pixel trong môi trường cố định. Nếu không, ta có thể quy cho mô hình một chênh lệch thực ra đến từ ảnh khác.
Vì sao tính hash của pixel?
SHA-256 là dấu vết tính từ các byte. Ở đây, array.tobytes() cung cấp byte của pixel, và hexdigest() tạo dấu vết của chúng dưới dạng văn bản. Tài liệu Python về hashlib mô tả các thao tác này.
prepare lưu PNG và dấu vết này trong outputs/prepared.json. Trước mỗi lần gọi OCR, src.cli tải lại PNG dưới dạng RGB và tính lại hash. Nếu dấu vết khác, bước đó thất bại.
Việc kiểm tra áp dụng cho các pixel RGB, không phải toàn bộ byte của tệp PNG. Nó cho phép xác minh nội dung hình ảnh dùng để đo khớp với nội dung đã chuẩn bị. Bản thân nó không phải biện pháp bảo vệ toàn bộ một chuỗi tài liệu khỏi sửa đổi có chủ ý.
load_image thêm một kiểm tra đầu vào: chiều rộng và chiều cao đều phải nằm trong 1 đến 4096 pixel. Ảnh sau đó được chuyển sang RGB. Cũng như với tệp nhận từ biểu mẫu, ta kiểm tra điều sắp xử lý trước khi gửi sang bước tiếp theo; tuy vậy kiểm tra kích thước này không phải chính sách chấp nhận tệp hoàn chỉnh.
Tải EasyOCR và giữ lại điều nó trả về
Ảnh đã sẵn sàng. Việc còn lại là tải các mô hình và đưa pixel cho chúng:
import torch
import easyocr


class Reader:
    def __init__(self):
        if not torch.cuda.is_available():
            raise RuntimeError("GPU CUDA requis")

        torch.set_num_threads(4)
        self.reader = easyocr.Reader(
            ["fr", "en"],
            gpu=True,
            model_storage_directory="/models/ocr",
            user_network_directory="/tmp/networks",
            download_enabled=False,
            verbose=False,
        )

    def read(self, array):
        boxes = self.reader.readtext(array, paragraph=False, workers=0)
        return [
            {
                "box": [[float(x), float(y)] for x, y in box],
                "text": text,
                "confidence": float(confidence),
            }
            for box, text, confidence in boxes
        ]
Đọc hàm khởi tạo như cấu hình dịch vụ
Điều kiện đầu tiên từ chối tiếp tục nếu CUDA không khả dụng. Vì thế chúng ta không âm thầm chuyển sang chế độ tính toán khác.
torch.set_num_threads(4) đặt song song cho các thao tác PyTorch trên CPU; nó không chỉ định bốn GPU. Đó là vai trò được mô tả trong tài liệu PyTorch 2.10.
Trình đọc tải các ngôn ngữ fr và en, bật GPU và dùng trọng số có tại /models/ocr. Với download_enabled=False, nó không thể tải một trọng số còn thiếu trong lúc suy luận. Vì vậy tệp thiếu phải được xử lý khi tải tài nguyên, không bị che bởi một lần tải ngầm giữa phép đo.
Đừng vứt bỏ thông tin giải thích lỗi
Trong read, readtext nhận mảng pixel. paragraph=False tắt việc gom thành đoạn; workers=0 giữ cấu hình tải do dự án dự kiến. Các tham số được mô tả trong tham chiếu API EasyOCR.
Sau đó phương thức của chúng ta biến mọi hộp do readtext trả về thành từ điển, không chọn thêm các kết quả tốt nhất. Tọa độ và độ tin cậy được chuyển thành số Python cho đầu ra JSON. Điều này không có nghĩa công cụ không có bộ lọc nội bộ: chúng ta giữ điều nó trả về, thay vì chọn sau đó chỉ những lần đọc thuận lợi.
Văn bản cuối được tạo bằng cách ghép các đoạn theo thứ tự nhận được. Với ba dòng của chúng ta, thứ tự này là một phần của kết quả đánh giá. Với cột hoặc bảng, nó có thể không đủ: các đoạn được nhận dạng tốt nhưng ghép sai thứ tự không nhất thiết tái tạo tài liệu.
Chạy nhận dạng
docker compose run --rm --no-deps app -m src.cli ocr
Lệnh trước tiên kiểm tra hash RGB của từng ảnh đã chuẩn bị, rồi ghi outputs/ocr.json. Mỗi kết quả giữ các hộp, văn bản nối lại, độ tin cậy, thời lượng và GPU do dự án chỉ ra.
Một lần warm-up, hay lượt làm nóng, được thực hiện trên ảnh 0 trước 50 lần đọc có bấm giờ. Thời gian mỗi ảnh không gồm việc tải mô hình và kết xuất PNG. Toàn bộ lộ trình được đo thì gồm các bước này: chúng ta không nói về cùng một đồng hồ.
Để đọc một đầu ra, hãy đối chiếu PNG, các hộp và văn bản của nó. Một mã tham chiếu vắng trong văn bản có thể do vùng không được trả về, nhận dạng sai hoặc ghép không phù hợp. JSON chi tiết cho phép điều tra; chỉ điểm tổng thể thì không cho biết cần xem ở đâu.
Đọc các chỉ số trước khi xem kết quả
Bây giờ chúng ta có hai đối tượng: văn bản mong đợi và văn bản nhận dạng. Trước khi so sánh điểm số của chúng, cần nêu rõ chương trình xem điều gì là khác biệt.
Một phép chuẩn hóa làm thay đổi so sánh
Hàm normalize áp dụng NFKC, chuyển thành chữ thường, lấy các nhóm ký tự \w+, rồi nối chúng bằng một khoảng trắng.
NFKC là phép chuẩn hóa Unicode hài hòa một số biểu diễn tương đương hoặc tương thích của ký tự. Nó không sửa lỗi OCR. Mẫu \w giữ ký tự chữ-số Unicode cùng dấu gạch dưới _; dấu gạch nối -, dấu chấm và dấu phẩy không thuộc mẫu đó. Các hành vi này được Python ghi lại cho unicodedata và re.
Đây là các ví dụ sư phạm về kết quả của hàm này, không phải đầu ra OCR đã thu:
Reference REF-000  →  reference ref 000
Total EUR 10.00    →  total eur 10 00
Total EUR 10,00    →  total eur 10 00
Dấu chấm và dấu phẩy biến mất như các ký hiệu phân biệt, nhưng các nhóm vẫn được tách bằng khoảng trắng. Nói rằng dấu câu « không còn được tính » không có nghĩa mọi khác biệt về phân tách đều vô hình: 10.00 trở thành 10 00, trong khi 1000 vẫn là 1000.
CER r3 đánh giá văn bản đã chuẩn hóa này, không phải bản sao từng ký tự của văn bản thô. Trong ví dụ trên, dấu chấm và dấu phẩy thập phân cho cùng chuỗi chuẩn hóa. Ngược lại, các kiểm tra trường vẫn xét văn bản thô.
Phép tính, không phải hộp đen
"""Normalisation déclarée et distance de Levenshtein par programmation dynamique."""
import re
import unicodedata


def normalize(text):
    return " ".join(re.findall(r"\w+", unicodedata.normalize("NFKC", text).lower()))


def distance(reference, hypothesis):
    row = list(range(len(hypothesis) + 1))
    for i, expected in enumerate(reference, 1):
        following = [i]
        for j, actual in enumerate(hypothesis, 1):
            following.append(
                min(
                    following[-1] + 1,
                    row[j] + 1,
                    row[j - 1] + (expected != actual),
                )
            )
        row = following
    return row[-1]


def evaluate(rows):
    test = [row for row in rows if row["split"] == "test"]
    errors = sum(
        distance(normalize(row["reference"]), normalize(row["text"]))
        for row in test
    )
    characters = sum(len(normalize(row["reference"])) for row in test)

    if not characters:
        raise ValueError("Références vides")

    return {
        "evaluated": len(test),
        "character_errors": errors,
        "reference_characters": characters,
        "cer": errors / characters,
        "reference_exact": sum(row["ref"] in row["text"] for row in test) / len(test),
        "amount_exact": sum(row["amount"] in row["text"] for row in test) / len(test),
        "mean_ocr_ms": 1000 * sum(row["seconds"] for row in test) / len(test),
    }
distance tính dần số thay đổi tối thiểu giữa hai chuỗi. Với mỗi cặp ký tự, nó giữ lựa chọn ít tốn kém nhất giữa chèn, xóa hoặc thay thế. Nếu hai ký tự bằng nhau, chi phí thay thế bằng không; nếu không, bằng một.
Đó là quy hoạch động: phép tính tái sử dụng kết quả trung gian thay vì bắt đầu lại mỗi so sánh từ đầu. row giữ hàng trước của phép tính này, following tạo hàng kế tiếp. Bạn không cần tự cài lại thuật toán để diễn giải điểm, nhưng ở đây bạn có thể thấy lỗi được đếm như thế nào.
Các giá trị của evaluate, từng giá trị một
Dòng đầu của evaluate chỉ giữ các mục có split bằng test, tức split == "test". 50 ảnh đều được đọc, nhưng điểm số và mean_ocr_ms của báo cáo này chỉ liên quan đến 40 ảnh kiểm thử.
character_errors cộng khoảng cách giữa các văn bản đã chuẩn hóa. reference_characters cộng độ dài của các văn bản mong đợi đã chuẩn hóa. Thương số cho cer. Kiểm tra Références vides ngăn tính tỷ lệ khi không có ký tự tham chiếu.
Hãy chú ý tên: row["reference"] là toàn bộ văn bản mong đợi, còn row["ref"] là mã tham chiếu nghiệp vụ, chẳng hạn REF-000. Vì vậy CER áp dụng cho ba dòng của tài liệu, không chỉ mã sản phẩm.
reference_exact đo tỷ lệ ảnh trong đó mã tham chiếu mong đợi xuất hiện trong văn bản thô. amount_exact tìm tương tự với số tiền. Cuối cùng, mean_ocr_ms đổi giây sang mili giây và tính trung bình trên các mục kiểm thử.
Cái bẫy nhỏ của từ « chính xác »
Tên amount_exact có thể tạo cảm giác chúng ta xác thực một trường đã trích xuất. Tuy nhiên hãy nhìn biểu thức: row["amount"] in row["text"]. Nó chỉ hỏi « chuỗi ký tự chính xác này có xuất hiện ở đâu đó không? »
Hãy lấy phản ví dụ sư phạm, không phải lỗi quan sát trong r3: chuỗi 10.00 cũng nằm trong 110.00. Vì thế tìm kiếm này có thể thành công dù toàn bộ số tiền khác. Ngược lại, 10,00 không chứa 10.00, kể cả khi một ứng dụng dự kiến xem hai cách viết là cùng một số.
Các ví dụ này không thay đổi mã hay kết quả của hướng dẫn. Chúng giải thích vì sao ta nói về sự hiện diện của số tiền, chứ không phải « trích xuất số tiền đúng 100 % ».
CER thấp cũng không đảm bảo mọi lỗi đều không có hậu quả. Một chữ cái có thể làm hỏng mã tham chiếu; một chữ số có thể thay đổi giá trị quan trọng. Vì vậy cũng cần đọc văn bản, các hộp và trường mong đợi cho các trường hợp quan trọng.
Kiểm tra đầu vào đặc biệt, rồi tính báo cáo
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
negatives kiểm tra hành vi trên ảnh trắng và tệp không hợp lệ. Ý tưởng giống kiểm thử API với nội dung rỗng hay tệp có định dạng sai: không chỉ giới hạn ở đầu vào diễn ra tốt.
Sau đó evaluate ghi outputs/evaluation.json, với CER, kiểm tra mã tham chiếu và số tiền, cùng thời lượng OCR trung bình. Các giá trị này phải được đọc theo định nghĩa của chúng, không phải như một điểm chung cho công cụ.
Kết quả r3 và giới hạn trong cách diễn giải
Điều hai lần tái tạo thực sự đã đo
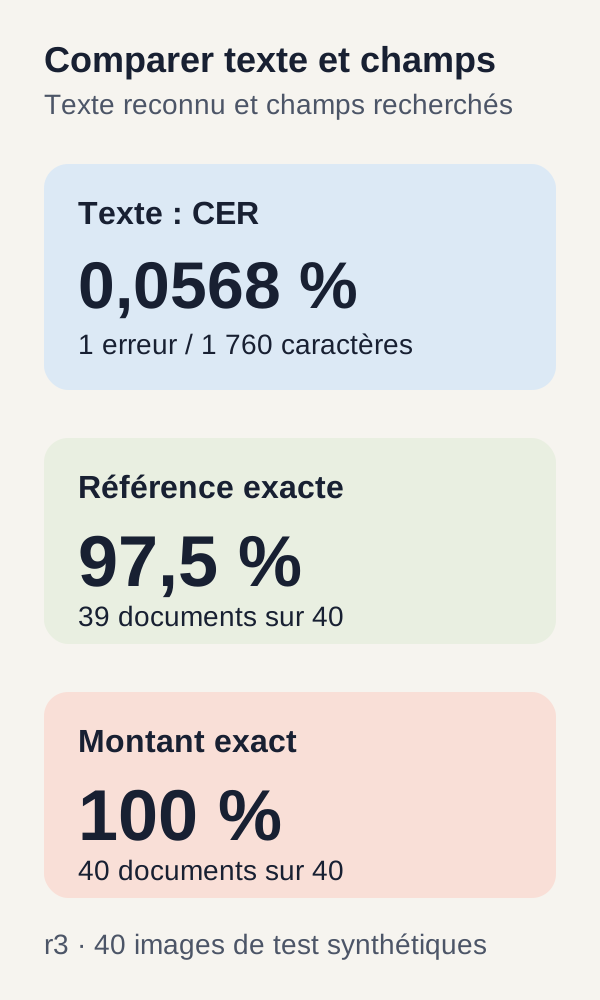
Hai lần tái tạo đã đánh giá cùng 40 ảnh kiểm thử. Chúng tìm thấy một lỗi trên 1 760 ký tự tham chiếu đã chuẩn hóa. Kết quả được báo cáo như sau:
| Phép đo | Lần tái tạo thứ nhất | Lần tái tạo thứ hai |
|---|---|---|
| Ảnh kiểm thử đã đánh giá | 40 | 40 |
| Lỗi ký tự | 1 | 1 |
| Ký tự tham chiếu | 1 760 | 1 760 |
| CER vi mô | 0,0005681818181818182 |
0,0005681818181818182 |
| CER theo phần trăm | Khoảng 0,0568 % | Khoảng 0,0568 % |
| Mã tham chiếu có mặt trong văn bản thô | 97,5 % | 97,5 % |
| Số tiền có mặt trong văn bản thô | 100 % | 100 % |
| Độ trễ OCR trung bình trên kiểm thử | 30,35 ms | 31,33 ms |
| VRAM tối đa được lấy mẫu | 600 MiB | 564 MiB |
| Thời lượng toàn bộ lộ trình, gồm tải tài nguyên | 87,04 s | 49,65 s |
Phép tính CER đọc đơn giản: 1 ÷ 1 760 = 0,0005681818181818182, tức khoảng 0,0568 % sau khi nhân với 100.
Trên 40 ảnh, 97,5 % tương ứng với 39 ảnh có mã tham chiếu mong đợi hiện diện. Đó là cách đọc khác của cùng phép đo, không phải kiểm thử bổ sung. Tương tự, số tiền có mặt trong 40 ảnh theo kiểm tra chuỗi con. Điều này không xác thực một trình phân tích hóa đơn.
Hai lần tái tạo cho thấy lộ trình được lặp lại trên bộ này. Chúng không phải hai bộ tài liệu độc lập: 40 ảnh kiểm thử là như nhau.
Đọc đúng các phép đo thời gian và bộ nhớ
Độ trễ ở đây là thời lượng của một lần đọc OCR, với các phần loại trừ đã mô tả ở trên. Thời lượng toàn lộ trình bao gồm nhiều công việc hơn, nhất là tải tài nguyên. Bản dựng thứ hai tái dùng các lớp Docker công khai: vì vậy 87,04 s và 49,65 s không phải hai lần cài đặt hoàn toàn không có bộ nhớ đệm.
VRAM là bộ nhớ của card đồ họa. Các mức tối đa 600 MiB và 564 MiB đến từ việc lấy mẫu khoảng một lần mỗi giây trên RTX 3090 đã dùng. Một đỉnh giữa hai lần đo có thể không được thấy. Các giá trị này không phải đỉnh thực tế được đảm bảo, cũng không phải cấu hình card tối thiểu.
Các số liệu này không đo lưu lượng đã nén, dung lượng Docker độc quyền sau khử trùng lặp, hay hành vi khi có tải. Chúng cũng không cho phép hứa hẹn cùng độ trễ cho nhiều người dùng đồng thời hoặc cho tài liệu lớn hơn.
Xoay có « làm giảm chất lượng » không?
16 ảnh sạch của kiểm thử cho CER 0. Các nhóm xoay, nhiễu và tương phản đều chứa 8 ảnh. Nhóm xoay có một lỗi, CER 0,002840909090909091 và mã tham chiếu hiện diện trong 87,5 % trường hợp. Số tiền vẫn hiện diện trong mọi nhóm.
Ta có thể muốn kết luận: « xoay giải thích lỗi ». Nhưng mã tham chiếu thay đổi từ nhóm này sang nhóm khác. Chúng ta không so sánh chính xác cùng một tài liệu trước và sau khi xoay.
Các nhóm này không được ghép cặp: khác biệt của chúng không chỉ liên quan tới biến đổi ảnh. Kết luận vẫn mang tính mô tả — một lỗi được quan sát trong nhóm xoay của bộ này — chứ không phải nhân quả. Muốn cô lập tác động của xoay, cần một giao thức khác, được mô tả trong bài tập.
Điều chúng ta đã học
Chúng ta đã xây dựng một chuỗi hoàn chỉnh ở quy mô nhỏ: xác định nội dung mong đợi, tạo ảnh, kiểm tra đầu vào, định vị văn bản, nhận dạng ký tự và tính các chỉ số mà ta có thể đọc mã.
Với lập trình viên web mới làm quen với AI, thay đổi chính nằm ở đây: đầu ra của mô hình cần được quan sát và đánh giá, không chỉ được dùng vì nó có hình thức phù hợp. JSON giúp tích hợp dễ hơn; nó không bảo đảm nội dung đúng.
CER mô tả một phần chênh lệch văn bản. Kiểm tra mã tham chiếu và số tiền đặt ra các câu hỏi khác, nhưng vẫn là tìm kiếm sự hiện diện. Không yếu tố nào trong số này một mình thay thế xác thực nghiệp vụ.
Hai lần tái tạo r3 xác thực lộ trình cục bộ này trên 50 ảnh tổng hợp, trong đó 40 ảnh kiểm thử. Chúng không xác thực một trình phân tích hóa đơn hay hiệu năng phổ quát trên tài liệu thực. Chính phạm vi hạn chế này giúp ta hiểu điều đang đo trước khi làm dự án phức tạp hơn.
Bài tập: dự đoán, sửa đổi, chạy, quan sát, giải thích
Trước hết, hãy đưa ra dự đoán
Trước khi chạy lệnh, hãy xem lại cách phân chia dữ liệu. Với tám mẫu kiểm thử, hai ảnh sạch mỗi mẫu và một ảnh của mỗi biến thể khác, bạn mong đợi bao nhiêu kết quả trong từng nhóm?
Câu hỏi thứ hai: nếu nhóm xoay có nhiều lỗi hơn, bạn đã chứng minh xoay là nguyên nhân chưa? Hãy viết câu trả lời trước khi đọc đầu ra.
Chạy, rồi quan sát
docker compose run --rm --no-deps app -m src.cli exercise
Hãy so sánh dự đoán của bạn với các chỉ số theo nhóm. clean có 16 ảnh; rotation, noise và contrast có 8 ảnh mỗi nhóm. Hãy giải thích cách đếm này từ các mẫu, thay vì học thuộc nó.
Lệnh exercise không sửa mô hình và không chạy huấn luyện mới. Nó nhóm các đầu ra đã có. Phần « sửa đổi » của bài tập nằm trong thí nghiệm tách riêng được đề xuất bên dưới, không nằm trong lệnh này.
Kết luận mong đợi là các nhóm mô tả dữ liệu đã cung cấp. Không phải xoay gây ra sự giảm chất lượng phổ quát.
Để kiểm tra một nguyên nhân, hãy thay đổi giao thức trong một bản sao
Một so sánh ghép cặp sẽ là kết xuất chính xác cùng văn bản trong một ảnh sạch và một ảnh xoay. Hai ảnh sẽ tạo thành một cặp. Khi đó bạn có thể so sánh lỗi của chúng trong khi giữ nguyên mã tham chiếu, số tiền và các tham số khác.
Hãy làm việc trong một thư mục riêng và chỉ thay đổi một yếu tố mỗi lần. Dự kiến việc tạo ảnh mới, đưa chúng qua OCR và các phép đo mới. Chỉ sửa cách nhóm đầu ra cũ không tạo ra các cặp này.
Đề xuất này chưa được thực hiện trong r3. Nó là một thí nghiệm mới, không có kết quả được báo trước. Giá trị của nó là học cách đặt một câu hỏi mà dữ liệu thực sự cho phép trả lời.
Thí nghiệm riêng của bạn, không có kết quả được báo trước
Để thử tài liệu của riêng mình, hãy tạo một thư mục làm việc riêng và giữ kho lưu trữ r3 không thay đổi. Nhờ vậy bạn giữ một điểm so sánh mà nội dung và hành vi mong đợi đã biết.
Trước khi chạy OCR, hãy mô tả loại tài liệu, chất lượng số hóa, ngôn ngữ, hướng và các quy tắc sự thật nền. Cũng hãy nêu chi phí của một lỗi: một mã tham chiếu không tìm thấy và một số tiền sai không nhất thiết có cùng hậu quả trong ứng dụng của bạn.
Hãy chọn các chỉ số trước khi xem kết quả. Bạn có thể đo lỗi mã tham chiếu, lỗi số tiền, tỷ lệ từ chối và kết quả rà soát của con người. Khi đó từ chối là một tài liệu mà ứng dụng của bạn không xử lý tự động theo một quy tắc cần xác định; cơ chế này không được cung cấp bởi phép tính CER đơn thuần.
Bản quét, bảng biểu, cột, logo, chữ viết tay và ảnh xuống cấp làm thay đổi vấn đề. Vì vậy đừng công bố điểm nào trước khi đo. Nếu thêm một trình phân tích số tiền hoặc ngưỡng tin cậy, hãy đánh giá bước mới này riêng: độ tin cậy EasyOCR ở đây không được hiệu chuẩn như xác suất đúng của nghiệp vụ.
Khắc phục sự cố hữu ích
nvidia-smi absent (không có nvidia-smi). Hãy cài hoặc sửa trình điều khiển NVIDIA, rồi chạy lại preflight. Khi kiểm tra này còn thất bại, hãy tiếp tục chẩn đoán môi trường thay vì chẩn đoán ảnh.
GPU được phát hiện trên Linux nhưng không có trong Docker. Hãy cấu hình NVIDIA Container Toolkit và kiểm tra GPU_DEVICE chỉ đúng card mong đợi. Việc phần cứng hiển thị trên máy chủ và được đưa vào container là hai kiểm tra riêng biệt.
fetch thất bại. Hãy kiểm tra mạng và hash. Đừng bỏ qua kiểm tra kích thước hoặc SHA-256 để làm lỗi biến mất: bạn sẽ mất liên kết với tài nguyên của lộ trình đã xác thực.
GPU CUDA requis (cần GPU CUDA). Kiểm tra trình điều khiển, việc đưa GPU vào Docker và GPU_DEVICE, rồi tiếp tục sau khi tải tài nguyên hoàn chỉnh. Mã cố ý từ chối tiếp tục khi không có CUDA.
Image modifiée depuis prepare (ảnh đã bị sửa từ bước prepare). Chạy lại prepare trước ocr. Đừng sửa PNG giữa các bước này trong lần tái tạo tham chiếu: kiểm tra dùng chính để phát hiện khác biệt giữa ảnh đã chuẩn bị và ảnh đã đo.
Hộp hoặc thứ tự đọc không như mong đợi. Mở outputs/ocr.json và PNG tương ứng. Văn bản nối theo thứ tự do công cụ trả về; nó không tự giải quyết tài liệu có cột. Hãy bắt đầu bằng việc xác định vấn đề đến từ vùng trả về, ký tự được nhận dạng hay cách ghép văn bản.
Những điều còn thiếu trước khi đưa vào xử lý tài liệu thực tế
Trong một ứng dụng thực, OCR sẽ là một thành phần của xử lý rộng hơn. Chuỗi cần xử lý các định dạng thực sự nhận được, hướng, căn thẳng ảnh, chất lượng quét, bố cục, bảng, ngôn ngữ và chữ viết tay cần thiết cho lĩnh vực của bạn.
Bước tiếp theo là liên kết trường một cách tin cậy: xác định giá trị nào ứng với nhãn nào, xác thực quy tắc số và tiền tệ, hiệu chuẩn việc từ chối và dự kiến rà soát của con người khi chi phí lỗi đòi hỏi. Đọc hai số tiền trong cùng một ảnh không đủ để biết số nào phải điền vào trường « tổng » của ứng dụng.
Vẫn còn mọi công việc quen thuộc của một ứng dụng web: tiếp nhận an toàn, xác thực, quyền đối với tài liệu, hạn ngạch, lưu trữ, quy tắc lưu giữ, giám sát, sao lưu và phục hồi. Các phép đo tải và đồng thời phải áp dụng cho dịch vụ hoàn chỉnh, không chỉ một lần đọc OCR riêng lẻ.
Cuối cùng, đánh giá phải dùng tài liệu đại diện, được phân chia theo các trường hợp quan trọng: loại tài liệu, ngôn ngữ, chất lượng quét hoặc khó khăn về bố cục. Đó là ý nghĩa của đánh giá phân tầng. 40 ảnh kiểm thử tổng hợp không thay thế điều đó.
Dọn dẹp chính xác
Khi kết thúc lộ trình, hãy chạy lệnh này từ thư mục gốc của kho lưu trữ:
docker compose down
Lệnh này thuộc lộ trình r3 đã xác thực. Nó dừng tài nguyên Compose của dự án và xóa các container cùng mạng liên quan, mà không xóa mô hình, ảnh Docker hay đầu ra. Hành vi dọn dẹp mặc định được mô tả trong tài liệu docker compose down.
Hãy giữ JSON và PNG khi bạn còn cần đọc lại kết quả. Chỉ xóa các thử nghiệm riêng sau khi đã kiểm tra nội dung của chúng. Không cần dọn sạch Docker toàn cục để hoàn thành hướng dẫn này.