





Immaginate un modulo nella vostra applicazione: l'utente carica l'immagine di un documento e vorreste precompilare un riferimento e un importo. Per il vostro codice applicativo, sono due stringhe da verificare. Ma nel file inviato queste informazioni sono ancora soltanto pixel. Come passare dall'uno all'altro?
Questo è il compito dell'OCR, il riconoscimento ottico dei caratteri. Costruiremo una piccola pipeline locale con Python, Docker ed EasyOCR, poi osserveremo ciò che legge davvero. Non soltanto un testo che sembra corretto sullo schermo: conserveremo anche le zone individuate, i punteggi del motore e gli errori misurati.
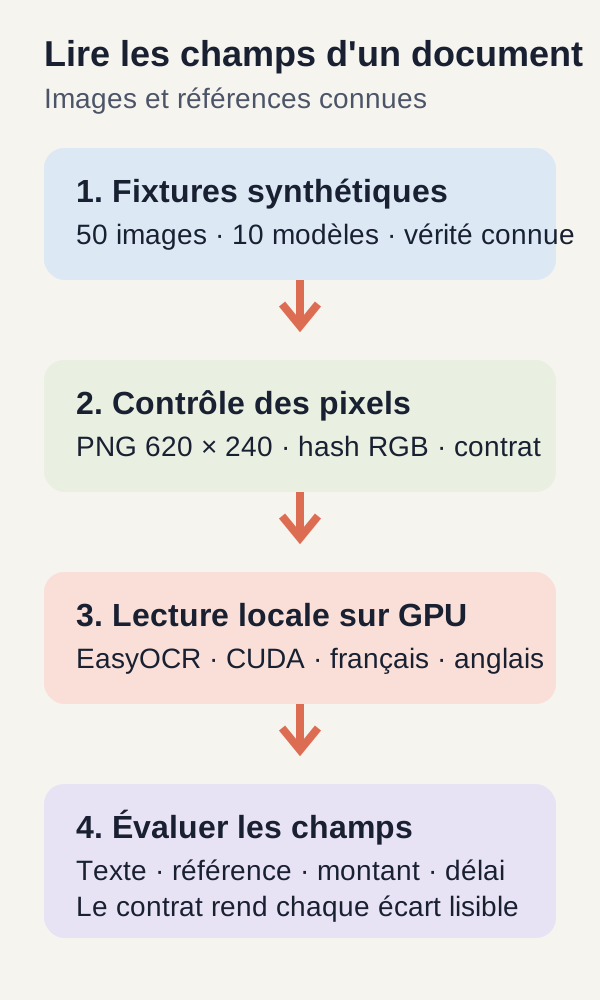
Per iniziare senza manipolare documenti privati, il progetto produce 50 immagini sintetiche di cui conosciamo già il contenuto. Le legge su una GPU CUDA, poi calcola il risultato su 40 immagini riservate al test. Questa distinzione tra ciò che ci aspettiamo e ciò che il modello produce sarà il filo conduttore.
Scaricare il progetto completo del tutorial.
I risultati presentati provengono da due riproduzioni convalidate di questo archivio r3, in directory nuove. Gli esempi aggiunti per spiegare un concetto sono indicati come tali: non sostituiscono gli output misurati del progetto.
Il problema e il risultato atteso
Leggere un testo non significa ancora capire un documento
Un OCR, dall'inglese optical character recognition, risponde a due domande successive: dove c'è del testo nell'immagine?, poi quali caratteri si trovano in quelle zone?
La prima fase è il rilevamento. La seconda è il riconoscimento. Il testo finale può poi essere composto riunendo i frammenti ottenuti. Questa separazione si ritrova nell'API di EasyOCR, con le operazioni di rilevamento e riconoscimento.
Prendiamo una situazione esemplificativa: nell'immagine vedete «Total EUR 10.00». Per la vostra applicazione restano diverse domande. Il motore ha letto tutte le cifre? Ha conservato il separatore decimale? Questo importo è il totale, un subtotale o un altro valore presente nel documento?
Riconoscere i caratteri ed estrarre un campo applicativo sono quindi due fasi diverse. Il nostro tutorial costruisce e valuta la prima pipeline; i suoi controlli sul riferimento e sull'importo restano volutamente semplici.
I file che otterrete
Alla fine del percorso, outputs/images/ conterrà i 50 PNG. outputs/prepared.json collegherà le immagini al testo atteso e alla relativa impronta di controllo. outputs/ocr.json conserverà, per ogni immagine, i riquadri di testo, i testi riconosciuti, le confidenze e i tempi misurati. Infine, outputs/evaluation.json conterrà il resoconto delle sole 40 immagini di test.
Per uno sviluppatore web, pensate a un test di integrazione: preparate dati noti, fate passare un input nel sistema, poi confrontate la risposta con ciò che era atteso. Qui l'input non è un modulo JSON ma un'immagine, e il risultato può contenere errori di lettura.
Prerequisiti GPU, Docker e risorse
Il percorso r3 è stato convalidato su Linux amd64, cioè l'architettura x86_64, con Docker Engine, Docker Compose, un driver NVIDIA, nvidia-smi e NVIDIA Container Toolkit. Le misurazioni di questo articolo sono state effettuate su una RTX 3090.
La GPU è la scheda usata per accelerare i calcoli del modello. CUDA è l'ambiente di calcolo NVIDIA impiegato in questo progetto. NVIDIA Container Toolkit permette di rendere questo accesso disponibile da Docker; una scheda visibile su Linux non è necessariamente visibile in un container. L'installazione è descritta nella guida ufficiale NVIDIA.
Questo percorso di inferenza usa esclusivamente CUDA. Non offre un ripiego CPU convalidato. Nel file .env fornito, definite GPU_DEVICE prima dell'avvio se dovete esporre una scheda diversa dalla scheda 0.
Il preflight, cioè il controllo preliminare, richiede 20 GiB liberi sul disco del progetto e nello spazio di archiviazione Docker, oltre a 12 GiB di RAM disponibile. Il container dell'applicazione è invece limitato a 8 GiB di memoria, 4 CPU e 256 processi. GiB e MiB sono unità binarie di capacità della memoria o del disco.
Non confondete questi valori: le soglie del preflight riguardano le risorse disponibili sull'host; il limite del container limita ciò che l'applicazione può usare. La RAM è la memoria principale della macchina, non la VRAM della scheda grafica.
Dopo aver estratto lo ZIP, dalla radice del progetto, iniziate con:
./scripts/preflight.sh
Questo script verifica Linux, Docker, Compose, la scheda scelta, l'inizializzazione di CUDA da Docker, la RAM e lo spazio su disco. Non configura il sistema al posto vostro. Se rileva la GPU sull'host ma non in Docker, configurate NVIDIA Container Toolkit, quindi rieseguite il controllo.
Queste verifiche definiscono le condizioni del percorso. Non garantiscono né la compatibilità con ogni scheda CUDA né tempi identici su tutte le macchine.
I dati prima dell'OCR
Perché generare noi stessi i documenti?
Prima di misurare una lettura, ci serve una risposta di riferimento. Nel machine learning si parla spesso di verità di base: l'informazione considerata corretta, alla quale confrontiamo l'output del modello.
Il file data/fixtures.json contiene 50 schede sintetiche. Una fixture è semplicemente un insieme di dati preparato per un test, come quelli che usate per popolare un database di sviluppo. Ecco la prima scheda del progetto:
{
  "id": 0,
  "template": 0,
  "split": "dev",
  "variant": "clean",
  "ref": "REF-000",
  "amount": "10.00"
}
id identifica l'immagine. template indica il suo modello. split segnala l'insieme a cui appartiene, qui quello di sviluppo. variant sceglie l'aspetto dell'immagine. Infine, ref e amount forniscono i valori attesi prima di ogni riconoscimento.
src/images.py trasforma questa scheda in tre righe:
BOUTIQUE 0
Reference REF-000
Total EUR 10.00
Non si tratta qui di un output OCR, ma del testo disegnato dal generatore. Conosciamo quindi la risposta senza chiederla al motore che vogliamo valutare. L'OCR riceve i pixel; il riferimento resta disponibile per il confronto successivo.
Variazioni controllate, non vere fatture
Ogni immagine RGB misura 620 × 240 pixel e usa il carattere DejaVu Sans a 28 pixel. RGB significa che ogni pixel è rappresentato dalle sue componenti rossa, verde e blu.
Il generatore applica una delle quattro varianti: immagine pulita, rotazione di 3 gradi, contrasto impostato a 0,4 o rumore gaussiano con deviazione standard 12. Il rumore aggiunge variazioni ai valori dei pixel. Il suo seme, 42 + id, consente di riprodurre lo stesso rumore per una determinata scheda nell'ambiente fissato.
La parola modello non indica dieci layout realistici di fatture. Nel codice presentato più avanti, il numero modifica in particolare la riga «BOUTIQUE» e lo spostamento orizzontale del testo. Tutte le immagini rimangono semplici schede di tre righe.
Perché separare sviluppo e test?
I dieci modelli sono suddivisi in due insiemi senza sovrapposizioni: due modelli per lo sviluppo, cioè 10 immagini, e otto per il test, cioè 40 immagini. Uno stesso modello non appartiene a entrambi gli insiemi.
L'idea è distinguere gli esempi che servono a mettere a punto il percorso da quelli che servono a misurarne il risultato. Ciò non significa che addestriamo EasyOCR sulle dieci immagini di sviluppo: qui usiamo modelli già addestrati, senza modificarne i pesi.
Fate attenzione anche alla dimensione dei gruppi di test:
| Variante | Immagini per modello di test | Totale sugli 8 modelli di test |
|---|---|---|
clean: immagine pulita |
2 | 16 |
rotation: rotazione di 3 gradi |
1 | 8 |
noise: rumore gaussiano |
1 | 8 |
contrast: contrasto a 0,4 |
1 | 8 |
| Totale | 5 | 40 |
Le annotazioni e le immagini sono interamente sintetiche: non viene esposto alcun documento privato. In compenso, questo insieme non rappresenta né fatture digitalizzate, né layout complessi, né scrittura a mano. La separazione dei modelli non elimina questo limite.
Installare, acquisire e preparare le immagini
Estraete l'archivio e posizionatevi nella sua radice. I comandi seguenti vanno eseguiti da questa directory, nell'ordine indicato. Corrispondono all'inizio di ciascuna delle due riproduzioni r3; il controllo preliminare viene ripetuto per presentare il percorso completo:
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app -m src.cli prepare
Che cosa fa ogni passaggio?
setup.sh prepara le directory con l'identità dell'utente corrente. docker compose build costruisce l'immagine Python 3.12.13 fissata dal progetto. Le dipendenze includono PyTorch 2.10.0+cu129, torchvision 0.25.0+cu129 ed EasyOCR 1.7.2.
PyTorch fornisce il motore di calcolo usato da EasyOCR; torchvision fa parte dello stack installato per l'elaborazione delle immagini. Le versioni qui sopra sono quelle del percorso convalidato, non un invito a sostituirle con le ultime disponibili. L'immagine Python è documentata su Docker Hub, mentre i pacchetti PyTorch CUDA interessati sono pubblicati nell'indice cu129.
Il servizio fetch acquisisce le risorse pubbliche. Recupera in particolare i pesi EasyOCR craft_mlt_25k e latin_g2 dalle release ufficiali di JaidedAI. I pesi sono i parametri numerici appresi dai modelli prima di questo tutorial. Caricarli consente di fare un'inferenza: applicare un modello già addestrato a una nuova immagine.
Il progetto controlla la dimensione e lo SHA-256 degli archivi e dei pesi estratti. Questa impronta permette di verificare che i file corrispondano a quelli attesi. La prima acquisizione convalidata rappresenta 91 536 692 byte.
fetch è l'unico servizio dotato di una rete bridge per questa acquisizione. L'applicazione usa poi una rete Docker interna, monta i modelli in sola lettura e scrive soltanto gli output. Questa separazione evita di mescolare il download delle risorse e l'elaborazione delle immagini.
I test precedono il percorso misurato
Il comando unittest deve superare i 15 test pubblici. Questi verificano in particolare la popolazione dei dati, la separazione dei modelli, il rendering deterministico, il calcolo della metrica e gli errori di immagine. Comprendono anche un vero rilevamento e riconoscimento su CUDA.
Quest'ultimo punto è importante: vedere una scheda in Docker non prova che il rilevatore la utilizzi. Il test ispeziona il dispositivo su cui si trova. Queste verifiche possono quindi già sollecitare il modello; precedono le letture cronometrate del percorso principale.
Infine, prepare scrive i 50 PNG e outputs/prepared.json, con l'hash RGB e il testo di riferimento associati a ogni immagine. A questo punto potete osservare le immagini che il motore dovrà leggere.
Nei comandi Compose, run avvia un'attività occasionale, --rm rimuove il suo container dopo l'esecuzione e --no-deps evita di avviare automaticamente i servizi collegati. I risultati registrati nelle directory montate restano disponibili. Queste opzioni sono illustrate nella documentazione di Docker Compose.
Vocabolario utile prima di leggere il codice
Un riquadro, un testo e una confidenza
In questo progetto, EasyOCR usa CRAFT per localizzare le regioni di testo e il riconoscitore latin_g2 per leggerne i caratteri. Il lettore è configurato con le lingue fr e en. Ricordate soprattutto la separazione dei ruoli: localizzare una zona non significa ancora riuscire a leggerla.
Per ogni zona restituita, conserviamo un riquadro definito da quattro punti, il testo riconosciuto e un punteggio di confidenza. Per visualizzare questa struttura, ecco un oggetto inventato a scopo didattico. Le sue coordinate e la sua confidenza non sono misure r3:
{
  "box": [[20.0, 80.0], [330.0, 80.0], [330.0, 110.0], [20.0, 110.0]],
  "text": "Reference REF-000",
  "confidence": 0.98
}
I quattro punti delimitano la regione interessata. Il testo indica ciò che il motore vi ha letto. La confidenza è un punteggio interno: 0.98 non significa che il vostro campo applicativo abbia il 98% di probabilità di essere corretto.
Per interpretare questo punteggio come una probabilità di correttezza, bisognerebbe verificare tale corrispondenza su dati rappresentativi: questo è il ruolo di una calibrazione. Il percorso r3 non svolge questo lavoro e non definisce una soglia di confidenza che garantisca la correttezza di un importo.
Il CER: contare gli errori di carattere
Il CER, dall'inglese character error rate, confronta il testo riconosciuto con il testo atteso. Usa la distanza di Levenshtein: il numero minimo di inserimenti, eliminazioni e sostituzioni di caratteri necessari per passare da un testo all'altro.
Illustrazione indipendente dai risultati r3: passare da REF-000 a REF-00O richiede di sostituire l'ultimo zero con la lettera O. Si tratta di una sostituzione. Eppure, in una ricerca di prodotti, questo solo carattere può impedire di ritrovare il riferimento corretto.
Il CER divide il numero di errori per il numero di caratteri attesi. Un CER pari a zero significa che non è stata conteggiata alcuna differenza secondo le regole di confronto usate. Queste regole sono importanti: r3 normalizza i testi prima di confrontarli, come vedremo nel codice.
Il resoconto usa un CER micro: somma gli errori di tutte le immagini di test, poi divide per il totale dei loro caratteri di riferimento. Non è una semplice media dei CER per immagine. Un testo atteso più lungo pesa di più nel totale.
I controlli dei campi: utili, ma limitati
Il programma verifica separatamente se REF-xxx e l'importo atteso sono presenti nel testo grezzo. Si tratta di ricerche per sottostringa, non di un parser di fatture.
Questi controlli non verificano la posizione di un valore nella pagina, la valuta, il formato numerico o l'associazione tra un'etichetta e il suo contenuto. Un valore può essere presente da qualche parte senza essere il campo che l'applicazione doveva estrarre. Tenete presente questa distinzione quando leggeremo le percentuali.
Generare le immagini e verificare i loro byte
La funzione render trasforma una fixture in pixel. Restituisce l'immagine, il testo atteso e un'impronta SHA-256 calcolata sui byte RGB. Ecco il codice del progetto, con una formattazione più ariosa:
"""Fiches synthétiques déterministes ; annotations indépendantes de l’OCR."""
import hashlib
import numpy as np
from PIL import Image, ImageDraw, ImageFont, ImageEnhance


def render(fixture):
    lines = [
        f'BOUTIQUE {fixture["template"]}',
        f'Reference {fixture["ref"]}',
        f'Total EUR {fixture["amount"]}',
    ]
    image = Image.new("RGB", (620, 240), "white")
    draw = ImageDraw.Draw(image)
    font = ImageFont.truetype("data/DejaVuSans.ttf", 28)

    for index, text in enumerate(lines):
        draw.text(
            (20 + fixture["template"] * 3, 20 + index * 60),
            text,
            font=font,
            fill="black",
        )

    if fixture["variant"] == "rotation":
        image = image.rotate(
            3,
            resample=Image.Resampling.BICUBIC,
            fillcolor="white",
        )

    if fixture["variant"] == "contrast":
        image = ImageEnhance.Contrast(image).enhance(0.4)

    array = np.array(image)

    if fixture["variant"] == "noise":
        noise = np.random.default_rng(42 + fixture["id"]).normal(
            0, 12, array.shape
        )
        array = np.clip(array.astype(float) + noise, 0, 255).astype("uint8")

    return (
        Image.fromarray(array),
        " ".join(lines),
        hashlib.sha256(array.tobytes()).hexdigest(),
    )


def load_image(path):
    with Image.open(path) as image:
        if not 0 < image.width <= 4096 or not 0 < image.height <= 4096:
            raise ValueError("Dimensions image hors plage")
        return np.array(image.convert("RGB"))
Dal JSON ai pixel
L'elenco lines costruisce le tre righe a partire dalla fixture. Image.new crea uno sfondo bianco di 620 × 240 pixel, poi ImageDraw vi disegna il testo. La posizione orizzontale dipende dal modello; quella verticale aumenta di 60 pixel a ogni riga.
Le condizioni successive scelgono la trasformazione. Una scheda rotation riceve una rotazione di 3 gradi; una scheda contrast riceve il fattore 0,4. Per il rumore, l'immagine diventa un array NumPy: i colori dei pixel sono allora numeri sui quali possiamo effettuare operazioni.
np.random.default_rng(42 + fixture["id"]) inizializza il generatore casuale da un seme legato all'immagine. normal(0, 12, array.shape) produce il rumore gaussiano previsto dal protocollo. Dopo l'aggiunta, np.clip riporta i valori tra 0 e 255, poi uint8 li rappresenta come interi senza segno a otto bit.
Il punto importante non è memorizzare ogni chiamata: a parità di fixture, vogliamo ritrovare gli stessi pixel nell'ambiente fissato. Altrimenti potremmo attribuire al modello uno scarto che in realtà proviene da un'immagine diversa.
Perché calcolare un hash dei pixel?
Lo SHA-256 è un'impronta calcolata a partire dai byte. Qui, array.tobytes() fornisce quelli dei pixel e hexdigest() ne produce l'impronta in forma testuale. La documentazione Python di hashlib descrive queste operazioni.
prepare salva il PNG e questa impronta in outputs/prepared.json. Prima di ogni chiamata OCR, src.cli ricarica il PNG in RGB e ne ricalcola l'hash. Se l'impronta è diversa, il passaggio fallisce.
Il controllo riguarda i pixel RGB, non l'insieme dei byte del file PNG. Permette di verificare che il contenuto visivo usato per la misurazione corrisponda a quello preparato. Da solo, non costituisce una protezione dell'intera catena documentale contro una modifica dannosa.
load_image aggiunge un controllo dell'input: larghezza e altezza devono essere entrambe comprese tra 1 e 4096 pixel. L'immagine viene poi convertita in RGB. Come per un file ricevuto da un modulo, verifichiamo ciò che stiamo per trattare prima di inviarlo alla fase successiva; questo controllo delle dimensioni non è tuttavia una politica completa di accettazione dei file.
Caricare EasyOCR e conservare ciò che restituisce
Le immagini sono pronte. Resta da caricare i modelli e sottoporre loro i pixel:
import torch
import easyocr


class Reader:
    def __init__(self):
        if not torch.cuda.is_available():
            raise RuntimeError("GPU CUDA requis")

        torch.set_num_threads(4)
        self.reader = easyocr.Reader(
            ["fr", "en"],
            gpu=True,
            model_storage_directory="/models/ocr",
            user_network_directory="/tmp/networks",
            download_enabled=False,
            verbose=False,
        )

    def read(self, array):
        boxes = self.reader.readtext(array, paragraph=False, workers=0)
        return [
            {
                "box": [[float(x), float(y)] for x, y in box],
                "text": text,
                "confidence": float(confidence),
            }
            for box, text, confidence in boxes
        ]
Leggere il costruttore come una configurazione di servizio
La prima condizione rifiuta di proseguire se CUDA non è disponibile. Non passiamo quindi silenziosamente a un'altra modalità di calcolo.
torch.set_num_threads(4) regola il parallelismo delle operazioni PyTorch sulla CPU; non indica quattro GPU. È il ruolo descritto dalla documentazione di PyTorch 2.10.
Il lettore carica le lingue fr e en, attiva la GPU e usa i pesi presenti in /models/ocr. Con download_enabled=False, non può scaricare un peso mancante durante l'inferenza. Un file assente deve quindi essere risolto durante l'acquisizione, non nascosto da un download implicito nel mezzo di una misurazione.
Non scartare le informazioni che spiegano un errore
In read, readtext riceve l'array di pixel. paragraph=False disattiva il raggruppamento in paragrafi; workers=0 conserva l'impostazione di caricamento prevista dal progetto. I parametri sono descritti nel riferimento dell'API EasyOCR.
Il nostro metodo trasforma poi tutti i riquadri restituiti da readtext in dizionari, senza un'ulteriore selezione dei risultati migliori. Le coordinate e le confidenze sono convertite in numeri Python per l'output JSON. Ciò non significa che il motore non abbia filtri interni: conserviamo ciò che restituisce, anziché scegliere a posteriori soltanto le letture favorevoli.
Il testo finale si ottiene unendo i frammenti nell'ordine ricevuto. Per le nostre tre righe, questo ordine fa parte del risultato valutato. Per colonne o una tabella, può essere insufficiente: frammenti ben riconosciuti ma assemblati nell'ordine sbagliato non ricostruiscono necessariamente il documento.
Avviare il riconoscimento
docker compose run --rm --no-deps app -m src.cli ocr
Il comando controlla prima l'hash RGB di ogni immagine preparata, poi scrive outputs/ocr.json. Ogni risultato conserva i riquadri, il testo concatenato, le confidenze, la durata e la GPU indicata dal progetto.
Sull'immagine 0 viene eseguito un warm-up, ovvero un passaggio di riscaldamento, prima delle 50 letture cronometrate. Il tempo per immagine esclude il caricamento del modello e il rendering dei PNG. Il percorso completo misurato include invece queste fasi: non stiamo parlando dello stesso cronometro.
Per leggere un output, avvicinate il PNG, i suoi riquadri e il suo testo. Un riferimento assente dal testo può dipendere da una zona non restituita, da un riconoscimento errato o da un assemblaggio inadeguato. Il JSON dettagliato permette di indagare; il solo punteggio globale non indica dove guardare.
Leggere le metriche prima dei risultati
Ora abbiamo due oggetti: il testo atteso e il testo riconosciuto. Prima di confrontarne i punteggi, bisogna precisare ciò che il programma considera una differenza.
Una normalizzazione che cambia il confronto
La funzione normalize applica NFKC, converte in minuscolo, recupera i gruppi di caratteri \w+, poi li unisce con uno spazio.
NFKC è una normalizzazione Unicode che uniforma alcune rappresentazioni equivalenti o compatibili dei caratteri. Non corregge gli errori OCR. Il pattern \w conserva i caratteri alfanumerici Unicode e il trattino basso _; il trattino -, il punto e la virgola non ne fanno parte. Questi comportamenti sono documentati da Python per unicodedata e re.
Ecco esempi didattici del risultato di questa funzione, non output OCR acquisiti:
Reference REF-000  →  reference ref 000
Total EUR 10.00    →  total eur 10 00
Total EUR 10,00    →  total eur 10 00
Il punto e la virgola scompaiono come segni distintivi, ma i gruppi restano separati da spazi. Dire che la punteggiatura «non conta più» non significa quindi che tutte le differenze di separazione diventino invisibili: 10.00 diventa 10 00, mentre 1000 resta 1000.
Il CER r3 valuta questo testo normalizzato, non una riproduzione carattere per carattere del testo grezzo. Nell'esempio qui sopra, un punto e una virgola decimale danno la stessa stringa normalizzata. I controlli dei campi continuano invece a esaminare il testo grezzo.
Il calcolo, senza scatola nera
"""Normalisation déclarée et distance de Levenshtein par programmation dynamique."""
import re
import unicodedata


def normalize(text):
    return " ".join(re.findall(r"\w+", unicodedata.normalize("NFKC", text).lower()))


def distance(reference, hypothesis):
    row = list(range(len(hypothesis) + 1))
    for i, expected in enumerate(reference, 1):
        following = [i]
        for j, actual in enumerate(hypothesis, 1):
            following.append(
                min(
                    following[-1] + 1,
                    row[j] + 1,
                    row[j - 1] + (expected != actual),
                )
            )
        row = following
    return row[-1]


def evaluate(rows):
    test = [row for row in rows if row["split"] == "test"]
    errors = sum(
        distance(normalize(row["reference"]), normalize(row["text"]))
        for row in test
    )
    characters = sum(len(normalize(row["reference"])) for row in test)

    if not characters:
        raise ValueError("Références vides")

    return {
        "evaluated": len(test),
        "character_errors": errors,
        "reference_characters": characters,
        "cer": errors / characters,
        "reference_exact": sum(row["ref"] in row["text"] for row in test) / len(test),
        "amount_exact": sum(row["amount"] in row["text"] for row in test) / len(test),
        "mean_ocr_ms": 1000 * sum(row["seconds"] for row in test) / len(test),
    }
distance calcola progressivamente il numero minimo di modifiche tra due stringhe. Per ogni coppia di caratteri, sceglie l'operazione meno costosa fra inserire, eliminare o sostituire. Se i due caratteri sono uguali, il costo della sostituzione è zero; altrimenti vale uno.
Si tratta di programmazione dinamica: il calcolo riusa risultati intermedi invece di ricominciare ogni confronto dall'inizio. row conserva la riga precedente del calcolo, following costruisce quella successiva. Non dovete reimplementare l'algoritmo per interpretare il punteggio, ma qui potete vedere come vengono conteggiati gli errori.
I valori di evaluate, uno per uno
La prima riga di evaluate mantiene soltanto le voci il cui split vale test, cioè split == "test". Vengono lette tutte le 50 immagini, ma i punteggi e mean_ocr_ms di questo resoconto riguardano le 40 immagini di test.
character_errors somma le distanze tra testi normalizzati. reference_characters somma le lunghezze dei testi attesi normalizzati. Il loro quoziente dà cer. Il controllo Références vides (riferimenti vuoti) impedisce di calcolare un rapporto senza caratteri di riferimento.
Attenzione ai nomi: row["reference"] è il testo completo atteso, mentre row["ref"] è il riferimento applicativo, per esempio REF-000. Il CER riguarda quindi le tre righe del documento, non solo il codice prodotto.
reference_exact misura la proporzione di immagini in cui il riferimento atteso è presente nel testo grezzo. amount_exact effettua la stessa ricerca per l'importo. Infine, mean_ocr_ms converte i secondi in millisecondi e ne calcola la media sulle voci di test.
La piccola trappola della parola «esatto»
Il nome amount_exact può far pensare che stiamo convalidando un campo estratto. Guardate però la sua espressione: row["amount"] in row["text"]. Pone soltanto la domanda: «questa sequenza esatta di caratteri appare da qualche parte?»
Prendiamo un controesempio didattico, che non è un errore osservato in r3: la stringa 10.00 è contenuta anche in 110.00. Questa ricerca potrebbe quindi riuscire mentre l'importo completo è diverso. Al contrario, 10,00 non contiene 10.00, anche se un'applicazione prevede di trattare queste due scritture come lo stesso numero.
Questi esempi non modificano né il codice né i risultati del tutorial. Spiegano perché parliamo di presenza dell'importo e non di «estrazione dell'importo corretta al 100%».
Un CER basso non garantisce neppure che tutti gli errori siano senza conseguenze. Una sola lettera può rendere inutilizzabile un riferimento; una sola cifra può cambiare un valore importante. Per i casi che contano, occorre quindi leggere anche il testo, i riquadri e i campi attesi.
Verificare gli input particolari, poi calcolare il resoconto
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
negatives verifica il comportamento su un'immagine bianca e su un file non valido. L'idea assomiglia ai test API su contenuto vuoto o file malformato: non limitarsi agli input che vanno bene.
evaluate scrive poi outputs/evaluation.json, con il CER, i controlli del riferimento e dell'importo, oltre alla durata media OCR. Questi valori vanno letti con le loro definizioni, non come un voto generale assegnato al motore.
Risultati r3 e limiti della loro interpretazione
Ciò che le due riproduzioni hanno effettivamente misurato
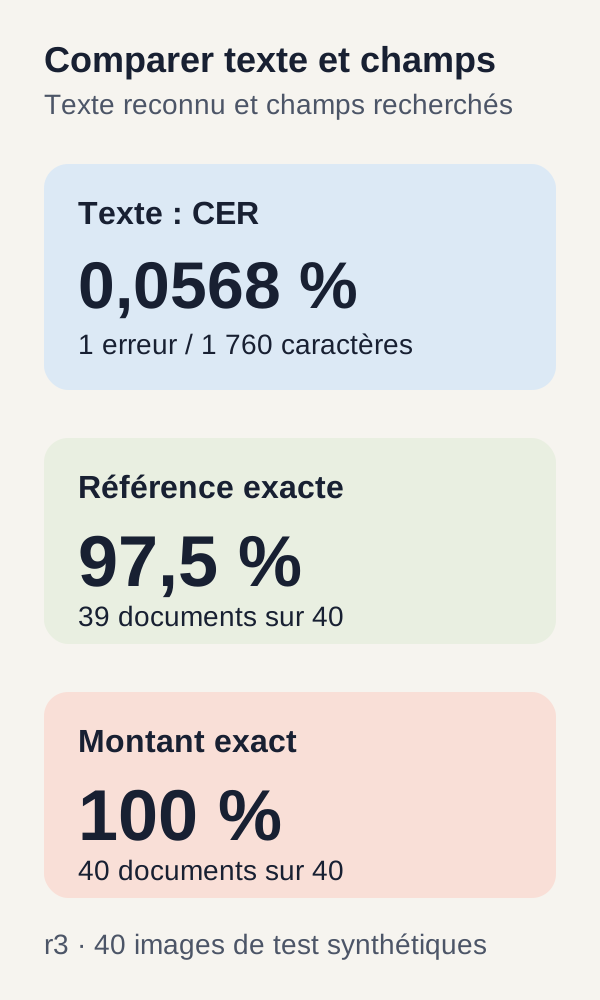
Le due riproduzioni hanno valutato le stesse 40 immagini di test. Hanno rilevato un errore su 1.760 caratteri di riferimento normalizzati. I risultati riportati sono i seguenti:
| Misura | Prima riproduzione | Seconda riproduzione |
|---|---|---|
| Immagini di test valutate | 40 | 40 |
| Errori di carattere | 1 | 1 |
| Caratteri di riferimento | 1.760 | 1.760 |
| CER micro | 0,0005681818181818182 |
0,0005681818181818182 |
| CER espresso in percentuale | Circa 0,0568% | Circa 0,0568% |
| Riferimento presente nel testo grezzo | 97,5% | 97,5% |
| Importo presente nel testo grezzo | 100% | 100% |
| Latenza OCR media sul test | 30,35 ms | 31,33 ms |
| Massimo di VRAM campionato | 600 MiB | 564 MiB |
| Durata del percorso completo, acquisizione inclusa | 87,04 s | 49,65 s |
Il calcolo del CER si legge semplicemente: 1 ÷ 1.760 = 0,0005681818181818182, cioè circa 0,0568% dopo la moltiplicazione per 100.
Su 40 immagini, il 97,5% corrisponde a 39 immagini in cui è presente il riferimento atteso. È un altro modo di leggere la stessa misura, non un test aggiuntivo. Analogamente, l'importo è presente nelle 40 immagini secondo il controllo per sottostringa. Questo non convalida un parser di fatture.
Le due riproduzioni mostrano la ripetizione del percorso su questo insieme. Non costituiscono due insiemi indipendenti di documenti: le 40 immagini di test sono le stesse.
Leggere correttamente le misure di tempo e memoria
La latenza corrisponde qui alla durata di una lettura OCR, con le esclusioni descritte sopra. La durata del percorso completo include più lavoro, in particolare l'acquisizione. La seconda build ha riutilizzato livelli Docker pubblici: gli 87,04 s e i 49,65 s non sono quindi due installazioni interamente prive di cache.
La VRAM è la memoria della scheda grafica. I massimi di 600 MiB e 564 MiB provengono da un campionamento effettuato circa una volta al secondo sulla RTX 3090 usata. Un picco fra due rilevamenti può non essere visto. Questi valori non sono né picchi reali garantiti né un dimensionamento minimo della scheda.
Questi dati non misurano il traffico compresso, lo spazio Docker esclusivo dopo la deduplicazione o il comportamento sotto carico. Non permettono neppure di promettere la stessa latenza per più utenti simultanei o per documenti più grandi.
La rotazione ha «ridotto la qualità»?
Le 16 immagini pulite del test danno un CER di 0. I gruppi rotazione, rumore e contrasto contengono ciascuno 8 immagini. Il gruppo rotazione comprende un errore, con un CER di 0,002840909090909091 e un riferimento presente nell'87,5% dei casi. Gli importi restano presenti in tutti i gruppi.
Si potrebbe essere tentati di concludere: «la rotazione spiega l'errore». Ma i riferimenti cambiano da un gruppo all'altro. Non confrontiamo esattamente lo stesso documento prima e dopo la rotazione.
Questi gruppi non sono appaiati: le loro differenze non riguardano soltanto la trasformazione dell'immagine. La conclusione resta descrittiva — in questo insieme è stato osservato un errore nel gruppo rotazione — e non causale. Per isolare l'effetto della rotazione, servirebbe un altro protocollo, descritto nell'esercizio.
Cosa abbiamo imparato
Abbiamo costruito una pipeline completa in piccola scala: definire il contenuto atteso, generare le immagini, controllare gli input, localizzare il testo, riconoscere i caratteri e calcolare metriche di cui possiamo leggere il codice.
Per uno sviluppatore web che scopre l'IA, il cambiamento principale è qui: un output del modello va osservato e valutato, non soltanto consumato perché ha la forma giusta. Il JSON facilita l'integrazione; non garantisce la correttezza del suo contenuto.
Il CER descrive una parte dello scarto testuale. I controlli di riferimento e importo pongono altre domande, ma restano ricerche di presenza. Nessuno di questi elementi sostituisce da solo la validazione applicativa.
Le due riproduzioni r3 convalidano questo percorso locale su 50 immagini sintetiche, di cui 40 di test. Non convalidano né un parser di fatture né una prestazione universale su documenti reali. È proprio questo perimetro limitato che ci permette di capire ciò che misuriamo prima di rendere il progetto più complesso.
Esercizio: prevedere, modificare, avviare, osservare, spiegare
Per prima cosa, fate una previsione
Prima di eseguire il comando, riprendete la ripartizione dei dati. Con otto modelli di test, due immagini pulite per modello e un'immagine di ogni altra variante, quanti risultati vi aspettate in ogni gruppo?
Seconda domanda: se il gruppo rotazione contiene più errori, avete dimostrato che la rotazione ne è la causa? Scrivete la risposta prima di leggere gli output.
Avviate, poi osservate
docker compose run --rm --no-deps app -m src.cli exercise
Confrontate la vostra previsione con le metriche per gruppo. clean comprende 16 immagini; rotation, noise e contrast ne comprendono 8 ciascuno. Spiegate questo conteggio a partire dai modelli, anziché memorizzarlo.
Il comando exercise non modifica il modello e non avvia un nuovo addestramento. Raggruppa gli output già ottenuti. La parte «modificare» dell'esercizio interviene nell'esperimento separato proposto qui sotto, non in questo comando.
La conclusione attesa è che i gruppi descrivono i dati forniti. Non è che la rotazione provochi una riduzione universale della qualità.
Per verificare una causa, cambiate il protocollo in una copia
Un confronto appaiato consisterebbe nel rendere esattamente lo stesso testo in un'immagine pulita e in un'immagine ruotata. Le due immagini formerebbero una coppia. Potreste allora confrontarne gli errori mantenendo il riferimento, l'importo e gli altri parametri.
Lavorate in una directory separata e fate variare un solo fattore alla volta. Prevedete la nuova generazione di immagini, il loro passaggio nell'OCR e le nuove misurazioni. Modificare soltanto il raggruppamento dei vecchi output non crea queste coppie.
Questa proposta non è stata eseguita in r3. Costituisce un nuovo esperimento, senza risultato preannunciato. Il suo interesse è imparare a porre una domanda che i dati consentano davvero di risolvere.
Il vostro esperimento separato, senza risultato preannunciato
Per provare i vostri documenti, create una directory di lavoro distinta e mantenete invariato l'archivio r3. Conserverete così un punto di confronto di cui conoscete il contenuto e il comportamento atteso.
Prima di avviare l'OCR, descrivete il tipo di documenti, la qualità della digitalizzazione, le lingue, gli orientamenti e le regole di verità di base. Precisate anche il costo di un errore: un riferimento irreperibile e un importo errato non hanno necessariamente le stesse conseguenze nella vostra applicazione.
Scegliete le vostre metriche prima di guardare i risultati. Potreste misurare gli errori di riferimento, gli errori di importo, il tasso di rifiuto e il risultato di una revisione umana. Un rifiuto corrisponderebbe allora a un documento che la vostra applicazione rifiuta di trattare automaticamente secondo una regola da definire; questo meccanismo non è fornito dal semplice calcolo del CER.
Scansioni, tabelle, colonne, loghi, scritture a mano e immagini degradate cambiano il problema. Non annunciate quindi alcun punteggio prima della misurazione. Se aggiungete un parser di importo o una soglia di confidenza, valutate questa nuova fase separatamente: la confidenza di EasyOCR qui non è calibrata come probabilità di correttezza applicativa.
Risoluzione dei problemi utile
nvidia-smi absent (nvidia-smi assente). Installate o riparate il driver NVIDIA, poi rieseguite il preflight. Finché questa verifica fallisce, proseguite la diagnosi dell'ambiente anziché quella delle immagini.
GPU rilevata su Linux, ma non in Docker. Configurate NVIDIA Container Toolkit e verificate che GPU_DEVICE indichi la scheda prevista. La visibilità dell'hardware sull'host e la sua esposizione al container sono due controlli distinti.
Errore di fetch. Verificate la rete e gli hash. Non aggirate i controlli di dimensione o SHA-256 per far sparire l'errore: perdereste il legame con le risorse del percorso convalidato.
GPU CUDA requis (GPU CUDA richiesta). Controllate il driver, l'esposizione della GPU in Docker e GPU_DEVICE, poi riprendete dopo l'acquisizione completa. Il codice rifiuta volutamente di proseguire senza CUDA.
Image modifiée depuis prepare (immagine modificata dopo prepare). Rieseguite prepare prima di ocr. Nella riproduzione di riferimento, non modificate i PNG fra queste fasi: il controllo serve proprio a rilevare una differenza tra l'immagine preparata e quella misurata.
Riquadri o ordine di lettura inattesi. Aprite outputs/ocr.json e i PNG associati. Il testo unito segue l'ordine restituito dal motore; non risolve automaticamente i documenti a colonne. Iniziate a stabilire se il problema dipende dalla zona restituita, dai caratteri riconosciuti o dall'assemblaggio del testo.
Ciò che manca prima di una produzione documentale
In un'applicazione reale, l'OCR sarebbe un componente di un trattamento più ampio. La pipeline dovrebbe gestire i formati realmente ricevuti, l'orientamento, il raddrizzamento delle immagini, la qualità delle scansioni, i layout, le tabelle, le lingue e la scrittura a mano necessari al vostro settore.
Il passaggio successivo sarebbe associare i campi in modo affidabile: determinare quale valore corrisponde a quale etichetta, convalidare le regole di numero e valuta, calibrare i rifiuti e prevedere una revisione umana quando il costo di un errore lo giustifica. Leggere due importi nella stessa immagine non basta a stabilire quale debba compilare il campo «totale» della vostra applicazione.
Resta anche tutto il lavoro familiare di un'applicazione web: acquisizione sicura, autenticazione, diritti sui documenti, quote, archiviazione, regole di conservazione, supervisione, backup e ripristino. Le misure di carico e concorrenza devono riguardare il servizio completo, non solo una lettura OCR isolata.
Infine, la valutazione deve usare documenti rappresentativi, ripartiti secondo i casi importanti: tipi di documenti, lingue, qualità delle scansioni o difficoltà di layout. Questo è il significato di una valutazione stratificata. Le 40 immagini di test sintetiche non la sostituiscono.
Pulizia esatta
Alla fine del percorso, eseguite questo comando dalla radice dell'archivio:
docker compose down
Fa parte del percorso r3 convalidato. Arresta le risorse Compose del progetto e rimuove i container e le reti interessati, senza eliminare i modelli, l'immagine Docker o gli output. Il comportamento predefinito di pulizia è descritto nella documentazione di docker compose down.
Conservate i JSON e i PNG finché vi servono per rileggere i risultati. Eliminate i vostri tentativi separati soltanto dopo averne verificato il contenuto. Una pulizia globale di Docker non è necessaria per completare questo tutorial.