





Imagine un formulario en su aplicación: el usuario carga la imagen de un documento y usted quiere rellenar previamente una referencia y un importe. Para su código de negocio, son dos cadenas que hay que comprobar. Pero, en el archivo enviado, esta información todavía son solo píxeles. ¿Cómo pasar de una cosa a la otra?
Ese es el papel del OCR, el reconocimiento óptico de caracteres. Vamos a construir una pequeña cadena local con Python, Docker y EasyOCR, y después veremos qué lee realmente. No solo un texto que parece correcto en pantalla: también conservaremos las zonas detectadas, las puntuaciones del motor y los errores medidos.
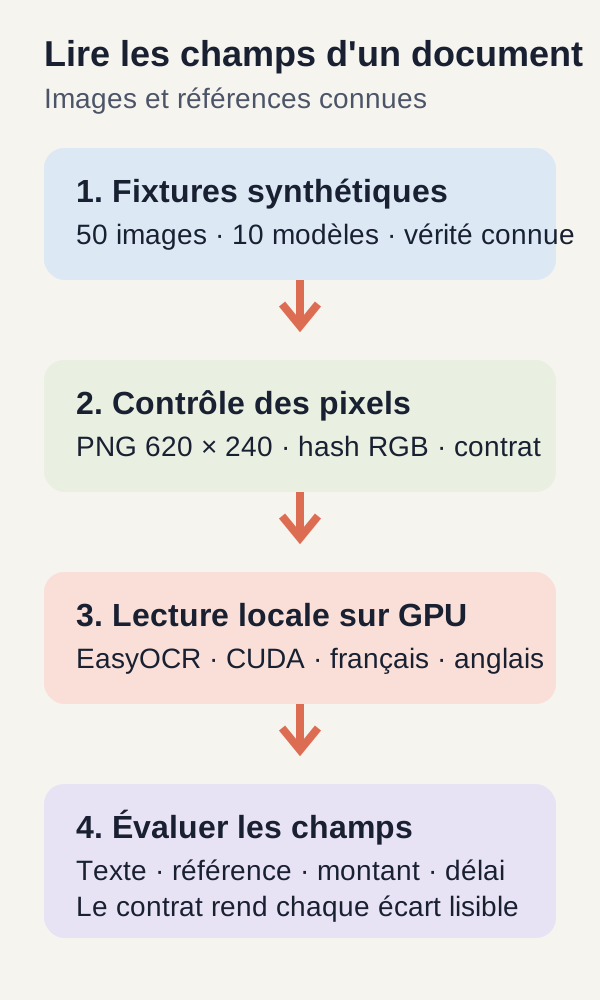
Para empezar sin manipular documentos privados, el proyecto fabrica 50 imágenes sintéticas cuyo contenido ya conocemos. Las lee en una GPU CUDA y después calcula su balance sobre 40 imágenes reservadas para la prueba. Esta diferencia entre lo que esperamos y lo que produce el modelo será nuestro hilo conductor.
Descargar el proyecto completo del tutorial.
Los resultados presentados proceden de dos reproducciones validadas de este archivo r3, en directorios nuevos. Los ejemplos añadidos para explicar una noción se señalan como tales: no sustituyen las salidas medidas del proyecto.
El problema y el resultado esperado
Leer texto todavía no es comprender un documento
Un OCR, por optical character recognition, responde a dos preguntas sucesivas: ¿dónde hay texto en la imagen? y después ¿qué caracteres hay en esas zonas?
La primera etapa es la detección. La segunda es el reconocimiento. Después se puede formar el texto final reuniendo los fragmentos obtenidos. Esta separación aparece en la API de EasyOCR, con las operaciones de detección y reconocimiento.
Tomemos una situación ilustrativa: ve «Total EUR 10.00» en una imagen. Para su aplicación siguen quedando varias preguntas. ¿El motor leyó todas las cifras? ¿Conservó el separador decimal? ¿Este importe es el total, un subtotal u otro valor presente en el documento?
Reconocer caracteres y extraer un campo de negocio son, por tanto, dos etapas distintas. Nuestro tutorial construye y evalúa la primera cadena; sus controles de referencia e importe siguen siendo deliberadamente simples.
Los archivos que obtendrá
Al final del recorrido, outputs/images/ contendrá los 50 PNG. outputs/prepared.json relacionará las imágenes con su texto esperado y su huella de control. outputs/ocr.json conservará, para cada imagen, las cajas de texto, los textos reconocidos, las confianzas y los tiempos medidos. Por último, outputs/evaluation.json contendrá el balance de solo las 40 imágenes de prueba.
Para un desarrollador web, piense en una prueba de integración: prepara datos conocidos, hace pasar una entrada por el sistema y compara después la respuesta con lo esperado. Aquí la entrada no es un formulario JSON, sino una imagen, y el resultado puede contener errores de lectura.
Requisitos de GPU, Docker y recursos
El recorrido r3 se validó en Linux amd64, es decir, la arquitectura x86_64, con Docker Engine, Docker Compose, un controlador NVIDIA, nvidia-smi y NVIDIA Container Toolkit. Las mediciones de este artículo se realizaron en una RTX 3090.
La GPU es la tarjeta utilizada para acelerar los cálculos del modelo. CUDA es el entorno de cálculo de NVIDIA empleado en este proyecto. NVIDIA Container Toolkit permite que este acceso esté disponible desde Docker; una tarjeta visible en Linux no lo está necesariamente en un contenedor. Su instalación se describe en la guía oficial de NVIDIA.
Este recorrido de inferencia es únicamente CUDA. No ofrece una alternativa de CPU validada. En el archivo .env proporcionado, defina GPU_DEVICE antes de iniciar si debe exponer otra tarjeta distinta de la tarjeta 0.
El preflight, es decir, la comprobación previa, exige 20 Gio libres en el disco del proyecto y en el almacenamiento Docker, además de 12 Gio de RAM disponible. El contenedor de la aplicación está limitado a 8 Gio de memoria, 4 CPU y 256 procesos. Gio y Mio son unidades binarias de capacidad de memoria o disco.
No confunda estos valores: los umbrales del preflight se refieren a los recursos disponibles en el host; el límite del contenedor restringe lo que puede utilizar la aplicación. La RAM es la memoria principal de la máquina, no la VRAM de la tarjeta gráfica.
Después de extraer el ZIP, desde la raíz del proyecto, empiece por:
./scripts/preflight.sh
Este script comprueba Linux, Docker, Compose, la tarjeta elegida, la inicialización CUDA desde Docker, la RAM y el espacio en disco. No configura su sistema por usted. Si detecta la GPU en el host pero no en Docker, configure NVIDIA Container Toolkit y vuelva a ejecutar el control.
Estas comprobaciones definen las condiciones del recorrido. No prometen ni compatibilidad con cada tarjeta CUDA ni tiempos idénticos en todas las máquinas.
Los datos antes del OCR
¿Por qué fabricar nosotros mismos los documentos?
Antes de medir una lectura necesitamos una respuesta de referencia. En aprendizaje automático se habla a menudo de verdad de terreno: la información considerada correcta, con la que comparamos la salida del modelo.
El archivo data/fixtures.json contiene 50 fichas sintéticas. Una fixture es simplemente un conjunto de datos preparado para una prueba, como los que usa para poblar una base de desarrollo. Esta es la primera ficha del proyecto:
{
  "id": 0,
  "template": 0,
  "split": "dev",
  "variant": "clean",
  "ref": "REF-000",
  "amount": "10.00"
}
id identifica la imagen. template designa su plantilla. split indica el conjunto al que pertenece, aquí el de desarrollo. variant elige el aspecto de la imagen. Por último, ref y amount proporcionan los valores esperados antes de cualquier reconocimiento.
src/images.py transforma esta ficha en tres líneas:
BOUTIQUE 0
Reference REF-000
Total EUR 10.00
No se trata aquí de una salida OCR, sino del texto que dibuja el generador. Por tanto conocemos la respuesta sin pedírsela al motor que queremos evaluar. El OCR recibe los píxeles; la referencia sigue disponible para la comparación posterior.
Variaciones controladas, no facturas reales
Cada imagen RGB mide 620 × 240 píxeles y utiliza la fuente DejaVu Sans a 28 píxeles. RGB significa que cada píxel está representado por sus componentes rojo, verde y azul.
El generador aplica una de cuatro variantes: una imagen limpia, una rotación de 3 grados, un contraste ajustado a 0,4 o un ruido gaussiano de desviación estándar 12. El ruido añade variaciones a los valores de los píxeles. Su semilla, 42 + id, permite reproducir el mismo ruido para una ficha dada en el entorno fijado.
La palabra plantilla no designa diez maquetas realistas de facturas. En el código mostrado más adelante, el número cambia en particular la línea «BOUTIQUE» y el desplazamiento horizontal del texto. Todas las imágenes siguen siendo fichas sencillas de tres líneas.
¿Por qué separar desarrollo y prueba?
Las diez plantillas se reparten en dos conjuntos sin solapamiento: dos plantillas para desarrollo, es decir, 10 imágenes, y ocho para prueba, es decir, 40 imágenes. Una misma plantilla no pertenece a ambos conjuntos.
La idea es distinguir los ejemplos que sirven para poner a punto el recorrido de los que sirven para medir su resultado. Esto no significa que entrenemos EasyOCR con las diez imágenes de desarrollo: usamos aquí modelos ya entrenados, sin modificar sus pesos.
Preste atención también al tamaño de los grupos de prueba:
| Variante | Imágenes por plantilla de prueba | Total en las 8 plantillas de prueba |
|---|---|---|
clean: imagen limpia |
2 | 16 |
rotation: rotación de 3 grados |
1 | 8 |
noise: ruido gaussiano |
1 | 8 |
contrast: contraste a 0,4 |
1 | 8 |
| Total | 5 | 40 |
Las anotaciones y las imágenes son completamente sintéticas: no se expone ningún documento privado. Como contrapartida, este conjunto no representa ni facturas digitalizadas, ni maquetaciones complejas, ni escritura manuscrita. La separación de las plantillas no elimina esta limitación.
Instalar, adquirir y preparar las imágenes
Extraiga el archivo y sitúese en su raíz. Los siguientes comandos se ejecutan desde este directorio, en el orden indicado. Corresponden al inicio de cada una de las dos reproducciones r3; la comprobación previa se repite para presentar el recorrido completo:
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app -m src.cli prepare
¿Qué hace cada etapa?
setup.sh prepara las carpetas con la identidad del usuario actual. docker compose build construye la imagen de Python 3.12.13 bloqueada por el proyecto. Las dependencias incluyen PyTorch 2.10.0+cu129, torchvision 0.25.0+cu129 y EasyOCR 1.7.2.
PyTorch proporciona el motor de cálculo utilizado por EasyOCR; torchvision forma parte de la pila instalada para los tratamientos de visión. Las versiones anteriores son las del recorrido validado, no una invitación a sustituirlas por las últimas disponibles. La imagen de Python está documentada en Docker Hub, y los paquetes PyTorch CUDA correspondientes se publican en el índice cu129.
El servicio fetch adquiere los recursos públicos. Recupera en particular los pesos de EasyOCR craft_mlt_25k y latin_g2 desde las releases oficiales de JaidedAI. Los pesos son los parámetros numéricos aprendidos por los modelos antes de este tutorial. Cargarlos permite realizar una inferencia: aplicar un modelo ya entrenado a una imagen nueva.
El proyecto controla el tamaño y el SHA-256 de los archivos, así como de los pesos extraídos. Esta huella permite comprobar que los archivos corresponden a los esperados. La primera adquisición validada representa 91 536 692 bytes.
fetch es el único servicio dotado de una red bridge para esta adquisición. Después la aplicación utiliza una red Docker interna, monta los modelos en solo lectura y solo escribe las salidas. La separación evita mezclar la descarga de recursos y el tratamiento de imágenes.
Las pruebas van antes del recorrido medido
El comando unittest debe hacer pasar las 15 pruebas públicas. Comprueban en particular la población de datos, la separación de plantillas, el renderizado determinista, el cálculo de la métrica y los errores de imagen. También incluyen una detección y reconocimiento reales en CUDA.
Este último punto importa: ver una tarjeta en Docker no prueba que el detector la use. La prueba inspecciona el dispositivo donde se encuentra. Por tanto, estas comprobaciones ya pueden solicitar el modelo; preceden a las lecturas cronometradas del recorrido principal.
Por último, prepare escribe los 50 PNG y outputs/prepared.json, con el hash RGB y el texto de referencia asociados a cada imagen. En este momento puede mirar las imágenes que deberá leer el motor.
En los comandos Compose, run inicia una tarea puntual, --rm elimina su contenedor después de ejecutarla y --no-deps evita iniciar automáticamente los servicios vinculados. Los resultados guardados en las carpetas montadas siguen disponibles. Estas opciones se detallan en la documentación de Docker Compose.
Vocabulario útil antes de leer el código
Una caja, un texto y una confianza
En este proyecto, EasyOCR utiliza CRAFT para localizar las regiones de texto y el reconocedor latin_g2 para leer sus caracteres. El lector se configura con los idiomas fr y en. Retenga sobre todo la separación de funciones: localizar una zona todavía no es lograr leerla.
Para cada zona devuelta, conservamos una caja definida por cuatro puntos, el texto reconocido y una puntuación de confianza. Para visualizar esta estructura, aquí tiene un objeto inventado con fines pedagógicos. Sus coordenadas y su confianza no son mediciones r3:
{
  "box": [[20.0, 80.0], [330.0, 80.0], [330.0, 110.0], [20.0, 110.0]],
  "text": "Reference REF-000",
  "confidence": 0.98
}
Los cuatro puntos delimitan la región afectada. El texto indica lo que el motor leyó allí. La confianza es una puntuación interna: 0.98 no significa que su campo de negocio tenga un 98 % de probabilidades de ser correcto.
Para interpretar esta puntuación como una probabilidad de exactitud, habría que comprobar esta correspondencia con datos representativos: ese es el papel de una calibración. El recorrido r3 no realiza este trabajo ni define un umbral de confianza que garantice la exactitud de un importe.
El CER: contar errores de caracteres
El CER, por character error rate, compara el texto reconocido con el texto esperado. Utiliza la distancia de Levenshtein: el número mínimo de inserciones, eliminaciones y sustituciones de caracteres necesarios para pasar de un texto a otro.
Ilustración independiente de los resultados r3: pasar de REF-000 a REF-00O exige sustituir el último cero por la letra O. Esto representa una sustitución. Sin embargo, para una búsqueda de producto, este único carácter puede impedir recuperar la referencia correcta.
El CER divide el número de errores por el número de caracteres esperados. Un CER de cero significa que no se contó ninguna diferencia según las reglas de comparación utilizadas. Estas reglas son importantes: r3 normaliza los textos antes de compararlos, como veremos en el código.
El balance utiliza un CER micro: se suman los errores de todas las imágenes de prueba y después se divide por el total de sus caracteres de referencia. No es una media simple de los CER por imagen. Un texto esperado más largo pesa más en el total.
Los controles de campos: útiles, pero limitados
El programa comprueba por separado si REF-xxx y el importe esperado están presentes en el texto bruto. Se trata de búsquedas por subcadena, no de un analizador de facturas.
Estos controles no comprueban la posición de un valor en la página, la divisa, el formato numérico ni la asociación entre una etiqueta y su contenido. Un valor puede aparecer en alguna parte sin ser el campo que la aplicación debía extraer. Tenga presente este matiz cuando leamos los porcentajes.
Generar las imágenes y comprobar sus bytes
La función render transforma una fixture en píxeles. Devuelve la imagen, el texto esperado y una huella SHA-256 calculada sobre los bytes RGB. Este es el código del proyecto, con un formato más espaciado:
"""Fiches synthétiques déterministes ; annotations indépendantes de l’OCR."""
import hashlib
import numpy as np
from PIL import Image, ImageDraw, ImageFont, ImageEnhance


def render(fixture):
    lines = [
        f'BOUTIQUE {fixture["template"]}',
        f'Reference {fixture["ref"]}',
        f'Total EUR {fixture["amount"]}',
    ]
    image = Image.new("RGB", (620, 240), "white")
    draw = ImageDraw.Draw(image)
    font = ImageFont.truetype("data/DejaVuSans.ttf", 28)

    for index, text in enumerate(lines):
        draw.text(
            (20 + fixture["template"] * 3, 20 + index * 60),
            text,
            font=font,
            fill="black",
        )

    if fixture["variant"] == "rotation":
        image = image.rotate(
            3,
            resample=Image.Resampling.BICUBIC,
            fillcolor="white",
        )

    if fixture["variant"] == "contrast":
        image = ImageEnhance.Contrast(image).enhance(0.4)

    array = np.array(image)

    if fixture["variant"] == "noise":
        noise = np.random.default_rng(42 + fixture["id"]).normal(
            0, 12, array.shape
        )
        array = np.clip(array.astype(float) + noise, 0, 255).astype("uint8")

    return (
        Image.fromarray(array),
        " ".join(lines),
        hashlib.sha256(array.tobytes()).hexdigest(),
    )


def load_image(path):
    with Image.open(path) as image:
        if not 0 < image.width <= 4096 or not 0 < image.height <= 4096:
            raise ValueError("Dimensions image hors plage")
        return np.array(image.convert("RGB"))
Del JSON a los píxeles
La lista lines construye las tres líneas a partir de la fixture. Image.new crea un fondo blanco de 620 × 240 píxeles, y ImageDraw dibuja allí el texto. La posición horizontal depende de la plantilla; la posición vertical aumenta 60 píxeles en cada línea.
Las siguientes condiciones eligen la transformación. Una ficha rotation recibe la rotación de 3 grados; una ficha contrast recibe el factor 0,4. Para el ruido, la imagen se convierte en un array NumPy: los colores de los píxeles pasan a ser números sobre los que podemos realizar operaciones.
np.random.default_rng(42 + fixture["id"]) inicializa el generador aleatorio a partir de una semilla vinculada a la imagen. normal(0, 12, array.shape) produce el ruido gaussiano previsto por el protocolo. Tras añadirlo, np.clip devuelve los valores entre 0 y 255, y uint8 los representa como enteros sin signo de ocho bits.
Lo importante no es memorizar cada llamada: con una fixture idéntica queremos recuperar los mismos píxeles en el entorno fijado. De lo contrario, podríamos atribuir al modelo una diferencia que en realidad procede de otra imagen.
¿Por qué calcular un hash de los píxeles?
SHA-256 es una huella calculada a partir de bytes. Aquí, array.tobytes() proporciona los de los píxeles y hexdigest() produce su huella en forma de texto. La documentación Python de hashlib describe estas operaciones.
prepare guarda el PNG y esta huella en outputs/prepared.json. Antes de cada llamada OCR, src.cli vuelve a cargar el PNG en RGB y recalcula su hash. Si la huella difiere, la etapa falla.
El control se aplica a los píxeles RGB, no al conjunto de bytes del archivo PNG. Permite comprobar que el contenido visual utilizado para la medición corresponde al preparado. No constituye por sí solo una protección de toda una cadena documental frente a una modificación maliciosa.
load_image añade un control de entrada: la anchura y la altura deben estar cada una entre 1 y 4096 píxeles. Después la imagen se convierte a RGB. Como con un archivo recibido por un formulario, comprobamos lo que vamos a tratar antes de enviarlo a la etapa siguiente; sin embargo, este control de dimensiones no es una política completa de aceptación de archivos.
Cargar EasyOCR y conservar lo que devuelve
Las imágenes están listas. Queda cargar los modelos y someterles los píxeles:
import torch
import easyocr


class Reader:
    def __init__(self):
        if not torch.cuda.is_available():
            raise RuntimeError("GPU CUDA requis")

        torch.set_num_threads(4)
        self.reader = easyocr.Reader(
            ["fr", "en"],
            gpu=True,
            model_storage_directory="/models/ocr",
            user_network_directory="/tmp/networks",
            download_enabled=False,
            verbose=False,
        )

    def read(self, array):
        boxes = self.reader.readtext(array, paragraph=False, workers=0)
        return [
            {
                "box": [[float(x), float(y)] for x, y in box],
                "text": text,
                "confidence": float(confidence),
            }
            for box, text, confidence in boxes
        ]
Leer el constructor como una configuración de servicio
La primera condición se niega a continuar si CUDA no está disponible. Por tanto, no cambiamos silenciosamente a otro modo de cálculo.
torch.set_num_threads(4) ajusta el paralelismo de las operaciones PyTorch en CPU; no designa cuatro GPU. Este es el papel descrito por la documentación de PyTorch 2.10.
El lector carga los idiomas fr y en, activa la GPU y utiliza los pesos presentes en /models/ocr. Con download_enabled=False, no puede descargar un peso que falte durante la inferencia. Por tanto, un archivo ausente debe resolverse durante la adquisición, no ocultarse mediante una descarga implícita en medio de una medición.
No descartar la información que explica un error
En read, readtext recibe el array de píxeles. paragraph=False desactiva la agrupación en párrafos; workers=0 conserva el ajuste de carga previsto por el proyecto. Los parámetros se describen en la referencia de la API de EasyOCR.
Nuestro método transforma después todas las cajas devueltas por readtext en diccionarios, sin seleccionar adicionalmente los mejores resultados. Las coordenadas y las confianzas se convierten en números Python para la salida JSON. Esto no significa que el motor no tenga ningún filtro interno: conservamos lo que devuelve, en lugar de escoger a posteriori solo las lecturas favorables.
El texto final se obtiene uniendo los fragmentos en el orden recibido. Para nuestras tres líneas, este orden forma parte del resultado evaluado. Para columnas o una tabla, puede ser insuficiente: fragmentos bien reconocidos pero ensamblados en mal orden no reconstruyen necesariamente el documento.
Ejecutar el reconocimiento
docker compose run --rm --no-deps app -m src.cli ocr
El comando controla primero el hash RGB de cada imagen preparada y después escribe outputs/ocr.json. Cada resultado conserva las cajas, el texto concatenado, las confianzas, la duración y la GPU indicada por el proyecto.
Se realiza un warm-up, o pasada de calentamiento, sobre la imagen 0 antes de las 50 lecturas cronometradas. El tiempo por imagen excluye la carga del modelo y el renderizado de los PNG. El recorrido completo medido incluye, por su parte, estas etapas: no hablamos del mismo cronómetro.
Para leer una salida, relacione el PNG, sus cajas y su texto. Una referencia ausente del texto puede deberse a una zona no devuelta, a un mal reconocimiento o a un ensamblaje inadecuado. El JSON detallado permite investigar; la puntuación global por sí sola no indica dónde mirar.
Leer las métricas antes de los resultados
Ahora tenemos dos objetos: el texto esperado y el texto reconocido. Antes de comparar sus puntuaciones, hay que precisar qué considera el programa una diferencia.
Una normalización que cambia la comparación
La función normalize aplica NFKC, pasa a minúsculas, recupera los grupos de caracteres \w+ y después los une con un espacio.
NFKC es una normalización Unicode que armoniza determinadas representaciones equivalentes o compatibles de los caracteres. No corrige los errores OCR. El patrón \w conserva los caracteres alfanuméricos Unicode y el guion bajo _; el guion -, el punto y la coma no forman parte de él. Estos comportamientos están documentados por Python para unicodedata y re.
Estos son ejemplos pedagógicos del resultado de esta función, y no salidas OCR capturadas:
Reference REF-000  →  reference ref 000
Total EUR 10.00    →  total eur 10 00
Total EUR 10,00    →  total eur 10 00
El punto y la coma desaparecen como signos distintivos, pero los grupos siguen separados por espacios. Decir que la puntuación «ya no cuenta» no significa, por tanto, que todas las diferencias de separación se vuelvan invisibles: 10.00 se convierte en 10 00, mientras que 1000 sigue siendo 1000.
El CER r3 evalúa este texto normalizado, no una reproducción carácter por carácter del texto bruto. En el ejemplo anterior, un punto y una coma decimal proporcionan la misma cadena normalizada. Los controles de campos, por su parte, siguen examinando el texto bruto.
El cálculo, sin caja negra
"""Normalisation déclarée et distance de Levenshtein par programmation dynamique."""
import re
import unicodedata


def normalize(text):
    return " ".join(re.findall(r"\w+", unicodedata.normalize("NFKC", text).lower()))


def distance(reference, hypothesis):
    row = list(range(len(hypothesis) + 1))
    for i, expected in enumerate(reference, 1):
        following = [i]
        for j, actual in enumerate(hypothesis, 1):
            following.append(
                min(
                    following[-1] + 1,
                    row[j] + 1,
                    row[j - 1] + (expected != actual),
                )
            )
        row = following
    return row[-1]


def evaluate(rows):
    test = [row for row in rows if row["split"] == "test"]
    errors = sum(
        distance(normalize(row["reference"]), normalize(row["text"]))
        for row in test
    )
    characters = sum(len(normalize(row["reference"])) for row in test)

    if not characters:
        raise ValueError("Références vides")

    return {
        "evaluated": len(test),
        "character_errors": errors,
        "reference_characters": characters,
        "cer": errors / characters,
        "reference_exact": sum(row["ref"] in row["text"] for row in test) / len(test),
        "amount_exact": sum(row["amount"] in row["text"] for row in test) / len(test),
        "mean_ocr_ms": 1000 * sum(row["seconds"] for row in test) / len(test),
    }
distance calcula progresivamente el número mínimo de modificaciones entre dos cadenas. Para cada pareja de caracteres, conserva la opción menos costosa entre insertar, eliminar o sustituir. Si ambos caracteres son iguales, el coste de la sustitución es cero; de lo contrario, vale uno.
Esto es programación dinámica: el cálculo reutiliza resultados intermedios en vez de reiniciar cada comparación desde el principio. row conserva la fila anterior de este cálculo y following construye la siguiente. No necesita reimplementar el algoritmo para interpretar la puntuación, pero aquí puede ver cómo se cuentan los errores.
Los valores de evaluate, uno a uno
La primera línea de evaluate solo conserva las entradas cuyo split vale test, es decir, split == "test". Las 50 imágenes se leen, pero las puntuaciones y mean_ocr_ms de este balance se refieren a las 40 imágenes de prueba.
character_errors suma las distancias entre textos normalizados. reference_characters suma las longitudes de los textos esperados normalizados. Su cociente da cer. El control Références vides (referencias vacías) impide calcular una proporción sin caracteres de referencia.
Atención a los nombres: row["reference"] es el texto completo esperado, mientras que row["ref"] es la referencia de negocio, por ejemplo REF-000. Por tanto, el CER se aplica a las tres líneas del documento, no solo al código de producto.
reference_exact mide la proporción de imágenes en las que la referencia esperada está presente en el texto bruto. amount_exact realiza la misma búsqueda para el importe. Por último, mean_ocr_ms convierte segundos a milisegundos y calcula su media sobre las entradas de prueba.
La pequeña trampa de la palabra «exacto»
El nombre amount_exact puede dar la impresión de que validamos un campo extraído. Sin embargo, observe su expresión: row["amount"] in row["text"]. Solo formula la pregunta «¿aparece esta secuencia exacta de caracteres en algún lugar?».
Tomemos un contraejemplo pedagógico, que no es un error observado en r3: la cadena 10.00 también está contenida en 110.00. Por tanto, esta búsqueda podría tener éxito aunque el importe completo sea diferente. A la inversa, 10,00 no contiene 10.00, incluso si una aplicación prevé tratar ambas escrituras como el mismo número.
Estos ejemplos no modifican ni el código ni los resultados del tutorial. Explican por qué hablamos de presencia del importe y no de «extracción del importe correcta al 100 %».
Un CER bajo tampoco garantiza que todos los errores carezcan de consecuencias. Una sola letra puede romper una referencia; una sola cifra puede cambiar un valor importante. Por eso también hay que leer el texto, las cajas y los campos esperados en los casos que importan.
Comprobar entradas particulares y calcular después el balance
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
negatives comprueba el comportamiento con una imagen blanca y un archivo no válido. La idea se parece a las pruebas de API sobre un contenido vacío o un archivo mal formado: no limitarse a las entradas que funcionan bien.
Después, evaluate escribe outputs/evaluation.json, con el CER, los controles de referencia e importe y la duración OCR media. Estos valores deben leerse con sus definiciones, no como una nota general atribuida al motor.
Resultados r3 y límites de su interpretación
Lo que las dos reproducciones midieron realmente
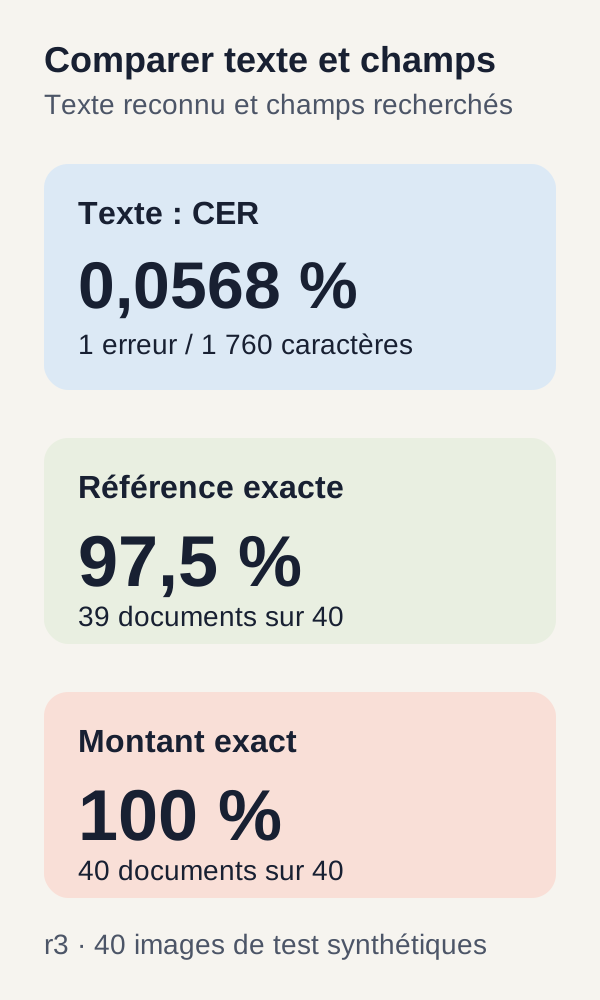
Las dos reproducciones evaluaron las mismas 40 imágenes de prueba. Encontraron un error en 1 760 caracteres de referencia normalizados. Los resultados comunicados son los siguientes:
| Medida | Primera reproducción | Segunda reproducción |
|---|---|---|
| Imágenes de prueba evaluadas | 40 | 40 |
| Errores de caracteres | 1 | 1 |
| Caracteres de referencia | 1 760 | 1 760 |
| CER micro | 0,0005681818181818182 |
0,0005681818181818182 |
| CER expresado en porcentaje | Aproximadamente 0,0568 % | Aproximadamente 0,0568 % |
| Referencia presente en el texto bruto | 97,5 % | 97,5 % |
| Importe presente en el texto bruto | 100 % | 100 % |
| Latencia OCR media en la prueba | 30,35 ms | 31,33 ms |
| Máximo de VRAM muestreado | 600 Mio | 564 Mio |
| Duración del recorrido completo, adquisición incluida | 87,04 s | 49,65 s |
El cálculo del CER se lee sencillamente: 1 ÷ 1 760 = 0,0005681818181818182, es decir, aproximadamente 0,0568 % después de multiplicar por 100.
En 40 imágenes, 97,5 % corresponde a 39 imágenes en las que está presente la referencia esperada. Es otra forma de leer la misma medida, no una prueba adicional. Del mismo modo, el importe está presente en las 40 imágenes según el control por subcadena. Esto no valida un analizador de facturas.
Las dos reproducciones muestran la repetición del recorrido sobre este conjunto. No constituyen dos conjuntos independientes de documentos: las 40 imágenes de prueba son las mismas.
Leer bien las mediciones de tiempo y memoria
La latencia corresponde aquí a la duración de una lectura OCR, con las exclusiones descritas anteriormente. La duración del recorrido completo incluye más trabajo, en particular la adquisición. La segunda compilación reutilizó capas Docker públicas: los 87,04 s y 49,65 s no son, por tanto, dos instalaciones completamente sin caché.
La VRAM es la memoria de la tarjeta gráfica. Los máximos de 600 Mio y 564 Mio proceden de un muestreo realizado aproximadamente una vez por segundo en la RTX 3090 utilizada. Un pico entre dos lecturas puede no verse. Estos valores no son picos reales garantizados ni un dimensionamiento mínimo de tarjeta.
Estas cifras no miden el tráfico comprimido, el espacio Docker exclusivo tras deduplicación ni el comportamiento bajo carga. Tampoco permiten prometer la misma latencia para varios usuarios simultáneos o para documentos más grandes.
¿La rotación «redujo la calidad»?
Las 16 imágenes limpias de la prueba dan un CER de 0. Los grupos de rotación, ruido y contraste contienen cada uno 8 imágenes. El grupo de rotación contiene un error, con un CER de 0,002840909090909091 y una referencia presente en el 87,5 % de los casos. Los importes siguen presentes en todos los grupos.
Podríamos sentirnos tentados de concluir: «la rotación explica el error». Pero las referencias cambian de un grupo a otro. No comparamos exactamente el mismo documento antes y después de la rotación.
Estos grupos no están emparejados: sus diferencias no se refieren únicamente a la transformación de la imagen. La conclusión sigue siendo descriptiva —se observó un error en el grupo de rotación de este conjunto— y no causal. Para aislar el efecto de la rotación haría falta otro protocolo, descrito en el ejercicio.
Lo que hemos aprendido
Hemos construido una cadena completa a pequeña escala: definir el contenido esperado, fabricar las imágenes, comprobar las entradas, localizar el texto, reconocer los caracteres y calcular métricas cuyo código podemos leer.
Para un desarrollador web que descubre la IA, el cambio principal está ahí: una salida del modelo debe observarse y evaluarse, no solo consumirse porque tiene la forma correcta. El JSON facilita la integración; no garantiza la exactitud de su contenido.
El CER describe una parte de la diferencia textual. Los controles de referencia e importe plantean otras preguntas, pero siguen siendo búsquedas de presencia. Ninguno de estos elementos sustituye por sí solo la validación de negocio.
Las dos reproducciones r3 validan este recorrido local sobre 50 imágenes sintéticas, de las cuales 40 son de prueba. No validan ni un analizador de facturas ni un rendimiento universal en documentos reales. Precisamente este perímetro limitado nos permite entender qué medimos antes de complicar el proyecto.
Ejercicio: predecir, modificar, ejecutar, observar, explicar
Primero, haga una predicción
Antes de ejecutar el comando, retome la distribución de los datos. Con ocho plantillas de prueba, dos imágenes limpias por plantilla y una imagen de cada otra variante, ¿cuántos resultados espera en cada grupo?
Segunda pregunta: si el grupo de rotación contiene más errores, ¿ha demostrado que la rotación es la causa? Escriba su respuesta antes de leer las salidas.
Ejecute y observe
docker compose run --rm --no-deps app -m src.cli exercise
Compare su predicción con las métricas por grupo. clean tiene 16 imágenes; rotation, noise y contrast tienen 8 cada uno. Explique este recuento a partir de las plantillas, en vez de memorizarlo.
El comando exercise no modifica el modelo ni ejecuta un nuevo entrenamiento. Agrupa las salidas ya obtenidas. La parte «modificar» del ejercicio interviene en la experiencia separada propuesta más abajo, no en este comando.
La conclusión esperada es que los grupos describen los datos proporcionados. No es que la rotación provoque una bajada universal de calidad.
Para probar una causa, cambie el protocolo en una copia
Una comparación emparejada consistiría en representar exactamente el mismo texto en una imagen limpia y en una imagen girada. Ambas imágenes formarían una pareja. Entonces podría comparar sus errores conservando la referencia, el importe y los demás parámetros.
Trabaje en una carpeta separada y haga variar un único factor cada vez. Prevea la nueva generación de imágenes, su paso por el OCR y las nuevas mediciones. Modificar solo la agrupación de las salidas antiguas no crea esas parejas.
Esta propuesta no se ejecutó en r3. Constituye una experiencia nueva, sin resultado anunciado de antemano. Su interés es aprender a formular una pregunta que los datos permitan resolver realmente.
Su experiencia separada, sin resultado anunciado de antemano
Para probar sus propios documentos, cree una carpeta de trabajo distinta y conserve el archivo r3 sin cambios. De este modo mantendrá un punto de comparación cuyo contenido y comportamiento esperado conoce.
Antes de iniciar el OCR, describa el tipo de documentos, la calidad de digitalización, los idiomas, las orientaciones y las reglas de verdad de terreno. Precise también el coste de un error: una referencia que no se encuentra y un importe erróneo no tienen necesariamente las mismas consecuencias en su aplicación.
Elija sus métricas antes de mirar los resultados. Podría medir los errores de referencia, los errores de importe, la tasa de rechazo y el resultado de una revisión humana. Un rechazo correspondería entonces a un documento que su aplicación se niega a tratar automáticamente según una regla que hay que definir; este mecanismo no lo proporciona el simple cálculo del CER.
Escaneos, tablas, columnas, logotipos, escritura manuscrita e imágenes degradadas cambian el problema. Por tanto, no anuncie ninguna puntuación antes de medir. Si añade un analizador de importes o un umbral de confianza, evalúe esta nueva etapa por separado: la confianza de EasyOCR no está calibrada aquí como una probabilidad de exactitud de negocio.
Solución de problemas útil
nvidia-smi absent (nvidia-smi ausente). Instale o repare el controlador NVIDIA y vuelva a ejecutar el preflight. Mientras falle esta comprobación, continúe el diagnóstico del entorno en lugar del de las imágenes.
GPU detectada en Linux, pero no en Docker. Configure NVIDIA Container Toolkit y compruebe que GPU_DEVICE designa la tarjeta esperada. La visibilidad del hardware en el host y su exposición al contenedor son dos controles distintos.
Fallo de fetch. Compruebe la red y los hashes. No sortee los controles de tamaño o SHA-256 para hacer desaparecer el error: perdería el vínculo con los recursos del recorrido validado.
GPU CUDA requis (GPU CUDA requerida). Compruebe el controlador, la exposición de la GPU en Docker y GPU_DEVICE, y reanude después de la adquisición completa. El código se niega deliberadamente a continuar sin CUDA.
Image modifiée depuis prepare (imagen modificada desde prepare). Vuelva a ejecutar prepare antes de ocr. No edite los PNG entre estas etapas en la reproducción de referencia: el control sirve precisamente para detectar una diferencia entre la imagen preparada y la imagen medida.
Cajas u orden de lectura inesperados. Abra outputs/ocr.json y los PNG asociados. El texto unido sigue el orden devuelto por el motor; no resuelve automáticamente los documentos con columnas. Empiece por determinar si el problema procede de la zona devuelta, de los caracteres reconocidos o del ensamblaje del texto.
Lo que falta antes de una producción documental
En una aplicación real, el OCR sería un componente de un tratamiento más amplio. La cadena debería gestionar los formatos realmente recibidos, la orientación, el enderezamiento de imágenes, la calidad del escaneo, las maquetaciones, las tablas, los idiomas y los manuscritos necesarios para su ámbito.
La etapa siguiente sería asociar los campos de forma fiable: determinar qué valor corresponde a qué etiqueta, validar las reglas de número y divisa, calibrar los rechazos y prever una revisión humana cuando el coste de un error lo justifique. Leer dos importes en la misma imagen no basta para determinar cuál debe rellenar el campo «total» de su aplicación.
También queda todo el trabajo habitual de una aplicación web: ingestión segura, autenticación, derechos documentales, cuotas, almacenamiento, reglas de retención, supervisión, copia de seguridad y restauración. Las mediciones de carga y concurrencia deben aplicarse al servicio completo, no solo a una lectura OCR aislada.
Por último, la evaluación debe usar documentos representativos, repartidos según los casos importantes: tipos de documentos, idiomas, calidades de escaneo o dificultades de maquetación. Ese es el sentido de una evaluación estratificada. Las 40 imágenes sintéticas de prueba no la sustituyen.
Limpieza exacta
Al final del recorrido, ejecute este comando desde la raíz del archivo:
docker compose down
Pertenece al recorrido r3 validado. Detiene los recursos Compose del proyecto y elimina los contenedores y redes afectados, sin eliminar los modelos, la imagen Docker ni las salidas. El comportamiento de limpieza por defecto se describe en la documentación de docker compose down.
Conserve los JSON y los PNG mientras los necesite para releer los resultados. Elimine sus pruebas separadas solo después de comprobar su contenido. No es necesaria una purga global de Docker para terminar este tutorial.