





Imaginez un formulaire dans votre application : l'utilisateur dépose l'image d'un document, et vous aimeriez préremplir une référence et un montant. Pour votre code métier, ce sont deux chaînes à vérifier. Mais, dans le fichier envoyé, ces informations ne sont encore que des pixels. Comment passer de l'un à l'autre ?
C'est le rôle de l'OCR, la reconnaissance optique de caractères. Nous allons construire une petite chaîne locale avec Python, Docker et EasyOCR, puis regarder ce qu'elle lit réellement. Pas seulement un texte qui semble correct à l'écran : nous conserverons aussi les zones repérées, les scores du moteur et les erreurs mesurées.
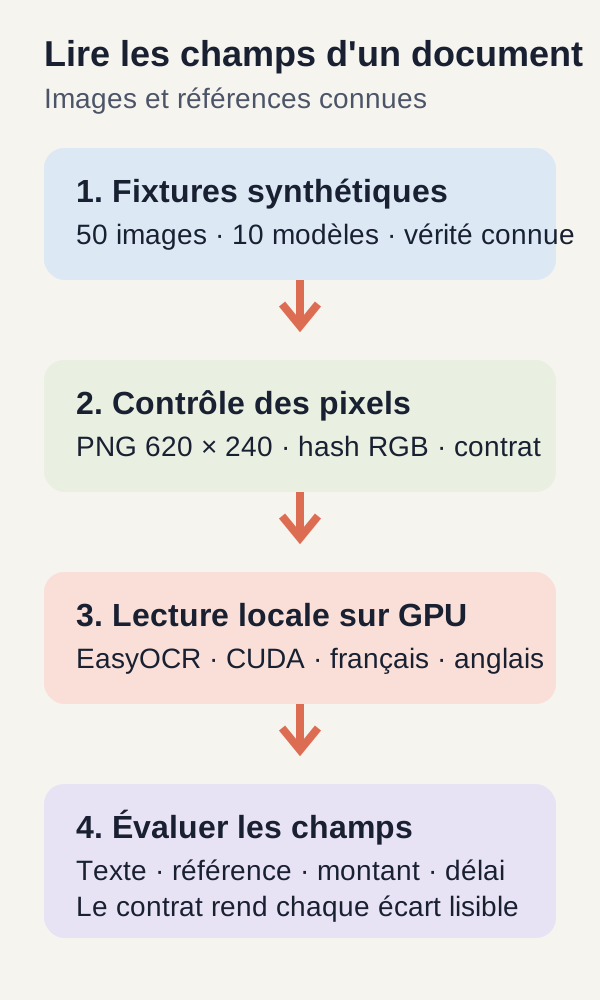
Pour commencer sans manipuler de documents privés, le projet fabrique 50 images synthétiques dont nous connaissons déjà le contenu. Il les lit sur un GPU CUDA, puis calcule son bilan sur 40 images réservées au test. Cette distinction entre ce que nous attendons et ce que le modèle produit sera notre fil conducteur.
Télécharger le projet complet du tutoriel.
Les résultats présentés viennent de deux reproductions validées de cette archive r3, dans des répertoires neufs. Les exemples ajoutés pour expliquer une notion sont signalés comme tels : ils ne remplacent pas les sorties mesurées du projet.
Le problème et le résultat attendu
Lire un texte n'est pas encore comprendre un document
Un OCR, pour optical character recognition, répond à deux questions successives : où y a-t-il du texte dans l'image ?, puis quels caractères se trouvent dans ces zones ?
La première étape est la détection. La seconde est la reconnaissance. Le texte final peut ensuite être constitué en réunissant les fragments obtenus. C'est cette séparation que l'on retrouve dans l'API d'EasyOCR, avec les opérations de détection et de reconnaissance.
Prenons une situation illustrative : vous voyez « Total EUR 10.00 » sur une image. Pour votre application, il reste plusieurs questions. Le moteur a-t-il lu tous les chiffres ? A-t-il conservé le séparateur décimal ? Ce montant est-il le total, un sous-total ou une autre valeur présente dans le document ?
Reconnaître des caractères et extraire un champ métier sont donc deux étapes différentes. Notre tutoriel construit et évalue la première chaîne ; ses contrôles de référence et de montant restent volontairement simples.
Les fichiers que vous allez obtenir
À la fin du parcours, outputs/images/ contiendra les 50 PNG. outputs/prepared.json reliera les images à leur texte attendu et à leur empreinte de contrôle. outputs/ocr.json conservera, pour chaque image, les boîtes de texte, les textes reconnus, les confiances et les temps mesurés. Enfin, outputs/evaluation.json contiendra le bilan des 40 images de test seulement.
Pour un développeur web, pensez à un test d'intégration : vous préparez des données connues, vous faites passer une entrée dans le système, puis vous comparez la réponse à ce qui était attendu. Ici, l'entrée n'est pas un formulaire JSON mais une image, et le résultat peut contenir des erreurs de lecture.
Prérequis GPU, Docker et ressources
Le parcours r3 a été validé sous Linux amd64, autrement dit l'architecture x86_64, avec Docker Engine, Docker Compose, un pilote NVIDIA, nvidia-smi et NVIDIA Container Toolkit. Les mesures de cet article ont été réalisées sur une RTX 3090.
Le GPU est la carte utilisée pour accélérer les calculs du modèle. CUDA est l'environnement de calcul NVIDIA employé dans ce projet. NVIDIA Container Toolkit permet de rendre cet accès disponible depuis Docker ; une carte visible sur Linux ne l'est pas nécessairement dans un conteneur. Son installation est décrite dans le guide officiel NVIDIA.
Ce parcours d'inférence est CUDA uniquement. Il ne propose pas de repli CPU validé. Dans le fichier .env fourni, définissez GPU_DEVICE avant le démarrage si vous devez exposer une autre carte que la carte 0.
Le préflight, c'est-à-dire le contrôle préalable, demande 20 Gio libres sur le disque du projet et le stockage Docker, ainsi que 12 Gio de RAM disponible. Le conteneur de l'application est, lui, plafonné à 8 Gio de mémoire, 4 CPU et 256 processus. Les Gio et Mio sont des unités binaires de capacité mémoire ou disque.
Ne confondez pas ces valeurs : les seuils du préflight concernent les ressources disponibles sur l'hôte ; le plafond du conteneur limite ce que l'application peut utiliser. La RAM est la mémoire principale de la machine, pas la VRAM de la carte graphique.
Après extraction du ZIP, depuis la racine du projet, commencez par :
./scripts/preflight.sh
Ce script vérifie Linux, Docker, Compose, la carte choisie, l'initialisation CUDA depuis Docker, la RAM et l'espace disque. Il ne configure pas votre système à votre place. S'il détecte le GPU sur l'hôte mais pas dans Docker, configurez NVIDIA Container Toolkit, puis relancez le contrôle.
Ces vérifications définissent les conditions du parcours. Elles ne promettent ni une compatibilité avec chaque carte CUDA, ni des temps identiques sur toutes les machines.
Les données avant l'OCR
Pourquoi fabriquer nous-mêmes les documents ?
Avant de mesurer une lecture, il nous faut une réponse de référence. En apprentissage automatique, on parle souvent de vérité terrain : l'information considérée comme correcte, à laquelle nous comparons la sortie du modèle.
Le fichier data/fixtures.json contient 50 fiches synthétiques. Une fixture est simplement un jeu de données préparé pour un test, comme ceux que vous utilisez pour remplir une base de développement. Voici la première fiche du projet :
{
  "id": 0,
  "template": 0,
  "split": "dev",
  "variant": "clean",
  "ref": "REF-000",
  "amount": "10.00"
}
id identifie l'image. template désigne son gabarit. split indique l'ensemble auquel elle appartient, ici le développement. variant choisit l'aspect de l'image. Enfin, ref et amount donnent les valeurs attendues avant toute reconnaissance.
src/images.py transforme cette fiche en trois lignes :
BOUTIQUE 0
Reference REF-000
Total EUR 10.00
Il ne s'agit pas ici d'une sortie OCR, mais du texte que le générateur dessine. Nous connaissons donc la réponse sans la demander au moteur que nous voulons évaluer. L'OCR reçoit les pixels ; la référence reste disponible pour la comparaison ultérieure.
Des variations contrôlées, pas de vraies factures
Chaque image RGB mesure 620 × 240 pixels et utilise la police DejaVu Sans à 28 pixels. RGB signifie que chaque pixel est représenté par ses composantes rouge, verte et bleue.
Le générateur applique l'une des quatre variantes : une image propre, une rotation de 3 degrés, un contraste réglé à 0,4, ou un bruit gaussien d'écart-type 12. Le bruit ajoute des variations aux valeurs des pixels. Sa graine, 42 + id, permet de reproduire le même bruit pour une fiche donnée dans l'environnement fixé.
Le mot gabarit ne désigne pas dix mises en page de factures réalistes. Dans le code présenté plus loin, le numéro change notamment la ligne « BOUTIQUE » et le décalage horizontal du texte. Toutes les images restent des fiches simples de trois lignes.
Pourquoi séparer développement et test ?
Les dix gabarits sont répartis en deux ensembles sans recouvrement : deux gabarits pour le développement, soit 10 images, et huit pour le test, soit 40 images. Un même gabarit n'appartient pas aux deux ensembles.
L'idée est de distinguer les exemples qui servent à mettre au point le parcours de ceux qui servent à en mesurer le résultat. Cela ne signifie pas que nous entraînons EasyOCR sur les dix images de développement : nous utilisons ici des modèles déjà entraînés, sans modifier leurs poids.
Attention aussi à la taille des groupes de test :
| Variante | Images par gabarit de test | Total sur les 8 gabarits de test |
|---|---|---|
clean : image propre |
2 | 16 |
rotation : rotation de 3 degrés |
1 | 8 |
noise : bruit gaussien |
1 | 8 |
contrast : contraste à 0,4 |
1 | 8 |
| Total | 5 | 40 |
Les annotations et les images sont entièrement synthétiques : aucun document privé n'est exposé. En contrepartie, ce jeu ne représente ni des factures numérisées, ni des mises en page complexes, ni de l'écriture manuscrite. La séparation des gabarits ne supprime pas cette limite.
Installer, acquérir et préparer les images
Extrayez l'archive et placez-vous à sa racine. Les commandes suivantes se lancent depuis ce répertoire, dans l'ordre indiqué. Elles correspondent au début de chacune des deux reproductions r3 ; le contrôle préalable est repris pour présenter le parcours complet :
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app -m src.cli prepare
Que fait chaque étape ?
setup.sh prépare les dossiers avec l'identité de l'utilisateur courant. docker compose build construit l'image Python 3.12.13 verrouillée par le projet. Les dépendances comprennent PyTorch 2.10.0+cu129, torchvision 0.25.0+cu129 et EasyOCR 1.7.2.
PyTorch fournit le moteur de calcul utilisé par EasyOCR ; torchvision fait partie de la pile installée pour les traitements de vision. Les versions ci-dessus sont celles du parcours validé, pas une invitation à les remplacer par les dernières disponibles. L'image Python est documentée sur Docker Hub, et les paquets PyTorch CUDA concernés sont publiés dans l'index cu129.
Le service fetch acquiert les ressources publiques. Il récupère notamment les poids EasyOCR craft_mlt_25k et latin_g2 depuis les releases officielles JaidedAI. Les poids sont les paramètres numériques appris par les modèles avant ce tutoriel. Les charger permet de faire une inférence : appliquer un modèle déjà entraîné à une nouvelle image.
Le projet contrôle la taille et le SHA-256 des archives ainsi que des poids extraits. Cette empreinte permet de vérifier que les fichiers correspondent à ceux attendus. La première acquisition validée représente 91 536 692 octets.
fetch est le seul service doté d'un réseau bridge pour cette acquisition. L'application utilise ensuite un réseau Docker interne, monte les modèles en lecture seule et n'écrit que les sorties. La séparation évite de mélanger téléchargement des ressources et traitement des images.
Les tests viennent avant le parcours mesuré
La commande unittest doit faire réussir les 15 tests publics. Ils vérifient notamment la population des données, la séparation des gabarits, le rendu déterministe, le calcul de la métrique et les erreurs d'image. Ils comprennent également une vraie détection et reconnaissance sur CUDA.
Ce dernier point compte : voir une carte dans Docker ne prouve pas que le détecteur l'utilise. Le test inspecte l'appareil sur lequel il se trouve. Ces vérifications peuvent donc déjà solliciter le modèle ; elles précèdent les lectures chronométrées du parcours principal.
Enfin, prepare écrit les 50 PNG et outputs/prepared.json, avec le hash RGB et le texte de référence associés à chaque image. À ce stade, vous pouvez regarder les images que le moteur devra lire.
Dans les commandes Compose, run lance une tâche ponctuelle, --rm retire son conteneur après exécution et --no-deps évite de lancer automatiquement les services liés. Les résultats enregistrés dans les dossiers montés restent disponibles. Ces options sont détaillées dans la documentation Docker Compose.
Vocabulaire utile avant de lire le code
Une boîte, un texte et une confiance
Dans ce projet, EasyOCR utilise CRAFT pour localiser les régions de texte et le reconnaisseur latin_g2 pour lire leurs caractères. Le lecteur est configuré avec les langues fr et en. Retenez surtout la séparation des rôles : localiser une zone n'est pas encore réussir à la lire.
Pour chaque zone renvoyée, nous conservons une boîte définie par quatre points, le texte reconnu et un score de confiance. Pour visualiser cette structure, voici un objet inventé à titre pédagogique. Ses coordonnées et sa confiance ne sont pas des mesures r3 :
{
  "box": [[20.0, 80.0], [330.0, 80.0], [330.0, 110.0], [20.0, 110.0]],
  "text": "Reference REF-000",
  "confidence": 0.98
}
Les quatre points délimitent la région concernée. Le texte indique ce que le moteur y a lu. La confiance est un score interne : 0.98 ne signifie pas que votre champ métier a 98 % de chances d'être correct.
Pour interpréter ce score comme une probabilité d'exactitude, il faudrait vérifier cette correspondance sur des données représentatives : c'est le rôle d'une calibration. Le parcours r3 n'effectue pas ce travail et ne définit pas un seuil de confiance garantissant l'exactitude d'un montant.
Le CER : compter les erreurs de caractères
Le CER, pour character error rate, compare le texte reconnu au texte attendu. Il utilise la distance de Levenshtein : le nombre minimal d'insertions, de suppressions et de substitutions de caractères nécessaires pour passer d'un texte à l'autre.
Illustration indépendante des résultats r3 : passer de REF-000 à REF-00O demande de remplacer le dernier zéro par la lettre O. Cela représente une substitution. Pour une recherche de produit, ce seul caractère peut pourtant empêcher de retrouver la bonne référence.
Le CER divise le nombre d'erreurs par le nombre de caractères attendus. Un CER de zéro signifie qu'aucune différence n'a été comptée selon les règles de comparaison utilisées. Ces règles sont importantes : r3 normalise les textes avant de les comparer, comme nous allons le voir dans le code.
Le bilan utilise un CER micro : on additionne les erreurs de toutes les images de test, puis on divise par le total de leurs caractères de référence. Ce n'est pas une moyenne simple des CER par image. Un texte attendu plus long pèse davantage dans le total.
Les contrôles de champs : utiles, mais limités
Le programme vérifie séparément si REF-xxx et le montant attendu sont présents dans le texte brut. Il s'agit de recherches par sous-chaîne, pas d'un parseur de facture.
Ces contrôles ne vérifient pas la position d'une valeur sur la page, la devise, le format numérique ou l'association entre une étiquette et son contenu. Une valeur peut être présente quelque part sans être le champ que l'application devait extraire. Gardez cette nuance en tête quand nous lirons les pourcentages.
Générer les images et vérifier leurs octets
La fonction render transforme une fixture en pixels. Elle renvoie l'image, le texte attendu et une empreinte SHA-256 calculée sur les octets RGB. Voici le code du projet, avec une mise en forme aérée :
"""Fiches synthétiques déterministes ; annotations indépendantes de l’OCR."""
import hashlib
import numpy as np
from PIL import Image, ImageDraw, ImageFont, ImageEnhance


def render(fixture):
    lines = [
        f'BOUTIQUE {fixture["template"]}',
        f'Reference {fixture["ref"]}',
        f'Total EUR {fixture["amount"]}',
    ]
    image = Image.new("RGB", (620, 240), "white")
    draw = ImageDraw.Draw(image)
    font = ImageFont.truetype("data/DejaVuSans.ttf", 28)

    for index, text in enumerate(lines):
        draw.text(
            (20 + fixture["template"] * 3, 20 + index * 60),
            text,
            font=font,
            fill="black",
        )

    if fixture["variant"] == "rotation":
        image = image.rotate(
            3,
            resample=Image.Resampling.BICUBIC,
            fillcolor="white",
        )

    if fixture["variant"] == "contrast":
        image = ImageEnhance.Contrast(image).enhance(0.4)

    array = np.array(image)

    if fixture["variant"] == "noise":
        noise = np.random.default_rng(42 + fixture["id"]).normal(
            0, 12, array.shape
        )
        array = np.clip(array.astype(float) + noise, 0, 255).astype("uint8")

    return (
        Image.fromarray(array),
        " ".join(lines),
        hashlib.sha256(array.tobytes()).hexdigest(),
    )


def load_image(path):
    with Image.open(path) as image:
        if not 0 < image.width <= 4096 or not 0 < image.height <= 4096:
            raise ValueError("Dimensions image hors plage")
        return np.array(image.convert("RGB"))
Du JSON aux pixels
La liste lines construit les trois lignes à partir de la fixture. Image.new crée un fond blanc de 620 × 240 pixels, puis ImageDraw y dessine le texte. La position horizontale dépend du gabarit ; la position verticale augmente de 60 pixels à chaque ligne.
Les conditions suivantes choisissent la transformation. Une fiche rotation reçoit la rotation de 3 degrés ; une fiche contrast reçoit le facteur 0,4. Pour le bruit, l'image devient un tableau NumPy : les couleurs des pixels sont alors des nombres sur lesquels nous pouvons effectuer des opérations.
np.random.default_rng(42 + fixture["id"]) initialise le générateur aléatoire à partir d'une graine liée à l'image. normal(0, 12, array.shape) produit le bruit gaussien prévu par le protocole. Après son ajout, np.clip ramène les valeurs entre 0 et 255, puis uint8 les représente comme des entiers non signés sur huit bits.
Le point important n'est pas de mémoriser chaque appel : à fixture identique, nous voulons retrouver les mêmes pixels dans l'environnement fixé. Sinon, nous pourrions attribuer au modèle un écart qui vient en réalité d'une image différente.
Pourquoi calculer un hash des pixels ?
Le SHA-256 est une empreinte calculée à partir d'octets. Ici, array.tobytes() fournit ceux des pixels, et hexdigest() produit leur empreinte sous forme de texte. La documentation Python de hashlib décrit ces opérations.
prepare sauvegarde le PNG et cette empreinte dans outputs/prepared.json. Avant chaque appel OCR, src.cli recharge le PNG en RGB et recalcule son hash. Si l'empreinte diffère, l'étape échoue.
Le contrôle porte sur les pixels RGB, pas sur l'ensemble des octets du fichier PNG. Il permet de vérifier que le contenu visuel utilisé pour la mesure correspond à celui préparé. Il ne constitue pas, à lui seul, une protection de toute une chaîne documentaire contre une modification malveillante.
load_image ajoute un contrôle d'entrée : largeur et hauteur doivent chacune être comprises entre 1 et 4096 pixels. L'image est ensuite convertie en RGB. Comme pour un fichier reçu par un formulaire, nous vérifions ce que nous allons traiter avant de l'envoyer à l'étape suivante ; ce contrôle de dimensions n'est toutefois pas une politique complète d'acceptation de fichiers.
Charger EasyOCR et conserver ce qu'il renvoie
Les images sont prêtes. Il reste à charger les modèles et à leur soumettre les pixels :
import torch
import easyocr


class Reader:
    def __init__(self):
        if not torch.cuda.is_available():
            raise RuntimeError("GPU CUDA requis")

        torch.set_num_threads(4)
        self.reader = easyocr.Reader(
            ["fr", "en"],
            gpu=True,
            model_storage_directory="/models/ocr",
            user_network_directory="/tmp/networks",
            download_enabled=False,
            verbose=False,
        )

    def read(self, array):
        boxes = self.reader.readtext(array, paragraph=False, workers=0)
        return [
            {
                "box": [[float(x), float(y)] for x, y in box],
                "text": text,
                "confidence": float(confidence),
            }
            for box, text, confidence in boxes
        ]
Lire le constructeur comme une configuration de service
La première condition refuse de continuer si CUDA n'est pas disponible. Nous ne basculons donc pas silencieusement vers un autre mode de calcul.
torch.set_num_threads(4) règle le parallélisme des opérations PyTorch sur CPU ; il ne désigne pas quatre GPU. C'est le rôle décrit par la documentation PyTorch 2.10.
Le lecteur charge les langues fr et en, active le GPU et utilise les poids présents dans /models/ocr. Avec download_enabled=False, il ne peut pas télécharger un poids manquant pendant l'inférence. Un fichier absent doit donc être résolu lors de l'acquisition, pas masqué par un téléchargement implicite au milieu d'une mesure.
Ne pas jeter les informations qui expliquent une erreur
Dans read, readtext reçoit le tableau de pixels. paragraph=False désactive le regroupement en paragraphes ; workers=0 conserve le réglage de chargement prévu par le projet. Les paramètres sont décrits dans la référence de l'API EasyOCR.
Notre méthode transforme ensuite toutes les boîtes renvoyées par readtext en dictionnaires, sans sélection supplémentaire des meilleurs résultats. Les coordonnées et les confiances sont converties en nombres Python pour la sortie JSON. Cela ne signifie pas que le moteur n'a aucun filtre interne : nous conservons ce qu'il renvoie, plutôt que de choisir a posteriori les seules lectures favorables.
Le texte final est obtenu en joignant les fragments dans l'ordre reçu. Pour nos trois lignes, cet ordre fait partie du résultat évalué. Pour des colonnes ou un tableau, il peut être insuffisant : des fragments bien reconnus mais assemblés dans le mauvais ordre ne reconstituent pas nécessairement le document.
Lancer la reconnaissance
docker compose run --rm --no-deps app -m src.cli ocr
La commande contrôle d'abord le hash RGB de chaque image préparée, puis écrit outputs/ocr.json. Chaque résultat conserve les boîtes, le texte concaténé, les confiances, la durée et le GPU indiqué par le projet.
Un warm-up, ou passage de chauffe, est effectué sur l'image 0 avant les 50 lectures chronométrées. Le temps par image exclut le chargement du modèle et le rendu des PNG. Le parcours complet mesuré inclut, lui, ces étapes : nous ne parlons pas du même chronomètre.
Pour lire une sortie, rapprochez le PNG, ses boîtes et son texte. Une référence absente du texte peut venir d'une zone non renvoyée, d'une mauvaise reconnaissance ou d'un assemblage inadéquat. Le JSON détaillé permet d'enquêter ; le score global, seul, ne dit pas où regarder.
Lire les métriques avant les résultats
Nous avons maintenant deux objets : le texte attendu et le texte reconnu. Avant de comparer leurs scores, il faut préciser ce que le programme considère comme une différence.
Une normalisation qui change la comparaison
La fonction normalize applique NFKC, passe en minuscules, récupère les groupes de caractères \w+, puis les relie par un espace.
NFKC est une normalisation Unicode qui harmonise certaines représentations équivalentes ou compatibles des caractères. Elle ne corrige pas les erreurs OCR. Le motif \w conserve les caractères alphanumériques Unicode ainsi que le tiret bas _ ; le tiret -, le point et la virgule n'en font pas partie. Ces comportements sont documentés par Python pour unicodedata et re.
Voici des exemples pédagogiques du résultat de cette fonction, et non des sorties OCR capturées :
Reference REF-000  →  reference ref 000
Total EUR 10.00    →  total eur 10 00
Total EUR 10,00    →  total eur 10 00
Le point et la virgule disparaissent comme signes distincts, mais les groupes restent séparés par des espaces. Dire que la ponctuation « ne compte plus » ne signifie donc pas que toutes les différences de séparation deviennent invisibles : 10.00 devient 10 00, tandis que 1000 reste 1000.
Le CER r3 évalue ce texte normalisé, pas une reproduction caractère pour caractère du texte brut. Dans l'exemple ci-dessus, un point et une virgule décimale donnent la même chaîne normalisée. Les contrôles de champs, eux, continuent à examiner le texte brut.
Le calcul, sans boîte noire
"""Normalisation déclarée et distance de Levenshtein par programmation dynamique."""
import re
import unicodedata


def normalize(text):
    return " ".join(re.findall(r"\w+", unicodedata.normalize("NFKC", text).lower()))


def distance(reference, hypothesis):
    row = list(range(len(hypothesis) + 1))
    for i, expected in enumerate(reference, 1):
        following = [i]
        for j, actual in enumerate(hypothesis, 1):
            following.append(
                min(
                    following[-1] + 1,
                    row[j] + 1,
                    row[j - 1] + (expected != actual),
                )
            )
        row = following
    return row[-1]


def evaluate(rows):
    test = [row for row in rows if row["split"] == "test"]
    errors = sum(
        distance(normalize(row["reference"]), normalize(row["text"]))
        for row in test
    )
    characters = sum(len(normalize(row["reference"])) for row in test)

    if not characters:
        raise ValueError("Références vides")

    return {
        "evaluated": len(test),
        "character_errors": errors,
        "reference_characters": characters,
        "cer": errors / characters,
        "reference_exact": sum(row["ref"] in row["text"] for row in test) / len(test),
        "amount_exact": sum(row["amount"] in row["text"] for row in test) / len(test),
        "mean_ocr_ms": 1000 * sum(row["seconds"] for row in test) / len(test),
    }
distance calcule progressivement le nombre minimal de modifications entre deux chaînes. À chaque paire de caractères, elle retient le moins coûteux entre insérer, supprimer ou remplacer. Si les deux caractères sont égaux, le coût du remplacement est nul ; sinon, il vaut un.
C'est de la programmation dynamique : le calcul réutilise des résultats intermédiaires au lieu de recommencer chaque comparaison depuis le début. row conserve la ligne précédente de ce calcul, following construit la suivante. Vous n'avez pas besoin de réimplémenter l'algorithme pour interpréter le score, mais vous pouvez voir ici comment les erreurs sont comptées.
Les valeurs de evaluate, une par une
La première ligne de evaluate garde uniquement les entrées dont split vaut test, c’est-à-dire split == "test". Les 50 images sont lues, mais les scores et mean_ocr_ms de ce bilan concernent les 40 images de test.
character_errors additionne les distances entre textes normalisés. reference_characters additionne les longueurs des textes attendus normalisés. Leur quotient donne cer. Le contrôle Références vides empêche de calculer un ratio sans caractères de référence.
Attention aux noms : row["reference"] est le texte complet attendu, alors que row["ref"] est la référence métier, par exemple REF-000. Le CER porte donc sur les trois lignes du document, pas uniquement sur le code produit.
reference_exact mesure la proportion d'images où la référence attendue est présente dans le texte brut. amount_exact fait la même recherche pour le montant. Enfin, mean_ocr_ms convertit les secondes en millisecondes et calcule leur moyenne sur les entrées de test.
Le petit piège du mot « exact »
Le nom amount_exact peut donner l'impression que nous validons un champ extrait. Regardez pourtant son expression : row["amount"] in row["text"]. Elle pose seulement la question « cette suite exacte de caractères apparaît-elle quelque part ? »
Prenons un contre-exemple pédagogique, qui n'est pas une erreur observée dans r3 : la chaîne 10.00 est aussi contenue dans 110.00. Cette recherche pourrait donc réussir alors que le montant complet est différent. Inversement, 10,00 ne contient pas 10.00, même si une application prévoit de traiter ces deux écritures comme le même nombre.
Ces exemples ne modifient ni le code ni les résultats du tutoriel. Ils expliquent pourquoi nous parlons de présence du montant et non d'« extraction de montant correcte à 100 % ».
Un CER faible ne garantit pas non plus que toutes les erreurs soient sans conséquence. Une seule lettre peut casser une référence ; un seul chiffre peut changer une valeur importante. Il faut donc lire aussi le texte, les boîtes et les champs attendus pour les cas qui comptent.
Vérifier les entrées particulières, puis calculer le bilan
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
negatives vérifie le comportement sur une image blanche et un fichier invalide. L'idée ressemble aux tests d'API sur un contenu vide ou un fichier mal formé : ne pas se limiter aux entrées qui se passent bien.
evaluate écrit ensuite outputs/evaluation.json, avec le CER, les contrôles de référence et de montant, ainsi que la moyenne de durée OCR. Ces valeurs sont à lire avec leurs définitions, pas comme une note générale attribuée au moteur.
Résultats r3 et limites de leur interprétation
Ce que les deux reproductions ont effectivement mesuré
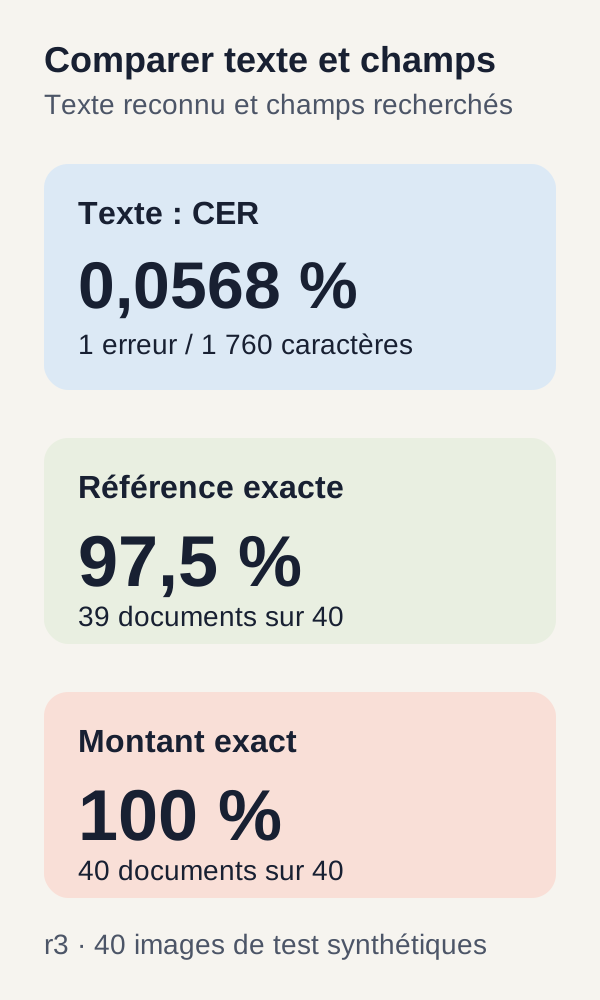
Les deux reproductions ont évalué les mêmes 40 images de test. Elles ont trouvé une erreur sur 1 760 caractères de référence normalisés. Les résultats rapportés sont les suivants :
| Mesure | Première reproduction | Seconde reproduction |
|---|---|---|
| Images de test évaluées | 40 | 40 |
| Erreurs de caractères | 1 | 1 |
| Caractères de référence | 1 760 | 1 760 |
| CER micro | 0,0005681818181818182 |
0,0005681818181818182 |
| CER exprimé en pourcentage | Environ 0,0568 % | Environ 0,0568 % |
| Référence présente dans le texte brut | 97,5 % | 97,5 % |
| Montant présent dans le texte brut | 100 % | 100 % |
| Latence moyenne OCR sur le test | 30,35 ms | 31,33 ms |
| Maximum de VRAM échantillonné | 600 Mio | 564 Mio |
| Durée du parcours complet, acquisition comprise | 87,04 s | 49,65 s |
Le calcul du CER se lit simplement : 1 ÷ 1 760 = 0,0005681818181818182, soit environ 0,0568 % après multiplication par 100.
Sur 40 images, 97,5 % correspond à 39 images où la référence attendue est présente. C'est une autre façon de lire la même mesure, pas un test supplémentaire. De même, le montant est présent dans les 40 images selon le contrôle par sous-chaîne. Cela ne valide pas un parseur de factures.
Les deux reproductions montrent la répétition du parcours sur ce jeu. Elles ne constituent pas deux jeux indépendants de documents : les 40 images de test sont les mêmes.
Bien lire les mesures de temps et de mémoire
La latence correspond ici à la durée d'une lecture OCR, avec les exclusions décrites plus haut. La durée du parcours complet inclut davantage de travail, notamment l'acquisition. Le second build a réutilisé des couches Docker publiques : les 87,04 s et 49,65 s ne sont donc pas deux installations entièrement dépourvues de cache.
La VRAM est la mémoire de la carte graphique. Les maximums de 600 Mio et 564 Mio sont issus d'un échantillonnage effectué environ une fois par seconde sur la RTX 3090 utilisée. Une pointe entre deux relevés peut ne pas être vue. Ces valeurs ne sont ni des pics réels garantis, ni un dimensionnement minimal de carte.
Ces chiffres ne mesurent pas le trafic compressé, l'espace Docker exclusif après déduplication ou le comportement sous charge. Ils ne permettent pas non plus de promettre la même latence pour plusieurs utilisateurs simultanés ou pour des documents plus grands.
La rotation a-t-elle « fait baisser la qualité » ?
Les 16 images propres du test donnent un CER de 0. Les groupes rotation, bruit et contraste contiennent chacun 8 images. Le groupe rotation comporte une erreur, avec un CER de 0,002840909090909091 et une référence présente dans 87,5 % des cas. Les montants restent présents dans tous les groupes.
On pourrait être tenté de conclure : « la rotation explique l'erreur ». Mais les références changent d'un groupe à l'autre. Nous ne comparons pas exactement le même document avant et après rotation.
Ces groupes ne sont pas appariés : leurs différences ne portent pas uniquement sur la transformation de l'image. La conclusion reste descriptive — une erreur a été observée dans le groupe rotation de ce jeu — et non causale. Pour isoler l'effet de la rotation, il faudrait un autre protocole, décrit dans l'exercice.
Ce que nous avons appris
Nous avons construit une chaîne complète à petite échelle : définir le contenu attendu, fabriquer les images, contrôler les entrées, localiser le texte, reconnaître les caractères et calculer des métriques dont nous pouvons lire le code.
Pour un développeur web qui découvre l'IA, le changement principal est là : une sortie du modèle doit être observée et évaluée, pas seulement consommée parce qu'elle a la bonne forme. Le JSON facilite l'intégration ; il ne garantit pas la justesse de son contenu.
Le CER décrit une partie de l'écart textuel. Les contrôles de référence et de montant posent d'autres questions, mais restent des recherches de présence. Aucun de ces éléments ne remplace à lui seul la validation métier.
Les deux reproductions r3 valident ce parcours local sur 50 images synthétiques, dont 40 de test. Elles ne valident ni un parseur de factures ni une performance universelle sur des documents réels. C'est précisément ce périmètre limité qui nous permet de comprendre ce que nous mesurons avant de complexifier le projet.
Exercice : prédire, modifier, lancer, observer, expliquer
D'abord, faites une prédiction
Avant d'exécuter la commande, reprenez la répartition des données. Avec huit gabarits de test, deux images propres par gabarit et une image de chaque autre variante, combien de résultats attendez-vous dans chaque groupe ?
Deuxième question : si le groupe rotation contient davantage d'erreurs, avez-vous démontré que la rotation en est la cause ? Écrivez votre réponse avant de lire les sorties.
Lancez, puis observez
docker compose run --rm --no-deps app -m src.cli exercise
Comparez votre prédiction aux métriques par groupe. clean comporte 16 images ; rotation, noise et contrast en comportent 8 chacun. Expliquez ce décompte à partir des gabarits, plutôt que de le mémoriser.
La commande exercise ne modifie pas le modèle et ne lance pas un nouvel entraînement. Elle regroupe les sorties déjà obtenues. La partie « modifier » de l'exercice intervient dans l'expérience séparée proposée ci-dessous, pas dans cette commande.
La conclusion attendue est que les groupes décrivent les données fournies. Elle n'est pas que la rotation provoque une baisse universelle de qualité.
Pour tester une cause, changez le protocole dans une copie
Une comparaison appariée consisterait à rendre exactement le même texte dans une image propre et dans une image tournée. Les deux images formeraient une paire. Vous pourriez alors comparer leurs erreurs en conservant la référence, le montant et les autres paramètres.
Travaillez dans un dossier séparé et faites varier un seul facteur à la fois. Prévoyez la nouvelle génération d'images, leur passage dans l'OCR et les nouvelles mesures. Modifier seulement le regroupement des anciennes sorties ne crée pas ces paires.
Cette proposition n'a pas été exécutée dans r3. Elle constitue une nouvelle expérience, sans résultat préannoncé. Son intérêt est d'apprendre à poser une question que les données permettent réellement de trancher.
Votre expérience séparée, sans résultat préannoncé
Pour essayer vos propres documents, créez un dossier de travail distinct et conservez l'archive r3 inchangée. Vous garderez ainsi un point de comparaison dont vous connaissez le contenu et le comportement attendu.
Avant de lancer l'OCR, décrivez le type de documents, la qualité de numérisation, les langues, les orientations et les règles de vérité terrain. Précisez aussi le coût d'une erreur : une référence introuvable et un montant erroné n'ont pas nécessairement les mêmes conséquences dans votre application.
Choisissez vos métriques avant de regarder les résultats. Vous pourriez mesurer les erreurs de référence, les erreurs de montant, le taux de rejet et le résultat d'une revue humaine. Un rejet correspondrait alors à un document que votre application refuse de traiter automatiquement selon une règle à définir ; ce mécanisme n'est pas fourni par le simple calcul de CER.
Scans, tableaux, colonnes, logos, écritures manuscrites et images dégradées changent le problème. N'annoncez donc aucun score avant la mesure. Si vous ajoutez un parseur de montant ou un seuil de confiance, évaluez cette nouvelle étape séparément : la confiance EasyOCR n'est pas calibrée ici comme une probabilité d'exactitude métier.
Dépannage utile
nvidia-smi absent. Installez ou réparez le pilote NVIDIA, puis relancez le préflight. Tant que cette vérification échoue, poursuivez le diagnostic de l'environnement plutôt que celui des images.
GPU détecté sur Linux, mais pas dans Docker. Configurez NVIDIA Container Toolkit et vérifiez que GPU_DEVICE désigne la carte attendue. La visibilité du matériel sur l'hôte et son exposition au conteneur sont deux contrôles distincts.
Échec de fetch. Vérifiez le réseau et les hashes. Ne contournez pas les contrôles de taille ou de SHA-256 pour faire disparaître l'erreur : vous perdriez le lien avec les ressources du parcours validé.
GPU CUDA requis. Contrôlez le pilote, l'exposition GPU dans Docker et GPU_DEVICE, puis reprenez après l'acquisition complète. Le code refuse volontairement de continuer sans CUDA.
Image modifiée depuis prepare. Relancez prepare avant ocr. N'éditez pas les PNG entre ces étapes dans la reproduction de référence : le contrôle sert justement à détecter une différence entre image préparée et image mesurée.
Boîtes ou ordre de lecture inattendus. Ouvrez outputs/ocr.json et les PNG associés. Le texte joint suit l'ordre renvoyé par le moteur ; il ne résout pas automatiquement les documents à colonnes. Commencez par déterminer si le problème vient de la zone renvoyée, des caractères reconnus ou de l'assemblage du texte.
Ce qui manque avant une production documentaire
Dans une application réelle, l'OCR serait une brique d'un traitement plus large. La chaîne devrait prendre en charge les formats réellement reçus, l'orientation, le redressement des images, la qualité de scan, les mises en page, les tableaux, les langues et les manuscrits nécessaires à votre domaine.
L'étape suivante serait d'associer les champs de façon fiable : déterminer quelle valeur correspond à quelle étiquette, valider les règles de nombre et de devise, calibrer les rejets et prévoir une revue humaine lorsque le coût d'une erreur le justifie. Lire deux montants dans la même image ne suffit pas à déterminer lequel doit remplir le champ « total » de votre application.
Il reste aussi tout le travail familier d'une application web : ingestion sécurisée, authentification, droits documentaires, quotas, stockage, règles de rétention, supervision, sauvegarde et restauration. Les mesures de charge et de concurrence doivent porter sur le service complet, pas uniquement sur une lecture OCR isolée.
Enfin, l'évaluation doit utiliser des documents représentatifs, répartis selon les cas importants : types de documents, langues, qualités de scan ou difficultés de mise en page. C'est le sens d'une évaluation stratifiée. Les 40 images synthétiques de test ne la remplacent pas.
Nettoyage exact
À la fin du parcours, lancez cette commande depuis la racine de l'archive :
docker compose down
Elle appartient au parcours r3 validé. Elle arrête les ressources Compose du projet et retire les conteneurs et réseaux concernés, sans supprimer les modèles, l'image Docker ou les sorties. Le comportement de nettoyage par défaut est décrit dans la documentation de docker compose down.
Conservez les JSON et les PNG tant que vous en avez besoin pour relire les résultats. Ne supprimez vos essais séparés qu'après avoir vérifié leur contenu. Une purge globale de Docker n'est pas nécessaire pour terminer ce tutoriel.