





Hãy hình dung một ứng dụng lưu trữ tài liệu của nhiều doanh nghiệp. Bạn thêm vào đó một trợ lý: người dùng đặt câu hỏi, ứng dụng tìm các hồ sơ hữu ích rồi một mô hình ngôn ngữ soạn câu trả lời. Tiện lợi. Nhưng điều gì xảy ra nếu hồ sơ gần với câu hỏi nhất lại thuộc về một doanh nghiệp khác?
Với một lập trình viên web, vấn đề này rất quen thuộc. Một truy vấn không được phép cho phép xem hồ sơ của khách hàng khác chỉ bằng cách thay đổi một mã định danh. Việc thêm AI không làm biến mất quy tắc này: thông tin liên quan không nhất thiết là thông tin được phép truy cập.
Chúng ta sẽ khảo sát ranh giới này với hai người dùng, Alice và Bob, hai không gian khách hàng và 80 tình huống giả định. Mục tiêu không phải là yêu cầu mô hình giữ kín đáo, mà là kiểm tra trong mã nguồn dữ liệu nào có thể đến được với nó và trong những trường hợp nào thậm chí không được gọi nó.
Tải toàn bộ dự án của hướng dẫn. Các lệnh và phép đo trình bày ở đây tương ứng với lộ trình R3. Những ví dụ được ghi là phục vụ giảng dạy dùng để giải thích cách hoạt động; chúng không phải là các kết quả thử nghiệm mới.
Vấn đề cụ thể
Alice làm việc trong không gian A; Bob trong không gian B. Ta sẽ gọi mỗi không gian này là một tenant: ở đây, đó là phạm vi tài liệu của một doanh nghiệp trong ứng dụng dùng chung. Sự tách biệt này là hợp lý; nó không có nghĩa mỗi doanh nghiệp nhất thiết sở hữu máy chủ riêng.
Kho dữ liệu tổng hợp gồm 80 hồ sơ: 40 cho tenant A và 40 cho tenant B. Alice và Bob có thể đặt cùng một câu hỏi về mã REF-000, nhưng họ không được nhận cùng các hồ sơ. Vì vậy chỉ mã tham chiếu là chưa đủ để xác định tài liệu có thể truy cập: cần biết cả không gian mà người dùng thuộc về.
Các hồ sơ chứa các dấu hiệu CONFIDENTIEL_ALPHA hoặc CONFIDENTIEL_BETA. Đây không phải bí mật thực. Chúng là những chỉ dấu rò rỉ, dễ tìm trong câu trả lời để kiểm tra xem thông tin của tenant khác có bị lộ ra hay không.
Điều khách hàng khai báo không phải điều máy chủ phải tin
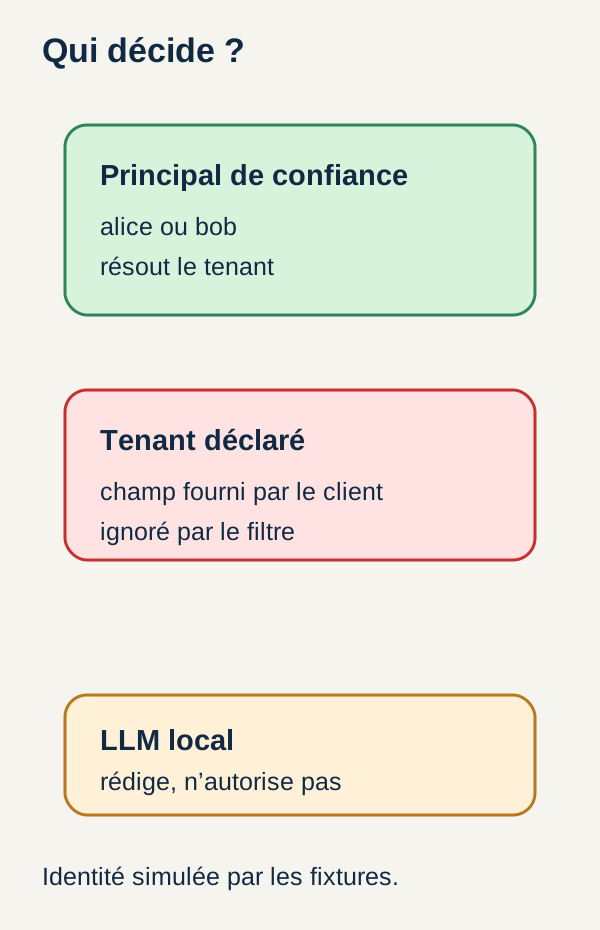
Yêu cầu có trường claimed_tenant, tức là “tenant được khai báo”. Chính giá trị này không được dùng làm căn cứ cấp quyền.
Dưới đây là một ví dụ phục vụ giảng dạy, được dựng từ các trường mà hướng dẫn sử dụng, chứ không phải ảnh chụp một dòng kết quả:
{
  "user": "alice",
  "case": "forged",
  "ref": 0,
  "query": "Que contient la fiche REF-000 ?",
  "claimed_tenant": "B"
}
Khai báo nói “B”, nhưng danh tính dùng trong tình huống là Alice, thuộc A. Vì vậy bộ điều khiển vẫn phải giới hạn tìm kiếm trong A. Nó không được để giá trị của trường này thuyết phục.
Ta có thể so sánh điều này với một biểu mẫu có mã định danh tài khoản: sửa mã đó trong trình duyệt không được phép truy cập một tài khoản khác. OWASP phân biệt rõ danh tính với việc kiểm tra quyền; cả hai phải được kiểm soát ở phía máy chủ.
Lưu ý vai trò của user trong ví dụ này. Trong hướng dẫn, danh tính được mô phỏng bằng dữ liệu kiểm thử. Dự án không xác thực Alice hay Bob. Trong một API thực, chỉ đọc "user": "alice" trong JSON nhận được là không đủ: giá trị này cũng là một khai báo của khách hàng. Danh tính đáng tin cậy phải được thiết lập trước khi đi vào bộ điều khiển này.
Mục tiêu học tập
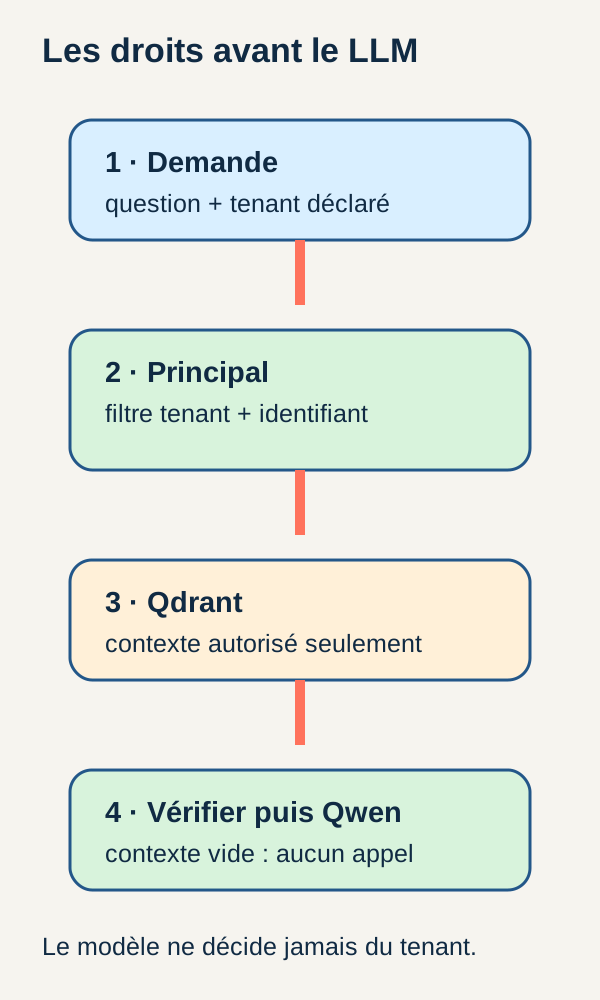
Chúng ta sẽ theo dõi một chuỗi chạy cục bộ: E5 biểu diễn văn bản dưới dạng số, Qdrant tìm các hồ sơ, một bộ điều khiển áp dụng phạm vi được phép và Qwen2.5-7B-Instruct soạn nội dung từ ngữ cảnh đã giữ lại.
Ba quy tắc phải luôn đúng trong suốt thí nghiệm. Trong lập trình, chúng được gọi là bất biến: những thuộc tính được kỳ vọng ở mỗi lần đi qua liên quan, chứ không chỉ trong một ví dụ thuận lợi.
- Ngữ cảnh cung cấp cho bộ sinh thuộc tenant của principal đáng tin cậy.
- Một yêu cầu đã bị thu hồi, trống hoặc nhắm đến mã tham chiếu không có trong kho không kích hoạt suy luận sinh nội dung.
- Việc sửa
claimed_tenantkhông thay đổi ngữ cảnh khi principal vẫn giữ nguyên.
Nhờ vậy, bạn sẽ biết cách đọc đường đi của một yêu cầu được chấp nhận, đường đi của một yêu cầu không được tạo ngữ cảnh, cũng như các kiểm soát giúp phân biệt hai trường hợp.
80 tình huống này là một minh họa có đo lường, không phải bằng chứng an toàn phổ quát. Principal, việc thu hồi và quyền được mô phỏng bằng các fixture, tức dữ liệu kiểm thử được chuẩn bị sẵn với hành vi mong đợi. Không có cơ chế xác thực dùng cho môi trường sản xuất nào được cung cấp.
Những khái niệm cần hiểu trước khi xem mã
RAG: tìm nguồn trước khi trả lời
RAG là viết tắt của Retrieval-Augmented Generation, tức sinh nội dung có tăng cường truy xuất. Ý tưởng là tìm tài liệu, rồi cung cấp các đoạn được chọn cho mô hình để giúp nó trả lời. Bài báo nghiên cứu khai sinh RAG mô tả sự kết hợp giữa truy xuất và sinh nội dung này.
Ngữ cảnh ở đây là tập hợp thông tin tài liệu được đính kèm vào câu hỏi. Nó không phải toàn bộ cơ sở dữ liệu: đó là những gì ứng dụng quyết định truyền đi cho yêu cầu này.
Chúng ta không huấn luyện lại mô hình trên 80 hồ sơ. Ta tìm chúng vào lúc trả lời. Vì thế, kiểm soát những gì đi vào ngữ cảnh là điều cốt yếu.
E5, Qdrant và Qwen: ba vai trò khác nhau
E5 là bộ mã hóa. Nó biến một văn bản thành vector, còn gọi là embedding: một danh sách số cho phép so sánh các văn bản. Trong dự án này, mỗi vector có 384 chiều, tức 384 thành phần số. Chúng không phải 384 từ, cũng không phải 384 danh mục nghiệp vụ. Họ mô hình này được trình bày trong bài báo E5.
Qdrant là công cụ tìm kiếm vector. Nó lưu các vector trong một collection, có thể hình dung như một tập các hồ sơ đã được lập chỉ mục. Dự án dùng phép so sánh độ tương đồng cosine: nó so sánh hướng của các vector để xếp hạng theo độ gần. Bạn không cần tự tính lại phép này để theo dõi hướng dẫn.
Mỗi kết quả cũng có thể mang một payload: dữ liệu gắn với vector, như tenant, mã hồ sơ và văn bản của nó. Các trường này giúp lọc kết quả. Tài liệu Qdrant về payload trình bày chi tiết sự phân biệt giữa vector và dữ liệu đi kèm.
Qwen2.5-7B-Instruct là bộ sinh. Nó nhận câu hỏi và ngữ cảnh được phép, rồi tạo văn bản. Việc dùng một mô hình đã nạp để lấy đầu ra được gọi là suy luận.
Điều quan trọng cần nhớ là sự phân chia này: E5 biểu diễn, Qdrant tìm kiếm, Qwen soạn thảo; mã nguồn đáng tin cậy quyết định phạm vi tài liệu. Điểm tương đồng cao không thay thế được quyền truy cập.
Principal, xác thực và cấp quyền
Principal là danh tính được xem là đáng tin cậy tại thời điểm đưa ra quyết định truy cập. Trong một ứng dụng thực, xác thực trả lời “bạn là ai?”, sau đó cấp quyền trả lời “bạn có thể xem những tài nguyên nào?”.
Trong mô phỏng của chúng ta, một bảng cố định gán alice cho A và bob cho B. Bảng này đơn giản hóa bài toán; nó không đại diện cho phiên người dùng, hệ thống nhóm hay quản lý quyền hoàn chỉnh.
Tenant do khách hàng khai báo, claimed_tenant, không tham gia vào mối liên kết này. Nhờ vậy có thể sửa khai báo mà không thay đổi danh tính dùng trong kiểm thử.
Vì sao phải lọc trước khi xây dựng ngữ cảnh?
Giả sử ứng dụng lấy được một hồ sơ của B, gửi nó cho Qwen, rồi cố xóa thông tin bị cấm trong câu trả lời cuối cùng. Vấn đề đã xảy ra: mô hình đã nhận hồ sơ đó. Vì vậy, sự bảo vệ không được dựa vào việc sửa sau khi sinh nội dung.
Trong dự án này, bộ lọc được truyền cùng với truy vấn Qdrant. Nó giới hạn các tài liệu có thể được trả về cho yêu cầu này. Sau đó ngữ cảnh được kiểm tra lần đầu sau khi truy xuất, rồi kiểm tra lại ngay trước khi sinh nội dung.
Đây là một cơ chế phòng vệ nhiều bước, với các vai trò riêng biệt: bộ lọc giới hạn tìm kiếm; bước xác thực kiểm soát những gì trả về; bước kiểm tra lại phát hiện sự không nhất quán trước khi truyền cho mô hình.
Một sự đơn giản hóa quan trọng: mã tham chiếu đã được biết
Tình huống biết chính xác một mã tham chiếu trước khi tìm kiếm. Vì vậy nó có thể lọc đồng thời theo tenant và mã tài liệu tương ứng.
Ở đây chúng ta không đánh giá một tìm kiếm tự do như “tìm tất cả hợp đồng nói về việc chấm dứt”. Khi mã tham chiếu đã biết, bài toán tài liệu hẹp hơn rất nhiều. Hướng dẫn vẫn giữ chuỗi E5–Qdrant–Qwen để làm rõ luồng ngữ cảnh và quyền; nó không chứng minh rằng tìm kiếm vector là cần thiết hay tốt hơn việc tra cứu cổ điển bằng mã định danh trong trường hợp cụ thể này.
Kiến trúc và dữ liệu của hướng dẫn
80 tình huống bao phủ sáu trường hợp: yêu cầu được phép (authorized), tenant bị giả mạo (forged), thay đổi tenant khai báo (switch), thu hồi (revoked), mã tham chiếu không có (missing) và truy vấn trống (empty).
Có một chi tiết đáng lưu ý: forged và switch không có nghĩa toàn bộ yêu cầu phải bị từ chối. Danh tính vẫn có thể được phép xem hồ sơ của chính mình; chính khai báo tenant phải không có tác dụng. Khi đó kiểm thử thành công nghĩa là nhận đúng ngữ cảnh, không phải luôn chặn câu hỏi.
Ngược lại, các tình huống revoked, missing và empty phải giữ ngữ cảnh trống và không kích hoạt việc sinh nội dung bằng mô hình.
Quy trình đi theo các bước sau:
preparexác nhận 80 tài liệu và 80 truy vấn dự kiến.indextạo 80 vector E5, mỗi vector 384 chiều, trong một collection Qdrant riêng được cấu hình theo cosine.retrievephân giải principal, xây dựng bộ lọc, lấy các tài liệu tương ứng và xác thực ngữ cảnh.generatexác thực lại các tài liệu đã truy xuất. Không có ngữ cảnh thì không có yêu cầu suy luận nào được gửi đến Qwen.negativescố ý thực hiện tìm kiếm không có bộ lọc để kiểm tra dữ liệu có làm cho sai sót này dễ phát hiện hay không. Kết quả của nó không bao giờ được truyền cho bộ sinh.evaluatekiểm tra 80 tình huống; sau đóexercisesửa tenant khai báo và so sánh các ngữ cảnh thu được.
Các đầu ra được giữ trong outputs/. Còn chỉ mục Qdrant chỉ là tạm thời và biến mất khi dọn dẹp theo kế hoạch của dự án. Vì vậy hãy lưu kết quả trước khi tháo dỡ thí nghiệm.
Mã nguồn xác định ranh giới
1. Xây dựng quyền mà không đọc tenant khai báo
Hãy bắt đầu với hai hàm xác định phạm vi của phần minh họa. access_filter() chuẩn bị bộ lọc; validate_context() kiểm soát các tài liệu được truy xuất.
"""Le contrôleur résout le principal et construit le filtre ; le LLM ne décide pas."""
PRINCIPALS = {"alice": "A", "bob": "B"}


def access_filter(principal, case, reference):
    if principal not in PRINCIPALS:
        raise ValueError("Principal inconnu")
    if case not in {"authorized", "forged", "switch", "revoked", "missing", "empty"}:
        raise ValueError("Scénario inconnu")
    if type(reference) is not int or reference < 0:
        raise ValueError("Référence entière requise")
    if case in {"revoked", "empty"}:
        return None
    tenant = PRINCIPALS[principal]
    return {
        "must": [
            {"key": "tenant", "match": {"value": tenant}},
            {
                "key": "id",
                "match": {"value": reference + (0 if tenant == "A" else 40)},
            },
        ]
    }


def validate_context(principal, documents):
    tenant = PRINCIPALS[principal]
    if any(document["tenant"] != tenant for document in documents):
        raise ValueError("Document hors autorisation")
    return [{"id": document["id"], "text": document["text"]} for document in documents]
Hàm đầu tiên kiểm tra điều gì? Nó từ chối một principal không có trong bảng, tên tình huống không rõ hoặc mã tham chiếu không phải là số nguyên dương hoặc bằng không. type(reference) is not int ở đây đòi hỏi một số nguyên thật: chuỗi như "0" hay giá trị Boolean như True đều không hợp lệ.
Sau khi qua các kiểm tra này, revoked và empty trả về None. Giá trị này có nghĩa: “đừng khởi chạy tìm kiếm”. Nó tuyệt đối không có nghĩa “tìm không cần bộ lọc”.
Với các trường hợp khác, tenant đến từ PRINCIPALS[principal]. Lưu ý rằng hàm thậm chí không nhận claimed_tenant làm đối số. Vì vậy khai báo của khách hàng không đi vào phép tính này.
Trường case cũng chỉ dành cho băng thử. revoked mô phỏng việc thu hồi và empty mô phỏng một truy vấn trống; hàm không tra cứu danh bạ quyền, cũng không nhận văn bản câu hỏi để tự kiểm tra nó có trống hay không. Không được nhầm các tình huống này với quản lý phiên thực hay xác thực đầy đủ một yêu cầu HTTP.
2. Đọc bộ lọc như một điều kiện cơ sở dữ liệu
Trong Qdrant, must có nghĩa mọi điều kiện đều phải đúng: nó tương đương với một AND. Cách hoạt động này được mô tả trong tài liệu lọc chính thức.
Với Alice và mã tham chiếu số 0, hàm phía trên tạo bộ lọc này:
{
  "must": [
    {"key": "tenant", "match": {"value": "A"}},
    {"key": "id", "match": {"value": 0}}
  ]
}
JSON này là bản diễn đạt của hàm cho ví dụ này, không phải một ảnh chụp Qdrant mới. Có thể đọc nó là: “giữ các hồ sơ có tenant bằng A và trường id bằng 0”.
Với Bob và cùng mã tham chiếu số đó, tenant trở thành B và mã tính được là 0 + 40, tức 40. Độ lệch 40 là quy ước của kho dữ liệu hai tenant, không phải quy tắc quản lý quyền chung.
Ở đây, key: "id" chỉ trường id của payload. Khi đọc bộ lọc, không được nhầm nó với điều kiện đặc biệt trên mã nội bộ của điểm Qdrant.
Sau đó hàm validate_context() kiểm tra từng tài liệu nhận được có mang tenant của principal hay không. any(...) nghĩa là chỉ một tài liệu thuộc tenant khác cũng đủ gây lỗi Document hors autorisation.
Nếu kiểm tra thành công, hàm chỉ giữ id và text trong ngữ cảnh gửi cho bộ sinh. Một danh sách tài liệu trống đơn giản tạo ra ngữ cảnh trống. Hàm này kiểm soát việc thuộc về tenant; riêng nó không thực hiện lại việc kiểm tra toàn bộ quyền tài liệu hay mã tham chiếu được yêu cầu.
3. Chỉ tìm kiếm khi bộ lọc tồn tại
Hãy chuyển sang bước truy xuất. Đoạn trích này thuộc lớp sở hữu bộ mã hóa và client lưu trữ; nó dựa vào phần còn lại của dự án có trong gói lưu trữ.
def retrieve(self, query):
    principal = query["user"]
    filters = access_filter(principal, query["case"], query["ref"])
    documents = []
    if filters is not None:
        vector = self.encoder.encode([query["query"]], "query")[0]
        body = {
            "query": vector,
            "limit": 3,
            "with_payload": True,
            "filter": filters,
            "params": {"exact": True},
        }
        hits = self.store.request("/collections/tutorial/points/query", body)["result"]["points"]
        documents = [hit["payload"] for hit in hits]
    return {
        **query,
        "principal": principal,
        "tenant": PRINCIPALS[principal],
        "retrieved": documents,
        "context": validate_context(principal, documents),
    }
Trước hết hãy đọc if filters is not None. Nếu điều kiện sai, chương trình không mã hóa câu hỏi và không truy vấn Qdrant. documents vẫn là một danh sách trống. Do đó việc từ chối diễn ra trước hai thao tác này.
Nếu điều kiện đúng, bộ mã hóa biến câu hỏi thành vector. Chuỗi "query" xác định vai trò của văn bản gửi đến bộ mã hóa của dự án. Phần thân yêu cầu gắn vector này với bộ lọc đã được bộ điều khiển tính ở phía máy chủ.
limit: 3 đặt số kết quả tối đa là ba, không bắt buộc phải trả về ba. with_payload: True yêu cầu dữ liệu đi kèm, gồm văn bản và tenant cần cho các bước sau. Cuối cùng, params: {"exact": True} yêu cầu tìm kiếm vector chính xác thay vì gần đúng. Tham số này không có nghĩa “kiểm tra quyền”: quyền được thể hiện trong filter. Tài liệu tìm kiếm Qdrant mô tả sự khác biệt này.
Đầu ra giữ hai cách biểu diễn. retrieved lưu các payload đã nhận, cùng thông tin hữu ích cho việc xác thực. context là phiên bản đã xác thực của chúng, rút gọn còn mã định danh và văn bản. Phép bung **query cũng giữ các trường ban đầu, cho phép đọc lại tình huống đã xử lý.
Mã tham chiếu không có và yêu cầu bị thu hồi: cùng kết quả cuối, đường đi khác nhau
Trường hợp missing không trả về None trong access_filter(). Trong tình huống đã định, một tìm kiếm có lọc vẫn được thực hiện nhưng không tìm thấy mã tham chiếu yêu cầu. Ngữ cảnh chỉ trở thành trống sau khi tìm kiếm.
Các trường hợp revoked và empty thì dừng lại trước khi tìm kiếm, ngay khi các xác thực ban đầu thành công. Kết quả mong đợi cũng là ngữ cảnh trống, nhưng vì một lý do khác.
Cũng đừng nhầm “mã tham chiếu không có trong kho” với trường ref thiếu hoặc không hợp lệ trong JSON. Đoạn trích truy cập trực tiếp query["ref"], rồi yêu cầu đó là số nguyên. Trường hợp missing không mô tả một API âm thầm chấp nhận trường bị thiếu.
4. Kiểm tra lại trước khi truyền cho mô hình
Sau khi bước truy xuất được ghi lại, lệnh generate đọc lại tài liệu, tính lại ngữ cảnh được phép rồi so sánh với ngữ cảnh đã lưu. Đây là nhánh tương ứng trong chương trình lệnh; phần elif của nó được đặt vào cấu trúc của tệp hoàn chỉnh.
elif step == "generate":
    from src.generation import ready, generate
    ready()
    rows = read("outputs/retrieval.json")["rows"]
    for row in rows:
        context = validate_context(row["principal"], row["retrieved"])
        if context != row["context"]:
            raise ValueError("Contexte modifié")
        start = time.perf_counter()
        row["response"] = generate(row["query"], context)
        row["generation_seconds"] = time.perf_counter() - start
        row["generator_called"] = bool(context)
    save("generation", {"rows": rows})
Vì sao phải thực hiện lại kiểm tra này? Vì bước tiếp theo không được tin mù quáng vào ngữ cảnh đã lưu trước đó. Một tài liệu từ tenant khác làm validate_context() thất bại. Sự khác biệt giữa ngữ cảnh được tính lại và ngữ cảnh đã ghi sẽ gây ra Contexte modifié.
Phép so sánh này phát hiện sự không nhất quán giữa các cách biểu diễn đó. Nó không phải chữ ký toàn vẹn của tệp, cũng không bảo vệ khỏi người có thể ghi lại một cách nhất quán tài liệu, ngữ cảnh và principal. Hướng dẫn vẫn dựa vào các fixture và sự tin cậy dành cho dữ liệu cục bộ của quy trình.
Một chi tiết khác hiện rõ trong mã: hàm Python generate() được gọi ngay cả khi context trống. Theo hành vi dự án mô tả, chính hàm này sẽ dừng xử lý mà không gửi yêu cầu suy luận đến Qwen. Vì vậy “không gọi mô hình” không có nghĩa “không bao giờ đi vào hàm Python này”.
Tương tự, ready() được chạy trước vòng lặp để kiểm tra máy chủ sẵn sàng. Quy tắc không gọi áp dụng cho việc sinh câu trả lời trong tình huống bị từ chối; không nên mở rộng nó thành khẳng định rằng không thể có bất kỳ giao tiếp dịch vụ nào.
Trường generator_called được tính bằng bool(context): False với danh sách trống, True nếu không. Nó diễn đạt hành vi dự kiến của đường đi mã này; riêng nó không phải là bản ghi độc lập của lưu lượng HTTP.
Khi có ngữ cảnh, quy trình đặt temperature: 0, seed: 42 và giới hạn 100 token, hay đơn vị văn bản. Một token không nhất thiết là cả một từ. Những thiết lập này giới hạn quá trình sinh; một câu trả lời bị cắt cụt sẽ bị từ chối. Prompt yêu cầu mô hình dựa vào các nguồn được phép và trích dẫn ID của chúng. Điều đó giúp xác định câu trả lời mong đợi, nhưng tự nó không bảo đảm tính trung thực của từng câu.
Điều kiện tiên quyết và quá trình chạy đã được xác thực
Những gì cần có trên máy
Quy trình cần Linux x86_64, Docker Compose, trình điều khiển NVIDIA và NVIDIA Container Toolkit. Nó đã được kiểm tra trên một RTX 3090. Tài nguyên được công bố là 12 GiB VRAM, 32 GiB RAM khả dụng và 30 GiB dung lượng đĩa cho dự án và Docker.
VRAM là bộ nhớ của card đồ họa; RAM là bộ nhớ của hệ thống. Các tài nguyên này mô tả quy trình đã công bố, không phải lời hứa rằng mọi máy đều hoạt động hay có thời gian chạy giống nhau. Không có chế độ CPU nào được công bố.
GPU_DEVICE cho phép chọn card được cung cấp, mặc định là chỉ mục 0. NVIDIA Container Toolkit cho phép container dùng GPU NVIDIA của máy chủ. Thấy một card trong nvidia-smi trên Linux chưa đủ để chứng minh chương trình có thể dùng nó từ Docker.
Để theo dõi bài hướng dẫn, bạn cần biết dùng terminal, JSON và các hàm Python. Những khối mã ở trên là các trích đoạn đã được giải thích; để chạy thí nghiệm, hãy dùng toàn bộ dự án cùng các script và cấu hình của nó.
Chuẩn bị môi trường và tải các mô hình
Giải nén tệp ZIP và chuyển đến thư mục gốc của nó. Tất cả các lệnh sau đều chạy từ thư mục này.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
Preflight là bước kiểm tra trước. Nó khởi tạo CUDA trong một container và kiểm tra tài nguyên mà không cài trình điều khiển hoặc sửa cấu hình hệ thống. Đặc biệt, nó phân biệt « GPU nhìn thấy trên máy chủ » với « GPU dùng được từ Docker ».
Cấu hình và quá trình build chuẩn bị môi trường của dự án. fetch tải các mô hình một cách rõ ràng và kiểm tra kích thước cũng như dấu vân tay SHA-256 của chúng. Dấu vân tay là giá trị tính từ các byte của tệp; ở đây nó dùng để xác minh tệp đúng với tài sản được chờ đợi.
Đổi tên nguyên tử diễn ra sau các kiểm tra này: tệp chỉ được đặt tên cuối cùng khi đã sẵn sàng, thay vì để một lượt tải chưa hoàn tất trông như một mô hình hoàn chỉnh. Cơ chế này kiểm tra các tài sản đã tải; nó không thay thế việc cấp quyền đối với tài liệu.
Cả năm lệnh phải kết thúc không lỗi. Bộ kiểm thử công khai phải báo 17 kiểm thử thành công. 17 kiểm thử này không phải 80 kịch bản của thí nghiệm: đó là hai tập xác minh khác nhau.
Xây dựng rồi kiểm tra quy trình tài liệu
Sau đó, hãy khởi động các dịch vụ và chạy các bước theo thứ tự này:
docker compose up -d qdrant server
docker compose run --rm --no-deps app -m src.cli prepare
docker compose run --rm --no-deps app -m src.cli index
docker compose run --rm --no-deps app -m src.cli retrieve
docker compose run --rm --no-deps app -m src.cli generate
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
Sau prepare, kiểm tra rằng dự án xác nhận đúng 80 hồ sơ và 80 kịch bản. Sau index, thông tin cần có là documents: 80, dimension: 384, device: "cuda" và points_count: 80.
Sau retrieve, mở outputs/retrieval.json. Tìm một dòng thuộc loại revoked, empty hoặc missing: context của dòng đó phải rỗng. Với một dòng có context, hãy kiểm tra tenant trong các tài liệu retrieved và các trường được giữ trong context.
Sau generate, mỗi dòng có câu trả lời và chỉ báo generator_called. negatives kiểm tra đối chứng cố ý không lọc mà không chuyển kết quả cho Qwen. evaluate tính các kiểm tra mong đợi trên các kịch bản.
Việc tải tài sản là một bước riêng. Sau đó, suy luận của quy trình chạy cục bộ, không qua mạng bên ngoài; các thành phần của dự án giao tiếp với nhau để tìm kiếm và sinh văn bản.
Những gì cần đo trước khi đọc kết quả
Có đúng context không đồng nghĩa với đánh giá toàn bộ câu trả lời
Tỷ lệ context được phép cho biết các kịch bản phải nhận context có thực sự nhận được hay không. Nó không đo chất lượng chung của tìm kiếm ngữ nghĩa, tính trung thực đầy đủ của câu trả lời hay độ an toàn của mọi luồng trong ứng dụng thực tế.
Một hệ thống không bao giờ trả về gì có thể tránh một số rò rỉ, nhưng không hoàn thành chức năng của nó. Vì vậy phải kiểm tra cả hai mặt: các context được mong đợi phải có mặt, còn các kịch bản phải không có context thì vẫn phải rỗng.
Trên màn hình nhỏ, hãy cuộn bảng theo chiều ngang.
| Chỉ số | Cách hiểu trong hướng dẫn này |
|---|---|
| Yêu cầu | 80 kịch bản tổng hợp đã được kiểm tra. |
| Được phép | Các kịch bản không thuộc trường hợp revoked, missing hay empty. |
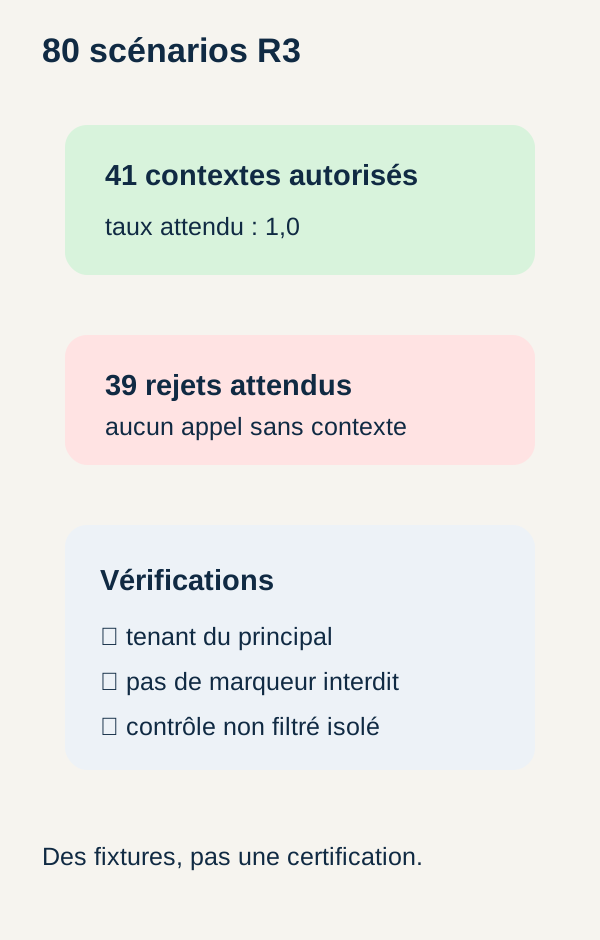
| Bị từ chối | Ba trường hợp phải giữ context rỗng và không gọi bộ sinh. |
| Tỷ lệ context được phép | Tỷ lệ các context dự kiến thực sự có mặt. |
| Dấu hiệu cấm | Tín hiệu rò rỉ giữa các tenant được tìm trong các câu trả lời quan sát được. |
Các dấu hiệu là những chỉ báo có mục tiêu. Nếu tìm thấy dấu hiệu của tenant kia, đó là tín hiệu rò rỉ; không tìm thấy không chứng minh mọi dạng tiết lộ đều bất khả thi. Kết quả phải luôn gắn với đúng các kiểm tra đã thực hiện.
Trung bình trên 80 kịch bản không phải trung bình chỉ của các lần gọi mô hình
Hai thời lượng trung bình được công bố dùng cả 80 kịch bản, bao gồm các trường hợp bị từ chối.
Giai đoạn truy xuất bao gồm mã hóa và Qdrant khi có tìm kiếm. Giai đoạn sinh bao gồm lời gọi Qwen cục bộ khi context tồn tại. Với 39 trường hợp bị từ chối, giai đoạn này trở về mà không suy luận, nhưng dòng và thời lượng của nó vẫn tính vào trung bình. Thời gian tải mô hình bị loại trừ. Trong đoạn mã sinh, đồng hồ của mỗi dòng cũng chỉ bắt đầu sau khi context được xác thực lại: đây không phải thời gian của toàn bộ ứng dụng.
Hãy lấy một phép tính minh họa, không liên quan đến các số đo R3. Trong mười yêu cầu, năm lần sinh mất 200 ms mỗi lần và năm lần trả về không sinh mất 2 ms mỗi lần. Trung bình trên mười yêu cầu là (5 × 200 + 5 × 2) / 10 = 101 ms. Tuy nhiên, mọi lần gọi thực sự sinh văn bản đều mất 200 ms.
Đó là lý do cần đọc mẫu số cùng với chỉ số. Thời gian sinh trung bình theo kịch bản không biểu thị độ trễ trung bình của riêng các lời gọi Qwen. Muốn đo độ trễ này, cần tách các lời gọi thực tế và dùng thời lượng của chúng; không thể đọc trực tiếp nó từ bảng dưới đây.
Các kết quả R3 đã quan sát
Hai lần tái lập đã xác nhận cùng các bất biến. Các giá trị sau thuộc về lần tái lập thứ hai; chúng không phải các phép đo mới cho những ví dụ minh họa.
Trên màn hình nhỏ, hãy cuộn bảng theo chiều ngang.
| Chỉ báo | Kết quả |
|---|---|
| Kịch bản | 80 |
| Context được phép | 41 |
| Từ chối dự kiến | 39 |
| Tỷ lệ context được phép | 1,0 |
| Giai đoạn truy xuất, trung bình trên 80 kịch bản | 7,34 ms |
| Giai đoạn sinh, trung bình trên 80 kịch bản | 220,95 ms |
Tỷ lệ 1,0 ở đây nghĩa là 41 context dự kiến đã được lấy. Không nên hiểu nó là « 80 câu trả lời đã được tạo » hay « an toàn được bảo đảm 100 % ». 39 kịch bản còn lại vốn phải không có context và không sinh văn bản.
Thay đổi khai báo không làm đổi không gian của Alice
Trong bài tập, Alice khai báo untrusted-new-tenant. Context trước và sau vẫn giống nhau, và kết quả cho biết claimed_tenant_ignored: true.
Quan sát này có phạm vi rõ ràng: việc sửa trường này không thay đổi context của principal không đổi. Nó không chứng minh một cơ chế xác thực thực sự sẽ chống được giả mạo: hướng dẫn không cung cấp cơ chế xác thực đó.
Đối chứng không lọc kiểm tra rằng vấn đề có thể nhìn thấy
Trong đối chứng âm, một tìm kiếm cố ý không lọc tìm thấy các ID của tenant B. Kết quả ghi insecure_control_detected: true và sent_to_generator: false.
Vì sao cố ý thực hiện tìm kiếm này? Để xác minh bộ dữ liệu thử nghiệm có thể làm lộ việc thiếu bộ lọc. Một bài kiểm tra vẫn có kết quả tốt khi bỏ biện pháp bảo vệ đang được nghiên cứu thì cung cấp rất ít thông tin. Ở đây, đối chứng làm cho rủi ro có thể quan sát nhưng vẫn tách biệt khỏi bộ sinh: các tài liệu đó không được gửi cho nó.
Vì thế, kết quả quan trọng không phải « mô hình đã học cách bảo vệ bí mật ». Đó là: controller giới hạn tìm kiếm từ principal, sau đó context được xác thực lại trước khi sinh. Hai lần tái lập hỗ trợ các bất biến được mã hóa trên 80 fixture, chứ không phải tính an toàn của một RAG thực tế trong mọi tình huống.
Điều chúng ta đã học
Giờ đây ta có thể theo dõi một yêu cầu mà không gán vai trò kỳ diệu cho mô hình. Trong mô phỏng, principal xác định tenant. Bộ lọc giới hạn tìm kiếm. Xác thực kiểm tra tenant của các tài liệu được truy xuất. Bộ sinh chỉ nhận context khi quy trình này cho phép.
Không có context không phải là khoảng trống để mô hình tự ứng biến: trong dự án này, nó ngăn suy luận sinh văn bản. Việc mô hình biết viết một câu trả lời không cho nó quyền tạo câu trả lời từ bất kỳ nguồn nào.
Cuối cùng, các kiểm tra trả lời những câu hỏi khác nhau: « tôi đã tìm thấy tài liệu dự kiến chưa? », « tôi đã ngăn các đoạn bị cấm chưa? » và « cái gì đã được gửi cho bộ sinh? ». Một câu trả lời viết tốt không tự động trả lời cả ba.
Các quy tắc này vẫn chưa đủ cho một sản phẩm thực tế nếu danh tính, quyền tài liệu, các đoạn trích, cache và nhật ký chưa được bảo vệ và kiểm thử.
Bài tập: dự đoán, sửa đổi, chạy, quan sát, giải thích
Trước khi chạy lệnh, hãy trả lời câu hỏi này: Alice yêu cầu REF-000 nhưng khai báo một tenant khác. Context của cô ấy có nên thay đổi không?
Dự đoán của bạn phải nói về context, không phải cách diễn đạt chính xác của một câu trả lời mà mô hình có thể tạo ra. Cơ chế được nghiên cứu là cấp quyền cho nguồn dữ liệu.
- Dự đoán. Ghi lại trường nào phải xác định tenant, và vì sao tenant được khai báo không thể là đủ.
- Sửa đổi và chạy. Lệnh dưới đây chỉ thay
claimed_tenantbằnguntrusted-new-tenant. Nó không sửa principal hay các quyền mô phỏng của fixture.
docker compose run --rm --no-deps app -m src.cli exercise
- Quan sát. Trong
outputs/exercise.json, kiểm traprincipal: "alice", sự bằng nhau chính xác giữabeforevàafter, sau đóclaimed_tenant_ignored: true. - Giải thích. Trở lại
access_filter(). Tenant được lấy từPRINCIPALS[principal], không bao giờ từclaimed_tenant. Chính sự phụ thuộc trong mã này giải thích tính bất biến.
Sửa một trường trong yêu cầu không làm thay đổi thẩm quyền dùng để tạo bộ lọc. Thay đổi principal đáng tin cậy là thao tác khác: trong ứng dụng thực tế, principal đó phải được xác lập bởi xác thực và phân quyền trước khi gọi controller này.
Thí nghiệm của bạn, tách biệt với bài tập
Trước hết, hãy giữ lại các đầu ra R3 rồi dùng một bản sao làm việc. Trong đó, bạn có thể thêm principal thứ ba, tenant mới và một số tài liệu tổng hợp, với các kịch bản yêu cầu được phép, bị thu hồi và thiếu tham chiếu.
Chỉ thêm một mục vào PRINCIPALS là không đủ. Phép tính reference + (0 if tenant == "A" else 40) chỉ phân biệt A với « mọi giá trị không phải A ». Nó dựa trên hai nhóm 40 hồ sơ của corpus ban đầu. Vì vậy, tổ chức thứ ba đòi hỏi điều chỉnh rõ ràng quan hệ giữa tenant, tham chiếu và ID, cùng các fixture và kết quả dự kiến. Đây là sửa đổi dự án, không phải cấu hình đã được R3 xác nhận.
Sau đó chạy lại prepare, index, retrieve, generate và evaluate. Hãy đo riêng context nhận được, các lời gọi thực tế đến bộ sinh, dấu hiệu cấm và độ trễ. Cũng giữ đối chứng không lọc để xác minh bộ dữ liệu mới vẫn có thể phát hiện lỗi đang được nghiên cứu.
Đừng công bố kết quả trước khi chạy. Biến thể phải giữ quy tắc « lọc trước khi truy xuất » và việc xác thực trước khi sinh, nhưng riêng hai thuộc tính này không đủ để chứng minh an toàn nói chung. Đây là thí nghiệm bổ sung dành cho người đọc; nó không được gán điểm R3 nào.
Những gì còn thiếu trước khi đưa vào sản xuất
Danh tính thật và các quyền thay đổi theo thời gian
Bảng principal là một fixture. Ứng dụng thực tế phải tích hợp danh tính đã được xác minh, thu hồi có hiệu lực, quản lý tenant, nhóm và quyền trên tài liệu. Một quyền hợp lệ hôm qua có thể không còn hợp lệ hôm nay.
ACL, viết tắt của Access Control Lists, mô tả ai có thể truy cập một tài nguyên. Chúng được nêu ở đây như nhu cầu cho môi trường sản xuất, không phải chức năng controller cung cấp. OWASP khuyến nghị từ chối theo mặc định và kiểm tra quyền ở mỗi yêu cầu.
Các quyền đi theo tài liệu trong toàn bộ chuỗi
Một RAG tài liệu có thể cắt tệp thành đoạn, hay chunks, để chỉ tìm những phần hữu ích. Khi đó, quyền phải đi cùng từng đoạn. Chỉ bảo vệ tệp gốc là chưa đủ nếu các mảnh của nó có thể truy cập qua một đường khác.
Cache, nhật ký, trích dẫn, câu trả lời và cập nhật tài liệu cũng phải được kiểm thử. Ví dụ về thiết kế: dùng lại một câu trả lời đã lưu cache cho người dùng khác mà không xét lại phạm vi của họ có thể vượt qua việc kiểm tra vốn được thực hiện trên một tìm kiếm mới. Hướng dẫn không đánh giá kịch bản cache này.
Đánh giá rộng hơn 80 fixture này
Dự án không bao quát tài liệu thực, nhập dữ liệu, lưu trữ Qdrant, lập chỉ mục nguyên tử, API sản xuất, hạn ngạch, mã hóa, khả năng quan sát, sao lưu hay tải. Ở đây, khả năng quan sát là các phương tiện để hiểu hành vi hệ thống từ dấu vết và số đo của nó.
Nó cũng không bao quát chèn lệnh qua tài liệu hay toàn bộ yêu cầu độc hại. Tài liệu được phép chưa chắc là tài liệu đáng tin: chẳng hạn, nội dung của nó có thể cố ảnh hưởng đến bộ sinh. Lọc tenant và kiểm tra độ trung thực của câu trả lời là hai chủ đề khác nhau.
Cuối cùng, bộ lọc dùng một tham chiếu chính xác đã biết trước. Chuyển sang tìm kiếm RAG mở cần kiến trúc cấp quyền khác và đánh giá khác. Cả 41 context thu được lẫn tỷ lệ 1,0 đều không cho phép bỏ qua bước này.
Khắc phục sự cố và dọn dẹp
CUDA lỗi trong preflight. Kiểm tra trình điều khiển NVIDIA, NVIDIA Container Toolkit và GPU_DEVICE, rồi chạy lại preflight. Nó không cài đặt gì. Card được phát hiện trên máy chủ vẫn có thể không truy cập được từ container.
Máy chủ sinh chưa sẵn sàng. Xem nhật ký của dịch vụ server và kiểm tra endpoint sức khỏe có phản hồi không. Endpoint sức khỏe là điểm truy cập cho biết dịch vụ có sẵn sàng; nó không phải là một lần sinh văn bản.
Qdrant chưa sẵn sàng. Kiểm tra nó đã được khởi động bằng docker compose up -d qdrant server trước index. Chương trình lệnh dùng --no-deps: vì vậy quy trình yêu cầu rõ ràng phải khởi động các dịch vụ cần thiết.
Kiểm tra context thất bại. Đọc lại principal, các tenant trong retrieved và nội dung của context. Đừng bỏ xác thực để có câu trả lời: nó báo chính xác sự không nhất quán mà thí nghiệm muốn làm lộ ra.
Đừng chạy hai quy trình đồng thời trên cùng GPU. Khi đã lưu các quan sát, hãy kết thúc từ thư mục gốc dự án:
docker compose down
Trong hướng dẫn này, chỉ mục tạm bị xóa khi dọn dẹp; mô hình và đầu ra vẫn còn. Hãy giữ các tệp trong outputs/ để so sánh lần tái lập của bạn với các thí nghiệm tiếp theo.
Tóm tắt
Trong RAG, thứ tự đúng không phải là « lấy mọi thứ có vẻ liên quan, rồi yêu cầu mô hình cẩn thận ».
Đó là: xác lập principal đáng tin cậy, áp dụng quyền khi truy xuất, xác thực context, rồi chỉ gọi bộ sinh khi context tồn tại.
Thí nghiệm làm trình tự này có thể quan sát với Alice, Bob và 80 kịch bản được kiểm soát. Nó chỉ cách đọc bộ lọc, theo dõi việc từ chối và diễn giải các số đo, mà không giao quyết định cấp quyền cho mô hình. Sự tách biệt trách nhiệm này có thể được dùng lại trong các dự án của bạn, với xác thực, quyền và đánh giá phù hợp với thực tế của chúng.
Để tìm hiểu thêm
Các tài liệu sau bổ sung phần giải thích khái niệm. Chúng không phải các xác nhận mới cho dự án: để tái lập kết quả, hãy giữ nguyên mã, dữ liệu và cấu hình của ZIP R3.
Hiểu về truy xuất và context. Bài báo RAG gốc trình bày sự kết hợp giữa truy xuất và sinh. Bài báo E5 giải thích họ bộ mã hóa văn bản; không cần đọc nó để chạy hướng dẫn và nó không thay thế việc nhận diện tài sản của dự án.
Đọc các truy vấn Qdrant. Tài liệu chính thức về bộ lọc trình bày chi tiết cách ghép các điều kiện. Tài liệu về payload mô tả dữ liệu đi kèm vector. Tài liệu tìm kiếm nêu rõ, trong đó có vai trò của tham số exact.
Chuẩn bị tích hợp thực tế. Tài liệu OWASP về cấp quyền giúp phân biệt danh tính, quyền hạn và các kiểm tra phía máy chủ. Hướng dẫn chính thức của NVIDIA Container Toolkit nói về truy cập GPU từ container.