





Imaginez une application qui héberge les documents de plusieurs entreprises. Vous lui ajoutez un assistant : un utilisateur pose une question, l'application retrouve les fiches utiles et un modèle de langage rédige une réponse. Pratique. Mais que se passe-t-il si la fiche la plus proche de la question appartient à une autre entreprise ?
Pour un développeur web, le problème est familier. Une requête ne doit pas permettre de consulter le dossier d'un autre client simplement en changeant un identifiant. Ajouter de l'IA ne fait pas disparaître cette règle : une information pertinente n'est pas nécessairement une information autorisée.
Nous allons explorer cette frontière avec deux utilisateurs, Alice et Bob, deux espaces clients et 80 scénarios fictifs. Le but n'est pas de demander au modèle d'être discret. Il est de vérifier, dans le code, quelles données peuvent lui parvenir et dans quels cas il ne doit même pas être appelé.
Télécharger le projet complet du tutoriel. Les commandes et les mesures présentées correspondent au parcours R3. Les exemples signalés comme pédagogiques servent à expliquer son fonctionnement ; ils ne constituent pas de nouvelles sorties expérimentales.
Le problème concret
Alice travaille dans l'espace A ; Bob dans l'espace B. Nous appellerons chacun de ces espaces un tenant : ici, c'est le périmètre documentaire d'une entreprise dans une application partagée. Cette séparation est logique ; elle ne signifie pas que chaque entreprise possède nécessairement son propre serveur.
Le corpus synthétique contient 80 fiches : 40 pour le tenant A et 40 pour le tenant B. Alice et Bob peuvent poser la même question sur une référence REF-000, mais ils ne doivent pas recevoir les mêmes fiches. La référence seule ne suffit donc pas à déterminer le document accessible : il faut aussi connaître l'espace auquel l'utilisateur appartient.
Les fiches contiennent des marqueurs CONFIDENTIEL_ALPHA ou CONFIDENTIEL_BETA. Ce ne sont pas de vrais secrets. Ce sont des témoins de fuite, faciles à rechercher dans les réponses pour vérifier si une information de l'autre tenant est ressortie.
Ce que le client déclare n'est pas ce que le serveur doit croire
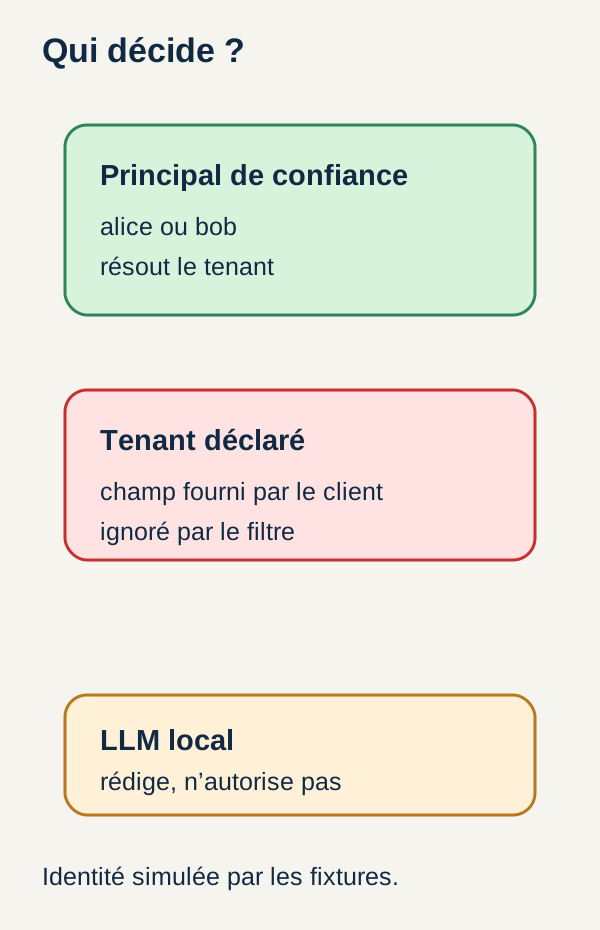
La demande contient un champ claimed_tenant, autrement dit le « tenant déclaré ». C'est précisément la valeur à ne pas prendre pour une autorisation.
Voici un exemple pédagogique, construit avec les champs utilisés par le tutoriel, et non une capture d'une ligne de résultat :
{
  "user": "alice",
  "case": "forged",
  "ref": 0,
  "query": "Que contient la fiche REF-000 ?",
  "claimed_tenant": "B"
}
La déclaration dit « B », mais l'identité utilisée par le scénario est Alice, rattachée à A. Le contrôleur doit donc continuer à limiter la recherche à A. Il ne doit pas se laisser convaincre par la valeur du champ.
On peut rapprocher cela d'un formulaire contenant un identifiant de compte : modifier cet identifiant dans le navigateur ne doit pas donner accès à un autre compte. L'OWASP distingue bien l'identité et la vérification des permissions, qui doivent être contrôlées côté serveur.
Attention au rôle de user dans cet exemple. Dans le tutoriel, l'identité est simulée par les données de test. Le projet n'authentifie pas Alice ou Bob. Dans une API réelle, il ne suffirait pas de lire "user": "alice" dans le JSON reçu : cette valeur serait, elle aussi, une déclaration du client. L'identité de confiance doit être établie avant l'entrée dans ce contrôleur.
Objectif pédagogique
Nous allons suivre une chaîne locale : E5 représente les textes sous forme de nombres, Qdrant retrouve les fiches, un contrôleur applique le périmètre autorisé et Qwen2.5-7B-Instruct rédige à partir du contexte retenu.
Trois règles devront rester vraies pendant l'expérience. En programmation, on parle d'invariants : des propriétés que l'on attend à chaque passage concerné, pas seulement sur un exemple favorable.
- Le contexte fourni au générateur appartient au tenant du principal de confiance.
- Une demande révoquée, vide ou visant une référence absente du corpus ne déclenche pas d'inférence de génération.
- Modifier
claimed_tenantne modifie pas le contexte lorsque le principal reste le même.
Vous saurez ainsi lire le chemin d'une demande acceptée, celui d'une demande qui ne doit produire aucun contexte, et les contrôles qui permettent de distinguer les deux.
Ces 80 scénarios sont une démonstration instrumentée, pas une preuve de sécurité universelle. Le principal, la révocation et les droits sont simulés par des fixtures, c'est-à-dire des données de test préparées à l'avance avec un comportement attendu. Aucune authentification de production n'est fournie.
Les notions à comprendre avant le code
Un RAG : chercher des sources avant de répondre
RAG signifie Retrieval-Augmented Generation, ou génération augmentée par récupération. L'idée est de rechercher des documents, puis de fournir les passages retenus au modèle pour l'aider à répondre. L'article de recherche à l'origine du RAG décrit cette association entre récupération et génération.
Le contexte est ici l'ensemble des informations documentaires jointes à la question. Ce n'est pas toute la base de données : c'est ce que l'application décide de transmettre pour cette demande.
Nous ne réentraînons pas le modèle sur les 80 fiches. Nous les retrouvons au moment de répondre. C'est pourquoi le contrôle de ce qui entre dans le contexte est central.
E5, Qdrant et Qwen : trois rôles différents
E5 est l'encodeur. Il transforme un texte en un vecteur, aussi appelé embedding : une liste de nombres qui permet de comparer des textes. Dans ce projet, chaque vecteur possède 384 dimensions, donc 384 composantes numériques. Ce ne sont ni 384 mots ni 384 catégories métier. La famille de modèles est présentée dans l'article E5.
Qdrant est le moteur de recherche vectorielle. Il conserve les vecteurs dans une collection, que l'on peut se représenter comme un ensemble de fiches indexées. Le projet utilise une comparaison par similarité cosinus : elle compare la direction des vecteurs afin de les classer par proximité. Il n'est pas nécessaire d'en refaire le calcul à la main pour suivre ce tutoriel.
Chaque résultat peut aussi porter un payload : les données associées au vecteur, comme le tenant, l'identifiant de la fiche et son texte. Ces champs permettent de filtrer les résultats. La documentation Qdrant sur les payloads détaille cette distinction entre vecteur et données associées.
Qwen2.5-7B-Instruct est le générateur. Il reçoit la question et le contexte autorisé, puis produit du texte. Utiliser un modèle déjà chargé pour obtenir une sortie s'appelle l'inférence.
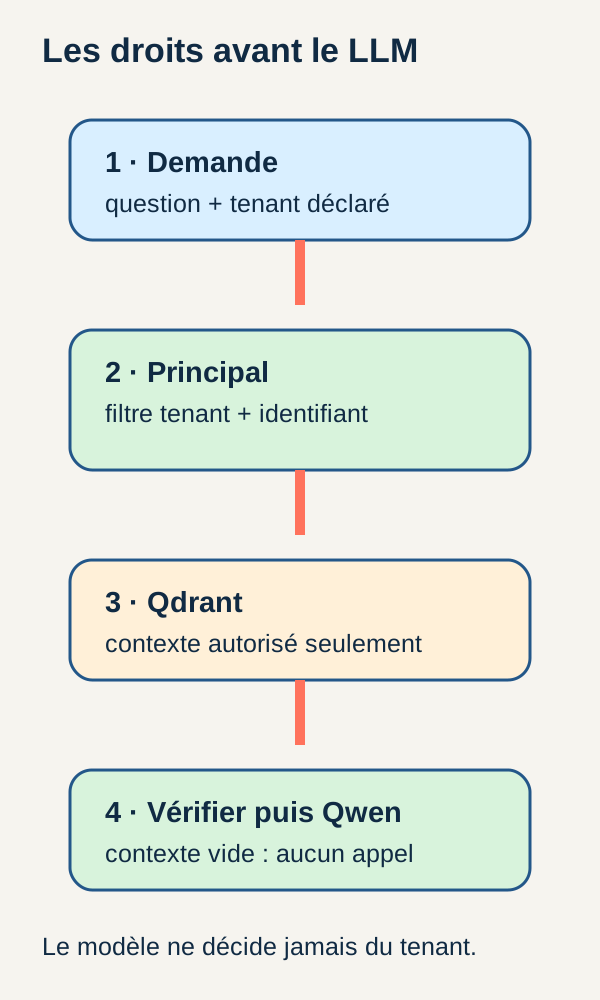
Retenez surtout la répartition : E5 représente, Qdrant recherche, Qwen rédige ; le code de confiance décide du périmètre documentaire. Un bon score de similarité ne remplace pas une permission.
Principal, authentification et autorisation
Le principal est l'identité considérée comme fiable au moment de prendre la décision d'accès. Dans une application réelle, l'authentification répond à « qui êtes-vous ? », puis l'autorisation à « quelles ressources pouvez-vous consulter ? ».
Dans notre simulation, une table fixe cette association : alice appartient à A et bob à B. Cette table simplifie le problème ; elle ne représente ni une session utilisateur, ni un système de groupes, ni une gestion complète des droits.
Le tenant déclaré par le client, claimed_tenant, ne participe pas à cette association. Cela permet de modifier la déclaration sans modifier l'identité utilisée par le test.
Pourquoi filtrer avant de construire le contexte ?
Supposons que l'application récupère une fiche de B, l'envoie à Qwen, puis tente de supprimer les informations interdites dans la réponse finale. Le problème est déjà arrivé : le modèle a reçu la fiche. La protection ne doit donc pas reposer sur une correction après génération.
Dans ce projet, le filtre est transmis avec la recherche Qdrant. Il limite les documents qui peuvent en sortir pour cette demande. Le contexte est ensuite vérifié une première fois après récupération, puis de nouveau juste avant la génération.
C'est une défense à plusieurs étapes, avec des rôles distincts : le filtre limite la recherche ; la validation contrôle ce qui en revient ; la revérification repère une incohérence avant transmission au modèle.
Une simplification importante : la référence est déjà connue
Le scénario connaît une référence exacte avant la recherche. Il peut donc filtrer à la fois sur le tenant et sur l'identifiant documentaire correspondant.
Nous n'évaluons pas ici une recherche libre du type « retrouve tous les contrats parlant de résiliation ». Avec une référence déjà connue, le problème documentaire est beaucoup plus étroit. Le tutoriel conserve la chaîne E5–Qdrant–Qwen pour rendre visible la circulation du contexte et des droits ; il ne démontre pas que la recherche vectorielle serait nécessaire ou supérieure à une consultation classique par identifiant dans ce cas précis.
Architecture et données du tutoriel
Les 80 scénarios couvrent six cas : demande autorisée (authorized), tenant forgé (forged), changement de tenant déclaré (switch), révocation (revoked), référence absente (missing) et requête vide (empty).
Un détail mérite de s'y arrêter : forged et switch ne signifient pas que toute la demande doit être rejetée. L'identité peut rester autorisée à consulter sa propre fiche ; c'est la déclaration de tenant qui doit rester sans effet. Le succès du test consiste alors à obtenir le bon contexte, pas à bloquer systématiquement la question.
À l'inverse, les scénarios revoked, missing et empty doivent conserver un contexte vide et ne pas déclencher de génération par le modèle.
Le parcours suit ces étapes :
prepareconfirme les 80 documents et les 80 requêtes prévus.indexproduit 80 vecteurs E5 de 384 dimensions dans une collection Qdrant dédiée, configurée en cosinus.retrieverésout le principal, construit le filtre, récupère les documents correspondants et valide le contexte.generaterevalide les documents récupérés. Sans contexte, aucune requête d'inférence n'est envoyée à Qwen.negativeseffectue volontairement une recherche sans filtre afin de vérifier que les données rendent cet oubli détectable. Ses résultats ne sont jamais transmis au générateur.evaluatevérifie les 80 scénarios ;exercisemodifie ensuite le tenant déclaré et compare les contextes obtenus.
Les sorties restent dans outputs/. L'index Qdrant, lui, est temporaire et disparaît au nettoyage prévu par ce projet. Conservez donc les résultats avant de démonter l'expérience.
Le code qui fixe la frontière
1. Construire les droits sans lire le tenant déclaré
Commençons par les deux fonctions qui définissent le périmètre de la démonstration. access_filter() prépare le filtre ; validate_context() contrôle les documents récupérés.
"""Le contrôleur résout le principal et construit le filtre ; le LLM ne décide pas."""
PRINCIPALS = {"alice": "A", "bob": "B"}


def access_filter(principal, case, reference):
    if principal not in PRINCIPALS:
        raise ValueError("Principal inconnu")
    if case not in {"authorized", "forged", "switch", "revoked", "missing", "empty"}:
        raise ValueError("Scénario inconnu")
    if type(reference) is not int or reference < 0:
        raise ValueError("Référence entière requise")
    if case in {"revoked", "empty"}:
        return None
    tenant = PRINCIPALS[principal]
    return {
        "must": [
            {"key": "tenant", "match": {"value": tenant}},
            {
                "key": "id",
                "match": {"value": reference + (0 if tenant == "A" else 40)},
            },
        ]
    }


def validate_context(principal, documents):
    tenant = PRINCIPALS[principal]
    if any(document["tenant"] != tenant for document in documents):
        raise ValueError("Document hors autorisation")
    return [{"id": document["id"], "text": document["text"]} for document in documents]
Que vérifie la première fonction ? Elle refuse un principal absent de la table, un nom de scénario inconnu ou une référence qui n'est pas un entier positif ou nul. type(reference) is not int exige ici un véritable entier : une chaîne comme "0" ou un booléen comme True ne convient pas.
Une fois ces contrôles passés, revoked et empty renvoient None. Cette valeur veut dire : « ne lance pas la recherche ». Elle ne signifie surtout pas « cherche sans filtre ».
Pour les autres cas, le tenant vient de PRINCIPALS[principal]. Remarquez que la fonction ne reçoit même pas claimed_tenant en argument. La déclaration du client n'entre donc pas dans ce calcul.
Le champ case est lui aussi propre au banc d'essai. revoked simule une révocation et empty une requête vide ; la fonction ne consulte pas un annuaire de droits et ne reçoit pas le texte de la question pour vérifier elle-même qu'il est vide. Ces scénarios ne doivent pas être confondus avec une gestion réelle de session ou une validation complète de requête HTTP.
2. Lire le filtre comme une condition de base de données
Dans Qdrant, must signifie que toutes les conditions doivent être vraies : c'est le rôle d'un AND. Ce fonctionnement est décrit dans la documentation officielle du filtrage.
Pour Alice, avec une référence numérique 0, la fonction ci-dessus construit ce filtre :
{
  "must": [
    {"key": "tenant", "match": {"value": "A"}},
    {"key": "id", "match": {"value": 0}}
  ]
}
Ce JSON est la traduction de la fonction pour cet exemple, pas une nouvelle capture Qdrant. Il se lit : « conserve les fiches dont le tenant vaut A et dont le champ id vaut 0 ».
Pour Bob et la même référence numérique, le tenant devient B et l'identifiant calculé vaut 0 + 40, soit 40. Le décalage de 40 est une convention du corpus à deux tenants, pas une règle générale de gestion des droits.
Ici, key: "id" désigne le champ id du payload. Il ne faut pas le confondre, à la lecture du filtre, avec une condition spéciale sur l'identifiant interne du point Qdrant.
La fonction validate_context() vérifie ensuite que chaque document reçu porte le tenant du principal. any(...) signifie qu'un seul document d'un autre tenant suffit à provoquer l'erreur Document hors autorisation.
Si la vérification réussit, elle ne conserve que id et text dans le contexte destiné au générateur. Une liste de documents vide donne simplement un contexte vide. Cette fonction contrôle l'appartenance au tenant ; elle n'effectue pas, à elle seule, une nouvelle vérification de tous les droits documentaires ni de la référence demandée.
3. Ne rechercher que lorsque le filtre existe
Passons à la récupération. Cet extrait appartient à la classe qui possède l'encodeur et le client de stockage ; il s'appuie sur le reste du projet fourni dans l'archive.
def retrieve(self, query):
    principal = query["user"]
    filters = access_filter(principal, query["case"], query["ref"])
    documents = []
    if filters is not None:
        vector = self.encoder.encode([query["query"]], "query")[0]
        body = {
            "query": vector,
            "limit": 3,
            "with_payload": True,
            "filter": filters,
            "params": {"exact": True},
        }
        hits = self.store.request("/collections/tutorial/points/query", body)["result"]["points"]
        documents = [hit["payload"] for hit in hits]
    return {
        **query,
        "principal": principal,
        "tenant": PRINCIPALS[principal],
        "retrieved": documents,
        "context": validate_context(principal, documents),
    }
Lisez d'abord le if filters is not None. S'il est faux, le programme n'encode pas la question et n'interroge pas Qdrant. documents reste une liste vide. Le refus a donc lieu avant ces deux opérations.
S'il est vrai, l'encodeur transforme la question en vecteur. La chaîne "query" précise le rôle du texte transmis à l'encodeur du projet. Le corps de la requête associe ce vecteur au filtre calculé côté contrôleur.
limit: 3 fixe un maximum de trois résultats, pas une obligation d'en retourner trois. with_payload: True demande les données associées, dont le texte et le tenant nécessaires à la suite. Enfin, params: {"exact": True} demande une recherche vectorielle exacte plutôt qu'approximative. Ce paramètre ne veut pas dire « vérifie les droits » : ceux-ci sont exprimés dans filter. La documentation de recherche Qdrant décrit cette différence.
La sortie conserve deux représentations. retrieved garde les payloads reçus, avec les informations utiles à la validation. context est leur version validée, réduite aux identifiants et aux textes. Le déballage **query conserve également les champs de départ, ce qui permet de relire le scénario traité.
Référence absente et demande révoquée : même résultat final, chemins différents
Le cas missing ne renvoie pas None dans access_filter(). Dans le scénario prévu, une recherche filtrée est bien effectuée, mais elle ne trouve pas la référence demandée. Le contexte reste vide après la recherche.
Les cas revoked et empty, eux, s'arrêtent avant la recherche, dès lors que les validations initiales ont réussi. Le résultat attendu est également un contexte vide, mais pour une autre raison.
Ne confondez pas non plus « référence absente du corpus » et « champ ref absent ou invalide dans le JSON ». L'extrait accède directement à query["ref"], puis exige un entier. Le cas missing ne décrit pas une API acceptant silencieusement un champ manquant.
4. Revérifier avant de transmettre au modèle
Une fois la récupération enregistrée, la commande generate relit les documents, recalcule leur contexte autorisé et le compare au contexte sauvegardé. Voici la branche correspondante du programme de commandes ; son elif s'insère dans la structure du fichier complet.
elif step == "generate":
    from src.generation import ready, generate
    ready()
    rows = read("outputs/retrieval.json")["rows"]
    for row in rows:
        context = validate_context(row["principal"], row["retrieved"])
        if context != row["context"]:
            raise ValueError("Contexte modifié")
        start = time.perf_counter()
        row["response"] = generate(row["query"], context)
        row["generation_seconds"] = time.perf_counter() - start
        row["generator_called"] = bool(context)
    save("generation", {"rows": rows})
Pourquoi refaire ce contrôle ? Parce que l'étape suivante ne doit pas accepter aveuglément un contexte enregistré plus tôt. Un document d'un autre tenant fait échouer validate_context(). Une différence entre le contexte recalculé et celui qui a été enregistré provoque Contexte modifié.
Cette comparaison détecte une incohérence entre ces représentations. Ce n'est pas une signature d'intégrité des fichiers, ni une protection contre quelqu'un qui pourrait réécrire de façon cohérente les documents, le contexte et le principal. Le tutoriel repose toujours sur ses fixtures et sur la confiance accordée aux données locales du parcours.
Un autre détail se voit dans le code : la fonction Python generate() est appelée même lorsque context est vide. C'est son comportement décrit par le projet qui arrête alors le traitement sans envoyer de demande d'inférence à Qwen. « Ne pas appeler le modèle » ne signifie donc pas « ne jamais entrer dans cette fonction Python ».
De même, ready() est exécutée avant la boucle pour vérifier la disponibilité du serveur. La règle d'absence d'appel concerne la génération d'une réponse pour le scénario rejeté ; elle ne doit pas être étendue à l'affirmation qu'aucune communication de service n'est possible.
Le champ generator_called est calculé avec bool(context) : False pour une liste vide, True sinon. Il exprime le comportement attendu de ce chemin de code ; ce n'est pas, à lui seul, une capture indépendante du trafic HTTP.
Lorsqu'un contexte existe, le parcours fixe temperature: 0, seed: 42 et une limite de 100 tokens, ou jetons de texte. Un jeton n'est pas nécessairement un mot entier. Ces réglages encadrent la génération ; une réponse tronquée est refusée. Le prompt demande au modèle de s'appuyer sur les sources autorisées et de citer leur ID. Cela aide à définir la réponse attendue, sans garantir à lui seul la fidélité de chaque phrase.
Prérequis et exécution validée
Ce qu'il faut avoir sur la machine
Le parcours demande Linux x86_64, Docker Compose, un pilote NVIDIA et NVIDIA Container Toolkit. Il a été vérifié sur une RTX 3090. Les ressources annoncées sont 12 Gio de VRAM, 32 Gio de RAM disponible et 30 Gio de disque pour le projet et Docker.
La VRAM est la mémoire de la carte graphique ; la RAM est celle du système. Ces ressources décrivent le parcours annoncé, pas une promesse de fonctionnement ou de temps identiques sur toute machine. Aucun mode CPU n'est annoncé.
GPU_DEVICE permet de choisir la carte exposée, avec l'index 0 par défaut. Le NVIDIA Container Toolkit permet aux conteneurs d'utiliser les GPU NVIDIA de l'hôte. Voir une carte dans nvidia-smi sur Linux ne suffit pas à prouver que le programme pourra l'utiliser depuis Docker.
Les notions utiles pour suivre le parcours sont celles d'un terminal, d'un JSON et de fonctions Python. Les blocs de code précédents sont des extraits expliqués : pour exécuter l'expérience, utilisez le projet complet, avec ses scripts et sa configuration.
Préparer l'environnement et acquérir les modèles
Extrayez le ZIP et placez-vous à sa racine. Toutes les commandes suivantes se lancent depuis ce répertoire.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
Le préflight est un contrôle préalable. Il initialise CUDA dans un conteneur et vérifie les ressources, sans installer de pilote ni modifier la configuration du système. Il permet notamment de distinguer « GPU visible sur l'hôte » et « GPU utilisable depuis Docker ».
La configuration et le build préparent l'environnement du projet. fetch acquiert explicitement les modèles et contrôle leurs tailles ainsi que leurs empreintes SHA-256. Une empreinte est une valeur calculée à partir des octets d'un fichier, utilisée ici pour vérifier qu'il correspond à l'actif attendu.
Le renommage atomique intervient après ces contrôles : le fichier est placé sous son nom final une fois prêt, plutôt que de laisser un téléchargement partiel apparaître comme un modèle complet. Ce mécanisme vérifie les actifs acquis ; il ne remplace pas l'autorisation documentaire.
Les cinq commandes doivent se terminer sans erreur. La suite publique doit annoncer 17 tests réussis. Ces 17 tests ne sont pas les 80 scénarios de l'expérience : ce sont deux ensembles de vérification distincts.
Construire puis vérifier le parcours documentaire
Lancez ensuite les services et les étapes dans cet ordre :
docker compose up -d qdrant server
docker compose run --rm --no-deps app -m src.cli prepare
docker compose run --rm --no-deps app -m src.cli index
docker compose run --rm --no-deps app -m src.cli retrieve
docker compose run --rm --no-deps app -m src.cli generate
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
Après prepare, vérifiez que le projet confirme bien 80 fiches et 80 scénarios. Après index, les informations attendues sont documents: 80, dimension: 384, device: "cuda" et points_count: 80.
Après retrieve, ouvrez outputs/retrieval.json. Cherchez une ligne de type revoked, empty ou missing : son contexte doit être vide. Pour une ligne disposant d'un contexte, vérifiez le tenant dans les documents de retrieved et les champs conservés dans context.
Après generate, les lignes comportent la réponse et l'indicateur generator_called. negatives vérifie le contrôle volontairement non filtré, sans transmettre ses résultats à Qwen. evaluate calcule les contrôles attendus sur les scénarios.
L'acquisition est une étape distincte. L'inférence du parcours est ensuite locale et hors réseau extérieur ; les composants du projet communiquent entre eux pour effectuer la recherche et la génération.
Ce qu’il faut mesurer avant de lire les sorties
Obtenir le bon contexte n'est pas la même chose qu'évaluer toute la réponse
Le taux de contexte autorisé indique si les scénarios qui devaient recevoir un contexte l'ont effectivement reçu. Il ne mesure ni la qualité générale de la recherche sémantique, ni la fidélité complète des réponses, ni la sécurité de tous les chemins d'une application réelle.
Un système qui ne retournerait jamais rien éviterait certaines fuites, mais ne remplirait pas sa fonction. Il faut donc vérifier les deux côtés : les contextes attendus sont présents, et les scénarios qui doivent rester sans contexte le restent.
Sur petit écran, faites défiler le tableau horizontalement.
| Mesure | Interprétation dans ce tutoriel |
|---|---|
| Requêtes | 80 scénarios synthétiques vérifiés. |
| Autorisées | Scénarios dont le cas n’est ni revoked, ni missing, ni empty. |
| Rejetées | Les trois cas qui doivent garder un contexte vide et ne pas appeler le générateur. |
| Taux de contexte autorisé | Proportion des contextes attendus effectivement présents. |
| Marqueur interdit | Signal de fuite inter-tenant cherché dans les réponses observées. |
Les marqueurs sont des témoins ciblés. Trouver un marqueur de l'autre tenant serait un signal de fuite ; ne pas le trouver ne démontre pas que toute forme de divulgation est impossible. Le résultat doit rester attaché aux contrôles réellement effectués.
Une moyenne sur 80 scénarios n'est pas une moyenne sur les seuls appels au modèle
Les deux durées moyennes publiées utilisent les 80 scénarios, rejets compris.
La phase de récupération inclut l'encodage et Qdrant lorsque la recherche est effectuée. La phase de génération inclut l'appel local à Qwen lorsqu'un contexte existe. Pour les 39 rejets, cette phase revient sans inférence, mais la ligne et sa durée restent dans la moyenne. Le chargement des modèles est exclu. Dans l'extrait de génération, le chronomètre de chaque ligne démarre aussi après la revalidation du contexte : ce n'est pas le temps de toute l'application.
Prenons un calcul pédagogique, sans rapport avec les mesures R3. Sur dix demandes, cinq générations prennent chacune 200 ms et cinq retours sans génération prennent chacun 2 ms. La moyenne sur les dix demandes est (5 × 200 + 5 × 2) / 10 = 101 ms. Pourtant, les appels qui ont réellement généré du texte ont pris 200 ms chacun.
Voilà pourquoi il faut lire le dénominateur avec la mesure. La moyenne de génération par scénario ne représente pas la latence moyenne des seuls appels à Qwen. Pour mesurer cette dernière, il faudrait isoler les appels effectifs et utiliser leurs durées ; on ne peut pas la lire directement dans le tableau ci-dessous.
Résultats R3 observés
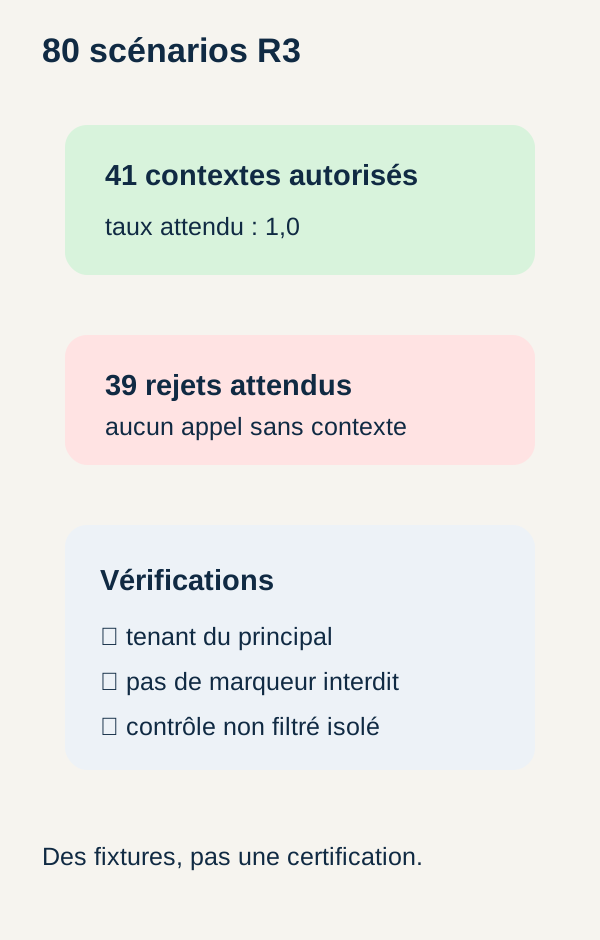
Deux reproductions ont validé les mêmes invariants. Les valeurs suivantes sont celles de la seconde reproduction ; elles ne constituent pas de nouvelles mesures réalisées pour les exemples pédagogiques.
Sur petit écran, faites défiler le tableau horizontalement.
| Indicateur | Résultat |
|---|---|
| Scénarios | 80 |
| Contextes autorisés | 41 |
| Rejets attendus | 39 |
| Taux de contexte autorisé | 1,0 |
| Phase de récupération, moyenne sur 80 scénarios | 7,34 ms |
| Phase de génération, moyenne sur 80 scénarios | 220,95 ms |
Le taux de 1,0 signifie ici que les 41 contextes attendus ont été obtenus. Il ne faut pas le lire comme « 80 réponses produites » ou « sécurité garantie à 100 % ». Les 39 autres scénarios devaient justement rester sans contexte et sans génération.
Changer la déclaration ne change pas l'espace d'Alice
Dans l'exercice, Alice déclare untrusted-new-tenant. Le contexte avant et après reste identique, et le résultat annonce claimed_tenant_ignored: true.
L'observation est précise : la modification de ce champ n'a pas modifié le contexte pour le principal inchangé. Elle ne démontre pas qu'une véritable authentification résisterait à une usurpation : cette authentification n'est pas fournie par le tutoriel.
Le contrôle non filtré vérifie que le problème serait visible
Dans le contrôle négatif, une recherche volontairement non filtrée retrouve des IDs du tenant B. Le résultat indique insecure_control_detected: true et sent_to_generator: false.
Pourquoi faire volontairement cette recherche ? Pour vérifier que le jeu d'essai est capable de révéler l'oubli du filtre. Un test qui resterait favorable même sans la protection étudiée serait peu informatif. Ici, le contrôle rend le risque observable, mais reste séparé du générateur : on ne lui transmet pas ces documents.
Le résultat important n'est donc pas « le modèle a appris à protéger un secret ». Il est : le contrôleur borne la recherche à partir du principal, puis le contexte est revérifié avant la génération. Les deux reproductions étayent les invariants codés sur 80 fixtures, pas la sécurité d'un RAG réel dans toutes les situations.
Ce que nous avons appris
Nous pouvons maintenant suivre une demande sans attribuer de rôle magique au modèle. Le principal détermine le tenant dans la simulation. Le filtre limite la recherche. La validation contrôle le tenant des documents récupérés. La génération ne reçoit un contexte que lorsque ce parcours l'autorise.
Une absence de contexte n'est pas un trou à combler en laissant le modèle improviser : dans ce projet, elle empêche l'inférence de génération. Le fait qu'un modèle sache formuler une réponse ne lui donne pas le droit d'en produire une à partir de n'importe quelle source.
Enfin, les contrôles répondent à des questions différentes : « ai-je trouvé le document attendu ? », « ai-je empêché les passages interdits ? » et « qu'est-ce qui a été envoyé au générateur ? ». Une réponse bien écrite ne répond pas automatiquement à ces trois questions.
Ces règles restent insuffisantes pour un produit réel tant que l'identité, les droits documentaires, les passages, les caches et les journaux ne sont pas eux aussi protégés et testés.
Exercice : prédire, modifier, exécuter, observer, expliquer
Avant d'exécuter la commande, prenez le temps de répondre à cette question : Alice demande REF-000, mais déclare un autre tenant. Son contexte doit-il changer ?
Votre prédiction doit porter sur le contexte, pas sur la formulation exacte d'une éventuelle réponse du modèle. Le mécanisme étudié est l'autorisation des sources.
- Prédire. Notez quel champ devrait déterminer le tenant, et pourquoi le tenant déclaré ne devrait pas suffire.
- Modifier et exécuter. La commande ci-dessous remplace uniquement
claimed_tenantparuntrusted-new-tenant. Elle ne modifie ni le principal ni les droits simulés de la fixture.
docker compose run --rm --no-deps app -m src.cli exercise
- Observer. Dans
outputs/exercise.json, vérifiezprincipal: "alice", l'égalité exacte entrebeforeetafter, puisclaimed_tenant_ignored: true. - Expliquer. Revenez à
access_filter(). Le tenant est obtenu parPRINCIPALS[principal], jamais parclaimed_tenant. C'est cette dépendance dans le code qui explique l'invariance.
La modification d'un champ de demande n'a pas modifié l'autorité utilisée pour construire le filtre. Changer le principal de confiance serait une autre opération : dans une application réelle, elle doit être établie par l'authentification et l'autorisation, avant l'appel à ce contrôleur.
Votre expérience, distincte de l’exercice
Conservez d'abord les sorties R3, puis utilisez une copie de travail. Vous pourrez y ajouter un troisième principal, un nouveau tenant et quelques documents synthétiques, avec des scénarios de demande autorisée, de révocation et de référence absente.
Il ne suffit pas d'ajouter une entrée à PRINCIPALS. Le calcul reference + (0 if tenant == "A" else 40) ne distingue que A et « tout ce qui n'est pas A ». Il repose sur les deux groupes de 40 fiches du corpus initial. Une troisième organisation demande donc d'adapter explicitement la correspondance entre tenants, références et identifiants, ainsi que les fixtures et leurs résultats attendus. C'est une modification du projet, pas une configuration déjà validée par R3.
Rejouez ensuite prepare, index, retrieve, generate et evaluate. Mesurez séparément les contextes obtenus, les appels effectifs au générateur, les marqueurs interdits et les latences. Conservez aussi le contrôle sans filtre pour vérifier que votre nouveau jeu permet toujours de détecter le défaut étudié.
N'annoncez pas de résultat avant l'exécution. La variante doit garder la règle « filtre avant récupération » et la validation avant génération, mais ces deux propriétés ne suffisent pas, à elles seules, à prouver une sécurité générale. Cette expérience supplémentaire est proposée au lecteur ; aucun score R3 ne lui est attribué.
Ce qui manque avant la production
Une vraie identité et des droits qui évoluent
La table de principaux est une fixture. Une application réelle doit intégrer une identité vérifiée, une révocation effective, la gestion des tenants, des groupes et des droits documentaires. Une autorisation qui était valable hier peut ne plus l'être aujourd'hui.
Les ACL, pour Access Control Lists, décrivent qui peut accéder à une ressource. Elles sont évoquées ici comme un besoin de production, pas comme une fonctionnalité fournie par le contrôleur. L'OWASP recommande notamment de refuser par défaut et de vérifier les permissions à chaque requête.
Des droits qui suivent le document dans toute la chaîne
Un RAG documentaire peut découper un fichier en passages, ou chunks, pour ne rechercher que les portions utiles. Les permissions doivent alors accompagner chaque passage. Protéger uniquement le fichier d'origine ne suffit pas si ses fragments deviennent accessibles par un autre chemin.
Les caches, les journaux, les citations, les réponses et les mises à jour documentaires doivent également être testés. À titre d'exemple de conception, réutiliser une réponse mise en cache pour un autre utilisateur sans réexaminer son périmètre pourrait contourner la vérification effectuée sur une recherche neuve. Le tutoriel n'évalue pas ce scénario de cache.
Une évaluation plus large que ces 80 fixtures
Le projet ne couvre pas les documents réels, l'ingestion, la persistance Qdrant, l'indexation atomique, une API de production, les quotas, le chiffrement, l'observabilité, les sauvegardes ou la charge. L'observabilité désigne ici les moyens de comprendre le comportement du système à partir de ses traces et mesures.
Il ne couvre pas non plus l'injection documentaire ni l'ensemble des requêtes malveillantes. Un document autorisé n'est pas nécessairement un document fiable : son contenu peut, par exemple, chercher à influencer le générateur. Filtrer les tenants et vérifier la fidélité d'une réponse sont deux sujets différents.
Enfin, le filtre utilise une référence exacte connue à l'avance. Passer à une recherche RAG ouverte demande une autre architecture d'autorisation et une autre évaluation. Ni les 41 contextes obtenus ni le taux de 1,0 ne permettent de sauter cette étape.
Dépannage et nettoyage
CUDA échoue pendant le préflight. Vérifiez le pilote NVIDIA, NVIDIA Container Toolkit et GPU_DEVICE, puis relancez le préflight. Il ne réalise aucune installation. Une carte détectée sur l'hôte peut rester inaccessible au conteneur.
Le serveur de génération n'est pas prêt. Consultez les journaux du service server et vérifiez que son endpoint de santé répond. Un endpoint de santé est un point d'accès qui indique si le service est disponible ; il ne constitue pas une génération de texte.
Qdrant n'est pas prêt. Vérifiez qu'il a été lancé avec docker compose up -d qdrant server avant index. Le programme de commandes utilise --no-deps : le parcours prévoit donc explicitement le démarrage des services nécessaires.
Un contrôle de contexte échoue. Relisez le principal, les tenants dans retrieved et le contenu de context. Ne supprimez pas la validation pour obtenir une réponse : elle vous signale précisément l'incohérence que l'expérience cherche à rendre visible.
Ne lancez pas deux parcours concurrents sur le même GPU. Une fois les observations conservées, terminez depuis la racine du projet :
docker compose down
Dans ce tutoriel, l'index temporaire est supprimé au nettoyage ; les modèles et les sorties restent disponibles. Gardez les fichiers de outputs/ pour pouvoir comparer votre reproduction à vos expériences suivantes.
Synthèse
Dans un RAG, le bon ordre n'est pas « récupérer tout ce qui semble pertinent, puis demander au modèle de faire attention ».
C'est : établir le principal de confiance, appliquer les droits à la récupération, valider le contexte, puis seulement appeler le générateur lorsqu'un contexte existe.
L'expérience rend cette séquence observable avec Alice, Bob et 80 scénarios contrôlés. Elle montre comment lire les filtres, suivre les refus et interpréter les mesures, sans déléguer une décision d'autorisation au modèle. C'est cette séparation des responsabilités que vous pourrez réutiliser dans vos propres projets, avec une authentification, des droits et une évaluation adaptés à leur réalité.
Pour approfondir
Les références suivantes complètent les explications de concepts. Elles ne constituent pas de nouvelles validations du projet : pour reproduire les résultats, conservez le code, les données et la configuration du ZIP R3.
Comprendre la recherche et le contexte. L'article original sur le RAG présente l'association récupération–génération. L'article E5 explique la famille d'encodeurs de texte ; sa lecture n'est pas nécessaire pour exécuter le tutoriel et ne remplace pas l'identification des actifs du projet.
Lire les requêtes Qdrant. La documentation officielle des filtres détaille la composition des conditions. La documentation des payloads décrit les données associées aux vecteurs. La documentation de recherche précise notamment le rôle du paramètre exact.
Préparer une intégration réelle. La fiche OWASP sur l'autorisation aide à distinguer identité, permissions et contrôles serveur. Le guide officiel NVIDIA Container Toolkit concerne l'accès aux GPU depuis les conteneurs.