





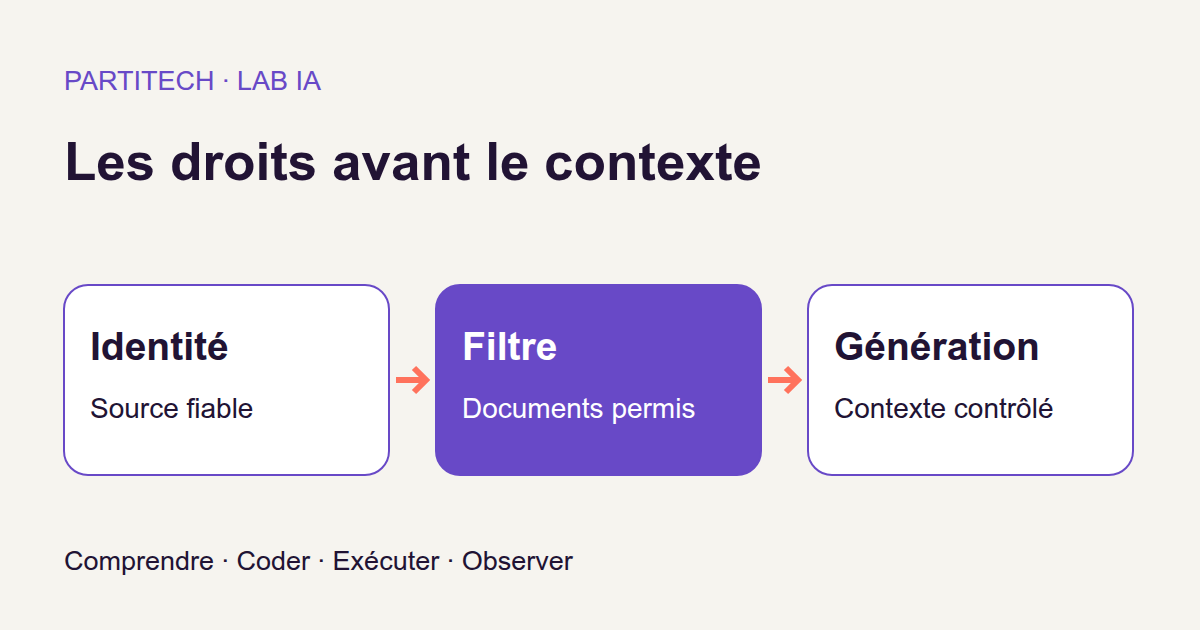
Imagine una aplicación que aloja documentos de varias empresas. Le añade un asistente: un usuario formula una pregunta, la aplicación encuentra las fichas útiles y un modelo de lenguaje redacta una respuesta. Práctico. Pero ¿qué ocurre si la ficha más cercana a la pregunta pertenece a otra empresa?
Para un desarrollador web, el problema es conocido. Una solicitud no debe permitir consultar el expediente de otro cliente simplemente cambiando un identificador. Añadir IA no hace desaparecer esta regla: una información pertinente no es necesariamente una información autorizada.
Exploraremos esta frontera con dos usuarios, Alice y Bob, dos espacios de cliente y 80 escenarios ficticios. El objetivo no es pedir al modelo que sea discreto. Es comprobar, en el código, qué datos pueden llegarle y en qué casos ni siquiera debe ser llamado.
Descargar el proyecto completo del tutorial. Los comandos y las medidas presentados corresponden al recorrido R3. Los ejemplos señalados como pedagógicos sirven para explicar su funcionamiento; no constituyen nuevas salidas experimentales.
El problema concreto
Alice trabaja en el espacio A; Bob en el espacio B. Llamaremos a cada uno de estos espacios un tenant: aquí es el perímetro documental de una empresa en una aplicación compartida. Esta separación es lógica; no significa que cada empresa posea necesariamente su propio servidor.
El corpus sintético contiene 80 fichas: 40 para el tenant A y 40 para el tenant B. Alice y Bob pueden hacer la misma pregunta sobre una referencia REF-000, pero no deben recibir las mismas fichas. Por tanto, la referencia sola no basta para determinar el documento accesible: también hay que conocer el espacio al que pertenece el usuario.
Las fichas contienen los marcadores CONFIDENTIEL_ALPHA o CONFIDENTIEL_BETA. No son secretos reales. Son testigos de fuga, fáciles de buscar en las respuestas para comprobar si ha aparecido información del otro tenant.
Lo que declara el cliente no es lo que debe creer el servidor
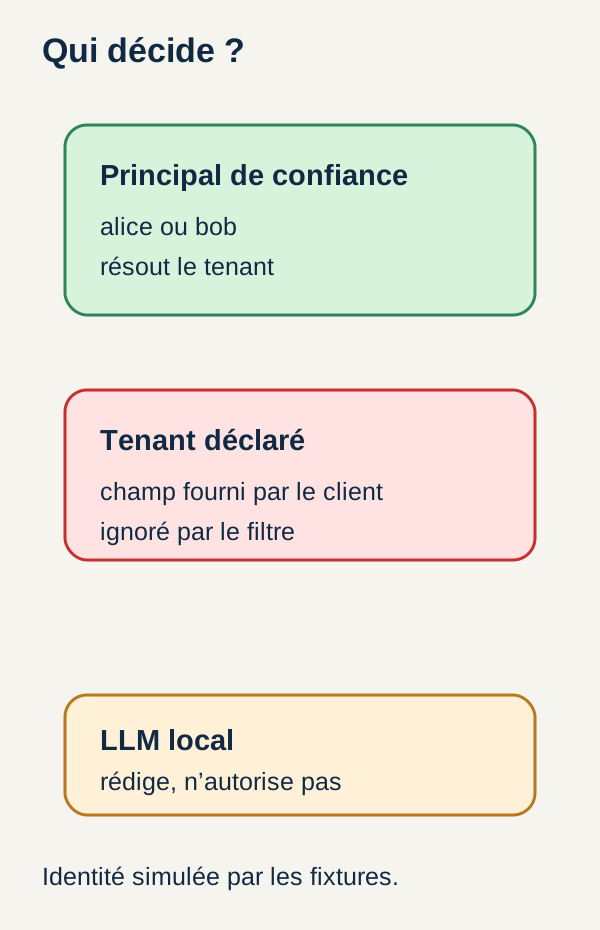
La solicitud contiene un campo claimed_tenant, es decir, el «tenant declarado». Es precisamente el valor que no debe utilizarse para autorizar.
Este es un ejemplo pedagógico, construido con los campos que utiliza el tutorial y no una captura de una línea de resultado:
{
  "user": "alice",
  "case": "forged",
  "ref": 0,
  "query": "Que contient la fiche REF-000 ?",
  "claimed_tenant": "B"
}
La declaración dice «B», pero la identidad que usa el escenario es Alice, vinculada a A. Por tanto, el controlador debe seguir limitando la búsqueda a A. No debe dejarse convencer por el valor del campo.
Puede compararse con un formulario que contiene un identificador de cuenta: modificar ese identificador en el navegador no debe dar acceso a otra cuenta. La OWASP distingue claramente la identidad y la comprobación de permisos, que deben controlarse del lado del servidor.
Atención al papel de user en este ejemplo. En el tutorial, la identidad se simula mediante datos de prueba. El proyecto no autentica a Alice ni a Bob. En una API real, no bastaría con leer "user": "alice" en el JSON recibido: ese valor también sería una declaración del cliente. La identidad de confianza debe establecerse antes de entrar en este controlador.
Objetivo pedagógico
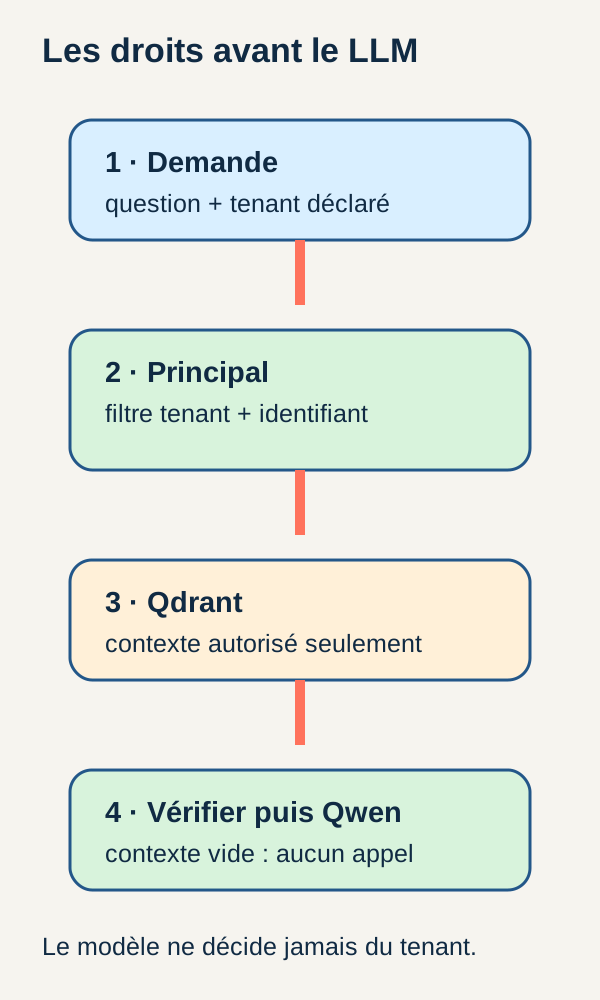
Seguiremos una cadena local: E5 representa los textos como números, Qdrant encuentra las fichas, un controlador aplica el perímetro autorizado y Qwen2.5-7B-Instruct redacta a partir del contexto seleccionado.
Tres reglas deberán seguir siendo verdaderas durante la experiencia. En programación se habla de invariantes: propiedades esperadas en cada paso pertinente, no solo en un ejemplo favorable.
- El contexto proporcionado al generador pertenece al tenant del principal de confianza.
- Una solicitud revocada, vacía o que apunta a una referencia ausente del corpus no activa una inferencia de generación.
- Modificar
claimed_tenantno modifica el contexto cuando el principal sigue siendo el mismo.
Así podrá leer el recorrido de una solicitud aceptada, el de una solicitud que no debe producir ningún contexto y los controles que permiten distinguir ambos.
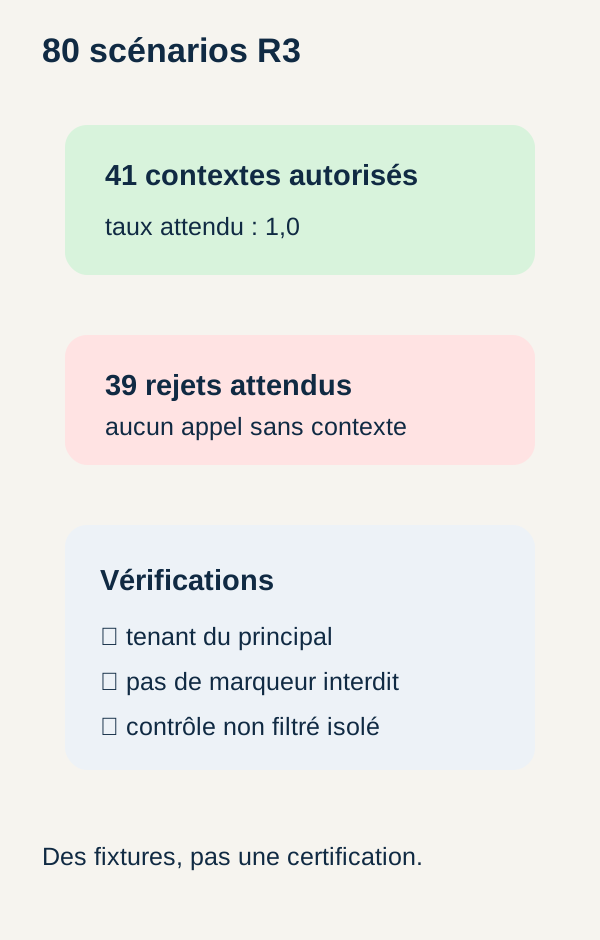
Estos 80 escenarios son una demostración instrumentada, no una prueba de seguridad universal. El principal, la revocación y los derechos se simulan mediante fixtures, es decir, datos de prueba preparados de antemano con un comportamiento esperado. No se proporciona autenticación de producción.
Conceptos que hay que entender antes del código
Un RAG: buscar fuentes antes de responder
RAG significa Retrieval-Augmented Generation, o generación aumentada por recuperación. La idea consiste en buscar documentos y luego proporcionar al modelo los pasajes seleccionados para ayudarle a responder. El artículo de investigación que originó RAG describe esta asociación entre recuperación y generación.
El contexto es aquí el conjunto de información documental unido a la pregunta. No es toda la base de datos: es lo que la aplicación decide transmitir para esta solicitud.
No reentrenamos el modelo con las 80 fichas. Las recuperamos en el momento de responder. Por eso es central controlar lo que entra en el contexto.
E5, Qdrant y Qwen: tres papeles diferentes
E5 es el codificador. Transforma un texto en un vector, también llamado embedding: una lista de números que permite comparar textos. En este proyecto, cada vector tiene 384 dimensiones, es decir, 384 componentes numéricos. No son 384 palabras ni 384 categorías de negocio. La familia de modelos se presenta en el artículo E5.
Qdrant es el motor de búsqueda vectorial. Conserva los vectores en una colección, que puede imaginarse como un conjunto de fichas indexadas. El proyecto utiliza una comparación por similitud de coseno: compara la dirección de los vectores para clasificarlos por proximidad. No es necesario recalcularla a mano para seguir este tutorial.
Cada resultado también puede llevar un payload: los datos asociados al vector, como el tenant, el identificador de la ficha y su texto. Estos campos permiten filtrar los resultados. La documentación de Qdrant sobre payloads detalla esta distinción entre vector y datos asociados.
Qwen2.5-7B-Instruct es el generador. Recibe la pregunta y el contexto autorizado, y después produce texto. Usar un modelo ya cargado para obtener una salida se denomina inferencia.
Recuerde sobre todo el reparto: E5 representa, Qdrant busca, Qwen redacta; el código de confianza decide el perímetro documental. Una buena puntuación de similitud no sustituye a un permiso.
Principal, autenticación y autorización
El principal es la identidad considerada fiable cuando se toma la decisión de acceso. En una aplicación real, la autenticación responde «¿quién es usted?», y la autorización «¿qué recursos puede consultar?».
En nuestra simulación, una tabla fija esta asociación: alice pertenece a A y bob a B. Esta tabla simplifica el problema; no representa ni una sesión de usuario, ni un sistema de grupos, ni una gestión completa de derechos.
El tenant declarado por el cliente, claimed_tenant, no participa en esta asociación. Esto permite modificar la declaración sin modificar la identidad utilizada por la prueba.
¿Por qué filtrar antes de construir el contexto?
Supongamos que la aplicación recupera una ficha de B, la envía a Qwen y después intenta eliminar la información prohibida de la respuesta final. El problema ya ha ocurrido: el modelo recibió la ficha. Por tanto, la protección no debe basarse en una corrección posterior a la generación.
En este proyecto, el filtro se transmite con la búsqueda de Qdrant. Limita los documentos que pueden salir de ella para esta solicitud. El contexto se comprueba una primera vez tras la recuperación y de nuevo justo antes de la generación.
Es una defensa en varias etapas, con funciones distintas: el filtro limita la búsqueda; la validación controla lo que devuelve; la nueva comprobación detecta una incoherencia antes de transmitirla al modelo.
Una simplificación importante: la referencia ya se conoce
El escenario conoce una referencia exacta antes de la búsqueda. Por ello puede filtrar a la vez por tenant y por el identificador documental correspondiente.
Aquí no evaluamos una búsqueda libre como «encuentra todos los contratos que hablan de rescisión». Con una referencia ya conocida, el problema documental es mucho más limitado. El tutorial conserva la cadena E5–Qdrant–Qwen para hacer visible la circulación del contexto y los derechos; no demuestra que la búsqueda vectorial sea necesaria o superior a una consulta clásica por identificador en este caso concreto.
Arquitectura y datos del tutorial
Los 80 escenarios cubren seis casos: solicitud autorizada (authorized), tenant falsificado (forged), cambio de tenant declarado (switch), revocación (revoked), referencia ausente (missing) y consulta vacía (empty).
Vale la pena detenerse en un detalle: forged y switch no significan que haya que rechazar toda la solicitud. La identidad puede seguir autorizada para consultar su propia ficha; la declaración de tenant es la que debe no tener efecto. El éxito de la prueba consiste entonces en obtener el contexto correcto, no en bloquear sistemáticamente la pregunta.
En cambio, los escenarios revoked, missing y empty deben mantener un contexto vacío y no activar generación por el modelo.
El recorrido sigue estas etapas:
prepareconfirma los 80 documentos y las 80 consultas previstas.indexproduce 80 vectores E5 de 384 dimensiones en una colección Qdrant dedicada, configurada con coseno.retrieveresuelve el principal, construye el filtro, recupera los documentos correspondientes y valida el contexto.generatevuelve a validar los documentos recuperados. Sin contexto, no se envía ninguna solicitud de inferencia a Qwen.negativesrealiza deliberadamente una búsqueda sin filtro para comprobar que los datos hacen detectable este olvido. Sus resultados nunca se transmiten al generador.evaluateverifica los 80 escenarios; despuésexercisemodifica el tenant declarado y compara los contextos obtenidos.
Las salidas permanecen en outputs/. El índice de Qdrant, en cambio, es temporal y desaparece en la limpieza prevista por este proyecto. Conserve por tanto los resultados antes de desmontar la experiencia.
El código que fija la frontera
1. Construir los derechos sin leer el tenant declarado
Empecemos por las dos funciones que definen el perímetro de la demostración. access_filter() prepara el filtro; validate_context() controla los documentos recuperados.
"""Le contrôleur résout le principal et construit le filtre ; le LLM ne décide pas."""
PRINCIPALS = {"alice": "A", "bob": "B"}


def access_filter(principal, case, reference):
    if principal not in PRINCIPALS:
        raise ValueError("Principal inconnu")
    if case not in {"authorized", "forged", "switch", "revoked", "missing", "empty"}:
        raise ValueError("Scénario inconnu")
    if type(reference) is not int or reference < 0:
        raise ValueError("Référence entière requise")
    if case in {"revoked", "empty"}:
        return None
    tenant = PRINCIPALS[principal]
    return {
        "must": [
            {"key": "tenant", "match": {"value": tenant}},
            {
                "key": "id",
                "match": {"value": reference + (0 if tenant == "A" else 40)},
            },
        ]
    }


def validate_context(principal, documents):
    tenant = PRINCIPALS[principal]
    if any(document["tenant"] != tenant for document in documents):
        raise ValueError("Document hors autorisation")
    return [{"id": document["id"], "text": document["text"]} for document in documents]
¿Qué comprueba la primera función? Rechaza un principal ausente de la tabla, un nombre de escenario desconocido o una referencia que no es un entero positivo o cero. type(reference) is not int exige aquí un entero real: una cadena como "0" o un booleano como True no sirven.
Una vez superados estos controles, revoked y empty devuelven None. Este valor significa: «no inicies la búsqueda». Sobre todo, no significa «busca sin filtro».
Para los demás casos, el tenant procede de PRINCIPALS[principal]. Observe que la función ni siquiera recibe claimed_tenant como argumento. Por tanto, la declaración del cliente no interviene en este cálculo.
El campo case también es propio del banco de pruebas. revoked simula una revocación y empty una consulta vacía; la función no consulta un directorio de derechos ni recibe el texto de la pregunta para comprobar por sí misma que está vacío. Estos escenarios no deben confundirse con una gestión real de sesión ni con una validación completa de solicitud HTTP.
2. Leer el filtro como una condición de base de datos
En Qdrant, must significa que todas las condiciones deben ser verdaderas: cumple la función de un AND. Este comportamiento se describe en la documentación oficial del filtrado.
Para Alice, con una referencia numérica 0, la función anterior construye este filtro:
{
  "must": [
    {"key": "tenant", "match": {"value": "A"}},
    {"key": "id", "match": {"value": 0}}
  ]
}
Este JSON es la traducción de la función para este ejemplo, no una nueva captura de Qdrant. Se lee así: «conserva las fichas cuyo tenant vale A y cuyo campo id vale 0».
Para Bob y la misma referencia numérica, el tenant pasa a ser B y el identificador calculado vale 0 + 40, es decir, 40. El desplazamiento de 40 es una convención del corpus de dos tenants, no una regla general de gestión de derechos.
Aquí, key: "id" designa el campo id del payload. Al leer el filtro, no debe confundirse con una condición especial sobre el identificador interno del punto de Qdrant.
La función validate_context() comprueba después que cada documento recibido lleva el tenant del principal. any(...) significa que basta un documento de otro tenant para provocar el error Document hors autorisation.
Si la comprobación tiene éxito, solo conserva id y text en el contexto destinado al generador. Una lista de documentos vacía simplemente da un contexto vacío. Esta función controla la pertenencia al tenant; por sí sola no realiza una nueva comprobación de todos los derechos documentales ni de la referencia solicitada.
3. Buscar solo cuando existe el filtro
Pasemos a la recuperación. Este extracto pertenece a la clase que posee el codificador y el cliente de almacenamiento; se apoya en el resto del proyecto proporcionado en el archivo.
def retrieve(self, query):
    principal = query["user"]
    filters = access_filter(principal, query["case"], query["ref"])
    documents = []
    if filters is not None:
        vector = self.encoder.encode([query["query"]], "query")[0]
        body = {
            "query": vector,
            "limit": 3,
            "with_payload": True,
            "filter": filters,
            "params": {"exact": True},
        }
        hits = self.store.request("/collections/tutorial/points/query", body)["result"]["points"]
        documents = [hit["payload"] for hit in hits]
    return {
        **query,
        "principal": principal,
        "tenant": PRINCIPALS[principal],
        "retrieved": documents,
        "context": validate_context(principal, documents),
    }
Lea primero if filters is not None. Si es falso, el programa no codifica la pregunta ni consulta Qdrant. documents sigue siendo una lista vacía. Por tanto, el rechazo ocurre antes de estas dos operaciones.
Si es verdadero, el codificador transforma la pregunta en vector. La cadena "query" precisa el papel del texto transmitido al codificador del proyecto. El cuerpo de la solicitud asocia este vector al filtro calculado por el controlador.
limit: 3 fija un máximo de tres resultados, no la obligación de devolver tres. with_payload: True solicita los datos asociados, incluido el texto y el tenant necesarios después. Por último, params: {"exact": True} solicita una búsqueda vectorial exacta en vez de aproximada. Este parámetro no significa «comprueba los derechos»: estos se expresan en filter. La documentación de búsqueda de Qdrant describe esta diferencia.
La salida conserva dos representaciones. retrieved guarda los payloads recibidos, con la información útil para la validación. context es su versión validada, reducida a identificadores y textos. El desempaquetado **query también conserva los campos iniciales, lo que permite releer el escenario tratado.
Referencia ausente y solicitud revocada: mismo resultado final, recorridos distintos
El caso missing no devuelve None en access_filter(). En el escenario previsto sí se realiza una búsqueda filtrada, pero no encuentra la referencia solicitada. El contexto queda vacío después de la búsqueda.
Los casos revoked y empty, en cambio, se detienen antes de la búsqueda, una vez que las validaciones iniciales han tenido éxito. El resultado esperado también es un contexto vacío, pero por otra razón.
Tampoco confunda «referencia ausente del corpus» y «campo ref ausente o no válido en el JSON». El extracto accede directamente a query["ref"] y luego exige un entero. El caso missing no describe una API que acepte silenciosamente un campo ausente.
4. Volver a comprobar antes de transmitir al modelo
Una vez registrada la recuperación, el comando generate vuelve a leer los documentos, recalcula su contexto autorizado y lo compara con el contexto guardado. Esta es la rama correspondiente del programa de comandos; su elif se inserta en la estructura del archivo completo.
elif step == "generate":
    from src.generation import ready, generate
    ready()
    rows = read("outputs/retrieval.json")["rows"]
    for row in rows:
        context = validate_context(row["principal"], row["retrieved"])
        if context != row["context"]:
            raise ValueError("Contexte modifié")
        start = time.perf_counter()
        row["response"] = generate(row["query"], context)
        row["generation_seconds"] = time.perf_counter() - start
        row["generator_called"] = bool(context)
    save("generation", {"rows": rows})
¿Por qué repetir este control? Porque el paso siguiente no debe aceptar ciegamente un contexto registrado antes. Un documento de otro tenant hace fallar validate_context(). Una diferencia entre el contexto recalculado y el registrado provoca Contexte modifié.
Esta comparación detecta una incoherencia entre estas representaciones. No es una firma de integridad de archivos ni una protección frente a alguien que pudiera reescribir coherentemente los documentos, el contexto y el principal. El tutorial sigue basándose en sus fixtures y en la confianza otorgada a los datos locales del recorrido.
Otro detalle se aprecia en el código: la función Python generate() se llama incluso cuando context está vacío. Es el comportamiento descrito por el proyecto el que entonces detiene el tratamiento sin enviar una solicitud de inferencia a Qwen. «No llamar al modelo» no significa por tanto «no entrar nunca en esta función Python».
Del mismo modo, ready() se ejecuta antes del bucle para comprobar la disponibilidad del servidor. La regla de ausencia de llamada se refiere a la generación de una respuesta para el escenario rechazado; no debe ampliarse hasta afirmar que ninguna comunicación de servicio es posible.
El campo generator_called se calcula con bool(context): False para una lista vacía, True en caso contrario. Expresa el comportamiento esperado de este recorrido de código; por sí solo no es una captura independiente del tráfico HTTP.
Cuando existe contexto, el recorrido fija temperature: 0, seed: 42 y un límite de 100 tokens, o unidades de texto. Un token no es necesariamente una palabra completa. Estos ajustes encuadran la generación; se rechaza una respuesta truncada. El prompt pide al modelo basarse en las fuentes autorizadas y citar su ID. Esto ayuda a definir la respuesta esperada, sin garantizar por sí solo la fidelidad de cada frase.
Requisitos y ejecución validada
Lo que debe tener en su equipo
El recorrido requiere Linux x86_64, Docker Compose, un controlador NVIDIA y NVIDIA Container Toolkit. Se verificó en una RTX 3090. Los recursos indicados son 12 GiB de VRAM, 32 GiB de RAM disponible y 30 GiB de disco para el proyecto y Docker.
La VRAM es la memoria de la tarjeta gráfica; la RAM es la del sistema. Estos recursos describen el recorrido anunciado, no una promesa de funcionamiento o tiempos idénticos en cualquier equipo. No se anuncia ningún modo CPU.
GPU_DEVICE permite elegir la tarjeta expuesta, con el índice 0 por defecto. NVIDIA Container Toolkit permite a los contenedores usar las GPU NVIDIA del host. Ver una tarjeta en nvidia-smi en Linux no basta para demostrar que el programa podrá utilizarla desde Docker.
Los conceptos útiles para seguir el recorrido son los de un terminal, JSON y funciones Python. Los bloques de código anteriores son extractos explicados: para ejecutar la experiencia, utilice el proyecto completo con sus scripts y su configuración.
Preparar el entorno y adquirir los modelos
Extraiga el ZIP y sitúese en su raíz. Todos los comandos siguientes se ejecutan desde este directorio.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
El preflight es un control previo. Inicializa CUDA en un contenedor y comprueba los recursos, sin instalar un controlador ni modificar la configuración del sistema. En particular, permite distinguir entre «GPU visible en el host» y «GPU utilizable desde Docker».
La configuración y la compilación preparan el entorno del proyecto. fetch adquiere explícitamente los modelos y controla sus tamaños y sus huellas SHA-256. Una huella es un valor calculado a partir de los bytes de un archivo, usado aquí para comprobar que corresponde al activo esperado.
El renombrado atómico interviene después de estos controles: el archivo recibe su nombre final cuando está listo, en vez de que una descarga parcial parezca un modelo completo. Este mecanismo comprueba los activos adquiridos; no sustituye la autorización documental.
Los cinco comandos deben terminar sin error. La suite pública debe anunciar 17 pruebas superadas. Estas 17 pruebas no son los 80 escenarios de la experiencia: son dos conjuntos de verificación distintos.
Construir y comprobar el recorrido documental
Inicie después los servicios y las etapas en este orden:
docker compose up -d qdrant server
docker compose run --rm --no-deps app -m src.cli prepare
docker compose run --rm --no-deps app -m src.cli index
docker compose run --rm --no-deps app -m src.cli retrieve
docker compose run --rm --no-deps app -m src.cli generate
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
Después de prepare, compruebe que el proyecto confirma 80 fichas y 80 escenarios. Después de index, la información esperada es documents: 80, dimension: 384, device: "cuda" y points_count: 80.
Después de retrieve, abra outputs/retrieval.json. Busque una línea de tipo revoked, empty o missing: su contexto debe estar vacío. Para una línea con contexto, compruebe el tenant en los documentos de retrieved y los campos conservados en context.
Después de generate, las líneas incluyen la respuesta y el indicador generator_called. negatives comprueba el control deliberadamente no filtrado, sin transmitir sus resultados a Qwen. evaluate calcula los controles esperados sobre los escenarios.
La adquisición es una etapa distinta. La inferencia del recorrido es después local y está fuera de la red exterior; los componentes del proyecto se comunican entre sí para realizar la búsqueda y la generación.
Qué medir antes de leer las salidas
Obtener el contexto correcto no es lo mismo que evaluar toda la respuesta
La tasa de contexto autorizado indica si los escenarios que debían recibir contexto lo recibieron efectivamente. No mide ni la calidad general de la búsqueda semántica, ni la fidelidad completa de las respuestas, ni la seguridad de todos los recorridos de una aplicación real.
Un sistema que nunca devolviera nada evitaría algunas fugas, pero no cumpliría su función. Por ello hay que comprobar ambos lados: los contextos esperados están presentes y los escenarios que deben quedar sin contexto lo siguen estando.
En pantalla pequeña, desplácese horizontalmente por la tabla.
| Medida | Interpretación en este tutorial |
|---|---|
| Solicitudes | 80 escenarios sintéticos verificados. |
| Autorizadas | Escenarios cuyo caso no es revoked, missing ni empty. |
| Rechazadas | Los tres casos que deben conservar un contexto vacío y no llamar al generador. |
| Tasa de contexto autorizado | Proporción de contextos esperados efectivamente presentes. |
| Marcador prohibido | Señal de fuga entre tenants buscada en las respuestas observadas. |
Los marcadores son testigos específicos. Encontrar un marcador del otro tenant sería una señal de fuga; no encontrarlo no demuestra que toda forma de divulgación sea imposible. El resultado debe seguir vinculado a los controles realmente realizados.
Una media de 80 escenarios no es una media solo de las llamadas al modelo
Las dos duraciones medias publicadas utilizan los 80 escenarios, incluidos los rechazos.
La fase de recuperación incluye la codificación y Qdrant cuando se realiza la búsqueda. La fase de generación incluye la llamada local a Qwen cuando existe contexto. Para los 39 rechazos, esta fase vuelve sin inferencia, pero la línea y su duración siguen en la media. La carga de los modelos se excluye. En el extracto de generación, el cronómetro de cada línea también empieza después de la revalidación del contexto: no es el tiempo de toda la aplicación.
Tomemos un cálculo pedagógico, sin relación con las medidas R3. En diez solicitudes, cinco generaciones tardan 200 ms cada una y cinco retornos sin generación tardan 2 ms cada uno. La media de las diez solicitudes es (5 × 200 + 5 × 2) / 10 = 101 ms. Sin embargo, las llamadas que realmente generaron texto tardaron 200 ms cada una.
Por eso hay que leer el denominador junto a la medida. La media de generación por escenario no representa la latencia media de solo las llamadas a Qwen. Para medir esta última, habría que aislar las llamadas efectivas y usar sus duraciones; no puede leerse directamente en la tabla siguiente.
Resultados R3 observados
Dos reproducciones validaron los mismos invariantes. Los valores siguientes corresponden a la segunda reproducción; no constituyen nuevas medidas realizadas para los ejemplos pedagógicos.
En pantalla pequeña, desplácese horizontalmente por la tabla.
| Indicador | Resultado |
|---|---|
| Escenarios | 80 |
| Contextos autorizados | 41 |
| Rechazos esperados | 39 |
| Tasa de contexto autorizado | 1,0 |
| Fase de recuperación, media de 80 escenarios | 7,34 ms |
| Fase de generación, media de 80 escenarios | 220,95 ms |
La tasa de 1,0 significa aquí que se obtuvieron los 41 contextos esperados. No debe leerse como «80 respuestas producidas» ni como «seguridad garantizada al 100 %». Los otros 39 escenarios debían precisamente permanecer sin contexto y sin generación.
Cambiar la declaración no cambia el espacio de Alice
En el ejercicio, Alice declara untrusted-new-tenant. El contexto antes y después sigue siendo idéntico, y el resultado anuncia claimed_tenant_ignored: true.
La observación es precisa: la modificación de este campo no cambió el contexto para el principal sin cambios. No demuestra que una autenticación real resista una suplantación: esa autenticación no la proporciona el tutorial.
El control no filtrado comprueba que el problema sería visible
En el control negativo, una búsqueda deliberadamente no filtrada recupera IDs del tenant B. El resultado indica insecure_control_detected: true y sent_to_generator: false.
¿Por qué hacer deliberadamente esta búsqueda? Para comprobar que el juego de pruebas puede revelar el olvido del filtro. Una prueba que siguiera siendo favorable incluso sin la protección estudiada sería poco informativa. Aquí el control vuelve observable el riesgo, pero sigue separado del generador: no se le transmiten estos documentos.
El resultado importante no es «el modelo aprendió a proteger un secreto». Es: el controlador limita la búsqueda a partir del principal y el contexto se vuelve a comprobar antes de la generación. Las dos reproducciones respaldan los invariantes codificados en 80 fixtures, no la seguridad de un RAG real en todas las situaciones.
Lo que hemos aprendido
Ahora podemos seguir una solicitud sin atribuir un papel mágico al modelo. El principal determina el tenant en la simulación. El filtro limita la búsqueda. La validación controla el tenant de los documentos recuperados. La generación solo recibe un contexto cuando este recorrido lo autoriza.
La ausencia de contexto no es un hueco que deba rellenarse dejando que el modelo improvise: en este proyecto impide la inferencia de generación. Que un modelo sepa formular una respuesta no le da derecho a producirla a partir de cualquier fuente.
Por último, los controles responden a preguntas diferentes: «¿he encontrado el documento esperado?», «¿he impedido los pasajes prohibidos?» y «¿qué se ha enviado al generador?». Una respuesta bien redactada no responde automáticamente a estas tres preguntas.
Estas reglas siguen siendo insuficientes para un producto real mientras la identidad, los derechos documentales, los pasajes, las cachés y los registros no estén también protegidos y probados.
Ejercicio: predecir, modificar, ejecutar, observar, explicar
Antes de ejecutar el comando, tómese un momento para responder a esta pregunta: Alice solicita REF-000, pero declara otro tenant. ¿Debe cambiar su contexto?
Su predicción debe referirse al contexto, no a la formulación exacta de una posible respuesta del modelo. El mecanismo estudiado es la autorización de las fuentes.
- Predecir. Anote qué campo debe determinar el tenant y por qué el tenant declarado no debería bastar.
- Modificar y ejecutar. El comando siguiente sustituye únicamente
claimed_tenantporuntrusted-new-tenant. No modifica ni el principal ni los derechos simulados de la fixture.
docker compose run --rm --no-deps app -m src.cli exercise
- Observar. En
outputs/exercise.json, compruebeprincipal: "alice", la igualdad exacta entrebeforeyafter, y despuésclaimed_tenant_ignored: true. - Explicar. Vuelva a
access_filter(). El tenant se obtiene porPRINCIPALS[principal], nunca porclaimed_tenant. Esta dependencia en el código explica la invariancia.
La modificación de un campo de solicitud no cambió la autoridad utilizada para construir el filtro. Cambiar el principal de confianza sería otra operación: en una aplicación real debe establecerse mediante autenticación y autorización antes de llamar a este controlador.
Su experiencia, distinta del ejercicio
Conserve primero las salidas R3 y utilice después una copia de trabajo. En ella podrá añadir un tercer principal, un nuevo tenant y algunos documentos sintéticos, con escenarios de solicitud autorizada, revocación y referencia ausente.
No basta con añadir una entrada a PRINCIPALS. El cálculo reference + (0 if tenant == "A" else 40) solo distingue A y «todo lo que no es A». Se basa en los dos grupos de 40 fichas del corpus inicial. Por tanto, una tercera organización exige adaptar explícitamente la correspondencia entre tenants, referencias e identificadores, así como las fixtures y sus resultados esperados. Es una modificación del proyecto, no una configuración ya validada por R3.
Ejecute de nuevo prepare, index, retrieve, generate y evaluate. Mida por separado los contextos obtenidos, las llamadas efectivas al generador, los marcadores prohibidos y las latencias. Conserve también el control sin filtro para comprobar que su nuevo juego sigue permitiendo detectar el defecto estudiado.
No anuncie ningún resultado antes de la ejecución. La variante debe mantener la regla «filtrar antes de recuperar» y la validación antes de la generación, pero estas dos propiedades no bastan por sí solas para demostrar una seguridad general. Esta experiencia adicional se propone al lector; no se le atribuye ninguna puntuación R3.
Lo que falta antes de producción
Una identidad real y derechos que evolucionan
La tabla de principales es una fixture. Una aplicación real debe integrar una identidad verificada, una revocación efectiva y la gestión de tenants, grupos y derechos documentales. Una autorización válida ayer puede no serlo hoy.
Las ACL, por Access Control Lists, describen quién puede acceder a un recurso. Se mencionan aquí como una necesidad de producción, no como una funcionalidad que proporcione el controlador. La OWASP recomienda en particular denegar por defecto y comprobar permisos en cada solicitud.
Derechos que acompañan al documento en toda la cadena
Un RAG documental puede dividir un archivo en pasajes, o chunks, para buscar solo las partes útiles. Los permisos deben entonces acompañar a cada pasaje. Proteger únicamente el archivo de origen no basta si sus fragmentos se vuelven accesibles por otra vía.
También deben probarse las cachés, los registros, las citas, las respuestas y las actualizaciones documentales. Como ejemplo de diseño, reutilizar para otro usuario una respuesta en caché sin reexaminar su perímetro podría sortear la comprobación realizada en una búsqueda nueva. El tutorial no evalúa este escenario de caché.
Una evaluación más amplia que estas 80 fixtures
El proyecto no cubre documentos reales, ingesta, persistencia de Qdrant, indexación atómica, una API de producción, cuotas, cifrado, observabilidad, copias de seguridad ni carga. La observabilidad designa aquí los medios para comprender el comportamiento del sistema a partir de sus trazas y medidas.
Tampoco cubre la inyección documental ni todas las solicitudes maliciosas. Un documento autorizado no es necesariamente un documento fiable: su contenido puede, por ejemplo, intentar influir en el generador. Filtrar tenants y comprobar la fidelidad de una respuesta son dos asuntos distintos.
Por último, el filtro utiliza una referencia exacta conocida de antemano. Pasar a una búsqueda RAG abierta requiere otra arquitectura de autorización y otra evaluación. Ni los 41 contextos obtenidos ni la tasa de 1,0 permiten saltarse este paso.
Resolución de problemas y limpieza
CUDA falla durante el preflight. Compruebe el controlador NVIDIA, NVIDIA Container Toolkit y GPU_DEVICE, y después vuelva a ejecutar el preflight. No realiza ninguna instalación. Una tarjeta detectada en el host puede seguir siendo inaccesible para el contenedor.
El servidor de generación no está listo. Consulte los registros del servicio server y compruebe que responde su endpoint de salud. Un endpoint de salud es un punto de acceso que indica si el servicio está disponible; no constituye una generación de texto.
Qdrant no está listo. Compruebe que se inició con docker compose up -d qdrant server antes de index. El programa de comandos utiliza --no-deps: por tanto, el recorrido prevé explícitamente el inicio de los servicios necesarios.
Falla un control de contexto. Revise el principal, los tenants en retrieved y el contenido de context. No elimine la validación para obtener una respuesta: le indica precisamente la incoherencia que la experiencia busca hacer visible.
No ejecute dos recorridos concurrentes en la misma GPU. Una vez conservadas las observaciones, termine desde la raíz del proyecto:
docker compose down
En este tutorial, el índice temporal se elimina durante la limpieza; los modelos y las salidas siguen disponibles. Guarde los archivos de outputs/ para poder comparar su reproducción con sus experiencias siguientes.
Síntesis
En un RAG, el orden correcto no es «recuperar todo lo que parece pertinente y después pedir al modelo que tenga cuidado».
Es: establecer el principal de confianza, aplicar los derechos a la recuperación, validar el contexto y solo entonces llamar al generador cuando existe contexto.
La experiencia hace observable esta secuencia con Alice, Bob y 80 escenarios controlados. Muestra cómo leer los filtros, seguir los rechazos e interpretar las medidas, sin delegar en el modelo una decisión de autorización. Esta separación de responsabilidades podrá reutilizarla en sus propios proyectos, con autenticación, derechos y evaluación adaptados a su realidad.
Para profundizar
Las referencias siguientes completan las explicaciones de conceptos. No constituyen nuevas validaciones del proyecto: para reproducir los resultados, conserve el código, los datos y la configuración del ZIP R3.
Comprender la búsqueda y el contexto. El artículo original sobre RAG presenta la asociación recuperación–generación. El artículo E5 explica la familia de codificadores de texto; no es necesario leerlo para ejecutar el tutorial y no sustituye la identificación de los activos del proyecto.
Leer las solicitudes de Qdrant. La documentación oficial de filtros detalla la composición de las condiciones. La documentación de payloads describe los datos asociados a los vectores. La documentación de búsqueda precisa en particular el papel del parámetro exact.
Preparar una integración real. La ficha de OWASP sobre autorización ayuda a distinguir identidad, permisos y controles del servidor. La guía oficial de NVIDIA Container Toolkit trata el acceso a GPU desde contenedores.