





Immaginate un'applicazione che ospita i documenti di più aziende. Le aggiungete un assistente: un utente pone una domanda, l'applicazione trova le schede utili e un modello linguistico redige una risposta. Comodo. Ma cosa succede se la scheda più vicina alla domanda appartiene a un'altra azienda?
Per uno sviluppatore web il problema è familiare. Una richiesta non deve permettere di consultare la cartella di un altro cliente semplicemente cambiando un identificativo. Aggiungere l'IA non fa sparire questa regola: un'informazione pertinente non è necessariamente un'informazione autorizzata.
Esploreremo questo confine con due utenti, Alice e Bob, due spazi cliente e 80 scenari fittizi. L'obiettivo non è chiedere al modello di essere discreto, ma verificare nel codice quali dati possono raggiungerlo e in quali casi non deve neppure essere chiamato.
Scarica il progetto completo del tutorial. I comandi e le misure presentati corrispondono al percorso R3. Gli esempi indicati come didattici ne spiegano il funzionamento; non costituiscono nuovi output sperimentali.
Il problema concreto
Alice lavora nello spazio A; Bob nello spazio B. Chiameremo ciascuno di questi spazi un tenant: qui è l'ambito documentale di un'azienda in un'applicazione condivisa. Questa separazione è logica, ma non significa che ogni azienda possieda necessariamente il proprio server.
Il corpus sintetico contiene 80 schede: 40 per il tenant A e 40 per il tenant B. Alice e Bob possono porre la stessa domanda su un riferimento REF-000, ma non devono ricevere le stesse schede. Il solo riferimento non basta dunque a determinare il documento accessibile: occorre conoscere anche lo spazio a cui appartiene l'utente.
Le schede contengono i marcatori CONFIDENTIEL_ALPHA o CONFIDENTIEL_BETA. Non sono segreti reali: sono sentinelle di fuga, facili da cercare nelle risposte per verificare se è emersa un'informazione dell'altro tenant.
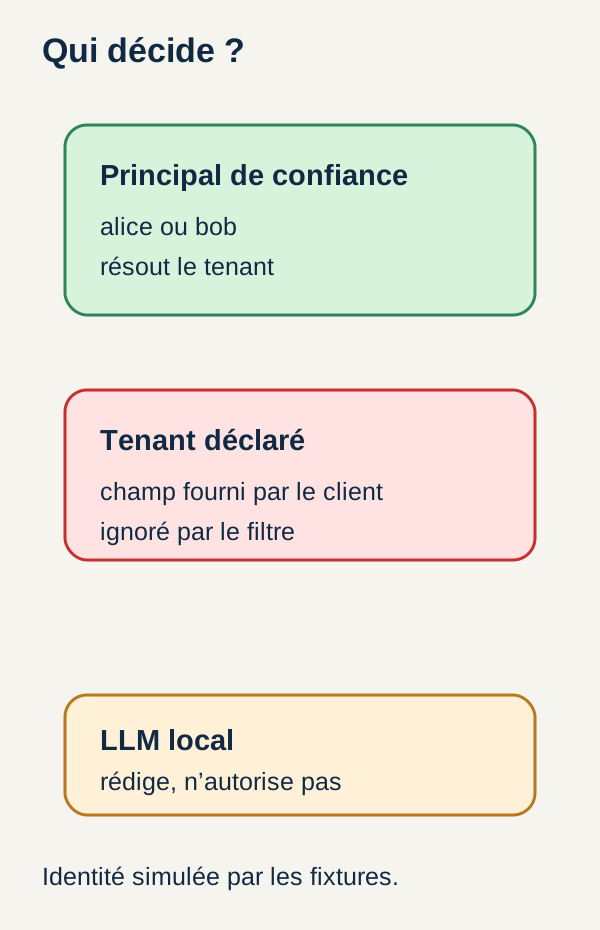
Ciò che il cliente dichiara non è ciò in cui il server deve credere
La richiesta contiene un campo claimed_tenant, cioè il «tenant dichiarato». È proprio il valore che non va usato per autorizzare.
Ecco un esempio didattico, costruito con i campi usati dal tutorial e non con una riga di risultato:
{
  "user": "alice",
  "case": "forged",
  "ref": 0,
  "query": "Que contient la fiche REF-000 ?",
  "claimed_tenant": "B"
}
La dichiarazione dice «B», ma l'identità usata dallo scenario è Alice, associata ad A. Il controller deve quindi continuare a limitare la ricerca ad A. Non deve lasciarsi convincere dal valore del campo.
È paragonabile a un modulo contenente un identificativo di conto: modificare quell'identificativo nel browser non deve dare accesso a un altro conto. L'OWASP distingue correttamente identità e verifica dei permessi, che devono essere controllati lato server.
Attenzione al ruolo di user in questo esempio. Nel tutorial l'identità è simulata dai dati di test. Il progetto non autentica Alice o Bob. In una vera API non basterebbe leggere "user": "alice" nel JSON ricevuto: anche quel valore sarebbe una dichiarazione del cliente. L'identità affidabile deve essere stabilita prima dell'ingresso in questo controller.
Obiettivo didattico
Seguiremo una catena locale: E5 rappresenta i testi come numeri, Qdrant ritrova le schede, un controller applica l'ambito autorizzato e Qwen2.5-7B-Instruct redige a partire dal contesto selezionato.
Tre regole dovranno restare vere durante l'esperimento. In programmazione si chiamano invarianti: proprietà attese in ogni passaggio interessato, non solo in un esempio favorevole.
- Il contesto fornito al generatore appartiene al tenant del principale affidabile.
- Una richiesta revocata, vuota o riferita a un documento assente dal corpus non attiva un'inferenza di generazione.
- Modificare
claimed_tenantnon modifica il contesto quando il principale resta lo stesso.
Saprete così leggere il percorso di una richiesta accettata, quello di una richiesta che non deve produrre alcun contesto e i controlli che permettono di distinguerli.
Questi 80 scenari sono una dimostrazione strumentata, non una prova di sicurezza universale. Il principale, la revoca e i diritti sono simulati da fixture, cioè dati di test preparati in anticipo con un comportamento atteso. Non viene fornita alcuna autenticazione di produzione.
Concetti da comprendere prima del codice
Un RAG: cercare fonti prima di rispondere
RAG significa Retrieval-Augmented Generation, ovvero generazione aumentata dal recupero. L'idea è cercare documenti e fornire al modello i passaggi selezionati per aiutarlo a rispondere. L'articolo di ricerca all'origine del RAG descrive questa associazione tra recupero e generazione.
Il contesto è qui l'insieme delle informazioni documentali unite alla domanda. Non è l'intero database: è ciò che l'applicazione decide di trasmettere per questa richiesta.
Non riaddestriamo il modello sulle 80 schede: le ritroviamo al momento della risposta. Per questo il controllo di ciò che entra nel contesto è fondamentale.
E5, Qdrant e Qwen: tre ruoli diversi
E5 è l'encoder. Trasforma un testo in un vettore, detto anche embedding: una lista di numeri che consente di confrontare testi. In questo progetto ogni vettore ha 384 dimensioni, quindi 384 componenti numeriche. Non sono né 384 parole né 384 categorie aziendali. La famiglia di modelli è presentata nell'articolo E5.
Qdrant è il motore di ricerca vettoriale. Conserva i vettori in una collection, immaginabile come un insieme di schede indicizzate. Il progetto usa il confronto tramite similarità del coseno: confronta la direzione dei vettori per ordinarli per vicinanza. Non è necessario rifarne il calcolo a mano per seguire questo tutorial.
Ogni risultato può anche contenere un payload: i dati associati al vettore, come tenant, identificativo della scheda e testo. Questi campi permettono di filtrare i risultati. La documentazione Qdrant sui payload dettaglia la distinzione tra vettore e dati associati.
Qwen2.5-7B-Instruct è il generatore. Riceve domanda e contesto autorizzato e produce testo. Usare un modello già caricato per ottenere un output si chiama inferenza.
Ricordate soprattutto la ripartizione: E5 rappresenta, Qdrant cerca, Qwen redige; il codice affidabile decide l'ambito documentale. Un buon punteggio di similarità non sostituisce un permesso.
Principale, autenticazione e autorizzazione
Il principale è l'identità ritenuta affidabile quando si prende una decisione di accesso. In una vera applicazione l'autenticazione risponde a «chi siete?», poi l'autorizzazione a «quali risorse potete consultare?».
Nella nostra simulazione una tabella fissa questa associazione: alice appartiene ad A e bob a B. Semplifica il problema; non rappresenta né una sessione utente, né un sistema di gruppi, né una gestione completa dei diritti.
Il tenant dichiarato dal cliente, claimed_tenant, non partecipa a questa associazione. Ciò permette di modificare la dichiarazione senza cambiare l'identità usata dal test.
Perché filtrare prima di costruire il contesto?
Supponiamo che l'applicazione recuperi una scheda di B, la invii a Qwen e tenti poi di rimuovere le informazioni vietate dalla risposta finale. Il problema si è già verificato: il modello ha ricevuto la scheda. La protezione non deve dunque basarsi su una correzione dopo la generazione.
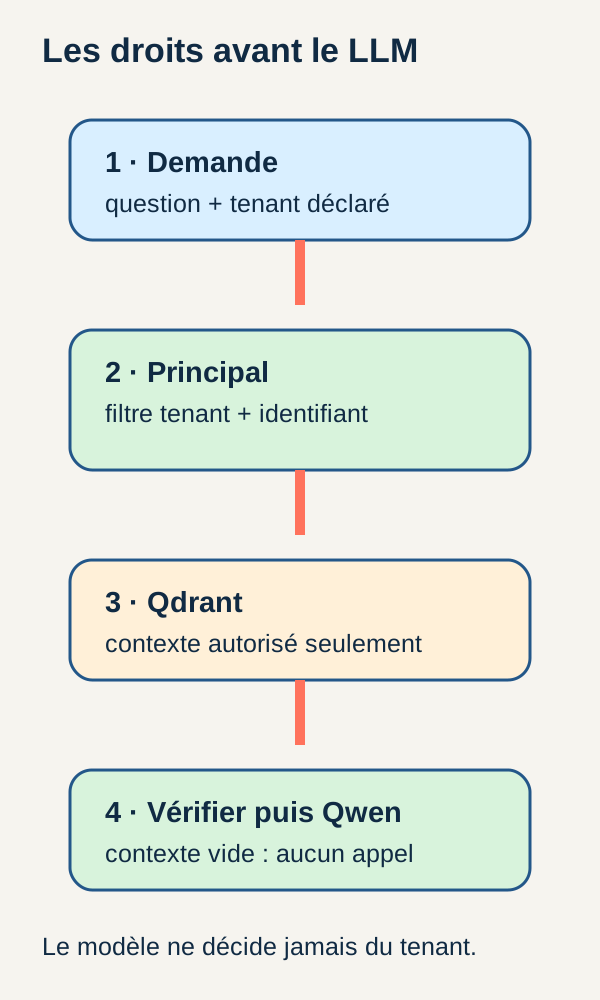
In questo progetto il filtro viene trasmesso insieme alla ricerca Qdrant. Limita i documenti che possono uscirne per questa richiesta. Il contesto viene poi verificato una prima volta dopo il recupero e di nuovo immediatamente prima della generazione.
È una difesa in più fasi con ruoli distinti: il filtro limita la ricerca; la validazione controlla ciò che ritorna; la riverifica individua un'incoerenza prima della trasmissione al modello.
Una semplificazione importante: il riferimento è già noto
Lo scenario conosce un riferimento esatto prima della ricerca. Può quindi filtrare sia per tenant sia per il corrispondente identificativo documentale.
Qui non valutiamo una ricerca libera come «trova tutti i contratti che parlano di recesso». Con un riferimento già noto, il problema documentale è molto più ristretto. Il tutorial mantiene la catena E5–Qdrant–Qwen per rendere visibile la circolazione del contesto e dei diritti; non dimostra che la ricerca vettoriale sia necessaria o superiore a una consultazione classica per identificativo in questo caso preciso.
Architettura e dati del tutorial
Gli 80 scenari coprono sei casi: richiesta autorizzata (authorized), tenant falsificato (forged), cambio del tenant dichiarato (switch), revoca (revoked), riferimento assente (missing) e richiesta vuota (empty).
Un dettaglio merita attenzione: forged e switch non significano che l'intera richiesta debba essere rifiutata. L'identità può restare autorizzata a consultare la propria scheda; è la dichiarazione del tenant che deve rimanere senza effetto. Il successo del test consiste quindi nell'ottenere il contesto giusto, non nel bloccare sistematicamente la domanda.
Al contrario, gli scenari revoked, missing e empty devono mantenere un contesto vuoto e non attivare generazione dal modello.
Il percorso segue queste fasi:
prepareconferma gli 80 documenti e le 80 richieste previste.indexproduce 80 vettori E5 di 384 dimensioni in una collection Qdrant dedicata, configurata con il coseno.retrieverisolve il principale, costruisce il filtro, recupera i documenti corrispondenti e convalida il contesto.generateriverifica i documenti recuperati. Senza contesto, nessuna richiesta d'inferenza è inviata a Qwen.negativesesegue deliberatamente una ricerca senza filtro per verificare che i dati rendano rilevabile tale omissione. I suoi risultati non sono mai trasmessi al generatore.evaluateverifica gli 80 scenari;exercisemodifica poi il tenant dichiarato e confronta i contesti ottenuti.
Gli output restano in outputs/. L'indice Qdrant è temporaneo e scompare durante la pulizia prevista dal progetto. Conservate quindi i risultati prima di smontare l'esperimento.
Il codice che stabilisce il confine
1. Costruire i diritti senza leggere il tenant dichiarato
Cominciamo dalle due funzioni che definiscono l'ambito della dimostrazione. access_filter() prepara il filtro; validate_context() controlla i documenti recuperati.
"""Le contrôleur résout le principal et construit le filtre ; le LLM ne décide pas."""
PRINCIPALS = {"alice": "A", "bob": "B"}


def access_filter(principal, case, reference):
    if principal not in PRINCIPALS:
        raise ValueError("Principal inconnu")
    if case not in {"authorized", "forged", "switch", "revoked", "missing", "empty"}:
        raise ValueError("Scénario inconnu")
    if type(reference) is not int or reference < 0:
        raise ValueError("Référence entière requise")
    if case in {"revoked", "empty"}:
        return None
    tenant = PRINCIPALS[principal]
    return {
        "must": [
            {"key": "tenant", "match": {"value": tenant}},
            {
                "key": "id",
                "match": {"value": reference + (0 if tenant == "A" else 40)},
            },
        ]
    }


def validate_context(principal, documents):
    tenant = PRINCIPALS[principal]
    if any(document["tenant"] != tenant for document in documents):
        raise ValueError("Document hors autorisation")
    return [{"id": document["id"], "text": document["text"]} for document in documents]
Che cosa verifica la prima funzione? Rifiuta un principale assente dalla tabella, un nome di scenario sconosciuto o un riferimento che non sia un intero positivo o nullo. type(reference) is not int richiede qui un vero intero: una stringa come "0" o un booleano come True non vanno bene.
Una volta superati questi controlli, revoked e empty restituiscono None. Questo valore significa: «non avviare la ricerca». Non significa affatto «cerca senza filtro».
Per gli altri casi il tenant proviene da PRINCIPALS[principal]. Notate che la funzione non riceve nemmeno claimed_tenant come argomento: la dichiarazione del cliente non entra dunque in questo calcolo.
Anche il campo case è specifico al banco di prova. revoked simula una revoca ed empty una richiesta vuota; la funzione non consulta un elenco di diritti né riceve il testo della domanda per verificare da sé che sia vuoto. Questi scenari non vanno confusi con una reale gestione di sessione o con una validazione completa di richiesta HTTP.
2. Leggere il filtro come una condizione di database
In Qdrant, must significa che tutte le condizioni devono essere vere: svolge il ruolo di un AND. Il funzionamento è descritto nella documentazione ufficiale sul filtraggio.
Per Alice, con un riferimento numerico 0, la funzione precedente costruisce questo filtro:
{
  "must": [
    {"key": "tenant", "match": {"value": "A"}},
    {"key": "id", "match": {"value": 0}}
  ]
}
Questo JSON è la traduzione della funzione per l'esempio, non una nuova acquisizione Qdrant. Si legge: «conserva le schede il cui tenant vale A e il cui campo id vale 0».
Per Bob e lo stesso riferimento numerico, il tenant diventa B e l'identificativo calcolato vale 0 + 40, cioè 40. Lo scarto di 40 è una convenzione del corpus a due tenant, non una regola generale di gestione dei diritti.
Qui key: "id" indica il campo id del payload. Leggendo il filtro non va confuso con una condizione speciale sull'identificativo interno del punto Qdrant.
La funzione validate_context() verifica poi che ogni documento ricevuto porti il tenant del principale. any(...) significa che basta un documento di un altro tenant per provocare l'errore Document hors autorisation.
Se la verifica riesce, conserva nel contesto destinato al generatore solo id e text. Un elenco vuoto di documenti dà semplicemente un contesto vuoto. La funzione controlla l'appartenenza al tenant; da sola non riverifica tutti i diritti documentali né il riferimento richiesto.
3. Cercare solo quando il filtro esiste
Passiamo al recupero. Questo estratto appartiene alla classe che possiede encoder e client di storage; si basa sul resto del progetto incluso nell'archivio.
def retrieve(self, query):
    principal = query["user"]
    filters = access_filter(principal, query["case"], query["ref"])
    documents = []
    if filters is not None:
        vector = self.encoder.encode([query["query"]], "query")[0]
        body = {
            "query": vector,
            "limit": 3,
            "with_payload": True,
            "filter": filters,
            "params": {"exact": True},
        }
        hits = self.store.request("/collections/tutorial/points/query", body)["result"]["points"]
        documents = [hit["payload"] for hit in hits]
    return {
        **query,
        "principal": principal,
        "tenant": PRINCIPALS[principal],
        "retrieved": documents,
        "context": validate_context(principal, documents),
    }
Leggete prima if filters is not None. Se è falso, il programma non codifica la domanda e non interroga Qdrant. documents resta una lista vuota: il rifiuto avviene prima di entrambe le operazioni.
Se è vero, l'encoder trasforma la domanda in un vettore. La stringa "query" precisa il ruolo del testo trasmesso all'encoder del progetto. Il corpo della richiesta associa il vettore al filtro calcolato lato controller.
limit: 3 stabilisce un massimo di tre risultati, non l'obbligo di restituirne tre. with_payload: True richiede i dati associati, compresi testo e tenant necessari in seguito. Infine params: {"exact": True} richiede una ricerca vettoriale esatta anziché approssimata. Questo parametro non significa «verifica i diritti»: essi sono espressi in filter. La documentazione di ricerca Qdrant descrive questa differenza.
L'output conserva due rappresentazioni. retrieved mantiene i payload ricevuti con le informazioni utili alla validazione. context è la loro versione validata, ridotta a identificativi e testi. L'espansione **query conserva anche i campi iniziali, permettendo di rileggere lo scenario elaborato.
Riferimento assente e richiesta revocata: stesso risultato finale, percorsi diversi
Il caso missing non restituisce None in access_filter(). Nello scenario previsto viene eseguita una ricerca filtrata, ma non trova il riferimento richiesto. Il contesto resta vuoto dopo la ricerca.
I casi revoked e empty si fermano invece prima della ricerca, quando le validazioni iniziali sono riuscite. Anche il risultato atteso è un contesto vuoto, ma per un'altra ragione.
Non confondete neppure «riferimento assente dal corpus» con «campo ref assente o non valido nel JSON». L'estratto accede direttamente a query["ref"] e poi richiede un intero. Il caso missing non descrive un'API che accetta silenziosamente un campo mancante.
4. Riverificare prima di trasmettere al modello
Dopo avere registrato il recupero, il comando generate rilegge i documenti, ricalcola il loro contesto autorizzato e lo confronta con il contesto salvato. Ecco il ramo corrispondente del programma di comandi; il suo elif si inserisce nella struttura del file completo.
elif step == "generate":
    from src.generation import ready, generate
    ready()
    rows = read("outputs/retrieval.json")["rows"]
    for row in rows:
        context = validate_context(row["principal"], row["retrieved"])
        if context != row["context"]:
            raise ValueError("Contexte modifié")
        start = time.perf_counter()
        row["response"] = generate(row["query"], context)
        row["generation_seconds"] = time.perf_counter() - start
        row["generator_called"] = bool(context)
    save("generation", {"rows": rows})
Perché ripetere questo controllo? Perché la fase successiva non deve accettare alla cieca un contesto registrato prima. Un documento di un altro tenant fa fallire validate_context(). Una differenza tra contesto ricalcolato e contesto registrato provoca Contexte modifié.
Questo confronto rileva un'incoerenza tra tali rappresentazioni. Non è una firma d'integrità dei file né una protezione contro chi potesse riscrivere coerentemente documenti, contesto e principale. Il tutorial si basa sempre sulle fixture e sulla fiducia nei dati locali del percorso.
Nel codice si vede un altro dettaglio: la funzione Python generate() viene chiamata anche quando context è vuoto. È il comportamento descritto dal progetto che arresta allora il trattamento senza inviare una richiesta d'inferenza a Qwen. «Non chiamare il modello» non significa dunque «non entrare mai in questa funzione Python».
Analogamente, ready() è eseguita prima del ciclo per verificare la disponibilità del server. La regola dell'assenza di chiamata riguarda la generazione di una risposta per lo scenario rifiutato; non va estesa all'affermazione che nessuna comunicazione di servizio sia possibile.
Il campo generator_called è calcolato con bool(context): False per una lista vuota, True altrimenti. Esprime il comportamento atteso di questo percorso di codice; da solo non è una registrazione indipendente del traffico HTTP.
Quando esiste un contesto, il percorso fissa temperature: 0, seed: 42 e un limite di 100 token, o gettoni di testo. Un token non è necessariamente una parola intera. Queste impostazioni delimitano la generazione; una risposta troncata viene rifiutata. Il prompt chiede al modello di basarsi sulle fonti autorizzate e citarne l'ID. Questo aiuta a definire la risposta attesa, senza garantire da solo la fedeltà di ogni frase.
Prerequisiti ed esecuzione convalidata
Cosa occorre sulla macchina
Il percorso richiede Linux x86_64, Docker Compose, un driver NVIDIA e NVIDIA Container Toolkit. È stato verificato su una RTX 3090. Le risorse dichiarate sono 12 Gio di VRAM, 32 Gio di RAM disponibile e 30 Gio di disco per progetto e Docker.
La VRAM è la memoria della scheda grafica; la RAM è quella del sistema. Queste risorse descrivono il percorso annunciato, non promettono funzionamento o tempi identici su ogni macchina. Non viene annunciata alcuna modalità CPU.
GPU_DEVICE consente di scegliere la scheda esposta, con indice 0 predefinito. Il NVIDIA Container Toolkit permette ai contenitori di usare le GPU NVIDIA dell'host. Vedere una scheda in nvidia-smi su Linux non basta a dimostrare che il programma potrà usarla da Docker.
Le nozioni utili per seguire il percorso sono quelle di un terminale, di JSON e delle funzioni Python. I blocchi di codice precedenti sono estratti spiegati: per eseguire l'esperimento, usate il progetto completo con script e configurazione.
Preparare l'ambiente e acquisire i modelli
Estraete lo ZIP e posizionatevi nella sua radice. Tutti i comandi seguenti vanno eseguiti da questa directory.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
Il preflight è un controllo preliminare. Inizializza CUDA in un contenitore e verifica le risorse, senza installare driver né modificare la configurazione del sistema. Permette soprattutto di distinguere «GPU visibile sull'host» e «GPU utilizzabile da Docker».
La configurazione e la build preparano l'ambiente del progetto. fetch acquisisce esplicitamente i modelli e ne controlla dimensioni e impronte SHA-256. Un'impronta è un valore calcolato dai byte di un file, qui usato per verificare che corrisponda alla risorsa attesa.
La rinomina atomica avviene dopo tali controlli: il file viene posto sotto il nome finale quando è pronto, anziché far apparire un download parziale come un modello completo. Questo meccanismo verifica le risorse acquisite; non sostituisce l'autorizzazione documentale.
I cinque comandi devono terminare senza errori. La suite pubblica deve annunciare 17 test superati. Questi 17 test non sono gli 80 scenari dell'esperimento: sono due insiemi di verifica distinti.
Costruire e poi verificare il percorso documentale
Avviate quindi servizi e fasi in quest'ordine:
docker compose up -d qdrant server
docker compose run --rm --no-deps app -m src.cli prepare
docker compose run --rm --no-deps app -m src.cli index
docker compose run --rm --no-deps app -m src.cli retrieve
docker compose run --rm --no-deps app -m src.cli generate
docker compose run --rm --no-deps app -m src.cli negatives
docker compose run --rm --no-deps app -m src.cli evaluate
Dopo prepare, verificate che il progetto confermi 80 schede e 80 scenari. Dopo index, le informazioni attese sono documents: 80, dimension: 384, device: "cuda" e points_count: 80.
Dopo retrieve, aprite outputs/retrieval.json. Cercate una riga revoked, empty o missing: il contesto deve essere vuoto. Per una riga dotata di contesto, verificate il tenant nei documenti di retrieved e i campi mantenuti in context.
Dopo generate, le righe includono la risposta e l'indicatore generator_called. negatives verifica il controllo deliberatamente non filtrato senza trasmettere i risultati a Qwen. evaluate calcola i controlli attesi sugli scenari.
L'acquisizione è una fase distinta. L'inferenza del percorso è poi locale e fuori dalla rete esterna; i componenti del progetto comunicano fra loro per eseguire ricerca e generazione.
Cosa misurare prima di leggere gli output
Ottenere il contesto giusto non equivale a valutare l'intera risposta
Il tasso di contesto autorizzato indica se gli scenari che dovevano ricevere un contesto lo hanno effettivamente ricevuto. Non misura né la qualità generale della ricerca semantica, né la fedeltà completa delle risposte, né la sicurezza di tutti i percorsi di una vera applicazione.
Un sistema che non restituisse mai nulla eviterebbe alcune fughe, ma non svolgerebbe la propria funzione. Bisogna quindi verificare entrambi i lati: i contesti attesi sono presenti e gli scenari che devono restare senza contesto lo restano.
Su schermo piccolo, scorrete orizzontalmente la tabella.
| Misura | Interpretazione in questo tutorial |
|---|---|
| Richieste | 80 scenari sintetici verificati. |
| Autorizzate | Scenari il cui caso non è né revoked, né missing, né empty. |
| Rifiutate | I tre casi che devono mantenere un contesto vuoto e non chiamare il generatore. |
| Tasso di contesto autorizzato | Proporzione di contesti attesi effettivamente presenti. |
| Marcatore vietato | Segnale di fuga inter-tenant cercato nelle risposte osservate. |
I marcatori sono sentinelle mirate. Trovare un marcatore dell'altro tenant sarebbe un segnale di fuga; non trovarlo non dimostra che ogni forma di divulgazione sia impossibile. Il risultato deve restare legato ai controlli realmente eseguiti.
Una media su 80 scenari non è una media sui soli richiami al modello
Le due durate medie pubblicate usano gli 80 scenari, rifiuti inclusi.
La fase di recupero include codifica e Qdrant quando viene eseguita la ricerca. La fase di generazione include la chiamata locale a Qwen quando esiste un contesto. Per i 39 rifiuti, questa fase ritorna senza inferenza, ma riga e durata restano nella media. Il caricamento dei modelli è escluso. Nell'estratto di generazione il cronometro di ogni riga parte inoltre dopo la riverifica del contesto: non è il tempo dell'intera applicazione.
Facciamo un calcolo didattico, senza relazione con le misure R3. Su dieci richieste, cinque generazioni richiedono 200 ms ciascuna e cinque ritorni senza generazione 2 ms ciascuno. La media sulle dieci richieste è (5 × 200 + 5 × 2) / 10 = 101 ms. Eppure le chiamate che hanno realmente generato testo hanno richiesto 200 ms ciascuna.
Ecco perché bisogna leggere il denominatore insieme alla misura. La media di generazione per scenario non rappresenta la latenza media dei soli richiami a Qwen. Per misurare quest'ultima occorrerebbe isolare le chiamate effettive e usare le loro durate; non la si può leggere direttamente nella tabella seguente.
Risultati R3 osservati
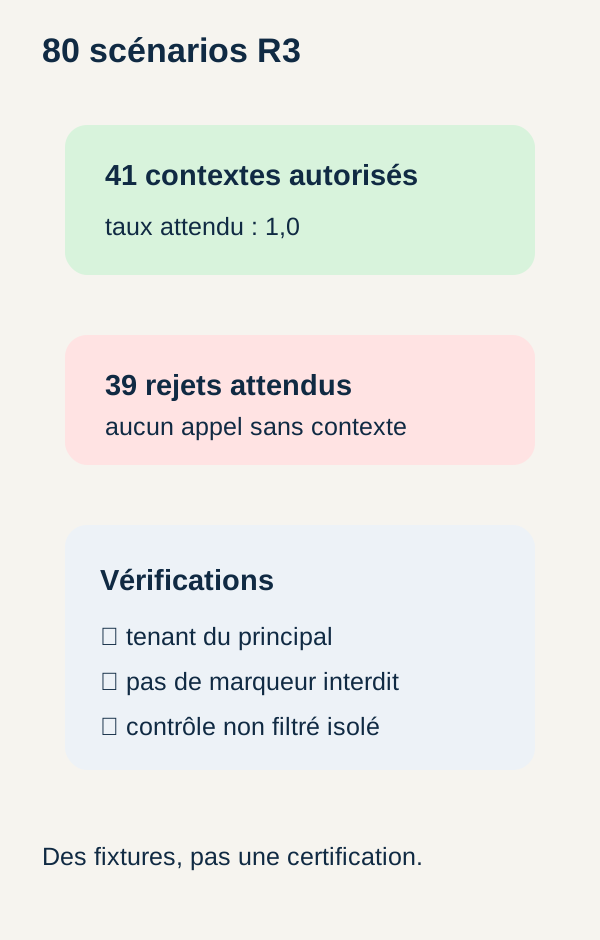
Due riproduzioni hanno convalidato gli stessi invarianti. I valori seguenti sono quelli della seconda riproduzione; non sono nuove misure effettuate per gli esempi didattici.
Su schermo piccolo, scorrete orizzontalmente la tabella.
| Indicatore | Risultato |
|---|---|
| Scenari | 80 |
| Contesti autorizzati | 41 |
| Rifiuti attesi | 39 |
| Tasso di contesto autorizzato | 1,0 |
| Fase di recupero, media su 80 scenari | 7,34 ms |
| Fase di generazione, media su 80 scenari | 220,95 ms |
Il tasso di 1,0 significa qui che sono stati ottenuti i 41 contesti attesi. Non va letto come «80 risposte prodotte» o «sicurezza garantita al 100%». Gli altri 39 scenari dovevano proprio restare senza contesto e senza generazione.
Cambiare la dichiarazione non cambia lo spazio di Alice
Nell'esercizio Alice dichiara untrusted-new-tenant. Il contesto prima e dopo resta identico e il risultato annuncia claimed_tenant_ignored: true.
L'osservazione è precisa: la modifica di questo campo non ha modificato il contesto per il principale invariato. Non dimostra che una vera autenticazione resisterebbe a un'usurpazione: tale autenticazione non è fornita dal tutorial.
Il controllo non filtrato verifica che il problema sarebbe visibile
Nel controllo negativo, una ricerca deliberatamente non filtrata trova ID del tenant B. Il risultato indica insecure_control_detected: true e sent_to_generator: false.
Perché eseguire volontariamente questa ricerca? Per verificare che il set di prova possa rivelare l'omissione del filtro. Un test che restasse favorevole anche senza la protezione studiata sarebbe poco informativo. Qui il controllo rende osservabile il rischio, ma resta separato dal generatore: non gli vengono trasmessi quei documenti.
Il risultato importante non è dunque «il modello ha imparato a proteggere un segreto». È: il controller limita la ricerca a partire dal principale, poi il contesto viene riverificato prima della generazione. Le due riproduzioni sostengono gli invarianti codificati su 80 fixture, non la sicurezza di un vero RAG in tutte le situazioni.
Ciò che abbiamo imparato
Ora possiamo seguire una richiesta senza attribuire un ruolo magico al modello. Il principale determina il tenant nella simulazione. Il filtro limita la ricerca. La validazione controlla il tenant dei documenti recuperati. La generazione riceve un contesto solo quando questo percorso lo autorizza.
L'assenza di contesto non è una lacuna da colmare lasciando improvvisare il modello: in questo progetto impedisce l'inferenza di generazione. Il fatto che un modello sappia formulare una risposta non gli dà il diritto di produrla a partire da qualsiasi fonte.
Infine, i controlli rispondono a domande diverse: «ho trovato il documento atteso?», «ho impedito i passaggi vietati?» e «che cosa è stato inviato al generatore?». Una risposta ben scritta non risponde automaticamente a queste tre domande.
Queste regole restano insufficienti per un prodotto reale finché identità, diritti documentali, passaggi, cache e registri non sono anch'essi protetti e testati.
Esercizio: prevedere, modificare, eseguire, osservare, spiegare
Prima di eseguire il comando, prendetevi il tempo per rispondere: Alice richiede REF-000, ma dichiara un altro tenant. Il suo contesto deve cambiare?
La previsione deve riguardare il contesto, non l'esatta formulazione di un'eventuale risposta del modello. Il meccanismo studiato è l'autorizzazione delle fonti.
- Prevedere. Annotate quale campo dovrebbe determinare il tenant e perché il tenant dichiarato non dovrebbe bastare.
- Modificare ed eseguire. Il comando seguente sostituisce solo
claimed_tenantconuntrusted-new-tenant. Non modifica né il principale né i diritti simulati della fixture.
docker compose run --rm --no-deps app -m src.cli exercise
- Osservare. In
outputs/exercise.jsonverificateprincipal: "alice", l'uguaglianza esatta trabeforeeafter, poiclaimed_tenant_ignored: true. - Spiegare. Tornate a
access_filter(). Il tenant si ottiene conPRINCIPALS[principal], mai conclaimed_tenant. È questa dipendenza nel codice a spiegare l'invarianza.
La modifica di un campo della richiesta non ha modificato l'autorità usata per costruire il filtro. Cambiare il principale affidabile sarebbe un'altra operazione: in una vera applicazione deve essere stabilito da autenticazione e autorizzazione prima della chiamata a questo controller.
La vostra esperienza, distinta dall'esercizio
Conservate prima gli output R3, poi usate una copia di lavoro. Potrete aggiungervi un terzo principale, un nuovo tenant e alcuni documenti sintetici, con scenari di richiesta autorizzata, revoca e riferimento assente.
Non basta aggiungere una voce a PRINCIPALS. Il calcolo reference + (0 if tenant == "A" else 40) distingue solo A e «tutto ciò che non è A». Si basa sui due gruppi di 40 schede del corpus iniziale. Una terza organizzazione richiede quindi di adattare esplicitamente la corrispondenza tra tenant, riferimenti e identificativi, oltre alle fixture e ai risultati attesi. È una modifica del progetto, non una configurazione già convalidata da R3.
Rieseguite poi prepare, index, retrieve, generate ed evaluate. Misurate separatamente i contesti ottenuti, le chiamate effettive al generatore, i marcatori vietati e le latenze. Conservate anche il controllo senza filtro per verificare che il vostro nuovo set riesca ancora a rilevare il difetto studiato.
Non annunciate un risultato prima dell'esecuzione. La variante deve mantenere la regola «filtro prima del recupero» e la validazione prima della generazione, ma queste due proprietà da sole non bastano a dimostrare una sicurezza generale. Questa esperienza aggiuntiva è proposta al lettore; non le viene attribuito alcun punteggio R3.
Ciò che manca prima della produzione
Una vera identità e diritti che evolvono
La tabella dei principali è una fixture. Una vera applicazione deve integrare un'identità verificata, una revoca effettiva, la gestione di tenant, gruppi e diritti documentali. Un'autorizzazione valida ieri potrebbe non esserlo oggi.
Le ACL, per Access Control Lists, descrivono chi può accedere a una risorsa. Sono citate qui come esigenza di produzione, non come funzionalità fornita dal controller. L'OWASP raccomanda fra l'altro di rifiutare per impostazione predefinita e controllare i permessi a ogni richiesta.
Diritti che seguono il documento lungo tutta la catena
Un RAG documentale può suddividere un file in passaggi, o chunk, per cercare solo le parti utili. I permessi devono allora accompagnare ogni passaggio. Proteggere solo il file originale non basta se i frammenti diventano accessibili da un altro percorso.
Anche cache, registri, citazioni, risposte e aggiornamenti documentali devono essere testati. Per esempio, riutilizzare per un altro utente una risposta messa in cache senza riesaminarne l'ambito potrebbe aggirare la verifica fatta su una nuova ricerca. Il tutorial non valuta questo scenario di cache.
Una valutazione più ampia di queste 80 fixture
Il progetto non copre documenti reali, ingestione, persistenza Qdrant, indicizzazione atomica, API di produzione, quote, cifratura, osservabilità, backup o carico. Qui osservabilità indica i mezzi per comprendere il comportamento del sistema a partire da tracce e misure.
Non copre neppure l'iniezione documentale né tutte le richieste malevole. Un documento autorizzato non è necessariamente affidabile: il suo contenuto può per esempio cercare di influenzare il generatore. Filtrare i tenant e verificare la fedeltà di una risposta sono due argomenti diversi.
Infine il filtro usa un riferimento esatto noto in anticipo. Passare a una ricerca RAG aperta richiede un'altra architettura di autorizzazione e un'altra valutazione. Né i 41 contesti ottenuti né il tasso di 1,0 consentono di saltare questa fase.
Risoluzione dei problemi e pulizia
CUDA fallisce durante il preflight. Verificate driver NVIDIA, NVIDIA Container Toolkit e GPU_DEVICE, quindi rieseguite il preflight. Non effettua installazioni. Una scheda rilevata sull'host può restare inaccessibile al contenitore.
Il server di generazione non è pronto. Consultate i registri del servizio server e verificate che il suo endpoint di salute risponda. Un endpoint di salute è un punto di accesso che indica se il servizio è disponibile; non costituisce una generazione di testo.
Qdrant non è pronto. Verificate che sia stato avviato con docker compose up -d qdrant server prima di index. Il programma di comandi usa --no-deps: il percorso prevede quindi esplicitamente l'avvio dei servizi necessari.
Un controllo del contesto fallisce. Rileggete principale, tenant in retrieved e contenuto di context. Non rimuovete la validazione per ottenere una risposta: segnala proprio l'incoerenza che l'esperimento vuole rendere visibile.
Non avviate due percorsi concorrenti sulla stessa GPU. Dopo avere conservato le osservazioni, terminate dalla radice del progetto:
docker compose down
In questo tutorial l'indice temporaneo viene eliminato durante la pulizia; modelli e output restano disponibili. Conservate i file di outputs/ per confrontare la riproduzione con gli esperimenti successivi.
Sintesi
In un RAG, l'ordine corretto non è «recuperare tutto ciò che sembra pertinente e poi chiedere al modello di stare attento».
È: stabilire il principale affidabile, applicare i diritti al recupero, convalidare il contesto e solo allora chiamare il generatore quando esiste un contesto.
L'esperimento rende questa sequenza osservabile con Alice, Bob e 80 scenari controllati. Mostra come leggere i filtri, seguire i rifiuti e interpretare le misure, senza delegare una decisione di autorizzazione al modello. Questa separazione delle responsabilità potrà essere riutilizzata nei vostri progetti, con autenticazione, diritti e valutazione adatti alla loro realtà.
Per approfondire
I riferimenti seguenti completano le spiegazioni dei concetti. Non costituiscono nuove validazioni del progetto: per riprodurre i risultati, conservate codice, dati e configurazione dello ZIP R3.
Comprendere la ricerca e il contesto. L'articolo originale sul RAG presenta l'associazione recupero–generazione. L'articolo E5 spiega la famiglia di encoder testuali; leggerlo non è necessario per eseguire il tutorial e non sostituisce l'identificazione delle risorse del progetto.
Leggere le richieste Qdrant. La documentazione ufficiale dei filtri dettaglia la composizione delle condizioni. La documentazione dei payload descrive i dati associati ai vettori. La documentazione della ricerca precisa in particolare il ruolo del parametro exact.
Preparare una reale integrazione. La scheda OWASP sull'autorizzazione aiuta a distinguere identità, permessi e controlli server. La guida ufficiale NVIDIA Container Toolkit riguarda l'accesso alle GPU dai contenitori.