





Votre application envoie un texte à un modèle local, puis attend sa réponse. Le traitement fonctionne, mais l’attente vous semble un peu longue. Une idée vient naturellement : ajouter une deuxième carte graphique pour aller deux fois plus vite.
Est-ce vraiment ce qui va se passer ? Pas forcément. Deux cartes peuvent se partager un travail, mais elles doivent aussi échanger des données. Et toutes les étapes d’une génération de texte ne profitent pas de cette répartition de la même façon.
Nous allons le vérifier avec un petit banc de mesure en Python et Docker. Le principe ressemble à un test de performance d’API : envoyer une charge connue, chronométrer les réponses, conserver les résultats et comparer deux configurations. La nouveauté consiste à comprendre ce que le modèle fait pendant cette attente.
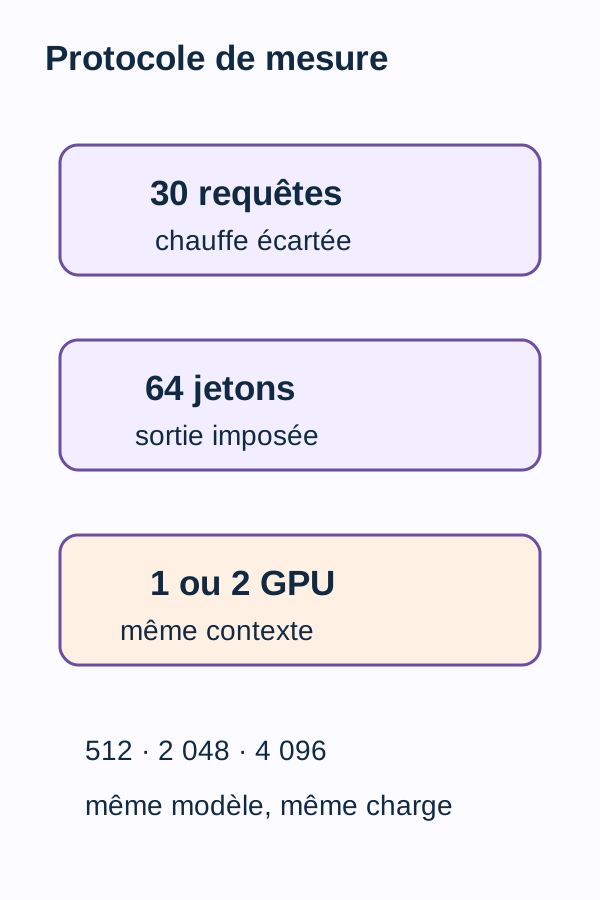
Télécharger le projet complet du tutoriel. Le projet compare le même Qwen 7B Q8_0, exécuté par llama.cpp, dans six modes : un ou deux GPU, avec des capacités de contexte de 512, 2 048 et 4 096 jetons.
Le scénario d’application web sert de point de départ : l’archive fournit un outil de mesure, pas une fonctionnalité métier prête à déployer. Vous n’allez pas entraîner un modèle, mais utiliser un modèle déjà entraîné et observer son exécution. Savoir lire des fonctions Python, du JSON et des commandes Docker suffit pour aborder le parcours ; les notions propres aux modèles de langage sont introduites ci-dessous.
Les résultats présentés sont ceux des reproductions r3 du projet. Les petits exemples de calcul sont signalés comme pédagogiques, et les calculs complémentaires sur les mesures sont identifiés comme tels : ils ne constituent pas de nouvelles expériences GPU.
Les notions nécessaires avant les commandes
Le modèle, le moteur et le GPU ne sont pas la même chose
Le modèle de langage, ou LLM, est ici Qwen 7B. Ses paramètres, aussi appelés poids, sont les valeurs numériques issues de son apprentissage. Le nom « 7B » désigne une taille de l’ordre de sept milliards de paramètres, pas sept milliards de mots stockés dans une base de données.
llama.cpp est le moteur qui charge ce modèle et exécute les calculs nécessaires pour produire du texte. Dans ce tutoriel, il expose un serveur HTTP : notre programme Python l’appelle comme il appellerait un autre service. Utiliser le modèle pour produire une sortie s’appelle faire de l’inférence.
La variante Q8_0 désigne une méthode de quantification : une représentation plus compacte des poids, utilisant ici des valeurs quantifiées sur 8 bits et des facteurs d’échelle. Ce nom ne signifie pas que toute la mémoire ou tous les calculs du programme sont en 8 bits. La présentation du format GGUF et de ses quantifications complète ce point.
Nous gardons cette variante identique dans les six modes. Comparer un modèle Q4 sur une carte à un modèle Q8 sur deux cartes mélangerait deux changements : la représentation du modèle et sa répartition matérielle. Ce n’est pas l’expérience que nous cherchons à faire.
Un jeton n’est pas forcément un mot
Un jeton, ou token, est une unité utilisée par le modèle pour représenter du texte. Selon son découpage, cette unité peut correspondre à un mot, à une partie de mot ou à un signe. On ne peut donc pas remplacer systématiquement « 64 jetons » par « 64 mots ».
Le texte envoyé au modèle est le prompt. Il comprend ici une partie de remplissage, appelée padding, puis le texte d’une requête. Ce remplissage est bien du texte à traiter : ce n’est pas une série de cases vides que le modèle ignorerait.
Nous allons compter séparément les jetons de l’entrée et ceux de la sortie. C’est aussi important que de distinguer la taille d’une requête HTTP de celle de sa réponse.
Capacité de contexte : la place disponible, pas la place occupée
La capacité de contexte est la limite configurée pour la séquence que le serveur peut gérer. Dans ce parcours, il faut y faire tenir le prompt et la génération demandée. Les six modes utilisent trois capacités : 512, 2 048 et 4 096.
Une analogie web permet de ne pas se tromper : autoriser un fichier de 10 Mo dans un formulaire ne signifie pas que tous les fichiers déposés pèsent 10 Mo. De la même façon, configurer 4 096 jetons ne signifie pas envoyer un prompt de 4 096 jetons.
Le protocole construit un padding fixe pour chaque capacité. À capacité donnée, il applique le même padding aux mêmes 30 requêtes en mono et en dual. Les prompts sont donc comparables entre ces deux modes ; cela ne signifie pas que les 30 questions ont toutes exactement la même longueur.
Le champ à lire est tokens_evaluated, qui conserve le nombre de jetons du prompt rapporté par le serveur. Nous verrons ainsi qu’au réglage 4 096, les prompts mesurés comptent en moyenne 2 080 jetons, et non 4 096.
Pendant l’attente, deux étapes différentes
Le préremplissage, ou prefill, correspond au traitement du prompt déjà disponible. Le modèle doit calculer les représentations dont il a besoin pour commencer à répondre.
Le décodage correspond ensuite à la production des nouveaux jetons. Dans une génération autorégressive, chaque nouveau jeton est choisi à partir de ce qui précède. Produire la suite n’est donc pas simplement lancer 64 calculs indépendants en parallèle. La documentation Hugging Face sur l’inférence des LLM explique ce mécanisme et les états intermédiaires conservés pendant la génération.
Pour notre client Python, ces étapes font partie d’une même attente HTTP. Le serveur fournit des temps internes, mais le client chronomètre son appel complet. Comme avec un profileur web, le temps d’une requête SQL et le temps total d’une route ne sont pas deux noms pour la même mesure.
Nous allons donc conserver la durée HTTP, le temps de préremplissage et le temps de décodage. Le chronomètre ne mesure pas le temps de rendu d’une page dans un navigateur : il observe le client de mesure fourni par le projet.
Pourquoi demander exactement 64 jetons ?
Imaginons, uniquement pour comprendre le problème, qu’un premier essai génère 12 jetons et le second 64. Même si le premier se termine plus vite, nous n’avons pas fait effectuer la même quantité de génération.
Le projet demande donc n_predict=64 et active ignore_eos. EOS est le marqueur de fin de génération ; l’ignorer évite qu’un arrêt naturel écourte la réponse. Le programme vérifie ensuite que le serveur a effectivement produit 64 jetons.
Nous construisons ainsi une charge comparable, pas une évaluation de la qualité des réponses. Une sortie forcée à 64 jetons peut être trop longue pour une petite question ou s’arrêter avant la fin d’une phrase. Ce comportement est voulu pour la mesure.
Un GPU ou deux GPU : comment le travail est-il réparti ?
La VRAM est la mémoire de la carte graphique. Elle est distincte de la RAM de la machine. En mode mono, le modèle est chargé sur une carte. En mode dual, le parcours décrit une répartition de ses couches entre deux cartes, avec tensor-split 1,1.
Une couche est une étape de calcul du réseau. Pour se représenter l’idée, imaginez une chaîne de traitement dont les premières étapes se trouvent sur une machine et les suivantes sur une autre : les résultats intermédiaires doivent passer de l’une à l’autre. La seconde machine ne rend pas automatiquement toutes les étapes simultanées.
Dans llama.cpp, --split-mode choisit la manière de répartir le modèle ; --tensor-split fournit les proportions. 1,1 exprime des parts égales, pas une promesse de temps divisé par deux ni d’occupation mémoire parfaitement identique. Le mode mono du projet utilise --split-mode none. La documentation du serveur distingue ces paramètres ; conservez ceux du ZIP pour reproduire le parcours.
Les deux VRAM ne deviennent pas une mémoire unifiée de 48 Gio. La présence de NVLink, une interconnexion matérielle entre cartes, n’est pas supposée dans cette expérience. Il ne faut pas non plus confondre ce partage d’un modèle avec deux serveurs indépendants qui recevraient chacun leurs propres requêtes.
Enfin, la charge est séquentielle : notre client attend une réponse avant d’envoyer la requête suivante. Nous ne cherchons donc pas encore à savoir combien d’utilisateurs simultanés le serveur pourrait servir.
Le code qui rend la comparaison contrôlée
Six modes, mais trois comparaisons utiles
La matrice de l’expérience est simple :
| Capacité de contexte | Référence sur un GPU | Comparaison sur deux GPU |
|---|---|---|
| 512 | mono-512 |
dual-512 |
| 2 048 | mono-2048 |
dual-2048 |
| 4 096 | mono-4096 |
dual-4096 |
Chaque comparaison se fait sur une ligne de ce tableau, donc à capacité égale. Opposer mono-512 à dual-4096 ne permettrait pas d’isoler le changement de répartition : le réglage de contexte et la charge construite pour ce réglage changeraient aussi.
Dans cli.py, chaque commande measure-<mode> fabrique les prompts à partir du padding prévu et des 30 requêtes. La fonction one() appelle /completion avec des paramètres fixes : 64 jetons demandés, température 0, graine 42, ignore_eos=true et cache_prompt=false.
Température et graine font partie des réglages conservés pour limiter les variations liées à la génération. Elles ne transforment pas une durée mesurée en constante universelle : l’état de la machine et le moteur d’exécution continuent de compter.
La chauffe et le cache répondent à deux questions différentes
Avant les mesures retenues, le programme envoie une requête de chauffe, ou warm-up. Elle fait passer le serveur par le chemin de génération, mais sa durée ne figure pas dans la moyenne. Le chargement initial et cette première requête ne sont donc pas mélangés aux 30 demandes suivantes.
Cela ne signifie pas que tous les effets de démarrage ou de variabilité disparaissent. La chauffe est une règle du protocole, pas une garantie d’état matériel parfait.
Le réglage cache_prompt=false, lui, concerne la réutilisation d’un préfixe traité lors d’une requête précédente. Nous ne voulons pas qu’un mode bénéficie d’un prompt commun déjà calculé alors que l’autre le relit. Ce réglage ne signifie pas « désactiver tous les caches de la machine ». Le cache des couches Docker, par exemple, est un sujet distinct.
Il ne faut pas non plus le confondre avec les états intermédiaires conservés pendant une même génération, souvent appelés cache KV. Ces états évitent de recalculer certains éléments du texte précédent à chaque nouveau jeton. La distinction entre réutilisation entre requêtes et calcul d’une réponse est détaillée dans les documentations de llama.cpp et de Hugging Face.
Conserver des observations avant de produire une moyenne
Pour chaque requête, le code garde le prompt, le texte brut produit, la durée HTTP, les timings du serveur, tokens_predicted, tokens_evaluated et l’indicateur de troncature.
Pourquoi garder autant de détails ? Parce qu’une moyenne seule ne permet pas de voir qu’une réponse était trop courte ou qu’un contexte a débordé. Les lignes individuelles jouent le même rôle que des traces de requêtes dans une application web : elles permettent de revenir à ce qui a effectivement été exécuté.
summarize() vérifie certaines conditions avant d’agréger les résultats. compare() calcule ensuite le ratio temps_mono / temps_dual, à capacité égale. Un ratio supérieur à 1 signifie que le dual a été plus rapide ; un ratio inférieur à 1 signifie qu’il a été plus lent. Nous prendrons le temps de calculer des exemples après l’exécution.
Les fonctions centrales à lire avant l'exécution
Attendre le serveur, puis démarrer le chronomètre
Dans client.py, ready() interroge /health pendant au plus 180 secondes pour attendre un serveur prêt. request() fixe un délai HTTP de 120 secondes. Attendre qu’un processus soit prêt et borner un appel HTTP sont deux responsabilités différentes.
Pour un développeur web, on retrouve la distinction entre « le conteneur a démarré » et « le service répond réellement ». Un serveur qui charge encore son modèle ne doit pas être pris pour une requête d’inférence anormalement lente.
one() : une requête, une observation complète
Voici le cœur de la mesure. padding, data, mode, capacity, request() et save() sont fournis par le reste du projet : cet extrait se lit dans son contexte, ce n’est pas un script autonome à copier dans un répertoire vide.
def one(query):
    prompt = padding + query["query"]
    start = time.perf_counter()
    result = request(
        "/completion",
        {
            "prompt": prompt,
            "n_predict": 64,
            "temperature": 0,
            "seed": 42,
            "ignore_eos": True,
            "cache_prompt": False,
        },
    )
    return {
        **query,
        "prompt": prompt,
        "raw": result["content"],
        "seconds": time.perf_counter() - start,
        "timings": result["timings"],
        "tokens_predicted": result["tokens_predicted"],
        "tokens_evaluated": result["tokens_evaluated"],
        "truncated": result.get("truncated", False),
    }


one(data["queries"][0])
rows = [one(q) for q in data["queries"]]
summarize(rows)
save(mode, {"mode": mode, "context_capacity": capacity, "rows": rows})
Commençons par prompt = padding + query["query"]. Le programme fabrique d’abord le texte de la demande, puis démarre le chronomètre avec time.perf_counter(). La construction de cette chaîne précède donc la mesure HTTP.
perf_counter() fournit un compteur adapté à la mesure d’une durée. Ce qui compte est la différence entre deux appels, pas la valeur absolue du compteur. L’attente de la réponse fait partie du temps écoulé : nous ne mesurons pas seulement le temps pendant lequel le processeur Python travaille. C’est le comportement décrit dans la documentation officielle de Python.
request() attend la réponse du serveur. La valeur seconds est calculée après son retour, tandis que timings conserve les mesures produites côté serveur. L’écriture du fichier par save() vient plus tard ; son temps n’est pas ajouté à chaque durée HTTP.
La notation **query recopie les champs de la requête dans le dictionnaire de résultat. Le code y ajoute ensuite ce qui a été observé. Cela permet de relier une durée à son entrée au lieu de conserver une liste anonyme de nombres.
Remarquez aussi result.get("truncated", False) : si le champ manque, cet extrait enregistre False. Ce choix dépend du contrat avec la version du serveur utilisée ; ce n’est pas un mécanisme indépendant capable de détecter toute troncature. Pour étudier les résultats r3, gardez le serveur et les fichiers fournis ensemble.
La première requête est jouée deux fois, mais mesurée une seule fois dans la liste
La ligne one(data["queries"][0]) appelle la première question pour la chauffe et ne conserve pas son résultat dans rows.
La compréhension de liste [one(q) for q in data["queries"]] parcourt ensuite les 30 requêtes, y compris la première. Elle attend chaque résultat avant de continuer : aucune concurrence n’est introduite ici.
Le comptage de cette boucle donne donc 31 appels à /completion par mode : 1 chauffe et 30 lignes retenues. Pour les six modes, cela représente 180 lignes de mesure et 6 chauffes supplémentaires, hors éventuels autres appels du parcours. La chauffe est bien exécutée, mais elle ne doit pas devenir une trente-et-unième ligne dans la moyenne.
summarize() : vérifier avant de calculer
Le second extrait est la fonction d’agrégation :
def summarize(rows):
    if not rows:
        raise ValueError("Mesures vides")
    if any(
        r["tokens_predicted"] != 64
        or r["truncated"]
        or r["seconds"] <= 0
        for r in rows
    ):
        raise ValueError("Longueur, contexte ou temps invalide")
    return {
        "queries": len(rows),
        "mean_ms": 1000 * sum(r["seconds"] for r in rows) / len(rows),
        "tokens_per_second": 64 * len(rows) / sum(r["seconds"] for r in rows),
        "mean_prompt_tokens": sum(r["tokens_evaluated"] for r in rows) / len(rows),
        "mean_prompt_ms": sum(r["timings"]["prompt_ms"] for r in rows) / len(rows),
        "mean_decode_ms": sum(r["timings"]["predicted_ms"] for r in rows) / len(rows),
    }
La première garde refuse une liste vide. La seconde parcourt les lignes avec any(...) : dès qu’une ligne génère autre chose que 64 jetons, signale une troncature ou possède une durée inférieure ou égale à zéro, le calcul est arrêté avec une erreur.
Ces refus ont une utilité très concrète. Une réponse arrêtée après 8 jetons ne doit pas améliorer artificiellement le débit d’une configuration. Un prompt qui déborde du contexte ne doit pas être comparé comme s’il avait été traité dans les mêmes conditions.
Le dictionnaire retourné rassemble ensuite le nombre de lignes, le temps HTTP moyen, le débit calculé sur le temps total, la longueur moyenne du prompt et les deux moyennes de timing serveur. Nous détaillons ces formules dans la section consacrée aux métriques.
Attention à la portée exacte de l’extrait : summarize() renvoie len(rows), mais ne contient pas de test imposant len(rows) == 30. Il ne compare pas non plus, à lui seul, les prompts des fichiers mono et dual. Les 30 requêtes et leur construction identique viennent du parcours ; il faut les retrouver dans les sorties. De même, cette fonction n’est pas un validateur exhaustif de toutes les valeurs numériques imaginables.
Enfin, compare() effectue les trois ratios à partir des fichiers produits. Les différences de configuration restent celles du Compose fourni : --split-mode none pour le mono et la répartition tensor-split 1,1 décrite pour le dual.
Lancer les six mesures dans l'ordre
Le poste utilisé et les ressources à prévoir
Le parcours testé demande Linux x86_64, Docker avec Compose, un pilote NVIDIA fonctionnel, NVIDIA Container Toolkit et deux RTX 3090.
Les provisions annoncées sont 12 Gio de RAM, 25 Gio de disque et 14 Gio de VRAM libre sur chacune des deux cartes. Ce sont des ressources prévues pour ce parcours, pas des minima démontrés par une recherche de seuil. Disposer de la quantité totale de mémoire sur une seule carte ne remplace pas la condition « sur chacune des cartes ».
Aucun mode d’inférence CPU n’est validé. Cela ne veut pas dire que le processeur de la machine ne sert à rien : Python, Docker et les échanges HTTP continuent d’en dépendre.
NVIDIA Container Toolkit permet à Docker d’exposer les GPU au conteneur. Il ne remplace pas le pilote installé sur l’hôte. Si le GPU fonctionne sous Linux mais n’est pas accessible dans Docker, consultez le guide officiel NVIDIA avant de poursuivre.
Extrayez le ZIP dans un dossier dédié, puis ouvrez un terminal à la racine du projet. Toutes les commandes ci-dessous partent de ce dossier. Évitez d’exécuter en même temps un autre travail sur les cartes mesurées : il introduirait une charge absente du protocole que vous cherchez à reproduire.
1. Valider l'hôte et construire l'environnement
Le préflight est le contrôle préalable. Il doit montrer que Docker accède aux deux cartes. Le script de configuration prépare les droits du projet ; le build construit l’image qui exécutera les mesures.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
À observer : le préflight et la construction doivent se terminer sans erreur. Vérifiez que GPU_DEVICE et GPU_DEVICE_2 désignent bien deux périphériques distincts. Deux variables portant des noms différents mais désignant la même carte ne créent pas un mode dual.
2. Acquérir le modèle, tester le contrat et préparer la charge
L’acquisition récupère et valide le modèle prévu par le projet. Les tests vérifient les métriques et les refus attendus. prepare écrit ensuite la description de la charge : les 30 requêtes par mode, les six modes et les 64 jetons de sortie.
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app -m src.cli prepare
À observer : la suite publique doit réussir. Ouvrez ensuite outputs/prepared.json : il doit contenir queries_per_mode: 30, les six modes et output_tokens: 64.
Ce contrôle ressemble à la vérification de fixtures avant un test d’API : vous devez connaître les entrées prévues avant d’interpréter la sortie. Le nombre exact de tests publics n’est pas indiqué dans cet article ; utilisez le compte rendu de la suite fournie, sans le remplacer par un nombre supposé.
Dans les commandes, app exécute le programme Python. run --rm crée un conteneur pour la commande puis le supprime à sa fin ; --no-deps empêche le démarrage automatique de services liés. C’est pour cela que les serveurs sont lancés explicitement à l’étape suivante. La référence de docker compose run précise ces options.
3. Mesurer un GPU aux trois contextes
Un profil Compose permet de sélectionner des services correspondant à un scénario. Ici, chaque profil porte le nom de sa configuration de mesure.
Nous allons répéter trois fois la même séquence : démarrer le serveur, mesurer, arrêter le profil. Ne laissez pas le serveur précédent actif : il pourrait encore réserver le port ou la VRAM.
docker compose --profile mono-512 up -d server-mono-512
docker compose run --rm --no-deps app -m src.cli measure-mono-512
docker compose --profile mono-512 down

docker compose --profile mono-2048 up -d server-mono-2048
docker compose run --rm --no-deps app -m src.cli measure-mono-2048
docker compose --profile mono-2048 down

docker compose --profile mono-4096 up -d server-mono-4096
docker compose run --rm --no-deps app -m src.cli measure-mono-4096
docker compose --profile mono-4096 down
À observer : trois fichiers outputs/mono-*.json doivent être présents. Chacun doit contenir 30 lignes, avec tokens_predicted égal à 64 et aucune troncature.
Ces fichiers sont les références sur un GPU. Conservez-les : le but n’est pas de retenir seulement la plus petite durée, mais de comparer chaque mode mono à son équivalent dual.
4. Mesurer deux GPU à contexte égal
Gardez les mêmes requêtes, le même padding pour chaque capacité, la même température et la même longueur de sortie. La variable étudiée dans chaque paire est la répartition du modèle.
docker compose --profile dual-512 up -d server-dual-512
docker compose run --rm --no-deps app -m src.cli measure-dual-512
docker compose --profile dual-512 down

docker compose --profile dual-2048 up -d server-dual-2048
docker compose run --rm --no-deps app -m src.cli measure-dual-2048
docker compose --profile dual-2048 down

docker compose --profile dual-4096 up -d server-dual-4096
docker compose run --rm --no-deps app -m src.cli measure-dual-4096
docker compose --profile dual-4096 down
À observer : trois fichiers outputs/dual-*.json, avec les mêmes attentes : 30 requêtes, 64 jetons produits par requête et aucun contexte tronqué.
Comparez aussi les prompts et leurs tokens_evaluated entre les fichiers correspondants. À ce stade, une incohérence de charge est plus importante qu’un joli chiffre de latence : il faut d’abord comprendre ce qui a réellement été comparé.
5. Agréger les six résultats
Cette commande relit les fichiers de mesure et calcule les agrégats et les ratios. Elle n’ajoute pas une nouvelle série de requêtes au tableau.
docker compose run --rm --no-deps app -m src.cli evaluate
À observer : outputs/evaluation.json doit contenir les six agrégats. Gardez également les fichiers par mode : ils restent nécessaires pour expliquer une moyenne inattendue.
Laissez la commande exercise pour plus tard. Nous allons d’abord apprendre à lire les résultats, puis formuler une prédiction avant de la lancer.
Lire les métriques avant les chiffres
Quel nombre répond à quelle question ?
| Champ | Ce qu’il mesure dans ce projet |
|---|---|
queries |
Le nombre de lignes utilisées pour l’agrégat : 30 attendues par mode. |
mean_ms |
La durée moyenne de l’appel HTTP, en millisecondes. |
tokens_per_second |
Les jetons générés divisés par la somme des durées HTTP. |
mean_prompt_tokens |
La moyenne de tokens_evaluated, donc la longueur du prompt rapportée par le serveur. |
mean_prompt_ms |
Le temps moyen de préremplissage rapporté par le serveur. |
mean_decode_ms |
Le temps moyen de décodage rapporté par le serveur. |
L’idée est de rapprocher une durée de son périmètre. mean_ms répond à « combien de temps notre client attend-il ? ». mean_decode_ms répond à une question plus étroite, concernant la phase de génération rapportée par le moteur.
Refaire une moyenne et un débit à la main
Prenons deux requêtes fictives, uniquement pour comprendre summarize(). Elles ont toutes deux généré 64 jetons sans troncature :
| Requête pédagogique | Durée HTTP | Jetons générés |
|---|---|---|
| A | 0,5 seconde | 64 |
| B | 1,5 seconde | 64 |
La durée moyenne vaut (0,5 + 1,5) / 2 = 1 seconde, soit 1 000 ms.
Le débit calculé par le projet vaut :
tokens_per_second = 64 × nombre de requêtes / somme des durées HTTP
Ici, il donne (64 × 2) / (0,5 + 1,5) = 64 tokens/s.
Ce n’est pas la moyenne arithmétique des débits individuels. La requête A donne 64 / 0,5 = 128 tokens/s ; B donne 64 / 1,5 ≈ 42,67 tokens/s. La moyenne de ces deux valeurs serait environ 85,33 tokens/s, un autre calcul que celui du code. Le projet rapporte bien le volume total produit au temps total mesuré.
Puisque chaque réponse contient exactement 64 jetons, on retrouve aussi directement :
tokens_per_second = 64 000 / mean_ms
Le temps moyen et ce débit ne sont donc pas deux preuves indépendantes d’une accélération : ils décrivent les mêmes durées, présentées dans deux unités différentes.
Les « tokens/s » ne mesurent pas seulement le décodage
Le numérateur de tokens_per_second compte les jetons générés, mais son dénominateur inclut tout le temps HTTP mesuré, préremplissage compris.
Prenons un autre exemple pédagogique : une requête met 300 ms à traiter son prompt, 680 ms à décoder sa réponse, et 1 000 ms au total côté client. Pour 64 jetons générés, le débit de bout en bout est 64 tokens/s. En divisant seulement par les 680 ms de décodage, on obtiendrait environ 94,12 tokens/s. Les deux calculs ont un sens, mais ils ne portent pas sur le même intervalle.
Les 20 ms restants dans cet exemple ne constituent pas une mesure isolée du réseau : c’est simplement la différence entre des périmètres de chronométrage. De la même façon, les temps internes du serveur ne doivent pas être considérés comme une décomposition universelle et exhaustive du temps HTTP.
Un préremplissage plus rapide peut donc améliorer les tokens/s de ce tutoriel sans accélérer le décodage. Nous allons précisément retrouver cette situation dans les résultats.
Lire un ratio sans inverser la conclusion
Le ratio du projet est :
ratio = temps_mono / temps_dual
Avec des durées fictives de 1 200 ms en mono et 1 000 ms en dual, le ratio vaut 1,2. Le dual met moins de temps. Mais la baisse de durée par rapport au mono est (1 200 - 1 000) / 1 200 ≈ 16,67 %, et non 20 %.
Avec 800 ms en mono et 1 000 ms en dual, le ratio vaut 0,8. Le dual met cette fois plus de temps : (1 000 - 800) / 800 = 25 % de durée supplémentaire.
On peut retenir la formule suivante pour exprimer la diminution de durée par rapport au mono :
diminution relative = 1 - temps_dual / temps_mono = 1 - 1 / ratio
Un résultat positif correspond à une baisse de durée ; un résultat négatif à une hausse. Le choix du dénominateur explique pourquoi « 20 % plus de débit » et « 20 % moins de temps » ne sont pas synonymes.
La bonne question reste donc : pour ce modèle, ces prompts, cette capacité et cette charge séquentielle, quelle durée change et de combien ? La quantité de VRAM ne répond pas, à elle seule, à cette question.
Résultats locaux observés
Les valeurs de la première reproduction
Les mesures suivantes proviennent de la première reproduction validée. La colonne « Contexte » désigne la capacité configurée, pas le nombre exact de jetons de chaque prompt.
Sur petit écran, faites défiler le tableau horizontalement.
| Contexte | Mono : ms moyens | Dual : ms moyens | Ratio mono/dual | Lecture |
|---|---|---|---|---|
| 512 | 711,80 | 709,49 | 1,003 | quasi identique, dual légèrement plus rapide |
| 2 048 | 886,90 | 843,31 | 1,052 | dual plus rapide sur cette charge |
| 4 096 | 1 124,56 | 1 025,49 | 1,097 | dual plus rapide sur cette charge |
Les débits correspondants sont 89,91, 72,16 et 56,91 tokens/s en mono, contre 90,21, 75,89 et 62,41 tokens/s en dual. Ils utilisent la formule de bout en bout expliquée précédemment, avec 64 jetons de sortie par requête.
À 512, la différence entre 711,80 ms et 709,49 ms est de 2,31 ms, soit environ 0,32 % de la durée mono. Ces deux dernières valeurs sont calculées à partir des moyennes affichées. On peut décrire un dual légèrement plus rapide dans ce tableau, mais pas conclure à un avantage stable à partir d’un écart aussi faible et de ces seules moyennes.
À 2 048 et 4 096, la durée moyenne dual est également plus basse. Le tableau décrit ce qui a été observé sur cette charge ; il ne démontre pas une relation générale selon laquelle augmenter le contexte rendrait toujours deux GPU plus avantageux.
À 4 096 : où le temps a-t-il été gagné ?
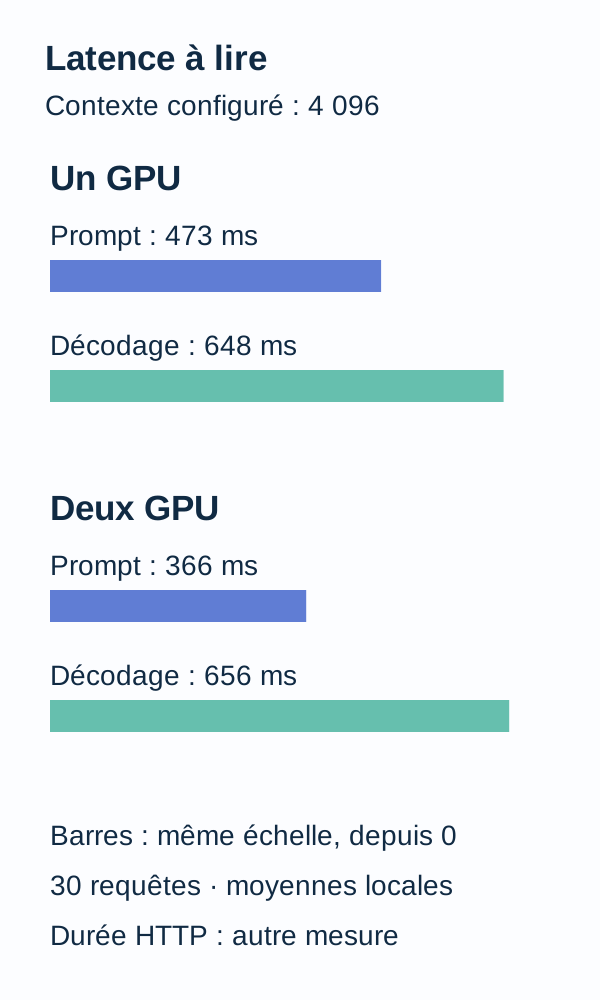
Les prompts effectivement évalués comptent alors en moyenne 2 080 jetons. Le préremplissage moyen passe de 473,17 ms en mono à 365,70 ms en dual ; le décodage passe de 648,18 ms à 656,43 ms.
Reprenons ces chiffres dans un tableau de lecture. La dernière colonne est une soustraction calculée à partir des valeurs publiées, pas une nouvelle mesure :
| Mesure à la capacité 4 096 | Mono | Dual | Différence dual − mono |
|---|---|---|---|
| Préremplissage moyen | 473,17 ms | 365,70 ms | −107,47 ms |
| Décodage moyen | 648,18 ms | 656,43 ms | +8,25 ms |
| Durée HTTP moyenne | 1 124,56 ms | 1 025,49 ms | −99,07 ms |
Le signe négatif indique une durée plus courte en dual. Le signe positif indique une durée plus longue.
Le gain se situe ici dans le préremplissage. Le décodage ne s’améliore pas : il ralentit légèrement. Cela précise la lecture des valeurs originales. La réponse complète arrive néanmoins plus vite parce que la baisse du préremplissage compense cette petite hausse du décodage et que le temps HTTP total diminue.
Les 99,07 ms représentent environ 8,81 % de durée HTTP en moins par rapport au mono, calculés à partir des moyennes affichées. Le ratio arrondi 1,097 ne signifie donc pas « 9,7 % de temps en moins ».
Et le débit global, lui, passe bien de 56,91 à 62,41 tokens/s. Ce n’est pas contradictoire avec un décodage légèrement plus lent : son calcul inclut le préremplissage. Voilà pourquoi il était important de définir les métriques avant de commenter les chiffres.
Ce que ces valeurs n’expliquent pas à elles seules
La décomposition localise le changement dans les temps rapportés par le serveur. Elle ne permet pas d’attribuer précisément ce gain à un transfert, à une interconnexion ou à une opération interne particulière : le tableau ne contient pas un profilage détaillé de ces mécanismes.
Deux exécutions complètes ont passé la validation sur le même poste. Le tableau ci-dessus n’est ni une moyenne des deux reproductions, ni le résultat d’une comparaison sur plusieurs machines. Aucune revue humaine indépendante ni mesure d’un parc hétérogène n’est revendiquée.
Un autre modèle, une autre interconnexion, un autre contexte, une charge concurrente ou une autre version de llama.cpp peut modifier l’équilibre. Le résultat est utile parce qu’il décrit une expérience identifiable, pas parce qu’il fournirait une règle d’achat universelle.
Ce que nous avons appris
Nous pouvons maintenant revenir à notre application web. Ajouter une carte n’équivaut pas à diviser par deux une attente HTTP : la façon de répartir le calcul et le poids de chaque étape comptent.
Le protocole rend cette question observable avec 30 requêtes identiques entre les deux modes d’une paire, une chauffe écartée, 64 jetons de sortie imposés et le nombre réel de jetons du prompt conservé. La capacité du serveur et la taille de la demande restent deux informations distinctes.
À 512, les durées observées sont presque identiques. À 2 048 et 4 096, le dual est plus rapide sur cette machine. À 4 096, la lecture détaillée montre un préremplissage plus court et un décodage légèrement plus long : regarder seulement les tokens/s aurait masqué cette différence.
La conclusion à conserver n’est donc pas « deux GPU sont meilleurs », ni « deux GPU ne servent à rien ». C’est : pour comparer deux configurations, définissez une charge identique, vérifiez ce qui a été exécuté, puis regardez quelle partie du temps change.
Exercice actif : prédire, modifier, exécuter, observer, expliquer
Prédire avant de regarder la réponse
Avant de lancer l’exercice, notez votre réponse à ces trois questions : deux GPU sont-ils nécessairement plus rapides ? Que signifie un ratio mono/dual de 0,8 ? Et un ratio de 1,2 ?
Ne vous contentez pas de « mieux » ou « moins bien ». Inventez pour chaque ratio deux durées cohérentes, puis indiquez quelle configuration fait attendre le client le plus longtemps.
docker compose run --rm --no-deps app -m src.cli exercise
Observer et expliquer
Le programme rappelle qu’un ratio inférieur à 1 signifie que le dual est plus lent pour cette charge. Rapprochez son explication de vos deux durées.
L’hypothèse « une carte supplémentaire diminue mécaniquement toute la latence » est trop forte. À 512, nous avons 711,80 ms contre 709,49 ms : un écart infime dans cette mesure. À 4 096, le temps total diminue mais le décodage augmente légèrement. Le comportement du système est plus précis que le simple nombre de cartes.
Pour vérifier votre compréhension, demandez-vous aussi pourquoi 62,41 tokens/s en dual ne prouve pas que la phase de décodage est devenue plus rapide. La réponse se trouve dans le dénominateur du débit : c’est la durée HTTP complète.
Modifier une seule variable dans une expérience séparée
Conservez vos sorties de référence, puis travaillez dans une copie du projet. Modifiez une seule capacité de contexte, de manière cohérente pour le couple mono/dual que vous souhaitez comparer. Reprenez les commandes de démarrage, de mesure et d’arrêt de cette paire.
Il faut conserver le même prompt construit pour les deux modes et vérifier que 64 jetons sont encore produits sans troncature. Si une modification change aussi la construction du padding, consignez-la : vous ne testez plus seulement une limite configurée, mais une autre longueur d’entrée. N’imposez pas artificiellement tokens_evaluated à la valeur de capacité pour rendre les fichiers cohérents.
L’article ne fournit pas de paramètre de commande supplémentaire pour automatiser cette variante. Repérez dans le Compose et dans cli.py du ZIP les définitions correspondantes, et documentez votre modification plutôt que d’inventer une option. La commande exercise et cette modification manuelle sont deux étapes distinctes.
Avant de relancer, écrivez votre prédiction sur la longueur du prompt, le préremplissage et le décodage. Après le lancement, comparez tokens_evaluated, mean_prompt_ms, mean_decode_ms et mean_ms. Expliquez ce qui change, mais aussi ce qui reste stable.
Votre nouveau résultat est une observation locale supplémentaire, pas une valeur r3 à substituer au tableau de référence. Un résultat sans amélioration est tout aussi utile pour apprendre à lire le mécanisme.
Dépannage et nettoyage
Les deux GPU ne sont pas distincts. Vérifiez GPU_DEVICE et GPU_DEVICE_2, puis reprenez le préflight. Ne lancez pas le profil dual tant que les deux variables ne désignent pas les cartes attendues.
Le serveur ne devient pas prêt. Consultez les journaux du service concerné et vérifiez les prérequis. La limite d’attente de disponibilité est de 180 secondes ; le délai HTTP d’une demande est fixé à 120 secondes. Un échec à cette étape n’est pas une mesure de performance à ajouter au tableau.
Une réponse est tronquée ou ne contient pas 64 jetons. N’intégrez pas cette ligne dans une comparaison présentée comme conforme au protocole. Vérifiez le contexte, le prompt et les paramètres du serveur, puis refaites la mesure dans des conditions documentées. Ne retirez pas simplement une ligne gênante pour améliorer la moyenne.
Le port ou la VRAM sont encore occupés. Un serveur précédent peut être resté actif. Utilisez la commande down du profil concerné, telle qu’elle figure plus haut, consultez ses logs et ne redémarrez que le profil à mesurer.
Le parcours arrête déjà chaque serveur avec son profil après la mesure. Ne sautez pas ces arrêts : la documentation des profils Compose précise que l’arrêt dépend des profils activés. Un docker compose down sans profil ne doit pas être pris pour une garantie de nettoyage d’un serveur profilé resté actif après une interruption.
Après les arrêts de profils prévus, terminez le parcours par la commande de nettoyage du projet :
docker compose down
Les modèles acquis et les JSON de sortie restent dans le dossier d’extraction. Sauvegardez les mesures utiles avant de supprimer uniquement votre extraction pour récupérer de l’espace. Ne purgez pas les volumes ou images d’autres projets pour terminer ce tutoriel.
Pour aller plus loin
Une moyenne ne décrit pas toutes les attentes
Rejouez ensuite la même matrice sur vos prompts réels, dans une expérience séparée, avec davantage de répétitions. Les percentiles p50, p95 et p99 permettent de lire la distribution des durées : p50 est la médiane ; p95 et p99 décrivent des seuils sous lesquels se situent respectivement environ 95 % et 99 % des observations.
L’intérêt pour une application web est immédiat : une moyenne convenable peut cacher quelques demandes très lentes. Avec seulement 30 mesures par mode, les percentiles élevés dépendent fortement des quelques valeurs les plus extrêmes ; les afficher ne remplace pas un protocole de répétition adapté.
Pour prolonger l’expérience, vous pouvez aussi alterner ou varier l’ordre des passages mono et dual au lieu de toujours mesurer tous les mono en premier. Ce serait une nouvelle variante du protocole, destinée à examiner un éventuel effet de l’ordre d’exécution ; elle ne fait pas partie des commandes r3 présentées ici.
Tester plusieurs clients est une autre expérience
Une charge concurrente consiste à soumettre plusieurs requêtes qui peuvent se chevaucher dans le temps. Elle fait intervenir la file d’attente, les limites du serveur et la mémoire disponible. Ce n’est pas la même question que la durée d’une suite de requêtes envoyées une à une.
Mesurez cette charge séparément, avec une file d’attente et des limites de mémoire observables. Ne traduisez pas les tokens/s séquentiels du tableau en nombre d’utilisateurs simultanés : ces utilisateurs n’ont pas été simulés dans ce parcours.
Pour que les nouvelles mesures restent interprétables, conservez ensemble le modèle, la version de llama.cpp, les paramètres serveur, les requêtes et les sorties. Changer un de ces éléments sans le noter revient à comparer deux configurations d’API dont on aurait perdu le détail.
Limites de production
Ce protocole ne mesure ni le débit sous concurrence, ni la file d’attente, ni la robustesse face à des prompts utilisateurs, ni le coût énergétique, ni la qualité des réponses. Il ne fournit pas non plus, à lui seul, une politique de déploiement ou une garantie de capacité.
Les ressources de l’hôte et le disque peuvent être influencés par d’autres processus. Des couches Docker publiques peuvent être réutilisées. Le fait d’écarter une chauffe ou de désactiver la réutilisation du prompt entre requêtes ne signifie donc pas que l’environnement entier est « à froid ».
Avant de choisir une infrastructure, reprenez vos prompts représentatifs et fixez vos critères : temps de réponse, latences élevées, débit sous la concurrence visée, erreurs acceptables et budget de VRAM. Ajoutez des répétitions, une observation des ressources et une évaluation de la qualité si le texte doit remplir une fonction métier.
Deux cartes ajoutent des possibilités matérielles ; seul un protocole adapté permet de savoir ce que ces possibilités apportent à votre application. Les mesures de ce tutoriel constituent un exemple de cette démarche, pas une conclusion valable pour tous les modèles ou tous les postes.
Références pour approfondir les notions
La documentation officielle du serveur llama.cpp décrit les paramètres de contexte, de répartition, de génération et les champs des réponses. Le ZIP conserve les paramètres réellement utilisés pour cette comparaison.
Les explications sur GGUF et la quantification, ainsi que le guide Hugging Face sur le coût de l’inférence, aident à distinguer stockage des poids, traitement du prompt et génération. Ce sont des compléments conceptuels ; le tutoriel n’utilise pas Transformers à la place de llama.cpp.
Pour le code d’exécution, consultez également la référence de time.perf_counter(), le guide des profils Docker Compose, la référence de docker compose run et le guide NVIDIA Container Toolkit.
Ces pages expliquent les concepts et les outils ; elles ne remplacent ni les fichiers du projet ni les sorties des reproductions. Leur contenu peut évoluer : pour retrouver le parcours présenté, gardez les versions et réglages du ZIP plutôt que de remplacer silencieusement le moteur par sa version courante.