





La vostra applicazione invia un testo a un modello locale e poi attende la risposta. Il processo funziona, ma l'attesa vi sembra un po' lunga. Viene spontanea un'idea: aggiungere una seconda scheda grafica per andare due volte più veloci.
È davvero ciò che accadrà? Non necessariamente. Due schede possono condividere il lavoro, ma devono anche scambiarsi dati. E non tutte le fasi della generazione di testo traggono lo stesso vantaggio da questa ripartizione.
Lo verificheremo con un piccolo banco di misura in Python e Docker. Il principio assomiglia a un test delle prestazioni di un'API: inviare un carico noto, cronometrare le risposte, conservare i risultati e confrontare due configurazioni. La novità consiste nel capire cosa fa il modello durante questa attesa.
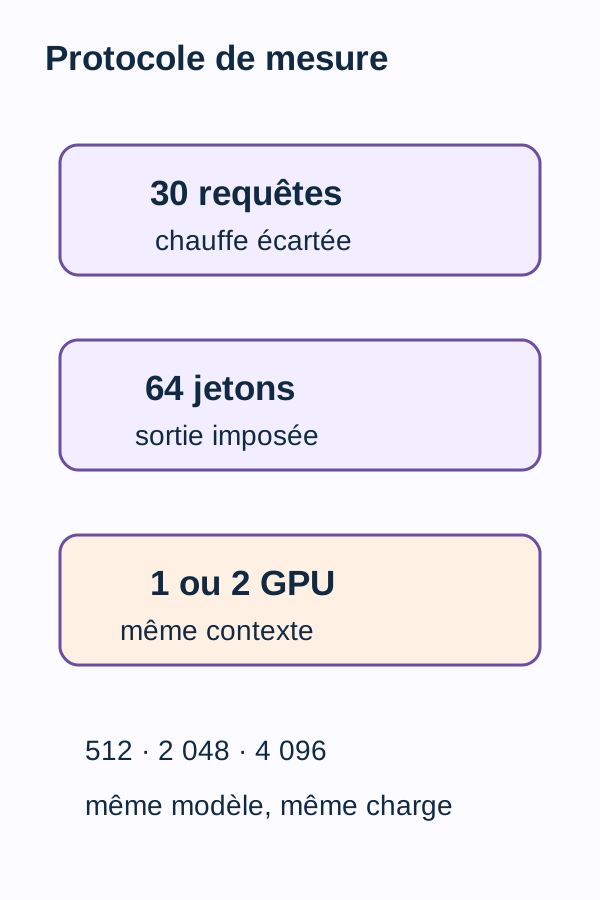
Scaricate il progetto completo del tutorial. Il progetto confronta lo stesso Qwen 7B Q8_0, eseguito da llama.cpp, in sei modalità: uno o due GPU, con capacità di contesto di 512, 2 048 e 4 096 token.
Lo scenario di un'applicazione web è il punto di partenza: l'archivio fornisce uno strumento di misura, non una funzionalità aziendale pronta al rilascio. Non addestrerete un modello, ma userete un modello già addestrato e ne osserverete l'esecuzione. Saper leggere funzioni Python, JSON e comandi Docker basta per seguire il percorso; le nozioni proprie dei modelli linguistici sono introdotte qui sotto.
I risultati presentati sono quelli delle riproduzioni r3 del progetto. I piccoli esempi di calcolo sono indicati come didattici e i calcoli aggiuntivi sulle misure sono identificati come tali: non costituiscono nuovi esperimenti GPU.
Le nozioni necessarie prima dei comandi
Il modello, il motore e la GPU non sono la stessa cosa
Il modello linguistico, o LLM, qui è Qwen 7B. I suoi parametri, chiamati anche pesi, sono valori numerici ottenuti durante l'apprendimento. Il nome «7B» indica una dimensione dell'ordine di sette miliardi di parametri, non sette miliardi di parole conservate in una base di dati.
llama.cpp è il motore che carica questo modello ed esegue i calcoli necessari per produrre testo. In questo tutorial espone un server HTTP: il nostro programma Python lo chiama come chiamerebbe un altro servizio. Usare il modello per produrre un risultato si chiama inferenza.
La variante Q8_0 indica un metodo di quantizzazione: una rappresentazione più compatta dei pesi, che qui usa valori quantizzati su 8 bit e fattori di scala. Questo nome non significa che tutta la memoria o tutti i calcoli del programma siano a 8 bit. La presentazione del formato GGUF e delle sue quantizzazioni completa questo punto.
Manteniamo identica questa variante nelle sei modalità. Confrontare un modello Q4 su una scheda con un modello Q8 su due schede mescolerebbe due cambiamenti: la rappresentazione del modello e la sua ripartizione hardware. Non è l'esperimento che vogliamo svolgere.
Un token non è necessariamente una parola
Un token è un'unità usata dal modello per rappresentare il testo. A seconda della sua suddivisione, può corrispondere a una parola, a una parte di parola o a un segno. Non si possono quindi sostituire sistematicamente «64 token» con «64 parole».
Il testo inviato al modello è il prompt. Qui comprende una parte di riempimento, chiamata padding, poi il testo di una richiesta. Questo riempimento è davvero testo da elaborare: non è una serie di caselle vuote che il modello ignorerebbe.
Conteremo separatamente i token in ingresso e quelli in uscita. È altrettanto importante quanto distinguere la dimensione di una richiesta HTTP da quella della sua risposta.
Capacità di contesto: lo spazio disponibile, non quello occupato
La capacità di contesto è il limite configurato per la sequenza che il server può gestire. In questo percorso devono starci il prompt e la generazione richiesta. Le sei modalità usano tre capacità: 512, 2 048 e 4 096.
Un'analogia web aiuta a non sbagliarsi: autorizzare un file di 10 Mo in un modulo non significa che tutti i file inviati pesino 10 Mo. Allo stesso modo, configurare 4 096 token non significa inviare un prompt di 4 096 token.
Il protocollo costruisce un padding fisso per ogni capacità. A parità di capacità, applica lo stesso padding alle stesse 30 richieste in mono e in dual. I prompt sono quindi confrontabili tra queste due modalità; ciò non significa che tutte e 30 le domande abbiano esattamente la stessa lunghezza.
Il campo da leggere è tokens_evaluated, che conserva il numero di token del prompt riportato dal server. Vedremo così che con l'impostazione 4 096 i prompt misurati contano in media 2 080 token, non 4 096.
Durante l'attesa, due fasi diverse
Il pre-riempimento, o prefill, corrisponde all'elaborazione del prompt già disponibile. Il modello deve calcolare le rappresentazioni di cui ha bisogno per iniziare a rispondere.
La decodifica corrisponde poi alla produzione di nuovi token. In una generazione autoregressiva, ogni nuovo token è scelto a partire da ciò che precede. Produrre il seguito non equivale quindi semplicemente ad avviare in parallelo 64 calcoli indipendenti. La documentazione Hugging Face sull'inferenza degli LLM spiega questo meccanismo e gli stati intermedi conservati durante la generazione.
Per il nostro client Python, queste fasi fanno parte di un'unica attesa HTTP. Il server fornisce tempi interni, ma il client cronometra la chiamata completa. Come con un profiler web, il tempo di una richiesta SQL e il tempo totale di una route non sono due nomi per la stessa misura.
Conserveremo quindi la durata HTTP, il tempo di pre-riempimento e il tempo di decodifica. Il cronometro non misura il tempo di rendering di una pagina nel browser: osserva il client di misura fornito dal progetto.
Perché chiedere esattamente 64 token?
Immaginiamo, solo per capire il problema, che un primo tentativo generi 12 token e il secondo 64. Anche se il primo termina più rapidamente, non abbiamo fatto generare la stessa quantità di testo.
Il progetto richiede quindi n_predict=64 e attiva ignore_eos. EOS è il marcatore di fine generazione; ignorarlo evita che un arresto naturale accorci la risposta. Il programma verifica poi che il server abbia effettivamente prodotto 64 token.
Costruiamo così un carico confrontabile, non una valutazione della qualità delle risposte. Un output forzato a 64 token può essere troppo lungo per una breve domanda o interrompersi prima della fine di una frase. Questo comportamento è voluto per la misura.
Una GPU o due GPU: come viene ripartito il lavoro?
La VRAM è la memoria della scheda grafica. È distinta dalla RAM della macchina. In modalità mono, il modello viene caricato su una scheda. In modalità dual, il percorso descrive una ripartizione dei suoi livelli fra due schede, con tensor-split 1,1.
Un livello è una fase di calcolo della rete. Per visualizzare l'idea, immaginate una catena di elaborazione le cui prime fasi si trovano su una macchina e le successive su un'altra: i risultati intermedi devono passare dall'una all'altra. La seconda macchina non rende automaticamente simultanee tutte le fasi.
In llama.cpp, --split-mode sceglie come ripartire il modello; --tensor-split fornisce le proporzioni. 1,1 esprime parti uguali, non una promessa di tempo dimezzato né di occupazione della memoria perfettamente identica. La modalità mono del progetto usa --split-mode none. La documentazione del server distingue questi parametri; mantenete quelli dello ZIP per riprodurre il percorso.
Le due VRAM non diventano una memoria unificata di 48 Gio. La presenza di NVLink, un'interconnessione hardware tra schede, non è presupposta in questo esperimento. Non bisogna neppure confondere questa condivisione di un modello con due server indipendenti che riceverebbero ciascuno le proprie richieste.
Infine, il carico è sequenziale: il nostro client attende una risposta prima di inviare la richiesta successiva. Non cerchiamo quindi ancora di sapere quanti utenti simultanei potrebbe servire il server.
Il codice che rende il confronto controllato
Sei modalità, ma tre confronti utili
La matrice dell'esperimento è semplice:
| Capacità di contesto | Riferimento su una GPU | Confronto su due GPU |
|---|---|---|
| 512 | mono-512 |
dual-512 |
| 2 048 | mono-2048 |
dual-2048 |
| 4 096 | mono-4096 |
dual-4096 |
Ogni confronto avviene su una riga di questa tabella, quindi a capacità uguale. Contrapporre mono-512 a dual-4096 non permetterebbe di isolare il cambiamento di ripartizione: cambierebbero anche l'impostazione del contesto e il carico costruito per tale impostazione.
In cli.py, ogni comando measure-<mode> costruisce i prompt a partire dal padding previsto e dalle 30 richieste. La funzione one() chiama /completion con parametri fissi: 64 token richiesti, temperatura 0, seed 42, ignore_eos=true e cache_prompt=false.
Temperatura e seed fanno parte delle impostazioni mantenute per limitare le variazioni dovute alla generazione. Non trasformano una durata misurata in una costante universale: lo stato della macchina e il motore di esecuzione continuano a contare.
Il warm-up e la cache rispondono a due domande diverse
Prima delle misure considerate, il programma invia una richiesta di warm-up. Fa passare il server dal percorso di generazione, ma la sua durata non compare nella media. Il caricamento iniziale e questa prima richiesta non sono quindi mescolati alle 30 richieste successive.
Questo non significa che tutti gli effetti di avvio o di variabilità scompaiano. Il warm-up è una regola del protocollo, non una garanzia di uno stato hardware perfetto.
L'impostazione cache_prompt=false, invece, riguarda il riutilizzo di un prefisso elaborato durante una richiesta precedente. Non vogliamo che una modalità benefici di un prompt comune già calcolato mentre l'altra lo rilegge. Questa impostazione non significa «disattivare tutte le cache della macchina». La cache dei livelli Docker, per esempio, è un argomento distinto.
Non bisogna neppure confonderla con gli stati intermedi conservati durante una stessa generazione, spesso chiamati cache KV. Questi stati evitano di ricalcolare alcuni elementi del testo precedente a ogni nuovo token. La distinzione tra riutilizzo tra richieste e calcolo di una risposta è descritta nelle documentazioni di llama.cpp e Hugging Face.
Conservare le osservazioni prima di calcolare una media
Per ogni richiesta, il codice conserva il prompt, il testo grezzo prodotto, la durata HTTP, i timing del server, tokens_predicted, tokens_evaluated e l'indicatore di troncamento.
Perché conservare tanti dettagli? Perché una media da sola non permette di vedere che una risposta era troppo corta o che un contesto ha superato il limite. Le righe individuali svolgono lo stesso ruolo delle tracce di richieste in un'applicazione web: permettono di risalire a ciò che è stato realmente eseguito.
summarize() verifica alcune condizioni prima di aggregare i risultati. compare() calcola poi il rapporto temps_mono / temps_dual, a capacità uguale. Un rapporto superiore a 1 significa che il dual è stato più rapido; uno inferiore a 1 significa che è stato più lento. Ci prenderemo il tempo per calcolare esempi dopo l'esecuzione.
Le funzioni centrali da leggere prima dell'esecuzione
Attendere il server, poi avviare il cronometro
In client.py, ready() interroga /health per al massimo 180 secondi in attesa di un server pronto. request() imposta un timeout HTTP di 120 secondi. Attendere che un processo sia pronto e delimitare una chiamata HTTP sono due responsabilità diverse.
Per uno sviluppatore web, ritroviamo la distinzione tra «il container è avviato» e «il servizio risponde davvero». Un server che sta ancora caricando il modello non deve essere scambiato per una richiesta di inferenza anormalmente lenta.
one(): una richiesta, un'osservazione completa
Ecco il cuore della misura. padding, data, mode, capacity, request() e save() sono forniti dal resto del progetto: questo estratto va letto nel suo contesto, non è uno script autonomo da copiare in una directory vuota.
def one(query):
    prompt = padding + query["query"]
    start = time.perf_counter()
    result = request(
        "/completion",
        {
            "prompt": prompt,
            "n_predict": 64,
            "temperature": 0,
            "seed": 42,
            "ignore_eos": True,
            "cache_prompt": False,
        },
    )
    return {
        **query,
        "prompt": prompt,
        "raw": result["content"],
        "seconds": time.perf_counter() - start,
        "timings": result["timings"],
        "tokens_predicted": result["tokens_predicted"],
        "tokens_evaluated": result["tokens_evaluated"],
        "truncated": result.get("truncated", False),
    }


one(data["queries"][0])
rows = [one(q) for q in data["queries"]]
summarize(rows)
save(mode, {"mode": mode, "context_capacity": capacity, "rows": rows})
Cominciamo da prompt = padding + query["query"]. Il programma costruisce prima il testo della richiesta, quindi avvia il cronometro con time.perf_counter(). La costruzione di questa stringa precede dunque la misura HTTP.
perf_counter() fornisce un contatore adatto alla misura di una durata. Ciò che conta è la differenza tra due chiamate, non il valore assoluto del contatore. L'attesa della risposta fa parte del tempo trascorso: non misuriamo solo il tempo in cui il processore Python lavora. È il comportamento descritto nella documentazione ufficiale di Python.
request() attende la risposta del server. Il valore seconds viene calcolato dopo il suo ritorno, mentre timings conserva le misure prodotte dal lato server. La scrittura del file tramite save() arriva più tardi; il suo tempo non viene aggiunto a ogni durata HTTP.
La notazione **query ricopia i campi della richiesta nel dizionario dei risultati. Il codice aggiunge poi ciò che è stato osservato. Questo permette di collegare una durata al suo input invece di conservare una lista anonima di numeri.
Notate anche result.get("truncated", False): se il campo manca, questo estratto registra False. Questa scelta dipende dal contratto con la versione di server usata; non è un meccanismo indipendente capace di rilevare ogni troncamento. Per studiare i risultati r3, mantenete insieme il server e i file forniti.
La prima richiesta viene eseguita due volte, ma misurata una sola volta nell'elenco
La riga one(data["queries"][0]) chiama la prima domanda per il warm-up e non ne conserva il risultato in rows.
La list comprehension [one(q) for q in data["queries"]] percorre poi le 30 richieste, compresa la prima. Attende ogni risultato prima di continuare: qui non viene introdotta alcuna concorrenza.
Il conteggio di questo ciclo dà quindi 31 chiamate a /completion per modalità: 1 warm-up e 30 righe conservate. Per le sei modalità, ciò rappresenta 180 righe di misura e 6 warm-up aggiuntivi, esclusi eventuali altri richiami del percorso. Il warm-up viene eseguito, ma non deve diventare una trentunesima riga nella media.
summarize(): verificare prima di calcolare
Il secondo estratto è la funzione di aggregazione:
def summarize(rows):
    if not rows:
        raise ValueError("Mesures vides")
    if any(
        r["tokens_predicted"] != 64
        or r["truncated"]
        or r["seconds"] <= 0
        for r in rows
    ):
        raise ValueError("Longueur, contexte ou temps invalide")
    return {
        "queries": len(rows),
        "mean_ms": 1000 * sum(r["seconds"] for r in rows) / len(rows),
        "tokens_per_second": 64 * len(rows) / sum(r["seconds"] for r in rows),
        "mean_prompt_tokens": sum(r["tokens_evaluated"] for r in rows) / len(rows),
        "mean_prompt_ms": sum(r["timings"]["prompt_ms"] for r in rows) / len(rows),
        "mean_decode_ms": sum(r["timings"]["predicted_ms"] for r in rows) / len(rows),
    }
Il primo controllo rifiuta una lista vuota. Il secondo percorre le righe con any(...): non appena una riga genera qualcosa di diverso da 64 token, segnala un troncamento o possiede una durata minore o uguale a zero, il calcolo viene interrotto con un errore.
Questi rifiuti hanno un'utilità molto concreta. Una risposta interrotta dopo 8 token non deve migliorare artificialmente il throughput di una configurazione. Un prompt che supera il contesto non deve essere confrontato come se fosse stato elaborato nelle stesse condizioni.
Il dizionario restituito riunisce poi il numero di righe, il tempo HTTP medio, il throughput calcolato sul tempo totale, la lunghezza media del prompt e le due medie dei timing server. Spieghiamo queste formule nella sezione dedicata alle metriche.
Attenzione alla portata esatta dell'estratto: summarize() restituisce len(rows), ma non contiene un test che imponga len(rows) == 30. Non confronta neppure, da solo, i prompt dei file mono e dual. Le 30 richieste e la loro costruzione identica provengono dal percorso; bisogna ritrovarle negli output. Allo stesso modo, questa funzione non è un validatore esaustivo di tutti i valori numerici immaginabili.
Infine, compare() esegue i tre rapporti a partire dai file prodotti. Le differenze di configurazione restano quelle del Compose fornito: --split-mode none per il mono e la ripartizione tensor-split 1,1 descritta per il dual.
Eseguire le sei misure nell'ordine
La postazione usata e le risorse da prevedere
Il percorso testato richiede Linux x86_64, Docker con Compose, un driver NVIDIA funzionante, NVIDIA Container Toolkit e due RTX 3090.
Le risorse indicate sono 12 Gio di RAM, 25 Gio di disco e 14 Gio di VRAM libera su ciascuna delle due schede. Sono risorse previste per questo percorso, non minimi dimostrati da una ricerca della soglia. Avere la quantità totale di memoria su una sola scheda non sostituisce la condizione «su ciascuna delle schede».
Non è convalidata alcuna modalità di inferenza CPU. Questo non significa che il processore della macchina sia inutile: Python, Docker e gli scambi HTTP continuano a dipenderne.
NVIDIA Container Toolkit consente a Docker di esporre le GPU al container. Non sostituisce il driver installato sull'host. Se la GPU funziona in Linux ma non è accessibile in Docker, consultate la guida ufficiale NVIDIA prima di proseguire.
Estraete lo ZIP in una cartella dedicata, quindi aprite un terminale nella radice del progetto. Tutti i comandi seguenti partono da questa cartella. Evitate di eseguire contemporaneamente un altro lavoro sulle schede misurate: introdurrebbe un carico assente dal protocollo che cercate di riprodurre.
1. Convalidare l'host e costruire l'ambiente
Il preflight è il controllo preliminare. Deve mostrare che Docker accede alle due schede. Lo script di configurazione prepara i permessi del progetto; il build costruisce l'immagine che eseguirà le misure.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
Da osservare: il preflight e la costruzione devono terminare senza errore. Verificate che GPU_DEVICE e GPU_DEVICE_2 indichino davvero due dispositivi distinti. Due variabili con nomi diversi che indicano la stessa scheda non creano una modalità dual.
2. Acquisire il modello, testare il contratto e preparare il carico
L'acquisizione recupera e convalida il modello previsto dal progetto. I test verificano le metriche e i rifiuti attesi. prepare scrive poi la descrizione del carico: le 30 richieste per modalità, le sei modalità e i 64 token in uscita.
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app -m src.cli prepare
Da osservare: la suite pubblica deve riuscire. Aprite poi outputs/prepared.json: deve contenere queries_per_mode: 30, le sei modalità e output_tokens: 64.
Questo controllo assomiglia alla verifica delle fixture prima di un test API: dovete conoscere gli input previsti prima di interpretare l'output. Il numero esatto dei test pubblici non è indicato in questo articolo; usate il resoconto della suite fornita, senza sostituirlo con un numero presunto.
Nei comandi, app esegue il programma Python. run --rm crea un container per il comando e lo elimina al termine; --no-deps impedisce l'avvio automatico dei servizi collegati. Per questo i server vengono avviati esplicitamente nella fase successiva. La documentazione di docker compose run precisa queste opzioni.
3. Misurare una GPU nei tre contesti
Un profilo Compose permette di selezionare servizi corrispondenti a uno scenario. Qui ogni profilo porta il nome della sua configurazione di misura.
Ripeteremo tre volte la stessa sequenza: avviare il server, misurare, arrestare il profilo. Non lasciate attivo il server precedente: potrebbe ancora riservare la porta o la VRAM.
docker compose --profile mono-512 up -d server-mono-512
docker compose run --rm --no-deps app -m src.cli measure-mono-512
docker compose --profile mono-512 down

docker compose --profile mono-2048 up -d server-mono-2048
docker compose run --rm --no-deps app -m src.cli measure-mono-2048
docker compose --profile mono-2048 down

docker compose --profile mono-4096 up -d server-mono-4096
docker compose run --rm --no-deps app -m src.cli measure-mono-4096
docker compose --profile mono-4096 down
Da osservare: devono essere presenti tre file outputs/mono-*.json. Ognuno deve contenere 30 righe, con tokens_predicted uguale a 64 e nessun troncamento.
Questi file sono i riferimenti su una GPU. Conservateli: lo scopo non è trattenere solo la durata più piccola, ma confrontare ogni modalità mono con l'equivalente dual.
4. Misurare due GPU a contesto uguale
Mantenete le stesse richieste, lo stesso padding per ogni capacità, la stessa temperatura e la stessa lunghezza di output. La variabile studiata in ogni coppia è la ripartizione del modello.
docker compose --profile dual-512 up -d server-dual-512
docker compose run --rm --no-deps app -m src.cli measure-dual-512
docker compose --profile dual-512 down

docker compose --profile dual-2048 up -d server-dual-2048
docker compose run --rm --no-deps app -m src.cli measure-dual-2048
docker compose --profile dual-2048 down

docker compose --profile dual-4096 up -d server-dual-4096
docker compose run --rm --no-deps app -m src.cli measure-dual-4096
docker compose --profile dual-4096 down
Da osservare: tre file outputs/dual-*.json, con le stesse aspettative: 30 richieste, 64 token prodotti per richiesta e nessun contesto troncato.
Confrontate anche i prompt e i loro tokens_evaluated tra i file corrispondenti. A questo punto, un'incoerenza del carico è più importante di una bella cifra di latenza: bisogna prima capire cosa è stato realmente confrontato.
5. Aggregare i sei risultati
Questo comando rilegge i file di misura e calcola gli aggregati e i rapporti. Non aggiunge una nuova serie di richieste alla tabella.
docker compose run --rm --no-deps app -m src.cli evaluate
Da osservare: outputs/evaluation.json deve contenere i sei aggregati. Conservate anche i file per modalità: restano necessari per spiegare una media inattesa.
Lasciate il comando exercise per più tardi. Impareremo prima a leggere i risultati, poi formuleremo una previsione prima di avviarlo.
Leggere le metriche prima dei numeri
Quale numero risponde a quale domanda?
| Campo | Cosa misura in questo progetto |
|---|---|
queries |
Il numero di righe usate per l'aggregato: 30 attese per modalità. |
mean_ms |
La durata media della chiamata HTTP, in millisecondi. |
tokens_per_second |
I token generati divisi per la somma delle durate HTTP. |
mean_prompt_tokens |
La media di tokens_evaluated, quindi la lunghezza del prompt riportata dal server. |
mean_prompt_ms |
Il tempo medio di pre-riempimento riportato dal server. |
mean_decode_ms |
Il tempo medio di decodifica riportato dal server. |
L'idea è mettere in relazione una durata con il suo perimetro. mean_ms risponde a «quanto attende il nostro client?». mean_decode_ms risponde a una domanda più ristretta, relativa alla fase di generazione riportata dal motore.
Rifare a mano una media e un throughput
Prendiamo due richieste fittizie, solo per comprendere summarize(). Entrambe hanno generato 64 token senza troncamento:
| Richiesta didattica | Durata HTTP | Token generati |
|---|---|---|
| A | 0,5 secondo | 64 |
| B | 1,5 secondi | 64 |
La durata media vale (0,5 + 1,5) / 2 = 1 secondo, cioè 1 000 ms.
Il throughput calcolato dal progetto vale:
tokens_per_second = 64 × numero di richieste / somma delle durate HTTP
Qui dà (64 × 2) / (0,5 + 1,5) = 64 tokens/s.
Non è la media aritmetica dei throughput individuali. La richiesta A dà 64 / 0,5 = 128 tokens/s; B dà 64 / 1,5 ≈ 42,67 tokens/s. La media di questi due valori sarebbe circa 85,33 tokens/s, un calcolo diverso da quello del codice. Il progetto riporta proprio il volume totale prodotto sul tempo totale misurato.
Poiché ogni risposta contiene esattamente 64 token, si ricava anche direttamente:
tokens_per_second = 64 000 / mean_ms
Il tempo medio e questo throughput non sono quindi due prove indipendenti di un'accelerazione: descrivono le stesse durate, presentate in due unità differenti.
I «token/s» non misurano soltanto la decodifica
Il numeratore di tokens_per_second conta i token generati, ma il suo denominatore include tutto il tempo HTTP misurato, compreso il pre-riempimento.
Prendiamo un altro esempio didattico: una richiesta impiega 300 ms per elaborare il prompt, 680 ms per decodificare la risposta e 1 000 ms in totale lato client. Per 64 token generati, il throughput end-to-end è 64 tokens/s. Dividendo solo per i 680 ms di decodifica, otterremmo circa 94,12 tokens/s. Entrambi i calcoli hanno senso, ma non riguardano lo stesso intervallo.
I 20 ms restanti in questo esempio non costituiscono una misura isolata della rete: sono semplicemente la differenza fra perimetri di cronometraggio. Allo stesso modo, i tempi interni del server non devono essere considerati una scomposizione universale ed esaustiva del tempo HTTP.
Un pre-riempimento più rapido può quindi migliorare i token/s di questo tutorial senza accelerare la decodifica. Ritroveremo esattamente questa situazione nei risultati.
Leggere un rapporto senza invertire la conclusione
Il rapporto del progetto è:
ratio = temps_mono / temps_dual
Con durate fittizie di 1 200 ms in mono e 1 000 ms in dual, il rapporto vale 1,2. Il dual impiega meno tempo. Ma la diminuzione della durata rispetto al mono è (1 200 - 1 000) / 1 200 ≈ 16,67 %, non 20 %.
Con 800 ms in mono e 1 000 ms in dual, il rapporto vale 0,8. Questa volta il dual impiega più tempo: (1 000 - 800) / 800 = 25 % di durata aggiuntiva.
Possiamo ricordare la formula seguente per esprimere la diminuzione della durata rispetto al mono:
diminution relative = 1 - temps_dual / temps_mono = 1 - 1 / ratio
Un risultato positivo corrisponde a una durata ridotta; un risultato negativo a una durata aumentata. La scelta del denominatore spiega perché «20 % di throughput in più» e «20 % di tempo in meno» non sono sinonimi.
La domanda corretta resta quindi: per questo modello, questi prompt, questa capacità e questo carico sequenziale, quale durata cambia e di quanto? La quantità di VRAM non risponde da sola a questa domanda.
Risultati locali osservati
I valori della prima riproduzione
Le misure seguenti provengono dalla prima riproduzione convalidata. La colonna «Contesto» indica la capacità configurata, non il numero esatto di token di ciascun prompt.
Su schermo piccolo, scorrete la tabella orizzontalmente.
| Contesto | Mono: ms medi | Dual: ms medi | Rapporto mono/dual | Lettura |
|---|---|---|---|---|
| 512 | 711,80 | 709,49 | 1,003 | quasi identico, dual leggermente più rapido |
| 2 048 | 886,90 | 843,31 | 1,052 | dual più rapido con questo carico |
| 4 096 | 1 124,56 | 1 025,49 | 1,097 | dual più rapido con questo carico |
I throughput corrispondenti sono 89,91, 72,16 e 56,91 tokens/s in mono, contro 90,21, 75,89 e 62,41 tokens/s in dual. Usano la formula end-to-end spiegata prima, con 64 token in uscita per richiesta.
A 512, la differenza tra 711,80 ms e 709,49 ms è 2,31 ms, cioè circa 0,32 % della durata mono. Questi ultimi due valori sono calcolati dalle medie visualizzate. Si può descrivere un dual leggermente più rapido in questa tabella, ma non concludere che abbia un vantaggio stabile da uno scarto così piccolo e dalle sole medie.
A 2 048 e 4 096, anche la durata media dual è più bassa. La tabella descrive quanto osservato con questo carico; non dimostra una relazione generale secondo cui aumentare il contesto renderebbe sempre più vantaggiose due GPU.
A 4 096: dove è stato guadagnato tempo?
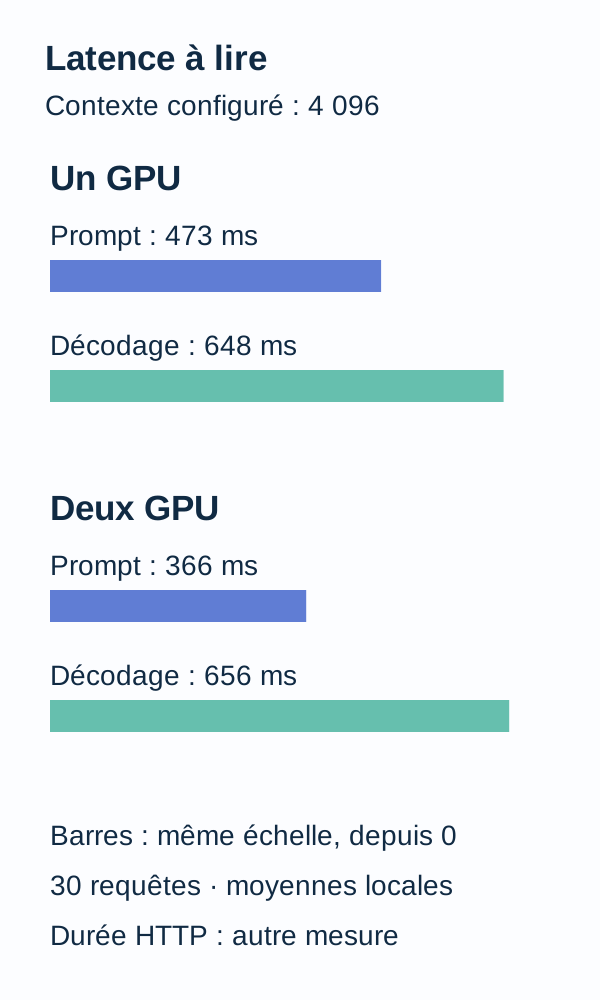
I prompt realmente valutati contano allora in media 2 080 token. Il pre-riempimento medio passa da 473,17 ms in mono a 365,70 ms in dual; la decodifica passa da 648,18 ms a 656,43 ms.
Riprendiamo questi numeri in una tabella di lettura. L'ultima colonna è una sottrazione calcolata dai valori pubblicati, non una nuova misura:
| Misura alla capacità 4 096 | Mono | Dual | Differenza dual − mono |
|---|---|---|---|
| Pre-riempimento medio | 473,17 ms | 365,70 ms | −107,47 ms |
| Decodifica media | 648,18 ms | 656,43 ms | +8,25 ms |
| Durata HTTP media | 1 124,56 ms | 1 025,49 ms | −99,07 ms |
Il segno negativo indica una durata più breve in dual. Il segno positivo indica una durata più lunga.
Il guadagno si trova qui nel pre-riempimento. La decodifica non migliora: rallenta leggermente. Questo precisa la lettura dei valori originali. La risposta completa arriva comunque più rapidamente perché la diminuzione del pre-riempimento compensa il piccolo aumento della decodifica e il tempo HTTP totale diminuisce.
I 99,07 ms rappresentano circa l'8,81 % di durata HTTP in meno rispetto al mono, calcolato dalle medie visualizzate. Il rapporto arrotondato 1,097 non significa quindi «9,7 % di tempo in meno».
E il throughput globale passa effettivamente da 56,91 a 62,41 tokens/s. Ciò non contraddice una decodifica leggermente più lenta: il suo calcolo include il pre-riempimento. Ecco perché era importante definire le metriche prima di commentare le cifre.
Ciò che questi valori non spiegano da soli
La scomposizione localizza il cambiamento nei tempi riportati dal server. Non permette di attribuire con precisione questo guadagno a un trasferimento, a un'interconnessione o a una particolare operazione interna: la tabella non contiene un profiling dettagliato di questi meccanismi.
Due esecuzioni complete hanno superato la convalida sulla stessa postazione. La tabella sopra non è né una media delle due riproduzioni né il risultato di un confronto su più macchine. Non viene rivendicata alcuna revisione umana indipendente né una misura su un parco eterogeneo.
Un altro modello, un'altra interconnessione, un altro contesto, un carico concorrente o un'altra versione di llama.cpp possono modificare l'equilibrio. Il risultato è utile perché descrive un esperimento identificabile, non perché fornirebbe una regola d'acquisto universale.
Cosa abbiamo imparato
Ora possiamo tornare alla nostra applicazione web. Aggiungere una scheda non equivale a dimezzare un'attesa HTTP: contano il modo in cui è ripartito il calcolo e il peso di ciascuna fase.
Il protocollo rende questa domanda osservabile con 30 richieste identiche tra le due modalità di una coppia, un warm-up escluso, 64 token di output imposti e il numero reale di token del prompt conservato. La capacità del server e la dimensione della richiesta restano due informazioni distinte.
A 512, le durate osservate sono quasi identiche. A 2 048 e 4 096, il dual è più rapido su questa macchina. A 4 096, la lettura dettagliata mostra un pre-riempimento più corto e una decodifica leggermente più lunga: guardare solo i token/s avrebbe nascosto questa differenza.
La conclusione da mantenere non è quindi «due GPU sono migliori», né «due GPU non servono a nulla». È questa: per confrontare due configurazioni, definite un carico identico, verificate cosa è stato eseguito, quindi osservate quale parte del tempo cambia.
Esercizio attivo: prevedere, modificare, eseguire, osservare, spiegare
Prevedere prima di guardare la risposta
Prima di avviare l'esercizio, annotate la vostra risposta a queste tre domande: due GPU sono necessariamente più rapide? Cosa significa un rapporto mono/dual di 0,8? E un rapporto di 1,2?
Non limitatevi a «meglio» o «peggio». Inventate per ogni rapporto due durate coerenti, poi indicate quale configurazione fa attendere più a lungo il client.
docker compose run --rm --no-deps app -m src.cli exercise
Osservare e spiegare
Il programma ricorda che un rapporto inferiore a 1 significa che il dual è più lento per questo carico. Avvicinate la sua spiegazione alle vostre due durate.
L'ipotesi «una scheda aggiuntiva riduce meccanicamente ogni latenza» è troppo forte. A 512, abbiamo 711,80 ms contro 709,49 ms: uno scarto minimo in questa misura. A 4 096, il tempo totale diminuisce ma la decodifica aumenta leggermente. Il comportamento del sistema è più preciso del semplice numero di schede.
Per verificare la vostra comprensione, chiedetevi anche perché 62,41 tokens/s in dual non prova che la fase di decodifica sia diventata più rapida. La risposta sta nel denominatore del throughput: è la durata HTTP completa.
Modificare una sola variabile in un esperimento separato
Conservate i vostri output di riferimento, poi lavorate in una copia del progetto. Modificate una sola capacità di contesto, in modo coerente per la coppia mono/dual che desiderate confrontare. Ripetete i comandi di avvio, misura e arresto della coppia.
Occorre mantenere lo stesso prompt costruito per le due modalità e verificare che 64 token siano ancora prodotti senza troncamento. Se una modifica cambia anche la costruzione del padding, annotatela: non testate più soltanto un limite configurato, ma anche un'altra lunghezza di input. Non imponete artificialmente tokens_evaluated al valore della capacità per rendere coerenti i file.
L'articolo non fornisce un parametro di comando supplementare per automatizzare questa variante. Individuate nel Compose e nel cli.py dello ZIP le definizioni corrispondenti e documentate la modifica invece di inventare un'opzione. Il comando exercise e questa modifica manuale sono due fasi distinte.
Prima di rieseguire, scrivete la vostra previsione sulla lunghezza del prompt, sul pre-riempimento e sulla decodifica. Dopo l'avvio, confrontate tokens_evaluated, mean_prompt_ms, mean_decode_ms e mean_ms. Spiegate cosa cambia, ma anche cosa resta stabile.
Il vostro nuovo risultato è un'osservazione locale aggiuntiva, non un valore r3 da sostituire alla tabella di riferimento. Un risultato senza miglioramento è altrettanto utile per imparare a leggere il meccanismo.
Risoluzione dei problemi e pulizia
Le due GPU non sono distinte. Verificate GPU_DEVICE e GPU_DEVICE_2, poi ripetete il preflight. Non avviate il profilo dual finché le due variabili non indicano le schede previste.
Il server non diventa pronto. Consultate i log del servizio interessato e verificate i prerequisiti. Il limite di attesa della disponibilità è 180 secondi; il timeout HTTP di una richiesta è fissato a 120 secondi. Un errore in questa fase non è una misura delle prestazioni da aggiungere alla tabella.
Una risposta è troncata o non contiene 64 token. Non integrate questa riga in un confronto presentato come conforme al protocollo. Verificate il contesto, il prompt e i parametri del server, quindi ripetete la misura in condizioni documentate. Non eliminate semplicemente una riga scomoda per migliorare la media.
La porta o la VRAM sono ancora occupate. Un server precedente può essere rimasto attivo. Usate il comando down del profilo interessato, come indicato sopra, consultate i suoi log e riavviate solo il profilo da misurare.
Il percorso arresta già ogni server con il proprio profilo dopo la misura. Non saltate questi arresti: la documentazione dei profili Compose precisa che l'arresto dipende dai profili attivati. Un docker compose down senza profilo non deve essere considerato una garanzia di pulizia di un server profilato rimasto attivo dopo un'interruzione.
Dopo gli arresti dei profili previsti, terminate il percorso con il comando di pulizia del progetto:
docker compose down
I modelli acquisiti e i JSON di output restano nella cartella di estrazione. Salvate le misure utili prima di eliminare solo la vostra estrazione per recuperare spazio. Non svuotate volumi o immagini di altri progetti per terminare questo tutorial.
Per andare oltre
Una media non descrive tutte le attese
Ripetete poi la stessa matrice sui vostri prompt reali, in un esperimento separato, con più ripetizioni. I percentili p50, p95 e p99 permettono di leggere la distribuzione delle durate: p50 è la mediana; p95 e p99 descrivono soglie sotto le quali si trovano rispettivamente circa il 95 % e il 99 % delle osservazioni.
L'interesse per un'applicazione web è immediato: una media accettabile può nascondere alcune richieste molto lente. Con sole 30 misure per modalità, i percentili elevati dipendono fortemente dai pochi valori più estremi; visualizzarli non sostituisce un protocollo di ripetizione adatto.
Per prolungare l'esperimento, potete anche alternare o variare l'ordine dei passaggi mono e dual invece di misurare sempre prima tutti i mono. Sarebbe una nuova variante del protocollo, destinata a esaminare un eventuale effetto dell'ordine di esecuzione; non fa parte dei comandi r3 presentati qui.
Testare più client è un altro esperimento
Un carico concorrente consiste nell'inviare più richieste che possono sovrapporsi nel tempo. Coinvolge la coda, i limiti del server e la memoria disponibile. Non è la stessa domanda della durata di una sequenza di richieste inviate una alla volta.
Misurate questo carico separatamente, con una coda e limiti di memoria osservabili. Non traducete i token/s sequenziali della tabella in un numero di utenti simultanei: questi utenti non sono stati simulati in questo percorso.
Perché le nuove misure restino interpretabili, mantenete insieme il modello, la versione di llama.cpp, i parametri server, le richieste e gli output. Cambiare uno di questi elementi senza annotarlo equivale a confrontare due configurazioni API di cui si sarebbe perso il dettaglio.
Limiti di produzione
Questo protocollo non misura né il throughput sotto concorrenza, né la coda, né la robustezza di fronte ai prompt degli utenti, né il costo energetico, né la qualità delle risposte. Non fornisce nemmeno, da solo, una politica di distribuzione o una garanzia di capacità.
Le risorse dell'host e il disco possono essere influenzati da altri processi. I livelli Docker pubblici possono essere riutilizzati. Escludere un warm-up o disattivare il riutilizzo del prompt tra richieste non significa quindi che l'intero ambiente sia «a freddo».
Prima di scegliere un'infrastruttura, riprendete i vostri prompt rappresentativi e definite i criteri: tempo di risposta, latenze elevate, throughput con la concorrenza prevista, errori accettabili e budget VRAM. Aggiungete ripetizioni, un'osservazione delle risorse e una valutazione della qualità se il testo deve svolgere una funzione aziendale.
Due schede aggiungono possibilità hardware; solo un protocollo adeguato permette di sapere cosa queste possibilità apportano alla vostra applicazione. Le misure del tutorial sono un esempio di questo approccio, non una conclusione valida per tutti i modelli o tutte le postazioni.
Riferimenti per approfondire le nozioni
La documentazione ufficiale del server llama.cpp descrive i parametri di contesto, ripartizione, generazione e i campi delle risposte. Lo ZIP conserva i parametri realmente usati per questo confronto.
Le spiegazioni su GGUF e la quantizzazione, così come la guida Hugging Face sul costo dell'inferenza, aiutano a distinguere memorizzazione dei pesi, elaborazione del prompt e generazione. Sono complementi concettuali; il tutorial non usa Transformers al posto di llama.cpp.
Per il codice di esecuzione, consultate anche il riferimento di time.perf_counter(), la guida ai profili Docker Compose, il riferimento di docker compose run e la guida NVIDIA Container Toolkit.
Queste pagine spiegano concetti e strumenti; non sostituiscono né i file del progetto né gli output delle riproduzioni. Il loro contenuto può evolvere: per ritrovare il percorso presentato, conservate versioni e impostazioni dello ZIP invece di sostituire silenziosamente il motore con la sua versione corrente.