





Su aplicación envía texto a un modelo local y después espera su respuesta. El proceso funciona, pero la espera parece algo larga. Surge una idea natural: añadir una segunda tarjeta gráfica para ir el doble de rápido.
¿Es realmente lo que ocurrirá? No necesariamente. Dos tarjetas pueden repartirse un trabajo, pero también deben intercambiar datos. Y no todas las etapas de una generación de texto se benefician de ese reparto del mismo modo.
Vamos a comprobarlo con un pequeño banco de medición en Python y Docker. El principio se parece a una prueba de rendimiento de API: enviar una carga conocida, cronometrar las respuestas, conservar los resultados y comparar dos configuraciones. La novedad consiste en comprender qué hace el modelo durante esa espera.
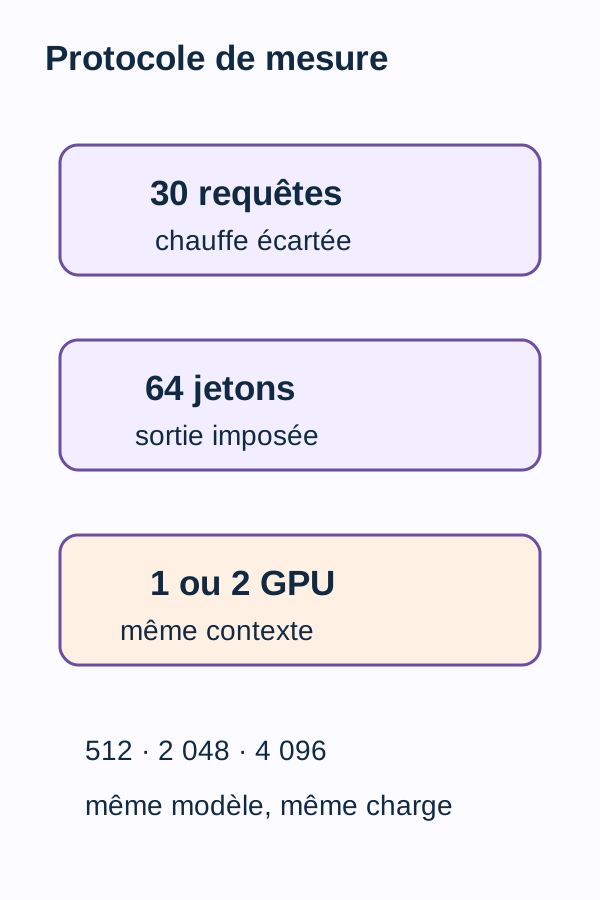
Descargar el proyecto completo del tutorial. El proyecto compara el mismo Qwen 7B Q8_0, ejecutado por llama.cpp, en seis modos: uno o dos GPU, con capacidades de contexto de 512, 2 048 y 4 096 tokens.
El escenario de aplicación web sirve como punto de partida: el archivo proporciona una herramienta de medición, no una funcionalidad de negocio lista para desplegar. No va a entrenar un modelo, sino a utilizar uno ya entrenado y observar su ejecución. Saber leer funciones de Python, JSON y comandos Docker basta para abordar el recorrido; los conceptos propios de los modelos de lenguaje se introducen a continuación.
Los resultados presentados son los de las reproducciones r3 del proyecto. Los pequeños ejemplos de cálculo se señalan como pedagógicos, y los cálculos complementarios sobre las mediciones se identifican como tales: no constituyen nuevos experimentos con GPU.
Los conceptos necesarios antes de los comandos
El modelo, el motor y la GPU no son lo mismo
El modelo de lenguaje, o LLM, es aquí Qwen 7B. Sus parámetros, también llamados pesos, son los valores numéricos procedentes de su entrenamiento. El nombre «7B» indica un tamaño del orden de siete mil millones de parámetros, no siete mil millones de palabras almacenadas en una base de datos.
llama.cpp es el motor que carga este modelo y ejecuta los cálculos necesarios para producir texto. En este tutorial expone un servidor HTTP: nuestro programa Python lo llama como llamaría a otro servicio. Usar el modelo para producir una salida se denomina inferencia.
La variante Q8_0 designa un método de cuantización: una representación más compacta de los pesos, que usa aquí valores cuantizados en 8 bits y factores de escala. Ese nombre no significa que toda la memoria o todos los cálculos del programa sean de 8 bits. La presentación del formato GGUF y sus cuantizaciones completa este punto.
Mantenemos idéntica esta variante en los seis modos. Comparar un modelo Q4 en una tarjeta con un modelo Q8 en dos tarjetas mezclaría dos cambios: la representación del modelo y su reparto de hardware. No es el experimento que buscamos realizar.
Un token no es necesariamente una palabra
Un token es una unidad que el modelo utiliza para representar texto. Según su segmentación, puede corresponder a una palabra, a una parte de palabra o a un signo. Por tanto, no se puede sustituir sistemáticamente «64 tokens» por «64 palabras».
El texto enviado al modelo es el prompt. Incluye aquí una parte de relleno, llamada padding, y después el texto de una consulta. Ese relleno es realmente texto que se debe procesar: no es una serie de casillas vacías que el modelo ignoraría.
Contaremos por separado los tokens de entrada y los de salida. Es tan importante como distinguir el tamaño de una solicitud HTTP del de su respuesta.
Capacidad de contexto: el espacio disponible, no el espacio ocupado
La capacidad de contexto es el límite configurado para la secuencia que el servidor puede gestionar. En este recorrido debe caber en ella el prompt y la generación solicitada. Los seis modos usan tres capacidades: 512, 2 048 y 4 096.
Una analogía web ayuda a no equivocarse: permitir un archivo de 10 MB en un formulario no significa que todos los archivos enviados pesen 10 MB. Del mismo modo, configurar 4 096 tokens no significa enviar un prompt de 4 096 tokens.
El protocolo construye un padding fijo para cada capacidad. Para una capacidad dada, aplica el mismo padding a las mismas 30 consultas en mono y en dual. Por tanto, los prompts son comparables entre esos dos modos; esto no significa que las 30 preguntas tengan exactamente la misma longitud.
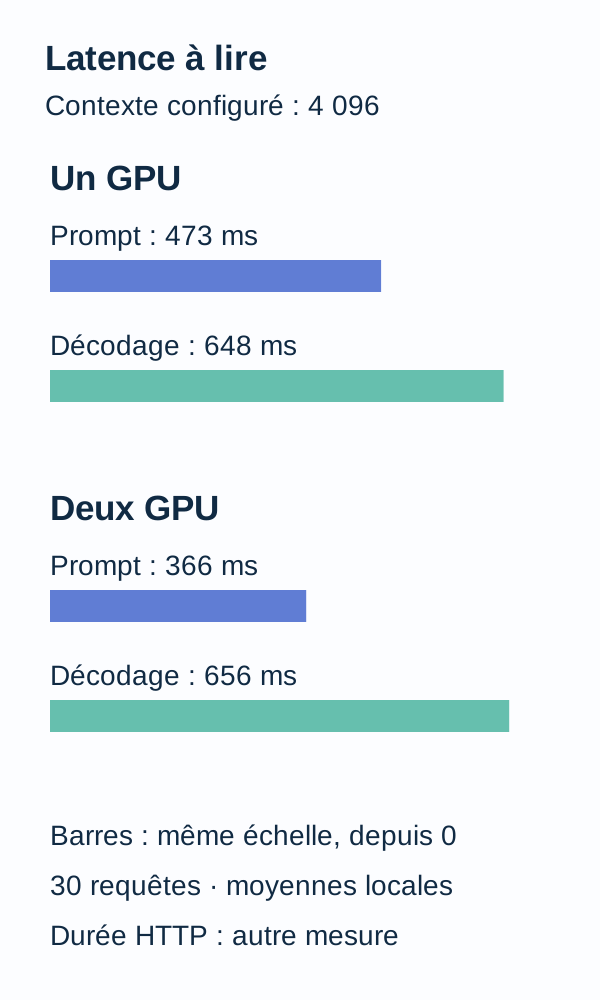
El campo que hay que leer es tokens_evaluated, que conserva el número de tokens del prompt comunicado por el servidor. Veremos así que con el ajuste 4 096, los prompts medidos cuentan 2 080 tokens de media, y no 4 096.
Durante la espera, dos etapas diferentes
El prellenado, o prefill, corresponde al procesamiento del prompt ya disponible. El modelo debe calcular las representaciones que necesita para empezar a responder.
La decodificación corresponde después a la producción de nuevos tokens. En una generación autorregresiva, cada nuevo token se elige a partir de lo anterior. Por tanto, producir la continuación no consiste simplemente en lanzar 64 cálculos independientes en paralelo. La documentación de Hugging Face sobre la inferencia de LLM explica este mecanismo y los estados intermedios conservados durante la generación.
Para nuestro cliente Python, estas etapas forman parte de una misma espera HTTP. El servidor proporciona tiempos internos, pero el cliente cronometra su llamada completa. Como con un perfilador web, el tiempo de una consulta SQL y el tiempo total de una ruta no son dos nombres para la misma medida.
Por tanto, conservaremos la duración HTTP, el tiempo de prellenado y el tiempo de decodificación. El cronómetro no mide el tiempo de renderizado de una página en un navegador: observa el cliente de medición suministrado por el proyecto.
¿Por qué pedir exactamente 64 tokens?
Imaginemos, solo para comprender el problema, que un primer ensayo genera 12 tokens y el segundo 64. Aunque el primero termine antes, no hemos hecho que realicen la misma cantidad de generación.
Por ello el proyecto solicita n_predict=64 y activa ignore_eos. EOS es el marcador de fin de generación; ignorarlo evita que una parada natural acorte la respuesta. El programa comprueba después que el servidor haya producido realmente 64 tokens.
Construimos así una carga comparable, no una evaluación de la calidad de las respuestas. Una salida forzada a 64 tokens puede ser demasiado larga para una pregunta breve o detenerse antes del final de una frase. Este comportamiento es intencionado para la medición.
¿Una GPU o dos GPU: cómo se reparte el trabajo?
La VRAM es la memoria de la tarjeta gráfica. Es distinta de la RAM de la máquina. En modo mono, el modelo se carga en una tarjeta. En modo dual, el recorrido describe un reparto de sus capas entre dos tarjetas, con tensor-split 1,1.
Una capa es una etapa de cálculo de la red. Para imaginar la idea, piense en una cadena de procesamiento cuyas primeras etapas están en una máquina y las siguientes en otra: los resultados intermedios deben pasar de una a otra. La segunda máquina no hace que todas las etapas sean automáticamente simultáneas.
En llama.cpp, --split-mode elige cómo repartir el modelo; --tensor-split proporciona las proporciones. 1,1 expresa partes iguales, no una promesa de tiempo dividido entre dos ni de ocupación de memoria perfectamente idéntica. El modo mono del proyecto usa --split-mode none. La documentación del servidor distingue estos parámetros; conserve los del ZIP para reproducir el recorrido.
Las dos VRAM no se convierten en una memoria unificada de 48 GiB. La presencia de NVLink, una interconexión de hardware entre tarjetas, no se presupone en este experimento. Tampoco hay que confundir este reparto de un modelo con dos servidores independientes que recibirían cada uno sus propias solicitudes.
Por último, la carga es secuencial: nuestro cliente espera una respuesta antes de enviar la siguiente solicitud. Por tanto, aún no buscamos saber cuántos usuarios simultáneos podría atender el servidor.
El código que hace controlada la comparación
Seis modos, pero tres comparaciones útiles
La matriz del experimento es sencilla:
| Capacidad de contexto | Referencia en una GPU | Comparación en dos GPU |
|---|---|---|
| 512 | mono-512 |
dual-512 |
| 2 048 | mono-2048 |
dual-2048 |
| 4 096 | mono-4096 |
dual-4096 |
Cada comparación se realiza en una fila de esta tabla, por tanto a igual capacidad. Oponer mono-512 a dual-4096 no permitiría aislar el cambio de reparto: también cambiarían el ajuste de contexto y la carga construida para ese ajuste.
En cli.py, cada comando measure-<mode> fabrica los prompts a partir del padding previsto y de las 30 consultas. La función one() llama a /completion con parámetros fijos: 64 tokens solicitados, temperatura 0, semilla 42, ignore_eos=true y cache_prompt=false.
La temperatura y la semilla forman parte de los ajustes conservados para limitar las variaciones vinculadas a la generación. No transforman una duración medida en una constante universal: el estado de la máquina y el motor de ejecución siguen contando.
El calentamiento y la caché responden a dos preguntas diferentes
Antes de las mediciones retenidas, el programa envía una solicitud de calentamiento, o warm-up. Hace pasar al servidor por la ruta de generación, pero su duración no aparece en la media. Por tanto, la carga inicial y esta primera solicitud no se mezclan con las 30 peticiones siguientes.
Eso no significa que desaparezcan todos los efectos de arranque o de variabilidad. El calentamiento es una regla del protocolo, no una garantía de un estado de hardware perfecto.
El ajuste cache_prompt=false se refiere, por su parte, a la reutilización de un prefijo procesado en una solicitud anterior. No queremos que un modo se beneficie de un prompt común ya calculado mientras el otro lo vuelve a leer. Este ajuste no significa «desactivar todas las cachés de la máquina». La caché de las capas Docker, por ejemplo, es un asunto distinto.
Tampoco debe confundirse con los estados intermedios conservados durante una misma generación, a menudo llamados caché KV. Esos estados evitan recalcular determinados elementos del texto anterior en cada token nuevo. La distinción entre reutilización entre solicitudes y cálculo de una respuesta se detalla en las documentaciones de llama.cpp y Hugging Face.
Conservar las observaciones antes de calcular una media
Para cada solicitud, el código conserva el prompt, el texto bruto producido, la duración HTTP, los tiempos del servidor, tokens_predicted, tokens_evaluated y el indicador de truncamiento.
¿Por qué conservar tantos detalles? Porque una media sola no permite ver que una respuesta fue demasiado corta o que un contexto se desbordó. Las filas individuales desempeñan el mismo papel que las trazas de solicitudes en una aplicación web: permiten volver a lo que se ejecutó realmente.
summarize() comprueba determinadas condiciones antes de agregar los resultados. Después, compare() calcula la relación tiempo_mono / tiempo_dual, a igual capacidad. Una relación superior a 1 significa que dual fue más rápido; una relación inferior a 1 significa que fue más lento. Dedicaremos tiempo a calcular ejemplos después de la ejecución.
Las funciones centrales que hay que leer antes de ejecutar
Esperar al servidor y después iniciar el cronómetro
En client.py, ready() consulta /health durante un máximo de 180 segundos para esperar a un servidor preparado. request() establece un tiempo de espera HTTP de 120 segundos. Esperar a que un proceso esté listo y acotar una llamada HTTP son dos responsabilidades distintas.
Para un desarrollador web, encontramos la distinción entre «el contenedor se ha iniciado» y «el servicio responde realmente». Un servidor que todavía carga su modelo no debe tomarse por una solicitud de inferencia anormalmente lenta.
one(): una solicitud, una observación completa
Aquí está el núcleo de la medición. padding, data, mode, capacity, request() y save() los proporciona el resto del proyecto: este extracto debe leerse en su contexto, no es un script autónomo para copiar en un directorio vacío.
def one(query):
    prompt = padding + query["query"]
    start = time.perf_counter()
    result = request(
        "/completion",
        {
            "prompt": prompt,
            "n_predict": 64,
            "temperature": 0,
            "seed": 42,
            "ignore_eos": True,
            "cache_prompt": False,
        },
    )
    return {
        **query,
        "prompt": prompt,
        "raw": result["content"],
        "seconds": time.perf_counter() - start,
        "timings": result["timings"],
        "tokens_predicted": result["tokens_predicted"],
        "tokens_evaluated": result["tokens_evaluated"],
        "truncated": result.get("truncated", False),
    }


one(data["queries"][0])
rows = [one(q) for q in data["queries"]]
summarize(rows)
save(mode, {"mode": mode, "context_capacity": capacity, "rows": rows})
Empecemos por prompt = padding + query["query"]. El programa fabrica primero el texto de la petición y después inicia el cronómetro con time.perf_counter(). Por tanto, la construcción de esta cadena precede a la medición HTTP.
perf_counter() proporciona un contador adecuado para medir una duración. Lo que importa es la diferencia entre dos llamadas, no el valor absoluto del contador. La espera de la respuesta forma parte del tiempo transcurrido: no medimos solo el tiempo durante el cual trabaja el procesador Python. Este es el comportamiento descrito en la documentación oficial de Python.
request() espera la respuesta del servidor. El valor seconds se calcula tras su retorno, mientras que timings conserva las medidas producidas en el servidor. La escritura del archivo mediante save() llega más tarde; su tiempo no se añade a cada duración HTTP.
La notación **query copia los campos de la solicitud en el diccionario de resultados. El código añade después lo observado. Esto permite relacionar una duración con su entrada, en vez de conservar una lista anónima de números.
Observe también result.get("truncated", False): si falta el campo, este extracto registra False. Esta elección depende del contrato con la versión de servidor utilizada; no es un mecanismo independiente capaz de detectar todo truncamiento. Para estudiar los resultados r3, conserve juntos el servidor y los archivos suministrados.
La primera solicitud se ejecuta dos veces, pero solo se mide una vez en la lista
La línea one(data["queries"][0]) llama a la primera pregunta para el calentamiento y no conserva su resultado en rows.
La comprensión de lista [one(q) for q in data["queries"]] recorre después las 30 consultas, incluida la primera. Espera cada resultado antes de continuar: aquí no se introduce ninguna concurrencia.
El recuento de este bucle da por tanto 31 llamadas a /completion por modo: 1 calentamiento y 30 filas retenidas. Para los seis modos, esto representa 180 filas de medición y 6 calentamientos adicionales, sin contar otras posibles llamadas del recorrido. El calentamiento se ejecuta, pero no debe convertirse en una trigésima primera fila de la media.
summarize(): comprobar antes de calcular
El segundo extracto es la función de agregación:
def summarize(rows):
    if not rows:
        raise ValueError("Mesures vides")
    if any(
        r["tokens_predicted"] != 64
        or r["truncated"]
        or r["seconds"] <= 0
        for r in rows
    ):
        raise ValueError("Longueur, contexte ou temps invalide")
    return {
        "queries": len(rows),
        "mean_ms": 1000 * sum(r["seconds"] for r in rows) / len(rows),
        "tokens_per_second": 64 * len(rows) / sum(r["seconds"] for r in rows),
        "mean_prompt_tokens": sum(r["tokens_evaluated"] for r in rows) / len(rows),
        "mean_prompt_ms": sum(r["timings"]["prompt_ms"] for r in rows) / len(rows),
        "mean_decode_ms": sum(r["timings"]["predicted_ms"] for r in rows) / len(rows),
    }
La primera guarda rechaza una lista vacía. La segunda recorre las filas con any(...): en cuanto una fila genera algo distinto de 64 tokens, señala un truncamiento o tiene una duración menor o igual que cero, el cálculo se detiene con un error.
Estos rechazos tienen una utilidad muy concreta. Una respuesta detenida tras 8 tokens no debe mejorar artificialmente el rendimiento de una configuración. Un prompt que desborda el contexto no debe compararse como si se hubiera tratado en las mismas condiciones.
El diccionario devuelto reúne después el número de filas, el tiempo HTTP medio, el rendimiento calculado sobre el tiempo total, la longitud media del prompt y las dos medias de tiempo del servidor. Detallamos estas fórmulas en la sección dedicada a las métricas.
Atención al alcance exacto del extracto: summarize() devuelve len(rows), pero no contiene ninguna prueba que imponga len(rows) == 30. Tampoco compara por sí sola los prompts de los archivos mono y dual. Las 30 consultas y su construcción idéntica proceden del recorrido; hay que encontrarlas en las salidas. Del mismo modo, esta función no es un validador exhaustivo de todos los valores numéricos imaginables.
Por último, compare() realiza las tres relaciones a partir de los archivos producidos. Las diferencias de configuración siguen siendo las del Compose suministrado: --split-mode none para mono y el reparto tensor-split 1,1 descrito para dual.
Ejecutar las seis mediciones en orden
El equipo utilizado y los recursos que hay que prever
El recorrido probado requiere Linux x86_64, Docker con Compose, un controlador NVIDIA operativo, NVIDIA Container Toolkit y dos RTX 3090.
Los recursos anunciados son 12 GiB de RAM, 25 GiB de disco y 14 GiB de VRAM libre en cada una de las dos tarjetas. Son recursos previstos para este recorrido, no mínimos demostrados mediante una búsqueda de umbral. Disponer de la cantidad total de memoria en una sola tarjeta no sustituye la condición «en cada una de las tarjetas».
No se valida ningún modo de inferencia por CPU. Eso no significa que el procesador de la máquina no sirva para nada: Python, Docker y los intercambios HTTP siguen dependiendo de él.
NVIDIA Container Toolkit permite a Docker exponer las GPU al contenedor. No sustituye al controlador instalado en el host. Si la GPU funciona en Linux pero no es accesible desde Docker, consulte la guía oficial de NVIDIA antes de continuar.
Extraiga el ZIP en una carpeta dedicada y abra después un terminal en la raíz del proyecto. Todos los comandos siguientes parten de esa carpeta. Evite ejecutar al mismo tiempo otro trabajo en las tarjetas medidas: introduciría una carga ausente del protocolo que busca reproducir.
1. Validar el host y construir el entorno
El preflight es el control previo. Debe mostrar que Docker accede a las dos tarjetas. El script de configuración prepara los permisos del proyecto; el build construye la imagen que ejecutará las mediciones.
./scripts/preflight.sh
sh scripts/setup.sh
docker compose build
Qué observar: el preflight y la construcción deben terminar sin error. Compruebe que GPU_DEVICE y GPU_DEVICE_2 designan realmente dos dispositivos distintos. Dos variables con nombres diferentes que designan la misma tarjeta no crean un modo dual.
2. Obtener el modelo, probar el contrato y preparar la carga
La adquisición recupera y valida el modelo previsto por el proyecto. Las pruebas verifican las métricas y los rechazos esperados. Después, prepare escribe la descripción de la carga: las 30 consultas por modo, los seis modos y los 64 tokens de salida.
docker compose --profile acquisition run --rm --no-deps fetch
docker compose run --rm --no-deps app -m unittest discover -s tests -v
docker compose run --rm --no-deps app -m src.cli prepare
Qué observar: la suite pública debe completarse correctamente. Abra después outputs/prepared.json: debe contener queries_per_mode: 30, los seis modos y output_tokens: 64.
Este control se parece a comprobar fixtures antes de una prueba de API: debe conocer las entradas previstas antes de interpretar la salida. El número exacto de pruebas públicas no se indica en este artículo; use el informe de la suite suministrada, sin sustituirlo por una cifra supuesta.
En los comandos, app ejecuta el programa Python. run --rm crea un contenedor para el comando y lo elimina al terminar; --no-deps impide el inicio automático de servicios relacionados. Por eso los servidores se inician explícitamente en el paso siguiente. La referencia de docker compose run precisa estas opciones.
3. Medir una GPU en los tres contextos
Un perfil Compose permite seleccionar servicios correspondientes a un escenario. Aquí, cada perfil lleva el nombre de su configuración de medición.
Repetiremos tres veces la misma secuencia: iniciar el servidor, medir, detener el perfil. No deje activo el servidor anterior: podría seguir reservando el puerto o la VRAM.
docker compose --profile mono-512 up -d server-mono-512
docker compose run --rm --no-deps app -m src.cli measure-mono-512
docker compose --profile mono-512 down

docker compose --profile mono-2048 up -d server-mono-2048
docker compose run --rm --no-deps app -m src.cli measure-mono-2048
docker compose --profile mono-2048 down

docker compose --profile mono-4096 up -d server-mono-4096
docker compose run --rm --no-deps app -m src.cli measure-mono-4096
docker compose --profile mono-4096 down
Qué observar: deben estar presentes tres archivos outputs/mono-*.json. Cada uno debe contener 30 filas, con tokens_predicted igual a 64 y sin truncamiento.
Estos archivos son las referencias en una GPU. Consérvelos: el objetivo no es recordar solo la duración menor, sino comparar cada modo mono con su equivalente dual.
4. Medir dos GPU con igual contexto
Mantenga las mismas consultas, el mismo padding para cada capacidad, la misma temperatura y la misma longitud de salida. La variable estudiada en cada par es el reparto del modelo.
docker compose --profile dual-512 up -d server-dual-512
docker compose run --rm --no-deps app -m src.cli measure-dual-512
docker compose --profile dual-512 down

docker compose --profile dual-2048 up -d server-dual-2048
docker compose run --rm --no-deps app -m src.cli measure-dual-2048
docker compose --profile dual-2048 down

docker compose --profile dual-4096 up -d server-dual-4096
docker compose run --rm --no-deps app -m src.cli measure-dual-4096
docker compose --profile dual-4096 down
Qué observar: tres archivos outputs/dual-*.json, con las mismas expectativas: 30 consultas, 64 tokens producidos por consulta y ningún contexto truncado.
Compare también los prompts y sus tokens_evaluated entre los archivos correspondientes. En este momento, una incoherencia de carga importa más que una cifra bonita de latencia: primero hay que comprender qué se comparó realmente.
5. Agregar los seis resultados
Este comando vuelve a leer los archivos de medición y calcula los agregados y las relaciones. No añade una nueva serie de consultas a la tabla.
docker compose run --rm --no-deps app -m src.cli evaluate
Qué observar: outputs/evaluation.json debe contener los seis agregados. Conserve asimismo los archivos por modo: siguen siendo necesarios para explicar una media inesperada.
Deje el comando exercise para más adelante. Primero aprenderemos a leer los resultados y después formularemos una predicción antes de ejecutarlo.
Leer las métricas antes que las cifras
¿Qué número responde a qué pregunta?
| Campo | Lo que mide en este proyecto |
|---|---|
queries |
El número de filas utilizadas para el agregado: se esperan 30 por modo. |
mean_ms |
La duración media de la llamada HTTP, en milisegundos. |
tokens_per_second |
Los tokens generados divididos por la suma de las duraciones HTTP. |
mean_prompt_tokens |
La media de tokens_evaluated, es decir, la longitud del prompt comunicada por el servidor. |
mean_prompt_ms |
El tiempo medio de prellenado comunicado por el servidor. |
mean_decode_ms |
El tiempo medio de decodificación comunicado por el servidor. |
La idea es acercar una duración a su perímetro. mean_ms responde a «¿cuánto espera nuestro cliente?». mean_decode_ms responde a una pregunta más acotada, sobre la fase de generación comunicada por el motor.
Recalcular una media y un rendimiento a mano
Tomemos dos consultas ficticias, solo para comprender summarize(). Ambas generaron 64 tokens sin truncamiento:
| Consulta pedagógica | Duración HTTP | Tokens generados |
|---|---|---|
| A | 0,5 segundo | 64 |
| B | 1,5 segundos | 64 |
La duración media vale (0,5 + 1,5) / 2 = 1 segundo, es decir, 1 000 ms.
El rendimiento calculado por el proyecto vale:
tokens_per_second = 64 × número de consultas / suma de las duraciones HTTP
Aquí da (64 × 2) / (0,5 + 1,5) = 64 tokens/s.
No es la media aritmética de los rendimientos individuales. La consulta A da 64 / 0,5 = 128 tokens/s; B da 64 / 1,5 ≈ 42,67 tokens/s. La media de esos dos valores sería aproximadamente 85,33 tokens/s, un cálculo distinto al del código. El proyecto relaciona correctamente el volumen total producido con el tiempo total medido.
Puesto que cada respuesta contiene exactamente 64 tokens, también se obtiene directamente:
tokens_per_second = 64 000 / mean_ms
Por tanto, el tiempo medio y este rendimiento no son dos pruebas independientes de una aceleración: describen las mismas duraciones, presentadas en dos unidades diferentes.
Los «tokens/s» no miden solo la decodificación
El numerador de tokens_per_second cuenta los tokens generados, pero su denominador incluye todo el tiempo HTTP medido, prellenado incluido.
Tomemos otro ejemplo pedagógico: una consulta tarda 300 ms en procesar su prompt, 680 ms en decodificar su respuesta y 1 000 ms en total del lado del cliente. Para 64 tokens generados, el rendimiento de extremo a extremo es de 64 tokens/s. Al dividir solo por los 680 ms de decodificación, se obtendrían aproximadamente 94,12 tokens/s. Ambos cálculos tienen sentido, pero no abarcan el mismo intervalo.
Los 20 ms restantes de este ejemplo no constituyen una medida aislada de la red: son simplemente la diferencia entre perímetros de cronometraje. Del mismo modo, los tiempos internos del servidor no deben considerarse una descomposición universal y exhaustiva del tiempo HTTP.
Un prellenado más rápido puede mejorar los tokens/s de este tutorial sin acelerar la decodificación. Encontraremos precisamente esta situación en los resultados.
Leer una relación sin invertir la conclusión
La relación del proyecto es:
ratio = tiempo_mono / tiempo_dual
Con duraciones ficticias de 1 200 ms en mono y 1 000 ms en dual, la relación vale 1,2. Dual tarda menos. Pero la reducción de duración respecto a mono es (1 200 - 1 000) / 1 200 ≈ 16,67 %, y no el 20 %.
Con 800 ms en mono y 1 000 ms en dual, la relación vale 0,8. Esta vez dual tarda más: (1 000 - 800) / 800 = 25 % de duración adicional.
Puede retenerse la siguiente fórmula para expresar la disminución de duración respecto a mono:
disminución relativa = 1 - tiempo_dual / tiempo_mono = 1 - 1 / ratio
Un resultado positivo corresponde a una reducción de duración; uno negativo, a un aumento. La elección del denominador explica por qué «20 % más de rendimiento» y «20 % menos de tiempo» no son sinónimos.
Por tanto, la pregunta correcta sigue siendo: para este modelo, estos prompts, esta capacidad y esta carga secuencial, qué duración cambia y en qué medida? La cantidad de VRAM no responde por sí sola a esta pregunta.
Resultados locales observados
Los valores de la primera reproducción
Las siguientes mediciones proceden de la primera reproducción validada. La columna «Contexto» designa la capacidad configurada, no el número exacto de tokens de cada prompt.
En pantalla pequeña, desplace la tabla horizontalmente.
| Contexto | Mono: ms medios | Dual: ms medios | Relación mono/dual | Lectura |
|---|---|---|---|---|
| 512 | 711,80 | 709,49 | 1,003 | casi idéntico, dual ligeramente más rápido |
| 2 048 | 886,90 | 843,31 | 1,052 | dual más rápido con esta carga |
| 4 096 | 1 124,56 | 1 025,49 | 1,097 | dual más rápido con esta carga |
Los rendimientos correspondientes son 89,91, 72,16 y 56,91 tokens/s en mono, frente a 90,21, 75,89 y 62,41 tokens/s en dual. Usan la fórmula de extremo a extremo explicada antes, con 64 tokens de salida por consulta.
En 512, la diferencia entre 711,80 ms y 709,49 ms es de 2,31 ms, es decir, aproximadamente el 0,32 % de la duración mono. Estos dos últimos valores se calculan a partir de las medias mostradas. Esta tabla permite describir dual como ligeramente más rápido, pero no concluir una ventaja estable a partir de una diferencia tan pequeña y de estas medias por sí solas.
En 2 048 y 4 096, la duración media dual también es menor. La tabla describe lo observado con esta carga; no demuestra una relación general según la cual aumentar el contexto siempre haga más ventajosas dos GPU.
En 4 096: ¿dónde se ganó tiempo?
Los prompts realmente evaluados cuentan entonces 2 080 tokens de media. El prellenado medio pasa de 473,17 ms en mono a 365,70 ms en dual; la decodificación pasa de 648,18 ms a 656,43 ms.
Retomemos estas cifras en una tabla de lectura. La última columna es una resta calculada a partir de los valores publicados, no una nueva medición:
| Medida con capacidad 4 096 | Mono | Dual | Diferencia dual − mono |
|---|---|---|---|
| Prellenado medio | 473,17 ms | 365,70 ms | −107,47 ms |
| Decodificación media | 648,18 ms | 656,43 ms | +8,25 ms |
| Duración HTTP media | 1 124,56 ms | 1 025,49 ms | −99,07 ms |
El signo negativo indica una duración más corta en dual. El signo positivo indica una duración más larga.
La ganancia se encuentra aquí en el prellenado. La decodificación no mejora: se ralentiza ligeramente. Esto precisa la lectura de los valores originales. Sin embargo, la respuesta completa llega antes porque la reducción del prellenado compensa este pequeño aumento de la decodificación y el tiempo HTTP total disminuye.
Los 99,07 ms representan aproximadamente un 8,81 % menos de duración HTTP respecto a mono, calculado a partir de las medias mostradas. Por tanto, la relación redondeada 1,097 no significa «9,7 % menos de tiempo».
Y el rendimiento global pasa efectivamente de 56,91 a 62,41 tokens/s. No contradice una decodificación ligeramente más lenta: su cálculo incluye el prellenado. Por eso era importante definir las métricas antes de comentar las cifras.
Lo que estos valores no explican por sí solos
La descomposición localiza el cambio en los tiempos comunicados por el servidor. No permite atribuir con precisión esta ganancia a una transferencia, una interconexión u operación interna concreta: la tabla no contiene un perfilado detallado de esos mecanismos.
Dos ejecuciones completas superaron la validación en el mismo equipo. La tabla anterior no es ni una media de las dos reproducciones ni el resultado de una comparación en varias máquinas. No se reivindica ninguna revisión humana independiente ni medición de un parque heterogéneo.
Otro modelo, otra interconexión, otro contexto, una carga concurrente u otra versión de llama.cpp pueden cambiar el equilibrio. El resultado es útil porque describe un experimento identificable, no porque proporcione una regla de compra universal.
Lo que hemos aprendido
Ahora podemos volver a nuestra aplicación web. Añadir una tarjeta no equivale a dividir entre dos una espera HTTP: importan la forma de repartir el cálculo y el peso de cada etapa.
El protocolo hace observable esta cuestión con 30 consultas idénticas entre los dos modos de un par, un calentamiento descartado, 64 tokens de salida impuestos y el número real de tokens del prompt conservado. La capacidad del servidor y el tamaño de la solicitud siguen siendo dos datos distintos.
En 512, las duraciones observadas son casi idénticas. En 2 048 y 4 096, dual es más rápido en esta máquina. En 4 096, la lectura detallada muestra un prellenado más corto y una decodificación ligeramente más larga: mirar solo los tokens/s habría ocultado esta diferencia.
La conclusión que hay que conservar no es «dos GPU son mejores» ni «dos GPU no sirven para nada». Es esta: para comparar dos configuraciones, defina una carga idéntica, compruebe qué se ejecutó y después observe qué parte del tiempo cambia.
Ejercicio activo: predecir, modificar, ejecutar, observar, explicar
Predecir antes de mirar la respuesta
Antes de iniciar el ejercicio, anote su respuesta a estas tres preguntas: ¿dos GPU son necesariamente más rápidas? ¿Qué significa una relación mono/dual de 0,8? ¿Y una relación de 1,2?
No se limite a «mejor» o «peor». Invente para cada relación dos duraciones coherentes e indique después qué configuración hace esperar más al cliente.
docker compose run --rm --no-deps app -m src.cli exercise
Observar y explicar
El programa recuerda que una relación inferior a 1 significa que dual es más lento para esta carga. Relacione su explicación con sus dos duraciones.
La hipótesis «una tarjeta adicional reduce mecánicamente toda la latencia» es demasiado fuerte. En 512 tenemos 711,80 ms frente a 709,49 ms: una diferencia mínima en esta medición. En 4 096 el tiempo total disminuye, pero la decodificación aumenta ligeramente. El comportamiento del sistema es más preciso que el simple número de tarjetas.
Para comprobar que lo entiende, pregúntese también por qué 62,41 tokens/s en dual no demuestra que la fase de decodificación se haya vuelto más rápida. La respuesta está en el denominador del rendimiento: es la duración HTTP completa.
Modificar una sola variable en un experimento separado
Conserve sus salidas de referencia y trabaje después en una copia del proyecto. Modifique una sola capacidad de contexto, de forma coherente para el par mono/dual que quiera comparar. Retome los comandos de inicio, medición y detención de ese par.
Debe conservarse el mismo prompt construido para ambos modos y comprobar que aún se producen 64 tokens sin truncamiento. Si una modificación cambia también la construcción del padding, regístrela: ya no se prueba solo un límite configurado, sino otra longitud de entrada. No fuerce artificialmente tokens_evaluated al valor de capacidad para que los archivos parezcan coherentes.
El artículo no proporciona un parámetro de comando adicional para automatizar esta variante. Localice en el Compose y en cli.py del ZIP las definiciones correspondientes, y documente su modificación en lugar de inventar una opción. El comando exercise y esta modificación manual son dos etapas distintas.
Antes de volver a ejecutar, escriba su predicción sobre la longitud del prompt, el prellenado y la decodificación. Tras la ejecución, compare tokens_evaluated, mean_prompt_ms, mean_decode_ms y mean_ms. Explique qué cambia, pero también qué permanece estable.
Su nuevo resultado es una observación local adicional, no un valor r3 para sustituir en la tabla de referencia. Un resultado sin mejora es igualmente útil para aprender a leer el mecanismo.
Solución de problemas y limpieza
Las dos GPU no son distintas. Compruebe GPU_DEVICE y GPU_DEVICE_2, y repita el preflight. No inicie el perfil dual mientras las dos variables no designen las tarjetas previstas.
El servidor no llega a estar preparado. Consulte los registros del servicio correspondiente y compruebe los requisitos previos. El límite de espera de disponibilidad es de 180 segundos; el tiempo de espera HTTP de una solicitud está fijado en 120 segundos. Un fallo en esta etapa no es una medida de rendimiento que deba añadirse a la tabla.
Una respuesta está truncada o no contiene 64 tokens. No incluya esa fila en una comparación presentada como conforme al protocolo. Compruebe el contexto, el prompt y los parámetros del servidor y vuelva a realizar la medición en condiciones documentadas. No elimine simplemente una fila incómoda para mejorar la media.
El puerto o la VRAM siguen ocupados. Puede que un servidor anterior haya quedado activo. Use el comando down del perfil correspondiente, tal como figura más arriba, consulte sus registros y reinicie solo el perfil que se vaya a medir.
El recorrido ya detiene cada servidor con su perfil después de medir. No omita esas detenciones: la documentación de perfiles Compose precisa que la detención depende de los perfiles activados. Un docker compose down sin perfil no debe tomarse como garantía de limpieza de un servidor perfilado que siguiera activo tras una interrupción.
Después de las detenciones de perfiles previstas, termine el recorrido con el comando de limpieza del proyecto:
docker compose down
Los modelos adquiridos y los JSON de salida permanecen en la carpeta de extracción. Guarde las mediciones útiles antes de eliminar únicamente su extracción para recuperar espacio. No purgue volúmenes o imágenes de otros proyectos para terminar este tutorial.
Para ir más lejos
Una media no describe todas las esperas
Vuelva a ejecutar la misma matriz con sus prompts reales, en un experimento separado y con más repeticiones. Los percentiles p50, p95 y p99 permiten leer la distribución de duraciones: p50 es la mediana; p95 y p99 describen umbrales por debajo de los cuales se sitúan aproximadamente el 95 % y el 99 % de las observaciones, respectivamente.
El interés para una aplicación web es inmediato: una media aceptable puede ocultar algunas solicitudes muy lentas. Con solo 30 mediciones por modo, los percentiles altos dependen mucho de los pocos valores más extremos; mostrarlos no sustituye un protocolo de repetición adecuado.
Para prolongar el experimento, también puede alternar o variar el orden de los pases mono y dual en vez de medir siempre primero todos los mono. Sería una nueva variante del protocolo, destinada a examinar un posible efecto del orden de ejecución; no forma parte de los comandos r3 presentados aquí.
Probar varios clientes es otro experimento
Una carga concurrente consiste en enviar varias solicitudes que pueden solaparse en el tiempo. Intervienen la cola de espera, los límites del servidor y la memoria disponible. No es la misma pregunta que la duración de una serie de solicitudes enviadas una a una.
Mida esta carga por separado, con una cola de espera y límites de memoria observables. No traduzca los tokens/s secuenciales de la tabla en número de usuarios simultáneos: esos usuarios no se simularon en este recorrido.
Para que las nuevas mediciones sigan siendo interpretables, conserve juntos el modelo, la versión de llama.cpp, los parámetros del servidor, las consultas y las salidas. Cambiar uno de estos elementos sin anotarlo equivale a comparar dos configuraciones de API cuyo detalle se ha perdido.
Límites de producción
Este protocolo no mide ni el rendimiento bajo concurrencia, ni la cola de espera, ni la robustez ante prompts de usuarios, ni el coste energético, ni la calidad de las respuestas. Tampoco proporciona por sí solo una política de despliegue ni una garantía de capacidad.
Los recursos del host y el disco pueden verse influidos por otros procesos. Pueden reutilizarse capas públicas de Docker. Por tanto, descartar un calentamiento o desactivar la reutilización del prompt entre solicitudes no significa que todo el entorno esté «en frío».
Antes de elegir una infraestructura, retome sus prompts representativos y fije sus criterios: tiempo de respuesta, latencias altas, rendimiento bajo la concurrencia prevista, errores aceptables y presupuesto de VRAM. Añada repeticiones, observación de recursos y una evaluación de calidad si el texto debe cumplir una función de negocio.
Dos tarjetas añaden posibilidades de hardware; solo un protocolo adecuado permite saber qué aportan esas posibilidades a su aplicación. Las mediciones de este tutorial son un ejemplo de este enfoque, no una conclusión válida para todos los modelos o equipos.
Referencias para profundizar en los conceptos
La documentación oficial del servidor llama.cpp describe los parámetros de contexto, reparto, generación y los campos de las respuestas. El ZIP conserva los parámetros realmente utilizados para esta comparación.
Las explicaciones sobre GGUF y la cuantización, así como la guía de Hugging Face sobre el coste de la inferencia, ayudan a distinguir el almacenamiento de pesos, el procesamiento del prompt y la generación. Son complementos conceptuales; el tutorial no utiliza Transformers en lugar de llama.cpp.
Para el código de ejecución, consulte también la referencia de time.perf_counter(), la guía de perfiles Docker Compose, la referencia de docker compose run y la guía de NVIDIA Container Toolkit.
Estas páginas explican los conceptos y las herramientas; no sustituyen ni los archivos del proyecto ni las salidas de las reproducciones. Su contenido puede evolucionar: para recuperar el recorrido presentado, conserve las versiones y los ajustes del ZIP en lugar de sustituir silenciosamente el motor por su versión actual.