





Vous avez peut-être déjà optimisé un traitement web qui parcourait plusieurs fois le même tableau. L'idée semblait simple : regrouper les opérations pour éviter du travail intermédiaire. Mais avant de comparer les temps, il fallait vérifier que la nouvelle version donnait toujours le même résultat.
Nous allons suivre cette démarche à l'intérieur d'un réseau neuronal. Notre opération s'appelle RMSNorm : elle remet à l'échelle des listes de nombres. Nous partirons d'une version PyTorch lisible, puis regrouperons son calcul dans un kernel Triton, une fonction exécutée sur le GPU. Une difficulté supplémentaire nous attend : pendant l'entraînement, obtenir la bonne sortie ne suffit pas. Il faut aussi calculer les bons gradients.
Le parcours aboutit à une RMSNorm reliée à Autograd, utilisée dans un petit réseau effectivement entraîné puis rechargé. Son objectif est de vérifier le calcul dans un périmètre précis, pas de démontrer que « Triton est toujours plus rapide ». Nous regarderons séparément la correction numérique et la latence.
Problème et formule de référence
Que normalise-t-on, exactement ?
Un réseau transforme ses entrées en suites de nombres intermédiaires : ce sont ses activations. Elles changent d'un exemple à l'autre. Les poids, eux, sont les paramètres que l'entraînement ajuste pour modifier le comportement du réseau.
Normaliser les activations consiste ici à contrôler leur échelle. Nous ne corrigeons ni une chaîne de caractères ni le format d'un document : nous appliquons une transformation numérique à l'intérieur du modèle.
Dans ce projet, l'entrée x est un tableau à deux dimensions, appelé tenseur. Un tenseur peut avoir davantage de dimensions, mais nous restons ici sur une matrice de M lignes et N colonnes. Chaque ligne est normalisée indépendamment des autres.
| Objet | Forme dans ce tutoriel | Comment le lire |
|---|---|---|
x |
M × N |
M lignes d'activations, avec N nombres par ligne. |
gamma |
N |
Un poids par colonne, partagé entre toutes les lignes. |
r |
Un nombre par ligne | L'inverse de la mesure d'échelle calculée pour cette ligne. |
y |
M × N |
Les activations obtenues après normalisation et multiplication par gamma. |
RMS signifie root mean square, soit « racine de la moyenne des carrés ». Prendre les carrés évite que des valeurs positives et négatives s'annulent. La moyenne tient compte de la longueur de la ligne ; la racine nous ramène à une mesure d'échelle.
Pour une ligne, la formule de référence est :
r = 1 / sqrt(mean(x²) + epsilon)
y = x × r × gamma
Les multiplications se font coordonnée par coordonnée. r est commun à toute la ligne, mais chaque colonne possède son propre gamma. Le petit nombre epsilon, fixé à 1e-6 dans les fonctions présentées, est ajouté avant la racine carrée. Il évite notamment une division par zéro pour une ligne entièrement nulle.
Faisons le calcul avec deux valeurs
Prenons x = [3, 4], gamma = [1, 1] et epsilon = 1e-6. Cet exemple est une illustration arithmétique, pas une ligne extraite des mesures GPU.
| Étape | Calcul | Résultat approché |
|---|---|---|
| Carrés | [3², 4²] |
[9, 16] |
| Moyenne des carrés | (9 + 16) / 2 |
12,5 |
| Dénominateur stabilisé | sqrt(12,5 + 0,000001) |
3,535534 |
Inverse r |
1 / 3,535534 |
0,282843 |
| Sortie | [3 × r, 4 × r] |
[0,848528 ; 1,131371] |
Nous avons conservé le rapport entre les deux valeurs, tout en changeant leur échelle. La seconde sortie dépasse 1 : normaliser ne signifie pas borner chaque nombre entre 0 et 1.
Changeons seulement gamma en [2, 0.5]. La sortie devient environ [1,697056 ; 0,565685]. Ces poids permettent au réseau d'ajuster séparément l'importance des coordonnées après la remise à l'échelle. Ils ne sont donc pas un simple réglage cosmétique.
Contrairement à LayerNorm, RMSNorm ne soustrait pas la moyenne de la ligne. Dans notre exemple, les deux sorties restent positives : leur moyenne n'est pas nulle. L'article original sur RMSNorm présente cette distinction ; la documentation de RMSNorm dans PyTorch donne également sa formule. Notre comparaison utilisera toutefois la référence écrite dans ce tutoriel, avec ses choix explicites de précision et d'epsilon.
Pourquoi avons-nous besoin d'un aller et d'un retour ?
Le forward, ou passage avant, calcule y à partir de x et de gamma. Pendant l'entraînement, le réseau produit ensuite une prédiction, comparée à une cible par une perte : un nombre que l'on cherche à réduire.
Le backward, ou rétropropagation, fait circuler les gradients en sens inverse. Un gradient mesure la sensibilité de la perte à une petite variation d'une valeur. Il ne met pas les poids à jour lui-même : l'optimiseur s'en sert pour le faire.
À l'entrée du backward de RMSNorm, dy signifie « gradient de la perte par rapport à y ». Ce n'est ni la différence y - x, ni directement l'erreur entre la prédiction et la cible. Les opérations placées après RMSNorm ont déjà contribué à son calcul.
Nous devons renvoyer deux objets : dx, pour poursuivre la rétropropagation vers la couche précédente, et dgamma, pour apprendre les poids de normalisation. Avec u = dy × gamma, les expressions à retrouver sont :
dx = r × u − x × r³ × mean(u × x)
dgamma = sum_lignes(dy × x × r)
Nous détaillerons ces formules au moment de leur implémentation. Retenez déjà la différence : la moyenne de dx porte sur les N colonnes d'une ligne, tandis que la somme de dgamma porte sur les M lignes.
PyTorch fournit les opérations sur tenseurs et Autograd organise leurs dérivées. Triton permet d'écrire le calcul GPU avec une syntaxe proche de Python. Un kernel regroupe des opérations à exécuter sur la carte ; il n'est pas un modèle préentraîné. Ici, nous devons fournir explicitement son backward pour le relier au reste du réseau.
Prérequis Docker et GPU
Vous devez savoir lire une fonction Python, manipuler des tableaux et utiliser un terminal avec Docker. Aucune expérience préalable de programmation CUDA n'est nécessaire pour suivre les explications.
Le parcours validé demande Linux x86_64, Docker avec Compose, NVIDIA Container Toolkit et une RTX 3090 de 24 Gio. Prévoyez 16 Gio de RAM et 16 Gio de disque, hors couches Docker partagées. La mémoire vidéo du GPU, ou VRAM, est distincte de la RAM du système. Aucun profil CPU ne remplace l'exécution CUDA du kernel.
Extrayez l'archive et placez votre terminal à sa racine. Toutes les commandes suivantes partent de ce même répertoire. Les extraits de l'article montrent les fonctions centrales, pas des fichiers autonomes : les imports, le contrat complet et les fonctions auxiliaires restent dans le projet téléchargeable.
setup.sh crée les répertoires locaux et écrit seulement UID/GID dans .env : ces identifiants servent à gérer les droits des fichiers. acquire ne télécharge ici ni modèle préentraîné ni jeu de données externe. Les données seront synthétiques ; outputs/ reçoit les contrôles et artifacts/ les checkpoints, c'est-à-dire les états sauvegardés du réseau. Les dépendances sont résolues et vérifiées pendant le build.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose config --quiet contrôle la configuration Compose. Le build prépare les services acquire et gpu. Enfin, check_environment.py initialise CUDA dans le conteneur et exécute un calcul : voir une carte depuis Linux ne suffit pas à prouver qu'elle est utilisable depuis Docker.
Si ce dernier contrôle échoue, arrêtez-vous à cette étape et vérifiez l'intégration avec le guide NVIDIA Container Toolkit. Ne changez pas la formule de RMSNorm pour contourner un problème d'environnement. Le réemploi de couches Docker peut modifier le temps de build ; il ne change pas le calcul numérique que nous chercherons à comparer.
Vérifier les garde-fous avant le kernel
Avant d'optimiser une fonction web, vous garderiez des tests sur ses entrées et ses sorties. Nous faisons la même chose avec le calcul GPU, en ajoutant le contrôle des gradients et de l'organisation mémoire.
La suite publique couvre les tailles irrégulières, le contrat de mémoire, les cas négatifs et les contrôles de gradients. Un cas négatif est une entrée qui doit être refusée, ou une variante erronée que le test doit savoir détecter. Une erreur attendue bien détectée est donc une réussite du test.
docker compose run --rm gpu python -m pytest -q
La suite doit terminer sans échec avant les mesures ou l'entraînement. Cette réussite concerne le code et les cas du projet : elle ne transforme pas notre opérateur en kernel universel acceptant n'importe quelle taille, n'importe quel type numérique ou n'importe quelle disposition mémoire.
Référence PyTorch : l’oracle numérique
Un oracle de test est simplement une version à laquelle on compare l'implémentation étudiée. Notre référence privilégie la lisibilité : nous pouvons rapprocher chaque ligne Python de la formule précédente.
Le dtype est le type numérique d'un tenseur. FP16, FP32 et FP64 désignent des nombres flottants stockés sur 16, 32 et 64 bits. Leurs précisions ne sont pas identiques. La référence travaille en float64 si l'entrée est déjà en float64, sinon en FP32 ; elle reconvertit ensuite la sortie vers le type de l'entrée.
def rmsnorm_reference(x, gamma, epsilon=1e-6):
    dtype = torch.float64 if x.dtype == torch.float64 else torch.float32
    xf = x.to(dtype)
    gf = gamma.to(dtype)
    r = torch.rsqrt(xf.square().mean(-1, keepdim=True) + epsilon)
    return (xf * r * gf).to(x.dtype)


def manual_backward(x, gamma, dy, epsilon=1e-6):
    r = torch.rsqrt(x.square().mean(-1, keepdim=True) + epsilon)
    u = dy * gamma
    dx = r * u - x * r.pow(3) * (u * x).mean(-1, keepdim=True)
    dgamma = (dy * x * r).sum(0)
    return dx, dgamma
Lire le forward, ligne par ligne
xf et gf sont les versions de travail de x et gamma, converties dans le type choisi. square() calcule les carrés. mean(-1, keepdim=True) calcule la moyenne sur le dernier axe, donc sur les colonnes.
Pourquoi conserver la dimension avec keepdim=True ? Pour une entrée M × N, la moyenne a la forme M × 1. Chaque ligne garde ainsi son propre nombre, que PyTorch peut multiplier par toutes les colonnes de cette même ligne. Cette extension automatique de forme s'appelle le broadcasting. gamma, de forme N, est de son côté réutilisé sur toutes les lignes.
torch.rsqrt(a) calcule 1 / sqrt(a). La dernière ligne applique donc exactement x × r × gamma, puis restitue le dtype initial. Calculer temporairement en FP32 ne signifie pas que la sortie restera en FP32 si l'entrée était en FP16.
Une formule de backward indépendante et lisible
manual_backward() exprime les deux dérivées sans passer par Triton. Son intérêt est de confronter une formule explicite aux gradients produits par Autograd.
Contrairement à rmsnorm_reference(), cette fonction ne convertit pas explicitement ses entrées vers un type plus précis. Elle doit donc être lue avec les dtypes de ses arguments ; ce n'est pas à elle seule une recette de réduction FP32 pour des tenseurs FP16. Le kernel, lui, rendra cette conversion visible dans ses chargements.
Le gradcheck ajoute une autre vérification : il perturbe légèrement les entrées et compare la variation numérique de la sortie à la dérivée calculée. Pour comprendre l'idée, la pente d'une fonction scalaire peut être estimée par (f(a + h) - f(a - h)) / (2 × h), avec un petit h. La documentation de gradcheck précise notamment le rôle de la double précision dans ses réglages habituels.
Dans ce parcours, le gradcheck float64 concerne la référence PyTorch, pas le kernel Triton FP32/FP16. La comparaison du kernel arrivera dans des contrôles séparés. Cette distinction évite d'attribuer à un programme un test exécuté sur un autre.
Générez maintenant ce contrôle de référence et les trois partitions synthétiques :
docker compose run --rm gpu python -m rmsnorm_kernel.cli reference --config configs/minimum.yaml
Les partitions séparent les données destinées à l'entraînement, à la validation et au test. Le détail de leur génération appartient au projet ; aucune donnée métier ni aucun modèle externe n'est nécessaire pour étudier cette opération.
Forward Triton : une ligne, un programme
Le contrat mémoire fait partie du calcul
Imaginez une fonction qui accepte un tableau rectangulaire, mais parcourt sa mémoire comme si toutes les lignes étaient rangées à la suite. Elle serait incorrecte sur une vue dont les éléments sont espacés autrement, même si les dimensions affichées paraissent bonnes.
Un tenseur contigu possède ici la disposition compacte attendue par le kernel. Les strides décrivent les pas nécessaires en mémoire pour avancer d'une ligne ou d'une colonne. Une transposition peut, par exemple, produire une vue non contiguë sans déplacer tous les nombres.
Avant d'écrire dans les sorties, le contrat du projet refuse les entrées non contiguës, les dtypes autres que FP32/FP16, les appareils différents, un epsilon invalide, N supérieur à 4096 et un espace temporaire, ou scratch, supérieur à 64 Mio. Le corps de check_contract() n'est pas reproduit ci-dessous : conservez les vérifications du fichier complet.
@triton.jit
def rmsnorm_forward_kernel(
    X, G, Y, R, N: tl.constexpr, EPS: tl.constexpr, BLOCK: tl.constexpr
):
    row = tl.program_id(0)
    column = tl.arange(0, BLOCK)
    x = tl.load(X + row * N + column, column < N, other=0).to(tl.float32)
    gamma = tl.load(G + column, column < N, other=0).to(tl.float32)
    inverse = tl.rsqrt(tl.sum(x * x, 0) / N + EPS)
    y = x * inverse * gamma
    tl.store(Y + row * N + column, y, column < N)
    tl.store(R + row, inverse)


def forward_op(x, gamma, epsilon=1e-6):
    check_contract(x, gamma, epsilon)
    m, n = x.shape
    y = torch.empty_like(x)
    inverse = torch.empty(m, device=x.device, dtype=torch.float32)
    rmsnorm_forward_kernel[(m,)](
        x, gamma, y, inverse, n, epsilon, triton.next_power_of_2(n)
    )
    return y, inverse
Qui calcule quelle ligne ?
La partie Python forward_op() contrôle les entrées, réserve les sorties, puis lance le kernel avec la grille [(m,)]. Nous demandons ainsi M instances du programme Triton, une par ligne.
tl.program_id(0) donne à chaque instance son numéro de ligne. Ce numéro ne représente ni un processus Docker ni une carte graphique supplémentaire. tl.arange(0, BLOCK) construit les positions de colonnes traitées ensemble. Le premier tutoriel de Triton présente ce modèle de programmation et ses masques mémoire.
X + row * N + column désigne les valeurs de la ligne voulue. La formule utilise N parce que les lignes réelles contiennent N valeurs. Elle n'utilise pas la taille arrondie BLOCK pour passer à la ligne suivante.
Le décorateur @triton.jit confie la compilation du kernel à Triton. Les paramètres marqués tl.constexpr sont connus lors de sa spécialisation : ils décrivent notamment les dimensions du bloc et les constantes de ce calcul, pas des poids appris.
N et BLOCK : deux tailles qu'il ne faut jamais confondre
triton.next_power_of_2(n) choisit une largeur de travail égale à la puissance de deux suivante. Avec N=257, le programme manipule donc BLOCK=512 positions, mais seules les colonnes 0 à 256 appartiennent à la ligne.
Cela ne transforme pas notre tenseur en une matrice à 512 colonnes. Les positions supplémentaires sont des emplacements de calcul à masquer. tl.load(..., column < N, other=0) ne lit pas les valeurs hors de la ligne : il leur substitue zéro. tl.store(..., column < N) n'écrit que les valeurs valides.
Pourquoi le zéro ? Il ne change pas la somme des carrés. En revanche, il ne faut pas le compter comme une observation supplémentaire dans la moyenne. La somme doit être divisée par N, et non par BLOCK.
Prenons un exemple plus petit, distinct des mesures : une ligne [1, 1, 1] traitée avec un bloc de quatre positions. La somme des carrés de [1, 1, 1, 0] vaut toujours 3. Diviser par 3 donne la moyenne correcte, 1 ; diviser par 4 donne 0,75. Le masque protège les accès mémoire, mais ne choisit pas le bon dénominateur à notre place.
Le même défaut est invisible à N=256, car BLOCK vaut alors lui aussi 256. Voilà pourquoi une taille irrégulière est un test utile, et non un détail de présentation.
Pourquoi convertir avant de réduire ?
Une réduction transforme plusieurs valeurs en un résultat, par exemple une somme ou une moyenne. Ici, les nombres sont convertis en FP32 dès le chargement, avant les carrés et leur somme. Convertir seulement après un calcul déjà arrondi ne permettrait pas de retrouver la précision perdue.
Le kernel calcule l'inverse RMS, applique gamma, puis écrit y. Y a le même type que x, grâce à torch.empty_like(x) ; R conserve un inverse par ligne, explicitement en FP32, pour le backward. empty_like réserve de la mémoire sans la remplir de zéros : c'est bien le kernel qui doit écrire chaque sortie utile.
Nous avons fusionné le forward, mais pas supprimé tout stockage intermédiaire : R est une donnée volontairement conservée entre l'aller et le retour.
docker compose run --rm gpu python -m rmsnorm_kernel.cli check-forward --config configs/minimum.yaml
Ce contrôle compare le forward aux tailles prévues, y compris des N qui ne sont pas des puissances de deux. La leçon LayerNorm de Triton approfondit les kernels de normalisation et de réduction ; elle ne remplace pas le contrat RMSNorm plus restreint de ce projet.
Backward des entrées : conserver le bon N
La difficulté : chaque valeur influence aussi le dénominateur
Pour calculer dx, nous ne pouvons pas nous contenter de multiplier dy par r × gamma. Ce serait oublier que r dépend lui-même de toute la ligne x.
Reprenons [3, 4]. Si nous changeons le premier nombre, son numérateur change, mais la somme des carrés change aussi. Le dénominateur commun aux deux sorties est donc modifié. Le backward doit tenir compte de cet effet collectif.
C'est le rôle des deux termes de la formule : r × u décrit l'effet direct ; −x × r³ × mean(u × x) ajoute l'effet du changement de normalisation. u = dy × gamma incorpore d'abord les poids par colonne.
Pour l'illustrer avec le même exemple, remettons gamma = [1, 1] et choisissons le gradient amont pédagogique dy = [1, 2]. Nous avons u = [1, 2], puis mean(u × x) = (3 + 8) / 2 = 5,5. Avec epsilon = 1e-6, la formule donne environ :
dx = [-0,090510 ; 0,067882]
Le premier gradient est négatif alors que les valeurs de dy sont positives. Ce n'est pas une anomalie : augmenter une entrée peut réduire d'autres sorties en augmentant leur dénominateur. Le gradient tient compte de tous les chemins par lesquels cette entrée influence la perte. Ces nombres illustrent la formule ; ce ne sont pas les écarts mesurés du kernel.
D'où vient le cube de r ?
Cette petite dérivation est facultative pour exécuter le projet, mais elle rend le code moins mystérieux.
Appelons s = mean(x²) + epsilon. Puisque r = s^(-1/2), la dérivée de r par rapport à s vaut −(1/2) × s^(-3/2), soit −r³ / 2. La dérivée de s par rapport à une coordonnée x_i vaut 2 × x_i / N.
En multipliant les deux, nous obtenons ∂r/∂x_i = −x_i × r³ / N. Il reste à sommer les contributions de toutes les sorties qui utilisent ce même r, ce qui donne le second terme de dx.
Le cube n'est donc pas un réglage à ajuster jusqu'à ce que le test passe : il vient de la dérivation de l'inverse de la racine carrée.
@triton.jit
def rmsnorm_dx_kernel(X, G, DY, R, DX, PARTIAL, N: tl.constexpr, BLOCK: tl.constexpr):
    row = tl.program_id(0)
    column = tl.arange(0, BLOCK)
    x = tl.load(X + row * N + column, column < N, other=0).to(tl.float32)
    gamma = tl.load(G + column, column < N, other=0).to(tl.float32)
    dy = tl.load(DY + row * N + column, column < N, other=0).to(tl.float32)
    inverse = tl.load(R + row)
    u = dy * gamma
    mean_ux = tl.sum(u * x, 0) / N
    dx = inverse * u - x * inverse * inverse * inverse * mean_ux
    tl.store(DX + row * N + column, dx, column < N)
    tl.store(PARTIAL + row * N + column, dy * x * inverse, column < N)


def backward_rows(x, gamma, dy, inverse, epsilon):
    check_contract(x, gamma, epsilon)
    if (
        dy.shape != x.shape
        or dy.dtype != x.dtype
        or dy.device != x.device
        or not dy.is_contiguous()
    ):
        raise ValueError("dy must match x and be contiguous")
    m, n = x.shape
    dx = torch.empty_like(x)
    partial = torch.empty((m, n), device=x.device, dtype=torch.float32)
    rmsnorm_dx_kernel[(m,)](
        x, gamma, dy, inverse, dx, partial, n, triton.next_power_of_2(n)
    )
    return dx, partial
Ce que produit ce kernel
Le programme charge x, gamma et dy en FP32, puis récupère l'inverse sauvegardé au forward. mean_ux additionne u × x et divise, là encore, par N. Les colonnes masquées restent sans contribution à cette somme.
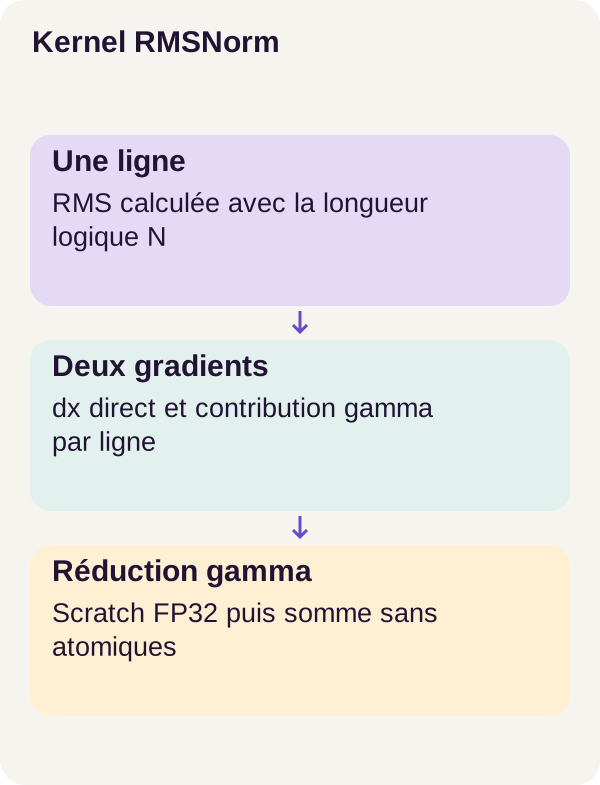
Il écrit ensuite deux objets. DX reçoit le gradient des entrées, dans une sortie de même forme et de même type que x. PARTIAL reçoit une contribution à dgamma pour chaque ligne et chaque colonne : dy × x × inverse. Ce tableau n'est pas encore le gradient final de gamma ; il sera réduit à l'étape suivante.
Dans backward_rows(), le contrôle supplémentaire exige que dy ait la même forme, le même dtype et le même appareil que x, et qu'il soit contigu. Le futur wrapper Autograd appellera dy.contiguous() pour satisfaire cette dernière condition. Cela ne rend pas pour autant acceptables les entrées utilisateur x et gamma non contiguës : elles restent rejetées par le contrat.
L'inverse est ici un intermédiaire interne, produit par forward_op() puis conservé pour ce même calcul. Cet extrait ne doit pas être interprété comme une API publique validant n'importe quel tenseur inverse fourni de l'extérieur.
Vérifiez maintenant dx contre la référence :
docker compose run --rm gpu python -m rmsnorm_kernel.cli check-backward --config configs/minimum.yaml
Si le forward est correct mais pas dx, inspectez la dérivée : le bon forward ne garantit pas que nous avons correctement implémenté son retour.
Réduire dgamma sans course d’écriture
Un poids partagé reçoit plusieurs contributions
Chaque colonne utilise le même poids gamma pour toutes les lignes. Son gradient doit donc rassembler les contributions de ces lignes. Imaginez plusieurs tâches qui calculent chacune une part d'un total : on additionne leurs contributions, on ne conserve pas arbitrairement la dernière.
Si tous les programmes GPU essayaient de modifier la même case sans coordination, nous aurions une course d'écriture. Une addition atomique peut empêcher la perte de contributions, mais l'ordre de ces additions concurrentes peut varier. En arithmétique flottante, cet ordre peut modifier les derniers chiffres du résultat.
Le minimum pédagogique choisit une autre organisation : chaque ligne écrit dans sa propre zone de partial, puis une seconde passe Triton somme ces contributions par colonne. Elle réduit en FP32 avant de convertir le résultat vers le dtype de gamma. Ce choix évite ici l'accumulation atomique concurrente ; il ne promet pas une identité bit à bit sur tous les matériels et toutes les versions.
def reduce_gamma_gradient(partial, dtype):
    m, n = partial.shape
    result = torch.empty(n, device=partial.device, dtype=dtype)
    gamma_sum_kernel[(triton.cdiv(n, 32),)](partial, result, m, n, 32, 32)
    return result
result possède N éléments, un gradient par poids. triton.cdiv(n, 32) est une division arrondie au supérieur : pour N=257, elle prévoit neuf programmes. Le corps de gamma_sum_kernel n'est pas reproduit dans cet extrait ; l'organisation complète de cette seconde réduction se lit dans l'archive. La fonction ci-dessus montre son lancement et le type de la sortie.
Une somme n'est pas une moyenne
Supposons, pour un exemple purement pédagogique, que deux lignes aient déjà produit les contributions suivantes :
| Contribution | Colonne 0 | Colonne 1 |
|---|---|---|
| Ligne 0 | 1 | 2 |
| Ligne 1 | 3 | 4 |
Somme attendue pour dgamma |
4 | 6 |
| Moyenne, qui serait incorrecte ici | 2 | 3 |
Il n'y a pas de division supplémentaire par M dans la formule de dgamma. Si la perte globale fait déjà une moyenne sur les exemples, cette pondération est transmise par dy. Diviser encore ici changerait le gradient de l'opération.
Avec une seule ligne, somme et moyenne sont identiques. Avec 17 lignes, elles ne le sont généralement plus : c'est pourquoi les cas M=1 et M=17 sont utiles pour détecter une confusion.
Le prix de cette organisation : un tableau temporaire
partial contient M × N nombres FP32 de quatre octets chacun. Son empreinte vaut donc M × N × 4 octets.
Pour la forme 128 × 257 du benchmark, cela représente 131 584 octets, soit 128,5 Kio. Ce calcul concerne seulement partial, pas toute la VRAM du programme. Avec M=4096 et N=4096, ce même tableau atteint 64 Mio ; une ligne supplémentaire dépasse cette borne.
Ces calculs expliquent le budget scratch : une largeur N autorisée ne suffit pas à rendre toutes les hauteurs M acceptables. Ils ne constituent pas une nouvelle mesure de mémoire du projet.
docker compose run --rm gpu python -m rmsnorm_kernel.cli check-gamma --config configs/minimum.yaml
Le contrôle check-gamma complète les vérifications précédentes : il vise le gradient du poids partagé, pas simplement les gradients des entrées.
Brancher Autograd et entraîner réellement
Nous disposons maintenant du forward, de dx et de dgamma. Il reste à les brancher dans PyTorch. C'est le rôle de la sous-classe torch.autograd.Function.
Pour un développeur web, on peut la voir comme un adaptateur : le reste du programme appelle une opération normale, tandis que l'adaptateur sait comment déléguer son exécution et son retour au code spécialisé. Autograd n'est pas un outil qui devine notre formule Triton : nous lui fournissons explicitement la règle de backward. La documentation PyTorch sur les fonctions personnalisées décrit cette interface.
class RMSNormFunction(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x, gamma, epsilon):
        y, inverse = forward_op(x, gamma, epsilon)
        ctx.save_for_backward(x, gamma, inverse)
        ctx.epsilon = epsilon
        CALLS["forward"] += 1
        return y

    @staticmethod
    def backward(ctx, dy):
        x, gamma, inverse = ctx.saved_tensors
        dx, partial = backward_rows(x, gamma, dy.contiguous(), inverse, ctx.epsilon)
        dgamma = reduce_gamma_gradient(partial, gamma.dtype)
        CALLS["backward"] += 1
        return dx, dgamma, None


def rmsnorm(x, gamma, epsilon=1e-6):
    return RMSNormFunction.apply(x, gamma, epsilon)
Ce que conserve ctx
ctx est le contexte d'un appel de la fonction. Au forward, save_for_backward(x, gamma, inverse) conserve les tenseurs nécessaires au retour. epsilon, qui n'est pas un tenseur appris dans ce contrat, est conservé séparément comme attribut.
Au backward, nous retrouvons ces mêmes tenseurs. dy.contiguous() assure la disposition compacte du gradient amont : cette méthode renvoie le tenseur s'il convient déjà et produit une copie contiguë lorsque c'est nécessaire, comme le précise la documentation de contiguous().
backward_rows() calcule dx et les contributions intermédiaires. reduce_gamma_gradient() les additionne. Enfin, return dx, dgamma, None répond aux trois arguments d'entrée, dans le même ordre : un gradient pour x, un pour gamma, aucun pour epsilon.
Ce None ne signifie pas que l'epsilon n'a aucun effet mathématique sur la sortie. Il signifie que ce paramètre n'est pas différencié par notre interface.
Des gradients ne sont pas encore des mises à jour
Aucun appel à un optimiseur n'apparaît dans cette classe. Elle calcule les sorties et rend les gradients ; la boucle d'entraînement extérieure utilise ensuite Adam pour modifier les paramètres. Les compteurs CALLS enregistrent les passages par le wrapper, pas le nombre exact de lancements GPU : un backward appelle ici le calcul par ligne puis la réduction de gamma.
Le petit réseau comparé est Linear → RMSNorm → SiLU → Linear. Une couche Linear combine les entrées avec des poids ; SiLU ajoute une transformation non linéaire. Les deux voies partent d'initialisations identiques : nous comparons donc la référence et le kernel sans leur donner des points de départ différents.
Le parcours entraîne 100 pas avec Adam et 32 exemples par pas, recharge les poids, puis vérifie que la voie kernel a appelé forward et backward 100 fois. Ce contrôle évite notamment de valider un entraînement qui serait resté, par erreur, sur la voie de référence.
docker compose run --rm gpu python -m rmsnorm_kernel.cli train-integration --config configs/minimum.yaml
L'intégration vérifie que notre opération participe réellement à un apprentissage. Le rechargement vérifie également les poids sauvegardés. Ce n'est pas la même affirmation qu'une reprise complète après interruption avec restauration de tout l'état de l'optimiseur ; ce second scénario n'est pas annoncé ici.
Mesures avant les résultats
Trois comparaisons numériques distinctes
Les contrôles couvrent 72 cas chacun pour le forward, dx et dgamma. Nous comparons donc les sorties, les gradients des entrées et ceux des poids : trois objets différents.
Les tolérances déclarées sont atol=1e-5, rtol=1e-4 en FP32, et atol=rtol=3e-3 en FP16. Atol est une marge absolue ; rtol ajoute une marge proportionnelle à la valeur de référence.
Pour lire ces paramètres, la règle de proximité de torch.allclose s'écrit, élément par élément :
abs(valeur - référence) ≤ atol + rtol × abs(référence)
Avec les tolérances FP32, une référence égale à 1 autorise un écart de 0,00011. Une référence égale à 100 autorise 0,01001. Ces exemples expliquent le calcul ; ils ne sont pas des cas capturés dans la campagne.
Un maximum d'erreur absolue ne suffit donc pas, seul, à conclure qu'une tolérance relative a été dépassée. Il faut connaître le dtype, la valeur de référence et le résultat du contrôle correspondant. Inversement, une petite moyenne d'erreur ne permettrait pas d'ignorer un élément qui échoue.
Pourquoi ne pas exiger toujours zéro ? Les nombres flottants ont une précision limitée et l'ordre des opérations peut modifier les arrondis, même pour des expressions mathématiquement équivalentes. La note de PyTorch sur la précision numérique décrit cette limite. Nous gardons des tolérances déclarées avant la comparaison, plutôt que de les agrandir après avoir vu une erreur.
Quel temps mesure le benchmark ?
Le protocole place des événements CUDA autour d'appels complets. Il conserve les allocations, le passage par Autograd et les lancements associés ; il ne réduit pas la mesure au seul corps du kernel Triton.
Une précision est utile : les événements CUDA mesurent un intervalle sur la chronologie du GPU. Ce ne sont pas des chronomètres qui attribuent séparément un coût CPU à chaque ligne Python. Leurs résultats décrivent donc ce périmètre d'exécution, pas une décomposition détaillée des allocations, du dispatch et du calcul.
La chauffe exécute les opérations avant de retenir les durées. Ici, les 20 appels de chauffe sont exclus ; les médianes sont calculées sur 50 échantillons de 20 appels. Les deux nombres 20 n'ont pas le même rôle : le premier concerne la préparation, le second le regroupement des appels mesurés.
La médiane décrit le milieu des observations ordonnées, contrairement à la moyenne qui additionne les durées puis divise par leur nombre. Elle ne décrit pas à elle seule les pires délais ni la variabilité complète.
docker compose run --rm gpu python -m rmsnorm_kernel.cli benchmark --config configs/minimum.yaml
Les observations du parcours
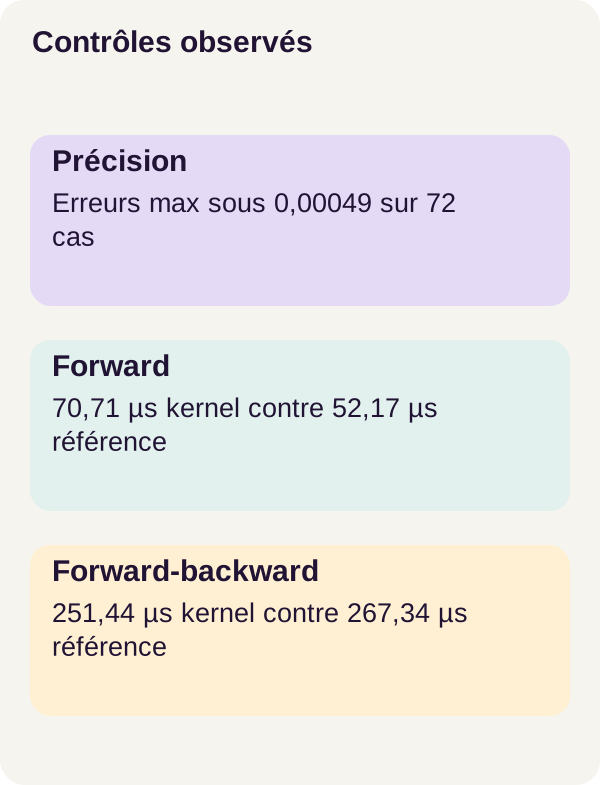
Les latences suivantes sont des mesures locales observées sur une RTX 3090, pour la forme 128 × 257 en FP32. Les trois lignes d'erreur résument chacune leur campagne de 72 cas ; ce tableau ne ventile pas ces maximums par dtype. Ne leur attribuez pas un cas individuel qui n'est pas indiqué dans le résumé.
Ces chiffres ne prédisent pas le meilleur kernel pour une autre forme, une autre carte, une comparaison avec torch.compile ou un autre périmètre de chronométrage.
Sur mobile, faites défiler le tableau horizontalement.
| Contrôle observé | Résultat |
|---|---|
| Erreur absolue max forward, 72 cas | 0,00024414 |
| Erreur absolue max dx, 72 cas | 0,00048828 |
| Erreur absolue max dgamma, 72 cas | 0,00012207 |
| Médiane référence forward | 52,17 µs |
| Médiane kernel forward | 70,71 µs |
| Médiane référence forward + backward | 267,34 µs |
| Médiane kernel forward + backward | 251,44 µs |
L'intégration donne une erreur initiale de sortie, ou output, de 1,19e-7 et de gradient de 5,96e-8. Après 100 pas, les voies référence et kernel ont une MSE test d'environ 0,30670 et un rechargement avec écart nul. La MSE est la moyenne des écarts au carré entre prédictions et cibles : ce n'est pas un pourcentage de réussite. La voie kernel a bien exécuté 100 forwards et 100 backwards.
Ces contrôles portent sur le petit réseau et ses données synthétiques. Ils ne mesurent pas une amélioration de compréhension d'un modèle de langage, ni une qualité métier.
Le forward et le parcours d'entraînement ne racontent pas la même chose
Le tableau suivant contient uniquement des différences calculées à partir des médianes publiées ci-dessus, pas de nouvelles mesures. Le pourcentage divise la différence de durée par la médiane de la référence.
| Périmètre | Différence kernel − référence | Variation de durée |
|---|---|---|
| Forward seul | 70,71 − 52,17 = +18,54 µs |
Environ +35,54 % |
| Forward + backward | 251,44 − 267,34 = −15,90 µs |
Environ −5,95 % |
Le forward isolé est donc plus lent pour cette forme mesurée. Le couple forward-backward est plus rapide dans ce périmètre. Un résultat peut être correct numériquement sans gagner en latence sur tous les usages.
Nous ne déduisons pas un « temps pur du backward » en soustrayant deux médianes de parcours distincts. Nous n'attribuons pas non plus l'écart à une cause précise sans profilage supplémentaire. Les nombres fournis ne détaillent pas cette attribution ni la dispersion complète des temps.
Pour une application qui fait uniquement des prédictions, le forward compte directement. Pour une boucle d'apprentissage, le forward et le backward comptent tous deux, mais ils ne représentent toujours pas à eux seuls le réseau complet, l'optimiseur et le chargement des données. La conclusion doit rester liée au travail réellement chronométré.
Ce que nous avons appris
Nous sommes partis d'une moyenne de carrés et avons construit un chemin complet : une référence lisible, un forward Triton, un backward des entrées, une réduction pour le poids partagé et un branchement Autograd utilisé pendant l'entraînement.
La correction dépend de détails que quelques lignes de formule peuvent cacher. N décrit les données ; BLOCK décrit le travail du programme GPU. Le masque empêche les accès hors de la ligne, mais ne corrige pas un mauvais dénominateur. La conversion en FP32 protège les calculs intermédiaires dans le périmètre choisi ; le contrat de contiguïté protège les hypothèses d'adressage.
Le gradient de gamma nous a aussi obligés à choisir une organisation mémoire : des contributions privées, puis une somme par colonne. Ce choix évite l'accumulation concurrente directe, au prix d'un scratch borné.
Enfin, chaque preuve garde son périmètre. Le gradcheck valide la référence float64 ; les comparaisons numériques évaluent le kernel FP32/FP16 ; l'entraînement et le rechargement vérifient son intégration. Aucun de ces contrôles n'étend automatiquement le support aux autres dtypes, strides ou dérivées d'ordre supérieur. Et aucun ne garantit un gain de vitesse universel.
Exercice : hypothèse avant la commande
Nous allons examiner une erreur très discrète : remplacer le dénominateur N par la largeur arrondie du bloc. Dans l'énoncé, BLOCK_SIZE désigne cette largeur, nommée BLOCK dans les kernels présentés.
Avant d'exécuter la commande, prenez une ligne de 257 valeurs égales à 1. Quelle est sa somme de carrés ? Quelle moyenne obtenez-vous en divisant par 257, puis par 512 ? Le dénominateur de RMSNorm devient-il plus grand ou plus petit ? Et l'amplitude de la sortie ?
Refaites mentalement le raisonnement avec 256 valeurs. Expliquez pourquoi un test limité à cette taille pourrait laisser passer le défaut.
docker compose run --rm gpu python -m rmsnorm_kernel.cli exercise --config configs/exercise.yaml
Comparez maintenant le scénario négatif à votre hypothèse. L'exercice doit rendre l'erreur observable ; il n'a pas pour but de remplacer le kernel de référence par une variante incorrecte.
Voici un repère arithmétique indépendant, avec gamma=1 et epsilon=1e-6, pour vérifier le sens de votre explication. Ce ne sont pas des sorties capturées de la commande :
| Ligne de 257 valeurs égales à 1 | Division correcte par N | Division erronée par BLOCK |
|---|---|---|
| Somme des carrés | 257 | 257 |
| Moyenne utilisée | 1 | 257 / 512 = 0,501953125 |
| Dénominateur avec epsilon | Environ 1,0000005 |
Environ 0,708487 |
| Sortie par coordonnée | Environ 0,9999995 |
Environ 1,411458 |
La mauvaise division sous-estime le dénominateur et amplifie trop la sortie. Les zéros de remplissage n'ont pas changé la somme ; ils ont changé la moyenne parce qu'ils ont été comptés à tort. À N=256, N et BLOCK coïncident : cette erreur précise n'apparaît plus.
Pour aller au bout de l'exercice, expliquez aussi pourquoi le backward doit utiliser le même N logique dans mean(u × x). Corriger uniquement le forward ne suffirait pas à obtenir les bonnes dérivées.
Adapter le kernel et passer en production
Élargir le contrat demande d'abord de nouveaux tests. BF16, strides arbitraires, N supérieur à 4096 et double backward ne sont pas des capacités acquises par ce tutoriel. BF16 est un autre format numérique ; le prendre en charge ne se déduit pas du support de FP16.
Un double backward calcule des dérivées des gradients. Il ne signifie pas simplement faire deux étapes d'entraînement. Une fonction qui permet un premier backward n'est pas automatiquement utilisable pour ces dérivées d'ordre supérieur. Le wrapper présenté ne constitue pas une validation de ce scénario.
Pour accepter des tableaux plus grands, redéfinissez le budget scratch et le plan de réduction. Pour accepter d'autres dispositions mémoire, adaptez l'adressage aux strides et testez-le. Ne vous contentez pas de retirer le rejet de check_contract() : cette suppression ne rendrait pas les hypothèses du kernel vraies.
Un fallback serait un retour explicite à la référence lorsqu'une entrée n'est pas prise en charge. Le projet n'en fournit pas de silencieux. En ajouter un demande de définir les conditions de bascule, de tester les deux chemins et de rendre cette bascule observable.
Enfin, une mise en production exige des formes représentatives du vrai réseau, des tests de charge, une mesure du périmètre visé, la compatibilité pilote/compilateur, de l'observabilité et une stratégie de retour à la référence. Le corpus synthétique et un seul hôte ne suffisent pas à établir ces propriétés. Toute comparaison avec une autre implémentation doit notamment conserver la même formule, le même epsilon et des exigences de précision explicites.
Dépannage et nettoyage
Le forward échoue surtout à N=257. Vérifiez la division par N, le masque column < N et les adresses qui utilisent row * N. Un résultat correct à 256 ne disculpe pas une confusion entre données et bloc de travail.
Le forward passe, mais dx diverge. Contrôlez le terme r³, la moyenne de u × x et l'inverse conservé depuis le forward. Ne cherchez pas d'abord à ajuster l'optimiseur : une dérivée erronée est déjà un problème avant l'entraînement.
Seul dgamma diverge ou varie. Inspectez les contributions de partial, la seconde réduction et le budget scratch. Vérifiez qu'il s'agit d'une somme sur les lignes, et non d'une moyenne.
Une entrée non contiguë est refusée. Le rejet est attendu : le contrat ne fournit pas de fallback silencieux. La mise en contiguïté de dy dans le wrapper ne modifie pas les règles applicables à x et gamma.
Une fois les observations conservées, générez les figures, contrôlez les checkpoints, prévisualisez le nettoyage puis arrêtez les services. Ces quatre commandes terminent le parcours dans cet ordre :
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
--dry-run ne supprime rien. Lisez les fichiers que le programme propose de nettoyer avant toute action destructive. La dernière commande arrête les services de ce projet Compose ; elle ne constitue pas une purge globale de vos environnements Docker.
Sources primaires
Les références ci-dessous approfondissent les mécanismes. Les exemples arithmétiques de cet article sont des illustrations pédagogiques ; les mesures locales restent celles du parcours r1. Les liens de documentation versionnés ne remplacent pas les dépendances du ZIP et n'imposent pas de changer leur version.
- RMSNorm — article original : principe de la normalisation sans soustraction de la moyenne.
- Triton — tutoriel LayerNorm : contexte des réductions et du backward de normalisation.
- PyTorch — Autograd : mécanisme de différentiation automatique.
- NVIDIA Container Toolkit — guide d’installation : accès au GPU depuis Docker.
Pour découvrir la programmation Triton, commencez par son exemple d'addition de vecteurs. Pour relire le contrat mathématique, consultez aussi RMSNorm dans PyTorch.
Pour le branchement au réseau, les pages Extending PyTorch, gradcheck et Tensor.contiguous complètent la lecture du wrapper.
Pour interpréter les mesures, gardez à portée de main torch.allclose, la note sur la précision numérique et la documentation des événements CUDA.