





Forse avete già ottimizzato un'elaborazione web che percorreva più volte lo stesso array. L'idea sembrava semplice: raggruppare le operazioni per evitare lavoro intermedio. Ma prima di confrontare i tempi, bisognava verificare che la nuova versione producesse ancora lo stesso risultato.
Seguiremo questo approccio all'interno di una rete neurale. La nostra operazione si chiama RMSNorm: riporta alla stessa scala liste di numeri. Partiremo da una versione PyTorch leggibile, poi raggrupperemo il calcolo in un kernel Triton, una funzione eseguita sulla GPU. Ci attende un'ulteriore difficoltà: durante l'addestramento non basta ottenere l'output corretto. Bisogna calcolare anche i gradienti corretti.
Scaricare il progetto completo
Il percorso porta a una RMSNorm collegata ad Autograd, usata in una piccola rete realmente addestrata e poi ricaricata. Il suo obiettivo è verificare il calcolo in un perimetro preciso, non dimostrare che «Triton è sempre più veloce». Esamineremo separatamente la correttezza numerica e la latenza.
Problema e formula di riferimento
Che cosa normalizziamo, esattamente?
Una rete trasforma i propri input in sequenze di numeri intermedi: sono le sue attivazioni. Cambiano da un esempio all'altro. I pesi, invece, sono i parametri che l'addestramento modifica per cambiare il comportamento della rete.
Normalizzare le attivazioni significa qui controllarne la scala. Non correggiamo né una stringa di caratteri né il formato di un documento: applichiamo una trasformazione numerica all'interno del modello.
In questo progetto, l'input x è un array bidimensionale, chiamato tensore. Un tensore può avere più dimensioni, ma qui restiamo su una matrice di M righe e N colonne. Ogni riga viene normalizzata indipendentemente dalle altre.
| Oggetto | Forma in questo tutorial | Come leggerlo |
|---|---|---|
x |
M × N |
M righe di attivazioni, con N numeri per riga. |
gamma |
N |
Un peso per colonna, condiviso da tutte le righe. |
r |
Un numero per riga | L'inverso della misura di scala calcolata per quella riga. |
y |
M × N |
Le attivazioni ottenute dopo la normalizzazione e la moltiplicazione per gamma. |
RMS significa root mean square, ossia «radice della media dei quadrati». Elevare al quadrato evita che valori positivi e negativi si annullino. La media tiene conto della lunghezza della riga; la radice ci riporta a una misura di scala.
Per una riga, la formula di riferimento è:
r = 1 / sqrt(mean(x²) + epsilon)
y = x × r × gamma
Le moltiplicazioni si effettuano coordinata per coordinata. r è comune a tutta la riga, ma ogni colonna possiede il proprio gamma. Il piccolo numero epsilon, fissato a 1e-6 nelle funzioni presentate, viene aggiunto prima della radice quadrata. Evita in particolare una divisione per zero per una riga interamente nulla.
Facciamo il calcolo con due valori
Prendiamo x = [3, 4], gamma = [1, 1] ed epsilon = 1e-6. Questo esempio è un'illustrazione aritmetica, non una riga estratta dalle misurazioni GPU.
| Passaggio | Calcolo | Risultato approssimato |
|---|---|---|
| Quadrati | [3², 4²] |
[9, 16] |
| Media dei quadrati | (9 + 16) / 2 |
12,5 |
| Denominatore stabilizzato | sqrt(12,5 + 0,000001) |
3,535534 |
Inverso r |
1 / 3,535534 |
0,282843 |
| Output | [3 × r, 4 × r] |
[0,848528 ; 1,131371] |
Abbiamo conservato il rapporto tra i due valori, modificandone al tempo stesso la scala. Il secondo output supera 1: normalizzare non significa limitare ogni numero tra 0 e 1.
Cambiamo soltanto gamma in [2, 0.5]. L'output diventa circa [1,697056 ; 0,565685]. Questi pesi consentono alla rete di regolare separatamente l'importanza delle coordinate dopo il cambio di scala. Non sono quindi una semplice regolazione estetica.
A differenza di LayerNorm, RMSNorm non sottrae la media della riga. Nel nostro esempio, i due output restano positivi: la loro media non è nulla. L'articolo originale su RMSNorm presenta questa distinzione; anche la documentazione di RMSNorm in PyTorch ne fornisce la formula. Il nostro confronto userà tuttavia il riferimento scritto in questo tutorial, con le sue scelte esplicite di precisione e di epsilon.
Perché abbiamo bisogno di un'andata e di un ritorno?
Il forward, o passaggio in avanti, calcola y a partire da x e gamma. Durante l'addestramento, la rete produce poi una previsione, confrontata con un obiettivo mediante una perdita: un numero che si cerca di ridurre.
Il backward, o retropropagazione, fa circolare i gradienti nella direzione opposta. Un gradiente misura la sensibilità della perdita a una piccola variazione di un valore. Non aggiorna da solo i pesi: l'ottimizzatore lo usa per farlo.
All'ingresso del backward di RMSNorm, dy significa «gradiente della perdita rispetto a y». Non è né la differenza y - x, né direttamente l'errore tra la previsione e l'obiettivo. Le operazioni poste dopo RMSNorm hanno già contribuito al suo calcolo.
Dobbiamo restituire due oggetti: dx, per proseguire la retropropagazione verso il livello precedente, e dgamma, per apprendere i pesi di normalizzazione. Con u = dy × gamma, le espressioni da trovare sono:
dx = r × u − x × r³ × mean(u × x)
dgamma = sum_lignes(dy × x × r)
Dettaglieremo queste formule al momento dell'implementazione. Tenete già presente la differenza: la media di dx riguarda le N colonne di una riga, mentre la somma di dgamma riguarda le M righe.
PyTorch fornisce le operazioni sui tensori e Autograd ne organizza le derivate. Triton consente di scrivere il calcolo GPU con una sintassi simile a Python. Un kernel raggruppa operazioni da eseguire sulla scheda; non è un modello preaddestrato. Qui dobbiamo fornire esplicitamente il suo backward per collegarlo al resto della rete.
Prerequisiti Docker e GPU
Dovete saper leggere una funzione Python, manipolare array e usare un terminale con Docker. Per seguire le spiegazioni non è necessaria alcuna esperienza precedente di programmazione CUDA.
Il percorso convalidato richiede Linux x86_64, Docker con Compose, NVIDIA Container Toolkit e una RTX 3090 da 24 Gio. Prevedete 16 Gio di RAM e 16 Gio di spazio su disco, escluse le immagini Docker condivise. La memoria video della GPU, o VRAM, è distinta dalla RAM di sistema. Nessun profilo CPU sostituisce l'esecuzione CUDA del kernel.
Estraete l'archivio e portate il terminale nella sua radice. Tutti i comandi seguenti partono da questa stessa directory. Gli estratti dell'articolo mostrano le funzioni centrali, non file autonomi: gli import, il contratto completo e le funzioni ausiliarie restano nel progetto scaricabile.
setup.sh crea le directory locali e scrive soltanto UID/GID in .env: questi identificativi servono a gestire i permessi dei file. Qui acquire non scarica né un modello preaddestrato né un set di dati esterno. I dati saranno sintetici; outputs/ riceve i controlli e artifacts/ i checkpoint, cioè gli stati salvati della rete. Le dipendenze vengono risolte e verificate durante la build.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose config --quiet controlla la configurazione Compose. La build prepara i servizi acquire e gpu. Infine, check_environment.py inizializza CUDA nel contenitore ed esegue un calcolo: vedere una scheda da Linux non basta a dimostrare che sia utilizzabile da Docker.
Se quest'ultimo controllo fallisce, fermatevi qui e verificate l'integrazione con la guida NVIDIA Container Toolkit. Non modificate la formula RMSNorm per aggirare un problema d'ambiente. Il riutilizzo dei layer Docker può modificare il tempo di build; non cambia il calcolo numerico che confronteremo.
Verificare le protezioni prima del kernel
Prima di ottimizzare una funzione web, conservereste test sui suoi input e output. Facciamo lo stesso con il calcolo GPU, aggiungendo il controllo dei gradienti e dell'organizzazione della memoria.
La suite pubblica copre dimensioni irregolari, il contratto di memoria, i casi negativi e i controlli dei gradienti. Un caso negativo è un input da rifiutare, o una variante errata che il test deve saper rilevare. Un errore previsto ben rilevato è quindi un successo del test.
docker compose run --rm gpu python -m pytest -q
La suite deve terminare senza errori prima delle misurazioni o dell'addestramento. Questo successo riguarda il codice e i casi del progetto: non trasforma il nostro operatore in un kernel universale che accetta qualsiasi dimensione, qualsiasi tipo numerico o qualsiasi disposizione della memoria.
Riferimento PyTorch: l'oracolo numerico
Un oracolo di test è semplicemente una versione con cui si confronta l'implementazione studiata. Il nostro riferimento privilegia la leggibilità: possiamo accostare ogni riga Python alla formula precedente.
Il dtype è il tipo numerico di un tensore. FP16, FP32 e FP64 indicano numeri in virgola mobile memorizzati rispettivamente su 16, 32 e 64 bit. Le loro precisioni non sono identiche. Il riferimento lavora in float64 se l'input è già in float64, altrimenti in FP32; poi riconverte l'output nel tipo dell'input.
def rmsnorm_reference(x, gamma, epsilon=1e-6):
    dtype = torch.float64 if x.dtype == torch.float64 else torch.float32
    xf = x.to(dtype)
    gf = gamma.to(dtype)
    r = torch.rsqrt(xf.square().mean(-1, keepdim=True) + epsilon)
    return (xf * r * gf).to(x.dtype)


def manual_backward(x, gamma, dy, epsilon=1e-6):
    r = torch.rsqrt(x.square().mean(-1, keepdim=True) + epsilon)
    u = dy * gamma
    dx = r * u - x * r.pow(3) * (u * x).mean(-1, keepdim=True)
    dgamma = (dy * x * r).sum(0)
    return dx, dgamma
Leggere il forward, riga per riga
xf e gf sono le versioni di lavoro di x e gamma, convertite nel tipo scelto. square() calcola i quadrati. mean(-1, keepdim=True) calcola la media sull'ultimo asse, quindi sulle colonne.
Perché conservare la dimensione con keepdim=True? Per un input M × N, la media ha forma M × 1. Ogni riga conserva così il proprio numero, che PyTorch può moltiplicare per tutte le colonne della stessa riga. Questa estensione automatica della forma si chiama broadcasting. gamma, di forma N, viene invece riutilizzato su tutte le righe.
torch.rsqrt(a) calcola 1 / sqrt(a). L'ultima riga applica quindi esattamente x × r × gamma, poi ripristina il dtype iniziale. Calcolare temporaneamente in FP32 non significa che l'output resterà FP32 se l'input era FP16.
Una formula di backward indipendente e leggibile
manual_backward() esprime le due derivate senza passare da Triton. Il suo interesse è confrontare una formula esplicita con i gradienti prodotti da Autograd.
A differenza di rmsnorm_reference(), questa funzione non converte esplicitamente i propri input in un tipo più preciso. Va quindi letta con i dtype dei suoi argomenti; da sola non è una ricetta di riduzione FP32 per tensori FP16. Il kernel renderà invece visibile questa conversione nei propri caricamenti.
Il gradcheck aggiunge un'altra verifica: perturba leggermente gli input e confronta la variazione numerica dell'output con la derivata calcolata. Per comprendere l'idea, la pendenza di una funzione scalare può essere stimata con (f(a + h) - f(a - h)) / (2 × h), con un piccolo h. La documentazione di gradcheck precisa in particolare il ruolo della doppia precisione nelle impostazioni abituali.
In questo percorso, il gradcheck float64 riguarda il riferimento PyTorch, non il kernel Triton FP32/FP16. Il confronto del kernel avverrà in controlli separati. Questa distinzione evita di attribuire a un programma un test eseguito su un altro.
Generate ora questo controllo di riferimento e le tre partizioni sintetiche:
docker compose run --rm gpu python -m rmsnorm_kernel.cli reference --config configs/minimum.yaml
Le partizioni separano i dati destinati all'addestramento, alla convalida e al test. Il dettaglio della loro generazione appartiene al progetto; per studiare questa operazione non sono necessari dati aziendali né un modello esterno.
Forward Triton: una riga, un programma
Il contratto di memoria fa parte del calcolo
Immaginate una funzione che accetta un array rettangolare, ma ne percorre la memoria come se tutte le righe fossero disposte una dopo l'altra. Sarebbe errata su una vista i cui elementi sono distanziati diversamente, anche se le dimensioni visualizzate sembrano corrette.
Un tensore contiguo possiede qui la disposizione compatta attesa dal kernel. Gli stride descrivono i passi necessari in memoria per avanzare di una riga o di una colonna. Una trasposizione può, per esempio, produrre una vista non contigua senza spostare tutti i numeri.
Prima di scrivere negli output, il contratto del progetto rifiuta gli input non contigui, i dtype diversi da FP32/FP16, dispositivi diversi, un epsilon non valido, N superiore a 4096 e uno spazio temporaneo, o scratch, superiore a 64 Mio. Il corpo di check_contract() non è riprodotto qui sotto: conservate le verifiche del file completo.
@triton.jit
def rmsnorm_forward_kernel(
    X, G, Y, R, N: tl.constexpr, EPS: tl.constexpr, BLOCK: tl.constexpr
):
    row = tl.program_id(0)
    column = tl.arange(0, BLOCK)
    x = tl.load(X + row * N + column, column < N, other=0).to(tl.float32)
    gamma = tl.load(G + column, column < N, other=0).to(tl.float32)
    inverse = tl.rsqrt(tl.sum(x * x, 0) / N + EPS)
    y = x * inverse * gamma
    tl.store(Y + row * N + column, y, column < N)
    tl.store(R + row, inverse)


def forward_op(x, gamma, epsilon=1e-6):
    check_contract(x, gamma, epsilon)
    m, n = x.shape
    y = torch.empty_like(x)
    inverse = torch.empty(m, device=x.device, dtype=torch.float32)
    rmsnorm_forward_kernel[(m,)](
        x, gamma, y, inverse, n, epsilon, triton.next_power_of_2(n)
    )
    return y, inverse
Chi calcola quale riga?
La parte Python forward_op() controlla gli input, riserva gli output, poi avvia il kernel con la griglia [(m,)]. Richiediamo così M istanze del programma Triton, una per riga.
tl.program_id(0) assegna a ogni istanza il suo numero di riga. Questo numero non rappresenta né un processo Docker né una GPU aggiuntiva. tl.arange(0, BLOCK) costruisce le posizioni di colonna elaborate insieme. Il primo tutorial Triton presenta questo modello di programmazione e le sue maschere di memoria.
X + row * N + column designa i valori della riga desiderata. La formula usa N perché le righe reali contengono N valori. Non usa la dimensione arrotondata BLOCK per passare alla riga successiva.
Il decoratore @triton.jit affida a Triton la compilazione del kernel. I parametri contrassegnati tl.constexpr sono noti durante la specializzazione: descrivono in particolare le dimensioni del blocco e le costanti del calcolo, non pesi appresi.
N e BLOCK: due dimensioni da non confondere mai
triton.next_power_of_2(n) sceglie una larghezza di lavoro uguale alla potenza di due successiva. Con N=257, il programma manipola quindi BLOCK=512 posizioni, ma soltanto le colonne da 0 a 256 appartengono alla riga.
Ciò non trasforma il nostro tensore in una matrice di 512 colonne. Le posizioni supplementari sono spazi di calcolo da mascherare. tl.load(..., column < N, other=0) non legge valori fuori dalla riga: vi sostituisce zero. tl.store(..., column < N) scrive solo i valori validi.
Perché zero? Non modifica la somma dei quadrati. Tuttavia, non bisogna contarlo come un'osservazione aggiuntiva nella media. La somma va divisa per N, non per BLOCK.
Prendiamo un esempio più piccolo, distinto dalle misurazioni: una riga [1, 1, 1] elaborata con un blocco di quattro posizioni. La somma dei quadrati di [1, 1, 1, 0] vale sempre 3. Dividere per 3 dà la media corretta, 1; dividere per 4 dà 0,75. La maschera protegge gli accessi in memoria, ma non sceglie al nostro posto il denominatore corretto.
Lo stesso difetto è invisibile a N=256, perché anche BLOCK vale 256. Ecco perché una dimensione irregolare è un test utile, non un dettaglio di presentazione.
Perché convertire prima di ridurre?
Una riduzione trasforma più valori in un risultato, per esempio una somma o una media. Qui i numeri sono convertiti in FP32 al caricamento, prima dei quadrati e della loro somma. Convertire soltanto dopo un calcolo già arrotondato non consentirebbe di recuperare la precisione perduta.
Il kernel calcola l'inverso RMS, applica gamma, poi scrive y. Y ha lo stesso tipo di x, grazie a torch.empty_like(x); R conserva un inverso per riga, esplicitamente in FP32, per il backward. empty_like riserva memoria senza riempirla di zeri: è proprio il kernel che deve scrivere ogni output utile.
Abbiamo fuso il forward, ma non eliminato tutto lo spazio intermedio: R è un dato volutamente conservato tra l'andata e il ritorno.
docker compose run --rm gpu python -m rmsnorm_kernel.cli check-forward --config configs/minimum.yaml
Questo controllo confronta il forward con le dimensioni previste, comprese N che non sono potenze di due. La lezione LayerNorm di Triton approfondisce i kernel di normalizzazione e riduzione; non sostituisce il contratto RMSNorm più limitato di questo progetto.
Backward degli input: conservare il giusto N
La difficoltà: ogni valore influenza anche il denominatore
Per calcolare dx, non possiamo limitarci a moltiplicare dy per r × gamma. Significherebbe dimenticare che r dipende a sua volta dall'intera riga x.
Riprendiamo [3, 4]. Se cambiamo il primo numero, il suo numeratore cambia, ma cambia anche la somma dei quadrati. Il denominatore comune ai due output viene quindi modificato. Il backward deve tenere conto di questo effetto collettivo.
È il ruolo dei due termini della formula: r × u descrive l'effetto diretto; −x × r³ × mean(u × x) aggiunge l'effetto della variazione di normalizzazione. u = dy × gamma incorpora prima i pesi per colonna.
Per illustrarlo con lo stesso esempio, riportiamo gamma = [1, 1] e scegliamo il gradiente a monte didattico dy = [1, 2]. Abbiamo u = [1, 2], poi mean(u × x) = (3 + 8) / 2 = 5,5. Con epsilon = 1e-6, la formula dà circa:
dx = [-0,090510 ; 0,067882]
Il primo gradiente è negativo mentre i valori di dy sono positivi. Non è un'anomalia: aumentare un input può ridurre altri output aumentando il loro denominatore. Il gradiente tiene conto di tutti i percorsi attraverso cui questo input influenza la perdita. Questi numeri illustrano la formula; non sono gli scostamenti misurati del kernel.
Da dove viene il cubo di r?
Questa breve derivazione è facoltativa per eseguire il progetto, ma rende il codice meno misterioso.
Chiamiamo s = mean(x²) + epsilon. Poiché r = s^(-1/2), la derivata di r rispetto a s vale −(1/2) × s^(-3/2), cioè −r³ / 2. La derivata di s rispetto a una coordinata x_i vale 2 × x_i / N.
Moltiplicando le due espressioni, otteniamo ∂r/∂x_i = −x_i × r³ / N. Resta da sommare i contributi di tutti gli output che usano lo stesso r, ottenendo così il secondo termine di dx.
Il cubo non è quindi un parametro da regolare finché il test non passa: deriva dalla derivazione dell'inverso della radice quadrata.
@triton.jit
def rmsnorm_dx_kernel(X, G, DY, R, DX, PARTIAL, N: tl.constexpr, BLOCK: tl.constexpr):
    row = tl.program_id(0)
    column = tl.arange(0, BLOCK)
    x = tl.load(X + row * N + column, column < N, other=0).to(tl.float32)
    gamma = tl.load(G + column, column < N, other=0).to(tl.float32)
    dy = tl.load(DY + row * N + column, column < N, other=0).to(tl.float32)
    inverse = tl.load(R + row)
    u = dy * gamma
    mean_ux = tl.sum(u * x, 0) / N
    dx = inverse * u - x * inverse * inverse * inverse * mean_ux
    tl.store(DX + row * N + column, dx, column < N)
    tl.store(PARTIAL + row * N + column, dy * x * inverse, column < N)


def backward_rows(x, gamma, dy, inverse, epsilon):
    check_contract(x, gamma, epsilon)
    if (
        dy.shape != x.shape
        or dy.dtype != x.dtype
        or dy.device != x.device
        or not dy.is_contiguous()
    ):
        raise ValueError("dy must match x and be contiguous")
    m, n = x.shape
    dx = torch.empty_like(x)
    partial = torch.empty((m, n), device=x.device, dtype=torch.float32)
    rmsnorm_dx_kernel[(m,)](
        x, gamma, dy, inverse, dx, partial, n, triton.next_power_of_2(n)
    )
    return dx, partial
Che cosa produce questo kernel
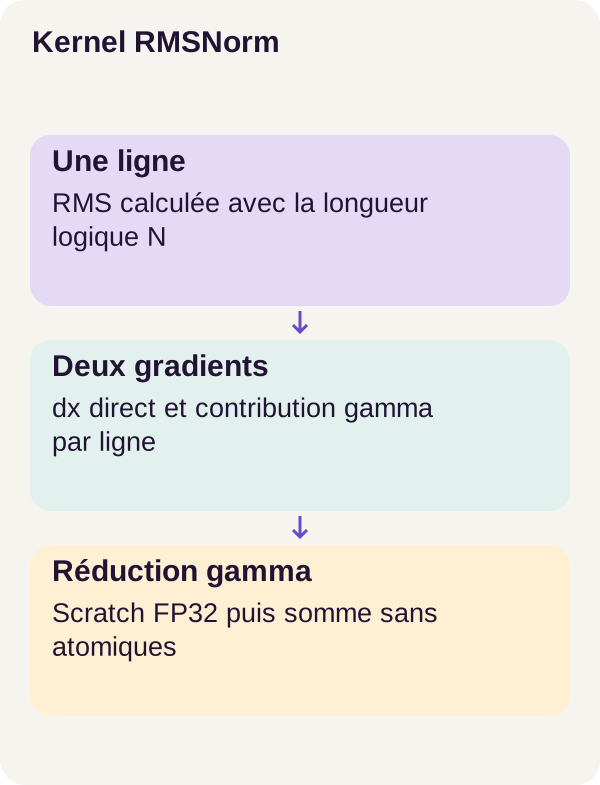
Il programma carica x, gamma e dy in FP32, poi recupera l'inverso salvato al forward. mean_ux somma u × x e divide, anche qui, per N. Le colonne mascherate non contribuiscono a questa somma.
Poi scrive due oggetti. DX riceve il gradiente degli input, in un output della stessa forma e dello stesso tipo di x. PARTIAL riceve un contributo a dgamma per ogni riga e colonna: dy × x × inverse. Questo array non è ancora il gradiente finale di gamma; verrà ridotto al passaggio successivo.
In backward_rows(), il controllo aggiuntivo richiede che dy abbia stessa forma, dtype e dispositivo di x, e che sia contiguo. Il futuro wrapper Autograd chiamerà dy.contiguous() per soddisfare quest'ultima condizione. Ciò non rende comunque accettabili gli input utente x e gamma non contigui: restano rifiutati dal contratto.
L'inverso è qui un intermedio interno, prodotto da forward_op() e conservato per questo stesso calcolo. Questo estratto non deve essere interpretato come un'API pubblica che convalida qualsiasi tensore inverse fornito dall'esterno.
Verificate ora dx rispetto al riferimento:
docker compose run --rm gpu python -m rmsnorm_kernel.cli check-backward --config configs/minimum.yaml
Se il forward è corretto ma dx no, ispezionate la derivata: un forward corretto non garantisce che ne abbiamo implementato correttamente il ritorno.
Ridurre dgamma senza una race condition in scrittura
Un peso condiviso riceve più contributi
Ogni colonna usa lo stesso peso gamma per tutte le righe. Il suo gradiente deve quindi raccogliere i contributi di tali righe. Immaginate più attività che calcolano ciascuna una parte di un totale: si sommano i loro contributi, non si conserva arbitrariamente l'ultimo.
Se tutti i programmi GPU cercassero di modificare la stessa cella senza coordinamento, avremmo una race condition in scrittura. Un'addizione atomica può evitare la perdita di contributi, ma l'ordine di queste addizioni concorrenti può variare. Nell'aritmetica in virgola mobile, questo ordine può modificare le ultime cifre del risultato.
Il minimo didattico sceglie un'altra organizzazione: ogni riga scrive nella propria area di partial, poi un secondo passaggio Triton somma questi contributi per colonna. Riduce in FP32 prima di convertire il risultato nel dtype di gamma. Questa scelta evita qui l'accumulo atomico concorrente; non promette un'identità bit per bit su tutti gli hardware e tutte le versioni.
def reduce_gamma_gradient(partial, dtype):
    m, n = partial.shape
    result = torch.empty(n, device=partial.device, dtype=dtype)
    gamma_sum_kernel[(triton.cdiv(n, 32),)](partial, result, m, n, 32, 32)
    return result
result possiede N elementi, un gradiente per peso. triton.cdiv(n, 32) è una divisione arrotondata per eccesso: per N=257 prevede nove programmi. Il corpo di gamma_sum_kernel non è riprodotto in questo estratto; l'organizzazione completa della seconda riduzione è nell'archivio. La funzione precedente ne mostra il lancio e il tipo dell'output.
Una somma non è una media
Supponiamo, per un esempio puramente didattico, che due righe abbiano già prodotto i contributi seguenti:
| Contributo | Colonna 0 | Colonna 1 |
|---|---|---|
| Riga 0 | 1 | 2 |
| Riga 1 | 3 | 4 |
Somma attesa per dgamma |
4 | 6 |
| Media, qui errata | 2 | 3 |
Non vi è una divisione aggiuntiva per M nella formula di dgamma. Se la perdita globale fa già una media sugli esempi, questa ponderazione viene trasmessa da dy. Dividere ancora qui modificherebbe il gradiente dell'operazione.
Con una sola riga, somma e media sono identiche. Con 17 righe, in genere non lo sono più: per questo i casi M=1 e M=17 sono utili per rilevare una confusione.
Il costo di questa organizzazione: un array temporaneo
partial contiene M × N numeri FP32 di quattro byte ciascuno. La sua impronta vale quindi M × N × 4 byte.
Per la forma 128 × 257 del benchmark, ciò rappresenta 131 584 byte, ossia 128,5 Kio. Questo calcolo riguarda solo partial, non tutta la VRAM del programma. Con M=4096 e N=4096, lo stesso array raggiunge 64 Mio; una riga in più supera questo limite.
Questi calcoli spiegano il budget scratch: una larghezza N autorizzata non basta a rendere accettabili tutte le altezze M. Non costituiscono una nuova misurazione di memoria del progetto.
docker compose run --rm gpu python -m rmsnorm_kernel.cli check-gamma --config configs/minimum.yaml
Il controllo check-gamma completa le verifiche precedenti: riguarda il gradiente del peso condiviso, non semplicemente i gradienti degli input.
Collegare Autograd e addestrare davvero
Ora disponiamo del forward, di dx e di dgamma. Resta da collegarli a PyTorch. È il ruolo della sottoclasse torch.autograd.Function.
Per uno sviluppatore web, possiamo vederla come un adattatore: il resto del programma chiama un'operazione normale, mentre l'adattatore sa come delegarne l'esecuzione e il ritorno al codice specializzato. Autograd non è uno strumento che indovina la nostra formula Triton: gli forniamo esplicitamente la regola di backward. La documentazione PyTorch sulle funzioni personalizzate descrive questa interfaccia.
class RMSNormFunction(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x, gamma, epsilon):
        y, inverse = forward_op(x, gamma, epsilon)
        ctx.save_for_backward(x, gamma, inverse)
        ctx.epsilon = epsilon
        CALLS["forward"] += 1
        return y

    @staticmethod
    def backward(ctx, dy):
        x, gamma, inverse = ctx.saved_tensors
        dx, partial = backward_rows(x, gamma, dy.contiguous(), inverse, ctx.epsilon)
        dgamma = reduce_gamma_gradient(partial, gamma.dtype)
        CALLS["backward"] += 1
        return dx, dgamma, None


def rmsnorm(x, gamma, epsilon=1e-6):
    return RMSNormFunction.apply(x, gamma, epsilon)
Cosa conserva ctx
ctx è il contesto di una chiamata della funzione. Al forward, save_for_backward(x, gamma, inverse) conserva i tensori necessari al ritorno. epsilon, che non è un tensore appreso in questo contratto, viene conservato separatamente come attributo.
Al backward ritroviamo questi stessi tensori. dy.contiguous() assicura la disposizione compatta del gradiente a monte: questo metodo restituisce il tensore se è già adatto e produce una copia contigua quando necessario, come precisa la documentazione di contiguous().
backward_rows() calcola dx e i contributi intermedi. reduce_gamma_gradient() li somma. Infine, return dx, dgamma, None risponde ai tre argomenti di input, nello stesso ordine: un gradiente per x, uno per gamma, nessuno per epsilon.
Questo None non significa che epsilon non abbia effetto matematico sull'output. Significa che questo parametro non è differenziato dalla nostra interfaccia.
I gradienti non sono ancora aggiornamenti
In questa classe non compare alcuna chiamata a un ottimizzatore. Calcola gli output e restituisce i gradienti; il ciclo di addestramento esterno usa poi Adam per modificare i parametri. I contatori CALLS registrano i passaggi nel wrapper, non il numero esatto di lanci GPU: qui un backward chiama il calcolo per riga e poi la riduzione di gamma.
La piccola rete confrontata è Linear → RMSNorm → SiLU → Linear. Un livello Linear combina gli input con pesi; SiLU aggiunge una trasformazione non lineare. Le due vie partono da inizializzazioni identiche: confrontiamo quindi riferimento e kernel senza assegnare loro punti di partenza diversi.
Il percorso addestra 100 passi con Adam e 32 esempi per passo, ricarica i pesi e verifica poi che la via kernel abbia chiamato forward e backward 100 volte. Questo controllo evita in particolare di convalidare un addestramento rimasto per errore sulla via di riferimento.
docker compose run --rm gpu python -m rmsnorm_kernel.cli train-integration --config configs/minimum.yaml
L'integrazione verifica che la nostra operazione partecipi davvero a un apprendimento. Il ricaricamento verifica anche i pesi salvati. Non è la stessa affermazione di una ripresa completa dopo un'interruzione, con il ripristino di tutto lo stato dell'ottimizzatore; questo secondo scenario non è annunciato qui.
Misurazioni prima dei risultati
Tre confronti numerici distinti
I controlli coprono 72 casi ciascuno per il forward, dx e dgamma. Confrontiamo dunque gli output, i gradienti degli input e quelli dei pesi: tre oggetti diversi.
Le tolleranze dichiarate sono atol=1e-5, rtol=1e-4 in FP32, e atol=rtol=3e-3 in FP16. Atol è un margine assoluto; rtol aggiunge un margine proporzionale al valore di riferimento.
Per leggere questi parametri, la regola di prossimità di torch.allclose si scrive, elemento per elemento:
abs(valeur - référence) ≤ atol + rtol × abs(référence)
Con le tolleranze FP32, un riferimento uguale a 1 autorizza uno scostamento di 0,00011. Un riferimento uguale a 100 autorizza 0,01001. Questi esempi spiegano il calcolo; non sono casi acquisiti nella campagna.
Un massimo errore assoluto non basta quindi, da solo, per concludere che una tolleranza relativa sia stata superata. Bisogna conoscere il dtype, il valore di riferimento e il risultato del controllo corrispondente. Al contrario, una piccola media dell'errore non consentirebbe di ignorare un elemento che fallisce.
Perché non richiedere sempre zero? I numeri in virgola mobile hanno una precisione limitata e l'ordine delle operazioni può modificare gli arrotondamenti, anche per espressioni matematicamente equivalenti. La nota di PyTorch sulla precisione numerica descrive questo limite. Manteniamo tolleranze dichiarate prima del confronto, invece di allargarle dopo aver osservato un errore.
Quale tempo misura il benchmark?
Il protocollo colloca eventi CUDA attorno a chiamate complete. Conserva le allocazioni, il passaggio attraverso Autograd e i lanci associati; non riduce la misura al solo corpo del kernel Triton.
Una precisazione è utile: gli eventi CUDA misurano un intervallo nella cronologia della GPU. Non sono cronometri che attribuiscono separatamente un costo CPU a ogni riga Python. I loro risultati descrivono quindi questo perimetro di esecuzione, non una scomposizione dettagliata delle allocazioni, del dispatch e del calcolo.
Il warm-up esegue le operazioni prima di registrare le durate. Qui sono escluse le 20 chiamate di warm-up; le mediane sono calcolate su 50 campioni di 20 chiamate. I due numeri 20 non hanno lo stesso ruolo: il primo riguarda la preparazione, il secondo il raggruppamento delle chiamate misurate.
La mediana descrive il centro delle osservazioni ordinate, a differenza della media che somma le durate e poi le divide per il loro numero. Da sola non descrive i ritardi peggiori né la variabilità completa.
docker compose run --rm gpu python -m rmsnorm_kernel.cli benchmark --config configs/minimum.yaml
Le osservazioni del percorso
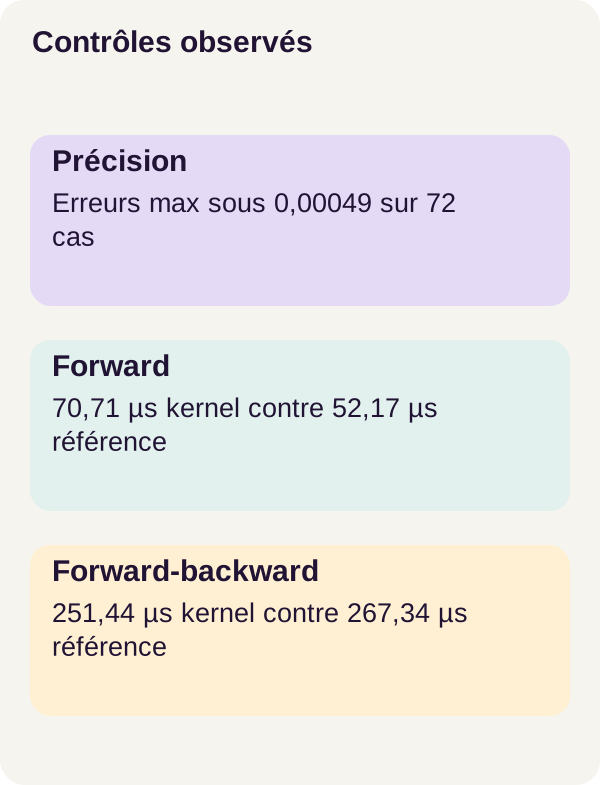
Le latenze seguenti sono misurazioni locali osservate su una RTX 3090, per la forma 128 × 257 in FP32. Le tre righe di errore riassumono ciascuna la propria campagna di 72 casi; questa tabella non ripartisce tali massimi per dtype. Non attribuite loro un caso individuale non indicato nel riepilogo.
Queste cifre non predicono il kernel migliore per un'altra forma, un'altra scheda, un confronto con torch.compile o un altro perimetro di cronometraggio.
Su mobile, scorrete la tabella orizzontalmente.
| Controllo osservato | Risultato |
|---|---|
| Errore assoluto max forward, 72 casi | 0,00024414 |
| Errore assoluto max dx, 72 casi | 0,00048828 |
| Errore assoluto max dgamma, 72 casi | 0,00012207 |
| Mediana riferimento forward | 52,17 µs |
| Mediana kernel forward | 70,71 µs |
| Mediana riferimento forward + backward | 267,34 µs |
| Mediana kernel forward + backward | 251,44 µs |
L'integrazione produce un errore iniziale di output, o output, di 1,19e-7 e di gradiente di 5,96e-8. Dopo 100 passi, le vie riferimento e kernel hanno una MSE test di circa 0,30670 e un ricaricamento con scarto nullo. La MSE è la media degli scarti al quadrato tra previsioni e obiettivi: non è una percentuale di successo. La via kernel ha eseguito effettivamente 100 forward e 100 backward.
Questi controlli riguardano la piccola rete e i suoi dati sintetici. Non misurano un miglioramento della comprensione di un modello linguistico, né una qualità aziendale.
Il forward e il percorso di addestramento non raccontano la stessa cosa
La tabella seguente contiene solo differenze calcolate dalle mediane pubblicate sopra, non nuove misurazioni. La percentuale divide la differenza di durata per la mediana del riferimento.
| Perimetro | Differenza kernel − riferimento | Variazione di durata |
|---|---|---|
| Solo forward | 70,71 − 52,17 = +18,54 µs |
Circa +35,54 % |
| Forward + backward | 251,44 − 267,34 = −15,90 µs |
Circa −5,95 % |
Il forward isolato è quindi più lento per questa forma misurata. La coppia forward-backward è più veloce in questo perimetro. Un risultato può essere numericamente corretto senza guadagnare latenza in tutti gli usi.
Non deduciamo un «tempo puro del backward» sottraendo due mediane di percorsi distinti. Non attribuiamo nemmeno lo scarto a una causa precisa senza profilazione aggiuntiva. I numeri forniti non dettagliano questa attribuzione né la dispersione completa dei tempi.
Per un'applicazione che esegue solo previsioni, il forward conta direttamente. Per un ciclo di apprendimento, forward e backward contano entrambi, ma non rappresentano comunque da soli l'intera rete, l'ottimizzatore e il caricamento dei dati. La conclusione deve restare legata al lavoro realmente cronometrato.
Cosa abbiamo imparato
Siamo partiti da una media di quadrati e abbiamo costruito un percorso completo: un riferimento leggibile, un forward Triton, un backward degli input, una riduzione per il peso condiviso e un collegamento Autograd usato durante l'addestramento.
La correttezza dipende da dettagli che poche righe di formula possono nascondere. N descrive i dati; BLOCK descrive il lavoro del programma GPU. La maschera impedisce accessi fuori dalla riga, ma non corregge un denominatore errato. La conversione FP32 protegge i calcoli intermedi nel perimetro scelto; il contratto di contiguità protegge le ipotesi di indirizzamento.
Il gradiente di gamma ci ha anche obbligati a scegliere un'organizzazione della memoria: contributi privati, poi una somma per colonna. Questa scelta evita l'accumulo concorrente diretto, al prezzo di uno scratch limitato.
Infine, ogni prova mantiene il proprio perimetro. Il gradcheck convalida il riferimento float64; i confronti numerici valutano il kernel FP32/FP16; addestramento e ricaricamento ne verificano l'integrazione. Nessuno di questi controlli estende automaticamente il supporto ad altri dtype, stride o derivate di ordine superiore. E nessuno garantisce un guadagno di velocità universale.
Esercizio: ipotesi prima del comando
Esamineremo un errore molto discreto: sostituire il denominatore N con la larghezza arrotondata del blocco. Nell'esercizio, BLOCK_SIZE designa questa larghezza, chiamata BLOCK nei kernel presentati.
Prima di eseguire il comando, prendete una riga di 257 valori uguali a 1. Qual è la sua somma dei quadrati? Quale media ottenete dividendo per 257, poi per 512? Il denominatore di RMSNorm diventa più grande o più piccolo? E l'ampiezza dell'output?
Ripetete mentalmente il ragionamento con 256 valori. Spiegate perché un test limitato a questa dimensione potrebbe lasciare passare il difetto.
docker compose run --rm gpu python -m rmsnorm_kernel.cli exercise --config configs/exercise.yaml
Confrontate ora lo scenario negativo con la vostra ipotesi. L'esercizio deve rendere osservabile l'errore; non ha lo scopo di sostituire il kernel di riferimento con una variante errata.
Ecco un riferimento aritmetico indipendente, con gamma=1 ed epsilon=1e-6, per verificare il senso della vostra spiegazione. Non sono output acquisiti dal comando:
| Riga di 257 valori uguali a 1 | Divisione corretta per N | Divisione errata per BLOCK |
|---|---|---|
| Somma dei quadrati | 257 | 257 |
| Media usata | 1 | 257 / 512 = 0,501953125 |
| Denominatore con epsilon | Circa 1,0000005 |
Circa 0,708487 |
| Output per coordinata | Circa 0,9999995 |
Circa 1,411458 |
La divisione errata sottostima il denominatore e amplifica eccessivamente l'output. Gli zeri di riempimento non hanno modificato la somma; hanno modificato la media perché sono stati contati a torto. A N=256, N e BLOCK coincidono: questo errore preciso non compare più.
Per completare l'esercizio, spiegate anche perché il backward deve usare lo stesso N logico in mean(u × x). Correggere soltanto il forward non basterebbe a ottenere le derivate corrette.
Adattare il kernel e passare in produzione
L'estensione del contratto richiede prima nuovi test. BF16, stride arbitrari, N superiore a 4096 e double backward non sono capacità acquisite da questo tutorial. BF16 è un altro formato numerico; supportarlo non deriva dal supporto di FP16.
Un double backward calcola derivate dei gradienti. Non significa semplicemente eseguire due fasi di addestramento. Una funzione che consente un primo backward non è automaticamente utilizzabile per queste derivate di ordine superiore. Il wrapper presentato non costituisce una convalida di questo scenario.
Per accettare array più grandi, ridefinite il budget scratch e il piano di riduzione. Per accettare altre disposizioni di memoria, adattate l'indirizzamento agli stride e testatelo. Non limitatevi a rimuovere il rifiuto di check_contract(): tale rimozione non renderebbe vere le ipotesi del kernel.
Un fallback sarebbe un ritorno esplicito al riferimento quando un input non è supportato. Il progetto non ne fornisce uno silenzioso. Aggiungerne uno richiede di definire le condizioni di commutazione, testare entrambi i percorsi e rendere osservabile questa commutazione.
Infine, una messa in produzione richiede forme rappresentative della rete reale, test di carico, una misurazione del perimetro previsto, compatibilità tra driver e compilatore, osservabilità e una strategia di ritorno al riferimento. Il corpus sintetico e un solo host non bastano a stabilire queste proprietà. Ogni confronto con un'altra implementazione deve in particolare mantenere la stessa formula, lo stesso epsilon e requisiti di precisione espliciti.
Risoluzione dei problemi e pulizia
Il forward fallisce soprattutto a N=257. Verificate la divisione per N, la maschera column < N e gli indirizzi che usano row * N. Un risultato corretto a 256 non scagiona una confusione tra dati e blocco di lavoro.
Il forward passa, ma dx diverge. Controllate il termine r³, la media di u × x e l'inverso conservato dal forward. Non cercate anzitutto di regolare l'ottimizzatore: una derivata errata è già un problema prima dell'addestramento.
Solo dgamma diverge o varia. Ispezionate i contributi di partial, la seconda riduzione e il budget scratch. Verificate che si tratti di una somma sulle righe, non di una media.
Un input non contiguo viene rifiutato. Il rifiuto è previsto: il contratto non fornisce un fallback silenzioso. Rendere contiguo dy nel wrapper non modifica le regole applicabili a x e gamma.
Dopo aver conservato le osservazioni, generate le figure, controllate i checkpoint, visualizzate in anteprima la pulizia e poi fermate i servizi. Questi quattro comandi concludono il percorso in questo ordine:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
--dry-run non elimina nulla. Leggete i file che il programma propone di pulire prima di qualsiasi azione distruttiva. L'ultimo comando arresta i servizi di questo progetto Compose; non costituisce una pulizia globale dei vostri ambienti Docker.
Fonti primarie
I riferimenti seguenti approfondiscono i meccanismi. Gli esempi aritmetici di questo articolo sono illustrazioni didattiche; le misurazioni locali restano quelle del percorso r1. I link alla documentazione versionata non sostituiscono le dipendenze dello ZIP né impongono di modificarne la versione.
- RMSNorm — articolo originale : principio della normalizzazione senza sottrazione della media.
- Triton — tutorial LayerNorm : contesto delle riduzioni e del backward di normalizzazione.
- PyTorch — Autograd : meccanismo di differenziazione automatica.
- NVIDIA Container Toolkit — guida di installazione : accesso alla GPU da Docker.
Per scoprire la programmazione Triton, iniziate dal suo esempio di addizione di vettori. Per rileggere il contratto matematico, consultate anche RMSNorm in PyTorch.
Per il collegamento alla rete, le pagine Extending PyTorch, gradcheck e Tensor.contiguous completano la lettura del wrapper.
Per interpretare le misurazioni, tenete a portata di mano torch.allclose, la nota sulla precisione numerica e la documentazione degli eventi CUDA.