





Puede que ya haya optimizado un proceso web que recorría varias veces la misma tabla. La idea parecía sencilla: agrupar las operaciones para evitar trabajo intermedio. Pero antes de comparar los tiempos, había que comprobar que la nueva versión seguía dando el mismo resultado.
Seguiremos este enfoque dentro de una red neuronal. Nuestra operación se llama RMSNorm: vuelve a escalar listas de números. Partiremos de una versión de PyTorch fácil de leer y después agruparemos su cálculo en un kernel de Triton, una función que se ejecuta en la GPU. Nos espera una dificultad adicional: durante el entrenamiento no basta con obtener la salida correcta. También hay que calcular los gradientes correctos.
Descargar el proyecto completo
El recorrido culmina en una RMSNorm conectada a Autograd, utilizada en una red pequeña que se entrena y luego se vuelve a cargar de verdad. Su objetivo es comprobar el cálculo en un ámbito preciso, no demostrar que «Triton siempre es más rápido». Examinaremos por separado la corrección numérica y la latencia.
Problema y fórmula de referencia
¿Qué normalizamos exactamente?
Una red transforma sus entradas en secuencias de números intermedios: son sus activaciones. Cambian de un ejemplo a otro. Los pesos, en cambio, son los parámetros que el entrenamiento ajusta para modificar el comportamiento de la red.
Normalizar las activaciones consiste aquí en controlar su escala. No corregimos ni una cadena de caracteres ni el formato de un documento: aplicamos una transformación numérica dentro del modelo.
En este proyecto, la entrada x es una tabla bidimensional, llamada tensor. Un tensor puede tener más dimensiones, pero aquí nos limitamos a una matriz de M filas y N columnas. Cada fila se normaliza independientemente de las demás.
| Objeto | Forma en este tutorial | Cómo leerlo |
|---|---|---|
x |
M × N |
M filas de activaciones, con N números por fila. |
gamma |
N |
Un peso por columna, compartido entre todas las filas. |
r |
Un número por fila | El inverso de la medida de escala calculada para esa fila. |
y |
M × N |
Las activaciones obtenidas tras normalizar y multiplicar por gamma. |
RMS significa root mean square, es decir, «raíz de la media de los cuadrados». Elevar al cuadrado evita que los valores positivos y negativos se anulen. La media tiene en cuenta la longitud de la fila; la raíz nos devuelve una medida de escala.
Para una fila, la fórmula de referencia es:
r = 1 / sqrt(mean(x²) + epsilon)
y = x × r × gamma
Las multiplicaciones se realizan coordenada a coordenada. r es común a toda la fila, pero cada columna posee su propio gamma. El pequeño número epsilon, fijado en 1e-6 en las funciones presentadas, se añade antes de la raíz cuadrada. Evita, entre otras cosas, una división por cero en una fila completamente nula.
Hagamos el cálculo con dos valores
Tomemos x = [3, 4], gamma = [1, 1] y epsilon = 1e-6. Este ejemplo es una ilustración aritmética, no una fila extraída de las mediciones de GPU.
| Paso | Cálculo | Resultado aproximado |
|---|---|---|
| Cuadrados | [3², 4²] |
[9, 16] |
| Media de los cuadrados | (9 + 16) / 2 |
12,5 |
| Denominador estabilizado | sqrt(12,5 + 0,000001) |
3,535534 |
Inverso r |
1 / 3,535534 |
0,282843 |
| Salida | [3 × r, 4 × r] |
[0,848528 ; 1,131371] |
Hemos conservado la proporción entre los dos valores, al tiempo que cambiamos su escala. La segunda salida supera 1: normalizar no significa limitar cada número entre 0 y 1.
Cambiemos solamente gamma a [2, 0.5]. La salida pasa a ser aproximadamente [1,697056 ; 0,565685]. Estos pesos permiten a la red ajustar por separado la importancia de las coordenadas tras el reescalado. Por tanto, no son un simple ajuste cosmético.
A diferencia de LayerNorm, RMSNorm no resta la media de la fila. En nuestro ejemplo, ambas salidas siguen siendo positivas: su media no es nula. El artículo original sobre RMSNorm presenta esta diferencia; la documentación de RMSNorm en PyTorch también da su fórmula. No obstante, nuestra comparación utilizará la referencia escrita en este tutorial, con sus elecciones explícitas de precisión y epsilon.
¿Por qué necesitamos una ida y una vuelta?
El forward, o pasada hacia delante, calcula y a partir de x y gamma. Durante el entrenamiento, la red produce después una predicción, comparada con un objetivo mediante una pérdida: un número que se busca reducir.
El backward, o retropropagación, hace circular los gradientes en sentido inverso. Un gradiente mide la sensibilidad de la pérdida a una pequeña variación de un valor. No actualiza los pesos por sí mismo: el optimizador lo utiliza para hacerlo.
En la entrada del backward de RMSNorm, dy significa «gradiente de la pérdida con respecto a y». No es ni la diferencia y - x, ni directamente el error entre la predicción y el objetivo. Las operaciones situadas después de RMSNorm ya han contribuido a su cálculo.
Debemos devolver dos objetos: dx, para continuar la retropropagación hacia la capa anterior, y dgamma, para aprender los pesos de normalización. Con u = dy × gamma, las expresiones que hay que obtener son:
dx = r × u − x × r³ × mean(u × x)
dgamma = sum_filas(dy × x × r)
Detallaremos estas fórmulas al implementarlas. De momento, conserve la diferencia: la media de dx se aplica a las N columnas de una fila, mientras que la suma de dgamma se aplica a las M filas.
PyTorch proporciona operaciones sobre tensores y Autograd organiza sus derivadas. Triton permite escribir el cálculo de GPU con una sintaxis cercana a Python. Un kernel agrupa operaciones que se ejecutarán en la tarjeta; no es un modelo preentrenado. Aquí debemos proporcionar explícitamente su backward para conectarlo con el resto de la red.
Requisitos de Docker y GPU
Debe saber leer una función de Python, manejar tablas y usar un terminal con Docker. No se necesita experiencia previa en programación CUDA para seguir las explicaciones.
El recorrido validado requiere Linux x86_64, Docker con Compose, NVIDIA Container Toolkit y una RTX 3090 de 24 GiB. Prevea 16 GiB de RAM y 16 GiB de disco, sin contar las capas de Docker compartidas. La memoria de vídeo de la GPU, o VRAM, es distinta de la RAM del sistema. Ningún perfil de CPU sustituye la ejecución CUDA del kernel.
Extraiga el archivo y sitúe su terminal en su raíz. Todos los comandos siguientes parten de ese mismo directorio. Los extractos del artículo muestran las funciones centrales, no archivos autónomos: las importaciones, el contrato completo y las funciones auxiliares permanecen en el proyecto descargable.
setup.sh crea los directorios locales y escribe solamente UID/GID en .env: estos identificadores sirven para gestionar los permisos de los archivos. Aquí acquire no descarga ni un modelo preentrenado ni un conjunto de datos externo. Los datos serán sintéticos; outputs/ recibe las comprobaciones y artifacts/ los checkpoints, es decir, los estados guardados de la red. Las dependencias se resuelven y verifican durante el build.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose config --quiet comprueba la configuración de Compose. El build prepara los servicios acquire y gpu. Por último, check_environment.py inicializa CUDA en el contenedor y ejecuta un cálculo: ver una tarjeta desde Linux no basta para demostrar que puede utilizarse desde Docker.
Si esta última comprobación falla, deténgase en este paso y revise la integración con la guía de NVIDIA Container Toolkit. No cambie la fórmula de RMSNorm para sortear un problema de entorno. La reutilización de capas de Docker puede modificar el tiempo de build; no cambia el cálculo numérico que queremos comparar.
Comprobar las protecciones antes del kernel
Antes de optimizar una función web, conservaría pruebas sobre sus entradas y sus salidas. Hacemos lo mismo con el cálculo de GPU, añadiendo la comprobación de los gradientes y de la organización de memoria.
La suite pública cubre tamaños irregulares, el contrato de memoria, los casos negativos y las comprobaciones de gradientes. Un caso negativo es una entrada que debe rechazarse, o una variante errónea que la prueba debe saber detectar. Por tanto, detectar correctamente un error esperado es un éxito de la prueba.
docker compose run --rm gpu python -m pytest -q
La suite debe terminar sin fallos antes de las mediciones o del entrenamiento. Este éxito se refiere al código y a los casos del proyecto: no transforma nuestro operador en un kernel universal que acepte cualquier tamaño, cualquier tipo numérico o cualquier disposición de memoria.
Referencia de PyTorch: el oráculo numérico
Un oráculo de prueba es simplemente una versión con la que se compara la implementación estudiada. Nuestra referencia prioriza la legibilidad: podemos relacionar cada línea de Python con la fórmula anterior.
El dtype es el tipo numérico de un tensor. FP16, FP32 y FP64 designan números de coma flotante almacenados en 16, 32 y 64 bits. Sus precisiones no son idénticas. La referencia trabaja en float64 si la entrada ya está en float64; de lo contrario, en FP32; después reconvierte la salida al tipo de la entrada.
def rmsnorm_reference(x, gamma, epsilon=1e-6):
    dtype = torch.float64 if x.dtype == torch.float64 else torch.float32
    xf = x.to(dtype)
    gf = gamma.to(dtype)
    r = torch.rsqrt(xf.square().mean(-1, keepdim=True) + epsilon)
    return (xf * r * gf).to(x.dtype)


def manual_backward(x, gamma, dy, epsilon=1e-6):
    r = torch.rsqrt(x.square().mean(-1, keepdim=True) + epsilon)
    u = dy * gamma
    dx = r * u - x * r.pow(3) * (u * x).mean(-1, keepdim=True)
    dgamma = (dy * x * r).sum(0)
    return dx, dgamma
Leer el forward, línea a línea
xf y gf son las versiones de trabajo de x y gamma, convertidas al tipo elegido. square() calcula los cuadrados. mean(-1, keepdim=True) calcula la media en el último eje, es decir, en las columnas.
¿Por qué conservar la dimensión con keepdim=True? Para una entrada M × N, la media tiene la forma M × 1. Así, cada fila conserva su propio número, que PyTorch puede multiplicar por todas las columnas de esa misma fila. Esta extensión automática de forma se llama broadcasting. gamma, de forma N, se reutiliza por su parte en todas las filas.
torch.rsqrt(a) calcula 1 / sqrt(a). Por tanto, la última línea aplica exactamente x × r × gamma y luego devuelve el dtype inicial. Calcular temporalmente en FP32 no significa que la salida se mantendrá en FP32 si la entrada estaba en FP16.
Una fórmula de backward independiente y legible
manual_backward() expresa las dos derivadas sin pasar por Triton. Su interés es confrontar una fórmula explícita con los gradientes producidos por Autograd.
A diferencia de rmsnorm_reference(), esta función no convierte explícitamente sus entradas a un tipo más preciso. Por tanto, debe leerse con los dtypes de sus argumentos; por sí sola no es una receta de reducción FP32 para tensores FP16. El kernel, en cambio, hará visible esta conversión en sus cargas.
El gradcheck añade otra verificación: perturba ligeramente las entradas y compara la variación numérica de la salida con la derivada calculada. Para entender la idea, la pendiente de una función escalar puede estimarse mediante (f(a + h) - f(a - h)) / (2 × h), con un h pequeño. La documentación de gradcheck precisa, en particular, el papel de la doble precisión en sus ajustes habituales.
En este recorrido, el gradcheck float64 se refiere a la referencia de PyTorch, no al kernel de Triton FP32/FP16. La comparación del kernel llegará en comprobaciones separadas. Esta distinción evita atribuir a un programa una prueba ejecutada sobre otro.
Genere ahora esta comprobación de referencia y las tres particiones sintéticas:
docker compose run --rm gpu python -m rmsnorm_kernel.cli reference --config configs/minimum.yaml
Las particiones separan los datos destinados al entrenamiento, la validación y la prueba. El detalle de su generación pertenece al proyecto; no se necesita ningún dato de negocio ni modelo externo para estudiar esta operación.
Forward de Triton: una fila, un programa
El contrato de memoria forma parte del cálculo
Imagine una función que acepta una tabla rectangular, pero recorre su memoria como si todas las filas estuvieran almacenadas una tras otra. Sería incorrecta sobre una vista cuyos elementos están espaciados de otra manera, aunque las dimensiones mostradas parezcan correctas.
Un tensor contiguo posee aquí la disposición compacta que espera el kernel. Los strides describen los saltos necesarios en memoria para avanzar una fila o una columna. Una transposición puede, por ejemplo, producir una vista no contigua sin mover todos los números.
Antes de escribir en las salidas, el contrato del proyecto rechaza las entradas no contiguas, los dtypes distintos de FP32/FP16, dispositivos diferentes, un epsilon no válido, N superior a 4096 y un espacio temporal, o scratch, superior a 64 MiB. El cuerpo de check_contract() no se reproduce a continuación: conserve las verificaciones del archivo completo.
@triton.jit
def rmsnorm_forward_kernel(
    X, G, Y, R, N: tl.constexpr, EPS: tl.constexpr, BLOCK: tl.constexpr
):
    row = tl.program_id(0)
    column = tl.arange(0, BLOCK)
    x = tl.load(X + row * N + column, column < N, other=0).to(tl.float32)
    gamma = tl.load(G + column, column < N, other=0).to(tl.float32)
    inverse = tl.rsqrt(tl.sum(x * x, 0) / N + EPS)
    y = x * inverse * gamma
    tl.store(Y + row * N + column, y, column < N)
    tl.store(R + row, inverse)


def forward_op(x, gamma, epsilon=1e-6):
    check_contract(x, gamma, epsilon)
    m, n = x.shape
    y = torch.empty_like(x)
    inverse = torch.empty(m, device=x.device, dtype=torch.float32)
    rmsnorm_forward_kernel[(m,)](
        x, gamma, y, inverse, n, epsilon, triton.next_power_of_2(n)
    )
    return y, inverse
¿Quién calcula cada fila?
La parte de Python forward_op() controla las entradas, reserva las salidas y después inicia el kernel con la cuadrícula [(m,)]. Así solicitamos M instancias del programa Triton, una por fila.
tl.program_id(0) da a cada instancia su número de fila. Este número no representa ni un proceso de Docker ni una tarjeta gráfica adicional. tl.arange(0, BLOCK) construye las posiciones de columnas que se tratan juntas. El primer tutorial de Triton presenta este modelo de programación y sus máscaras de memoria.
X + row * N + column designa los valores de la fila deseada. La fórmula utiliza N porque las filas reales contienen N valores. No usa el tamaño redondeado BLOCK para pasar a la fila siguiente.
El decorador @triton.jit confía la compilación del kernel a Triton. Los parámetros marcados como tl.constexpr se conocen al especializarlo: describen, entre otras cosas, las dimensiones del bloque y las constantes de este cálculo, no pesos aprendidos.
N y BLOCK: dos tamaños que nunca deben confundirse
triton.next_power_of_2(n) elige una anchura de trabajo igual a la siguiente potencia de dos. Con N=257, el programa maneja por tanto BLOCK=512 posiciones, pero solo las columnas 0 a 256 pertenecen a la fila.
Esto no transforma nuestro tensor en una matriz de 512 columnas. Las posiciones adicionales son lugares de cálculo que deben enmascararse. tl.load(..., column < N, other=0) no lee valores fuera de la fila: los sustituye por cero. tl.store(..., column < N) solo escribe los valores válidos.
¿Por qué cero? No cambia la suma de los cuadrados. Sin embargo, no debe contarse como una observación adicional en la media. La suma debe dividirse por N, y no por BLOCK.
Tomemos un ejemplo más pequeño, distinto de las mediciones: una fila [1, 1, 1] tratada con un bloque de cuatro posiciones. La suma de los cuadrados de [1, 1, 1, 0] sigue siendo 3. Dividir por 3 da la media correcta, 1; dividir por 4 da 0,75. La máscara protege los accesos a memoria, pero no elige por nosotros el denominador correcto.
El mismo defecto es invisible con N=256, pues BLOCK también vale entonces 256. Por eso un tamaño irregular es una prueba útil y no un detalle de presentación.
¿Por qué convertir antes de reducir?
Una reducción transforma varios valores en un resultado, por ejemplo una suma o una media. Aquí, los números se convierten a FP32 desde la carga, antes de los cuadrados y de su suma. Convertir solo después de un cálculo ya redondeado no permitiría recuperar la precisión perdida.
El kernel calcula el inverso RMS, aplica gamma y después escribe y. Y tiene el mismo tipo que x, gracias a torch.empty_like(x); R conserva un inverso por fila, explícitamente en FP32, para el backward. empty_like reserva memoria sin llenarla de ceros: es el kernel quien debe escribir cada salida útil.
Hemos fusionado el forward, pero no eliminado todo almacenamiento intermedio: R es un dato que se conserva deliberadamente entre la ida y la vuelta.
docker compose run --rm gpu python -m rmsnorm_kernel.cli check-forward --config configs/minimum.yaml
Esta comprobación compara el forward con los tamaños previstos, incluidos N que no son potencias de dos. La lección LayerNorm de Triton profundiza en los kernels de normalización y reducción; no sustituye el contrato RMSNorm, más restringido, de este proyecto.
Backward de las entradas: conservar el N correcto
La dificultad: cada valor también influye en el denominador
Para calcular dx, no podemos limitarnos a multiplicar dy por r × gamma. Eso olvidaría que r depende a su vez de toda la fila x.
Volvamos a [3, 4]. Si cambiamos el primer número, cambia su numerador, pero también cambia la suma de los cuadrados. Por tanto, se modifica el denominador común a las dos salidas. El backward debe tener en cuenta este efecto colectivo.
Ese es el papel de los dos términos de la fórmula: r × u describe el efecto directo; −x × r³ × mean(u × x) añade el efecto del cambio de normalización. u = dy × gamma incorpora primero los pesos por columna.
Para ilustrarlo con el mismo ejemplo, volvamos a poner gamma = [1, 1] y elijamos el gradiente ascendente pedagógico dy = [1, 2]. Tenemos u = [1, 2], y después mean(u × x) = (3 + 8) / 2 = 5,5. Con epsilon = 1e-6, la fórmula da aproximadamente:
dx = [-0,090510 ; 0,067882]
El primer gradiente es negativo aunque los valores de dy sean positivos. No es una anomalía: aumentar una entrada puede reducir otras salidas al aumentar su denominador. El gradiente tiene en cuenta todos los caminos mediante los cuales esta entrada influye en la pérdida. Estos números ilustran la fórmula; no son las desviaciones medidas del kernel.
¿De dónde sale el cubo de r?
Esta pequeña derivación es opcional para ejecutar el proyecto, pero hace que el código resulte menos misterioso.
Llamemos s = mean(x²) + epsilon. Puesto que r = s^(-1/2), la derivada de r con respecto a s vale −(1/2) × s^(-3/2), es decir, −r³ / 2. La derivada de s con respecto a una coordenada x_i vale 2 × x_i / N.
Al multiplicar ambas, obtenemos ∂r/∂x_i = −x_i × r³ / N. Falta sumar las contribuciones de todas las salidas que usan ese mismo r, lo que da el segundo término de dx.
Por tanto, el cubo no es un ajuste que deba modificarse hasta que la prueba pase: procede de la derivación del inverso de la raíz cuadrada.
@triton.jit
def rmsnorm_dx_kernel(X, G, DY, R, DX, PARTIAL, N: tl.constexpr, BLOCK: tl.constexpr):
    row = tl.program_id(0)
    column = tl.arange(0, BLOCK)
    x = tl.load(X + row * N + column, column < N, other=0).to(tl.float32)
    gamma = tl.load(G + column, column < N, other=0).to(tl.float32)
    dy = tl.load(DY + row * N + column, column < N, other=0).to(tl.float32)
    inverse = tl.load(R + row)
    u = dy * gamma
    mean_ux = tl.sum(u * x, 0) / N
    dx = inverse * u - x * inverse * inverse * inverse * mean_ux
    tl.store(DX + row * N + column, dx, column < N)
    tl.store(PARTIAL + row * N + column, dy * x * inverse, column < N)


def backward_rows(x, gamma, dy, inverse, epsilon):
    check_contract(x, gamma, epsilon)
    if (
        dy.shape != x.shape
        or dy.dtype != x.dtype
        or dy.device != x.device
        or not dy.is_contiguous()
    ):
        raise ValueError("dy must match x and be contiguous")
    m, n = x.shape
    dx = torch.empty_like(x)
    partial = torch.empty((m, n), device=x.device, dtype=torch.float32)
    rmsnorm_dx_kernel[(m,)](
        x, gamma, dy, inverse, dx, partial, n, triton.next_power_of_2(n)
    )
    return dx, partial
Lo que produce este kernel
El programa carga x, gamma y dy en FP32 y después recupera el inverso guardado en el forward. mean_ux suma u × x y divide, de nuevo, por N. Las columnas enmascaradas no contribuyen a esta suma.
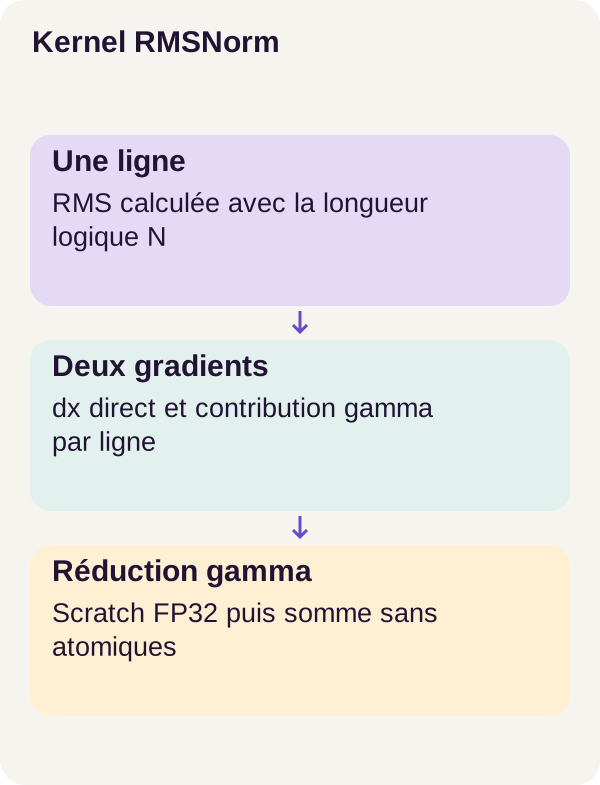
Después escribe dos objetos. DX recibe el gradiente de las entradas, en una salida de la misma forma y el mismo tipo que x. PARTIAL recibe una contribución a dgamma para cada fila y columna: dy × x × inverse. Esta tabla aún no es el gradiente final de gamma; se reducirá en el siguiente paso.
En backward_rows(), la comprobación adicional exige que dy tenga la misma forma, el mismo dtype y el mismo dispositivo que x, y que sea contiguo. El futuro wrapper de Autograd llamará a dy.contiguous() para cumplir esta última condición. Eso no hace aceptables las entradas de usuario x y gamma no contiguas: el contrato sigue rechazándolas.
El inverso es aquí un intermediario interno, producido por forward_op() y conservado para este mismo cálculo. Este extracto no debe interpretarse como una API pública que valida cualquier tensor inverse suministrado desde fuera.
Compruebe ahora dx frente a la referencia:
docker compose run --rm gpu python -m rmsnorm_kernel.cli check-backward --config configs/minimum.yaml
Si el forward es correcto pero dx no lo es, inspeccione la derivada: un forward correcto no garantiza que hayamos implementado correctamente su retorno.
Reducir dgamma sin una condición de carrera de escritura
Un peso compartido recibe varias contribuciones
Cada columna utiliza el mismo peso gamma para todas las filas. Por tanto, su gradiente debe reunir las contribuciones de estas filas. Imagine varias tareas que calculan cada una una parte de un total: se suman sus contribuciones, no se conserva arbitrariamente la última.
Si todos los programas de GPU intentaran modificar la misma celda sin coordinación, tendríamos una condición de carrera de escritura. Una suma atómica puede impedir la pérdida de contribuciones, pero el orden de estas sumas simultáneas puede variar. En aritmética de coma flotante, ese orden puede modificar las últimas cifras del resultado.
El mínimo pedagógico elige otra organización: cada fila escribe en su propia zona de partial, y después una segunda pasada de Triton suma estas contribuciones por columna. Reduce en FP32 antes de convertir el resultado al dtype de gamma. Esta elección evita aquí la acumulación atómica simultánea; no promete una identidad bit a bit en todos los equipos y todas las versiones.
def reduce_gamma_gradient(partial, dtype):
    m, n = partial.shape
    result = torch.empty(n, device=partial.device, dtype=dtype)
    gamma_sum_kernel[(triton.cdiv(n, 32),)](partial, result, m, n, 32, 32)
    return result
result posee N elementos, un gradiente por peso. triton.cdiv(n, 32) es una división redondeada hacia arriba: para N=257, prevé nueve programas. El cuerpo de gamma_sum_kernel no se reproduce en este extracto; la organización completa de esta segunda reducción se lee en el archivo. La función anterior muestra su lanzamiento y el tipo de la salida.
Una suma no es una media
Supongamos, como ejemplo puramente pedagógico, que dos filas ya han producido las siguientes contribuciones:
| Contribución | Columna 0 | Columna 1 |
|---|---|---|
| Fila 0 | 1 | 2 |
| Fila 1 | 3 | 4 |
Suma esperada para dgamma |
4 | 6 |
| Media, que sería incorrecta aquí | 2 | 3 |
No hay división adicional por M en la fórmula de dgamma. Si la pérdida global ya hace una media sobre los ejemplos, esta ponderación se transmite mediante dy. Dividir de nuevo aquí cambiaría el gradiente de la operación.
Con una sola fila, suma y media son idénticas. Con 17 filas, por lo general ya no lo son: por eso los casos M=1 y M=17 son útiles para detectar una confusión.
El precio de esta organización: una tabla temporal
partial contiene M × N números FP32 de cuatro bytes cada uno. Por tanto, su huella es de M × N × 4 bytes.
Para la forma 128 × 257 del benchmark, esto representa 131 584 bytes, es decir, 128,5 KiB. Este cálculo se refiere solo a partial, no a toda la VRAM del programa. Con M=4096 y N=4096, esta misma tabla alcanza 64 MiB; una fila adicional supera este límite.
Estos cálculos explican el presupuesto de scratch: que una anchura N esté permitida no basta para que todas las alturas M sean aceptables. No constituyen una nueva medición de memoria del proyecto.
docker compose run --rm gpu python -m rmsnorm_kernel.cli check-gamma --config configs/minimum.yaml
La comprobación check-gamma completa las verificaciones anteriores: se dirige al gradiente del peso compartido, no solo a los gradientes de las entradas.
Conectar Autograd y entrenar de verdad
Ahora tenemos el forward, dx y dgamma. Falta conectarlos en PyTorch. Ese es el papel de la subclase torch.autograd.Function.
Para un desarrollador web, puede verse como un adaptador: el resto del programa llama a una operación normal, mientras el adaptador sabe cómo delegar su ejecución y su retorno al código especializado. Autograd no es una herramienta que adivina nuestra fórmula de Triton: le proporcionamos explícitamente la regla de backward. La documentación de PyTorch sobre funciones personalizadas describe esta interfaz.
class RMSNormFunction(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x, gamma, epsilon):
        y, inverse = forward_op(x, gamma, epsilon)
        ctx.save_for_backward(x, gamma, inverse)
        ctx.epsilon = epsilon
        CALLS["forward"] += 1
        return y

    @staticmethod
    def backward(ctx, dy):
        x, gamma, inverse = ctx.saved_tensors
        dx, partial = backward_rows(x, gamma, dy.contiguous(), inverse, ctx.epsilon)
        dgamma = reduce_gamma_gradient(partial, gamma.dtype)
        CALLS["backward"] += 1
        return dx, dgamma, None


def rmsnorm(x, gamma, epsilon=1e-6):
    return RMSNormFunction.apply(x, gamma, epsilon)
Lo que conserva ctx
ctx es el contexto de una llamada a la función. En el forward, save_for_backward(x, gamma, inverse) conserva los tensores necesarios para el retorno. epsilon, que no es un tensor aprendido en este contrato, se conserva aparte como atributo.
En el backward recuperamos estos mismos tensores. dy.contiguous() garantiza la disposición compacta del gradiente ascendente: este método devuelve el tensor si ya es adecuado y produce una copia contigua cuando es necesario, como precisa la documentación de contiguous().
backward_rows() calcula dx y las contribuciones intermedias. reduce_gamma_gradient() las suma. Por último, return dx, dgamma, None responde a los tres argumentos de entrada, en el mismo orden: un gradiente para x, uno para gamma y ninguno para epsilon.
Este None no significa que epsilon no tenga ningún efecto matemático en la salida. Significa que este parámetro no se diferencia mediante nuestra interfaz.
Los gradientes todavía no son actualizaciones
No aparece ninguna llamada a un optimizador en esta clase. Calcula las salidas y devuelve los gradientes; el bucle de entrenamiento exterior utiliza después Adam para modificar los parámetros. Los contadores CALLS registran los pasos por el wrapper, no el número exacto de lanzamientos de GPU: aquí, un backward llama al cálculo por fila y luego a la reducción de gamma.
La pequeña red comparada es Linear → RMSNorm → SiLU → Linear. Una capa Linear combina las entradas con pesos; SiLU añade una transformación no lineal. Ambas vías parten de inicializaciones idénticas: comparamos así la referencia y el kernel sin darles puntos de partida diferentes.
El recorrido entrena 100 pasos con Adam y 32 ejemplos por paso, vuelve a cargar los pesos y luego comprueba que la vía del kernel ha llamado a forward y backward 100 veces. Esta comprobación evita en particular validar un entrenamiento que se hubiera mantenido por error en la vía de referencia.
docker compose run --rm gpu python -m rmsnorm_kernel.cli train-integration --config configs/minimum.yaml
La integración comprueba que nuestra operación participa realmente en un aprendizaje. La recarga también comprueba los pesos guardados. No es la misma afirmación que una reanudación completa tras una interrupción con restauración de todo el estado del optimizador; este segundo escenario no se anuncia aquí.
Mediciones antes de los resultados
Tres comparaciones numéricas distintas
Las comprobaciones cubren 72 casos cada una para el forward, dx y dgamma. Por tanto, comparamos las salidas, los gradientes de las entradas y los de los pesos: tres objetos distintos.
Las tolerancias declaradas son atol=1e-5, rtol=1e-4 en FP32, y atol=rtol=3e-3 en FP16. Atol es un margen absoluto; rtol añade un margen proporcional al valor de referencia.
Para leer estos parámetros, la regla de proximidad de torch.allclose se escribe, elemento a elemento:
abs(valor - referencia) ≤ atol + rtol × abs(referencia)
Con las tolerancias FP32, una referencia igual a 1 permite una diferencia de 0,00011. Una referencia igual a 100 permite 0,01001. Estos ejemplos explican el cálculo; no son casos capturados en la campaña.
Por tanto, un máximo de error absoluto no basta por sí solo para concluir que se ha superado una tolerancia relativa. Hay que conocer el dtype, el valor de referencia y el resultado de la comprobación correspondiente. A la inversa, una media de error pequeña no permitiría ignorar un elemento que falla.
¿Por qué no exigir siempre cero? Los números de coma flotante tienen una precisión limitada y el orden de las operaciones puede modificar los redondeos, incluso para expresiones matemáticamente equivalentes. La nota de PyTorch sobre precisión numérica describe este límite. Mantenemos tolerancias declaradas antes de la comparación, en lugar de ampliarlas tras ver un error.
¿Qué tiempo mide el benchmark?
El protocolo coloca eventos CUDA alrededor de llamadas completas. Conserva las asignaciones, el paso por Autograd y los lanzamientos asociados; no reduce la medición al solo cuerpo del kernel de Triton.
Conviene una precisión: los eventos CUDA miden un intervalo en la cronología de la GPU. No son cronómetros que asignen por separado un coste de CPU a cada línea de Python. Por tanto, sus resultados describen este ámbito de ejecución, no una descomposición detallada de las asignaciones, el dispatch y el cálculo.
El calentamiento ejecuta las operaciones antes de conservar las duraciones. Aquí se excluyen las 20 llamadas de calentamiento; las medianas se calculan sobre 50 muestras de 20 llamadas. Los dos números 20 no tienen el mismo papel: el primero se refiere a la preparación, el segundo a la agrupación de las llamadas medidas.
La mediana describe el centro de las observaciones ordenadas, a diferencia de la media, que suma las duraciones y luego divide por su número. Por sí sola no describe los peores retrasos ni la variabilidad completa.
docker compose run --rm gpu python -m rmsnorm_kernel.cli benchmark --config configs/minimum.yaml
Las observaciones del recorrido
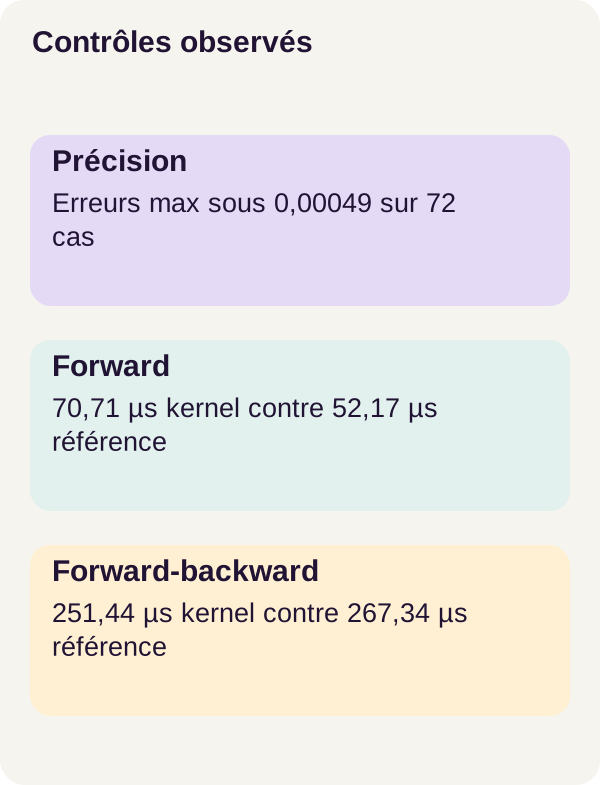
Las siguientes latencias son mediciones locales observadas en una RTX 3090, para la forma 128 × 257 en FP32. Las tres líneas de error resumen cada una su campaña de 72 casos; esta tabla no desglosa estos máximos por dtype. No les atribuya un caso individual que no se indique en el resumen.
Estas cifras no predicen el mejor kernel para otra forma, otra tarjeta, una comparación con torch.compile u otro ámbito de temporización.
En móvil, desplácese horizontalmente por la tabla.
| Comprobación observada | Resultado |
|---|---|
| Error absoluto máximo forward, 72 casos | 0,00024414 |
| Error absoluto máximo dx, 72 casos | 0,00048828 |
| Error absoluto máximo dgamma, 72 casos | 0,00012207 |
| Mediana referencia forward | 52,17 µs |
| Mediana kernel forward | 70,71 µs |
| Mediana referencia forward + backward | 267,34 µs |
| Mediana kernel forward + backward | 251,44 µs |
La integración da un error inicial de salida, o output, de 1,19e-7 y de gradiente de 5,96e-8. Tras 100 pasos, las vías de referencia y del kernel tienen una MSE de prueba de aproximadamente 0,30670 y una recarga con diferencia nula. La MSE es la media de las diferencias al cuadrado entre predicciones y objetivos: no es un porcentaje de éxito. La vía del kernel ha ejecutado efectivamente 100 forwards y 100 backwards.
Estas comprobaciones se aplican a la pequeña red y a sus datos sintéticos. No miden una mejora de comprensión de un modelo de lenguaje ni una calidad de negocio.
El forward y el recorrido de entrenamiento no cuentan lo mismo
La siguiente tabla contiene solo diferencias calculadas a partir de las medianas publicadas arriba, no nuevas mediciones. El porcentaje divide la diferencia de duración por la mediana de la referencia.
| Ámbito | Diferencia kernel − referencia | Variación de duración |
|---|---|---|
| Solo forward | 70,71 − 52,17 = +18,54 µs |
Aproximadamente +35,54 % |
| Forward + backward | 251,44 − 267,34 = −15,90 µs |
Aproximadamente −5,95 % |
Por tanto, el forward aislado es más lento para esta forma medida. El conjunto forward-backward es más rápido en este ámbito. Un resultado puede ser numéricamente correcto sin ganar en latencia en todos los usos.
No deducimos un «tiempo puro del backward» restando dos medianas de recorridos distintos. Tampoco atribuimos la diferencia a una causa precisa sin perfilado adicional. Los números proporcionados no detallan esta atribución ni la dispersión completa de los tiempos.
Para una aplicación que solo hace predicciones, el forward cuenta directamente. Para un bucle de aprendizaje, forward y backward cuentan ambos, pero aún no representan por sí solos la red completa, el optimizador y la carga de datos. La conclusión debe seguir ligada al trabajo realmente cronometrado.
Lo que hemos aprendido
Hemos partido de una media de cuadrados y construido un camino completo: una referencia legible, un forward de Triton, un backward de las entradas, una reducción para el peso compartido y una conexión de Autograd utilizada durante el entrenamiento.
La corrección depende de detalles que unas pocas líneas de fórmula pueden ocultar. N describe los datos; BLOCK describe el trabajo del programa de GPU. La máscara impide los accesos fuera de la fila, pero no corrige un denominador erróneo. La conversión a FP32 protege los cálculos intermedios en el ámbito elegido; el contrato de contigüidad protege las hipótesis de direccionamiento.
El gradiente de gamma también nos obligó a elegir una organización de memoria: contribuciones privadas y después una suma por columna. Esta elección evita la acumulación simultánea directa, a costa de un scratch limitado.
Por último, cada prueba conserva su ámbito. El gradcheck valida la referencia float64; las comparaciones numéricas evalúan el kernel FP32/FP16; el entrenamiento y la recarga comprueban su integración. Ninguna de estas comprobaciones amplía automáticamente el soporte a otros dtypes, strides o derivadas de orden superior. Y ninguna garantiza una ganancia de velocidad universal.
Ejercicio: hipótesis antes del comando
Examinaremos un error muy discreto: sustituir el denominador N por la anchura redondeada del bloque. En el enunciado, BLOCK_SIZE designa esta anchura, llamada BLOCK en los kernels presentados.
Antes de ejecutar el comando, tome una fila de 257 valores iguales a 1. ¿Cuál es su suma de cuadrados? ¿Qué media obtiene al dividir por 257 y después por 512? ¿El denominador de RMSNorm se vuelve mayor o menor? ¿Y la amplitud de la salida?
Repita mentalmente el razonamiento con 256 valores. Explique por qué una prueba limitada a este tamaño podría dejar pasar el defecto.
docker compose run --rm gpu python -m rmsnorm_kernel.cli exercise --config configs/exercise.yaml
Compare ahora el escenario negativo con su hipótesis. El ejercicio debe hacer observable el error; no pretende sustituir el kernel de referencia por una variante incorrecta.
Aquí tiene una referencia aritmética independiente, con gamma=1 y epsilon=1e-6, para comprobar el sentido de su explicación. No son salidas capturadas del comando:
| Fila de 257 valores iguales a 1 | División correcta por N | División errónea por BLOCK |
|---|---|---|
| Suma de los cuadrados | 257 | 257 |
| Media utilizada | 1 | 257 / 512 = 0,501953125 |
| Denominador con epsilon | Aproximadamente 1,0000005 |
Aproximadamente 0,708487 |
| Salida por coordenada | Aproximadamente 0,9999995 |
Aproximadamente 1,411458 |
La división errónea subestima el denominador y amplifica demasiado la salida. Los ceros de relleno no han cambiado la suma; han cambiado la media porque se contaron incorrectamente. Con N=256, N y BLOCK coinciden: este error preciso ya no aparece.
Para completar el ejercicio, explique también por qué el backward debe usar el mismo N lógico en mean(u × x). Corregir únicamente el forward no bastaría para obtener las derivadas correctas.
Adaptar el kernel y pasar a producción
Ampliar el contrato requiere primero nuevas pruebas. BF16, strides arbitrarios, N superior a 4096 y double backward no son capacidades adquiridas por este tutorial. BF16 es otro formato numérico; admitirlo no se deduce del soporte de FP16.
Un double backward calcula derivadas de los gradientes. No significa simplemente realizar dos pasos de entrenamiento. Una función que permite un primer backward no es automáticamente utilizable para estas derivadas de orden superior. El wrapper presentado no constituye una validación de este escenario.
Para aceptar tablas más grandes, redefina el presupuesto de scratch y el plan de reducción. Para aceptar otras disposiciones de memoria, adapte el direccionamiento a los strides y pruébelo. No se limite a eliminar el rechazo de check_contract(): esa eliminación no haría verdaderas las hipótesis del kernel.
Un fallback sería un retorno explícito a la referencia cuando una entrada no es compatible. El proyecto no proporciona uno silencioso. Añadirlo requiere definir las condiciones de cambio, probar ambas rutas y hacer observable este cambio.
Por último, una puesta en producción exige formas representativas de la red real, pruebas de carga, una medición del ámbito previsto, compatibilidad de controlador/compilador, observabilidad y una estrategia de retorno a la referencia. El corpus sintético y un solo host no bastan para establecer estas propiedades. Cualquier comparación con otra implementación debe conservar en particular la misma fórmula, el mismo epsilon y requisitos de precisión explícitos.
Resolución de problemas y limpieza
El forward falla sobre todo con N=257. Compruebe la división por N, la máscara column < N y las direcciones que usan row * N. Un resultado correcto con 256 no exculpa una confusión entre los datos y el bloque de trabajo.
El forward pasa, pero dx diverge. Controle el término r³, la media de u × x y el inverso conservado desde el forward. No intente primero ajustar el optimizador: una derivada errónea ya es un problema antes del entrenamiento.
Solo dgamma diverge o varía. Inspeccione las contribuciones de partial, la segunda reducción y el presupuesto de scratch. Compruebe que se trata de una suma sobre las filas y no de una media.
Se rechaza una entrada no contigua. El rechazo es esperado: el contrato no proporciona un fallback silencioso. Hacer contiguo dy en el wrapper no modifica las reglas aplicables a x y gamma.
Una vez conservadas las observaciones, genere las figuras, compruebe los checkpoints, previsualice la limpieza y después detenga los servicios. Estos cuatro comandos terminan el recorrido en este orden:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
--dry-run no elimina nada. Lea los archivos que el programa propone limpiar antes de cualquier acción destructiva. El último comando detiene los servicios de este proyecto Compose; no constituye una purga global de sus entornos Docker.
Fuentes primarias
Las referencias siguientes profundizan en los mecanismos. Los ejemplos aritméticos de este artículo son ilustraciones pedagógicas; las mediciones locales siguen siendo las del recorrido r1. Los enlaces de documentación versionados no sustituyen las dependencias del ZIP ni obligan a cambiar su versión.
- RMSNorm — artículo original: principio de la normalización sin restar la media.
- Triton — tutorial de LayerNorm: contexto de las reducciones y del backward de normalización.
- PyTorch — Autograd: mecanismo de diferenciación automática.
- NVIDIA Container Toolkit — guía de instalación: acceso a la GPU desde Docker.
Para descubrir la programación con Triton, empiece por su ejemplo de suma de vectores. Para revisar el contrato matemático, consulte también RMSNorm en PyTorch.
Para la conexión con la red, las páginas Extending PyTorch, gradcheck y Tensor.contiguous completan la lectura del wrapper.
Para interpretar las mediciones, tenga a mano torch.allclose, la nota sobre precisión numérica y la documentación de los eventos CUDA.