





Vous devez ajouter un import de tableaux PDF à une application web. Vous commencez par extraire le texte : les mots sont là, les nombres aussi. Pourtant, une fois les données placées dans un tableur, un montant se retrouve dans la mauvaise colonne, un en-tête apparaît deux fois et une case vide a disparu. L’extraction a réussi à lire le texte, mais pas à retrouver son organisation.
C’est le problème que nous allons explorer avec le rapport fictif Helix Quarterly Ledger. Son tableau contient un en-tête « Quarter 1 » fusionné sur deux colonnes, des décimaux et une cellule volontairement vide. Pour le reconstruire, nous devons répondre à deux questions différentes : où sont les cellules, puis quels mots appartiennent à chacune ?
Nous allons adapter Table Transformer pour la reconnaissance de structure, ou TATR, puis utiliser du Python pour reconstruire la grille et y rattacher les mots du PDF. Le modèle repère des objets visuels ; le code les transforme en un tableau exploitable, avec des exports HTML, CSV et JSON de provenance.
Télécharger le projet complet du tutoriel r003
Le parcours et les résultats de référence sont ceux du projet r003. Les petits exemples numériques ajoutés pour comprendre les calculs sont explicitement pédagogiques : ils ne constituent pas de nouvelles mesures du modèle. De même, les figures illustrent le mécanisme et les résultats observés, pas une validation sur vos propres documents.
Ce que nous allons construire
Une région de tableau en entrée, pas une page à explorer
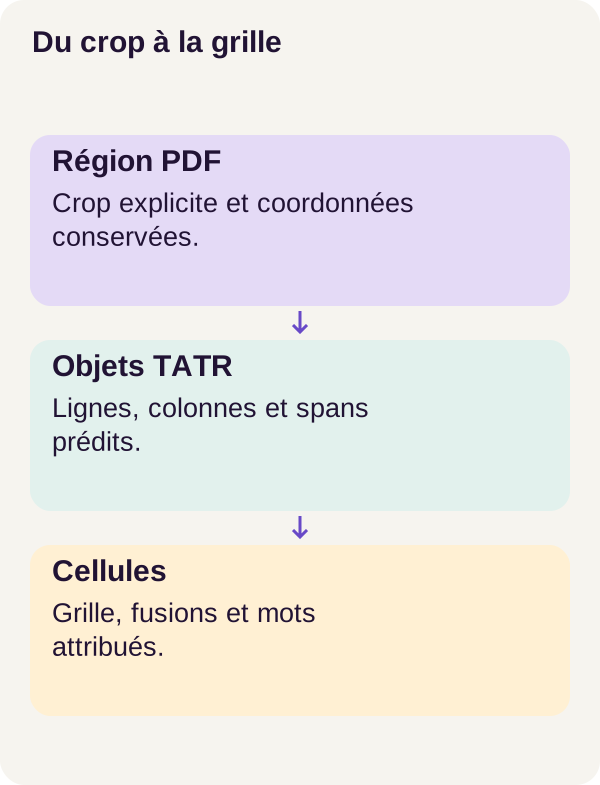
L’entrée est un PDF natif, c’est-à-dire un document dont le texte est directement extractible, accompagné d’un rectangle déclaré dans data/regions.json. Ce rectangle indique la région à traiter. Une image de cette région, appelée crop, est fournie au modèle.
Le projet ne cherche pas automatiquement les tableaux sur une page entière. On lui indique où regarder, puis on évalue sa capacité à comprendre la structure de ce qui se trouve dans cette zone. Retrouver le tableau dans la page serait une étape supplémentaire, avec ses propres erreurs à mesurer.
À partir du crop, TATR prédit six types d’objets : table, colonne, ligne, en-tête de colonne, en-tête projeté et cellule fusionnée. Chaque objet est associé à une boîte et à un score. Le code présenté plus loin exploite les lignes, les colonnes et les cellules fusionnées pour construire la grille ; toutes les catégories prédites ne jouent donc pas le même rôle dans cet extrait.
Le nom « Transformer » ne signifie pas que nous allons demander à un chatbot de rédiger un tableau. Ici, il s’agit d’un modèle de détection visuelle. La documentation Table Transformer distingue bien la détection d’un tableau et la reconnaissance de sa structure.
Deux chemins qui se rejoignent
D’un côté, l’image de la région permet de prédire des lignes, des colonnes et des fusions. De l’autre, le texte natif fournit des mots avec leurs coordonnées. Le programme rassemble ces deux informations : il crée les cellules, puis associe chaque mot à une cellule ou le signale comme non attribué.
Pour un développeur web, pensez à une jointure. Nous avons une collection de cellules et une collection de mots. Mais il n’existe pas encore de clé étrangère cell_id dans les mots : nous devons déterminer ce lien à partir de la géométrie.
Le résultat conserve cette association. Le HTML peut représenter les fusions avec rowspan et colspan. Le CSV, lui, aligne des valeurs dans une grille aplatie ; il ne décrit pas la fusion comme le fait HTML. Gardez donc aussi le JSON de provenance : il conserve la structure et les coordonnées nécessaires pour revenir à la source.
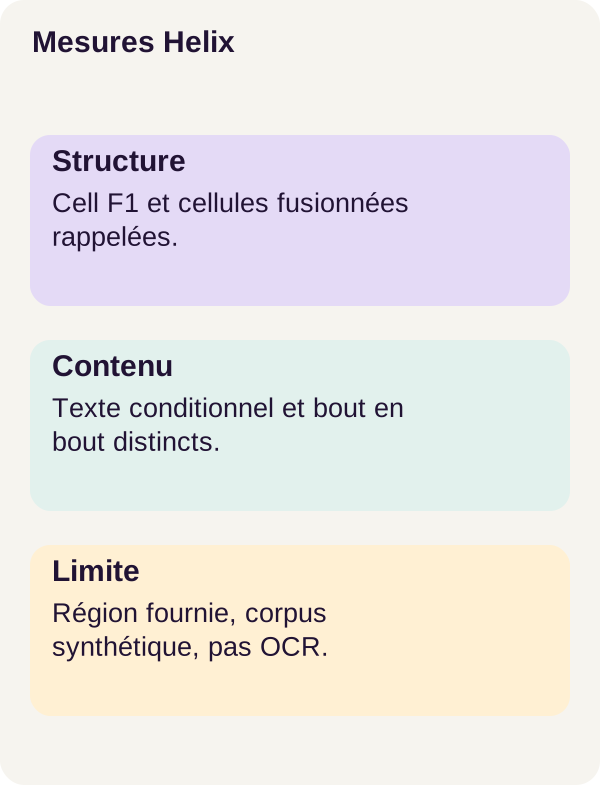
Le corpus comprend 480 PDF Helix fictifs, issus de 60 familles : 336 documents d’entraînement, 72 de validation et 72 de test. Les familles sont séparées entre ces groupes. Le texte est anglais, natif et synthétique. Aucun OCR, scan ou PDF client n’est évalué dans ce parcours.
Les repères nécessaires avant le code
Des boîtes dans le même repère
Une boîte, ou bounding box, est un rectangle décrit ici par [gauche, haut, droite, bas]. C’est proche de ce que vous manipulez lorsque vous positionnez un élément dans une interface : une largeur, une hauteur et une position, exprimées dans un repère donné.
Le piège est de mélanger les repères. Les mots viennent du PDF ; les prédictions viennent de l’image du crop. Il faut tenir compte de l’origine de cette région, de son échelle de rendu et de son padding, la marge ajoutée autour de l’image.
Prenons un exemple pédagogique où toutes les coordonnées PDF ont déjà été exprimées dans un repère d’origine en haut à gauche. La région commence en (100, 200). Un point du mot se trouve en (120, 230). Dans la région, il est donc à (20, 30). Avec une échelle de deux pixels par unité et une marge de 10 pixels, il devient (50, 70) : on soustrait l’origine, on multiplie par deux, puis on ajoute la marge.
Comparer directement (120, 230) à une boîte exprimée en pixels du crop serait incohérent. Le mot pourrait être déclaré extérieur à une cellule alors qu’il se trouve visuellement dedans. Ce calcul simplifié explique le besoin ; pour reproduire les transformations exactes, conservez celles du projet.
Des lignes et des colonnes, mais pas encore des cellules
Une ligne définit une bande horizontale. Une colonne définit une bande verticale. Leur intersection forme une cellule candidate. Avec trois lignes et deux colonnes, nous obtenons d’abord six cellules, même si certaines ne contiennent aucun texte.
Une fusion change cette organisation. L’en-tête « Quarter 1 » doit occuper une seule cellule qui couvre deux colonnes, et non deux cellules qui répètent le même texte. Nous appellerons aussi cette zone un span : une cellule qui s’étend sur plusieurs positions de la grille.
Le code décrit chaque cellule par quatre indices : row_start, row_end, col_start, col_end. Les débuts sont inclus et les fins exclues, comme dans une tranche Python. Ainsi, (0, 1, 0, 2) désigne la ligne d’indice 0 et les colonnes d’indices 0 et 1. On peut en déduire rowspan = 1 - 0 = 1 et colspan = 2 - 0 = 2.
Ce que TATR apprend à prédire
TATR repose sur DETR, pour DEtection TRansformer. Le modèle représente l’image par des caractéristiques numériques, puis utilise des requêtes apprises pour produire des propositions d’objets. Ces requêtes sont des vecteurs ajustés pendant l’apprentissage, pas des questions en français ni des requêtes SQL. Les composants appelés têtes de prédiction produisent notamment la catégorie et les coordonnées de chaque proposition. Le dépôt officiel DETR présente cette architecture.
Pendant l’entraînement, nous disposons d’annotations : les objets attendus, avec leur catégorie et leur boîte. Il faut comparer les propositions à ces références. Mais la première proposition n’est pas nécessairement la première ligne du tableau ; l’ordre des sorties ne suffit donc pas à choisir les correspondances.
C’est là qu’intervient l’appariement hongrois : chercher une association entre prédictions et cibles qui minimise le coût total, sans affecter la même prédiction à deux cibles.
Dans cet exemple inventé, plus le coût est petit, meilleure est la correspondance :
| Proposition | Ligne attendue A | Ligne attendue B |
|---|---|---|
| P1 | 9 | 1 |
| P2 | 2 | 8 |
Associer les éléments dans leur ordre d’apparition coûterait 9 + 8 = 17. Associer P1 à B et P2 à A coûte 1 + 2 = 3. Nous retenons cette seconde combinaison. Le principe ne consiste pas à choisir séparément la meilleure cible de chaque proposition : les choix doivent rester compatibles entre eux.
Le code d’appariement de DETR combine des coûts de classe et de géométrie. Cet appariement aux annotations sert à l’apprentissage ; l’inférence ne peut pas l’utiliser pour consulter les réponses attendues.
Une perte pour apprendre, plusieurs mesures pour comprendre
Une fonction de perte donne une valeur numérique à l’erreur du modèle. L’entraînement ajuste ses paramètres pour réduire cette valeur. Dans ce parcours, elle rassemble la classification, une distance L1 sur les coordonnées et GIoU.
La classification vérifie le type d’objet : ligne, colonne ou autre catégorie. La distance L1 additionne les écarts absolus entre coordonnées correspondantes. Par exemple, entre les vecteurs fictifs (0,10 ; 0,20 ; 0,30 ; 0,40) et (0,12 ; 0,20 ; 0,28 ; 0,45), elle vaut 0,02 + 0 + 0,02 + 0,05 = 0,09. Cet exemple explique l’opération, pas les valeurs observées pendant l’entraînement.
L’IoU, pour Intersection over Union, mesure le recouvrement de deux boîtes : aire commune divisée par aire de leur union. Deux boîtes identiques ont une IoU de 1 ; deux boîtes disjointes ont une IoU de 0.
Mais une boîte située juste à côté de la bonne position et une boîte très éloignée peuvent toutes deux avoir une IoU nulle. GIoU ajoute une information liée à la région qui englobe les deux boîtes, afin de fournir un signal même sans recouvrement. La présentation de GIoU par ses auteurs permet d’explorer ce mécanisme visuellement.
Ne confondez pas ces calculs avec l’attribution des mots. Pour un mot, nous diviserons l’aire commune avec une cellule par l’aire du mot, et non par l’union des deux rectangles. Une petite boîte de mot peut être entièrement dans une grande cellule : sa couverture vaut alors 1, même si leur IoU est faible.
Des données contrôlées, une vraie séparation
Le générateur fait varier les bordures, les marges internes, les tailles et les nombres de lignes et de colonnes. Il ajoute une ligne de corps vide et parfois une colonne vide. Cela oblige le programme à distinguer une cellule sans texte d’une cellule qu’il n’a pas reconstruite.
Dans votre application, une case vide peut avoir un sens. Elle ne signifie pas automatiquement zéro, et elle ne doit pas faire glisser la valeur suivante vers la gauche. Le tutoriel conserve donc la géométrie avant de se demander s’il y a des mots à y placer.
Les 336 documents d’entraînement servent à ajuster les paramètres. Les 72 documents de validation permettent d’examiner le comportement pendant la mise au point ; les 72 documents de test servent à la mesure finale. La séparation par familles évite qu’un même gabarit se retrouve dans plusieurs groupes. Elle ne transforme pas pour autant les documents synthétiques en échantillon représentatif de tous les PDF.
Les annotations servent à entraîner et à évaluer. Le service inference ne peut pas ouvrir leurs fichiers. Le rectangle de région est, lui, une entrée utilisateur fixée avant la génération et la prédiction : il indique où regarder, sans fournir la grille attendue.
C’est une différence essentielle pour lire les scores. Nous mesurons la reconstruction sachant que la région est fournie. Ajouter ultérieurement un détecteur de tableaux ne permettrait pas de conserver ce score comme si sa propre localisation était toujours parfaite. Il faudrait mesurer cette nouvelle étape, puis l’ensemble du parcours.
Exemple calculable : l’en-tête Helix
Reprenons « Quarter 1 » sur une version simplifiée, avec des coordonnées choisies pour le calcul. La ligne occupe l’intervalle vertical [20, 50]. Les deux colonnes occupent [10, 110] et [110, 210] horizontalement.
Avant fusion, nous avons deux cellules : [10, 20, 110, 50] et [110, 20, 210, 50]. Un span qui couvre entièrement ces deux cellules permet de les remplacer par une seule : [10, 20, 210, 50], avec les indices (0, 1, 0, 2).
C’est maintenant à cette cellule unique que nous rattachons les mots « Quarter » et « 1 ». Voici une représentation pédagogique de la cellule après attribution, avec des identifiants fictifs :
{
  "row_start": 0,
  "row_end": 1,
  "col_start": 0,
  "col_end": 2,
  "box": [10, 20, 210, 50],
  "word_ids": [101, 102],
  "text": "Quarter 1"
}
Ce n’est pas un export réel du corpus, mais un exemple de la structure manipulée par les fonctions ci-dessous. Le point important est qu’il reste une cellule et deux mots, pas deux copies de l’en-tête.
Que faire d’un mot à cheval sur une limite ? Avec le seuil de couverture de 0.5, une cellule doit couvrir au moins la moitié de sa boîte. Dans un autre exemple fictif, 60 pixels carrés communs sur une boîte de mot de 100 pixels carrés donnent 0,6 : cette cellule est admissible. Si aucune cellule n’atteint 0,5, le mot reste dans unassigned_word_ids.
Les spans peuvent aussi entrer en conflit. Le code traite d’abord les plus confiants et mémorise les positions déjà fusionnées. Un conflit qui atteint ce contrôle incrémente rejected_spans. Nous allons lire précisément ce compteur, car il ne représente pas tous les candidats écartés.
Le code central : faire de la grille puis joindre les mots
Reconstruire une grille à partir des objets prédits
Les fonctions suivantes reçoivent des objets déjà représentés par label, score et box. label est la catégorie, score le score associé à la proposition, et box ses coordonnées. Les fonctions utilitaires importées calculent les aires, intersections et IoU.
Les identifiants utiles ici sont 1 pour une colonne, 2 pour une ligne et 5 pour une cellule fusionnée. Les catégories 0, 3 et 4 désignent respectivement la table et les deux types d’en-tête. Vous pouvez retrouver cette nomenclature dans la configuration du modèle TATR. Les classes d’en-tête distinguent des rôles dans le tableau ; elles ne sont pas utilisées directement par cette fonction de reconstruction.
Lisez d’abord les deux fonctions comme une chaîne : axis_intervals() fabrique des bandes ordonnées ; reconstruct() croise ces bandes puis applique les fusions.
from .boxes import area, intersection, iou


def axis_intervals(objects, label, axis, threshold):
    candidates = sorted(
        [o for o in objects if o["label"] == label], key=lambda o: -o["score"]
    )
    kept = []
    for item in candidates:
        if all(iou(item["box"], other["box"]) < threshold for other in kept):
            kept.append(item)
    kept.sort(key=lambda o: (o["box"][axis] + o["box"][axis + 2]) / 2)
    unique = []
    for item in kept:
        center = (item["box"][axis] + item["box"][axis + 2]) / 2
        if not unique or center - unique[-1][0] > 0.5:
            unique.append((center, item))
    if not unique:
        return []
    # Turn noisy overlapping intervals into a partition. This can be wrong geometrically; IoU and word scores expose it.
    bounds = (
        [min(o["box"][axis] for _, o in unique)]
        + [(a[0] + b[0]) / 2 for a, b in zip(unique, unique[1:])]
        + [max(o["box"][axis + 2] for _, o in unique)]
    )
    return [[a, b] for a, b in zip(bounds, bounds[1:]) if b > a]


def reconstruct(objects, config):
    objects = [
        o
        for o in objects
        if o["score"] >= config["score_threshold"] and area(o["box"]) > 0
    ]
    rows = axis_intervals(objects, 2, 1, config["nms_iou"])
    cols = axis_intervals(objects, 1, 0, config["nms_iou"])
    cells = []
    for r, (top, bottom) in enumerate(rows):
        for c, (left, right) in enumerate(cols):
            cells.append(
                {
                    "row_start": r,
                    "row_end": r + 1,
                    "col_start": c,
                    "col_end": c + 1,
                    "box": [left, top, right, bottom],
                }
            )
    rejected = 0
    occupied = set()
    for span in sorted(
        [o for o in objects if o["label"] == 5], key=lambda o: -o["score"]
    ):
        covered = [
            cell
            for cell in cells
            if area(intersection(cell["box"], span["box"])) / area(cell["box"])
            >= config["span_coverage"]
        ]
        if len(covered) < 2:
            continue
        r0 = min(c["row_start"] for c in covered)
        r1 = max(c["row_end"] for c in covered)
        c0 = min(c["col_start"] for c in covered)
        c1 = max(c["col_end"] for c in covered)
        positions = {(r, c) for r in range(r0, r1) for c in range(c0, c1)}
        if positions & occupied:
            rejected += 1
            continue
        occupied |= positions
        cells = [
            cell
            for cell in cells
            if not (r0 <= cell["row_start"] < r1 and c0 <= cell["col_start"] < c1)
        ]
        cells.append(
            {
                "row_start": r0,
                "row_end": r1,
                "col_start": c0,
                "col_end": c1,
                "box": [cols[c0][0], rows[r0][0], cols[c1 - 1][1], rows[r1 - 1][1]],
            }
        )
    cells.sort(key=lambda cell: (cell["row_start"], cell["col_start"]))
    return {
        "rows": len(rows),
        "columns": len(cols),
        "cells": cells,
        "rejected_spans": rejected,
    }
axis_intervals() : passer de rectangles bruités à des bandes
La fonction sélectionne d’abord les objets de la catégorie demandée et les trie par score décroissant. Elle conserve un candidat seulement si son IoU avec chaque objet déjà retenu reste sous threshold. C’est un filtrage des recouvrements, piloté ici par nms_iou : l’idée est d’éviter de compter plusieurs propositions presque identiques comme plusieurs lignes ou colonnes.
Les objets retenus sont ensuite triés selon leur centre. Avec axis=0, on regarde les coordonnées horizontales ; avec axis=1, les verticales. La liste unique écarte aussi les centres distants d’au plus 0.5 unité dans le repère utilisé. Ce 0.5 est une distance, pas un seuil de confiance.
Enfin, la fonction transforme les intervalles en une partition : des bandes contiguës qui se rejoignent à une frontière commune. Les frontières internes sont placées à mi-distance entre centres voisins.
Par exemple, si deux intervalles fictifs [0, 40] et [30, 70] survivent aux filtres, leurs centres valent 20 et 50. La frontière commune devient (20 + 50) / 2 = 35. Les bandes reconstruites sont donc [0, 35] et [35, 70].
Nous avons supprimé leur chevauchement, mais nous n’avons pas prouvé que 35 est la vraie séparation dans le document. C’est une règle de post-traitement, autrement dit du code exécuté après les prédictions du modèle. Le commentaire de la fonction le rappelle : une grille régulière peut rester géométriquement fausse.
reconstruct() : créer les intersections, puis fusionner
Le premier filtre élimine les objets dont le score est insuffisant ou dont la boîte a une aire nulle. Les lignes et colonnes restantes produisent ensuite toutes les intersections, au moyen des deux boucles for. C’est à ce stade qu’une cellule vide continue d’exister : la grille est créée sans consulter le texte.
Viennent les spans, triés du score le plus élevé au plus faible. Pour chacun, covered contient les cellules dont la boîte est suffisamment couverte selon span_coverage. Le dénominateur est ici l’aire de la cellule, pas celle du mot ni celle du span.
Si moins de deux cellules sont couvertes, le candidat est ignoré : il n’y a pas plusieurs cellules à fusionner. Sinon, le code récupère leurs indices extrêmes et construit positions, l’ensemble des positions de grille comprises dans le rectangle obtenu.
occupied mémorise les positions déjà prises par des fusions acceptées. L’expression positions & occupied cherche une intersection entre ces deux ensembles. Si elle n’est pas vide, la nouvelle fusion entre en conflit avec une précédente : elle est refusée et rejected_spans augmente.
Sinon, les cellules élémentaires concernées sont retirées, puis une cellule fusionnée est ajoutée. Sa boîte est reconstruite à partir des limites de lignes et de colonnes ; elle ne reprend pas aveuglément les coordonnées brutes du span prédit. Le tri final ordonne les cellules par ligne puis par colonne.
Une précision à la lecture du code : rejected_spans compte les conflits qui atteignent le test sur occupied, pas tous les spans ignorés. Un candidat peut être éliminé au seuil de score ou ne plus couvrir deux cellules après une fusion précédente. Un compteur à zéro ne signifie donc pas que chaque proposition de fusion a été acceptée.
assign_words() : attribuer chaque mot sans le dupliquer
Nous avons les cases ; il reste à les remplir. Cette fonction n’invente pas leur texte : elle utilise les mots extraits du PDF et leurs boîtes.
from .boxes import area, intersection


def assign_words(grid, words, coverage=0.5):
    cells = [{**cell, "word_ids": [], "text": ""} for cell in grid["cells"]]
    unassigned = []
    for word in words:
        scores = [
            area(intersection(cell["box"], word["box"])) / area(word["box"])
            for cell in cells
        ]
        if scores and max(scores) >= coverage:
            cells[max(range(len(cells)), key=lambda i: scores[i])]["word_ids"].append(
                word["id"]
            )
        else:
            unassigned.append(word["id"])
    byid = {word["id"]: word for word in words}
    for cell in cells:
        cell["text"] = " ".join(byid[index]["text"] for index in cell["word_ids"])
    assigned = [index for cell in cells for index in cell["word_ids"]]
    assert len(set(assigned)) == len(assigned) and set(assigned + unassigned) == set(
        byid
    )
    return {**grid, "cells": cells, "unassigned_word_ids": unassigned}
La première ligne crée une copie des cellules avec une liste word_ids vide et un texte vide. Pour chaque mot, scores contient sa fraction de couverture par chacune des cellules.
Le code choisit la cellule ayant la meilleure couverture, à condition que cette couverture atteigne coverage. Il ne retient pas toutes les cellules dépassant le seuil : un mot est ajouté à une seule liste. Si deux cellules ont exactement le même score maximal, max() conserve ici la première rencontrée. C’est un départage déterministe, pas une preuve que le rattachement est juste.
Si aucune cellule ne convient, l’identifiant est ajouté à unassigned. Le mot ne disparaît donc pas silencieusement de la comptabilité des entrées.
byid construit ensuite un dictionnaire pour retrouver rapidement un mot à partir de son identifiant. L’instruction " ".join(...) assemble les textes associés à une cellule en les séparant par des espaces. Elle conserve l’ordre dans lequel les mots ont été fournis : cette fonction ne reconstruit pas elle-même leur ordre de lecture.
Enfin, l’assertion vérifie deux propriétés : aucun identifiant attribué n’est répété parmi les cellules, et l’ensemble des identifiants attribués ou non attribués correspond aux identifiants d’entrée. Avec des identifiants d’entrée uniques, la boucle rend ainsi visible le sort de chaque mot.
Cela protège contre une duplication silencieuse, mais ne valide pas la bonne colonne. Il faut aussi que les mots entrants possèdent des boîtes d’aire positive, puisque cette aire sert de diviseur ; le contrôle de cette condition n’apparaît pas dans l’extrait. En adaptant votre ingestion, vérifiez donc la préparation des entrées plutôt que de supposer que cette fonction traite toutes les anomalies possibles.
Retenez les trois questions distinctes : le mot est-il conservé, est-il attribué une seule fois, et est-il attribué au bon endroit ? Seule la comparaison aux références permet de répondre à la dernière.
Prérequis, puis commandes exactes
Vous devez savoir lire du Python, utiliser un terminal et lancer Docker. Les notions d’apprentissage sont introduites au fil du parcours ; il n’est pas nécessaire d’avoir déjà entraîné un détecteur pour suivre les calculs de grille.
Le parcours de référence utilise Linux, Docker Engine, Compose, un pilote NVIDIA et NVIDIA Container Toolkit. Il a été observé sur une RTX 3090 de 24 Gio, en float32, c’est-à-dire avec des nombres à virgule flottante sur 32 bits. Prévoyez environ 24 Gio de RAM et 18 Gio de disque : ce sont des estimations de préparation, pas des minima mesurés pour toutes les machines. Le profil CPU est NOT_TESTED.
Le pilote rend le GPU utilisable par Linux ; le Toolkit permet au conteneur Docker d’y accéder et ne remplace pas l’installation du pilote. nvidia-smi vérifie la visibilité côté hôte ; check_environment.py vérifie ensuite un vrai calcul dans Docker.
Décompressez le ZIP dans un répertoire de travail et ouvrez un terminal à sa racine. Toutes les commandes ci-dessous partent de ce répertoire. Gardez les dépendances et la révision de modèle verrouillées dans le projet, plutôt que de les remplacer par les versions courantes des documentations.
Étape 1 — préparer et vérifier
Nous commençons par contrôler l’environnement, préparer les dossiers, valider Compose et construire les trois services. acquisition récupère les fichiers du modèle ; tutorial permet de préparer, entraîner et évaluer ; inference produit les prédictions sans avoir accès aux annotations.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Chaque commande doit terminer avec un code retour nul. L’acquisition récupère les 115 Mo de fichiers TATR à la révision verrouillée. Les tests contrôlent notamment les coordonnées, les cellules fusionnées, le nettoyage et l’acquisition.
Ces tests vérifient le fonctionnement du programme. Ils ne signifient pas que le modèle saura reconstruire correctement n’importe quel tableau. Vérifiez aussi l’accès effectif au GPU dans Docker avant de passer à l’entraînement.
Étape 2 — préparer le crop et la baseline
Une baseline est une méthode de référence à laquelle nous comparerons le modèle adapté. Elle évite de conclure qu’une solution est utile simplement parce qu’elle emploie un réseau de neurones.
docker compose run --rm tutorial python -m pdftables.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli inspect-labels --config configs/minimum.yaml
docker compose run --rm inference python -m pdftables.cli baseline --config configs/minimum.yaml
prepare doit annoncer 480 pages, réparties en 336/72/72. Inspectez les crops et les annotations d’apprentissage avant d’entraîner : les lignes vides sont-elles présentes ? L’en-tête est-il entièrement visible ? Ses colonnes sont-elles correctement représentées ? Réservez les références de test à l’évaluation, sans les utiliser pour retoucher le cadrage ou les réglages.
La comparaison finale portera sur pdfplumber, TATR préentraîné et TATR adapté, tous appliqués aux mêmes régions connues. La documentation de pdfplumber décrit une extraction fondée sur les lignes graphiques ou les alignements de mots, leurs intersections et les cellules obtenues. C’est un point de comparaison concret, pas un adversaire qu’il faudrait volontairement affaiblir.
Étape 3 — adapter et vérifier la reprise
Nous partons du modèle déjà entraîné Table Transformer structure recognition. Adapter, ou faire du fine-tuning, consiste à poursuivre l’apprentissage sur notre corpus plutôt qu’à initialiser tout le modèle au hasard.
Dans ce projet, seuls le décodeur, les requêtes apprises et les têtes sont adaptés. Le décodeur transforme les requêtes et les informations visuelles en représentations servant aux prédictions ; les têtes en tirent les classes et les boîtes. Les autres poids sont gelés : ils restent utilisés dans le calcul, mais ne sont pas modifiés par l’entraînement. Le projet en conserve un inventaire.
Il s’agit donc d’une adaptation partielle, pas d’un réentraînement complet. Le parcours ne compare pas ici toutes les stratégies de gel possibles ; ne lui attribuons pas un résultat qu’il ne mesure pas.
docker compose run --rm tutorial python -m pdftables.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli train-continuous --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli train-resume --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli verify-resume --config configs/minimum.yaml
Une époque correspond à un passage sur les exemples d’entraînement. Le premier essai s’interrompt après quatre époques. Le témoin continu repart du même modèle préentraîné et en réalise huit. La reprise recharge l’essai interrompu et effectue les quatre restantes.
Pourquoi cette répétition ? Pour vérifier que l’interruption ne change pas l’expérience. Un checkpoint est une sauvegarde de son état. Recharger uniquement les poids ne suffit pas à poursuivre exactement le même calcul : il faut aussi retrouver l’optimiseur, qui pilote leur mise à jour, et les états des générateurs pseudo-aléatoires, désignés par RNG. La documentation PyTorch sur les checkpoints explique la différence entre sauvegarder pour prédire et sauvegarder pour reprendre un entraînement.
Dans le parcours validé, verify-resume conclut EXACT. Ce résultat concerne les contrôles et l’environnement de cette reproduction ; il ne faut pas le supposer acquis après un changement de matériel ou de dépendances.
Étape 4 — prédire et mesurer
L’inférence utilise les poids enregistrés pour produire les objets, reconstruire la grille et attribuer les mots. L’évaluation intervient ensuite, séparément, avec les annotations de référence.
docker compose run --rm inference python -m pdftables.cli predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli evaluate --config configs/minimum.yaml
Relier chaque défaut à une décision
Après predict, ouvrez regions-and-grid.png, les boîtes prédites et export/table.json. Commencez par une table, pas par la moyenne générale. Suivez une valeur depuis le PDF jusqu’à son identifiant de mot, sa cellule et son texte exporté.
Une ligne manquante réduit le nombre d’intersections disponibles. Une colonne mal délimitée peut envoyer un mot dans la mauvaise cellule. Une fusion erronée peut réunir deux cellules pourtant distinctes. Un mot non attribué peut révéler un problème de couverture ou de repère. Ces défauts ne se corrigent pas tous en entraînant davantage le réseau.
Le HTML vous aide à inspecter les fusions ; le CSV facilite une lecture tabulaire ; le JSON conserve les coordonnées et les identifiants nécessaires au diagnostic. Si l’affichage paraît correct, vérifiez tout de même les montants et les associations.
L’évaluateur examine trois couches : les positions de cellules, les couples mot-cellule et le texte normalisé. Si la structure se dégrade, commencez par les bandes et les spans. Si elle est correcte mais que les associations baissent, inspectez les mots proches d’une frontière et le seuil de couverture. Si seul le texte diffère, vérifiez l’extraction des caractères et leur normalisation, c’est-à-dire les transformations appliquées avant comparaison.
Une cellule vide mérite la même attention : ne la supprimez pas simplement pour rendre l’export plus compact. Son absence pourrait masquer une erreur de structure.
Lire les métriques avant les chiffres
Précision, rappel et F1 : trois questions simples
La précision demande : parmi les éléments prédits, combien sont corrects ? Le rappel demande : parmi les éléments attendus, combien avons-nous retrouvés ? Le F1 combine les deux avec la formule 2 × précision × rappel / (précision + rappel) lorsque le dénominateur est non nul.
Supposons que quatre cellules soient attendues et que nous en prédisions trois, toutes correctes. La précision vaut 3/3 = 1, le rappel 3/4 = 0,75 et le F1 environ 0,857. Nous n’avons rien inventé, mais il manque encore une cellule : la précision seule le cacherait.
Structure et association : deux niveaux différents
La cell F1 compare les positions des cellules, décrites par (début ligne, fin ligne, début colonne, fin colonne). Une cellule couvrant deux colonnes n’est pas équivalente à deux cellules séparées. Il s’agit ici de la structure de grille, pas simplement de la ressemblance visuelle entre deux rectangles.
L’association F1 compare les couples formés par un mot et sa cellule. Même si les mots sont tous présents, les envoyer dans les mauvaises colonnes produit des associations incorrectes. Et deux montants identiques restent deux mots distincts grâce à leurs identifiants.
Cette distinction explique pourquoi l’absence de doublons dans assign_words() ne suffit pas : une affectation unique peut être une mauvaise affectation.
Pourquoi « contenu parfait » peut être trompeur
L’exactitude de contenu conditionnelle ne regarde que les cellules communes entre prédiction et référence. Elle répond à la question : « sur les cellules dont la position a été retrouvée, le texte est-il correct ? »
L’exactitude de contenu de bout en bout utilise toutes les cellules de référence dans son dénominateur. Elle pénalise donc aussi les cellules manquantes. Ici, « bout en bout » reste relatif au parcours du tutoriel, avec une région fournie et du texte natif : cela n’inclut pas une détection page entière ou un OCR.
Prenons un exemple pédagogique avec dix cellules attendues. Le programme n’en retrouve que deux, mais leur texte est exact. Son contenu conditionnel vaut 2/2 = 1. Son contenu de bout en bout vaut 2/10 = 0,2. Les deux mesures sont correctes ; elles ne répondent simplement pas à la même question.
Dans les résultats réels de la baseline pdfplumber, les 371 cellules communes contiennent les bons mots : le contenu conditionnel vaut donc 1. Pourtant, seules 16 tables sur 72 sont entièrement exactes et le contenu de bout en bout vaut 0,1593. C’est précisément le piège qu’il faut apprendre à repérer.
Une table entière exacte est un critère plus exigeant
table_accuracy exige à la fois la structure et le texte exacts pour un document. Une table contenant beaucoup de cellules correctes et une seule erreur ne compte pas comme une table exacte.
Ces métriques sont celles du projet : ce ne sont pas les métriques GriTS. Le dépôt officiel Table Transformer décrit GriTS, un autre protocole de comparaison des grilles. Les noms et définitions ne sont pas interchangeables ; on ne peut pas mettre côte à côte des nombres calculés différemment comme s’ils mesuraient la même chose.
Les résultats du parcours r003
Sur les 72 documents de test, les valeurs sont arrondies à quatre décimales :
Sur mobile, faites défiler le tableau horizontalement.
| Variante | Cell F1 | Association F1 | Contenu conditionnel | Contenu bout en bout | Tables exactes |
|---|---|---|---|---|---|
| pdfplumber | 0,2748 | 0,3140 | 1,0000 | 0,1593 | 16/72 |
| TATR préentraîné | 0,8897 | 0,6532 | 0,7473 | 0,6909 | 0/72 |
| TATR adapté | 0,9974 | 0,9858 | 0,9871 | 0,9820 | 67/72 |
L’adaptation améliore ici les mesures de structure, d’association et de contenu par rapport au modèle préentraîné. Elle obtient 67/72 tables exactes, contre 0/72 pour TATR préentraîné et 16/72 pour pdfplumber.
Le zéro du modèle préentraîné ne signifie pas qu’il ne trouve rien : sa cell F1 vaut 0,8897. Il signifie qu’aucune des 72 tables ne satisfait simultanément tous les critères d’exactitude. Les erreurs peuvent être peu nombreuses dans chaque document et suffire à faire échouer ce critère strict.
Le résultat adapté conserve 80/80 cellules fusionnées, mais cinq tables ne sont pas exactes. Bien retrouver les fusions ne garantit donc pas que toute la structure et tout le contenu soient justes. Pour un montant, une erreur localisée compte davantage que l’impression générale d’un tableau bien dessiné.
Ces résultats concernent les crops Helix synthétiques de ce parcours. Ils ne démontrent pas la même qualité sur des scans, des tableaux réels, des factures ou une détection sur page entière.
Ce que nous avons appris
Extraire un tableau demande de reconstruire son organisation, puis de retrouver les liens entre cellules et mots. TATR propose des objets visuels ; le post-traitement transforme ces propositions en bandes, intersections et fusions ; l’attribution géométrique y place le texte natif.
La provenance garde ces décisions inspectables. Elle permet de revenir d’une valeur exportée à ses mots et à ses coordonnées, mais elle ne garantit pas à elle seule que la décision est bonne.
Enfin, la forme et le contenu se contrôlent séparément. Une cellule vide doit rester visible, une fusion ne doit pas dupliquer son texte, et un bon score conditionnel ne doit pas cacher les cellules absentes. Sur le corpus de référence, l’adaptation apporte un gain mesuré, sans rendre les 72 tables toutes exactes.
Exercice — distinguer forme et contenu
Avant d’exécuter le scénario, prenez un instant pour prédire les résultats. Imaginez d’abord que deux colonnes soient fusionnées sans changer les mots. Est-ce que conserver tout le texte suffit à garder de bonnes mesures de structure et d’association ?
Imaginez maintenant que l’on remplace un chiffre, mais que les cellules et les identifiants de mots restent à leur place. Quelles mesures peuvent rester bonnes ? La table doit-elle encore être considérée comme exacte ? Notez votre raisonnement avant les commandes.
docker compose run --rm tutorial python -m pdftables.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
La première commande exécute l’exercice fourni. La suivante produit les figures depuis les sorties, puis la dernière contrôle les checkpoints, les fichiers sauvegardés du modèle.
Dans le premier scénario, les spans changent et les mots ne sont plus associés aux mêmes cellules : structure et associations se détériorent, même sans perte de mots.
Dans le second, la grille peut rester correcte tandis que le texte devient faux. Si les identifiants et leurs affectations sont conservés, les mesures d’association ne détectent pas à elles seules la substitution du chiffre ; il faut examiner le contenu. Un tableau peut donc être parfaitement structuré et contenir une valeur erronée.
Comparez les tableaux et leurs mesures aux hypothèses notées. Ne corrigez ni les mots ni les annotations pour obtenir un meilleur score : l’exercice sert justement à rendre visible cette dissociation.
Vous pouvez aussi refaire à la main le calcul de couverture du mot de 100 pixels carrés. Avec 60 pixels carrés dans une cellule, il est accepté au seuil 0.5. Avec seulement 40 et aucune autre cellule suffisamment couvrante, il reste non attribué. Ce calcul pédagogique n’exige aucun nouvel entraînement.
Adapter, dépanner et nettoyer
Diagnostiquer avant de changer le modèle
Le GPU est visible dans Linux, mais CUDA échoue dans Docker ? Vérifiez d’abord l’intégration avec la documentation NVIDIA Container Toolkit. CUDA est l’environnement utilisé pour les calculs sur le GPU ; une carte visible côté hôte ne prouve pas que le programme conteneurisé peut l’utiliser.
L’en-tête est coupé ? Examinez la région fournie et la marge du crop. Un modèle ne peut pas reconstruire fidèlement ce qui a été retiré de son entrée. Pour vos propres documents, corrigez le cadrage avant une nouvelle prédiction. Pour mesurer le protocole de test, ne réajustez pas ce cadrage en fonction des réponses attendues.
Un mot semble avoir disparu ? Consultez unassigned_word_ids, puis vérifiez la boîte du mot, le crop et le seuil de couverture. Ne l’ajoutez pas arbitrairement à une cellule pour améliorer l’affichage. Vérifiez aussi l’ordre des mots avant leur assemblage : assign_words() conserve l’ordre reçu.
Le HTML semble bon, mais les chiffres sont faux ? Revenez au JSON de provenance et comparez les mots sources. Un changement de colonne ou de caractère n’appelle pas le même diagnostic qu’une ligne absente.
Passer à vos documents : une extension à évaluer
Dans une application réelle, séparez la détection des tableaux, l’OCR si le document en a besoin, la reconstruction de structure et les contrôles de contenu. Ces étapes supplémentaires ne sont pas validées par les scores du tutoriel.
Ajoutez des contrôles adaptés aux données : types attendus, unités, formats numériques et validation humaine des cas ambigus. Une chaîne comme 12.50 doit d’abord être correctement extraite et localisée ; son interprétation comme montant appartient à une autre décision de l’application.
Journalisez la région, l’échelle, les scores, les mots non attribués et la version du modèle. Conservez des annotations fiables représentatives de vos documents pour mesurer les erreurs. Une interface de revue pourrait, par exemple, permettre de cliquer sur une cellule exportée pour retrouver ses mots dans la page : c’est une piste d’intégration, pas une fonctionnalité annoncée comme présente dans le ZIP.
Les références officielles liées dans l’article servent à approfondir les mécanismes : Table Transformer et DETR pour les prédictions, GIoU pour la géométrie, pdfplumber pour l’extraction, PyTorch pour les sauvegardes et NVIDIA pour l’accès GPU. Elles ne remplacent pas les fichiers et les commandes du parcours r003.
Conserver les exports, puis nettoyer
Copiez les résultats et figures que vous souhaitez conserver avant d’exécuter les commandes suivantes. Le nettoyage supprime uniquement outputs/ ; il conserve data/generated/ et assets/checkpoints/.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
La première commande arrête le projet. Le service tutorial exécute ensuite le nettoyage ciblé, puis le dernier arrêt termine le parcours. Il n’est pas nécessaire de supprimer globalement les données Docker pour étudier ce tutoriel.