





Necesita añadir una importación de tablas PDF a una aplicación web. Empieza extrayendo el texto: las palabras están ahí, también los números. Sin embargo, una vez colocados los datos en una hoja de cálculo, un importe acaba en la columna equivocada, un encabezado aparece dos veces y una celda vacía ha desaparecido. La extracción ha logrado leer el texto, pero no recuperar su organización.
Este es el problema que vamos a explorar con el informe ficticio Helix Quarterly Ledger. Su tabla contiene un encabezado «Quarter 1» fusionado sobre dos columnas, decimales y una celda deliberadamente vacía. Para reconstruirla, debemos responder a dos preguntas distintas: ¿dónde están las celdas y qué palabras pertenecen a cada una?
Adaptaremos Table Transformer para el reconocimiento de estructura, o TATR, y después usaremos Python para reconstruir la cuadrícula y asociarle las palabras del PDF. El modelo detecta objetos visuales; el código los convierte en una tabla utilizable, con exportaciones HTML, CSV y JSON de procedencia.
Descargar el proyecto completo del tutorial r003
El recorrido y los resultados de referencia son los del proyecto r003. Los pequeños ejemplos numéricos añadidos para comprender los cálculos son explícitamente pedagógicos: no constituyen nuevas mediciones del modelo. Del mismo modo, las figuras ilustran el mecanismo y los resultados observados, no una validación sobre sus propios documentos.
Lo que vamos a construir
Una región de tabla como entrada, no una página que explorar
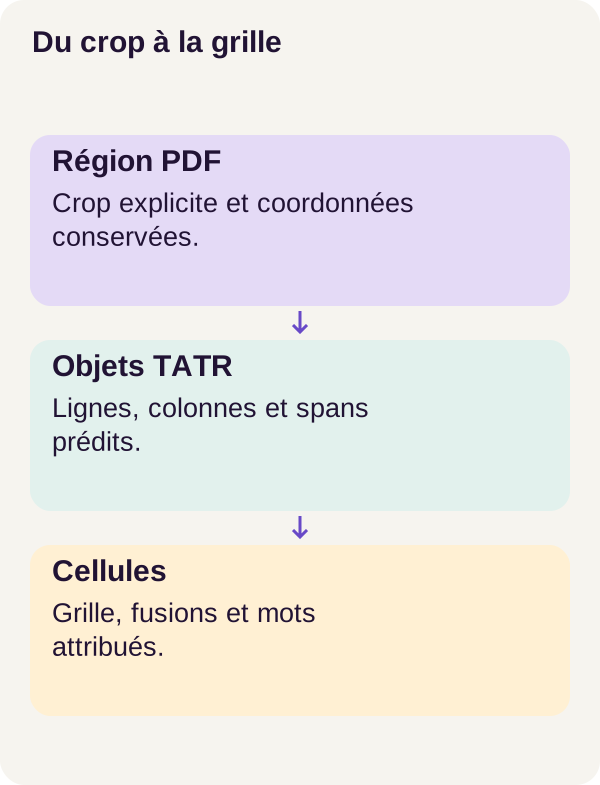
La entrada es un PDF nativo, es decir, un documento cuyo texto se puede extraer directamente, acompañado de un rectángulo declarado en data/regions.json. Este rectángulo indica la región que se debe tratar. Se proporciona al modelo una imagen de esta región, denominada crop.
El proyecto no busca automáticamente las tablas en una página completa. Se le indica dónde mirar y después se evalúa su capacidad para comprender la estructura de lo que se encuentra en esa zona. Encontrar la tabla en la página sería un paso adicional, con sus propios errores que medir.
A partir del crop, TATR predice seis tipos de objetos: tabla, columna, fila, encabezado de columna, encabezado proyectado y celda fusionada. Cada objeto está asociado a una caja y una puntuación. El código presentado más adelante utiliza las filas, las columnas y las celdas fusionadas para construir la cuadrícula; por tanto, no todas las categorías predichas desempeñan el mismo papel en este extracto.
El nombre «Transformer» no significa que vayamos a pedir a un chatbot que redacte una tabla. Aquí se trata de un modelo de detección visual. La documentación de Table Transformer distingue claramente la detección de una tabla del reconocimiento de su estructura.
Dos caminos que se unen
Por un lado, la imagen de la región permite predecir filas, columnas y fusiones. Por otro, el texto nativo proporciona palabras con sus coordenadas. El programa reúne ambas informaciones: crea las celdas y luego asocia cada palabra a una celda o la señala como no asignada.
Para un desarrollador web, piense en una unión. Tenemos una colección de celdas y una colección de palabras. Pero las palabras aún no tienen una clave foránea cell_id: debemos determinar ese vínculo a partir de la geometría.
El resultado conserva esta asociación. El HTML puede representar las fusiones con rowspan y colspan. El CSV, por su parte, alinea valores en una cuadrícula aplanada; no describe la fusión como lo hace HTML. Conserve también el JSON de procedencia: mantiene la estructura y las coordenadas necesarias para volver a la fuente.
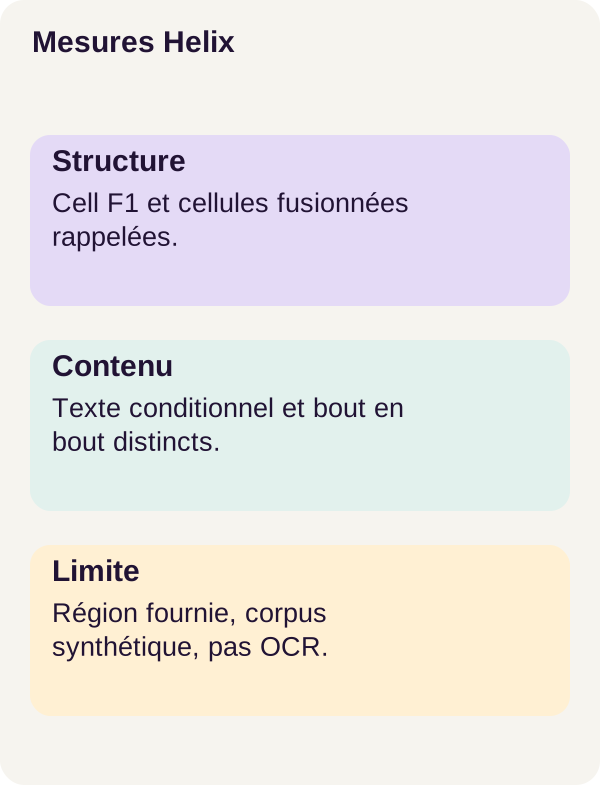
El corpus incluye 480 PDF Helix ficticios, procedentes de 60 familias: 336 documentos de entrenamiento, 72 de validación y 72 de prueba. Las familias están separadas entre estos grupos. El texto es inglés, nativo y sintético. En este recorrido no se evalúan OCR, escaneos ni PDF de clientes.
Referencias necesarias antes del código
Cajas en el mismo sistema de coordenadas
Una caja, o bounding box, es un rectángulo descrito aquí por [izquierda, arriba, derecha, abajo]. Se parece a lo que manipula al colocar un elemento en una interfaz: una anchura, una altura y una posición, expresadas en un sistema de coordenadas dado.
La trampa consiste en mezclar sistemas de coordenadas. Las palabras proceden del PDF; las predicciones, de la imagen del crop. Hay que tener en cuenta el origen de esta región, su escala de renderizado y su padding, el margen añadido alrededor de la imagen.
Tomemos un ejemplo pedagógico en el que todas las coordenadas PDF ya se han expresado en un sistema cuyo origen está arriba a la izquierda. La región comienza en (100, 200). Un punto de la palabra está en (120, 230). Por tanto, dentro de la región está en (20, 30). Con una escala de dos píxeles por unidad y un margen de 10 píxeles, pasa a (50, 70): se resta el origen, se multiplica por dos y se añade el margen.
Comparar directamente (120, 230) con una caja expresada en píxeles del crop sería incoherente. La palabra podría declararse fuera de una celda aunque visualmente esté dentro. Este cálculo simplificado explica la necesidad; para reproducir las transformaciones exactas, conserve las del proyecto.
Filas y columnas, pero todavía no celdas
Una fila define una franja horizontal. Una columna define una franja vertical. Su intersección forma una celda candidata. Con tres filas y dos columnas obtenemos primero seis celdas, aunque algunas no contengan texto.
Una fusión modifica esta organización. El encabezado «Quarter 1» debe ocupar una única celda que cubra dos columnas, no dos celdas que repitan el mismo texto. También llamaremos a esta zona un span: una celda que se extiende sobre varias posiciones de la cuadrícula.
El código describe cada celda mediante cuatro índices: row_start, row_end, col_start, col_end. Los inicios se incluyen y los finales se excluyen, como en un segmento de Python. Así, (0, 1, 0, 2) designa la fila de índice 0 y las columnas de índices 0 y 1. De ello se deduce rowspan = 1 - 0 = 1 y colspan = 2 - 0 = 2.
Lo que TATR aprende a predecir
TATR se basa en DETR, por DEtection TRansformer. El modelo representa la imagen mediante características numéricas y luego utiliza consultas aprendidas para producir propuestas de objetos. Estas consultas son vectores ajustados durante el entrenamiento, no preguntas en francés ni consultas SQL. Los componentes denominados cabezas de predicción producen, entre otras cosas, la categoría y las coordenadas de cada propuesta. El repositorio oficial de DETR presenta esta arquitectura.
Durante el entrenamiento disponemos de anotaciones: los objetos esperados, con su categoría y su caja. Hay que comparar las propuestas con estas referencias. Pero la primera propuesta no es necesariamente la primera fila de la tabla; por tanto, el orden de las salidas no basta para elegir las correspondencias.
Aquí interviene el emparejamiento húngaro: busca una asociación entre predicciones y objetivos que minimice el coste total, sin asignar la misma predicción a dos objetivos.
En este ejemplo inventado, cuanto menor es el coste, mejor es la correspondencia:
| Propuesta | Fila esperada A | Fila esperada B |
|---|---|---|
| P1 | 9 | 1 |
| P2 | 2 | 8 |
Asociar los elementos según su orden de aparición costaría 9 + 8 = 17. Asociar P1 con B y P2 con A cuesta 1 + 2 = 3. Elegimos esta segunda combinación. El principio no consiste en elegir por separado el mejor objetivo para cada propuesta: las elecciones deben seguir siendo compatibles entre sí.
El código de emparejamiento de DETR combina costes de clase y geometría. Este emparejamiento con las anotaciones sirve para el aprendizaje; la inferencia no puede utilizarlo para consultar las respuestas esperadas.
Una pérdida para aprender, varias métricas para comprender
Una función de pérdida asigna un valor numérico al error del modelo. El entrenamiento ajusta sus parámetros para reducir ese valor. En este recorrido reúne la clasificación, una distancia L1 sobre las coordenadas y GIoU.
La clasificación comprueba el tipo de objeto: fila, columna u otra categoría. La distancia L1 suma las diferencias absolutas entre coordenadas correspondientes. Por ejemplo, entre los vectores ficticios (0,10 ; 0,20 ; 0,30 ; 0,40) y (0,12 ; 0,20 ; 0,28 ; 0,45), vale 0,02 + 0 + 0,02 + 0,05 = 0,09. Este ejemplo explica la operación, no los valores observados durante el entrenamiento.
La IoU, por Intersection over Union, mide el solapamiento de dos cajas: el área común dividida por el área de su unión. Dos cajas idénticas tienen una IoU de 1; dos cajas disjuntas tienen una IoU de 0.
Pero una caja situada justo al lado de la posición correcta y una caja muy alejada pueden tener ambas una IoU nula. GIoU añade información relacionada con la región que engloba ambas cajas para proporcionar una señal incluso sin solapamiento. La presentación de GIoU por sus autores permite explorar visualmente este mecanismo.
No confunda estos cálculos con la asignación de palabras. Para una palabra, dividiremos el área común con una celda por el área de la palabra, no por la unión de ambos rectángulos. Una caja de palabra pequeña puede estar por completo dentro de una celda grande: entonces su cobertura vale 1, aunque su IoU sea baja.
Datos controlados, una separación real
El generador varía los bordes, los márgenes internos, los tamaños y los números de filas y columnas. Añade una fila de cuerpo vacía y, a veces, una columna vacía. Esto obliga al programa a distinguir una celda sin texto de una celda que no ha reconstruido.
En su aplicación, una celda vacía puede tener significado. No equivale automáticamente a cero y no debe desplazar el valor siguiente hacia la izquierda. Por eso el tutorial conserva la geometría antes de preguntarse si hay palabras que colocar en ella.
Los 336 documentos de entrenamiento sirven para ajustar los parámetros. Los 72 documentos de validación permiten examinar el comportamiento durante la puesta a punto; los 72 documentos de prueba sirven para la medición final. La separación por familias evita que una misma plantilla aparezca en varios grupos. Sin embargo, no convierte los documentos sintéticos en una muestra representativa de todos los PDF.
Las anotaciones sirven para entrenar y evaluar. El servicio inference no puede abrir sus archivos. El rectángulo de región, en cambio, es una entrada de usuario fijada antes de la generación y la predicción: indica dónde mirar, sin proporcionar la cuadrícula esperada.
Esta es una diferencia esencial para interpretar las puntuaciones. Medimos la reconstrucción sabiendo que se proporciona la región. Añadir más adelante un detector de tablas no permitiría conservar esta puntuación como si su propia localización fuera siempre perfecta. Habría que medir esta nueva etapa y luego el recorrido completo.
Ejemplo calculable: el encabezado Helix
Retomemos «Quarter 1» en una versión simplificada, con coordenadas elegidas para el cálculo. La fila ocupa el intervalo vertical [20, 50]. Las dos columnas ocupan horizontalmente [10, 110] y [110, 210].
Antes de la fusión tenemos dos celdas: [10, 20, 110, 50] y [110, 20, 210, 50]. Un span que cubra por completo estas dos celdas permite sustituirlas por una sola: [10, 20, 210, 50], con los índices (0, 1, 0, 2).
Ahora asociamos las palabras «Quarter» y «1» a esta única celda. Esta es una representación pedagógica de la celda después de la asignación, con identificadores ficticios:
{
  "row_start": 0,
  "row_end": 1,
  "col_start": 0,
  "col_end": 2,
  "box": [10, 20, 210, 50],
  "word_ids": [101, 102],
  "text": "Quarter 1"
}
No es una exportación real del corpus, sino un ejemplo de la estructura manipulada por las funciones siguientes. Lo importante es que sigue habiendo una celda y dos palabras, no dos copias del encabezado.
¿Qué hacer con una palabra a caballo sobre un límite? Con el umbral de cobertura 0.5, una celda debe cubrir al menos la mitad de su caja. En otro ejemplo ficticio, 60 píxeles cuadrados comunes sobre una caja de palabra de 100 píxeles cuadrados dan 0,6: esta celda es admisible. Si ninguna celda alcanza 0,5, la palabra permanece en unassigned_word_ids.
Los spans también pueden entrar en conflicto. El código trata primero los más fiables y memoriza las posiciones ya fusionadas. Un conflicto que llega a este control incrementa rejected_spans. Leeremos este contador con precisión, porque no representa todos los candidatos descartados.
El código central: crear la cuadrícula y después unir las palabras
Reconstruir una cuadrícula a partir de objetos predichos
Las funciones siguientes reciben objetos ya representados por label, score y box. label es la categoría, score la puntuación asociada a la propuesta y box sus coordenadas. Las funciones utilitarias importadas calculan áreas, intersecciones e IoU.
Los identificadores útiles aquí son 1 para una columna, 2 para una fila y 5 para una celda fusionada. Las categorías 0, 3 y 4 designan respectivamente la tabla y los dos tipos de encabezado. Puede encontrar esta nomenclatura en la configuración del modelo TATR. Las clases de encabezado distinguen roles en la tabla; esta función de reconstrucción no las utiliza directamente.
Lea primero las dos funciones como una cadena: axis_intervals() fabrica franjas ordenadas; reconstruct() cruza estas franjas y después aplica las fusiones.
from .boxes import area, intersection, iou


def axis_intervals(objects, label, axis, threshold):
    candidates = sorted(
        [o for o in objects if o["label"] == label], key=lambda o: -o["score"]
    )
    kept = []
    for item in candidates:
        if all(iou(item["box"], other["box"]) < threshold for other in kept):
            kept.append(item)
    kept.sort(key=lambda o: (o["box"][axis] + o["box"][axis + 2]) / 2)
    unique = []
    for item in kept:
        center = (item["box"][axis] + item["box"][axis + 2]) / 2
        if not unique or center - unique[-1][0] > 0.5:
            unique.append((center, item))
    if not unique:
        return []
    # Turn noisy overlapping intervals into a partition. This can be wrong geometrically; IoU and word scores expose it.
    bounds = (
        [min(o["box"][axis] for _, o in unique)]
        + [(a[0] + b[0]) / 2 for a, b in zip(unique, unique[1:])]
        + [max(o["box"][axis + 2] for _, o in unique)]
    )
    return [[a, b] for a, b in zip(bounds, bounds[1:]) if b > a]


def reconstruct(objects, config):
    objects = [
        o
        for o in objects
        if o["score"] >= config["score_threshold"] and area(o["box"]) > 0
    ]
    rows = axis_intervals(objects, 2, 1, config["nms_iou"])
    cols = axis_intervals(objects, 1, 0, config["nms_iou"])
    cells = []
    for r, (top, bottom) in enumerate(rows):
        for c, (left, right) in enumerate(cols):
            cells.append(
                {
                    "row_start": r,
                    "row_end": r + 1,
                    "col_start": c,
                    "col_end": c + 1,
                    "box": [left, top, right, bottom],
                }
            )
    rejected = 0
    occupied = set()
    for span in sorted(
        [o for o in objects if o["label"] == 5], key=lambda o: -o["score"]
    ):
        covered = [
            cell
            for cell in cells
            if area(intersection(cell["box"], span["box"])) / area(cell["box"])
            >= config["span_coverage"]
        ]
        if len(covered) < 2:
            continue
        r0 = min(c["row_start"] for c in covered)
        r1 = max(c["row_end"] for c in covered)
        c0 = min(c["col_start"] for c in covered)
        c1 = max(c["col_end"] for c in covered)
        positions = {(r, c) for r in range(r0, r1) for c in range(c0, c1)}
        if positions & occupied:
            rejected += 1
            continue
        occupied |= positions
        cells = [
            cell
            for cell in cells
            if not (r0 <= cell["row_start"] < r1 and c0 <= cell["col_start"] < c1)
        ]
        cells.append(
            {
                "row_start": r0,
                "row_end": r1,
                "col_start": c0,
                "col_end": c1,
                "box": [cols[c0][0], rows[r0][0], cols[c1 - 1][1], rows[r1 - 1][1]],
            }
        )
    cells.sort(key=lambda cell: (cell["row_start"], cell["col_start"]))
    return {
        "rows": len(rows),
        "columns": len(cols),
        "cells": cells,
        "rejected_spans": rejected,
    }
axis_intervals(): pasar de rectángulos ruidosos a franjas
La función selecciona primero los objetos de la categoría solicitada y los ordena por puntuación decreciente. Conserva un candidato solo si su IoU con cada objeto ya retenido permanece por debajo de threshold. Es un filtrado de solapamientos, gobernado aquí por nms_iou: la idea es evitar contar varias propuestas casi idénticas como varias filas o columnas.
Los objetos retenidos se ordenan después según su centro. Con axis=0 se observan las coordenadas horizontales; con axis=1, las verticales. La lista unique también descarta centros separados como máximo 0.5 unidades en el sistema utilizado. Ese 0.5 es una distancia, no un umbral de confianza.
Por último, la función transforma los intervalos en una partición: franjas contiguas que se unen en una frontera común. Las fronteras internas se sitúan a mitad de distancia entre centros vecinos.
Por ejemplo, si dos intervalos ficticios [0, 40] y [30, 70] sobreviven a los filtros, sus centros valen 20 y 50. La frontera común pasa a ser (20 + 50) / 2 = 35. Las franjas reconstruidas son, por tanto, [0, 35] y [35, 70].
Hemos eliminado su solapamiento, pero no hemos demostrado que 35 sea la separación real en el documento. Es una regla de posprocesamiento, es decir, código ejecutado después de las predicciones del modelo. El comentario de la función lo recuerda: una cuadrícula regular puede seguir siendo geométricamente errónea.
reconstruct(): crear las intersecciones y después fusionar
El primer filtro elimina los objetos cuya puntuación es insuficiente o cuya caja tiene área nula. Las filas y columnas restantes producen después todas las intersecciones mediante los dos bucles for. En esta fase una celda vacía sigue existiendo: la cuadrícula se crea sin consultar el texto.
A continuación vienen los spans, ordenados de la puntuación más alta a la más baja. Para cada uno, covered contiene las celdas cuya caja está suficientemente cubierta según span_coverage. El denominador aquí es el área de la celda, no la de la palabra ni la del span.
Si se cubren menos de dos celdas, se ignora el candidato: no hay varias celdas que fusionar. De lo contrario, el código recupera sus índices extremos y construye positions, el conjunto de posiciones de cuadrícula incluidas en el rectángulo resultante.
occupied memoriza las posiciones ya tomadas por fusiones aceptadas. La expresión positions & occupied busca una intersección entre ambos conjuntos. Si no está vacía, la nueva fusión entra en conflicto con una anterior: se rechaza y rejected_spans aumenta.
De lo contrario, se retiran las celdas elementales afectadas y se añade una celda fusionada. Su caja se reconstruye a partir de los límites de filas y columnas; no reutiliza ciegamente las coordenadas brutas del span predicho. La ordenación final organiza las celdas por fila y después por columna.
Una precisión al leer el código: rejected_spans cuenta los conflictos que llegan a la prueba sobre occupied, no todos los spans ignorados. Un candidato puede eliminarse por el umbral de puntuación o dejar de cubrir dos celdas después de una fusión anterior. Por tanto, un contador en cero no significa que se haya aceptado cada propuesta de fusión.
assign_words(): asignar cada palabra sin duplicarla
Ya tenemos las celdas; queda llenarlas. Esta función no inventa su texto: utiliza las palabras extraídas del PDF y sus cajas.
from .boxes import area, intersection


def assign_words(grid, words, coverage=0.5):
    cells = [{**cell, "word_ids": [], "text": ""} for cell in grid["cells"]]
    unassigned = []
    for word in words:
        scores = [
            area(intersection(cell["box"], word["box"])) / area(word["box"])
            for cell in cells
        ]
        if scores and max(scores) >= coverage:
            cells[max(range(len(cells)), key=lambda i: scores[i])]["word_ids"].append(
                word["id"]
            )
        else:
            unassigned.append(word["id"])
    byid = {word["id"]: word for word in words}
    for cell in cells:
        cell["text"] = " ".join(byid[index]["text"] for index in cell["word_ids"])
    assigned = [index for cell in cells for index in cell["word_ids"]]
    assert len(set(assigned)) == len(assigned) and set(assigned + unassigned) == set(
        byid
    )
    return {**grid, "cells": cells, "unassigned_word_ids": unassigned}
La primera línea crea una copia de las celdas con una lista word_ids vacía y un texto vacío. Para cada palabra, scores contiene su fracción de cobertura por cada una de las celdas.
El código elige la celda con la mejor cobertura, siempre que esa cobertura alcance coverage. No conserva todas las celdas que superan el umbral: una palabra se añade a una única lista. Si dos celdas tienen exactamente la misma puntuación máxima, max() conserva aquí la primera encontrada. Es un desempate determinista, no una prueba de que la asociación sea correcta.
Si ninguna celda es adecuada, el identificador se añade a unassigned. Así, la palabra no desaparece silenciosamente de la contabilidad de entradas.
Después, byid construye un diccionario para recuperar rápidamente una palabra a partir de su identificador. La instrucción " ".join(...) ensambla los textos asociados a una celda separándolos con espacios. Conserva el orden en que se proporcionaron las palabras: esta función no reconstruye por sí misma su orden de lectura.
Por último, la aserción comprueba dos propiedades: ningún identificador asignado se repite entre las celdas y el conjunto de identificadores asignados o no asignados corresponde a los identificadores de entrada. Con identificadores de entrada únicos, el bucle hace visible así el destino de cada palabra.
Esto protege contra una duplicación silenciosa, pero no valida la columna correcta. También es necesario que las palabras de entrada tengan cajas de área positiva, puesto que esta área sirve de divisor; el control de esta condición no aparece en el extracto. Al adaptar su ingesta, compruebe la preparación de las entradas en vez de suponer que esta función trata todas las anomalías posibles.
Conserve las tres preguntas distintas: ¿se conserva la palabra, se asigna una sola vez y se asigna al lugar correcto? Solo la comparación con las referencias permite responder a la última.
Requisitos previos y comandos exactos
Debe saber leer Python, utilizar una terminal y ejecutar Docker. Las nociones de aprendizaje se introducen a lo largo del recorrido; no hace falta haber entrenado antes un detector para seguir los cálculos de la cuadrícula.
El recorrido de referencia utiliza Linux, Docker Engine, Compose, un controlador NVIDIA y NVIDIA Container Toolkit. Se observó en una RTX 3090 de 24 GiB, en float32, es decir, con números de coma flotante de 32 bits. Prevea aproximadamente 24 GiB de RAM y 18 GiB de disco: son estimaciones de preparación, no mínimos medidos para todas las máquinas. El perfil de CPU es NOT_TESTED.
El controlador hace que Linux pueda utilizar la GPU; el Toolkit permite que el contenedor Docker acceda a ella y no sustituye la instalación del controlador. nvidia-smi comprueba la visibilidad en el host; check_environment.py comprueba después un cálculo real en Docker.
Descomprima el ZIP en un directorio de trabajo y abra una terminal en su raíz. Todos los comandos siguientes se ejecutan desde ese directorio. Mantenga las dependencias y la revisión del modelo bloqueadas en el proyecto, en lugar de sustituirlas por las versiones actuales de las documentaciones.
Paso 1: preparar y comprobar
Empezamos por controlar el entorno, preparar las carpetas, validar Compose y construir los tres servicios. acquisition recupera los archivos del modelo; tutorial permite preparar, entrenar y evaluar; inference produce las predicciones sin acceso a las anotaciones.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Cada comando debe terminar con un código de salida nulo. La adquisición recupera los 115 MB de archivos TATR en la revisión bloqueada. Las pruebas controlan, entre otras cosas, las coordenadas, las celdas fusionadas, la limpieza y la adquisición.
Estas pruebas verifican el funcionamiento del programa. No significan que el modelo vaya a reconstruir correctamente cualquier tabla. Compruebe también el acceso efectivo a la GPU en Docker antes de pasar al entrenamiento.
Paso 2: preparar el crop y la línea base
Una línea base es un método de referencia con el que compararemos el modelo adaptado. Evita concluir que una solución es útil simplemente porque emplea una red neuronal.
docker compose run --rm tutorial python -m pdftables.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli inspect-labels --config configs/minimum.yaml
docker compose run --rm inference python -m pdftables.cli baseline --config configs/minimum.yaml
prepare debe anunciar 480 páginas, repartidas en 336/72/72. Inspeccione los crops y las anotaciones de entrenamiento antes de entrenar: ¿están presentes las filas vacías? ¿El encabezado está completamente visible? ¿Sus columnas están correctamente representadas? Reserve las referencias de prueba para la evaluación, sin usarlas para retocar el encuadre o los ajustes.
La comparación final se realizará con pdfplumber, TATR preentrenado y TATR adaptado, todos aplicados a las mismas regiones conocidas. La documentación de pdfplumber describe una extracción basada en líneas gráficas o alineaciones de palabras, sus intersecciones y las celdas obtenidas. Es un punto de comparación concreto, no un adversario que hubiera que debilitar deliberadamente.
Paso 3: adaptar y comprobar la reanudación
Partimos del modelo ya entrenado Table Transformer structure recognition. Adaptar, o realizar fine-tuning, consiste en continuar el entrenamiento con nuestro corpus en vez de inicializar todo el modelo al azar.
En este proyecto solo se adaptan el decodificador, las consultas aprendidas y las cabezas. El decodificador transforma las consultas y la información visual en representaciones que sirven para las predicciones; las cabezas extraen de ellas las clases y las cajas. Los demás pesos están congelados: siguen utilizándose en el cálculo, pero el entrenamiento no los modifica. El proyecto conserva un inventario de ellos.
Por tanto, se trata de una adaptación parcial, no de un reentrenamiento completo. El recorrido no compara aquí todas las estrategias posibles de congelación; no le atribuyamos un resultado que no mide.
docker compose run --rm tutorial python -m pdftables.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli train-continuous --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli train-resume --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli verify-resume --config configs/minimum.yaml
Una época corresponde a una pasada por los ejemplos de entrenamiento. El primer ensayo se interrumpe tras cuatro épocas. El testigo continuo parte del mismo modelo preentrenado y realiza ocho. La reanudación recarga el ensayo interrumpido y realiza las cuatro restantes.
¿Por qué esta repetición? Para comprobar que la interrupción no cambia el experimento. Un checkpoint es una copia de su estado. Recargar únicamente los pesos no basta para continuar exactamente el mismo cálculo: también hay que recuperar el optimizador, que guía su actualización, y los estados de los generadores pseudoaleatorios, denominados RNG. La documentación de PyTorch sobre checkpoints explica la diferencia entre guardar para predecir y guardar para reanudar un entrenamiento.
En el recorrido validado, verify-resume concluye EXACT. Este resultado se refiere a los controles y al entorno de esta reproducción; no debe suponerse adquirido después de cambiar el hardware o las dependencias.
Paso 4: predecir y medir
La inferencia utiliza los pesos guardados para producir los objetos, reconstruir la cuadrícula y asignar las palabras. La evaluación interviene después, por separado, con las anotaciones de referencia.
docker compose run --rm inference python -m pdftables.cli predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli evaluate --config configs/minimum.yaml
Relacionar cada defecto con una decisión
Después de predict, abra regions-and-grid.png, las cajas predichas y export/table.json. Empiece por una tabla, no por la media general. Siga un valor desde el PDF hasta su identificador de palabra, su celda y su texto exportado.
Una fila ausente reduce el número de intersecciones disponibles. Una columna mal delimitada puede enviar una palabra a la celda equivocada. Una fusión errónea puede reunir dos celdas que, sin embargo, son distintas. Una palabra no asignada puede revelar un problema de cobertura o de sistema de coordenadas. No todos estos defectos se corrigen entrenando más la red.
El HTML ayuda a inspeccionar las fusiones; el CSV facilita una lectura tabular; el JSON conserva las coordenadas y los identificadores necesarios para el diagnóstico. Aunque la visualización parezca correcta, compruebe también los importes y las asociaciones.
El evaluador examina tres capas: las posiciones de las celdas, las parejas palabra-celda y el texto normalizado. Si la estructura se degrada, empiece por las franjas y los spans. Si es correcta pero las asociaciones bajan, inspeccione las palabras cercanas a una frontera y el umbral de cobertura. Si solo difiere el texto, compruebe la extracción de caracteres y su normalización, es decir, las transformaciones aplicadas antes de comparar.
Una celda vacía merece la misma atención: no la elimine simplemente para hacer la exportación más compacta. Su ausencia podría ocultar un error de estructura.
Leer las métricas antes que las cifras
Precisión, exhaustividad y F1: tres preguntas sencillas
La precisión pregunta: entre los elementos predichos, ¿cuántos son correctos? La exhaustividad pregunta: entre los elementos esperados, ¿cuántos hemos recuperado? El F1 combina ambos mediante la fórmula 2 × precisión × exhaustividad / (precisión + exhaustividad) cuando el denominador no es nulo.
Supongamos que se esperan cuatro celdas y predecimos tres, todas correctas. La precisión vale 3/3 = 1, la exhaustividad 3/4 = 0,75 y el F1 aproximadamente 0,857. No hemos inventado nada, pero sigue faltando una celda: la precisión por sí sola lo ocultaría.
Estructura y asociación: dos niveles distintos
El cell F1 compara las posiciones de las celdas, descritas por (inicio de fila, fin de fila, inicio de columna, fin de columna). Una celda que cubre dos columnas no equivale a dos celdas separadas. Aquí se trata de la estructura de cuadrícula, no solo del parecido visual entre dos rectángulos.
El F1 de asociación compara las parejas formadas por una palabra y su celda. Aunque estén presentes todas las palabras, enviarlas a columnas equivocadas produce asociaciones incorrectas. Y dos importes idénticos siguen siendo dos palabras distintas gracias a sus identificadores.
Esta distinción explica por qué la ausencia de duplicados en assign_words() no basta: una asignación única puede ser una asignación incorrecta.
Por qué un «contenido perfecto» puede engañar
La exactitud de contenido condicional solo considera las celdas comunes entre la predicción y la referencia. Responde a la pregunta: «en las celdas cuya posición se ha recuperado, ¿el texto es correcto?»
La exactitud de contenido de extremo a extremo utiliza todas las celdas de referencia en su denominador. Por tanto, también penaliza las celdas ausentes. Aquí, «de extremo a extremo» sigue siendo relativo al recorrido del tutorial, con una región proporcionada y texto nativo: no incluye una detección de página completa ni OCR.
Tomemos un ejemplo pedagógico con diez celdas esperadas. El programa solo recupera dos, pero su texto es exacto. Su contenido condicional vale 2/2 = 1. Su contenido de extremo a extremo vale 2/10 = 0,2. Ambas medidas son correctas; simplemente no responden a la misma pregunta.
En los resultados reales de la línea base pdfplumber, las 371 celdas comunes contienen las palabras correctas: el contenido condicional vale por tanto 1. Sin embargo, solo 16 tablas de 72 son completamente exactas y el contenido de extremo a extremo vale 0,1593. Este es precisamente el error que hay que aprender a detectar.
Una tabla completa exacta es un criterio más exigente
table_accuracy exige para un documento tanto la estructura como el texto exactos. Una tabla que contiene muchas celdas correctas y un solo error no cuenta como una tabla exacta.
Estas métricas son las del proyecto: no son métricas GriTS. El repositorio oficial de Table Transformer describe GriTS, otro protocolo para comparar cuadrículas. Los nombres y las definiciones no son intercambiables; no se pueden poner lado a lado números calculados de forma distinta como si midieran lo mismo.
Resultados del recorrido r003
En los 72 documentos de prueba, los valores se redondean a cuatro decimales:
En móvil, desplace la tabla horizontalmente.
| Variante | Cell F1 | F1 de asociación | Contenido condicional | Contenido de extremo a extremo | Tablas exactas |
|---|---|---|---|---|---|
| pdfplumber | 0,2748 | 0,3140 | 1,0000 | 0,1593 | 16/72 |
| TATR preentrenado | 0,8897 | 0,6532 | 0,7473 | 0,6909 | 0/72 |
| TATR adaptado | 0,9974 | 0,9858 | 0,9871 | 0,9820 | 67/72 |
La adaptación mejora aquí las medidas de estructura, asociación y contenido respecto al modelo preentrenado. Obtiene 67/72 tablas exactas, frente a 0/72 para TATR preentrenado y 16/72 para pdfplumber.
El cero del modelo preentrenado no significa que no encuentre nada: su cell F1 vale 0,8897. Significa que ninguna de las 72 tablas satisface simultáneamente todos los criterios de exactitud. Los errores pueden ser poco numerosos en cada documento y bastar para hacer fallar este criterio estricto.
El resultado adaptado conserva 80/80 celdas fusionadas, pero cinco tablas no son exactas. Recuperar bien las fusiones no garantiza por tanto que toda la estructura y todo el contenido sean correctos. Para un importe, un error localizado cuenta más que la impresión general de una tabla bien dibujada.
Estos resultados se refieren a los crops Helix sintéticos de este recorrido. No demuestran la misma calidad en escaneos, tablas reales, facturas o detección de página completa.
Lo que hemos aprendido
Extraer una tabla exige reconstruir su organización y después recuperar los vínculos entre celdas y palabras. TATR propone objetos visuales; el posprocesamiento convierte estas propuestas en franjas, intersecciones y fusiones; la asignación geométrica coloca en ellas el texto nativo.
La procedencia mantiene inspeccionables estas decisiones. Permite volver de un valor exportado a sus palabras y sus coordenadas, pero no garantiza por sí sola que la decisión sea correcta.
Por último, la forma y el contenido se controlan por separado. Una celda vacía debe seguir siendo visible, una fusión no debe duplicar su texto y una buena puntuación condicional no debe ocultar las celdas ausentes. En el corpus de referencia, la adaptación aporta una mejora medida, sin hacer exactas las 72 tablas.
Ejercicio: distinguir forma y contenido
Antes de ejecutar el escenario, dedique un momento a predecir los resultados. Imagine primero que se fusionan dos columnas sin cambiar las palabras. ¿Basta con conservar todo el texto para mantener buenas medidas de estructura y asociación?
Imagine ahora que se sustituye una cifra, pero las celdas y los identificadores de palabras permanecen en su lugar. ¿Qué medidas pueden seguir siendo buenas? ¿La tabla debe seguir considerándose exacta? Anote su razonamiento antes de los comandos.
docker compose run --rm tutorial python -m pdftables.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
El primer comando ejecuta el ejercicio proporcionado. El siguiente produce las figuras a partir de las salidas y el último controla los checkpoints, los archivos guardados del modelo.
En el primer escenario, los spans cambian y las palabras dejan de estar asociadas a las mismas celdas: la estructura y las asociaciones se deterioran, incluso sin pérdida de palabras.
En el segundo, la cuadrícula puede seguir siendo correcta mientras el texto se vuelve erróneo. Si se conservan los identificadores y sus asignaciones, las medidas de asociación no detectan por sí solas la sustitución de la cifra; hay que examinar el contenido. Una tabla puede estar perfectamente estructurada y contener un valor erróneo.
Compare las tablas y sus medidas con las hipótesis anotadas. No corrija ni las palabras ni las anotaciones para obtener una puntuación mejor: el ejercicio sirve precisamente para hacer visible esta disociación.
También puede rehacer a mano el cálculo de cobertura de la palabra de 100 píxeles cuadrados. Con 60 píxeles cuadrados en una celda se acepta con el umbral 0.5. Con solo 40 y ninguna otra celda que cubra lo suficiente, permanece sin asignar. Este cálculo pedagógico no requiere ningún entrenamiento nuevo.
Adaptar, depurar y limpiar
Diagnosticar antes de cambiar el modelo
¿La GPU es visible en Linux, pero CUDA falla en Docker? Compruebe primero la integración con la documentación de NVIDIA Container Toolkit. CUDA es el entorno utilizado para cálculos en GPU; una tarjeta visible en el host no demuestra que el programa en contenedor pueda usarla.
¿El encabezado está recortado? Examine la región proporcionada y el margen del crop. Un modelo no puede reconstruir fielmente lo que se ha eliminado de su entrada. Para sus propios documentos, corrija el encuadre antes de una nueva predicción. Para medir el protocolo de prueba, no reajuste ese encuadre en función de las respuestas esperadas.
¿Parece que ha desaparecido una palabra? Consulte unassigned_word_ids y después compruebe la caja de la palabra, el crop y el umbral de cobertura. No la añada arbitrariamente a una celda para mejorar la visualización. Compruebe también el orden de las palabras antes de ensamblarlas: assign_words() conserva el orden recibido.
¿El HTML parece correcto, pero las cifras son erróneas? Vuelva al JSON de procedencia y compare las palabras fuente. Un cambio de columna o de carácter no requiere el mismo diagnóstico que una fila ausente.
Pasar a sus documentos: una extensión que evaluar
En una aplicación real, separe la detección de tablas, el OCR si el documento lo necesita, la reconstrucción de estructura y los controles de contenido. Estas etapas adicionales no están validadas por las puntuaciones del tutorial.
Añada controles adaptados a los datos: tipos esperados, unidades, formatos numéricos y validación humana de los casos ambiguos. Una cadena como 12.50 debe extraerse y localizarse correctamente antes; interpretarla como un importe corresponde a otra decisión de la aplicación.
Registre la región, la escala, las puntuaciones, las palabras no asignadas y la versión del modelo. Conserve anotaciones fiables representativas de sus documentos para medir los errores. Una interfaz de revisión podría, por ejemplo, permitir pulsar una celda exportada para recuperar sus palabras en la página: es una pista de integración, no una funcionalidad anunciada como presente en el ZIP.
Las referencias oficiales enlazadas en el artículo sirven para profundizar en los mecanismos: Table Transformer y DETR para las predicciones, GIoU para la geometría, pdfplumber para la extracción, PyTorch para las copias guardadas y NVIDIA para el acceso a GPU. No sustituyen los archivos y los comandos del recorrido r003.
Conservar las exportaciones y después limpiar
Copie los resultados y las figuras que desee conservar antes de ejecutar los comandos siguientes. La limpieza elimina únicamente outputs/; conserva data/generated/ y assets/checkpoints/.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
El primer comando detiene el proyecto. El servicio tutorial ejecuta después la limpieza específica y la última detención finaliza el recorrido. No es necesario eliminar globalmente los datos de Docker para estudiar este tutorial.