





Dovete aggiungere l'importazione di tabelle PDF a un'applicazione web. Iniziate estraendo il testo: ci sono le parole e anche i numeri. Eppure, una volta inseriti i dati in un foglio di calcolo, un importo finisce nella colonna sbagliata, un'intestazione compare due volte e una cella vuota è scomparsa. L'estrazione ha letto il testo, ma non ne ha ritrovato l'organizzazione.
È il problema che esploreremo con il rapporto fittizio Helix Quarterly Ledger. La sua tabella contiene un'intestazione “Quarter 1” unita su due colonne, decimali e una cella deliberatamente vuota. Per ricostruirla, dobbiamo rispondere a due domande diverse: dove sono le celle e quali parole appartengono a ciascuna?
Adatteremo Table Transformer per il riconoscimento della struttura, o TATR, quindi useremo Python per ricostruire la griglia e collegarvi le parole del PDF. Il modello individua oggetti visivi; il codice li trasforma in una tabella utilizzabile, con esportazioni HTML, CSV e JSON di provenienza.
Scaricare il progetto completo del tutorial r003
Il percorso e i risultati di riferimento sono quelli del progetto r003. I piccoli esempi numerici aggiunti per comprendere i calcoli sono esplicitamente didattici: non costituiscono nuove misurazioni del modello. Allo stesso modo, le figure illustrano il meccanismo e i risultati osservati, non una convalida sui vostri documenti.
Cosa costruiremo
Una regione di tabella in ingresso, non una pagina da esplorare
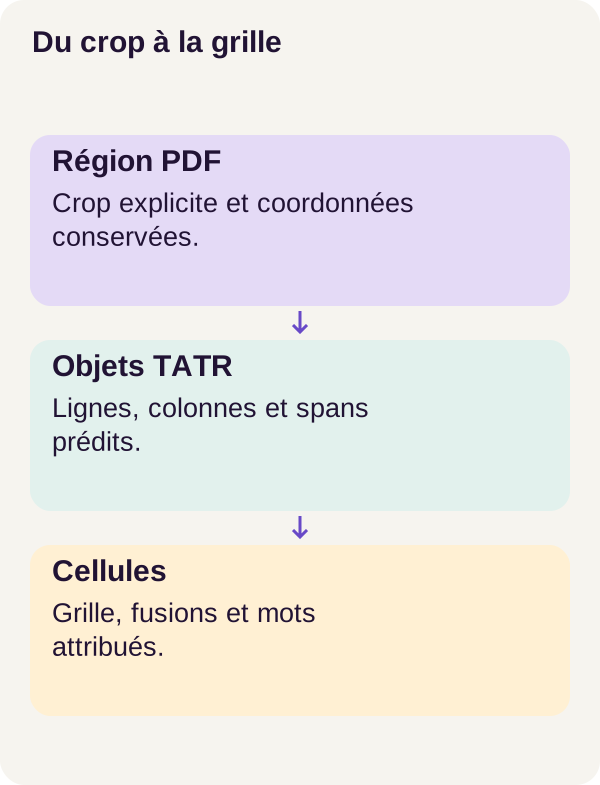
L'input è un PDF nativo, cioè un documento il cui testo è direttamente estraibile, accompagnato da un rettangolo dichiarato in data/regions.json. Questo rettangolo indica la regione da elaborare. Al modello viene fornita un'immagine di questa regione, chiamata crop.
Il progetto non cerca automaticamente le tabelle in una pagina intera. Gli indichiamo dove guardare, poi valutiamo la sua capacità di comprendere la struttura di ciò che si trova in quella zona. Ritrovare la tabella nella pagina sarebbe una fase aggiuntiva, con errori propri da misurare.
A partire dal crop, TATR predice sei tipi di oggetti: tabella, colonna, riga, intestazione di colonna, intestazione proiettata e cella unita. A ogni oggetto sono associati un riquadro e un punteggio. Il codice presentato più avanti usa righe, colonne e celle unite per costruire la griglia; pertanto non tutte le categorie predette hanno lo stesso ruolo in questo estratto.
Il nome “Transformer” non significa che chiederemo a un chatbot di redigere una tabella. Qui si tratta di un modello di rilevamento visivo. La documentazione di Table Transformer distingue chiaramente il rilevamento di una tabella dal riconoscimento della sua struttura.
Due percorsi che convergono
Da un lato, l'immagine della regione consente di predire righe, colonne e fusioni. Dall'altro, il testo nativo fornisce parole con le loro coordinate. Il programma riunisce queste due informazioni: crea le celle, poi associa ogni parola a una cella oppure la segnala come non assegnata.
Per uno sviluppatore web, pensate a una join. Abbiamo una raccolta di celle e una raccolta di parole. Ma nelle parole non esiste ancora una chiave esterna cell_id: dobbiamo determinare questo legame dalla geometria.
Il risultato conserva questa associazione. L'HTML può rappresentare le fusioni con rowspan e colspan. Il CSV invece allinea i valori in una griglia appiattita; non descrive la fusione come fa l'HTML. Conservate quindi anche il JSON di provenienza: mantiene struttura e coordinate necessarie per risalire alla fonte.
Il corpus comprende 480 PDF Helix fittizi, provenienti da 60 famiglie: 336 documenti di addestramento, 72 di convalida e 72 di test. Le famiglie sono separate tra questi gruppi. Il testo è inglese, nativo e sintetico. In questo percorso non vengono valutati OCR, scansioni o PDF dei clienti.
I riferimenti necessari prima del codice
Riquadri nello stesso sistema di riferimento
Un riquadro, o bounding box, è un rettangolo qui descritto da [sinistra, alto, destra, basso]. È simile a ciò che usate quando posizionate un elemento in un'interfaccia: larghezza, altezza e posizione, espresse in un dato sistema di riferimento.
L'insidia è mescolare i sistemi di riferimento. Le parole provengono dal PDF; le predizioni dall'immagine del crop. Occorre tenere conto dell'origine di questa regione, della sua scala di rendering e del suo padding, il margine aggiunto intorno all'immagine.
Prendiamo un esempio didattico in cui tutte le coordinate PDF sono già espresse in un sistema con origine in alto a sinistra. La regione inizia in (100, 200). Un punto della parola si trova in (120, 230). Nella regione è quindi in (20, 30). Con una scala di due pixel per unità e un margine di 10 pixel, diventa (50, 70): si sottrae l'origine, si moltiplica per due e poi si aggiunge il margine.
Confrontare direttamente (120, 230) con un riquadro espresso in pixel del crop sarebbe incoerente. La parola potrebbe essere dichiarata esterna a una cella mentre visivamente è al suo interno. Questo calcolo semplificato spiega la necessità; per riprodurre le trasformazioni esatte, conservate quelle del progetto.
Righe e colonne, ma non ancora celle
Una riga definisce una fascia orizzontale. Una colonna definisce una fascia verticale. La loro intersezione forma una cella candidata. Con tre righe e due colonne otteniamo inizialmente sei celle, anche se alcune non contengono testo.
Una fusione modifica questa organizzazione. L'intestazione “Quarter 1” deve occupare una sola cella che copre due colonne, non due celle che ripetono lo stesso testo. Chiameremo questa zona anche span: una cella estesa su più posizioni della griglia.
Il codice descrive ogni cella con quattro indici: row_start, row_end, col_start, col_end. Gli inizi sono inclusi e le fini escluse, come in una slice Python. Così (0, 1, 0, 2) designa la riga di indice 0 e le colonne di indice 0 e 1. Se ne possono dedurre rowspan = 1 - 0 = 1 e colspan = 2 - 0 = 2.
Ciò che TATR impara a predire
TATR si basa su DETR, da DEtection TRansformer. Il modello rappresenta l'immagine mediante caratteristiche numeriche, poi usa query apprese per produrre proposte di oggetti. Queste query sono vettori regolati durante l'addestramento, non domande in francese né query SQL. I componenti chiamati teste di predizione producono in particolare categoria e coordinate di ogni proposta. Il repository ufficiale di DETR presenta questa architettura.
Durante l'addestramento disponiamo di annotazioni: gli oggetti attesi, con categoria e riquadro. Bisogna confrontare le proposte con questi riferimenti. Ma la prima proposta non è necessariamente la prima riga della tabella; l'ordine degli output non basta dunque per scegliere le corrispondenze.
Qui interviene l'abbinamento ungherese: cercare un'associazione tra predizioni e target che minimizzi il costo totale, senza assegnare la stessa predizione a due target.
In questo esempio inventato, più il costo è basso, migliore è la corrispondenza:
| Proposta | Riga attesa A | Riga attesa B |
|---|---|---|
| P1 | 9 | 1 |
| P2 | 2 | 8 |
Associare gli elementi nel loro ordine di apparizione costerebbe 9 + 8 = 17. Associare P1 a B e P2 ad A costa 1 + 2 = 3. Manteniamo questa seconda combinazione. Il principio non consiste nello scegliere separatamente il target migliore per ogni proposta: le scelte devono restare compatibili tra loro.
Il codice di abbinamento di DETR combina costi di classe e geometria. Questo abbinamento con le annotazioni serve all'addestramento; l'inferenza non può usarlo per consultare le risposte attese.
Una perdita per imparare, diverse misure per comprendere
Una funzione di perdita assegna un valore numerico all'errore del modello. L'addestramento regola i suoi parametri per ridurre questo valore. In questo percorso riunisce classificazione, distanza L1 sulle coordinate e GIoU.
La classificazione verifica il tipo di oggetto: riga, colonna o altra categoria. La distanza L1 somma gli scarti assoluti tra coordinate corrispondenti. Per esempio, tra i vettori fittizi (0,10 ; 0,20 ; 0,30 ; 0,40) e (0,12 ; 0,20 ; 0,28 ; 0,45), vale 0,02 + 0 + 0,02 + 0,05 = 0,09. Questo esempio spiega l'operazione, non i valori osservati durante l'addestramento.
L'IoU, da Intersection over Union, misura la sovrapposizione di due riquadri: area comune divisa per l'area della loro unione. Due riquadri identici hanno IoU pari a 1; due riquadri disgiunti hanno IoU pari a 0.
Ma un riquadro posto appena accanto alla posizione corretta e uno molto lontano possono entrambi avere IoU nulla. GIoU aggiunge un'informazione legata alla regione che ingloba i due riquadri, in modo da fornire un segnale anche senza sovrapposizione. La presentazione di GIoU dei suoi autori consente di esplorare visivamente questo meccanismo.
Non confondete questi calcoli con l'assegnazione delle parole. Per una parola, divideremo l'area comune con una cella per l'area della parola, non per l'unione dei due rettangoli. Un piccolo riquadro di parola può essere interamente in una grande cella: la sua copertura vale allora 1, anche se la loro IoU è bassa.
Dati controllati, una vera separazione
Il generatore varia bordi, margini interni, dimensioni e numero di righe e colonne. Aggiunge una riga del corpo vuota e talvolta una colonna vuota. Questo obbliga il programma a distinguere una cella senza testo da una cella che non ha ricostruito.
Nella vostra applicazione, una cella vuota può avere un significato. Non equivale automaticamente a zero e non deve far scorrere a sinistra il valore successivo. Il tutorial conserva quindi la geometria prima di chiedersi se vi siano parole da collocarvi.
I 336 documenti di addestramento servono a regolare i parametri. I 72 documenti di convalida consentono di esaminare il comportamento durante la messa a punto; i 72 documenti di test servono alla misurazione finale. La separazione per famiglie evita che lo stesso modello si trovi in più gruppi. Non trasforma tuttavia i documenti sintetici in un campione rappresentativo di tutti i PDF.
Le annotazioni servono ad addestrare e valutare. Il servizio inference non può aprire i loro file. Il rettangolo della regione è invece un input utente fissato prima della generazione e della predizione: indica dove guardare, senza fornire la griglia attesa.
È una differenza essenziale per leggere i punteggi. Misuriamo la ricostruzione sapendo che la regione è fornita. Aggiungere successivamente un rilevatore di tabelle non permetterebbe di conservare questo punteggio come se la sua localizzazione fosse sempre perfetta. Bisognerebbe misurare questa nuova fase, poi l'intero percorso.
Esempio calcolabile: l'intestazione Helix
Riprendiamo “Quarter 1” in una versione semplificata, con coordinate scelte per il calcolo. La riga occupa l'intervallo verticale [20, 50]. Le due colonne occupano orizzontalmente [10, 110] e [110, 210].
Prima della fusione abbiamo due celle: [10, 20, 110, 50] e [110, 20, 210, 50]. Uno span che copre interamente queste due celle consente di sostituirle con una sola: [10, 20, 210, 50], con gli indici (0, 1, 0, 2).
È ora a questa cella unica che colleghiamo le parole “Quarter” e “1”. Ecco una rappresentazione didattica della cella dopo l'assegnazione, con identificativi fittizi:
{
  "row_start": 0,
  "row_end": 1,
  "col_start": 0,
  "col_end": 2,
  "box": [10, 20, 210, 50],
  "word_ids": [101, 102],
  "text": "Quarter 1"
}
Non è un'esportazione reale del corpus, ma un esempio della struttura manipolata dalle funzioni qui sotto. Il punto importante è che rimangono una cella e due parole, non due copie dell'intestazione.
Che cosa fare di una parola a cavallo di un limite? Con la soglia di copertura 0.5, una cella deve coprire almeno metà del suo riquadro. In un altro esempio fittizio, 60 pixel quadrati comuni su un riquadro di parola di 100 pixel quadrati danno 0,6: questa cella è ammissibile. Se nessuna cella raggiunge 0,5, la parola rimane in unassigned_word_ids.
Anche gli span possono entrare in conflitto. Il codice elabora prima quelli più affidabili e memorizza le posizioni già unite. Un conflitto che arriva a questo controllo incrementa rejected_spans. Leggeremo con precisione questo contatore, perché non rappresenta tutti i candidati scartati.
Il codice centrale: creare la griglia poi collegare le parole
Ricostruire una griglia dagli oggetti predetti
Le funzioni seguenti ricevono oggetti già rappresentati da label, score e box. label è la categoria, score il punteggio associato alla proposta e box le sue coordinate. Le funzioni di utilità importate calcolano aree, intersezioni e IoU.
Gli identificativi utili qui sono 1 per una colonna, 2 per una riga e 5 per una cella unita. Le categorie 0, 3 e 4 designano rispettivamente la tabella e i due tipi di intestazione. Potete ritrovare questa nomenclatura nella configurazione del modello TATR. Le classi di intestazione distinguono ruoli nella tabella; questa funzione di ricostruzione non le usa direttamente.
Leggete anzitutto le due funzioni come una catena: axis_intervals() crea fasce ordinate; reconstruct() incrocia queste fasce e poi applica le fusioni.
from .boxes import area, intersection, iou


def axis_intervals(objects, label, axis, threshold):
    candidates = sorted(
        [o for o in objects if o["label"] == label], key=lambda o: -o["score"]
    )
    kept = []
    for item in candidates:
        if all(iou(item["box"], other["box"]) < threshold for other in kept):
            kept.append(item)
    kept.sort(key=lambda o: (o["box"][axis] + o["box"][axis + 2]) / 2)
    unique = []
    for item in kept:
        center = (item["box"][axis] + item["box"][axis + 2]) / 2
        if not unique or center - unique[-1][0] > 0.5:
            unique.append((center, item))
    if not unique:
        return []
    # Turn noisy overlapping intervals into a partition. This can be wrong geometrically; IoU and word scores expose it.
    bounds = (
        [min(o["box"][axis] for _, o in unique)]
        + [(a[0] + b[0]) / 2 for a, b in zip(unique, unique[1:])]
        + [max(o["box"][axis + 2] for _, o in unique)]
    )
    return [[a, b] for a, b in zip(bounds, bounds[1:]) if b > a]


def reconstruct(objects, config):
    objects = [
        o
        for o in objects
        if o["score"] >= config["score_threshold"] and area(o["box"]) > 0
    ]
    rows = axis_intervals(objects, 2, 1, config["nms_iou"])
    cols = axis_intervals(objects, 1, 0, config["nms_iou"])
    cells = []
    for r, (top, bottom) in enumerate(rows):
        for c, (left, right) in enumerate(cols):
            cells.append(
                {
                    "row_start": r,
                    "row_end": r + 1,
                    "col_start": c,
                    "col_end": c + 1,
                    "box": [left, top, right, bottom],
                }
            )
    rejected = 0
    occupied = set()
    for span in sorted(
        [o for o in objects if o["label"] == 5], key=lambda o: -o["score"]
    ):
        covered = [
            cell
            for cell in cells
            if area(intersection(cell["box"], span["box"])) / area(cell["box"])
            >= config["span_coverage"]
        ]
        if len(covered) < 2:
            continue
        r0 = min(c["row_start"] for c in covered)
        r1 = max(c["row_end"] for c in covered)
        c0 = min(c["col_start"] for c in covered)
        c1 = max(c["col_end"] for c in covered)
        positions = {(r, c) for r in range(r0, r1) for c in range(c0, c1)}
        if positions & occupied:
            rejected += 1
            continue
        occupied |= positions
        cells = [
            cell
            for cell in cells
            if not (r0 <= cell["row_start"] < r1 and c0 <= cell["col_start"] < c1)
        ]
        cells.append(
            {
                "row_start": r0,
                "row_end": r1,
                "col_start": c0,
                "col_end": c1,
                "box": [cols[c0][0], rows[r0][0], cols[c1 - 1][1], rows[r1 - 1][1]],
            }
        )
    cells.sort(key=lambda cell: (cell["row_start"], cell["col_start"]))
    return {
        "rows": len(rows),
        "columns": len(cols),
        "cells": cells,
        "rejected_spans": rejected,
    }
axis_intervals(): passare da rettangoli rumorosi a fasce
La funzione seleziona dapprima gli oggetti della categoria richiesta e li ordina per punteggio decrescente. Conserva un candidato solo se il suo IoU con ogni oggetto già mantenuto resta sotto threshold. È un filtraggio delle sovrapposizioni, qui guidato da nms_iou: l'idea è evitare di contare più proposte quasi identiche come più righe o colonne.
Gli oggetti mantenuti vengono poi ordinati in base al loro centro. Con axis=0 si guardano le coordinate orizzontali; con axis=1, quelle verticali. L'elenco unique scarta anche i centri distanti al massimo 0.5 unità nel sistema usato. Questo 0.5 è una distanza, non una soglia di affidabilità.
Infine, la funzione trasforma gli intervalli in una partizione: fasce contigue che si incontrano a una frontiera comune. Le frontiere interne sono poste a metà distanza tra centri vicini.
Per esempio, se due intervalli fittizi [0, 40] e [30, 70] superano i filtri, i loro centri valgono 20 e 50. La frontiera comune diventa (20 + 50) / 2 = 35. Le fasce ricostruite sono dunque [0, 35] e [35, 70].
Abbiamo eliminato la loro sovrapposizione, ma non abbiamo dimostrato che 35 sia la vera separazione nel documento. È una regola di post-elaborazione, cioè codice eseguito dopo le predizioni del modello. Il commento della funzione lo ricorda: una griglia regolare può rimanere geometricamente errata.
reconstruct(): creare le intersezioni, poi unire
Il primo filtro elimina gli oggetti il cui punteggio è insufficiente o il cui riquadro ha area nulla. Le righe e colonne restanti producono poi tutte le intersezioni, mediante i due cicli for. È in questa fase che una cella vuota continua a esistere: la griglia viene creata senza consultare il testo.
Seguono gli span, ordinati dal punteggio più alto al più basso. Per ciascuno, covered contiene le celle il cui riquadro è sufficientemente coperto secondo span_coverage. Il denominatore qui è l'area della cella, non quella della parola né quella dello span.
Se sono coperte meno di due celle, il candidato viene ignorato: non vi sono più celle da unire. Altrimenti il codice recupera i loro indici estremi e costruisce positions, l'insieme delle posizioni della griglia comprese nel rettangolo ottenuto.
occupied memorizza le posizioni già prese da fusioni accettate. L'espressione positions & occupied cerca un'intersezione tra questi due insiemi. Se non è vuota, la nuova fusione entra in conflitto con una precedente: viene rifiutata e rejected_spans aumenta.
Altrimenti, le celle elementari interessate vengono rimosse, poi viene aggiunta una cella unita. Il suo riquadro è ricostruito dai limiti di righe e colonne; non riprende ciecamente le coordinate grezze dello span predetto. L'ordinamento finale dispone le celle per riga e poi per colonna.
Una precisazione nella lettura del codice: rejected_spans conta i conflitti che arrivano al test su occupied, non tutti gli span ignorati. Un candidato può essere eliminato alla soglia di punteggio o non coprire più due celle dopo una fusione precedente. Un contatore a zero non significa dunque che ogni proposta di fusione sia stata accettata.
assign_words(): assegnare ogni parola senza duplicarla
Abbiamo le caselle; resta da riempirle. Questa funzione non ne inventa il testo: usa le parole estratte dal PDF e i loro riquadri.
from .boxes import area, intersection


def assign_words(grid, words, coverage=0.5):
    cells = [{**cell, "word_ids": [], "text": ""} for cell in grid["cells"]]
    unassigned = []
    for word in words:
        scores = [
            area(intersection(cell["box"], word["box"])) / area(word["box"])
            for cell in cells
        ]
        if scores and max(scores) >= coverage:
            cells[max(range(len(cells)), key=lambda i: scores[i])]["word_ids"].append(
                word["id"]
            )
        else:
            unassigned.append(word["id"])
    byid = {word["id"]: word for word in words}
    for cell in cells:
        cell["text"] = " ".join(byid[index]["text"] for index in cell["word_ids"])
    assigned = [index for cell in cells for index in cell["word_ids"]]
    assert len(set(assigned)) == len(assigned) and set(assigned + unassigned) == set(
        byid
    )
    return {**grid, "cells": cells, "unassigned_word_ids": unassigned}
La prima riga crea una copia delle celle con un elenco word_ids vuoto e un testo vuoto. Per ogni parola, scores contiene la sua frazione di copertura da parte di ciascuna cella.
Il codice sceglie la cella con la copertura migliore, a condizione che questa raggiunga coverage. Non conserva tutte le celle che superano la soglia: una parola viene aggiunta a un solo elenco. Se due celle hanno esattamente lo stesso punteggio massimo, max() conserva qui la prima incontrata. È uno spareggio deterministico, non la prova che il collegamento sia corretto.
Se nessuna cella è adatta, l'identificativo viene aggiunto a unassigned. La parola non scompare quindi silenziosamente dal conteggio degli input.
byid costruisce poi un dizionario per ritrovare rapidamente una parola dal suo identificativo. L'istruzione " ".join(...) assembla i testi associati a una cella separandoli con spazi. Conserva l'ordine in cui le parole sono state fornite: questa funzione non ricostruisce da sola il loro ordine di lettura.
Infine, l'asserzione verifica due proprietà: nessun identificativo assegnato si ripete tra le celle e l'insieme degli identificativi assegnati o non assegnati corrisponde agli identificativi in ingresso. Con identificativi in ingresso univoci, il ciclo rende così visibile il destino di ogni parola.
Questo protegge da una duplicazione silenziosa, ma non convalida la colonna corretta. Occorre anche che le parole in ingresso possiedano riquadri di area positiva, poiché quest'area serve da divisore; il controllo di questa condizione non appare nell'estratto. Adattando la vostra ingestione, verificate dunque la preparazione degli input invece di supporre che questa funzione tratti ogni possibile anomalia.
Ricordate le tre domande distinte: la parola è conservata, è assegnata una sola volta ed è assegnata nel posto giusto? Solo il confronto con i riferimenti consente di rispondere all'ultima.
Prerequisiti, poi comandi esatti
Dovete saper leggere Python, usare un terminale e avviare Docker. Le nozioni di apprendimento vengono introdotte lungo il percorso; non è necessario avere già addestrato un rilevatore per seguire i calcoli della griglia.
Il percorso di riferimento usa Linux, Docker Engine, Compose, un driver NVIDIA e NVIDIA Container Toolkit. È stato osservato su una RTX 3090 da 24 GiB, in float32, cioè con numeri in virgola mobile a 32 bit. Prevedete circa 24 GiB di RAM e 18 GiB di disco: sono stime di preparazione, non minimi misurati per tutte le macchine. Il profilo CPU è NOT_TESTED.
Il driver rende la GPU utilizzabile da Linux; il Toolkit consente al contenitore Docker di accedervi e non sostituisce l'installazione del driver. nvidia-smi verifica la visibilità lato host; check_environment.py verifica poi un calcolo reale in Docker.
Decomprimete lo ZIP in una directory di lavoro e aprite un terminale nella sua radice. Tutti i comandi qui sotto partono da questa directory. Mantenete dipendenze e revisione del modello bloccate nel progetto, invece di sostituirle con le versioni correnti delle documentazioni.
Passaggio 1 — preparare e verificare
Iniziamo controllando l'ambiente, preparando le directory, convalidando Compose e costruendo i tre servizi. acquisition recupera i file del modello; tutorial permette di preparare, addestrare e valutare; inference produce le predizioni senza accesso alle annotazioni.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Ogni comando deve terminare con un codice di ritorno nullo. L'acquisizione recupera i 115 MB di file TATR alla revisione bloccata. I test controllano in particolare coordinate, celle unite, pulizia e acquisizione.
Questi test verificano il funzionamento del programma. Non significano che il modello saprà ricostruire correttamente qualsiasi tabella. Verificate anche l'accesso effettivo alla GPU in Docker prima di passare all'addestramento.
Passaggio 2 — preparare il crop e la baseline
Una baseline è un metodo di riferimento al quale confronteremo il modello adattato. Evita di concludere che una soluzione sia utile semplicemente perché usa una rete neurale.
docker compose run --rm tutorial python -m pdftables.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli inspect-labels --config configs/minimum.yaml
docker compose run --rm inference python -m pdftables.cli baseline --config configs/minimum.yaml
prepare deve indicare 480 pagine, ripartite in 336/72/72. Ispezionate i crop e le annotazioni di addestramento prima di addestrare: le righe vuote sono presenti? L'intestazione è interamente visibile? Le sue colonne sono rappresentate correttamente? Riservate i riferimenti di test alla valutazione, senza usarli per ritoccare l'inquadratura o le impostazioni.
Il confronto finale riguarderà pdfplumber, TATR preaddestrato e TATR adattato, tutti applicati alle stesse regioni note. La documentazione di pdfplumber descrive un'estrazione basata su linee grafiche o allineamenti delle parole, sulle loro intersezioni e sulle celle ottenute. È un termine di confronto concreto, non un avversario da indebolire intenzionalmente.
Passaggio 3 — adattare e verificare la ripresa
Partiamo dal modello già addestrato Table Transformer structure recognition. Adattare, o fare fine-tuning, consiste nel proseguire l'addestramento sul nostro corpus invece di inizializzare a caso l'intero modello.
In questo progetto vengono adattati solo il decoder, le query apprese e le teste. Il decoder trasforma query e informazioni visive in rappresentazioni utilizzate per le predizioni; le teste ne ricavano classi e riquadri. Gli altri pesi sono congelati: restano usati nel calcolo, ma non vengono modificati dall'addestramento. Il progetto ne conserva un inventario.
Si tratta dunque di un adattamento parziale, non di un riaddestramento completo. Il percorso non confronta qui tutte le possibili strategie di congelamento; non attribuiamogli un risultato che non misura.
docker compose run --rm tutorial python -m pdftables.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli train-continuous --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli train-resume --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli verify-resume --config configs/minimum.yaml
Un'epoca corrisponde a un passaggio sugli esempi di addestramento. Il primo esperimento si interrompe dopo quattro epoche. Il controllo continuo riparte dallo stesso modello preaddestrato e ne esegue otto. La ripresa ricarica l'esperimento interrotto ed esegue le quattro rimanenti.
Perché questa ripetizione? Per verificare che l'interruzione non modifichi l'esperimento. Un checkpoint è un salvataggio del suo stato. Ricaricare soltanto i pesi non basta per proseguire esattamente lo stesso calcolo: occorre anche ritrovare l'ottimizzatore, che ne guida l'aggiornamento, e gli stati dei generatori pseudocasuali, indicati con RNG. La documentazione PyTorch sui checkpoint spiega la differenza tra salvare per predire e salvare per riprendere un addestramento.
Nel percorso convalidato, verify-resume conclude EXACT. Questo risultato riguarda i controlli e l'ambiente di questa riproduzione; non va considerato acquisito dopo un cambiamento di hardware o dipendenze.
Passaggio 4 — predire e misurare
L'inferenza usa i pesi salvati per produrre gli oggetti, ricostruire la griglia e assegnare le parole. La valutazione interviene poi separatamente, con le annotazioni di riferimento.
docker compose run --rm inference python -m pdftables.cli predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdftables.cli evaluate --config configs/minimum.yaml
Collegare ogni difetto a una decisione
Dopo predict, aprite regions-and-grid.png, i riquadri predetti e export/table.json. Cominciate da una tabella, non dalla media generale. Seguite un valore dal PDF fino al suo identificativo di parola, alla sua cella e al suo testo esportato.
Una riga mancante riduce il numero di intersezioni disponibili. Una colonna delimitata male può inviare una parola nella cella sbagliata. Una fusione errata può riunire due celle invece distinte. Una parola non assegnata può rivelare un problema di copertura o di sistema di riferimento. Non tutti questi difetti si correggono addestrando maggiormente la rete.
L'HTML aiuta a ispezionare le fusioni; il CSV facilita una lettura tabellare; il JSON conserva coordinate e identificativi necessari alla diagnosi. Se la visualizzazione sembra corretta, verificate comunque gli importi e le associazioni.
Il valutatore esamina tre livelli: posizioni delle celle, coppie parola-cella e testo normalizzato. Se la struttura degrada, iniziate da fasce e span. Se è corretta ma le associazioni diminuiscono, ispezionate le parole vicine a una frontiera e la soglia di copertura. Se differisce soltanto il testo, verificate l'estrazione dei caratteri e la loro normalizzazione, cioè le trasformazioni applicate prima del confronto.
Una cella vuota merita la stessa attenzione: non eliminatela semplicemente per rendere l'esportazione più compatta. La sua assenza potrebbe nascondere un errore di struttura.
Leggere le metriche prima dei numeri
Precisione, richiamo e F1: tre domande semplici
La precisione chiede: tra gli elementi predetti, quanti sono corretti? Il richiamo chiede: tra gli elementi attesi, quanti ne abbiamo ritrovati? L'F1 combina i due con la formula 2 × precisione × richiamo / (precisione + richiamo) quando il denominatore non è nullo.
Supponiamo che siano attese quattro celle e che ne prediciamo tre, tutte corrette. La precisione vale 3/3 = 1, il richiamo 3/4 = 0,75 e l'F1 circa 0,857. Non abbiamo inventato nulla, ma manca ancora una cella: la sola precisione lo nasconderebbe.
Struttura e associazione: due livelli diversi
La cell F1 confronta le posizioni delle celle, descritte da (inizio riga, fine riga, inizio colonna, fine colonna). Una cella che copre due colonne non equivale a due celle separate. Qui si tratta della struttura della griglia, non solo della somiglianza visiva tra due rettangoli.
L'association F1 confronta le coppie formate da una parola e dalla sua cella. Anche se tutte le parole sono presenti, inviarle nelle colonne sbagliate produce associazioni errate. E due importi identici restano due parole distinte grazie ai loro identificativi.
Questa distinzione spiega perché l'assenza di duplicati in assign_words() non basta: un'assegnazione unica può essere un'assegnazione sbagliata.
Perché un “contenuto perfetto” può trarre in inganno
L'accuratezza condizionale del contenuto considera soltanto le celle comuni tra predizione e riferimento. Risponde alla domanda: “nelle celle di cui è stata ritrovata la posizione, il testo è corretto?”
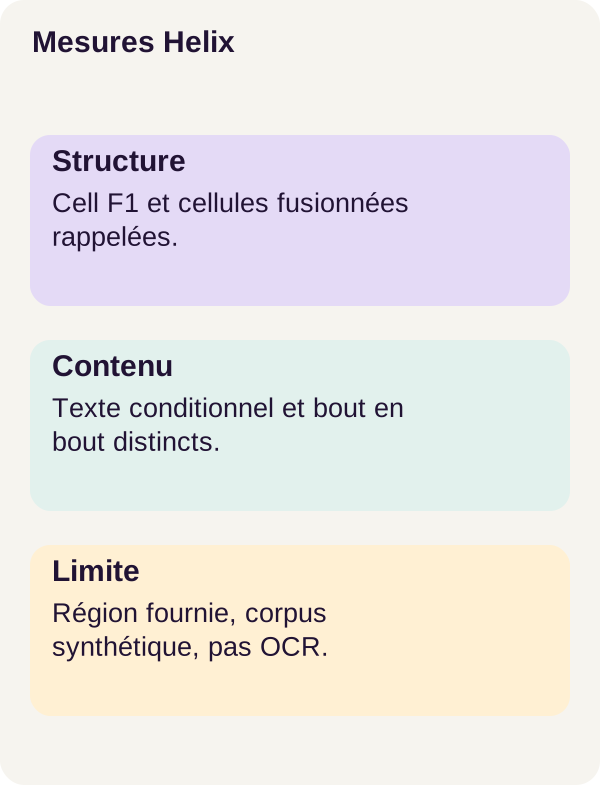
L'accuratezza end-to-end del contenuto usa nel denominatore tutte le celle di riferimento. Penalizza quindi anche le celle mancanti. Qui “end-to-end” resta relativo al percorso del tutorial, con regione fornita e testo nativo: non include rilevamento su pagina intera né OCR.
Prendiamo un esempio didattico con dieci celle attese. Il programma ne ritrova solo due, ma il loro testo è esatto. Il suo contenuto condizionale vale 2/2 = 1. Il suo contenuto end-to-end vale 2/10 = 0,2. Entrambe le misure sono corrette; semplicemente non rispondono alla stessa domanda.
Nei risultati reali della baseline pdfplumber, le 371 celle comuni contengono le parole corrette: il contenuto condizionale vale quindi 1. Eppure, solo 16 tabelle su 72 sono interamente esatte e il contenuto end-to-end vale 0,1593. È proprio l'insidia che bisogna imparare a individuare.
Una tabella intera esatta è un criterio più esigente
table_accuracy richiede insieme struttura e testo esatti per un documento. Una tabella che contiene molte celle corrette e un solo errore non conta come tabella esatta.
Queste metriche sono quelle del progetto: non sono le metriche GriTS. Il repository ufficiale di Table Transformer descrive GriTS, un altro protocollo per confrontare le griglie. Nomi e definizioni non sono intercambiabili; non si possono affiancare numeri calcolati in modo diverso come se misurassero la stessa cosa.
I risultati del percorso r003
Sui 72 documenti di test, i valori sono arrotondati a quattro decimali:
Su mobile, scorrete la tabella orizzontalmente.
| Variante | Cell F1 | Association F1 | Contenuto condizionale | Contenuto end-to-end | Tabelle esatte |
|---|---|---|---|---|---|
| pdfplumber | 0,2748 | 0,3140 | 1,0000 | 0,1593 | 16/72 |
| TATR preaddestrato | 0,8897 | 0,6532 | 0,7473 | 0,6909 | 0/72 |
| TATR adattato | 0,9974 | 0,9858 | 0,9871 | 0,9820 | 67/72 |
L'adattamento migliora qui le misure di struttura, associazione e contenuto rispetto al modello preaddestrato. Ottiene 67/72 tabelle esatte, contro 0/72 per TATR preaddestrato e 16/72 per pdfplumber.
Lo zero del modello preaddestrato non significa che non trovi nulla: il suo cell F1 vale 0,8897. Significa che nessuna delle 72 tabelle soddisfa simultaneamente tutti i criteri di esattezza. Gli errori possono essere poco numerosi in ogni documento e bastare a far fallire questo criterio severo.
Il risultato adattato conserva 80/80 celle unite, ma cinque tabelle non sono esatte. Ritrovare bene le fusioni non garantisce quindi che tutta la struttura e tutto il contenuto siano corretti. Per un importo, un errore localizzato conta più dell'impressione generale di una tabella ben disegnata.
Questi risultati riguardano i crop Helix sintetici di questo percorso. Non dimostrano la stessa qualità su scansioni, tabelle reali, fatture o rilevamento su pagina intera.
Cosa abbiamo imparato
Estrarre una tabella richiede di ricostruirne l'organizzazione, poi di ritrovare i legami tra celle e parole. TATR propone oggetti visivi; la post-elaborazione trasforma queste proposte in fasce, intersezioni e fusioni; l'assegnazione geometrica vi colloca il testo nativo.
La provenienza rende queste decisioni ispezionabili. Consente di risalire da un valore esportato alle sue parole e coordinate, ma non garantisce da sola che la decisione sia corretta.
Infine, forma e contenuto si controllano separatamente. Una cella vuota deve rimanere visibile, una fusione non deve duplicare il testo e un buon punteggio condizionale non deve nascondere le celle assenti. Sul corpus di riferimento, l'adattamento offre un guadagno misurato, senza rendere esatte tutte le 72 tabelle.
Esercizio — distinguere forma e contenuto
Prima di eseguire lo scenario, prendetevi un momento per predire i risultati. Immaginate anzitutto che due colonne siano unite senza modificare le parole. Conservare tutto il testo basta a mantenere buone misure di struttura e associazione?
Immaginate ora di sostituire una cifra, mentre celle e identificativi delle parole restano al loro posto. Quali misure possono restare buone? La tabella deve ancora essere considerata esatta? Annotate il vostro ragionamento prima dei comandi.
docker compose run --rm tutorial python -m pdftables.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Il primo comando esegue l'esercizio fornito. Il successivo produce le figure dagli output, poi l'ultimo controlla i checkpoint, i file salvati del modello.
Nel primo scenario, gli span cambiano e le parole non sono più associate alle stesse celle: struttura e associazioni peggiorano, anche senza perdita di parole.
Nel secondo, la griglia può rimanere corretta mentre il testo diventa falso. Se identificativi e assegnazioni sono mantenuti, le misure di associazione non rilevano da sole la sostituzione della cifra; occorre esaminare il contenuto. Una tabella può quindi essere perfettamente strutturata e contenere un valore errato.
Confrontate le tabelle e le loro misure con le ipotesi annotate. Non correggete né le parole né le annotazioni per ottenere un punteggio migliore: l'esercizio serve proprio a rendere visibile questa dissociazione.
Potete anche rifare a mano il calcolo della copertura della parola di 100 pixel quadrati. Con 60 pixel quadrati in una cella, viene accettata alla soglia 0.5. Con solo 40 e nessun'altra cella sufficientemente coprente, resta non assegnata. Questo calcolo didattico non richiede alcun nuovo addestramento.
Adattare, risolvere problemi e pulire
Diagnosticare prima di cambiare il modello
La GPU è visibile in Linux, ma CUDA fallisce in Docker? Verificate anzitutto l'integrazione con la documentazione NVIDIA Container Toolkit. CUDA è l'ambiente usato per i calcoli sulla GPU; una scheda visibile lato host non prova che il programma containerizzato possa usarla.
L'intestazione è tagliata? Esaminate la regione fornita e il margine del crop. Un modello non può ricostruire fedelmente ciò che è stato rimosso dal suo input. Per i vostri documenti, correggete l'inquadratura prima di una nuova predizione. Per misurare il protocollo di test, non riadattate questa inquadratura in funzione delle risposte attese.
Una parola sembra scomparsa? Consultate unassigned_word_ids, quindi verificate il riquadro della parola, il crop e la soglia di copertura. Non aggiungetela arbitrariamente a una cella per migliorare la visualizzazione. Verificate anche l'ordine delle parole prima di assemblarle: assign_words() conserva l'ordine ricevuto.
L'HTML sembra corretto, ma le cifre sono sbagliate? Tornate al JSON di provenienza e confrontate le parole sorgenti. Un cambiamento di colonna o di carattere non richiede la stessa diagnosi di una riga assente.
Passare ai vostri documenti: un'estensione da valutare
In un'applicazione reale, separate il rilevamento delle tabelle, l'OCR se il documento ne ha bisogno, la ricostruzione della struttura e i controlli del contenuto. Queste fasi aggiuntive non sono convalidate dai punteggi del tutorial.
Aggiungete controlli adatti ai dati: tipi attesi, unità, formati numerici e validazione umana dei casi ambigui. Una stringa come 12.50 deve prima essere estratta e localizzata correttamente; la sua interpretazione come importo appartiene a un'altra decisione dell'applicazione.
Registrate regione, scala, punteggi, parole non assegnate e versione del modello. Conservate annotazioni affidabili rappresentative dei vostri documenti per misurare gli errori. Un'interfaccia di revisione potrebbe, per esempio, permettere di fare clic su una cella esportata per ritrovare le sue parole nella pagina: è una pista di integrazione, non una funzionalità annunciata come presente nello ZIP.
I riferimenti ufficiali collegati nell'articolo servono ad approfondire i meccanismi: Table Transformer e DETR per le predizioni, GIoU per la geometria, pdfplumber per l'estrazione, PyTorch per i salvataggi e NVIDIA per l'accesso GPU. Non sostituiscono i file e i comandi del percorso r003.
Conservare le esportazioni, poi pulire
Copiate risultati e figure che desiderate conservare prima di eseguire i comandi seguenti. La pulizia elimina solo outputs/; conserva data/generated/ e assets/checkpoints/.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Il primo comando arresta il progetto. Il servizio tutorial esegue poi la pulizia mirata, quindi l'ultimo arresto conclude il percorso. Non è necessario eliminare globalmente i dati Docker per studiare questo tutorial.