





Vous développez un écran de gestion documentaire. Votre objectif semble simple : proposer une catégorie pour chaque document, afin de faciliter son classement. Vous commencez par quelques conditions : un titre contient « brouillon », un paragraphe demande une relecture, une autre phrase annonce une approbation.
Puis arrive la pièce fictive V-033. Son titre contient « validé », mais son corps indique « pour relecture ». Quelle règle faut-il croire ? Donner systématiquement la priorité au titre ne résout pas le problème : un titre peut aussi contenir une négation ou une ancienne mention.
C’est le point de départ de la supervision faible : utiliser des indices imparfaits pour construire des données d’apprentissage, sans les traiter comme des réponses certaines. Ici, nous allons écrire des règles, apprendre à combiner leurs avis, puis entraîner un classifieur textuel à partir du résultat.
Le programme propose des classes pour des documents fictifs. Il ne modifie aucun statut administratif et ne déduit pas une approbation réelle d’un titre. Notre question sera plus modeste, mais mesurable : cette chaîne apprend-elle quelque chose d’utile, ou fait-elle moins bien qu’une méthode plus simple ?
Télécharger le projet complet du tutoriel
Ce que vous allez construire
Le parcours suit document → votes de règles → probabilités de classes → classifieur textuel → proposition.
Une classe est simplement une catégorie à prédire. Une règle peut en proposer une, ou ne pas se prononcer. Le premier modèle reçoit ces votes et estime une répartition de probabilités entre les trois classes. Par exemple, il peut accorder davantage de probabilité à EN_REVUE tout en conservant une hésitation avec ANNONCE_APPROUVE.
Un second modèle, le classifieur textuel, apprend ensuite à partir du texte des documents et de ces distributions. Les deux modèles ont donc des entrées différentes : le premier combine les avis des règles ; le second apprend à classer le texte. Ce tutoriel n’utilise pas un grand modèle de langage chargé de rédiger une réponse.
Pourquoi ne pas s’arrêter aux règles ? Parce que nous voulons tester si leur combinaison permet de fournir un signal d’apprentissage utile au classifieur. C’est une possibilité à évaluer, pas un bénéfice acquis. Le principe général est présenté dans cette introduction à la supervision faible par l’équipe de recherche de Stanford. Le projet du ZIP en expose un mécanisme limité, dont nous pouvons suivre les calculs.
Nous comparerons quatre méthodes : le vote majoritaire, le modèle qui combine les votes, un classifieur entraîné sur quelques annotations fiables et le classifieur utilisant la supervision faible. Au passage, nous expliquerons l’abstention, les variables latentes et l’algorithme EM, sans supposer que vous les connaissez déjà.
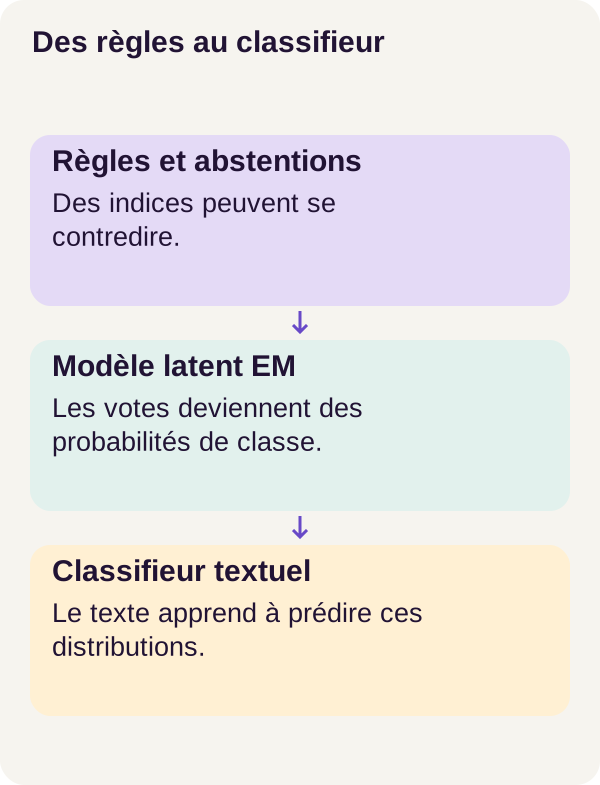
Une règle constitue un indice imparfait, pas une annotation fiable.
Préparer un environnement CPU reproductible
Vous devez savoir lire du Python, utiliser un terminal et lancer Docker. Un tableau numérique est ici un ensemble de nombres organisés en lignes et en colonnes ; nous préciserons ce que représentent ses dimensions à chaque étape.
Ce projet est validé sur CPU, c’est-à-dire sur le processeur de la machine. Aucun GPU NVIDIA n’est nécessaire. Le README recommande 12 Gio de RAM et 6 Gio de disque de travail, auxquels s’ajoute le stockage Docker. Ce sont des indications de préparation, pas des mesures de consommation garanties.
Décompressez le ZIP et ouvrez un terminal dans son dossier racine, celui qui contient README.md. Toutes les commandes suivantes partent de ce répertoire. Vérifiez l’environnement, préparez les dossiers, puis construisez les services.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference
Le premier script effectue les contrôles préalables. Le second prépare les répertoires. docker compose config --quiet vérifie la configuration Compose ; build construit les environnements nécessaires au parcours. Corrigez une erreur bloquante avant de passer à l’étape suivante.
Les services séparent les rôles : tutorial prépare les données et les évaluations ; learning reçoit les entrées d’apprentissage et les annotations autorisées ; inference produit les prédictions sans consulter les réponses attendues. assets/ conserve les états appris et outputs/ les résultats. Le fichier Compose du ZIP détaille les montages et les restrictions.
Le modèle est initialisé localement : nous n’allons pas télécharger les poids d’un modèle préentraîné. L’étape acquisition vérifie ici un registre vide et ne télécharge aucun poids tiers. Elle reste présente dans le parcours, avant le contrôle de l’environnement conteneurisé et les tests.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Le parcours de référence rapporte 24 tests réussis. Ils vérifient des comportements du programme et le rejet de cas invalides. Ne les confondez pas avec une mesure de qualité documentaire : des tests réussis ne signifient pas que toutes les propositions de classe sont justes.
Lire les données et les annotations
Les trois classes du projet sont BROUILLON, EN_REVUE et ANNONCE_APPROUVE. La dernière désigne une annonce dans un document fictif, pas une validation légale. Les textes peuvent contenir des négations, des mentions anciennes ou des titres trompeurs.
Le code représente les classes par des entiers. Voici le petit dictionnaire à garder en tête :
| Valeur | Signification |
|---|---|
0 |
BROUILLON |
1 |
EN_REVUE |
2 |
ANNONCE_APPROUVE |
-1 |
Abstention : aucune classe proposée. |
-1 n’est pas une quatrième catégorie de document. C’est une information sur le comportement d’une règle ou d’une méthode : elle ne se prononce pas.
Une annotation, aussi appelée label ou étiquette, indique la classe de référence d’un exemple. Le corpus comporte des ensembles séparés pour l’apprentissage, la validation et le test. L’apprentissage sert à ajuster les paramètres ; la validation permet d’examiner le comportement pendant le développement ; le test sert à mesurer le résultat final sur des documents séparés.
Le test contient 360 documents, avec 120 références de chaque classe. Nous disposons également de 90 ancrages : des exemples d’apprentissage dont la classe est connue. Le mot « ancrage » décrit leur rôle : ils donnent des points de repère fiables au modèle intermédiaire. Ils servent aussi à entraîner un petit classifieur de comparaison, sans supervision faible.
Nous ne sommes donc pas dans un apprentissage dépourvu de toute annotation. La question est de savoir ce que les règles apportent en plus de ces exemples fiables.
Créons les données.
docker compose run --rm tutorial python -m ged_supervision_faible_statuts.cli prepare --config configs/minimum.yaml
Observez la séparation entre les textes et les annotations. Le programme peut lire le titre, le corps et les métadonnées autorisées d’un document. Il ne doit pas lire sa réponse de test pour fabriquer une prédiction. Les 90 ancrages sont une partie explicitement autorisée de la supervision ; les références du test restent réservées à l’évaluation.
Construire des règles qui peuvent s'abstenir
Une règle produit un avis, pas une certitude
Une fonction d’étiquetage est une fonction Python qui cherche un indice et retourne une classe, ou -1 lorsqu’elle n’a aucun avis. Pour un développeur web, pensez à la distinction entre une valeur absente et une valeur égale à zéro : ici, « je ne sais pas » ne doit jamais devenir BROUILLON par défaut.
Le projet comporte huit règles. Certaines inspectent le titre, d’autres le corps ; une autre utilise une date d’export. Cette dernière encode volontairement une corrélation fictive fragile : un export tardif ne prouve pas une approbation.
Voici la fonction centrale. Les extraits de l’article se lisent avec les constantes et les fonctions auxiliaires du ZIP ; les commandes exécutent le projet complet.
def apply_label_functions(document):
    title = normalize(document["title"])
    body = normalize(document["text"])
    date = document.get("export_date")
    # Deliberately imperfect: title rule ignores negation, body approval excludes quoted and negated mentions.
    tests = [
        ("valide" in title, 2, "validé dans le titre"),
        ("provisoire" in title or "brouillon" in title, 0, "titre provisoire"),
        ("relecture" in title, 1, "titre relecture"),
        (
            "pour relecture" in body and "pas pour relecture" not in body,
            1,
            "corps pour relecture",
        ),
        ("version de travail" in body, 0, "corps version de travail"),
        (
            "annonce une approbation obtenue" in body
            and "aucune signature" not in body,
            2,
            "annonce positive et absence de négation détectée",
        ),
        (
            bool(date and date >= "2026-08-26"),
            2,
            "export tardif : corrélation fictive, pas approbation",
        ),
        ("commentaires attendus" in body, 1, "commentaires attendus"),
    ]
    return [
        {
            "rule": name,
            "vote": k if active else ABSTAIN,
            "reason": reason if active else "aucun motif reconnu",
        }
        for name, (active, k, reason) in zip(RULES, tests)
    ]
normalize() harmonise la casse et les accents avant la recherche. Cela facilite la comparaison de chaînes, mais ne donne pas à la règle une compréhension de la phrase.
Chaque élément de tests contient trois informations : une condition, le numéro de classe proposé si elle est vraie et une justification textuelle. zip(RULES, tests) associe ces éléments aux noms des règles. Le résultat conserve rule, vote et reason, ce qui permet de retrouver l’origine d’un avis.
Regardez la première condition : elle cherche simplement valide dans le titre normalisé. Elle ignore volontairement la négation. À titre de contre-exemple pédagogique, un titre « Non validé » contient lui aussi cette chaîne après normalisation. La règle peut donc voter dans le mauvais sens tout en exécutant exactement le code prévu.
Les conditions du corps sont un peu plus sélectives : l’une exclut la formulation pas pour relecture, une autre vérifie l’absence de aucune signature. Ce sont des tests de chaînes précis, pas un analyseur général de négations ou de citations. Le commentaire de l’extrait doit se lire dans ce périmètre restreint.
Enfin, la date 2026-08-26 est le seuil fixé dans la règle d’export du corpus fictif. Ce n’est ni une date à remplacer par celle du jour, ni une règle métier à transposer telle quelle.
Pour V-033, le titre et le corps nous donnent ainsi des indices contradictoires. Nous allons les conserver plutôt que masquer le conflit par un ordre arbitraire de conditions.
Commencer par une majorité simple
Avant d’apprendre à combiner les règles, calculons une référence sans apprentissage, ou baseline : compter les votes.
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli baseline --config configs/minimum.yaml
outputs/rules.json décrit les conflits et les abstentions. La majorité renvoie un avis vide si aucune règle ne vote ou si plusieurs classes arrivent en tête à égalité. Elle ne choisit pas la première classe uniquement pour produire une réponse.
Le tableau votes comporte une ligne par document et une colonne par règle, soit huit colonnes dans le parcours principal. La fonction suivante transforme ce tableau en proportions de votes et en décisions.
def majority_vote(votes):
    counts = np.stack([(votes == k).sum(1) for k in range(3)], axis=1)
    total = counts.sum(1)
    probabilities = np.divide(
        counts,
        total[:, None],
        out=np.full(counts.shape, 1 / 3, dtype=np.float64),
        where=total[:, None] > 0,
    )
    tied = (counts == counts.max(1, keepdims=True)).sum(1) > 1
    predicted = np.where((total == 0) | tied, -1, counts.argmax(1))
    return probabilities, predicted
Pour chaque classe k, (votes == k).sum(1) compte les avis correspondants sur chaque document. np.stack(..., axis=1) rassemble ces comptes en trois colonnes, dans l’ordre BROUILLON, EN_REVUE, ANNONCE_APPROUVE. total compte uniquement les votes exprimés : les -1 ne sont ajoutés à aucune classe.
total[:, None] donne au total une forme en colonne, afin de diviser les trois comptes d’une ligne par le même nombre. Le paramètre where évite une division par zéro. Lorsqu’aucune règle ne parle, out fournit une distribution uniforme : un tiers pour chaque classe.
Mais une distribution n’est pas encore une décision. tied repère les égalités, et np.where impose une prédiction -1 lorsque le total est nul ou que plusieurs classes gagnent.
Prenons trois petits exemples pédagogiques, limités à trois règles pour lire les calculs facilement. Ce ne sont pas les sorties complètes de V-033.
Avec les votes [1, 1, 2], les comptes sont [0, 2, 1]. La distribution vaut [0 ; 2/3 ; 1/3] et la décision est 1, donc EN_REVUE.
Avec [2, 1, -1], les comptes sont [0, 1, 1]. La distribution vaut [0 ; 0,5 ; 0,5], mais la décision reste -1 : il y a égalité.
Avec [-1, -1, -1], la distribution vaut [1/3 ; 1/3 ; 1/3] et la décision est également -1. Cette fois, personne n’a voté.
Les deux derniers cas conduisent à la même abstention, mais pas pour la même raison. Conserver les votes et les probabilités permet de comprendre cette différence.
Estimer une classe cachée avec EM
Le problème : connaître les classes pour évaluer les règles… et inversement
Le vote majoritaire donne le même poids à tous les avis. Nous aimerions aller plus loin : une règle se trompe-t-elle souvent sur une classe ? Confond-elle un brouillon avec un document en revue ? Son avis apporte-t-il quelque chose lorsque d’autres règles la contredisent ?
La difficulté est circulaire. Pour connaître les erreurs des règles, il faudrait connaître les classes des documents. Pour estimer ces classes, nous voulons justement utiliser les règles.
Une variable latente est une information non directement observée. Ici, c’est la classe de référence d’un document lorsqu’elle ne fait pas partie des ancrages. Le modèle va maintenir des hypothèses probabilistes sur cette classe, au lieu de décider immédiatement qu’elle vaut 0, 1 ou 2.
Trois tableaux à comprendre
pi contient les proportions de classes estimées. Par exemple, [0,2 ; 0,5 ; 0,3] signifie que, sans nouvel indice, le modèle répartit ses probabilités à 20 %, 50 % et 30 %. Ces valeurs appartiennent à l’exemple numérique fourni plus loin ; ce ne sont pas les proportions apprises du corpus annoncées à l’avance.
theta décrit le comportement de chaque règle. Ses dimensions suivent l’ordre règle, classe latente, vote observé. Avec huit règles et trois classes, sa forme est (8, 3, 3). Une case theta[j, k, c] représente la probabilité attribuée au vote c de la règle j lorsque la classe supposée est k. Une case hors de la diagonale représente donc une confusion possible, pas nécessairement une erreur de programmation.
q contient une distribution par document. Avec N documents, sa forme est (N, 3). Une ligne indique à quel point chaque classe est plausible selon les paramètres actuels. Dans le vocabulaire d’EM, ces valeurs sont aussi appelées responsabilités : elles feront contribuer partiellement le document à plusieurs classes lors de la mise à jour.
Ici, theta ne comporte pas de colonne pour -1. Les abstentions sont ignorées dans le calcul des votes ; leur fréquence n’est pas modélisée comme une quatrième sortie.
Alterner estimation et mise à jour
EM signifie Expectation-Maximization. L’algorithme alterne deux opérations : l’étape E estime q avec les paramètres actuels ; l’étape M recalcule pi et theta avec ces distributions. Les ancrages gardent leur classe connue pendant ce processus.
Autrement dit : « Avec ce que je sais des règles, quelles classes sont plausibles ? Puis, avec ces classes plausibles, comment dois-je réestimer le comportement des règles ? »
Le modèle fait une simplification importante : il suppose les votes indépendants lorsque la classe réelle est connue. Cela permet de multiplier leurs contributions. Mais deux règles copiées ne constituent pas deux observations indépendantes : elles suivent exactement le même indice. Nous testerons cette limite dans l’exercice.
Additionner les indices sans perdre les petites probabilités
Le calcul commence en logarithmes. Le logarithme transforme un produit en somme : au lieu de multiplier plusieurs probabilités, le programme additionne leurs logarithmes.
def log_joint(votes, pi, theta):
    result = np.broadcast_to(np.log(pi), (len(votes), 3)).copy()
    for j in range(votes.shape[1]):
        rows = np.flatnonzero(votes[:, j] >= 0)
        for k in range(3):
            result[rows, k] += np.log(theta[j, k, votes[rows, j]])
    return result
np.broadcast_to(...).copy() prépare une ligne de trois scores par document, initialisée avec log(pi). La boucle parcourt ensuite les règles. np.flatnonzero(votes[:, j] >= 0) sélectionne uniquement les documents pour lesquels la règle j a exprimé un avis.
Pour chaque classe possible k, le programme ajoute la contribution du vote effectivement observé. Il ne compte donc plus seulement « combien de règles ont choisi cette classe ? » ; il demande « ces votes sont-ils plausibles si cette classe est la bonne ? ».
À ce stade, les scores ne forment pas encore une distribution normalisée. C’est le rôle de l’étape E.
def e_step(votes, pi, theta, anchors):
    validate_inputs(votes, pi, theta, anchors)
    joint = log_joint(votes, pi, theta)
    q = np.exp(joint - logsumexp(joint)[:, None])
    for i, k in anchors.items():
        q[i] = np.eye(3)[k]
    return q
La ligne qui construit q remet les trois scores d’un document sous forme de probabilités dont la somme vaut un. logsumexp sert à effectuer cette normalisation de manière stable, même avec de très petites probabilités.
La normalisation doit se faire document par document. L’expression logsumexp(joint)[:, None] attend ici un normalisateur par ligne, pour le soustraire aux trois scores correspondants. Conservez la fonction auxiliaire du projet : une fonction de bibliothèque portant le même nom peut demander un axe explicite. La documentation SciPy de logsumexp explique ce calcul et le rôle de cet axe ; ce n’est pas une instruction de remplacement du code.
Enfin, np.eye(3)[k] construit une cible certaine pour un ancrage. Si sa classe connue est 1, sa ligne devient [0, 1, 0]. Les règles ne peuvent pas lui substituer leur propre hypothèse.
Pour un document sans vote et sans ancrage, aucun nouvel indice n’a été ajouté : q reste égal à pi. S’il s’agit d’un ancrage, sa classe connue prend le dessus, même sans vote.
Compter des contributions partielles avec l’étape M
Passons maintenant de ces hypothèses aux nouveaux paramètres.
def m_step_map(votes, q, alpha=1.1):
    if (
        alpha <= 1
        or q.shape != (len(votes), 3)
        or (q < 0).any()
        or not np.isfinite(q).all()
        or not np.allclose(q.sum(1), 1)
    ):
        raise ValueError("Invalid responsibilities or Dirichlet prior")
    pi = q.sum(0) + alpha - 1
    pi /= pi.sum()
    theta = np.full((votes.shape[1], 3, 3), alpha - 1, dtype=np.float64)
    for j in range(votes.shape[1]):
        for c in range(3):
            theta[j, :, c] += q[votes[:, j] == c].sum(0)
    theta /= theta.sum(2, keepdims=True)
    return pi, theta
Les contrôles initiaux exigent une distribution valide par document : trois composantes, aucune valeur négative ou non finie, et une somme proche de un. Une valeur « non finie » désigne notamment un infini ou NaN, le résultat numérique d’un calcul indéfini.
q.sum(0) additionne les contributions de tous les documents à chaque classe. Un document dont la distribution est [0,1 ; 0,7 ; 0,2] contribue ainsi pour 0,1 à la première classe, 0,7 à la seconde et 0,2 à la troisième. C’est un comptage pondéré, pas une conversion prématurée en étiquette certaine.
Pour theta, q[votes[:, j] == c].sum(0) ne conserve que les documents sur lesquels la règle j a voté c. Leurs contributions sont ajoutées à la colonne de ce vote, puis chaque distribution est normalisée sur les trois votes possibles.
Le paramètre alpha=1.1 apporte un petit a priori de Dirichlet. Concrètement, ce code ajoute alpha - 1, soit 0,1, aux comptes avant normalisation. Cela évite une probabilité exactement nulle uniquement parce qu’une combinaison n’a reçu aucune contribution. Le suffixe map désigne l’estimation maximum a posteriori : les observations sont combinées à cet a priori.
Ce lissage évite certains blocages numériques ; il ne crée pas de nouvelles connaissances sur les documents. Les hypothèses du modèle et la qualité des règles continuent de limiter le résultat.
Observer le petit exemple avant l’apprentissage complet
Exécutons d’abord le calcul illustratif fourni.
docker compose run --rm tutorial python -m ged_supervision_faible_statuts.cli inspect-mechanism --config configs/minimum.yaml
Dans outputs/mechanism.json, la matrice illustrative n’est pas le résultat entraîné du corpus. Pour les votes [2, 1, -1], la distribution obtenue vaut environ [0,0403 ; 0,5369 ; 0,4228]. Sa somme vaut un, à l’arrondi près. Pour la ligne sans vote, elle reste [0,2 ; 0,5 ; 0,3].
Comparez avec la majorité : les mêmes deux avis contradictoires lui donnaient une égalité. Ici, les proportions de classes et les paramètres des règles produisent une autre répartition. Il n’y a pas eu de nouveau vote : c’est la manière d’interpréter les votes qui a changé. Ces nombres n’indiquent pas à eux seuls que l’interprétation est correcte.
Ajustons maintenant EM sur les données d’apprentissage, avec une interruption, un témoin continu, puis une reprise et son contrôle.
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli fit-em --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli fit-em --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli fit-em --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli verify-em --config configs/minimum.yaml
interrupt interrompt le calcul prévu pour le test de reprise ; continuous fournit le parcours témoin ; resume reprend l’état sauvegardé. verify-em compare les parcours concernés.
Un checkpoint est un état enregistré permettant de retrouver un calcul. Reprendre ne consiste pas à redémarrer avec des paramètres quelconques : il faut retrouver l’état et la progression attendus. Examinez les distributions obtenues et le contrôle de reprise avant de passer au classifieur.
Entraîner le classifieur sur des cibles souples
Ne pas transformer une hésitation en certitude
Une cible est le résultat que l’on demande au modèle d’apprendre. Une cible classique indique une classe unique. Une cible souple conserve au contraire une distribution entre les classes.
Prenons la distribution pédagogique [0,04 ; 0,54 ; 0,42], proche de l’exemple précédent. La remplacer par [0, 1, 0] ferait disparaître l’hésitation entre EN_REVUE et ANNONCE_APPROUVE. Avec la cible souple, le classifieur reçoit aussi cette incertitude estimée. Cela ne rend pas la cible plus vraie, mais évite de la présenter comme une certitude qu’elle n’a pas.
Transformer le texte en nombres avec TF-IDF
Le classifieur reçoit une représentation TF-IDF du titre et du corps, pas directement le tableau des huit votes. Un vecteur est une suite de nombres ; ici, ses coordonnées décrivent les termes retenus dans le texte.
TF, pour term frequency, reflète la fréquence d’un terme dans le document. IDF, pour inverse document frequency, tient compte de sa rareté dans les documents d’apprentissage. Leur combinaison pondère les termes, puis le projet normalise le vecteur.
Pour l’intuition, imaginez que presque tous les documents contiennent le mot « document », mais que seuls certains contiennent « relecture ». Le second peut fournir un indice plus distinctif. Cela ne veut pas dire qu’un terme rare révèle automatiquement la bonne classe : sa valeur dépend des données et de l’apprentissage. La documentation scikit-learn sur TF-IDF approfondit cette représentation ; les choix exacts du parcours restent ceux du ZIP.
Nous avons donc deux objets à ne pas confondre : le vecteur de texte, qui sert d’entrée, et la distribution sur les trois classes, qui sert de cible. Le nombre de caractéristiques du texte n’est pas le nombre de classes à prédire.
Comprendre la fonction de perte
Le projet utilise un MLP, ou perceptron multicouche : un réseau de couches linéaires séparées par des activations. Les couches combinent les valeurs d’entrée avec des paramètres appris ; les activations permettent de ne pas se limiter à une simple transformation linéaire.
Le réseau produit trois logits, c’est-à-dire trois scores bruts. Ils ne sont pas encore des probabilités et n’ont pas à avoir une somme égale à un. Pendant l’entraînement, une fonction de perte mesure l’écart avec la cible. L’apprentissage ajuste les paramètres pour réduire cette perte ; les gradients indiquent comment une variation des paramètres affecte le calcul.
Voici la perte utilisée avec les cibles souples.
def soft_cross_entropy(logits, targets):
    if (
        logits.shape != targets.shape
        or logits.ndim != 2
        or not torch.isfinite(targets).all()
        or (targets < 0).any()
        or not torch.allclose(
            targets.sum(1), torch.ones(len(targets), dtype=targets.dtype)
        )
    ):
        raise ValueError("Expected a distribution per example")
    return -(targets * F.log_softmax(logits, dim=-1)).sum(1).mean()
logits et targets doivent avoir la même forme : une ligne par exemple du lot et trois colonnes. Le lot, ou batch, est le groupe de documents traité ensemble. Les contrôles vérifient notamment que les cibles sont finies, positives ou nulles et normalisées.
F.log_softmax(logits, dim=-1) transforme les scores en logarithmes de probabilités sur les classes. La multiplication par targets pondère chaque contribution selon la cible. .sum(1) additionne les contributions des trois classes pour chaque document, puis .mean() calcule la moyenne sur le lot. Le signe moins produit la perte d’entropie croisée.
La documentation PyTorch de l’entropie croisée décrit aussi ce cas de cibles probabilistes. Elle rappelle que leur validité doit être contrôlée par le code appelant : des nombres quelconques ne deviennent pas une distribution uniquement parce qu’on les transmet à une fonction de perte.
Apprendre avec davantage de cibles n’aide pas nécessairement si elles sont peu informatives. Si les distributions hésitent presque également entre les classes, le réseau reçoit un signal très différent de celui d’une annotation fiable. Il faut mesurer ce qu’il en fait, pas supposer que le second modèle corrigera automatiquement le premier.
Entraîner et vérifier la reprise
Exécutez les entraînements interrompu, continu et repris, puis comparez les états.
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli verify-resume --config configs/minimum.yaml
Le parcours contrôle séparément la reprise d’EM et celle du classifieur. Ce sont deux calculs distincts, avec leurs propres états appris. Les résultats de référence établissent leur reproductibilité dans cet environnement CPU ; ils ne garantissent pas une identité numérique après un changement de dépendances ou d’environnement.
Produisons ensuite les deux prédictions : le classifieur utilisant seulement les 90 ancrages, puis celui utilisant la supervision faible.
docker compose run --rm inference python -m ged_supervision_faible_statuts.cli predict --config configs/minimum.yaml --variant anchors
docker compose run --rm inference python -m ged_supervision_faible_statuts.cli predict --config configs/minimum.yaml --variant main
À ce stade, nous faisons de l’inférence : nous utilisons les paramètres appris pour prédire. Ce n’est plus l’étape où nous ajustons les paramètres à partir des cibles. Le service inference ne voit pas les classes de référence.
Les fichiers predictions-anchors.json et predictions-main.json permettent de comparer les méthodes document par document. Retrouvez V-033 et demandez-vous : les deux classifieurs proposent-ils la même classe ? Quelle hésitation leurs distributions expriment-elles ? Ne déduisez pas la réponse du seul mot « validé » : inspectez les sorties effectivement produites.
Comprendre les métriques avant les résultats
Une métrique est une mesure choisie pour évaluer le programme. Ici, nous voulons examiner trois choses différentes : la méthode se prononce-t-elle, classe-t-elle correctement et attribue-t-elle des probabilités utiles ? Un seul nombre ne répond pas à ces trois questions.
Couverture et accuracy : répondre n’est pas réussir
La couverture est la part des documents pour lesquels une méthode prend une décision. Sur dix documents, une méthode qui en classe sept et s’abstient sur trois a une couverture de 0,7, même si ses sept décisions sont correctes.
L’accuracy, ou exactitude, compte les décisions correctes. Dans ce projet, son dénominateur comprend les 360 documents de test, abstentions incluses. On ne retire donc pas les documents difficiles pour améliorer artificiellement le score.
Une couverture de 1 signifie « une décision pour chaque document », pas « toutes les décisions sont justes ». Inversement, une méthode peut faire de bonnes propositions tout en laissant beaucoup de documents sans réponse.
Précision, rappel et macro-F1 : regarder les classes séparément
Pour une classe donnée, la précision demande : parmi les documents que j’ai placés dans cette classe, combien y appartiennent réellement ? Le rappel demande : parmi les documents qui devaient y être placés, combien ai-je retrouvés ?
Prenons un exemple pédagogique : vous prédisez quatre documents EN_REVUE, dont trois corrects, alors que cinq étaient attendus. La précision vaut 3/4, soit 0,75 ; le rappel vaut 3/5, soit 0,60. Le F1 combine les deux par 2 × précision × rappel / (précision + rappel), soit environ 0,6667 ici.
Le macro-F1 calcule le F1 de chacune des trois classes, puis en fait la moyenne. Chaque classe compte autant dans cette moyenne. Une abstention sur un document attendu dans une classe constitue une référence manquée : elle diminue son rappel.
Le macro-F1 ne représente donc pas directement le pourcentage de documents bien classés. Il ne vérifie pas non plus si la confiance affichée par la méthode est justifiée.
Brier et log-loss : évaluer aussi les probabilités
Le score de Brier compare toute la distribution prédite au vecteur de la classe de référence. Dans la convention du projet, on additionne les trois erreurs au carré, puis on moyenne sur les documents. Sa plage est de 0 à 2, et une valeur plus basse est préférable. La documentation du Brier multiclasse présente cette définition ; vérifiez toujours la convention utilisée avant de comparer des scores issus de projets différents.
Pour un calcul pédagogique, supposons que la référence soit EN_REVUE. Son vecteur est [0, 1, 0]. Avec la prédiction [0,1 ; 0,7 ; 0,2], l’erreur est :
(0,1 - 0)² + (0,7 - 1)² + (0,2 - 0)² = 0,14.
Une prédiction exactement égale à la référence donne zéro. Une certitude totale placée sur la mauvaise classe donne deux.
La log-loss regarde la probabilité attribuée à la classe correcte, avec le calcul -log(probabilité correcte) pour un document. Si cette probabilité vaut 0,9, la perte est d’environ 0,1054 ; si elle vaut 0,01, la perte monte à environ 4,6052. Une erreur très assurée est donc fortement pénalisée. Le principe est détaillé dans la documentation de la log-loss.
Ces deux scores évaluent les probabilités, mais ne sont pas interchangeables. Ils ne constituent pas non plus, à eux seuls, un diagnostic complet de calibration, c’est-à-dire de l’accord entre la confiance annoncée et la fréquence des réussites. La documentation sur la calibration explique notamment pourquoi le Brier mélange plusieurs aspects de la qualité prédictive.
Calculer et interpréter les résultats
Lançons l’évaluation.
docker compose run --rm tutorial python -m ged_supervision_faible_statuts.cli evaluate --config configs/minimum.yaml
Les valeurs suivantes sont arrondies ; elles portent sur les 360 documents de test.
Sur mobile, faites défiler le tableau horizontalement.
| Méthode | Couverture | Macro-F1 | Brier | Log-loss |
|---|---|---|---|---|
| Vote majoritaire | 0,7444 | 0,7721 | 0,2735 | 1,4439 |
| Modèle latent EM | 1,0000 | 0,3789 | 0,6666 | 1,0985 |
| Classifieur sur 90 ancrages | 1,0000 | 0,7666 | 0,4260 | 0,7594 |
| Classifieur avec supervision faible | 1,0000 | 0,6118 | 0,6344 | 1,0511 |
La majorité obtient le meilleur macro-F1 du tableau, mais elle s’abstient sur 92 documents. Elle prend donc une décision sur 360 - 92 = 268 documents, soit 268/360 ≈ 0,7444 de couverture. Il faut lire les deux colonnes ensemble.
Son Brier est également le plus bas, mais sa log-loss est la plus élevée. Ce n’est pas une contradiction : les mesures ne pénalisent pas de la même manière les distributions. Des probabilités très faibles attribuées à la bonne classe peuvent notamment peser fortement dans la log-loss. Pour expliquer précisément les erreurs du parcours, il faut consulter les sorties par document ; le tableau seul ne donne pas leur détail.
Le modèle latent EM répond partout, mais ses distributions restent proches de l’uniforme. Voici un repère purement mathématique, pas une nouvelle expérience : une distribution [1/3 ; 1/3 ; 1/3] donne un Brier de 2/3 ≈ 0,6667 et une log-loss de log(3) ≈ 1,0986, quelle que soit la classe correcte. Les valeurs observées pour EM, 0,6666 et 1,0985, sont très proches de ce repère. Choisir la composante la plus élevée ne signifie pas que le modèle dispose d’un indice net pour trancher.
Le classifieur sur 90 ancrages fait ici mieux que celui utilisant la supervision faible. Les deux couvrent tous les documents, mais le premier a un macro-F1 supérieur et des erreurs probabilistes plus faibles. Sur ce corpus, passer par les règles et le modèle latent n’améliore donc pas ce point de comparaison.
Ce résultat négatif est central. Il ne prouve pas que toute supervision faible échoue ; il montre que cette combinaison de données, de règles et de modèles ne suffit pas à obtenir un gain. Une architecture plus élaborée doit être confrontée aux résultats, même lorsqu’ils contredisent l’intuition de départ.
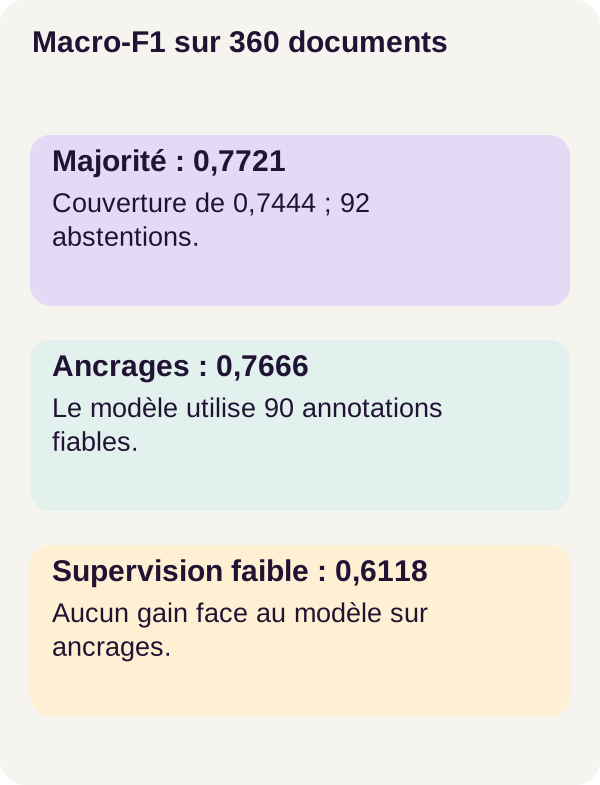
Les méthodes ne partagent pas la même couverture : la majorité s’abstient sur 92 documents.
Ce que nous avons appris
Une règle fournit un avis partiel. Elle peut être correcte, se tromper ou ne pas se prononcer. L’abstention ne doit pas devenir une classe métier par défaut, et un conflit ne doit pas être masqué pour produire une réponse à tout prix.
EM estime une classe cachée en s’appuyant sur des hypothèses concernant les votes. Les ancrages lui donnent des repères fiables, mais des distributions peu informatives restent un signal d’apprentissage limité pour le classifieur suivant.
Enfin, couverture, macro-F1 et erreurs probabilistes racontent des choses différentes. Le parcours nous apprend autant à construire une chaîne de supervision faible qu’à reconnaître le cas où elle ne fait pas mieux que les annotations fiables déjà disponibles.
Exercice : une règle copiée est-elle une nouvelle information ?
Avant de lancer l’expérience, notez votre hypothèse : que se passe-t-il si nous copions la règle « validé dans le titre » ? Le nombre de votes change-t-il ? Avons-nous appris quelque chose de nouveau sur le document ? Prévoyez séparément l’effet sur le modèle latent et sur le classifieur textuel.
Pour vous aider à raisonner, reprenez l’exemple pédagogique [2, 1, -1]. En dupliquant le premier avis, on obtient [2, 1, -1, 2]. La majorité ne voit plus d’égalité, alors qu’aucune nouvelle information n’a été observée. Deux copies de la même condition restent dépendantes, même si elles occupent deux colonnes distinctes.
La variante fournie duplique cette règle, réentraîne la chaîne concernée et évalue sur les mêmes pièces.
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli exercise --config configs/minimum.yaml
docker compose run --rm inference python -m ged_supervision_faible_statuts.cli predict --config configs/minimum.yaml --variant duplicate
docker compose run --rm tutorial python -m ged_supervision_faible_statuts.cli evaluate-exercise --config configs/minimum.yaml
Ouvrez outputs/exercise-comparison.json et comparez les mesures à vos prédictions. Dans le parcours de référence, le macro-F1 du modèle latent diminue d’environ 0,2122, alors que celui du classifieur augmente d’environ 0,0144. Ce sont des écarts de score, pas des variations relatives en pourcentage.
Le Brier du classifieur augmente légèrement : l’amélioration de son macro-F1 ne s’accompagne donc pas d’une amélioration de cette mesure probabiliste. La copie n’a fourni aucune observation indépendante, et ses effets ne sont pas identiques aux deux étapes de la chaîne.
Ne retenez donc pas une règle simpliste comme « dupliquer fait toujours baisser tous les scores ». Retenez plutôt la question à poser : quelle information a réellement été ajoutée, et à quelle étape observe-t-on son effet ?
Pour votre expérience personnelle, choisissez ensuite une seule règle et modifiez son traitement d’une négation. Écrivez d’abord ce qui devrait changer. Rejouez le parcours dans une extraction séparée, en conservant les mêmes ensembles d’évaluation, puis comparez les votes, les abstentions, les exemples et les métriques.
Cette modification personnelle est distincte de la variante de référence : son résultat n’est pas connu à l’avance. Pour une démarche de développement, utilisez la validation pour choisir une amélioration et gardez le test final à l’écart de ces choix, plutôt que d’ajuster sans cesse les règles pour améliorer son score.
Inspecter les figures et contrôler les fichiers
Produisez les figures à partir de vos sorties, puis contrôlez les checkpoints.
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Les fichiers outputs/rules.json, outputs/evaluation.json et les figures permettent de revenir des moyennes aux exemples. Pour V-033, suivez le même chemin que le programme : les indices présents dans le document, les avis des règles, les distributions estimées, puis les propositions des classifieurs. Un résultat moyen ne remplace pas l’inspection de ce parcours.
Les tests négatifs vérifient que le programme refuse une entrée incohérente. Ils couvrent notamment les votes hors des classes autorisées, les probabilités non finies, les distributions mal normalisées et les ancrages invalides. Le succès du test consiste alors à constater le refus attendu, pas à obtenir une classe coûte que coûte.
Dépanner et nettoyer
Compose échoue ? Commencez par son contrôle de configuration, présent dans les premières commandes. Vérifiez l’erreur avant d’attribuer le problème au modèle.
Un état d’entraînement existe déjà ? Utilisez une extraction propre plutôt que l’écraser. Mélanger les résultats de deux essais rendrait les comparaisons difficiles à interpréter.
Une distribution est refusée ? Inspectez les entrées et leur construction. Une somme incorrecte, une valeur négative ou non finie révèle un problème à comprendre. Ne remplacez pas silencieusement les probabilités par une classe arbitraire pour faire passer le contrôle.
Avant le nettoyage, conservez les figures et résultats utiles. Les commandes suivantes arrêtent le projet, effacent seulement outputs/, puis terminent le parcours. Le corpus et les checkpoints sont conservés.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Du tutoriel à une application réelle
Le corpus synthétique permet d’étudier le mécanisme ; il ne représente pas toutes les formulations et toutes les pratiques d’une organisation. Pour une application de gestion électronique de documents, ou GED, commencez par des annotations fiables représentatives des textes et de leurs évolutions.
Mesurez les corrélations entre règles, la couverture, les erreurs par classe et la calibration sur un jeu séparé. Une règle qui exploite une habitude de rédaction ou une date peut cesser d’être utile lorsque les pratiques changent. Les titres, les citations et les dates ne doivent pas devenir des preuves d’un statut administratif.
Côté application, distinguez clairement la proposition du modèle et l’état officiel. Un écran pourrait présenter l’avis proposé, les indices utilisés et une possibilité de contrôle humain ; cette interface est une piste d’intégration, pas une fonctionnalité déjà fournie par le tutoriel.
Ajoutez les droits d’accès, la confidentialité, le versionnement des règles, la traçabilité des propositions, la supervision du service et le contrôle humain. Ces mesures complètent l’évaluation statistique : même un meilleur score ne remplace pas les règles qui déterminent qui peut consulter un document ou modifier son état.
Pour aller plus loin
Améliorer une règle à partir d’erreurs identifiées. Choisissez une confusion observable, formulez une hypothèse, puis mesurez si la modification réduit cette erreur sans en déplacer simplement le coût vers une autre classe.
Comparer plusieurs budgets d’annotations fiables. Le résultat des 90 ancrages donne un point de départ pour étudier l’effet de davantage ou de moins d’exemples vérifiés. Il ne permet pas de prédire les scores de ces nouvelles expériences.
Examiner les dépendances entre règles. Deux règles peuvent être différentes dans le code tout en exploitant presque toujours le même indice. L’exercice de duplication est un cas particulièrement visible de ce problème.
Construire une interface de revue des cas contradictoires. Elle pourrait montrer le document, les votes, les probabilités et la correction humaine. L’intérêt serait de rendre les erreurs inspectables, pas de masquer l’hésitation derrière une seule étiquette.
Références pour approfondir les explications
Le code complet du ZIP décrit les calculs EM et le parcours reproductible R001. Les liens ajoutés au fil du texte renvoient à la présentation de la supervision faible par Stanford et aux documentations de SciPy, PyTorch et scikit-learn pour les mécanismes numériques et les mesures.
Ces références complètent les explications ; elles ne constituent ni une nouvelle validation du projet ni une invitation à remplacer ses implémentations. Pour reproduire les résultats, conservez les dépendances, configurations et commandes du ZIP. Les exemples pédagogiques de votes et de probabilités sont distingués des mesures du corpus.